11. Lokasyon × yıl birleşik tesadüf blokları (TDÖ / VCU birleşik varyans analizi)
Şablon kimliği: lokasyon_yil_tbd · Kategori: deney_tasarimi · Dil: R · Dosya: pro/sablonlar/deney_tasarimi/lokasyon_yil_tbd.R (satır 1–482; üstbilgi 1–94) · Örnek veri: _ornek/lokasyon_yil_tbd.csv · Paketler: lme4, lmerTest, emmeans, pbkrtest (Kenward-Roger seçiliyse), stats, graphics
11.1 Ne işe yarar
Çeşit tescili için yürütülen tarımsal değerleri ölçme (TDÖ; İngilizce value for cultivation and use, VCU) denemelerinde aday çeşitler, standart çeşitlerle birlikte birden çok lokasyonda ve birden çok yılda denenir. Her lokasyonda deneme tesadüf blokları deseninde kurulur. Şablon bu denemelerin lokasyon ve yıllar üzerinden birleşik varyans analizini yapar ve Tohumluk Tescil ve Sertifikasyon Merkez Müdürlüğü (TTSM) teknik talimatlarının istediği iki tabloyu üretir. Cevapladığı soru şudur: "Çeşitler arasındaki farklar, lokasyondan lokasyona ve yıldan yıla değişen çevre koşullarının üstünde, güvenilir biçimde gösterilebiliyor mu?"
- i=1,\dots,l lokasyon; j=1,\dots,y yıl; k=1,\dots,t lokasyon içindeki tekrar (blok); m=1,\dots,ç çeşit.
- L_i: lokasyon; Y_j: yıl; C_m: çeşit; (LY), (LC), (YC), (LYC): etkileşimler.
- R_{k(i)}: i. lokasyonun k. tekrarı; (RY)_{jk(i)}: o tekrarın j. yıldaki sapması. İkisi de her zaman rastgeledir.
- C_m her zaman sabittir. Lokasyon ve yıl sabit ya da rastgele seçilir; rastgele bir etmeni içeren bütün etkileşimler de rastgele olur.
- e_{ijkm}\sim N(0,\sigma^2_e): parsel hatası.
Ne zaman kullanılır? Aynı çeşit kümesi en az iki lokasyonda ve en az iki yılda, her lokasyonda en az iki tekrarlı tesadüf bloklarıyla denenmişse; tekrarlar lokasyon içinde tanımlıysa; TTSM biçiminde varyans analizi ve ortalama verim tablosu gerekiyorsa.
Ne zaman kullanılmaz?
- Yalnız lokasyonlar (ya da yalnız yıllar) üzerinden birleştirme yapılacaksa: şablon en az iki lokasyon ve iki yıl ister; temel programdaki Çok Lokasyonlu Tesadüf Blokları (Birleştirilmiş Varyans Analizi).
- Lokasyonlarda tamamlanmamış bloklar (alfa, kafes) kullanılmışsa: her deneme
alfa_kafesşablonuyla (Bölüm 2) çözümlenir; birleşik çözümleme içinfa_karma_modelşablonu. - Çeşit × çevre etkileşiminin yapısı (hangi çeşit hangi çevrede öne çıkıyor) modellenecekse:
fa_karma_modelşablonu. - Lokasyonların hata varyansları çok farklıysa ve bu modellenecekse:
lme_varyans_yapilarişablonu. - Lokasyonlar ya da yıllar arasında çeşit kümesi değişiyorsa (boş hücreler): tip III hipotezleri kestirilebilir kısımla sınırlanır; karma model yaklaşımı için temel programdaki Çapraz LMM (Çapraz Rastgele Etkili Karma Model).
- Özel karşıtlıklar (adaylar standartların ortalamasına karşı) gerekiyorsa:
r_emmeans_kontrastşablonu.
Temel programla ilişki. Temel programdaki Çok Lokasyonlu Tesadüf Blokları analizi çevreyi tek bir etmen (lokasyon) olarak alır. Bu şablon lokasyon ve yılı ayrı etmenler olarak, tekrarları lokasyon içinde ve yıllarla çapraz alır; her etki için paydayı beklenen kareler ortalamasından kendisi kurar; lokasyon ve yılın sabit ya da rastgele oluşunun dört bileşimini, REML karşılığını ve TTSM tablolarını verir.
11.2 Şablonun girdileri
Form, üstbilgideki on üç [[param]] bloğundan kurulur (lokasyon_yil_tbd.R:10–93).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Yanıt (ör. verim, kg/da) · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | y (105–108). |
Lokasyon · lokasyon |
kategorik sütun · Değişkenler | uygun ilk sütun | herhangi bir sütun | L (109). |
Yıl · yil |
kategorik sütun · Değişkenler | uygun ilk sütun | herhangi bir sütun | Y (109). |
Tekrar (blok; lokasyon içinde, yıllar boyunca aynı) · tekrar |
kategorik sütun · Değişkenler | uygun ilk sütun | herhangi bir sütun | R; lokasyonla birleştirilir (119–121). |
Çeşit / aday · cesit |
kategorik sütun · Değişkenler | uygun ilk sütun | herhangi bir sütun | C (109). |
Lokasyon etkisi · lok_etkisi |
seçim · Model | rastgele |
rastgele, sabit |
L ve onu içeren etkileşimlerin türü (126, 157–175, 258–260). |
Yıl etkisi · yil_etkisi |
seçim · Model | rastgele |
rastgele, sabit |
Y ve onu içeren etkileşimlerin türü (126). |
Çeşit testi, ortalamalar ve AÖF için yöntem · payda_yontemi |
seçim · Model | anova |
anova, reml_satterthwaite, reml_kr |
Ortalamalar ve karşılaştırmalar hangi yoldan (266–269, 349–379). |
Çoklu karşılaştırma yöntemi · coklu_karsilastirma |
seçim · Seçenekler | aof |
aof, tukey, bonferroni |
Kritik değer ve p (384–391). |
Önem düzeyi α · alfa |
ondalık · Seçenekler | 0,05 | 0,001–0,2 | Kritik değerler, harf grupları (103–104). |
Harf gruplarını ver · harf_gruplari |
onay · Çıktı | açık | açık / kapalı | harf sütunu ve şekildeki harfler (413, 457, 476). |
AÖF ve ikili karşılaştırma tablosunu ver · aof_goster |
onay · Çıktı | açık | açık / kapalı | SED, AÖF satırları ve ikili tablo (426–434, 462). |
Varyans analizi tablosu biçimi · tablo_bicimi |
seçim · Çıktı | ikisi |
ikisi, ttsm, ayrintili |
TTSM tabloları ve/ya da ayrıntılı tablolar (292–293). |
Örnek ayar (satır 9) varsayılanlarla aynıdır: y = verim, lokasyon = lokasyon, yil = yil, tekrar = tekrar, cesit = cesit; lokasyon ve yıl rastgele, ANOVA yolu, AÖF, α = 0,05.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde deneme verisini açın." | 97 |
| Beş sütundan biri seçilmemiş | "Yanıt, lokasyon, yıl, tekrar ve çeşit sütunlarını seçin." | 99–100 |
| Aynı sütun iki role verilmiş | "…farklı sütunlar olmalı." | 102 |
| α, 0 ile 0,5 arasında değil | "α 0 ile 0,5 arasında olmalı." | 104 |
| 12'den az tam gözlem | "En az 12 tam gözlem gerekli." | 110 |
| Yanıt sabit | "Yanıt sabit." | 111 |
| 2'den az lokasyon / yıl / çeşit | "En az 2 lokasyon gerekli…" / "En az 2 yıl gerekli…" / "En az 2 çeşit gerekli." | 112–114 |
| Bir lokasyonda 2'den az tekrar | "Her lokasyonda en az 2 tekrar gerekli." | 115–116 |
| Aynı lokasyon × yıl × tekrar × çeşit iki kez | "…her parsel tek satır olmalı." | 117–118 |
| Karma model uydurulamadı | "Karma model kurulamadı: …" | 264 |
| Kenward-Roger seçili, pbkrtest yok | "Kenward-Roger için pbkrtest paketi gerekli…" | 267–268 |
Eksik ya da sayıya çevrilemeyen yanıtlı satırlar atılır (satır 107–108). Durdurmayan uyarılar çıktının sonunda "Uyarılar:" satırında toplanır: boş hücre (242); dengesiz veri ve eksik parsel sayısı (243); REML'de sınırda kestirilen bileşen (279); negatif moment kestirimi (335–336); dörtten az düzeyli rastgele lokasyon ya da yıl (479–480).
11.3 Örnek veri
Dosya: _ornek/lokasyon_yil_tbd.csv. Şablon için benzetimle üretilmiştir; gerçek bir deneme değildir. 3 lokasyon × 2 yıl × 4 tekrar × 8 çeşit = 192 parsel; dengeli, eksik değer yok.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
lokasyon |
Lokasyon | kategorik | Ankara, Eskisehir, Konya; her biri 64 parsel. |
yil |
Yıl | ikili | 2024, 2025; her biri 96 parsel. |
tekrar |
Tekrar | sayısal | 1–4; her lokasyonda aynı numaralar. |
cesit |
Çeşit | kategorik | C1 … C8; her biri 24 parsel. |
verim |
Yanıt | sayısal | 325,7–563,2; ortalama 443,83; standart sapma 55,90. |
Lokasyon × yıl ortalamaları:
| 2024 | 2025 | Lokasyon ort. | |
|---|---|---|---|
| Ankara | 370,99 | 432,05 | 401,52 |
| Eskisehir | 423,14 | 446,29 | 434,71 |
| Konya | 498,47 | 492,07 | 495,27 |
Yıl farkı Ankara'da 61, Konya'da −6 birimdir: belirgin bir lokasyon × yıl etkileşimi vardır.
Düzey sırası. Dört etmen de metne çevrilip factor() ile kurulur (satır 109); düzeyler alfabetiktir. Sıra hiçbir sonucu değiştirmez: kareler toplamları toplam-sıfır kodlamayla hesaplanır, çeşit ortalamaları büyükten küçüğe sıralanır, ikili karşılaştırmalar çeşit adlarıyla yazılır. Tekrar numaraları lokasyon adıyla birleştirilir ("Ankara:1"; satır 119): farklı lokasyonlardaki aynı numaralı tekrarlar ayrı bloklardır. Aynı lokasyonda aynı numaralı tekrar ise yıllar boyunca aynı blok sayılır (11.8).
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) lokasyon ve yıl sabit; (3) lokasyon sabit, yıl rastgele; (4) lokasyon rastgele, yıl sabit; (5) örnek ayar + REML, Satterthwaite; (6) örnek ayar + REML, Kenward-Roger; (7) örnek ayar + Tukey.
11.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) etmenleri ve birleşik etiketleri kur; (2) tip III kareler toplamlarını hesapla; (3) her kaynağın beklenen kareler ortalamasını sentezle; (4) her etki için paydayı kareler ortalamalarının doğrusal bileşimi olarak kur, Satterthwaite sd'siyle F testini yap; (5) moment varyans bileşenlerini çöz; (6) aynı modeli REML ile uydur; (7) çeşit ortalamalarını, SED'i, AÖF'yi ve harf gruplarını seçilen yoldan hesapla; (8) her lokasyonu yıllar üzerinden ayrıca çözümleyip Form 5 tablosunu kur.
11.4.1 Varyans analizi tablosu ve serbestlik dereceleri
Model, TTSM'nin Lokasyon-Yıl Birleşik Varyans Analiz Tablosu'ndaki kaynaklarla birebir aynıdır. Dengeli veride serbestlik dereceleri:
| Varyasyon kaynağı | Serbestlik derecesi | Örnek (l=3, y=2, t=4, ç=8) |
|---|---|---|
| Genel | g-1 | 191 |
| Lokasyon | l-1 | 2 |
| Tekrar(Lok) | l(t-1) | 9 |
| Yıl | y-1 | 1 |
| Lok*Yıl | (l-1)(y-1) | 2 |
| Tekrar*Yıl(Lok) | l(t-1)(y-1) | 9 |
| Çeşit | ç-1 | 7 |
| Lok*Çeşit | (l-1)(ç-1) | 14 |
| Yıl*Çeşit | (y-1)(ç-1) | 7 |
| Lok*Yıl*Çeşit | (l-1)(y-1)(ç-1) | 14 |
| Hata | ly(t-1)(ç-1) | 126 |
Tablonun üst yarısı (Lokasyon … Tekrar*Yıl(Lok)) bloklar arası tabakadır: l\,t\,y=24 blok-yıl biriminin 23 serbestlik derecesini paylaşır. Alt yarısı parsel tabakasıdır. Hata, çeşit × tekrar(lokasyon × yıl) etkileşimidir.
11.4.2 Tip III kareler toplamları
Her terim toplam-sıfır karşıtlıklarıyla kodlanır ve terimin kareler toplamı, o terimin sütunları modelden çıkarıldığında artık kareler toplamındaki artış olarak hesaplanır (satır 178–204):
- \mathbf X: bütün terimlerin (rastgele olanlar dahil) toplam-sıfır kodlu tasarım matrisi; \mathbf X_{-i}: i. terimin sütunları çıkarılmış matris.
- \mathrm{AKT}(\cdot): o matrisle yapılan en küçük kareler uyumunun artık kareler toplamı.
- İç içe terimler (Tekrar(Lok), Tekrar*Yıl(Lok)) her lokasyonun içinde ayrı ayrı toplam-sıfır kodlanır (
ic_ice, satır 142–153).
Neden tip III ve toplam-sıfır kodlama?
Dengeli veride bütün kareler toplamı tanımları (ardışık, kısmi, tip III) aynı sayıyı verir ve klasik el hesabıyla örtüşür (11.6, Adım 1). Eksik parsel olduğunda terimler dik olmaktan çıkar; ardışık kareler toplamı terimlerin yazılış sırasına bağlı olur. Tip III tanımı her terimi, öteki bütün terimler modeldeyken sınar ve sıradan bağımsızdır. Toplam-sıfır kodlama, bir ana etkinin sütunlarını çıkarmanın "etkileşimler üzerinden ortalaması alınmış ana etki sıfırdır" hipotezine karşılık gelmesini sağlar; köşe kodlamasında aynı işlem başka bir hipotezi sınardı.
11.4.3 Beklenen kareler ortalaması
Rastgele etkiler varken \mathrm{KO}_i'nin beklenen değeri, hata varyansına ek olarak bazı varyans bileşenlerini de içerir. Şablon katsayıları Hartley'in (1967) sentez yöntemiyle hesaplar (satır 195–199):
- \mathbf Z_j: j. rastgele terimin gösterge matrisi (her düzeye bir sütun).
- \mathbf H(\cdot): o matrisin sütun uzayına izdüşüm; \mathbf A_i, \mathrm{KT}_i=\mathbf y^{\top}\mathbf A_i\mathbf y'yi veren matristir.
- Q_i: i. terim sabitse, etkilerinin karesel biçimi (tabloda "Q(…)"); H_0 altında sıfırdır.
- Mutlak değeri 10^{-10}'dan küçük katsayılar sıfır sayılır (satır 205).
Dengeli veride katsayı bir kuralla bulunur: j. terim i. terimin bütün etmenlerini içeriyorsa c_{ij}=N/(j\text{. terimin düzey sayısı}), içermiyorsa 0. Örnek veride (N=192) lokasyon ve yıl rastgeleyken:
| Kaynak | Beklenen kareler ortalaması |
|---|---|
| Lokasyon | \sigma^2_e+4\sigma^2_{LYC}+8\sigma^2_{LC}+8\sigma^2_{RY(L)}+32\sigma^2_{LY}+16\sigma^2_{R(L)}+64\sigma^2_{L} |
| Tekrar(Lok) | \sigma^2_e+8\sigma^2_{RY(L)}+16\sigma^2_{R(L)} |
| Yıl | \sigma^2_e+4\sigma^2_{LYC}+12\sigma^2_{YC}+8\sigma^2_{RY(L)}+32\sigma^2_{LY}+96\sigma^2_{Y} |
| Lok*Yıl | \sigma^2_e+4\sigma^2_{LYC}+8\sigma^2_{RY(L)}+32\sigma^2_{LY} |
| Tekrar*Yıl(Lok) | \sigma^2_e+8\sigma^2_{RY(L)} |
| Çeşit | \sigma^2_e+4\sigma^2_{LYC}+12\sigma^2_{YC}+8\sigma^2_{LC}+Q(C) |
| Lok*Çeşit | \sigma^2_e+4\sigma^2_{LYC}+8\sigma^2_{LC} |
| Yıl*Çeşit | \sigma^2_e+4\sigma^2_{LYC}+12\sigma^2_{YC} |
| Lok*Yıl*Çeşit | \sigma^2_e+4\sigma^2_{LYC} |
| Hata | \sigma^2_e |
Koddaki tercih
Sentez sınırsız (unrestricted) model içindir: sabit × rastgele bir etkileşimin etkilerine "sabit etmen üzerinden toplamı sıfır" kısıtı konmaz. Sonuç olarak rastgele bir ana etkinin beklenen kareler ortalaması, onu içeren sabit × rastgele etkileşimin bileşenini de içerir. Örneğin lokasyon sabit, yıl rastgeleyken E(\mathrm{KO}_{Y})'de 32\sigma^2_{LY} ve 12\sigma^2_{YC} bulunur ve yıl, \mathrm{KO}_{LY}+\mathrm{KO}_{YC}-\mathrm{KO}_{LYC} bileşimine karşı sınanır. Kısıtlı modelde bu terimler düşer. Karma model yazılımlarının (REML) kurduğu model de sınırsız modeldir; iki yol bu yüzden aynı hipotezleri sınar.
11.4.4 Payda bileşimi ve Satterthwaite serbestlik derecesi
Bir etkinin F testinde payda, beklenen değeri H_0 altında payın beklenen değerine eşit olan bir büyüklük olmalıdır. Şablon her etki için, öteki rastgele terimlerin ve hatanın kareler ortalamalarından böyle bir doğrusal bileşim arar (satır 207–221):
- c_k: bileşim katsayıları; dengeli veride +1 ve -1'dir. Payda tek bir kareler ortalamasıysa sd o kaynağın sd'sidir (satır 227).
- \mathrm{sd}_{payda}: Satterthwaite'in (1946) yaklaşık serbestlik derecesi; kesirli olabilir.
- p=P(F_{\mathrm{sd}_i,\ \mathrm{sd}_{payda}}>F). \mathrm{KO}_{payda}\le0 çıkarsa F ve p boş bırakılır (228).
Çeşit için, lokasyon ve yıl rastgeleyken:
Bu, E(\mathrm{KO}_C)'nin Q(C) dışındaki kısmıdır; çeşit, \mathrm{KO}_{LC}+\mathrm{KO}_{YC}-\mathrm{KO}_{LYC}'ye karşı sınanır. Lokasyon ve yılın türüne göre çeşit paydası değişir (McIntosh, 1983):
| Lokasyon | Yıl | Çeşit paydası | Payda sd | Çeşit F | p | AÖF (%5) |
|---|---|---|---|---|---|---|
| rastgele | rastgele | \mathrm{KO}_{LC}+\mathrm{KO}_{YC}-\mathrm{KO}_{LYC} | 7,49 | 6,58 | 0,0099 | 31,80 |
| rastgele | sabit | \mathrm{KO}_{LC} | 14 | 5,96 | 0,0023 | 30,72 |
| sabit | rastgele | \mathrm{KO}_{YC} | 7 | 15,41 | 0,0009 | 21,06 |
| sabit | sabit | \mathrm{KO}_{Hata} | 126 | 37,18 | <0{,}0001 | 11,35 |
Neden lokasyon ve yıl varsayılan olarak rastgele?
Tescil kararı, çeşidin denendiği üç lokasyon ve iki yıl için değil, önerileceği bölgenin bütün tarlaları ve gelecek yılları için verilir. Denenen çevreler bu kitlenin bir örneğidir. Çevreler rastgele alındığında çeşit farkı, çeşit × çevre etkileşimlerine karşı sınanır: bir çeşidin üstünlüğü ancak çevreden çevreye tutarlıysa anlamlı çıkar. Çevreler sabit alınırsa sonuç yalnız o lokasyon ve yıllar için geçerlidir; test parsel hatasına karşı yapılır ve çok daha kolay anlamlı çıkar (örnekte F 6,58 yerine 37,18; AÖF 31,80 yerine 11,35). İki sonucun farkı bir hesap ayrıntısı değil, sorulan sorunun farkıdır.
Eksi işaretli bileşimde Satterthwaite yaklaşımı
Satterthwaite formülü, bileşimdeki katsayıların hepsi pozitifken iyi çalışır. Eksi işaretli terim varsa bileşim negatif bile çıkabilir ve yaklaşık sd güvenilirliğini yitirir; Gaylor ve Hopper (1969) eksi terimin katkısı küçük kaldıkça yaklaşımın kullanılabileceğini göstermiştir. Örnekte çeşit paydasında eksi terimin payı büyüktür (1186/2228) ve sd 7,49'a düşer. Az sayıda lokasyon ve yılda bu kaçınılmazdır; şablon dörtten az düzeyli rastgele etmen için ayrıca uyarı yazar.
11.4.5 Moment varyans bileşenleri
Beklenen kareler ortalaması tablosu, varyans bileşenleri için bir doğrusal denklem sistemidir. Gözlenen kareler ortalamaları beklenen değerlerinin yerine konup sistem çözülür (satır 234–235):
- \mathbf E: rastgele terimlerin ve hatanın beklenen kareler ortalaması katsayılarından oluşan kare matris.
- Dengeli veride sistem üçgendir; örneğin \hat\sigma^2_{LYC}=(\mathrm{KO}_{LYC}-\mathrm{KO}_{Hata})/4.
- Kestirimler negatif çıkabilir: bir etkileşimin kareler ortalaması, altındaki terimin kareler ortalamasından küçükse (Searle, Casella ve McCulloch, 1992).
11.4.6 REML yolu
Aynı model doğrusal karma model olarak REML ile (Patterson ve Thompson, 1971) uydurulur (satır 257–265); tarla denemelerinde karma modelin kuruluşu için Piepho, Büchse ve Emrich (2003) temel başvurudur. Rastgele terimler seçime göre kurulur: tekrar(lokasyon) ve tekrar × yıl(lokasyon) her zaman; lokasyon rastgeleyse lokasyon, lokasyon × çeşit; yıl rastgeleyse yıl, yıl × çeşit; ikisinden biri rastgeleyse lokasyon × yıl ve lokasyon × yıl × çeşit. Rastgele olmayanlar sabit etkilere girer.
Koddaki tercih
Model lmerTest::lmer(…, REML = TRUE) ile, bobyqa eniyileyicisi ve sıkı durma ölçütüyle (rhoend = 1e-12) uydurulur (satır 263). Sınırda (0) kestirilen bir bileşen varsa (ölçeklenmiş parametre <10^{-6}; satır 271), o bileşen modelden çıkarılarak model yeniden uydurulur ve F testleri ile ortalama karşılaştırmaları bu ikinci modelden alınır (273–281); varyans bileşenleri tablosu ilk modelden yazılır (284). Sabit etki testleri anova(type = 3, ddf =) ile, Satterthwaite (Kuznetsova, Brockhoff ve Christensen, 2017) ya da Kenward-Roger (Kenward ve Roger, 1997; Halekoh ve Højsgaard, 2014) sd'siyle verilir (282). lme4 için Bates ve ark. (2015). Bütün model toplam-sıfır karşıtlıklarıyla kurulur (262).
Neden sınırdaki bileşen çıkarılıyor?
Sıfır kestirilen bir bileşen olabilirliği ve sabit etki kestirimlerini değiştirmez; ama payda serbestlik derecesinin yaklaşık hesabı, modelde hangi bileşenlerin bulunduğuna bağlıdır. Bileşen modelde kalırsa Kenward-Roger ve Satterthwaite hesapları, bilgi taşımayan bir parametrenin belirsizliğini de hesaba katar ve sd değişir. Bileşeni çıkarmak, sd'yi gerçekten kestirilen bileşenlere dayandırır. Dengeli veride bu, sıfır çıkan etkileşimin kareler toplamının bir üst etkileşimle havuzlanmasına denktir (11.6, Adım 6).
Dengeli veride ve bütün moment kestirimleri pozitifken REML ile moment yöntemi aynı bileşenleri, aynı F ve sd değerlerini verir. Ayrışma, bir moment kestirimi negatif olduğunda başlar: REML o bileşeni sıfırda tutar ve geri kalanları yeniden dengeler.
11.4.7 Çeşit ortalamaları, SED, AÖF ve harf grupları
Çeşit ortalamaları kestirilmiş marjinal ortalamalardır (EMM): her çeşidin, lokasyon, yıl ve tekrarlar üzerinden eşit ağırlıkla dengelenmiş ortalaması. Dengeli veride ham ortalamayla aynıdır. ANOVA yolunda (satır 349–363):
- \mathbf L: çeşit ortalamalarını katsayılardan üreten matris (kesişim + çeşidin toplam-sıfır kodu).
- \mathrm{KO}_{payda} ve sd: çeşit F testinin paydası ve Satterthwaite sd'si; bütün ikili karşılaştırmalarda aynı sd kullanılır (362).
- Dengeli veride v_{mm}=1/(l\,y\,t) ve v_{mm'}=0: \operatorname{SH}=\sqrt{\mathrm{KO}_{payda}/(lyt)}, \operatorname{SED}=\sqrt{2\,\mathrm{KO}_{payda}/(lyt)}.
ANOVA yolunun SH'si karşılaştırma içindir
ANOVA yolundaki SH, \operatorname{SED}/\sqrt2'dir: iki çeşidin farkına giren belirsizliğin bir çeşide düşen payıdır. Lokasyon ve yıl rastgeleyken bir çeşit ortalamasının kendi belirsizliği lokasyon, yıl ve blok bileşenlerini de içerir; bunlar farkta sadeleşir ama tek ortalamada kalır. Örnekte ANOVA yolunun SH'si 9,64, REML yolunun (bütün bileşenleri içeren) SH'si 30,26'dır. Bir çeşidin verimi için güven aralığı kurulacaksa REML yolunun SH'si kullanılır; çeşitler karşılaştırılacaksa SED ve AÖF.
REML yolunda ortalamalar, SH'ler ve her ikili farkın SED'i ile sd'si emmeans'ten (Lenth ve Piaskowski, 2026) alınır (satır 365–378); karşılaştırma sd'si ikili farkların sd'lerinin ortalamasıdır.
Karşılaştırma ölçütü, ortalama SED ile kritik değerin çarpımıdır (satır 384–394):
- \overline{\operatorname{SED}}=\sqrt{\operatorname{ort}(\operatorname{SED}^2)}: ikili SED'lerin karesel ortalaması; dengeli veride hepsi eşittir.
- q: öğrencileştirilmiş açıklık dağılımının çeyreği; k: çeşit sayısı. Bonferroni'de k(k-1)/2 karşılaştırmanın her biri \alpha/[k(k-1)/2] düzeyinde, iki yönlü sınanır.
- İkili p değerleri aynı tanımlarla hesaplanır (388–391); Bonferroni p'si 1'i aşamaz.
Harf grupları (satır 395–410): çeşitler büyükten küçüğe sıralanır. Her çeşitten başlayarak, içindeki bütün çiftlerin farkı önemsiz (p>\alpha) kalacak biçimde aşağı doğru en uzun dizi bulunur; daha önce bulunan bir dizinin içinde kalmayan her dizi yeni bir harf alır. Aynı harfi paylaşan çeşitler arasındaki fark önemsizdir.
Neden AÖF varsayılan?
TTSM tabloları AÖF (asgari önemli fark) ister ve çeşit denemelerinde yerleşik ölçüt odur. AÖF yalnız tek bir karşılaştırmanın hata olasılığını denetler: sekiz çeşitte 28 ikili karşılaştırma vardır ve hiçbir gerçek fark yokken en az birinin anlamlı çıkma olasılığı \alpha'nın çok üstündedir. Çok sayıda aday varsa ve yanlış üstünlük savının bedeli yüksekse Tukey seçilir; örnekte ölçüt 31,80'den 54,92'ye çıkar.
11.4.8 Form 5: ortalama verim tablosu
TTSM'nin buğday ve arpa talimatlarındaki Form 5, çeşit × lokasyon ortalamalarını ve her lokasyonun kendi istatistiklerini tek tabloda verir. Şablon her lokasyonu yıllar üzerinden ayrıca çözümler (satır 441–455): model tekrar, yıl, tekrar × yıl, çeşit ve yıl × çeşit terimlerinden oluşur; yıl formdaki seçimle aynı türdedir.
- Lokasyon sütunları: o lokasyonda çeşidin yıllar ve tekrarlar üzerinden ortalaması.
- F satırı: o lokasyondaki çeşit F'si. Yıl rastgeleyse payda \mathrm{KO}_{YC} ((y-1)(ç-1) sd), sabitse \mathrm{KO}_{Hata}.
- DK (%): 100\sqrt{\mathrm{KO}_{Hata}}/\bar y, o lokasyonun kendi hatası ve ortalamasıyla.
- AÖF satırı: \text{kritik değer}\times\sqrt{2\,\mathrm{KO}_{payda}/n_ç}; n_ç o lokasyonda çeşit başına parsel sayısı (451).
- Ortalama sütunu ve son sütundaki F, DK, AÖF: birleşik çözümlemenin değerleri.
11.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–94 | Üstbilgi: açıklama, örnek veri ve ayar, on üç parametre. | Form ve varsayılanlar (Bölüm 1.2). |
| 95–131 | Sütun denetimleri, eksik satırların atılması, etmenler, birleşik etiketler, denge denetimi. | dengeli: eksik parsel yok ve her lokasyonda aynı tekrar sayısı (130). |
| 132–175 | Kodlama yardımcıları (cs, kat, ic_ice, gosterge) ve terim_kur(). |
Her terim: kodlu sütunlar, rastgele mi, gösterge matrisi. |
| 177–238 | birlesik_anova(): tip III KT, sentezlenmiş beklenen KO, payda bileşimi, Satterthwaite, moment bileşenleri. |
Payda katsayıları tamsayıya yakınsa yuvarlanır (219). |
| 240–254 | Birleşik çözümleme; boş hücre ve dengesizlik uyarıları; kaynak adları; özet satırı. | Dengesiz veride sd'ler TTSM formüllerinden sapar (243). |
| 256–285 | REML: model formülü, lmer, sınırdaki bileşenin çıkarılması, tip III F testleri. |
İkinci uyum yalnız test ve karşılaştırmalar içindir (273–281). |
| 287–344 | TTSM varyans analizi tablosu; ayrıntılı tablo; beklenen KO tablosu; varyans bileşenleri; REML F tablosu. | TTSM tablosunda olasılık yüzde olarak yazılır (296). |
| 346–434 | Çeşit ortalamaları (ANOVA ya da REML yolu), SED, kritik değerler, ikili p'ler, harf grupları, özet ve ikili tablolar. | Kritik değer seçilen yönteme göre (384–387). |
| 436–467 | Form 5: lokasyon başına çözümleme ve tablonun kurulması. | Lokasyon çözümlemeleri her zaman ANOVA yolundandır (446–451). |
| 469–482 | Şekil (ortalamalar ± AÖF/2, harfler); az düzey uyarısı; uyarıların yazılması. | Çubuklar üst üste binmiyorsa fark AÖF'den büyüktür. |
11.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/lokasyon_yil_tbd/elle_hesap.py ile hesaplanmıştır. Betik şablonun yolunu (model karşılaştırması, QR ayrışımı, lme4) izlemez: dengeli tasarımın klasik el hesabını uygular. Kareler toplamları hücre ortalamalarından, beklenen kareler ortalaması katsayıları 11.4.3'teki kuraldan, REML değerleri havuzlamalı kapalı biçimden gelir. R tarafında kareler toplamları stats::aov ile, REML denklemleri Fisher puanlama yinelemesiyle (skor ve beklenen bilgi matrisi; lme4 kullanılmadan) çözülmüştür (r_dogrulama.R).
Adım 1 — Düzeltilmemiş kareler toplamları ve KT. Bir etmen kümesi S için R(S)=\sum_{\text{hücre}}n\,\bar y^2; R(\varnothing)=N\bar y^2 düzeltme terimidir.
| S | R(S) | S | R(S) |
|---|---|---|---|
| \varnothing | 37821701,3333 | L,C | 38248062,8375 |
| L | 38110925,4241 | Y,C | 37963322,4367 |
| Y | 37853998,7085 | L,R | 38134405,2700 |
| C | 37924362,4458 | L,R,Y | 38208395,2925 |
| L,Y | 38179815,2819 | L,Y,C | 38340222,3700 |
| \sum y^2 | 38418500,0800 |
Kareler toplamları içerme-dışlama ile bulunur; örneğin:
Adım 2 — Kareler ortalamaları.
| Kaynak | sd | KT | KO |
|---|---|---|---|
| Lokasyon | 2 | 289224,0907 | 144612,0454 |
| Tekrar(Lok) | 9 | 23479,8459 | 2608,8718 |
| Yıl | 1 | 32297,3752 | 32297,3752 |
| Lok*Yıl | 2 | 36592,4826 | 18296,2413 |
| Tekrar*Yıl(Lok) | 9 | 5100,1647 | 566,6850 |
| Çeşit | 7 | 102661,1125 | 14665,8732 |
| Lok*Çeşit | 14 | 34476,3009 | 2462,5929 |
| Yıl*Çeşit | 7 | 6662,6156 | 951,8022 |
| Lok*Yıl*Çeşit | 14 | 16607,0591 | 1186,2185 |
| Hata | 126 | 49697,6994 | 394,4262 |
| Genel | 191 | 596798,7467 |
Adım 3 — Çeşit ve lokasyon testleri (lokasyon ve yıl rastgele).
Lokasyon için payda beş kareler ortalamasının bileşimidir:
Lokasyon ortalamaları 401,5 ile 495,3 arasında değiştiği hâlde test anlamlı değildir: payda sd'si 2,77'dir, çünkü lokasyon farkı yalnız üç lokasyon ve iki yılın oluşturduğu çevre değişkenliğine karşı ölçülebilir.
Adım 4 — Moment varyans bileşenleri. Tablonun altından yukarıya:
Öteki bileşenler: \hat\sigma^2_{RY(L)}=21{,}5323; \hat\sigma^2_{R(L)}=127{,}6367; \hat\sigma^2_{LY}=529{,}3051; \hat\sigma^2_{Y}=148{,}2870; \hat\sigma^2_{L}=1921{,}8319. Yıl × çeşit bileşeni negatiftir: bu etkileşimin kareler ortalaması (951,8) üç yönlü etkileşiminkinden (1186,2) küçüktür.
Adım 5 — Ortalamalar ve karşılaştırma ölçütleri (ANOVA yolu). Her çeşit l\,y\,t=24 parselin ortalamasıdır.
t_{0{,}975;\,7{,}4873}=2{,}333783 ile \text{AÖF}=2{,}333783\cdot13{,}6265=31{,}8013. Tukey için q_{0{,}95;\,8;\,7{,}4873}=5{,}700084 ve ölçüt 5{,}700084/\sqrt2\cdot13{,}6265=54{,}9225. En büyük fark C7 − C8 =76{,}1625 (p=0{,}000653; Tukey p=0{,}008528); C1 − C7 =-46{,}2750 AÖF ile önemli (p=0{,}010395), Tukey ile önemsizdir (p=0{,}108507).
Adım 6 — REML (lokasyon ve yıl rastgele). Yıl × çeşit bileşeni sıfırda tutulur; bu etkileşimin kareler toplamı üç yönlü etkileşimle havuzlanır:
\hat\sigma^2_{L}=1920{,}6110; blok bileşenleri ve hata moment değerleriyle aynıdır. Yıl × çeşit modelden çıkınca çeşit paydası \mathrm{KO}_{LC}'ye iner:
Bir çeşit ortalamasının REML standart hatası bütün bileşenleri içerir:
Adım 7 — Form 5, Ankara. Lokasyon içi çözümlemede \mathrm{KO}_C=3250{,}5079, \mathrm{KO}_{YC}=1733{,}8086, \mathrm{KO}_{Hata}=382{,}1680; lokasyon ortalaması 401,5188.
Yıl sabit alınsaydı aynı lokasyonda F=3250{,}5079/382{,}1680=8{,}5054 ve AÖF 19,7259 olurdu.
Adım 8 — İkisi de sabit. Çeşit hataya karşı sınanır: F=14665{,}8732/394{,}4262=37{,}1828 (sd 7; 126); \operatorname{SED}=\sqrt{2\cdot394{,}4262/24}=5{,}7331; \text{AÖF}=1{,}978971\cdot5{,}7331=11{,}3457. Lokasyon \mathrm{KO}_{R(L)}'ye karşı (F=55{,}4309), yıl ve lokasyon × yıl \mathrm{KO}_{RY(L)}'ye karşı sınanır (F=56{,}9935 ve 32,2864).
11.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1–3 ve 5–7).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| KT Lokasyon | 2,892241·105 | 2,892241·105 | 2,892241·105 | 1,2e−14 | ✓ |
| KT Tekrar(Lok) | 23479,8459375 | 23479,84593751 | 23479,8459375 | 2,3e−13 | ✓ |
| KT Yıl | 32297,37520833 | 32297,37520833 | 32297,37520833 | 5,1e−15 | ✓ |
| KT Lok×Yıl | 36592,48260417 | 36592,48260417 | 36592,48260417 | 4,8e−14 | ✓ |
| KT Tekrar×Yıl(Lok) | 5100,1646875 | 5100,16468749 | 5100,1646875 | 1,6e−12 | ✓ |
| KT Çeşit | 1,026611·105 | 1,026611·105 | 1,026611·105 | 4,4e−14 | ✓ |
| KT Lok×Çeşit | 34476,3009375 | 34476,3009375 | 34476,3009375 | 1,0e−13 | ✓ |
| KT Yıl×Çeşit | 6662,615625 | 6662,61562501 | 6662,615625 | 1,3e−12 | ✓ |
| KT Lok×Yıl×Çeşit | 16607,0590625 | 16607,05906248 | 16607,0590625 | 1,1e−12 | ✓ |
| KT Hata | 49697,699375 | 49697,699375 | 49697,699375 | 7,4e−14 | ✓ |
| F Lokasyon | 6,69041714 | 6,69041714 | 6,69041714 | 1,7e−13 | ✓ |
| Payda KO Lokasyon | 21614,80252728 | 21614,80252729 | 21614,80252728 | 1,8e−13 | ✓ |
| Payda sd Lokasyon (Satterthwaite) | 2,76938132 | 2,76938132 | 2,76938132 | 2,7e−13 | ✓ |
| p Lokasyon | 0,08701819 | 0,08701819 | 0,08701819 | 1,3e−14 | ✓ |
| F Tekrar(Lok) | 4,6037427 | 4,6037427 | 4,6037427 | 1,8e−12 | ✓ |
| p Tekrar(Lok) | 0,01640165 | 0,01640165 | 0,01640165 | 9,5e−14 | ✓ |
| F Yıl | 1,7881568 | 1,7881568 | 1,7881568 | 2,0e−13 | ✓ |
| Payda KO Yıl | 18061,82502976 | 18061,82502977 | 18061,82502976 | 1,9e−13 | ✓ |
| Payda sd Yıl (Satterthwaite) | 1,94640546 | 1,94640546 | 1,94640546 | 2,9e−13 | ✓ |
| p Yıl | 0,31602022 | 0,31602022 | 0,31602022 | 2,4e−15 | ✓ |
| F Lok×Yıl | 13,46819819 | 13,46819819 | 13,46819819 | 1,7e−12 | ✓ |
| Payda KO Lok×Yıl | 1358,47728423 | 1358,47728422 | 1358,47728423 | 1,7e−12 | ✓ |
| Payda sd Lok×Yıl (Satterthwaite) | 13,42893587 | 13,42893587 | 13,42893587 | 8,6e−13 | ✓ |
| p Lok×Yıl | 6,175987·10−4 | 6,175987·10−4 | 6,175987·10−4 | 3,2e−15 | ✓ |
| F Tekrar×Yıl(Lok) | 1,43673262 | 1,43673262 | 1,43673262 | 1,6e−12 | ✓ |
| p Tekrar×Yıl(Lok) | 0,17929015 | 0,17929015 | 0,17929015 | 9,7e−13 | ✓ |
| F Çeşit | 6,5820065 | 6,5820065 | 6,5820065 | 1,2e−12 | ✓ |
| Payda KO Çeşit | 2228,17665179 | 2228,17665179 | 2228,17665179 | 1,3e−12 | ✓ |
| Payda sd Çeşit (Satterthwaite) | 7,48726723 | 7,48726723 | 7,48726723 | 2,3e−12 | ✓ |
| p Çeşit | 0,00987997 | 0,00987997 | 0,00987997 | 2,5e−14 | ✓ |
| F Lok×Çeşit | 2,07600279 | 2,07600279 | 2,07600279 | 1,2e−12 | ✓ |
| p Lok×Çeşit | 0,09206466 | 0,09206466 | 0,09206466 | 3,7e−13 | ✓ |
| F Yıl×Çeşit | 0,80238356 | 0,80238356 | 0,80238356 | 2,0e−12 | ✓ |
| p Yıl×Çeşit | 0,59875393 | 0,59875393 | 0,59875393 | 1,4e−12 | ✓ |
| F Lok×Yıl×Çeşit | 3,00745373 | 3,00745373 | 3,00745373 | 1,2e−12 | ✓ |
| p Lok×Yıl×Çeşit | 5,202060·10−4 | 5,202060·10−4 | 5,202060·10−4 | 7,4e−15 | ✓ |
| Moment bileşeni \hat\sigma^2(Lokasyon) | 1921,83191933 | 1921,83191933 | 1921,83191933 | 2,2e−14 | ✓ |
| Moment bileşeni \hat\sigma^2(Tekrar(Lok)) | 127,63667535 | 127,63667535 | 127,63667535 | 7,3e−13 | ✓ |
| Moment bileşeni \hat\sigma^2(Yıl) | 148,28698103 | 148,28698103 | 148,28698103 | 2,6e−13 | ✓ |
| Moment bileşeni \hat\sigma^2(Lok×Yıl) | 529,30512556 | 529,30512556 | 529,30512556 | 1,9e−13 | ✓ |
| Moment bileşeni \hat\sigma^2(Tekrar×Yıl(Lok)) | 21,53234747 | 21,53234747 | 21,53234747 | 5,3e−12 | ✓ |
| Moment bileşeni \hat\sigma^2(Lok×Çeşit) | 159,54680246 | 159,54680246 | 159,54680246 | 1,3e−12 | ✓ |
| Moment bileşeni \hat\sigma^2(Yıl×Çeşit) | −19,53468936 | −19,53468936 | −19,53468936 | 1,1e−11 | ✓ |
| Moment bileşeni \hat\sigma^2(Lok×Yıl×Çeşit) | 197,94807974 | 197,94807974 | 197,94807974 | 1,8e−12 | ✓ |
| Moment bileşeni \hat\sigma^2(Hata) | 394,42618552 | 394,42618552 | 394,42618552 | 7,5e−14 | ✓ |
| REML bileşeni \hat\sigma^2(Lokasyon) | 1920,61703466 | 1920,61100125 | 1920,61100125 | 3,1e−6 | ✗ |
| REML bileşeni \hat\sigma^2(Tekrar(Lok)) | 127,63667458 | 127,63667535 | 127,63667535 | 6,0e−9 | ✓ |
| REML bileşeni \hat\sigma^2(Yıl) | 145,84458333 | 145,84514486 | 145,84514486 | 3,9e−6 | ✗ |
| REML bileşeni \hat\sigma^2(Lok×Yıl) | 531,7461212 | 531,74696173 | 531,74696173 | 1,6e−6 | ✗ |
| REML bileşeni \hat\sigma^2(Tekrar×Yıl(Lok)) | 21,53234083 | 21,53234747 | 21,53234747 | 3,1e−7 | ✓ |
| REML bileşeni \hat\sigma^2(Lok×Çeşit) | 169,31409565 | 169,31414714 | 169,31414714 | 3,0e−7 | ✓ |
| REML bileşeni \hat\sigma^2(Yıl×Çeşit) | 0 | 0 | 0 | 0 | ✓ |
| REML bileşeni \hat\sigma^2(Lok×Yıl×Çeşit) | 178,4134068 | 178,41339038 | 178,41339038 | 9,2e−8 | ✓ |
| REML bileşeni \hat\sigma^2(Hata) | 394,42619176 | 394,42618552 | 394,42618552 | 1,6e−8 | ✓ |
| Genel ortalama | 443,83333333 | 443,83333333 | — | 7,7e−16 | ✓ |
| DK (%) | 4,47469 | 4,47469 | — | 3,8e−14 | ✓ |
| EMM SH (ANOVA yolu) | 9,63538758 | 9,63538758 | 9,63538758 | 6,5e−13 | ✓ |
| SED (ANOVA yolu) | 13,62649579 | 13,62649579 | 13,62649579 | 6,4e−13 | ✓ |
| AÖF %5 (ANOVA yolu) | 31,80128454 | 31,80128454 | 31,80128454 | 2,2e−13 | ✓ |
| Tukey HSD %5 (ANOVA yolu) | 54,92252162 | 54,92252162 | 54,92252162 | 9,0e−11 | ✓ |
| C1 − C7: p (AÖF) | 0,01039481 | 0,01039481 | 0,01039481 | 3,2e−15 | ✓ |
| C1 − C7: p (Tukey) | 0,10850733 | 0,10850733 | 0,10850733 | 1,8e−11 | ✓ |
| C7 − C8: p (AÖF) | 6,526667·10−4 | 6,526667·10−4 | 6,526667·10−4 | 2,6e−15 | ✓ |
| C7 − C8: p (Tukey) | 0,00852843 | 0,00852843 | 0,00852843 | 3,0e−10 | ✓ |
| C1 − C2: p (AÖF) | 0,54844338 | 0,54844338 | 0,54844338 | 2,1e−13 | ✓ |
| C1 − C2: p (Tukey) | 0,99697738 | 0,99697738 | 0,99697738 | 1,9e−11 | ✓ |
| REML: çeşit F | 5,95545935 | 5,95545982 | 5,95545982 | 7,8e−8 | ✓ |
| REML: payda sd (Satterthwaite) | 13,99999879 | 14 | — | 8,6e−8 | ✓ |
| REML: çeşit p | 0,00231307 | 0,00231307 | 0,00231307 | 1,5e−9 | ✓ |
| REML: EMM SH | 30,26370114 | 30,26371329 | 30,26371329 | 4,0e−7 | ✓ |
| REML: SED | 14,32536537 | 14,32536481 | 14,32536481 | 3,9e−8 | ✓ |
| REML: AÖF %5 | 30,7248532 | 30,72485175 | 30,72485175 | 4,7e−8 | ✓ |
| REML (Kenward–Roger): AÖF %5 | 30,72485295 | 30,72485175 | 30,72485175 | 3,9e−8 | ✓ |
| İkisi sabit: çeşit F | 37,18280822 | 37,18280822 | 37,18280822 | 3,1e−14 | ✓ |
| İkisi sabit: lokasyon F | 55,43087513 | 55,43087513 | 55,43087513 | 2,2e−13 | ✓ |
| İkisi sabit: yıl F | 56,9935276 | 56,9935276 | 56,9935276 | 1,6e−12 | ✓ |
| İkisi sabit: SED | 5,73313603 | 5,73313603 | 5,73313603 | 3,7e−14 | ✓ |
| İkisi sabit: AÖF %5 | 11,34570767 | 11,34570767 | 11,34570767 | 1,2e−11 | ✓ |
| Lokasyon sabit, yıl rastgele: çeşit F | 15,40852996 | 15,40852996 | — | 1,3e−12 | ✓ |
| Lokasyon sabit, yıl rastgele: AÖF %5 | 21,0593458 | 21,0593458 | — | 6,7e−13 | ✓ |
| Form 5 Ankara: F | 1,87477898 | 1,87477898 | 1,87477898 | 1,3e−13 | ✓ |
| Form 5 Ankara: DK (%) | 4,86879344 | 4,86879344 | 4,86879344 | 3,1e−14 | ✓ |
| Form 5 Ankara: AÖF | 49,23032656 | 49,23032656 | 49,23032656 | 7,1e−14 | ✓ |
| Form 5 Ankara: AÖF (yıl sabit) | 19,72585922 | 19,72585922 | 19,72585922 | 3,2e−14 | ✓ |
| Form 5 Ankara: C7 ortalaması | 424,0125 | 424,0125 | — | 0 | ✓ |
| Form 5 Eskisehir: F | 14,73983663 | 14,73983663 | 14,73983663 | 2,4e−14 | ✓ |
| Form 5 Eskisehir: DK (%) | 4,10527954 | 4,10527954 | 4,10527954 | 2,6e−14 | ✓ |
| Form 5 Eskisehir: AÖF | 33,66414812 | 33,66414812 | 33,66414812 | 6,1e−15 | ✓ |
| Form 5 Eskisehir: AÖF (yıl sabit) | 18,00757256 | 18,00757256 | 18,00757256 | 2,7e−14 | ✓ |
| Form 5 Eskisehir: C7 ortalaması | 491,5625 | 491,5625 | — | 0 | ✓ |
| Form 5 Konya: F | 5,63115217 | 5,63115217 | 5,63115217 | 5,6e−13 | ✓ |
| Form 5 Konya: DK (%) | 4,4357219 | 4,4357219 | 4,4357219 | 3,6e−14 | ✓ |
| Form 5 Konya: AÖF | 33,01405259 | 33,01405259 | 33,01405259 | 2,5e−13 | ✓ |
| Form 5 Konya: AÖF (yıl sabit) | 22,16729064 | 22,16729064 | 22,16729064 | 3,4e−14 | ✓ |
| Form 5 Konya: C7 ortalaması | 526,7625 | 526,7625 | — | 0 | ✓ |
Ölçütü karşılayan: 92/95. Python: hücre ortalamalarından düzeltilmemiş kareler toplamları ve içerme-dışlama (model karşılaştırması ve QR kullanılmadan), dengeli tasarım kuralıyla beklenen KO; REML için havuzlamalı kapalı biçim. R: stats::aov kareler toplamları, elle yazılan payda bileşimleri, qtukey/ptukey ve REML denklemlerinin Fisher puanlama ile çözümü (lme4, lmerTest ve emmeans kullanılmadan). REML satırlarındaki fark, şablondaki lmer eniyileyicisinin durma toleransından gelir.
ANOVA yolundaki bütün büyüklükler (kareler toplamları, paydalar, Satterthwaite sd'leri, F, p, moment bileşenleri, ortalamalar, SED, AÖF, Tukey, Form 5) üç yöntemde örtüşür; en büyük fark 10^{-11} düzeyindedir. REML yolunda F, sd, SED ve AÖF ölçüt içindedir. Üç REML bileşeni (lokasyon, yıl, lokasyon × yıl) kapalı biçimden göreli 1{,}6\times10^{-6} ile 3{,}9\times10^{-6} kadar ayrılır: bu bileşenler yalnız üç lokasyon ve iki yıla dayanır, REML yüzeyi bu yönlerde çok yassıdır ve yinelemeli eniyileyici en büyük noktaya altıncı basamakta ulaşır. Bağımsız Python (kapalı biçim) ve R (Fisher puanlama) çözümleri birbirleriyle 10^{-9} içinde aynıdır.
11.7 Çıktıyı okuma
Çalıştırma 1'in (örnek ayar) metin çıktısı (satırlar sayfaya sığacak biçimde bölünmüş, uyarı satırı kısaltılmıştır):
n = 192 parsel; 3 lokasyon, 2 yıl, 4 tekrar, 8 çeşit; lokasyon rastgele, yıl rastgele;
tekrarlar rastgele.
Uyarılar: REML: Yıl*Çeşit varyansı sınırda (0) kestirildi; REML F testlerinde ve ortalama
karşılaştırmalarında bu bileşen modelden çıkarıldı […] | Tip III moment kestirimlerinden
en az biri negatif; REML bu bileşeni sınırda (0) kestirir ve iki yolun F/sd'leri ayrışabilir.
| Rastgele etkili lokasyon ya da yıl 4'ten az düzeyde: varyans bileşenleri ve Satterthwaite
sd'leri az bilgiye dayanır.
"TTSM Lokasyon × Yıl varyans analizi tablosu":
| varyasyon_kaynagi | serbestlik_derecesi | kareler_ortalamasi | F_degeri | olasilik_yuzde |
|---|---|---|---|---|
| Genel | 191 | |||
| Lokasyon | 2 | 144612,0454 | 6,6904 | 8,7018 |
| Tekrar(Lok) | 9 | 2608,8718 | 4,6037 | 1,6402 |
| Yıl | 1 | 32297,3752 | 1,7882 | 31,6020 |
| Lok*Yıl | 2 | 18296,2413 | 13,4682 | 0,0618 |
| Tekrar*Yıl(Lok) | 9 | 566,6850 | 1,4367 | 17,9290 |
| Çeşit | 7 | 14665,8732 | 6,5820 | 0,9880 |
| Lok*Çeşit | 14 | 2462,5929 | 2,0760 | 9,2065 |
| Yıl*Çeşit | 7 | 951,8022 | 0,8024 | 59,8754 |
| Lok*Yıl*Çeşit | 14 | 1186,2185 | 3,0075 | 0,0520 |
| Hata | 126 | 394,4262 |
"Ayrıntılı varyans analizi" tablosu aynı satırlara kareler toplamını, paydanın yazılı bileşimini (ör. KO(Lok*Çeşit) + KO(Yıl*Çeşit) − KO(Lok*Yıl*Çeşit)), payda kareler ortalamasını, payda sd'sini ve p'yi (olasılık olarak) ekler. "Beklenen kareler ortalaması" tablosu 11.4.3'teki satırları metin olarak verir. "Varyans bileşenleri" tablosu:
| bilesen | ANOVA_tip3 | REML |
|---|---|---|
| Lokasyon | 1921,8319 | 1920,6170 |
| Tekrar(Lok) | 127,6367 | 127,6367 |
| Yıl | 148,2870 | 145,8446 |
| Lok*Yıl | 529,3051 | 531,7461 |
| Tekrar*Yıl(Lok) | 21,5323 | 21,5323 |
| Lok*Çeşit | 159,5468 | 169,3141 |
| Yıl*Çeşit | −19,5347 | 0,0000 |
| Lok*Yıl*Çeşit | 197,9481 | 178,4134 |
| Hata | 394,4262 | 394,4262 |
"REML sabit etki F testleri": Çeşit, pay sd 7, payda sd 14,0000, F=5{,}9555, p=0{,}0023. "Çeşit ortalamaları (EMM)" ve "Çeşit testi ve karşılaştırma ölçütleri":
| cesit | EMM | SH | harf | olcut | deger | |
|---|---|---|---|---|---|---|
| C7 | 480,7792 | 9,6354 | a | genel ortalama | 443,8333 | |
| C6 | 462,5792 | 9,6354 | ab | değişim katsayısı DK (%) | 4,4747 | |
| C5 | 461,9708 | 9,6354 | ab | çeşit F | 6,5820 | |
| C4 | 443,9458 | 9,6354 | bc | çeşit F payda sd | 7,4873 | |
| C2 | 443,0667 | 9,6354 | bc | çeşit p | 0,0099 | |
| C1 | 434,5042 | 9,6354 | bcd | SED | 13,6265 | |
| C3 | 419,2042 | 9,6354 | cd | AÖF (Fisher LSD) (α = 0,050) | 31,8013 | |
| C8 | 404,6167 | 9,6354 | d | karşılaştırma sd | 7,4873 |
"İkili çeşit karşılaştırmaları" tablosu 28 çiftin her biri için farkı, SED'i, sd'yi, p'yi ve önemliyse * işaretini verir. "Form 5: ortalama verim sonuçları":
| Çeşitler | Ankara | Eskisehir | Konya | Ortalama | harf |
|---|---|---|---|---|---|
| C7 | 424,01 | 491,56 | 526,76 | 480,78 | a |
| C6 | 408,24 | 471,46 | 508,04 | 462,58 | ab |
| C5 | 415,91 | 454,75 | 515,25 | 461,97 | ab |
| C4 | 417,86 | 426,33 | 487,65 | 443,95 | bc |
| C2 | 389,84 | 448,56 | 490,80 | 443,07 | bc |
| C1 | 408,83 | 412,59 | 482,10 | 434,50 | bcd |
| C3 | 367,23 | 389,36 | 501,03 | 419,20 | cd |
| C8 | 380,24 | 383,10 | 450,51 | 404,62 | d |
| F | 1,87 | 14,74 | 5,63 | 6,58 | |
| DK (%) | 4,87 | 4,11 | 4,44 | 4,47 | |
| AÖF (Fisher LSD) | 49,23 | 33,66 | 33,01 | 31,80 | |
| Lokasyon Ort. | 401,52 | 434,71 | 495,27 | 443,83 |
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| İlk satır | Parsel, lokasyon, yıl, tekrar, çeşit sayıları; etkilerin türü | Tekrar sayısı lokasyonlar arasında farklıysa "4/3" gibi yazılır. |
| TTSM tablosu | Kaynak, sd, KO, F, olasılık (%) | olasilik_yuzde =100p: 0,9880 değeri p=0{,}0099 demektir, %5'in altındadır. |
| Ayrıntılı tablo | KT, payda bileşimi, payda KO ve sd, p | Her F'nin neye bölündüğünü gösterir; kesirli payda sd'si sentezlenmiş paydadır. |
| Beklenen KO | Her kaynağın içerdiği bileşenler | Payda seçiminin gerekçesi; sabit etkilerde Q(…). |
| Varyans bileşenleri | Moment ve REML kestirimleri | Negatif moment değeri ve sıfır REML değeri aynı şeyi söyler: o etkileşim, altındakinden ayırt edilemiyor. |
| Çeşit*çevre bileşenleri | \hat\sigma^2_{LC}, \hat\sigma^2_{YC}, \hat\sigma^2_{LYC} | Büyüklükleri çeşit sıralamasının çevreye ne kadar bağlı olduğunu gösterir. |
| EMM, SH, harf | Çeşit ortalaması, karşılaştırma SH'si, grup | Harf paylaşan çeşitler ayırt edilemez. SH için 11.4.7'deki uyarı. |
| SED, AÖF | Fark standart hatası ve asgari önemli fark | İki ortalamanın farkı AÖF'den büyükse \alpha düzeyinde önemlidir. |
| Form 5 | Çeşit × lokasyon ortalamaları ve lokasyon istatistikleri | Lokasyon F ve AÖF'si o lokasyonun yıllara göre birleşik çözümlemesindendir. |
Şekil 11.1. Şablonun çizdiği çeşit ortalamaları (örnek veri; büyükten küçüğe). Çubuklar ± AÖF/2'dir (±15,90): iki çeşidin çubukları üst üste binmiyorsa farkları AÖF'den büyüktür. Üstteki harfler AÖF gruplarıdır.
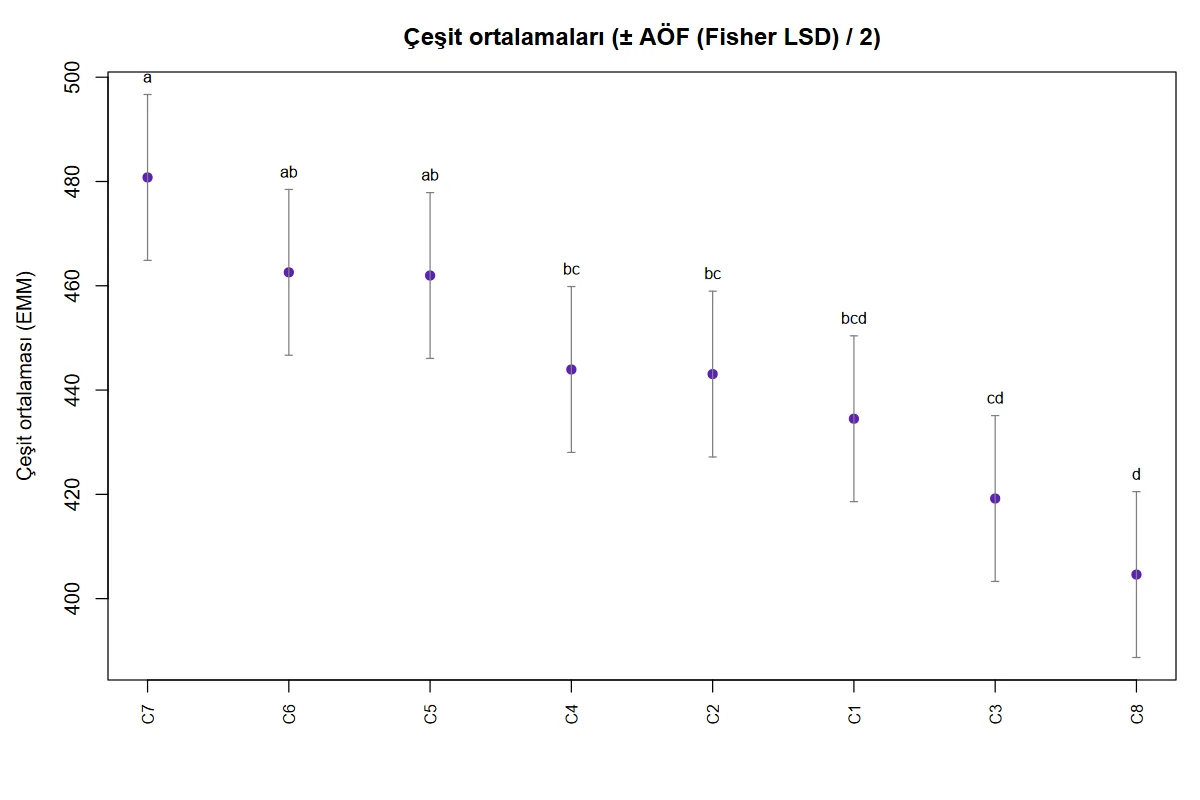
Form 5'te Ankara'nın F'si 1,87'dir ve AÖF'si (49,23) lokasyondaki bütün çeşit farklarından büyüktür: Ankara'da çeşit sıralaması iki yıl arasında değişmiş, yıl × çeşit kareler ortalaması (1733,8) büyük çıkmıştır. Eskisehir'de ise sıralama tutarlıdır (F=14{,}74). Birleşik çözümlemedeki önemli lokasyon × yıl × çeşit etkileşimi (p=0{,}0005) bu farkı yansıtır.
Rapor cümlesi:
Sekiz çeşit, üç lokasyonda ve iki yılda, dört tekrarlı tesadüf blokları deseninde denendi (192 parsel). Lokasyon ve yılın rastgele alındığı birleşik varyans analizinde çeşit etkisi önemli bulundu (F_{7;\,7{,}49} = 6,58; p = 0,010; payda: KO(Lok×Çeşit) + KO(Yıl×Çeşit) − KO(Lok×Yıl×Çeşit), Satterthwaite serbestlik derecesi). Lokasyon × yıl (p < 0,001) ve lokasyon × yıl × çeşit (p < 0,001) etkileşimleri önemli, lokasyon × çeşit (p = 0,092) ve yıl × çeşit (p = 0,599) etkileşimleri önemsizdi. Genel ortalama 443,8 kg/da, değişim katsayısı %4,5, asgari önemli fark (%5) 31,8 kg/da idi. En yüksek verim C7'de (480,8 kg/da) elde edildi; C6 ve C5 onunla aynı grupta, C8 (404,6 kg/da) en düşük gruptaydı. REML çözümlemesinde yıl × çeşit varyansı sıfır kestirildi ve çeşit etkisi yine önemliydi (F_{7;\,14} = 5,96; p = 0,002).
11.8 Sık hatalar ve tuzaklar
- Sabit ve rastgele seçimini sonuca göre yapmak. Aynı veride çeşit F'si 6,58 (ikisi rastgele) ile 37,18 (ikisi sabit), AÖF 31,80 ile 11,35 arasında değişir. Seçim, sonucun hangi çevrelere genelleneceğine göre ve çözümlemeden önce yapılır; tescil denemelerinde çevreler rastgeledir.
- Olasılık sütununu olasılık sanmak. TTSM tablosundaki
olasilik_yuzdeyüzdedir. Çeşit satırındaki 0,9880, p=0{,}99 değil p=0{,}0099'dur. Ayrıntılı tablodakipsütunu olasılıktır. - Her yıl yeniden kurulan blokları "aynı tekrar" saymak. Model, aynı lokasyondaki aynı numaralı tekrarın yıllar boyunca aynı parsel düzenini koruduğunu varsayar (çok yıllık bitkiler, sabit deneme alanı). Tek yıllık bitkilerde deneme her yıl yeni bir tarlada ve yeni rastgeleleştirmeyle kurulur; o durumda tekrarlar lokasyon × yıl içinde iç içedir ve Tekrar(Lok) ile Tekrar*Yıl(Lok) tek bir kaynakta (ly(t-1) sd) birleşir. Çeşit testi ve AÖF bundan etkilenmez; lokasyon, yıl ve lokasyon × yıl testlerinin paydaları değişir.
- ANOVA yolunun SH'sini çeşit ortalamasının güven aralığı için kullanmak. Bu SH (9,64) yalnız karşılaştırma içindir; çevreler rastgeleyken bir çeşit ortalamasının standart hatası 30,26'dır (REML yolu).
- Az sayıda çevrede önemsiz sonucu "fark yok" diye okumak. Üç lokasyon ve iki yılda çeşit paydasının sd'si 7,49, lokasyon paydasınınki 2,77'dir. Testin gücü çevre sayısıyla belirlenir; tekrar sayısını artırmak bu sd'leri değiştirmez.
- Negatif varyans bileşenini hata saymak. Negatif moment kestirimi, gerçek değeri sıfır ya da sıfıra yakın bir bileşenin örnekleme oynaklığıdır. Şablon bunu uyarır; REML sütunu aynı bileşeni sıfır verir. İki yolun çeşit F'si ayrışır (6,58 ve 5,96); ikisi birlikte raporlanır.
- Form 5'teki lokasyon AÖF'sini tek yıllık deneme AÖF'si sanmak. Lokasyon sütunları iki yılın ortalamasıdır ve AÖF, yıl rastgeleyken yıl × çeşit etkileşimine dayanır (7 sd). Tek bir yılın tek bir lokasyondaki denemesi ayrıca çözümlenir.
- Önemli etkileşimi görmezden gelip yalnız genel ortalamaları raporlamak. Lokasyon × yıl × çeşit önemliyse çeşit sıralaması çevreden çevreye değişiyordur; Form 5'in lokasyon sütunları ve çevre bazında ortalamalar birlikte değerlendirilir.
- Eksik parselli veride TTSM serbestlik derecelerini beklemek. Dengesiz veride sd'ler formüllerden sapar, beklenen kareler ortalaması katsayıları kesirli olur ve paydalar tamsayı olmayan katsayılarla kurulur; şablon bunu uyarır ve REML yolunu önerir.
- AÖF'yi çok sayıda çeşitte tek ölçüt almak. 28 karşılaştırmada AÖF aile düzeyinde hata olasılığını denetlemez; C1 − C7 farkı AÖF ile önemli, Tukey ile önemsizdir.
11.9 Uzman soruları
S1. Çeşit paydası neden üç kareler ortalamasının bileşimi?
Lokasyon ve yıl rastgeleyken çeşit kareler ortalamasının beklenen değeri üç etkileşim bileşenini içerir: 4\sigma^2_{LYC}+12\sigma^2_{YC}+8\sigma^2_{LC}. Tek başına hiçbir kareler ortalaması bu üçünü aynı katsayılarla içermez: \mathrm{KO}_{LC}'de \sigma^2_{YC}, \mathrm{KO}_{YC}'de \sigma^2_{LC} yoktur. İkisinin toplamı gerekenleri verir ama \sigma^2_e+4\sigma^2_{LYC}'yi iki kez sayar; \mathrm{KO}_{LYC} çıkarılarak fazlalık giderilir. Böyle kurulan teste yaklaşık (quasi) F testi denir ve sd'si Satterthwaite formülüyle bulunur.
S2. Payda negatif çıkarsa ne olur?
Eksi işaretli bileşimlerde bu olabilir: \mathrm{KO}_{LYC}, \mathrm{KO}_{LC}+\mathrm{KO}_{YC}'den büyükse. Şablon o durumda F ve p'yi boş bırakır (satır 228). Bu, modelin veriye uymadığını değil, çevre sayısının bileşenleri ayırmaya yetmediğini gösterir. REML yolu seçilir: negatif olacak bileşenler sıfıra çekilir ve payda her zaman pozitif kalır.
S3. REML'de çeşit F'si neden tam olarak KO(Çeşit)/KO(Lok×Çeşit)?
Yıl × çeşit bileşeni sıfır kestirildiği için model, o terimin bulunmadığı modelle aynıdır. Dengeli veride o modelin çeşit tabakası üç kaynaktan oluşur: çeşit, lokasyon × çeşit ve (yıl × çeşit ile havuzlanmış) artık etkileşim. Çeşidin beklenen kareler ortalaması \sigma^2_e+4\sigma^2_{LYC}+8\sigma^2_{LC}+Q(C) olur ve bu, Q dışında E(\mathrm{KO}_{LC})'dir. Payda tek bir kareler ortalamasıdır; sd'si 14 ve tamdır. Elle hesap (5,95546) ile şablonun REML F'si (5,95546) yedi basamakta örtüşür.
S4. ANOVA ve REML yolundan hangisi raporlanmalı?
Dengeli veride ve bütün moment kestirimleri pozitifken ikisi aynıdır; hangisinin yazıldığı fark etmez. Negatif moment kestirimi varsa iki yol ayrışır. ANOVA yolu TTSM tablosuyla ve klasik yayınlarla birebir tutarlıdır ve yansız F paydası kullanır; REML yolu varyans bileşenlerini parametre uzayının içinde tutar ve daha yüksek sd verir. Dengesiz veride (eksik parsel) REML yolu tercih edilir: her ikili fark için ayrı SED ve sd verir. Şablon iki yolun sonuçlarını her çalıştırmada birlikte yazar; raporda TTSM tablosu ANOVA yolundan, varyans bileşenleri iki sütunla verilir.
S5. Kenward-Roger ile Satterthwaite bu örnekte fark eder mi?
Hayır. Dengeli veride ve tek kareler ortalamalı paydada ikisi de sd = 14 verir (şablonun Satterthwaite sd'si 13,999999, Kenward-Roger 14,000000); AÖF iki seçenekte de 30,7249'dur. Fark, dengesiz veride ortaya çıkar: Kenward-Roger sabit etkilerin kovaryans matrisini de düzeltir ve küçük denemelerde daha tutucudur.
S6. Sınırsız model yerine kısıtlı model kullanılsaydı ne değişirdi?
Yalnız rastgele ana etkilerin (lokasyon, yıl) testleri değişirdi. Kısıtlı modelde, rastgele bir etmenin sabit bir etmenle etkileşimi o rastgele etmenin beklenen kareler ortalamasına girmez. Lokasyon sabit, yıl rastgeleyken sınırsız modelde yıl, \mathrm{KO}_{LY}+\mathrm{KO}_{YC}-\mathrm{KO}_{LYC}'ye karşı sınanır (F=1{,}79; sd 1,95); kısıtlı modelde lokasyon × yıl ve yıl × çeşit bileşenleri (ikisi de sabit bir etmenle etkileşim) yılın beklenen kareler ortalamasından düşer ve yıl, \mathrm{KO}_{RY(L)}'ye karşı sınanır. Çeşit sabit olduğundan çeşit testi iki modelde aynıdır; tescil kararını taşıyan satırlar model seçiminden etkilenmez. Lokasyon ve yıl ikisi de sabitken iki model arasında fark yoktur.
S7. Tekrar × yıl(lokasyon) terimi ne işe yarar?
Aynı blok iki yıl gözlendiğinde, bloğun yıldan yıla sapması parsellerin ortak bir bileşenidir. Bu terim olmasaydı o değişkenlik hataya karışır; lokasyon × yıl ve yıl, gerçekte 24 blok-yıl biriminden gelen bilgiyle değil 192 parselle sınanıyormuş gibi görünürdü. Terim, bloklar arası tabakayı parsel tabakasından ayırır. Örnekte bileşeni küçüktür (21,5) ve testi önemsizdir (p=0{,}18); yine de modelde kalır, çünkü tasarımın rastgeleleştirme yapısının parçasıdır.
S8. Harf grupları geçişli olmayan sonuç verebilir mi?
Dengeli veride ve tek bir ölçütle (AÖF ya da Tukey) vermez: sıralı ortalamalarda "a ile c farksızsa a ile b de farksızdır" kuralı geçerlidir ve algoritmanın bulduğu diziler bütün önemsiz çiftleri kapsar. Dengesiz veride ya da REML yolunda SED'ler çiftten çifte değişir; uzak iki ortalama farksız, yakın iki ortalama farklı çıkabilir. Algoritma ardışık dizilerle çalıştığı için böyle bir durumda harfler her önemsiz çifti göstermeyebilir; o zaman ikili karşılaştırma tablosu esas alınır.
S9. Lokasyon etkisi neden önemsiz, oysa lokasyon ortalamaları çok farklı?
Lokasyon ortalamaları 401,5, 434,7 ve 495,3'tür; lokasyon varyans bileşeni en büyük bileşendir (1921,8). Ama lokasyon rastgeleyken test "bu üç lokasyon farklı mı" değil, "lokasyonlar kitlesinde varyans sıfırdan büyük mü" sorusunu sorar ve bunu yalnız üç lokasyonla, lokasyon × yıl değişkenliğine (yalnız iki yıl) karşı yapar. Payda sd'si 2,77'dir ve F=6{,}69 bu sd ile p=0{,}087 verir. Lokasyon sabit alındığında aynı ortalamalar F=55{,}4, p<0{,}0001 verir. Lokasyon testi çeşit önerisi için belirleyici değildir; önemli olan çeşit ve çeşit × çevre satırlarıdır.
11.10 Kaynaklar
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Gaylor, D. W., & Hopper, F. N. (1969). Estimating the degrees of freedom for linear combinations of mean squares by Satterthwaite's formula. Technometrics, 11(4), 691–706. https://doi.org/10.1080/00401706.1969.10490732
- Halekoh, U., & Højsgaard, S. (2014). A Kenward-Roger approximation and parametric bootstrap methods for tests in linear mixed models: The R package pbkrtest. Journal of Statistical Software, 59(9), 1–32. https://doi.org/10.18637/jss.v059.i09
- Hartley, H. O. (1967). Expectations, variances and covariances of ANOVA mean squares by "synthesis". Biometrics, 23(1), 105–114. https://doi.org/10.2307/2528284
- Kenward, M. G., & Roger, J. H. (1997). Small sample inference for fixed effects from restricted maximum likelihood. Biometrics, 53(3), 983–997. https://doi.org/10.2307/2533558
- Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- Lenth, R., & Piaskowski, J. (2026). emmeans: Estimated marginal means, aka least-squares means (R paketi, sürüm 2.0.4). https://doi.org/10.32614/CRAN.package.emmeans
- McIntosh, M. S. (1983). Analysis of combined experiments. Agronomy Journal, 75(1), 153–155. https://doi.org/10.2134/agronj1983.00021962007500010041x
- Patterson, H. D., & Thompson, R. (1971). Recovery of inter-block information when block sizes are unequal. Biometrika, 58(3), 545–554. https://doi.org/10.1093/biomet/58.3.545
- Piepho, H.-P., Büchse, A., & Emrich, K. (2003). A hitchhiker's guide to mixed models for randomized experiments. Journal of Agronomy and Crop Science, 189(5), 310–322. https://doi.org/10.1046/j.1439-037X.2003.00049.x
- Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin, 2(6), 110–114. https://doi.org/10.2307/3002019
- Searle, S. R., Casella, G., & McCulloch, C. E. (1992). Variance components. Wiley. https://doi.org/10.1002/9780470316856
- Tohumluk Tescil ve Sertifikasyon Merkez Müdürlüğü. (t.y.). Tarımsal değerleri ölçme denemeleri teknik talimatları (baklagil yem bitkileri; buğday; arpa). T.C. Tarım ve Orman Bakanlığı.