126. Çift sağlam kestirim (AIPW) (Python)
Şablon kimliği: cift_saglam_aipw_py · Kategori: nedensel çıkarım · Dil: Python · Dosya: pro/sablonlar/nedensel/cift_saglam_aipw_py.py (satır 1–336; üstbilgi 1–65) · Örnek veri: _ornek/lalonde.csv · Paketler: numpy 2.4.6, pandas 2.3.3, scipy 1.16.3, statsmodels 0.14.6, matplotlib 3.10.9 (Python 3.13.1) · R eşi: Bölüm 125
126.1 Ne işe yarar
Şablon, Bölüm 125'teki cift_saglam_aipw şablonunun Python karşılığıdır ve aynı soruyu yanıtlar: ikili bir tedavinin (iş eğitimi programına katılım) sürekli ya da 0/1 bir sonuç (1978 kazancı) üzerindeki ortalama tedavi etkisi (ATE) nedir? Lojistik eğilim skoru \hat e(X) ve sonuç modeli \hat m_a(X) ile artırılmış ters olasılık ağırlıklı (AIPW) kestirici kurulur:
- A_i: tedavi göstergesi; X_i: ortak değişkenler; \Pr(A=1\mid X)=\hat e(X), \Pr(A=0\mid X)=1-\hat e(X).
- \hat m_a(X)=\mathrm{E}[Y\mid A=a,X]: sürekli sonuçta doğrusal, 0/1 sonuçta lojistik regresyon.
Eğilim ya da sonuç modelinden biri doğruysa kestirici tutarlıdır (Robins ve ark., 1994; Bang ve Robins, 2005); ikisi birden yanlışsa hata birikebilir (Kang ve Schafer, 2007). Hesabı R şablonu gibi taban R glm.fit ile değil, statsmodels GLM'iyle (Seabold ve Perktold, 2010) ve numpy ile yapar. Kavramların ayrıntılı anlatımı (çift sağlamlık, varsayımlar, etki fonksiyonu SH'si, yığılmış M-kestirimi, kırpma, IPW ve regresyon düzeltmesi) Bölüm 125.1 ve 125.4'tedir; bu bölüm kendi başına okunabilmesi için hesabı özetler ve Python'a özgü noktaları anlatır.
Önemli: İki şablon aynı veride ATE, SH, GA ve p için aynı sayıları verir (10^{-8} göreli içinde; 126.6.1). Tedavi düzeyi kuralı (sayısalda büyük, metinde alfabetik son düzey; tedavi_duzeyi alanı), sütunların ölçeklenmesiyle sayısal koşullama, örtüşme tanısı ve tam ayrışmada durma iki şablonda aynıdır; kalan fark yalnız altyapıdır (R'de glm.fit, Python'da statsmodels; 126.8).
Ne zaman kullanılır?
- R'nin kurulu olmadığı ya da kullanıcının Python yorumlayıcısıyla çalıştığı bilgisayarlarda.
- Sonuç 0/1 ve ortak değişkenler çok farklı ölçeklerdeyse (R eşi bu durumda durabilir).
- İki şablonun aynı sayıları verdiğini doğrulamak ve sonucu çapraz denetlemek için.
Ne zaman kullanılmaz?
- Çok sayıda karıştırıcı ve esnek öğrenici istendiğinde: Bölüm 124
cift_makine_ogrenmesi(yalnız R). - Ağırlıklı dengeleme ve denge tanısı: Bölüm 127
dengeleme_agirliklari(ya da Python eşi Bölüm 128); hedefli güncelleme: Bölüm 139tmle. - Gözlenmeyen karıştırıcı kuşkusu: Bölüm 131
ihmal_duyarlilik(Python eşi Bölüm 132). - Üç ya da daha çok düzeyli tedavi ve zamana göre değişen tedavi bu şablonda yoktur (Bölüm 134
msm_ipw).
Temel programla ilişki. Temel programdaki Propensity Score Analysis (eğilim skoru) paneli eşleştirme, ters olasılık ağırlıklandırma ve tabakalama yapar; sonuç modeliyle birleşen çift sağlam kestirici ve sandviç SH yalnız bu iki şablondadır.
126.2 Şablonun girdileri
Form, üstbilgideki 8 [[param]] bloğundan kurulur (cift_saglam_aipw_py.py:11–64); alanlar R eşiyle özdeştir. Türlerin anlamı ve formun ortak denetimi Bölüm 1.2'dedir. Üstbilgideki yan dosya alanı (10. satır) kitabın konusu değildir (Bölüm 1.1).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
İkili tedavi değişkeni · tedavi |
sütun · Değişkenler | ilk sütun | tam iki düzeyli | Tedavi A (11–15, 89–105). |
Tedavi sayılan düzey (boş = sayısalda büyük, metinde alfabetik son düzey) · tedavi_duzeyi |
metin · Değişkenler | boş | tedavi sütunundaki iki düzeyden biri | Boşsa varsayılan kural, doluysa yazılan düzey tedavi sayılır (51–57, 99–105). |
Ortak değişkenler · ortak |
sütunlar · Değişkenler | yok | en az 1 sütun | X (16–21, 84–86, 118–135). |
Sonuç değişkeni · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal | Y (22–26, 106). |
Sonuç modeli · sonuc_modeli |
seçim · Model | ayri |
ayri, ortak |
Ayrı ya da tek model (27–33, 146, 182–200). |
Eğilim skoru kırpma sınırı \varepsilon · ps_sinir |
ondalık · Seçenekler | 0 | 0–0,1 | e\in[\varepsilon,1-\varepsilon] (34–41, 150, 155–158). |
Sonuç modeli ailesi · sonuc_ailesi |
seçim · Model | otomatik |
otomatik, dogrusal, lojistik |
Aile (42–49, 111–116, 151–152). |
Güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | GA ve başlık (58–64, 116, 246, 264–267). |
Şablonun kendi denetimleri (mq.hata):
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 80–81 |
| Tedavi ve sonuç aynı sütun | "Tedavi ve sonuç farklı olmalı." | 82–83 |
| Tedavi ve sonuçtan farklı ortak değişken yok | "… en az bir ortak değişken seçin." | 84–87 |
| Tedavinin düzey sayısı \ne2 | "Tedavi değişkeninin tam iki düzeyi olmalı." | 95–96 |
tedavi_duzeyi alanındaki düzey tedavi sütununda yok |
"'…' düzeyi tedavi sütununda yok; düzeyler: …" | 100–102 |
Sonuç sayısal değil (to_numeric sonucu sonsuz ya da NaN) |
"Sonuç değişkeni sayısal olmalı." | 107–108 |
| Sonuç sabit | "Sonuç değişkeni sabit." | 109–110 |
Sonuç 0/1 değil, aile lojistik |
"Lojistik sonuç modeli için sonuç 0/1 olmalı." | 113–114 |
| Ortak değişken sabit ya da tek düzeyli | "'…' sabit (tek düzeyli); ortak değişkenlerden çıkarın." | 122–123, 128–129 |
| Tasarım matrisi eş doğrusal | "Ortak değişkenler doğrusal bağımlı…" | 140–142 |
| Bir tedavi grubunda gözlem <k+2 | "Her tedavi grubunda model parametresi sayısından fazla gözlem gerekli." | 143–145 |
| Ayrı modellerde bir grupta tasarım eş doğrusal | "… 'tek model' seçin." | 147–149 |
Model kurulamadı (statsmodels hatası) |
"Model kurulamadı: …" | 202–203 |
| Katsayı sonlu değil | "Modeller yakınsamadı (tam ayrışma olabilir)." | 204–205 |
Eğilim modeli uyarı verdi, hata verdi (eski statsmodels tam ayrışmada hata verir) ya da eğilim skorları 10^{-8}'den küçük/büyük (1-10^{-8}) |
"Eğilim skoru modeli tam (ya da yarı) ayrışma gösteriyor: …" (uyarı metni eklenir) | 207–212 |
| \hat\mu_1 ya da \hat\mu_0 sonlu değil | "Potansiyel sonuç ortalamaları sonlu değil …" | 217–219 |
Türev matrisi tersinemedi (LinAlgError) |
"Sandviç varyansı hesaplanamadı (tekil türev matrisi)." | 231–234 |
Eksik değerli satırlar sessizce atılır (dropna, 88): çıktıdaki n atıldıktan sonraki sayıdır. Tedavi ya da sonuç sütunu ortak değişken listesindeyse çıkarılır (84). Tedavi düzeyi. Sütun türüne bağlı değildir (89–105): düzeyler mq.kimlik ile metne çevrilir; hepsi sayıya benziyorsa sayısal olarak sıralanır ve büyük olan (0/1'de 1, 1/2'de 2) tedavidir, değilse düzeyler alfabetik sıralanır ve son düzey tedavidir (kontrol < tedavi: tedavi). tedavi_duzeyi alanı doluysa yazılan düzey tedavi sayılır; alandaki düzey tedavi sütununda yoksa şablon düzeyleri sayarak durur. R eşi aynı kuralı kullanır (Bölüm 125); iki şablon "kategorik" ya da "ikili" işaretli tedavi sütununda aynı grubu tedavi sayar. Çıktı "Tedavi sayılan düzey: '…' (n = …); kontrol: '…' (n = …). Kural: …" satırıyla seçimi yazar. Tohum kullanılmaz: hesap belirlenimcidir; Bölüm 1.3'teki Tohum alanı sonucu etkilemez.
Örnek ayar (ornek_param, satır 9): tedavi = treat, ortak = age, educ, race, married, nodegree, re74, re75, y = re78, sonuc_modeli = ayri, ps_sinir = 0. R eşiyle aynıdır.
126.3 Örnek veri
lalonde.csv, R eşiyle aynı dosyadır (Bölüm 125.3; LaLonde, 1986; Dehejia ve Wahba, 1999): 614 gözlem (185 tedavi, 429 kontrol), 9 sütun, eksik değer yok; tedavi treat (iş eğitimi programına katılım), sonuç re78 (1978 kazancı, dolar), ortak değişkenler age, educ, race (black, hispan, white), married, nodegree, re74, re75. Veri sekmesinin türleri: race kategorik; treat, married, nodegree ikili; öteki sayısal.
Düzey sırası. Kategorik ortak değişken (race) bu şablonda metne çevrilip alfabetik sıralanır ve alfabetik ilk düzey başvuru olur (black; 128–134); düzeylerin sırası R eşindeki veri sekmesi sırasıyla uyuşmak zorunda değildir. Tam gösterge kodlu ve kesişimli modelde başvuru düzeyi ATE ve SH'yi değiştirmez: race düzeyleri ters sırada ve "kategorik" ise iki şablon aynı sonucu verir (469{,}6399; ap_race_sira, ar_race_sira).
Bu bölümde kullanılan çalıştırmalar R eşiyle aynı adlı ve aynı ayarlıdır (adı ap_…): aipwpy_ornek (örnek ayar), ap_ortak, ap_ayri_ps05, ap_ortak_ps05, ap_g90, ap_ikili_ortak, ap_ikili_oto, ap_ikili_bin, ap_dogrusal_ikili, ap_sent, ap_metin, ap_metin_kat, ap_t12, ap_uc, ap_eksik, ap_sabit, ap_ayrisma, ap_esdogrusal, ap_tam_ayrisma, … Türetilmiş veriler Bölüm 125.3'te tanıtılmıştır.
126.4 Yöntem: formüller ve hesap adımları
Hesap sırası: veri ve tasarım matrisi hazırlanır (80–152); eğilim skoru işlevi ve yığılmış tahmin denklemleri tanımlanır (155–177); modeller uydurulur (179–205); \hat\mu_1,\hat\mu_0 hesaplanır (215–220); sayısal türev ve sandviç varyans kurulur (221–239); etki fonksiyonu SH'si hesaplanır (240–246); tablolar yazılır (248–324); şekil çizilir (328–336).
126.4.1 Eğilim skoru ve sonuç modelleri
\hat e(X)=\operatorname{expit}(X\hat\gamma); \hat\gamma, sm.GLM(A, X, family=Binomial()) ile bulunur (186). X tasarım matrisi: kesişim sütunu, sayısal ortak değişkenler ve kategorik değişkenlerin alfabetik ilk düzey dışındaki göstergeleridir (118–135). Sonuç modeli:
- Ayrı: \hat m_1 yalnız tedavi görenlerde, \hat m_0 yalnız kontrollerde uydurulur (192–196).
- Tek model: Y ve (X,A) üzerinde tek GLM; \hat m_1 ve \hat m_0 tedavi göstergesi 1 ve 0'a sabitlenerek tahmin edilir (197–200).
Aile sürekli sonuçta Gauss, 0/1 sonuçta (ya da lojistik seçilince) binomdur; sonuc_ailesi = dogrusal 0/1 sonuçta doğrusal olasılık modeli kurar (111–116, 151–152).
126.4.2 AIPW kestiricisi ve etki fonksiyonu SH'si
\hat\mu_1,\hat\mu_0 yukarıdaki gibidir (215–216). Etki fonksiyonları \mathrm{IF}_{1,i}=\hat\tau_{1,i}-\hat\mu_1, \mathrm{IF}_{0,i}=\hat\tau_{0,i}-\hat\mu_0 (\hat\tau_{1,i}=\hat m_1+A_i(Y_i-\hat m_1)/\hat e_i vb.) ve ana standart hata
\widehat{\mathrm{Var}} örneklem varyansıdır (np.var(..., ddof=1); 241–246). Güven aralığı \hat\theta\pm z_{(1+g)/2}\mathrm{SH}, z=\hat\theta/\mathrm{SH} ve p=2\Phi(-|z|) (scipy.stats.norm; 202, 208–216).
- \hat e_i,\ \hat m_{a,i}: tahmin edilmiş değerler; SH bunların kestirim belirsizliğini hesaba katmaz (AIPW paketinin ve yaygın pratiğin tanımı).
- \mathrm{IF}: etki fonksiyonu; \mathrm{Var}(\mathrm{IF})/n kestiricinin asimptotik varyansıdır.
126.4.3 Yığılmış tahmin denklemleri ve sandviç SH
Tüm modellerin belirsizliğini katan ikinci SH, bütün tahmin denklemlerini birlikte çözen bir M-kestirim sisteminden alınır (Lunceford ve Davidian, 2004). Parametre vektörü \boldsymbol\theta=(\gamma,\beta,\mu_1,\mu_0); gözlem başına tahmin fonksiyonu
(tek model için sonuç bloğu (Y_i-m_i)(X_i,A_i)), \widehat{\mathbf V}=\mathbf A^{-1}\mathbf B\mathbf A^{-\prime}/n, \mathbf A=-\tfrac1n\sum_i\partial\boldsymbol\psi_i/\partial\boldsymbol\theta', \mathbf B=\tfrac1n\sum_i\boldsymbol\psi_i\boldsymbol\psi_i' (psi, 160–177; \mathbf B, 229–230; \mathbf V, 236) ve \mathrm{SH}_{\mathrm{sandvic}}(\widehat{\mathrm{ATE}})=\sqrt{V_{\mu_1\mu_1}+V_{\mu_0\mu_0}-2V_{\mu_1\mu_0}} (239).
Koddaki tercih
\mathbf A sayısal türevle bulunur: merkezi fark, adım h_j=10^{-6}\max(1,|\theta_j|) (221–228). Adımın duyarsız kalması için tasarım matrisinin her sütunu en büyük mutlak değerine bölünür (137–139): model aynıdır, yalnız katsayılar yeniden ölçeklenir; \hat\mu_a, ATE ve iki SH ortak değişkenlerin ölçü birimine bağlı değildir (örnek veride çözümsel değerle 4\times10^{-9} göreli içinde; sütunlar sent biriminde de 118044{,}88). np.linalg.inv yalnız tam tekil matriste hata verir (231–234); kötü koşullu matrisi kabul eder, ölçekleme bu durumu önler.
Çözümsel türev kapalı biçimde yazılabilir; blokları Bölüm 125.4.4'te verilmiştir (sonuç bloğunda w=1 doğrusal, w=m(1-m) lojistik) ve bağımsız doğrulama bunu kullanır (126.6).
126.4.4 Kırpma ve karşılaştırma kestiricileri
\varepsilon>0 iken e\leftarrow\operatorname{clip}(e,\varepsilon,1-\varepsilon) yalnız AIPW terimlerinde uygulanır (155–158, 213); psi içindeki eğilim bloğu kırpılmamış \hat e ile yazılır (160–161, 177): \hat\gamma kırpılmamış lojistik olabilirliğin kökü olduğundan blok \hat\gamma'da sıfırdır ve \mathrm{SH}_{\mathrm{sandvic}} kırpmada da anlamını korur. Kırpılan gözlem sayısı ayrıca notta ve tanı tablosunun kirpilan sütununda yazılır (214, 283–292, 309–312). Karşılaştırma tablosu normalize IPW (\sum A_iY_i/\hat e_i\big/\sum A_i/\hat e_i-\ldots) ve regresyon düzeltmesini (n^{-1}\sum(\hat m_1-\hat m_0)) yazar (268–274). İkisinin SH'si yoktur.
126.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–65 | Üstbilgi: 8 parametre, örnek veri, ayar. | Yan dosya alanı (10. satır) kitap dışıdır. |
| 66–77 | İçe aktarmalar; _m dil yardımcısı. |
statsmodels ve scipy yoksa şablon çalışmaz. |
| 80–88 | Veri, ortak değişken ve sonuç denetimi; eksik satırlar çıkarılır (88). | |
| 89–105 | Tedavi düzeyi: sütun türünden bağımsız kural, tedavi_duzeyi alanı, A. |
Düzey sayısı \ne2 (95–96) ya da alandaki düzey yok (100–102) ise durur. |
| 106–116 | Sonuç, aile ve güven düzeyi. | |
| 117–152 | Tasarım matrisi; sütunların ölçeklenmesi (137–139); grup büyüklüğü ve eş doğrusallık; ilink, GLM ailesi. |
Kategorik düzeyler alfabetik (129). |
| 155–177 | ps_of ve psi: eğilim skoru ve yığılmış tahmin denklemleri. |
Eğilim bloğu kırpılmamış e ile (160–161, 177). |
| 179–219 | GLM uydurmaları; uyarılar catch_warnings ile toplanır; yakınsama, ayrışma ve sonluluk denetimi; \hat\mu_1,\hat\mu_0. |
Eğilim modelinde uyarı/hata ya da e<10^{-8}, e>1-10^{-8} durdurur (207–212); sonuç modeli uyarıları çıktıya yazılır (326–327). |
| 220–239 | \boldsymbol\theta, sayısal türev, \mathbf B, \mathbf V ve sandviç SH'ler. | LinAlgError (231–234). |
| 240–246 | Etki fonksiyonları, ana SH'ler, z_c. | n-1 bölenli. |
| 248–275 | Konsol satırı, tedavi sayılan düzey notu, AIPW tablosu, karşılaştırma tablosu. | mq.sayi ile Türkçe ondalık virgül. |
| 276–324 | Örtüşme tanısı tablosu, ağırlıklı SMD tablosu; kırpma, zayıf örtüşme ve denge uyarıları; eğilim skoru aralığı. | Zayıf örtüşme eşiği e<0{,}01 ya da e>0{,}99 (313); denge eşiği |\mathrm{SMD}|>0{,}1 (318). |
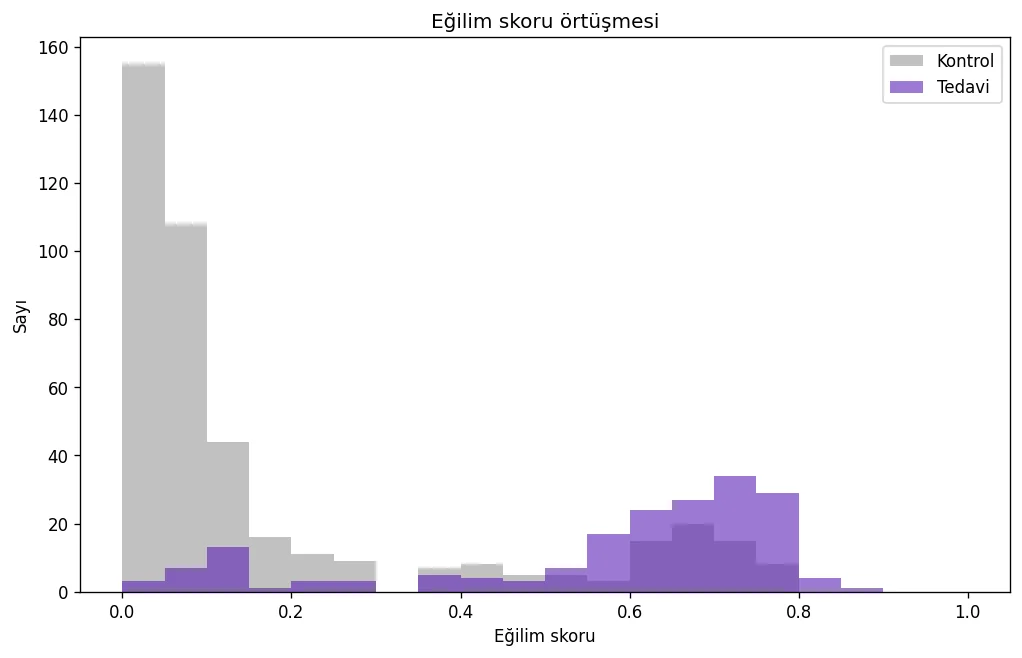
| 326–336 | Uyarılar; eğilim skoru örtüşme grafiği (yarı saydam iki histogram). | Şekil 126.1. |
Süre: örnek ayarda çalıştırma 3,73 s (R eşi 1,96 s).
126.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler Bölüm 125.6'daki aynı betiklerle hesaplanmıştır (dogrulama/cift_saglam_aipw/elle_hesap.py ve r_dogrulama.R; numpy ve taban R; şablonun hiçbir işlevi, statsmodels ve sayısal türev kullanılmaz; ek olarak tek model için AIPW paketi). Girdi bu şablonun çıktılarıdır (ap_* çalıştırmaları).
Adım 1 — Eğilim skoru. Lojistik regresyon katsayıları \hat\gamma=(-1{,}66328;\ 0{,}015777;\ 0{,}161307;\ -2{,}08173;\ -3{,}06537;\ -0{,}832113;\ 0{,}707297;\ -7{,}178\times10^{-5};\ 5{,}345\times10^{-5}) (kesişim, age, educ, hispan, white, married, nodegree, re74, re75). Eğilim skoru aralığı tedavi [0{,}0250;\ 0{,}8532], kontrol [0{,}0091;\ 0{,}7892] (şablonun konsol satırıyla aynı). 158 gözlemin \hat e<0{,}05 olduğu görülür.
Adım 2 — Sonuç modelleri. Her grupta EKK: \overline{\hat m_1}=7371{,}321, \overline{\hat m_0}=6296{,}413 (regresyon düzeltmesi 1074{,}909).
Adım 3 — Artık düzeltmeleri ve AIPW. n^{-1}\sum A_i(Y_i-\hat m_{1i})/\hat e_i=-478{,}408, n^{-1}\sum(1-A_i)(Y_i-\hat m_{0i})/(1-\hat e_i)=126{,}860; \hat\mu_1=6892{,}9132, \hat\mu_0=6423{,}2733, \widehat{\mathrm{ATE}}=469{,}6400 (şablon 469{,}6399736). Normalize IPW 224{,}676.
Adım 4 — Etki fonksiyonu SH'si. \mathrm{SH}(\widehat{\mathrm{ATE}})=926{,}15508, \mathrm{SH}(\hat\mu_1)=867{,}61127, \mathrm{SH}(\hat\mu_0)=355{,}08317 (şablonla 10^{-8} içinde aynı).
Adım 5 — Sandviç SH. Çözümsel türevli \mathbf A ile 1180{,}448823; şablon 1180{,}448823 (göreli fark 4\times10^{-9}).
Adım 6 — Tek model ve AIPW paketi. sonuc_modeli = ortak: ATE 887{,}1699 (şablon 887{,}169905), SH 937{,}3385; AIPW paketi 887{,}1699 ve 937{,}3385 verir.
Adım 7 — Kırpma ve 0/1 sonuç. \varepsilon=0{,}05 ayrı modellerde ATE 799{,}6186, SH 716{,}2382; tek modelde 1210{,}3384, SH 713{,}0636. re78>0 sonucu, ayrı lojistik modeller: ATE 0{,}0368187, SH 0{,}0682890, sandviç 0{,}0724227 (şablon 0{,}0724227256; 5\times10^{-6} göreli); tek model: 0{,}0321503, SH 0{,}0671042.
126.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| ayrı sonuç modelleri: \hat\mu_1 | 6892,91323181 | 6892,91323181 | 6892,91324026 | 1,2e−9 | ✓ |
| ayrı sonuç modelleri: \hat\mu_0 | 6423,27325822 | 6423,27325822 | 6423,27325725 | 1,5e−10 | ✓ |
| ayrı sonuç modelleri: ATE | 469,63997359 | 469,63997359 | 469,63998301 | 2,0e−8 | ✓ |
| ayrı sonuç modelleri: SH(ATE), etki fonksiyonu | 926,15507993 | 926,15507993 | 926,1550679 | 1,3e−8 | ✓ |
| ayrı sonuç modelleri: SH(\hat\mu_1) | 867,61127209 | 867,61127209 | 867,61125919 | 1,5e−8 | ✓ |
| ayrı sonuç modelleri: SH(ATE), sandviç | 1180,44882282 | 1180,44882254 | — | 2,4e−10 | ✓ |
| ayrı sonuç modelleri: IPW (normalize) | 224,6763091 | 224,6763091 | 224,67630827 | 3,7e−9 | ✓ |
| ayrı sonuç modelleri: regresyon düzeltmesi | 1074,9085414 | 1074,9085414 | 1074,9085414 | 7,2e−15 | ✓ |
| tek sonuç modeli: \hat\mu_1 | 7317,81283884 | 7317,81283884 | 7317,81284847 | 1,3e−9 | ✓ |
| tek sonuç modeli: \hat\mu_0 | 6430,64293336 | 6430,64293336 | 6430,64293243 | 1,4e−10 | ✓ |
| tek sonuç modeli: ATE | 887,16990548 | 887,16990548 | 887,16991604 | 1,2e−8 | ✓ |
| tek sonuç modeli: SH(ATE), etki fonksiyonu | 937,33851761 | 937,33851761 | 937,33850551 | 1,3e−8 | ✓ |
| tek sonuç modeli: SH(\hat\mu_1) | 880,97494782 | 880,97494782 | 880,97493498 | 1,5e−8 | ✓ |
| tek sonuç modeli: SH(ATE), sandviç | 958,72288852 | 958,72288866 | — | 1,4e−10 | ✓ |
| tek sonuç modeli: IPW (normalize) | 224,6763091 | 224,6763091 | 224,67630827 | 3,7e−9 | ✓ |
| tek sonuç modeli: regresyon düzeltmesi | 1548,243802 | 1548,243802 | 1548,243802 | 3,1e−15 | ✓ |
| ayrı modeller, \varepsilon=0{,}05: \hat\mu_1 | 7227,97458612 | 7227,97458612 | 7227,97458193 | 5,8e−10 | ✓ |
| ayrı modeller, \varepsilon=0{,}05: \hat\mu_0 | 6428,3560254 | 6428,3560254 | 6428,35602443 | 1,5e−10 | ✓ |
| ayrı modeller, \varepsilon=0{,}05: ATE | 799,61856072 | 799,61856072 | 799,61855751 | 4,0e−9 | ✓ |
| ayrı modeller, \varepsilon=0{,}05: SH(ATE), etki fonksiyonu | 716,23815052 | 716,23815052 | 716,23814739 | 4,4e−9 | ✓ |
| ayrı modeller, \varepsilon=0{,}05: SH(\hat\mu_1) | 639,88088098 | 639,88088098 | 639,88087734 | 5,7e−9 | ✓ |
| ayrı modeller, \varepsilon=0{,}05: IPW (normalize) | 432,17344173 | 432,17344173 | 432,17343414 | 1,8e−8 | ✓ |
| ayrı modeller, \varepsilon=0{,}05: regresyon düzeltmesi | 1074,9085414 | 1074,9085414 | 1074,9085414 | 7,2e−15 | ✓ |
| tek model, \varepsilon=0{,}05: \hat\mu_1 | 7647,87029019 | 7647,87029019 | 7647,87028807 | 2,8e−10 | ✓ |
| tek model, \varepsilon=0{,}05: \hat\mu_0 | 6437,5319033 | 6437,5319033 | 6437,53190235 | 1,5e−10 | ✓ |
| tek model, \varepsilon=0{,}05: ATE | 1210,33838689 | 1210,33838689 | 1210,33838572 | 9,6e−10 | ✓ |
| tek model, \varepsilon=0{,}05: SH(ATE), etki fonksiyonu | 713,06361031 | 713,06361031 | 713,06360801 | 3,2e−9 | ✓ |
| tek model, \varepsilon=0{,}05: SH(\hat\mu_1) | 638,73826431 | 638,73826431 | 638,73826172 | 4,1e−9 | ✓ |
| tek model, \varepsilon=0{,}05: IPW (normalize) | 432,17344173 | 432,17344173 | 432,17343414 | 1,8e−8 | ✓ |
| tek model, \varepsilon=0{,}05: regresyon düzeltmesi | 1548,243802 | 1548,243802 | 1548,243802 | 3,1e−15 | ✓ |
| 0/1 sonuç, tek model: \hat\mu_1 | 0,79358359 | 0,79358359 | 0,79358359 | 5,7e−10 | ✓ |
| 0/1 sonuç, tek model: \hat\mu_0 | 0,76143334 | 0,76143334 | 0,76143334 | 4,1e−11 | ✓ |
| 0/1 sonuç, tek model: ATE | 0,03215025 | 0,03215025 | 0,03215025 | 6,1e−10 | ✓ |
| 0/1 sonuç, tek model: SH(ATE), etki fonksiyonu | 0,06710424 | 0,06710424 | 0,06710424 | 1,0e−9 | ✓ |
| 0/1 sonuç, tek model: SH(\hat\mu_1) | 0,06313619 | 0,06313619 | 0,06313619 | 1,1e−9 | ✓ |
| 0/1 sonuç, tek model: SH(ATE), sandviç | 0,06588857 | 0,06588857 | — | 2,6e−12 | ✓ |
| 0/1 sonuç, tek model: IPW (normalize) | 0,02154976 | 0,02154976 | 0,02154976 | 5,4e−10 | ✓ |
| 0/1 sonuç, tek model: regresyon düzeltmesi | 0,062262 | 0,062262 | 0,062262 | 2,8e−11 | ✓ |
| 0/1 sonuç, ayrı modeller: \hat\mu_1 | 0,79724303 | 0,79724303 | 0,79724303 | 8,9e−10 | ✓ |
| 0/1 sonuç, ayrı modeller: \hat\mu_0 | 0,76042433 | 0,76042433 | 0,76042433 | 1,3e−11 | ✓ |
| 0/1 sonuç, ayrı modeller: ATE | 0,03681871 | 0,03681871 | 0,03681871 | 9,0e−10 | ✓ |
| 0/1 sonuç, ayrı modeller: SH(ATE), etki fonksiyonu | 0,06828904 | 0,06828904 | 0,06828904 | 1,0e−9 | ✓ |
| 0/1 sonuç, ayrı modeller: SH(\hat\mu_1) | 0,06427873 | 0,06427873 | 0,06427872 | 1,1e−9 | ✓ |
| 0/1 sonuç, ayrı modeller: SH(ATE), sandviç | 0,07242269 | 0,07242269 | — | 2,6e−11 | ✓ |
| 0/1 sonuç, ayrı modeller: IPW (normalize) | 0,02154976 | 0,02154976 | 0,02154976 | 5,4e−10 | ✓ |
| 0/1 sonuç, ayrı modeller: regresyon düzeltmesi | 0,09115917 | 0,09115917 | 0,09115917 | 2,2e−9 | ✓ |
Ölçütü karşılayan: 46/46. Ölçüt satır başına 10^{-6} (değer 1'den büyükse göreli); sandviç SH'de 10^{-5} göreli: şablon türev matrisini sayısal türevle alır (sütunları en büyük mutlak değerlerine bölünmüş tasarımda, adım h=10^{-6}\max(1,|\theta_j|)), bağımsız Python çözümsel türev kullanır (bölüm 126.4.4). R sütunu taban R (glm.fit, açık formül) ve ayrıca tek model için AIPW paketidir. \varepsilon>0 iken sandviç satırı verilmez. 0/1 sonuç ve ayrı modeller satırında R şablonu da çalışır; re74 ve re75 bin dolar biriminde yazılmış aynı verinin R sütunu ATE ve SH'yi ölçekten bağımsız olarak verir.
126.6.2 R şablonuyla karşılaştırma (ikiz)
Aşağıdaki tablo iki şablonu aynı veri ve ayarla çalıştırır (dogrulama/cift_saglam_aipw/karsilastir.py). Farklar göreli, |a-b|/|a|; "durur" şablonun hata iletisiyle bittiği anlamına gelir.
| Çalıştırma | R şablonu | Python şablonu | ATE farkı (göreli) | SH farkı (göreli) | SH sandviç farkı (göreli) | Not |
|---|---|---|---|---|---|---|
| örnek ayar (ayrı modeller) | tamam | tamam | 2,0e−8 | 1,3e−8 | 3,9e−9 | |
| tek sonuç modeli | tamam | tamam | 1,2e−8 | 1,3e−8 | 9,0e−9 | |
| ayrı modeller, \varepsilon=0{,}05 | tamam | tamam | 4,0e−9 | 4,4e−9 | 1,2e−9 | |
| tek model, \varepsilon=0{,}05 | tamam | tamam | 9,6e−10 | 3,2e−9 | 1,4e−9 | |
| %90 güven düzeyi | tamam | tamam | 2,0e−8 | 1,3e−8 | 3,9e−9 | |
| 0/1 sonuç, doğrusal aile (doğrusal olasılık) | tamam | tamam | 2,6e−8 | 1,5e−8 | 7,8e−9 | |
| 0/1 sonuç, otomatik (lojistik), ayrı modeller | tamam | tamam | 2,4e−8 | 1,5e−8 | 7,0e−9 | |
| 0/1 sonuç, lojistik, tek model | tamam | tamam | 1,9e−8 | 1,5e−8 | 1,2e−8 | |
0/1 sonuç, re74/re75 bin dolar, ayrı modeller |
tamam | tamam | 2,4e−8 | 1,5e−8 | 7,5e−9 | |
0/1 sonuç, re74/re75 on dolar, ayrı modeller |
tamam | tamam | 2,4e−8 | 1,5e−8 | 7,3e−9 | |
sürekli sonuç, re74/re75/re78 sent (×100) |
tamam | tamam | 2,0e−8 | 1,3e−8 | 3,8e−9 | |
| sürekli sonuçta lojistik aile istendi | hata | hata | — | — | — | iki şablon da aynı iletiyle durur |
tedavi metin (tedavi/kontrol), ikili türde |
tamam | tamam | 2,0e−8 | 1,3e−8 | 3,9e−9 | |
| tedavi metin, sütun türü 'kategorik' | tamam | tamam | 2,0e−8 | 1,3e−8 | 3,9e−9 | |
| tedavi 1/2 kodlu | tamam | tamam | 2,0e−8 | 1,3e−8 | 3,9e−9 | |
| tedavi üç düzeyli | hata | hata | — | — | — | iki şablon da aynı iletiyle durur |
| eksik değerli 7 satır | tamam | tamam | 1,0e−7 | 2,3e−8 | 6,9e−9 | |
| sabit ortak değişken | hata | hata | — | — | — | iki şablon da aynı iletiyle durur |
| tedavinin kopyası ortak değişken | hata | hata | — | — | — | iki şablon da aynı iletiyle durur |
| eş doğrusal ortak değişkenler | hata | hata | — | — | — | iki şablon da aynı iletiyle durur |
race düzeyleri ters sırada ve 'kategorik' |
tamam | tamam | 2,0e−8 | 1,3e−8 | 3,3e−9 | |
race ve educ 'kategorik' |
hata | hata | — | — | — | iki şablon da aynı iletiyle durur |
| sonuç 'kategorik' türde | tamam | tamam | 2,0e−8 | 1,3e−8 | 3,9e−9 | |
| ondalık virgüllü metin sütunları | hata | hata | — | — | — | iki şablon da aynı iletiyle durur |
| tedavi ortak değişken listesinde | tamam | tamam | 1,0e−15 | 1,5e−15 | 6,4e−11 |
126.7 Çıktıyı okuma
Örnek ayarda şablonun dört tablosu ve konsol notları (aipwpy_ornek; sayılar olduğu gibi):
n = 614 (tedavi 185, kontrol 429); sonuç: sürekli (doğrusal); sonuç modeli: gruplara göre ayrı
Tedavi sayılan düzey: '1' (n = 185); kontrol: '0' (n = 429). Kural: sayıya benzeyen düzeylerde büyük, değilse alfabetik son düzey.

AIPW kestirimleri (SH, %95 GA ve p: etki fonksiyonu; SH_sandvic: yığılmış M-kestirimi)
  parametre                             kestirim       SH SH_sandvic    GA_alt    GA_ust
  Potansiyel sonuç ortalaması, tedavi  6892.9132 867.6113  1141.9127 5192.4264 8593.4001
  Potansiyel sonuç ortalaması, kontrol 6423.2733 355.0832   351.3101 5727.3230 7119.2235
  ATE                                   469.6400 926.1551  1180.4488 -1345.5906 2284.8706
  (devamı) z: 7.944702; 18.089490; 0.507086   p: 1.946578e-15; 3.856424e-73; 0.6120947

Kestiricilerin karşılaştırması
  kestirici                              ATE        SH SH_sandvic
  AIPW                              469.6400  926.1551  1180.4488
  IPW (normalize ağırlık)           224.6763        NaN       NaN
  Regresyon düzeltmesi (g-hesaplama) 1074.9085       NaN       NaN

Örtüşme tanısı (eğilim skoru ve ters olasılık ağırlıkları)
  grup     n e_en_kucuk e_en_buyuk en_buyuk_agirlik etkin_n kirpilan
  tedavi 185     0.0250     0.8532          40.0773 58.3267        0
  kontrol 429    0.0091     0.7892           4.7432 329.0078        0

Ortak değişken dengesi (standartlaştırılmış ortalama farkı; hedef |SMD| < 0,1)
  degisken     SMD_ham SMD_agirlikli
  age          -0.2419       -0.1676
  educ          0.0448        0.1296
  racehispan   -0.2769        0.0156
  racewhite    -1.4057       -0.1376
  married      -0.7195       -0.2098
  nodegree      0.2350       -0.1155
  re74         -0.5958       -0.2740
  re75         -0.2870       -0.1579

Uyarı: 1 gözlemin eğilim skoru 0,01'in altında ya da 0,99'un üstünde (örtüşme zayıf; en büyük ağırlık 40,1, etkin n tedavi 58,3, kontrol 329,0); kırpma sınırı düşünün.
Uyarı: ağırlıklandırmadan sonra bazı ortak değişkenlerde |SMD| 0,1'in üstünde; eğilim modeli dengeyi sağlamıyor olabilir.
Eğilim skoru aralığı: tedavi [0,0250; 0,8532], kontrol [0,0091; 0,7892].
Şekil 126.1. Şablonun şekli: eğilim skoru örtüşmesi (`matplotlib`, yarı saydam histogram; gri kontrol, mor tedavi; 20 aralık). R eşinden farkı: sütunlar yan yana değil, üst üste çizilir ve eksen sayıları ondalık noktalıdır.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Konsol satırı ve tedavi düzeyi notu | n, tedavi ve kontrol sayısı, sonuç ve model türü; hangi düzeyin tedavi, hangisinin kontrol sayıldığı ve bunun kuralı. | Tedavi sayılan düzeyin beklediğiniz grup olduğunu doğrulayın; değilse tedavi_duzeyi alanıyla seçin (126.8). |
| Potansiyel sonuç ortalamaları | \hat\mu_1,\hat\mu_0, SH, GA, z, p. | Herkes tedavi alsaydı ya da almasaydı beklenen sonuç. |
ATE |
\hat\mu_1-\hat\mu_0, SH etki fonksiyonundan. | Programın ortalama etkisi 469{,}64 dolar; p=0{,}61: sıfırdan ayırt edilemez. |
SH_sandvic |
Yığılmış M-kestirimi sandviç SH. | Ana SH'den (926) büyükse (1180) modellerin belirsizliği de önemlidir. |
| Kestiricilerin karşılaştırması | AIPW, normalize IPW, regresyon düzeltmesi. | 470, 225 ve 1075'in dağılması örtüşme ve model belirleme duyarlılığını gösterir. |
| Eğilim skoru aralığı | Her grup için en küçük ve en büyük \hat e (kırpılmışsa kırpılmış). | Kontrolün en küçük \hat e'si 0{,}009: ağırlıklar uçlaşabilir. |
| Örtüşme tanısı tablosu | Her grupta gözlem sayısı, kırpılmış \hat e'nin en küçük ve en büyüğü, en büyük ters olasılık ağırlığı, etkin örneklem büyüklüğü (\sum w)^2/\sum w^2 ve kırpılan gözlem sayısı. | Tedavi grubunda en büyük ağırlık 40{,}1 ve etkin n 58{,}3 (n_1=185). |
| Ortak değişken dengesi | Her model matrisi sütunu için tedavi–kontrol standartlaştırılmış ortalama farkı, ham ve ters olasılık ağırlıklı. | Ağırlıklandırma dengeyi sağlıyorsa |\mathrm{SMD}|<0{,}1; örnek veride re74 (-0{,}274) ve married (-0{,}210) bu eşiği aşar ve şablon uyarır. |
İş eğitimi programına katılımın 1978 kazancı üzerindeki ortalama etkisi, yaş, eğitim, ırk, evlilik, diploma durumu ve 1974–1975 kazançları kontrol edilerek çift sağlam (AIPW) kestiriciyle 469{,}64 dolar bulunmuştur (SH 926{,}16; %95 GA -1345{,}59 ile 2284{,}87; p=0{,}612). Yığılmış sandviç SH 1180{,}45'tir.
126.8 Sık hatalar ve tuzaklar
- Tedavi düzeyinin seçimi. Hangi düzeyin tedavi sayıldığı sütun türüne ve düzey sırasına bağlı değildir ve R eşiyle aynıdır: sayıya benzeyen düzeylerde büyük, metinde alfabetik son düzey tedavidir;
tedavi/kontroletiketli sütunda ATE +469{,}64 ve n_1=185 çıkar (iki şablonda; 126.6.2). Çıktının "Tedavi sayılan düzey" satırı seçimi yazar; beklediğiniz grupla uyuşmuyorsatedavi_duzeyialanına tedavi düzeyini yazın (kontrolyazılırsa ATE -469{,}64 olur, SH aynıdır). - Büyük ölçekli ortak değişkenler ve sandviç SH. Tasarım matrisinin sütunları ölçeklendiğinden sandviç SH ortak değişkenlerin ölçü birimine bağlı değildir:
re74,re75,re78sent birimine çevrilince (\times100) ATE 46963{,}997, ana SH 92615{,}51 ve sandviç SH 118044{,}88 (yüz kat) yazılır; R eşi de aynı değerleri verir. - 0/1 sonuç ve varsayılan ayrı model. Python doğru sonucu verir (ATE 0{,}0368; SH 0{,}0683) ve R eşi de dolar ölçekli
re74ile çalışır (Bölüm 125.8). - Kırpma ve sandviç. \varepsilon=0{,}05 ATE'yi 469{,}64'ten 799{,}62'ye (ayrı modeller) ve 887{,}17'den 1210{,}34'e (tek model) kaydırır. Kırpılan 158 gözlem notta ve tanı tablosunda yazılır; eğilim skoru aralığı kırpılmış değerleri gösterir. Eğilim bloğu kırpılmamış skorla yazıldığından \mathrm{SH}_{\mathrm{sandvic}} kırpmada da anlamını korur (ayrı modellerde 1089{,}24; ana SH 716{,}24).
- Ağırlık patlaması ve örtüşme. Örtüşme tanısı tablosu ve uyarısı \hat e<0{,}01 ya da \hat e>0{,}99 olan gözlemleri sayar (örnek veride 1 gözlem; en büyük ağırlık 40{,}1, tedavi grubunun etkin n'si 58{,}3); IPW, AIPW ve regresyon düzeltmesinin dağılması örtüşme sorununu ayrıca ele verir.
-
Tam ayrışma. Bir ortak değişken tedaviyi tam ayırıyorsa
statsmodelsuyarı verir (ya da eski sürümlerde hata); şablon uyarıları artık gizlemez, "Eğilim skoru modeli tam (ya da yarı) ayrışma gösteriyor" iletisiyle durur ve uyarı metnini iletiye ekler (ap_tam_ayrisma). Ayrışan değişkeni ortak değişkenlerden çıkarın. -
Eksik değer. Sessizce atılır (n=607, ATE 204{,}4); çıktıdaki n'yi veri sayınızla karşılaştırın.
- Kategorik değişkenin sayısal değer sanılması ve eş doğrusallık.
educ"kategorik" yapılırsanodegreeile eş doğrusal olur ve "doğrusal bağımlı" hatası çıkar (iki şablonda da). - Tedavi sonrası değişkenler
ortak'a konmamalıdır; şablon denetlemez.
126.9 Uzman soruları
S1. Python ve R şablonları neden aynı ATE'yi veriyor?
İkisi de aynı iki lojistik/doğrusal modeli en çok olabilirlikle (EKK ya da Fisher puanlama) uydurur ve aynı formülü uygular; ayrılık yalnız kayan nokta yakınsama toleransından gelir (10^{-8} göreli). statsmodels GLM'in IRLS'si ve glm.fit farklı başlangıç ve duruş ölçütleri kullanır.
S2. Hangi SH'yi raporlamalıyım?
Ana SH etki fonksiyonundan (926{,}16) \hat e ve \hat m'yi sabit sayar. Sandviç (1180{,}45) kestirim belirsizliğini de içerir ve iyi belirlenmiş modellerde ana SH'ye yakın olur. Aradaki büyük fark zayıf örtüşmeyi gösterir. Sandviçi raporlamak daha temkinlidir; ama ortak değişken ölçeği büyükse sandviç sayısal olarak güvenilmez olabilir (126.8): bu durumda ölçeği normalleştirin.
S3. Neden ayrı ve tek model bu kadar farklı?
Ayrı modelde \hat m_1 185 tedavi gözleminde, \hat m_0 429 kontrol gözleminde uydurulur; tedavi ve ortak değişken etkileşimlerine izin verilir. Tek modelde tedavi etkisi sabittir. Zayıf örtüşmede kontrol grubunun \hat m_1'i az gözlem içeren bölgelerde tahmin edilir ve ATE sonuç modeline duyarlıdır: regresyon düzeltmesi 1075 ve 1548. İkisini raporlayın.
S4. Kırpma sınırı nasıl seçilir?
Kırpma, ağırlıkları 1/\varepsilon ile sınırlar (SH azalır) ve \hat\mu_a'yı yanlı kılar. Pratikte 0{,}01–0{,}05 denenir ve sonucun nasıl kaydığı raporlanır (Crump ve ark., 2009). Şablonun varsayılanı kırpmamaktır.
S5. 0/1 sonuçta doğrusal olasılık modeli ne zaman yeterli?
ATE'nin tanımı değişmez (risk farkı). Lojistik sonuç modeli tahmin olasılığını (0{,}1) içinde tutar; doğrusal olasılık modeli dışına taşıyabilir. Örnek veride ATE 0{,}0368 (lojistik, ayrı) ve 0{,}0422 (doğrusal, SH 0{,}0695). Çift sağlamlık gereği her ikisi de tutarlı olabilir; fark küçük örneklemde ve uç eğilim skorlarında büyür.
S6. Sınır durumu: tek bir ortak değişken tedaviyi tam ayırıyor
Eğilim skoru 0 ya da 1 olur ve \hat\mu_0 tanımsızdır; şablon "Eğilim skoru modeli tam (ya da yarı) ayrışma gösteriyor" iletisiyle durur. Yakın ayrışmada katsayılar sonludur, ama ağırlıklar çok büyüktür; tanı tablosundaki küçük e, büyük ağırlık ve küçük etkin n bunu gösterir. Ayrışan değişkeni çıkarmak yetmez: örtüşme yoktur.
S7. Başka bir uygulama (AIPW paketi) ile ne zaman ayrışır?
Tek modelde AIPW paketi (Zhong ve ark., 2021; k\_split=1, SL.glm) ile aynıdır: ATE 887{,}1699, SH 937{,}3385. Şablonun varsayılan ayrı modelleri paketin kurmadığı bir seçenektir. Paket çapraz uydurmayı k\_split>1 ile açabilir; şablonda yoktur.
S8. R eşi ile ne zaman ayrışıyor?
Tedavi düzeyi kuralı, sandviç türevin ölçeklenmesi ve tam ayrışmada durma iki şablonda aynıdır; ATE ve SH tüm doğrulama çalıştırmalarında 10^{-8} içinde aynıdır (126.6.2).
126.10 Kaynaklar
- Bang, H., & Robins, J. M. (2005). Doubly robust estimation in missing data and causal inference models. Biometrics, 61(4), 962–973. https://doi.org/10.1111/j.1541-0420.2005.00377.x
- Crump, R. K., Hotz, V. J., Imbens, G. W., & Mitnik, O. A. (2009). Dealing with limited overlap in estimation of average treatment effects. Biometrika, 96(1), 187–199. https://doi.org/10.1093/biomet/asn055
- Dehejia, R. H., & Wahba, S. (1999). Causal effects in nonexperimental studies: Reevaluating the evaluation of training programs. Journal of the American Statistical Association, 94(448), 1053–1062. https://doi.org/10.1080/01621459.1999.10473858
- Kang, J. D. Y., & Schafer, J. L. (2007). Demystifying double robustness: A comparison of alternative strategies for estimating a population mean from incomplete data. Statistical Science, 22(4), 523–539. https://doi.org/10.1214/07-STS227
- LaLonde, R. J. (1986). Evaluating the econometric evaluations of training programs with experimental data. The American Economic Review, 76(4), 604–620.
- Lunceford, J. K., & Davidian, M. (2004). Stratification and weighting via the propensity score in estimation of causal treatment effects: A comparative study. Statistics in Medicine, 23(19), 2937–2960. https://doi.org/10.1002/sim.1903
- Robins, J. M., Rotnitzky, A., & Zhao, L. P. (1994). Estimation of regression coefficients when some regressors are not always observed. Journal of the American Statistical Association, 89(427), 846–866. https://doi.org/10.1080/01621459.1994.10476818
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. Proceedings of the 9th Python in Science Conference, 92–96. https://doi.org/10.25080/Majora-92bf1922-011
- Zhong, Y., Kennedy, E. H., Bodnar, L. M., & Naimi, A. I. (2021). AIPW: An R package for augmented inverse probability–weighted estimation of average causal effects. American Journal of Epidemiology, 190(12), 2690–2699. https://doi.org/10.1093/aje/kwab207
- Yazılım kaydı (şablonun
ozet.jsonçıktısı): Python 3.13.1; numpy 2.4.6, pandas 2.3.3, scipy 1.16.3, statsmodels 0.14.6, matplotlib 3.10.9.