82. Dizi çeşitliliği ve nötralite testleri
Şablon kimliği: notralite_testleri · Kategori: genetik · Dil: R · Dosya: pro/sablonlar/genetik/notralite_testleri.R (satır 1–387; üstbilgi 1–95) · Örnek veri: _ornek/haplotip_woodmouse.csv · Paketler: yok (taban R)
82.1 Ne işe yarar
Şablon, tek bir gen bölgesinden okunmuş hizalanmış DNA dizilerinde çeşitliliği özetler ve gözlenen çeşitlilik deseninin nötr denge modeline uyup uymadığını sınar. Nötr denge modeli şunu varsayar: mutasyonlar seçilim açısından yansızdır, popülasyonun büyüklüğü uzun süredir sabittir, çiftleşme rastgeledir ve bölgede rekombinasyon yoktur. Cevapladığı soru: "Bu dizilerdeki mutasyonların sayısı, sıklık dağılımı ve haplotip sayısı, sabit büyüklükte bir popülasyonda yansız mutasyonlardan beklenenle bağdaşıyor mu?"
Testlerin ortak fikri, popülasyonun mutasyon parametresi \theta'nın aynı veriden iki ayrı yolla kestirilip karşılaştırılmasıdır:
- n: dizi sayısı; k_{ij}: i. ve j. dizi arasındaki farklı konum sayısı.
- \hat\theta_\pi: ortalama ikili fark (Tajima'nın kestiricisi); orta sıklıktaki mutasyonlara duyarlıdır.
- S: ayrışan (en az iki farklı baz görülen) konum sayısı; \hat\theta_W: Watterson'ın (1975) kestiricisi; her mutasyonu sıklığına bakmadan bir kez sayar, seyrek mutasyonlara duyarlıdır.
- Nötr dengede ikisinin beklenen değeri aynıdır: \theta=2N_e\mu (haploit, tek ebeveynden kalıtılan bölge için; \mu dizi başına kuşak başına mutasyon oranı).
İki kestirim birbirinden ayrışıyorsa bir varsayım bozulmuştur. Seyrek mutasyon fazlası (\hat\theta_W>\hat\theta_\pi) yakın zamanda genişlemiş bir popülasyonu ya da arındırıcı seçilimi; orta sıklıkta mutasyon fazlası (\hat\theta_\pi>\hat\theta_W) daralmış ya da alt popülasyonlara bölünmüş bir popülasyonu ya da dengeleyici seçilimi düşündürür. Şablon bu karşılaştırmayı beş istatistikle yapar (Tajima D; Fu F_s; Fu–Li D^* ve F^*; Ramos-Onsins ve Rozas R_2) ve ikili farkların dağılımını (uyumsuzluk dağılımı) ani genişleme modeliyle karşılaştırır.
Ne zaman kullanılır? Mitokondri ya da kloroplast bölgesi gibi rekombinasyonsuz tek bir lokusun dizileri varsa; popülasyonun demografik geçmişi (genişleme, darboğaz) ya da lokus üzerindeki seçilim sorgulanıyorsa; yayımlanmış özet değerlerden (n, haplotip sayısı, \theta_\pi, S) Tajima D ya da Fu F_s yeniden hesaplanacaksa (özet kipi).
Ne zaman kullanılmaz?
- Diziler hizalanmamışsa: önce
dizi_hizalama(Bölüm 70). - Haplotiplerin birbirine nasıl bağlandığı soruluyorsa:
haplotip_agi(Bölüm 77). - Popülasyonlar arası farklılaşma isteniyorsa:
dizi_amova(Bölüm 68). - Veri çok lokuslu genotipse (mikrosatellit, SNP): çeşitlilik için
genetik_cesitlilik(Bölüm 73), Hardy–Weinberg dengesi içinhardy_weinberg(Bölüm 78). - Birden çok lokus birlikte sınanacaksa ya da rekombinasyon varsa: testlerin sıfır dağılımları tek, rekombinasyonsuz lokus içindir; şablon lokusları birleştirmez.
- Dış grup dizisi gerektiren testler (Fu–Li D ve F, Fay–Wu H) şablonda yoktur.
Temel programla ilişki. Temel programda dizi verisiyle çalışan bir analiz yoktur.
82.2 Şablonun girdileri
Form, üstbilgideki on iki [[param]] bloğundan kurulur (notralite_testleri.R:11–85).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Veri kipi · kip |
seçim · Model | dizi |
dizi, ozet |
Dizi kipi (264–387) ya da özet kipi (242–263). |
Dizi sütunu (dizi kipi) · dizi |
sütun · Değişkenler | boş | herhangi bir sütun | Diziler (267–270). |
Popülasyon (dizi kipi) · populasyon |
kategorik sütun · Değişkenler | boş | boş olabilir | Her popülasyon için ayrı satır (271, 274–277, 300). |
Örneklem büyüklüğü n (özet kipi) · n_sutun |
sayısal sütun · Değişkenler | boş | tam sayı, 2–5000 | Özet kipinde n (243–244, 248–250). |
Haplotip sayısı (özet kipi) · k_sutun |
sayısal sütun · Değişkenler | boş | tam sayı, 1–n | Özet kipinde haplotip sayısı (243–244, 248–249). |
Ortalama ikili fark \theta_\pi (özet kipi) · pi_sutun |
sayısal sütun · Değişkenler | boş | \ge 0; dizi başına | Özet kipinde \theta_\pi (243–244, 251). |
Ayrışan konum sayısı S (özet kipi) · s_sutun |
sayısal sütun · Değişkenler | boş | boş olabilir | Verilirse Tajima D ve \theta_W (245, 255–257). |
Nötralite testleri için koalesan benzetimi sayısı · B_notr |
tamsayı · Seçenekler | 500 | 0–10000 | F_s, D^*, F^*, R_2'nin p değerleri (101, 323–330). |
Uyumsuzluk dağılımı için parametrik bootstrap sayısı · B_uyum |
tamsayı · Seçenekler | 100 | 0–2000 | SSD ve r'nin p değerleri (102, 336–343). |
Uyumsuzluk uyumunda ek başlangıç sayısı · ek_baslangic |
tamsayı · Gelişmiş | 0 | 0–20 | 0: tek başlangıç (moment kestirimleri). Sıfırdan büyükse bu kadar ek başlangıç noktası da denenir ve en küçük SSD alınır (103, 219–231; 333, 340). |
Fu–Li D^*, F^* ve R_2 benzetiminde koşul · benzetim_kosulu |
seçim · Model | S |
S, theta |
Mutasyonların dallara dağıtılma biçimi (105, 324). |
Fu F_s benzetiminde \theta · fs_theta |
seçim · Model | pi |
pi, W |
F_s benzetiminde kullanılan \theta (106, 325). |
Örnek ayar (ornek_param, satır 9): kip = dizi, dizi = dizi, populasyon = populasyon. Benzetim sayıları varsayılandadır (500 ve 100).
Dizi kipi. Her satır bir bireyin hizalanmış dizisidir; A, C, G, T, IUPAC belirsizlik kodları, N, ? ve - kabul edilir. Herhangi bir dizide A, C, G, T dışında bir karakter bulunan konum bütün çözümlemeden çıkarılır (tam silme, satır 289–293) ve çıkarılan konum sayısı not olarak yazılır. Popülasyon verilirse sonuçlar bütün örneklem ("Tümü") ve her popülasyon için ayrı satırlarda verilir (bir popülasyonun adı bütün örneklemin etiketiyle aynıysa onun satırı "Tümü (popülasyon)" adıyla verilir); popülasyonu boş olan diziler yalnız "Tümü" satırına girer. Dörtten az dizili gruplar atlanır.
Özet kipi. Her satır bir örneklemin yayımlanmış özetidir: n, haplotip sayısı, \theta_\pi ve isteğe bağlı S. Bu kipte yalnız Tajima D (ve p değerleri) ile Fu F_s hesaplanır; benzetim, Fu–Li testleri, R_2 ve uyumsuzluk dağılımı yoktur.
Şablonun kendi denetimleri.
| Koşul | İleti | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 89 |
| Özet kipinde n, haplotip sayısı ya da \theta_\pi sütunu boş | "Özet kipinde n, haplotip sayısı ve θπ sütunları seçilmeli." | 219 |
| Özet kipinde eksiksiz satır yok | "Eksiksiz satır yok (n, haplotip sayısı, θπ)." | 223 |
| n ya da haplotip sayısı tam sayı değil | "n ve haplotip sayısı tam sayı olmalı." | 224 |
| n<2 ya da haplotip sayısı aralık dışında | "Her satırda n ≥ 2 ve 1 ≤ haplotip sayısı ≤ n olmalı." | 225 |
| n>5000 | "n en çok 5000 olabilir." | 226 |
| \theta_\pi<0 | "θπ negatif olamaz." | 227 |
| Dizi kipinde dizi sütunu boş | "Dizi kipinde dizi sütunu seçilmeli." | 243 |
| 4'ten az dizi | "Nötralite testleri için en az 4 dizi gerekli (… var)." | 256 |
| 1000'den çok dizi | "Bu şablon en çok 1000 diziyle çalışır (benzetim süresi)." | 257 |
| DNA dışı karakter | "… dizide DNA dışı karakter var ('…') …" | 258–260 |
| Uzunluklar farklı | "Diziler hizalanmamış: uzunluklar farklı … önce hizalayın …" | 262–263 |
| Tam silmeden sonra konum kalmamış | "Bütün konumlarda eksik ya da belirsiz baz var …" | 267 |
| Çözümlenecek grup kalmamış | "Çözümlenecek grup kalmadı." | 327 |
Çalıştırmayı durdurmayan notlar: boş diziler ve popülasyonu eksik diziler (273, 276); çıkarılan konum sayısı (292); tekil mutasyon bulunmayan grup için uyarı (319–321); dörtten az dizili gruplar (351); ayrışan konumu olmayan grup (356); benzetim p değeri 0 çıktıysa anlamı (358–360); özet kipinde tek haplotipli satırda F_s'nin tanımsız olduğu (262); uyumsuzluk uyumunda \theta_0 ya da \theta_1'in belirlenemediği grupların uyarısı (363–364).
82.3 Örnek veri
Dosya: _ornek/haplotip_woodmouse.csv (Bölüm 77 ile aynı dosya). Orman faresinin (Apodemus sylvaticus) mitokondriyal sitokrom b dizileri (Michaux ve ark., 2003): 15 özgün diziden, pegas paketinin kılavuzundaki gibi yerine koyarak çekilmiş 80 dizi; popülasyon etiketleri sırayla atanmıştır.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
birey |
kullanılmaz | metin | 80 ad. |
bolge |
kullanılmaz | ikili | regA 40, regB 40. |
populasyon |
Popülasyon | kategorik | pop1–pop4, 20'şer dizi. |
dizi |
Dizi | kategorik | 965 karakter; 15 farklı dizi; 458 N. |
Gruplar çıktıda önce "Tümü", sonra popülasyonlar harf sırasıyla yer alır (satır 297–300); sonuçlar düzey sırasına bağlı değildir. 965 konumun 55'inde en az bir dizide bilinmeyen baz vardır; çözümleme 910 konumla yapılır.
Örnek veri bağımsız bireylerden oluşmaz
80 dizi, 15 dizinin yinelenmiş kopyalarıdır. Bu yüzden bütün örneklemde hiçbir mutasyon tek bir dizide görülmez (\eta_s=0), haplotip sayısı (15) dizi sayısına göre çok azdır ve ikili farkların dağılımı birkaç değerde yığılır. Aşağıdaki sayılar hesabın nasıl yapıldığını gösterir; biyolojik bir sonuç olarak okunmaz. Şablon \eta_s=0 durumunda bunu hatırlatan bir uyarı yazar.
Özet kipi için iki küçük veri kullanılır: (i) Chen ve Temme'nin (2020) Tablo 1'indeki yedi (n, k, \theta) üçlüsü ve onlara eklenen iki satır; (ii) Tajima D'nin yaygın çalışılmış örneği olan beş dizili, 20 konumlu ikili veri (0 → A, 1 → G).
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar, çalıştırma tohumu 2026; (2) aynı ayar, benzetim sayısı 3000, bootstrap 0, tohum 11; (3) benzetim_kosulu = theta, fs_theta = W; (4) özet kipi (dokuz satır); (5) beş dizili örnek, dizi kipi, benzetimsiz.
82.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) tam silme; (2) her grup için çeşitlilik ölçüleri; (3) beş test istatistiği; (4) koalesan benzetimiyle p değerleri; (5) uyumsuzluk dağılımı, ani genişleme modelinin uydurulması ve parametrik bootstrap.
82.4.1 Çeşitlilik ölçüleri
| Ölçü | Tanım | Sütun |
|---|---|---|
| S | Ayrışan konum sayısı | S |
| \eta | Toplam mutasyon sayısı: her konumda (farklı baz sayısı − 1) toplamı | eta |
| \eta_s | Tekil mutasyon sayısı: örneklemde yalnız bir dizide görülen baz sayısı | eta_s |
| Haplotip sayısı, H_d | Farklı dizi sayısı; H_d=\frac{n}{n-1}(1-\sum p_h^2) (Nei, 1987) | haplotip, Hd |
| \theta_\pi, \pi | Ortalama ikili fark; \pi=\theta_\pi/L | theta_pi, pi |
| \theta_W | S/a_1; konum başına \theta_W/L | theta_W, theta_W_konum |
Her konumda en çok iki baz varsa \eta=S'dir; üç bazlı konum \eta'ya 2 ekler. Grup düzeyindeki ölçüler o grubun dizileriyle yeniden hesaplanır, ancak L bütün örneklemin tam silmeli konum sayısıdır ve bütün gruplarda aynıdır.
Neden tam silme?
Testlerin kuramı her dizinin aynı konumlarda gözlendiğini varsayar: a_1 ve varyans sabitleri n'ye bağlıdır ve bir konumda yalnız bazı diziler biliniyorsa o konum için geçerli n değişir. Tam silme bu sorunu konumu atarak çözer. Bedeli, tek bir kısa okunmuş dizinin bütün örneklemde konum kaybettirmesidir; böyle diziler çözümlemeden önce çıkarılır. Çift bazında silme uygulayan programlar aynı veride farklı \theta_\pi ve S verebilir (82.9, S1).
82.4.2 Tajima D
- Pay, iki \theta kestiriminin farkıdır; payda bu farkın nötr modeldeki standart sapmasının kestirimidir.
- D<0: seyrek mutasyon fazlası (genişleme, arındırıcı seçilim, seçici süpürme sonrası). D>0: orta sıklıkta mutasyon fazlası (darboğaz, alt bölünme, dengeleyici seçilim).
- n<4 ya da S<1 ise hesaplanmaz.
p değeri iki yoldan verilir. Beta yaklaşımı (Tajima, 1989): D'nin alabileceği en küçük ve en büyük değerler
arasında, ortalaması 0 ve varyansı 1 olan bir beta dağılımı varsayılır; iki yanlı p değeri küçük kuyruğun iki katıdır. Normal yaklaşım: 2\,\Phi(-\lvert D\rvert).
Koddaki tercih
tajima() (satır 129–138) pegas paketinin (Paradis, 2010) tajima.test işleviyle aynı sabitleri ve aynı beta parametrelerini kullanır. Tajima D için benzetim p değeri verilmez; öteki dört testin p değerleri benzetimledir (82.4.6).
82.4.3 Fu Fs
- K: n dizilik örneklemdeki haplotip sayısı; k_{\text{göz}}: gözlenen haplotip sayısı.
- \lvert s(n,k)\rvert: birinci tür işaretsiz Stirling sayısı; n nesnenin k döngüye ayrıldığı permütasyonların sayısı.
- Olasılık, Ewens'ın (1972) örnekleme formülünden gelir: sonsuz alel modelinde \theta verildiğinde haplotip sayısının dağılımı.
- F_s çok negatifse (S' küçük): gözlenen haplotip sayısı \hat\theta_\pi'den beklenenden fazladır; yeni, seyrek haplotiplerin çokluğu genişlemeyi düşündürür. Pozitif F_s haplotip eksikliğidir.
Neden haplotip sayısı θπ'ye göre değerlendiriliyor?
\hat\theta_\pi eski, orta sıklıktaki mutasyonların ağırlığını taşır ve yakın zamanlı genişlemeden az etkilenir; haplotip sayısı ise her yeni mutasyonla artar ve genişlemeye çok duyarlıdır. Fu (1997) bu ikisinin karşılaştırılmasının, genişleme ve genetik otostop gibi seyrek varyant fazlası üreten süreçlere karşı Tajima D'den ve Fu–Li testlerinden daha güçlü olduğunu göstermiştir.
Koddaki tercih
Stirling sayıları n büyüdükçe çok hızlı büyür (n\approx170 dolayında çift duyarlıklı sayının sınırı aşılır). Şablon bunları logaritma ölçeğinde özyinelemeyle üretir: \lvert s(m+1,k)\rvert=m\lvert s(m,k)\rvert+\lvert s(m,k-1)\rvert (log_stirling, satır 112–116). F_s doğrudan \ln S'-\ln(1-S') olarak, iki ayrı log-toplamın farkından hesaplanır (117–122); böylece S' 0'a ya da 1'e çok yakınken de sonuç bozulmaz (Chen ve Temme, 2020). Tek haplotipli örneklemde S'=1 olduğundan F_s tanımsızdır ve boş bırakılır.
82.4.4 Fu–Li D* ve F*
Fu ve Li'nin (1993) testleri soy ağacının dış dallarındaki (tek bir diziye giden) mutasyonları öteki mutasyonlarla karşılaştırır. Dış grup olmadığında dış dal mutasyonlarının yerine tekil mutasyonlar (\eta_s) kullanılır; yıldız bunu belirtir.
- a_n=a_1 (82.1'deki harmonik toplam); u_D, v_D, u_F, v_F: yalnız n'ye bağlı sabitler (satır 142–149).
- D^*: toplam mutasyon sayısı ile tekil mutasyon sayısını; F^*: ortalama ikili fark ile tekil mutasyon sayısını karşılaştırır.
- Negatif değer tekil mutasyon fazlasıdır (genişleme, arındırıcı seçilim); pozitif değer tekil mutasyon eksikliğidir.
Koddaki tercih
F^*'ın varyans sabitleri, Fu ve Li'nin makalesindeki biçimde değil, Simonsen, Churchill ve Aquadro'nun (1995) düzelttiği biçimde alınır (satır 148–149). \eta_s=0 olduğunda iki istatistik de tanımlıdır ve büyük pozitif değer alır; şablon bu durumda uyarı yazar (319–321), çünkü tekil mutasyonun hiç bulunmaması gerçek örneklemlerde çok seyrektir ve çoğu zaman yinelenmiş dizilerin işaretidir.
82.4.5 R2
- U_i: i. dizinin taşıdığı tekil mutasyon sayısı.
- Genişlemiş bir popülasyonda soy ağacı yıldız biçimlidir: her dizinin dış dalı uzundur ve üzerinde yaklaşık \theta_\pi/2 tekil mutasyon bulunur; farklar küçülür ve R_2 küçük çıkar.
Ramos-Onsins ve Rozas (2002), küçük örneklemlerde (n\approx10) genişlemeye karşı en güçlü testin R_2, büyük örneklemlerde F_s olduğunu göstermiştir.
82.4.6 Koalesan benzetimi ve p değerleri
F_s, D^*, F^* ve R_2'nin nötr modeldeki dağılımları kapalı biçimde bilinmez; p değerleri sabit büyüklüklü nötr koalesan benzetiminden alınır (Hudson, 1990). Her benzetimde: (1) n soy geçmişe doğru izlenir; k soy varken bir sonraki birleşmeye kadar geçen süre, oranı k(k-1)/\theta olan üstel dağılımdan çekilir ve rastgele iki soy birleştirilir; (2) mutasyonlar dallara yerleştirilir; (3) her mutasyon altındaki dizilerde 1, ötekilerde 0 olan bir sütun üretir (sonsuz konum modeli); (4) istatistik benzetilmiş veriden yeniden hesaplanır.
| İstatistik | Benzetimdeki \theta | Mutasyonlar | p değeri |
|---|---|---|---|
| F_s | \hat\theta_\pi (ya da fs_theta = W ile \hat\theta_W) |
dal uzunluğuyla Poisson | alt kuyruk: \#\{F_s^*\le F_s\}/B |
| D^*, F^* | \hat\theta_W | tam S mutasyon, dallara uzunlukla orantılı (ya da theta ile Poisson) |
iki yanlı: 2\min(\text{alt},\text{üst}) |
| R_2 | \hat\theta_W | aynı | alt kuyruk: \#\{R_2^*\le R_2\}/B |
Neden S sabit tutuluyor?
\theta bilinmez; kestirimi kullanılırsa benzetilen verideki mutasyon sayısı benzetimden benzetime değişir ve p değerine \theta kestiriminin belirsizliği karışır. Ayrışan konum sayısını gözlenen değerde sabit tutmak (mutasyonları ağacın dallarına uzunlukla orantılı dağıtmak) testi \theta'dan bağımsız kılar; D^*, F^* ve R_2 mutasyonların sayısına değil dağılımına bakan istatistikler olduğundan doğal koşul budur (Ramos-Onsins ve Rozas, 2002). F_s ise haplotip sayısının \theta'ya göre fazlalığını ölçer ve \theta üzerinden koşullanır.
Koddaki tercih
Benzetici şablonun kendi koal() işlevidir (satır 184–200); paket kullanılmaz. p değeri b/B'dir (b gözlenen kadar uç benzetim sayısı); gözlenen değer sayıma katılmaz. Bu yüzden p değeri 0 çıkabilir; şablon bunun "p<1/B" anlamına geldiğini not olarak yazar. F_s benzetiminde tek haplotipli ya da hiç mutasyonsuz çıkan tekrarlar (F_s tanımsız) sayımın dışında bırakılır. Benzetimler MerQuR+'ın çalıştırmaya atadığı tohumla başlar; formda tohum alanı yoktur. Tohum betik adımına kaydedilir ve adım yeniden oynatıldığında aynı p değerleri elde edilir; yeni bir çalıştırmada p değerleri Monte Carlo hatası kadar değişir (B=500 ve p=0{,}05 için standart hata 0{,}01).
82.4.7 Uyumsuzluk dağılımı ve ani genişleme modeli
Uyumsuzluk (mismatch) dağılımı, n(n-1)/2 dizi çiftinin fark sayılarının dağılımıdır. Sabit büyüklükte, dengedeki bir popülasyonda beklenen dağılım geometrik biçimde azalır:
Rogers ve Harpending'in (1992) ani genişleme modelinde popülasyon \tau mutasyon birimi önce \theta_0'dan \theta_1'e bir anda büyümüştür:
- \tau=2ut: genişlemeden bu yana geçen süre, mutasyon birimiyle (u: bölgenin tamamı için kuşak başına mutasyon oranı; t: kuşak sayısı).
- \theta_0=2N_0u, \theta_1=2N_1u: genişlemeden önceki ve sonraki büyüklükler.
- Genişleme, dağılımda tepesi yaklaşık \tau'da olan tek bir dalga oluşturur; dalga zamanla sağa kayar.
Parametreler, gözlenen ve beklenen oranların farklarının kareleri toplamı en küçüklenerek kestirilir; iki uyum ölçüsü verilir:
- g_i: tam i konumda ayrışan çiftlerin oranı; d: gözlenen en büyük fark; g_{d+1}=0; i_{\max}=d+3.
- SSD: modelin gözlenen dağılıma uzaklığı. r: Harpending'in (1994) pürüzlülük indeksi; komşu sınıflar arasındaki sıçramaların büyüklüğü. Düzgün, tek tepeli dağılımda küçük; çok tepeli (dengedeki, yapılı) dağılımda büyüktür.
Koddaki tercih
En küçük kareler stats::optim(method = "L-BFGS-B") ile, parametrelerin logaritmaları üzerinde yapılır (satır 216–218). Başlangıç değerleri Rogers'ın (1995) moment kestirimleridir: \hat\theta_0=\sqrt{v-m}, \hat\tau=m-\hat\theta_0 (m ve v ikili farkların ortalaması ve varyansı); \theta_1 için başlangıç \max(100,\,10m)'dir. Sınırlar: \tau\in[10^{-3},\,10\,i_{\max}+10], \theta_0\in[10^{-6},\,10\,i_{\max}+10], \theta_1\in[10^{-2},\,10^{4}]. Moment kestirimleri de tabloda ayrıca verilir (tau_moment, theta0_moment). p değerleri parametrik bootstrap iledir (Schneider ve Excoffier, 1999): kestirilen (\hat\tau,\hat\theta_0,\hat\theta_1) ile genişleme koalesanından veri benzetilir, model her tekrarda yeniden uydurulur ve benzetilen SSD (ya da r) gözlenenden büyük ya da ona eşit olan tekrarların oranı alınır (337–343). Küçük p, genişleme modelinin reddi demektir. Yukarıdaki uyum tek başlangıç noktasından yapılır (varsayılan, ek_baslangic = 0). "Uyumsuzluk uyumunda ek başlangıç sayısı" sıfırdan büyükse moment kestirimlerine dayalı sabit bir ızgaradan (rastgele değil; çalıştırma tohumundan bağımsız) o kadar ek başlangıç noktası daha denenir, en küçük SSD'yi veren çözüm alınır ve eşitlikte ana başlangıç kalır (219–231); parametrik bootstrap tekrarlarında da aynı sayıda ek başlangıç kullanılır (340), bu yüzden süre yaklaşık (1 + ek başlangıç) kat uzar. Konsola hangi grupta hangi başlangıcın daha küçük SSD verdiği yazılır (347, 365). Örnek veride (beş grup, ek_baslangic = 5; benzetim kapalı) SSD hiçbir grupta artmaz; hedef yüzeyi $ heta_0$ ve $ heta_1$ yönünde düz olduğundan SSD sekiz basamağa kadar aynı kalırken parametreler değişir: Tümü $ au$ 12,2222 → 12,2226, $ heta_0$ 0,32534 → 0,32488; pop2 $ heta_0$ 0,00375 → 0,00100 (başlangıç değerinden kıpırdamadı; bu durum "θ0 ve/ya da θ1 belirlenemedi" uyarısıyla bildirilir). Bağımsız Python en iyilemesi (kendi başlangıçlarıyla) aynı SSD'ye ulaşır.
Üç parametre aynı güvenle kestirilmez
Dağılımın biçimini asıl belirleyen \tau'dur (dalganın yeri). \theta_0 yalnız dağılımın sıfıra yakın ucunu, \theta_1 yalnız dalganın hafifçe yayılmasını etkiler; hedef yüzeyi bu iki yönde çok düzdür ve farklı eniyileyiciler SSD'yi sekizinci basamağa kadar aynı bulurken \theta_0 için birbirinden uzak değerler verebilir (82.6, Adım 7). \theta_0 ve \theta_1 kestirimleri sayısal olarak yorumlanmaz; \theta_1 üst sınıra (10^4) ya da \theta_0 alt sınıra dayanmışsa bu, verinin o parametre hakkında bilgi taşımadığını gösterir. Şablon, bir grupta eniyileyici yakınsamadıysa, \theta_1 üst sınıra (10^4), \theta_0 alt sınıra (10^{-6}) dayandıysa ya da \theta_0 başlangıç değerinden kıpırdamadıysa grup adını bir uyarıyla yazar (satır 235–237, 323, 338–339); SSD, r ve p değerleri bu durumdan etkilenmez.
82.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–95 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on bir parametre. | Form buradan kurulur (Bölüm 1.2). |
| 96–106 | Dil yardımcısı; kipin, benzetim sayılarının ve iki benzetim seçeneğinin okunması. | Paket yüklenmez. |
| 108–122 | Log-toplam yardımcıları, log_stirling, fu_fs. |
F_s doğrudan log ölçeğinde (82.4.3). |
| 123–152 | sabitler, tajima, fu_li. |
n<4 ya da S<1 (\eta<1) ise boş değer döner. |
| 153–180 | istatistik (gözlenen veri; dört durumlu), istatistik_ikili (benzetim; 0/1), r2_ist. |
İkili sürümde tekil mutasyon, sütun toplamı 1 ya da n-1 olan konumdur (173). |
| 182–200 | koal: koalesan ağacı, isteğe bağlı büyüklük değişimi (\tau, \theta_0, \theta_1), mutasyonların yerleştirilmesi. |
S verilirse çok terimli, verilmezse Poisson (196). |
| 202–239 | F_sabit, F_genis, uyum: beklenen dağılımlar ve en küçük kareler uyumu. |
Bootstrap tekrarlarında başlangıç, gözlenen verinin çözümüdür (340). |
| 241–263 | Özet kipi: denetimler, satır satır Tajima D ve F_s, tablo. | Blok invisible(NULL) ile biter; dizi kipi else dalındadır. |
| 266–300 | Dizi kipi: okuma, denetimler, tam silme, ayrışan konumların kodlanması, grupların kurulması. | Gruplar adla tutulan bir listedir; ilk öğe "Tümü"dür (297–298). |
| 301–350 | Grup döngüsü: çeşitlilik, testler, benzetim p değerleri, uyumsuzluk uyumu ve bootstrap. | Ayrışan konumu olmayan grupta testler boş bırakılır (313–317). |
| 351–387 | Notlar, üç tablo, ilk grubun ayrıntılı uyumsuzluk tablosu, şekil. | Şekil en çok altı grubu gösterir (371); ayrıntılı tablo yalnız ilk grup içindir (367–370). |
F_s'nin hesabı iki satırdır:
t <- log_stirling(n) + seq_len(n) * log(theta)
lse(t[k:n]) - lse(t[1:(k - 1)])       # ln(S′/(1 − S′)) = ln(S′) − ln(T′)
82.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/notralite_testleri/elle_hesap.py ile, şablonun işlevleri kullanılmadan hesaplanmıştır: F_s Stirling sayıları yerine haplotip sayısının dağılımının Bernoulli evrişimiyle, öteki istatistikler 82.4'teki formüllerle, uyumsuzluk uyumu çok başlangıçlı ayrı bir eniyilemeyle, benzetim p değerleri ayrı yazılmış bir koalesan benzeticisiyle. R tarafında (r_dogrulama.R) Tajima D, R_2, H_d ve \pi pegas paketinin işlevleriyle, F_s kesin tam sayı Stirling sayılarıyla (gmp, Rmpfr), uyum nlminb ile bulunmuştur.
Adım 1 — Tam silme. 965 konumun 55'inde en az bir dizide bilinmeyen baz vardır; 910 konum kalır.
Adım 2 — Çeşitlilik ("Tümü", n=80). 910 konumun 50'si ayrışır: 48'inde iki, 2'sinde üç farklı baz vardır; S=50, \eta=48+2\times2=52. Hiçbir baz tek bir dizide görülmez: \eta_s=0. Farklı dizi sayısı 15, H_d=0{,}9363924. 3160 dizi çiftinin ortalama farkı \hat\theta_\pi=10{,}5107595; \pi=10{,}5107595/910=0{,}0115503. a_1=\sum_{i=1}^{79}1/i=4{,}9529793:
Adım 3 — Tajima D. a_2=1{,}6323556, e_1=0{,}0282403, e_2=0{,}0033461:
Beta yaklaşımıyla p=0{,}8614, normal yaklaşımla p=0{,}8933. Beş dizili örnekte (n=5, S=4, \hat\theta_\pi=2): a_1=2{,}0833, \hat\theta_W=4/2{,}0833=1{,}92 ve D=0{,}2734498; bu, örneğin yayımlanmış değeridir (0{,}2734).
Adım 4 — Fu Fs. \theta=10{,}5107595 ve n=80 için haplotip sayısı, i=0,\dots,79 için başarı olasılığı \theta/(\theta+i) olan bağımsız Bernoulli denemelerinin toplamı gibi dağılır; beklenen değeri 23{,}08'dir. Bu dağılımda P(K\ge15)=0{,}9930447:
Gözlenen 15 haplotip beklenenden azdır; F_s pozitiftir. Özet kipinde Chen ve Temme'nin (2020) Tablo 1'indeki yedi durum için bulunan değerler (-6{,}8294578; -10{,}1290263; -10{,}2298131; -26{,}4155959; -46{,}7623896; -112{,}4248080; -192{,}2182390) tablodaki yayımlanmış değerlerle yedi ondalık basamak aynıdır. n=2001 durumunda S'\approx e^{-192}'dir; log ölçeği olmadan hesaplanamaz.
Adım 5 — Fu–Li D* ve F*. "Tümü" satırında \eta_s=0 olduğundan paylar \frac{80}{79}\times52=52{,}658 ve \hat\theta_\pi=10{,}511'e iner: D^*=2{,}1286936, F^*=1{,}5457905. pop1'de (n=20, \eta=34, \eta_s=10, \hat\theta_\pi=9{,}9210526, a_n=3{,}5477397) D^*'ın payı \frac{20}{19}\times34-3{,}5477397\times10=0{,}3121 ve D^*=0{,}0146028, F^*=0{,}0601735'tir.
Adım 6 — R2. "Tümü" satırında her dizi için U_i=0'dır; formül R_2=\hat\theta_\pi/(2S)=10{,}5107595/100=0{,}1051076'ya iner. pop1'de R_2=0{,}1451585.
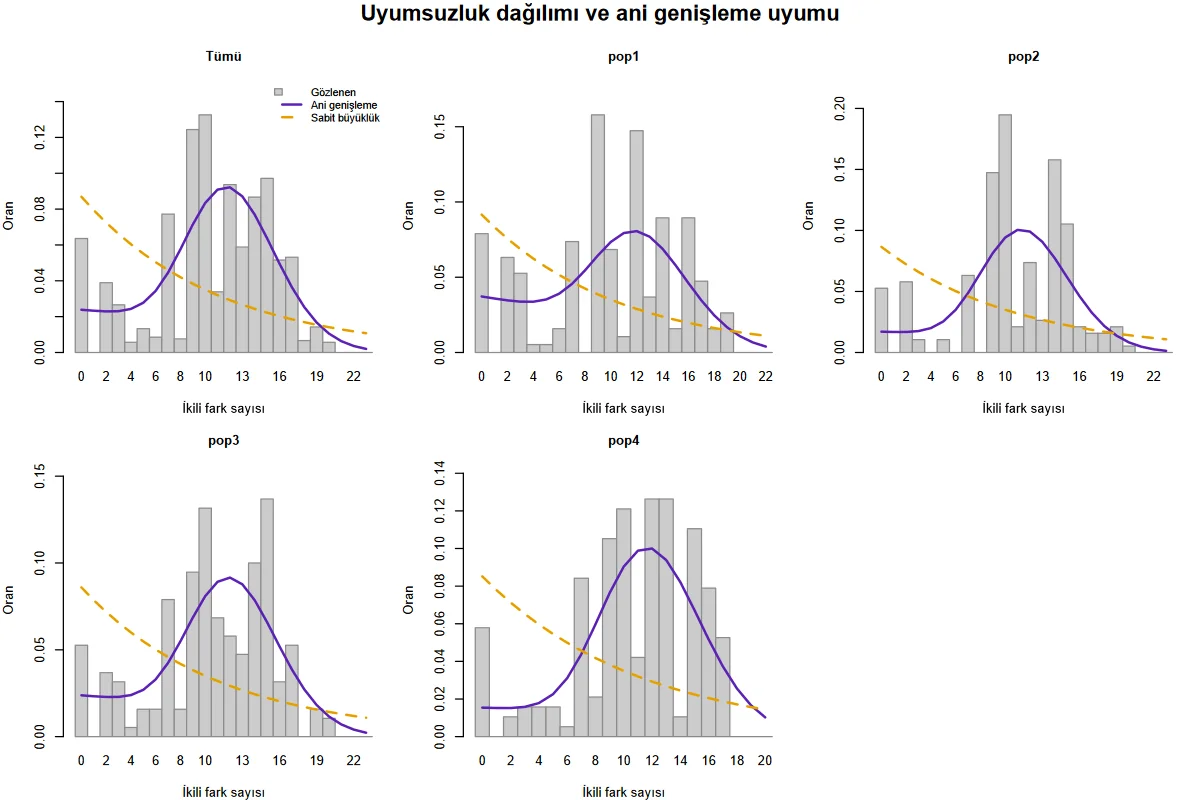
Adım 7 — Uyumsuzluk dağılımı ("Tümü"). 3160 çiftin 201'i özdeştir (g_0=0{,}0636); tam bir konumda ayrışan çift yoktur (g_1=0); en büyük fark 20'dir. Ortalama m=10{,}5107595, varyans v=22{,}7893745. Moment kestirimleri:
Pürüzlülük r=0{,}0493241. En küçük kareler uyumunun sonucu eniyileyiciye göre şöyledir:
| Grup | Eniyileyici | \hat\tau | \hat\theta_0 | \hat\theta_1 | SSD |
|---|---|---|---|---|---|
| Tümü | MerQuR+ (L-BFGS-B) | 12,2222 | 0,32534 | 40,953 | 0,0183817396 |
| Python (L-BFGS-B + Nelder–Mead, 28 başlangıç) | 12,2225 | 0,32498 | 40,953 | 0,0183817396 | |
R (nlminb, 8 başlangıç) |
12,2377 | 0,30982 | 40,929 | 0,0183817458 | |
| pop2 | MerQuR+ | 12,0395 | 0,00375 | 57,680 | 0,0445671455 |
| Python | 12,0432 | 0,000001 | 57,674 | 0,0445671439 | |
| R | 12,0429 | 0,00026 | 57,674 | 0,0445671439 | |
| pop3 | MerQuR+ | 12,5051 | 0,22575 | 41,033 | 0,0186465366 |
| Python | 12,5253 | 0,20480 | 41,022 | 0,0186465257 | |
| R | 12,5253 | 0,20480 | 41,022 | 0,0186465257 |
SSD üç yolda sekizinci basamağa kadar aynıdır; \hat\tau üçüncü anlamlı basamakta, \hat\theta_0 ise büyüklük sırası düzeyinde oynar. pop2'de \theta_0'ı 10^{-6}'dan 0{,}01'e çıkarmak SSD'yi yalnız 8\times10^{-8} değiştirir: veri \theta_0'ın "küçük" olduğunu söyler, değerini söylemez. En küçük kareler \hat\tau'su (12{,}2) moment kestiriminden (7{,}0) büyüktür, çünkü moment kestirimi dağılımın sıfırdaki yığılmasını (g_0=0{,}064; yinelenmiş diziler) büyük bir \theta_0'a yorar.
Şablonun parametrelerinde modelin beklediği oranlar ayrı bir uygulamayla (Poisson ağırlıklarıyla evrişim) yeniden hesaplanmıştır: fark 0 için 0{,}0238386, fark 12 için 0{,}0921550; sabit büyüklük beklentisi fark 0 için 1/(\hat\theta_\pi+1)=0{,}0868752'dir.
Adım 8 — Benzetim p değerleri. Şablonun p değerleri (çalıştırma 2: B=3000) ile ayrı yazılmış benzeticinin p değerleri (B=3000; başka bir rastgele sayı üreteci) karşılaştırılmıştır. İki kod aynı çekilişleri kullanmaz; beklenen, farkların Monte Carlo hatası düzeyinde kalmasıdır (p=0{,}5 dolayında alt kuyruk için standart hata 0{,}009; iki yanlı p için bunun iki katı).
| Grup | p(F_s) | p(D^*) | p(F^*) | p(R_2) | ||||
|---|---|---|---|---|---|---|---|---|
| MerQuR+ | bağımsız | MerQuR+ | bağımsız | MerQuR+ | bağımsız | MerQuR+ | bağımsız | |
| Tümü | 0,915 | 0,914 | 0,000 | 0,000 | 0,060 | 0,067 | 0,657 | 0,656 |
| pop1 | 0,643 | 0,630 | 0,976 | 0,999 | 0,986 | 0,971 | 0,701 | 0,717 |
| pop2 | 0,533 | 0,533 | 0,399 | 0,377 | 0,385 | 0,367 | 0,220 | 0,218 |
| pop3 | 0,401 | 0,385 | 0,269 | 0,307 | 0,281 | 0,323 | 0,197 | 0,201 |
| pop4 | 0,528 | 0,531 | 0,710 | 0,677 | 0,634 | 0,599 | 0,300 | 0,289 |
Örnek ayarda (B=500; çalıştırma 1) aynı p değerleri daha kaba çözünürlükle elde edilir ("Tümü": 0{,}904; 0{,}000; 0{,}076; 0{,}690). Parametrik bootstrap için "Tümü" satırında şablon (B=100) p_{\mathrm{SSD}}=0{,}02 ve p_r=0{,}00; bağımsız benzetici ve eniyileyici (B=300) 0{,}017 ve 0{,}000 verir.
Adım 9 — Koşulun etkisi (çalıştırma 3). D^*, F^* ve R_2 benzetimi \theta_W koşullu yapıldığında ve F_s benzetiminde \theta_W kullanıldığında "Tümü" satırının p değerleri 0{,}910 (F_s), 0{,}000 (D^*), 0{,}088 (F^*) ve 0{,}638 (R_2) olur; bu veride iki koşul arasındaki fark Monte Carlo hatasından büyük değildir.
82.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1, 4 ve 5).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Tümü: S | 50 | 50 | 50 | 0 | ✓ |
| Tümü: \eta | 52 | 52 | 52 | 0 | ✓ |
| Tümü: \eta_s | 0 | 0 | 0 | 0 | ✓ |
| Tümü: haplotip sayısı | 15 | 15 | 15 | 0 | ✓ |
| Tümü: H_d | 0,93639241 | 0,93639241 | 0,93639241 | 2,2e−16 | ✓ |
| Tümü: \theta_\pi | 10,51075949 | 10,51075949 | 10,51075949 | 1,4e−15 | ✓ |
| Tümü: \pi | 0,01155029 | 0,01155029 | 0,01155029 | 1,0e−17 | ✓ |
| Tümü: \theta_W | 10,09493422 | 10,09493422 | 10,09493422 | 4,4e−15 | ✓ |
| Tümü: Tajima D | 0,13413832 | 0,13413832 | 0,13413832 | 4,4e−16 | ✓ |
| Tümü: p (beta) | 0,86144105 | 0,86144105 | 0,86144105 | 5,6e−16 | ✓ |
| Tümü: p (normal) | 0,8932932 | 0,8932932 | 0,8932932 | 2,2e−16 | ✓ |
| Tümü: Fu F_s | 4,9612649 | 4,9612649 | 4,9612649 | 4,5e−15 | ✓ |
| Tümü: Fu–Li D^* | 2,12869358 | 2,12869358 | 2,12869358 | 2,1e−16 | ✓ |
| Tümü: Fu–Li F^* | 1,54579052 | 1,54579052 | 1,54579052 | 0 | ✓ |
| Tümü: R_2 | 0,10510759 | 0,10510759 | 0,10510759 | 1,2e−16 | ✓ |
| pop1: S | 33 | 33 | 33 | 0 | ✓ |
| pop1: \eta | 34 | 34 | 34 | 0 | ✓ |
| pop1: \eta_s | 10 | 10 | 10 | 0 | ✓ |
| pop1: haplotip sayısı | 11 | 11 | 11 | 0 | ✓ |
| pop1: H_d | 0,92105263 | 0,92105263 | 0,92105263 | 3,3e−16 | ✓ |
| pop1: \theta_\pi | 9,92105263 | 9,92105263 | 9,92105263 | 3,6e−16 | ✓ |
| pop1: \pi | 0,01090226 | 0,01090226 | 0,01090226 | 4,3e−17 | ✓ |
| pop1: \theta_W | 9,30169719 | 9,30169719 | 9,30169719 | 3,8e−16 | ✓ |
| pop1: Tajima D | 0,26252576 | 0,26252576 | 0,26252576 | 3,9e−16 | ✓ |
| pop1: p (beta) | 0,7845155 | 0,7845155 | 0,7845155 | 7,8e−16 | ✓ |
| pop1: p (normal) | 0,79291613 | 0,79291613 | 0,79291613 | 3,3e−16 | ✓ |
| pop1: Fu F_s | 0,62508916 | 0,62508916 | 0,62508916 | 3,1e−15 | ✓ |
| pop1: Fu–Li D^* | 0,01460277 | 0,01460277 | 0,01460277 | 3,4e−16 | ✓ |
| pop1: Fu–Li F^* | 0,06017355 | 0,06017355 | 0,06017355 | 3,5e−17 | ✓ |
| pop1: R_2 | 0,14515846 | 0,14515846 | 0,14515846 | 4,4e−16 | ✓ |
| pop2: Tajima D | −0,67155688 | −0,67155688 | −0,67155688 | 5,6e−16 | ✓ |
| pop2: Fu F_s | 0,04974899 | 0,04974899 | 0,04974899 | 3,5e−15 | ✓ |
| pop2: Fu–Li D^* | −0,74497456 | −0,74497456 | −0,74497456 | 1,0e−15 | ✓ |
| pop2: Fu–Li F^* | −0,89276422 | −0,89276422 | −0,89276422 | 2,2e−16 | ✓ |
| pop2: R_2 | 0,10496182 | 0,10496182 | 0,10496182 | 9,7e−17 | ✓ |
| pop3: Tajima D | −0,64662192 | −0,64662192 | −0,64662192 | 6,7e−16 | ✓ |
| pop3: Fu F_s | −0,71233821 | −0,71233821 | −0,71233821 | 4,4e−15 | ✓ |
| pop3: Fu–Li D^* | −0,99104898 | −0,99104898 | −0,99104898 | 4,4e−16 | ✓ |
| pop3: Fu–Li F^* | −1,08534303 | −1,08534303 | −1,08534303 | 0 | ✓ |
| pop3: R_2 | 0,10348275 | 0,10348275 | 0,10348275 | 2,1e−16 | ✓ |
| pop4: Tajima D | −0,53572262 | −0,53572262 | −0,53572262 | 5,6e−16 | ✓ |
| pop4: Fu F_s | 0,10704254 | 0,10704254 | 0,10704254 | 1,2e−15 | ✓ |
| pop4: Fu–Li D^* | −0,33934026 | −0,33934026 | −0,33934026 | 2,8e−16 | ✓ |
| pop4: Fu–Li F^* | −0,49106018 | −0,49106018 | −0,49106018 | 0 | ✓ |
| pop4: R_2 | 0,11076957 | 0,11076957 | 0,11076957 | 3,3e−16 | ✓ |
| Tümü: ikili farkların ortalaması | 10,51075949 | 10,51075949 | 10,51075949 | 1,4e−15 | ✓ |
| Tümü: ikili farkların varyansı | 22,78937454 | 22,78937454 | — | 7,8e−16 | ✓ |
| Tümü: \tau (moment) | 7,00667401 | 7,00667401 | 7,00667401 | 5,1e−16 | ✓ |
| Tümü: \theta_0 (moment) | 3,50408548 | 3,50408548 | 3,50408548 | 2,5e−16 | ✓ |
| Tümü: SSD (en küçük) | 0,01838174 | 0,01838174 | 0,01838175 | 6,2e−9 | ✓ |
| Tümü: pürüzlülük r | 0,04932413 | 0,04932413 | 0,04932413 | 1,4e−17 | ✓ |
| pop1: SSD (en küçük) | 0,03434898 | 0,03434898 | 0,03434931 | 3,3e−7 | ✓ |
| pop1: pürüzlülük r | 0,10590028 | 0,10590028 | 0,10590028 | 2,2e−16 | ✓ |
| pop2: SSD (en küçük) | 0,04456715 | 0,04456714 | 0,04456714 | 1,5e−9 | ✓ |
| pop2: pürüzlülük r | 0,1033241 | 0,1033241 | 0,1033241 | 3,2e−16 | ✓ |
| pop3: SSD (en küçük) | 0,01864654 | 0,01864653 | 0,01864653 | 1,1e−8 | ✓ |
| pop3: pürüzlülük r | 0,04354571 | 0,04354571 | 0,04354571 | 3,5e−17 | ✓ |
| pop4: SSD (en küçük) | 0,02165861 | 0,02165861 | 0,02165861 | 2,9e−9 | ✓ |
| pop4: pürüzlülük r | 0,06235457 | 0,06235457 | 0,06235457 | 1,4e−17 | ✓ |
| Tümü, fark = 0: gözlenen oran | 0,06360759 | 0,06360759 | — | 2,8e−17 | ✓ |
| Tümü, fark = 0: ani genişleme beklentisi (şablonun parametrelerinde) | 0,02383864 | 0,02383864 | 0,02383864 | 1,9e−15 | ✓ |
| Tümü, fark = 0: sabit büyüklük beklentisi | 0,08687524 | 0,08687524 | — | 0 | ✓ |
| Tümü, fark = 10: gözlenen oran | 0,13259494 | 0,13259494 | — | 2,2e−16 | ✓ |
| Tümü, fark = 10: ani genişleme beklentisi (şablonun parametrelerinde) | 0,08343415 | 0,08343415 | 0,08343415 | 3,7e−13 | ✓ |
| Tümü, fark = 10: sabit büyüklük beklentisi | 0,03501041 | 0,03501041 | — | 2,1e−17 | ✓ |
| Tümü, fark = 12: gözlenen oran | 0,09367089 | 0,09367089 | — | 2,8e−17 | ✓ |
| Tümü, fark = 12: ani genişleme beklentisi (şablonun parametrelerinde) | 0,092155 | 0,092155 | 0,092155 | 1,6e−13 | ✓ |
| Tümü, fark = 12: sabit büyüklük beklentisi | 0,02919157 | 0,02919157 | — | 1,9e−16 | ✓ |
| Özet kipi, n/k; \theta = 25/20; 9,39: F_s | −6,82945775 | −6,82945775 | −6,82945775 | 2,2e−15 | ✓ |
| Özet kipi, n/k; \theta = 50/31; 9,61: F_s | −10,12902633 | −10,12902633 | −10,12902633 | 5,6e−15 | ✓ |
| Özet kipi, n/k; \theta = 100/40; 9,37: F_s | −10,2298131 | −10,2298131 | −10,2298131 | 1,4e−15 | ✓ |
| Özet kipi, n/k; \theta = 250/67; 8,96: F_s | −26,41559595 | −26,41559595 | −26,41559595 | 9,1e−15 | ✓ |
| Özet kipi, n/k; \theta = 500/95; 9,04: F_s | −46,76238956 | −46,76238956 | −46,76238956 | 3,3e−14 | ✓ |
| Özet kipi, n/k; \theta = 1000/152; 9,07: F_s | −112,42480798 | −112,42480798 | −112,42480798 | 2,6e−14 | ✓ |
| Özet kipi, n/k; \theta = 2001/213; 9,03: F_s | −192,21823898 | −192,21823898 | −192,21823898 | 5,1e−14 | ✓ |
| Özet kipi, n/k; \theta = 5/5; 2: F_s | −3,06805294 | −3,06805294 | −3,06805294 | 1,0e−15 | ✓ |
| Özet kipi, n/k; \theta = 100/31; 39,37: F_s | 11,82549084 | 11,82549084 | 11,82549084 | 3,0e−15 | ✓ |
| Özet kipi, beş dizi: Tajima D | 0,27344977 | 0,27344977 | 0,27344977 | 6,7e−16 | ✓ |
| Özet kipi, beş dizi: p (beta) | 0,77148706 | 0,77148706 | 0,77148706 | 1,2e−15 | ✓ |
| Özet kipi, beş dizi: \theta_W | 1,92 | 1,92 | 1,92 | 2,3e−16 | ✓ |
| Beş dizi (dizi kipi): Fu–Li D^* | 0,27344977 | 0,27344977 | 0,27344977 | 2,2e−16 | ✓ |
| Beş dizi (dizi kipi): Fu–Li F^* | 0,27833725 | 0,27833725 | 0,27833725 | 5,6e−17 | ✓ |
| Beş dizi (dizi kipi): R_2 | 0,19364917 | 0,19364917 | 0,19364917 | 1,4e−16 | ✓ |
Ölçütü karşılayan: 83/83. Python: F_s Stirling sayıları yerine Bernoulli evrişimiyle; ötekiler özgün formüllerle; uyumsuzluk uyumu çok başlangıçlı L-BFGS-B ve Nelder–Mead ile. R: Tajima D, R_2, H_d ve \pi pegas işlevleriyle, F_s kesin tam sayı Stirling sayıları (gmp) ve çok duyarlıklı toplamla (Rmpfr), uyum nlminb ile. SSD satırlarında üç eniyileyicinin bulduğu en küçük değerler karşılaştırılmıştır; \tau, \theta_0, \theta_1 kestirimleri bölüm metnindeki ayrı tabloda verilir.
Benzetim ve bootstrap p değerleri bu tabloda yoktur; bağımsız benzeticiyle karşılaştırmaları Adım 8'dedir. \hat\tau, \hat\theta_0 ve \hat\theta_1 kestirimleri de tabloya alınmamıştır: üç eniyileyici aynı en küçük SSD'ye ulaşır, ama düz hedef yüzeyi nedeniyle parametreler 10^{-6} ölçütünü karşılayacak kadar belirlenmez (Adım 7).
82.7 Çıktıyı okuma
Örnek ayarın konsol metni ve tabloları (uzun satırlar bölünmüş, geniş tablolar iki parçada verilmiş, uyumsuzluk dağılımı tablosu kısaltılmıştır):
Not: eksik/belirsiz baz içeren 55 konum çıkarıldı (tam silme); 910 konum kullanıldı.
Uyarı (Tümü): tekil (singleton) mutasyon yok (ηs = 0). Fu–Li D* ve F* bu durumda tanımlıdır (Fu ve Li 1993
formülü), ancak yalnız η ve θπ'ye dayanır ve nötr beklentiye göre aşırı pozitif çıkar; …
Dizi çeşitliliği ve nötralite testleri: 80 dizi, 910 konum (tam silme), 5 grup;
benzetim: 500 (nötralite), 100 (uyumsuzluk)
Not: benzetim p değeri 0, 500 benzetimin hiçbirinde gözlenen kadar uç bir değer çıkmadığı
anlamına gelir (p < 1/500).

Dizi çeşitliliği (S, η, ηs, haplotip, Hd, θπ, π = θπ/L, θW)
grup  n   L  S  eta  eta_s  haplotip     Hd  theta_pi     pi  theta_W  theta_W_konum
Tümü 80 910 50   52      0        15 0.9364   10.5108 0.0116  10.0949         0.0111
pop1 20 910 33   34     10        11 0.9211    9.9211 0.0109   9.3017         0.0102
pop2 20 910 45   47     20        12 0.9474   10.5579 0.0116  12.6841         0.0139
pop3 20 910 45   47     22        13 0.9474   10.6368 0.0117  12.6841         0.0139
pop4 20 910 44   45     16        12 0.9421   10.7421 0.0118  12.4023         0.0136

Nötralite testleri (Tajima D; Fu Fs; Fu–Li D*, F*; R2; benzetim p değerleri)
grup  Tajima_D  p_D_beta  p_D_normal   Fu_Fs   p_Fs
Tümü    0.1341    0.8614      0.8933  4.9613 0.9040
pop1    0.2625    0.7845      0.7929  0.6251 0.6180
pop2   -0.6716    0.5440      0.5019  0.0497 0.5420
pop3   -0.6466    0.5606      0.5179 -0.7123 0.3860
pop4   -0.5357    0.6365      0.5922  0.1070 0.5380
grup  FuLi_Dstar  p_Dstar  FuLi_Fstar  p_Fstar     R2   p_R2
Tümü      2.1287   0.0000      1.5458   0.0760 0.1051 0.6900
pop1      0.0146   0.9360      0.0602   0.8800 0.1452 0.7300
pop2     -0.7450   0.4320     -0.8928   0.4160 0.1050 0.2180
pop3     -0.9910   0.2520     -1.0853   0.2800 0.1035 0.1740
pop4     -0.3393   0.6520     -0.4911   0.5880 0.1108 0.2760

Uyumsuzluk dağılımı: ani genişleme modeli (τ, θ0, θ1), SSD ve pürüzlülük r
grup  ortalama  varyans     tau  theta0  theta1
Tümü   10.5108  22.7894 12.2222  0.3253 40.9534
pop1    9.9211  27.4911 12.4271  0.4497 25.8740
pop2   10.5579  20.7453 12.0395  0.0037 57.6800
pop3   10.6368  22.3806 12.5051  0.2257 41.0335
pop4   10.7421  18.8167 12.3528  0.0046 63.8745
grup  tau_moment  theta0_moment    SSD  p_SSD      r    p_r
Tümü      7.0067         3.5041 0.0184 0.0200 0.0493 0.0000
pop1      5.7294         4.1917 0.0343 0.1100 0.1059 0.0200
pop2      7.3661         3.1918 0.0446 0.0200 0.1033 0.0100
pop3      7.2099         3.4269 0.0186 0.1300 0.0435 0.0700
pop4      7.9005         2.8416 0.0217 0.0500 0.0624 0.0200

Uyumsuzluk dağılımı (Tümü)
 fark  gozlenen_oran  beklenen_genisleme  beklenen_sabit
    0         0.0636              0.0238          0.0869
    1         0.0000              0.0233          0.0793
   10         0.1326              0.0834          0.0350
   11         0.0339              0.0909          0.0320
   12         0.0937              0.0922          0.0292
Özet kipinin tablosu (çalıştırma 4; ilk yedi satır Chen ve Temme'nin Tablo 1'i, sekizinci satır beş dizili örnek):
Tajima D ve Fu Fs (özet istatistiklerden; Fs kesin Ewens formülüyle)
 satir    n  haplotip  theta_pi      S  theta_W  Tajima_D  p_beta  p_normal     Fu_Fs
     1   25        20    9.3900    NaN      NaN       NaN     NaN       NaN   -6.8295
     2   50        31    9.6100    NaN      NaN       NaN     NaN       NaN  -10.1290
     7 2001       213    9.0300    NaN      NaN       NaN     NaN       NaN -192.2182
     8    5         5    2.0000 4.0000   1.9200    0.2734  0.7715    0.7845   -3.0681
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
L |
Tam silmeden sonra kalan konum sayısı | Bütün gruplarda aynıdır; \pi ve konum başına \theta_W bununla bölünür. |
S, eta, eta_s |
Ayrışan konum, toplam mutasyon, tekil mutasyon | eta_s = 0 yinelenmiş diziler için uyarı işaretidir. |
theta_pi, theta_W |
\theta'nın iki kestirimi (dizi başına) | Yakınlıkları nötr dengeyle bağdaşır; theta_W büyükse seyrek mutasyon fazlası vardır. |
Tajima_D, p_D_beta, p_D_normal |
D ve iki yanlı iki p değeri | Beta yaklaşımı Tajima'nın önerisidir; ikisi çoğu zaman yakındır. |
Fu_Fs, p_Fs |
F_s ve alt kuyruk p değeri | Yalnız negatif F_s için küçük p beklenir. Fu'nun (1997) benzetimlerine dayanan yaygın uygulamada %5 düzeyi için p<0{,}02 aranır. |
FuLi_Dstar, FuLi_Fstar, p_Dstar, p_Fstar |
İstatistikler ve iki yanlı benzetim p değerleri | İşaret yönü gösterir: negatif tekil fazlası, pozitif tekil eksikliği. |
R2, p_R2 |
R_2 ve alt kuyruk p değeri | Küçük R_2 ve küçük p genişlemeyi düşündürür. |
tau, theta0, theta1 |
Ani genişleme modelinin en küçük kareler kestirimleri | Yalnız tau yorumlanır; t=\tau/(2u) ile kuşak sayısına çevrilir. |
tau_moment, theta0_moment |
Rogers'ın moment kestirimleri | En küçük kareler çözümünden çok farklıysa dağılım tek dalgalı değildir. |
SSD, p_SSD |
Model uyumsuzluğu ve bootstrap p değeri | Küçük p: ani genişleme modeli reddedilir. Büyük p genişlemenin kanıtı değil, reddedilememesidir. |
r, p_r |
Pürüzlülük ve bootstrap p değeri | Küçük p: dağılım, genişleme modelinin beklediğinden daha pürüzlüdür. |
| Uyumsuzluk dağılımı tablosu | İlk grubun gözlenen ve iki modelden beklenen oranları | Çubuk grafiğin sayısal karşılığıdır; öteki gruplar yalnız şekilde gösterilir. |
Şekil 82.1. Uyumsuzluk dağılımları (örnek ayar). Çubuklar gözlenen oranlar; mor çizgi ani genişleme modelinin, turuncu kesikli çizgi sabit büyüklük modelinin beklentisidir. Dağılımlar çok tepelidir: 80 dizi yalnız 15 farklı diziden oluştuğu için ikili farklar birkaç değerde yığılır.
Rapor cümlesi (örnek ayar, bütün örneklem):
Sitokrom b dizilerinde (80 dizi; eksik ya da belirsiz baz içeren konumlar çıkarıldıktan sonra 910 konum) 50 ayrışan konum ve 15 haplotip belirlendi (Hd = 0,936; π = 0,0116; θπ = 10,51; θW = 10,09). Tajima D (0,134; p = 0,861), Fu Fs (4,96; p = 0,904) ve R2 (0,105; p = 0,690) nötr denge beklentisinden sapma göstermedi. Uyumsuzluk dağılımı çok tepeliydi ve ani genişleme modeli reddedildi (SSD = 0,018; p = 0,02; pürüzlülük r = 0,049; p < 0,01). Benzetim p değerleri 500, uyumsuzluk p değerleri 100 tekrara dayanır.
82.8 Sık hatalar ve tuzaklar
- Yinelenmiş ya da haplotipe indirgenmiş dizilerle test yapmak. Testler her dizinin bağımsız bir birey olduğunu varsayar. Yalnız farklı haplotiplerin (frekanssız) verilmesi seyrek varyantları şişirir; yinelenmiş diziler tekil mutasyonları yok eder. Örnek veride \eta_s=0'dır ve D^* için p=0{,}000 çıkar; bu bir yapaylıktır. Her birey için bir dizi verilir.
- Anlamlı bir testi tek bir nedene bağlamak. Negatif D ya da F_s genişlemeden, seçici süpürmeden ya da arındırıcı seçilimden; pozitif D darboğazdan, alt bölünmeden ya da dengeleyici seçilimden gelebilir. Demografi bütün lokusları, seçilim tek lokusu etkiler; ayrım için birden çok bağımsız lokus gerekir.
- Yapılı popülasyonları tek örneklemde birleştirmek. Farklılaşmış popülasyonların dizileri "Tümü" satırında birleştirildiğinde orta sıklıkta varyant fazlası oluşur ve D pozitife kayar; popülasyon satırları ayrı okunur.
- Popülasyona "Tümü" adını vermek. Bütün örneklem satırı bu adla tutulur (arayüz İngilizceyken "All"). Aynı adı taşıyan bir popülasyon varsa bütün örneklemin satırı korunur ve popülasyon satırı "Tümü (popülasyon)" ("All (population)") adıyla ayrı verilir (satır 297–300); iki satırı karıştırmamak için popülasyonu başka bir adla kodlamak yine de daha okunaklıdır.
- Benzetim p değerini 0 olarak raporlamak. b/B tanımında 0, "p<1/B" demektir; B=500 için "p<0{,}002" yazılır. Yayın için benzetim sayısı en az 1000'e, bootstrap sayısı varsayılan 100'den en az 1000'e çıkarılır; 100 tekrarla p değeri yalnız 0,01 adımlarla değişir.
- D^* ve F^*'ın iki yanlı p değerini tek yanlı hipotezle okumak. Genişleme hipotezi negatif yöndedir; istatistik pozitifken küçük p genişlemeyi desteklemez.
- F_s'yi 0,05 düzeyinde değerlendirmek. 82.7'deki tabloya bakınız.
- Özet kipinde konum başına \pi girmek. Alan dizi başına ortalama farkı ister (\pi\times L). Konum başına değer girilirse \theta çok küçük alınır; F_s büyük pozitif, D büyük negatif çıkar ve uyarı verilmez.
- Kısa okunmuş tek bir diziyi veride bırakmak. Tam silme o dizinin eksik olduğu bütün konumları herkes için atar; "… konum çıkarıldı" notundaki sayı büyükse eksikleri çok olan diziler çıkarılıp yeniden çalıştırılır.
- \theta_0 ve \theta_1 kestirimlerini sayı olarak yorumlamak. 82.4.7'deki uyarı. Aynı nedenle \hat\tau'dan türetilen genişleme zamanı kaba bir büyüklüktür; mutasyon oranındaki belirsizlik ve bölgenin tamamı için oranın kullanılması gereği (u=\mu\times L) ayrıca hesaba katılır (Schenekar ve Weiss, 2011).
- SSD'nin büyük p değerini genişlemenin kanıtı saymak. Test genişleme modelini sıfır hipotezi alır; küçük örneklemde gücü düşüktür ve hemen her tek tepeli dağılım "reddedilemez".
- Rekombinasyonlu ya da çok lokuslu veriyi tek lokus gibi vermek. Rekombinasyon haplotip sayısını artırır ve F_s'yi negatife iter; mutasyon sıklıklarına dayalı istatistiklerin (D, D^*, F^*) varyansını ise küçültür. Rekombinasyonsuz sıfır dağılımıyla p değerleri iki durumda da geçerliliğini yitirir (Ramírez-Soriano ve ark., 2008).
- Çok grubun yalnız ilk altısını şekilde görüp ötekileri unutmak. Şekil en çok altı paneldir; tablolar bütün grupları içerir.
- Dörtten az dizili popülasyonun sessizce düştüğünü fark etmemek. Atlanan gruplar yalnız bir notla bildirilir; "Tümü" satırına katılırlar.
82.9 Uzman soruları
S1. Aynı veri başka bir programda neden farklı θπ, S ya da D verebilir?
En sık neden eksik verinin ele alınışıdır. Şablon tam silme uygular: bir konum herhangi bir dizide bilinmiyorsa atılır. Bazı uygulamalar ikili farkları çift bazında silmeyle sayar ve ayrışan konumları bütün hizalamadan bulur; o zaman \hat\theta_\pi ve S farklı konum kümelerine dayanır. Örnek veride tam silmeyle S=50, ham hizalamada ayrışan konum sayısı 56'dır (Bölüm 77). İkinci neden, belirsizlik kodlarının bilinmeyen sayılıp sayılmaması ve boşlukların beşinci durum olarak ele alınıp alınmamasıdır. Eksiksiz hizalamada şablonun D, p değerleri ve R_2'si pegas paketinin tajima.test ve R2.test işlevleriyle aynıdır (82.6.1).
S2. Tajima D'nin beta p değeri ne kadar güvenilir; neden benzetim kullanılmıyor?
Tajima (1989), D'nin dağılımının normalden çarpık olduğunu ve sınırlı bir aralıkta kaldığını gösterip beta dağılımını önermiştir. Yaklaşım orta büyüklükte n ve S için iyidir; çok küçük S'de D yalnız birkaç değer alabilir ve hiçbir sürekli yaklaşım tam değildir. Koalesan benzetimi daha doğru bir sıfır dağılımı verir. Şablon D için kapalı biçimli iki p değerini verir; sınırdaki bir sonuç benzetimle doğrulanmak isteniyorsa öteki testlerin benzetim p değerleri aynı yönü gösteriyor mu diye bakılır ya da benzetim ayrı bir araçla yapılır.
S3. Fs'nin p değeri neden alt kuyruktan ve neden 0,02 sınırı kullanılıyor?
F_s, haplotip fazlasını (genişleme, otostop) saptamak için tasarlanmıştır; ilgi alanı negatif uçtur ve p değeri "benzetimlerin ne kadarı gözlenenden küçük ya da ona eşit F_s verdi" sorusudur. F_s'nin sıfır dağılımı simetrik değildir ve S''nin kendisi bir olasılık olmasına karşın düzgün dağılmaz; Fu'nun (1997) benzetimlerine dayanılarak %5 anlamlılık düzeyi için 0{,}02 sınırı kullanılır; yaygın yazılımlar benzetim p değerini bu sınırla yorumlar (Excoffier ve Lischer, 2010). Raporda sınırın hangisi olduğu açıkça yazılır.
S4. Stirling sayıları neden logaritma ölçeğinde hesaplanıyor?
\lvert s(n,k)\rvert sayıları n! büyüklüğüne yaklaşır: n\approx170 dolayında çift duyarlıklı kayan nokta sınırını aşarlar. Ayrıca 1-S' doğrudan çıkarma ile hesaplanırsa S' 1'e çok yakınken bütün anlamlı basamaklar yiter. Şablon terimlerin logaritmalarını özyinelemeyle üretir ve \ln S' ile \ln(1-S')'yı iki ayrı toplamdan bulur; çıkarma yapılmaz. Chen ve Temme (2020) bu biçimin büyük n'de taşma ve iptal hatası içermediğini göstermiş, kesin değerleri tablo hâlinde yayımlamıştır; şablon n=2001'e kadar yedi değeri yedi ondalık basamak yeniden üretir. Özet kipinde n en çok 5000 olabilir.
S5. Benzetimde S'ye koşullamak ile θ'ya koşullamak arasındaki fark ne zaman önemlidir?
S koşullu benzetim her tekrarda tam gözlenen sayıda mutasyon yerleştirir; \theta koşullu benzetimde mutasyon sayısı Poisson dağılır ve \theta'nın kestirimine bağlıdır. İkisi S büyükken yakın sonuç verir (82.6, Adım 9). S küçükken (birkaç ayrışan konum) fark büyür: \theta koşullu benzetimde S=0 çıkan tekrarlar istatistiği tanımsız bırakır ve atılır, kalan tekrarlar gözlenenden farklı S değerleri içerir. Ramos-Onsins ve Rozas (2002) güç karşılaştırmalarını S koşullu yapmıştır; varsayılan bu yüzden S'dir.
S6. R2, Fs ve Tajima D aynı veride farklı sonuç verirse hangisine bakılır?
Üçü aynı sapmanın farklı yüzlerine bakar ve güçleri örneklem büyüklüğüne göre değişir. Ramos-Onsins ve Rozas'ın (2002) benzetimlerinde genişlemeye karşı küçük örneklemlerde R_2, büyük örneklemlerde F_s en güçlüdür; Tajima D ikisinden de zayıftır. Ramírez-Soriano ve ark. (2008) testlerin gücünün ve geçerliliğinin rekombinasyonla değiştiğini göstermiştir. Uygulamada önce veri yapısına uygun test seçilir, sonra bakılır; testlerin hepsi hesaplanıp anlamlı çıkan raporlanırsa çoklu karşılaştırma sorunu doğar.
S7. Uyumsuzluk dağılımında moment kestirimi ile en küçük kareler kestirimi neden bu kadar farklı?
Rogers'ın (1995) moment kestirimi \theta_1\to\infty varsayar ve yalnız ortalama ile varyansı kullanır: \hat\theta_0=\sqrt{v-m}. Dağılım modelin öngördüğü tek dalgadan sapıyorsa (çok tepe, sıfırda yığılma) varyans şişer ve fazlalık \theta_0'a yüklenir; \hat\tau=m-\hat\theta_0 küçülür. En küçük kareler bütün dağılımı kullanır ve dalganın tepesini izler. Örnek veride ikisi 7{,}0 ve 12{,}2'dir; bu büyüklükte bir ayrılık, modelin veriye uymadığının bağımsız bir işaretidir ve SSD testinin sonucuyla (p=0{,}02) tutarlıdır.
S8. Parametrik bootstrapta model her tekrarda neden yeniden uyduruluyor?
Gözlenen SSD, parametreler veriye uydurulduktan sonraki artıktır; en iyi uyan parametreler seçildiği için gerçek parametrelerdeki sapmadan küçüktür. Benzetilen veride SSD doğru parametrelerle (yeniden uydurmadan) hesaplansaydı sistematik olarak daha büyük çıkar ve p değeri yapay biçimde büyürdü. Her tekrarın yeniden uydurulması, gözlenen ile benzetilen istatistiğin aynı işlemden geçmesini sağlar (Schneider ve Excoffier, 1999). Bedeli süredir: bu adım şablonun en yavaş kısmıdır.
S9. Tekil mutasyon yokken D* ve F* neden hesaplanıyor da uyarıyla veriliyor?
Formüller \eta_s=0'da tanımlıdır: paylar \frac{n}{n-1}\eta ve \hat\theta_\pi'ye iner, paydalar değişmez. Sonuç her zaman pozitiftir ve mutasyon sayısıyla büyür; nötr modelde tekil mutasyonların beklenen sayısı \theta\,n/(n-1) olduğundan gerçek bir örneklemde hiç tekil bulunmaması olağanüstüdür. Değer bu yüzden bir test sonucu olarak değil, verinin bağımsız bireylerden oluşmadığının göstergesi olarak okunur. Şablon hesabı gizlemez, yorumu uyarıyla sınırlar.
82.10 Kaynaklar
- Chen, S., & Temme, N. M. (2020). A faster and more accurate algorithm for calculating population genetics statistics requiring sums of Stirling numbers of the first kind. G3 Genes|Genomes|Genetics, 10(11), 3959–3967. https://doi.org/10.1534/g3.120.401575
- Ewens, W. J. (1972). The sampling theory of selectively neutral alleles. Theoretical Population Biology, 3(1), 87–112. https://doi.org/10.1016/0040-5809(72)90035-4
- Excoffier, L., & Lischer, H. E. L. (2010). Arlequin suite ver 3.5: A new series of programs to perform population genetics analyses under Linux and Windows. Molecular Ecology Resources, 10(3), 564–567. https://doi.org/10.1111/j.1755-0998.2010.02847.x
- Fu, Y.-X. (1997). Statistical tests of neutrality of mutations against population growth, hitchhiking and background selection. Genetics, 147(2), 915–925. https://doi.org/10.1093/genetics/147.2.915
- Fu, Y.-X., & Li, W.-H. (1993). Statistical tests of neutrality of mutations. Genetics, 133(3), 693–709. https://doi.org/10.1093/genetics/133.3.693
- Harpending, H. C. (1994). Signature of ancient population growth in a low-resolution mitochondrial DNA mismatch distribution. Human Biology, 66(4), 591–600.
- Hudson, R. R. (1990). Gene genealogies and the coalescent process. Oxford Surveys in Evolutionary Biology, 7, 1–44.
- Michaux, J. R., Magnanou, E., Paradis, E., Nieberding, C., & Libois, R. (2003). Mitochondrial phylogeography of the Woodmouse (Apodemus sylvaticus) in the Western Palearctic region. Molecular Ecology, 12(3), 685–697. https://doi.org/10.1046/j.1365-294X.2003.01752.x
- Nei, M. (1987). Molecular evolutionary genetics. Columbia University Press. https://doi.org/10.7312/nei-92038
- Paradis, E. (2010). pegas: An R package for population genetics with an integrated–modular approach. Bioinformatics, 26(3), 419–420. https://doi.org/10.1093/bioinformatics/btp696
- Ramírez-Soriano, A., Ramos-Onsins, S. E., Rozas, J., Calafell, F., & Navarro, A. (2008). Statistical power analysis of neutrality tests under demographic expansions, contractions and bottlenecks with recombination. Genetics, 179(1), 555–567. https://doi.org/10.1534/genetics.107.083006
- Ramos-Onsins, S. E., & Rozas, J. (2002). Statistical properties of new neutrality tests against population growth. Molecular Biology and Evolution, 19(12), 2092–2100. https://doi.org/10.1093/oxfordjournals.molbev.a004034
- Rogers, A. R. (1995). Genetic evidence for a Pleistocene population explosion. Evolution, 49(4), 608–615. https://doi.org/10.1111/j.1558-5646.1995.tb02297.x
- Rogers, A. R., & Harpending, H. (1992). Population growth makes waves in the distribution of pairwise genetic differences. Molecular Biology and Evolution, 9(3), 552–569. https://doi.org/10.1093/oxfordjournals.molbev.a040727
- Schenekar, T., & Weiss, S. (2011). High rate of calculation errors in mismatch distribution analysis results in numerous false inferences of biological importance. Heredity, 107(6), 511–512. https://doi.org/10.1038/hdy.2011.48
- Schneider, S., & Excoffier, L. (1999). Estimation of past demographic parameters from the distribution of pairwise differences when the mutation rates vary among sites: Application to human mitochondrial DNA. Genetics, 152(3), 1079–1089. https://doi.org/10.1093/genetics/152.3.1079
- Simonsen, K. L., Churchill, G. A., & Aquadro, C. F. (1995). Properties of statistical tests of neutrality for DNA polymorphism data. Genetics, 141(1), 413–429. https://doi.org/10.1093/genetics/141.1.413
- Tajima, F. (1989). Statistical method for testing the neutral mutation hypothesis by DNA polymorphism. Genetics, 123(3), 585–595. https://doi.org/10.1093/genetics/123.3.585
- Watterson, G. A. (1975). On the number of segregating sites in genetical models without recombination. Theoretical Population Biology, 7(2), 256–276. https://doi.org/10.1016/0040-5809(75)90020-9