197. Doz-yanıt meta-analizi (Greenland–Longnecker, kısıtlı kübik spline)
Şablon kimliği: doz_yanit_meta · Kategori: meta_analiz · Dil: R · Dosya: pro/sablonlar/meta_analiz/doz_yanit_meta.R (satır 1–248; üstbilgi 1–106) · Örnek veri: _ornek/alcohol_crc.csv · Paketler: dosresmeta 2.2.0, Hmisc 5.3-0 (R 4.5.3)
197.1 Ne işe yarar
Gözlemsel çalışmalar bir maruziyeti (alkol, fiziksel etkinlik, besin, ilaç dozu) kategorilere ayırır ve her kategori için referans kategoriye göre bir göreli risk (RR) ya da olasılık oranı (OR) bildirir. Bu şablon bu kategori düzeyi sonuçlarından, çalışmalar arasında birleştirilmiş sürekli bir doz-yanıt eğrisi çıkarır: dozdaki her birimlik artışın log RR'yi ne kadar değiştirdiğini, ilişkinin doğrusal olup olmadığını ve seçilen dozlarda birleştirilmiş RR'yi verir. Yalnız en yüksek ile en düşük kategoriyi karşılaştıran bir meta-analizin aksine her kategorideki bilgiyi kullanır.
Bu ifadede i çalışma, j referans dışı kategori, x_{ij} kategorinin tipik dozu, x_{i0} çalışmanın referans dozu, \mathbf z(x) doz tabanıdır (log-doğrusalda x; ikinci derecede (x,x^2); kısıtlı kübik splinede x ve p-2 kübik terim, p düğüm sayısı). \boldsymbol\beta birleştirilmiş katsayı vektörü, \boldsymbol\Psi çalışmalar arası rastgele etki kovaryansıdır. Model kesişimsizdir: referans dozda log RR tanım gereği 0'dır.
Aynı çalışmanın RR'leri ortak referans kategoriyi paylaştığı için ilişkilidir; bu ilişki ihmal edilirse standart hatalar yanlış çıkar. Şablon bu kovaryansı her kategorideki vaka ve kişi-yıl (ya da denek) sayılarından yaklaşık hesaplar (Greenland ve Longnecker, 1992; Hamling ve ark., 2008) ve iki aşamalı yaklaşımı izler (Orsini ve ark., 2012; Crippa ve Orsini, 2016): her çalışmada genelleştirilmiş en küçük kareler (GLS), ardından çalışma katsayı vektörlerinin çok değişkenli birleştirilmesi. Seçenek olarak tek aşamalı yaklaşım (Crippa ve ark., 2019) vardır.
Ne zaman kullanılır?
- Her çalışma en az bir referans kategori ve en az bir referans dışı kategori için log RR (ya da log OR) ve standart hata bildiriyorsa ve doz-yanıt eğrisi soruluyorsa.
- Eğrinin biçimi önemliyse (eşik, J biçimi, doyma): kısıtlı kübik spline ve doğrusallıktan sapma testi bunu sorar.
Ne zaman kullanılmaz?
- Bütün çalışmalar yalnız iki grup karşılaştırıyorsa (tedavi–kontrol): tek bir etki büyüklüğü birleştirilir. Bu iş temel programdaki Meta-Analiz analizindedir.
- Birleştirilecek şey tek bir oran ya da prevalanssa:
oran_meta(Bölüm 198). - Birleştirilecek şey tanı testinin duyarlılığı ve özgüllüğüyse:
tanisal_meta(Bölüm 199). - Çalışma düzeyinde zaten bir eğim ve varyansı varsa ve başka ölçüt yoksa: yalnız bu eğimlerin birleştirilmesi
cok_degiskenli_meta(Bölüm 195) ile yapılabilir; bu şablonun kovaryans yaklaşımı gerekmez. - Bir çalışmada referans kategori yoksa (log RR = 0 ve boş SH satırı) ya da çalışma tek bir referans dışı kategoriye sahipse ve iki aşamalı yaklaşım seçiliyse: şablon durur (197.2).
- Ağ üzerinde birden çok tedavi karşılaştırılıyorsa:
ag_meta(Bölüm 194). Aynı çalışmadan birden çok etki büyüklüğü bağımlılığı çok düzeyli ise:cok_duzeyli_meta(Bölüm 196).
Temel programla ilişki. Temel programdaki Meta-Analiz analizi çalışma başına tek bir etki büyüklüğü ve standart hata ile çalışır; çalışma içi kovaryans ve doz-yanıt eğrisi yoktur. Bu şablon yalnız MerQuR+'ta vardır.
197.2 Şablonun girdileri
Form, üstbilgideki 13 [[param]] bloğundan kurulur (doz_yanit_meta.R:11–105). Türlerin ve ortak denetimin anlamı Bölüm 1.2'de anlatılmıştır.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
log göreli risk · logrr |
sayısal sütun · Değişkenler | yok | sayısal sütun | y; referans satırında 0 (12–14, 123). |
log RR standart hatası · se |
sayısal sütun · Değişkenler | yok | sayısal sütun; referans satırında boş | s (16–20, 123). |
Doz · doz |
sayısal sütun · Değişkenler | yok | sayısal sütun | x (21–25, 123). |
Çalışma kimliği · calisma |
kategorik sütun · Değişkenler | yok | herhangi sütun | Çalışma etiketi (26–30, 120). |
Vaka sayısı · vaka |
sayısal sütun · Değişkenler | yok | sayısal sütun, \ge 0 | A_{ij} (31–35, 124). |
Kişi-yıl ya da denek · n |
sayısal sütun · Değişkenler | yok | sayısal sütun, >0 | N_{ij} (36–40, 124). |
Çalışma deseni · tur |
seçim · Model | ir |
ir (kohort, kişi-yıl), ci (kohort, kümülatif insidans), cc (vaka-kontrol) |
Kovaryansın hücre yapısı (41–47, 121). |
Desen sütunu · tur_sutun |
kategorik sütun, zorunlu değil · Değişkenler | boş | sütunda yalnız ir, ci, cc |
Doluysa tur'un yerine çalışma bazında geçer (48–53, 114, 121–122). |
Doz-yanıt biçimi · bicim |
seçim · Model | rcs |
rcs (kısıtlı kübik spline), dogrusal, kuadratik |
Doz tabanı (54–60, 139–147). |
Spline düğüm sayısı · dugum |
tamsayı · Model | 4 | 3–5 | Düğümler yüzdeliklerde (61–68, 140–142). |
Kovaryans yaklaşımı · kovaryans |
seçim · Model | gl |
gl, h (Hamling), indep (köşegen) |
dosresmeta(covariance=) (69–75, 155). |
Birleştirme yöntemi · yontem |
seçim · Model | reml |
reml, ml, fixed, mm |
dosresmeta(method=) (76–82, 135, 155). |
Tahmin tablosu doz adımı · adim |
ondalık · Çıktı | 0 (otomatik) | \ge 0 | Tablo ızgarası (83–89, 193–196). |
Çözümleme yaklaşımı · asama |
seçim · Model | 2stage |
2stage, 1stage |
proc= (90–97, 151, 155). |
Güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | z_{\alpha/2} (98–105, 164). |
Şablona özgü denetimler (mq_hata ve notlar), sırasıyla:
- Veri açık değil (110). Altı sütun (
logrr,se,doz,calisma,vaka,n) farklı olmalı: "log RR, SH, doz, çalışma, vaka ve n için farklı sütunlar seçin." (113). - Satır silme:
sedışındaki sütunlardan biri eksik olan satır çözümlemeden çıkarılır; çıkarılan satır sayısı ve çalışmaları yazılır, en az 6 eksiksiz satır gerekir (116–122). logrr,se,doz,vaka,nsayısal olmalı (123); desen sütununda yalnızir,ci,cc(126); vaka negatif ya da n\le0 olamaz (129).- Her çalışmada tam bir referans satırı (log RR = 0 ve SH boş) olmalı; uymayan çalışmalar adlarıyla yazılır (131–132). Referans dışında en az bir kategori gerekir (iki aşamalıda, 133–134); standart hatalar pozitif (135); referans dışı satırda SH boşsa durur (136); Greenland–Longnecker ve Hamling kovaryansında referans dışı kategoride vaka sayısı 0 ise durur (137–139); en az 2 çalışma (141); doz sabit olamaz (142). İki aşamalıda her çalışmada K_i\ge q referans dışı kategori gerekir ve yetersiz çalışmalar adlarıyla yazılır (158–163).
- 3'ten az çalışma varsa birleştirme zorla sabit etkiliye çevrilir ve bu not yazılır (144).
- Spline düğümleri birbirinden ayrılmıyorsa (az sayıda farklı doz) hata (151). Tek aşamalı yaklaşım ile momentler yöntemi birlikte seçilemez (164).
- Paketin kendi hataları "Model kurulamadı: …" iletisiyle iletilir (169); bu iletiler paketin İngilizcesindedir (yukarıdaki ön denetimlerden geçen girdilerde görülmez).
- Kestirimler sonlu değilse "Kestirimler sonlu değil; model yakınsamadı." (178). Paket yakınsama uyarısı verirse (ya da nesne
converged = FALSEise) "UYARI: kestirim yakınsamadı" metni yazılır ve katsayı tablosunun başlığına "YAKINSAMADI" eklenir (173–176, 186).
Örnek ayar (ornek_param, 9. satır): logrr = logrr, se = se, doz = dose, calisma = id, vaka = cases, n = peryears, tur = ir, bicim = rcs, dugum = 4.
Tohum. Kestirim deterministiktir (hiçbir adımda rastgele sayı üretilmez); kod panelindeki Tohum alanı (Bölüm 1.3) sonucu değiştirmez.
197.3 Örnek veri
alcohol_crc.csv: Crippa ve Orsini (2016) vinyetinin alkol tüketimi ve kolorektal kanser verisi; dosresmeta paketinin alcohol_crc nesnesi. 8 çalışma, 48 satır (her çalışmada 1 referans ve 5 referans dışı kategori), eksik değer yalnız referans satırlarının se hücrelerindedir. Hepsi kohort ve insidans oranıdır (ir). Doz gram/gündür; 38 farklı değer, ortalama 20,80, 0–60,6 aralığı.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
id |
çalışma | kategorik | 8 düzey: atm, hpm, io, n1, n2, nt, ntm, nym (ilk görülme sırası) |
type |
desen | kategorik | hepsi ir; örnek ayarda kullanılmaz (tur_sutun boş) |
dose |
doz | sayısal | 0–60,6; 8 referans satırında 0 |
cases |
vaka | sayısal | 4–446 (çalışma toplamı 184–796) |
peryears |
kişi-yıl | sayısal | 100–234 830 (çalışma toplamı: nt 10 974 ve ntm 10 661, öbürleri 203 364–659 494) |
logrr |
log RR | sayısal | referans 0; en küçük −0,7363, en büyük 0,8808 |
se |
SH | sayısal | 0,0867–0,5260; referans satırında boş |
Çalışma toplam vakaları: atm 184, hpm 408, io 796, n1 220, n2 420, nt 484, ntm 642, nym 492. Düzey sırası bu şablonda sonuç üretmez: çalışma kimliği yalnız gruplama içindir (124). Doz, vaka, kişi-yıl, log RR ve SH sayısal rollerdir; veri sekmesinde "kategorik" türde gelseler bile sayı olarak aktarılırlar (Bölüm 1.3).
Bölümde kullanılan çalıştırmalar:
| Ad | Ayar |
|---|---|
ornek |
örnek ayar (spline, 4 düğüm, REML) |
dogrusal, kuadratik, dugum3, dugum5 |
bicim / dugum |
fixed, ml, mm |
yontem |
indep, hamling |
kovaryans = indep, h |
1stage |
asama = 1stage |
g90 |
guven = 0,9, adim = 10 |
e_* |
uç durumlar (197.8) |
197.4 Yöntem: formüller ve hesap adımları
Hesap sırası: satırlar çalışma ve doza göre dizilir (130); doz tabanı kurulur (146–157); her çalışmada log RR vektörünün kovaryans matrisi Greenland–Longnecker (ya da Hamling) yaklaşımıyla kurulur ve GLS ile çalışma katsayı vektörü \hat{\boldsymbol\beta}_i bulunur; çalışma vektörleri çok değişkenli rastgele etkiler modeliyle birleştirilir; Wald ve Cochran sınamaları ile tahmin tablosu yazılır. Birinci ve ikinci aşama dosresmeta::dosresmeta içindedir (167–170); şablon tabanı, çıktıları ve tabloları kurar.
197.4.1 Doz tabanı
Log-doğrusal: \mathbf z(x)=(x). İkinci derece: \mathbf z(x)=(x,x^2). Kısıtlı kübik spline (p düğüm t_1<\dots<t_p): \mathbf z(x)=\bigl(x,\ s_1(x),\dots,s_{p-2}(x)\bigr),
Bu ifadede t_j düğümlerdir; spline t_1'in solunda ve t_p'nin sağında doğrusaldır (kısıtlama), arada kübiktir. Payda (t_p-t_1)^2, tabanı ölçekten bağımsız kılar (Hmisc rcspline.eval varsayılanı norm = 2; Harrell, 2015). Katsayılar bu yüzden dose, dose', dose'' adlarını taşır: ilki doğrusal terim, ötekiler kübik terimlerdir.
Neden düğümler yüzdeliklerde?
Düğüm yerleşimi doz dağılımına uyar: veri nerede yoğunsa esneklik orada olur. Şablon düğümleri bütün satırların (referans satırları dahil) dozlarının yüzdeliklerine koyar: 3 düğümde %10, 50, 90; 4 düğümde %5, 35, 65, 95; 5 düğümde %5, 27,5, 50, 72,5, 95 (141–142; R'nin 7 numaralı yüzdelik tanımı). Örnek veride 48 satırın 8'i sıfır doz olduğundan 4 düğüm 0;\ 8{,}8696;\ 22{,}8314;\ 58{,}4167 olur: ilk düğüm referans dozun üstüne düşer. 3 düğümde 0;\ 14{,}25;\ 57{,}18, 5 düğümde 0;\ 1{,}8265;\ 14{,}25;\ 35{,}6767;\ 58{,}4167.
Koddaki tercih
Hmisc::rcspline.eval(x, knots = dugumler, inclx = TRUE) (152): inclx = TRUE ile ilk sütun x'in kendisidir. Sütunlar s1… adlarıyla veri çerçevesine eklenir (157) ve formül .y ~ s1 + s2 + … olur (163). Kesişim terimi formülde vardır ama dosresmeta kesişimsiz kestirir; model kesişimsizdir.
197.4.2 Çalışma içi kovaryans: Greenland–Longnecker
Bir çalışmada K+1 kategori (biri referans) varsa log RR'ler \hat y_j=\log(\mathrm{RR}_j), j=1,\dots,K, birbirleriyle ilişkilidir çünkü hepsi aynı referans kategoriye göre hesaplanmıştır. Bildirilen RR'ler ve vaka toplamı korunarak uydurulmuş vaka sayıları A'_0,A'_1,\dots,A'_K bulunur (Greenland ve Longnecker, 1992): \sum_j A'_j=\sum_j A_j ve \log\bigl(\tfrac{A'_j/N_j}{A'_0/N_0}\bigr)=\hat y_j (ir için; öbür desenlerde denklem olasılık oranı biçimindedir: \log\tfrac{A'_j\,(N_0-A'_0)}{(N_j-A'_j)\,A'_0}=\hat y_j). Çözüm sabit nokta yinelemesiyle bulunur:
Bu ifadede ir'de c_j=1/A'_j (c_0=1/A'_0), kümülatif insidansta ve vaka-kontrolde c_j=1/A'_j+1/(N_j-A'_j) ve e_j=\hat y_j+\log\frac{A'_0\,(N_j-A'_j)}{A'_j\,(N_0-A'_0)}. A'_0=\sum_jA_j-\sum_{j\ge1}A'_j her adımda yeniden hesaplanır. Başlangıç değeri bildirilen vakalardır. Kovaryans matrisinin köşegeni bildirilen \mathrm{SH}_j^2, köşegen dışı terimleri
olur. Kümülatif insidansta s_0=1/A'_0-1/N_0, s_j=s_0+1/A'_j-1/N_j; vaka-kontrolde s_0=1/A'_0+1/(N_0-A'_0), s_j=s_0+1/A'_j+1/(N_j-A'_j) (dosresmeta::covar.logrr).
Neden uydurulmuş sayılar?
Yayınlarda genellikle yalnız RR ve güven aralığı vardır; referans kategorinin belirsizliği (kovaryansın ortak kaynağı) açıkça bildirilmez. Uydurulmuş vaka sayıları, bildirilen RR ve vaka toplamıyla uyumlu bir tabloyu yeniden kurar ve ortak kaynağın büyüklüğünü (1/A'_0) bu tablodan alır. Örnekte atm çalışması: bildirilen vakalar 28, 38, 43, 32, 16, 27; uydurulmuş 26,5973; 34,0061; 42,8531; 33,3584; 17,9492; 29,2359 (toplam 184 korunur). Ortak kaynak 1/A'_0=0{,}037598; ilk ve ikinci kategorinin kovaryansı 0{,}036287, SH² değerleri 0{,}06305 ve 0{,}06032.
Koddaki tercih
covariance = P$kovaryans (168): gl yukarıdaki yinelemedir, h Hamling ve ark. (2008) yaklaşımıdır (en iyileme ile uydurulmuş sayılar), indep kovaryansı sıfır alır ve köşegen bırakır. Yineleme dosresmeta içinde \sum(\Delta A')^2<10^{-5} eşiğinde durur (grl, tol = 1e-05).
Bağımsız varsayım sonucu değiştirir
Aynı veride kovaryansı yok saymak (indep) birleştirilmiş katsayıları ve model \chi^2'sini belirgin biçimde değiştirir: spline katsayıları -0{,}0140;\ 0{,}1507;\ -0{,}2535 (gl: -0{,}0097;\ 0{,}1274;\ -0{,}2144), model \chi^2=16{,}32 (gl: 28{,}36), doğrusallıktan sapma p=0{,}020 (gl: 0{,}078). İlişkili RR'leri bağımsız saymak GLS'in ağırlıklarını ve SH'leri bozar.
197.4.3 Birinci aşama: çalışma içi GLS
Çalışma i için referans dışı satırlar \mathbf y_i (K_i uzunluğunda), tasarım matrisi \mathbf X_i (K_i\times q; satır j için \mathbf z(x_{ij})-\mathbf z(x_{i0}), yani doz tabanı referans dozdan merkezlenmiştir) ve kovaryans \mathbf S_i ile
Bu ifadede q doz tabanının sütun sayısıdır (1, 2 ya da p-1). İki aşamalı yaklaşım için her çalışmada K_i\ge q referans dışı kategori gerekir; aksi hâlde paket "A two-stage approach requires that each study provides at least p non-referent obs" iletisiyle durur. Şablon bu koşulu denetler (158–163).
Log-doğrusal modelde (q=1) çalışma eğimleri ve SH'leri: atm 0{,}007141 (0{,}003912), hpm 0{,}009169 (0{,}003044), io 0{,}002359 (0{,}004106), n1 -0{,}002125 (0{,}006536), n2 0{,}004906 (0{,}004072), nt 0{,}012631 (0{,}005995), ntm 0{,}006132 (0{,}003314), nym 0{,}006880 (0{,}002990).
197.4.4 İkinci aşama: çok değişkenli birleştirme
Çalışma vektörleri \hat{\boldsymbol\beta}_i\sim N(\boldsymbol\beta,\ \mathbf V_i+\boldsymbol\Psi) ile birleştirilir; \mathbf V_i birinci aşamadaki kovaryanstır. Sabit etkilide \boldsymbol\Psi=\mathbf 0 ve
Rastgele etkilide \boldsymbol\Psi yapısız (tam) bir kovaryans matrisidir ve REML ya da ML ile kestirilir; \hat{\boldsymbol\beta} aynı formül, ama \mathbf V_i yerine \mathbf V_i+\hat{\boldsymbol\Psi} ile bulunur. REML log-olabilirliği (dosresmeta'nın kullandığı mixmeta/metafor sabitiyle)
Bu ifadede Q_\Psi=\sum_i(\hat{\boldsymbol\beta}_i-\hat{\boldsymbol\beta})^{\top}(\mathbf V_i+\boldsymbol\Psi)^{-1}(\hat{\boldsymbol\beta}_i-\hat{\boldsymbol\beta}), k çalışma sayısı, N=kq ikinci aşamadaki değer sayısıdır. ML'de \log|\sum_i(\mathbf V_i+\boldsymbol\Psi)^{-1}| ve \tfrac q2\log k terimleri yoktur, sabit -\tfrac N2\log2\pi'dir. AIC ve BIC, serbest parametre sayısı \mathrm{par}=q+q(q+1)/2 ile -2\ell+2\,\mathrm{par} ve -2\ell+\mathrm{par}\log N^*'dir (N^*=N-q REML'de, N ML'de). Momentler yöntemi (mm) olabilirlik kullanmaz; log-olabilirlik, AIC ve BIC boş kalır.
Neden çok değişkenli?
Aynı çalışmanın q katsayısı birbirine bağlıdır (örneğin \beta_1 ile \beta_2 spline tabanının yapısından dolayı güçlü ters ilişkilidir). Katsayıları ayrı ayrı birleştirmek bu ilişkiyi atar ve eğrinin güven bandını yanlış verir.
197.4.5 Testler, heterojenlik ve tahmin tablosu
Model \chi^2: \hat{\boldsymbol\beta}^{\top}\mathrm{Var}(\hat{\boldsymbol\beta})^{-1}\hat{\boldsymbol\beta}, q sd (188–189). Doğrusallıktan sapma: spline ya da ikinci derece terimlerin tümünün sıfır olduğunu sınayan Wald testi, \hat{\boldsymbol\beta}_{2:q}^{\top}\mathrm{Var}_{2:q,2:q}^{-1}\hat{\boldsymbol\beta}_{2:q}, q-1 sd (200–203). Cochran Q: sabit etkili birleştirmeye göre
Bu ifadede \hat{\boldsymbol\beta}_F sabit etkili çözümdür; Q rastgele etkili model seçilse de sabit etkili çözüme göre hesaplanır. I^2 şablonda Q sonlu ve pozitifse \max\{0,(Q-sd)/Q\}\times100 olarak hesaplanır; Q=0 ise 0, Q hesaplanmamışsa (tek aşamalı yaklaşımda Q yoktur) tanımsızdır (NA) ve bu bir notla bildirilir (193, 205–207).
Tahmin tablosu. Referans doz x_{\mathrm{ref}}=\min(\text{doz}) (218), ızgara x_{\mathrm{ref}},\ x_{\mathrm{ref}}+h,\dots,\max(\text{doz}) ve h = adim; adim = 0 ise h=\mathrm{signif}\bigl((\max-\min)/5,\,2\bigr) (226). Her x için \mathbf d=\mathbf z(x)-\mathbf z(x_{\mathrm{ref}}),
Koddaki tercih
z_{\alpha/2}: güven 0,95 ise 1,96, değilse qnorm((1 + guven)/2) (181). Katsayı tablosunun p değerleri 2\Phi(-|z|)'dir (184); düzeltme yoktur, her katsayı ayrı sınanır.
197.4.6 Tek aşamalı yaklaşım
asama = 1stage (164, 168): bütün çalışmalar tek bir doğrusal karma modelde kestirilir (Crippa ve ark., 2019). Referans dışı yalnız bir kategorisi olan çalışmalar da kullanılabilir. Q, tek aşamalı modelde sabit etkili birinci aşama çözümü olmadığından üretilmez; momentler yöntemi bu yaklaşımla kullanılamaz. Örnek veride tek aşamalı çözüm kestirimleri -0{,}0092;\ 0{,}1202;\ -0{,}2008 (iki aşamalı REML: -0{,}0097;\ 0{,}1274;\ -0{,}2144) ve log-olabilirlik -2{,}65'tir; paket "convergence not reached after maximum number of iterations" uyarısını verir; şablon bunu "UYARI: kestirim yakınsamadı" ve tablo başlığında "YAKINSAMADI" ile bildirir.
197.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 107–111 | .m iki dilli ileti yardımcısı; dosresmeta yüklenir; veri ve bos yardımcısı. |
Hmisc taban içinde :: ile çağrılır (152), yüklenmeden de çalışır. |
| 112–122 | Sütun adlarının farklılığı; tur_sutun'la veri alt kümesi; se dışı eksikleri at; en az 6 satır. |
Referans satırları se boş olduğundan eksik sayılmaz; atılan satır sayısı ve çalışmaları yazılır. |
| 123–129 | Sayısal tür, desen, vaka ve n denetimi. | tur_sutun doluysa değer kümesi ir/ci/cc ile sınırlıdır. |
| 130–142 | Çalışma ve doza göre sıralama; referans satırı sayımı; kategori sayısı, SH pozitifliği, çalışma sayısı, doz değişkenliği. | Aynı dozlu iki satır sessizce kabul edilir. |
| 143–144 | Yöntem; 3'ten az çalışmada sabit etkiliye geçiş. | Geçişin notu mq_metin ile yazılır. |
| 146–163 | Doz tabanı (rcs, kuadratik, dogrusal), s1… sütunları ve formül. |
Düğümler ayrışmıyorsa hata (151). |
| 164–178 | Tek aşamalı + mm denetimi; dosresmeta çağrısı; uyarıların toplanması; summary ve print; sonlu kestirim denetimi. |
Paket uyarıları metin olarak "Uyarılar:" satırında sonda verilir (240); yakınsama durumu okunur ve yakınsamadıysa uyarı yazılır (173–176). |
| 179–186 | Katsayı tablosu: kestirim, SH, z, p, GA. | Terim adları doz, doz', doz''; ikinci derecede doz, doz^2 (182–183). |
| 188–204 | Model testleri, Q, I^2, log-olabilirlik, AIC, BIC, doğrusallıktan sapma. | Sabit etkilide log-olabilirlik boş (194, 198). |
| 208–217 | Rastgele etki SD'leri metni. | SD'ler \sqrt{\max(\mathrm{diag}\,\Psi,0)}; \Psi sınırdaysa ( |
| 218–240 | Tahmin ızgarası ve tablo; uyarı metni. | Referans doz bütün verinin en küçük dozudur; çalışmaların referansları farklıysa not yazılır (221–225); ızgara 1000 satırı aşmaz (227–231). |
| 241–247 | RR eğrisi ve güven bandı; y ekseni logaritmik; rug çizgisi. | Şekil tek panel. |
Çıktı tabloları: Doz-yanıt katsayıları; Model testleri, heterojenlik ve uyum; Birleştirilmiş göreli risk. Bir şekil.
197.6 Elle hesap: örnek veride bağımsız yeniden hesap
Doğrulama dosresmeta, mixmeta ve Hmisc kullanılmadan yapılmıştır: dogrulama/doz_yanit_meta/elle_hesap.py (numpy/scipy; spline tabanı, Greenland–Longnecker yinelemesi, GLS, çok değişkenli REML) ve r_dogrulama.R (taban R ile aynı adımlar ve ikinci aşamada metafor::rma.mv, yapısız kovaryans). Bağımsız hesap yinelemeyi 10^{-12}'ye kadar sürdürür; dosresmeta 10^{-5}'te durur.
Adım 1 — Düğümler ve taban. 4 düğüm: 0;\ 8{,}869640;\ 22{,}831404;\ 58{,}416706. Doz 22{,}8571 için s_1=22{,}8571, s_2=3{,}499365, s_3=0{,}801941.
Adım 2 — Uydurulmuş sayılar ve kovaryans. atm çalışması için 197.4.2'deki değerler; yineleme 6 kategoride toplam vakayı (202) 2\times10^{-6} içinde korur.
Adım 3 — Birinci aşama. Log-doğrusal modelde sekiz çalışma eğimi 197.4.3'tedir. Spline modelde atm: \hat{\boldsymbol\beta}=(-0{,}03381;\ 0{,}2086;\ -0{,}30673), SH (0{,}0304;\ 0{,}2890;\ 0{,}5250).
Adım 4 — Sabit etkili birleştirme. Log-doğrusal: eğim 0{,}006438 (SH 0{,}001352), z=4{,}7614, Q=4{,}7798 (7 sd, p=0{,}687). Rastgele etkili REML çözümü sınırdadır (\hat\tau^2\approx0), eğim aynıdır ve \ell_R=29{,}6176. Spline: sabit etkili \hat{\boldsymbol\beta}=(-0{,}007839;\ 0{,}113246;\ -0{,}190427), SH (0{,}006996;\ 0{,}075163;\ 0{,}140311), Q=20{,}5628 (21 sd).
Adım 5 — REML. Çok değişkenli REML (Cholesky parametrizasyonuyla en küçük -2\ell_R): \hat{\boldsymbol\beta}=(-0{,}009730;\ 0{,}127396;\ -0{,}214400); \mathrm{Var}(\hat{\boldsymbol\beta}) köşegeni (6{,}645\cdot10^{-5};\ 6{,}537\cdot10^{-3};\ 2{,}215\cdot10^{-2}); \chi^2_{\mathrm{model}}=28{,}3635, doğrusallıktan sapma \chi^2=5{,}0900 (2 sd); \ell_R=43{,}0661, AIC =-68{,}1323, BIC =-58{,}7316. \hat{\boldsymbol\Psi} sınır çözümüdür: köşegen (1{,}25\cdot10^{-4};\ 6{,}03\cdot10^{-3};\ 1{,}62\cdot10^{-2}) ve korelasyonlar \pm1 (rank 1).
Adım 6 — Tahmin. Doz 36 için taban farkı \mathbf d=(36;\ 12{,}5735;\ 4{,}9201) ve \mathbf d^{\top}\hat{\boldsymbol\beta}'dan \widehat{\mathrm{RR}}=1{,}2173, \mathrm{SH}(\log\mathrm{RR})=0{,}0659.
Adım 7 — Yayımlanmış değerlerle karşılaştırma. Crippa ve Orsini (2016) log-doğrusal model: eğim 0{,}0064 (SH 0{,}0014), Q=4{,}7797, \ell_R=29{,}6176; spline: -0{,}0097;\ 0{,}1274;\ -0{,}2144, \chi^2=28{,}3632, Q=20{,}5624, doğrusallıktan sapma \chi^2=5{,}1. Hepsi şablonun çıktısıyla örtüşür (197.7).
197.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| katsayı 1, kısıtlı kübik spline, 4 düğüm, REML | −0,00972965 | −0,00973006 | −0,00973005 | 4,1e−7 | ✓ |
| SH 1, kısıtlı kübik spline, 4 düğüm, REML | 0,00815084 | 0,00815141 | 0,0081514 | 5,7e−7 | ✓ |
| katsayı 2, kısıtlı kübik spline, 4 düğüm, REML | 0,1273927 | 0,12739638 | 0,12739632 | 3,7e−6 | ✓ |
| SH 2, kısıtlı kübik spline, 4 düğüm, REML | 0,0808469 | 0,08085 | 0,08084997 | 3,1e−6 | ✓ |
| katsayı 3, kısıtlı kübik spline, 4 düğüm, REML | −0,21439352 | −0,2144002 | −0,21440009 | 6,7e−6 | ✓ |
| SH 3, kısıtlı kübik spline, 4 düğüm, REML | 0,14881238 | 0,14881718 | 0,14881714 | 4,8e−6 | ✓ |
| Q, kısıtlı kübik spline, 4 düğüm, REML | 20,56243253 | 20,56276634 | 20,56276631 | 1,6e−5 | ✓ |
| I² (%), kısıtlı kübik spline, 4 düğüm, REML | 0 | 0 | 0 | 0 | ✓ |
| χ² (model), kısıtlı kübik spline, 4 düğüm, REML | 28,36317491 | 28,36348986 | — | 1,1e−5 | ✓ |
| χ² (doğrusal olmama), kısıtlı kübik spline, 4 düğüm, REML | 5,09054993 | 5,0900307 | — | 1,0e−4 | ✓ |
| logLik, kısıtlı kübik spline, 4 düğüm, REML | 43,06621961 | 43,06614558 | 43,06614563 | 1,7e−6 | ✓ |
| AIC, kısıtlı kübik spline, 4 düğüm, REML | −68,13243922 | −68,13229116 | — | 2,2e−6 | ✓ |
| BIC, kısıtlı kübik spline, 4 düğüm, REML | −58,73173728 | −58,73158922 | — | 2,5e−6 | ✓ |
| katsayı 1, log-doğrusal, REML | 0,00643754 | 0,00643755 | 0,00643755 | 1,4e−8 | ✓ |
| SH 1, log-doğrusal, REML | 0,00135204 | 0,00135204 | 0,00135204 | 2,8e−9 | ✓ |
| Q, log-doğrusal, REML | 4,77972797 | 4,7797712 | 4,77977122 | 9,0e−6 | ✓ |
| I² (%), log-doğrusal, REML | 0 | 0 | 0 | 0 | ✓ |
| χ² (model), log-doğrusal, REML | 22,67039749 | 22,67058942 | — | 8,5e−6 | ✓ |
| logLik, log-doğrusal, REML | 29,61762183 | 29,61760368 | 29,61760368 | 6,1e−7 | ✓ |
| AIC, log-doğrusal, REML | −55,23524367 | −55,23520736 | — | 6,6e−7 | ✓ |
| BIC, log-doğrusal, REML | −55,34342337 | −55,34338706 | — | 6,6e−7 | ✓ |
| katsayı 1, ikinci dereceden, REML | −0,00156829 | −0,00156819 | −0,00156819 | 9,2e−8 | ✓ |
| SH 1, ikinci dereceden, REML | 0,00430063 | 0,00430069 | 0,00430069 | 5,9e−8 | ✓ |
| katsayı 2, ikinci dereceden, REML | 1,635786·10−4 | 1,635768·10−4 | 1,635768·10−4 | 1,8e−9 | ✓ |
| SH 2, ikinci dereceden, REML | 8,186157·10−5 | 8,186246·10−5 | 8,186245·10−5 | 8,9e−10 | ✓ |
| Q, ikinci dereceden, REML | 14,21652623 | 14,216796 | 14,21679596 | 1,9e−5 | ✓ |
| I² (%), ikinci dereceden, REML | 1,52306004 | 1,5249287 | 1,5249284 | 1,2e−3 | ✓ |
| χ² (model), ikinci dereceden, REML | 26,85340196 | 26,85344382 | — | 1,6e−6 | ✓ |
| χ² (doğrusal olmama), ikinci dereceden, REML | 3,99294167 | 3,99276658 | — | 4,4e−5 | ✓ |
| logLik, ikinci dereceden, REML | 77,06346213 | 77,06336898 | 77,06336903 | 1,2e−6 | ✓ |
| AIC, ikinci dereceden, REML | −144,12692426 | −144,12673796 | — | 1,3e−6 | ✓ |
| BIC, ikinci dereceden, REML | −140,93163761 | −140,93145131 | — | 1,3e−6 | ✓ |
| katsayı 1, spline, 3 düğüm, REML | −0,00136589 | −0,00136581 | −0,00136582 | 8,0e−8 | ✓ |
| SH 1, spline, 3 düğüm, REML | 0,00414249 | 0,00414255 | 0,00414256 | 6,2e−8 | ✓ |
| katsayı 2, spline, 3 düğüm, REML | 0,02097457 | 0,02097436 | 0,02097437 | 2,1e−7 | ✓ |
| SH 2, spline, 3 düğüm, REML | 0,01025842 | 0,01025854 | 0,01025854 | 1,2e−7 | ✓ |
| Q, spline, 3 düğüm, REML | 14,58830843 | 14,58860672 | 14,58860667 | 2,0e−5 | ✓ |
| I² (%), spline, 3 düğüm, REML | 4,03273921 | 4,03470137 | 4,03470108 | 4,9e−4 | ✓ |
| χ² (model), spline, 3 düğüm, REML | 27,2269569 | 27,22701061 | — | 2,0e−6 | ✓ |
| χ² (doğrusal olmama), spline, 3 düğüm, REML | 4,1804685 | 4,18029353 | — | 4,2e−5 | ✓ |
| logLik, spline, 3 düğüm, REML | 43,50967834 | 43,50958506 | 43,50958511 | 2,1e−6 | ✓ |
| AIC, spline, 3 düğüm, REML | −77,01935667 | −77,01917013 | — | 2,4e−6 | ✓ |
| BIC, spline, 3 düğüm, REML | −73,82407003 | −73,82388348 | — | 2,5e−6 | ✓ |
| katsayı 1, spline, 4 düğüm, sabit etkili | −0,00783901 | −0,00783869 | −0,00783869 | 3,1e−7 | ✓ |
| SH 1, spline, 4 düğüm, sabit etkili | 0,00699649 | 0,00699646 | 0,00699646 | 3,0e−8 | ✓ |
| katsayı 2, spline, 4 düğüm, sabit etkili | 0,11324813 | 0,11324622 | 0,11324622 | 1,9e−6 | ✓ |
| SH 2, spline, 4 düğüm, sabit etkili | 0,07516331 | 0,07516301 | 0,07516301 | 3,0e−7 | ✓ |
| katsayı 3, spline, 4 düğüm, sabit etkili | −0,19042946 | −0,1904265 | −0,1904265 | 3,0e−6 | ✓ |
| SH 3, spline, 4 düğüm, sabit etkili | 0,14031177 | 0,14031122 | 0,14031122 | 5,5e−7 | ✓ |
| Q, spline, 4 düğüm, sabit etkili | 20,56243253 | 20,56276634 | 20,56276631 | 1,6e−5 | ✓ |
| I² (%), spline, 4 düğüm, sabit etkili | 0 | 0 | 0 | 0 | ✓ |
| χ² (model), spline, 4 düğüm, sabit etkili | 28,81918843 | 28,81913121 | — | 2,0e−6 | ✓ |
| χ² (doğrusal olmama), spline, 4 düğüm, sabit etkili | 6,14879094 | 6,14854179 | — | 4,1e−5 | ✓ |
| katsayı 1, spline, 4 düğüm, ML | −0,00916976 | −0,00916967 | −0,00916967 | 9,3e−8 | ✓ |
| SH 1, spline, 4 düğüm, ML | 0,00775606 | 0,00775614 | 0,00775614 | 8,2e−8 | ✓ |
| katsayı 2, spline, 4 düğüm, ML | 0,1232207 | 0,12322039 | 0,1232204 | 3,1e−7 | ✓ |
| SH 2, spline, 4 düğüm, ML | 0,07901455 | 0,07901486 | 0,07901487 | 3,2e−7 | ✓ |
| katsayı 3, spline, 4 düğüm, ML | −0,20731902 | −0,20731873 | −0,20731876 | 2,9e−7 | ✓ |
| SH 3, spline, 4 düğüm, ML | 0,14612676 | 0,14612716 | 0,14612718 | 4,2e−7 | ✓ |
| Q, spline, 4 düğüm, ML | 20,56243253 | 20,56276634 | 20,56276631 | 1,6e−5 | ✓ |
| I² (%), spline, 4 düğüm, ML | 0 | 0 | 0 | 0 | ✓ |
| χ² (model), spline, 4 düğüm, ML | 28,51333646 | 28,51336777 | — | 1,1e−6 | ✓ |
| χ² (doğrusal olmama), spline, 4 düğüm, ML | 5,47054635 | 5,47031448 | — | 4,2e−5 | ✓ |
| logLik, spline, 4 düğüm, ML | 50,7604135 | 50,76033172 | 50,76033178 | 1,6e−6 | ✓ |
| AIC, spline, 4 düğüm, ML | −83,52082701 | −83,52066344 | — | 2,0e−6 | ✓ |
| BIC, spline, 4 düğüm, ML | −72,91834253 | −72,91817897 | — | 2,2e−6 | ✓ |
| katsayı 1, spline, 4 düğüm, bağımsız kovaryans, REML | −0,01395406 | −0,01395406 | −0,01395406 | 5,4e−10 | ✓ |
| SH 1, spline, 4 düğüm, bağımsız kovaryans, REML | 0,00765448 | 0,00765447 | 0,00765448 | 5,7e−10 | ✓ |
| katsayı 2, spline, 4 düğüm, bağımsız kovaryans, REML | 0,15068355 | 0,15068356 | 0,15068358 | 2,9e−8 | ✓ |
| SH 2, spline, 4 düğüm, bağımsız kovaryans, REML | 0,08941941 | 0,08941941 | 0,08941941 | 3,6e−9 | ✓ |
| katsayı 3, spline, 4 düğüm, bağımsız kovaryans, REML | −0,2535383 | −0,25353832 | −0,25353836 | 6,4e−8 | ✓ |
| SH 3, spline, 4 düğüm, bağımsız kovaryans, REML | 0,16893494 | 0,16893494 | 0,16893493 | 1,5e−8 | ✓ |
| Q, spline, 4 düğüm, bağımsız kovaryans, REML | 19,50112334 | 19,50112334 | 19,50112334 | 6,2e−14 | ✓ |
| I² (%), spline, 4 düğüm, bağımsız kovaryans, REML | 0 | 0 | 0 | 0 | ✓ |
| χ² (model), spline, 4 düğüm, bağımsız kovaryans, REML | 16,31621957 | 16,31622057 | — | 6,1e−8 | ✓ |
| χ² (doğrusal olmama), spline, 4 düğüm, bağımsız kovaryans, REML | 7,82834759 | 7,82834784 | — | 3,1e−8 | ✓ |
| logLik, spline, 4 düğüm, bağımsız kovaryans, REML | 42,02791913 | 42,02791913 | 42,02791913 | 8,5e−13 | ✓ |
| AIC, spline, 4 düğüm, bağımsız kovaryans, REML | −66,05583825 | −66,05583825 | — | 4,4e−14 | ✓ |
| BIC, spline, 4 düğüm, bağımsız kovaryans, REML | −56,65513632 | −56,65513632 | — | 4,9e−14 | ✓ |
| RR, doz 12, ornek (%95) | 0,94726644 | 0,94726344 | — | 3,0e−6 | ✓ |
| RR alt sınır, doz 12, ornek (%95) | 0,83735212 | 0,83734102 | — | 1,1e−5 | ✓ |
| RR üst sınır, doz 12, ornek (%95) | 1,07160856 | 1,07161599 | — | 6,9e−6 | ✓ |
| RR, doz 60, ornek (%95) | 1,53221989 | 1,53221311 | — | 4,4e−6 | ✓ |
| RR alt sınır, doz 60, ornek (%95) | 1,25102361 | 1,25101942 | — | 3,3e−6 | ✓ |
| RR üst sınır, doz 60, ornek (%95) | 1,8766215 | 1,87661116 | — | 5,5e−6 | ✓ |
| RR, doz 10, güven %90, adım 10 | 0,94171164 | 0,94170876 | — | 2,9e−6 | ✓ |
| RR alt sınır, doz 10, güven %90, adım 10 | 0,85277232 | 0,85276308 | — | 9,2e−6 | ✓ |
| RR üst sınır, doz 10, güven %90, adım 10 | 1,03992684 | 1,03993174 | — | 4,7e−6 | ✓ |
| RR, doz 60, güven %90, adım 10 | 1,53221989 | 1,53221311 | — | 4,4e−6 | ✓ |
| RR alt sınır, doz 60, güven %90, adım 10 | 1,29248012 | 1,29247557 | — | 3,5e−6 | ✓ |
| RR üst sınır, doz 60, güven %90, adım 10 | 1,81642855 | 1,81641886 | — | 5,3e−6 | ✓ |
Ölçütü karşılayan: 91/91. Ölçüt: göreli fark ≤ 10⁻⁴ (I² için 5·10⁻³, doğrusal olmama χ² için 2·10⁻⁴; Greenland-Longnecker yinelemesinin dosresmeta'daki 10⁻⁵ eşiği ve çalışmalar arası kovaryansın sınır çözümünün düz olabilirliği nedeniyle). Yayımlanmış değerler (log-doğrusal eğim 0,0064 [SH 0,0014], Q = 4,7797, logLik 29,6176; spline Q = 20,5624, χ² = 28,3632) bölüm 197.6'da ayrıca verilmiştir.
Q ve katsayılardaki 10^{-5} mertebesindeki farklar dosresmeta'nın yineleme eşiğindendir (bağımsız hesap yinelemeyi sonuna kadar sürdürür). Rastgele etki kovaryansı \hat{\boldsymbol\Psi} sınırda olduğunda olabilirlik düzdür; bu yüzden \hat{\boldsymbol\Psi}'nin kendisi doğrulama tablosuna alınmamıştır, katsayılar, SH'ler ve olabilirlik üç yolda örtüşür. 5 düğümlü model (\ell_R=30{,}72) bağımsız Python hesabıyla kıyaslanmış, rma.mv bu modelde (10 varyans bileşeni, 8 çalışma) yakınsamamıştır. Hamling kovaryansı ve tek aşamalı yaklaşım bağımsız olarak yeniden hesaplanmamıştır; yalnız şablonun çıktısı gösterilir.
197.7 Çıktıyı okuma
Konsol çıktısı (ornek), olduğu gibi (kısaltılmış):
Call:  dosresmeta(formula = .y ~ s1 + s2 + s3, id = .id, type = .tur,
    cases = .vaka, n = .n, data = d, se = .se, covariance = "gl",
    method = "reml")

Two-stage random-effects meta-analysis
Estimation method: REML
Covariance approximation: Greenland & Longnecker

Chi2 model: X2 = 28.3632 (df = 3), p-value = 0.0000

Fixed-effects coefficients
    Estimate  Std. Error        z  Pr(>|z|)  95%ci.lb  95%ci.ub
s1   -0.0097      0.0082  -1.1937    0.2326   -0.0257    0.0062
s2    0.1274      0.0808   1.5757    0.1151   -0.0311    0.2858
s3   -0.2144      0.1488  -1.4407    0.1497   -0.5061    0.0773

Between-study random-effects (co)variance components
    Std. Dev  Corr
s1    0.0112    s1  s2
s2    0.0777    -1
s3    0.1274     1  -1

Univariate Cochran Q-test for residual heterogeneity:
Q = 20.5624 (df = 21), p-value = 0.4859
I-square statistic = 0.0%

8 studies, 24 values, 3 fixed and 6 random-effects parameters
  logLik       AIC       BIC
 43.0662  -68.1324  -58.7317

Çalışmalar arası rastgele etki standart sapmaları: 0,0112; 0,0777; 0,1274
UYARI: çalışmalar arası kovaryans matrisi Ψ sınırda kestirildi (|korelasyon| > 0,99 ya da bir standart sapma sıfıra yakın). Çalışma sayısı katsayı sayısına göre az olabilir; Ψ tanımlı değildir ve rastgele etkili güven aralıkları sabit etkili aralıklara yakın çıkar. Daha az düğüm ya da log-doğrusal biçim deneyin.
Model testleri ve uyum
| ölçüt | değer |
|---|---|
| çalışma sayısı | 8 |
| doz kategorisi (referans dışı) | 40 |
| chi2_model (3 sd) | 28.3632 (p=3{,}05\cdot10^{-6}) |
| Q (21 sd) | 20.5624 (p=0{,}4859) |
| I2_yuzde | 0 |
| logLik · AIC · BIC | 43.0662 · −68.1324 · −58.7317 |
| chi2_dogrusal_olmama (2 sd) | 5.0905 (p=0{,}0785) |
Birleştirilmiş göreli risk (referans doz = 0)
| doz | RR | GA alt | GA üst |
|---|---|---|---|
| 0 | 1.0000 | 1.0000 | 1.0000 |
| 12 | 0.9473 | 0.8374 | 1.0716 |
| 24 | 1.0671 | 0.9419 | 1.2090 |
| 36 | 1.2173 | 1.0698 | 1.3852 |
| 48 | 1.3700 | 1.2039 | 1.5591 |
| 60 | 1.5322 | 1.2510 | 1.8766 |
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
dose, dose', dose'' |
Spline katsayıları (log RR ölçeği) | Tek tek yorumlanmaz: tabanın sütunlarıdır. Birlikte \chi^2=28{,}36 (3 sd), yani doz–yanıt ilişkisi vardır. Tek tek p değerleri büyüktür çünkü katsayılar birbirine güçlü bağlıdır. |
chi2_dogrusal_olmama |
Spline terimlerin sıfır olduğu sınaması | \chi^2=5{,}09 (2 sd, p=0{,}078): %5 düzeyinde doğrusallıktan sapma kanıtı yoktur. |
| Q, I² | Sabit etkili çözüme göre artık heterojenlik | Q (21 sd) =20{,}56, I^2=\%0: çalışmalar arası heterojenlik gözlenmiyor. |
| Rastgele etki SD'leri | \sqrt{\mathrm{diag}\,\Psi} | Sıfıra yakın; korelasyonlar ±1 olduğundan \Psi sınırdadır (197.8). |
| logLik, AIC, BIC | Modellerin karşılaştırılması | Aynı veri, aynı kovaryans, aynı yöntemle (REML) karşılaştırılabilir: log-doğrusal -55{,}24; ikinci derece -144{,}13; 3 düğüm -77{,}02; 4 düğüm -68{,}13 (AIC). Farklı kovaryans ya da tek/iki aşamalı yaklaşım arasında karşılaştırılamaz. |
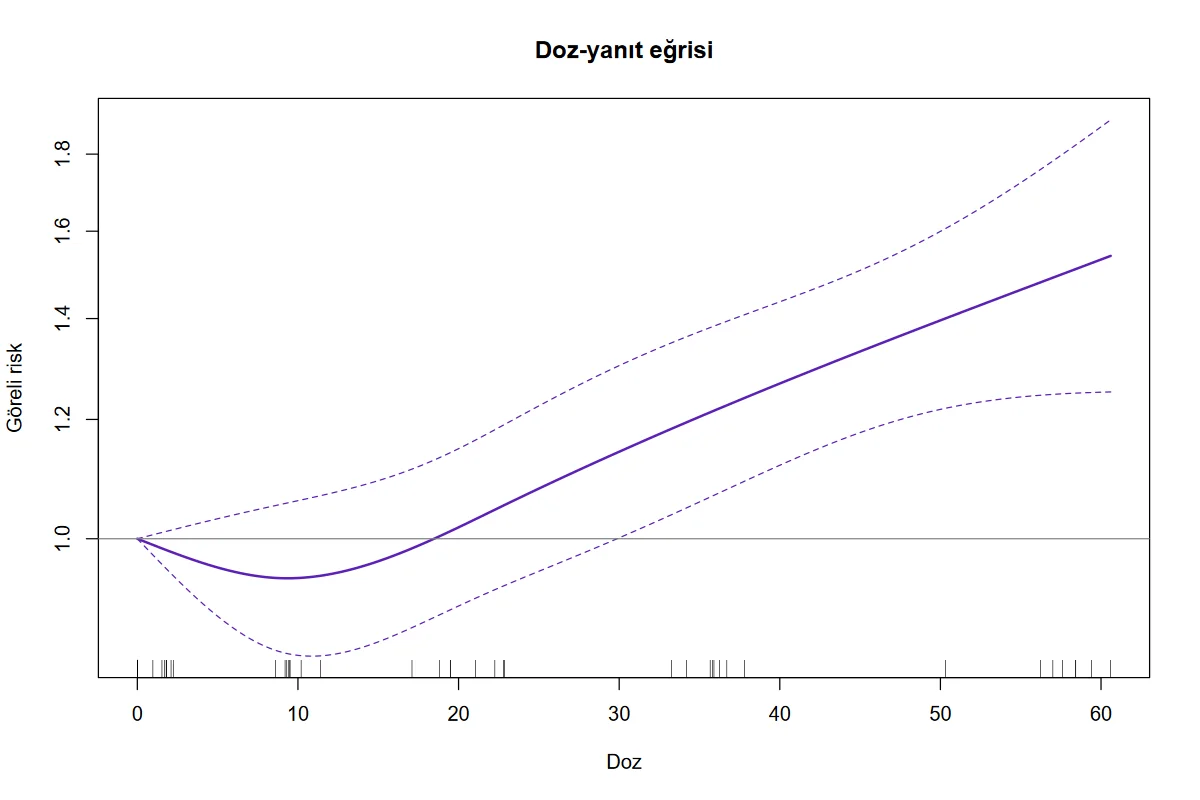
| Tahmin tablosu | Doz başına RR ve GA | RR 12 g/gün'de 0,95, 36'da 1,22, 60'ta 1,53; eğri yaklaşık doğrusal artar. |
Şekil 197.1. Birleştirilmiş doz-yanıt eğrisi (kısıtlı kübik spline, 4 düğüm; kesikli çizgiler %95 GA; y ekseni logaritmik; alttaki çizgiler gözlenen dozlar).
Ek çalıştırmalar (spline katsayıları, Q, \chi^2 model):
| Çalıştırma | Katsayılar | Q | \chi^2 model | Not |
|---|---|---|---|---|
dogrusal |
0{,}006438 | 4{,}7797 | 22{,}67 (1 sd) | Eğim 0,0064 [SH 0,0014]; \tau^2=0 |
kuadratik |
-0{,}001568;\ 0{,}000164 | 14{,}2165 | 26{,}85 (2 sd) | doz² katsayısı p=0{,}046 |
dugum3 |
-0{,}0014;\ 0{,}0210 | 14{,}5883 | 27{,}23 (2 sd) | doğrusal olmama p=0{,}041 |
fixed |
-0{,}0078;\ 0{,}1132;\ -0{,}1904 | 20{,}5624 | 28{,}82 | log-olabilirlik boş |
ml |
-0{,}0092;\ 0{,}1232;\ -0{,}2073 | 20{,}5624 | 28{,}51 | \ell=50{,}76 |
mm |
-0{,}0095;\ 0{,}1209;\ -0{,}2012 | 20{,}5624 | 28{,}21 | olabilirlik yok |
indep |
-0{,}0140;\ 0{,}1507;\ -0{,}2535 | 19{,}5011 | 16{,}32 | kovaryans yok sayıldı |
hamling |
-0{,}0098;\ 0{,}1301;\ -0{,}2201 | 20{,}2501 | 27{,}83 | gl'ye yakın |
1stage |
-0{,}0092;\ 0{,}1202;\ -0{,}2008 | yok | 28{,}46 | yakınsama uyarısı |
g90 |
ornek'le aynı |
20{,}5624 | 28{,}36 | GA %90; adım 10 (0, 10, …, 60) |
Doğrusal modelde stdout katsayı satırı (Intercept) adını taşır (paketin etiketi); şablonun tablosunda terim dose'dur.
Rapor cümlesi. Sekiz kohort çalışmasından alkol tüketimi ile kolorektal kanser riski arasındaki doz-yanıt ilişkisi, çalışma içi kovaryansın Greenland ve Longnecker yöntemiyle yaklaşıklandığı iki aşamalı çok değişkenli rastgele etkili modelle (REML; 4 düğümlü kısıtlı kübik spline) incelendi. Model \chi^2 testi doz-yanıt ilişkisini destekledi (\chi^2=28{,}36, sd =3, p<0{,}001); doğrusallıktan sapma anlamlı değildi (\chi^2=5{,}09, sd =2, p=0{,}078). Referans dozla (0 g/gün) karşılaştırıldığında birleştirilmiş RR 36 g/gün'de 1,22 (%95 GA 1,07–1,39) ve 60 g/gün'de 1,53 (1,25–1,88) bulundu. Çalışmalar arası heterojenlik gözlenmedi (Q=20{,}56, sd =21, p=0{,}486; I^2=\%0).
197.8 Sık hatalar ve tuzaklar
- Referans satırı zorunludur. Her çalışmada log RR =0 ve SH boş olan tam bir satır bulunmalıdır; ikisinden biri eksikse çalışma "referans satırı yok" diye listelenir (131–132). Referans dışı bir satırda SH boş bırakılırsa şablon "standart hata boş" iletisiyle durur (
e_se_eksik). - Vaka sayısı 0 olan kategori Greenland–Longnecker yinelemesini bozar: şablon "vaka sayısı 0" iletisiyle durur (
e_vaka0). Çözüm: kategoriyi birleştirmek ya dakovaryans = indepile bağımsız varsaymaktır. - Her çalışmada en az q referans dışı kategori gerekir. 4 düğümlü spline q=3 ister; yalnız 2 referans dışı kategorisi olan çalışma varsa şablonun kendi denetimi geçilir ve paket durur (
e_az_kategori). Çalışma çıkarılmalı, düğüm sayısı ya da biçim azaltılmalıdır; ya da tek aşamalı yaklaşım seçilir. - Rastgele etki kovaryansı sınırdadır. 8 çalışma ve 3 katsayı ile yapısız \boldsymbol\Psi (6 parametre) kestirilemez: örnekte korelasyonlar \pm1'dir. Sonuç: \hat\tau^2\approx0 ve birleştirilmiş SH'ler sabit etkiliye yakın çıkar. Heterojenlik yokmuş gibi okunmamalıdır; küçük çalışma sayısında rastgele etkiler olabilirliği düzdür; şablon bu durumda "Ψ sınırda kestirildi" uyarısı yazar. Düğüm sayısını azaltmak ya da
fixedile karşılaştırmak yol gösterir. - Tek aşamalı yaklaşımda Q ve I^2 yoktur. Tablo Q, Q_sd, Q_p ve I^2 için boş (NA) yazar ve bir not ekler. Paket yakınsama uyarısı verirse "UYARI: kestirim yakınsamadı" yazılır; sonuçlar yorumlanmamalıdır.
- Referans doz bütün verinin en küçük dozudur. Çalışmaların referans dozları farklıysa (her çalışmanın kendi referansı vardır) tahmin tablosu yine en küçük dozu sıfır noktası alır; şablon bunu bir notla bildirir (
e_ref_farkli). - Doz birimi ve tipik değer. Aralıklı (açık uçlu) kategoriler için tipik değer (ortanca, aralık ortası) kullanıcı tarafından belirlenir; şablon bunu sınamaz. Aynı çalışmada iki satırın dozu aynıysa yine de kabul edilir.
- Ondalık virgüllü doz sütunu sayısal olmaz; "sayısal sütun değil" iletisi gelir (
e_virgul). Ondalık nokta kullanın. - Tahmin tablosu 1000 satırı aşmaz.
adimçok küçük seçilirse adım (\max-\min)/1000'e büyütülür ve not yazılır. - Spline düğümleri referans satırları da sayar. Çok sayıda sıfır doz satırı varsa ilk düğüm sıfıra düşer (197.4.1); bu paketin vinyeti ile aynıdır ama düğümlerin yeri doz dağılımına, dağılım referans satırlarına bağlıdır.
tur_sutundoluykenturalanı yok sayılır. Karışık desenli çalışmalar için gereklidir; sütunda başka bir değer ("cohort", "case-control") durumu hata verir (126).
197.9 Uzman soruları
S1. Neden iki aşamalı ve neden çok değişkenli birleştirme?
İki aşamalı yaklaşım her çalışmanın kendi ilişkili RR'lerini yalnız o çalışmada GLS ile çözer; çalışmalar arası heterojenlik ancak ikinci aşamada, katsayı vektörleri üzerinden modellenir. Çok değişkenli birleştirme q katsayının ilişkisini korur: örnekte \hat\beta_1 ile \hat\beta_2 arasındaki korelasyon güçlü negatiftir (vcov -6{,}1\cdot10^{-4}, SH'ler 0{,}0082 ve 0{,}0808 ile \rho=-0{,}93). Katsayıları tek tek birleştirmek eğrinin GA'sını yanlış verirdi.
S2. Çalışma içi kovaryansı bağımsız saymak hangi yönde yanıltır?
Ortak referans kategori, çalışma içi log RR'leri pozitif ilişkili kılar. Bunu yok saymak GLS'in bu bilgiyi kullanmasını engeller ve çalışma katsayılarının SH'lerini bozar. Örnekte indep model \chi^2'sini 28,36'dan 16,32'ye düşürür, doğrusallıktan sapma p'sini 0,078'den 0,020'ye çeker: yanıtın biçimi hakkındaki sonuç kovaryans varsayımına bağlıdır.
S3. `gl` ile `h` (Hamling) arasındaki fark ne kadar büyüktür?
Örnekte küçüktür: katsayılar -0{,}0097;\ 0{,}1274;\ -0{,}2144 ve -0{,}0098;\ 0{,}1301;\ -0{,}2201, Q 20{,}56 ve 20{,}25, log-olabilirlik 43{,}066 ve 43{,}063. Greenland–Longnecker toplam vaka sayısını korur; Hamling ve ark. (2008) aynı RR'leri ve SH'leri yeniden üreten uydurulmuş sayıları sayısal en iyilemeyle arar. Ayrıntı farkı kişi-yıl ya da denek sayılarının küçük olduğu çalışmalarda artar; bu durumda iki yöntemin karşılaştırılması önerilir.
S4. Sınır durumu: bir çalışmada yalnız bir referans dışı kategori varsa?
İki aşamalıda şablon durur ("her çalışmada en az q referans dışı doz kategorisi olmalı"; q doz tabanının sütun sayısıdır). Log-doğrusal modelde (q=1) bir kategori yeter; spline için q=3 ister. Tek aşamalı yaklaşım yalnız bir kategorili çalışmaları da kullanabilir (Crippa ve ark., 2019) ve şablonda asama = 1stage ile seçilir; momentler yöntemi ile birlikte seçilemez (164).
S5. Neden Q rastgele etkili model seçilse de aynı çıkıyor?
Şablonun Q'su paketin "Cochran Q" satırıdır ve sabit etkili birleştirmeye göre hesaplanır: örnekte ornek, fixed, ml ve mm için hep 20{,}5624'tür. Rastgele etkiler modelinin artık heterojenliğini ölçen ayrı bir Q yoktur; heterojenlik \boldsymbol\Psi'nin kendisiyle okunur.
S6. Başka bir tanımla fark: kategorik (en yüksek–en düşük) meta-analizi.
En yüksek ve en düşük kategoriyi karşılaştıran meta-analiz yalnız iki noktaya bakar ve doz birimlerini göz ardı eder; çalışmalar arasında kategori sınırları farklıysa karşılaştırılamaz. Doz-yanıt çözümü kategorinin tipik dozunu kullanır ve ortak bir eğri uydurur; ama tipik doz seçimi (aralık ortası, ortanca) sonucu etkiler. Bu şablon çalışma düzeyinde doz-yanıt modeli kurar; çalışma düzeyindeki ekolojik yanılgı bireysel doz-yanıtı için geçerli değildir.
S7. Referans doz neden `min(doz)`?
Birleştirilmiş eğrinin referans dozda 1 olması için bir sıfır noktası gerekir; şablon bütün verinin en küçük dozunu seçer (218). Çalışmaların kendi referansları farklı olabilir (bu durumda şablon bir not yazar); bu durumda \boldsymbol\beta doz farklarından kestirilir (her çalışma kendi referans dozundan merkezlenir, 197.4.3) ve tahmin tablosu birleştirilmiş eğriyi \min(\text{doz})'a göre yeniden ölçekler. Referanslar aynıysa (alkol örneğinde hepsi 0) sorun yoktur.
S8. Güven düzeyi yalnız aralıkları mı değiştirir?
Evet: yalnız katsayı tablosundaki GA'yı ve tahmin tablosunun GA'sını (kod: zk, 181); model \chi^2, Q ve olabilirlik bundan bağımsızdır. g90'ta z=1{,}6449; 60 g/gün için RR 1{,}5322 ve %90 GA (1{,}2925;\ 1{,}8164) (%95: 1{,}2510;\ 1{,}8766). Izgara en büyük dozu (60,6) aşmayacak biçimde 60'ta biter.
197.10 Kaynaklar
Crippa, A., Discacciati, A., Bottai, M., Spiegelman, D., & Orsini, N. (2019). One-stage dose–response meta-analysis for aggregated data. Statistical Methods in Medical Research, 28(5), 1579–1596. https://doi.org/10.1177/0962280218773122
Crippa, A., & Orsini, N. (2016). Multivariate dose-response meta-analysis: The dosresmeta R package. Journal of Statistical Software, 72(Code Snippet 1), 1–15. https://doi.org/10.18637/jss.v072.c01
Gasparrini, A., Armstrong, B., & Kenward, M. G. (2012). Multivariate meta-analysis for non-linear and other multi-parameter associations. Statistics in Medicine, 31(29), 3821–3839. https://doi.org/10.1002/sim.5471
Greenland, S., & Longnecker, M. P. (1992). Methods for trend estimation from summarized dose-response data, with applications to meta-analysis. American Journal of Epidemiology, 135(11), 1301–1309. https://doi.org/10.1093/oxfordjournals.aje.a116237
Hamling, J., Lee, P., Weitkunat, R., & Ambühl, M. (2008). Facilitating meta-analyses by deriving relative effect and precision estimates for alternative comparisons from a set of estimates presented by exposure level or disease category. Statistics in Medicine, 27(7), 954–970. https://doi.org/10.1002/sim.3013
Harrell, F. E., Jr. (2015). Regression modeling strategies (2nd ed.). Springer. https://doi.org/10.1007/978-3-319-19425-7
Harrell, F. E., Jr. (2026). Hmisc: Harrell miscellaneous (R package version 5.3-0). https://doi.org/10.32614/CRAN.package.Hmisc
Orsini, N., Li, R., Wolk, A., Khudyakov, P., & Spiegelman, D. (2012). Meta-analysis for linear and nonlinear dose-response relations: Examples, an evaluation of approximations, and software. American Journal of Epidemiology, 175(1), 66–73. https://doi.org/10.1093/aje/kwr265