64. Aykırı lokus ve seçilim taraması (pcadapt, FST aykırılığı, sNMF farklılaşma testi, LFMM2 çevre ilişkilendirmesi)
Şablon kimliği: aykiri_lokus · Kategori: genetik · Dil: R · Dosya: pro/sablonlar/genetik/aykiri_lokus.R (satır 1–550; üstbilgi 1–228) · Örnek veri: _ornek/pcadapt_geno3pops.csv · Paketler: pcadapt 4.4.1, qvalue 2.42.0, LEA 3.22.0 (sNMF ve LFMM2 seçilirse), taban R
64.1 Ne işe yarar
Şablon, genom boyunca dağılmış çok sayıda SNP içinden, popülasyonlar arasındaki farklılaşması genomun geri kalanından belirgin biçimde büyük olan lokusları arar. Cevapladığı soru şudur: "Bu SNP'lerden hangileri, popülasyonların ortak geçmişinin (sürüklenme, göç) açıklayabileceğinden daha çok ayrışmış ve bu yüzden yerel uyum (seçilim) adayıdır?"
Bütün yöntemlerin ortak düşüncesi aynıdır: nötr lokusların çoğunluğu "olağan" farklılaşmayı tanımlar; her lokus için bir istatistik hesaplanır; istatistiğin olağan dağılımına göre uç kalan lokuslar aykırı lokus (outlier) sayılır.
Şablon dört yöntemi tek formda toplar:
| Yöntem | Gereken bilgi | İstatistik | Olağan dağılım |
|---|---|---|---|
| pcadapt | Yalnız genotipler | SNP'nin ilk K temel bileşenle ilişkisi (sağlam Mahalanobis uzaklığı) | \chi^2_K, genomik şişme katsayısıyla ölçeklenmiş |
| FST aykırılığı | Genotipler + popülasyon etiketi | Lokus başına Weir–Cockerham \theta | Lewontin–Krakauer: \chi^2_{d}; ayrıca deneysel zarf |
| sNMF farklılaşma testi | Yalnız genotipler | Kestirilen ata popülasyonlar arası F_{ST} | F_{K-1,\,n-K}, genomik kontrol |
| LFMM2 | Genotipler + çevre değişkenleri | SNP ile çevre arasındaki ilişki (gizil etkenler arındırılmış) | F_{d,\,n-d-1}, genomik kontrol |
Ne zaman kullanılır? Birkaç yüzden on binlere kadar iki alelli SNP ve onlarca–yüzlerce birey varsa; popülasyonlar arasında yerel uyum izleri aranıyorsa; ilişkilendirme analizinden önce yapıyı bozan lokuslar ayıklanacaksa; genotip–çevre ilişkisi taranacaksa (LFMM2).
Ne zaman kullanılmaz?
- Yalnız popülasyon yapısı (temel bileşenler, soy katsayıları) isteniyorsa:
populasyon_yapisi(Bölüm 84). - Genel ve çiftler arası F_{ST} ve güven aralıkları isteniyorsa:
f_istatistikleri(Bölüm 71). - Bir fenotiple SNP ilişkisi aranıyorsa:
gwas(Bölüm 76); vaka–kontrol tasarımı içinvaka_kontrol_genetik(Bölüm 93). - Nicel özellik farklılaşması nötr beklentiyle karşılaştırılacaksa:
qst_fst(Bölüm 86). - Çok alelli işaretleyiciler (mikrosatellit), haploit ya da poliploit veri: şablon bunları çıkarır ya da durdurur.
- Birkaç on SNP: "olağan dağılım" veriden kestirildiği için az lokusla tarama anlamsızdır.
Temel programla ilişki. Temel programda seçilim taraması yoktur. Temel Bileşenler Analizi genotip matrisine uygulanabilir, ama SNP başına test, genomik şişme düzeltmesi ve q değeri orada bulunmaz.
64.2 Şablonun girdileri
Form, üstbilgideki 26 [[param]] bloğundan kurulur (aykiri_lokus.R:11–227).
Değişkenler ve model
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
SNP sütunları · lokuslar |
sütunlar · Değişkenler | boş | 0/1/2 sayısal ya da a1/a2 metin |
Boşsa popülasyon, kimlik ve çevre dışındaki bütün sayısal sütunlar (241, 252–257). |
Popülasyon · populasyon |
kategorik sütun · Değişkenler | boş | herhangi sütun | FST için zorunlu; puan grafiğinde renk; sNMF'de otomatik K (238, 349–353, 493). |
Birey kimliği · birey |
kategorik sütun · Değişkenler | boş | herhangi sütun | Yalnız satır adı; mq_kimlik ile tek biçimli metne çevrilir (273–274; Bölüm 1.5). |
Çevre değişkenleri · cevre |
sütunlar (sayısal) · Değişkenler | boş | sayısal sütunlar | LFMM2'nin açıklayıcıları; değerleri mq_sayisal ile okunur (240, 517–518; Bölüm 1.5). |
Alel ayırıcısı · ayirici |
metin · Değişkenler | / |
boş olmayan metin | Metin genotiplerin bölünmesi (242, 289). |
Eksik genotip kodları · eksik_kodlar |
metin · Değişkenler | boş | virgülle ayrılmış kodlar | Boşsa varsayılan liste (boş hücre, NA, 0, 00, 000, ?, -, ., -9) eksik sayılır; doluysa alandaki kodlar bu listenin yerine geçer (boş hücre ve NA her zaman eksik); baş ve son boşluk kırpılır, boş kodlar atılır (satır 233–234; Bölüm 1.5). |
Yöntem · yontem |
seçim · Model | pcadapt_fst |
pcadapt_fst, pcadapt, fst, snmf, lfmm2, hepsi |
Hangi adımların çalışacağı (345–357). |
K · K |
tamsayı · Model | 0 | 0–50 | 0: tarama grafiğinden otomatik; pcadapt ve LFMM2'nin K'sı (362–384). |
pcadapt test istatistiği · istatistik |
seçim · Model | mahalanobis |
mahalanobis, componentwise |
pcadapt(method =) (387–388); bileşen başına p değerleri z-skorlarından şablonda hesaplanır (390–397). |
sNMF ata popülasyon sayısı · snmf_K |
tamsayı · Model | 0 | 0, 2–50 | 0: popülasyon sayısı (en az 2), yoksa K+1 (248–249, 493). |
Seçenekler
| Alan · ad | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|
Tarama grafiğindeki en büyük K · K_en_cok |
20 | 3–50 | İlk PCA'nın bileşen sayısı; otomatik kuralın tabanı da bundan hesaplanır (360, 368–374). |
En küçük alel frekansı eşiği · maf |
0,05 | 0–0,45 | Altındaki lokuslar çıkarılır (307–311); pcadapt'a da verilir. |
Çoklu test düzeltmesi · duzeltme |
qvalue |
qvalue, BH, BY, holm, bonferroni |
duzelt() (321–332). |
Aykırı lokus eşiği · alfa |
0,1 | 0,001–0,5 | Düzeltilmiş p (ya da q) bu değerden küçükse aykırı. |
FST budama oranı · kirpma |
0,05 | 0–0,3 | \bar F için iki uçtan atılan pay (456–459). |
\bar F için en küçük H_e · he_en_az |
0,1 | 0–0,5 | Düşük heterozigotluklu lokuslar \bar F'ye girmez (454). |
LD budaması · ld_budama, ld_pencere, ld_r2 |
kapalı; 200; 0,1 | —; 1–100000; 0,01–0,99 | pcadapt(LD.clumping = list(size, thr)) (247). |
Gelişmiş
| Alan · ad | Varsayılan | Kodda etkisi |
|---|---|---|
q değeri \pi_0 kestirimi · qvalue_pi0 |
smoother (bootstrap) |
qvalue(pi0.method =) (250–251, 324). |
pcadapt yakınsama toleransı · pcadapt_tol |
10^{-4} (10^{-7}–10^{-2}) | Kesik SVD'nin toleransı (246, 368, 388). |
sNMF düzenlileştirme, tolerans, yineleme, tekrar, tohum · snmf_alfa, snmf_tolerans, snmf_iterasyon, snmf_tekrar, snmf_tohum |
10; 10^{-5}; 200; 1; 1 | LEA::snmf() bağımsız değişkenleri (500–501). |
sNMF genomik kontrol · snmf_gc |
açık | snmf.pvalues(genomic.control =, lambda = K − 1) (506–508); kapalıyken istatistik (K-1)'e bölünür ve özet tablosunda GIF boş kalır (64.4.5). |
LFMM2 ridge \lambda · lfmm_lambda |
10^{-5} | lfmm2(lambda =) (526). |
LFMM2 genomik kontrol · lfmm_gc |
açık | lfmm2.test(genomic.control =) (527). |
Örnek ayar (ornek_param, satır 9): populasyon = "pop", birey = "birey"; SNP listesi boş (1500 sayısal sütunun hepsi), yöntem pcadapt_fst, K=0.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 237 |
snmf_K = 1 |
"sNMF için K en az 2 olmalı (0 = otomatik)." | 249 |
| Boş listede hiç sayısal sütun yok | "SNP sütunu bulunamadı…" | 255–256 |
| Popülasyon, kimlik ya da çevre sütunu SNP olarak da seçilmiş | "…SNP olarak da seçilemez." | 258 |
| Kalan birey 3'ten az | "En az 3 birey gerekli." | 272 |
| Sayısal SNP'de 0/1/2 dışı değer | "'…' sütununda 0/1/2 dışında değer var (ör. …)" | 285–286 |
Metin SNP'de alellerden yalnız biri eksik kodu (0/1, A/?) |
"'…' lokusunda … genotipte alellerden yalnız biri eksik kodu…" (ortak ayrıştırıcı; Bölüm 1.5) | 289 |
| Metin SNP'de ayırıcısız ya da ikiden çok parçalı genotip | "…ayırıcı ('/') içermeyen genotip var (ör. …)"; "…ikiden çok alelli genotip var…" (ortak ayrıştırıcı) | 289 |
| Hepsi eksik ya da çok alelli | "Çözümlenecek SNP kalmadı…" | 303 |
| Süzgeçlerden sonra 3'ten az SNP | "…en az 3 polimorfik SNP gerekli." | 313 |
| Bir bireyin kalan SNP'lerin hiçbirinde genotipi yok | "… bireyin hiçbir SNP'de genotipi yok (ör. …); bu bireyleri veriden çıkarın." | 315–318 |
Yöntem fst, popülasyon yok |
"FST aykırılığı için popülasyon sütunu gerekli." | 350 |
Yöntem lfmm2, çevre yok |
"LFMM2 için en az bir çevre değişkeni seçin." | 355 |
| K\ge n ya da K\ge L | "K (…) birey (…) ve SNP (…) sayısından küçük olmalı." | 363 |
| pcadapt hata verdi | "pcadapt çalıştırılamadı: …" | 368 |
| Popülasyon sayısı < 2; bir popülasyonda < 2 birey | "…en az iki popülasyon…"; "Her popülasyonda en az 2 birey…" | 432, 434 |
| \bar F için 5'ten az lokus | "F̄ için yeterli lokus yok (heterozigotluk eşiğini düşürün)." | 455 |
| \bar F\le0 | "Budanmış ortalama FST … sıfır ya da negatif … test uygulanamaz." | 460–461 |
| sNMF K\ge n; sNMF hata verdi | "sNMF K (…) birey sayısından … küçük olmalı."; "sNMF çalıştırılamadı: …" | 494, 503 |
| Çevre sütununda sayıya çevrilemeyen değer | mq_sayisal iletisi: sütun adı ve örnek değerler (Bölüm 1.5) |
517 |
| Çevrede eksik değer; sabit çevre değişkeni | "…LFMM2 eksiksiz çevre verisi ister."; "Sabit çevre değişkeni var; çıkarın." | 519–520 |
Notlar (durdurmaz). Popülasyonu eksik bireylerin çıkarılması (266); metin genotiplerin okuma dökümü, "Genotip okuma: … lokusta … genotipin … tanesi eksik sayıldı (boş hücre: …; eksik kodu: …)" (297; Bölüm 1.5); bütünüyle eksik, ikiden çok alelli, tek alelli ve düşük frekanslı lokusların çıkarılması (298–310); popülasyon yokken FST adımının atlanması (351); q değeri kestirilemezse Benjamini–Hochberg'e geçiş (326); bileşen başına testte bileşenlerin genomik şişme katsayıları (395–397); LFMM2 için eksik genotiplerin doldurulması (524); %99 deneysel zarfın dışındaki lokus sayısı (545–548).
Eksik genotip. Sayısal SNP sütununda boş hücre eksiktir. Metin sütunda boş hücre ve NA, 0, 00, 000, ?, -, ., -9 kodları eksik sayılır; ayırıcılı yazımda iki alelin ikisi de eksik kodu olmalıdır (0/0). Alellerinden yalnız biri eksik kodu olan genotip (0/1) çalıştırmayı durdurur: "0" gerçek bir alelin adıysa alel yeniden kodlanır (kuralın tamamı ve gerekçesi Bölüm 1.5'te). Eksik genotip kodları alanı doluysa (virgülle ayrılmış, ör. .) alandaki kodlar bu listenin yerine eksik sayılır; boş hücre ve NA her zaman eksiktir ve yarı eksik durma kuralı yeni listeye göre işler: VCF tarzı 0/1 kodlu veride alana yalnız . yazılırsa 0 gerçek alel olur (satır 233–234). Her adım eksikleri kendi yoluyla ele alır: pcadapt adımına ve K seçimine eksik hücreler eksik (NA) olarak verilir, paket alel frekansını o lokusta genotipi olan bireylerden hesaplar (365–367); FST adımı lokus bazında eksik bireyleri atar (436); sNMF eksik hücreleri dosyaya eksik simgesiyle yazar (497–498); LFMM2 eksik hücreleri lokus ortalamasının yuvarlanmışıyla doldurur ve not yazar (521–525). Süzgeçlerden sonra kalan SNP'lerin hiçbirinde genotipi olmayan birey varsa çalıştırma, birey sayısını ve örnek kimlikleri vererek durur (315–318); böyle bir bireyin temel bileşen puanı tanımsızdır.
64.3 Örnek veri
Dosya: _ornek/pcadapt_geno3pops.csv; pcadapt paketinin örnek verisi (Luu ve ark., 2017): üç popülasyondan 150 birey (her birinden 50), 1500 SNP. Benzetim verisidir; SNP'lerin bir bölümü yerel uyum altında üretilmiştir. Eksik genotip yoktur.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
birey |
Kimlik | metin | 150 farklı değer. |
pop |
Popülasyon | kategorik (3 düzey) | POP1, POP2, POP3; her biri 50 birey. |
snp0001–snp1500 |
SNP | sayısal | 0/1/2; küçük alel frekansı en az 0,193; H_e en az 0,312. |
Bütün SNP'ler frekans eşiğini geçer; süzgeç hiçbir lokusu çıkarmaz. Popülasyon düzeylerinin sırası sonucu etkilemez (\theta ve Lewontin–Krakauer istatistiği etiket sırasına bağlı değildir); yalnız puan grafiğindeki renk sırasını belirler.
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) yalnız pcadapt, bileşen başına, K=2; (3) yalnız pcadapt, K=1; (4) yalnız FST, düzeltme BH; (5) örnek ayar, Bonferroni, eşik 0,05; (6) LD budaması açık; (7) ek sınama verisi dogrulama/aykiri_lokus/al_cevre.csv (örnek verinin ilk 300 SNP'si ve iki çevre değişkeni: env1 popülasyona bağlı, env2 saf gürültü): "Uygulanabilen bütün yöntemler", düzeltme BH; (8) aynı veride sNMF ve LFMM2'nin genomik kontrolsüz çalıştırmaları ve tek çevre değişkenli (env1) LFMM2; (9) eksik genotipli iki sınama verisi: al_eksik8.csv (ilk 300 SNP, 45 000 hücrenin 8'i eksik; yalnız pcadapt, K=2) ve al_karma.csv (ilk 120 SNP, hücrelerin %2'si eksik, 10 SNP A/G metin biçiminde; örnek yöntem ve "Yalnız FST").
64.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) genotip matrisini kur (n\times L; 0/1/2), eksik, çok alelli, tek alelli ve düşük frekanslı lokusları çıkar; (2) K_en_cok bileşenli PCA ile tarama grafiğini çiz ve K'yı seç; (3) seçilen yöntemlere göre pcadapt, FST, sNMF, LFMM2 adımlarını çalıştır; (4) her adımın p değerlerini düzelt ve eşikle karşılaştır; (5) özet, aykırı lokus ve lokus başına tabloları yaz.
64.4.1 Genotip matrisi ve süzgeçler
Sayısal sütun olduğu gibi alınır (0, 1, 2 = sayılan alelin kopya sayısı). Metin sütun ortak genotip ayrıştırıcısıyla okunur (satır 289; kural Bölüm 1.5); aleller ada göre sıralanır ve ikinci alelin kopyaları sayılır (satır 290–294). Her lokus için:
- g_{ij}: i. bireyin j. lokustaki genotipi (0/1/2); n_j: o lokusta genotipi olan birey sayısı.
- \text{maf}_j=0 olan (tek alelli) ve \text{maf}_j<
mafolan lokuslar çıkarılır; kalan lokus sayısı L'dir.
Neden düşük frekanslı lokuslar atılır?
Nadir alelde \theta ve z-skorlarının örnekleme dağılımı çarpıktır; ölçekleme paydası \sqrt{2\hat p(1-\hat p)} küçülür ve birkaç bireyin genotipi istatistiği uçurur. Yanlış aykırıların çoğu bu lokuslardan gelir. 0,05 eşiği yazındaki olağan seçimdir; küçük örneklemde (popülasyon başına 20'den az birey) 0,10'a yükseltmek uygundur.
64.4.2 Temel bileşenler ve K'nın seçimi
pcadapt genotip matrisini lokus bazında merkezleyip ölçekler ve tekil değer ayrışımını alır:
- \mathbf Z: n\times L ölçeklenmiş genotip matrisi; payda, Hardy–Weinberg altında genotipin standart sapmasıdır.
- \mathbf U: bireylerin bileşen puanları (sütunları birim uzunlukta); d_k: tekil değerler; \pi_k: k. bileşenin toplam varyanstaki payı.
- Popülasyon yapısı ilk birkaç bileşende toplanır; r ayrık popülasyon çoğu zaman r-1 bileşenle ayrılır.
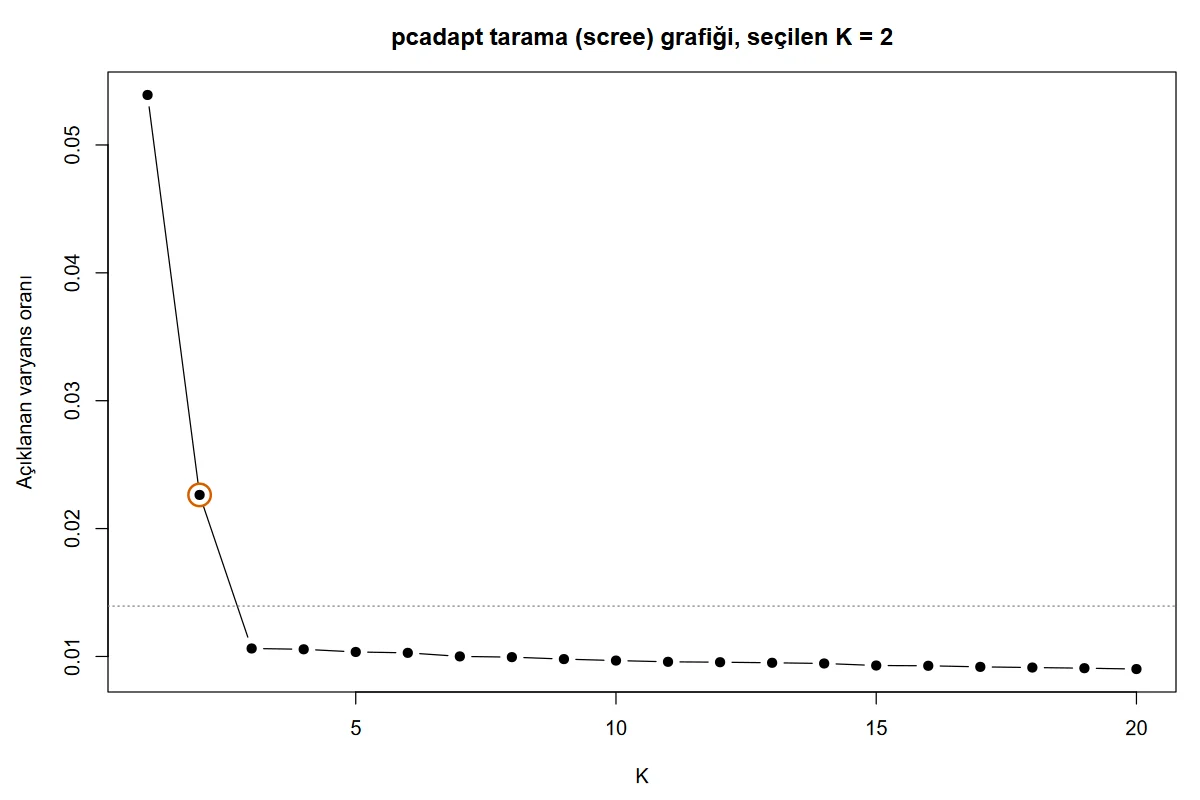
K elle verilmemişse şablon tarama (scree) grafiğinin "dirseğini" sayısal bir kuralla bulur (satır 369–375):
- m: ilk PCA'da hesaplanan bileşen sayısı, \min(
K_en_cok,\ n-1,\ L-1). - Ortanca: ilk m bileşenin ikinci yarısının payı; "gürültü tabanı"nı temsil eder.
- Sayım baştan başlar ve tabanın 1,5 katını aşmayan ilk bileşende durur; sonuç en az 1, en çok m-1'dir.
Neden 1,5 kat ve neden ikinci yarının ortancası?
Cattell'in (1966) dirsek ölçütü gözle uygulanır: yapı taşıyan bileşenler dik iner, gürültü bileşenleri düz bir kuyruk oluşturur. Kuyruğun düzeyi ikinci yarının ortancasıyla, "belirgin biçimde üstünde olma" 1,5 katla sayısallaştırılmıştır. Kural bir kolaylıktır, kestirim değildir: yapı sürekli ise (uzaklıkla yalıtım) ya da K_en_cok küçük seçilirse taban yanlış yere düşer. Grafik her zaman gözle denetlenir ve gerekirse K elle verilir.
Koddaki tercih
İlk çağrı pcadapt(x, K = Kmax, min.maf, LD.clumping, tol) (satır 368) yalnız tekil değerler içindir; test için ikinci bir çağrı seçilen K ile yapılır (388). Genotip matrisi pakete read.pcadapt(G, type = "lfmm") ile, eksik hücreler NA olarak verilir (367). pcadapt ayrışımı RSpectra'nın kesik SVD'siyle, tol (varsayılan 10^{-4}) yakınsama ölçütüyle alır; örnek veride tam SVD ile fark 10^{-14} düzeyindedir. K seçimi yalnız K'yı kullanan yöntemlerde çalışır (365): pcadapt adımı seçilmişse her zaman; sNMF ya da LFMM2 seçilmişse K = 0 iken, çünkü bu yöntemlerin K'sı buradan türetilir. "Yalnız FST" K kullanmaz; bu seçimde temel bileşen hesabı yapılmaz, tarama grafiği ve özet tablosunun "K seçimi" satırı üretilmez. Tarama grafiğinin dikey ekseni \pi_k'nin kendisidir (377): pcadapt'ın döndürdüğü tekil değerler toplam varyansın kareköküne bölünmüş olduğundan kareleri doğrudan toplam varyans payıdır (369). Otomatik kural da aynı \pi_k değerleri üzerinde çalışır; grafikteki noktalı çizgi kuralın eşiğidir (380).
64.4.3 pcadapt: z-skorları ve sağlam Mahalanobis uzaklığı
Her SNP, ilk K bileşen puanına regresyonla bağlanır; katsayılar artık standart sapmasına bölünerek z-skoruna çevrilir:
- \mathbf z_j: j. SNP'nin ölçeklenmiş genotip vektörü (\mathbf Z'nin sütunu); \mathbf U_K: ilk K puan sütunu.
- \zeta_{jk}: SNP j'nin k. bileşenle ilişkisinin z-skoru. Yapıyı kuran bileşenle güçlü ilişkili SNP, o yapının ayırdığı popülasyonlar arasında çok farklılaşmıştır.
Test istatistiği, K boyutlu z-skoru vektörünün z-skorları bulutunun merkezine sağlam Mahalanobis uzaklığıdır:
- \tilde{\boldsymbol\mu}, \tilde{\boldsymbol\Sigma}: z-skorlarının sağlam konum ve kovaryans kestirimi (OGK: dikleştirilmiş Gnanadesikan–Kettenring; Maronna ve Zamar, 2002).
- \hat\lambda: genomik şişme katsayısı (GIF); istatistiklerin ortancasının, \chi^2_K dağılımının ortancasına oranı.
- \chi^2_{K;\,0{,}5}: K serbestlik dereceli ki-kare dağılımının ortancası (K=2 için 1{,}386).
Neden sağlam kovaryans ve neden GIF?
Aykırı lokuslar aranan şeyin kendisidir; olağan kovaryans kestirimi onlardan etkilenir, bulutu şişirir ve aykırıları gizler (maskeleme). OGK, uç gözlemlerin ağırlığını düşürerek "çoğunluğun" biçimini kestirir; örnek veride kovaryans 1500 lokusun 1250'sinden hesaplanır. GIF ikinci bir güvencedir: z-skorları tam olarak standart normal değildir (artık yapı, bağlantı dengesizliği), bu yüzden D^2 tam \chi^2_K dağılmaz. Lokusların çoğu nötr varsayıldığından ortanca nötr dağılımı temsil eder; istatistik ortancası kuramsal ortancaya eşitlenecek biçimde ölçeklenir (Devlin ve Roeder, 1999; François ve ark., 2016).
Koddaki tercih
pcadapt(x, K, method = "mahalanobis") (satır 388; yöntem için Duforet-Frebourg ve ark., 2016; paketin bu sürümü için Privé ve ark., 2020); uzaklık bigutilsr::dist_ogk ile, iki dikleştirme adımı ve %90 kantil eşiğiyle hesaplanır. pcadapt_istatistik sütunu GIF'e bölünmemiş D^2'dir; p bölünmüş değerden gelir. K=1'de uzaklık yerine (\zeta_j-\operatorname{ortanca}\zeta)^2 kullanılır. LD budaması açıksa temel bileşenler LD'ye göre seyreltilmiş SNP'lerden kestirilir, test yine bütün SNP'lere uygulanır; komşuluk sütun sırasına göredir.
Bileşen başına seçenek. istatistik = componentwise seçildiğinde her bileşen için ayrı bir test yapılır; z-skorunun karesi o bileşenin kendi genomik şişme katsayısına bölünür ve bir serbestlik dereceli ki-kare dağılımıyla karşılaştırılır:
- \hat\lambda_k: k. bileşenin genomik şişme katsayısı; \chi^2_{1;\,0{,}5}=0{,}4549.
- p_{jk}: j. lokusun k. bileşenle ilişkisinin p değeri. Ölçekleme gereği her bileşende p değerlerinin ortancası 0,5'tir.
- Düzeltme her bileşenin p değerleri içinde ayrı yapılır; bir lokus, bileşenlerden herhangi birinde düzeltilmiş p'si eşiğin altındaysa aykırı sayılır (satır 401–409).
Örnek veride (K=2) \hat\lambda_1=5{,}9402 ve \hat\lambda_2=2{,}7318'dir. p değerlerinin ortancası iki bileşende 0,5; birinci dördebölenleri 0,2375 ve 0,2492; ortalamaları 0,4901 ve 0,4945'tir. q<0{,}1 ölçütüyle 134 lokus aykırıdır. Bu seçenek, bir lokusu hangi bileşenin (dolayısıyla hangi popülasyon ayrımının) öne çıkardığını gösterir: snp0081'de p_{1}=0{,}624, p_{2}=9{,}3\times10^{-14}'tür; lokus ikinci bileşenin ayırdığı popülasyonlar arasında farklılaşmıştır.
Koddaki tercih
Bileşen başına p değerleri paketin $pvalues çıktısından alınmaz; şablon bunları paketin $zscores matrisinden kendisi hesaplar: sweep(z2, 2, gif_cw, "/") ile her sütun kendi katsayısına bölünür ve pchisq(…, df = 1, lower.tail = FALSE) uygulanır (satır 390–394). Neden: pcadapt 4.4.1 bu bölmeyi L\times K matrisi K uzunluklu vektöre doğrudan bölerek yapar ve katsayılar sütunlara değil satırlara dağılır; yukarıdaki tanım ancak sütun bazında bölmeyle elde edilir. Bileşenlerin katsayıları çıktıya bir notla yazılır ("Not: bileşen başına p değerleri z-skorlarından şablonda hesaplandı; her bileşen kendi genomik şişme katsayısına bölündü (GIF: PC1 = 5,9402; PC2 = 2,7318).", 388–390); özet tablosunun GIF sütunu bu seçenekte boştur. p değerlerinin özeti ayrı bir tablodur (398–400). Bu seçenekte Manhattan grafiği çizilmez.
64.4.4 FST aykırılığı: Weir–Cockerham \theta ve Lewontin–Krakauer testi
Her lokus için Weir ve Cockerham'ın (1984) varyans bileşenleri hesaplanır (r popülasyon, n_i birey, \hat p_i alel frekansı, \hat h_i gözlenen heterozigot oranı):
- a: popülasyonlar arası, b: popülasyon içi bireyler arası, c: birey içi (gametler arası) varyans bileşeni.
- \hat\theta: F_{ST}'nin kestirimi; popülasyonlar arası bileşenin toplam içindeki payı. Yansızlık düzeltmesi nedeniyle negatif çıkabilir (örnek veride 1500 lokusun 351'inde); negatif değer "farklılaşma yok" demektir.
- n_c: eşit olmayan örneklem büyüklükleri için düzeltilmiş ortalama büyüklük; dengeli örnekte \bar n'ye eşittir.
Lewontin ve Krakauer (1973) testi, nötr lokuslarda F_{ST}'nin tipik değerine oranının ölçeklenmiş ki-kare dağıldığına dayanır:
- \bar F: "tipik" (nötr) F_{ST}; şablonda budanmış ortalama (aşağıda).
- d: popülasyon sayısı eksi bir.
- \hat\theta_j\le0 ise T_j\le0 ve p_j=1'dir.
\bar F şöyle bulunur (satır 454–459): H_e=2\bar p(1-\bar p) değeri he_en_az'ın altındaki lokuslar çıkarılır; kalan \hat\theta'ların alt ve üst kirpma kantilleri (R'nin 7. tür kantili) bulunur; bu iki sınırın içinde kalanların yalın ortalaması alınır.
Neden budanmış ortalama?
Seçilim altındaki lokuslar F_{ST} dağılımının üst kuyruğunu şişirir; dengeleyici seçilim alt kuyruğu. Tipik değer bu uçlardan arındırılmazsa \bar F büyür ve test güç kaybeder. İki uçtan budama, Whitlock ve Lotterhos'un (2015) OutFLANK yöntemindeki düşüncedir. Şablon o yöntemin yalın bir benzeridir: serbestlik derecesi veriden kestirilmez, d=r-1 alınır; budanmış ortalamadaki küçük yanlılık düzeltilmez.
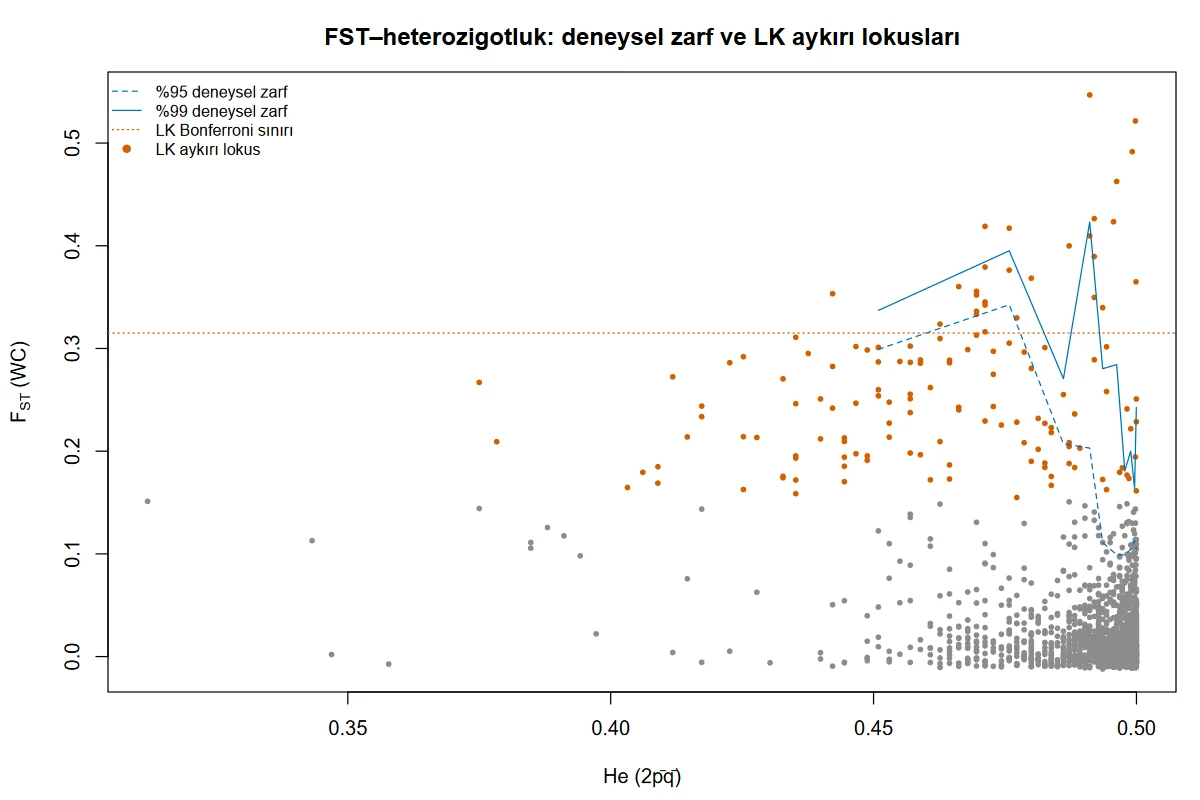
Deneysel zarf. Lokuslar H_e'ye göre on dilime ayrılır; her dilimde \hat\theta'nın %95 ve %99 kantilleri hesaplanıp grafiğe çizilir; kendi diliminin %99 kantilini aşan lokuslar zarf99_disi olarak işaretlenir (satır 466–471). Bu, F_{ST}–heterozigotluk yaklaşımının (Beaumont ve Nichols, 1996; Flanagan ve Jones, 2017) benzetimsiz bir betimidir.
Zarf bir test değildir
%99 kantili verinin kendisinden hesaplandığı için her dilimin yaklaşık %1'i, seçilim olsun olmasın, zarfın dışında kalır: 1500 lokusta 20, 300 lokusta 10 lokus. Zarf bu yüzden betimseldir: zarf99_disi sütunu lokus başına tabloda yer alır, ama bir lokusun "Aykırı lokuslar" tablosuna girmesini sağlamaz; o tabloyu yalnız testlerin kararları (*_aykiri sütunları) doldurur (satır 537–538). Zarfın dışındaki lokus sayısı çıktıya ayrı bir notla yazılır: "Not: 20 lokus %99 deneysel zarfın dışında (zarf99_disi sütunu). … Betimseldir, test değildir ve aykırı lokus tablosuna alınmaz." (545–548).
64.4.5 sNMF farklılaşma testi
sNMF (Frichot ve ark., 2014) popülasyon etiketine gerek duymadan her bireyi K ata popülasyonun karışımı olarak yazar: \mathbf Q (n\times K soy katsayıları) ve \mathbf G (ata popülasyonlardaki genotip frekansları) negatif olmayan matris ayrışımıyla kestirilir. Martins ve ark.'nın (2016) testi bu kestirimlerden lokus başına bir F_{ST} kurar:
- \bar q_k: k. ata popülasyonun ortalama soy katsayısı; f_{jk}: j. lokusun k. ata popülasyondaki alel frekansı.
- z_j^2, genomik kontrolle ölçeklenip F_{K-1,\,n-K} dağılımıyla karşılaştırılır: \hat\lambda=\operatorname{ortanca}(z^2)/F_{0{,}5;\,K-1,\,n-K}, p_j=P(F_{K-1,\,n-K}>z_j^2/\hat\lambda).
- Genomik kontrol kapalıyken istatistik F dağılımının ölçeğine pay serbestlik derecesine bölünerek getirilir: F_j=z_j^2/(K-1)=\dfrac{F_{ST,j}/(K-1)}{(1-F_{ST,j})/(n-K)}, p_j=P(F_{K-1,\,n-K}>F_j).
Koddaki tercih
İki fonksiyon da LEA paketindendir (Frichot ve François, 2015). Genotipler geçici bir .geno dosyasına yazılır (her satır bir SNP, eksik hücre 9); LEA::snmf(K, entropy = TRUE, repetitions, seed, iterations, alpha, tolerance) çalıştırılır ve LEA::snmf.pvalues(ploidy = 2, genomic.control, lambda = K − 1) çağrılır (satır 495–507); tekrar sayısı birden büyükse çapraz entropisi en düşük çalıştırma seçilir. K: snmf_K ≥ 2 ise o; değilse popülasyon sütunu varsa popülasyon sayısı; yoksa pcadapt K'sı artı bir. sNMF'nin kendi tohumu vardır (snmf_tohum, varsayılan 1); sonuç arayüzün çalıştırma tohumundan bağımsızdır ve aynı ayarlarla her çalıştırmada aynıdır. Paketin z^2 tanımında (K-1)'e bölme yoktur; paket z^2'yi yalnız lambda bağımsız değişkenine böler. Genomik kontrol açıkken lambda veriden kestirilen \hat\lambda'dır ve (K-1) çarpanını içine alır. Genomik kontrol kapalıyken şablon lambda = K − 1 verir (507); böylece karşılaştırılan büyüklük F=z^2/(K-1) olur. Bu durumda bir şişme katsayısı kestirilmediği için özet tablosunun GIF hücresi boş bırakılır (508).
64.4.6 LFMM2: çevre ilişkilendirmesi
LFMM2 (Caye ve ark., 2019) genotipleri çevre değişkenleri ve K gizil etkenle açıklar:
- \mathbf Y: n\times L genotip matrisi (sütunları merkezlenmiş); \mathbf X: n\times d çevre değişkenleri (merkezlenmiş).
- \mathbf B: lokus başına çevre etkileri; \mathbf U (n\times K): gizil etken puanları; \mathbf V: yükleri. Gizil etkenler, çevreyle karışan popülasyon yapısını temsil eder.
- Kestirim, \mathbf B üzerinde ridge cezasıyla (\lambda) en küçük karelerdir ve kapalı biçimde, iki tekil değer ayrışımıyla çözülür.
Çözüm adımları: \mathbf X=\mathbf Q\boldsymbol\Sigma\mathbf R^{\top} ayrışımı alınır; \mathbf D_\lambda=\operatorname{diag}\big(\sqrt{\lambda/(\lambda+\sigma_1^2)},\dots,\sqrt{\lambda/(\lambda+\sigma_d^2)},1,\dots,1\big) kurulur; \mathbf D_\lambda\mathbf Q^{\top}\mathbf Y'nin ilk K tekil bileşeni alınır ve \hat{\mathbf U}=\mathbf Q\mathbf D_\lambda^{-1}\mathbf U_K\mathbf S_K bulunur. Test, gizil etkenler arındırıldıktan sonra çevre değişkenlerinin birlikte etkisidir:
- \mathrm{KT}_{0,j}: \hat{\mathbf U}'dan arındırılmış genotipin kareler toplamı; \mathrm{KT}_{1,j}: aynı artığın, \hat{\mathbf U}'dan arındırılmış çevre değişkenlerine regresyonundan kalan kareler toplamı.
- d: çevre değişkeni sayısı. Birden çok değişken seçildiğinde test tek tek değişkenleri değil, hepsini birden sınar.
Koddaki tercih
LEA::lfmm2(input, env, K, lambda) ve LEA::lfmm2.test(full = TRUE, genomic.control) (satır 526–527). K, pcadapt adımının K'sıdır (elle verilen ya da otomatik). Çevre değişkenleri ölçeklenmez, yalnız merkezlenir; ridge cezası çok küçük olduğundan (10^{-5}) ölçek sonucu pratikte etkilemez. Payda serbestlik derecesi n-d-1'dir; gizil etkenler için düşüm yapılmaz, bu fark genomik kontrolle birlikte ölçeklenir. Eksik genotipler lokus ortalamasının yuvarlanmışıyla doldurulur ve not yazılır.
64.4.7 Çoklu test: q değeri ve öteki düzeltmeler
Binlerce lokus sınandığında ailece hata oranı fazla tutucudur; alışılmış ölçüt yanlış keşif oranıdır (YKO). q değeri (Storey ve Tibshirani, 2003), bir lokus aykırı ilan edildiğinde beklenen yanlış keşif payıdır:
- \hat\pi_0: nötr lokusların kestirilen payı. p değerleri nötr lokuslarda tekdüze dağıldığından, büyük p'lerin yoğunluğu bu payı verir.
smootherseçeneğinde \hat\pi_0(\lambda), \lambda=0{,}05,\dots,0{,}95 için hesaplanır, 3 serbestlik dereceli düzgünleştirme eğrisiyle uydurulur ve eğrinin \lambda=0{,}95'teki değeri alınır (1'i aşarsa 1). - p_{(1)}\le\dots\le p_{(L)}: sıralı p değerleri. \hat\pi_0=1 alınırsa formül Benjamini–Hochberg düzeltmesidir.
bootstrap seçeneği, adına karşın yeniden örnekleme yapmaz: her \lambda için kestirimin ortalama kare hatasını kapalı formülle hesaplar ve en küçük hatalı \hat\pi_0(\lambda)'yı seçer; sonuç tohuma bağlı değildir. Bir lokus q< alfa ise aykırıdır (varsayılan 0,1: aykırı listesinin beklenen yanlış payı %10). q değeri kestirilemezse şablon Benjamini–Hochberg'e geçer ve not yazar (satır 324–328). BH, BY, Holm ve Bonferroni p.adjust ile uygulanır. Düzeltme her yöntemin kendi p değerleri içinde yapılır; yöntemler arası birleşik düzeltme yoktur.
64.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–228 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, 25 parametre. | Form buradan kurulur (Bölüm 1.2). |
| 229–234 | .m(); ortak genotip ayrıştırıcısına bağlama (mq_genotip_eksik, mq_genotip). |
Ayrıştırıcı ortak katmandadır ve yalnız metin sütunlarda kullanılır; kuralı Bölüm 1.5'tedir. |
| 236–258 | Girdiler ve varsayılanlar; boş listede sayısal sütunların SNP sayılması. | Metin SNP sütunları boş listede seçilmez. |
| 260–319 | Popülasyonu eksik bireyler; kimlikler (mq_kimlik); genotip matrisi G; okuma dökümü (297); eksik, çok alelli, tek alelli, düşük frekanslı lokusların çıkarılması; hiçbir SNP'de genotipi olmayan birey denetimi (315–318); özet satırı. |
Her çıkarma için ayrı not. |
| 321–343 | duzelt() (q değeri ya da p.adjust); manhattan() çizim yardımcısı. |
q değeri yalnız eksik olmayan p'lerden kestirilir. |
| 345–357 | Yönteme göre adım bayrakları; popülasyon ya da çevre yoksa atlama ya da hata. | "Hepsi" seçiliyken popülasyon yoksa FST adımı notla, çevre yoksa LFMM2 adımı not yazılmadan atlanır; tek yöntem seçiliyken hata verir. |
| 359–384 | K seçimi: K_en_cok bileşenli pcadapt, otomatik kural, tarama grafiği. |
Yalnız K kullanan yöntemlerde çalışır (365); eksik hücreler NA olarak verilir (367). |
| 386–426 | pcadapt testi (Mahalanobis ya da bileşen başına; bileşen başına p şablonda hesaplanır, 383–390), Manhattan ve puan grafikleri. | Puan grafiği yalnız K\ge2'de; Manhattan yalnız Mahalanobis'te. |
| 428–489 | wc_lokus(); \bar F; Lewontin–Krakauer; deneysel zarf; FST tablosu ve grafiği. |
Bir lokusta 2'den az bireyi kalan popülasyon o lokusta dışarıda tutulur (439). |
| 491–513 | sNMF: .geno dosyası, snmf, snmf.pvalues, Manhattan. |
Geçici klasörde çalışır; genomik kontrol kapalıyken lambda = K − 1 (507). |
| 515–532 | LFMM2: çevre değerleri (mq_sayisal) ve denetimleri, eksik doldurma, lfmm2, lfmm2.test, Manhattan. |
Çevrede eksik değer kabul edilmez. |
| 534–550 | Özet tablosu; aykırı lokuslar (en çok 200 satır, ilk yöntemin p'sine göre sıralı); zarf notu; lokus başına tablo. | Aykırı birleşimi yalnız _aykiri sütunlarıdır (537–538); zarf99_disi birleşime girmez, sayısı notla yazılır (545–548). |
64.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/aykiri_lokus/elle_hesap.py ile, pcadapt, bigutilsr, qvalue, hierfstat ve LEA kullanılmadan hesaplanmıştır: tam SVD, regresyon z-skorları, OGK kovaryansı, Weir–Cockerham bileşenleri, q değeri ve LFMM2 çözümü doğrudan formülden yazılmıştır. R tarafında (r_dogrulama.R) taban svd, hierfstat::wc, bigutilsr::dist_ogk ve elle kurulan q değeri kullanılmıştır.
Adım 1 — K'nın seçimi. İlk beş bileşenin varyans payı 0{,}05391; 0{,}02263; 0{,}01062; 0{,}01056; 0{,}01035'tir. İlk 20 bileşenin ikinci yarısının (10.–20.) ortancası 0{,}009293, eşik 1{,}5\cdot0{,}009293=0{,}013940. İlk iki pay eşiği aşar, üçüncüsü aşmaz: K_{\text{oto}}=2. Üç popülasyon iki bileşenle ayrılır.
Adım 2 — Bir lokusun pcadapt istatistiği (snp0081). z-skorları \boldsymbol\zeta=(-1{,}1936;\ -12{,}3142): lokus ikinci bileşenle çok güçlü ilişkilidir. Sağlam Mahalanobis uzaklığı D^2=84{,}4421.
Adım 3 — GIF ve p. 1500 lokusun D^2 ortancasının \chi^2_{2;\,0{,}5}=1{,}3863'e oranı \hat\lambda=1{,}442173'tür.
(İki serbestlik dereceli ki-karede P(\chi^2_2>x)=e^{-x/2}.)
Adım 4 — q değeri. pcadapt p değerlerinden \hat\pi_0=0{,}9030 kestirilir: lokusların yaklaşık %90'ı nötr sayılır. snp0081 en küçük p'ye sahiptir; q=\hat\pi_0\cdot1500\cdot p/1=2{,}614\times10^{-10}. q<0{,}1 olan 154 lokus vardır.
Adım 5 — Aynı lokusun Weir–Cockerham \theta'sı. Üç popülasyonda n_i=50; \hat p=(0{,}72;\ 0{,}90;\ 0{,}24); \hat h=(0{,}40;\ 0{,}20;\ 0{,}44).
Adım 6 — \bar F ve Lewontin–Krakauer. Bütün lokuslarda H_e\ge0{,}1'dir. 1500 \hat\theta'nın %5 ve %95 kantilleri -0{,}008223 ve 0{,}240292; arada kalan 1350 lokusun ortalaması \bar F=0{,}0327604 (budamasız ortalama 0{,}044907).
Lewontin–Krakauer p değerlerinde \hat\pi_0 eğrisi 1'i aşar ve 1'e kırpılır; q değeri bu durumda Benjamini–Hochberg düzeltmesine eşittir. snp0081 için q=5{,}538\times10^{-4}; q<0{,}1 olan 141 lokus vardır. Zarfın dışında 20 lokus kalır.
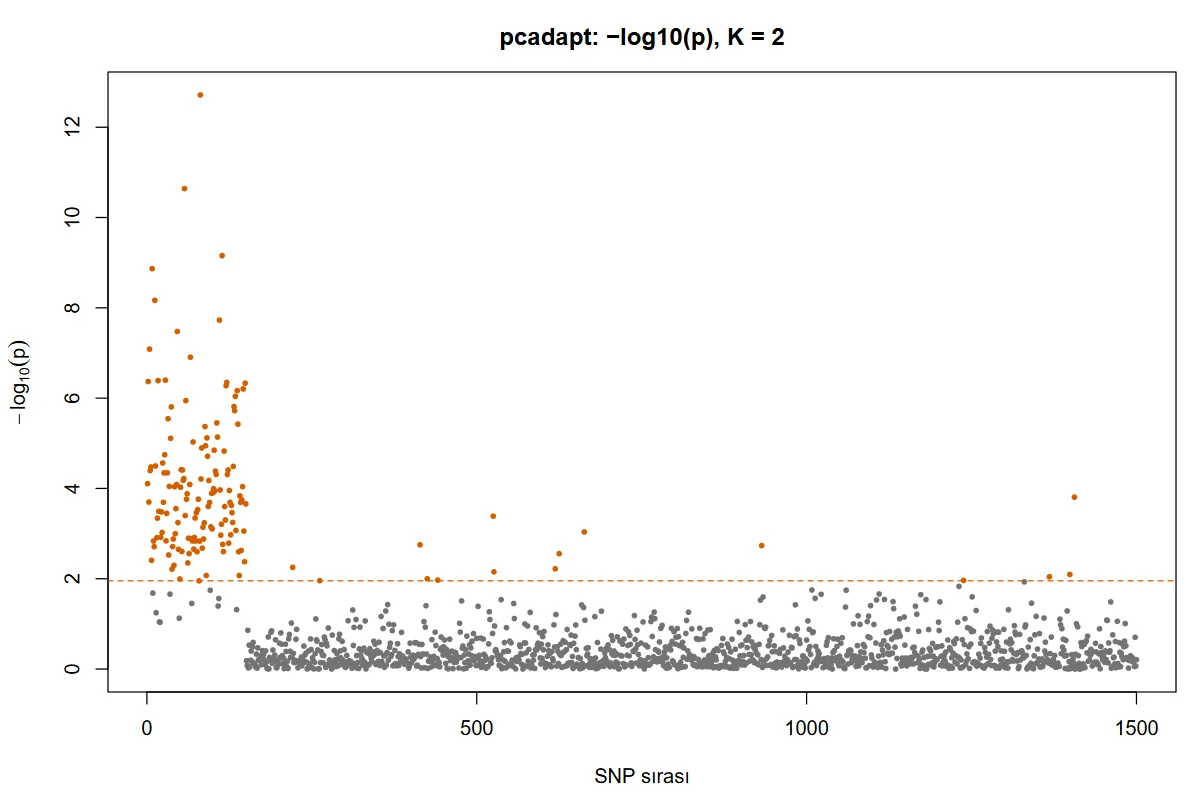
Adım 7 — Yöntemlerin örtüşmesi. 140 lokus iki yöntemde de aykırıdır; 14'ü yalnız pcadapt'ta, 1'i yalnız Lewontin–Krakauer'de. Aykırıların büyük bölümü ilk 150 SNP'dedir (pcadapt 139, Lewontin–Krakauer 129); benzetimde seçilim altındaki lokuslar bunlardır. Bonferroni düzeltmesi ve 0,05 eşiğiyle sayılar 39 ve 23'e iner.
Adım 8 — Ek veride LFMM2 ve sNMF. 300 SNP ve iki çevre değişkeniyle: LFMM2 (K=2, d=2) \hat\lambda=1{,}4561; sNMF (K=3) \hat\lambda=19{,}587. İkinci değer, \hat\lambda'nın (K-1)=2 çarpanını içermesini ve bu alt veride lokusların yarısının seçilim altında olmasını birlikte yansıtır (64.9 S7, S8). Genomik kontrol kapatıldığında istatistik F=z^2/2'dir ve F_{2,\,147} ile karşılaştırılır: snp0150 için p=1{,}133\times10^{-6} (genomik kontrolle 0{,}2186); Benjamini–Hochberg düzeltmesiyle 300 lokusun 172'si eşiğin altında kalır.
Adım 9 — Bileşen başına test. Örnek veride K=2 z-skorlarının karelerinin ortancaları \chi^2_{1;\,0{,}5}=0{,}4549'a bölünür: \hat\lambda_1=5{,}9402, \hat\lambda_2=2{,}7318. snp0081 için \zeta=(-1{,}1936;\ -12{,}3142):
İki bileşenin q değerlerinden en az biri 0,1'in altında olan 134 lokus vardır.
Adım 10 — Eksik genotipli veri. al_eksik8.csv verisinde (8 eksik hücre) şablon pcadapt GIF'ini 1{,}470566 verir. Aynı veri pakete, paketin belgelediği dosya yoluyla (eksik hücrenin 9 ile gösterildiği LFMM dosyası) verildiğinde GIF yine 1{,}470566'dır ve 300 lokusun p değerleri iki yolda birebir aynıdır; eksik hücre içeren ilk lokusun (15.) alel frekansı, genotipi olan 149 bireyden elle hesaplanan 0{,}694631 değerine eşittir (dogrulama/aykiri_lokus/eksik_dosya_yolu.R). Hücrelerin %2'si eksik olan al_karma.csv verisinde çalıştırma tamamlanır: 148 birey, 120 SNP, K=2, GIF 1{,}3868.
64.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1–5, 7, 8; karşılaştırma dogrulama/hardy_weinberg/karsilastir_k3.py). sNMF satırlarında ayrışımın kendisi yeniden yazılmamış, aynı tohum ve ayarlarla LEA::snmf ayrıca çalıştırılıp test istatistiği \mathbf Q ve \mathbf G matrislerinden elle hesaplanmıştır; öteki bütün satırlar şablonun çağırdığı fonksiyonlar kullanılmadan elde edilmiştir.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Otomatik K | 2 | 2 | — | 0 | ✓ |
| pcadapt GIF (K=2) | 1,44217313 | 1,44217313 | 1,44217313 | 6,9e−15 | ✓ |
| snp0081: Mahalanobis D^2 | 84,44206461 | 84,44206461 | 84,44206461 | 1,2e−15 | ✓ |
| snp0081: pcadapt p | 1,930204·10−13 | 1,930204·10−13 | 1,930204·10−13 | 1,8e−26 | ✓ |
| snp0081: pcadapt q | 2,614366·10−10 | 2,614396·10−10 | 2,614366·10−10 | 3,0e−15 | ✓ |
| snp0081: WC \theta | 0,41889292 | 0,41889292 | 0,41889292 | 0 | ✓ |
| snp0081: T_{LK} | 25,57313097 | 25,57313097 | 25,57313097 | 1,1e−15 | ✓ |
| snp0081: LK p | 2,798112·10−6 | 2,798112·10−6 | 2,798112·10−6 | 3,0e−21 | ✓ |
| snp0081: LK q | 5,538169·10−4 | 5,538169·10−4 | 5,538169·10−4 | 4,7e−17 | ✓ |
| snp0057: Mahalanobis D^2 | 70,6659648 | 70,6659648 | 70,6659648 | 2,0e−16 | ✓ |
| snp0057: pcadapt p | 2,290146·10−11 | 2,290146·10−11 | 2,290146·10−11 | 1,5e−24 | ✓ |
| snp0057: pcadapt q | 1,550945·10−8 | 1,550963·10−8 | 1,550945·10−8 | 1,8e−13 | ✓ |
| snp0057: WC \theta | 0,54683702 | 0,54683702 | 0,54683702 | 3,3e−16 | ✓ |
| snp0057: T_{LK} | 33,38403191 | 33,38403191 | 33,38403191 | 4,3e−16 | ✓ |
| snp0057: LK p | 5,633127·10−8 | 5,633127·10−8 | 5,633127·10−8 | 2,5e−22 | ✓ |
| snp0057: LK q | 8,449691·10−5 | 8,449691·10−5 | 8,449691·10−5 | 3,3e−19 | ✓ |
| snp0009: Mahalanobis D^2 | 11,17249904 | 11,17249904 | 11,17249904 | 1,7e−15 | ✓ |
| snp0009: pcadapt p | 0,02078561 | 0,02078561 | 0,02078561 | 1,7e−16 | ✓ |
| snp0009: pcadapt q | 0,17595675 | 0,17595877 | 0,17595675 | 2,0e−6 | ✗ |
| snp0009: WC \theta | 0,14420713 | 0,14420713 | 0,14420713 | 2,8e−16 | ✓ |
| snp0009: T_{LK} | 8,803748 | 8,803748 | 8,803748 | 2,0e−16 | ✓ |
| snp0009: LK p | 0,01225435 | 0,01225435 | 0,01225435 | 1,2e−17 | ✓ |
| snp0009: LK q | 0,12419953 | 0,12419953 | 0,12419953 | 1,0e−15 | ✓ |
| pcadapt aykırı lokus sayısı (q<0{,}1) | 154 | 154 | 154 | 0 | ✓ |
| Genel ortalama F_{ST} | 0,04490694 | 0,04490694 | 0,04490694 | 6,9e−18 | ✓ |
| \bar F için lokus sayısı | 1350 | 1350 | 1350 | 0 | ✓ |
| Budanmış ortalama \bar F | 0,03276039 | 0,03276039 | 0,03276039 | 3,5e−17 | ✓ |
| LK aykırı lokus sayısı (q<0{,}1) | 141 | 141 | 141 | 0 | ✓ |
| %99 zarf dışındaki lokus sayısı | 20 | 20 | 20 | 0 | ✓ |
| Bonferroni, \alpha=0{,}05: pcadapt aykırı | 39 | 39 | — | 0 | ✓ |
| Bonferroni, \alpha=0{,}05: LK aykırı | 23 | 23 | — | 0 | ✓ |
| BH: snp0009 LK düzeltilmiş p | 0,12419953 | 0,12419953 | 0,12419953 | 1,0e−15 | ✓ |
| pcadapt GIF (K=1) | 5,67205896 | 5,67205896 | 5,67205896 | 2,8e−15 | ✓ |
| Bileşen başına, snp0081: p (PC1) | 0,62432302 | 0,62432302 | 0,62432302 | 4,8e−14 | ✓ |
| Bileşen başına, snp0081: p (PC2) | 9,308834·10−14 | 9,308834·10−14 | 9,308834·10−14 | 5,7e−26 | ✓ |
| Bileşen başına, snp0082: p (PC1) | 0,07537071 | 0,07537071 | 0,07537071 | 2,9e−15 | ✓ |
| Bileşen başına, snp0082: p (PC2) | 2,174298·10−4 | 2,174298·10−4 | 2,174298·10−4 | 1,5e−17 | ✓ |
| Bileşen başına: ortanca p (PC1) | 0,50000003 | 0,50000003 | 0,50000003 | 2,2e−16 | ✓ |
| Bileşen başına: ortanca p (PC2) | 0,50000001 | 0,50000001 | 0,50000001 | 1,1e−16 | ✓ |
| Bileşen başına: ortalama p (PC1) | 0,49006057 | 0,49006057 | 0,49006057 | 2,8e−15 | ✓ |
| Bileşen başına: ortalama p (PC2) | 0,4944847 | 0,4944847 | 0,4944847 | 2,4e−15 | ✓ |
| Bileşen başına: aykırı lokus sayısı (q<0{,}1) | 134 | 134 | — | 0 | ✓ |
| Ek veri: pcadapt GIF | 1,45970482 | 1,45970482 | — | 0 | ✓ |
| Ek veri: budanmış ortalama \bar F | 0,12313388 | 0,12313388 | — | 1,7e−16 | ✓ |
| LFMM2 (2 çevre değişkeni): GIF | 1,45612699 | 1,45612699 | 1,45612699 | 5,3e−11 | ✓ |
| LFMM2, snp0001: p | 0,73258251 | 0,73258251 | 0,73258251 | 4,7e−11 | ✓ |
| LFMM2, snp0150: p | 0,87850509 | 0,87850509 | 0,87850509 | 3,4e−11 | ✓ |
| LFMM2, GIF düzeltmesiz, snp0001: p | 0,63592144 | 0,63592144 | 0,63592144 | 7,4e−11 | ✓ |
| LFMM2 (1 çevre değişkeni): GIF | 1,79249168 | 1,79249168 | 1,79249168 | 1,3e−11 | ✓ |
| sNMF (K=3): GIF | 19,58724992 | 19,58724992 | 19,58724992 | 1,5e−14 | ✓ |
| sNMF, snp0001: p | 0,09917467 | 0,09917467 | 0,09917467 | 4,6e−15 | ✓ |
| sNMF, snp0150: p | 0,21855165 | 0,21855165 | 0,21855165 | 5,9e−15 | ✓ |
| sNMF, genomik kontrolsüz, snp0001: p | 2,052209·10−9 | 2,052209·10−9 | 2,052209·10−9 | 1,2e−23 | ✓ |
| sNMF, genomik kontrolsüz, snp0150: p | 1,133061·10−6 | 1,133061·10−6 | 1,133061·10−6 | 1,3e−20 | ✓ |
| sNMF, genomik kontrolsüz: aykırı lokus sayısı (BH <0{,}1) | 172 | 172 | 172 | 0 | ✓ |
Ölçütü karşılayan: 54/55. Python: tam SVD, z-skorları, OGK sağlam Mahalanobis uzaklığı, Weir–Cockerham \theta, Lewontin–Krakauer testi, q değeri, LFMM2 çözümü ve tam model F testi numpy/scipy ile elle. R: taban svd, lm.fit, bigutilsr::dist_ogk, hierfstat::wc, smooth.spline ile elle q değeri, QR ile elle LFMM2. sNMF kestirimi yeniden yazılmamış, aynı tohumla LEA::snmf yeniden çalıştırılmış ve test istatistiği Q ve G matrislerinden elle hesaplanmıştır. Bütün lokuslar üzerinde en büyük fark: Mahalanobis D^2 2,0·10−14, pcadapt p 5,9·10−15, \theta 1,0·10−15, LK p 1,0·10−15, LFMM2 p 1,3·10−10, sNMF p 1,2·10−14, bileşen başına p 8,4·10−14. Çok küçük p değerleri mutlak farkla ayırt edilemediğinden iki dizi ayrıca \log_{10}p üzerinden karşılaştırılmıştır: bileşen başına p değerlerinde (iki bileşen, 1500 lokus) en büyük fark 2,6·10−13, genomik kontrolsüz sNMF p değerlerinde (300 lokus) 2,5·10−13. pcadapt q değerinde R 9,0·10−15, Python 1,0·10−05 (Python, \pi_0 eğrisini tam 3 serbestlik derecesiyle çözer; smooth.spline aynı dereceyi sayısal aramayla, 10^{-5} düzeyinde bir farkla tutturur).
Ölçütü karşılamayan tek satır bir q değeridir ve fark \hat\pi_0'ın kestiriminden gelir: smooth.spline 3 serbestlik derecesini sayısal aramayla, küçük bir toleransla tutturur (\hat\pi_0=0{,}902967); Python hesabı aynı eğriyi tam 3 dereceyle çözer (0{,}902977). p değerleri ve aykırı lokus sayıları aynıdır. "Bileşen başına" satırlarında bağımsız hesap 64.4.3'teki tanımdır: z-skorları taban SVD ve regresyonla yeniden kurulmuş, her bileşen kendi genomik şişme katsayısına bölünmüştür. "Genomik kontrolsüz" sNMF satırlarında bağımsız hesap F=z^2/(K-1) tanımıdır.
64.7 Çıktıyı okuma
Örnek ayarın konsol metni:
Aykırı lokus taraması: 150 birey, 1500 SNP (eksik genotip oranı 0,000)
Not: 20 lokus %99 deneysel zarfın dışında (zarf99_disi sütunu). Zarf
lokusların kendi FST dağılımının kantilidir; tanım gereği lokusların
yaklaşık %1'i dışarıda kalır. Betimseldir, test değildir ve aykırı lokus
tablosuna alınmaz.
(Not tek satırdır; burada sayfaya sığması için bölünmüştür.) "Özet" ve "FST aykırılığı" tabloları:
adim                       K  K_otomatik     GIF  sinanan  aykiri
K seçimi                   2           2     NaN     1500     NaN
pcadapt (Mahalanobis)      2         NaN  1.4422     1500     154
FST (Lewontin–Krakauer)  NaN         NaN     NaN     1500     141

olcu                                                       deger
Popülasyon sayısı                                         3.0000
Serbestlik derecesi d                                     2.0000
Genel ortalama FST (lokus ortalaması)                     0.0449
F̄ için kullanılan lokus (He eşiği ve budama sonrası)   1350.0000
Budanmış ortalama F̄                                      0.0328
LK aykırı lokus (düzeltilmiş < alfa)                    141.0000
%99 deneysel zarf dışındaki lokus                        20.0000
"Aykırı lokuslar" tablosunun ilk satırları (155 satır: iki testten en az birinde aykırı olan lokuslar; pcadapt_p'ye göre sıralı; sütunların bir bölümü; üç lokusta da pcadapt_aykiri, LK_aykiri ve zarf99_disi işaretlidir):
lokus    pcadapt_istatistik  pcadapt_p  pcadapt_q     He  FST_WC    T_LK       p_LK       q_LK
snp0081              84.442  1.930e-13  2.614e-10  0.471  0.4189  25.573  2.798e-06  5.538e-04
snp0057              70.666  2.290e-11  1.551e-08  0.491  0.5468  33.384  5.633e-08  8.450e-05
snp0114              60.803  6.997e-10  3.159e-07  0.442  0.3533  21.569  2.072e-05  1.700e-03
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Konsol satırı | Süzgeçlerden sonraki birey ve SNP sayısı, eksik genotip oranı | Çıkarılan lokuslar üstündeki notlarda. |
K, K_otomatik |
Kullanılan ve kuralın önerdiği K | Elle K verildiyse ikisi farklı olabilir; tarama grafiğiyle karşılaştırılır. |
GIF |
Genomik şişme katsayısı | 1'e yakın: istatistik beklenen dağılıma uyuyor. Büyük değer: K yetersiz, yapı arındırılmamış ya da aykırılar çoğunlukta. Bileşen başına testte (katsayılar notta yazılır) ve genomik kontrolü kapatılmış sNMF ve LFMM2 adımlarında boştur. |
sinanan, aykiri |
p'si hesaplanan lokus sayısı; düzeltilmiş p< alfa olanlar |
Eşik ve düzeltme tablo başlığındadır. |
| "Genel ortalama FST (lokus ortalaması)" | \hat\theta_j'lerin yalın ortalaması | Çok lokuslu Weir–Cockerham kestirimi değildir (o, a ve a+b+c toplamlarının oranıdır; örnek veride 0,0460). |
pcadapt_istatistik |
GIF'e bölünmemiş D^2 | p için GIF'e bölünür. |
pcadapt_p, pcadapt_q |
Ham ve düzeltilmiş p | Sütun adı _q olsa da seçilen düzeltmeyi taşır (BH, Holm …). |
He, FST_WC, T_LK, p_LK, q_LK |
2\bar p(1-\bar p), \hat\theta, T, ham ve düzeltilmiş p | Negatif \hat\theta sıfır farklılaşma demektir. |
*_aykiri |
Yöntemin kararı | Yöntemler farklı varsayımlara dayanır; birden çok yöntemde aykırı olan lokus daha güçlü adaydır. |
zarf99_disi |
Kendi H_e diliminin %99 kantilini aşan lokus | Betimseldir; her zaman lokusların yaklaşık %1'i. "Aykırı lokuslar" tablosuna girişi belirlemez; sayısı ayrı notla yazılır. |
p_PC1, q_PC1, … |
Bileşen başına testte her bileşenin ham ve düzeltilmiş p değeri | Hangi bileşenin lokusu öne çıkardığını gösterir; pcadapt_aykiri bileşenlerden herhangi birindeki karardır. |
snmf_p, lfmm2_p ve _q |
sNMF ve LFMM2'nin p ve düzeltilmiş p değerleri | LFMM2 çevreyle ilişkiyi sınar; ötekiler farklılaşmayı. |
Ek veride (çalıştırma 7) dört yöntemin hiçbiri aykırı lokus bulmaz:
adim                                K  K_otomatik      GIF  sinanan  aykiri
K seçimi                            2           2      NaN      300     NaN
pcadapt (Mahalanobis)               2         NaN   1.4597      300       0
FST (Lewontin–Krakauer)           NaN         NaN      NaN      300       0
sNMF (K = 3)                        3         NaN  19.5872      300       0
LFMM2 (K = 2, 2 çevre değişkeni)    2         NaN   1.4561      300       0
Bu alt veri örnek verinin ilk 300 SNP'sidir ve yarısı seçilim altındaki lokuslardır. "Olağan" düzey bu lokuslarla birlikte kestirildiği için tipik değerler büyür (genel ortalama F_{ST} 0,132; \bar F 0,123) ve hiçbir lokus öne çıkamaz. Bu çalıştırmada "Aykırı lokuslar" tablosu üretilmez; konsola "Seçilen eşikte aykırı lokus bulunmadı." ve ardından "Not: 10 lokus %99 deneysel zarfın dışında …" satırları yazılır. Zarfın dışındaki 10 lokus lokus başına tabloda zarf99_disi sütunundan izlenir.
Bileşen başına testin (çalıştırma 2) notu (tek satırdır), p değeri özeti ve özet tablosu:
Not: bileşen başına p değerleri z-skorlarından şablonda hesaplandı; her
bileşen kendi genomik şişme katsayısına bölündü (GIF: PC1 = 5,9402;
PC2 = 2,7318).

bilesen   en_kucuk      Q1  ortanca  ortalama      Q3  en_buyuk     n
PC1      4.607e-11  0.2375   0.5000    0.4901  0.7436    0.9999  1500
PC2      9.309e-14  0.2492   0.5000    0.4945  0.7534    0.9993  1500

adim                      K  K_otomatik  GIF  sinanan  aykiri
K seçimi                  2           2  NaN     1500     NaN
pcadapt (bileşen başına)  2         NaN  NaN     1500     134
"Yalnız FST" seçiminde (çalıştırma 4) özet tablosu tek satırdır; "K seçimi" satırı ve tarama grafiği yoktur:
adim                       K  K_otomatik  GIF  sinanan  aykiri
FST (Lewontin–Krakauer)  NaN         NaN  NaN     1500     141
Şekil 64.1. Şablonun tarama grafiği (örnek veri). Halka seçilen K=2'yi, noktalı çizgi otomatik kuralın eşiğini (1{,}5\times0{,}00929=0{,}0139) gösterir. Dikey eksen bileşenin toplam varyans içindeki payıdır (\pi_k): ilk iki bileşen 0,0539 ve 0,0226.
Şekil 64.2. pcadapt Manhattan grafiği (örnek veri, K=2). Turuncu noktalar q<0{,}1 olan 154 lokustur; kesikli çizgi aykırı lokusların en küçük -\log_{10}p değeridir. Yatay eksen sütun sırasıdır, kromozom konumu değildir.
Şekil 64.3. F_{ST}–heterozigotluk grafiği (örnek veri). Mavi çizgiler %95 (kesikli) ve %99 deneysel zarf; turuncu noktalar Lewontin–Krakauer aykırı lokusları; noktalı çizgi testin Bonferroni sınırıdır.
Rapor cümlesi (örnek ayar):
Seçilim izi taşıyan lokuslar iki yöntemle tarandı (n = 150 birey, 3 popülasyon, 1500 SNP; küçük alel frekansı eşiği 0,05). Temel bileşenlere dayalı taramada (pcadapt, K = 2, sağlam Mahalanobis uzaklığı, genomik şişme katsayısı 1,44) 154 lokus, Weir–Cockerham F_{ST} değerlerine uygulanan Lewontin–Krakauer testinde (budanmış ortalama \bar F = 0{,}033) 141 lokus aykırı bulundu (q < 0{,}10); 140 lokus iki yöntemde ortaktı. En güçlü sinyal snp0081 lokusundaydı (F_{ST} = 0{,}42; pcadapt q = 2{,}6 \times 10^{-10}).
64.8 Sık hatalar ve tuzaklar
- Eksik genotip oranına bakmadan yöntemleri karşılaştırmak. Dört adım eksik hücreyi farklı ele alır: pcadapt eksiği eksik olarak alır, FST adımı o lokusta eksik bireyi atar, sNMF hücreyi maskeler, LFMM2 lokus ortalamasının yuvarlanmışıyla doldurur (64.2). Eksik oranı düşükken fark önemsizdir; oran yükseldikçe yöntemler aynı veriyi sınamaz ve doldurma LFMM2'de ilişkileri zayıflatır. Konsoldaki "eksik genotip oranı" raporlanır; eksiği çok olan lokus ve bireyler taramadan önce ayıklanır. Kalan SNP'lerin hiçbirinde genotipi olmayan birey çalıştırmayı durdurur; ileti örnek kimlikleri verir.
- Metin genotipte "0"ı alel adı olarak kullanmak.
0,00,000ve-9eksik kodudur.0/1gibi yalnız bir aleli eksik kodu olan genotip çalıştırmayı durdurur; alel yeniden kodlanır (0 → A, 1 → B) ya da sütun 0/1/2 sayısal biçimine çevrilir (Bölüm 1.5). - SNP listesini boş bırakıp sayısal ek sütun taşımak. Fenotip, koordinat ya da çevre sütunu çevre alanına konmamışsa SNP sayılır ve "0/1/2 dışında değer var" hatası verir. Tersine, metin (
A/G) kodlu SNP'ler boş listede hiç seçilmez ve not yazılmaz; metin genotipli veride sütunlar açıkça işaretlenir. - K'yı denetlemeden otomatik kurala bırakmak. Yanlış K her şeyi değiştirir: örnek veride K=1 ile GIF 5,67'ye çıkar ve aykırı lokus sayısı 80'e iner; ikinci bileşenin taşıdığı yapı testten çıkmıştır. Tarama ve puan grafikleri gözle denetlenir.
- Büyük GIF'i görmezden gelmek. GIF 1'den çok büyükse düzeltme p değerlerini kurtarır gibi görünür, ama asıl sorun (eksik K, akraba bireyler, karışık örnek) yerinde durur.
- Aykırıların çoğunlukta olduğu veri. Yöntemlerin hepsi "lokusların çoğu nötr" varsayar. Aday gen paneli ya da önceden seçilmiş SNP kümesi bu varsayımı bozar; ek verideki gibi hiçbir lokus aykırı çıkmaz. Tarama, genomu temsil eden bir SNP kümesiyle yapılır.
- Zarf dışındaki lokusları anlamlı saymak.
zarf99_disiher çalıştırmada lokusların yaklaşık %1'ini işaretler; konsoldaki "… lokus %99 deneysel zarfın dışında" notu bir bulgu değil, bu tanımın sonucudur. Karar*_aykirisütunlarına göre verilir; "Aykırı lokuslar" tablosu yalnız bu sütunlardan kurulur. - Lewontin–Krakauer testini hiyerarşik yapıda kullanmak. Test popülasyonların eşit ve bağımsız ayrıştığını varsayar. Bazı popülasyonlar birbirine ötekilerden yakınsa nötr F_{ST} dağılımı \chi^2_d'den geniştir ve yanlış aykırılar artar; pcadapt bu yapıya daha dayanıklıdır.
- Bileşen başına testte aykırı sayısını Mahalanobis sayısıyla karşılaştırmak. Bileşen başına seçenekte her bileşen ayrı düzeltilir ve lokus herhangi birinde eşiğin altındaysa aykırı sayılır; K arttıkça yapılan test sayısı da artar. Örnek veride sayılar 134 (bileşen başına) ve 154'tür (Mahalanobis); iki liste aynı soruyu yanıtlamaz. Tarama için Mahalanobis, bir lokusu hangi bileşenin ayırdığını görmek için bileşen başına seçenek kullanılır.
- sNMF ya da LFMM2'de genomik kontrolü kapatmak. Kapalıyken istatistik kuramsal F dağılımıyla doğrudan karşılaştırılır; dağılım veriye uymuyorsa (artık yapı, bağımlı lokuslar, aykırıların çokluğu) p değerleri küçülür. Ek veride sNMF adımında 300 lokusun 172'si aykırı çıkar (açıkken 0). Seçenekler, kuramsal dağılımın geçerli olduğuna ilişkin ayrı bir kanıt yoksa açık bırakılır.
- LFMM2'de birden çok çevre değişkenini tek tek yorumlamak. Test bütün değişkenlerin ortak etkisidir. Tek değişkenin etkisi için şablon o değişkenle ayrıca çalıştırılır.
- Aykırı lokusu "seçilim altında gen" diye raporlamak. Aykırılık bir adaylıktır: bağlantılı seçilim, düşük rekombinasyon, yapı artığı ve genotipleme hatası aynı izi bırakır. Yanlış keşif oranı 0,1 ise listedeki her on lokustan biri beklenen yanlıştır.
- Sütun sırasını kromozom sırası sanmak. LD budaması ve Manhattan ekseni sütun sırasını kullanır; sütunlar konuma göre dizilmemişse budama anlamsızdır.
64.9 Uzman soruları
S1. Genomik şişme katsayısı neden ortancadan hesaplanıyor ve 1,44 ne söylüyor?
Ortanca, aykırı lokuslardan etkilenmeyen bir konum ölçüsüdür: lokusların yarısından azı seçilim altındaysa istatistiklerin ortancası nötr lokuslarca belirlenir. Kuramsal ortancaya oranı, nötr dağılımın \chi^2_K'den ne kadar geniş olduğunu verir. 1,44, z-skorlarının beklenenden %44 daha yayvan olduğunu gösterir; nedeni iki bileşenin yakalamadığı artık yapı, lokuslar arası bağımlılık ve sağlam kovaryansın yalnız "iç" %83'ten (1250/1500 lokus) kestirilmesidir. Bölme, bu genişlemenin bütün lokuslarda aynı çarpanla etkilediğini varsayar; çarpan büyüdükçe varsayım zayıflar.
S2. pcadapt neden popülasyon etiketine gerek duymuyor ve bu bir üstünlük mü?
Temel bileşenler yapıyı veriden çıkarır; bir SNP'nin o bileşenlerle ilişkisi, bileşenin ayırdığı gruplar arasındaki frekans farkının ölçüsüdür. Etiketler yanlış ya da belirsizse (karışmış bireyler, sürekli yapı) bu bir üstünlüktür: test, bireylerin gerçek soy bileşimine göre kurulur. Bedeli K seçimidir ve bileşenlerin yapı dışındaki şeyleri (uzun LD blokları, parti etkisi) de yakalayabilmesidir; LD budaması ilki için vardır.
S3. Lewontin–Krakauer testine yöneltilen eleştiriler bu şablonda geçerli mi?
Evet. Nei ve Maruyama (1975) ile Robertson (1975), F_{ST}'nin nötr varyansının 2\bar F^2/d olmadığını, popülasyonlar ortak atadan farklı zamanlarda ayrıldığında ya da aralarında göç olduğunda varyansın büyüdüğünü gösterdi. Şablon d=r-1 alır ve bu etkiyi düzeltmez; OutFLANK d'yi budanmış dağılımdan kestirerek kısmen düzeltir. Bu yüzden yalnız Lewontin–Krakauer'de aykırı olan lokuslar temkinle, pcadapt ile ortak olanlar daha güvenle yorumlanır. Örnek veride (üç popülasyonun bağımsız ayrıştığı benzetim) iki yöntem 140 lokusta buluşur.
S4. Lewontin–Krakauer q değerleri neden Benjamini–Hochberg ile aynı çıkıyor?
q değeri BH'den yalnız \hat\pi_0 çarpanıyla ayrılır. Lewontin–Krakauer p değerlerinde negatif \hat\theta'lı 351 lokusun p'si tam 1'dir; büyük p'lerin yoğunluğu tekdüze beklentiyi aşar, \hat\pi_0 eğrisi 1'in üstüne çıkar ve 1'e kırpılır. pcadapt p değerlerinde böyle bir yığılma yoktur ve \hat\pi_0=0{,}903 bulunur; q değerleri BH'den %10 küçüktür. p=1'deki yığılma, T'nin negatif değerlerde kesilmesinin sonucudur ve testin kalibrasyonunu sınarken göz önünde tutulur.
S5. Otomatik K kuralı ne zaman yanılır?
Üç durumda. (1) K_en_cok küçükse "ikinci yarı" hâlâ yapı taşıyan bileşenleri içerir, taban yükselir ve K küçük çıkar; kural ayrıca en çok m-1 verir. (2) Yapı ayrık değil sürekliyse özdeğerler dirseksiz, yavaş azalır ve 1,5 kat eşiği keyfî bir yerde keser. (3) Birey sayısı SNP sayısına yakınsa gürültü özdeğerleri de eşit olmayan bir dağılım izler ve ilk gürültü bileşeni tabanın 1,5 katını aşabilir. Kural tarama grafiğinin okunmasını kolaylaştırır; karar puan grafiğiyle ve popülasyon bilgisiyle birlikte verilir.
S6. Aynı lokus pcadapt'ta aykırı, Lewontin–Krakauer'de değilse hangisine güvenilir?
İki test farklı büyüklükleri sınar. pcadapt, lokusun ilk K bileşenin herhangi bir doğrultusundaki ilişkisini ölçer ve tek bir popülasyonun ayrıştığı lokusları iyi yakalar. \hat\theta bütün popülasyonlar arasındaki ortalama farklılaşmadır; yalnız bir popülasyonda frekansı değişen lokusta daha küçük kalır. Örnek veride 14 lokus yalnız pcadapt'ta, 1 lokus yalnız Lewontin–Krakauer'de aykırıdır. Uyuşmazlıkta lokusun popülasyon başına alel frekanslarına ve puan grafiğine bakılır; güçlü aday listesi iki yöntemin kesişimidir.
S7. sNMF adımında GIF neden 19,6 gibi büyük bir değer?
İki nedenle. Paket, F dağılımıyla karşılaştırdığı istatistiği F_{ST}(n-K)/(1-F_{ST}) olarak tanımlar; F_{K-1,\,n-K} için gereken (K-1)'e bölme yoktur, bu çarpan (K=3'te 2) GIF'e yansır. Geri kalan şişme verinin kendisinden gelir: ek verinin 300 lokusunun yarısı seçilim altındadır ve ortanca nötr düzeyi temsil etmez. Genomik kontrol açıkken p değerleri ortancaya göre ölçeklenir ve hiçbir lokus aykırı çıkmaz. Kapalıyken şablon istatistiği (K-1)'e bölerek F ölçeğine getirir ve kuramsal F_{2,\,147} dağılımıyla karşılaştırır: 172 lokus aykırı görünür. İki sonuç arasındaki uçurum, bu alt veride "lokusların çoğu nötr" varsayımının tutmadığını gösterir; ne ortanca nötr düzeyi ne de kuramsal dağılım gerçek nötr dağılımı temsil eder.
S8. LFMM2 neden ek veride çevreyle ilişkili lokus bulamıyor, oysa `env1` popülasyona bağlı?
Tam da bu yüzden. env1 popülasyon ortalamalarıyla birlikte değişir; popülasyon yapısı iki gizil etkenle modelden arındırıldığında çevre değişkeninin lokuslarla ilişkisinin büyük bölümü de gider. LFMM, çevre ile yapının karıştığı tasarımlarda yapıyı öncelikli sayar: bu, yanlış pozitifleri azaltır ama çevresel eğim yapının eksenine paralelse gücü düşürür. env2 saf gürültüdür ve hiçbir ilişki beklenmez. Çevresel ilişkilendirme, çevrenin yapıyla tam örtüşmediği (aynı popülasyon içinde çevre farkı olan) örneklemelerde bilgi verir.
S9. Eşik neden 0,05 değil 0,1 ve q değeri ile düzeltilmiş p aynı şey mi?
q değeri bir yanlış keşif oranıdır: "q<0{,}1 olan lokusların beklenen %10'u yanlıştır". Tarama çalışmalarında amaç aday listesi çıkarmaktır ve %10 yanlış pay yaygın bir seçimdir; ailece hata oranı için 0,05 alışkanlığı buraya taşınmaz. Holm ve Bonferroni seçilirse sütun adı yine _q kalır, ama içerik ailece hata oranını denetleyen düzeltilmiş p'dir; örnek veride Bonferroni ve 0,05 ile aykırı sayısı 154'ten 39'a iner. Raporda hangi ölçütün kullanıldığı açıkça yazılır.
64.10 Kaynaklar
- Beaumont, M. A., & Nichols, R. A. (1996). Evaluating loci for use in the genetic analysis of population structure. Proceedings of the Royal Society B, 263(1377), 1619–1626. https://doi.org/10.1098/rspb.1996.0237
- Caye, K., Jumentier, B., Lepeule, J., & François, O. (2019). LFMM 2: Fast and accurate inference of gene-environment associations in genome-wide studies. Molecular Biology and Evolution, 36(4), 852–860. https://doi.org/10.1093/molbev/msz008
- Cattell, R. B. (1966). The scree test for the number of factors. Multivariate Behavioral Research, 1(2), 245–276. https://doi.org/10.1207/s15327906mbr0102_10
- Devlin, B., & Roeder, K. (1999). Genomic control for association studies. Biometrics, 55(4), 997–1004. https://doi.org/10.1111/j.0006-341X.1999.00997.x
- Duforet-Frebourg, N., Luu, K., Laval, G., Bazin, E., & Blum, M. G. B. (2016). Detecting genomic signatures of natural selection with principal component analysis: Application to the 1000 Genomes data. Molecular Biology and Evolution, 33(4), 1082–1093. https://doi.org/10.1093/molbev/msv334
- Flanagan, S. P., & Jones, A. G. (2017). Constraints on the FST–heterozygosity outlier approach. Journal of Heredity, 108(5), 561–573. https://doi.org/10.1093/jhered/esx048
- François, O., Martins, H., Caye, K., & Schoville, S. D. (2016). Controlling false discoveries in genome scans for selection. Molecular Ecology, 25(2), 454–469. https://doi.org/10.1111/mec.13513
- Frichot, E., & François, O. (2015). LEA: An R package for landscape and ecological association studies. Methods in Ecology and Evolution, 6(8), 925–929. https://doi.org/10.1111/2041-210X.12382
- Frichot, E., Mathieu, F., Trouillon, T., Bouchard, G., & François, O. (2014). Fast and efficient estimation of individual ancestry coefficients. Genetics, 196(4), 973–983. https://doi.org/10.1534/genetics.113.160572
- Lewontin, R. C., & Krakauer, J. (1973). Distribution of gene frequency as a test of the theory of the selective neutrality of polymorphisms. Genetics, 74(1), 175–195. https://doi.org/10.1093/genetics/74.1.175
- Luu, K., Bazin, E., & Blum, M. G. B. (2017). pcadapt: An R package to perform genome scans for selection based on principal component analysis. Molecular Ecology Resources, 17(1), 67–77. https://doi.org/10.1111/1755-0998.12592
- Maronna, R. A., & Zamar, R. H. (2002). Robust estimates of location and dispersion for high-dimensional datasets. Technometrics, 44(4), 307–317. https://doi.org/10.1198/004017002188618509
- Martins, H., Caye, K., Luu, K., Blum, M. G. B., & François, O. (2016). Identifying outlier loci in admixed and in continuous populations using ancestral population differentiation statistics. Molecular Ecology, 25(20), 5029–5042. https://doi.org/10.1111/mec.13822
- Nei, M., & Maruyama, T. (1975). Lewontin-Krakauer test for neutral genes. Genetics, 80(2), 395. https://doi.org/10.1093/genetics/80.2.395
- Privé, F., Luu, K., Vilhjálmsson, B. J., & Blum, M. G. B. (2020). Performing highly efficient genome scans for local adaptation with R package pcadapt version 4. Molecular Biology and Evolution, 37(7), 2153–2154. https://doi.org/10.1093/molbev/msaa053
- Robertson, A. (1975). Remarks on the Lewontin-Krakauer test. Genetics, 80(2), 396. https://doi.org/10.1093/genetics/80.2.396
- Storey, J. D., & Tibshirani, R. (2003). Statistical significance for genomewide studies. Proceedings of the National Academy of Sciences, 100(16), 9440–9445. https://doi.org/10.1073/pnas.1530509100
- Weir, B. S., & Cockerham, C. C. (1984). Estimating F-statistics for the analysis of population structure. Evolution, 38(6), 1358–1370. https://doi.org/10.1111/j.1558-5646.1984.tb05657.x
- Whitlock, M. C., & Lotterhos, K. E. (2015). Reliable detection of loci responsible for local adaptation: Inference of a null model through trimming the distribution of FST. The American Naturalist, 186(S1), S24–S36. https://doi.org/10.1086/682949