210. Anket örneklem seçimi: basit rastgele, sistematik, tabakalı, PPS, küme ve iki aşamalı
Şablon kimliği: orneklem_secimi · Kategori: anket · Dil: R · Dosya: pro/sablonlar/anket/orneklem_secimi.R (satır 1–438; üstbilgi 1–121) · Örnek veri: _ornek/belcika_belediye.csv · Paketler: sampling 2.11
210.1 Ne işe yarar
Etkin veri, bir örnekleme çerçevesidir (her satır bir birim: kişi, hane, okul, orman bölmesi). Şablon bu çerçeveden olasılıklı bir örneklem seçer ve her birim için içerilme olasılığını \pi_i ile tasarım ağırlığını 1/\pi_i verir. Cevapladığı soru: "Bu çerçeveden, n birimlik (ya da m kümelik) bir örneklemi, her birimin seçilme olasılığı bilinecek biçimde nasıl seçerim?" Altı yöntem sunar:
| Yöntem | Seçim | İçerilme olasılığı |
|---|---|---|
srs |
iadesiz basit rastgele | n_h/N_h |
sistematik |
rastgele başlangıçlı sistematik (kesirli aralık) | n_h/N_h |
pps |
büyüklükle orantılı, iadesiz (Tillé, Brewer, Sampford, Midzuno, pivot) | \pi_i=n\,x_i/\sum x (kesin birimler düzeltilir) |
pps_sis |
büyüklükle orantılı sistematik | aynı \pi_i |
kume |
tek aşamalı küme (kümeler SRS, PPS ya da PPS sistematik; seçilen kümenin tüm birimleri) | \pi_c |
iki_asamali |
kümeler, sonra kümede en çok m_2 birim (SRS) | \pi_c\cdot\pi_{i\mid c} |
Tabaka sütunu seçilirse örneklem tabakalara orantılı, Neyman (en iyi) ya da eşit dağıtılır ve seçim her tabakada ayrı yapılır. Birim ağırlıkları w_i=1/\pi_i ile bu ağırlıkların toplamı \sum_{i\in s}1/\pi_i çerçeve büyüklüğü N'nin yansız kestirimidir (tabakalı SRS'de tam N'dir).
Ne zaman kullanılır? Çerçeve (kayıt listesi) elinizde olduğunda ve seçimi yinelenebilir (tohumlu) biçimde yapmak ve her birimin seçilme olasılığını belgelemek istediğinizde.
Ne zaman kullanılmaz?
- Örneklem büyüklüğünü (kaç birim gerektiğini) hesaplamak için: temel programdaki Örneklem Büyüklüğü Hesaplayıcı (oran için hata payı, tasarım etkisi, yanıt oranı, tabaka dağılımı).
- Deney birimlerini muamelelere atamak için (tam tesadüf, bloklar, Latin kare): temel programdaki Rastgeleleştirme (Deneme) Planı; deney tasarımı şablonları (
alfa_kafes,coyd, …) ayrı kategoridedir. - Seçilmiş anketin analizi ve ağırlıkların kalibrasyonu: temel programın Weighted Mean (Survey Means) analizleri ve
kalibrasyon_raking(Bölüm 208). - Birimler zaten toplanmışsa ve eksik veri varsa:
sicak_deste(Bölüm 211). - İadeli (yerine koyarak) seçim ya da çok aşamalı (üç aşamalı) tasarım gerekiyorsa: bu şablonda yok.
Temel programla ilişki. Temel programda çerçeveden örneklem seçen bir analiz yoktur. İki yakın araç vardır: Örneklem Büyüklüğü Hesaplayıcı (survey/engine/sample_calculator.py; oran için n, tasarım etkisi ve yanıt oranı düzeltmesi, tabakalara orantılı dağıtım) yalnız sayıyı verir, birimleri seçmez; Rastgeleleştirme (Deneme) Planı (stats/randomization_plan.py) deneme planıdır, olasılık ağırlığı üretmez. Seçilmiş örneklemin analizi temel programın Survey Means / Freq / Total / Reg / Logistic analizleriyle yapılır; bunlar ağırlık, tabaka ve küme sütunlarını alır. Bu şablonun çıktısındaki kimlik, tabaka, kume, pi ve agirlik sütunları, o analizlerin girdisi olarak (kimlikle çerçeveye bağlanarak) kullanılabilir.
210.2 Şablonun girdileri
Form, üstbilgideki on dokuz [[param]] bloğundan kurulur (orneklem_secimi.R:10–120).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Seçim yöntemi · yontem |
seçim · Model | srs |
srs, sistematik, pps, pps_sis, kume, iki_asamali |
Dal seçimi (140, 168, 337). |
Toplam örneklem büyüklüğü · n |
tamsayı · Model | 50 | 1–1 000 000 | Birim yöntemlerinde n (128); küme yöntemlerinde kullanılmaz. |
Tabaka sütunu · tabaka |
kategorik sütun · Değişkenler | boş | herhangi sütun | Tabaka (129, 181, 340). |
Tabakalara dağıtım · dagitim |
seçim · Model | orantili |
orantili, neyman, esit |
n_h ya da m_h payları (225–235, 359–369). |
Neyman değişkeni · neyman_degisken |
sayısal sütun · Değişkenler | boş | sayısal | S_h (132, 227, 361). |
Büyüklük ölçüsü · boyut |
sayısal sütun · Değişkenler | boş | pozitif | PPS x_i (130, 183, 341). |
Birim kimliği · kimlik |
sütun · Değişkenler | boş | herhangi sütun | Çıktıda etiket (131, 180, 339). |
Tüm birimlerin olasılıkları · tum_birimler |
onay · Çıktı | açık | açık / kapalı | Çerçevenin tamamını tabloya yazar (316, 416); 5000 birimden büyük çerçevede tablonun kesildiğini söyleyen bir not eklenir (319–321, 419–421). |
İadesiz PPS algoritması · pps_algoritma |
seçim · Model | tille |
tille, brewer, sampford, midzuno, pivotal |
pps_sec (141–145). |
Sıralama değişkeni · siralama |
sütun · Değişkenler | boş | herhangi sütun | Sistematik seçimde tabaka içinde sıralama (133, 376). |
Küme sütunu · kume |
sütun · Değişkenler | boş | herhangi sütun | Birincil birim (170, 182). |
Küme sayısı m · kume_sayisi |
tamsayı · Model | 6 | 1–1 000 000 | Toplam seçilecek küme (175). |
Kümelerin seçimi · kume_secim |
seçim · Model | srs |
srs, pps, pps_sis |
Birinci aşama (172–173, 243–250). |
Küme içi birim sayısı m_2 · ikinci_n |
tamsayı · Model | 5 | 1–1 000 000 | İki aşamalı ikinci aşama (176, 256). |
Tohum · tohum |
tamsayı · Gelişmiş | 0 | 0–2 000 000 000 | >0 ise set.seed (139). |
Örnek ayar (ornek_param, satır 9): yontem = srs, n = 60, tabaka = Province, dagitim = orantili, kimlik = INS, tum_birimler = açık.
Tohum. Şablonun kendi tohum alanı vardır: pozitifse set.seed(tohum) ile seçim bu tohumla yapılır (139); 0 ise kod panelinin çalıştırma tohumu kullanılır (ortak bölüm 1.3: araç çubuğundaki Tohum alanı; boşsa her çalıştırmaya yeni bir tohum atanır, künyede "Tohum: …" yazılır). Aynı tohum ve aynı veriyle seçim aynıdır (os_h_tohum_ayni_a/b: tohum 7, iki ayrı çalıştırma, ortak olmayan birim 0); tohum = 0 ve çalıştırma tohumu 5 ve 6 farklı örneklem verir, 5 ve 5 aynısını verir. Dağıtım ve olasılıklar tohumdan bağımsızdır.
Şablonun kendi denetimleri (mq_hata; birim yöntemleri):
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Çerçeve boş | "Önce Veri sekmesinde bir örnekleme çerçevesi açın." | 125 |
| PPS ve büyüklük yok | "PPS seçimi için bir büyüklük ölçüsü sütunu seçin." | 136 |
| Neyman ve değişken yok | "Neyman dağıtımı için S_h'nin hesaplanacağı değişkeni seçin." | 137–138 |
| Geçerli birim <2 | "Çerçevede en az 2 geçerli birim olmalı." | 347 |
| n\ge N | "Örneklem büyüklüğü (n) çerçeve büyüklüğünden (N) küçük olmalı." | 348–349 |
| n<H | "n en az tabaka sayısı (H) olmalı." | 355 |
| Neyman: tabakada <2 geçerli değer | "…her tabakada değişkenin en az 2 geçerli değeri olmalı." | 360 |
| Neyman: tüm S_h=0 | "…standart sapmaları sıfır; Neyman dağıtımı tanımsız." | 361 |
| Dağıtım yerleşmiyor | "Bu dağıtımla istenen örneklem büyüklüğü tabakalara yerleştirilemiyor." | 367 |
| PPS: tabakada n_h\ge N_h | "PPS'de bir tabakanın örneklem büyüklüğü tabaka büyüklüğüne eşit ya da büyük." | 375 |
| PPS algoritması başarısız | "İadesiz PPS algoritması (…) … başka bir algoritma seçin." | 143–145 |
Küme yöntemlerinde: küme sütunu yok (171); m<1 (177) ya da m_2<1 (178); negatif büyüklük (191); geçerli küme <2 (189, 218); m>M (220); m<H (222); Neyman için tabakada <2 küme (229) ve tüm S_h=0 (230); dağıtım yerleşmiyor (236).
210.3 Örnek veri
belcika_belediye.csv: Belçika'nın 589 belediyesi (Tillé ve Matei, sampling paketi; belgianmunicipalities). Eksik değer yok.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
Commune |
ad | kategorik | belediye adı |
INS |
birim kimliği | sayısal | 11001–92142 |
Province |
tabaka | kategorik | 9 il: N_h=70, 111, 64, 65, 69, 84, 44, 44, 38 |
Arrondiss |
küme | kategorik | 43 arrondissement (ilçe); il içinde yuvalanmış |
Tot04 |
büyüklük ölçüsü, Neyman değişkeni | sayısal | 2004 nüfusu; 86–457 319 (ortanca 11 432) |
averageincome, medianincome, TaxableIncome |
(kullanılmıyor) | sayısal | gelir göstergeleri |
Tabaka ve küme sütunları R'de as.character ile alınır; tabakalar metin sırasıyla sıralanır (sort(unique(...)), 352), kümeler tabaka içinde factor düzey sırasıyla. İl numaraları 1–9 tek hanelidir; 10 ve üzeri numaralarda ("10" < "2") sıra metin sırası olur (211'de de aynı). Çıktı tabloları tabakaları bu sırayla yazar.
Bölümde kullanılan çalıştırmalar (dogrulama/orneklem_secimi/isler.py, tohum 1): os_ornek; os_neyman; os_esit; os_sis; os_sis_sirali; os_pps_tille, _brewer, _sampford, _midzuno, _pivotal, os_pps_sis, os_pps_tabakali; os_kume_srs, os_kume_pps; os_iki_srs, os_iki_pps, os_iki_tabakali, os_iki_neyman, os_kume_tabakali_pps; os_h_* (uç ve hata durumları).
210.4 Yöntem: formüller ve hesap adımları
210.4.1 Tabakalara dağıtım
Tabaka h'de çerçeve N_h birimdir. Dağıtım için pay a_h seçilir ve n_h=n\,a_h/\sum a_h yuvarlanır:
- N_h: tabakadaki birim sayısı; S_h: tabakada Neyman değişkeninin örnek standart sapması (n_h-1 paydalı).
- Orantılı dağıtım örnekleme kesrini tabakalar arasında eşit yapar; Neyman, tabakadaki değişkenlik ve büyüklükle orantılı birim ayırır (Cochran, 1977; Neyman, 1934): değişkenliği çok olan tabakadan daha çok birim.
Yuvarlama (en büyük kalan). Pay x_h=n\,a_h/\sum a ise \lfloor x_h\rfloor alınır, kalan birimler kesirli kısmı en büyük olan tabakalara verilir (eşitlikte küçük tabaka numarası; 147–151). Sınırlar: 1\le n_h\le N_h. Bir pay N_h'yi aşarsa tabaka N_h'de sabitlenir ya da 1'in altındaysa 1'de sabitlenir ve kalan n ötekilere yeniden dağıtılır (152–166). Örnek veri, n=60: orantılı (7, 11, 7, 7, 7, 9, 4, 4, 4); Neyman (S_h Tot04'ten; 53\,663; 22\,687; 18\,685; …) (15, 10, 5, 8, 8, 7, 3, 1, 3); eşit (7, 7, 7, 7, 7, 7, 6, 6, 6).
Neden Neyman'da 8. tabaka tek birim?
Pay N_hS_h=44\cdot4718 küçüktür; x_h<1 olduğundan tabaka 1'e sabitlenir ve kalan n ötekilere yeniden dağıtılır (kucuk dalı, 158–161). Sonuç: bir tabakada tek birimle varyans kestirimi yapılamaz; Neyman'da tabaka başına en az 2 birim isteniyorsa n artırılmalıdır.
210.4.2 Birim seçimi: SRS ve sistematik
SRS: \pi_i=n_h/N_h; sampling::srswor(n_h, N_h) (n_h birim sample.int ile). Sistematik: \pi_i=n_h/N_h (kesirli aralık N_h/n_h); UPsystematic(pik): a=(0,\ \text{cumsum}(\pi))-U\ (\mathrm{mod}\ 1) ve s_i=1 eğer a_i>a_{i+1} (U\sim\mathrm{U}(0{,}1) tek rastgele sayı). Sıralama değişkeni verilirse çerçeve tabaka içinde ona göre sıralanır (örtük tabakalama; 373).
210.4.3 PPS: büyüklükle orantılı seçim
- x_i: büyüklük ölçüsü (örnekte
Tot04); C: kesin seçilen birimler kümesi, k=|C|. - Kesin birimin \pi_i=1 olur: örnekte mutlaka bulunur. Çıkarıldıktan sonra kalan birimlerin olasılıkları (n-k) üzerinden yeniden hesaplanır; yeni bir birim 1'e ulaşırsa süreç yinelenir (
sampling::inclusionprobabilities; Särndal ve ark., 1992).
Örnek veride n=100: sekiz belediye kesin seçilir (en büyüğü Anvers, Tot04 = 457 319); \sum\pi_i=100. n=300 için 90, n=30 için 1 kesin birim vardır. Seçim algoritması pps_algoritma ile belirlenir; hepsi verilen \pi_i'yi tam sağlar: Tillé (eleme; Tillé, 1996), Brewer (Brewer, 1963), Sampford (1967; seçim reddetmeyle yapıldığından büyük n'de yavaş), Midzuno, pivot (Deville ve Tillé, 1998). pps_sis ise UPsystematic ile sistematik PPS'dir (birimler çerçeve sırasındadır; sıralama değişkeni etkisi 373).
Neden kesin birimler?
n\,x_i/\sum x\ge1 olan birimin olasılığı 1'i aşamaz; olduğu gibi bırakılırsa \sum\pi_i\ne n olur. Büyük birimleri kesin alıp kalan n-k birimi küçük olanlara dağıtmak \sum\pi_i=n'yi korur.
210.4.4 Küme ve iki aşamalı seçim
Birincil birim kümedir (örnekte Arrondiss; 43 küme, M). Tek aşamalı: kümeler seçilir, seçilen kümenin tüm birimleri alınır: \pi_i=\pi_c. SRS ile \pi_c=m/M; PPS ile \pi_c=m\,X_c/\sum X (X_c = kümedeki büyüklük ölçüsü toplamı, boyut yoksa kümedeki birim sayısı N_c; kesin kümeler yinelemeli). İki aşamalı: seçilen kümeden m_c=\min(m_2,N_c) birim SRS ile seçilir, \pi_{i\mid c}=m_c/N_c ve
- \pi_c: kümenin birinci aşamada seçilme olasılığı; \pi_{i\mid c}: seçilen kümede birimin seçilme olasılığı; N_c: kümedeki birim sayısı.
- Kümede N_c<m_2 ise kümenin tamamı alınır (\pi_{i\mid c}=1).
Tabaka varsa küme sayısı m tabakalara küme sayısıyla orantılı (a_h=M_h), eşit ya da kümelerin toplamlarının standart sapmasıyla Neyman (a_h=M_hS_h, S_h = tabakadaki küme toplamlarının sd'si) dağıtılır ve seçim her tabakada ayrı yapılır; 1\le m_h\le M_h. Örnek: m=18: orantılı (1{,}2{,}3{,}3{,}3{,}2{,}1{,}2{,}1), eşit (2,\dots,2), Neyman (3{,}3{,}2{,}2{,}2{,}3{,}1{,}1{,}1).
Koddaki tercih
Birim yöntemlerinde srswor, UPsystematic, UPtille, UPbrewer, UPsampford, UPmidzuno, UPpivotal, inclusionprobabilities (sampling; 141–145, 244–249, 376–382). Tohum set.seed ile (139). İki aşamalıda küme içi birim sırası sampling::cluster'daki merge() sırasıdır (260–270): aynı tohumla sampling::mstage ile aynı birimler seçilir (210.6).
210.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 122–139 | .m; sampling yüklenir; parametreler; PPS ve Neyman koşulları; tohum (tohum > 0 ise set.seed). |
Tohum 0: çalıştırmanın tohumu. |
| 141–145 | pps_sec: seçilen algoritma; hata iletisi. |
Sampford büyük n'de çok yavaş olabilir. |
| 147–166 | yuvarla (en büyük kalan) ve dagit (sınırlı dağıtım). |
1\le n_h\le N_h. |
| 168–206 | Küme yöntemleri: çerçeve hazırlanır (eksik tabaka/küme satırları atılır, not düşer); küme tablosu: N_c, büyüklük, Neyman toplamı. | Büyüklüğü 0 olan küme çıkarılır (207–216). |
| 217–236 | M, M_h; denetimler; tabakalara küme dağıtımı. | |
| 238–277 | Her tabakada kümeler (SRS/PPS/PPS sistematik), \pi_c, iki aşamalıda küme içi SRS, \pi_{i\mid c}. | merge() sırası (260–270). |
| 278–336 | Küme çıktıları: tasarım özeti, tabaka dağıtımı, küme tablosu, seçilen örneklem, tüm birimler; şekil. | Kümeli tasarımda \sum1/\pi_i yaklaşık N'dir. |
| 337–352 | Birim yöntemleri: çerçeve; eksik tabaka/büyüklük satırları atılır, not düşer; N, n denetimi. | |
| 354–370 | Tabaka dağıtımı. | |
| 372–389 | Her tabakada \pi ve seçim: PPS (\pi yinelemeli), SRS, sistematik. | Kesin birim işareti \pi\ge1-10^{-12} (381). |
| 390–437 | Çıktılar: tasarım özeti, tabaka dağıtımı (N_h, n_h, kesir, ağırlık), seçilen örneklem, tüm birimler, şekil. | Tüm birimler tablosu 5000 satırla sınırlıdır; çerçeve daha büyükse kesildiği ve tabloda olmayan birim sayısı not olarak yazılır (419–421). |
210.6 Elle hesap: örnek veride bağımsız yeniden hesap
Bağımsız hesaplar dogrulama/orneklem_secimi/elle_hesap.py (numpy/pandas; dağıtım, PPS olasılıkları ve küme olasılıkları kapalı formülle; sampling ve şablon çağrılmaz) ve r_dogrulama.R (temel R: aynı tohumla sample.int ve runif; ayrıca sampling::mstage ile iki aşamalı seçim) ile yapılmıştır.
Adım 1 — Tabaka dağıtımı. n=60 ve N_h=(70{,}111{,}64{,}65{,}69{,}84{,}44{,}44{,}38) için orantılı pay x_h=60N_h/589=(7{,}13;\ 11{,}31;\ 6{,}52;\ 6{,}62;\ 7{,}03;\ 8{,}56;\ 4{,}48;\ 4{,}48;\ 3{,}87); tabanlar toplamı 56; kalan 4 birim en büyük kesirlere (0,87; 0,62; 0,56; 0,52) verilir: (7{,}11{,}7{,}7{,}7{,}9{,}4{,}4{,}4). Üç hesap aynıdır; Neyman ve eşit dağıtım da.
Adım 2 — PPS olasılıkları. n=100, x=\texttt{Tot04}: ilk adımda 100\,x_i/\sum x (\sum x=10{,}417{,}122) ile sekiz birim \ge1; bunlar kesin, kalan 92 birim için \pi_i=92\,x_i/\sum_{j\notin C}x_j; ilk beş birimin olasılığı (0{,}146722;\ 1;\ 0{,}124039;\ 0{,}162971;\ 0{,}106627), en küçüğü 0{,}000892, toplam 100{,}0000.
Adım 3 — Küme olasılıkları. SRS, m=6, M=43: \pi_c=6/43=0{,}139535. PPS: \pi_c ilk beş küme için (0{,}545688;\ 0{,}178788;\ 0{,}239143;\ 0{,}578416;\ 0{,}328822), toplam 6. İki aşamalıda 1. küme (N_c=30): \pi_{i\mid c}=5/30=0{,}166667; 2. küme (N_c=13): 0{,}384615.
Adım 4 — Aynı tohumla aynı birimler. Tohum 1, tabakalı SRS: temel R'de tabakalar metin sırasıyla dolaşılıp her birinde sample.int(N_h, n_h) çağrılır: seçilen 60 birim şablonla aynıdır. Sistematik seçimde tabaka başına runif(1) ile aynı sonuç alınır; tek aşamalı küme SRS'de sample.int(43, 6) ile aynı 6 küme (97 birim) seçilir.
Adım 5 — Algoritmaların içerilme olasılıkları (Monte Carlo). 60 belediyelik çerçeve, n=10, \pi_i aralığı 0{,}0193–1, her algoritma 3000 kez çalıştırıldı (mc_pps.R): ortalama örneklem büyüklüğü hepsinde 10; her birimin gözlenen seçilme sıklığı ile \pi_i arasındaki en büyük standartlaştırılmış fark Tillé 2,66; Brewer 2,09; Sampford 2,55; Midzuno 2,32; pivot 2,57; sistematik 2,79 (3'ü aşan birim yok). Yani beş algoritma ve sistematik seçim verilen olasılıkları sağlar.
210.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| orantılı: n_h (tabaka 1) | 7 | 7 | — | 0 | ✓ |
| orantılı: n_h (tabaka 2) | 11 | 11 | — | 0 | ✓ |
| orantılı: n_h (tabaka 3) | 7 | 7 | — | 0 | ✓ |
| orantılı: n_h (tabaka 4) | 7 | 7 | — | 0 | ✓ |
| orantılı: n_h (tabaka 5) | 7 | 7 | — | 0 | ✓ |
| orantılı: n_h (tabaka 6) | 9 | 9 | — | 0 | ✓ |
| orantılı: n_h (tabaka 7) | 4 | 4 | — | 0 | ✓ |
| orantılı: n_h (tabaka 8) | 4 | 4 | — | 0 | ✓ |
| orantılı: n_h (tabaka 9) | 4 | 4 | — | 0 | ✓ |
| Neyman (Tot04): n_h (tabaka 1) | 15 | 15 | — | 0 | ✓ |
| Neyman (Tot04): n_h (tabaka 2) | 10 | 10 | — | 0 | ✓ |
| Neyman (Tot04): n_h (tabaka 3) | 5 | 5 | — | 0 | ✓ |
| Neyman (Tot04): n_h (tabaka 4) | 8 | 8 | — | 0 | ✓ |
| Neyman (Tot04): n_h (tabaka 5) | 8 | 8 | — | 0 | ✓ |
| Neyman (Tot04): n_h (tabaka 6) | 7 | 7 | — | 0 | ✓ |
| Neyman (Tot04): n_h (tabaka 7) | 3 | 3 | — | 0 | ✓ |
| Neyman (Tot04): n_h (tabaka 8) | 1 | 1 | — | 0 | ✓ |
| Neyman (Tot04): n_h (tabaka 9) | 3 | 3 | — | 0 | ✓ |
| eşit: n_h (tabaka 1) | 7 | 7 | — | 0 | ✓ |
| eşit: n_h (tabaka 2) | 7 | 7 | — | 0 | ✓ |
| eşit: n_h (tabaka 3) | 7 | 7 | — | 0 | ✓ |
| eşit: n_h (tabaka 4) | 7 | 7 | — | 0 | ✓ |
| eşit: n_h (tabaka 5) | 7 | 7 | — | 0 | ✓ |
| eşit: n_h (tabaka 6) | 7 | 7 | — | 0 | ✓ |
| eşit: n_h (tabaka 7) | 6 | 6 | — | 0 | ✓ |
| eşit: n_h (tabaka 8) | 6 | 6 | — | 0 | ✓ |
| eşit: n_h (tabaka 9) | 6 | 6 | — | 0 | ✓ |
| PPS n=100: Σπ | 100 | 100 | — | 0 | ✓ |
| PPS n=100: kesin seçilen birim | 8 | 8 | — | 0 | ✓ |
| PPS n=100: en büyük π | 1 | 1 | — | 0 | ✓ |
| PPS n=100: en küçük π | 8,923663·10−4 | 8,923663·10−4 | — | 5,0e−17 | ✓ |
| PPS n=100: π (birim 1) | 0,14672163 | 0,14672163 | — | 5,0e−16 | ✓ |
| PPS n=100: π (birim 2) | 1 | 1 | — | 0 | ✓ |
| PPS n=100: π (birim 3) | 0,12403892 | 0,12403892 | — | 2,1e−16 | ✓ |
| PPS n=100: π (birim 4) | 0,16297099 | 0,16297099 | — | 3,6e−16 | ✓ |
| PPS n=100: π (birim 5) | 0,1066274 | 0,1066274 | — | 4,3e−16 | ✓ |
| PPS n=300: Σπ | 300 | 300 | — | 0 | ✓ |
| PPS n=300: kesin seçilen birim | 90 | 90 | — | 0 | ✓ |
| PPS n=300: en büyük π | 1 | 1 | — | 0 | ✓ |
| PPS n=300: en küçük π | 0,00334383 | 0,00334383 | — | 1,3e−17 | ✓ |
| PPS n=300: π (birim 1) | 0,5497883 | 0,5497883 | — | 2,2e−16 | ✓ |
| PPS n=300: π (birim 2) | 1 | 1 | — | 0 | ✓ |
| PPS n=300: π (birim 3) | 0,46479274 | 0,46479274 | — | 0 | ✓ |
| PPS n=300: π (birim 4) | 0,61067716 | 0,61067716 | — | 0 | ✓ |
| PPS n=300: π (birim 5) | 0,39954912 | 0,39954912 | — | 5,0e−16 | ✓ |
| PPS n=30: Σπ | 30 | 30 | — | 0 | ✓ |
| PPS n=30: kesin seçilen birim | 1 | 1 | — | 0 | ✓ |
| PPS n=30: en büyük π | 1 | 1 | — | 0 | ✓ |
| PPS n=30: en küçük π | 2,504066·10−4 | 2,504066·10−4 | — | 2,0e−18 | ✓ |
| PPS n=30: π (birim 1) | 0,0411715 | 0,0411715 | — | 4,9e−17 | ✓ |
| PPS n=30: π (birim 2) | 1 | 1 | — | 0 | ✓ |
| PPS n=30: π (birim 3) | 0,03480651 | 0,03480651 | — | 2,8e−17 | ✓ |
| PPS n=30: π (birim 4) | 0,04573123 | 0,04573123 | — | 4,9e−17 | ✓ |
| PPS n=30: π (birim 5) | 0,02992067 | 0,02992067 | — | 5,2e−17 | ✓ |
| tabakalı PPS n=60: Σπ | 60 | 60 | — | 1,2e−16 | ✓ |
| tabakalı PPS n=60: kesin seçilen birim | 4 | 4 | — | 0 | ✓ |
| küme SRS m=6: π₁ (her küme) | 0,13953488 | 0,13953488 | — | 2,2e−16 | ✓ |
| küme PPS m=6: Σπ₁ | 6 | 6 | — | 3,0e−16 | ✓ |
| küme PPS m=6: π₁ (küme 1) | 0,54568834 | 0,54568834 | — | 3,3e−16 | ✓ |
| küme PPS m=6: π₁ (küme 2) | 0,17878777 | 0,17878777 | — | 5,6e−17 | ✓ |
| küme PPS m=6: π₁ (küme 3) | 0,23914302 | 0,23914302 | — | 1,9e−16 | ✓ |
| küme PPS m=6: π₁ (küme 4) | 0,57841638 | 0,57841638 | — | 0 | ✓ |
| küme PPS m=6: π₁ (küme 5) | 0,32882172 | 0,32882172 | — | 1,1e−16 | ✓ |
| iki aşamalı: π₂ (küme 1) | 0,16666667 | 0,16666667 | — | 3,3e−16 | ✓ |
| iki aşamalı: π₂ (küme 2) | 0,38461538 | 0,38461538 | — | 3,9e−16 | ✓ |
| iki aşamalı: π₂ (küme 3) | 0,18518519 | 0,18518519 | — | 1,7e−16 | ✓ |
| iki aşamalı: π₂ (küme 4) | 0,26315789 | 0,26315789 | — | 1,1e−16 | ✓ |
| iki aşamalı: π₂ (küme 5) | 0,14285714 | 0,14285714 | — | 1,4e−16 | ✓ |
| küme sayısı orantılı: m_h (tabaka 1) | 1 | 1 | — | 0 | ✓ |
| küme sayısı orantılı: m_h (tabaka 2) | 2 | 2 | — | 0 | ✓ |
| küme sayısı orantılı: m_h (tabaka 3) | 3 | 3 | — | 0 | ✓ |
| küme sayısı orantılı: m_h (tabaka 4) | 3 | 3 | — | 0 | ✓ |
| küme sayısı orantılı: m_h (tabaka 5) | 3 | 3 | — | 0 | ✓ |
| küme sayısı orantılı: m_h (tabaka 6) | 2 | 2 | — | 0 | ✓ |
| küme sayısı orantılı: m_h (tabaka 7) | 1 | 1 | — | 0 | ✓ |
| küme sayısı orantılı: m_h (tabaka 8) | 2 | 2 | — | 0 | ✓ |
| küme sayısı orantılı: m_h (tabaka 9) | 1 | 1 | — | 0 | ✓ |
| küme sayısı Neyman: m_h (tabaka 1) | 3 | 3 | — | 0 | ✓ |
| küme sayısı Neyman: m_h (tabaka 2) | 3 | 3 | — | 0 | ✓ |
| küme sayısı Neyman: m_h (tabaka 3) | 2 | 2 | — | 0 | ✓ |
| küme sayısı Neyman: m_h (tabaka 4) | 2 | 2 | — | 0 | ✓ |
| küme sayısı Neyman: m_h (tabaka 5) | 2 | 2 | — | 0 | ✓ |
| küme sayısı Neyman: m_h (tabaka 6) | 3 | 3 | — | 0 | ✓ |
| küme sayısı Neyman: m_h (tabaka 7) | 1 | 1 | — | 0 | ✓ |
| küme sayısı Neyman: m_h (tabaka 8) | 1 | 1 | — | 0 | ✓ |
| küme sayısı Neyman: m_h (tabaka 9) | 1 | 1 | — | 0 | ✓ |
| tabakalı küme PPS: m_h (tabaka 1) | 1 | 1 | — | 0 | ✓ |
| tabakalı küme PPS: m_h (tabaka 2) | 2 | 2 | — | 0 | ✓ |
| tabakalı küme PPS: m_h (tabaka 3) | 3 | 3 | — | 0 | ✓ |
| tabakalı küme PPS: m_h (tabaka 4) | 3 | 3 | — | 0 | ✓ |
| tabakalı küme PPS: m_h (tabaka 5) | 3 | 3 | — | 0 | ✓ |
| tabakalı küme PPS: m_h (tabaka 6) | 2 | 2 | — | 0 | ✓ |
| tabakalı küme PPS: m_h (tabaka 7) | 1 | 1 | — | 0 | ✓ |
| tabakalı küme PPS: m_h (tabaka 8) | 2 | 2 | — | 0 | ✓ |
| tabakalı küme PPS: m_h (tabaka 9) | 1 | 1 | — | 0 | ✓ |
| tabakalı SRS: Σ 1/π_i (örneklem) = N | 589 | 589 | — | 0 | ✓ |
| kümeli iki aşamalı: Σ π₁ (kümeler) | 18 | 18 | — | 0 | ✓ |
| tabakalı SRS (tohum 1): seçilen birim sayısı | 60 | 60 | — | 0 | ✓ |
| tabakalı SRS (tohum 1): ortak olmayan birim sayısı | 0 | 0 | — | 0 | ✓ |
| tabakalı sistematik (tohum 1): seçilen birim sayısı | 60 | 60 | — | 0 | ✓ |
| tabakalı sistematik (tohum 1): ortak olmayan birim sayısı | 0 | 0 | — | 0 | ✓ |
| tek aşamalı küme SRS (tohum 1): seçilen birim sayısı | 97 | 97 | — | 0 | ✓ |
| tek aşamalı küme SRS (tohum 1): ortak olmayan birim sayısı | 0 | 0 | — | 0 | ✓ |
| iki aşamalı SRS (tohum 1; sampling::mstage): seçilen birim sayısı | 30 | 30 | — | 0 | ✓ |
| iki aşamalı SRS (tohum 1; sampling::mstage): ortak olmayan birim sayısı | 0 | 0 | — | 0 | ✓ |
| tohum = 7, iki ayrı çalıştırma: ortak olmayan birim | 0 | 0 | — | 0 | ✓ |
| tohum = 0, çalıştırma tohumu 5 ve 5: ortak olmayan birim | 0 | 0 | — | 0 | ✓ |
| tohum = 0, çalıştırma tohumu 5 ve 6: ortak olmayan birim > 0 | 1 | 1 | — | 0 | ✓ |
Ölçütü karşılayan: 108/108. Bağımsız Python kolu: tabaka dağıtımı (en büyük kalan), PPS içerilme olasılıkları (kesin birimlerin yinelemeli çıkarılması), küme dağıtımı ve küme/birim olasılıkları; R kolu: aynı tohumla temel R sample.int ve runif ile seçilen birimlerin yeniden üretimi (sampling kullanılmadan). İki aşamalı seçimde küme içi birim sırası paketin merge() sırasıdır (temel R sample.int ile aynı sırada değildir; 210.8); bu satır sampling::mstage ile karşılaştırılır. Seçilen birimlerde ölçüt 'ortak olmayan birim sayısı = 0'dır.
210.7 Çıktıyı okuma
Yöntem: Basit rastgele (iadesiz); N = 589, n = 60.
-- Tasarım özeti
 Çerçeve büyüklüğü N 589 | Örneklem büyüklüğü n 60 | Tabaka sayısı 9 | Kesin seçilen birim 0
 Σ π_i (çerçeve) 60 | Σ 1/π_i (örneklem) 589
-- Tabaka dağıtımı
 tabaka  N_h  n_h   kesir      agirlik
 1        70    7   0.100000   10.000000
 2       111   11   0.099099   10.090909
 ...
-- Seçilen örneklem
 kimlik tabaka  pi        agirlik
 11001   1      0.100000  10.000000
 11024   1      0.100000  10.000000
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Tasarım özeti | N, n, tabaka sayısı, kesin birim, \sum\pi_i, \sum1/\pi_i. | \sum\pi_i=n olmalıdır. Tabakalı SRS'de \sum1/\pi_i=N tam, PPS ve kümeli tasarımda yaklaşık (örnek: PPS Tillé 597,14; Brewer 493,43; pivot 621,74; N=589): seçimin rastgele olduğunu gösterir. |
| Tabaka dağıtımı | N_h, n_h, kesir, ağırlık N_h/n_h (PPS'de kesin birim sayısı). | Neyman'da S_h sütunu eklenir. |
| Seçilen örneklem | Kimlik, tabaka, (kümeli: küme, \pi_1, \pi_2), \pi, ağırlık. | Bu tablo analiz veri setiyle kimlik üzerinden birleştirilir. |
| Tüm birimler | Çerçevenin her birimi için \pi, ağırlık, secildi. |
5000 birimden fazlasında ilk 5000 birimle kesilir; kesildiğini ve kaç birimin tabloda olmadığını bir not söyler. Seçilen birimlerin tamamı "Seçilen örneklem" tablosundadır. |
| Şekil | PPS'de \pi_i'ye karşı büyüklük (log); tabakalı SRS'de tabaka ve seçilen birim sayısı. | Dolu noktalar seçilen birimlerdir. |
Şekil 210.1. PPS (Tillé, n=100): içerilme olasılığı ve büyüklük ölçüsü (dolu: seçilen).
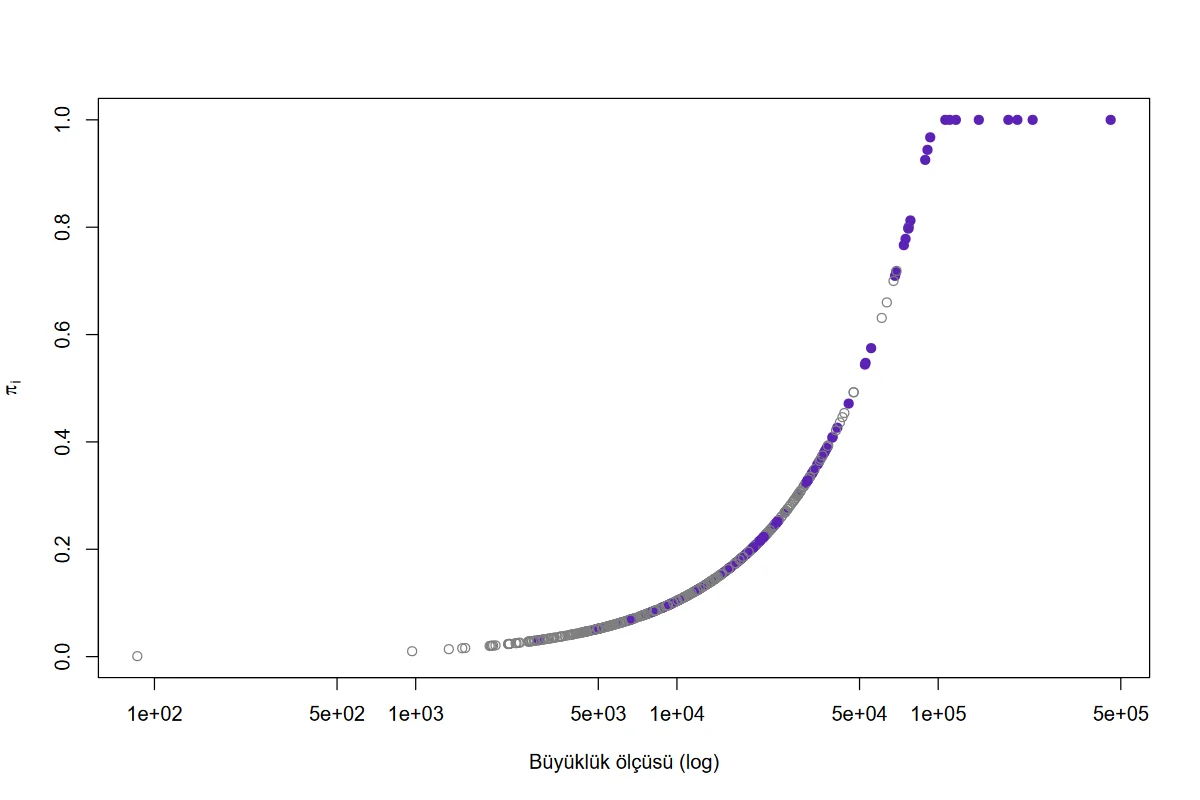
PPS algoritmalarının karşılaştırması (n=100, tek örneklem, tohum 1): sekiz kesin birim hepsinde; \sum1/\pi_i Tillé 597,14; Brewer 493,43; Midzuno 562,87; pivot 621,74; PPS sistematik 597,52. Tek bir çekilişle karşılaştırma yapılamaz; algoritmaların ortak özelliği \pi_i'yi tam sağlamalarıdır, ikili olasılıkları farklıdır (varyans kestirimi için önemlidir).
Belçika belediyeleri çerçevesinden 9 il (tabaka) içinde orantılı dağıtımla iadesiz basit rastgele (tohum 1) 60 belediye seçildi; tabaka içi örnekleme kesirleri 0,091–0,109 arasındadır ve tasarım ağırlıklarının toplamı çerçeve büyüklüğüne (589) eşittir.
210.8 Sık hatalar ve tuzaklar
nküme yöntemlerinde yok sayılır. Aynıkume_sayisiile n rastgele çıkar (os_kume_srs: 97 birim; B3). Hedef n için iki aşamalı seçim ve m_2 kullanın (n=m\cdot m_2 ancak tüm kümeler \ge m_2 birimliyse).- Büyük çerçevede tablo kesilir. 5000 birimden büyük çerçevede "tüm birimler" tablosu ilk 5000 birimle kesilir (
os_h_cerceve6000: 6000 birim; "Not: çerçeve 6000 birim; … kalan 1000 birim tabloda yok"). Seçilen birimlerin tamamı ayrı "Seçilen örneklem" tablosundadır; tüm çerçevenin olasılıklarına ihtiyacınız varsa çerçeveyi parçalara bölüp ayrı ayrı çalıştırın. - Neyman ve küçük tabakalar. Neyman payı küçük tabakaları 1 birime iner (
os_neyman: 8. tabaka); tabaka başına birim sayısı 2'nin altındaysa tabaka içi varyans kestirilemez. n'yi artırın ya da tabakaları birleştirin. - PPS'de kesin birimler. Büyük birimler (Anvers) olasılığı 1 olarak örnekte yer alır; bu birimlerin ağırlığı 1'dir. Çok çarpık dağılımda kesin birim sayısı artar (n=300: 90 birim) ve PPS'nin kazancı azalır. n_h\ge N_h olan tabaka hata verir (378).
- Sampford yavaşlığı. Reddetmeyle çalışır; n büyük ve çarpık büyüklükte çok yavaş olabilir. Tillé varsayılandır.
- Sistematik ve çerçeve sırası. Sıralama değişkeni yoksa çerçeve sırası kullanılır; periyodik çerçevede yanlılık doğabilir (B4).
- İki aşamalıda tohum ve R sürümü. Küme içi birim sırası
merge()çıktısına bağlıdır (B2); aynı tohum aynı R sürümünde aynı örneklemi verir. - Tohum.
tohum = 0iken sonuç Kod paneli Tohum alanına bağlıdır; yinelenebilirlik için şablonuntohumalanına pozitif bir sayı yazın ve künyedeki tohumu kaydedin. - Eksik tabaka/küme. Tabakası, kümesi ya da PPS büyüklüğü eksik/sıfır/negatif olan birimler çerçeveden çıkarılır ve bir not yazılır (346–347, 186–187); sonuç N artık çerçevenin tamamı değildir.
- Yinelenen kimlik. Denetlenmez (B5).
210.9 Uzman soruları
S1. Orantılı dağıtımla tabakalı SRS neden basit rastgele örneklemden iyidir?
Orantılı tabakalı örneklemde her tabaka çerçevedeki payı kadar temsil edilir; tabakalar arası değişkenlik varyanstan çıkar. Ağırlıklar eşit kalır (N_h/n_h\approx N/n, örnekte 9,1–11,0; yuvarlama yüzünden tam eşit değil). Kazanç, tabaka ortalamalarının birbirinden farkına bağlıdır; farklılık yoksa kazanç yoktur. Tabaka sütunu seçilmişse şablon bunu doğrudan uygular (355–369).
S2. Neyman dağıtımı ne zaman orantılıdan üstündür?
Tabakalar arasında standart sapmalar çok farklıysa. Neyman n_h\propto N_hS_h ile ortalamanın varyansını en küçük yapar (maliyet eşitken). Örnekte S_h (53\,663 ile 4718 arası) çok farklı olduğundan 1. tabaka 15, 8. tabaka 1 birim alır. S_h'nin önceden bilinmeyen bir değişkenden hesaplanması gerekir; şablon çerçevedeki yardımcı değişkenden hesaplar (neyman_degisken).
S3. PPS neden iyi, ne zaman kötü?
Büyüklük ölçüsü hedef değişkenle orantılıysa (nüfus ve toplam gelir) \pi_i\propto x_i ağırlıkları 1/\pi_i\propto1/x_i hedef toplamların varyansını küçültür (Horvitz-Thompson). Ölçü hedefle ilişkisizse ya da ters ilişkiliyse varyans artar. Örnekte Tot04 ile nüfus toplamı gibi değişkenler için uygundur.
S4. Tillé, Brewer, Sampford, Midzuno ve pivot arasında fark nedir?
Hepsi verilen \pi_i'yi tam sağlar; ikili içerilme olasılıkları \pi_{ij} (ve dolayısıyla Horvitz-Thompson varyansı) farklıdır. Tillé (eleme) ve Brewer yaygın ve hızlıdır; Sampford \pi_{ij}\le\pi_i\pi_j özelliğini taşır (Yates-Grundy varyansı için uygun) ama reddetmeyle çalışır ve büyük n'de yavaştır; pivot yöntemi çok hızlıdır, bazı birim çiftlerinin birlikte seçilme olasılığı 0 olabilir. Midzuno'nun kuramsal olarak \pi_i üzerinde bir koşulu vardır; sampling uygulaması denenen olasılıklarda çalışmıştır (aşağıdaki Monte Carlo denetimi). Şablon seçimi pps_algoritma ile yaptırır, ikili olasılık vermez.
S5. Küme örneklemesinde neden n sabit değil?
Seçilen kümelerin büyüklüğü rastgeledir ve tüm birimleri alınır; n=\sum_{c\in s}N_c. PPS ile küme büyüklüğü \pi_c'yi belirlediğinden n'nin değişkenliği azalır ama sıfırlanmaz. n sabit isteniyorsa iki aşamalı ve kümeler eşit büyüklükteyse ya da m_2 ile sınırlandırın.
S6. Tabakalı iki aşamalıda ağırlıklar neden eşit değil?
\pi_i=\pi_c\,\pi_{i\mid c} ve \pi_{i\mid c}=m_c/N_c kümeye göre değişir (örnekte 1. kümede 5/30, 2. kümede 5/13). Ağırlıklar eşit olsun isteniyorsa küme içi seçim kümenin büyüklüğüyle orantılı (PPS) ve küme içi sabit sayı olmalıdır; bu şablonda küme PPS'si ve küme içi SRS birlikte seçilebilir (os_iki_pps).
S7. Aynı tohum başka bir bilgisayarda aynı örneklemi verir mi?
Aynı R sürümü ve aynı sampling sürümünde evet. R'nin rastgele sayı üreteci ve sample.int algoritması sürümler arasında değişebilir (R 3.6'da örnekleme çekirdeği değişti); iki aşamalıda ayrıca merge() sırası (B2). Yinelenebilirlik için seçimi kaydedin (seçilen örneklem tablosu), tohuma güvenmeyin.
S8. Tohum alanı ile şablonun tohumu arasındaki ilişki nedir?
Şablonun tohum alanı pozitifse seçim onunla yapılır ve kod panelindeki tohum yok sayılır; 0 ise kod panelinin tohumu geçerlidir (139). tohum = 0 iken Kod paneli Tohum alanı boşsa her çalıştırmaya yeni tohum atanır ve künyeye yazılır; bu tohum alana girilince aynı seçim yinelenir (os_h_tohum0_a/b: tohum 5 ve 5 aynı, 5 ve 6 farklı).
210.10 Kaynaklar
Brewer, K. R. W. (1963). A model of systematic sampling with unequal probabilities. Australian Journal of Statistics, 5(1), 5–13. https://doi.org/10.1111/j.1467-842X.1963.tb00132.x
Cochran, W. G. (1977). Sampling techniques (3rd ed.). Wiley.
Deville, J.-C., & Tillé, Y. (1998). Unequal probability sampling without replacement through a splitting method. Biometrika, 85(1), 89–101. https://doi.org/10.1093/biomet/85.1.89
Lohr, S. L. (2021). Sampling: Design and analysis (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9780429298899
Neyman, J. (1934). On the two different aspects of the representative method: The method of stratified sampling and the method of purposive selection. Journal of the Royal Statistical Society, 97(4), 558–625. https://doi.org/10.2307/2342192
Sampford, M. R. (1967). On sampling without replacement with unequal probabilities of selection. Biometrika, 54(3–4), 499–513. https://doi.org/10.1093/biomet/54.3-4.499
Särndal, C.-E., Swensson, B., & Wretman, J. (1992). Model assisted survey sampling. Springer. https://doi.org/10.1007/978-1-4612-4378-6
Tillé, Y. (1996). An elimination procedure for unequal probability sampling without replacement. Biometrika, 83(1), 238–241. https://doi.org/10.1093/biomet/83.1.238
Tillé, Y. (2006). Sampling algorithms. Springer. https://doi.org/10.1007/0-387-34240-0
Tillé, Y., & Matei, A. (2025). sampling: Survey sampling (R package version 2.11) [Computer software].