91. Tohum Bahçesinde Genetik Çeşitlilik ve Statü Sayısı
Şablon kimliği: tohum_bahcesi_cesitlilik · Kategori: genetik · Dil: R · Dosya: pro/sablonlar/genetik/tohum_bahcesi_cesitlilik.R (satır 1–386; üstbilgi 1–129) · Örnek veri: _ornek/tohum_bahcesi_cesitlilik.csv · Paketler: yok (yalnız taban R)
91.1 Ne işe yarar
Klonal tohum bahçesinde her klon tohum ürününe aynı ölçüde katkı yapmaz: birkaç klon kozalağın ve çiçek tozunun büyük kısmını üretir. Şablon şu soruyu cevaplar: "N klonlu bu bahçenin tohum ürünü, eşit katkı yapan ve birbiriyle ilişkisiz kaç ebeveynin çeşitliliğini taşıyor; hasat ve seyreltme kararları bu sayıyı ve beklenen genetik kazancı nasıl değiştirir?"
Cevap üç büyüklükle verilir. Doğurganlık değişkenliği \Psi, katkıların eşitsizliğini ölçer; etkili ebeveyn sayısı N_p=N/\Psi, yalnız bu eşitsizliği hesaba katar; statü sayısı N_s=1/(2\Theta), klonlar arasındaki akrabalığı da katar:
- p_i: i. klonun gen havuzuna katkı payı (\sum_i p_i=1).
- \theta_{ij}: i ve j klonları arasındaki ortak ata katsayısı (birinden ve ötekinden rastgele çekilen iki alelin soydan özdeş olma olasılığı); \theta_{ii} klonun kendisiyle katsayısıdır ve kendileşmemiş bir klonda \tfrac12'dir.
- \Theta: grup akrabalığı; gen havuzundan yerine koyarak çekilen iki alelin soydan özdeş olma olasılığı.
Ne zaman kullanılır? Klon başına kozalak, tohum ya da dişi strobil sayımı (ve varsa erkek strobil ya da çiçek tozu ölçümü) elde olduğunda; tohum ürününün çeşitliliği belgelenecekse; eşit tohum toplama, en verimli klonlardan toplamayı sınırlama, rameta sayılarını eşitleme ve düşük ıslah değerli klonları seyreltme seçenekleri çeşitlilik ve kazanç bakımından karşılaştırılacaksa. Aynı hesap, ebeveyn başına döl sayısı bilinen bir ıslah popülasyonuna da uygulanır.
Ne zaman kullanılmaz?
- Klonların doğurganlık payı değil, bireylerin belirteç genotipleri eldeyse ve çeşitlilik alel zenginliği ya da heterozigotlukla ölçülecekse:
genetik_cesitlilik(Bölüm 73). - Klonlar arasındaki akrabalık bilinmiyor, belirteçlerden ya da soy kütüğünden kestirilecekse: önce
akrabalik(Bölüm 62); onun ürettiği ortak ata katsayısı matrisi bu şablona matris olarak verilir. - Polen kirliliği ya da kendileşme oranı belirteçlerle ölçülecekse (babalık çözümlemesi): bu şablon oranları kestirmez, girdi olarak alır.
- Çok kuşaklı ıslah planı (akrabalık sınırlamalı seçim, en uygun katkı) kurulacaksa: şablon tek kuşaklık ürünü değerlendirir.
- Islah değerlerinin kendisi kestirilecekse: temel programın karma model analizleri ya da
kalitim_derecesişablonu.
Temel programla ilişki. Temel programda statü sayısı ya da doğurganlık değişkenliği hesaplayan bir analiz yoktur; bu şablon MerQuR+'a özgüdür.
91.2 Şablonun girdileri
Form, üstbilgideki on yedi [[param]] bloğundan kurulur (tohum_bahcesi_cesitlilik.R:10–128).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Klon / ebeveyn kimliği · klon |
kategorik sütun · Değişkenler | ilk uygun sütun | herhangi bir sütun | Metne çevrilir; aynı kimlik birden çok satırdaysa satırlar birleştirilir (146, 164–174). |
Dişi doğurganlık · disi |
sayısal sütun · Değişkenler | ilk sayısal sütun | negatif olmayan sayı | p_{f,i} payları (146, 208). |
Erkek doğurganlık · erkek |
sayısal sütun · Değişkenler | boş | negatif olmayan sayı | p_{m,i} payları; boşsa erkek_yoksa varsayımı (147, 205). |
Rameta (aşı) sayısı · rameta |
sayısal sütun · Değişkenler | boş | pozitif sayı | Rameta eşitleme senaryosu (148, 326–329). |
Islah değeri · islah_degeri |
sayısal sütun · Değişkenler | boş | sayı | Beklenen kazanç G ve seyreltme sırası (149, 226, 342). |
Erkek doğurganlık verilmediğinde varsayım · erkek_yoksa |
seçim · Seçenekler | disi_ile_ayni |
disi_ile_ayni, esit |
p_m=p_f ya da p_m=1/N (204). |
Klonlar arası akrabalık · akrabalik |
seçim · Model | iliskisiz |
iliskisiz, aile, kosoy_matris, eklemeli_matris |
\theta matrisinin kaynağı (186–200). |
Aile · aile |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | akrabalik = aile iken aynı ailedeki klonlar akraba sayılır (190–191). |
Aile içi ortak ata katsayısı · aile_kosoy |
ondalık · Model | 0,125 | 0–0,5 | Aynı ailedeki iki klonun \theta_{ij} değeri (189, 191). |
Akrabalık matrisi sütunları · matris |
sütunlar · Değişkenler | boş | satır sayısı kadar sayısal sütun | \theta ya da A=2\theta matrisi (153–157, 193–199). |
Polen kirliliği oranı · kirlilik |
ondalık · Seçenekler | 0 | 0–1 | c: dış polenle döllenen tohum payı (139, 210). |
Kendileşme oranı · kendilesme |
ondalık · Seçenekler | 0 | 0–1 | s: rastgele çiftleşmenin üstüne eklenen kendileşme payı (139, 210, 225). |
Kendileşme payı tanımı · kendilesme_tanimi |
seçim · Seçenekler | ek |
ek, toplam |
ek: s rastgele çiftleşmedeki kendileşmenin üstüne eklenir (bugünkü hesap). toplam: s kendileşen tohumun toplam payıdır (140, 210–218). |
Dış polenin ıslah değeri · dis_polen_degeri |
ondalık · Seçenekler | 0 | \pm10^{9} | G ürün hesabındaki (c/2)\,BV_{\text{dış}} terimi (139, 226). |
Seyreltme düzeyleri · seyreltme |
metin · Seçenekler | 10, 20, 30 |
0–100 arası yüzdeler; boş = yok | Her düzey için bir senaryo satırı (333–355). |
Üst sınır senaryosu · ust_sinir |
ondalık · Seçenekler | 10 | 0–90; 0 = yok | En verimli %x klonun dişi doğurganlığı sınırlanır (317–325). |
Kuşak sayısı · kusak |
tam sayı · Çıktı | 10 | 1–200 | Heterozigotluk kaybı tablosunun satır sayısı (142, 281). |
Örnek ayar (ornek_param, satır 9): klon = klon, disi = kozalak, erkek = strobil, rameta = rameta, islah_degeri = islah_degeri, akrabalik = aile, aile = aile, aile_kosoy = 0,125, kirlilik = 0,1, kendilesme = 0,05, seyreltme = "10, 20, 30", ust_sinir = 10. Varsayılandan farklı olanlar akrabalık kipi (aile), kirlilik ve kendileşme oranlarıdır.
Şablonun kendi denetimleri (çalıştırmayı durdurur).
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 126 |
| Klon ya da dişi doğurganlık seçilmemiş | "Klon ve dişi doğurganlık sütunları seçilmeli." | 127 |
| Doğurganlık, rameta ya da ıslah değeri sütunu sayısal türde değil | "'…' sayısal olmalı." | 128–129 |
| c<0, s<0 ya da c+s>1 | "oranlar 0 ile 1 arasında olmalı ve toplamları 1'i geçmemeli" | 132 |
| Matris kipinde matris sütunu seçilmemiş | "matris sütunları seçilmeli" | 146 |
| Matris sütunu sayısı satır sayısına eşit değil | "Akrabalık matrisi kare olmalı: … satır, … matris sütunu." | 147 |
| Geçerli satır sayısı 2'den az | "Doğurganlığı bilinen en az 2 klon gerekli." | 153 |
| Negatif doğurganlık | "Doğurganlık değerleri negatif olamaz." | 154 |
| Matris kipinde yinelenen klon kimliği | "her klon tek satırda olmalı" | 156 |
| Birleştirme sonrası tek klon | "En az 2 farklı klon gerekli" | 167 |
| Dişi (ya da verilen erkek) doğurganlık toplamı 0 | "Hiçbir klonda dişi/erkek doğurganlık yok" | 168–169 |
| Islah değeri bazı klonlarda eksik | "bütün klonlarda ıslah değeri gerekli" | 172 |
| Rameta sayısı eksik ya da pozitif değil | "Rameta sayıları pozitif olmalı." | 174 |
| Aile kipinde aile sütunu seçilmemiş | "aile sütunu seçilmeli" | 179 |
| Matriste eksik değer; simetrik olmayan matris; köşegen [0{,}5;\,1] dışında; negatif öğe | ilgili ileti | 185–189 |
| Seyreltme düzeyi sayı değil ya da (0,\,100) dışında | "0 ile 100 arasında yüzdeler olmalı" | 306 |
Uyarılar (durdurmaz): eksik klon kimliği ya da eksik doğurganlığı olan satırlar atılır ve sayısı yazılır (159–160); yinelenen klon kimlikleri birleştirilir (171); ıslah değeri sütunu bütünüyle boşsa kazanç hesaplanmaz (180); matris pozitif yarı tanımlı değilse not düşülür (199); dişi ya da erkek doğurganlık sabitse korelasyon hesaplanmaz (267); bir seyreltme düzeyi uygulanamıyorsa (kalan klon 2'den az ya da kalanlarda doğurganlık yok) o satır atlanır (347).
Satırların birleştirilmesi. Veri rameta (aşı) başına bir satır tutuyorsa aynı klon kimliği yinelenir. Şablon bu durumda klonun dişi ve erkek doğurganlıklarını toplar, ıslah değerinin ortalamasını alır, aile bilgisini klonun ilk satırından okur; rameta sütunu verilmemişse klonun satır sayısını rameta sayısı sayar (166–173).
91.3 Örnek veri
Dosya: _ornek/tohum_bahcesi_cesitlilik.csv. Sabit tohumla üretilmiş yapay bir çam tohum bahçesi: 30 klon, 6 sütun, eksik değer yok.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
klon |
Klon kimliği | metin | K01–K30; her klon tek satır. |
kozalak |
Dişi doğurganlık | sayısal | Toplam 3900; ortalama 130; en az 0 (K14), en çok 577 (K20). |
strobil |
Erkek doğurganlık | sayısal | Toplam 18468; ortalama 615,6; iki klonda 0 (K07, K21), en çok 3054 (K15). |
rameta |
Rameta sayısı | sayısal | 3–8; toplam 173. |
islah_degeri |
Islah değeri | sayısal | −17,5 ile 16,3 arası; ortalama −0,47. |
aile |
Aile | metin | 23 klonda klonun kendi adı (ilişkisiz); üç ailede birden çok klon: F1 (K03, K17), F2 (K08, K22, K29), F3 (K11, K25). |
Klon kimliği ve aile sütunları metin türündedir; düzey sırası hiçbir hesabı etkilemez. Klon tablosu verinin satır sırasıyla yazılır; öteki bütün sonuçlar satır sırasından bağımsızdır (satırları karıştırılmış veriyle farklar 10^{-13}'ün altındadır).
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) akrabalik = iliskisiz, c=s=0; (3) erkek sütunu boş, varsayılan erkek_yoksa; (4) erkek sütunu boş, erkek_yoksa = esit; (5) aynı akrabalık \theta ve A matrisi sütunlarıyla; (6) rameta başına bir satır tutan 173 satırlık veri; (7) tek yarım kardeş ailesinden 20 eşit doğurganlıklı klon; (8) Kang ve ark.'nın (2004) Tablo 1'indeki üç değişim katsayısını taşıyan 180 klonluk yapay diziler; (9) sınır ve yazım denemeleri (karıştırılmış satırlar, boş aile hücreleri, sayı kimlikli klonlar, ondalıklı seyreltme düzeyleri).
91.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) eksik satırlar atılır, yinelenen klonlar birleştirilir; (2) \theta matrisi akrabalık kipine göre kurulur; (3) dişi, erkek ve toplam paylardan \Psi, N_p, \Theta, N_s hesaplanır; (4) kirlilik ve kendileşme oranlarıyla tohum ürününün gen katkıları, statü sayısı ve beklenen kendileşme katsayısı bulunur; (5) aynı çekirdek her senaryonun değiştirilmiş doğurganlıklarıyla yeniden çağrılır; (6) Lorenz noktaları, klon sayısı tablosu ve iki şekil yazılır.
91.4.1 Doğurganlık payları ve erkeklik indeksi
- f_i, m_i: i. klonun dişi ve erkek doğurganlık ölçüsü (kozalak ve erkek strobil sayısı gibi).
- p_{f,i}, p_{m,i}: klonun ana ve baba olarak payı; p_i gen havuzuna toplam katkısı.
- M_i: erkeklik indeksi; 0 yalnız ana, 1 yalnız baba olarak katkı demektir. p_{f,i}+p_{m,i}=0 ise hücre boş kalır.
Neden iki payın ortalaması?
Her tohum genlerinin yarısını anadan, yarısını babadan alır. Bir klonun ürüne gen katkısı bu yüzden ana ve baba paylarının yarı yarıya ortalamasıdır. Dişi ve erkek ölçülerinin birimi (kozalak sayısı, strobil sayısı) farklı olabilir; paylar ayrı ayrı normalleştirildiği için birim sonucu etkilemez.
Koddaki tercih
Erkek sütunu verilmemişse erkek_pay iki varsayımdan birini kurar (satır 204): varsayılan p_m=p_f (her klonun baba payı ana payıyla aynı), seçenek p_m=1/N (baba katkıları eşit). İlki toplam \Psi'yi en büyük, ikincisi en küçük yapar; hangisinin kullanıldığı konsola yazılır (243–246). Hasat biçimini değiştiren senaryolarda (eşit tohum toplama, üst sınır) çiçek tozu payları p_m=p_f varsayımıyla gözlenen doğurganlıktan türetilir ve değişmez (m_polen, satır 312–313); rameta eşitleme ve seyreltmede polen de bahçenin kendisiyle birlikte değiştiğinden payları senaryonun doğurganlığından kurulur (91.8).
91.4.2 Doğurganlık değişkenliği ve etkili ebeveyn sayısı
- CV: doğurganlığın klonlar arası değişim katsayısı; standart sapma N bölenlidir (N-1 değil).
- r: dişi ve erkek doğurganlık arasındaki Pearson korelasyonu.
- \Psi=1 bütün klonların eşit katkısı, \Psi=N tek klonun bütün ürünü vermesi demektir.
Neden CV N bölenli?
N\sum p_i^2=CV^2+1 özdeşliği yalnız kitle varyansıyla (N bölen) tamdır: \sum p_i^2=\tfrac1N+\sum(p_i-\tfrac1N)^2 ve ikinci terim N\,\mathrm{Var}_N(p)'dir. Bahçedeki klonlar bir örneklem değil, ürünü veren kitlenin tamamıdır; bu yüzden kitle varyansı kullanılır. N-1 bölenli değişim katsayısıyla hesaplanan \Psi, örnek veride (N=30) yaklaşık %2 büyük çıkar.
Toplam için ikinci formül birincinin açılımıdır: p_i=(p_{f,i}+p_{m,i})/2 yerine konunca N\sum p_i^2=\tfrac14(\Psi_f+\Psi_m)+\tfrac12N\sum p_{f,i}p_{m,i} ve N\sum p_{f,i}p_{m,i}=1+r\,CV_f\,CV_m olur. Şablon iki yolu da hesaplar; tabloda Psi paylardan, Psi_CV değişim katsayılarından gelir ve ikisi aynı sayıdır.
Şablon ayrıca dişi ve erkek doğurganlık arasındaki Pearson r'yi (iki yönlü p değeriyle) ve Spearman \rho'yu verir. Pozitif korelasyon, kozalağı çok olan klonların çiçek tozunun da çok olduğunu ve toplam \Psi'nin büyüdüğünü gösterir; negatif korelasyon dişi ve erkek eşitsizliklerinin birbirini kısmen dengelediği anlamına gelir.
Koddaki tercih
cvN fonksiyonu N bölenli standart sapmayı elle kurar (satır 206). Pearson r stats::cor, p değeri stats::cor.test ile hesaplanır (N\ge3 ise; satır 250, 243). Spearman \rho cor(method = "spearman") ile bulunur; onun için p değeri hesaplanmaz ve tablodaki hücre boş kalır (265).
91.4.3 Grup akrabalığı, statü sayısı ve gen çeşitliliği
- \boldsymbol\theta: N\times N ortak ata katsayısı matrisi; köşegeni \theta_{ii}=(1+F_i)/2, F_i klonun kendileşme katsayısı.
- N_s (statü sayısı): aynı grup akrabalığını veren, birbiriyle ilişkisiz, kendileşmemiş ve eşit katkılı klonların sayısı.
- N_r: göreli statü sayısı; GD: gen çeşitliliği (kaynak popülasyonun heterozigotluğunun korunan payı).
Neden 1/(2\Theta)?
İlişkisiz, kendileşmemiş ve eşit katkılı n klonda \theta_{ii}=\tfrac12, \theta_{ij}=0 ve p_i=1/n'dir; \Theta=n\cdot\tfrac{1}{n^2}\cdot\tfrac12=\tfrac{1}{2n}. Tersine çevrilince n=1/(2\Theta) bulunur. Herhangi bir bahçenin \Theta'sı bu ölçeğe çevrildiğinde "kaç ideal klona eşdeğer" sorusunun cevabı elde edilir. Klonlar ilişkisiz ve kendileşmemişse \Theta=\tfrac12\sum p_i^2 ve N_s=N_p olur; akrabalık N_s'yi N_p'nin altına çeker.
Akrabalık kipleri \boldsymbol\theta'yı şöyle kurar:
| Kip | \theta_{ii} | \theta_{ij} (i\ne j) |
|---|---|---|
| İlişkisiz ve kendileşmemiş | \tfrac12 | 0 |
| Aile sütunu | \tfrac12 | aynı ailedeyse aile_kosoy, değilse 0 |
| \theta matrisi | sütunlardaki değer | sütunlardaki değer |
| A matrisi | A_{ii}/2 | A_{ij}/2 |
Koddaki tercih
Aile kipinde matris outer(a, a, "==") * tk ile kurulur, köşegen 0,5 yapılır (satır 190–191). Aile hücresi boş olan klon kendi başına bir aile sayılır (190); böylece boş hücreli klonlar birbirine akraba sayılmaz. Matris kipinde sütunların sırası satırların klon sırasıyla aynı olmalıdır: i. satırın j. matris sütunundaki değer, i. ve j. satırdaki klonların katsayısıdır. Şablon sütun adlarını klon adlarıyla eşleştirmez; simetriyi (10^{-8} toleransla), köşegenin [0{,}5;\,1] aralığını ve negatif öğe olmadığını denetler (194–198). Eksik doğurganlık nedeniyle atılan satırların matristeki satır ve sütunları da atılır (193).
Aile kipi iki sınırlama taşır: aile içi katsayı bütün ailelerde aynıdır ve aileler arası akrabalık sıfır sayılır. Karışık dereceli akrabalıkta (bazı klonlar tam kardeş, bazıları kuzen) matris kipi kullanılır; matris Bölüm 62'deki soy kütüğü kipinden elde edilebilir.
91.4.4 Tohum ürünü: polen kirliliği ve kendileşme
Ebeveyn düzeyindeki \Theta, bütün döllenmelerin bahçe içi çiçek tozuyla ve paylarla orantılı olduğunu varsayar. Tohum ürünü için iki oran eklenir: c, bahçe dışından gelen çiçek tozuyla döllenen tohumların payı; s, rastgele çiftleşmede beklenenin üstünde, ananın kendi çiçek tozuyla döllenen tohumların payı.
- \pi_i: i. klonun tohum ürünündeki baba payı; \sum_i\pi_i=1-c (kalan c dış polendir).
- g_i: klonun tohum ürününün gen havuzundaki payı; \sum_i g_i=1-c/2.
- F_{\text{tohum}}: tohumun beklenen kendileşme katsayısı; ana ile babanın ortak ata katsayısının bütün ana–baba birleşimleri üzerinden beklenen değeri.
Neden dış polen çeşitliliği artırıyor görünüyor?
Dış polen ilişkisiz ve sonsuz çeşitlilikte bir kaynak sayılır: bahçedeki hiçbir klonla ve kendi içinde akrabalığı yoktur (\theta=0). Gen havuzunun c/2'lik payı bu yüzden \Theta_{\text{ürün}}'e hiç katkı yapmaz ve statü sayısı yükselir. Bedeli kazanç tarafındadır: dış polenin ıslah değeri (varsayılan 0) bahçe klonlarınınkinden düşükse ürünün beklenen ıslah değeri azalır. Çevredeki meşcereler bahçe klonlarıyla akrabaysa bu varsayım çeşitliliği olduğundan yüksek gösterir.
s toplam kendileşme payı değildir
Formüldeki bahçe içi çapraz terim (1-s-c)\,\mathbf p_f^{\top}\boldsymbol\theta\,\mathbf p_m, ananın kendi çiçek tozuyla rastlantısal döllenmesini de içerir (i=j terimleri, toplam payı (1-s-c)\sum_i p_{f,i}p_{m,i}). s bunun üstüne eklenir. Örnek ayarda s=0{,}05 girilmiştir; modelin içerdiği toplam kendileşme payı ise 0{,}05+0{,}85\cdot0{,}0489=0{,}0916'dır. Babalık çözümlemesiyle ölçülmüş toplam kendileşme oranı eldeyse forma bu oranın rastlantısal payı aşan kısmı yazılır; toplam oran yazılırsa F_{\text{tohum}} olduğundan büyük çıkar.
Toplam oranı doğrudan girmek için "Kendileşme payı tanımı" toplam seçilir (140, 210–218). Bu tanımda s kendileşen tohumun toplam payıdır (rastgele çiftleşmede aynı klonun polenini alma dahil) ve kalan (1-s-c), her dişi i için yalnız başka klonların polenine dağıtılır: baba j\ne i olasılığı (1-s-c)\,p_{m,j}/(1-p_{m,i}), dişi payları p_f değişmez. Çapraz terimden i=j çiftleri çıkmış olur; F_{\text{tohum}}=s\sum_i p_{f,i}\theta_{ii}+(1-s-c)\sum_i \frac{p_{f,i}}{1-p_{m,i}}\sum_{j\ne i}p_{m,j}\theta_{ij} olur ve babanın gen payı buna göre s\,p_{f,j}+(1-s-c)\,p_{m,j}\sum_{i\ne j}p_{f,i}/(1-p_{m,i}) biçimini alır. Örnek ayarda (s=0{,}05, c=0{,}1) F_{\text{tohum}} 0,04786'dan 0,02712'ye, \Theta 0,029156'dan 0,028742'ye ve N_s (tohum ürünü) 17,149'dan 17,396'ya geçer; s=0 iken bu tanımda hiç kendileşme yoktur. Bu üç değer, (anne, baba) çiftlerinin olasılık matrisi kurularak bağımsız hesaplanır (olasılıkların toplamı 1-c, köşegen toplamı s). Çıktıya "Kendileşme payı tanımı: toplam" notu yazılır ve "Modeldeki toplam kendileşme payı" notu yazılmaz (238–242).
c=s=0 ve p_f=p_m iken g=p ve F_{\text{tohum}}=\Theta olur: gamet havuzu yaklaşımındaki "bir sonraki kuşağın kendileşmesi bu kuşağın grup akrabalığına eşittir" sonucu (Kang ve Lindgren, 1999). Dişi ve erkek paylar farklıyken F_{\text{tohum}}=\mathbf p_f^{\top}\boldsymbol\theta\mathbf p_m ile \Theta=\mathbf p^{\top}\boldsymbol\theta\mathbf p ayrışır: ilki ana ile babanın akrabalığıdır, ikincisi gen havuzundan çekilen herhangi iki genin. Yüksek dişi payı olan klonların erkek payı düşükse F_{\text{tohum}}<\Theta olur (91.9 S5).
Beklenen genetik kazanç iki düzeyde verilir:
- BV_i: klonun ıslah değeri (sütundaki ölçekte; şablon ölçeği değiştirmez).
- BV_{\text{dış}}: dış polenin ıslah değeri (
dis_polen_degeri). Islah değerleri bahçe ortalamasından sapma olarak verilmişse 0, ıslah edilmemiş kaynağı temsil etmez; dış kaynağın o ölçekteki değeri yazılır.
91.4.5 Kuşaklar boyunca heterozigotluk kaybı
- H_t/H_0: t kuşak sonra korunan heterozigotluk payı; kayıp 1-H_t/H_0.
- 1/(2N_e)=\Theta_{\text{ürün}}: kuşak başına beklenen kayıp.
Neden N_e yerine statü sayısı?
İdeal bir popülasyonda kuşak başına heterozigotluk kaybı 1/(2N_e)'dir (Wright, 1931). Statü sayısı, aynı grup akrabalığını veren ideal klon sayısı olarak tanımlandığından bu formülde N_e'nin yerine geçer. Tablo, tohum ürününün statü sayısının sonraki bütün kuşaklarda aynı kaldığını varsayan bir izdüşümdür; gerçek bir ıslah planında her kuşağın N_s'si farklıdır.
91.4.6 Senaryolar
Her senaryo dişi (ve gerekirse erkek) doğurganlık vektörünü değiştirir, 91.4.1–91.4.4'teki hesabı yeniden yapar ve tabloya bir satır ekler (satır 304–359).
| Senaryo | Dişi doğurganlık | Erkek doğurganlık | Tohum oranı |
|---|---|---|---|
| Mevcut | f_i | m_i | 1 |
| Eşit tohum toplama | kozalak veren klonlarda 1, ötekilerde 0 | m_i | n^{+}\min_{f>0}f_i\big/\sum f_i |
| Üst sınır (%x) | \min(f_i,\,q); q en verimli (k+1). klonun değeri | m_i | \sum\min(f_i,q)\big/\sum f_i |
| Rameta eşitleme | f_i/r_i | m_i/r_i | hesaplanmaz |
| Seyreltme (%y) | çıkarılan k klon dışındakilerin f_i'si | aynı klonların m_i'si | \sum_{\text{kalan}}f_i\big/\sum f_i |
- n^{+}: kozalak veren klon sayısı; her birinden en az kozalak veren klonunki kadar toplanabildiği için tohum oranı n^{+}\min f/\sum f'dir.
- k=\lfloor N\,x/100+0{,}5\rfloor: yüzdeye karşılık gelen klon sayısı (yarım yukarı yuvarlanır); üst sınır senaryosu 1\le k<N ise kurulur.
- r_i: rameta sayısı.
Neden üst sınır "bir sonraki klonun düzeyi"?
En verimli k klondan toplanan kozalak, sıradaki klonun verdiği kadarla sınırlanırsa hiçbir klon ürünü tek başına sürüklemez ve tohum kaybı küçük kalır (Kang ve ark., 2003, 2004). Eşit toplama ise çeşitliliği en çok artıran, ama en az kozalak veren klonun düzeyine inildiği için en çok tohum kaybettiren uçtur. İki senaryo, çeşitlilik ile ürün miktarı arasındaki dengenin iki ucunu gösterir.
Seyreltme sırası. Islah değeri verilmişse klonlar ıslah değerine göre artan sırayla çıkarılır; eşitlikte toplam payı p_i küçük olan önce gider; o da eşitse klon kimliğinin doğal sırası kullanılır (harf kısmı, sonra sayı kısmı: K2, K10'dan öncedir; satır 340–342). Islah değeri yoksa sıra yalnız p_i'ye göredir. Seyreltmede \boldsymbol\theta matrisinden çıkarılan klonların satır ve sütunları silinir, kalan klonların payları yeniden normalleştirilir; c ve s değişmez.
Koddaki tercih
seyreltme metninde noktalı virgül varsa düzeyleri yalnız noktalı virgül ayırır ve virgül ondalık sayılır (12,5; 25 iki düzey: %12,5 ve %25); noktalı virgül yoksa virgül ve boşluk liste ayırıcısıdır (10, 20, 30; ondalık düzey nokta ile: 12.5) ve 12,5 gibi rakamlar arası virgül için ondalık olabileceği uyarısı yazılır (satır 330–335). Senaryo satırlarının adında uygulanan yüzde ve çıkarılan klon sayısı yazdığından sonuç denetlenebilir. Düzeyler küçükten büyüğe sıralanır ve yinelenenler bir kez alınır (343).
91.4.7 Lorenz noktaları ve klon sayısının etkisi
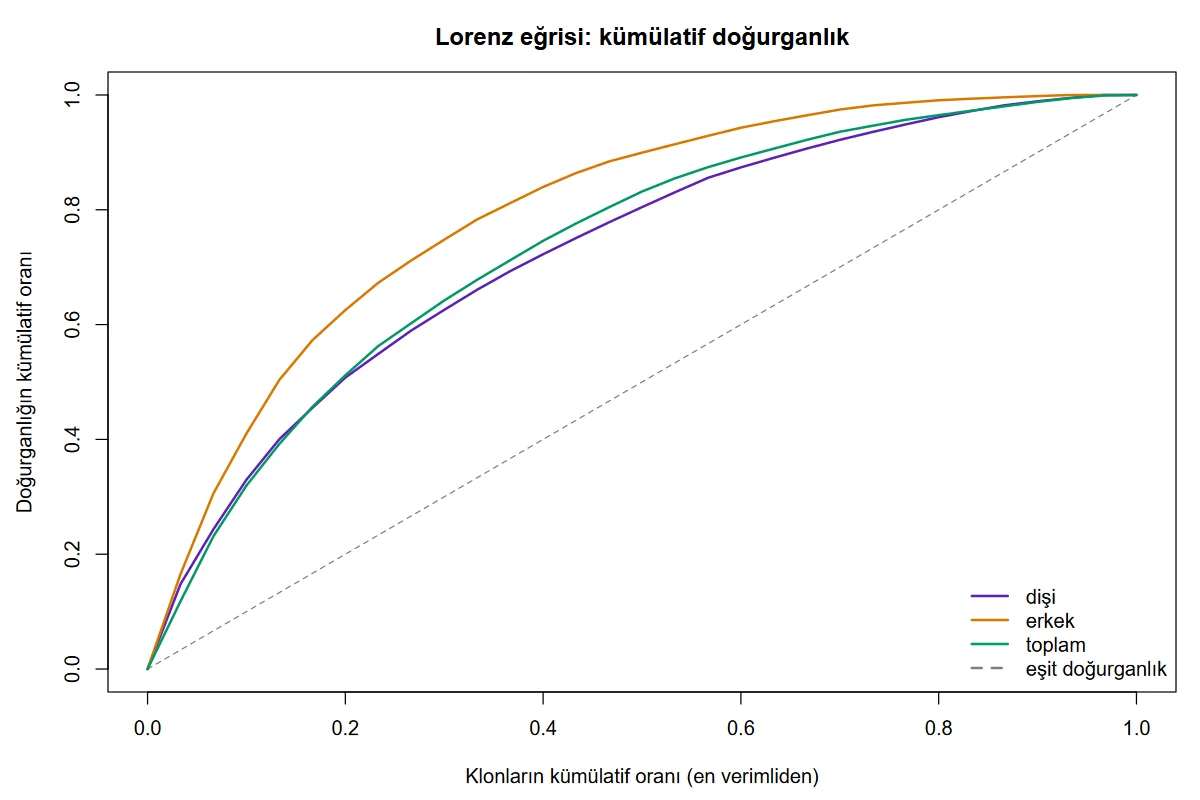
Paylar büyükten küçüğe sıralanıp birikimli toplanır; klonların en verimli %10, %20, %25 ve %50'sinin (yine \lfloor N x+0{,}5\rfloor klon, en az 1) dişi, erkek ve toplam paydaki birikimli katkısı tabloya yazılır (satır 295–300). Son tablo, aynı \Psi korunurken klon sayısı 10, 20, 30, 50, 100 ve N olsaydı beklenecek N_p=N/\Psi değerlerini verir (363–365); bu, "bahçeyi büyütmek mi, katkıları eşitlemek mi" sorusuna kaba bir karşılaştırma ölçüsüdür ve akrabalığı hesaba katmaz.
91.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–129 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on altı parametre. | Form buradan kurulur (Bölüm 1.2). |
| 130–143 | Yardımcılar (.m, bos, sayi_p); parametre okuma; oran denetimi. |
Boş bırakılan sayısal alan varsayılanına döner (132). |
| 145–183 | Klon başına veri çerçevesi; eksik satırların atılması; yinelenen klonların birleştirilmesi; doğurganlık, ıslah değeri ve rameta denetimleri. | Dişi doğurganlığı eksik satır, erkek değeri olsa da atılır (159). Matris kipinde özgün satır numarası saklanır (151). |
| 185–200 | \boldsymbol\theta matrisi: ilişkisiz, aile ya da matris. | Varsayılan diag(0.5, N) (186). |
| 202–229 | Hesap çekirdeği cekirdek: paylar, \Psi, \Theta, g, F_{\text{tohum}}, G. |
Bütün senaryolar bu tek fonksiyonu çağırır; ikinci dereceden biçim crossprod(q, Tm %*% q) (209). |
| 231–268 | Konsol özeti; tablo 1 (doğurganlık değişkenliği) ve tablo 2 (korelasyon). | Erkek sütunu yoksa tablo 2 yazılmaz ve tabloların sırası bir kayar. |
| 270–292 | Tablo 3 (tohum ürünü), tablo 4 (heterozigotluk kaybı), tablo 5 (klon tablosu). | G satırları yalnız ıslah değeri varsa eklenir (274). |
| 294–300 | Tablo 6 (Lorenz noktaları). | |
| 302–360 | Senaryolar: sen yardımcı fonksiyonu ve tablo 7. |
Islah değeri yoksa G_urun sütunu silinir (357). |
| 362–365 | Tablo 8 (klon sayısının etkisi). | |
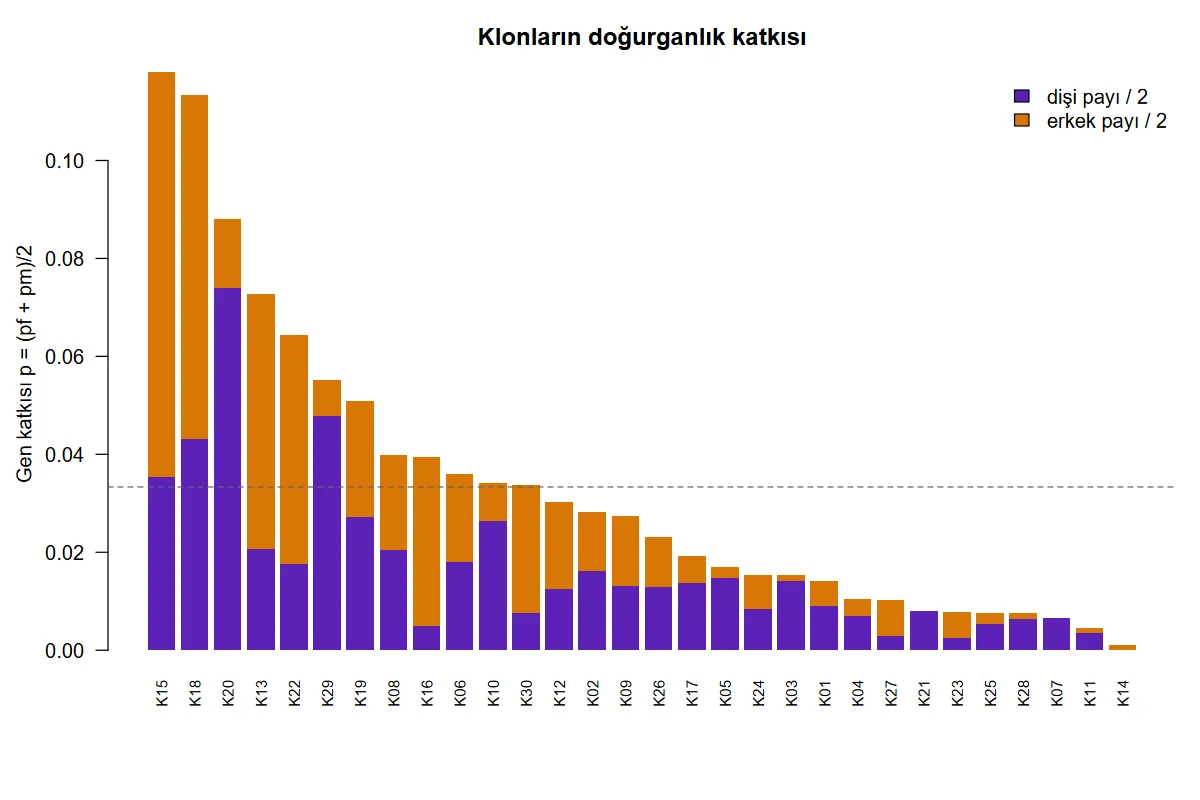
| 367–386 | Şekil 1 (Lorenz eğrisi) ve şekil 2 (klon katkıları çubuk grafiği). | Çubuklar toplam paya göre azalan sıradadır (378). |
Şablon rastgele sayı kullanmaz; aynı veri ve ayar her çalıştırmada aynı sonucu verir.
91.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/tohum_bahcesi_cesitlilik/elle_hesap.py ile, bütün toplamlar klon çiftleri üzerinde açık döngüyle kurularak hesaplanmıştır. R tarafında (r_dogrulama.R) başka formülasyonlar kullanılmıştır: \Psi değişim katsayılarından, \Theta aile toplamlarından, tohum ürünü büyüklükleri ana × baba olasılık tablosundan.
Adım 1 — Paylar. \sum f=3900, \sum m=18468. K15 klonu için (276 kozalak, 3054 strobil):
Adım 2 — Doğurganlık değişkenliği. \sum p_f^2=0{,}062506, \sum p_m^2=0{,}084497, \sum p^2=0{,}061219:
Değişim katsayılarıyla: CV_f=0{,}935517, CV_m=1{,}238915, r=0{,}403875;
N_p=30/1{,}836576=16{,}3347.
Adım 3 — Grup akrabalığı. Aile kipinde \Theta=\tfrac12\sum p_i^2+0{,}125\sum_{\text{aile}}\big[(\sum_{i\in a}p_i)^2-\sum_{i\in a}p_i^2\big]. Üç ailenin katkısı:
| Aile | Klonlar | \sum p_i | (\sum p_i)^2-\sum p_i^2 |
|---|---|---|---|
| F1 | K03, K17 | 0,034616 | 0,000591 |
| F2 | K08, K22, K29 | 0,159275 | 0,016606 |
| F3 | K11, K25 | 0,012230 | 0,000070 |
| Toplam | 0,017266 |
N_r=15{,}2588/30=0{,}5086; GD=0{,}967232. Akrabalık yok sayılsaydı N_s=N_p=16{,}3347 olurdu; farkın neredeyse tamamı F2 ailesinden gelir, çünkü üç üyesi birlikte gen havuzunun %15,9'unu verir.
Adım 4 — Tohum ürünü. c=0{,}1, s=0{,}05. K15 için \pi=0{,}05\cdot0{,}070769+0{,}85\cdot0{,}165367=0{,}144100 ve g=(0{,}070769+0{,}144100)/2=0{,}107435. Bütün klonlarda \sum g_i=0{,}95, \sum g_i^2=0{,}054329; aile içi çapraz toplam 0{,}015936:
Adım 5 — Tohumda beklenen kendileşme. \sum p_{f,i}p_{m,i}=0{,}048937; \mathbf p_f^{\top}\boldsymbol\theta\mathbf p_m=\tfrac12\cdot0{,}048937+0{,}002424=0{,}026892:
Adım 6 — Kazanç. G_{\text{ebeveyn}}=\sum p_iBV_i=-3{,}2254; G_{\text{ürün}}=\sum g_iBV_i+0{,}05\cdot0=-2{,}9174. Ebeveyn düzeyindeki değerin ortalama ıslah değerinden (-0{,}47) düşük olması, ürüne en çok katkı yapan klonların (K15, K18) ıslah değerlerinin düşük olmasındandır.
Adım 7 — Heterozigotluk. Kuşak başına kayıp \Theta_{\text{ürün}}=0{,}029156; on kuşak sonra H_{10}/H_0=0{,}970844^{10}=0{,}743864.
Adım 8 — Bir senaryo: %10 seyreltme. k=\lfloor3+0{,}5\rfloor=3; en düşük ıslah değerli üç klon K09 (-17{,}5), K15 (-16{,}6) ve K06 (-14{,}1) çıkarılır. Kalan 27 klonla \Psi=1{,}836453, N_s=13{,}4382, N_{s,\text{ürün}}=15{,}0418, G_{\text{ürün}}=-0{,}2867; tohum oranı (3900-103-276-140)/3900=0{,}8669.
Adım 9 — Yayımlanmış değerlerle karşılaştırma. Lindgren ve Mullin'in (1998) örneği: tek bir yarım kardeş ailesinden 20 eşit doğurganlıklı klon. \Theta=\tfrac{1}{20}\cdot\tfrac12+\tfrac{19}{20}\cdot\tfrac18=0{,}14375 ve N_s=3{,}4783; şablon aynı veride 3,47826 verir. Kang ve ark.'nın (2004) 180 klonlu Kore çamı bahçesi için Tablo 1'de verdiği üç değişim katsayısı (1,425; 1,025; 0,743) aynı CV'yi taşıyan yapay dizilerle şablona verildiğinde \Psi=3{,}03; 2{,}05; 1{,}55, N_p=59{,}4; 87{,}8; 116{,}0 ve N_r=0{,}33; 0{,}49; 0{,}64 elde edilir; bunlar makalenin Tablo 1'indeki değerlerdir.
91.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle okunmuştur (çalıştırmalar 1–4 ve 6–8).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Dişi CV (N bölenli) | 0,93551661 | 0,93551661 | 0,93551661 | 3,3e−16 | ✓ |
| Erkek CV | 1,23891512 | 1,23891512 | 1,23891512 | 3,6e−15 | ✓ |
| \Psi dişi (N\sum p^2) | 1,87519132 | 1,87519132 | 1,87519132 | 2,1e−15 | ✓ |
| \Psi erkek (N\sum p^2) | 2,53491067 | 2,53491067 | 2,53491067 | 1,4e−15 | ✓ |
| \Psi toplam (N\sum p^2) | 1,83657629 | 1,83657629 | 1,83657629 | 7,3e−16 | ✓ |
| \Psi toplam (CV formülü) | 1,83657629 | 1,83657629 | 1,83657629 | 7,3e−16 | ✓ |
| N_p dişi | 15,99836756 | 15,99836756 | 15,99836756 | 1,7e−15 | ✓ |
| N_p erkek | 11,83473654 | 11,83473654 | 11,83473654 | 7,5e−16 | ✓ |
| N_p toplam | 16,33474208 | 16,33474208 | 16,33474208 | 1,7e−15 | ✓ |
| \Theta dişi | 0,03363805 | 0,03363805 | 0,03363805 | 6,9e−18 | ✓ |
| \Theta erkek | 0,0436494 | 0,0436494 | 0,0436494 | 4,2e−17 | ✓ |
| \Theta toplam | 0,0327679 | 0,0327679 | 0,0327679 | 2,1e−17 | ✓ |
| N_s dişi | 14,86411937 | 14,86411937 | 14,86411937 | 6,7e−15 | ✓ |
| N_s erkek | 11,45491153 | 11,45491153 | 11,45491153 | 3,3e−15 | ✓ |
| N_s toplam | 15,25883395 | 15,25883395 | 15,25883395 | 1,2e−15 | ✓ |
| N_r toplam | 0,5086278 | 0,5086278 | 0,5086278 | 6,7e−16 | ✓ |
| Pearson r | 0,40387508 | 0,40387508 | 0,40387508 | 0 | ✓ |
| Pearson r: p | 0,02687198 | 0,02687198 | 0,02687198 | 0 | ✓ |
| Spearman \rho | 0,56691512 | 0,56691512 | 0,56691512 | 1,1e−16 | ✓ |
| Tohum ürünü \Theta | 0,02915625 | 0,02915625 | 0,02915625 | 1,7e−17 | ✓ |
| Tohum ürünü N_s | 17,1489805 | 17,1489805 | 17,1489805 | 2,7e−15 | ✓ |
| Tohumda beklenen F | 0,04785827 | 0,04785827 | 0,04785827 | 4,2e−17 | ✓ |
| \sum g | 0,95 | 0,95 | 0,95 | 0 | ✓ |
| G ebeveyn | −3,22543198 | −3,22543198 | −3,22543198 | 1,5e−15 | ✓ |
| G ürün | −2,91739667 | −2,91739667 | −2,91739667 | 1,2e−15 | ✓ |
| H_{10}/H_0 | 0,74386373 | 0,74386373 | 0,74386373 | 1,1e−16 | ✓ |
| K15: p | 0,11806818 | 0,11806818 | 0,11806818 | 4,2e−16 | ✓ |
| K15: g | 0,10743487 | 0,10743487 | 0,10743487 | 9,7e−17 | ✓ |
| K20: p | 0,08805276 | 0,08805276 | 0,08805276 | 4,2e−17 | ✓ |
| K20: g | 0,08963972 | 0,08963972 | 0,08963972 | 0 | ✓ |
| Lorenz %10: toplam pay | 0,31956282 | 0,31956282 | 0,31956282 | 2,8e−16 | ✓ |
| Lorenz %50: toplam pay | 0,83180703 | 0,83180703 | 0,83180703 | 0 | ✓ |
| Lorenz %10: dişi pay | 0,32974359 | 0,32974359 | 0,32974359 | 2,8e−16 | ✓ |
| Lorenz %10: erkek pay | 0,41016894 | 0,41016894 | 0,41016894 | 2,2e−16 | ✓ |
| Eşit toplama: N_s | 20,09993062 | 20,09993062 | 20,09993062 | 2,1e−15 | ✓ |
| Eşit toplama: N_s ürün | 23,44152068 | 23,44152068 | 23,44152068 | 2,0e−15 | ✓ |
| Eşit toplama: F | 0,04077843 | 0,04077843 | 0,04077843 | 2,1e−17 | ✓ |
| Eşit toplama: G ürün | −2,24257161 | −2,24257161 | −2,24257161 | 1,4e−15 | ✓ |
| Eşit toplama: tohum oranı | 0,14871795 | 0,14871795 | 0,14871795 | 2,8e−16 | ✓ |
| Üst sınır %10: N_s | 15,889613 | 15,889613 | 15,889613 | 2,9e−15 | ✓ |
| Üst sınır %10: N_s ürün | 18,06685368 | 18,06685368 | 18,06685368 | 1,8e−15 | ✓ |
| Üst sınır %10: F | 0,04823974 | 0,04823974 | 0,04823974 | 6,9e−18 | ✓ |
| Üst sınır %10: G ürün | −3,06731148 | −3,06731148 | −3,06731148 | 1,2e−15 | ✓ |
| Üst sınır %10: tohum oranı | 0,8825641 | 0,8825641 | 0,8825641 | 4,4e−16 | ✓ |
| Rameta eşitleme: N_s | 16,05719747 | 16,05719747 | 16,05719747 | 2,2e−16 | ✓ |
| Rameta eşitleme: N_s ürün | 18,09440689 | 18,09440689 | 18,09440689 | 2,7e−15 | ✓ |
| Rameta eşitleme: F | 0,0467598 | 0,0467598 | 0,0467598 | 4,9e−17 | ✓ |
| Rameta eşitleme: G ürün | −2,1935479 | −2,1935479 | −2,1935479 | 8,1e−16 | ✓ |
| Seyreltme %10: N_s | 13,4382357 | 13,4382357 | 13,4382357 | 2,0e−15 | ✓ |
| Seyreltme %10: N_s ürün | 15,04183035 | 15,04183035 | 15,04183035 | 2,4e−16 | ✓ |
| Seyreltme %10: F | 0,05048448 | 0,05048448 | 0,05048448 | 1,4e−17 | ✓ |
| Seyreltme %10: G ürün | −0,28671053 | −0,28671053 | −0,28671053 | 0 | ✓ |
| Seyreltme %20: N_s | 11,99649259 | 11,99649259 | 11,99649259 | 4,3e−15 | ✓ |
| Seyreltme %20: N_s ürün | 13,35511685 | 13,35511685 | 13,35511685 | 1,2e−15 | ✓ |
| Seyreltme %20: F | 0,05146311 | 0,05146311 | 0,05146311 | 2,1e−17 | ✓ |
| Seyreltme %20: G ürün | 2,6263874 | 2,6263874 | 2,6263874 | 5,1e−16 | ✓ |
| Seyreltme %30: N_s | 9,63948049 | 9,63948049 | 9,63948049 | 5,5e−16 | ✓ |
| Seyreltme %30: N_s ürün | 10,82239389 | 10,82239389 | 10,82239389 | 4,4e−15 | ✓ |
| Seyreltme %30: F | 0,05920146 | 0,05920146 | 0,05920146 | 4,2e−17 | ✓ |
| Seyreltme %30: G ürün | 3,89028808 | 3,89028808 | 3,89028808 | 1,0e−15 | ✓ |
| Seyreltme %30: tohum oranı | 0,65641026 | 0,65641026 | 0,65641026 | 4,4e−16 | ✓ |
| Klon sayısı 50: N_p | 27,22457013 | 27,22457013 | 27,22457013 | 2,5e−15 | ✓ |
| İlişkisiz, c=s=0: \Psi toplam | 1,83657629 | 1,83657629 | 1,83657629 | 7,3e−16 | ✓ |
| İlişkisiz, c=s=0: N_s toplam | 16,33474208 | 16,33474208 | 16,33474208 | 2,0e−15 | ✓ |
| İlişkisiz, c=s=0: N_s ürün | 16,33474208 | 16,33474208 | 16,33474208 | 2,0e−15 | ✓ |
| İlişkisiz, c=s=0: F | 0,02446836 | 0,02446836 | 0,02446836 | 1,7e−17 | ✓ |
| Erkek yok (p_m=p_f): \Psi toplam | 1,87519132 | 1,87519132 | 1,87519132 | 2,1e−15 | ✓ |
| Erkek yok (p_m=p_f): N_s toplam | 14,86411937 | 14,86411937 | 14,86411937 | 6,7e−15 | ✓ |
| Erkek yok (p_m=p_f): N_s ürün | 16,46993836 | 16,46993836 | 16,46993836 | 1,3e−15 | ✓ |
| Erkek yok (p_m=p_f): F | 0,05359234 | 0,05359234 | 0,05359234 | 2,8e−17 | ✓ |
| Erkek yok (p_m=1/N): \Psi toplam | 1,21879783 | 1,21879783 | 1,21879783 | 2,7e−15 | ✓ |
| Erkek yok (p_m=1/N): N_s toplam | 22,59962977 | 22,59962977 | 22,59962977 | 1,9e−15 | ✓ |
| Erkek yok (p_m=1/N): N_s ürün | 24,10273328 | 24,10273328 | 24,10273328 | 1,0e−15 | ✓ |
| Erkek yok (p_m=1/N): F | 0,04064145 | 0,04064145 | 0,04064145 | 1,4e−17 | ✓ |
| Rameta başına kayıt: rameta eşitleme N_s | 16,05719747 | 16,05719747 | — | 2,2e−16 | ✓ |
| Yarım kardeş 20 klon: N_s (Lindgren ve Mullin, 1998) | 3,47826087 | 3,47826087 | 3,47826087 | 6,4e−16 | ✓ |
| CV=1{,}425, N=180: \Psi | 3,030625 | 3,030625 | 3,030625 | 1,5e−16 | ✓ |
| CV=1{,}425, N=180: N_p | 59,39368942 | 59,39368942 | 59,39368942 | 3,6e−16 | ✓ |
| CV=1{,}425, N=180: N_r | 0,32996494 | 0,32996494 | 0,32996494 | 1,1e−16 | ✓ |
| CV=1{,}025, N=180: \Psi | 2,050625 | 2,050625 | 2,050625 | 4,3e−16 | ✓ |
| CV=1{,}025, N=180: N_p | 87,77811643 | 87,77811643 | 87,77811643 | 1,1e−15 | ✓ |
| CV=1{,}025, N=180: N_r | 0,4876562 | 0,4876562 | 0,4876562 | 1,7e−16 | ✓ |
| CV=0{,}743, N=180: \Psi | 1,552049 | 1,552049 | 1,552049 | 1,4e−16 | ✓ |
| CV=0{,}743, N=180: N_p | 115,97571984 | 115,97571984 | 115,97571984 | 2,0e−15 | ✓ |
| CV=0{,}743, N=180: N_r | 0,64430955 | 0,64430955 | 0,64430955 | 3,3e−16 | ✓ |
Ölçütü karşılayan: 85/85. Python: bütün toplamlar klon çiftleri üzerinde açık döngüyle. R: \Psi için CV formülleri, \Theta için aile toplamları, tohum ürünü için ana × baba olasılık tablosu. Son dokuz satırdaki CV değerleri Kang ve ark. (2004) Tablo 1'dekilerdir.
Akrabalığın \theta ve A matrisi sütunlarıyla verildiği çalıştırmalar (5) aile kipiyle bütün tablolarda aynı sayıları verir (fark 0).
91.7 Çıktıyı okuma
Örnek ayarın konsol metni:
Klonal tohum bahçesi: N = 30 klon; akrabalık: aile içi θ = 0,125; polen kirliliği c = 0,1, kendileşme s = 0,05
Modeldeki toplam kendileşme payı: 0,0916 (girilen s = 0,05 artı rastgele çiftleşmede aynı klonun polenini
alma payı 0,0416). Babalık çözümlemesinden bulunan toplam kendileşme oranını bu alana yazmayın: s,
rastgele çiftleşmenin üstüne eklenen paydır.
Ψ_CV: dişi ve erkek için CV² + 1, toplam için 1 + ¼(CVf² + CVm²) + ½·r·CVf·CVm (CV, N bölenli). Np = N/Ψ; Ns = 1/(2Θ); Nr = Ns/N; GD = 1 − Θ.
G_urun = Σg·BV + (c/2)·BVdış: tohum ürününün beklenen ıslah değeri (dış polenin ıslah değeri BVdış = 0).
Tablolar (kısaltılmış: sayılar yuvarlanmış, bazı sütunlar atılmıştır; tablolarda tam hassasiyet saklanır):
Doğurganlık değişkenliği (Ψ = N·Σp²), etkili ebeveyn sayısı Np, grup akrabalığı Θ ve …
      dogurganlik  ortalama      CV     Psi       Np    Np_N    Theta       Ns      Nr      GD
             dişi     130.0  0.9355  1.8752  15.9984  0.5333  0.03364  14.8641  0.4955  0.9664
            erkek     615.6  1.2389  2.5349  11.8347  0.3945  0.04365  11.4549  0.3818  0.9564
 toplam (ebeveyn)       NaN     NaN  1.8366  16.3347  0.5445  0.03277  15.2588  0.5086  0.9672
Dişi ve erkek doğurganlık arasındaki korelasyon
      olcut   deger       p   n
  Pearson r  0.4039  0.0269  30
 Spearman ρ  0.5669     NaN  30
Tohum ürünü: polen kirliliği ve kendileşme ile statü sayısı, gen çeşitliliği ve …
                           olcut     deger
 Θ (tohum ürünü grup akrabalığı)   0.02916
   Ns (tohum ürünü statü sayısı)  17.14898
                       Nr = Ns/N   0.57163
    GD = 1 − Θ (gen çeşitliliği)   0.97084
 F (tohumda beklenen kendileşme)   0.04786
    Σg (bahçe kaynaklı gen payı)   0.95000
               G ebeveyn = Σp·BV  -3.22543
    G ürün = Σg·BV + (c/2)·BVdış  -2.91740
Senaryolar: doğurganlık eşitleme, üst sınır, rameta eşitleme ve seyreltme (…)
                                                senaryo      Ns  Ns_urun  tohum_orani  G_urun
                          mevcut (gözlenen doğurganlık)  15.259   17.149       1.0000  -2.917
             eşit tohum toplama (kozalak veren 29 klon)  20.100   23.442       0.1487  -2.243
         üst sınır: en verimli %10 (3 klon) eşit miktar  15.890   18.067       0.8826  -3.067
            rameta eşitleme (rameta başına doğurganlık)  16.057   18.094          NaN  -2.194
 seyreltme %10: en düşük ıslah değerli 3 klon çıkarıldı  13.438   15.042       0.8669  -0.287
 seyreltme %20: en düşük ıslah değerli 6 klon çıkarıldı  11.996   13.355       0.7097   2.626
 seyreltme %30: en düşük ıslah değerli 9 klon çıkarıldı   9.639   10.822       0.6564   3.890
Senaryo tablosunun burada gösterilmeyen sütunları N, Psi, Np, Nr, GD_urun ve F_tohum'dur (F_tohum yedi satırda sırasıyla 0,0479; 0,0408; 0,0482; 0,0468; 0,0505; 0,0515; 0,0592).
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Tablo 1 | Dişi, erkek ve toplam için CV, \Psi (iki yoldan), N_p, N_p/N, \Theta, N_s, N_r, GD | Raporlanacak satır "toplam (ebeveyn)"dir. Örnekte erkek katkısı dişiden daha eşitsizdir (\Psi_m=2{,}53, \Psi_f=1{,}88). N_s<N_p farkı akrabalığın payıdır. |
| Tablo 2 | Pearson r ve p değeri, Spearman \rho | Pozitif korelasyon toplam \Psi'yi artırır. Spearman satırında p yoktur. |
| Tablo 3 | Tohum ürününün \Theta, N_s, N_r, GD, F değerleri, \sum g ve kazançlar | N_{s,\text{ürün}} ile tablo 1'deki N_s arasındaki fark c ve s'nin etkisidir. \sum g=1-c/2 denetimdir. |
| Tablo 4 | Kuşak başına korunan heterozigotluk ve kayıp | Sabit N_e varsayımıyla izdüşüm; başlıkta N_e ve 1/(2N_e) yazar. |
| Tablo 5 | Her klonun ham değerleri, payları, M_i ve g_i | Ürünü sürükleyen klonlar buradan okunur (K15 ve K18 birlikte tohum ürününün gen havuzunun %21'ini verir). M_i uçları (K07, K21: 0; K14: 1) tek yönlü katkı yapan klonlardır. |
| Tablo 6 | En verimli %10, %20, %25, %50 klonun birikimli payı | Örnekte 3 klon dişi doğurganlığın %33'ünü, erkek doğurganlığın %41'ini verir. |
| Tablo 7 | Her senaryoda N, \Psi, N_p, N_s, N_r, ürün statü sayısı, GD, F, tohum oranı, G | Satırlar birlikte okunur: çeşitlilik (Ns_urun), ürün miktarı (tohum_orani) ve kazanç (G_urun) arasındaki denge. |
| Tablo 8 | Aynı \Psi ile farklı klon sayılarında N_p | Akrabalığı içermeyen kaba ölçü. |
| Şekil 1 | Lorenz eğrisi (dişi, erkek, toplam) | Köşegenden uzaklık eşitsizliktir. |
| Şekil 2 | Klonların dişi ve erkek katkısı, azalan sırada | Kesikli çizgi eşit katkıdır (1/N). |
Şekil 91.1. Şablonun çizdiği Lorenz eğrisi (örnek veri). Erkek doğurganlık (turuncu) dişiden (mor) daha eşitsizdir; toplam (yeşil) ikisinin arasındadır.
Şekil 91.2. Klonların gen katkısı p=(p_f+p_m)/2; mor dişi, turuncu erkek payının yarısıdır. K15 ve K18 katkılarının çoğunu baba olarak, K20 ana olarak yapar.
Rapor cümlesi (örnek ayar):
Otuz klonlu bahçede doğurganlık değişkenliği \Psi = 1{,}84 (dişi 1,88; erkek 2,53; r = 0{,}40), etkili ebeveyn sayısı N_p = 16{,}3 ve aile içi akrabalık (\theta = 0{,}125) hesaba katıldığında statü sayısı N_s = 15{,}3 (N_r = 0{,}51) bulundu. Polen kirliliği %10 ve ek kendileşme %5 varsayımıyla tohum ürününün statü sayısı 17,1, gen çeşitliliği 0,971 ve tohumda beklenen kendileşme katsayısı 0,048'dir. En düşük ıslah değerli klonların %20'sinin çıkarılması ürünün beklenen ıslah değerini −2,92'den 2,63'e yükseltir, ürün statü sayısını 13,4'e düşürür ve mevcut tohumun %71'ini korur.
91.8 Sık hatalar ve tuzaklar
- Seyreltme düzeyini ondalık virgülle yazmak.
12,5; 25üç düzey olarak okunur (%5, %12, %25). Ondalıklı düzey nokta ile yazılır (12.5; 25); sonuç tablosundaki senaryo adlarından uygulanan yüzdeler denetlenir. - Toplam kendileşme oranını s diye girmek. Varsayılanda s, rastgele çiftleşmedeki rastlantısal kendileşmenin üstüne eklenir (91.4.4); toplam oranı girmek için "Kendileşme payı tanımı"
toplamseçilir. Örnek ayarda rastlantısal kendileşmenin payı %4,2'dir (0{,}85\cdot0{,}0489) ve girilen %5 buna eklenir. - Erkek doğurganlık yokken senaryoları karşılaştırmak. Varsayılan p_m=p_f altında "eşit tohum toplama" yalnız dişi payları eşitler; çiçek tozu payları gözlenen doğurganlıkta kalır (hasat biçimi polen katkısını değiştirmez). Örnek veride erkek sütunu çıkarılırsa ürün statü sayısı 16,5'ten 25,3'e çıkar (\Psi 1,875'ten 1,245'e); erkek sütunu verildiğinde aynı senaryo 17,1'den 23,4'e çıkarır. Erkek ölçüsü yoksa senaryo kazançları yine de yaklaşık okunur.
- Erkek varsayımının sonucu belirlediğini unutmak. Aynı veride toplam N_s, p_m=p_f ile 14,9, p_m=1/N ile 22,6, ölçülen erkek paylarla 15,3'tür. Erkek doğurganlık ölçülmemişse iki varsayım da çalıştırılır ve aralık raporlanır.
- N-1 bölenli değişim katsayısından \Psi hesaplamak. Yayınlardan alınan CV örneklem standart sapmasıyla hesaplanmışsa CV^2+1 şablonun \Psi'siyle tam örtüşmez; fark N büyüdükçe küçülür.
- Aile kipinde farklı dereceli akrabalığı tek katsayıyla temsil etmek.
aile_kosoybütün aileler için aynıdır; tam kardeş ve yarım kardeş aileleri birlikteyse matris kipi kullanılır. - Matris sütunlarını klon sırasından farklı sırada seçmek. Şablon sütun adlarına bakmaz; matris, satırların sırasıyla aynı sırada verilmelidir. Simetri denetimi yanlış sırayı her zaman yakalamaz.
- Hiç kozalak vermeyen klonları veriden çıkarmak. Sıfır doğurganlıklı klon N'ye girer ve \Psi ile N_r'yi doğru büyüklükte tutar; çıkarılırsa bahçe olduğundan dengeli görünür.
- Dişi doğurganlığı eksik satırı fark etmemek. Kozalak sayımı boş olan klon, erkek değeri olsa da hesaptan düşer ve N azalır; konsoldaki "… satır … çıkarıldı" satırı okunur. Kozalak vermediği bilinen klona 0 yazılır.
- Statü sayısındaki artışı çeşitlilik kazancı sanmak. Polen kirliliği N_{s,\text{ürün}}'ü yükseltir, çünkü dış polen ilişkisiz sayılır; aynı anda ürünün beklenen ıslah değeri dış polenin değerine doğru kayar.
- Seyreltmede yalnız kazanca bakmak. %30 seyreltme G'yi 3,89'a çıkarırken ürün statü sayısını 17,1'den 10,8'e, tohumu %66'ya indirir ve F'yi 0,048'den 0,059'a yükseltir.
- Tek yılın sayımına dayanmak. Doğurganlık yıldan yıla değişir; bol tohum yıllarında \Psi küçülür. Çok yıllık veri önceden toplanır ya da yıllar ayrı ayrı çalıştırılır.
91.9 Uzman soruları
S1. Etkili ebeveyn sayısı N_p ile statü sayısı N_s arasındaki fark nedir?
N_p=1/\sum p_i^2 yalnız katkıların eşitsizliğini ölçer ve klonları ilişkisiz sayar. N_s=1/(2\Theta) aynı eşitsizliğe klonlar arası ortak ata katsayılarını ve klonların kendi kendileşmesini ekler. Klonlar ilişkisiz ve kendileşmemişse ikisi eşittir. Örnekte 16,3 ve 15,3'tür; 30 klondan yalnız yedisi akraba olduğu hâlde fark bir klona yakındır, çünkü akraba klonlardan F2 ailesi ürünün %16'sını verir.
S2. Statü sayısı ile varyans ya da kendileşme etkili büyüklüğü aynı şey mi?
Hayır. Kendileşme etkili büyüklüğü bir kuşaktan ötekine kendileşmenin artış hızını ölçer; statü sayısı ise başlangıçtaki ilişkisiz popülasyona göre birikmiş grup akrabalığının ideal klon sayısına çevrilmiş hâlidir (Lindgren ve Mullin, 1998). Tek kuşaklık bir tohum bahçesinde ikisi yakındır; çok kuşaklı ıslahta ayrışırlar. Tablo 4 bu yüzden bir izdüşümdür, kestirim değildir.
S3. Neden \theta_{ii}=\tfrac12? Klon kendisiyle tam akraba değil mi?
Ortak ata katsayısı alel düzeyinde tanımlıdır: aynı diploit bireyden yerine koyarak çekilen iki alel yarı olasılıkla aynı kopyadır (özdeş), yarı olasılıkla öteki kopyadır ve birey kendileşmemişse özdeş değildir. Kendileşmiş bir klonda \theta_{ii}=(1+F)/2'dir; matris kipinde köşegene bu değer yazılır (A matrisinde 1+F).
S4. Polen kirliliği %10 iken neden \sum g=0{,}95?
Kirlilik yalnız baba tarafını etkiler: tohumların ana genlerinin tamamı, baba genlerinin %90'ı bahçeden gelir; toplam (1+0{,}9)/2=0{,}95. Kalan %5 dış polendir ve \theta=0 varsayımıyla \Theta_{\text{ürün}}'e katkı yapmaz. Dış polenin kendi içinde akrabalığı olsaydı (küçük, yalıtılmış bir komşu meşcere) bu pay da grup akrabalığına eklenirdi; şablon bu durumu modellemez.
S5. F_{\text{tohum}} neden \Theta'ya eşit değil?
\Theta=\mathbf p^{\top}\boldsymbol\theta\mathbf p, gen havuzundan çekilen herhangi iki genin akrabalığıdır ve ana–ana, baba–baba çiftlerini de içerir. Bir tohumun kendileşme katsayısı ise yalnız kendi anası ile babasının akrabalığıdır: \mathbf p_f^{\top}\boldsymbol\theta\mathbf p_m. Örnek veride akrabalık yok sayılıp c=s=0 alındığında \Theta=0{,}0306, F_{\text{tohum}}=0{,}0245'tir: dişi ve erkek paylar yalnız orta düzeyde ilişkili olduğundan (r=0{,}40) aynı klonun hem ana hem baba olma olasılığı, payların eşit olduğu durumdakinden küçüktür. p_f=p_m iken iki büyüklük eşitlenir.
S6. Kendileşmeli tohum ürünü formülleri yayımlanmış mı?
Yapı taşları yayımlanmıştır: grup akrabalığı (Cockerham, 1967; Lindgren ve Mullin, 1998), s=0 için kirlilikli ürünün statü sayısı ve kazancı (Oh ve ark., 2007), p_f=p_m ve c=s=0 için F=\Theta (Kang ve Lindgren, 1999). Şablonun genel formülü bunların birleşimidir ve o özel durumlarda onlara indirgenir; s>0 ile genel durum için yayımlanmış bir sayısal örnek yoktur. Bu bölümdeki doğrulama o kısım için yalnız iki bağımsız hesabın şablonla örtüşmesine dayanır.
S7. Üst sınır senaryosunda yüzde nasıl klon sayısına çevriliyor ve bağlar ne olur?
k=\lfloor N x/100+0{,}5\rfloor; N=30, x=10 için 3. Sınır değeri, azalan sıradaki (k+1). klonun dişi doğurganlığıdır (örnekte K15'in 276 kozalağı) ve bütün klonlara pmin ile uygulanır. k. ve (k+1). klon eşitse sınır yalnız daha üsttekileri keser; kesilen klon sayısı k'den az olur. Senaryo yalnız dişi doğurganlığı değiştirir.
S8. Seyreltme ıslah değerine göre yapılırken çeşitlilik neden bu kadar düşüyor?
İki neden vardır. Klon sayısı azalır ve çıkarılan klonlar arasında ilişkisiz olanlar çoktur; akraba klonlar (F2) kaldığı için akrabalığın payı büyür. Ayrıca ıslah değeri düşük klonların bir kısmı az katkı yapan klonlardır; onların çıkarılması katkıları eşitlemez. Örnekte %30 seyreltmede \Psi 1,84'ten 1,88'e çıkar. Islah değeri yerine doğurganlığa göre seyreltme (ıslah değeri sütunu boş) \Psi'yi 1,45'e indirir ve ürün statü sayısını 15,1'de tutar, ama kazanç sağlamaz.
S9. Rameta eşitleme senaryosu neyi varsayar?
Bir klonun doğurganlığının rameta sayısıyla orantılı olduğunu ve her klondan eşit sayıda rameta bırakıldığında klon doğurganlığının rameta başına ortalamaya ineceğini. Rameta başına doğurganlık klonlar arasında çok farklıysa (örnekte K15: 276/7, K20: 577/8) eşitleme sınırlı kalır: \Psi 1,84'ten 1,71'e iner. Tohum oranı hesaplanmaz, çünkü kaç rameta bırakılacağı senaryoda tanımlı değildir.
S10. Yapay veride ölçek değişirse (kozalak yerine tohum ağırlığı) sonuç değişir mi?
Paylar oranlardan kurulduğu için bir sütunun sabit bir sayıyla çarpılması hiçbir sonucu değiştirmez. Değişen, ölçünün doğurganlığı ne kadar iyi temsil ettiğidir: kozalak sayısı dolu tohum sayısıyla orantılı değilse (klonlar arasında kozalak başına tohum farklıysa) p_f yanlıdır. Erkek tarafta strobil sayısı çiçek tozu miktarının ve döllenme başarısının yalnız kaba bir göstergesidir; fenolojik örtüşme şablonda yoktur.
91.10 Kaynaklar
- Cockerham, C. C. (1967). Group inbreeding and coancestry. Genetics, 56(1), 89–104. https://doi.org/10.1093/genetics/56.1.89
- Kang, K. S., Bila, A. D., Harju, A. M., & Lindgren, D. (2003). Estimation of fertility variation in forest tree populations. Forestry, 76(3), 329–344. https://doi.org/10.1093/forestry/76.3.329
- Kang, K. S., Choi, W. Y., Han, S. U., & Kim, C. S. (2004). Effective number and seed production in a clonal seed orchard of Pinus koraiensis. Forest Genetics, 11(3–4), 279–282.
- Kang, K. S., & Lindgren, D. (1999). Fertility variation among clones of Korean pine (Pinus koraiensis S. et Z.) and its implications on seed orchard management. Forest Genetics, 6(3), 191–200.
- Lindgren, D., & Mullin, T. J. (1998). Relatedness and status number in seed orchard crops. Canadian Journal of Forest Research, 28(2), 276–283. https://doi.org/10.1139/x97-217
- Oh, C. Y., Kang, K. S., Choi, W. Y., Han, S. U., & Kim, C. S. (2007). Genetic gain and diversity in a clonal seed orchard of Pinus koraiensis under various thinning intensities [Conference paper]. Southern Forest Tree Improvement Conference.
- Park, J.-M., Kang, H.-I., Yeom, D.-B., Kang, K.-S., El-Kassaby, Y. A., & Lee, K.-M. (2020). Gender, reproductive output covariation and their role on gene diversity of Pinus koraiensis seed orchard crops. BMC Plant Biology, 20, 418. https://doi.org/10.1186/s12870-020-02632-9
- R Core Team. (2026). R: A language and environment for statistical computing (Version 4.5.3) [Computer software]. R Foundation for Statistical Computing. https://www.R-project.org/
- Wright, S. (1931). Evolution in Mendelian populations. Genetics, 16(2), 97–159. https://doi.org/10.1093/genetics/16.2.97