30. Beta regresyon (oran ve yüzde yanıt)
Şablon kimliği: beta_regresyon · Kategori: model · Dil: Python · Dosya: pro/sablonlar/model/beta_regresyon.py (satır 1–244; üstbilgi 1–88) · Örnek veri: _ornek/bitki_ortusu.csv · Paketler: statsmodels 0.14.6 (othermod.betareg.BetaModel), numpy, pandas, scipy, matplotlib
30.1 Ne işe yarar
Şablon, 0 ile 1 arasında sürekli değer alan bir yanıtın (örtü oranı, hasar yüzdesi, bütçe payı, doğru yanıt oranı) ortalamasını açıklayıcı değişkenlere bağlar. Cevapladığı soru şudur: "Açıklayıcı bir birim arttığında beklenen oran nasıl değişir ve oranların ortalama çevresindeki saçılımı ne kadardır?" Yanıtın beta dağıldığı varsayılır:
- \mu_i: i. gözlemin beklenen oranı; 0<\mu_i<1. \phi_i>0: hassasiyet (precision) parametresi; büyüdükçe varyans küçülür.
- g: ortalama bağlantı fonksiyonu (varsayılan logit, g(\mu)=\ln\frac{\mu}{1-\mu}). h: hassasiyet bağlantı fonksiyonu (varsayılan log).
- \mathbf x_i: sabit terim ve ortalama modelinin açıklayıcıları; \mathbf z_i: sabit terim ve (seçildiyse) hassasiyet değişkenleri. Hassasiyet değişkeni seçilmezse \phi bütün gözlemlerde aynıdır.
- Varyans \mu(1-\mu) ile orantılıdır: ortalama 0'a ya da 1'e yaklaştıkça saçılım kendiliğinden daralır. Sıradan regresyonun sabit varyans varsayımı oran verisinde bu yüzden tutmaz.
Bu parametreleme Ferrari ve Cribari-Neto'nundur (2004); hassasiyetin de değişkenlere bağlandığı biçim Smithson ve Verkuilen (2006) ile Simas, Barreto-Souza ve Rocha'da (2010) verilir.
Ne zaman kullanılır? Yanıt gerçekten sürekli bir oransa (alan payı, süre payı, konsantrasyon oranı, 0–100 arası yüzde puanı) ve değerler 0 ile 1'in içinde kalıyorsa; ortalama sınırlara yaklaştıkça saçılımın daraldığı, dağılımın çarpıklaştığı görülüyorsa; kestirimlerin (0, 1) dışına taşmaması isteniyorsa.
Ne zaman kullanılmaz?
- Oran bir sayımdan geliyorsa (çimlenen / ekilen tohum): payda bilgisi atılmamalıdır; temel programdaki İkili Lojistik Regresyon (binom yanıt) ya da aşırı yayılım varsa GLMM (Genelleştirilmiş Doğrusal Karma Modeller) kullanılır.
- Veride çok sayıda tam 0 ya da 1 varsa: sınır dönüşümü (30.4.2) birkaç değer için bir çaredir, yığılma için değil; sıfır/bir şişirilmiş model gerekir (Ospina ve Ferrari, 2012). Hazır şablonu yoktur; olabilirliği
ozel_olabilirlikşablonunda yazılır. - Gözlemler kümelenmişse (aynı parselden yinelenen ölçüm, blok): rastgele etkili beta modeli için
glmmtmb_ailelerşablonu. - Açıklayıcı kategorikse: bu şablonun değişken listeleri yalnız sayısal sütun alır; kategorik açıklayıcı 0/1 gösterge sütunlarına çevrilerek verilir ya da
glmmtmb_ailelerkullanılır. - Yanıt 1'i aşabilen bir oransa (verim oranı, büyüme katsayısı): beta dağılımı uygun değildir; temel programdaki Gamma / Ters Gauss / Tweedie GLM.
Temel programla ilişki. Temel programda beta regresyon yoktur. Oran yanıtı orada ya logit dönüşümüyle Doğrusal Regresyona ya da sayım biçiminde lojistik regresyona taşınır. Bu şablon dönüşüm yapmadan, oranın kendi ölçeğinde olabilirlik kurar; katsayıların yorumu lojistik regresyondakine benzer, ama varyans ayrı bir parametreyle (\phi) kestirilir.
30.2 Şablonun girdileri
Form on bir [[param]] bloğundan kurulur (beta_regresyon.py:10–87).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Oran yanıtı · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | y (satır 105). |
Açıklayıcı değişkenler (ortalama) · x |
sütunlar · Değişkenler | boş | en az 1 sayısal sütun | \mathbf X; sabit eklenir (100, 133). |
Hassasiyet (φ) değişkenleri · z |
sütunlar · Değişkenler | boş | sayısal sütunlar; isteğe bağlı | \mathbf Z; boşsa yalnız sabit (101, 134). |
Yanıt ölçeği · olcek |
seçim · Değişkenler | oran |
oran, yuzde |
yuzde ise y/100 (107–110). |
0 ve 1 değerlerini içeri çek · sinir_duzelt |
onay · Seçenekler | açık | açık / kapalı | Sınır değeri varsa dönüşüm ya da hata (116–122). |
Ortalama bağlantı fonksiyonu · baglanti |
seçim · Model | logit |
logit, probit, cloglog, loglog, cauchit |
g (134). |
Hassasiyet (φ) bağlantı fonksiyonu · hassasiyet_baglanti |
seçim · Model | log |
log, sqrt, identity |
h (135). |
Sınır düzeltme sabiti s · sinir_s |
ondalık · Seçenekler | 0,5 | 0,001–1 | Dönüşümdeki s (121–122). |
Güven düzeyi (%) · guven |
ondalık · Seçenekler | 95 | 50–99,9 | GA'ların düzeyi (128, 149). |
Optimizasyon yöntemi · cozucu |
seçim · Gelişmiş | bfgs |
bfgs, newton, lbfgs, nm |
fit(method = …) (132, 140–145, 185). |
En çok yineleme · en_cok_yineleme |
tamsayı · Gelişmiş | 500 | 10–100000 | fit(maxiter = …) (133, 185). |
Örnek ayar (satır 9): y = ortu_orani, x = [nem, egim]; öteki alanlar varsayılandadır. Güven düzeyi bu şablonda yüzde olarak girilir (95); 0,95 yazılırsa form 50'den küçük olduğu için kabul etmez.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 98–99 |
| Yanıt dışında açıklayıcı kalmadı | "Yanıttan farklı en az bir açıklayıcı değişken seçin." | 102–103 |
| n< (açıklayıcı + hassasiyet değişkeni sayısı) + 5 | "Gözlem sayısı model için yetersiz." | 112–113 |
| Yanıt (ölçek dönüşümünden sonra) 0'dan küçük ya da 1'den büyük | "Yanıt 0–1 (ya da yüzde ölçeğinde 0–100) aralığında olmalı." | 114–115 |
| Tam 0 ya da 1 var ve dönüşüm kapalı | "… gözlem tam 0 ya da 1; beta dağılımı bunları kapsamaz. Dönüşümü açın." | 118–120 |
| Yanıt sabit | "Yanıt sabit." | 123–124 |
BetaModel ya da fit hata verdi |
"Model kurulamadı: …" | 197–198 |
| Seçilen çözücü ve Newton-Raphson en büyük noktaya ulaşamadı (skor sıfırlanmadı ya da Hessian negatif tanımlı değil) | "Model yakınsamadı: <çözücü> ve Newton-Raphson en büyük olabilirlik noktasına ulaşamadı … Modeli sadeleştirin ya da başka bir bağlantı seçin." | 199–201 |
| Kestirim ya da SH sonlu değil | "Model yakınsamadı (kestirimler sonlu değil)." | 203–204 |
Eksik değer: seçilen bütün sütunlar sayıya çevrilir ve herhangi birinde eksik olan satır atılır (satır 104). Yanıt sütunu açıklayıcı ya da hassasiyet listesinde de seçilmişse listeden sessizce çıkarılır (100–101). Durdurmayan iki uyarı vardır: "Yüzde (0-100)" ölçeği seçili ama en büyük değer 1 ya da altındaysa "Uyarı: yanıt ölçeği … veri zaten 0–1 aralığında bir oransa ölçeği 'Oran (0-1)' yapın" satırı (221–223; değerler yine 100'e bölünür) ve seçilen çözücü en büyük noktaya ulaşamayıp Newton-Raphson devreye girdiğinde "Not: … kestirimler Newton-Raphson … ile elde edildi" satırı (230–232); tablo iki durumda da yazılır.
30.3 Örnek veri
Dosya: _ornek/bitki_ortusu.csv. 80 örnek alanda bitki örtüsü oranı ile iki ortam değişkeni; öğretim amaçlı üretilmiş yapay veridir, eksik değer yoktur.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
ortu_orani |
Yanıt | sayısal | 0,1263–0,9152; ortalama 0,5307; standart sapma 0,1752. Tam 0 ya da 1 yok. |
nem |
Açıklayıcı | sayısal | Standartlaştırılmış nem indeksi; −2,768 – 2,841; ortalama 0,131. |
egim |
Açıklayıcı; hassasiyet değişkeni (çalıştırma 2) | sayısal | Eğim; 0–9,48; ortalama 4,394. |
Kategorik değişken olmadığından düzey sırası bu şablonda rol oynamaz.
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) örnek ayar + hassasiyet değişkeni egim; (3) probit, tamamlayıcı log-log, log-log ve cauchit bağlantıları; (4) en küçük iki değeri 0, en büyük değeri 1 yapılmış kopya veride (kurgusal; dogrulama/beta_regresyon/ortu_sinir.csv) sınır dönüşümü, s=0{,}5 ve s=0{,}1; (5) yayımlanmış bir veri: _ornek/beta_regresyon_gida.csv, 38 hanenin gıda harcamasının gelire oranı (Cribari-Neto ve Zeileis, 2010); (6) Newton-Raphson, L-BFGS ve Nelder-Mead çözücüleri; (7) karekök ve özdeşlik hassasiyet bağlantıları.
30.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) sütunları sayıya çevir, eksikleri at, yüzde ölçeğini orana çevir; (2) sınır değeri varsa yanıtı içeri çek; (3) tasarım matrislerini kur; (4) seçilen çözücüyle log-olabilirliği en büyükle ve Newton-Raphson ile en büyük noktayı doğrula; (5) gözlenen bilgiden SH, z, p ve GA'ları hesapla; (6) log-olabilirlik, AIC, BIC ve sözde R^2'yi yaz; (7) tabloyu ve şekli üret.
30.4.1 Beta yoğunluğu ve log-olabilirlik
- \Gamma: gama fonksiyonu. Klasik biçim parametreleri a=\mu\phi ve b=(1-\mu)\phi'dir; \mu=a/(a+b), \phi=a+b.
- \ln y_i ve \ln(1-y_i) yüzünden y_i=0 ya da y_i=1 olan bir gözlemin katkısı -\infty'dur; olabilirlik bu değerlerde tanımsızdır.
- \mu_i=g^{-1}(\mathbf x_i^{\top}\boldsymbol\beta) ve \phi_i=h^{-1}(\mathbf z_i^{\top}\boldsymbol\gamma) yerine konur; en büyükleme (\boldsymbol\beta,\boldsymbol\gamma) üzerindedir.
Neden ortalama–hassasiyet parametrelemesi?
Klasik (a,b) parametrelerinin ikisi de hem ortalamayı hem varyansı değiştirir; bir açıklayıcının "ortalamayı nasıl etkilediği" sorusu onlarla sorulamaz. (\mu,\phi) ile ortalama tek başına bir regresyona bağlanır ve \phi yalnız saçılımı taşır. Bu, genelleştirilmiş doğrusal modellerdeki ortalama–yayılım ayrımının beta dağılımına uyarlanmasıdır.
30.4.2 Sınır değerleri: Smithson–Verkuilen dönüşümü
- n: eksikler atıldıktan sonraki gözlem sayısı. s: sınır düzeltme sabiti; varsayılan 0,5.
- y=0 değeri s/n'ye, y=1 değeri 1-(1-s)/n'ye taşınır; s=0{,}5 için aralık simetrik olarak [0{,}5/n;\ 1-0{,}5/n]'ye sıkışır.
- Dönüşüm doğrusaldır ve bütün gözlemlere uygulanır (satır 122); yalnız sınırdakilere değil. n=80, s=0{,}5 ile 0 → 0,00625; 1 → 0,99375; 0,5316 → 0,531205.
Koddaki tercih
Dönüşüm yalnız veride en az bir tam 0 ya da 1 varsa yapılır (satır 116–122). "İçeri çek" kutusu açık olsa da sınır değeri yoksa yanıt olduğu gibi kullanılır; kutu kapalıyken sınır değeri varsa şablon durur. Çıktıdaki not, kaç gözlemin tam 0 ya da 1 olduğunu ve dönüşümün bütün yanıtlara uygulandığını yazar (218–220).
Dönüşüm sonuçları s'ye duyarlı kılar
Sınıra itilen bir gözlemin logit'i s'ye göre çok değişir: n=80'de s=0{,}5 ile \operatorname{logit}(0{,}00625)=-5{,}07, s=0{,}1 ile \operatorname{logit}(0{,}00125)=-6{,}68. Örnek verinin üç değeri sınıra çekilmiş kopyasında nem katsayısı s=0{,}5 ile 0,7351, s=0{,}1 ile 0,7689 çıkar; özgün veride 0,5819'dur. Sınır değerleri birkaç taneden fazlaysa dönüşüm yerine sıfır/bir şişirilmiş model düşünülür.
30.4.3 Bağlantı fonksiyonları
| Seçenek | g(\mu) | \mu=g^{-1}(\eta) | Özellik |
|---|---|---|---|
logit |
\ln\frac{\mu}{1-\mu} | \dfrac{1}{1+e^{-\eta}} | Simetrik; e^{\beta} oran çarpanı olarak yorumlanır. |
probit |
\Phi^{-1}(\mu) | \Phi(\eta) | Simetrik; kuyrukları logit'ten ince. |
cloglog |
\ln\big(-\ln(1-\mu)\big) | 1-e^{-e^{\eta}} | Asimetrik; 1'e hızlı, 0'a yavaş yaklaşır. |
loglog |
-\ln(-\ln\mu) | e^{-e^{-\eta}} | Asimetrik; 0'a hızlı, 1'e yavaş yaklaşır. |
cauchit |
\tan\big(\pi(\mu-\tfrac12)\big) | \tfrac12+\tfrac{1}{\pi}\arctan\eta | Simetrik; kalın kuyruk, uç değerlere dayanıklı. |
Hassasiyet için: log (\phi=e^{\zeta}), sqrt (\phi=\zeta^2), identity (\phi=\zeta); \zeta=\mathbf z^{\top}\boldsymbol\gamma.
Neden hassasiyette varsayılan log?
\phi pozitif olmak zorundadır. Log bağlantıda \phi=e^{\zeta} her \zeta için pozitiftir ve en iyileyici kısıtsız çalışır. Özdeşlik bağlantısında \zeta bir gözlemde sıfırın altına inerse olabilirlik tanımsızlaşır; karekök bağlantısında \phi=\zeta^2 pozitiftir, ama \zeta ve -\zeta aynı \phi'yi verdiğinden olabilirlik yüzeyi iki tepelidir ve hassasiyet değişkeni varken yinelemeli yöntemler yerel ya da ıraksak noktalarda durabilir; şablon bu yüzden her çözümü skor ve Hessian ölçütüyle doğrular (30.4.4, 30.8).
Koddaki tercih
Logit ve log seçiliyken model BetaModel(y, X, exog_precision=Z) ile, paketin varsayılan bağlantılarıyla kurulur; başka bir seçimde bağlantı nesneleri açıkça verilir (satır 173–176). Başlığın ilk satırı ortalama bağlantısının kimliğini yazar ("probit bağlantı"); hassasiyet bağlantısı yorum satırında görünür (224–229).
30.4.4 En çok olabilirlik: skor, Hessian ve çözücü
- \psi: digama fonksiyonu (\ln\Gamma'nın türevi). y^{\dagger}: yanıtın logit'i; \mu^{\dagger}: onun beklenen değeri, E(y^{\dagger})=\mu^{\dagger}.
- d\mu/d\eta: bağlantının ters türevi; logit'te \mu(1-\mu). d\phi/d\zeta: log bağlantıda \phi.
- İlk denklem, ağırlıklı bir regresyonun normal denklemlerine benzer: gözlenen logit ile beklenen logit arasındaki fark, açıklayıcılarla dik olana kadar \boldsymbol\beta değiştirilir.
Denklemlerin kapalı çözümü yoktur; yinelemeyle çözülür. Kovaryans, çözümdeki ikinci türev matrisinden gelir:
- -\mathbf H: gözlenen bilgi matrisi. Beklenen bilgi (Fisher bilgisi) onun beklenen değeridir; ikisi büyük örneklemde yakınsar, küçük örneklemde SH'lerde yüzde birkaç fark verebilir.
- \boldsymbol\beta ile \boldsymbol\gamma blokları dik değildir: ortalama ve hassasiyet kestirimleri ilişkilidir ve \phi'nin belirsizliği \boldsymbol\beta'nın SH'lerine yansır.
Koddaki tercih
BetaModel.fit başlangıç değerlerini kendisi kurar (hassasiyet bağlantısı log değilse başlangıcı şablon verir, aşağıda). Seçilen çözücü varsayılan olarak BFGS'dir (satır 185; yakınsama ölçütü gradyan normu 10^{-5}); "Newton-Raphson", "L-BFGS" ve "Nelder-Mead" seçenekleri method olarak geçer (140–145). Çözücünün durduğu noktadan Newton-Raphson çalıştırılır (analitik skor ve Hessian, en çok 200 yineleme; 161–166, 189) ve yalnız en büyük nokta ölçütünü sağlayan sonuç kabul edilir: skorun en büyük mutlak bileşeni 10^{-4}'ten küçük ve Hessian negatif tanımlı (148–158). Hassasiyet bağlantısı log değilse başlangıç, log bağlantılı modelin \hat\phi değerlerinden kurulur (177–183). Çözücü en büyük noktaya çekilemeyen bir yerde kalırsa Newton-Raphson başlangıçtan yeniden çalıştırılır ve metne bunu söyleyen not eklenir (190–196, 230–232); hiçbiri ölçütü sağlayamazsa şablon "Model yakınsamadı" iletisiyle durur (199–201). Kovaryans gözlenen bilgiden gelir (hess_type = "oim"). Uyarılar bastırılır (141–142).
Çözücü seçimi sonucu değiştirmez
Örnek veride dört çözücünün (BFGS, Newton-Raphson, L-BFGS, Nelder-Mead) hepsi nem katsayısı olarak 0,58193436, sabit terim olarak −0,38390251 verir: her biri durduğu noktadan Newton-Raphson ile en büyük noktaya indirildiği için çözücüler arasındaki 10^{-6}–10^{-5} düzeyindeki farklar kalmaz. "En çok yineleme" ve "Çözücü" alanları yalnız Newton-Raphson'a verilen başlangıcı etkiler (30.6.1).
30.4.5 Wald çıkarımı
- \Phi: standart normal dağılım fonksiyonu; z_{0{,}975}=1{,}959964. Serbestlik derecesi düzeltmesi yoktur (normal yaklaşım).
- Hassasiyet satırları (\gamma) bağlantı ölçeğindedir: log bağlantıda sabit terim \ln\phi'dir ve p değeri "\ln\phi=0", yani "\phi=1" hipotezini sınar; bu sınamanın uygulamada bir anlamı yoktur. Bir hassasiyet değişkeninin katsayısı için sınama ise anlamlıdır: saçılım o değişkenle değişiyor mu?
30.4.6 Uyum ölçüleri
- k: kestirilen parametre sayısı; ortalama katsayıları + hassasiyet katsayıları (örnek ayarda 3+1=4).
- \hat\eta_i=\mathbf x_i^{\top}\hat{\boldsymbol\beta}: doğrusal kestirici. g(y_i): yanıtın bağlantı ölçeğindeki değeri (logit'te \ln\frac{y}{1-y}).
- Sözde R^2 Ferrari ve Cribari-Neto'nun (2004) tanımıdır: bağlantı ölçeğinde gözlenen ile kestirilen arasındaki korelasyonun karesi. Açıklanan varyans oranı değildir ve hassasiyet modelini hesaba katmaz.
- Beta yoğunluğu 1'den büyük değerler alabildiğinden log-olabilirlik pozitif, AIC ve BIC negatif çıkabilir; yalnız aynı yanıt üzerindeki modeller arasında karşılaştırılır.
30.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–88 | Üstbilgi: açıklama, örnek veri ve ayar, 11 parametre. | Form buradan kurulur (Bölüm 1.2). |
| 89–104 | İçe aktarmalar, dil seçici _m; açıklayıcı listelerinden yanıtın çıkarılması; sayıya çevirme ve eksik satırların atılması. |
dict.fromkeys yinelenen sütunları tekler (104). |
| 105–124 | Yanıt dizisi; yüzde ölçeği ve şüpheli ölçek denetimi (106–110); n ve aralık denetimi; sınır değerleri ve dönüşüm; sabit yanıt denetimi. | Dönüşüm bütün y'ye uygulanır (122). |
| 126–137 | statsmodels içe aktarmaları; seçeneklerin okunması; bağlantı nesneleri; \mathbf X ve \mathbf Z. | has_constant="add": sabit her zaman eklenir (136–137). |
| 138–204 | Çözücü yardımcıları _uydur, _durgun, _newton (140–166); BetaModel kurulumu, başlangıç, seçilen çözücü ve Newton-Raphson ile doğrulama (169–196); hata ve sonlu olmayan kestirim denetimi (197–204). |
En büyük nokta ölçütü: skor ≤ 10^{-4} ve Hessian negatif tanımlı (148–158). |
| 206–214 | Terim adları, GA'lar, katsayı tablosu; \hat\eta, \hat\mu ve sözde R^2. | GA düzeyi 95 değilse alpha = 1 − guven/100 (207). |
| 215–232 | Metin: model, n, log-olabilirlik, AIC, BIC, sözde R^2; sınır notu; ölçek notu; şüpheli ölçek uyarısı; yedek çözücü notu. | Türkçe arayüzde sayılar mq.sayi ile ondalık virgüllüdür. |
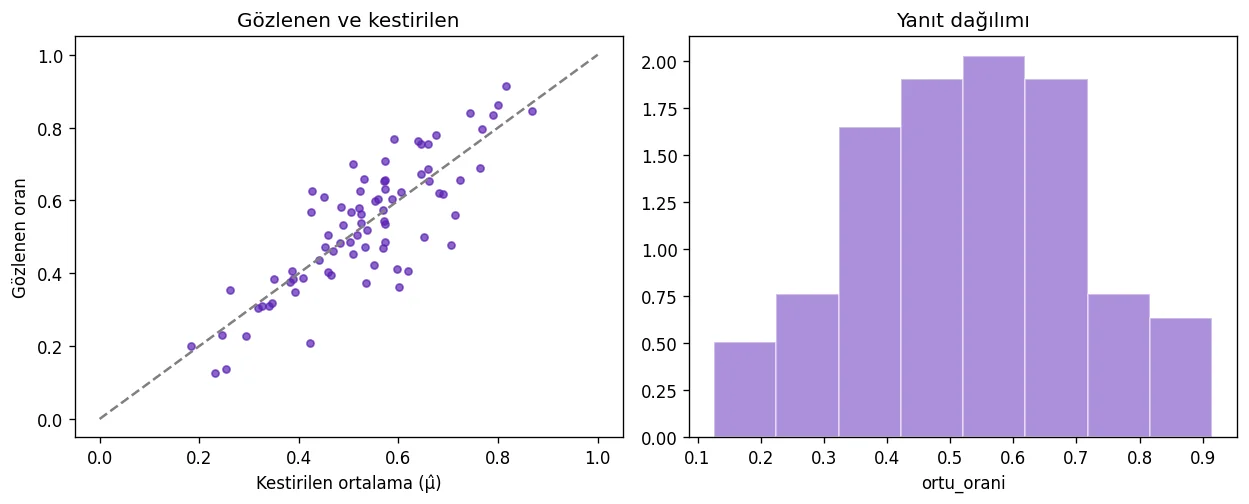
| 234–244 | Şekil (gözlenen–kestirilen saçılım, yanıt histogramı), tablo ve şeklin kaydı. | Saçılımdaki y dönüştürülmüş yanıttır. |
30.6 Elle hesap: örnek veride bağımsız yeniden hesap
Değerler dogrulama/beta_regresyon/elle_hesap.py ile hesaplanmıştır. Betik statsmodels'i ve şablon kodunu kullanmaz: 30.4.1'deki log-olabilirliği, 30.4.4'teki skoru ve ikinci türevleri scipy.special fonksiyonlarıyla (\ln\Gamma, digama, trigama) açıkça yazar ve adım yarılamalı Newton-Raphson uygular. R tarafında (r_dogrulama.R) aynı olabilirlik lgamma ile yazılmış, nlminb ile en büyüklenmiş, kovaryans numDeriv::hessian ile sayısal ikinci türevden alınmıştır; kestirimler ayrıca glmmTMB paketiyle denetlenmiştir.
Adım 1 — Başlangıç. \ln\frac{y}{1-y}'nin nem ve eğim üzerine EKK regresyonu: \boldsymbol\beta^{(0)}=(-0{,}397762;\ 0{,}625006;\ 0{,}103857). Başlangıç hassasiyeti momentlerden: \phi^{(0)}=\overline{\hat\mu(1-\hat\mu)}\,/\,\overline{(y-\hat\mu)^2}-1=23{,}0381, \ln\phi^{(0)}=3{,}137148.
Adım 2 — Newton-Raphson yinelemeleri. Her adımda \boldsymbol\theta\leftarrow\boldsymbol\theta-\mathbf H^{-1}\mathbf s (\mathbf s: skor).
| Yineleme | sabit | nem | eğim | \ln\phi | \ell | en büyük \lvert s_j\rvert |
|---|---|---|---|---|---|---|
| 0 | −0,397762 | 0,625006 | 0,103857 | 3,137148 | 75,443732 | 16,89 |
| 1 | −0,382582 | 0,578252 | 0,100824 | 3,197686 | 75,875750 | 1,64 |
| 2 | −0,383886 | 0,581891 | 0,101090 | 3,187607 | 75,881258 | 0,019 |
| 3 | −0,383903 | 0,581934 | 0,101094 | 3,187496 | 75,881259 | 2\times10^{-6} |
Dördüncü yinelemede skor 10^{-10}'un altına iner. EKK başlangıcı çözüme yakındır, ama aynı değildir: logit dönüşümlü EKK nem katsayısını 0,625 verir, en çok olabilirlik 0,582.
Adım 3 — Standart hatalar. [-\mathbf H]^{-1}'in köşegeni: 0,00730079; 0,00244814; 0,00026415; 0,02409732. Karekökleri:
Nem için z=0{,}581934/0{,}049479=11{,}7613; %95 GA 0{,}581934\pm1{,}959964\cdot0{,}049479=[0{,}484958;\ 0{,}678911].
Adım 4 — Uyum ölçüleri. \ell=75{,}881259, k=4, n=80:
Adım 5 — Yorum büyüklükleri. \hat\phi=e^{3{,}187496}=24{,}2277; delta yöntemiyle \operatorname{SH}(\hat\phi)=24{,}2277\cdot0{,}155233=3{,}7609. e^{0{,}581934}=1{,}7895 (GA [1{,}6241;\ 1{,}9717]) ve e^{0{,}101094}=1{,}1064. Açıklayıcıların ortalamasında \hat\mu=0{,}5341; bu noktada standart sapma \sqrt{0{,}5341\cdot0{,}4659/25{,}2277}=0{,}0993 ve nemin bir birimlik artışının oran ölçeğindeki eğimi 0{,}581934\cdot0{,}5341\cdot0{,}4659=0{,}1448'dir.
Adım 6 — Değişken hassasiyet (\phi eğime bağlı). \hat{\boldsymbol\gamma}=(3{,}809747;\ -0{,}127712), \operatorname{SH}(\hat\gamma_{\text{eğim}})=0{,}058092, z=-2{,}198, p=0{,}0279; \ell=78{,}375435. Olabilirlik oranı testi: 2(78{,}375435-75{,}881259)=4{,}988, \chi^2_1, p=0{,}0255. Hassasiyet eğimle azalır: eğim 1'de \hat\phi=39{,}73, 5'te 23,84, 9'da 14,30; dik alanlarda örtü oranı daha değişkendir. Ortalama katsayıları neredeyse değişmez (nem 0,5745), sabitin SH'si 0,0854'ten 0,0712'ye iner.
Adım 7 — Yayımlanmış veriyle karşılaştırma. Gıda harcaması verisinde (38 hane; oran ~ gelir + kişi sayısı) bağımsız hesap: sabit −0,622548; gelir −0,012299; kişi sayısı 0,118462; \hat\phi=35{,}60975; \ell=45{,}3335; sözde R^2=0{,}3878. Bunlar Cribari-Neto ve Zeileis'in (2010) yayımladığı değerlerle bütün basamaklarda aynıdır. Standart hatalar ise orada 0,223854; 0,003036; 0,035341; 8,0796, burada 0,221372; 0,003084; 0,035737; 8,0817'dir. Fark hesap hatası değildir: yayımlanan değerler beklenen bilgiden, şablonun değerleri gözlenen bilgiden gelir (30.4.4); n=38'de ikisi %1–2 ayrışır.
30.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun "Beta regresyon katsayıları" tablosundan tam hassasiyetle alınmıştır (çalıştırmalar 1–6). Log-olabilirlik, AIC, BIC ve sözde R^2 yalnız metin satırında yazıldığından oradaki yuvarlamayla karşılaştırılmıştır.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Örnek ayar: sabit | −0,38390251 | −0,38390251 | −0,38390251 | 2,3e−10 | ✓ |
| Örnek ayar: nem | 0,58193436 | 0,58193436 | 0,58193436 | 3,3e−11 | ✓ |
| Örnek ayar: eğim | 0,10109372 | 0,10109372 | 0,10109372 | 5,2e−11 | ✓ |
| Örnek ayar: \ln\phi | 3,18749602 | 3,18749602 | 3,18749602 | 4,5e−11 | ✓ |
| Örnek ayar: SH(sabit) | 0,08544467 | 0,08544467 | 0,08544467 | 3,7e−11 | ✓ |
| Örnek ayar: SH(nem) | 0,04947865 | 0,04947865 | 0,04947865 | 3,6e−12 | ✓ |
| Örnek ayar: SH(eğim) | 0,01625261 | 0,01625261 | 0,01625261 | 7,2e−12 | ✓ |
| Örnek ayar: SH(\ln\phi) | 0,15523312 | 0,15523312 | 0,15523312 | 3,2e−11 | ✓ |
| Örnek ayar: z (nem) | 11,76132271 | 11,76132271 | 11,76132271 | 1,6e−11 | ✓ |
| Örnek ayar: p (sabit) | 7,022833·10−6 | 7,022833·10−6 | 7,022833·10−6 | 1,5e−13 | ✓ |
| Örnek ayar: GA alt (nem) | 0,48495799 | 0,48495799 | 0,48495799 | 2,6e−11 | ✓ |
| Örnek ayar: GA üst (nem) | 0,67891073 | 0,67891073 | 0,67891073 | 4,0e−11 | ✓ |
| %90 GA alt (nem) | 0,50054923 | 0,50054923 | — | 3,3e−16 | ✓ |
| Örnek ayar: log-olabilirlik (metin, 4 ondalık) | 75,8813 | 75,8813 | 75,8813 | 0 | ✓ |
| Örnek ayar: AIC (metin, 3 ondalık) | −143,763 | −143,763 | −143,763 | 0 | ✓ |
| Örnek ayar: BIC (metin, 3 ondalık) | −134,234 | −134,234 | −134,234 | 0 | ✓ |
| Örnek ayar: sözde R^2 (metin, 4 ondalık) | 0,7087 | 0,7087 | 0,7087 | 0 | ✓ |
| Newton-Raphson çözücüsü: nem | 0,58193436 | 0,58193436 | 0,58193436 | 3,3e−11 | ✓ |
| Newton-Raphson çözücüsü: \ln\phi | 3,18749602 | 3,18749602 | 3,18749602 | 4,5e−11 | ✓ |
| Newton-Raphson çözücüsü: z (nem) | 11,76132271 | 11,76132271 | 11,76132271 | 1,6e−11 | ✓ |
| Değişken hassasiyet: nem | 0,57445479 | 0,57445479 | 0,57445479 | 5,1e−11 | ✓ |
| Değişken hassasiyet: \gamma_0 | 3,80974732 | 3,80974732 | 3,80974733 | 4,9e−10 | ✓ |
| Değişken hassasiyet: \gamma_{\text{eğim}} | −0,12771227 | −0,12771227 | −0,12771227 | 4,2e−10 | ✓ |
| Değişken hassasiyet: SH(\gamma_{\text{eğim}}) | 0,05809221 | 0,05809221 | 0,05809221 | 3,9e−10 | ✓ |
| Değişken hassasiyet: log-olabilirlik (metin, 4 ondalık) | 78,3754 | 78,3754 | 78,3754 | 0 | ✓ |
| Probit: nem | 0,35831932 | 0,35831932 | 0,35831932 | 2,0e−11 | ✓ |
| Probit: SH(nem) | 0,02957527 | 0,02957527 | 0,02957527 | 7,1e−12 | ✓ |
| Probit: sözde R^2 (metin, 4 ondalık) | 0,7071 | 0,7071 | 0,7071 | 0 | ✓ |
| Sınır dönüşümü (s=0{,}5): nem | 0,7350622 | 0,7350622 | 0,7350622 | 1,2e−10 | ✓ |
| Sınır dönüşümü: SH(nem) | 0,06258059 | 0,06258059 | 0,06258059 | 1,2e−11 | ✓ |
| Sınır dönüşümü: \ln\phi | 2,64790164 | 2,64790164 | 2,64790164 | 2,4e−10 | ✓ |
| Gıda harcaması: sabit | −0,62254806 | −0,62254806 | −0,62254806 | 5,6e−10 | ✓ |
| Gıda harcaması: gelir | −0,01229884 | −0,01229884 | −0,01229884 | 4,6e−12 | ✓ |
| Gıda harcaması: kişi sayısı | 0,1184621 | 0,1184621 | 0,1184621 | 4,9e−11 | ✓ |
| Gıda harcaması: \ln\phi | 3,57261949 | 3,57261949 | 3,57261949 | 1,2e−9 | ✓ |
| Gıda harcaması: SH(gelir) | 0,00308401 | 0,00308401 | 0,00308401 | 2,7e−12 | ✓ |
Ölçütü karşılayan: 36/36. Python: analitik skor ve gözlenen Hessian ile Newton-Raphson (numpy, scipy.special; statsmodels kullanılmadan). R: açık log-olabilirlik (lgamma) + nlminb ve numDeriv::hessian. Şablon seçilen çözücünün durduğu noktadan Newton-Raphson ile en büyük noktaya indiği için bütün satırlar bağımsız değerlerle 10^{-8} içinde örtüşür.
Bütün satırlar ölçütü karşılar: şablon seçilen çözücünün durduğu noktadan Newton-Raphson ile en büyük noktaya indiği için BFGS, L-BFGS ve Nelder-Mead çalıştırmaları da bağımsız hesaplarla 10^{-8} içinde örtüşür. Tablodaki "Newton-Raphson çözücüsü" satırları aynı şablonun çözücü seçeneği değiştirilerek aynı değerleri verdiğini gösterir.
30.7 Çıktıyı okuma
Örnek ayarın metin çıktısı:
Beta regresyon, logit bağlantı: ortu_orani ~ nem + egim
n = 80; log-olabilirlik = 75,8813; AIC = -143,763; BIC = -134,234; sözde R² = 0,7087
Ortalama katsayıları logit ölçeğindedir; exp(b) olasılık oranı benzeri yorumlanır. φ katsayıları log ölçeğindedir.
"Beta regresyon katsayıları" tablosu (altı ondalık; p üç anlamlı basamak):
| terim | kestirim | SH | z | p | ga_alt | ga_ust |
|---|---|---|---|---|---|---|
| (Sabit) | −0,383903 | 0,085445 | −4,493 | 7{,}02\cdot10^{-6} | −0,551371 | −0,216434 |
| nem | 0,581934 | 0,049479 | 11,761 | 6{,}18\cdot10^{-32} | 0,484958 | 0,678911 |
| egim | 0,101094 | 0,016253 | 6,220 | 4{,}97\cdot10^{-10} | 0,069239 | 0,132948 |
| φ: (Sabit) | 3,187496 | 0,155233 | 20,534 | 1{,}08\cdot10^{-93} | 2,883245 | 3,491747 |
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Başlık satırı | Ortalama bağlantısı, model; hassasiyet değişkeni varsa | φ ~ … |
Hangi değişkenin ortalamaya, hangisinin saçılıma girdiği buradan okunur. |
| Uyum satırı | n, \ell, AIC, BIC, sözde R^2 | AIC ve BIC bağlantı ya da hassasiyet modeli seçiminde kullanılır; küçük olan yeğlenir. |
| Sınır notu | Sınırdaki gözlem sayısı ve dönüşüm formülü | Dönüşüm yapıldıysa bütün yanıtlar kaydırılmıştır; sonuçlar s ile birlikte raporlanır. |
| nem, egim | Logit ölçeğinde katsayı | e^{0{,}582}=1{,}79: nem bir birim artınca \mu/(1-\mu) 1,79 katına çıkar. Oran ölçeğindeki etki \mu'ye bağlıdır; ortalamada 0,145'tir. |
| φ: (Sabit) | \ln\hat\phi | \hat\phi=e^{3{,}187}=24{,}2; \mu=0{,}5'te standart sapma \sqrt{0{,}25/25{,}2}=0{,}0995. Satırın p değeri yorumlanmaz. |
| φ: değişken | Hassasiyetin log ölçeğindeki eğimi | Negatif katsayı: değişken arttıkça saçılım büyür. |
| Yedek çözücü notu | Seçilen çözücü en büyük noktada durmadı; kestirimler Newton-Raphson ile elde edildi | Sonuç ölçütü sağlar (skor ve Hessian); not yalnız bilgidir. Çözücü ya da bağlantı değiştirilerek aynı log-olabilirliğin bulunup bulunmadığı denetlenebilir. |
Bağlantı fonksiyonlarının aynı veride karşılaştırması (çalıştırma 3): logit AIC −143,763; probit −143,972; log-log −144,016; tamamlayıcı log-log −141,042; cauchit −141,318. Simetrik bağlantılar arasındaki fark 0,3'ün altındadır; bu veride bağlantı seçimi sonucu belirlemez ve yorumu en kolay olan logit yeğlenir.
Şekil 30.1. Şablonun şekli (örnek ayar). Sol: kestirilen ortalamaya karşı gözlenen oran ve 45° çizgisi; noktaların çizgi çevresindeki yayılımı ortada geniş, uçlarda dardır. Sağ: yanıtın histogramı.
Rapor cümlesi:
Bitki örtüsü oranı logit bağlantılı beta regresyonla modellendi (en çok olabilirlik; n = 80). Nem (b = 0{,}582; SH = 0,049; z = 11{,}76; p < 0{,}001) ve eğim (b = 0{,}101; SH = 0,016; z = 6{,}22; p < 0{,}001) örtü oranını artırdı; nemdeki bir birimlik artış oranın olasılık oranı benzeri büyüklüğünü 1,79 katına çıkardı (%95 GA 1,62–1,97). Hassasiyet parametresi \hat\phi = 24{,}2 olarak kestirildi (log-olabilirlik 75,88; AIC = −143,76; sözde R^2 = 0{,}709).
30.8 Sık hatalar ve tuzaklar
- Yüzde verisini "oran", oran verisini "yüzde" ölçeğiyle çalıştırmak. 0–100 arası değerler "Oran" seçiliyken aralık denetimine takılır ve şablon durur. Tersi durmaz, ama uyarır: 0–1 arası değerler "Yüzde" seçiliyken 100'e bölünür, hepsi 0–0,01 aralığına düşer ve model bu ölçekte uyar; çıktıya "Uyarı: yanıt ölçeği 'Yüzde (0-100)' seçildi, ama en büyük değer …" satırı yazılır (221–223). Örnek veride bu durumda sabit −5,49, \ln\hat\phi=8{,}38, log-olabilirlik 434,71 çıkar. Uyarı çıktıysa ölçek seçimi denetlenir.
- Sayımdan gelen oranı beta ile modellemek. 3/5 ile 60/100 aynı oranı verir, ama taşıdıkları bilgi aynı değildir. Payda biliniyorsa binom model kullanılır.
- Sınır dönüşümünü fark etmeden uygulamak. Tek bir 0 değeri bile bütün yanıtları kaydırır ve katsayıları değiştirir (30.4.2). Not satırı görüldüğünde s için duyarlılık çalıştırması yapılır.
- Karekök hassasiyet bağlantısını hassasiyet değişkeniyle kullanırken sonucu çözücü adına bırakmak. Karekök bağlantıda \phi=\zeta^2 olabilirlik yüzeyini iki tepeli yapar. Örnek veride
φ ~ egimve karekök bağlantıyla BFGS tek başına log-olabilirliği −45,10 noktasında, Nelder-Mead 5000 yinelemeyle 53,66 noktasında durur; bunlar en büyük nokta değildir. Şablon yalnız skor ve Hessian ölçütünü sağlayan sonucu kabul eder: çözücünün durduğu noktadan, olmazsa log bağlantılı çözümden türetilen başlangıçtan Newton-Raphson çalıştırır ve 78,2085'e ulaşır (\hat\gamma_0=6{,}4154; \hat\gamma_{\text{eğim}}=-0{,}2915); bağımsız hesap da bu değeri verir. Çözücü en büyük noktada durmadıysa çıktıda bunu söyleyen bir not bulunur; log bağlantılı modelin log-olabilirliğiyle (78,3754) karşılaştırma yine yararlıdır. - e^{b}'yi oran farkı sanmak. Katsayı logit ölçeğindedir; "nem bir birim artınca örtü oranı 0,58 artar" yanlıştır. Oran ölçeğindeki etki b\,\mu(1-\mu)'dir ve \mu ile değişir.
- φ satırının p değerini yorumlamak. Sabit hassasiyet satırı \ln\phi=0 hipotezini sınar; anlamlı çıkması modelin "iyi" olduğunu göstermez.
- Standart hataları başka bir yazılımın çıktısıyla basamak basamak karşılaştırmak. Bazı paketler beklenen bilgiyi kullanır; kestirimler aynı, SH'ler küçük örneklemde %1–2 farklı olur (30.6, Adım 7).
- Kategorik açıklayıcıyı kodlarıyla vermek. 1, 2, 3 diye kodlanmış bir sınıf değişkeni sayısal sütun olarak seçilebilir ve tek bir doğrusal eğim gibi modele girer. Sınıflar önce 0/1 gösterge sütunlarına ayrılır.
30.9 Uzman soruları
S1. Standart hatalar gözlenen bilgiden mi, beklenen bilgiden mi?
Gözlenen bilgiden: BetaModel varsayılanı hess_type = "oim"dir ve şablon bunu değiştirmez. Kovaryans, çözümdeki analitik Hessian'ın negatifinin tersidir. Beklenen bilgiyle fark, skor denklemlerindeki (y^{\dagger}-\mu^{\dagger}) terimlerinin ikinci türeve katkısından gelir; bu terimlerin beklenen değeri sıfırdır, ama örneklemde sıfır değildir. Gıda harcaması verisinde (n=38) gelir katsayısının SH'si gözlenen bilgiyle 0,003084, beklenen bilgiyle 0,003036'dır.
S2. Sözde R² hassasiyet modeli değişince neden neredeyse aynı kalıyor?
Tanım yalnız doğrusal kestirici \hat\eta ile g(y) arasındaki korelasyona dayanır; \phi tanımda yoktur. Hassasiyet değişkeni eklendiğinde \hat{\boldsymbol\beta} az değiştiği için ölçü de az değişir (0,7087 → 0,7085), oysa log-olabilirlik 2,49 artar. Hassasiyet modelinin katkısı AIC ya da olabilirlik oranı testiyle değerlendirilir, sözde R^2 ile değil.
S3. Sınır değeri yokken "içeri çek" kutusu açık kalırsa veri dönüştürülür mü?
Hayır. Dönüşüm yalnız en az bir tam 0 ya da 1 bulunduğunda uygulanır (satır 117); örnek veride kutu açık olduğu hâlde yanıt değişmeden kullanılır. Bu, sınır değeri içermeyen iki veri kümesinin sonuçlarının kutu ayarından bağımsız olması demektir; buna karşılık tek bir sınır gözlemi eklenince bütün gözlemler (y(n-1)+s)/n ile kayar.
S4. Neden t değil z; küçük örneklemde bu sorun mu?
En çok olabilirlik kestiricisinin dağılımı asimptotik normaldir ve beta regresyonda artık serbestlik derecesine karşılık gelen kesin bir dağılım yoktur. Küçük örneklemde Wald aralıkları dar kalabilir; \phi'nin en çok olabilirlik kestirimi de yukarı yanlıdır (varyansı küçük gösterir). n<30 dolayında olabilirlik oranı testi yeğlenir ya da bootstrap_ozel şablonuyla aralık kurulur.
S5. Özdeşlik bağlantısında φ satırı ne anlama gelir?
\phi'nin kendisi. Sabit hassasiyette özdeşlik bağlantısı örnek veride \hat\phi=24{,}2277 (SH 3,7609) verir; bu, log bağlantıdaki e^{3{,}187496} ve delta yöntemi SH'siyle aynıdır. Kestirim parametrelemeden bağımsızdır; değişen yalnız Wald aralığının hangi ölçekte simetrik olduğudur. Log ölçeğindeki aralık geri dönüştürüldüğünde her zaman pozitiftir; özdeşlikteki aralık küçük \phi'de sıfırın altına inebilir.
S6. Logit dönüşümlü doğrusal regresyon aynı işi görmez mi?
Yaklaşık olarak görür, ama iki farkla. Birincisi, E[\operatorname{logit}(Y)]\neq\operatorname{logit}(E[Y]): dönüşümlü regresyon logit'in ortalamasını modeller, beta regresyon ortalamanın logit'ini. Örnek veride nem katsayısı dönüşümlü EKK ile 0,625, beta regresyonla 0,582'dir. İkincisi, dönüşümlü regresyon logit ölçeğinde sabit varyans varsayar; beta regresyon varyansı \mu ve \phi'den türetir.
S7. Hassasiyet değişkeni için Wald testi ile olabilirlik oranı testi farklı sonuç verir mi?
Örnek veride yakındır: Wald z=-2{,}198 (p=0{,}0279), olabilirlik oranı \chi^2_1=4{,}988 (p=0{,}0255). Şablon yalnız Wald değerini yazar; olabilirlik oranı, hassasiyet değişkenli ve değişkensiz iki çalıştırmanın log-olabilirlik farkının iki katıdır ve elle hesaplanır.
S8. Başlangıç değerleri sonucu etkiler mi?
Beta log-olabilirliği logit–log bağlantılarında iyi huyludur ve EKK başlangıcı çözüme yakındır; bağımsız hesap başka bir başlangıçla (momentler) dört Newton adımında aynı noktaya varır. Etki, olabilirlik yüzeyinin tek tepeli olmadığı durumlarda görülür: karekök hassasiyet bağlantısı ve hassasiyet değişkeni birlikteyken yinelemeli çözücüler farklı noktalarda durabilir (30.8). Şablon bu yüzden her çözümü Newton-Raphson ve skor/Hessian ölçütüyle doğrular; log-olabilirlik ölçütü sağlanan en büyük noktadadır.
30.10 Kaynaklar
- Brooks, M. E., Kristensen, K., van Benthem, K. J., Magnusson, A., Berg, C. W., Nielsen, A., Skaug, H. J., Mächler, M., & Bolker, B. M. (2017). glmmTMB balances speed and flexibility among packages for zero-inflated generalized linear mixed modeling. The R Journal, 9(2), 378–400. https://doi.org/10.32614/RJ-2017-066
- Cribari-Neto, F., & Zeileis, A. (2010). Beta regression in R. Journal of Statistical Software, 34(2), 1–24. https://doi.org/10.18637/jss.v034.i02
- Douma, J. C., & Weedon, J. T. (2019). Analysing continuous proportions in ecology and evolution: A practical introduction to beta and Dirichlet regression. Methods in Ecology and Evolution, 10(9), 1412–1430. https://doi.org/10.1111/2041-210X.13234
- Ferrari, S. L. P., & Cribari-Neto, F. (2004). Beta regression for modelling rates and proportions. Journal of Applied Statistics, 31(7), 799–815. https://doi.org/10.1080/0266476042000214501
- Ospina, R., & Ferrari, S. L. P. (2012). A general class of zero-or-one inflated beta regression models. Computational Statistics & Data Analysis, 56(6), 1609–1623. https://doi.org/10.1016/j.csda.2011.10.005
- Seabold, S., & Perktold, J. (2010). Statsmodels: Econometric and statistical modeling with Python. Proceedings of the 9th Python in Science Conference, 92–96. https://doi.org/10.25080/Majora-92bf1922-011
- Simas, A. B., Barreto-Souza, W., & Rocha, A. V. (2010). Improved estimators for a general class of beta regression models. Computational Statistics & Data Analysis, 54(2), 348–366. https://doi.org/10.1016/j.csda.2009.08.017
- Smithson, M., & Verkuilen, J. (2006). A better lemon squeezer? Maximum-likelihood regression with beta-distributed dependent variables. Psychological Methods, 11(1), 54–71. https://doi.org/10.1037/1082-989X.11.1.54
- Virtanen, P., Gommers, R., Oliphant, T. E., et al. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2