60. Boş Şablon (Python)
Şablon kimliği: bos_python · Kategori: öğretici · Dil: Python · Dosya: pro/sablonlar/ogretici/bos_python.py (satır 1–50; üstbilgi 1–15) · Örnek veri: _ornek/gruplu_verim.csv · Paketler: pandas 2.3.3, numpy, matplotlib 3.10.9
60.1 Ne işe yarar
Bu şablon bir istatistik yöntemi değildir; kullanıcının kendi Python şablonunu yazarken başlayacağı iskelettir. Bir şablonun taşıması gereken her parçayı en küçük hâliyle gösterir: üstbilgi, tek bir parametre, veri denetimi, iki dilli ileti, bir metin çıktısı, bir tablo ve bir şekil. Çalıştırıldığında seçilen sayısal sütunun gözlem sayısını, ortalamasını ve standart sapmasını yazar, verinin özet tablosunu ve sütunun histogramını üretir.
Ne zaman kullanılır? Kütüphanede karşılığı olmayan bir hesabı form, tablo ve şekil düzeniyle yinelenebilir kılmak istendiğinde; bir analizin kurum içi sürümü yazılacağında; şablon sözleşmesini (üstbilgi → form → P → çıktı) öğrenmek için.
Ne zaman kullanılmaz?
- Yalnız özet istatistik gerekiyorsa: temel programdaki Tanımlayıcı İstatistikler.
- Yapılacak hesap R paketine dayanıyorsa:
bos_r(Bölüm 61). - Kütüphanede aynı işi yapan hazır bir şablon varsa (yeniden örnekleme için
bootstrap_ozel,permutasyon_ozel; olabilirlik içinozel_olabilirlik): hazır şablonun girdi denetimleri ve doğrulaması yeniden yazılmaz.
Temel programla ilişki. Şablonlar temel programın veri sekmesindeki etkin veriyi kullanır ve sonuçlarını temel programın sonuç kartlarına yazar. Şablon kodu veriyi değiştirmez: df bir kopyadır.
60.2 Şablonun girdileri
Üstbilgi, dosyanın başında # /// mq-sablon ile # /// satırları arasındaki yorum satırlarına gömülü bir TOML belgesidir (bos_python.py:1–15).
| Üstbilgi alanı | İskeletteki değer | Kural (pro/kod/sablon.py) |
|---|---|---|
kimlik |
bos_python |
Küçük harf, rakam ve alt çizgi; 1–64 karakter (85, 317–319). |
surum |
1 | Tamsayı; çalıştırma kaydında kimlik@surum (323–326). |
dil |
python |
python ya da r; yazılmazsa python (320–322). |
kategori |
ogretici |
Kütüphanedeki küme; yazılmazsa genel (333). |
baslik, aciklama |
Türkçe, İngilizce, İspanyolca | Düz metin de yazılabilir; üç dile aynen kopyalanır (263–268). |
ornek_veri, ornek_param |
gruplu_verim.csv; degisken = "verim" |
"Örnek veriyi aç" düğmesinin yüklediği dosya ve forma yazdığı değerler. |
[[param]] |
tek blok | Her blok formda bir alan kurar. |
İskeletin tek parametresi:
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Sayısal değişken · degisken |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | df[P["degisken"]] (32). |
Bir [[param]] bloğunda ad (harf ya da alt çizgiyle başlar, en çok 41 karakter) ve tur zorunludur (271–277). Öteki anahtarlar: etiket, aciklama, varsayilan, bolum (degiskenler, model, secenekler, gelismis, cikti; bilinmeyen değer yok sayılır), sayı türlerinde en_az ve en_cok, secim türünde secenekler (boş olamaz), sütun türlerinde zorunlu, sutunlar türünde sayisal ve en_az_sayi. bolum yazılmazsa sütun türleri Değişkenler, ötekiler Seçenekler sekmesine yerleşir (82–84). Aynı ad iki blokta kullanılamaz (328–330). Tür listesi Bölüm 1.2'dedir.
Şablonun kendi denetimleri.
| Koşul | İleti | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 29–30 |
| Sütunda sayıya çevrilebilen değer yok | "Seçilen değişkende sayısal değer yok." | 32–34 |
Formun biçimsel denetimi (Bölüm 1.2) kod çalışmadan önce yapılır: sayısal olmayan bir sütun seçilirse, aralık dışı bir sayı ya da seçeneklerde bulunmayan bir değer verilirse, şemada olmayan bir parametre adı gönderilirse çalıştırma başlamaz (sablon.py:831–931).
60.3 Örnek veri
Dosya: _ornek/gruplu_verim.csv. 60 parsel, 4 sütun; eksik değer yoktur.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
parsel |
kullanılmaz | metin | P01–P60; 60 tekil değer. |
grup |
kullanılmaz (türetilmiş örnekte grup) | kategorik (3 düzey) | Kontrol, Gübre_A, Gübre_B; her birinde 20 parsel. |
blok |
kullanılmaz | kategorik (5 düzey) | B1–B5; her birinde 12 parsel. |
verim |
Seçilen değişken | sayısal | 2,31–15,27; ortalama 6,9945. |
grup düzeyleri verideki ilk görülme sırasıyla gelir: Kontrol, Gübre_A, Gübre_B (Bölüm 1.3). Bu bölümdeki çalıştırmalar: (1) iskelet, örnek ayar; (2) iskeletten türetilen örnek şablon (60.4.4), y = verim, grup = grup; (3) aynı şablon, grup = blok, güven düzeyi 0,90, nokta grafiği; (4) sözleşmenin sınır durumları (60.8).
60.4 Yöntem: formüller ve hesap adımları
Bir şablonun çalışması dört aşamadır: (1) üstbilgi ayrıştırılır ve form kurulur; (2) form değerleri denetlenir ve P sözlüğüne yazılır; (3) kod, hazır adların bulunduğu bir ad alanında çalışır; (4) kodun bıraktığı metin, tablo ve şekiller sonuç kartına toplanır.
60.4.1 Hazır adlar
Kod çalışmaya başladığında şu adlar tanımlıdır (pro/kod/isci.py:283–299):
| Ad | İçerik |
|---|---|
df |
Etkin verinin kopyası (pandas veri çerçevesi); veri açık değilse None. |
P |
Form değerleri sözlüğü: P["degisken"] → "verim". |
pd, np |
pandas ve numpy. |
mq |
Çıktı nesnesi (aşağıda). |
display |
mq.goster: bir nesneyi türüne göre tablo, şekil ya da metin olarak gösterir. |
P'deki değerin türü parametrenin türüne bağlıdır: sütun türlerinde sütun adı (metin), sutunlar'da ad listesi, tamsayi ve ondalik'ta sayı, secim'de seçilen deger (metin), metin'de metin, onay'da mantıksal. Zorunlu olmayan boş sütun alanı None, boş sütun listesi [] gelir. Değerler koda metin olarak yapıştırılmaz; sözlük olarak verilir.
60.4.2 Çıktı sözleşmesi
| Çağrı | Ne yapar | Kaynak |
|---|---|---|
mq.metin(...), print(...) |
Konsol metnine satır ekler. | pro/mq/cikti.py:377–378 |
mq.tablo(df, ad=...) |
Adlandırılmış tablo ekler; veri çerçevesi, seri ya da veri çerçevesine çevrilebilen nesne alır; tabloyu geri döndürür. | 260–270 |
mq.sekil(fig=None, baslik=...) |
Şekli başlığıyla kaydeder; fig verilmezse etkin matplotlib şekli alınır; aynı şekil iki kez kaydedilmez. |
272–278 |
mq.hata(ileti) |
Çalıştırmayı durdurur; kullanıcıya yalnız ileti gösterilir. | 321–324 |
mq.sayi(x, basamak=4, bicim="f") |
Arayüz diline göre sayı metni (Türkçede ondalık virgül). | 305–313 |
mq.p(p, basamak=4) |
p değeri metni; eşikten küçükse "< 0,0001". | 315–319 |
mq.dil, mq.veri_adi, mq.seed |
Arayüz dili (tr, en, es), veri dosyasının adı, çalıştırmanın tohumu. |
213–236 |
Sınırlar: bir çalıştırmada en çok 12 tablo ve 12 şekil (isci.py:38–39); tablo başına 5000 satır ve 200 sütun, fazlası kesilir (cikti.py:39–40). Tablodaki sayısal hücreler tam hassasiyetle saklanır; sayı, mantıksal değer ve tarih dışındaki hücreler metne çevrilir (cikti.py:46–59). Şekiller 120 dpi ile, kenar boşlukları kırpılarak kaydedilir.
Neden mq.hata, neden raise değil?
mq.hata kullanıcının düzeltebileceği durumlar içindir (yanlış sütun, yetersiz gözlem): sonuç kartında yalnız ileti görünür. Sıradan bir Python hatası ise program hatası sayılır; kartta hata türü, satır numarası ve çağrı izi gösterilir. İskelet, veri yokluğunu ve boş sütunu mq.hata ile karşılar (satır 30, 34).
Koddaki tercih
İletiler _m(tr, en) yardımcısıyla seçilir (satır 22–23): arayüz Türkçeyse ilk metin, değilse ikincisi döner. Sayılar metne mq.sayi ile çevrilir; f-dizgesi içindeki {x.mean():.4f} yazımı Türkçe arayüzde de nokta üretir. İskelet bu iki kuralı örnekler; türetilen şablonlarda da korunur.
60.4.3 İskeletin hesabı
İskeletin yaptığı hesap, seçilen sütunun eksik olmayan değerleri x_1,\dots,x_n üzerinde ortalama ve standart sapmadır:
- n: sayıya çevrilebilen değerlerin sayısı.
pd.to_numeric(errors="coerce")çevrilemeyen hücreyi eksik yapar;dropna()onları atar (satır 32). - s: n-1 bölenli standart sapma (
ddof=1, satır 38); n=1 ise tanımsızdır ve "NA" yazılır.
Tablo, df.describe(include="all").T çağrısının sonucudur (satır 42): her sütun için bir satır; sayısal sütunlarda sayı, ortalama, standart sapma, en küçük, çeyrekler ve en büyük; öteki sütunlarda sayı, tekil değer sayısı, en sık değer ve sıklığı. Çeyrekler doğrusal ara değerle hesaplanır (Hyndman ve Fan, 1996, tür 7): sıralı değerlerde (n-1)q konumu. Histogramın kutu sayısı bins="auto" ile seçilir (satır 46): Sturges (1926) ve Freedman-Diaconis (1981) kurallarının verdiği sayılardan büyük olanı.
60.4.4 İskeletten yeni şablon kurmak
Yeni bir şablon dört adımda kurulur: (1) üstbilgide kimlik, baslik ve aciklama değiştirilir; (2) her girdi için bir [[param]] bloğu yazılır; (3) gövdede önce mq.hata denetimleri, sonra hesap gelir; (4) sonuçlar mq.metin, mq.tablo ve mq.sekil ile bildirilir. Aşağıdaki örnek (dogrulama/bos_python/turetilmis.py) iskeleti, grup ortalamalarını ve t dağılımına dayalı güven aralıklarını veren bir şablona çevirir. Üstbilgiye üç parametre eklenmiştir:
# [[param]]
# ad = "grup"
# tur = "kategorik_sutun"
# etiket = { tr = "Grup", en = "Group" }
# [[param]]
# ad = "guven"
# tur = "ondalik"
# bolum = "secenekler"
# varsayilan = 0.95
# en_az = 0.5
# en_cok = 0.999
# etiket = { tr = "Güven düzeyi", en = "Confidence level" }
# [[param]]
# ad = "cizim"
# tur = "secim"
# bolum = "cikti"
# varsayilan = "kutu"
# etiket = { tr = "Şekil", en = "Figure" }
# secenekler = [ { deger = "kutu", etiket = { tr = "Kutu grafiği", en = "Box plot" } }, { deger = "nokta", etiket = { tr = "Nokta grafiği", en = "Strip chart" } } ]
Gövdenin hesap bölümü:
duzeyler = list(dict.fromkeys(g))            # verideki ilk görülme sırası
for duzey in duzeyler:
    v = y[g == duzey]
    sh = v.std(ddof=1) / np.sqrt(v.size)
    tk = stats.t.ppf(1 - (1 - P["guven"]) / 2, v.size - 1)
    satirlar.append({"grup": duzey, "n": int(v.size), "ortalama": v.mean(), "SH": sh,
                     "GA_alt": v.mean() - tk * sh, "GA_ust": v.mean() + tk * sh})
mq.tablo(pd.DataFrame(satirlar), ad=_m("Grup ortalamaları", "Group means"))
- \bar y_g, s_g, n_g: g. grubun ortalaması, standart sapması ve gözlem sayısı.
- t_{1-\alpha/2,\,n_g-1}: n_g-1 serbestlik dereceli t dağılımının kantili; \alpha=1-\texttt{guven}.
- Her grup kendi standart sapmasıyla değerlendirilir; ortak varyans kullanılmaz.
Şablon dosyası kullanıcı şablon klasörüne (sablonlarim) konduğunda kütüphanede görünür; klasör alt klasörleriyle birlikte taranır, adı alt çizgiyle başlayan dosya ve klasörler atlanır, üstbilgisi geçersiz dosya listeye alınmaz (sablon.py:708–727). Kod sekmesindeki "Şablon olarak kaydet" komutu aynı işi yapar: başlıktan bir kimlik türetir, üstbilgiyi yeniden yazar ve dosyayı bu klasöre kaydeder (944–977).
60.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–15 | Üstbilgi. | 10. satırdaki alan, karşılaştırma yan dosyasının neden bulunmadığını açıklar; kullanıcı şablonunda gerekmez. |
| 16–17 | Hazır adları ve çıktı çağrılarını anımsatan yorum. | Yorum çevirisi yan dosyada (.ceviri.json) tutulur. |
| 18 | matplotlib.pyplot içe aktarılır. |
pd, np, mq hazırdır; öteki paketler içe aktarılır. |
| 22–23 | _m(tr, en): ileti dili. |
mq.dil okunur. |
| 29–34 | Veri ve sütun denetimi; x sayıya çevrilir, eksikler atılır. |
Sütun "kategorik" türde gelse de pd.to_numeric değerleri okur. |
| 36–40 | İki metin satırı: veri adı ve boyutu; n, ortalama, SS. | Sayılar mq.sayi ile (4 ondalık). |
| 42–43 | describe tablosu, "Veri özeti" adıyla. |
Karışık türlü hücreler metne çevrilerek saklanır. |
| 45–50 | Histogram; mq.sekil(fig, baslik=…). |
Renk #5B21B6; başlık kartta şeklin adıdır. |
60.6 Elle hesap: örnek veride bağımsız yeniden hesap
Bir iskelet için doğrulama, "belgelenen sözleşme çalışıyor mu" sorusudur. İki şey denetlenmiştir: iskeletin ve türetilmiş şablonun tablo sayıları bağımsız hesapla; sözleşmenin denetimleri sınır durumlarıyla (60.8). Bağımsız hesap dogrulama/bos_python/elle_hesap.py ile, pandas kullanılmadan (csv modülü ve açık formüller) yapılmıştır; R tarafı r_dogrulama.R'dir.
Adım 1 — Ortalama ve standart sapma. n=60, \sum x_i=419{,}67:
Adım 2 — Çeyrekler. (n-1)q konumları 14,75; 29,5; 44,25'tir. Sıralı değerlerde doğrusal ara değer: Q_1=5{,}2250, medyan =6{,}6500, Q_3=8{,}0475; en küçük 2,31, en büyük 15,27.
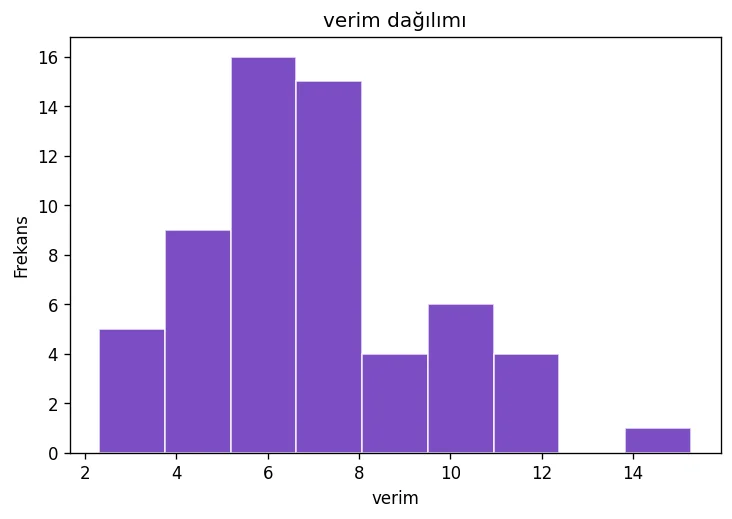
Adım 3 — Histogram kutuları. Sturges: \lceil\log_2 60+1\rceil=7. Freedman-Diaconis: kutu genişliği 2\,(Q_3-Q_1)\,n^{-1/3}=1{,}4419, kutu sayısı \lceil(15{,}27-2{,}31)/1{,}4419\rceil=9. Büyük olan 9'dur; Şekil 60.1'de dokuz kutu vardır.
Adım 4 — Türetilmiş şablon. Kontrol grubu: n=20, \bar y=5{,}3725, \text{SH}=0{,}381973, t_{0{,}975;\,19}=2{,}093024:
Gübre_A: 7,1930 (SH 0,4488) [6,2537; 8,1323]; Gübre_B: 8,4180 (SH 0,6452) [7,0677; 9,7683].
60.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu iskeletin "Veri özeti" tablosundan ve türetilmiş şablonun "Grup ortalamaları" tablosundan alınmıştır (çalıştırmalar 1–3).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Veri özeti: verim, count | 60 | 60 | 60 | 0 | ✓ |
| Veri özeti: verim, mean | 6,9945 | 6,9945 | 6,9945 | 0 | ✓ |
| Veri özeti: verim, std | 2,5514007 | 2,5514007 | 2,5514007 | 1,7e−16 | ✓ |
| Veri özeti: verim, min | 2,31 | 2,31 | 2,31 | 0 | ✓ |
| Veri özeti: verim, 25% | 5,225 | 5,225 | 5,225 | 0 | ✓ |
| Veri özeti: verim, 50% | 6,65 | 6,65 | 6,65 | 0 | ✓ |
| Veri özeti: verim, 75% | 8,0475 | 8,0475 | 8,0475 | 0 | ✓ |
| Veri özeti: verim, max | 15,27 | 15,27 | 15,27 | 0 | ✓ |
| Veri özeti: grup, unique | 3 | 3 | 3 | 0 | ✓ |
| Veri özeti: grup, freq | 20 | 20 | — | 0 | ✓ |
| Veri özeti: blok, unique | 5 | 5 | 5 | 0 | ✓ |
| Veri özeti: parsel, unique | 60 | 60 | — | 0 | ✓ |
| Türetilmiş şablon: Kontrol, ortalama | 5,3725 | 5,3725 | 5,3725 | 0 | ✓ |
| Türetilmiş şablon: Kontrol, SH | 0,38197332 | 0,38197332 | 0,38197332 | 5,6e−17 | ✓ |
| Türetilmiş şablon: Kontrol, GA_alt | 4,57302065 | 4,57302065 | 4,57302065 | 3,9e−15 | ✓ |
| Türetilmiş şablon: Kontrol, GA_ust | 6,17197935 | 6,17197935 | 6,17197935 | 2,9e−15 | ✓ |
| Türetilmiş şablon: Gübre_A, ortalama | 7,193 | 7,193 | 7,193 | 1,2e−16 | ✓ |
| Türetilmiş şablon: Gübre_A, SH | 0,44876972 | 0,44876972 | 0,44876972 | 0 | ✓ |
| Türetilmiş şablon: Gübre_A, GA_alt | 6,25371418 | 6,25371418 | 6,25371418 | 3,1e−15 | ✓ |
| Türetilmiş şablon: Gübre_A, GA_ust | 8,13228582 | 8,13228582 | 8,13228582 | 2,6e−15 | ✓ |
| Türetilmiş şablon: Gübre_B, ortalama | 8,418 | 8,418 | 8,418 | 0 | ✓ |
| Türetilmiş şablon: Gübre_B, SH | 0,64515017 | 0,64515017 | 0,64515017 | 1,1e−16 | ✓ |
| Türetilmiş şablon: Gübre_B, GA_alt | 7,06768518 | 7,06768518 | 7,06768518 | 4,3e−15 | ✓ |
| Türetilmiş şablon: Gübre_B, GA_ust | 9,76831482 | 9,76831482 | 9,76831482 | 2,9e−15 | ✓ |
| Türetilmiş şablon (blok, %90): B1, GA alt | 4,30223901 | 4,30223901 | 4,30223901 | 2,9e−14 | ✓ |
| Türetilmiş şablon (blok, %90): B1, GA üst | 5,49776099 | 5,49776099 | 5,49776099 | 2,2e−14 | ✓ |
| Türetilmiş şablon (blok, %90): B5, GA alt | 4,6041187 | 4,6041187 | 4,6041187 | 3,9e−14 | ✓ |
| Türetilmiş şablon (blok, %90): B5, GA üst | 6,34921463 | 6,34921463 | 6,34921463 | 2,9e−14 | ✓ |
Ölçütü karşılayan: 28/28. Python: csv ve numpy ile açık formüller (pandas kullanılmadan). R: açık formüller ve quantile(type = 7).
60.7 Çıktıyı okuma
İskeletin konsol metni:
Veri: gruplu_verim.csv  (60 satır × 4 sütun)
verim: n = 60, ortalama = 6,9945, SS = 2,5514
"Veri özeti" tablosu (kısaltılmış):
| count | unique | top | freq | mean | std | min | 25% | 50% | 75% | max | |
|---|---|---|---|---|---|---|---|---|---|---|---|
| parsel | 60 | 60 | P01 | 1 | |||||||
| grup | 60 | 3 | Kontrol | 20 | |||||||
| blok | 60 | 5 | B1 | 12 | |||||||
| verim | 60 | 6,9945 | 2,5514 | 2,31 | 5,225 | 6,65 | 8,0475 | 15,27 |
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| İlk metin satırı | Veri dosyasının adı ve boyutu | mq.veri_adi boşsa "-" yazılır. |
| İkinci metin satırı | Seçilen sütunun n, ortalama ve SS değeri | Dört ondalık, arayüz diline göre ayırıcı. |
| Veri özeti | Bütün sütunların describe özeti |
Sütuna uymayan hücreler boştur; sıklıklar eşitken top bu veride ilk görülen değerdir. |
| Şekil | Seçilen sütunun histogramı | Başlık ve eksen adları arayüz diline göre. |
Şekil 60.1. İskeletin çizdiği histogram (örnek veri, verim; dokuz kutu).
Türetilmiş şablonun konsol satırı verim ~ grup: 3 grup, n = 60, güven düzeyi 0,950; tablosu üç satırdır (60.6, Adım 4). Form değerleri değiştirildiğinde (grup = blok, güven 0,90, nokta grafiği) aynı kod beş satırlı tablo ve nokta grafiği üretir; kodda değişiklik gerekmez.
Rapor cümlesi (türetilmiş şablon):
Parsel verimi kontrol grubunda ortalama 5,37 (%95 GA [4,57; 6,17]), Gübre A grubunda 7,19 (%95 GA [6,25; 8,13]) ve Gübre B grubunda 8,42 (%95 GA [7,07; 9,77]) idi (her grupta n = 20).
60.8 Sık hatalar ve tuzaklar
- Üstbilgi satırını yorum işaretsiz bırakmak.
# /// mq-sablonile# ///arasındaki her satır#ile başlamalıdır; bir satır bile başlamıyorsa dosya şablon sayılmaz. Açılış satırından önce yalnız yorum ve boş satır bulunabilir. - Sayıyı f-dizgesiyle biçimlemek.
f"{ort:.4f}"Türkçe arayüzde nokta yazar;mq.sayi(ort)ayırıcıyı dile göre seçer. Tablolara ise metin değil sayı yazılır; biçimleme sonuç kartına bırakılır. - Kullanıcı hatasını sıradan hata olarak bırakmak. Yanlış seçimlerin doğuracağı durumlar gövdenin başında
mq.hataile karşılanır; aksi hâlde kullanıcı çağrı izi görür. - Form denetimine güvenip gövdede denetim yapmamak. Form yalnız tür ve aralık denetler. "Güven düzeyi 1,5" ya da "seçeneklerde olmayan şekil" formda durur ("değer 0,5 ile 0,999 arasında olmalı"; "geçerli bir seçenek değil"); "en az iki grup" ya da "yanıt ile grup aynı sütun" gibi yöntem koşulları gövdede denetlenir.
- Sütunun pandas türünü veri sekmesindeki türle karıştırmak.
sayisal_sutunalanı sütunun pandas türüne bakar. Veri sekmesinde "kategorik" yapılmış sayısal bir sütun formda yine seçilebilir; iskeletpd.to_numerickullandığından değerleri doğru okur. Türetilen şablonda gruplama sütunuastype(str)ile metne çevrilerek kullanılır. df'yi değiştirip verinin değişmesini beklemek.dfkopyadır; veri sekmesindeki veri değişmez.- On ikiden çok tablo ya da şekil üretmek. Fazlası sonuç kartına alınmaz; kaç tanesinin dışarıda kaldığı çalıştırma kaydına yazılır. Uzun döngülerde tablolar birleştirilir.
- Rastgelelik kullanıp tohumu düşünmemek. Yürütücü her çalıştırmada
randomvenumpy.randomiçin bir tohum ayarlar ve bunu kayda geçirir; aynı adım yeniden oynatıldığında aynı sayılar üretilir. Kendi üretecini kuran kod (np.random.default_rng()) tohumumq.seed'den almalıdır.
60.9 Uzman soruları
S1. Parametreler koda nasıl ulaşır; metin olarak mı yerleştirilir?
Hayır. Form değerleri denetlendikten sonra P sözlüğü olarak ad alanına konur (isci.py:290–291); kod metni değişmez. Bu, sütun adındaki tırnak ya da boşluk gibi karakterlerin kodu bozmasını ve değerlerin kod olarak yorumlanmasını önler. Şemada bulunmayan bir ad gönderilirse çalıştırma "bilinmeyen şablon parametresi" iletisiyle başlamadan durur.
S2. Varsayılanı olmayan sütun alanı formda nasıl dolar?
varsayilanlar (sablon.py:795–828) sütun alanına, başka bir alanın kullanmadığı uygun ilk sütunu önerir: sayisal_sutun için ilk sayısal sütun, kategorik_sutun için önce sayısal olmayanlar. Örnek veride degisken için tek sayısal sütun verim'dir. Zorunlu olmayan alan boş bırakılır.
S3. Aynı şablon gömülü ve harici yorumlayıcıda aynı mı çalışır?
Ad alanı ve mq çağrıları aynıdır. Kullanıcı kendi Python yorumlayıcısını seçtiğinde veri düz metin olarak aktarılır ve mq nesnesi yardımcı bir betikle kurulur (pro/kod/harici_mq.py); sınırlar aynıdır (12 tablo, 12 şekil, 5000 × 200). Fark, kullanılabilir paketlerdedir: harici yorumlayıcıda yalnız o ortamda kurulu paketler vardır ve temel programın iç modülleri içe aktarılamaz.
S4. Tabloya biçimlenmiş metin yazmak neden önerilmez?
Tablolar tam hassasiyetle saklanır ve sonuç kartında arayüz diline göre biçimlenir; dışa aktarımda sayı olarak kalır. Metne çevrilmiş sayı sıralanamaz, başka bir dile geçildiğinde ayırıcısı değişmez ve yuvarlama geri alınamaz. İskeletin describe tablosunda sayısal ve metin hücreler aynı sütunda bulunduğundan o tablo karışık türlüdür; kendi tablolarında her sütun tek türde tutulur.
S5. İskeletin histogramı ile R iskeletinin histogramı neden farklı görünür?
Kutu kuralları farklıdır. Python iskeleti bins="auto" ile Sturges ve Freedman-Diaconis sayılarından büyüğünü (9) alır ve aralığı eşit böler. R iskeleti hist()'in varsayılanını kullanır: Sturges sayısı (7) "güzel" sınırlar verecek biçimde yuvarlanır ve yedi kutu çizilir (Bölüm 61). İkisi de aynı veriyi gösterir; özet sayılar aynıdır.
S6. Türetilmiş şablondaki güven aralığı neden gruplara ortak varyans kullanmıyor?
Örnek, sözleşmeyi göstermek için en yalın tanımı seçer: her grup kendi standart hatası ve kendi serbestlik derecesiyle (n_g-1=19). Ortak varyanslı aralık (tek yönlü ANOVA'nın hata kareler ortalamasıyla, N-a=57 serbestlik derecesi) gruplar arası varyans eşitliği varsayar; istenirse gövdede iki satırla eklenir. Hangi tanımın kullanıldığı şablonun aciklama alanında yazılır.
60.10 Kaynaklar
- Freedman, D., & Diaconis, P. (1981). On the histogram as a density estimator: L2 theory. Zeitschrift für Wahrscheinlichkeitstheorie und Verwandte Gebiete, 57(4), 453–476. https://doi.org/10.1007/BF01025868
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
- McKinney, W. (2010). Data structures for statistical computing in Python. In S. van der Walt & J. Millman (Eds.), Proceedings of the 9th Python in Science Conference (pp. 56–61). https://doi.org/10.25080/Majora-92bf1922-00a
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161