52. Bağımlı veri için bootstrap (blok, dairesel, durağan; küme ve yabani küme bootstrap) (Python)
Şablon kimliği: bagimli_bootstrap_py · Kategori: yeniden_ornekleme · Dil: Python · Dosya: pro/sablonlar/yeniden_ornekleme/bagimli_bootstrap_py.py (satır 1–281; üstbilgi 1–96) · Örnek veri: _ornek/lynx.csv (küme kipi için _ornek/petersen.csv) · Paketler: NumPy 2.4.6, SciPy 1.16.3, pandas 2.3.3, Matplotlib 3.10.9
52.1 Ne işe yarar
Bu şablon, Bölüm 51'deki bagimli_bootstrap şablonunun NumPy ile yazılmış eşdeğeridir. Aynı iki soruyu cevaplar: ardışık gözlemleri ilişkili bir zaman serisinde ortalama, medyan, 1. gecikme otokorelasyonu ya da AR(p) katsayılarının standart hatası ve güven aralığı (blok bootstrap); kümelenmiş veride doğrusal regresyon katsayılarının standart hatası (küme ve yabani küme bootstrap'ı). Form alanları, varsayılanlar, blok kuralları, ideal standart hata formülü ve tabloların sütunları R şablonuyla aynıdır.
Yöntemin anlatımı (bağımlı veride olağan bootstrap neden yetmez, blokların kurulması, ideal varyans, üç kovaryans kestirimi, çift ve yabani küme bootstrap'ı) Bölüm 51.4'tedir ve burada yinelenmez. Bu bölüm iki şablonun farklarını anlatır: rastgele sayı üreteci ve tohum, çekiliş sırası, hesap yolu, denetimler, veri türlerine davranış ve aynı veride elde edilen sayılar.
Ne zaman kullanılır / kullanılmaz? Koşullar Bölüm 51.1 ile aynıdır. İki sürüm arasında seçim şu ölçütlerle yapılır:
- R kurulu değilse ya da çalışma akışı Python'daysa bu şablon;
bootvesandwichpaketlerinin çıktısıyla birebir karşılaştırma gerekiyorsabagimli_bootstrap(Bölüm 51). - Çalıştırmanın tohumu iki şablonda da etkilidir (52.4.1); iki şablonun üreteçleri farklı olduğundan aynı tohum aynı kopyaları vermez.
- Kopyaların kendisine erişmek ya da istatistiği değiştirmek isteniyorsa bu şablon: yeniden örnekleme döngüsü ve küme kopyaları kodda açıktır.
- Gözlemler bağımsızsa temel programdaki Bootstrap Güven Aralığı ya da
bootstrap_ozel(Bölüm 53).
Temel programla ilişki. Bölüm 51.1'deki ile aynıdır: temel programda blok ve küme bootstrap'ı yoktur; kümelenmiş standart hatanın kapalı formülü Panel Veri Regresyonu analizindedir.
52.2 Şablonun girdileri
Form, R şablonundakiyle aynı on iki alandan oluşur (bagimli_bootstrap_py.py:11–95); adlar, türler, varsayılanlar ve sınırlar birebir aynıdır.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Bağımlılık türü · tur |
seçim · Model | zaman |
zaman, kume |
Kip seçimi (135, 223). |
Seri ya da bağımlı değişken · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | Seri (136) ya da yanıt (234). |
Seriye log10 dönüşümü · log10_donusum |
onay · Seçenekler | kapalı | açık / kapalı | np.log10; seri pozitif olmalı (145–148). |
İstatistik · istatistik |
seçim · Model | ortalama |
ortalama, medyan, otokor1, ar |
Yeniden örneklenen seriye uygulanan işlev (160–161); otokorelasyon ve AR'de gecikmeli satırlara uygulanan işlev (165–183). |
AR mertebesi p · p |
tamsayı · Model | 2 | 1–10 | Yule-Walker mertebesi (157, 161, 165–183). |
Blok yöntemi · yontem |
seçim · Model | dairesel |
hareketli, dairesel, duragan |
Başlangıç aralığı ve blok uzunlukları (184–202). |
Blok uzunluğu l · l |
tamsayı · Model | 0 | 0–500 | 0 ise \operatorname{round}(n^{1/3}) (154). |
Açıklayıcılar · x |
sütunlar (sayısal) · Değişkenler | boş | en az 1 sayısal sütun (küme kipi) | Tasarım matrisi; sabit sütun eklenir (226, 235). |
Küme değişkeni · kume |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Metne çevrilip kodlanır (230). |
Küme bootstrap türü · kume_yontemi |
seçim · Model | xy |
xy, wild, webb |
Kopya üretim dalı (255–261). |
Bootstrap tekrar sayısı B · B |
tamsayı · Seçenekler | 1999 | 99–20000 | Döngü sayısı (112). |
Güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | Yüzdelik olasılıkları ve normal kantil (114–116). |
Örnek ayar (ornek_param, satır 10) R şablonuyla aynıdır: tur = zaman, y = lynx, log10_donusum = açık, istatistik = ortalama, yontem = dairesel, l = 5, B = 999.
Şablonun kendi denetimleri. İletiler R şablonuyla aynı metinlerdir; farklı olanlar kalın yazılmıştır.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 111 |
| Seride 3'ten az sayısal gözlem | "Seride yeterli sayısal gözlem yok." | 139 |
| Ortada eksik değer | "Serinin ortasında eksik değer var; …" | 142 |
| log10 seçili, sıfır ya da negatif değer | "log10 dönüşümü için seri pozitif olmalı." | 147 |
| n<20 | "Blok bootstrap için en az 20 gözlem gerekli." | 151 |
| Seri sabit | "Seri sabit." | 153 |
| l\ge n/2 | "Blok uzunluğu serinin yarısından kısa olmalı." | 156 |
ar seçili ve n<10p |
"AR mertebesi seri uzunluğuna göre çok büyük." | 159 |
| Küme değişkeni boş | "Kümelenmiş regresyon için bir küme değişkeni seçin." | 225 |
| Açıklayıcı kalmadı | "En az bir açıklayıcı seçin." | 228 |
| G<10 | "Küme bootstrap'ı için en az 10 küme gerekli." | 233 |
| Yanıt ya da açıklayıcı sayıya çevrilemiyor | "Bağımlı değişken ve açıklayıcılar sayısal olmalı." | 217 |
| Yanıt ya da bir açıklayıcı sabit (tek ileti) | "Bağımlı değişken ya da bir açıklayıcı sabit." | 219 |
| Açıklayıcılar doğrusal bağımlı | "Açıklayıcılar doğrusal bağımlı; birini çıkarın." | 221 |
R şablonundaki "Gözlem sayısı çok az" (n<q+5) denetimi ve yeniden örnekleme çağrısını saran "çalıştırılamadı" iletileri bu şablonda yoktur. Eksik değer kuralı aynıdır: zaman kipinde uçlardaki eksikler atılır, ortadaki eksik durdurur (140–144); küme kipinde eksik içeren satır atılır (209).
Sütunlar pd.to_numeric(…, errors="coerce") ile okunur (136, 234–235): sütunun veri sekmesindeki türü "kategorik" olsa da değerler doğru alınır; R sürümü de aynı sonucu verir (Bölüm 51.2).
52.3 Örnek veri
Örnek veriler Bölüm 51.3'tekilerle aynıdır: zaman serisi kipi için _ornek/lynx.csv (1821–1934 yılları, 114 yıllık vaşak yakalama sayıları; log10 ölçeğinde ortalama 2,9037, 1. gecikme otokorelasyonu 0,785; satır sırası zaman sırasıdır), kümelenmiş regresyon kipi için _ornek/petersen.csv (500 firma × 10 yıl = 5000 gözlem; y, x, firm, year). Veri sekmesi bütün sütunları "sayısal" algılar.
Küme değişkeni metne çevrilip verideki ilk görülme sırasıyla kodlanır (pd.factorize, satır 230). Sıra sonucu etkilemez: çift bootstrap kümeleri ad ayırmadan çeker, yabani bootstrap'ta ağırlıklar kümeler arasında değişimlidir.
Bu bölümde kullanılan çalıştırmalar, Bölüm 51'dekilerle aynı ayarlardadır: (1) örnek ayar; (2) yontem = hareketli; (3) yontem = duragan; (4) istatistik = medyan; (5) istatistik = otokor1; (6) istatistik = ar, p = 2; (7) guven = 0,90; (8) B=4000 ve 20000; (9) log10 kapalı; (10) küme kipi, petersen.csv, üç bootstrap türü, B=999; (11) çalıştırmanın tohumu 7 ve 2026 verilerek ve tohum hiç verilmeden.
52.4 Yöntem: formüller ve hesap adımları
Formüller Bölüm 51.4'tekilerdir; aşağıda yalnız bu şablonun onları nasıl uyguladığı ve R şablonundan ayrıldığı yerler anlatılır. Hesap sırası aynıdır.
52.4.1 Rastgele sayı üreteci ve tohum
Bootstrap sonucunu belirleyen tek rastgele öğe başlangıç noktalarıdır (ve durağan bootstrap'ta blok uzunlukları, yabani bootstrap'ta ağırlıklar). İki şablon bunları farklı üreteçlerden, farklı tohum kuralıyla ve farklı sırayla çeker.
| R şablonu (Bölüm 51) | Python şablonu | |
|---|---|---|
| Üreteç | Mersenne-Twister (R'nin varsayılanı) | PCG64 (np.random.default_rng) |
| Tohum | Çalıştırmanın tohumu (Tohum alanı boşsa arayüz her çalıştırmaya yenisini atar) | Çalıştırmanın tohumu (mq.seed, satır 113); tohum hiç verilmemişse (yürütücü tohumsuz çağrılırsa) 20261029 |
| Arayüzden aynı ayarla yeniden çalıştırma | Farklı (Monte Carlo hatası kadar) | Farklı (Monte Carlo hatası kadar) |
| Kaydedilmiş betiğin yeniden oynatılması | Aynı (tohum betik adımında saklıdır) | Aynı |
| Çalıştırma tohumunun etkisi | Var | Var |
| Çekiliş sırası (sabit blok) | Bütün kopyaların bütün başlangıçları tek çağrıda (B\times b matris) | Kopya başına bir çağrı (b başlangıç) |
| Çekiliş sırası (durağan) | Önce bütün blok uzunlukları, sonra bütün başlangıçlar | Blok blok: uzunluk, sonra başlangıç |
Tohum
Rastgele sayı üreteci np.random.default_rng(mq.seed if mq.seed is not None else 20261029) ile kurulur (satır 113). Çalıştırmanın tohumu Kod panelindeki Tohum alanından gelir; alan boşsa MerQuR+ her çalıştırmaya yeni bir tohum atar, kullanılan tohumu künyeye ve betik adımına yazar (pro/gui/kod_panel.py:552–572, Bölüm 1.3). Aynı tohum aynı sonucu, farklı tohum Monte Carlo hatası kadar farklı sonucu verir (tohum 7, 2026 ve 20261029 ile ortalamanın SH'si 0,0774; 0,0787 ve 0,0792). Bu bölümdeki sayılar tohum 20261029 ile (yürütücünün tohum verilmediğinde kullandığı değer) elde edilmiştir; arayüzde Tohum alanına bu sayı yazılarak yinelenir.
İki şablon neden aynı sayıları vermez?
Kestirim, bağımsızlık varsayımlı standart hata, ideal standart hata, regresyon katsayıları, klasik ve küme-sağlam standart hatalar rastgele çekilişe bağlı değildir; iki şablonda son basamağa kadar aynıdır. Bootstrap ortalaması, yanlılık, bootstrap standart hatası ve güven sınırları ise çekilen kopyalara bağlıdır. İki üreteç farklı sayı dizileri üretir; aynı tohum verilebilseydi bile kopyalar aynı olmazdı. Bu büyüklükler iki şablonda yalnız Monte Carlo hatası içinde örtüşür: fark B büyüdükçe 1/\sqrt B hızıyla küçülür (52.6.2).
52.4.2 Blokların kurulması
Blok planı R şablonuyla aynıdır: b=\lceil n/l\rceil blok; ilk b-1 blok l, son blok r=1+(n-1)\bmod l uzunluğunda (satır 198–199). Sarma için seri (ya da gecikmeli satırlar matrisi) iki kez art arda yazılır (yy = np.vstack([veri_m, veri_m]), 185) ve blok yy[s : s + uzunluk] dilimiyle alınır; bu, dizinleri n'ye göre sarmakla aynıdır. Başlangıçlar 0 tabanlıdır: dairesel ve durağan yöntemde \{0,\dots,n-1\}, hareketli blokta \{0,\dots,n-l\} (son_bas, 186; otokorelasyon ve AR'de n yerine N=n-K satır).
Durağan bootstrap'ta her blok için önce uzunluk rng.geometric(1/l) ile (değerler 1, 2, …; ortalama l), sonra başlangıç çekilir; uzunluk kalan gözlem sayısıyla sınırlanır (192). tsboot'taki 1+\text{Geo}(1/l) ile aynı dağılımdır.
52.4.3 İstatistikler
Ortalama ve medyan NumPy işlevleridir. Otokorelasyon ve AR katsayıları için şablon Yule-Walker denklemlerini kendisi kurar ve çözer (ar_yw, satır 127–132):
- Tanım Bölüm 51.4.3'tekiyle aynıdır (bölen n, ortalama çıkarılmış).
-
- gecikme otokorelasyonu, p=1 için bu sistemin çözümüdür: \phi_1=c_1/c_0=r_1 (satır 161).
- R şablonu aynı denklemleri
stats::ar.yw(Levinson-Durbin özyinelemesi) ile çözer; şablonnp.linalg.solvekullanır. İki yol aynı katsayıları verir (örnek seride \phi_1=1{,}3504376101, \phi_2=-0{,}7200308905).
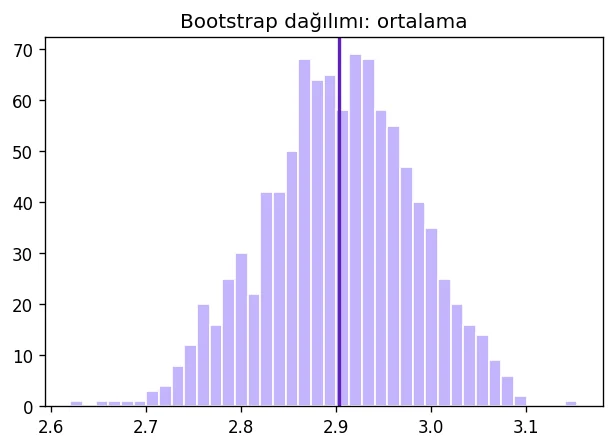
Blok ek yerlerinin otokorelasyon ve AR katsayılarını sıfıra çekmesi bu şablonda da R şablonundaki gibi aşılır (Bölüm 51.4.3): otokorelasyon ve AR'de seri değil gecikmeli satırlar blok blok yeniden örneklenir (satır 165–183); kopyaya uygulanan işlev (ist_g) satırların ortak ortalamasını çıkarır ve gecikme k otokovaryansını (j,\,j+k) sütun çiftlerinin ortalaması olarak alır. Örnek seride r_1=0{,}7851, kopyaların ortalaması 0,7841, SH 0,0299, yüzdelik aralık [0,7228; 0,8386].
52.4.4 Kopyalardan özetler ve ideal standart hata
ozet işlevi (satır 119–124) Bölüm 51.4.4'teki beş büyüklüğü hesaplar (hesaplanamayan kopyalar nan* işlevleriyle atlanır): bootstrap ortalaması, yanlılık, B-1 bölenli standart sapma, np.quantile ile yüzdelik sınırlar (varsayılan doğrusal ara değerleme; R'nin tip 7 tanımıyla aynı) ve yanlılık çıkarılmamış normal aralık. İdeal dairesel blok standart hatası Bölüm 51.4.5'teki formülün doğrudan uygulamasıdır (190–196): n başlangıcın blok toplamları ve var() (n bölenli).
52.4.5 Kümelenmiş regresyon
Katsayılar, klasik ve CR1 kovaryansları matris formülleriyle hesaplanır (satır 242–250); paket çağrısı yoktur. CR1 çarpanı \frac{G}{G-1}\cdot\frac{n-1}{n-k} açık yazılmıştır (249).
Koddaki tercih
Çift bootstrap (255–258): kümeler alt alta dizilmez; her kopyada G küme çekilir, her kümenin kaç kez çekildiği sayılır (np.bincount) ve bu sayı kümenin bütün satırlarına ağırlık olarak verilir. Ağırlıklı normal denklemler (\mathbf X^{\top}\mathbf W\mathbf X)\boldsymbol\beta=\mathbf X^{\top}\mathbf W\mathbf y çözülür. Tam sayı ağırlıklı en küçük kareler, satırların o sayıda yinelenmesiyle özdeştir; sonuç R'deki satır dizme yoluyla aynıdır, bellek ve süre bakımından daha ucuzdur.
Yabani bootstrap (259–261): ağırlıklar rng.choice ile çekilir, yeni yanıt \hat y+\hat e\,v_g kurulur ve önceden hesaplanmış (\mathbf X^{\top}\mathbf X)^{-1}\mathbf X^{\top} ile katsayılar bulunur. Webb noktaları \mp\sqrt{1{,}5},\ \mp1,\ \mp\sqrt{0{,}5} (232).
Kopya katsayıları bb dizisinde saklanır; tabloya yalnız standart sapmaları, normal aralık ve normal Wald p değeri yazılır (262–267).
52.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–96 | Üstbilgi: R şablonuyla aynı parametreler; ek bir alan (satır 9) karşılaştırma yan dosyasının adını verir. | Form buradan kurulur (Bölüm 1.2). |
| 97–116 | İçe aktarmalar, dil yardımcısı, B, çalıştırmanın tohumuyla kurulan üreteç (113), güven düzeyi, pq, normal kantil. |
Aynı tohum aynı kopyaları verir. |
| 119–132 | ozet (kopya özetleri) ve ar_yw (Yule-Walker). |
np.quantile doğrusal ara değerleme kullanır. |
| 135–163 | Zaman kipi: seriyi oku, uçları kırp, log10, denetimler, blok uzunluğu, istatistik işlevi (kestirim için) ve adlar. | pd.to_numeric: tür "kategorik" olsa da değerler okunur. |
| 164–202 | Gecikmeli satırlar ve kopya istatistiği (165–183); yeniden örnekleme döngüsü: durağan (187–197) ya da sabit blok (198–201); her kopyada istatistik. | Python döngüsüdür; B büyüdükçe süre doğrusal artar. |
| 204–217 | Özet satırı, bootstrap tablosu, "Ayrıntılar" tablosu, ideal SH. | Bağımsızlık varsayımlı SH np.std(y)/√n (209). |
| 218–222 | Kopyaların histogramı ve kestirim çizgisi. | Eksen adı yazılmaz; yatay eksen ilk parametredir. |
| 223–241 | Küme kipi: seçimler, eksik satırlar, küme kodlaması, sayısallık, sabitlik ve rank denetimleri. | matrix_rank doğrusal bağımlılığı yakalar. |
| 242–250 | EKK katsayıları, klasik SH, küme skor toplamları U, CR1. |
np.add.at(U, g, X * e[:, None]) küme toplamını kurar. |
| 251–262 | Çift ya da yabani küme bootstrap döngüsü; kopyaların standart sapması. | Kopyalar bb'de saklıdır; yüzdelik aralık istenirse np.quantile(bb, …, axis=0) ile eklenebilir. |
| 263–281 | Özet satırı, iki tablo, standart hataların çubuk grafiği. | Sütunlar R şablonuyla aynı adlardadır. |
Kritik satırlar:
rng = np.random.default_rng(mq.seed if mq.seed is not None else 20261029)
…
nb = int(np.ceil(N / lb))
lens = [lb] * (nb - 1) + [1 + (N - 1) % lb]
st = rng.integers(0, son_bas, nb)
z = np.concatenate([yy[s: s + ln] for s, ln in zip(st, lens)])
52.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/bagimli_bootstrap_py/elle_hesap.py ile hesaplanmıştır. Bağımsız hesap şablonun rastgele sayı akışını aynı çağrı sırasıyla yeniden üretir (aynı kopyalar için bu zorunludur), hesabı ise ayrı yoldan yapar: bloklar çift uzunluklu dizi yerine n'ye göre sarılan dizinlerle kurulur; otokorelasyon ve AR katsayıları Durbin-Levinson özyinelemesiyle bulunur; çift bootstrap küme toplamlarından (n_g, \sum x, \sum y, \sum x^2, \sum xy) kapalı biçimli basit regresyonla, yabani bootstrap \hat{\boldsymbol\beta}+(\mathbf X^{\top}\mathbf X)^{-1}\sum_gv_g\mathbf u_g eşitliğiyle hesaplanır; yüzdelikler sıralı değerlerden elle alınır.
Adım 1 — Rastgele çekilişe bağlı olmayan büyüklükler. n=114, \bar y=2{,}903664, \operatorname{SH}_{\text{iid}}=0{,}052070, ideal dairesel blok SH'si 0,079344 (l=5: b=23, r=4, V_5=3{,}582999, V_4=2{,}990574). Bölüm 51.6'daki Adım 1, 2 ve 6 ile aynıdır.
Adım 2 — İlk kopya. Şablonun akışında ilk kopyanın 23 başlangıç noktası (1 tabanlı yazılmış): 24, 49, 113, 110, 67, 112, 27, 99, 65, 92, 23, 57, 98, 22, 45, 89, 35, 40, 32, 50, 47, 63, 56. Birinci blok y_{24},\dots,y_{28} = 2,3284; 2,7372; 3,0141; 3,3282; 3,4041 (toplam 14,8120). Üçüncü blok 113'ten başlar ve sarar: y_{113},y_{114},y_{1},y_{2},y_{3} = 3,4244; 3,5310; 2,4298; 2,5065; 2,7672. Kopyanın ortalaması \bar y^{*}_1=2{,}816913. R şablonunun ilk kopyası başka başlangıçlardan oluşur (93, 7, 90, …; ortalama 2,932702): iki akış birbirinden bağımsızdır.
Adım 3 — 999 kopyanın özeti.
Yüzdelik alt sınır: h=24{,}95; sıralı kopyaların 25. ve 26.'sı 2,748384 ve 2,748964; q^{*}_{0{,}025}=2{,}748384+0{,}95\times0{,}000580=2{,}748935. Üst sınır: 974. ve 975. değerler 3,052807 ve 3,054432; q^{*}_{0{,}975}=3{,}052888. Normal aralık: 2{,}903664\mp1{,}959964\times0{,}079193=[2{,}748448;\ 3{,}058879].
Adım 4 — Öteki yöntem ve istatistikler (aynı akış, her çalıştırmada baştan):
| Çalıştırma | Bootstrap ort. | SH | Yüzdelik GA |
|---|---|---|---|
| Ortalama, hareketli | 2,899182 | 0,080390 | [2,735701; 3,050207] |
| Ortalama, durağan | 2,902947 | 0,066411 | [2,767371; 3,027219] |
| Medyan, dairesel | 2,923894 | 0,124982 | [2,718502; 3,186674] |
| Otokorelasyon(1), dairesel | 0,784120 | 0,029909 | [0,722828; 0,838582] |
| AR(2) \phi_1, dairesel | 1,362918 | 0,074989 | [1,216141; 1,515254] |
| AR(2) \phi_2, dairesel | −0,739892 | 0,043911 | [−0,826884; −0,653636] |
Durağan bootstrap'ta çekilen blokların ortalama uzunluğu 4,86'dır (son blokların kesilmesi nedeniyle 5'in biraz altında).
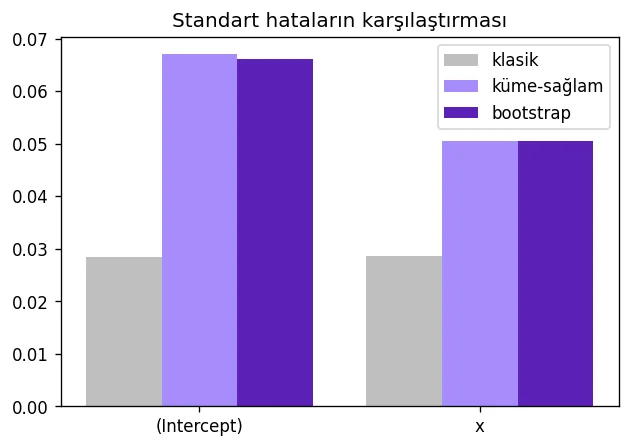
Adım 5 — Kümelenmiş regresyon. Katsayılar ve kapalı formüllü standart hatalar Bölüm 51.6 Adım 7'dekilerdir: \hat\beta=(0{,}029680;\ 1{,}034833); klasik SH 0,028359 ve 0,028583; CR1 0,067013 ve 0,050596. Çift bootstrap'ın ilk kopyasında çekilen firmalar 102, 213, 494, 481, 293, 489, 118, 431, … . 999 kopyanın standart sapması: sabit 0,066209, x 0,050587; x için aralık [0{,}935684;\ 1{,}133983]. Yabani bootstrap: Rademacher 0,065063 ve 0,050820; Webb 0,065489 ve 0,050848.
52.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır. R sütunu yalnız rastgele çekilişe bağlı olmayan büyüklükleri içerir (Bölüm 51'in R hesabından); R, NumPy'nin üretecini yeniden kuramadığı için kopyalara bağlı satırlarda boştur.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Ortalama, dairesel: kestirim | 2,90366375 | 2,90366375 | 2,90366375 | 3,1e−16 | ✓ |
| Ortalama, dairesel: bootstrap ortalaması | 2,9040316 | 2,9040316 | — | 0 | ✓ |
| Ortalama, dairesel: yanlılık | 3,678462·10−4 | 3,678462·10−4 | — | 4,6e−17 | ✓ |
| Ortalama, dairesel: bootstrap SH | 0,07919293 | 0,07919293 | — | 4,2e−17 | ✓ |
| Ortalama, dairesel: yüzdelik GA alt | 2,74893519 | 2,74893519 | — | 0 | ✓ |
| Ortalama, dairesel: yüzdelik GA üst | 3,05288785 | 3,05288785 | — | 0 | ✓ |
| Ortalama, dairesel: normal GA alt | 2,74844847 | 2,74844847 | — | 0 | ✓ |
| Ortalama, dairesel: normal GA üst | 3,05887904 | 3,05887904 | — | 0 | ✓ |
| Bağımsızlık varsayımıyla SH | 0,05206987 | 0,05206987 | 0,05206987 | 6,2e−17 | ✓ |
| İdeal dairesel blok SH'si (l=5) | 0,0793443 | 0,0793443 | 0,0793443 | 8,3e−17 | ✓ |
| Ortalama, dairesel, %90: yüzdelik GA alt | 2,76664138 | 2,76664138 | — | 0 | ✓ |
| Ortalama, dairesel, %90: yüzdelik GA üst | 3,03273538 | 3,03273538 | — | 0 | ✓ |
| Ortalama, dairesel, %90: normal GA alt | 2,77340298 | 2,77340298 | — | 0 | ✓ |
| Ortalama, dairesel, %90: normal GA üst | 3,03392452 | 3,03392452 | — | 0 | ✓ |
| Ortalama, hareketli: bootstrap ortalaması | 2,89918162 | 2,89918162 | — | 0 | ✓ |
| Ortalama, hareketli: bootstrap SH | 0,0803905 | 0,0803905 | — | 4,2e−17 | ✓ |
| Ortalama, hareketli: yüzdelik GA alt | 2,73570083 | 2,73570083 | — | 0 | ✓ |
| Ortalama, hareketli: yüzdelik GA üst | 3,05020741 | 3,05020741 | — | 0 | ✓ |
| Ortalama, durağan: bootstrap ortalaması | 2,90294657 | 2,90294657 | — | 1,5e−16 | ✓ |
| Ortalama, durağan: bootstrap SH | 0,06641093 | 0,06641093 | — | 2,8e−17 | ✓ |
| Ortalama, durağan: yüzdelik GA alt | 2,76737056 | 2,76737056 | — | 0 | ✓ |
| Ortalama, durağan: yüzdelik GA üst | 3,02721921 | 3,02721921 | — | 0 | ✓ |
| Medyan, dairesel: kestirim | 2,88699263 | 2,88699263 | 2,88699263 | 0 | ✓ |
| Medyan, dairesel: bootstrap SH | 0,12498228 | 0,12498228 | — | 8,3e−17 | ✓ |
| Medyan, dairesel: yüzdelik GA alt | 2,71850169 | 2,71850169 | — | 0 | ✓ |
| Medyan, dairesel: yüzdelik GA üst | 3,18667387 | 3,18667387 | — | 1,4e−16 | ✓ |
| Otokorelasyon(1), dairesel: kestirim | 0,78512404 | 0,78512404 | 0,78512404 | 0 | ✓ |
| Otokorelasyon(1), dairesel: bootstrap ortalaması | 0,78411981 | 0,78411981 | — | 0 | ✓ |
| Otokorelasyon(1), dairesel: bootstrap SH | 0,0299086 | 0,0299086 | — | 3,1e−17 | ✓ |
| Otokorelasyon(1), dairesel: yüzdelik GA alt | 0,72282787 | 0,72282787 | — | 1,1e−16 | ✓ |
| Otokorelasyon(1), dairesel: yüzdelik GA üst | 0,83858155 | 0,83858155 | — | 0 | ✓ |
| AR(2) \phi_1, dairesel: kestirim | 1,35043761 | 1,35043761 | 1,35043761 | 1,6e−16 | ✓ |
| AR(2) \phi_1, dairesel: bootstrap ortalaması | 1,36291824 | 1,36291824 | — | 4,9e−16 | ✓ |
| AR(2) \phi_1, dairesel: bootstrap SH | 0,0749895 | 0,0749895 | — | 1,4e−16 | ✓ |
| AR(2) \phi_2, dairesel: kestirim | −0,72003089 | −0,72003089 | −0,72003089 | 5,6e−16 | ✓ |
| AR(2) \phi_2, dairesel: bootstrap ortalaması | −0,73989152 | −0,73989152 | — | 1,1e−16 | ✓ |
| AR(2) \phi_2, dairesel: bootstrap SH | 0,04391056 | 0,04391056 | — | 2,8e−17 | ✓ |
| Ham seri ortalaması, dairesel: kestirim | 1538,01754386 | 1538,01754386 | 1538,01754386 | 0 | ✓ |
| Ham seri ortalaması, dairesel: bootstrap SH | 206,99768242 | 206,99768242 | — | 0 | ✓ |
| Ham seri: ideal SH (l=5) | 210,92694361 | 210,92694361 | 210,92694361 | 0 | ✓ |
| Küme: katsayı (sabit) | 0,02967972 | 0,02967972 | 0,02967972 | 2,4e−17 | ✓ |
| Küme: klasik SH (sabit) | 0,02835932 | 0,02835932 | 0,02835932 | 1,0e−17 | ✓ |
| Küme: küme-sağlam SH, CR1 (sabit) | 0,0670127 | 0,0670127 | 0,0670127 | 9,7e−17 | ✓ |
| Küme: katsayı (x) | 1,03483344 | 1,03483344 | 1,03483344 | 3,2e−15 | ✓ |
| Küme: klasik SH (x) | 0,02858329 | 0,02858329 | 0,02858329 | 6,2e−17 | ✓ |
| Küme: küme-sağlam SH, CR1 (x) | 0,05059573 | 0,05059573 | 0,05059573 | 2,3e−16 | ✓ |
| Küme: bootstrap SH (çift; sabit) | 0,06620937 | 0,06620937 | — | 1,4e−17 | ✓ |
| Küme: bootstrap SH (çift; x) | 0,05058747 | 0,05058747 | — | 8,3e−17 | ✓ |
| Küme: GA alt (çift; x) | 0,93568381 | 0,93568381 | — | 7,8e−16 | ✓ |
| Küme: GA üst (çift; x) | 1,13398307 | 1,13398307 | — | 5,9e−16 | ✓ |
| Küme: p (çift; sabit) | 0,65395782 | 0,65395782 | — | 4,4e−16 | ✓ |
| Küme: bootstrap SH (yabani, Rademacher; sabit) | 0,06506344 | 0,06506344 | — | 5,6e−17 | ✓ |
| Küme: bootstrap SH (yabani, Rademacher; x) | 0,05081957 | 0,05081957 | — | 2,8e−17 | ✓ |
| Küme: bootstrap SH (yabani, Webb; sabit) | 0,06548915 | 0,06548915 | — | 1,4e−17 | ✓ |
| Küme: bootstrap SH (yabani, Webb; x) | 0,05084779 | 0,05084779 | — | 2,1e−17 | ✓ |
Ölçütü karşılayan: 55/55. Python: şablonun numpy akışı (sabit tohum 20261029) aynı çağrı sırasıyla, hesap ise ayrı yoldan (mod n dizinleri, Durbin-Levinson, küme toplamları, skor toplamları). R sütunu yalnız rastgele çekilişe bağlı olmayan büyüklükleri içerir; R numpy'nin üretecini yeniden kuramaz.
52.6.2 İki şablon aynı veride
Aşağıdaki tablo bagimli_bootstrap (R; doğrulama çalıştırıcısında tohum 2026) ve bagimli_bootstrap_py şablonlarının aynı veri ve ayarla verdiği sonuçları yan yana koyar. Son sütun, standart hata farkının kendi Monte Carlo standart hatasına oranıdır: bir bootstrap standart hatasının Monte Carlo standart hatası yaklaşık \operatorname{SH}/\sqrt{2B}, iki bağımsız akışın farkınınki \operatorname{SH}/\sqrt{B}'dir. Oranın mutlak değeri 2'yi aşmıyorsa fark yalnız rastgele çekilişten gelir.
| Çalıştırma | Büyüklük | R şablonu | Python şablonu | Fark | Fark / Monte Carlo SH'si |
|---|---|---|---|---|---|
| Ortalama, dairesel, l=5 | kestirim | 2,903664 | 2,903664 | 0 | — |
| Ortalama, dairesel, l=5 | bootstrap SH | 0,077185 | 0,079193 | −0,002008 | −0,81 |
| Ortalama, dairesel, l=5 | yüzdelik GA alt | 2,755823 | 2,748935 | 0,006888 | — |
| Ortalama, dairesel, l=5 | yüzdelik GA üst | 3,040101 | 3,052888 | −0,012787 | — |
| Ortalama, hareketli | kestirim | 2,903664 | 2,903664 | 0 | — |
| Ortalama, hareketli | bootstrap SH | 0,082891 | 0,080390 | 0,002501 | 0,97 |
| Ortalama, hareketli | yüzdelik GA alt | 2,728641 | 2,735701 | −0,007060 | — |
| Ortalama, hareketli | yüzdelik GA üst | 3,050906 | 3,050207 | 0,000699 | — |
| Ortalama, durağan | kestirim | 2,903664 | 2,903664 | 0 | — |
| Ortalama, durağan | bootstrap SH | 0,066510 | 0,066411 | 0,000099 | 0,05 |
| Ortalama, durağan | yüzdelik GA alt | 2,771026 | 2,767371 | 0,003655 | — |
| Ortalama, durağan | yüzdelik GA üst | 3,032063 | 3,027219 | 0,004844 | — |
| Medyan, dairesel | kestirim | 2,886993 | 2,886993 | 0 | — |
| Medyan, dairesel | bootstrap SH | 0,126736 | 0,124982 | 0,001753 | 0,44 |
| Medyan, dairesel | yüzdelik GA alt | 2,720979 | 2,718502 | 0,002477 | — |
| Medyan, dairesel | yüzdelik GA üst | 3,185122 | 3,186674 | −0,001552 | — |
| Otokorelasyon(1), dairesel | kestirim | 0,785124 | 0,785124 | 0 | — |
| Otokorelasyon(1), dairesel | bootstrap SH | 0,030152 | 0,029909 | 0,000243 | 0,26 |
| Otokorelasyon(1), dairesel | yüzdelik GA alt | 0,724438 | 0,722828 | 0,001610 | — |
| Otokorelasyon(1), dairesel | yüzdelik GA üst | 0,839140 | 0,838582 | 0,000558 | — |
| Ortalama, dairesel, B=4000 | kestirim | 2,903664 | 2,903664 | 0 | — |
| Ortalama, dairesel, B=4000 | bootstrap SH | 0,077748 | 0,080264 | −0,002517 | −2,01 |
| Ortalama, dairesel, B=4000 | yüzdelik GA alt | 2,744531 | 2,740771 | 0,003761 | — |
| Ortalama, dairesel, B=4000 | yüzdelik GA üst | 3,050975 | 3,055695 | −0,004720 | — |
| Ortalama, dairesel, B=20000 | kestirim | 2,903664 | 2,903664 | 0 | — |
| Ortalama, dairesel, B=20000 | bootstrap SH | 0,079487 | 0,079501 | −0,000014 | −0,03 |
| Ortalama, dairesel, B=20000 | yüzdelik GA alt | 2,743311 | 2,742511 | 0,000801 | — |
| Ortalama, dairesel, B=20000 | yüzdelik GA üst | 3,054381 | 3,055706 | −0,001325 | — |
| Küme (çift) | katsayı (x) | 1,034833 | 1,034833 | 0 | — |
| Küme (çift) | küme-sağlam SH (x) | 0,050596 | 0,050596 | 0 | — |
| Küme (çift) | bootstrap SH (sabit) | 0,066090 | 0,066209 | −0,000120 | −0,06 |
| Küme (çift) | bootstrap SH (x) | 0,049392 | 0,050587 | −0,001196 | −0,76 |
| Yabani (Rademacher) | bootstrap SH (sabit) | 0,067321 | 0,065063 | 0,002257 | 1,08 |
| Yabani (Rademacher) | bootstrap SH (x) | 0,049421 | 0,050820 | −0,001399 | −0,88 |
| Yabani (Webb) | bootstrap SH (sabit) | 0,066592 | 0,065489 | 0,001103 | 0,53 |
| Yabani (Webb) | bootstrap SH (x) | 0,049872 | 0,050848 | −0,000976 | −0,61 |
Okuma:
- Kestirimler ve kapalı formüllü standart hatalar aynıdır (fark sıfır): iki şablon aynı tanımları uygular.
- Bootstrap standart hataları Monte Carlo hatası içinde örtüşür: on üç karşılaştırmada oran −2,0 ile +1,1 arasındadır. En büyük oran (B=4000; −2,0) beklenen aralığın sınırındadır ve tek başına bir tanım farkına işaret etmez: B=20000'de iki değer 0,079487 ve 0,079501'dir, ideal değer 0,079344.
- Yüzdelik sınırlar standart hatadan daha çok oynar: B=999'da sınırlar arasındaki fark 0,013'e kadar çıkar, B=20000'de 0,0013'e iner. Kuyruk kantilleri az sayıda kopyaya dayanır; güven sınırı raporlanacaksa B büyük tutulur.
- Durağan bootstrap'ta iki şablon aynı dağılımı kullanır (SH 0,066510 ve 0,066411): blok uzunluğu tanımı aynıdır.
- Otokorelasyonda iki şablon aynı sonucu verir (SH 0,0302 ve 0,0299; yüzdelik aralık [0,7244; 0,8391] ve [0,7228; 0,8386]; kestirim 0,7851): iki şablonda da kopyalar gecikmeli satırlardan hesaplanır.
52.7 Çıktıyı okuma
Örnek ayarın konsol metni ve tabloları (tablolar dört ondalığa yuvarlanmış):
Blok bootstrap: n = 114, l = 5, B = 999, yöntem = dairesel, istatistik = ortalama

Blok bootstrap (dairesel, l = 5, B = 999)
parametre  kestirim  bootstrap_ort  yanlilik  SH_bootstrap
 ortalama    2.9037         2.9040    0.0004        0.0792
GA_yuzdelik_alt  GA_yuzdelik_ust  GA_normal_alt  GA_normal_ust
         2.7489           3.0529         2.7484         3.0589

Ayrıntılar
                                   olcut    deger
                                       n 114.0000
                         blok uzunluğu l   5.0000
                                       B 999.0000
bağımsız (iid) bootstrap varsayımıyla SH   0.0521
       ideal (B → ∞) dairesel blok SH'si   0.0793
Küme kipi (çalıştırma 10, çift bootstrap):
Küme bootstrap: n = 5000, G = 500, B = 999, tür = xy

Kümelenmiş regresyon: xy bootstrap SH (G = 500 küme, B = 999)
  parametre  kestirim  SH_klasik  SH_kume_saglam_CR1  SH_bootstrap  GA_alt  GA_ust  p_bootstrap
(Intercept)    0.0297     0.0284              0.0670        0.0662 -0.1001  0.1594       0.6540
          x    1.0348     0.0286              0.0506        0.0506  0.9357  1.1340       0.0000
Tabloların sütunları ve yorumu Bölüm 51.7'dekiyle aynıdır; burada yalnız farklar verilir.
| Öğe | R şablonundan farkı | Nasıl yorumlanır |
|---|---|---|
bootstrap_ort, yanlilik, SH_bootstrap, yüzdelik ve normal GA |
Sayılar Monte Carlo hatası içinde farklıdır (52.6.2). | Rapor edilen şablon belirtilir. |
kestirim, bağımsızlık varsayımlı SH, ideal SH, klasik ve CR1 SH |
Aynı. | Karşılaştırmanın sabit noktalarıdır. |
| "Ayrıntılar" tablosu | Küme kipinde n, G, B ondalıklı görünür (5000.0). |
Değerler tam sayıdır. |
| Küme kipi parametre adları | Sabit terim (Intercept), açıklayıcılar sütun adlarıyla. |
R şablonuyla aynı adlar. |
| Histogram | Eksen adları yoktur. | Yatay eksen istatistiğin değeri, dikey eksen sıklıktır. |
Şekil 52.1. Şablonun şekli (örnek ayar): 999 dairesel blok kopyasında ortalamanın dağılımı; dikey çizgi özgün kestirimdir (2,9037).
Şekil 52.2. Küme kipinin şekli: her katsayı için klasik (gri), küme-sağlam (açık mor) ve bootstrap (koyu mor) standart hataları.
Rapor cümlesi (örnek ayar):
Vaşak serisinin (1821–1934, n = 114) log10 ölçeğindeki ortalaması 2,904 bulundu. Standart hata dairesel blok bootstrap'ıyla kestirildi (blok uzunluğu 5, B = 999; MerQuR+
bagimli_bootstrap_pyşablonu, sabit rastgele sayı akışı): SH = 0,079; %95 yüzdelik GA [2,749; 3,053]. Blok bootstrap standart hatasının kuramsal (B → ∞) değeri 0,079, gözlemlerin bağımsız sayılması durumunda elde edilecek değer 0,052'dir.
52.8 Sık hatalar ve tuzaklar
Bölüm 51.8'deki tuzaklar (zaman sırası, otokorelasyon ve AR'de yüzdelik aralık, tek blok uzunluğu, eğilimli seri, ortadaki eksik değer, log ölçeği, p_bootstrap'ın anlamı, az küme, kümeleme düzeyi) bu şablon için de geçerlidir. Bu şablona özgü olanlar:
- Tek bir tohumla yetinmek. Aynı tohum aynı sonucu verir; kararlılık farklı tohumlarla (ya da B büyütülerek) sınanır.
- İki şablonun sayılarını basamak basamak karşılaştırmak. Bootstrap'a bağlı sütunlar yalnız Monte Carlo hatası içinde aynıdır (B=999'da standart hatada yaklaşık %3, yüzdelik sınırlarda daha çok). Birebir aynı olması gerekenler kestirim, ideal standart hata ve kapalı formüllü standart hatalardır.
- Aynı çalışmada iki şablonu karıştırmak. Bir tablodaki güven aralığı R, ötekindeki Python şablonundan alınırsa sınırlar tutarsız görünür. Tek şablon seçilir ve belirtilir.
- Seride sayıya çevrilemeyen değer bırakmak. Bu şablon
pd.to_numeric(…, errors="coerce")ile okur; çevrilemeyen değer eksik sayılır (ortadaysa çalıştırma durur). R şablonu aynı durumda hangi sütunda kaç değerin sayı olmadığını söyleyen bir iletiyle durur (Bölüm 51.2). - Çok büyük B ve uzun seri. Yeniden örnekleme Python döngüsüdür ve AR istatistiğinde her kopyada bir doğrusal sistem çözülür; süre B ile doğrusal artar. Çift bootstrap'ta her kopyada n\times k boyutlu ağırlıklı çarpım kurulur.
- Küme kipinde çok az gözlem. R şablonundaki n<q+5 denetimi burada yoktur; açıklayıcı sayısına yakın gözlemle çalıştırma, rank denetimini geçerse sürer.
52.9 Uzman soruları
S1. Aynı tohum verilse R ve Python aynı kopyaları üretir mi?
Hayır. R'nin varsayılan üreteci Mersenne-Twister'dır ve tamsayı çekilişinde reddetmeli örnekleme kullanır; NumPy'nin default_rng üreteci PCG64'tür ve sınırlı tamsayıları Lemire yöntemiyle üretir. Aynı tohum iki üreteçte ilgisiz diziler başlatır. Üstelik çekiliş sırası da farklıdır: tsboot bütün başlangıçları tek matriste çeker, bu şablon kopya kopya ilerler. Birebir aynı kopyalar ancak bir üreteç ötekinin diliyle yeniden kurulursa elde edilir; Bölüm 51.6'daki bağımsız hesap bunu R'nin üreteci için yapar.
S2. Tohum sabitken sonucun Monte Carlo hatası nasıl bilinir?
Üç yol vardır. (1) Ortalama ve dairesel blokta ideal standart hata tablodadır; Monte Carlo değeriyle farkı doğrudan okunur (0,079193 ve 0,079344). (2) Standart hatanın Monte Carlo standart hatası yaklaşık \operatorname{SH}/\sqrt{2B}'dir: B=999'da 0,0018. (3) B değiştirilir: 999, 4000 ve 20000 kopyada standart hata 0,0792; 0,0803; 0,0795 çıkar. Yüzdelik sınırlar için kapalı bir hata formülü yoktur; onlar için B büyütülür.
S3. Çift bootstrap'ta satırları yinelemek yerine ağırlık kullanmak sonucu değiştirir mi?
Değiştirmez. Bir küme w kez çekildiyse satırlarının normal denklemlere katkısı w ile çarpılır; bu, satırların w kez alt alta yazılmasıyla aynı toplamları verir. Fark yalnız sayısaldır (yuvarlama, 10^{-15} düzeyi) ve hesap yüküdür: 5000 satırlı veride kopya başına 5000 satırlık yeni matris kurmak yerine ağırlık vektörü kurulur. Bağımsız hesap aynı sonucu küme toplamlarından, satırlara hiç dönmeden bulur (doğrulama tablosu, fark <10^{-12}).
S4. Yule-Walker katsayıları ar.yw ile aynı mı?
Evet. İki şablon da n bölenli örneklem otokovaryanslarını ve ortalaması çıkarılmış seriyi kullanır; R Levinson-Durbin özyinelemesiyle, bu şablon doğrudan doğrusal çözümle ilerler. Örnek seride ikisi \phi_1=1{,}3504376101, \phi_2=-0{,}7200308905 verir. En çok olabilirlik ya da en küçük kareler AR kestirimi ayrı tanımlardır ve farklı katsayılar verir.
S5. Kopyalar eldeyken küme kipinde neden yüzdelik aralık yok?
R şablonunda vcovBS kopyaları döndürmez; bu şablon iki sürümün tablolarını aynı tutmak için aynı sütunları yazar. Kopyalar bb dizisindedir (satır 253–261); kod sekmesinde tabloya np.quantile(bb, [0.025, 0.975], axis=0) eklenerek yüzdelik aralık alınabilir. Bölüm 51'in bağımsız hesabında R'nin çekilişleriyle x için yüzdelik aralık [0,9319; 1,1242], normal aralık [0,9380; 1,1316] bulunmuştur: bu veride iki tanım yakındır.
S6. Durağan bootstrap'ın iki uygulaması aynı mı?
Dağılım olarak evet: iki şablonda da blok uzunluğu ortalaması l olan geometrik dağılımdan gelir (1'den başlar), başlangıçlar n nokta üzerinde tekdüzedir, bloklar sarar ve son blok n'yi tamamlayacak biçimde kesilir. Çekiliş sırası farklıdır (52.4.1) ama bu yalnız hangi rastgele sayının hangi bloğa gittiğini değiştirir. Örnek seride standart hata 0,066510 (R) ve 0,066411'dir; fark Monte Carlo standart hatasının 0,05 katıdır.
S7. Hangi sürümün sonucu "doğru"?
İkisi de aynı bootstrap dağılımından çekilmiş sonlu örneklemlerdir; hiçbiri ötekinden daha doğru değildir. Doğruluğu belirleyen B'dir. İdeal değerin bilindiği durumda (ortalama, dairesel blok) iki şablon da ona yakınsar: B=20000'de 0,079487 ve 0,079501, ideal 0,079344. Yöntemsel doğruluk (blok uzunluğunun uygunluğu, durağanlık, ek yeri etkisi) ise iki sürümde ortaktır ve B ile düzelmez.
52.10 Kaynaklar
- Cameron, A. C., Gelbach, J. B., & Miller, D. L. (2008). Bootstrap-based improvements for inference with clustered errors. Review of Economics and Statistics, 90(3), 414–427. https://doi.org/10.1162/rest.90.3.414
- Davison, A. C., & Hinkley, D. V. (1997). Bootstrap methods and their application. Cambridge University Press. https://doi.org/10.1017/CBO9780511802843
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., Wieser, E., Taylor, J., Berg, S., Smith, N. J., Kern, R., Picus, M., Hoyer, S., van Kerkwijk, M. H., Brett, M., Haldane, A., del Río, J. F., Wiebe, M., Peterson, P., … Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Künsch, H. R. (1989). The jackknife and the bootstrap for general stationary observations. The Annals of Statistics, 17(3), 1217–1241. https://doi.org/10.1214/aos/1176347265
- McKinney, W. (2010). Data structures for statistical computing in Python. Proceedings of the 9th Python in Science Conference, 56–61. https://doi.org/10.25080/Majora-92bf1922-00a
- Petersen, M. A. (2009). Estimating standard errors in finance panel data sets: Comparing approaches. Review of Financial Studies, 22(1), 435–480. https://doi.org/10.1093/rfs/hhn053
- Politis, D. N., & Romano, J. P. (1992). A circular block-resampling procedure for stationary data. In R. LePage & L. Billard (Eds.), Exploring the limits of bootstrap (pp. 263–270). Wiley.
- Politis, D. N., & Romano, J. P. (1994). The stationary bootstrap. Journal of the American Statistical Association, 89(428), 1303–1313. https://doi.org/10.1080/01621459.1994.10476870
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S. J., Brett, M., Wilson, J., Millman, K. J., Mayorov, N., Nelson, A. R. J., Jones, E., Kern, R., Larson, E., … SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2
- Webb, M. D. (2023). Reworking wild bootstrap-based inference for clustered errors. Canadian Journal of Economics, 56(3), 839–858. https://doi.org/10.1111/caje.12661