12. Off-type ile yeknesaklık değerlendirmesi (sabit popülasyon standardı, DUS)
Şablon kimliği: offtype · Kategori: deney tasarımı · Dil: R · Dosya: pro/sablonlar/deney_tasarimi/offtype.R (satır 1–360; üstbilgi 1–186) · Örnek veri: _ornek/offtype.csv · Paketler: yalnız temel R (stats, graphics)
12.1 Ne işe yarar
Kendine döllenen ve vejetatif çoğaltılan türlerde bir çeşidin bitkileri neredeyse birbirinin aynısıdır. Yeknesaklık bu türlerde ölçülerek değil sayılarak sınanır: örnekteki bitkilerden kaçı çeşidin tanımına uymuyor? Tanıma uymayan bitkiye tip dışı bitki (off-type) denir; şablonun ekran metinleri İngilizce terimi kullanır. Cevaplanan soru şudur: "n bitkilik örnekte en çok kaç tip dışı bitkiye izin verilir ve bu kuralla yanlış karar verme olasılıkları nedir?" Yöntem UPOV TGP/8/5 Bölüm II §8'deki sabit popülasyon standardı yaklaşımıdır.
Örnekteki tip dışı bitki sayısı X, çeşitteki gerçek tip dışı oranı p iken binom dağılır:
- n: incelenen bitki sayısı (örnek büyüklüğü).
- p: çeşitteki gerçek tip dışı bitki oranı; bilinmez.
- P (popülasyon standardı): türün test kılavuzunda kabul edilebilir sayılan en yüksek oran (ör. %1). Gerçek oranı P'yi aşmayan çeşit yeknesaktır.
Karar kuralı bir sınır sayıdır: gözlenen tip dışı bitki sayısı k'yı aşarsa çeşit yeknesak değildir. k, yeknesak bir çeşidin (p=P) en az kabul olasılığı kadar (ör. %95) olasılıkla kabul edilmesini sağlayan en küçük sayıdır.
Şablon bir karar şeması hesaplayıcısıdır: n, P ve kabul olasılığından k'yı, I. ve II. tip hata olasılıklarını, işletim karakteristiği (OC) eğrisini ve k'nın n ile nasıl değiştiğini verir; gözlenen sayı girilirse kararı da yazar. İki yıllık sınama için iki yol sunar: yılların toplamıyla birleşik test ya da iki aşamalı ardışık test.
Ne zaman kullanılır? Yeknesaklık tip dışı bitki sayısıyla değerlendiriliyorsa; bir tür için örnek büyüklüğü ve sınır sayı seçilecek ya da var olan bir şemanın hata olasılıkları görülecekse; birçok çeşidin sayımı aynı kuralla topluca değerlendirilecekse (satır başına değerlendirme).
Ne zaman kullanılmaz?
- Özellik ölçülüyor ve bitkiler arası standart sapma karşılaştırılıyorsa (çapraz döllenen türler):
coyu(Bölüm 5). - Sorulan soru farklılıksa:
coyd(Bölüm 4). - Amaç bir oranın güven aralığı ya da iki oranın karşılaştırmasıysa (tescil kuralı olmadan): temel programdaki Binom Testi ve Ki-Kare Bağımsızlık Testi.
- Üretim sürecinde kusurlu oranı zaman içinde izlenecekse:
nitelik_kartlari(nitelik kontrol kartları). - Karar ikiden çok aşamada verilecekse: şablon en çok iki aşamayı kapsar.
Temel programla ilişki. Temel programın binom testi tek bir gözlem için p değeri verir. Bu şablon bir kuralın özelliklerini hesaplar: sınır sayı, kuralın iki hata olasılığı ve bunların n ile gerçek orana göre değişimi. Veri gerektirmez; yalnız satır başına değerlendirme için Veri sekmesinde bir tablo açılır.
12.2 Şablonun girdileri
Form, üstbilgideki yirmi dört [[param]] bloğundan kurulur (offtype.R:10–185). Şablonun ana girdileri sayı kutularıdır; sütun alanlarının hepsi isteğe bağlıdır.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Test türü · kip |
seçim · Model | tek |
tek, iki_asamali |
Tek (ya da birleşik) test ile iki aşamalı ardışık test arasında seçim (209, 235, 256). |
Örnek büyüklüğü n · n |
tamsayı · Model | 100 | 1–100000 | Tek testte toplam, iki aşamalıda yıl başına bitki sayısı (210). |
Gözlenen off-type sayısı · gozlenen |
tamsayı · Model | 0 | 0–100000 | Tek testte gözlenen sayı; iki aşamalıda 1. yılın sayısı K_1 (211). |
Popülasyon standardı P (%) · populasyon_standardi |
ondalık · Model | 1,0 | 0,001–50 | Yüzde olarak; kodda 100'e bölünür (212). |
Kabul olasılığı (%, en az) · kabul_olasiligi |
ondalık · Model | 95,0 | 50–99,999 | Yüzde olarak (213); k'nın hesabına girer (196). |
İzin verilen en fazla off-type · k_kaynagi |
seçim · Model | hesapla |
hesapla, elle |
k kabul olasılığından hesaplanır ya da elle girilir (236). |
k (elle) · k_elle |
tamsayı · Model | 3 | 0–100000 | Yalnız elle seçiliyse (236). |
II. tip hata için gerçek oran (%) · gercek_oran |
ondalık · Model | 0,0 | 0–100 | 0 ise yalnız katlar; pozitifse o oran da eklenir (221, 226–231). |
II. tip hata için P katları · katlar |
metin · Model | 2, 5, 10 |
1'den büyük sayılar | \beta'nın hesaplandığı oranlar q\cdot P (218–225). |
İki aşamalı: a1 · ilk_yil_kabul |
tamsayı · Seçenekler | 0 | 0–100000 | 1. yılda K_1<a_1 ise kabul; 0 ise 1. yılda kabul yok (257). |
İki aşamalı: r1 · ilk_yil_ret |
tamsayı · Seçenekler | 2 | 0–100000 | 1. yılda K_1>r_1 ise ret (257). |
İki aşamalı: r · iki_yil_siniri |
tamsayı · Seçenekler | 3 | 0–200000 | İki yıl toplamı K_1+K_2>r ise ret (257). |
İki aşamalı: 2. yıl gözlenen K2 · ikinci_yil_gozlenen |
tamsayı · Seçenekler | −1 | −1–100000 | −1: 2. yıl henüz yok (258, 265–267). |
Satır etiketi · etiket_sutunu |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Satır başına tablonun ilk sütunu; boşsa satır numarası (299). |
Örnek büyüklüğü n (satır başına) · n_sutunu |
sayısal sütun · Değişkenler | boş | sayısal sütun | Seçilirse satır başına değerlendirme çalışır (289). |
Gözlenen off-type sayısı · offtype_sutunu |
sayısal sütun · Değişkenler | boş | sayısal sütun | Varsa satır başına karar sütunu eklenir (298, 314–317). |
Popülasyon standardı % · p_sutunu |
sayısal sütun · Değişkenler | boş | sayısal sütun | Satıra özgü P; boş hücre formdaki değeri alır (294–295). |
Kabul olasılığı % · kabul_sutunu |
sayısal sütun · Değişkenler | boş | sayısal sütun | Satıra özgü kabul olasılığı; boş hücre formdaki değeri alır (296). |
Sabit k · k_sutunu |
sayısal sütun · Değişkenler | boş | sayısal sütun | Doluysa o satırda k hesaplanmaz, bu değer kullanılır (297, 306). |
OC eğrisi: en küçük oran (%) · oc_alt |
ondalık · Çıktı | 0,0 | 0–99 | Eğrinin yatay ekseninin başı (331). |
OC eğrisi: en büyük oran (%) · oc_ust |
ondalık · Çıktı | 10,0 | 0,01–100 | Eksenin sonu (331). |
OC eğrisi: nokta sayısı · oc_nokta |
tamsayı · Çıktı | 201 | 11–5001 | Eğrinin çözünürlüğü (333). |
k ↔ n tablosu ve testere grafiği: en büyük n · tablo_n_ust |
tamsayı · Çıktı | 200 | 1–20000 | Tablo ve grafik n=1,\dots bu değere kadar (322–328, 347–358). |
α ve β'nın n'ye göre grafiği · testere_grafigi |
onay · Çıktı | açık | açık / kapalı | İkinci grafik (347). |
Örnek ayar (ornek_param, satır 9): kip = tek, n = 100, gozlenen = 0, populasyon_standardi = 1,0, kabul_olasiligi = 95,0, k_kaynagi = hesapla, katlar = "2, 5, 10", gercek_oran = 0; ayrıca satır başına değerlendirme için etiket_sutunu = sema, n_sutunu = n, p_sutunu = P_yuzde, kabul_sutunu = kabul_yuzde. Varsayılandan fark yalnız bu dört sütun seçimidir.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Sayı alanı sayıya çevrilemiyor | "'…' sayısal olmalı." | 191–194 |
| n<1 | "n en az 1 olmalı." | 210 |
| P ya da kabul olasılığı 0–100 aralığının dışında | "… 0 ile 100 arasında olmalı." | 214–215 |
| Gözlenen sayı negatif ya da n'den büyük | "negatif olamaz", "n'yi aşamaz" | 216–217 |
| Katlardan biri 1'den büyük değil | "1'den büyük sayılar olmalı (ör. 2, 5, 10)" | 220 |
| Gerçek oran %100 ya da üstü | "%100'den küçük olmalı" | 229 |
| Elle k negatif | "k negatif olamaz." | 237 |
| İki aşamalı: a_1, r_1 ya da r negatif | "negatif olamaz" | 259 |
| İki aşamalı: a_1>r_1+1 | "kabul ve ret bölgeleri çakışır" | 260 |
| İki aşamalı: K_2>n | "n'yi aşamaz" | 263 |
| Satır başına: veri açık değil ya da sütun yok | "bir tablo açın", "Sütun yok: …" | 290–291 |
| Satır başına: değerlendirilebilir satır yok | "Değerlendirilebilir satır yok …" | 302 |
| OC aralığı geçersiz | "0 ≤ alt < üst ≤ 100" | 332 |
Durdurmayan uyarılar çalıştırmanın sonunda tek satırda, "Uyarılar:" başlığıyla ve dikey çizgiyle ayrılarak yazılır (satır 359): q\cdot P\ge\%100 olan katın atlandığı (225); girilen gerçek oranın P'den büyük olmadığı (227); elle girilen k ile kabul olasılığının sağlanmadığı (239); iki aşamalıda r<r_1 ya da a_1=r_1+1 (261–262); iki aşamalı testin \alpha'sının 100- kabul olasılığını aştığı (276); satır başına değerlendirmede geçersiz satırların atlandığı (304).
12.3 Örnek veri
Dosya: _ornek/offtype.csv. TGP/8/5 Bölüm II §8'deki çözümlü şemaların dökümüdür: ana metindeki şema (n=100, P=\%1) ve Örnek 1–4'ün 16 şeması; toplam 17 satır. Her satır bir şemadır, bir çeşidin sayımı değil; dosyada gözlenen tip dışı bitki sütunu yoktur.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
sema |
Satır etiketi | metin | bolum_8_1_2, ornek1_a, …, ornek4_c. |
kaynak_bolum |
kullanılmaz | kategorik | Kaynak belgedeki paragraf numarası. |
P_yuzde |
Popülasyon standardı | sayısal | %1, %2 ya da %3. |
n |
Örnek büyüklüğü | sayısal | 5–120. |
kabul_yuzde |
Kabul olasılığı | sayısal | %90, %95, %99; bir satırda (ornek2_e) boş. |
k_kaynak, alfa_kaynak, b2P_kaynak, b5P_kaynak, b10P_kaynak |
kullanılmaz | sayısal | Kaynak belgenin verdiği k, \alpha ve \beta değerleri (yüzde, yuvarlanmış); şablonun sonuçlarıyla yan yana koymak içindir. |
Kategorik bir faktör ya da düzey sırasına bağlı seçenek yoktur.
Örnek ayarda iki hesap birlikte yapılır: formdaki sayılarla tek şema (n=100, P=\%1, kabul %95, gözlenen 0) ve veri tablosunun 17 satırı için satır başına değerlendirme. İkisi birbirinden bağımsızdır.
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) iki aşamalı, n=60, a_1=0, r_1=2, r=3, K_1=1 (kaynaktaki e şeması); (3) iki aşamalı, n=60, a_1=0, r_1=3, r=4, K_1=3, K_2=2, kabul %99 (g şeması); (4) iki aşamalı, n=58, a_1=1, r_1=2, r=2, K_1=2, K_2=0, kabul %90 (h şeması); (5) tek test, k_kaynagi = elle, k_elle = 1, gözlenen 2, gercek_oran = 3. (2)–(5)'te satır başına değerlendirme kapalıdır (n_sutunu boş).
12.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) girdiler oranlara çevrilir ve denetlenir; (2) tek testte k, \alpha ve \beta; iki aşamalı testte \alpha, \beta, ikinci yıla geçme olasılığı ve beklenen örnek büyüklüğü hesaplanır, karar yazılır; (3) istenirse veri tablosunun her satırı ayrı değerlendirilir; (4) k\leftrightarrow n tablosu; (5) OC eğrisi ve testere grafiği.
12.4.1 İzin verilen en fazla tip dışı bitki sayısı
- \gamma: kabul olasılığı (oran olarak; %95 için 0,95).
- Toplam, gerçek oran tam P iken en çok c tip dışı bitki görme olasılığıdır.
- k: bu olasılığı \gamma'ya ulaştıran ilk sayı. Daha küçük bir sınır yeknesak çeşitleri gereğinden sık reddeder; daha büyüğü gereksiz yere gevşektir.
Koddaki tercih
k, binom dağılımının çeyreklik işleviyle bulunur: stats::qbinom(kabul - TOL, n, p) (satır 196). qbinom(q, n, p), P(X\le c)\ge q olan en küçük c'yi verir; tanım formülün aynısıdır. TOL = 1e-10 (satır 189) kayan nokta payıdır: birikimli olasılık kabul olasılığına tam eşitse (örneğin n=1, P=\%5, \gamma=0{,}95: P(X\le0)=0{,}95) eşitlik "sağlandı" sayılmalıdır; ikili gösterimde 0,95 tam temsil edilemediğinden pay olmadan sonuç bir büyük çıkabilirdi. Normal ya da Poisson yaklaşımı kullanılmaz; hesap tamdır.
12.4.2 I. ve II. tip hata
- \alpha (I. tip hata): oranı tam standartta olan yeknesak bir çeşidin reddedilme olasılığı. Tanım gereği \alpha\le1-\gamma.
- \beta(P_q) (II. tip hata): gerçek oranı P_q>P olan, yani yeknesak olmayan bir çeşidin kabul edilme olasılığı.
- P_q=q\cdot P: şablon varsayılan olarak q=2,\ 5,\ 10 için hesaplar (TGP/8/5'in tablolarındaki katlar); kullanıcı ayrıca bir gerçek oran girebilir.
- Kodda
alfa_fvebeta_f(satır 197–198):pbinombirikimli olasılığı.
Neden α çoğu zaman 1 − γ'dan çok küçük?
X tam sayıdır; birikimli olasılık basamak basamak artar ve \gamma'ya tam denk gelmez. k, \gamma'yı aşan ilk basamaktır; aşma payı kadar \alpha küçülür. Örnek ayarda P(X\le2)=0{,}9206<0{,}95, P(X\le3)=0{,}9816: k=3 ve \alpha=\%1{,}84'tür, %5 değil. Bu basamaklı yapı, hata olasılıklarının n ile testere dişi gibi değişmesinin nedenidir (12.4.5).
β yalnız seçilen oranlarda verilir
II. tip hata tek bir sayı değildir; gerçek oranın işlevidir. Tablo üç noktasını (2P, 5P, 10P), OC eğrisi tamamını gösterir. Bir şemayı "\beta %26" diye özetlemek, hangi oranda olduğu söylenmeden anlamsızdır.
12.4.3 Birleşik test
İki yılın sayımları tek bir örnek gibi birleştirilebilir: toplam bitki sayısı n_1+n_2 ve toplam tip dışı bitki sayısı K_1+K_2 tek teste girilir. Şablonda bunun ayrı bir kipi yoktur; "Tek test" seçilir ve toplamlar yazılır (satır 16'daki açıklama). Varsayım, gerçek oranın iki yılda aynı olduğu ve bitkilerin bağımsız örneklendiğidir.
12.4.4 İki aşamalı ardışık test
İki aşamalı (çift örneklemeli) kabul planı düşüncesi Dodge ve Romig'e (1929) dayanır. Her yıl n bitki incelenir. Birinci yılın sonucu açıkça iyi ya da açıkça kötüyse karar o yıl verilir; aradaysa ikinci yıl beklenir:
| Durum | Karar |
|---|---|
| K_1>r_1 | 1. yılda ret |
| K_1<a_1 | 1. yılda kabul |
| a_1\le K_1\le r_1 | 2. yıl testi; K_1+K_2>r ise ret, değilse kabul |
Gerçek oran p iken kabul olasılığı, ikinci yıla geçme olasılığı ve beklenen örnek büyüklüğü:
- K_1, K_2: iki yılın tip dışı bitki sayıları; bağımsız, her biri binom(n,p).
- a_1: birinci yıl kabul sınırı (K_1<a_1 kabul); a_1=0 ise birinci yılda kabul yoktur.
- r_1: birinci yıl ret sınırı; r: iki yıl toplamının ret sınırı.
- \alpha=1-A(P); \beta(P_q)=A(P_q).
- D(p): ikinci yıla geçme olasılığı; n_e: ortalamada incelenen bitki sayısı.
Koddaki tercih
Hesap iki_asama() işlevindedir (satır 200–207). Sınırları kullanıcı verir; şablon a_1, r_1, r aramaz. Verilen şemanın \alpha'sı 100- kabul olasılığını aşarsa uyarı yazar (276), r<r_1 ise ikinci yıla geçen bazı çeşitlerin sonuca bakılmadan reddedileceğini, a_1=r_1+1 ise ikinci yıla hiç geçilmeyeceğini bildirir (261–262). a_1>r_1+1 kabul ve ret bölgelerinin çakışması demektir; çalıştırma durur (260).
İki aşamalı test ne kazandırır?
Aynı toplam bitki sayısıyla benzer hata olasılıkları elde edilir, ama açıkça yeknesak olmayan çeşitler ikinci yılı beklemeden reddedilir. 2\times60 bitkiyle, P=\%1'de: birleşik test (n=120, k=3) \alpha=\%3{,}30 ve \beta(5P)=\%14{,}44 verir; iki aşamalı e şeması (a_1=0, r_1=2, r=3) \alpha=\%4{,}35 ve \beta(5P)=\%13{,}38 verir. Gerçek oran %5 olan bir çeşit için beklenen örnek büyüklüğü 120 yerine 85'tir; oran %10 ise 63.
12.4.5 OC eğrisi, k ↔ n tablosu ve testere grafiği
OC eğrisi kabul olasılığını gerçek oranın işlevi olarak çizer: tek testte P(X\le k\mid p), iki aşamalıda A(p). Eğrinin p=P'deki yüksekliği 1-\alpha, P_q'deki yüksekliği \beta(P_q)'dur. İyi bir şemada eğri P'nin hemen sağında hızla düşer.
k\leftrightarrow n tablosu, n=1,\dots, tablo_n_ust için k'yı hesaplar ve aynı k'yı veren ardışık n değerlerini tek satırda toplar (satır 324–326). TGP/8/5'in sınır tablolarıyla aynı biçimdedir.
Testere grafiği \alpha ve \beta'yı n'ye karşı çizer. k sabitken n arttıkça \alpha büyür, \beta küçülür; n bir eşiği geçince k bir artar, \alpha birden düşer ve \beta birden yükselir.
Tablo ve testere grafiği her kipte tek test kuralını gösterir
k\leftrightarrow n tablosu ve testere grafiği, formdaki P ve kabul olasılığıyla tek test için hesaplanır (satır 322–328, 347–358); iki aşamalı kip seçildiğinde de böyledir; başlıklar bunu "tek test" diye belirtir. İki aşamalı şemanın kendi özellikleri özet tablosunda, \beta tablosunda ve OC eğrisindedir.
12.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–186 | Üstbilgi: açıklama, örnek ayar, 24 parametre. | Açıklama (satır 7) kaynak tablolarla karşılaştırmanın sonucunu da verir. |
| 187–207 | Yardımcılar: .m, fmt, TOL, sayi, k_bul, alfa_f, beta_f, iki_asama. |
Bütün olasılıklar qbinom, pbinom, dbinom ile; yaklaşım yok. |
| 209–232 | Girdilerin okunması ve denetimi; yüzdeler orana çevrilir; \beta için oran listesi oranlar kurulur. |
Katlar virgül, noktalı virgül ya da boşlukla ayrılır (218). |
| 235–255 | Tek test: k, gerçek kabul olasılığı, \alpha, karar; özet tablosu, karar metni, \beta tablosu; OC işlevi. | Karar: gözlenen >k ise ret (240). |
| 256–285 | İki aşamalı test: sınırların denetimi, iki_asama, karar; özet ve \beta tabloları; OC işlevi. |
K_2=-1 ve a_1\le K_1\le r_1 ise "karar yok: 2. yıl testi gerekli" (266). |
| 287–319 | Satır başına değerlendirme: sütunların okunması, geçerlilik süzgeci, k, \alpha, \beta sütunları, varsa karar. | Yalnız n_sutunu seçiliyse çalışır; her zaman tek test kuralıyla. |
| 321–328 | k\leftrightarrow n tablosu. | Ardışık n değerleri cumsum(diff(ks) != 0) ile gruplanır. |
| 330–345 | OC eğrisi; P ve kabul olasılığı kılavuz çizgileri; \beta noktaları. | Aralık Çıktı sekmesinden ayarlanır. |
| 347–360 | Testere grafiği; uyarılar. | Grafik tablo_n_ust \ge2 ve onay kutusu açıksa çizilir. |
İki aşamalı hesabın tamamı altı satırdır (201–206):
i <- if (r1 >= a1) a1:r1 else integer(0)
pi <- stats::dbinom(i, n, p)
devam <- sum(pi)
ret <- stats::pbinom(r1, n, p, lower.tail = FALSE) + sum(pi * stats::pbinom(r - i, n, p, lower.tail = FALSE))
kabul <- (if (a1 > 0) stats::pbinom(a1 - 1, n, p) else 0) + sum(pi * stats::pbinom(r - i, n, p))
c(ret = ret, kabul = kabul, devam = devam, ne = n + n * devam)
i, ikinci yıla geçilen K_1 değerleridir. ret ve kabul ayrı ayrı hesaplanır; toplamları 1'dir.
Satır başına değerlendirmenin geçerlilik süzgeci (satır 300–301) bir satırı şu koşullarda kabul eder: n pozitif tam sayı; P ve kabul olasılığı 0–100 arasında; varsa sabit k negatif olmayan tam sayı; varsa gözlenen sayı 0 ile n arasında. Öteki satırlar atlanır ve sayıları uyarıda yazılır.
12.6 Elle hesap: örnek veride bağımsız yeniden hesap
Değerler dogrulama/offtype/elle_hesap.py ile, kesirli (tam) aritmetikle hesaplanmıştır: binom olasılıkları math.comb ve fractions üzerinden toplanır, hiçbir dağılım işlevi çağrılmaz. R tarafında (r_dogrulama.R) birikimli olasılık tamamlanmamış beta işlevinden (P(X\le k)=I_{1-p}(n-k,\,k+1), pbeta), iki aşamalı test choose ile açık toplamdan gelir.
Adım 1 — Sınır sayı. n=100, P=0{,}01:
| x | P(X=x) | P(X\le x) |
|---|---|---|
| 0 | 0{,}99^{100}=0{,}366032 | 0,366032 |
| 1 | 0,369730 | 0,735762 |
| 2 | 0,184865 | 0,920627 |
| 3 | 0,060999 | 0,981626 |
| 4 | 0,014942 | 0,996568 |
Birikimli olasılık 0,95'i ilk kez x=3'te geçer: k=3.
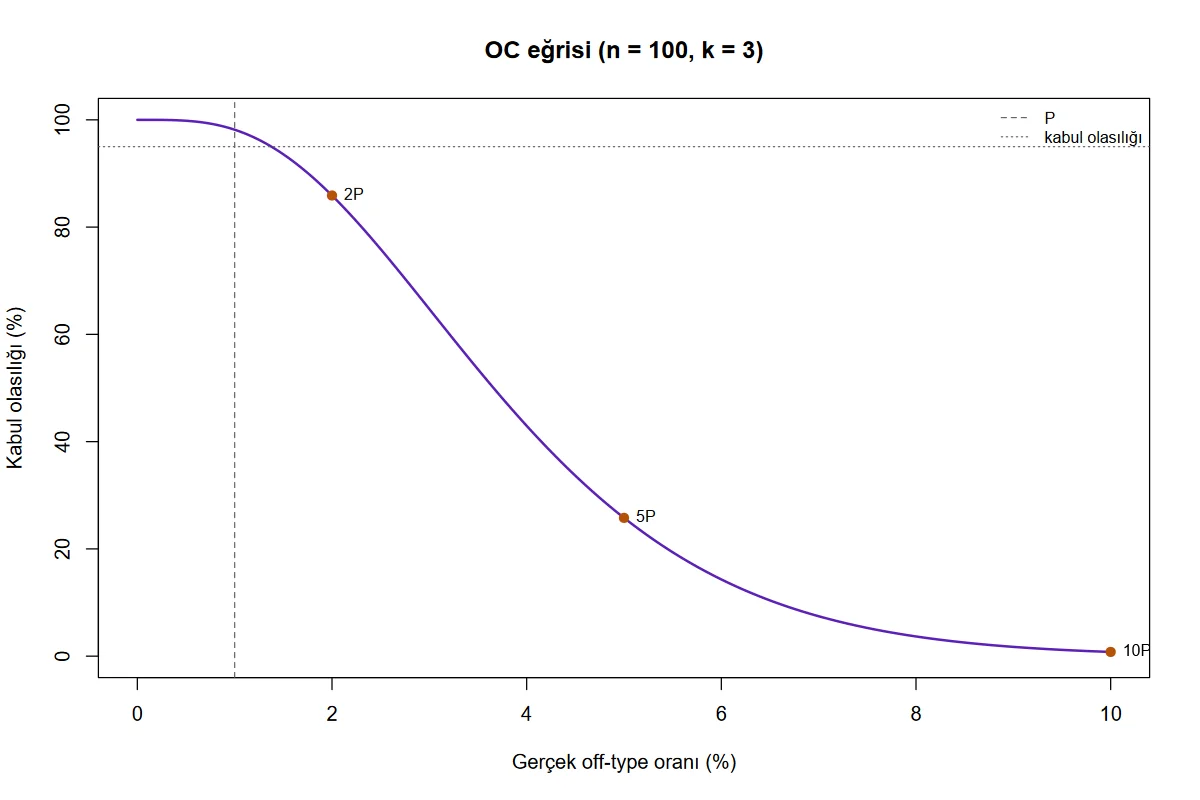
Adım 2 — Hata olasılıkları. \alpha=1-0{,}981626=0{,}018374 (%1,84). Gerçek oran 2P=\%2 iken P(X\le3)=0{,}858962; 5P=\%5 iken 0,257839; 10P=\%10 iken 0,007836. Oranı standardın iki katı olan bir çeşit bu şemayla %86 olasılıkla kabul edilir; on katı olan %0,8 olasılıkla.
Adım 3 — Karar. Gözlenen 0 \le3: kabul.
Adım 4 — k\leftrightarrow n. P=\%1, kabul %95 için sınırlar: n=1–5'te k=0; 6–35'te 1; 36–82'de 2; 83–137'de 3; 138–198'de 4; 199–200'de 5. Basamağın iki yanında \alpha: n=82, k=2 için %4,95; n=83, k=3 için %0,98.
Adım 5 — İki aşamalı e şeması. n=60, P=0{,}01, a_1=0, r_1=2, r=3:
| i | P(K_1=i) | P(K_2\le3-i) | Çarpım |
|---|---|---|---|
| 0 | 0,547157 | 0,996877 | 0,545448 |
| 1 | 0,331610 | 0,977580 | 0,324175 |
| 2 | 0,098813 | 0,878767 | 0,086834 |
| Toplam | 0,977580 | 0,956457 |
a_1=0 olduğundan birinci yılda kabul yoktur; A(P)=0{,}956457, \alpha=\%4{,}354. İkinci yıla geçme olasılığı %97,76; beklenen örnek büyüklüğü 60+60\cdot0{,}977580=118{,}65. \beta: 2P'de %75,43, 5P'de %13,38, 10P'de %0,14. K_1=1 gözlendiğinde 0\le1\le2 olduğundan karar ikinci yıla kalır.
Adım 6 — h şeması. n=58, a_1=1, r_1=2, r=2: K_1=0 ise birinci yılda kabul. \alpha=\%9{,}961; ikinci yıla geçme olasılığı P'de %42,12; beklenen örnek büyüklüğü 82,43; \beta(2P)=\%62{,}40. K_1=2, K_2=0: toplam 2 \le r, kabul.
Adım 7 — Elle girilen sınır. n=100, k=1: P(X\le1\mid P)=0{,}735762<0{,}95; şablon uyarı yazar. \alpha=\%26{,}42; gerçek oran %3 iken \beta=\%19{,}46. Gözlenen 2 >1: ret.
12.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1–5). Olasılıklar yüzde olarak verilir.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| n=100, P=\%1: k | 3 | 3 | 3 | 0 | ✓ |
| P(X\le 3\mid P) (%) | 98,16259636 | 98,16259636 | 98,16259636 | 2,9e−16 | ✓ |
| I. tip hata \alpha (%) | 1,83740364 | 1,83740364 | 1,83740364 | 5,4e−15 | ✓ |
| \beta (2P) (%) | 85,89615634 | 85,89615634 | 85,89615634 | 1,7e−16 | ✓ |
| \beta (5P) (%) | 25,78386591 | 25,78386591 | 25,78386591 | 3,9e−15 | ✓ |
| \beta (10P) (%) | 0,78364871 | 0,78364871 | 0,78364871 | 1,0e−15 | ✓ |
| k=0 için en büyük n | 5 | 5 | 5 | 0 | ✓ |
| k=1 için en büyük n | 35 | 35 | 35 | 0 | ✓ |
| k=2 için en büyük n | 82 | 82 | 82 | 0 | ✓ |
| k=3 için en büyük n | 137 | 137 | 137 | 0 | ✓ |
| k=4 için en büyük n | 198 | 198 | 198 | 0 | ✓ |
| ornek1_b: k | 1 | 1 | 1 | 0 | ✓ |
| ornek1_b: \alpha (%) | 9,86910015 | 9,86910015 | 9,86910015 | 2,0e−15 | ✓ |
| ornek1_b: \beta (5P) (%) | 24,99942247 | 24,99942247 | 24,99942247 | 2,4e−15 | ✓ |
| ornek2_b: k | 0 | 0 | 0 | 0 | ✓ |
| ornek2_b: \alpha (%) | 9,60792032 | 9,60792032 | 9,60792032 | 1,1e−15 | ✓ |
| ornek2_b: \beta (5P) (%) | 59,049 | 59,049 | 59,049 | 0 | ✓ |
| ornek3_a: k | 3 | 3 | 3 | 0 | ✓ |
| ornek3_a: \alpha (%) | 3,29849122 | 3,29849122 | 3,29849122 | 3,0e−15 | ✓ |
| ornek3_a: \beta (5P) (%) | 14,44076134 | 14,44076134 | 14,44076134 | 1,6e−15 | ✓ |
| ornek3_d: k | 4 | 4 | 4 | 0 | ✓ |
| ornek3_d: \alpha (%) | 0,73832945 | 0,73832945 | 0,73832945 | 6,0e−15 | ✓ |
| ornek3_d: \beta (5P) (%) | 27,81912711 | 27,81912711 | 27,81912711 | 2,4e−15 | ✓ |
| ornek4_a: k | 1 | 1 | 1 | 0 | ✓ |
| ornek4_a: \alpha (%) | 8,17857758 | 8,17857758 | 8,17857758 | 1,1e−15 | ✓ |
| ornek4_a: \beta (5P) (%) | 28,39012121 | 28,39012121 | 28,39012121 | 0 | ✓ |
| ornek4_c: k | 3 | 3 | 3 | 0 | ✓ |
| ornek4_c: \alpha (%) | 0,11032882 | 0,11032882 | 0,11032882 | 3,0e−15 | ✓ |
| ornek4_c: \beta (5P) (%) | 78,98907027 | 78,98907027 | 78,98907027 | 3,6e−16 | ✓ |
| İki aşamalı e: \alpha (%) | 4,3543304 | 4,3543304 | 4,3543304 | 9,2e−15 | ✓ |
| İki aşamalı e: 2. yıla geçme olasılığı (%) | 97,75798352 | 97,75798352 | 97,75798352 | 1,0e−15 | ✓ |
| İki aşamalı e: beklenen örnek büyüklüğü | 118,65479011 | 118,65479011 | 118,65479011 | 1,1e−15 | ✓ |
| İki aşamalı e: \beta (2P) (%) | 75,42520073 | 75,42520073 | 75,42520073 | 1,3e−15 | ✓ |
| İki aşamalı e: \beta (5P) (%) | 13,38186892 | 13,38186892 | 13,38186892 | 1,9e−15 | ✓ |
| İki aşamalı e: \beta (10P) (%) | 0,14233887 | 0,14233887 | 0,14233887 | 5,6e−17 | ✓ |
| İki aşamalı g: \alpha (%) | 0,89030631 | 0,89030631 | 0,89030631 | 4,0e−14 | ✓ |
| İki aşamalı g: 2. yıla geçme olasılığı (%) | 99,68766708 | 99,68766708 | 99,68766708 | 2,9e−16 | ✓ |
| İki aşamalı g: beklenen örnek büyüklüğü | 119,81260025 | 119,81260025 | 119,81260025 | 2,4e−15 | ✓ |
| İki aşamalı g: \beta (2P) (%) | 89,86776209 | 89,86776209 | 89,86776209 | 1,1e−15 | ✓ |
| İki aşamalı g: \beta (5P) (%) | 27,0249578 | 27,0249578 | 27,0249578 | 7,5e−15 | ✓ |
| İki aşamalı g: \beta (10P) (%) | 0,53780782 | 0,53780782 | 0,53780782 | 1,0e−15 | ✓ |
| İki aşamalı h: \alpha (%) | 9,96094277 | 9,96094277 | 9,96094277 | 2,0e−15 | ✓ |
| İki aşamalı h: 2. yıla geçme olasılığı (%) | 42,12200892 | 42,12200892 | 42,12200892 | 8,4e−16 | ✓ |
| İki aşamalı h: beklenen örnek büyüklüğü | 82,43076518 | 82,43076518 | 82,43076518 | 5,2e−16 | ✓ |
| İki aşamalı h: \beta (2P) (%) | 62,40175604 | 62,40175604 | 62,40175604 | 1,6e−15 | ✓ |
| İki aşamalı h: \beta (5P) (%) | 9,52152481 | 9,52152481 | 9,52152481 | 3,2e−15 | ✓ |
| İki aşamalı h: \beta (10P) (%) | 0,25551028 | 0,25551028 | 0,25551028 | 1,0e−15 | ✓ |
| Elle k=1: P(X\le 1\mid P) (%) | 73,57619789 | 73,57619789 | 73,57619789 | 3,9e−16 | ✓ |
| Elle k=1: \beta (gerçek oran %3) (%) | 19,46221201 | 19,46221201 | 19,46221201 | 1,8e−16 | ✓ |
Ölçütü karşılayan: 49/49. Python: kesirli (tam) aritmetikle binom toplamları (fractions, math.comb); sonuç yalnız yazdırılırken ondalığa çevrilir. R: birikimli olasılık tamamlanmamış beta işlevinden (pbeta), iki aşamalı test choose ile açık çift toplamdan; şablonun qbinom/pbinom/dbinom çağrıları kullanılmamıştır.
Python sütunu kesirli aritmetikle hesaplandığından yuvarlama hatası taşımaz; farklar R'nin dağılım işlevlerinin kayan nokta hatasıdır.
12.7 Çıktıyı okuma
Örnek ayarla konsol metni:
Karar: kabul: yeknesak (gözlenen ≤ k). Gözlenen 0, sınır k = 3 (n = 100, P = %1).
Dört tablo yazılır (kısaltılmış, ilk altı ondalık):
Off-type karar şeması (binom, tam)
                        örnek büyüklüğü n  100.000000
               popülasyon standardı P (%)    1.000000
               kabul olasılığı (%, en az)   95.000000
         izin verilen en fazla off-type k    3.000000
 P(X ≤ k | P): gerçek kabul olasılığı (%)   98.162596
                        I. tip hata α (%)    1.837404
                        gözlenen off-type    0.000000

II. tip hata β = P(X ≤ k | gerçek oran) (%)
 oran  gercek_oran       beta  ret_olasiligi
   2P            2  85.896156      14.103844
   5P            5  25.783866      74.216134
  10P           10   0.783649      99.216351

Satır başına off-type değerlendirmesi (tek ya da birleşik test; olasılıklar %)
      etiket    n  P  kabul_olasiligi  k    P_kabul      alfa    beta_2P    beta_5P   beta_10P
 bolum_8_1_2  100  1               95  3  98.162596  1.837404  85.896156  25.783866   0.783649
    ornek1_a   60  1               90  2  97.757984  2.242016  88.125797  41.743577   5.304508
    ornek1_b   53  1               90  1  90.130900  9.869100  71.348706  24.999422   2.588226
    ornek2_e    6  2               95  1  99.431288  0.568712  97.844724  88.573500  65.536000
    ornek3_a  120  1               90  3  96.701509  3.298491  78.000459  14.440761   0.157497
    ornek4_a   16  3               90  1  91.821422  8.178578  75.105442  28.390121   2.611159
    ...
k ↔ n tablosu, tek test (P = %1, kabul olasılığı %95)
 n_alt  n_ust  k
     1      5  0
     6     35  1
    36     82  2
    83    137  3
   138    198  4
   199    200  5
İki aşamalı çalıştırmada (e şeması) özet tablosu şu satırları taşır: yıl başına n, P, a_1, r_1, r, I. tip hata (%4,354330), 2. yıla geçme olasılığı (%97,757984), beklenen örnek büyüklüğü (118,654790), gözlenen K_1 ve K_2; \beta tablosuna her oran için ikinci yıla geçme olasılığı ve beklenen örnek büyüklüğü eklenir.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Karar satırı | Kabul ya da ret, gözlenen sayı ve sınır | Tek testte gözlenen \le k kabuldür. İki aşamalıda "karar yok" ikinci yılın beklendiğini söyler. |
| Karar şeması tablosu | n, P, kabul olasılığı, k, gerçek kabul olasılığı, \alpha, gözlenen | "Gerçek kabul olasılığı" istenenden büyüktür; fark k'nın tam sayı olmasındandır. |
| II. tip hata tablosu | Her oran için \beta ve 1-\beta | \beta yüksekse şema o orandaki çeşitleri ayırt edemez. |
| Satır başına tablo | Her satır için n, P, kabul olasılığı, k, gerçek kabul olasılığı, \alpha, her kat için \beta; varsa gözlenen ve karar | Birçok şemayı ya da çeşidi yan yana karşılaştırmak içindir. |
| k\leftrightarrow n tablosu | Aynı k'yı veren n aralıkları | Aralığın sonundaki n aynı k için en küçük \beta'yı verir; planlamada aralığın üst ucu seçilir. |
| "Uyarılar:" satırı | Biriken uyarılar | Elle k ya da iki aşamalı sınırlar kabul olasılığını sağlamıyorsa burada görülür. |
Şekil 12.1. Şablonun çizdiği OC eğrisi (örnek ayar: n=100, k=3). Dikey kesikli çizgi popülasyon standardı (%1), yatay noktalı çizgi istenen kabul olasılığıdır (%95). Noktalar 2P, 5P ve 10P'deki II. tip hatadır.
Şekil 12.2. Şablonun çizdiği testere grafiği (P=\%1, kabul %95). Kalın çizgi I. tip hata; ince çizgiler 2P, 5P ve 10P'deki II. tip hata. Her sıçrama k'nın bir arttığı n değeridir (6, 36, 83, 138, 199).
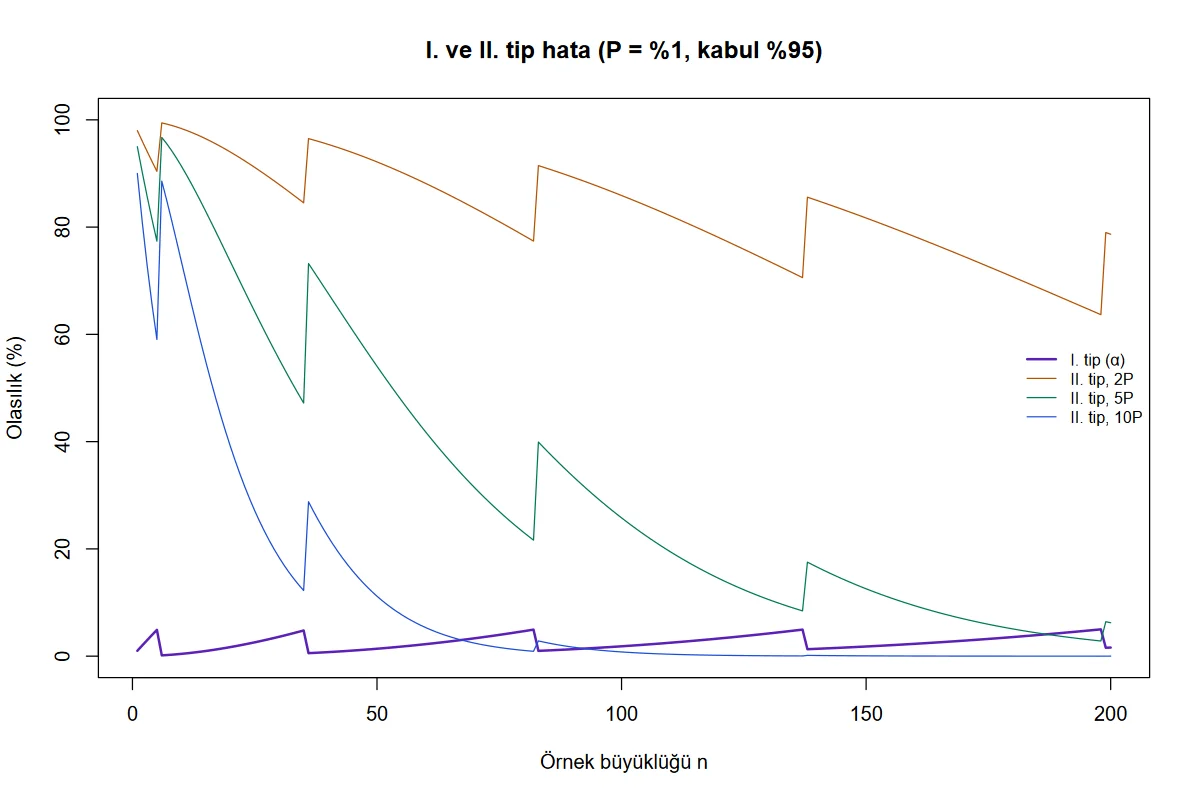
Şekil 12.2 planlama için okunur: \alpha hiçbir n'de %5'i aşmaz; \beta(2P) ise 200 bitkiye kadar %63'ün altına inmez. Standardın iki katı orandaki bir çeşidi güvenilir biçimde yakalamak yüzlerce bitki ister; n=500'de \beta(2P)=\%45{,}7, n=1000'de %15,4'tür.
Rapor cümlesi (örnek ayar):
Yeknesaklık, tip dışı bitki sayısıyla ve sabit popülasyon standardı yaklaşımıyla değerlendirildi (popülasyon standardı %1, kabul olasılığı en az %95). 100 bitkilik örnekte izin verilen en fazla tip dışı bitki sayısı 3'tür (binom, tam hesap; I. tip hata %1,8; gerçek oran %2, %5 ve %10 iken II. tip hata sırasıyla %85,9, %25,8 ve %0,8). Örnekte tip dışı bitki gözlenmedi; çeşit yeknesak kabul edildi.
12.8 Sık hatalar ve tuzaklar
- Yüzdeyi oran olarak girmek. P ve kabul olasılığı yüzde olarak yazılır: %1 için
1, %95 için95.0,01yazılırsa standart %0,01 olur ve k sıfıra iner. - İki aşamalıda toplam n'yi girmek. İki aşamalı kipte n yıl başına bitki sayısıdır; birleşik testte ise iki yılın toplamı.
- Birleşik testte yılların sınırlarını toplamak. Birleşik testin sınırı toplam n için baştan hesaplanır: 2\times60 bitkide k=3'tür, 60 bitkinin sınırının (2) iki katı değil.
- a_1'in anlamını karıştırmak. Kabul koşulu K_1<a_1'dir (küçük, eşit değil). a_1=1 "sıfır tip dışı bitkide kabul" demektir; a_1=0 birinci yılda hiç kabul olmayacağını söyler.
- Formdaki özetle satır başına tabloyu aynı şey sanmak. Üstteki karar ve tablolar yalnız formdaki sayılar içindir; satır başına tablo veri tablosundan gelir. Örnek ayarda ikisi birlikte çalışır.
- Satır başına tabloda boş hücreleri gözden kaçırmak. P ya da kabul olasılığı boş olan satır formdaki genel değeri alır. Örnek veride
ornek2_esatırının kabul olasılığı boştur; formdaki %95 ile k=1 bulunur. Kaynak belge bu şemada k=0 kullanır; aynı sonuç içink_sutunuseçilip sabit k verilir. - İki aşamalı kipte k\leftrightarrow n tablosunu iki aşamalı şemanın tablosu sanmak. Tablo ve testere grafiği her kipte tek test kuralını gösterir (12.4.5).
- Elle k girip uyarıyı okumamak. Elle girilen sınır kabul olasılığını sağlamayabilir; "Uyarılar:" satırı gerçek kabul olasılığını yazar.
- \beta'yı tek sayı sanmak. \beta gerçek orana bağlıdır; raporda hangi oranda verildiği yazılır.
- Küçük örneklerde şemaya güvenmek. n=6, P=\%2 için k=1 ve \beta(10P)=\%65{,}5'tir: gerçek oranı %20 olan bir çeşit üç denemenin ikisinde kabul edilir. Küçük n'de test yalnız çok bozuk çeşitleri ayırır.
- Gerçek oran alanına P'den küçük bir değer yazmak. Hesap yapılır ve uyarı yazılır; sonuç II. tip hata değil, o orandaki kabul olasılığıdır.
- Katları Türkçe ondalık virgülle yazmak. Katlar virgülle ayrılır;
2,5iki ayrı kat (2 ve 5) olarak okunur. Ondalıklı kat nokta ile yazılır (2.5). - Tip dışı bitki tanımını şablondan beklemek. Hangi bitkinin tip dışı sayılacağı türün test kılavuzuna ve uzmanın gözlemine bağlıdır; şablon yalnız sayılarla çalışır.
12.9 Uzman soruları
S1. Neden binom dağılımı; sonlu popülasyon için hipergeometrik gerekmez mi?
Örnek, çeşidin çok büyük bir bitki topluluğundan (tohum partisinden) çekilir; örnek büyüklüğü topluluğa göre çok küçüktür ve geri koymadan örnekleme ile geri koyarak örnekleme arasındaki fark ihmal edilir. TGP/8/5 binom modelini kullanır; şablon belgeyi izler ve sonlu popülasyon düzeltmesi yapmaz. Bitkilerin tip dışı olma durumlarının bağımsız olduğu da varsayılır; tip dışı bitkiler parselde kümeleniyorsa (ör. bulaşık bir tohum sırası) gerçek değişkenlik binomdan büyüktür ve hata olasılıkları hesaplanandan yüksektir.
S2. k neden P(X ≤ k) ≥ γ koşulunu sağlayan en küçük sayı; en büyük k ile P(X ≤ k) ≤ γ olamaz mıydı?
İki tanım farklı yanı korur. Şablonun (ve TGP/8/5 tablolarının) tanımı başvuru sahibini korur: yeknesak bir çeşidin kabul olasılığı en az \gamma'dır, \alpha\le1-\gamma. Öteki tanımda \alpha\ge1-\gamma olurdu ve yeknesak çeşitler istenenden sık reddedilirdi. Tam sayı olma nedeniyle ikisi arasında bir basamak fark vardır; örnekte k=2 alınsaydı \alpha=\%7{,}9, \beta(2P)=\%67{,}7 olurdu.
S3. 1e-10'luk pay sonucu değiştirebilir mi?
Yalnız birikimli olasılığın kabul olasılığına 10^{-10}'dan yakın olduğu durumda; bu, uygulamada tam eşitlik demektir. Pay olmadan böyle bir durumda sonuç, 0,95'in ikili gösterimdeki yuvarlamasına göre k ya da k+1 çıkardı. Doğrulamada Python sütunu k'yı kesirli aritmetikle, pay kullanmadan bulur; örnek verinin 17 şemasında ve n=1,\dots,200 tablosunda şablonla aynıdır.
S4. β(2P) neden bu kadar yüksek; şema işe yaramıyor mu?
%1 ile %2'yi ayırt etmek, beklenen sayıları 1 ile 2 olan iki dağılımı ayırt etmektir; 100 bitkide bu iki dağılım büyük ölçüde örtüşür. Şema, standardı açıkça aşan çeşitleri yakalamak için tasarlanmıştır: 5P'de \beta=\%25{,}8, 10P'de %0,8. \beta(2P)'yi düşürmenin yolu örnek büyüklüğüdür ve bedeli ağırdır (1000 bitkide %15,4). Hangi oranın "kabul edilemez" sayılacağı ve o oranda hangi \beta'nın yeterli olduğu düzenleyici bir karardır; şablon bu kararın sonuçlarını gösterir.
S5. Birleşik test mi, iki aşamalı test mi?
Aynı toplam bitki sayısıyla hata olasılıkları yakındır (12.4.4'teki karşılaştırma: \alpha %3,30 ve %4,35; \beta(5P) %14,44 ve %13,38). Fark iş yükünde ve zamandadır: iki aşamalı testte kötü çeşitler birinci yılda elenir; a_1>0 seçilirse iyi çeşitler de birinci yılda kabul edilebilir (h şemasında P'deki bir çeşit için ikinci yıla geçme olasılığı %42'dir). Birleşik testte karar her zaman iki yıl bekler ama kural daha yalındır. İki yılda gerçek oranın değiştiğinden kuşkulanılıyorsa (ör. tohum partisi farklıysa) iki yöntemin ortak varsayımı da zayıflar.
S6. İki aşamalı testin sınırları nasıl seçilir?
Şablon sınırları aramaz; verilen şemanın özelliklerini hesaplar. Uygulamada birkaç aday şema denenir ve şu üçü birlikte gözetilir: \alpha\le1-\gamma (şablon aşılırsa uyarır), ilgilenilen P_q'de \beta'nın yeterince küçük olması, ve beklenen örnek büyüklüğü. r_1 küçüldükçe birinci yılda ret artar (\alpha büyür, iş azalır); a_1 büyüdükçe birinci yılda kabul artar (\beta büyür, iş azalır).
S7. Şablonun değerleri kaynak belgedeki tablolarla birebir aynı mı?
Sınır sayı k örnek verideki şemalarda kaynakla aynıdır; tek ayrı durum kabul olasılığı verilmemiş ornek2_e satırıdır (12.8). \alpha ve \beta kaynakta tam sayıya (küçük değerler bir ondalığa) yuvarlanmıştır; şablonun tam binom değerleri bunlarla yuvarlama içinde uyuşur. Birkaç değerde fark yuvarlamayı aşar: örneğin ornek3_a için kaynak \beta(5P)=15 verir, tam değer %14,44'tür; ornek4_a için kaynak \beta(2P)=78, tam değer %75,11'dir. Tam değerler bu bölümde üç bağımsız yolla aynı bulunmuştur (12.6.1); veri dosyasındaki _kaynak sütunları karşılaştırmayı okura bırakır.
S8. Gözlenen sayı tam k'ya eşitse karar nedir?
Kabul. k "izin verilen en fazla" sayıdır; ret koşulu gözlenen >k'dır (satır 240). İki aşamalıda eşitlikler de aynı yöndedir: K_1=r_1 ret değildir (ikinci yıla geçilir), K_1+K_2=r kabuldür, K_1=a_1 birinci yılda kabul değildir.
S9. Kabul olasılığı ile güven düzeyi aynı şey mi?
Hayır. Kabul olasılığı bir kuralın özelliğidir: oranı tam P olan çeşidin kabul edilme olasılığının alt sınırı. Gözlenen veriden gerçek oran için kurulan güven aralığıyla ilgisi dolaylıdır. Gözlenen sayı k'yı aşmıyor diye "gerçek oran %95 güvenle P'nin altındadır" denemez; örnekte 3 tip dışı bitki gözlenen bir çeşit kabul edilir, oysa 3/100 için tek yanlı %95 Clopper–Pearson (1934) üst sınırı %7,6'dır. Kural yeknesaklığı kanıtlamaz; yeknesak olmama kanıtı yeterince güçlü değilse kabul eder.
S10. OC eğrisi neden P'de tam %95'ten geçmiyor?
Eğri, hesaplanan k için gerçek kabul olasılığını çizer; k tam sayı olduğundan bu olasılık P'de %95'in üstündedir (örnekte %98,2). Yatay kılavuz çizgisi istenen alt sınırı, eğrinin P'deki yüksekliği gerçekleşeni gösterir. Aradaki boşluk testere grafiğindeki \alpha çizgisinin %5'in altında kalan kısmıdır.
12.10 Kaynaklar
- Clopper, C. J., & Pearson, E. S. (1934). The use of confidence or fiducial limits illustrated in the case of the binomial. Biometrika, 26(4), 404–413. https://doi.org/10.1093/biomet/26.4.404
- Dodge, H. F., & Romig, H. G. (1929). A method of sampling inspection. Bell System Technical Journal, 8(4), 613–631. https://doi.org/10.1002/j.1538-7305.1929.tb01240.x
- International Union for the Protection of New Varieties of Plants. (2007). TGP/8/1 Draft 6, Part II: Techniques used in DUS examination. UPOV.
- International Union for the Protection of New Varieties of Plants. (2022). Trial design and techniques used in the examination of distinctness, uniformity and stability (Document TGP/8/5). UPOV. https://www.upov.int/edocs/tgpdocs/en/tgp_8.pdf
- R Core Team. (2026). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/