54. Yeniden örneklemeli çoklu test düzeltmesi: Westfall-Young adım aşağı maxT ve minP (permütasyon ya da bootstrap)
Şablon kimliği: coklu_test_yeniden_ornekleme · Kategori: yeniden_ornekleme · Dil: R · Dosya: pro/sablonlar/yeniden_ornekleme/coklu_test_yeniden_ornekleme.R (satır 1–396; üstbilgi 1–90) · Örnek veri: _ornek/coklu_test_yeniden_ornekleme_golub.csv · Paketler: taban R 4.5.3 (stats, utils, graphics); ek paket yüklenmez
54.1 Ne işe yarar
İki grup çok sayıda sonuç değişkeninde karşılaştırıldığında (genler, metabolitler, klinik sonlanımlar, bir ölçeğin alt boyutları) her değişkene ayrı bir test uygulanır ve yüzlerce, binlerce p değeri elde edilir. Hiçbir gerçek fark yokken bile bunların yaklaşık %5'i 0,05'in altına düşer. Şablonun cevapladığı soru: "Bütün aile içinde bir tane bile yanlış ret yapma olasılığı α'yı aşmayacak biçimde hangi değişkenler farklıdır?"
- H_{0j}: j. değişkende iki grubun aynı olduğu hipotezi (j=1,\dots,m).
- FWER: aile boyu hata oranı; m testin tamamında en az bir yanlış ret olasılığı.
- \tilde p_j: düzeltilmiş p değeri; α ile doğrudan karşılaştırılır. "Düzeltilmiş p ≤ α olan hipotezleri reddet" kuralı FWER'i α'da tutar.
Bonferroni ve Holm düzeltmeleri bu güvenceyi testlerin birbirine nasıl bağlı olduğuna bakmadan verir; değişkenler ilişkiliyken gereğinden serttir. Westfall ve Young'ın (1993) yeniden örneklemeli yöntemleri sıfır dağılımını veriden kurar: grup etiketleri karıştırılır (ya da veri bootstrap ile yeniden örneklenir), her seferinde bütün değişkenlerin istatistikleri birlikte yeniden hesaplanır ve bunların en büyüğünün (maxT) ya da p değerlerinin en küçüğünün (minP) dağılımı elde edilir. Bir gözlemin bütün değişkenleri birlikte taşındığı için değişkenler arasındaki ilişki sıfır dağılımına kendiliğinden yansır.
Ne zaman kullanılır? İki grup ve çok sayıda sayısal sonuç değişkeni varsa; kesin doğrulama gerektiren, yanlış pozitifin pahalı olduğu bir seçim yapılacaksa (FWER denetimi); değişkenler birbiriyle ilişkiliyse; istatistiklerin kuramsal dağılımına (normallik, serbestlik derecesi) güvenilmiyorsa.
Ne zaman kullanılmaz?
- Elde yalnız p değerleri varsa (ham veri yoksa) ya da analitik düzeltme yeterliyse: temel programdaki Çoklu Karşılaştırma Düzeltme.
- Amaç keşifse ve bulguların bir bölümünün yanlış çıkması kabul edilebiliyorsa (yanlış keşif oranı, FDR): temel programdaki Çoklu Karşılaştırma Düzeltme (Benjamini-Hochberg); bu şablon BH sütununu yalnız karşılaştırma için verir.
- Tek bir sonuç değişkeni sınanacaksa:
permutasyon_ozel(Bölüm 56) ya da temel programdaki Permütasyon Testi. - İkiden çok grup, eşleştirilmiş ölçümler ya da ortak değişken düzeltmesi gerekiyorsa: şablon yalnız iki bağımsız grubu karşılaştırır; grup ortalamalarının çoklu karşılaştırması için
r_emmeans_kontrast(Bölüm 26) ya daozel_kontrast(Bölüm 38). - Gözlemler bağımsız değilse (aynı hastanın birden çok örneği): etiket permütasyonu geçerli değildir; önce birim düzeyine özetlenir.
Temel programla ilişki. Temel programdaki Çoklu Karşılaştırma Düzeltme, verilen bir p değeri listesine analitik düzeltmeler uygular (Bonferroni, Holm, Benjamini-Hochberg ve benzerleri); testler arasındaki bağımlılığı kullanmaz ve ham veriyi görmez. Bu şablon ham veriden başlar: istatistikleri kendisi hesaplar, sıfır dağılımını yeniden örneklemeyle kurar ve analitik düzeltmeleri de aynı tabloda yan yana verir.
54.2 Şablonun girdileri
Form, üstbilgideki on bir [[param]] bloğundan kurulur (coklu_test_yeniden_ornekleme.R:11–89).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Grup değişkeni (iki düzeyli) · grup |
kategorik sütun · Değişkenler | ilk sütun | tam iki düzeyli sütun | Düzey sırası MerQuR+ kuralıdır (faktörde Veri sekmesinin sırası; metinde sayıysa sayısal sıra, değilse ilk görülme); ikinci düzey 1, birinci 0 kodlanır (119–130). |
Sonuç değişkenleri · sonuclar |
sütunlar (sayısal) · Değişkenler | boş | boş ya da en az 2 sayısal sütun | Boşsa grup dışındaki bütün sayısal sütunlar (96–108). |
Test istatistiği · istatistik |
seçim · Model | t |
t, t_esvar, wilcoxon |
Welch t, havuzlanmış t ya da standartlaştırılmış sıra toplamı (141–145, 163–185). |
Yeniden örnekleme · yontem |
seçim · Model | permutasyon |
permutasyon, bootstrap |
Sıfır dağılımının kaynağı (202, 209–245). |
Seçenek hipotez · yon |
seçim · Model | abs |
abs, ust, alt |
Uçluk ölçüsü: \lvert T\rvert, T ya da -T (186–187). |
Yeniden örnekleme sayısı B (permütasyonda gözlenen dahil) · B |
tamsayı · Model | 10000 | 100–1000000 | Permütasyonda gözlenen ilk örnektir, B-1 rastgele dizilim çekilir (224); bootstrap'ta B çekiliş (235). |
Olası permütasyon sayısı ≤ B ise tam sayım yap · tam_sayim |
onay · Seçenekler | açık | açık, kapalı | \binom{n}{n_1}\le B ise bütün ayrımlar sayılır, B bu sayıya eşitlenir (210–222). |
minP için yeniden örnekleme p değerleri · minp_tabani |
seçim · Seçenekler | yeniden |
yeniden, parametrik |
Her yeniden örneklemenin p değeri: kendi yeniden örnekleme dağılımından ya da t / normal dağılımdan (263, 286, 296–304). |
Tohum (0 = çalıştırmanın tohumu) · tohum |
tamsayı · Seçenekler | 0 | 0–2147483647 | Pozitif değer set.seed(tohum) ile sabit tohumdur; 0 ise Kod panelindeki Tohum alanından gelen çalıştırma tohumu (mq_tohum) kullanılır (204–206). |
Anlamlılık düzeyi α · alfa |
ondalık · Seçenekler | 0,05 | 0,0001–0,5 | Ret tablosuna eklenen düzey, özet satırı ve grafiklerdeki çizgi (351–352, 358, 379, 385). |
Ana tabloda gösterilecek değişken sayısı · satir_sayisi |
tamsayı · Çıktı | 50 | 0–100000 (0 = hepsi) | Ana tablonun ilk kaç satırının yazılacağı (346–349). |
Örnek ayar (ornek_param, satır 9): grup = sinif, sonuclar boş (3051 gen), istatistik = t, yontem = permutasyon, B = 10000, tohum = 20261104 (tohum alanının varsayılanı 0'dır: çalıştırmanın tohumu); öteki alanlar varsayılandadır.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 93 |
| Grup seçilmemiş ya da veride yok | "Grup değişkenini seçin." | 95 |
| Grup dışında 2'den az sayısal sonuç değişkeni | "En az iki sayısal sonuç değişkeni gerekir" | 102 |
| Seçilen sonuç değişkenlerinden biri sayısal değil | "Sayısal olmayan sonuç değişkenleri: …" | 104 |
| Grup iki düzeyli değil | "Grup değişkeni tam iki düzeyli olmalı (şu an … düzey)." | 110 |
| Bir grupta 2'den az gözlem | "Her grupta en az iki gözlem gerekir." | 116 |
| Elemelerden sonra 2'den az değişken kaldı | "Geçerli en az iki sonuç değişkeni kalmadı." | 142 |
| Bir değişkende gözlenen istatistik hesaplanamıyor | "Bazı değişkenlerde istatistik hesaplanamadı (grup içi varyans sıfır)." | 182 |
| Bootstrap ile Wilcoxon birlikte seçilmiş | "Bootstrap yalnız t istatistikleriyle kullanılabilir…" | 191 |
Çalıştırmayı durdurmayan, yalnız bildirilen durumlar: grup değeri eksik satırların çıkarılması (118); bir grubunda ikiden az gözlemi olan değişkenlerin çıkarılması (137–139); sabit değişkenlerin çıkarılması (148–150); tam sayım kapalıyken olası permütasyon sayısının B'yi aşmadığı notu (254–255); bellek sınırı nedeniyle minP'nin hesaplanmadığı uyarısı (260–262).
Ailenin kimlerden oluştuğu
Düzeltilmiş p değerleri ailedeki bütün değişkenlere bağlıdır; aileye bir değişken eklemek ya da çıkarmak ötekilerin sonucunu değiştirir. Sonuç listesi boş bırakıldığında aile "grup dışındaki bütün sayısal sütunlar"dır: veride bir sıra numarası ya da yaş sütunu varsa o da sınanır; veri sekmesinde türü "kategorik" olan ama değerleri sayı olan sütunlar sayı olarak aileye alınır ve adlarıyla bildirilir; sayısal olmayan sütunlar da adlarıyla bildirilip dışarıda bırakılır. Kaç değişkenin sınandığı çıktının ilk satırında yazılır; bu sayı beklenenle karşılaştırılır. Küçük ve bilinçli seçilmiş bir ailede değişkenler formda tek tek işaretlenir.
54.3 Örnek veri
Dosya: _ornek/coklu_test_yeniden_ornekleme_golub.csv. Golub ve arkadaşlarının (1999) lösemi çalışmasının, multtest paketiyle dağıtılan önişlenmiş gen ifadesi verisi: 38 hasta (satır), 3051 gen (sütun). Eksik değer yoktur.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
sinif |
Grup | ikili | ALL (akut lenfoblastik lösemi) 27 hasta, AML (akut miyeloid lösemi) 11 hasta. |
g1 … g3051 |
Sonuç | sayısal | Önişlenmiş ifade düzeyleri; −1,608 ile 3,898 arasında. Sütun adları paketteki sırayı izler. |
Düzey sırası: şablon düzeyleri metin olarak sıralar (ALL, AML); istatistik ikinci düzey eksi birinci düzey, yani AML − ALL'dir. Pozitif istatistik genin AML'de daha yüksek ifade edildiğini gösterir. İki yönlü sınamada sıra sonucu etkilemez; tek yönlü seçeneklerde hangi düzeyin "ikinci" olduğu çıktının ilk satırından denetlenir (54.8).
Olası etiket dizilimi sayısı \binom{38}{11}\approx1{,}2\times10^{9}'dur; B'den büyük olduğundan örnek ayarda rastgele permütasyon kullanılır.
Tam sayımı ve elle hesabı gösterebilmek için bölümde şablonun ikinci örnek dosyası da kullanılır: _ornek/coklu_test_yeniden_ornekleme_golub_kucuk.csv (aynı verinin ilk 6 ALL ve ilk 6 AML hastası ile ilk 100 geni; \binom{12}{6}=924 dizilim).
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) örnek ayar, satir_sayisi = 0 (bütün genler); (3) küçük veri, Welch t, tam sayım; (4) küçük veri, havuzlanmış t; (5) küçük veri, Wilcoxon; (6) küçük veri, tek yönlü (yon = ust); (7) küçük veride dokuz hücresi boşaltılmış sürüm (eksik değer); (8) küçük veri, bootstrap (B=2000, havuzlanmış t), iki minP tabanıyla; (9) örnek veri, havuzlanmış t; (10) örnek veri, bootstrap (B=2000); (11) örnek veri, B=100000.
54.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) grubu kodla, sonuç matrisini kur, kullanılamayan değişkenleri ele; (2) her değişken için gözlenen istatistiği ve parametrik p değerini hesapla; (3) B yeniden örnekleme üret ve her birinde bütün istatistikleri yeniden hesapla; (4) ham yeniden örnekleme p değerlerini say; (5) en büyük istatistiğin dağılımından tek adımlı ve adım aşağı maxT'yi kur; (6) bellek elveriyorsa en küçük p'nin dağılımından tek adımlı ve adım aşağı minP'yi kur; (7) parametrik p'ye Bonferroni, Holm ve Benjamini-Hochberg düzeltmelerini uygula; (8) tabloları ve iki şekli üret.
54.4.1 Test istatistikleri
Her değişken için, o değişkende gözlemi bulunan k_1 (ikinci düzey) ve k_0 (birinci düzey) birimden:
- \bar x_g, s_g^2: grubun ortalaması ve (k_g-1 bölenli) varyansı.
- \nu: parametrik p değerinde kullanılan serbestlik derecesi; Welch'te Welch-Satterthwaite yaklaşımıdır ve değişkenden değişkene farklıdır.
- W_1: ikinci grubun sıra toplamı. Sıralar değişkenin eksik olmayan N gözlemi içinde verilir; bağlı değerler ortalama sıra alır.
- T^{\text{Wilcoxon}}: sıra toplamının, sıfır hipotezi altındaki ortalaması çıkarılıp standart sapmasına bölünmüş hâli. Varyansta bağ düzeltmesi yoktur.
Parametrik p değeri t_\nu dağılımından (Wilcoxon'da standart normalden) alınır; iki yönlüde kuyruk olasılığının iki katıdır (satır 188–193). Uçluk ölçüsü seçenek hipoteze göre A=\lvert T\rvert (iki yönlü), A=T (ikinci grup büyük) ya da A=-T (ikinci grup küçük) olarak tanımlanır; izleyen bütün formüllerde "büyük A = sıfır hipotezine daha aykırı" demektir.
Neden varsayılan Welch t?
Grupların varyansı değişkenden değişkene farklı olabilir; havuzlanmış t varyans eşitliğini varsayar ve grup büyüklükleri de farklıysa (burada 27 ve 11) bu varsayıma duyarlıdır. Welch t her grubun kendi varyansını kullanır. Bedeli şudur: Welch istatistiğinin sıfır dağılımı değişkenden değişkene farklıdır (farklı \nu); maxT bütün istatistikleri aynı ölçekte karşılaştırdığından ağır kuyruklu değişkenler en büyük değeri belirler. minP bu dengesizliği gidermek için vardır (54.4.5).
Koddaki tercih
t istatistikleri konum ve ölçek değişmez olduğundan her sütun önce ortalamasından arındırılır ve en büyük mutlak değerine bölünür (satır 153–156); bu, çok büyük ya da çok küçük ölçekli değişkenlerde kareler toplamındaki sayısal kaybı önler ve sonucu değiştirmez. Bütün yeniden örneklemelerin istatistikleri matris çarpımıyla birlikte hesaplanır: etiketler n\times(öbek) boyutlu bir ağırlık matrisidir; grup toplamları, kareler toplamları ve gözlem sayıları crossprod ile bulunur (163–185). Eksik hücreler 0 ile doldurulur ve ayrı bir 0/1 matrisiyle sayılır; böylece her değişken kendi k_1, k_0 değerleriyle hesaplanır. Uçluk değerleri 12 anlamlı basamağa yuvarlanır (187): matematiksel olarak eşit istatistikler (ör. tam sayımda bir ayrım ve tümleyeni) yuvarlama hatası yüzünden farklı sayılmaz.
54.4.2 Sıfır dağılımının üretilmesi
Permütasyon. Grup etiketleri n gözlem arasında yeniden dağıtılır; her gözlemin bütün değişkenleri birlikte kalır. Gözlenen etiketleme ilk örnektir; kalan B-1 örnek için sample.int(n) ile rastgele dizilim çekilir (satır 224). tam_sayim açıksa ve \binom{n}{n_1}\le B ise rastgele çekim yerine n_1 birimin bütün seçimleri combn ile sıralanır; gözlenen seçim başa alınır ve B bu sayıya eşitlenir (210–222).
Bootstrap. Her değişkenden kendi grup ortalaması çıkarılır; böylece iki grubun ortalaması eşitlenir (sıfır hipotezi kurulur), varyanslar ve değişkenler arası ilişki korunur. Arındırılmış n satırdan yerine koyarak n satır çekilir; ilk n_0 çekiliş birinci gruba, kalan n_1 çekiliş ikinci gruba yazılır (231–244). Gözlenen örnek dağılıma katılmaz; B çekilişin hepsi yeniden örneklemedir.
- x_{ij}: i. gözlemin j. değişkeni; g(i): gözlemin grubu.
- \mathbf x^{c}_i: gözlemin arındırılmış satırı (bütün değişkenler birlikte).
- Çekilen satırların özgün grubu dikkate alınmaz; yeni gruplar çekiliş sırasına göre oluşur.
Permütasyon mu, bootstrap mı?
Permütasyon, sıfır hipotezi altında iki grubun bütün ortak dağılımının aynı olduğunu varsayar; rastgele atamalı çalışmada bu tasarımdan gelir ve test sonlu örneklemde kesindir. Gruplar yalnız ortalamada değil varyansta ya da ilişki yapısında da ayrışıyorsa (gözlemsel karşılaştırmalarda sık) etiketleri karıştırmak bu farkı da siler ve sıfır dağılımı gerçeği yansıtmayabilir. Bootstrap yalnız ortalamaları eşitler; geri kalan farkları korur, ama geçerliliği asimptotiktir ve küçük gruplarda (burada 11) kaba olabilir. Şablonun varsayılanı permütasyondur; bootstrap, varyans farkının belirgin olduğu ve grupların yeterince büyük olduğu durumlar içindir. Bootstrap'ta sıralar yeniden örneklemede anlamını yitirdiğinden Wilcoxon ile birlikte seçilemez (satır 207–208).
54.4.3 Ham yeniden örnekleme p değeri
- A_j: j. değişkenin gözlenen uçluk değeri; A^{*}_{j,b}: b. yeniden örneklemedeki değeri.
- Permütasyonda b=1 gözlenen örnektir; sayım en az 1, p değeri en az 1/B'dir.
- Tam sayımda p_j kesin permütasyon p değeridir.
Bu sütun (p_ham) düzeltilmemiştir; tek bir değişken önceden seçilmiş olsaydı kullanılacak p değeridir. Parametrik karşılığı p_parametrik sütunudur.
Bootstrap'ta ham p sıfır olabilir
Bootstrap'ta gözlenen örnek ham p ve maxT sayımına girmediğinden hiçbir çekiliş gözlenen değere ulaşmazsa p_j=0 yazılır (SAS'taki tanım). Bu, "p<1/B" olarak okunur; sıfır olasılık anlamına gelmez. Formdaki "B (permütasyonda gözlenen dahil)" ifadesi permütasyon için geçerlidir; bootstrap'ta B çekilişin tamamı yeniden örneklemedir. minP için bootstrap'ta gözlenen örnek yeniden örnekleme kümesine eklenir (B+1 değer; permütasyondaki gibi): her değişkenin p değeri bu B+1 değer içindeki sırasından alınır ve gözlenen p da aynı kümeden gelir. Böylece ham p'si 0 olan değişkenin minP değeri otomatik olarak 0 olmaz; çıktı bu kuralı yazar.
54.4.4 maxT: tek adımlı ve adım aşağı
Tek adımlı. Her yeniden örneklemede bütün değişkenlerin en büyük uçluk değeri alınır; j. değişkenin düzeltilmiş p değeri, bu en büyük değerin gözlenen A_j'ye ulaşma sıklığıdır:
Adım aşağı. Değişkenler gözlenen uçluğa göre büyükten küçüğe sıralanır: A_{(1)}\ge A_{(2)}\ge\dots\ge A_{(m)}. r. sıradaki değişken yalnız kendisi ve kendisinden sonrakiler üzerinden alınan en büyük değerle karşılaştırılır; ardından p değerlerinin sıraya göre azalmaması sağlanır:
- u_{r,b}: b. yeniden örneklemede, sıradaki ilk r-1 değişken dışarıda bırakıldığında kalanların en büyük uçluğu ("ardışık en büyük").
- p^{\circ}_{(r)}: tekdüzelik sağlanmadan önceki değer.
- Son adım (ardışık en büyük p): daha uç bir değişkenin düzeltilmiş p değeri, daha az uç olanınkinden büyük olamaz.
- r=1 için iki yöntem aynıdır: en uç değişkenin adım aşağı ve tek adımlı değeri eşittir.
Neden adım aşağı daha güçlüdür ve FWER yine korunur?
Tek adımlı yöntem her değişkeni, bütün hipotezler doğruymuş gibi kurulan en büyük değer dağılımıyla karşılaştırır. En uç değişken reddedildikten sonra onun sıfır hipotezinin yanlış olduğu kabul edilmiştir; ikinci değişkeni sınarken birinciyi sıfır dağılımında tutmak gereksiz bir cezadır. Adım aşağı yöntem her adımda yalnız henüz reddedilmemiş hipotezlerin en büyüğüne bakar; bu en büyük değer daha küçük (ya da eşit) olduğundan p değerleri de küçülür. Westfall ve Young (1993), doğru hipotezlerin ortak dağılımının yanlış olanlardan etkilenmediği koşulda (alt küme pivotluğu) FWER'in güçlü anlamda, yani hangi hipotezlerin doğru olduğuna bakılmaksızın α'da kaldığını gösterir. Tek adımlı değerler tabloda karşılaştırma için durur; karar adım aşağı sütundan verilir.
Koddaki tercih
Yeniden örneklemeler öbekler hâlinde işlenir (öbek büyüklüğü 4\times10^{6}/m satır; satır 270). Her öbekte uçluk matrisi gözlenen sıranın tersine dizilir, satır boyunca cummax alınır ve yeniden çevrilir (280–283): k. sütun u_{k,b} olur, ilk sütun genel en büyük değerdir ve ayrıca saklanır (285). Sayımlar öbekten öbeğe toplanır; adj_maxt[ord] <- cummax(say_maxt / B) tekdüzelik adımıdır (290). Böylece maxT için yalnız B uzunluğunda bir vektör bellekte tutulur.
54.4.5 minP: tek adımlı ve adım aşağı
minP aynı yapıyı istatistik yerine p değerleriyle kurar. Önce her yeniden örneklemenin her değişkeni için bir p değeri gerekir. İki taban vardır:
Gözlenen karşılaştırma değeri p^{\text{k}}_j, yeniden örnekleme tabanında gözlenen örneğin kümedeki p'si (permütasyonda ham p p_j; bootstrap'ta B+1 değerli kümeden), parametrik tabanda parametrik p'dir. Aşağıdaki B, bootstrap'ta B+1 olur. Değişkenler bu p değerine göre küçükten büyüğe sıralanır (p^{\text{k}}_{(1)}\le\dots\le p^{\text{k}}_{(m)}) ve:
- P^{*}_{j,b}: b. yeniden örneklemede j. değişkenin p değeri. Yeniden örnekleme tabanında değişkenin B değeri kendi içinde sıralanır; b. değerin sırası p değerini verir.
- \nu^{*}_{j,b}: yeniden örneklenmiş verinin serbestlik derecesi (Welch'te her seferinde yeniden hesaplanır).
- q_{r,b}: ardışık en küçük p; maxT'deki u_{r,b}'nin karşılığı.
maxT varken neden minP?
maxT istatistikleri doğrudan karşılaştırır; bütün değişkenlerin sıfır dağılımı aynıysa en uygunudur. Dağılımlar farklıysa (Welch'te farklı serbestlik dereceleri, farklı eksik sayısı, çarpık değişkenler) aynı \lvert T\rvert değeri bir değişkende olağan, ötekinde çok uçtur; en büyük değeri ağır kuyruklu değişkenler belirler ve hafif kuyrukluların reddedilmesi zorlaşır. minP her değişkeni önce kendi dağılımında p değerine çevirir; bütün değişkenler aynı ölçeğe (0–1) gelir ve aileye eşit ağırlıkla katılır. Havuzlanmış t, eksiksiz veri ve parametrik tabanda p değeri istatistiğin her değişkende aynı azalan fonksiyonudur; bu durumda minP ile maxT özdeştir (küçük veride doğrulandı: en büyük fark 0).
Yeniden örnekleme tabanında minP'nin tabanı vardır
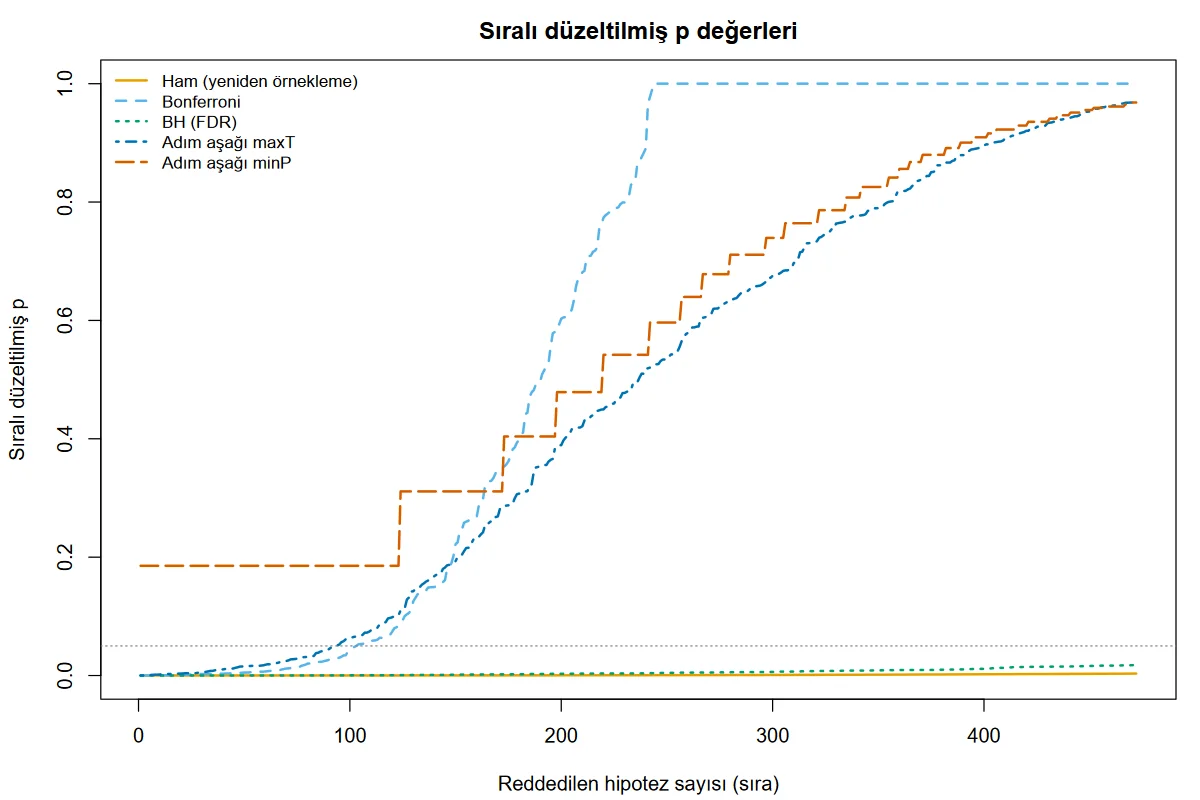
Yeniden örnekleme tabanında bir p değeri 1/B'den küçük olamaz. Değişken sayısı B'ye göre büyükse yeniden örneklemelerin önemli bir bölümünde en az bir değişken kendi en uç değerini alır ve o örneklemenin en küçük p'si 1/B olur. Bu bölümün oranı, minP'nin inebileceği en küçük düzeltilmiş p değeridir. Örnek ayarda (3051 gen, B=10000) oran 0{,}1854'tür: ham p'si 1/B olan 123 genin hepsinin minP değeri 0{,}1854 yazılır ve α = 0,05'te minP hiçbir hipotezi reddetmez. Bu, yöntemin bilinen bir özelliğidir (Ge, Dudoit ve Speed, 2003): yeniden örnekleme tabanlı minP, değişken sayısının çok üstünde bir B ister. Çok değişkenli veride karar maxT sütunundan verilir ya da minp_tabani = parametrik seçilir. Bootstrap ile yeniden örnekleme tabanı birlikte kullanıldığında ham p'si 0 olan değişkenlerin minP değeri de 0 yazılır (54.4.3); bu değerler yorumlanmaz, bootstrap'ta minP için parametrik taban kullanılır.
Koddaki tercih
minP için bütün uçluk değerleri B\times m boyutlu bir matriste tutulur (satır 267, 286). Bellek sınırı B\times m\le3{,}1\times10^{7} hücredir (258–259); aşılırsa minP hesaplanmaz, sütunları tablodan çıkarılır ve bir uyarı yazılır. Örnek ayar (10000\times3051=3{,}051\times10^{7}) sınırın hemen altındadır. Yeniden örnekleme tabanında p değerleri sütun sütun rank(·, ties.method = "min") ile üretilir (302); sıralama anahtarı önce p, eşitlikte daha büyük istatistiktir (307). Karşılaştırmalar 12 anlamlı basamağa yuvarlanmış değerlerle yapılır (306).
54.4.6 Analitik düzeltmeler
Karşılaştırma için parametrik p değerlerine stats::p.adjust ile üç düzeltme uygulanır (satır 338). Parametrik p'ler küçükten büyüğe p_{(1)}\le\dots\le p_{(m)} sıralandığında:
- Bonferroni ve Holm FWER'i, Benjamini-Hochberg (BH) yanlış keşif oranını (FDR) denetler.
- Holm, Bonferroni'nin adım aşağı biçimidir; her zaman en az onun kadar güçlüdür.
- BH sütunu FWER güvencesi vermez: "reddedilenlerin beklenen yanlış oranı α'yı aşmaz" der.
Bu üç sütun parametrik p'ye, maxT ve minP sütunları yeniden örneklemeye dayanır; iki aile farklı ham p değerlerinden yola çıkar. Aralarındaki fark yalnız "bağımlılığı kullanma" kazancını değil, parametrik ve yeniden örneklemeli p değerlerinin farkını da içerir (54.9, S1).
54.4.7 Monte Carlo hatası ve ret sayıları
- \tilde p: yeniden örneklemeyle kestirilen düzeltilmiş p değeri (burada adım aşağı maxT).
- B: yeniden örnekleme sayısı; standart hata 1/\sqrt B ile küçülür.
Rastgele yeniden örneklemede her düzeltilmiş p değeri bir orandır ve B ile sınırlı bir doğrulukla bilinir. Şablon bu standart hatayı adım aşağı maxT için MC_SH_maxT sütununda verir; tam sayımda 0'dır (satır 339). En büyük değeri \sqrt{0{,}25/B}'dir (B=10000 için 0{,}005). İkinci tablo, α'nın çeşitli düzeylerinde (0{,}01; seçilen α; 0{,}1; 0{,}2; …; 1) her yöntemin kaç hipotezi reddettiğini sayar (351–357).
54.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–90 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on bir parametre. | Form buradan kurulur (Bölüm 1.2). |
| 91–111 | Dil yardımcısı; grup ve sonuç sütunlarının belirlenmesi; sayısallık denetimi. | Liste boşsa is.numeric olan bütün sütunlar alınır. |
| 116–140 | Grup değeri eksik satırların atılması; düzeylerin kurulması ve 0/1 kodu; sonuç matrisi; eksik hücre haritası; bir grubunda ikiden az gözlemi olan değişkenlerin elenmesi. | factor(as.character(·)): düzeyler metin sırasındadır. |
| 141–161 | Wilcoxon için sütun içi sıralar; sabit değişkenlerin elenmesi; t için merkezleme ve ölçekleme; eksiklerin 0 ile doldurulması. | Sıralar bir kez verilir; permütasyon sıraları değiştirmez. |
| 163–200 | istatistik_hesap(), uçluk işlevi uc(), parametrik p işlevi; gözlenen istatistikler ve parametrik p. |
Gözlenen istatistiklerden biri hesaplanamazsa çalıştırma durur (198). |
| 202–255 | Tohum; tam sayım, rastgele permütasyon ya da bootstrap için etiket üreticisi; özet satırı. | Rastgele çekilişlerin tamamı döngüden önce yapılır (224, 235): sonuç öbek büyüklüğünden bağımsızdır. |
| 257–291 | Bellek sınırı; öbek döngüsü: istatistikler, ham sayım, ardışık en büyükler, maxT sayımı; ham p, adım aşağı ve tek adımlı maxT. | 54.4.4. |
| 293–336 | minP: p matrisi (iki taban), sıralama, ardışık en küçükler, adım aşağı ve tek adımlı minP. | 54.4.5; bellek sınırı aşıldıysa atlanır. |
| 338–367 | Analitik düzeltmeler, Monte Carlo SH, ana tablo (adım aşağı maxT'ye göre sıralı), ret tablosu, metin satırları. | Tablo sırası: adım aşağı maxT, eşitlikte daha büyük uçluk. |
| 369–396 | İki şekil: sıralı düzeltilmiş p eğrileri; en büyük istatistiğin sıfır dağılımı. | Şekil hatası çalıştırmayı durdurmaz (tryCatch). |
54.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/coklu_test_yeniden_ornekleme/elle_hesap.py ile, şablon kodu kullanılmadan hesaplanmıştır: istatistikler ham veriden (merkezleme ve ölçekleme yapılmadan), düzeltmeler 54.4'teki tanımların doğrudan uygulamasıyla, tam sayım itertools.combinations ile. Rastgele permütasyon ve bootstrap çalıştırmalarında R'nin rastgele sayı üreteci Python'da yeniden kurulmuş, böylece aynı dizilimler bağımsız bir kodla işlenmiştir. R tarafında (r_dogrulama.R) tam sayım multtest::mt.maxT ve mt.minP ile, örnek ayar ise ayrı yazılmış açık bir döngüyle yinelenmiştir.
Adım 1 — Bir genin Welch istatistiği (örnek veri, g2124). AML (k_1=11): ortalama 1{,}586668, varyans 0{,}135144. ALL (k_0=27): ortalama -0{,}294793, varyans 0{,}522498.
Adım 2 — Analitik düzeltmeler. g2124 en küçük parametrik p'ye sahiptir: Bonferroni =3051\times2{,}781\times10^{-12}=8{,}485\times10^{-9}; Holm ve BH bu gen için aynı değeri verir (sıradaki ilk hipotez).
Adım 3 — Ham permütasyon p değeri. 10000 dizilimin (gözlenen dahil) yalnız birinde, gözlenenin kendisinde, \lvert T^{*}\rvert\ge10{,}5777'dir: p=1/10000=0{,}0001. Bu, B=10000 ile yazılabilecek en küçük ham p'dir ve 123 gen bu değeri alır.
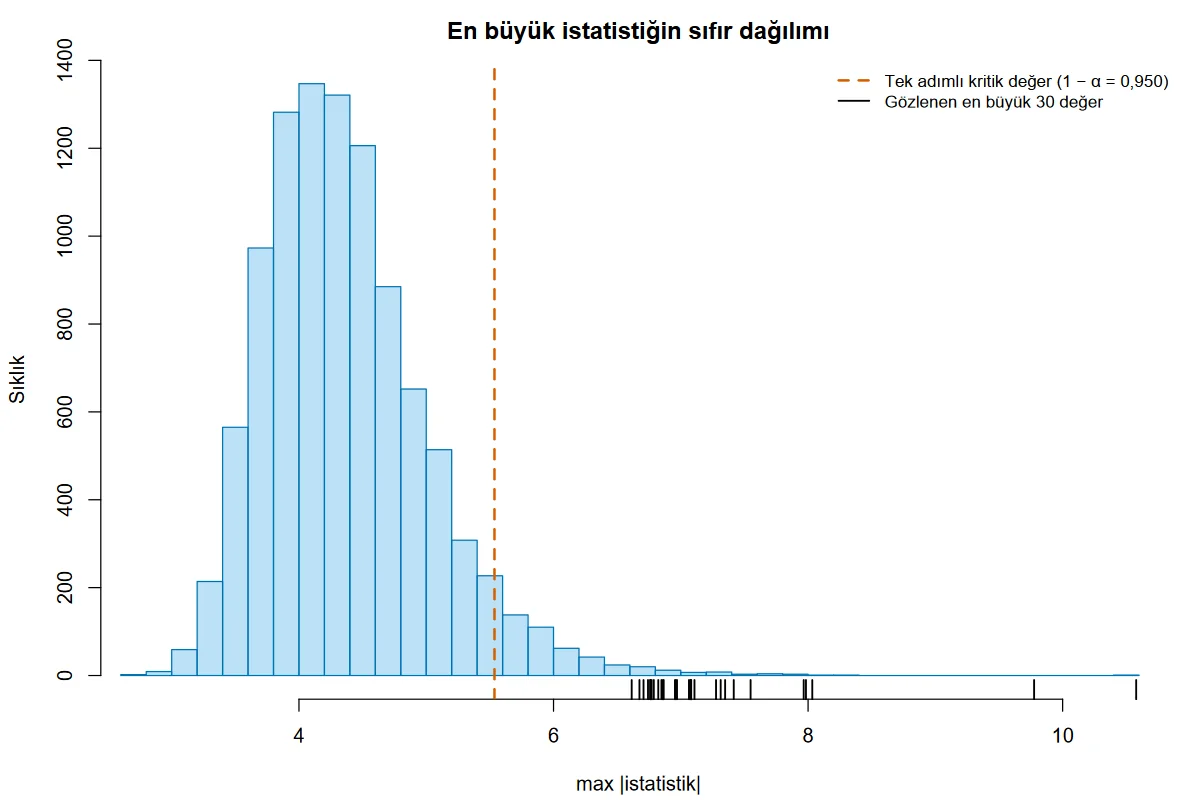
Adım 4 — maxT. Her dizilimde 3051 genin en büyük \lvert T^{*}\rvert değeri alınır. Bu 10000 değerin %95 yüzdeliği 5{,}5360'tır: tek adımlı yöntemin α = 0,05 kritik değeri. Gözlenen \lvert T\rvert'si bu değeri aşan 91 gen vardır (tek adımlı ret sayısı). g2124 için en büyük değer yalnız gözlenen dizilimde 10{,}5777'ye ulaşır: \tilde p=0{,}0001. Üçüncü sıradaki g896 (\lvert T\rvert=8{,}0329) için sayım 3'tür: \tilde p=0{,}0003. Adım aşağı yöntem 92 gen reddeder; tek adımlıdan bir fazla.
Karşılaştırma: Bonferroni'nin α = 0,05 için istediği parametrik p 0{,}05/3051=1{,}64\times10^{-5}'tir ve 103 gen bunu sağlar.
Adım 5 — minP'nin tabanı. Her dizilimde her genin p değeri, o genin 10000 değeri içindeki sırasından bulunur. 10000 dizilimin 1854'ünde en az bir gen kendi en uç değerindedir; bu dizilimlerde en küçük p 0{,}0001'dir. Ham p'si 0{,}0001 olan bir gen için "en küçük p ≤ 0,0001" koşulu tam bu 1854 dizilimde sağlanır: \tilde p^{\,\text{minP}}=0{,}1854. Daha küçük bir değer olanaksızdır.
Adım 6 — Tam sayım (küçük veri, 924 dizilim). Burada her sayım bir tam sayıdır ve p değerleri kesindir. En uç iki gen:
| Gen | T | Ham sayım | Tek adımlı maxT | Adım aşağı maxT | Tek adımlı minP | Adım aşağı minP |
|---|---|---|---|---|---|---|
| g13 | 3,379593 | 2 | 334 | 334 | 166 | 166 |
| g82 | 3,166055 | 12 | 428 | 426 | 558 | 554 |
| p değeri (sayım / 924) | 0,002165; 0,012987 | 0,361472; 0,463203 | 0,361472; 0,461039 | 0,179654; 0,603896 | 0,179654; 0,599567 |
g13 için: AML ortalaması 0{,}236755, varyansı 0{,}287689; ALL ortalaması -0{,}544458, varyansı 0{,}032910; T=0{,}781213/\sqrt{0{,}047948+0{,}005485}=3{,}379593. Ham sayım 2'dir: grup büyüklükleri eşit olduğundan gözlenen ayrım ile tümleyeni (bütün etiketlerin yer değiştirmesi) aynı \lvert T\rvert'yi verir; iki yönlü kesin p 2/924'ten küçük olamaz. 924 dizilimin 334'ünde 100 genin en büyük \lvert T^{*}\rvert değeri 3{,}3796'ya ulaşır: tek adımlı maxT =334/924.
g82'de adım aşağı etkisi görülür: g13 dışarıda bırakılınca en büyük değerin 3{,}1661'e ulaştığı dizilim sayısı 428'den 426'ya iner. Aynı tabloda minP ile maxT'nin farklı sıraladığı da görülür: g13'ün ham p değeri ulaşılabilir en küçük değerdir (2/924) ve minP onu öne çıkarır (0{,}18'e karşı maxT 0{,}36); g82 için durum terstir. Bu küçük örnekte hiçbir gen α = 0,05'te reddedilmez: 6'ya 6 karşılaştırmada 100 gen için FWER denetimi çok serttir.
Adım 7 — Eksik değer (çalıştırma 7). g5'te bir ALL hastasının değeri boşaltıldığında gen k_0=5, k_1=6 ile hesaplanır; öteki genler 6'ya 6 kalır. Her dizilimde g5'in grup büyüklükleri, eksik hücrenin hangi gruba düştüğüne göre değişir. Welch T=-3{,}152151, kesin ham p 22/924=0{,}023810, adım aşağı maxT 0{,}478355.
54.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1, 3–8).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Örnek ayar, g2124: istatistik | 10,57774809 | 10,57774809 | 10,57774809 | 8,4e−16 | ✓ |
| Örnek ayar, g2124: p parametrik | 2,780971·10−12 | 2,780971·10−12 | 2,780971·10−12 | 1,3e−22 | ✓ |
| Örnek ayar, g2124: p ham | 1,000000·10−4 | 1,000000·10−4 | 1,000000·10−4 | 0 | ✓ |
| Örnek ayar, g2124: Bonferroni | 8,484743·10−9 | 8,484743·10−9 | 8,484743·10−9 | 3,9e−19 | ✓ |
| Örnek ayar, g2124: Holm | 8,484743·10−9 | 8,484743·10−9 | 8,484743·10−9 | 3,9e−19 | ✓ |
| Örnek ayar, g2124: BH | 8,484743·10−9 | 8,484743·10−9 | 8,484743·10−9 | 3,9e−19 | ✓ |
| Örnek ayar, g2124: maxT tek adım | 1,000000·10−4 | 1,000000·10−4 | 1,000000·10−4 | 0 | ✓ |
| Örnek ayar, g2124: maxT adım aşağı | 1,000000·10−4 | 1,000000·10−4 | 1,000000·10−4 | 0 | ✓ |
| Örnek ayar, g2124: minP tek adım | 0,1854 | 0,1854 | 0,1854 | 0 | ✓ |
| Örnek ayar, g2124: minP adım aşağı | 0,1854 | 0,1854 | 0,1854 | 0 | ✓ |
| Örnek ayar, g2124: Monte Carlo SH (maxT) | 9,999500·10−5 | 9,999500·10−5 | 9,999500·10−5 | 4,1e−20 | ✓ |
| Örnek ayar, g2939: istatistik | −7,5483478 | −7,5483478 | −7,5483478 | 2,4e−16 | ✓ |
| Örnek ayar, g2939: p parametrik | 1,707946·10−7 | 1,707946·10−7 | 1,707946·10−7 | 1,3e−18 | ✓ |
| Örnek ayar, g2939: Holm | 5,187033·10−4 | 5,187033·10−4 | 5,187033·10−4 | 3,9e−15 | ✓ |
| Örnek ayar, g2939: maxT tek adım | 0,001 | 0,001 | 0,001 | 0 | ✓ |
| Örnek ayar, g2939: maxT adım aşağı | 0,001 | 0,001 | 0,001 | 0 | ✓ |
| Örnek ayar, g808: istatistik | 6,78781948 | 6,78781948 | 6,78781948 | 1,6e−15 | ✓ |
| Örnek ayar, g808: Bonferroni | 0,02760506 | 0,02760506 | 0,02760506 | 3,0e−14 | ✓ |
| Örnek ayar, g808: BH | 3,000550·10−4 | 3,000550·10−4 | 3,000550·10−4 | 4,1e−16 | ✓ |
| Örnek ayar, g808: maxT tek adım | 0,004 | 0,004 | 0,004 | 0 | ✓ |
| Örnek ayar, g808: maxT adım aşağı | 0,004 | 0,004 | 0,004 | 0 | ✓ |
| Örnek ayar, g808: minP adım aşağı | 0,1854 | 0,1854 | 0,1854 | 0 | ✓ |
| Örnek ayar, 50. satır g1882: istatistik | −6,08499554 | −6,08499554 | −6,08499554 | 4,4e−16 | ✓ |
| Örnek ayar, 50. satır g1882: maxT adım aşağı | 0,0154 | 0,0154 | 0,0154 | 0 | ✓ |
| Örnek ayar, ret sayısı α = 0,01: maxT adım aşağı | 39 | 39 | 39 | 0 | ✓ |
| Örnek ayar, ret sayısı α = 0,05: p ham | 1048 | 1048 | 1048 | 0 | ✓ |
| Örnek ayar, ret sayısı α = 0,05: Bonferroni | 103 | 103 | 103 | 0 | ✓ |
| Örnek ayar, ret sayısı α = 0,05: Holm | 103 | 103 | 103 | 0 | ✓ |
| Örnek ayar, ret sayısı α = 0,05: BH | 695 | 695 | 695 | 0 | ✓ |
| Örnek ayar, ret sayısı α = 0,05: maxT tek adım | 91 | 91 | 91 | 0 | ✓ |
| Örnek ayar, ret sayısı α = 0,05: maxT adım aşağı | 92 | 92 | 92 | 0 | ✓ |
| Örnek ayar, ret sayısı α = 0,05: minP adım aşağı | 0 | 0 | 0 | 0 | ✓ |
| Örnek ayar, ret sayısı α = 0,2: maxT adım aşağı | 150 | 150 | 150 | 0 | ✓ |
| Örnek ayar, ret sayısı α = 0,2: minP adım aşağı | 123 | 123 | 123 | 0 | ✓ |
| Örnek ayar, ret sayısı α = 0,5: maxT adım aşağı | 236 | 236 | 236 | 0 | ✓ |
| Örnek ayar, ret sayısı α = 0,5: minP tek adım | 219 | 219 | 219 | 0 | ✓ |
| Tam sayım (Welch t), g13: istatistik | 3,37959287 | 3,37959287 | 3,37959287 | 1,8e−15 | ✓ |
| Tam sayım (Welch t), g13: p ham | 0,0021645 | 0,0021645 | 0,0021645 | 6,5e−17 | ✓ |
| Tam sayım (Welch t), g13: maxT tek adım | 0,36147186 | 0,36147186 | 0,36147186 | 4,4e−16 | ✓ |
| Tam sayım (Welch t), g13: maxT adım aşağı | 0,36147186 | 0,36147186 | 0,36147186 | 4,4e−16 | ✓ |
| Tam sayım (Welch t), g13: minP tek adım | 0,17965368 | 0,17965368 | 0,17965368 | 4,2e−16 | ✓ |
| Tam sayım (Welch t), g13: minP adım aşağı | 0,17965368 | 0,17965368 | 0,17965368 | 4,2e−16 | ✓ |
| Tam sayım (Welch t), g82: istatistik | 3,16605495 | 3,16605495 | 3,16605495 | 4,2e−16 | ✓ |
| Tam sayım (Welch t), g82: p ham | 0,01298701 | 0,01298701 | 0,01298701 | 1,2e−17 | ✓ |
| Tam sayım (Welch t), g82: maxT tek adım | 0,46320346 | 0,46320346 | 0,46320346 | 2,2e−16 | ✓ |
| Tam sayım (Welch t), g82: maxT adım aşağı | 0,46103896 | 0,46103896 | 0,46103896 | 0 | ✓ |
| Tam sayım (Welch t), g82: minP tek adım | 0,6038961 | 0,6038961 | 0,6038961 | 1,1e−16 | ✓ |
| Tam sayım (Welch t), g82: minP adım aşağı | 0,5995671 | 0,5995671 | 0,5995671 | 4,4e−16 | ✓ |
| Tam sayım (havuzlanmış t), g13: istatistik | 3,37959287 | 3,37959287 | 3,37959287 | 1,7e−15 | ✓ |
| Tam sayım (havuzlanmış t), g13: p ham | 0,0021645 | 0,0021645 | 0,0021645 | 6,5e−17 | ✓ |
| Tam sayım (havuzlanmış t), g13: maxT adım aşağı | 0,36147186 | 0,36147186 | 0,36147186 | 4,4e−16 | ✓ |
| Tam sayım (havuzlanmış t), g13: minP adım aşağı | 0,17965368 | 0,17965368 | 0,17965368 | 4,2e−16 | ✓ |
| Tam sayım (Wilcoxon), g13: istatistik | 2,88230677 | 2,88230677 | 2,88230677 | 7,7e−16 | ✓ |
| Tam sayım (Wilcoxon), g13: p ham | 0,0021645 | 0,0021645 | 0,0021645 | 6,5e−17 | ✓ |
| Tam sayım (Wilcoxon), g13: maxT adım aşağı | 0,17965368 | 0,17965368 | 0,17965368 | 4,2e−16 | ✓ |
| Tam sayım (Wilcoxon), g13: minP adım aşağı | 0,17965368 | 0,17965368 | 0,17965368 | 4,2e−16 | ✓ |
| Tam sayım (tek yönlü, üst), g13: p ham | 0,00108225 | 0,00108225 | 0,00108225 | 8,2e−17 | ✓ |
| Tam sayım (tek yönlü, üst), g13: maxT adım aşağı | 0,20779221 | 0,20779221 | 0,20779221 | 1,9e−16 | ✓ |
| Tam sayım (tek yönlü, üst), g13: minP adım aşağı | 0,09199134 | 0,09199134 | 0,09199134 | 1,4e−17 | ✓ |
| Eksik veri (Welch t, tam sayım), g5: istatistik | −3,15215114 | −3,15215114 | −3,15215114 | 1,3e−15 | ✓ |
| Eksik veri (Welch t, tam sayım), g5: p ham | 0,02380952 | 0,02380952 | 0,02380952 | 1,0e−17 | ✓ |
| Eksik veri (Welch t, tam sayım), g5: maxT adım aşağı | 0,47835498 | 0,47835498 | 0,47835498 | 4,4e−16 | ✓ |
| Eksik veri (Welch t, tam sayım), g5: minP adım aşağı | 0,78354978 | 0,78354978 | 0,78354978 | 4,4e−16 | ✓ |
| Eksik veri (Welch t, tam sayım), g63: istatistik | −1,24156117 | −1,24156117 | −1,24156117 | 1,6e−15 | ✓ |
| Eksik veri (Welch t, tam sayım), g63: p ham | 0,25324675 | 0,25324675 | 0,25324675 | 2,2e−16 | ✓ |
| Rastgele permütasyon (küçük veri, B = 1000), g13: p ham | 0,003 | 0,003 | — | 0 | ✓ |
| Rastgele permütasyon (küçük veri, B = 1000), g13: maxT adım aşağı | 0,374 | 0,374 | — | 0 | ✓ |
| Rastgele permütasyon (küçük veri, B = 1000), g13: minP adım aşağı | 0,139 | 0,139 | — | 0 | ✓ |
| Bootstrap (havuzlanmış t, B = 2000), g13: p ham | 0,007 | 0,007 | — | 0 | ✓ |
| Bootstrap (havuzlanmış t, B = 2000), g13: maxT tek adım | 0,2125 | 0,2125 | — | 0 | ✓ |
| Bootstrap (havuzlanmış t, B = 2000), g13: maxT adım aşağı | 0,2125 | 0,2125 | — | 0 | ✓ |
| Bootstrap (havuzlanmış t, B = 2000), g13: minP adım aşağı | 0,24337831 | 0,24337831 | — | 3,1e−16 | ✓ |
| Bootstrap (parametrik minP), g82: maxT adım aşağı | 0,2835 | 0,2835 | — | 0 | ✓ |
| Bootstrap (parametrik minP), g82: minP adım aşağı | 0,2835 | 0,2835 | — | 0 | ✓ |
Ölçütü karşılayan: 74/74. Python: tanımların doğrudan uygulaması (ham veriden istatistik, itertools ile tam sayım, R'nin üretecinin Python'daki yeniden kuruluşuyla aynı permütasyon ve bootstrap çekilişleri). R: tam sayımda multtest::mt.maxT ve mt.minP (adım aşağı) ile combn üzerinde açık döngü (tek adımlı); örnek ayarda aynı tohumla sample.int, matrixStats ile açık Welch formülü; analitik düzeltmeler p.adjust. Örnek ayarda 3051 genin on sütununun tamamında iki bağımsız hesapla en büyük fark 1,2·10−11 büyüklüğündedir (göreli; satir_sayisi = 0 çalıştırması).
Rastgele yeniden örnekleme içeren satırlardaki eşitlik, aynı tohumla aynı dizilimlerin üretilmesine dayanır; dizilimler üç ayrı kodda bağımsız olarak işlenmiştir. Farklı bir üreteçle aynı tanım Monte Carlo hatası kadar ayrışır: multtest kendi üreteciyle B=10000 kullandığında α = 0,05'te 91, α = 0,01'de 39 gen reddeder (şablon 92 ve 39); 3051 genin adım aşağı maxT değerlerinde en büyük fark 0{,}0104'tür. Eksik değerli veride Welch t sonuçları multtest ile aynıdır; Wilcoxon istatistiği ise eksik değerli değişkenlerde multtest'inkinden ayrışır (g5: şablon -2{,}0083, multtest -2{,}2418). Şablonun değeri, eksik olmayan 11 gözlemin sıralarından 54.4.1'deki formülle elle bulunan değerdir: AML sıra toplamı 25, beklenen 6\times12/2=36, varyans 6\times5\times12/12=30, T=(25-36)/\sqrt{30}=-2{,}0083.
54.7 Çıktıyı okuma
Örnek ayarın konsol metni (uzun satırlar bölünmüş, uyarı ve son iki satır kısaltılmıştır):
Gruplar: ALL (n = 27) ve AML (n = 11); 3051 sonuç değişkeni; istatistik: Welch t (AML − ALL);
  rastgele permütasyon, B = 10000 (gözlenen dahil), tohum 20261104.
minP (yeniden örnekleme tabanı): ulaşılabilir en küçük düzeltilmiş p değeri 0,1854
  (B = 10000, 3051 değişken).
Uyarı: ulaşılabilir en küçük minP değeri (0,1854) α = 0,05'den büyük; bu tabanda minP ile
  bu α düzeyinde hiçbir hipotez reddedilemez. B'yi büyütmek yetmez … parametrik tabanı seçin …
α = 0,05 düzeyinde reddedilen: ham p 1048, Bonferroni 103, Holm 103, adım aşağı maxT 92,
  adım aşağı minP 0; BH (FDR) 695.
maxT ve minP aile boyu hata oranını (FWER) güçlü biçimde denetler ve testler arasındaki …
Monte Carlo standart hatası p(1 − p)/B'nin kareköküdür; B = 10000 için en çok 0,0050.
Ana tablonun ilk sekiz satırı (iki parça hâlinde; yuvarlanmış):
degisken istatistik p_parametrik  p_ham Bonferroni      Holm        BH
   g2124    10.5777    2.781e-12 0.0001  8.485e-09 8.485e-09 8.485e-09
    g829     9.7758    2.279e-08 0.0001  6.954e-05 6.945e-05 1.391e-05
    g896     8.0329    1.537e-09 0.0001  4.689e-06 4.687e-06 2.344e-06
    g766     7.9833    1.577e-08 0.0001  4.813e-05 4.808e-05 1.203e-05
   g2600     7.9655    8.424e-09 0.0001  2.570e-05 2.568e-05 8.567e-06
   g2939    -7.5483    1.708e-07 0.0001  5.211e-04 5.187e-04 3.474e-05
   g1995    -7.4159    8.349e-07 0.0001  2.547e-03 2.523e-03 7.546e-05
   g2386    -7.3481    5.924e-08 0.0001  1.807e-04 1.803e-04 2.206e-05

degisken maxT_tek maxT_adim minP_tek minP_adim MC_SH_maxT
   g2124   0.0001    0.0001   0.1854    0.1854     0.0001
    g829   0.0001    0.0001   0.1854    0.1854     0.0001
    g896   0.0003    0.0003   0.1854    0.1854     0.0002
    g766   0.0003    0.0003   0.1854    0.1854     0.0002
   g2600   0.0003    0.0003   0.1854    0.1854     0.0002
   g2939   0.0010    0.0010   0.1854    0.1854     0.0003
   g1995   0.0013    0.0013   0.1854    0.1854     0.0004
   g2386   0.0015    0.0015   0.1854    0.1854     0.0004
Ret tablosu (ilk yedi satır):
Reddedilen hipotez sayısı (p ≤ α)
alfa  p_parametrik  p_ham  Bonferroni  Holm    BH  maxT_tek  maxT_adim  minP_tek  minP_adim
0.01           663    639          67    67   382        39         39         0          0
0.05          1078   1048         103   103   695        91         92         0          0
0.10          1334   1317         125   127   934       118        120         0          0
0.20          1679   1657         148   149  1251       150        150       123        123
0.30          1913   1896         163   163  1503       177        178       123        123
0.40          2108   2089         180   182  1756       200        201       172        172
0.50          2277   2265         190   194  1937       233        236       219        219
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| minP satırı ve uyarı | minP'nin yeniden örnekleme tabanında ulaşabileceği en küçük düzeltilmiş p; \alpha'dan büyükse uyarı | Taban \alpha'dan büyükse minP bu \alpha'da hiçbir hipotezi reddedemez; sütun "0" ret yazar ama bu "fark yok" anlamına gelmez. Parametrik tabanda bu satır yazılmaz. |
| Özet satırı | Düzeyler ve büyüklükleri, sınanan değişken sayısı, istatistik ve yönü, yeniden örnekleme türü, B, tohum | Önce değişken sayısına ve "(AML − ALL)" yönüne bakılır. Tam sayımda "tam permütasyon sayımı, B = …" yazar. |
istatistik |
Gözlenen T (ikinci − birinci düzey) | İşaret yönü verir: pozitif, ikinci düzeyde daha yüksek. |
p_parametrik, p_ham |
Düzeltilmemiş p: kuramsal dağılımdan ve yeniden örneklemeden | Tek başına karar için kullanılmaz; p_ham en az 1/B'dir (permütasyon). |
Bonferroni, Holm, BH |
Parametrik p'nin analitik düzeltmeleri | İlk ikisi FWER, BH FDR. |
maxT_tek, maxT_adim |
Tek adımlı ve adım aşağı maxT düzeltilmiş p | Karar sütunu maxT_adim'dir: ≤ α ise hipotez FWER = α düzeyinde reddedilir. |
minP_tek, minP_adim |
Tek adımlı ve adım aşağı minP düzeltilmiş p | Önce sütunun en küçük değerine bakılır; α'dan büyükse yöntem bu B ile karar veremez (54.4.5). |
MC_SH_maxT |
Adım aşağı maxT'nin Monte Carlo standart hatası | \tilde p\mp2\operatorname{SH} aralığı α'yı içeriyorsa karar B'ye duyarlıdır; B artırılır. |
| Ret tablosu | Her α düzeyinde her yöntemin ret sayısı | Yöntemlerin sertliğini yan yana gösterir. p_parametrik ve p_ham sütunları düzeltmesiz sayımlardır. |
Örnek veride 3051 genin 1048'i düzeltmesiz 0,05 düzeyinde "anlamlı"dır; hiçbir fark olmasaydı yaklaşık 153 gen beklenirdi. FWER denetimiyle sayı 92'ye (maxT) ya da 103'e (Holm) iner; FDR denetimiyle 695'tir. Bu üç sayı üç ayrı soruyu yanıtlar: 92 genin hiçbirinin yanlış pozitif olmadığına %95 güvenilir; 695 genin ise yaklaşık %5'inin yanlış pozitif olması beklenir.
Şekil 54.1. Şablonun birinci şekli (örnek ayar): düzeltilmiş p değerleri küçükten büyüğe sıralanmış, yatay eksen sıra numarasıdır. Bir eğrinin kesikli yatay çizgiyi (α = 0,05) kestiği yer, o yöntemin reddettiği hipotez sayısıdır. Ham ve BH eğrileri yatay eksene yapışıktır (yüzlerce ret); Bonferroni ve adım aşağı maxT 100 dolayında yükselir; minP eğrisi 0,1854'ten başlar ve çizgiye hiç inmez.
Şekil 54.2. Şablonun ikinci şekli: 10000 dizilimde 3051 genin en büyük \lvert T^{*}\rvert değerinin dağılımı. Kesikli çizgi dağılımın %95 yüzdeliğidir (5,54): tek adımlı maxT'nin kritik değeri. Alt kenardaki çizgiler gözlenen en büyük 30 değerdir; hepsi kritik değerin sağındadır.
Rapor cümlesi (örnek ayar):
ALL (n = 27) ve AML (n = 11) hastaları 3051 genin ifade düzeyi bakımından Welch t istatistiğiyle karşılaştırıldı. Çoklu test düzeltmesi, aile boyu hata oranını denetleyen Westfall-Young adım aşağı maxT yöntemiyle, grup etiketlerinin 10 000 permütasyonu (gözlenen dahil) üzerinden yapıldı. Düzeltilmiş p ≤ 0,05 ölçütüyle 92 gen iki grup arasında farklı bulundu (α = 0,01'de 39 gen); en güçlü fark g2124 genindeydi (t = 10,58; düzeltilmiş p = 0,0001). Karşılaştırma için, parametrik p değerlerine uygulanan Holm düzeltmesi 103, Benjamini-Hochberg yanlış keşif oranı düzeltmesi 695 gen verdi.
54.8 Sık hatalar ve tuzaklar
- Örnek ayarda minP sütununu karar için okumak. Çok değişkenli veride yeniden örnekleme tabanlı minP'nin en küçük değeri α'nın üstünde kalır (örnek veride 0,1854) ve "adım aşağı minP 0" yazılır. Bu, fark olmadığı anlamına gelmez; yöntemin bu B ile çözünürlüğü yetmemektedir. Şablon bu tabanı çıktıda yazar ve \alpha'yı aşıyorsa uyarır. Karar maxT'den verilir ya da parametrik taban seçilir.
- B'yi büyüterek minP'yi kurtarmaya çalışmak. B\times m 31 milyon hücreyi aşınca minP hiç hesaplanmaz ve sütunları tablodan çıkar (örnek veride B=100000 ile yalnız maxT verilir). Çok değişkenli veride yeniden örnekleme tabanlı minP'nin gerektirdiği B bellek sınırının ötesindedir.
- Bootstrap ile yeniden örnekleme tabanlı minP'nin gücünü yüksek sanmak. Bootstrap'ta ham p 0 olabilir; minP için gözlenen örnek kümeye eklendiğinden bu değişkenlerin minP değeri artık 0 yazılmaz, ama taban yine yüksektir: örnek veride (B=2000) ham p'si 0 olan 223 gen vardır ve minP'nin ulaşabileceği en küçük değer 0,4098'dir; α = 0,05'te de 0,01'de de "minP 0" yazılır ve çıktı bunu uyarıyla bildirir. Aynı çalıştırmada maxT 36 ve 96, parametrik tabanlı minP 21 ve 76 gen reddeder. Bootstrap seçildiğinde minP için
minp_tabani = parametrikkullanılır. - Tek yönlü sınamada "ikinci grup"u varsaymak. İkinci grup, MerQuR+ düzey sırasında (kullanıcı sırası; yoksa sayısal sıra; yoksa verideki ilk görülme) ikinci olandır; R'nin yerel ayara bağlı alfabetik sırası kullanılmaz. Özet satırındaki "(… − …)" ifadesi her zaman okunur. Küçük veride gruplar 2 ve 10 olarak kodlandığında düzey sırası 2, 10 olur, istatistik "10 − 2" olur ve ALL/AML etiketleriyle aynı yönü (AML − ALL) sınar (aynı gen için ham p 0{,}0714).
- Aileyi denetlemeden "bütün sayısal sütunlar"ı kullanmak. Kimlik numarası, yaş ya da tarih gibi sütunlar aileye girerse hem anlamsız birer test eklenir hem de öteki değişkenlerin düzeltilmiş p değerleri değişir. Veri sekmesinde "kategorik" türde duran ama değerleri sayı olan sütunlar da aileye alınır (adlarıyla bildirilir); bir kimlik ya da kod sütunu bu türdeyse sonuç değişkeni listesi elle verilir. Özet satırındaki değişken sayısı denetlenir.
- Analitik ve yeniden örneklemeli sütunları aynı ham p'den türemiş sanmak. Bonferroni, Holm ve BH parametrik p'ye; maxT ve minP yeniden örneklemeye dayanır. Örnek veride Bonferroni'nin (110) maxT'den (92) fazla ret vermesi, Bonferroni'nin daha güçlü olduğunu değil, parametrik p değerlerinin permütasyon dağılımının öngördüğünden daha küçük olduğunu gösterir (54.9, S1).
- Düzeltilmiş p'yi yeniden düzeltmek.
maxT_adimdoğrudan α ile karşılaştırılır; ayrıca değişken sayısına bölünmez ya da çarpılmaz. - Küçük gruplarda tam sayımın sınırını unutmak. 6'ya 6 karşılaştırmada 924 dizilim vardır ve iki yönlü ham p en az 2/924=0{,}0022'dir; birkaç yüz değişkenlik bir ailede FWER denetimiyle ret neredeyse olanaksızdır. 4'e 4'te (70 dizilim) en küçük ham p 0{,}029'dur.
- Eşiğe yakın sonuçları tek çalıştırmayla kesin saymak. Düzeltilmiş p değeri 0{,}05 çevresindeki genlerde Monte Carlo standart hatası 0{,}002'dir (B=10000); eşiğin iki yanındaki birkaç gen tohuma göre yer değiştirir (örnek veride B=10000 ile 92, B=100000 ile yine 92; α = 0,10'da 120 ve 117).
- Bağımlı gözlemlerde etiket karıştırmak. Aynı hastadan birden çok örnek ya da teknik yineleme varsa satırlar değiştirilebilir değildir; etiketler hasta düzeyinde karıştırılmalıdır. Şablon satırları bağımsız sayar.
54.9 Uzman soruları
S1. Golub verisinde Bonferroni (110) neden maxT'den (92) çok hipotez reddediyor? Yeniden örnekleme daha güçlü değil miydi?
İki sütun aynı ham p değerinden yola çıkmaz. Bonferroni, Welch-Satterthwaite t dağılımından gelen parametrik p'ye uygulanır; bu p değerleri 10^{-12}'ye kadar iner. maxT ise permütasyon dağılımını kullanır; 27'ye 11 gibi dengesiz gruplarda Welch istatistiğinin permütasyon dağılımı t dağılımından ağır kuyruklu olabilir; bu veride düzeltmesiz 0,05 düzeyinde parametrik p 1078, permütasyon p 1048 gen verir. "Bağımlılığı kullanma" kazancı ancak aynı ham p üzerinden görülür: Bonferroni permütasyon ham p'sine uygulansaydı en küçük değer 3051\times0{,}0001=0{,}305 olur ve hiçbir gen reddedilmezdi; maxT aynı permütasyonlardan 92 gen çıkarır. 16 gen yalnız Bonferroni'de, 5 gen yalnız maxT'de reddedilir. Parametrik p'ye güvenip güvenmemek ayrı bir karardır: maxT sonucu normallik ve serbestlik derecesi yaklaşımına dayanmaz.
S2. minP neden 0,1854'ün altına inemiyor ve bu hesaplanabilir mi?
Yeniden örnekleme tabanında bir dizilimde bir genin p değeri, o genin B değeri içindeki sırasıdır; en uç değeri aldığı dizilimde 1/B'dir. m gen bağımsız olsaydı bir dizilimde hiçbirinin kendi en ucunda olmama olasılığı (1-1/B)^m olurdu: m=3051, B=10000 için 0{,}737; yani dizilimlerin %26'sında en küçük p 1/B olurdu. Genler ilişkili olduğundan aynı dizilim birçok genin en ucu olur ve oran %18,5'e iner (bağımsız hesap: 1854 dizilim). Şablon bu tabanı çıktıda yazar (örnek ayarda 0,1854) ve \alpha'dan büyükse uyarır. Taban m/B oranıyla büyür; bağımsızlık yaklaşımıyla α = 0,05'in altına inmesi için B'nin m'nin yaklaşık yirmi katını aşması gerekir. Ge, Dudoit ve Speed (2003) bu nedenle minP için çok büyük B ve özel bir depolama algoritması önerir.
S3. Welch t ile permütasyon birlikte tutarlı mı? Varyanslar farklıysa etiketler değiştirilebilir değildir.
Permütasyonun kesinliği, sıfır hipotezinin "iki dağılım aynıdır" olmasına dayanır; bu durumda varyanslar da eşittir ve Welch ile havuzlanmış t aynı sıfır hipotezini sınar. Sıfır hipotezi yalnız "ortalamalar eşit" ise ve varyanslar gerçekten farklıysa etiket permütasyonu yaklaşık bir testtir. Welch istatistiği bu durumda havuzlanmış t'den daha dayanıklıdır: studentleştirilmiş istatistiğin permütasyon dağılımı asimptotik olarak doğru dağılıma yakınsar. Örnek veride iki istatistik benzer sonuç verir: adım aşağı maxT ile α = 0,05'te Welch 92, havuzlanmış t 94 gen; α = 0,01'de 39 ve 54. Varyans farkı kaygısı büyükse bootstrap seçeneği grup içi varyansları koruyan sıfır dağılımını kullanır (örnek veride 96 gen).
S4. Tek adımlı ve adım aşağı maxT arasındaki fark neden bu kadar küçük?
Adım aşağı kazancı, reddedilen hipotezlerin sıfır dağılımından çıkarılmasından gelir. 3051 genin yaklaşık yüzü reddediliyorsa geriye kalan 2950 genin en büyük değeri, 3051 genin en büyük değerinden çok az küçüktür. Örnek veride ret sayıları 91 ve 92'dir; küçük veride g82 için sayım 428'den 426'ya iner. Kazanç, hipotezlerin büyük bölümü yanlış olduğunda ya da aile küçük olduğunda belirginleşir (ör. 10 sonlanımın 6'sı farklıysa). Adım aşağı değer hiçbir zaman tek adımlıdan büyük değildir; karar için her zaman o kullanılır.
S5. Sonuçlar multtest paketiyle aynı mı?
Tanım aynıdır. Tam sayımda (924 dizilim) Welch t, havuzlanmış t ve Wilcoxon için istatistikler, ham p, adım aşağı maxT ve adım aşağı minP mt.maxT ve mt.minP ile 10^{-15} düzeyinde aynıdır (doğrulama tablosu). Rastgele permütasyonda üreteçler farklıdır; B=10000 ile multtest α = 0,05'te 91, şablon 92 gen reddeder ve düzeltilmiş p değerleri en çok 0{,}0104 ayrışır (iki bağımsız Monte Carlo kestiriminin farkı için beklenen büyüklük). İki ayrım: eksik değerli değişkenlerde Wilcoxon istatistiği multtest'inkinden farklıdır, şablon 54.4.1'deki formülü eksik olmayan gözlemlere uygular; ve şablon tek adımlı düzeltmeleri de verir.
S6. Tam sayımda ham p neden 1/924 değil de 2/924'ten başlıyor?
İki grup eşit büyüklükteyse her ayrımın bir tümleyeni vardır: aynı iki küme, etiketleri değişmiş olarak. Tümleyen ayrımda T işaret değiştirir, \lvert T\rvert aynı kalır. İki yönlü sınamada gözlenen ayrım ve tümleyeni birlikte sayılır; en küçük ham p 2/\binom{n}{n_1}'dir. Tek yönlü sınamada tümleyen ters uçtadır ve en küçük p 1/924'tür. Şablon uçluk değerlerini 12 anlamlı basamağa yuvarladığı için tümleyen ayrım, yuvarlama hatası yüzünden "biraz küçük" sayılıp atlanmaz.
S7. FWER yerine FDR kullanmalı mıyım?
Sorunun ne olduğuna bağlıdır. FWER "listemde tek bir yanlış bile olmasın" der; doğrulama deneyi pahalıysa, bulgu doğrudan karara dönüşecekse (tanı belirteci, ruhsat sonlanımı) uygundur. FDR "listemin en çok %5'i yanlış olsun" der; keşif amaçlı taramada, izleyen bir doğrulama aşaması varsa uygundur. Örnek veride FWER 92, FDR 695 gen verir. Şablon FDR'yi yalnız parametrik p'nin BH düzeltmesi olarak, karşılaştırma için verir; yeniden örneklemeli bir FDR yöntemi içermez. Asıl amaç FDR ise temel programdaki Çoklu Karşılaştırma Düzeltme kullanılır.
S8. Eksik değerler nasıl ele alınıyor; satır mı siliniyor?
Hayır. Grup değeri eksik satırlar atılır; sonuç değişkenlerindeki eksikler ise hücre düzeyinde ele alınır: her değişkenin istatistiği, o değişkende gözlemi olan birimlerden hesaplanır ve grup büyüklükleri değişkene özgüdür. Bir yeniden örneklemede eksik hücre hangi gruba düşerse o grubun büyüklüğü bir azalır; bir grupta ikiden az gözlem kalırsa o dizilimde değişkenin uçluğu "en az uç" sayılır. Bir grubunda baştan ikiden az gözlemi olan değişkenler aileden çıkarılır ve adları yazılır. Değişkenlerin sıfır dağılımları eksik sayısına göre farklılaştığından eksikli veride minP'nin (parametrik tabanla) dengeleyici etkisi daha anlamlıdır.
S9. Bootstrap seçeneğinde sıfır dağılımı nasıl "sıfır" oluyor?
Grup ortalamaları çıkarılarak. Arındırılmış veride iki grubun her değişkendeki ortalaması tam sıfırdır; bu havuzdan çekilen iki sözde grubun ortalama farkının beklenen değeri de sıfırdır. Değişkenlerin varyansları ve aralarındaki ilişki arındırmadan etkilenmez ve sıfır dağılımına taşınır. Permütasyondan farkı: çekilen satırlar iki özgün grubun karışımıdır ve yerine koyarak seçilir; gözlenen örnek dağılımın bir üyesi değildir. Bu yüzden bootstrap p değerleri 0 olabilir ve yöntemin geçerliliği büyük örneklem yaklaşımına dayanır. Örnek veride B=2000 bootstrap ile adım aşağı maxT α = 0,05'te 96 gen reddeder (permütasyon 92).
S10. Kaç yeniden örnekleme gerekir?
maxT için ölçüt, α çevresindeki düzeltilmiş p değerlerinin Monte Carlo hatasıdır: \sqrt{\alpha(1-\alpha)/B}. α = 0,05 ve B=10000 için 0{,}0022; eşiğe bu kadar yakın genlerin kararı tohuma bağlıdır. Örnek veride B=10000 ve B=100000 çalıştırmaları α = 0,05'te aynı sayıyı (92), α = 0,01'de 39 ve 38'i verir. Ulaşılabilir en küçük düzeltilmiş p 1/B'dir; α = 0,001 düzeyinde karar verilecekse B en az 10 000, tercihen 100 000 seçilir. Olası dizilim sayısı küçükse tam sayım hem daha hızlı hem kesindir.
54.10 Kaynaklar
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Dudoit, S., Shaffer, J. P., & Boldrick, J. C. (2003). Multiple hypothesis testing in microarray experiments. Statistical Science, 18(1), 71–103. https://doi.org/10.1214/ss/1056397487
- Ge, Y., Dudoit, S., & Speed, T. P. (2003). Resampling-based multiple testing for microarray data analysis. TEST, 12(1), 1–77. https://doi.org/10.1007/BF02595811
- Golub, T. R., Slonim, D. K., Tamayo, P., Huard, C., Gaasenbeek, M., Mesirov, J. P., Coller, H., Loh, M. L., Downing, J. R., Caligiuri, M. A., Bloomfield, C. D., & Lander, E. S. (1999). Molecular classification of cancer: Class discovery and class prediction by gene expression monitoring. Science, 286(5439), 531–537. https://doi.org/10.1126/science.286.5439.531
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70.
- Phipson, B., & Smyth, G. K. (2010). Permutation P-values should never be zero: Calculating exact P-values when permutations are randomly drawn. Statistical Applications in Genetics and Molecular Biology, 9(1), Article 39. https://doi.org/10.2202/1544-6115.1585
- Pollard, K. S., Dudoit, S., & van der Laan, M. J. (2005). Multiple testing procedures: The multtest package and applications to genomics. In R. Gentleman, V. J. Carey, W. Huber, R. A. Irizarry, & S. Dudoit (Eds.), Bioinformatics and computational biology solutions using R and Bioconductor (pp. 249–271). Springer. https://doi.org/10.1007/0-387-29362-0_15
- R Core Team. (2026). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Welch, B. L. (1947). The generalization of 'Student's' problem when several different population variances are involved. Biometrika, 34(1–2), 28–35. https://doi.org/10.1093/biomet/34.1-2.28
- Westfall, P. H., & Young, S. S. (1993). Resampling-based multiple testing: Examples and methods for p-value adjustment. Wiley.