106. Markov rejim değiştirme regresyonu (R)
Şablon kimliği: markov_rejim · Kategori: zaman serisi · Dil: R · Dosya: pro/sablonlar/zaman_serisi/markov_rejim.R (satır 1–321; üstbilgi 1–107) · Örnek veri: _ornek/usmacro.csv · Paketler: R 4.5.3, numDeriv 2016.8-1.1 · Python eşi: Bölüm 107
106.1 Ne işe yarar
Şablon, bir zaman serisinin ilişkisinin zaman içinde gizli bir durum (rejim) tarafından değiştirildiği durumda regresyonu kestirir. Cevapladığı soru şudur: "Yanıtın kesişimi, açıklayıcılarının ve gecikmesinin katsayıları (isteğe bağlı olarak hata varyansı) iki ya da üç farklı değer takımı arasında geçiş yapıyorsa, her dönemde hangi takım geçerliydi ve rejimler ne kadar kalıcıdır?" Rejimleri gözlenen bir değişken değil, Markov zinciri olarak varsayılan gizli bir s_t\in\{1,\dots,k\} belirler:
Olabilirlik Hamilton'ın (1989) süzgeciyle kurulur, rejim olasılıkları Kim'in (1994) düzgünleştiricisiyle üretilir ve en çok olabilirlik kestirimi çok başlangıçlı sayısal en büyükleme ile bulunur. Sonuç; rejime göre katsayılar, hata standart sapması, k\times k geçiş olasılıkları matrisi, beklenen rejim süreleri ve her dönem için rejim olasılıklarıdır.
Ne zaman kullanılır?
- Faiz, enflasyon, büyüme ya da talep gibi bir serinin "durgun/hareketli" ya da "düşük/yüksek" dönemlere ayrıştığından kuşkulanıldığında ve dönem sınırlarının önceden bilinmediği durumlarda.
- Rejimin süresi ve kalıcılığı da soruysa (beklenen süre 1/(1-p_{ii})).
- Açıklayıcı katsayılarının rejime göre değişmesi bir hipotezse (örnekte çıktı açığının ve enflasyonun faiz üzerindeki etkisi).
Ne zaman kullanılmaz?
- Kırılma tarihi biliniyor ya da kırılma sayısı az ve kalıcıysa: Bölüm 112
yapisal_kirilma(ve Python eşi Bölüm 113); kırılmalı birim kök sınaması için Bölüm 105kirilmali_birim_kok. - Rejimi gözlenen bir eşik değişkeni belirliyorsa (gizli zincir yok): Bölüm 100
esik_ar. - Değişen şey oynaklıksa ve ortalama denklemi sabitse: Bölüm 102
garch_genis; çok değişkenli oynaklık ilişkisi için Bölüm 98dcc_garch. - Ortalamanın kendisi rejime göre değişen Hamilton AR'si isteniyorsa (gecikmelerin ortalamadan sapma olarak girdiği biçim): şablon böyle bir model kestirmez; yanıt gecikmeleri yalnız açıklayıcıdır ve katsayıları da rejime göre değişir (106.4.1). Daha genel durum-uzay kurulumu için Bölüm 99
durum_uzay_genel. - Seri kısaysa (n<\max(30,\,3\cdotparametre sayısı)) ya da rejimler gözlemle ayrışmıyorsa (106.8).
- Rejim sayısını bir olabilirlik oranı sınamasıyla seçmek isteniyorsa: bu sınamanın olağan \chi^2 dağılımı geçerli değildir (106.9, S5); şablon böyle bir sınama sunmaz.
Temel programla ilişki. Temel programda rejim değiştirme regresyonu yoktur; kırılma ve eşik modelleri de farklı şablonlardadır. Bu şablon yalnız MerQuR+'ta bulunur; doğrulama bu nedenle bağımsız Python ve R hesaplarıyla yapılmıştır (106.6).
106.2 Şablonun girdileri
Form, üstbilgideki 13 [[param]] bloğundan kurulur (markov_rejim.R:10–106). Türlerin ve formun ortak denetiminin anlamı Bölüm 1.2'de anlatılmıştır.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Yanıt · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | y_t; zaman sırasında olmalıdır (10–14, 114). |
Açıklayıcılar · x |
sütunlar (sayısal, isteğe bağlı) · Değişkenler | boş | sayısal sütunlar | Katsayıları rejime göre değişir; y ve zaman listeden sessizce çıkarılır (15–21, 112, 115–116). |
Yanıtın gecikme sayısı · gecikme |
tamsayı · Model | 0 | 0–4 | y_{t-1},\dots,y_{t-L} açıklayıcı olarak eklenir; ilk L satır düşer (22–29, 117–122). |
Rejim sayısı · k |
tamsayı · Model | 2 | 2–3 | k (30–37, 113). |
Hata varyansı da değişsin · degisken_varyans |
onay · Model | kapalı | açık/kapalı | Açıksa k ayrı \sigma_j^2, kapalıysa ortak \sigma^2 (38–43, 153). |
Zaman etiketi · zaman |
sütun (isteğe bağlı) · Değişkenler | boş | herhangi sütun | Etiket; seçiliyse artan ve tekil olması denetlenir (44–49, 111, 123–141, 308, 318). |
Başlangıç noktası sayısı · baslangic |
tamsayı · Gelişmiş | 10 | 1–50 | BFGS'nin başlatıldığı nokta sayısı (50–57, 211–221). |
Güven düzeyi (%) · guven |
ondalık · Seçenekler | 95 | 50–99,9 | Katsayı GA'sı \hat\beta\pm z_{1-\alpha/2}\mathrm{SH} (58–65, 158, 275–280). |
Rastgele başlangıç tohumu · tohum |
tamsayı · Gelişmiş | 1 | 0–2147483647 | set.seed(tohum) (66–74, 159, 202). |
En çok yineleme · en_cok_yineleme |
tamsayı · Gelişmiş | 2000 | 10–100000 | Her BFGS çalıştırmasının maxit değeri (75–82, 160, 223, 225). |
Yakınsama toleransı · tolerans |
ondalık · Gelişmiş | 10^{-14} | 10^{-16}–10^{-4} | İkinci BFGS reltol = tolerans; ilki 100\times; nlminb \text{tolerans}/10 (83–91, 161, 223–232). |
BFGS sonrası nlminb · nlminb_incelt |
onay · Gelişmiş | açık | açık/kapalı | En iyi çözümü nlminb ile inceltir (92–97, 162, 232–236). |
Hessian başlangıç adımı · hessian_adim |
ondalık · Gelişmiş | 0,001 | 10^{-6}–0,1 | numDeriv::hessian d değeri; SH'leri etkiler (98–106, 163, 255). |
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 110 |
| Tam gözlem sayısı n<\max(30,\,3\,\text{npar}) | "Tam gözlem sayısı (n) … parametre için çok az; en az … gerekli." | 155 |
| Yanıt sabit | "Yanıt sabit." | 156 |
Açıklayıcılar sabit ya da doğrusal bağımlı (qr(X)$rank < p) |
"Açıklayıcılar sabit ya da doğrusal bağımlı; birini çıkarın." | 157 |
zaman sütunu artan değil ya da tekrar eden dönem içeriyor |
"'…' zaman sütunu artan sırada değil ya da tekrar eden dönem içeriyor (ilk sorun: …)…" | 136, 139 |
| Serinin ortasında eksik gözlem (ilk ve son tam satır arasında tam olmayan satır) | "Serinin ortasında eksik gözlem var (… satır; ilk: …)…" | 146 |
| Hiçbir başlangıçtan sonlu (ve değişken varyansta dejenere olmayan) olabilirlik elde edilemedi | "Olabilirlik en büyüklenemedi (rejimler ayrışmıyor olabilir); rejim sayısını azaltın." ya da, hepsi dejenereyse, "Her başlangıç dejenere bir çözüme … vardı; …" | 231 |
| Hessian tersine çevrilemedi ya da köşegeni geçersiz | Uyarı: "Hessian tersine çevrilemedi; standart hatalar verilemiyor…"; SH sütunları NA, çalıştırma sürer |
266–267 |
Parametre sayısı \text{npar}=k(k-1)+k\,p+n_v'dir; p kesişim dahil sütun sayısı, n_v=k (değişken varyans) ya da 1'dir (154). Örnekte k=2, p=4, n_v=1 olduğundan \text{npar}=2+8+1=11 ve alt sınır \max(30{,}33)=33'tür. Zaman sütunu seçili değilse etiket olarak gözlem sırası (1, 2, …) kullanılır (123). Seçiliyse sütun artan ve tekil olmalıdır (125–141): Tarih ya da sayı sütunu, 2010Q4 ya da 1954-07 gibi yıl-dönem metni (yıl·100 + dönem anahtarıyla) ya da sayıya çevrilebilen metin olarak çözümlenirse sıra denetlenir; artmayan ya da tekrar eden dönem çalıştırmayı durdurur, çözümlenemeyen etiketlerde yalnız tekrar aranır ve sıranın eskiden yeniye olduğu varsayıldığı bir not yazılır. Atlanmış dönemler (eksik satır) frekans bilinmediğinden bu denetimde aranmaz; ortadaki eksik gözlemler ayrıca denetlenir (aşağıda).
Tohum. Kod panelinin araç çubuğundaki Tohum alanı (Bölüm 1.3) bu şablonun başlangıç noktalarını etkilemez: şablon 202. satırda set.seed(tohum) ile kendi form değerini yeniden kurar. Sonucu yinelenebilir kılan, formdaki "Rastgele başlangıç tohumu"dur (varsayılan 1). Birinci başlangıç noktası rastgele değildir (106.4.4); yalnız baslangic >1 ise tohum sonucu etkileyebilir. Örnek ayarda tohum 1 ile 7 aynı çözümü verir (log-olabilirlik -229{,}25614).
Örnek ayar (ornek_param, satır 9): y = fedfunds, x = [ogap, enflasyon], gecikme = 1, k = 2, degisken_varyans = kapalı, zaman = ceyrek, baslangic = 10; öteki alanlar varsayılandadır.
106.3 Örnek veri
usmacro.csv: ABD üç aylık makro serileri, 226 satır (1954Q3–2010Q4). Dosyada kaynak atfı yoktur; üstbilgi açıklaması bir yayımlı yazılım kılavuzu örneğini doğrulama için anar.
| Değişken | Rol | Tür (veri sekmesinin algıladığı) | Özet |
|---|---|---|---|
ceyrek |
zaman etiketi | tarih | 1954Q3 … 2010Q4, artan sırada; yalnız çıktıda etiket olarak kullanılır |
fedfunds |
yanıt | sayısal | federal fon faizi (%); ortalama 5,428; sd 3,405; en büyük 17,78 |
ogap |
açıklayıcı | sayısal | çıktı açığı; ortalama −0,587; sd 2,757 |
enflasyon |
açıklayıcı | sayısal | enflasyon (ilk 4 satırda eksik); ortalama 3,889 |
Kategorik değişken yoktur; düzey sırası bu şablonu etkilemez. Yanıtın bir gecikmesi eklendiğinde ilk satır, enflasyon eksik olduğu için de ilk dört satır düşer: n=222 (1955Q3–2010Q4).
Bu bölümde şu çalıştırmalar kullanılır (hepsi dogrulama/cikti/markov_rejim_* klasörlerindedir): markov_rejim_ornek (örnek ayar), _sabit (yalnız kesişim, gecikme 0), _gec0 (gecikme 0, iki açıklayıcı), _dv ve _dv_b30 (değişken varyans; 10 ve 30 başlangıç), _k3 (k=3), _tohum7, _b1 (tek başlangıç), _iter10, _iter10b, _ters, _ortaeksik, _kisa36, _sabity, _bagimli, _virgul, _kategorik. Python eşinin aynı çalıştırmaları Bölüm 107.3'tedir.
106.4 Yöntem: formüller ve hesap adımları
Hesap sırası şudur: yanıtın gecikmeleri açıklayıcı matrisine eklenir, eksik satırlar atılır; kısıtsız bir \boldsymbol\theta vektörü olasılıklara ve katsayılara çevrilir; Hamilton süzgeci olabilirliği verir; olabilirlik birden çok başlangıçtan BFGS'yle (isteğe bağlı olarak nlminb ile) en büyüklenir; rejimler kesişime göre sıralanır; Kim düzgünleştiricisi rejim olasılıklarını üretir; sayısal Hessian standart hataları verir.
106.4.1 Model, açıklayıcı matrisi ve parametreler
- \mathbf x_t: kesişimi,
xsütunlarını ve yanıtın L gecikmesini içeren p boyutlu satır (117–123, 150). - \boldsymbol\beta_j: j. rejimin p katsayısı; \sigma_j: j. rejimin hata standart sapması (n_v=1 ise bütün rejimlerde aynı).
- \phi: standart normal yoğunluk (
dnorm, 158).
Koddaki tercih
Gecikmeler açıklayıcıdır. Gecikmeli yanıt sütunları X0'a y(t−l) adıyla eklenir (117–122) ve her rejimde ayrı katsayı alır. Bu, "kesişim değiştiren" bir AR'dir: y_t=\alpha_{s_t}+\sum_l\phi_{l,s_t}y_{t-l}+\dots. Ortalamanın rejime göre değiştiği ve gecikmelerin ortalamadan sapma olarak girdiği Hamilton AR'si y_t-\mu_{s_t}=\sum_l\phi_l(y_{t-l}-\mu_{s_{t-l}})+\varepsilon_t bundan farklı bir modeldir ve gecikme sayısı kadar geçmiş rejime bağlı olduğundan durum uzayı k^{L+1} olur. Şablon bu modeli kestirmez.
Eksik değerler. Yanıt, açıklayıcılar ve gecikmeler birlikte tam olan satırlar tutulur (complete.cases, 142); ilk L satır gecikme nedeniyle düşer. Serinin başındaki ve sonundaki eksikler bu biçimde düşer. Ortadaki eksik gözlem (ilk ve son tam satır arasındaki her tam olmayan satır) ise Markov zincirini keser; satırları atıp iki yanını bitiştirmek bu boşluk boyunca geçişi yanlış kurardı, bu yüzden çalıştırma kaç satırın ve hangisinin eksik olduğunu söyleyen bir iletiyle durur (144–149; 106.8). Eksikleri doldurmak ya da yalnız kesintisiz bir bölümü çözümlemek gerekir.
Kısıtsız parametre. Kestirim kısıtsız \boldsymbol\theta üzerinde yapılır (167–175): her kaynak rejim i için k-1 lojit, ardından \mathrm{vec}(\mathbf B) (p\times k) ve n_v tane \ln\sigma:
Neden lojit ve log dönüşümü
Olasılıkların [0{,}1]'de ve satır toplamının 1 olması, \sigma>0 koşulu BFGS için kısıtsız bir uzayda sağlanır. Hessian ise bu dönüşümlü uzayda değil, doğal parametrelerde (p_{ij}, \beta, \sigma^2) hesaplanır (106.4.5); böylece SH doğrudan yorumlanabilir ama sınırda sayısal olarak kırılgan olur.
106.4.2 Hamilton süzgeci ve olabilirlik
Başlangıç tahmin olasılığı \boldsymbol\xi_{1|0}=\boldsymbol\pi, geçiş matrisinin durağan (ergodik) dağılımıdır: \boldsymbol\pi'=\boldsymbol\pi'\mathbf P, \mathbf 1'\boldsymbol\pi=1. Her t için:
- \mathbf e_t=(f(y_t\mid s_t=1),\dots,f(y_t\mid s_t=k))': rejim koşullu yoğunluklar (
E, 158). - \boldsymbol\xi_{t|t-1}: \Pr(s_t=j\mid y_1,\dots,y_{t-1}) (kodda
PR); \boldsymbol\xi_{t|t}: süzülmüş olasılık (koddaF). - \odot: eleman eleman çarpım; \mathbf P: satırları kaynak rejim olan geçiş matrisi.
- f_t sıfır ya da sonlu değilse süzgeç -10^{300} döndürür ve çözücü o noktayı reddeder (189).
Koddaki tercih
Ergodik başlangıç. \boldsymbol\pi, \big[(\mathbf I-\mathbf P)';\ \mathbf 1'\big]\boldsymbol\pi=(\mathbf 0{,}1)' sisteminin qr.solve ile çözümüdür; negatifler 0'a çekilip yeniden ölçeklenir (176–180). Birinci gözlem bu dağılımla ağırlıklandığından olabilirlik koşulsuzdur: ilk gözlemden ilk rejime ilişkin bilgi atılmaz. İlk rejimi sabit ya da serbest parametre alan kurulumlar farklı bir olabilirlik üretir.
106.4.3 Kim düzgünleştiricisi
Süzülmüş olasılık yalnız t'ye kadar olan gözlemi kullanır; düzgünleştirilmiş olasılık bütün örneği:
- \oslash: eleman eleman bölme; kodda payda \max(\boldsymbol\xi_{t+1|t},10^{-300}) ile korunur (196).
- Son dönemde süzülmüş ve düzgünleştirilmiş olasılık eşittir.
Çıktıdaki duzgun_ortalama, düzgünleştirilmiş olasılıkların sütun ortalamasıdır (303); örnekte (0{,}5624;\ 0{,}4376), durağan olasılıklara (0{,}5627;\ 0{,}4373) yakındır ama özdeş değildir.
106.4.4 Çok başlangıçlı en büyükleme ve rejim sıralaması
Olabilirlik rejim modellerinde çok tepeli olduğundan en büyükleme baslangic kadar noktadan başlatılır; degisken_varyans açıksa en az 30 noktadan (211–230).
| Başlangıç | Kesişimler | Öteki katsayılar | Geçişler | \ln\sigma |
|---|---|---|---|---|
| j=1 (rastgele değil) | OLS kesişimi + OLS artıklarının \frac{i-0{,}5}{k} nicelleri | OLS katsayısı | köşegen 0{,}9, kalan eşit pay | \ln(\hat s/\sqrt k) |
| j>1 | +\ \mathrm{sort}\,N(0,\hat s^2) (k değer) | +\ N\big(0,\,[0{,}1(|\hat\beta|+0{,}1)]^2\big) | j=1 ile aynı | j=1 ile aynı |
Her başlangıçta önce optim(method = "BFGS", reltol = 100·tolerans), sonra bu çözümden reltol = tolerans ile ikinci BFGS çalışır (223–225); bir başlangıç hata verirse ya da sonsuz değer üretirse sessizce atlanır. Çözüm sonlu değilse atlanır; degisken_varyans açıkken dejenere çözümler de atlanır (bir rejimin \hat\sigma_j<10^{-3}\,\mathrm{sd}(y) olması ya da düzgünleştirilmiş olasılıklarının toplamının 5 gözlemden az olması; 213–217, 227). En düşük -\ell değerli geçerli çözüm, ancak öncekinden 10^{-9} den fazla düşükse korunur (229). nlminb_incelt açıksa bu çözüm nlminb ile (\text{rel.tol}=\text{tolerans}/10, en çok 3000 yineleme) bir kez daha iyileştirilir ve yalnız amaç büyümezse ve çözüm dejenere değilse kabul edilir (232–234). Son olarak rejimler kesişime göre artan sıralanır (238–239).
Neden kesişime göre sıralama
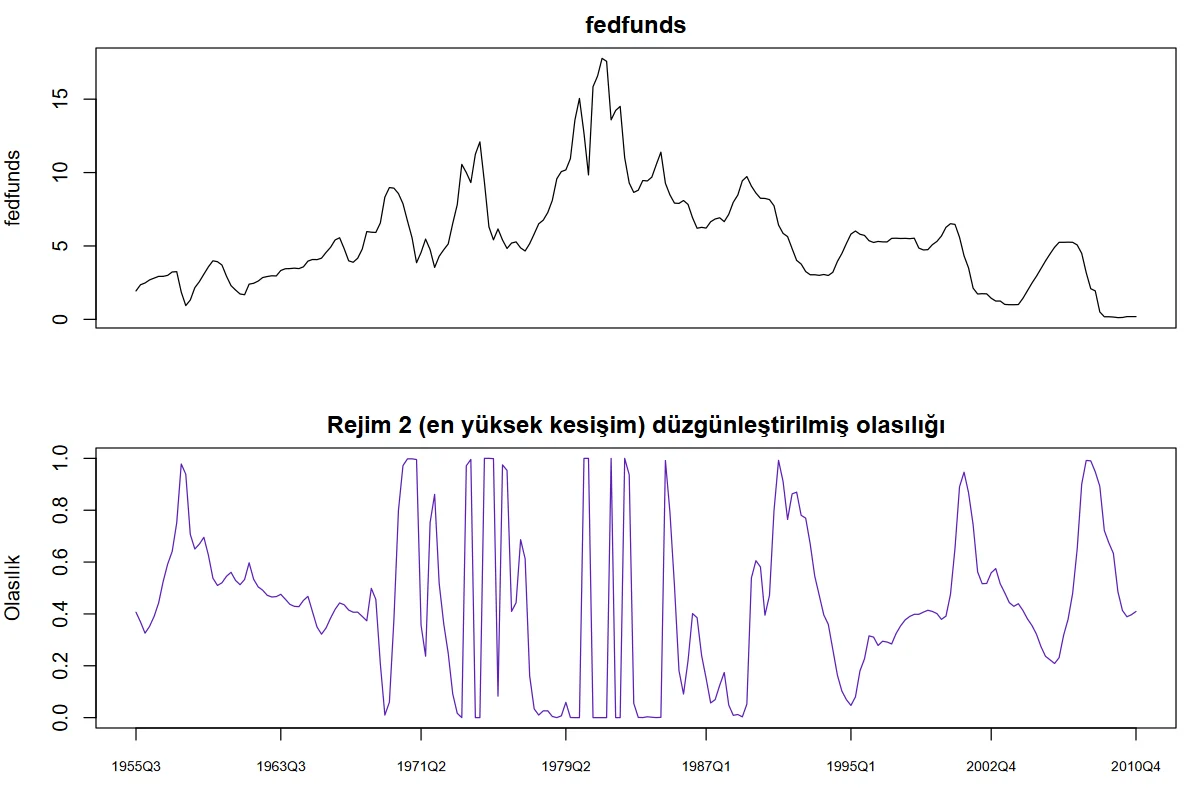
Rejim etiketleri modelin kendisinde tanımsızdır: (\boldsymbol\beta_1,\boldsymbol\beta_2,\mathbf P) ile etiketleri değiştirilmiş takım aynı olabilirliği verir (etiket değişimi). Kesişime göre sıralama bu keyfîliği giderir; kesişimler eşitse (ya da kestirimde çok yakınsa) sıra anlamsızlaşır, yorumlar yalnız rejimin içeriğine bakılarak yapılmalıdır. Rejim k "en yüksek kesişimli" rejimdir ve şekil bunun olasılığını çizer (315–316).
Yakınsama okunmaz ve yerel en büyükler
En iyi çözümün yakınsama durumu okunur (235–236): nlminb yineleme sınırına varmadan BFGS değerini doğruladıysa yakınsama tamamdır; değilse BFGS'nin convergence kodu okunur ve sıfır değilse (örnekte en_cok_yineleme = 10 ve nlminb_incelt kapalıyken \ell=-230{,}171, doğrusu -229{,}256) çıktıya "tam yakınsama bildirmedi" uyarısı yazılır (284). Başlangıçların kaçının en iyi çözüme vardığı da yazılır (285–291); yalnız bir başlangıç en iyi değere varabildiyse ayrıca uyarı gelir. Çözüm başlangıç sayısına duyarlıdır: değişken varyanslı modelde 10 başlangıçlı bir arama -221{,}449 yerel en büyüğünde kalabilir; şablon bu yüzden en az 30 başlangıç kullanır ve -201{,}878'e varır (106.7).
106.4.5 Standart hatalar ve türetilen büyüklükler
Standart hatalar, doğal parametre vektörü \boldsymbol\vartheta=(p_{ij}\,(j<k),\ \boldsymbol\beta,\ \sigma^2) üzerinde -\ell'nin sayısal Hessian'ından (gözlenen bilgi) gelir (243–267):
- \hat E[D_j]: j. rejimde kalınan beklenen dönem sayısı (geometrik dağılımın ortalaması),
beklenen_sure. - n: gecikme ve eksik satırlar düştükten sonraki gözlem sayısı; \text{npar}=k(k-1)+kp+n_v.
- GA: \hat\beta\pm z_{1-\alpha/2}\,\mathrm{SH}, z_{1-\alpha/2}=
qnorm((1+guven/100)/2)(275).
Koddaki tercih
Hessian. numDeriv::hessian(nll_d, dogal, method.args = list(d = hessian_adim, eps = 1e-6, r = 4)) (255): Richardson dış kestirimi, başlangıç adımı d göreli ölçektedir. numDeriv yoksa ya da sonuç sonlu değilse, ya da bir öğe 10^{200}'ü aşıyorsa (olasılık sınırı ihlal edildiğinde amaç 10^{300} döner) merkezî farklarla yerel bir Hessian kurulur (257–264). Tersi alınamazsa ya da köşegeni negatif/sonsuzsa bütün SH'ler NA olur (266). Sınıra yapışmış bir geçiş olasılığının (<10^{-6} ya da >1-10^{-6}) SH'si, bu satırda Hessian bozulduğundan NA yazılır (268–271). Son hedefin geçiş olasılığı p_{ik}=1-\sum_{j<k}p_{ij} kısıttan gelir ve SH'si verilmez (298–299).
106.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–107 | Üstbilgi: 13 parametre, örnek veri ve ayar. | Tohum alanı şablona özgüdür (66–74). |
| 108–116 | .m dil yardımcısı; veri denetimi; zaman, xs, k, L; yanıt ve açıklayıcıların sayıya çevrilmesi. |
x listesinden y ve zaman çıkarılır (112). |
| 117–156 | Gecikmeler, etiket, zaman sırası denetimi (125–141), tam satırlar, ortadaki eksik denetimi (144–149), X matrisi, n, p, npar ve denetimler. | n<\max(30{,}3\text{npar}), sabit yanıt, rank (155–157). |
| 158–165 | Seçeneklerin okunması; OLS (\hat s, başlangıç için). | Başlangıç noktaları OLS'e dayanır (164–165). |
| 167–199 | coz (\boldsymbol\theta\to\mathbf P,\mathbf B,\boldsymbol\sigma), ergodik, suzgec (Hamilton + Kim), nll. |
Süzgeç 189. satırda sonlu olmayan olabilirliği reddeder. |
| 201–230 | Başlangıç noktaları ve çift BFGS; en iyi çözüm. | Yakınsama durumu 235–236'da okunur; dejenere çözümler atlanır (213–217). |
| 231–240 | Hata denetimi, nlminb inceltmesi, rejim sıralaması, son süzgeç/düzgünleştirici çalıştırması. |
Sıralama \mathbf P'nin satır ve sütunlarını birlikte değiştirir (239). |
| 243–273 | Doğal parametrelerde Hessian, SH, \mathrm{SH}(\sigma). | Hessian çökerse SH NA (266–267). |
| 275–310 | Altı tablo: katsayılar, \sigma, geçişler, süreler, uyum, rejim olasılıkları. | Gözlem başına tablo n satırdır (308–310). |
| 312–320 | İki panelli şekil. | Yatay eksen etiketleri zaman sütunundan, 8 noktada (317–318). |
Kritik çağrılar:
r <- optim(th0, nll, method = "BFGS", control = list(maxit = maxit, reltol = tol * 100))
r <- optim(r$par, nll, method = "BFGS", control = list(maxit = maxit, reltol = tol))
Satır 223 ve 225; 229. satır en iyi geçerli çözümü -\ell değeriyle seçer.
Süre: örnek ayarda (n=222, 10 başlangıç, nlminb açık) çalıştırma 11,2 s sürmüştür; k=3 ve çok başlangıçta dakikalar sürebilir.
106.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/markov_rejim/elle_hesap.py ile hesaplanmıştır: yalnız numpy ve scipy kullanılmış; şablonun süzgeci, düzgünleştiricisi ve en büyükleyicisi çağrılmamıştır. Girdi, şablonun kestirimleridir (tablo1–3). Veri: y= fedfunds; \mathbf x=(1,\ \texttt{ogap},\ \texttt{enflasyon},\ y_{t-1}); n=222.
Adım 1 — Olabilirlik. İleri özyineleme log uzayında (logsumexp) yeniden yazılmıştır. Şablonun \hat{\mathbf P}=\begin{pmatrix}0{,}7885422&0{,}2114578\\0{,}2720712&0{,}7279288\end{pmatrix}, \hat\sigma=0{,}5764495 ve katsayılarıyla \ell=-229{,}2561443, şablonun -229{,}2561443 değerine 5\times10^{-15} içinde eşittir.
Adım 2 — Ergodik dağılım ve süreler. İki rejimde \pi_1=p_{21}/(p_{12}+p_{21})=0{,}5626782, \pi_2=0{,}4373218 (özdeğer çözümüyle aynı). \hat E[D_1]=1/0{,}2114578=4{,}7290765 dönem, \hat E[D_2]=3{,}6755081 dönem. Yani 1. rejimde (düşük kesişim) ortalama 4,7 çeyrek, 2. rejimde 3,7 çeyrek kalınır.
Adım 3 — Süzülmüş ve düzgünleştirilmiş olasılık. İlk gözlemde süzülmüş olasılık \boldsymbol\pi\odot\mathbf e_1'in normalleştirilmişidir: (0{,}5565758;\ 0{,}4434242). Düzgünleştirme, Kim özyinelemesi yerine ileri-geri (alfa-beta) çarpımıyla yeniden yazılmıştır: t=1 için (0{,}5935475;\ 0{,}4064525), t=50 için rejim 1 0{,}5932227, son gözlemde süzülmüşle eşit (0{,}5905858;\ 0{,}4094142).
Adım 4 — Bilgi ölçütleri. \mathrm{AIC}=-2(-229{,}2561443)+2\cdot11=480{,}5122887 ve \mathrm{BIC}=458{,}5122887+11\ln222=517{,}9417399.
Adım 5 — Yeniden en büyükleme. Olabilirlik kendi log-lojit dönüşümüyle scipy BFGS'ye verilmiştir. Şablonun çözümünden başlayınca \ell=-229{,}2561443354 (fark 1{,}5\times10^{-13}), parametreler en çok 1{,}4\times10^{-9} oynar; çözümde merkezî farkla gradyan normu 3{,}5\times10^{-5}'tir. Çözüm noktasından rastgele bozulmuş (N(0{,}0{,}03^2) kısıtsız ölçekte) bir başlangıçtan BFGS ve Nelder–Mead aynı \ell'ye varır. Aynı iş R'de nlm ile yapılmıştır (fark \le3\times10^{-9}).
Adım 6 — Standart hatalar. Dört düzeyli Richardson merkezî-fark Hessian'ı (adım 10^{-3}) şablonunkinden farklıdır ama yakındır: \mathrm{SH}(\hat\alpha_1)=0{,}1279238 (şablon 0{,}1279190; R numDeriv, r = 6: 0{,}1279245). En büyük göreli fark 4\times10^{-5}'tir; bu fark Hessian'ın sayısal hatasıdır, kestirim farkı değildir. Hessian'ın en küçük özdeğeri 45{,}7>0: çözüm yerel bir en büyüktür.
106.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu markov_rejim_ornek çalıştırmasının tablolarından tam hassasiyetle alınmıştır. Python sütunu elle_hesap.py'den, R sütunu r_dogrulama.R'den gelir. R tarafında süzgeç ölçekli ileri-geri özyinelemeyle, ergodik dağılım eigen ile, en büyükleme nlm ile, Hessian numDeriv::hessian (d =10^{-3}, r = 6) ve optimHess ile yeniden yapılmıştır; şablonun kendi suzgec, coz ve optim çağrıları kullanılmamıştır. Standart hata satırlarının ölçütü 10^{-4}'tür (Hessian'ın sayısal hatası); öbür satırlarda ölçüt 10^{-6} (yeniden en büyüklenen katsayılarda 10^{-5}).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | Ölçüt | |
|---|---|---|---|---|---|---|
| Log-olabilirlik | −229,25614434 | −229,25614434 | −229,25614434 | 2,1e−15 | 1e−6 | ✓ |
| AIC | 480,51228867 | 480,51228867 | 480,51228867 | 2,0e−15 | 1e−6 | ✓ |
| BIC | 517,94173987 | 517,94173987 | 517,94173987 | 1,8e−15 | 1e−6 | ✓ |
| Yeniden en büyükleme: log-olabilirlik (şablon çözümünden başlayarak) | −229,25614434 | −229,25614434 | −229,25614434 | 2,7e−15 | 1e−6 | ✓ |
| Yeniden en büyükleme: log-olabilirlik (bozulmuş başlangıçtan) | −229,25614434 | −229,25614434 | −229,25614434 | 2,2e−14 | 1e−6 | ✓ |
| Rejim 1: kesişim, yeniden en büyüklenmiş | −0,09449239 | −0,09449239 | −0,09449239 | 4,9e−10 | 1e−5 | ✓ |
| Rejim 1: ogap, yeniden en büyüklenmiş | 0,03430717 | 0,03430717 | 0,03430717 | 1,6e−9 | 1e−5 | ✓ |
| Rejim 1: enflasyon, yeniden en büyüklenmiş | 0,21252748 | 0,21252748 | 0,21252748 | 2,1e−9 | 1e−5 | ✓ |
| Rejim 1: yanıt(t−1), yeniden en büyüklenmiş | 0,92925739 | 0,92925739 | 0,92925739 | 1,5e−9 | 1e−5 | ✓ |
| Rejim 2: kesişim, yeniden en büyüklenmiş | 0,65549528 | 0,65549528 | 0,65549528 | 6,7e−10 | 1e−5 | ✓ |
| Rejim 2: ogap, yeniden en büyüklenmiş | 0,13554245 | 0,13554245 | 0,13554245 | 1,2e−9 | 1e−5 | ✓ |
| Rejim 2: enflasyon, yeniden en büyüklenmiş | −0,02739279 | −0,02739279 | −0,02739279 | 1,4e−9 | 1e−5 | ✓ |
| Rejim 2: yanıt(t−1), yeniden en büyüklenmiş | 0,83144577 | 0,83144577 | 0,83144577 | 3,0e−9 | 1e−5 | ✓ |
| p_{11}, yeniden en büyüklenmiş | 0,78854223 | 0,78854223 | 0,78854223 | 1,4e−10 | 1e−5 | ✓ |
| p_{21}, yeniden en büyüklenmiş | 0,27207123 | 0,27207123 | 0,27207123 | 6,3e−11 | 1e−5 | ✓ |
| \sigma, yeniden en büyüklenmiş | 0,57644948 | 0,57644948 | 0,57644948 | 9,5e−11 | 1e−5 | ✓ |
| Beklenen süre, rejim 1 | 4,72907653 | 4,72907653 | 4,72907653 | 7,5e−16 | 1e−6 | ✓ |
| Beklenen süre, rejim 2 | 3,6755081 | 3,6755081 | 3,6755081 | 2,4e−16 | 1e−6 | ✓ |
| Durağan olasılık, rejim 1 | 0,5626782 | 0,5626782 | 0,5626782 | 0 | 1e−6 | ✓ |
| Durağan olasılık, rejim 2 | 0,4373218 | 0,4373218 | 0,4373218 | 5,6e−17 | 1e−6 | ✓ |
| Düzgünleştirilmiş olasılık ortalaması, rejim 1 | 0,5623954 | 0,5623954 | 0,5623954 | 1,0e−15 | 1e−6 | ✓ |
| Düzgünleştirilmiş olasılık, t=1, rejim 1 | 0,59354752 | 0,59354752 | 0,59354752 | 9,0e−15 | 1e−6 | ✓ |
| Düzgünleştirilmiş olasılık, t=50, rejim 1 | 0,59322273 | 0,59322273 | 0,59322273 | 3,3e−15 | 1e−6 | ✓ |
| Düzgünleştirilmiş olasılık, t=n, rejim 2 | 0,40941422 | 0,40941422 | 0,40941422 | 1,8e−15 | 1e−6 | ✓ |
| Süzülmüş olasılık, t=1, rejim 1 (ergodik başlangıç) | 0,55657577 | 0,55657577 | — | 1,1e−16 | 1e−6 | ✓ |
| Süzülmüş olasılık, t=n, rejim 2 | 0,40941422 | 0,40941422 | — | 1,8e−15 | 1e−6 | ✓ |
| SH rejim 1: kesişim | 0,12791899 | 0,12792377 | 0,12792454 | 5,5e−6 | 1e−4 | ✓ |
| SH rejim 1: ogap | 0,02401348 | 0,02401376 | 0,02401361 | 2,8e−7 | 1e−4 | ✓ |
| SH rejim 1: enflasyon | 0,02973508 | 0,02973511 | 0,02973507 | 3,1e−8 | 1e−4 | ✓ |
| SH rejim 1: yanıt(t−1) | 0,02708495 | 0,02708527 | 0,02708537 | 4,2e−7 | 1e−4 | ✓ |
| SH rejim 2: kesişim | 0,13738855 | 0,13738899 | 0,13738906 | 5,1e−7 | 1e−4 | ✓ |
| SH rejim 2: ogap | 0,0294112 | 0,02941126 | 0,02941125 | 6,0e−8 | 1e−4 | ✓ |
| SH rejim 2: enflasyon | 0,04080479 | 0,0408057 | 0,04080591 | 1,1e−6 | 1e−4 | ✓ |
| SH rejim 2: yanıt(t−1) | 0,03332317 | 0,03332358 | 0,03332363 | 4,6e−7 | 1e−4 | ✓ |
| SH p_{11} | 0,06411787 | 0,0641179 | 0,06411793 | 6,4e−8 | 1e−4 | ✓ |
| SH p_{21} | 0,09299106 | 0,09299138 | 0,09299189 | 8,3e−7 | 1e−4 | ✓ |
| SH \sigma^2 | 0,03488227 | 0,0348823 | 0,03488229 | 2,7e−8 | 1e−4 | ✓ |
| SH \sigma (delta yöntemi) | 0,03025614 | 0,03025616 | 0,03025616 | 2,3e−8 | 1e−4 | ✓ |
Ölçütü karşılayan: 38/38. Örnek ayar (fedfunds ~ ogap, enflasyon, fedfunds(t−1); k=2). Bağımsız Python hesabı log-uzayda ileri özyineleme, ileri-geri (alfa-beta) düzgünleştirme, özdeğer çözümüyle ergodik dağılım, scipy BFGS/Nelder–Mead ile yeniden en büyükleme ve kendi Richardson Hessian'ını kullanır; R hesabı ölçekli ileri-geri özyineleme, eigen, nlm ve numDeriv::hessian (d = 10⁻³, r = 6) kullanır. Standart hatalar sayısal ikinci türevdir; yöntemler arasında \approx4\times10^{-5} göreli farkla ayrışır, bu yüzden SH satırlarının ölçütü 10^{-4}'tür.
106.7 Çıktıyı okuma
Örnek ayarın konsol metni ve tabloları (rejim olasılıkları tablosundan 3 ilk ve 3 son dönem):
Başlangıç noktaları: 10 başlangıçtan 10'i geçerli çözüme vardı; bunların 8'i en iyi çözüme (log-olabilirlik -229,25614) vardı.
n = 222 (gecikmeler ve eksikler düşüldükten sonra); 2 rejim; 11 parametre; log-olabilirlik = -229,25614

Rejime göre katsayılar (gözlenen bilgi SH, %95 GA)
rejim  terim           kestirim   SH        z          p            GA_alt     GA_ust
1      kesişim         -0.0944924 0.127919  -0.738689  0.460096     -0.345209  0.156224
1      ogap             0.0343072 0.0240135  1.42866   0.153101     -0.0127584 0.0813727
1      enflasyon        0.212527  0.0297351  7.14737   8.84589e-13   0.154248  0.270807
1      fedfunds(t-1)    0.929257  0.027085  34.309     5.76372e-258  0.876172  0.982343
2      kesişim          0.655495  0.137389   4.77111   1.83217e-06   0.386219  0.924772
2      ogap             0.135542  0.0294112  4.60853   4.05523e-06   0.0778976 0.193187
2      enflasyon       -0.0273928 0.0408048 -0.671313  0.502021     -0.107369  0.0525831
2      fedfunds(t-1)    0.831446  0.0333232 24.951    2.0837e-137   0.766134  0.896758

Hata standart sapması
rejim  sigma     SH_sigma   sigma2    SH_sigma2
ortak  0.576449  0.0302561  0.332294  0.0348823

Geçiş olasılıkları p[kaynak → hedef]
kaynak hedef olasilik SH
1      1     0.788542 0.0641179
1      2     0.211458 NA
2      1     0.272071 0.0929911
2      2     0.727929 NA

Beklenen rejim süresi (dönem) ve durağan olasılıklar
rejim  beklenen_sure ergodik_olasilik duzgun_ortalama
1      4.72908       0.562678         0.562395
2      3.67551       0.437322         0.437605

Model uyumu: logLik -229.256 | AIC 480.512 | BIC 517.942 | n 222 | parametre 11

zaman   y     duzgun_rejim1 duzgun_rejim2 suzulmus_rejim1 suzulmus_rejim2
1955Q3  1.94  0.5935        0.4065        0.5566          0.4434
1955Q4  2.36  0.6310        0.3690        0.5776          0.4224
1956Q1  2.48  0.6742        0.3258        0.6561          0.3439
…
2010Q2  0.19  0.6110        0.3890        0.6004          0.3996
2010Q3  0.19  0.6029        0.3971        0.5980          0.4020
2010Q4  0.19  0.5906        0.4094        0.5906          0.4094
Şekil 106.1. Şablonun çizdiği grafik (örnek veri): üstte `fedfunds`, altta en yüksek kesişimli rejim (rejim 2) için düzgünleştirilmiş olasılık. Yatay eksen etiketleri `zaman` sütunundandır.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Katsayı tablosu | Her rejimin her teriminin kestirimi, SH, z, p, GA. | Aynı terimin rejimler arası farkı, rejimlerin içeriğidir. Örnekte rejim 1'de enflasyon etkisi 0{,}213 (z=7{,}15) ve çıktı açığı etkisi anlamsız; rejim 2'de çıktı açığı etkisi 0{,}136 (z=4{,}61) ve enflasyon etkisi anlamsız. İki rejim arasındaki fark için ayrı bir sınama yoktur; GA'ların çakışmaması gevşek bir ölçüttür. |
| Gecikme katsayısı | Yanıtın bir gecikmesinin katsayısı (satır fedfunds(t-1)). |
0{,}929 ve 0{,}831: faiz çok kalıcıdır. Kalıcılık rejime göre değişir; rejim 1'de daha yüksektir. |
| Hata sd'si | sigma: ortak hata sd'si; SH_sigma: delta yöntemiyle SH'si. |
\hat\sigma=0{,}576 (\mathrm{SH}=0{,}030). degisken_varyans açıksa her rejim için ayrı satır gelir. |
| Geçiş olasılıkları | p_{ij} ve SH (son hedefin SH'si NA). |
\hat p_{11}=0{,}789, \hat p_{22}=0{,}728: rejimler orta derecede kalıcıdır. p_{12}=1-p_{11} kısıttan gelir. |
| Beklenen süre | beklenen_sure: 1/(1-\hat p_{jj}). |
4{,}73 ve 3{,}68 çeyrek. p_{jj}\to1'de sonsuza gider. |
| Durağan olasılık | ergodik_olasilik: uzun dönem rejim payı; duzgun_ortalama: örnek içi ortalama düzgünleştirilmiş olasılık. |
Birbirine yakındır; fark, örneklemin zincirin durağan dağılımından sapmasıdır. |
| AIC, BIC | -2\ell+2\,\text{npar} ve -2\ell+\text{npar}\ln n. | Yalnız aynı n ile uydurulan modeller arasında karşılaştırılır (106.8). |
| Rejim olasılıkları | duzgun_rejim1…k ve suzulmus_rejim1…k: her dönem için rejim olasılıkları. |
Düzgünleştirilmiş olasılık sınıflandırma için, süzülmüş olasılık "o gün bilinebilecek" olasılık için kullanılır. Örnekte 222 çeyreğin 80'inde rejim 2 olasılığı 0{,}5'in üstündedir. |
Ek çalıştırmalar (aynı veri; R şablonu):
| Çalıştırma | n | npar | \ell | AIC | BIC | Not |
|---|---|---|---|---|---|---|
yalnız kesişim, gecikme = 0 |
226 | 5 | -508{,}636 | 1027{,}272 | 1044{,}375 | \hat\sigma=2{,}108; \hat p_{11}=0{,}982, \hat p_{22}=0{,}950; süre 55{,}9 ve 19{,}9 |
gecikme = 0, ogap, enflasyon |
222 | 9 | -360{,}618 | 739{,}237 | 769{,}861 | rejimler çok kalıcı (65{,}9 ve 23{,}7 çeyrek) |
örnek ayar (gecikme = 1) |
222 | 11 | -229{,}256 | 480{,}512 | 517{,}942 | gecikme AIC'yi 259 azaltır |
| k=3 | 222 | 19 | -180{,}806 | 399{,}611 | 464{,}262 | \hat p_{21}=1{,}6\times10^{-9}: sınırda; bu olasılığın SH'si verilmez |
degisken_varyans (en az 30 başlangıç) |
222 | 12 | -201{,}878 | 427{,}755 | 468{,}587 | \hat\sigma=(1{,}360;\ 0{,}296); 30 başlangıçtan 27'si geçerli, 4'ü en iyi değere vardı, 3'ü dejenere olduğu için atıldı |
degisken_varyans açıkken olabilirlik çok tepelidir; şablon en az 30 başlangıç kullanır ve dejenere çözümleri (bir rejimin \hat\sigma_j<10^{-3}\,\mathrm{sd}(y) ya da 5 gözlemden az rejimi) atar. 10 başlangıçla bulunabilecek çözüm (-221{,}449; \hat\sigma=0{,}830;\ 0{,}394) yerel bir en büyüktür ve bu çözümden 19{,}6 log-olabilirlik birimi düşüktür; tohum 3 ve 50 başlangıç da aynı -201{,}878'i verir. Bağımsız bir çok başlangıçlı arama (\sigma_j\ge0{,}1 sınırıyla, 24 başlangıç) 22 başlangıçta -201{,}8776 değerini buldu ve şablonun çıktısıyla örtüşür; olabilirlik \sigma\to0 için sınırsız olduğundan sınırsız aramada bundan yüksek değerler vardır ve bunlar sapkındır (106.8).
Rapor cümlesi (örnek ayar):
ABD federal fon faizi (1955Q3–2010Q4, n=222), yanıtın bir gecikmesi, çıktı açığı ve enflasyonla, rejime göre kesişim ve katsayıları değişen iki rejimli bir Markov rejim değiştirme regresyonuyla çözümlenmiştir (Hamilton süzgeci, 10 başlangıçlı en çok olabilirlik; log-olabilirlik =-229{,}26). Birinci rejimde enflasyon etkisi anlamlı (0{,}213; z=7{,}15), ikinci rejimde çıktı açığı etkisi anlamlıdır (0{,}136; z=4{,}61). Rejimler orta derecede kalıcıdır (\hat p_{11}=0{,}789, \hat p_{22}=0{,}728; beklenen süreler 4{,}7 ve 3{,}7 çeyrek).
106.8 Sık hatalar ve tuzaklar
- Zaman sütunu artan ve tekil olmalıdır. Zaman sütunu seçiliyse sıra denetlenir: örnek veri ters sırada verilirse (
2010Q4önce) çalıştırma "artan sırada değil" iletisiyle durur. Atlanmış dönem (eksik satır) denetlenmez; zaman sütunu seçilmediyse veri sırası kullanıcının sorumluluğundadır. - Aradaki eksik gözlem çalıştırmayı durdurur. Yanıtta ya da açıklayıcıda ortada eksik değer varsa (örnekte
fedfunds'ta 10 ardışık eksik: gecikmeyle birlikte 11 satır) çalıştırma, kaç satırın eksik olduğunu ve ilk eksik satırı söyleyen bir iletiyle durur; satırları atıp iki yanını bitiştirmek zincirde yanlış geçiş kurardı. Eksikleri doldurun ya da kesintisiz bir bölümü çözümleyin. - Çok kısa seri. n<\max(30,\,3\,\text{npar}) durdurur; ilk 36 satır ile örnek ayar n=32<33 olduğundan durur. Sınır geçildiğinde bile \text{npar} başına 3 gözlem rejim kestirimi için azdır; rejimlerin ayrışmadığı çözümler (örn. \hat p_{ii}\approx1) SH üretemez.
degisken_varyansaçıkken olabilirlik sınırsızdır. Bir rejim birkaç gözlemi tam açıklayacak biçimde \sigma_j\to0 olursa \ell\to+\infty. Şablon en az 30 başlangıç kullanır ve \hat\sigma_j<10^{-3}\,\mathrm{sd}(y) ya da düzgünleştirilmiş olasılık toplamı 5 gözlemden az olan çözümleri atar; hepsi dejenereyse durur. Yine de sonucu farklı başlangıç sayılarıyla yinelemek iyi bir alışkanlıktır; çıktıdaki "başlangıç noktaları" satırı kaçının en iyi çözüme vardığını söyler.- Yerel en büyük ve etiket. Olabilirlik çok tepelidir. Rejim sayısı arttıkça (örnekte k=3) 10 başlangıç yetmeyebilir; çıktıdaki "başlangıç noktaları" satırı en iyi çözüme kaç başlangıcın vardığını söyler (yalnız biri vardıysa uyarı gelir),
baslangicartırılıp \ell'nin yinelendiği doğrulanmalıdır. Bir olasılık 0'a yapışırsa (\hat p_{21}=1{,}6\times10^{-9}) rejim gerçekte ayrışmıyor olabilir; Hessian sınırda bozulduğundan bu olasılığın SH'si verilmez (boş). - Yakınsama uyarısı.
en_cok_yinelemeküçültüldüğünde venlminb_inceltkapatıldığında sonuç (\ell=-230{,}171) "tam yakınsama bildirmedi" uyarısıyla yazılır (106.4.4). - AIC ve BIC aynı örneklemde karşılaştırılmalıdır.
gecikmeartırıldığında n düşer (yalnız kesişimli çalıştırmada 226, bir gecikmeyle 225); bilgi ölçütleri farklı örneklemlerde uydurulan modeller için karşılaştırılamaz. - p değerleri normal yaklaşıktır. z=\hat\beta/\mathrm{SH} normal kabul edilir; rejim kalıcılığı düşükse ya da bir rejimde az gözlem varsa SH iyimser kalır. Rejim sayısı için olabilirlik oranı sınaması geçerli değildir (106.9, S5).
- Ondalık virgüllü sütun forma girmez. Sayısal rol atanan sütun metin türündeyse ("ogap" virgüllü yazılmışsa) form "sayısal bir sütun değil" iletisiyle çalıştırmayı başlatmaz (denetim Bölüm 1.2). Veri sekmesinde "kategorik" olarak işaretlenmiş sayısal bir sütun sayısal rolde sayı olarak aktarılır ve sonuç değişmez (
markov_rejim_kategorik: \ell=-229{,}25614). - Tohum. Kod panelinin Tohum alanı bu şablonda etkisizdir; formdaki tohum kullanılır (106.2).
baslangic = 1ile yalnız deterministik başlangıç denenir.
106.9 Uzman soruları
S1. Neden başlangıç dağılımı ergodik, ilk rejim sabit ya da serbest değil?
İlk gözlemin rejim dağılımı ya sabitlenir, ya serbest parametre yapılır (k-1 ek parametre) ya da \mathbf P'nin durağan dağılımına eşitlenir. Şablon üçüncüsünü seçer (176–180). Bu, ek parametre gerektirmez ve örnek uzunsa sonucu pek etkilemez. Etki aynı parametrelerde ölçülebilir: örnek çözümde ilk gözlemin dağılımı (0{,}5627;\ 0{,}4373) yerine eşit pay (0{,}5;\ 0{,}5) alınırsa \ell=-229{,}2640 (0{,}008 fark), birinci rejim kesin alınırsa -229{,}2027, ikinci rejim kesin alınırsa -229{,}3293 olur (bağımsız Python hesabı). Durağan dağılım zincirin gerçekten durağan olduğunu varsayar; kısa örneklerde ilk gözlemin ağırlığı artar.
S2. SH'ler neden doğal parametrelerde ve neden \sigma için delta yöntemi?
Hessian, kısıtsız \boldsymbol\theta'da hesaplanıp dönüştürülmek yerine doğrudan (p_{ij},\boldsymbol\beta,\sigma^2) üzerinde hesaplanır; böylece SH'ler olasılık ve katsayı ölçeğinde okunur. \sigma'nın SH'si ise \sigma^2'ninkinden \mathrm{SH}(\sigma)=\mathrm{SH}(\sigma^2)/(2\hat\sigma) ile türetilir (örnekte 0{,}0349/(2\cdot0{,}5764)=0{,}03026). Doğal parametre uzayında olasılık sınırı ihlal edildiğinde amaç 10^{300} döndüğünden, sınıra yapışmış bir kestirimde Hessian bozulur ve SH güvenilmez olur.
S3. Düzgünleştirilmiş olasılık neden süzülmüştür farklı ve sınıflama için hangisi?
Süzülmüş olasılık \Pr(s_t\mid y_{1:t}) yalnız o güne kadarki bilgiyi, düzgünleştirilmiş olasılık \Pr(s_t\mid y_{1:n}) bütün örneği kullanır. Geçmişe dönük bir rejim tarihi çıkarmak için düzgünleştirilmiş olasılık, gerçek zamanlı bir uyarı için süzülmüş olasılık kullanılır. Örnekte 1955Q3'te 0{,}5935 ve 0{,}5566 (rejim 1) bu farkı gösterir. Son dönemde ikisi eşittir.
S4. Gecikmeli yanıtı açıklayıcı almak Hamilton AR'siyle aynı mı?
Hayır. Burada katsayıları rejime göre değişen bir AR vardır; gecikmeler yanıtın kendi değerleridir ve yalnız s_t'ye bağlıdır, olabilirlik k durumlu bir süzgeçle hesaplanır. Hamilton AR'sinde gecikmeler ortalamadan sapma olarak girer ve geçmiş L rejime bağlı olduğundan durum uzayı k^{L+1} olur; olabilirlik de farklıdır. Örnekte \hat\phi_1=0{,}929 ve 0{,}831 (rejime göre farklı) bir kesişim-değiştiren AR'nin sonucudur; "kalıcılığın rejime göre değiştiği" yorumu bu modelin içindedir.
S5. Rejim sayısını olabilirlik oranıyla sınayabilir miyiz?
H_0: "k rejim yeterli" altında geçiş olasılıkları ve ek rejimin katsayıları tanımsızdır (Davies sorunu) ve olabilirlik oranı istatistiği olağan \chi^2 dağılımını izlemez (Hansen, 1992; Garcia, 1998). Şablon böyle bir sınama sunmaz. Örnekte k=2 için \ell=-229{,}256, k=3 için -180{,}806 (fark 48{,}45) olsa da bu fark \chi^2 ile yorumlanmamalıdır; bilgi ölçütleri (\mathrm{BIC}: 517{,}9 ve 464{,}3) kaba bir kılavuzdur, çünkü parametre sayısı k arttıkça hızla büyür ve yerel en büyük riski de artar.
S6. Neden BFGS, sonra nlminb, sonra Hessian? Hangi ayar neyi değiştirir?
BFGS (\text{reltol}=100\times ve 1\times\text{tolerans}), dönüşümlü uzayda düzgün olabilirlikte hızlı yaklaşır; nlminb sınırlı yineleme ve \text{tolerans}/10 ile bir kez daha iyileştirir. en_cok_yineleme ve tolerans yalnız kestirimin kesinliğini etkiler ve normal koşulda 10^{-9} düzeyinde fark yaratır; yerel en büyüğü ise baslangic ve tohum belirler. hessian_adim yalnız SH'leri etkiler: örnekte d=0{,}01 ile bütün katsayı SH'leri varsayılan d=0{,}001 sonuçlarıyla dört ondalığa kadar aynıdır.
S7. degisken_varyans açıkken olabilirlik neden sınırsızdır ve ne yapılmalı?
\sigma_j\to0 ve \mu_{jt} bir gözleme eşitlenirse yoğunluk 1/\sigma_j\to\infty olur; olabilirlik bu dejenere bölgede sınırsızdır. Dejenere çözüm bir rejimin birkaç gözlemi içerdiği ve \hat p_{jj}'nin 0{,}5 ya da 1'e yapıştığı çözümdür. Çözümler: \sigma_j için alt sınır koymak (bağımsız aramada \sigma_j\ge0{,}1), rejim başına en az gözlem sayısı istemek, \hat\sigma_j ve \mathrm{SH} birlikte denetlemek. Şablon alt sınır yerine dejenere çözümü atar (bir rejimde \hat\sigma_j<10^{-3}\,\mathrm{sd}(y) ya da 5 gözlemden az) ve en az 30 başlangıç kullanır (106.8).
S8. Başka bir araçla çalıştırılan aynı model neden biraz farklı sonuç verebilir?
Üstbilgi açıklaması, EM tabanlı bir paketin farklı bir olabilirlik tanımı kullandığını ve sonuçların biraz farklı olduğunu söyler; bu bölümde o paketle karşılaştırma yapılmamıştır. Aynı Hamilton olabilirliği bile üç noktada ayrışabilir: ilk gözlemin rejim dağılımı (S1: örnek çözümde 0{,}008 ile 0{,}07 arası log-olabilirlik farkı), \sigma^2'nin n ya da n-p ile ölçeklenmesi ve çözücünün vardığı yerel en büyük. Doğrulama bu nedenle olabilirliğin kendisini bağımsız yeniden hesaplar ve ikinci bir çözücüyle en büyükler (106.6).
106.10 Kaynaklar
- Garcia, R. (1998). Asymptotic null distribution of the likelihood ratio test in Markov switching models. International Economic Review, 39(3), 763–788. https://doi.org/10.2307/2527399
- Gilbert, P., & Varadhan, R. (2019). numDeriv: Accurate numerical derivatives (R package version 2016.8-1.1). https://CRAN.R-project.org/package=numDeriv
- Hamilton, J. D. (1989). A new approach to the economic analysis of nonstationary time series and the business cycle. Econometrica, 57(2), 357–384. https://doi.org/10.2307/1912559
- Hamilton, J. D. (1990). Analysis of time series subject to changes in regime. Journal of Econometrics, 45(1–2), 39–70. https://doi.org/10.1016/0304-4076(90)90093-9
- Hamilton, J. D. (1994). Time series analysis. Princeton University Press.
- Hansen, B. E. (1992). The likelihood ratio test under nonstandard conditions: Testing the Markov switching model of GNP. Journal of Applied Econometrics, 7(S1), S61–S82. https://doi.org/10.1002/jae.3950070506
- Kim, C.-J. (1994). Dynamic linear models with Markov-switching. Journal of Econometrics, 60(1–2), 1–22. https://doi.org/10.1016/0304-4076(94)90036-1
- Kim, C.-J., & Nelson, C. R. (1999). State-space models with regime switching: Classical and Gibbs-sampling approaches with applications. MIT Press.
- R Core Team (2026). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/