93. Vaka-kontrol genetik ilişkilendirme
Şablon kimliği: vaka_kontrol_genetik · Kategori: genetik · Dil: R · Dosya: pro/sablonlar/genetik/vaka_kontrol_genetik.R (satır 1–270; üstbilgi 1–92) · Örnek veri: _ornek/astim_snp.csv · Paketler: taban R (stats, graphics); isteğe bağlı coin 1.4.6
93.1 Ne işe yarar
Şablon, birbirinden bağımsız hasta (vaka) ve sağlıklı (kontrol) bireylerde iki alelli bir işaretleyicinin (SNP) genotip dağılımını karşılaştırır. Cevapladığı soru şudur: "Bu SNP'nin genotipleri vakalarda ve kontrollerde farklı sıklıkta mı; farklıysa risk alel kopyası sayısıyla nasıl değişiyor?"
Küçük alelin kopya sayısı x\in\{0{,}1{,}2\} olsun. Şablonun bütün testleri ve modelleri tek bir lojistik çerçevenin özel hâlleridir:
- x: küçük (seyrek) alelin kopya sayısı; 0 yaygın alelin homozigotu (referans genotip), 1 heterozigot, 2 küçük alelin homozigotu.
- f(x): genotip etkisi; biçimi kalıtım modelini belirler (93.4.4). f\equiv0 sıfır hipotezidir.
- \mathbf z: isteğe bağlı ortak değişkenler (yaş, cinsiyet, ülke …); \boldsymbol\gamma katsayıları.
- e^{f(x)-f(0)}: genotipin referans genotipe göre odds oranı (OR).
Şablon her SNP için üç tablo üretir: (1) vaka ve kontrollerde genotip sayıları; (2) tek SNP testleri: alelik \chi^2, Cochran–Armitage eğilim testi (üç skor takımıyla), genotipik 2 sd \chi^2, kontrollerde Hardy–Weinberg testi, isteğe bağlı Monte Carlo kesin p; (3) beş kalıtım modeli için lojistik regresyon: odds oranı, güven aralığı, olabilirlik oranı p'si ve AIC.
Ne zaman kullanılır? Aday gen çalışmasında az sayıda SNP'nin hastalıkla ilişkisini sınamak; kalıtım biçimini (baskın, çekinik, eklemeli) karşılaştırmak; ilişkiyi ortak değişkenlere göre düzeltmek.
Ne zaman kullanılmaz?
- Aile verisi (hasta çocuk ve ebeveynler) varsa ve tabakalaşma kaygısı varsa:
tdt(Bölüm 90). - Özellik sürekliyse ya da binlerce marker akrabalık düzeltmesiyle taranacaksa:
gwas(Bölüm 76). - Kontrollerde Hardy–Weinberg dengesinin kesin testi isteniyorsa:
hardy_weinberg(Bölüm 78); bu şablon yalnız \chi^2 yaklaşımını verir. - Hücre sayıları çok küçükse (bir genotip yalnız vakalarda ya da yalnız kontrollerde):
kesin_lojistik(Bölüm 36). - İkiden çok alelli lokus: şablon durur; lokus önce iki alelli biçime indirgenir.
Temel programla ilişki. Temel programdaki çapraz tablo \chi^2'si genotipik testi, ikili lojistik regresyon tek bir kalıtım modelini verir. Şablonun eklediği: genotip metninin alel sayısına çevrilmesi, küçük alelin ve referans genotipin kendiliğinden belirlenmesi, eğilim testinin üç skorla kurulması ve beş modelin tek çalıştırmada yan yana getirilmesi.
93.2 Şablonun girdileri
Form, üstbilgideki dokuz [[param]] bloğundan kurulur (vaka_kontrol_genetik.R:10–70).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Vaka-kontrol durumu · durum |
kategorik sütun · Değişkenler | ilk uygun sütun | sayısal 0/1 ya da iki düzeyli metin | Sayısalda 1 = vaka; metinde vaka düzeyi 'Vaka düzeyi' alanından, yoksa bilinen vaka/kontrol adından, yoksa sayısal ya da düzey sırasından alınır ve çıktıda yazılır (105–148). |
SNP sütunları · lokuslar |
sütunlar · Değişkenler | yok (en az 1) | a1/a2 metni ya da sayısal 0/1/2 |
Her sütun ayrı çözümlenir (101, 178). |
Ortak değişkenler · ortak_degiskenler |
sütunlar · Değişkenler | boş | herhangi sütun | Sayısal sütun doğrusal, öteki türler faktör olarak bütün modellere girer (102, 152–153). |
Alel ayırıcısı · ayirici |
metin · Değişkenler | / |
boş olmayan metin | Metin genotipi böler (104). |
Eksik genotip kodları · eksik_kodlar |
metin · Değişkenler | boş | virgülle ayrılmış kodlar | Boşsa varsayılan liste (boş hücre, NA, 0, 00, 000, ?, -, ., -9) eksik sayılır; doluysa alandaki kodlar bu listenin yerine geçer (boş hücre ve NA her zaman eksik); baş ve son boşluk kırpılır, boş kodlar atılır (satır 97–98; Bölüm 1.5). |
Vaka düzeyi · vaka_duzeyi |
metin · Değişkenler | boş | durum sütununun bir düzeyi | Metin durumda vaka düzeyini adıyla belirler (öteki ölçütlerden önce gelir); sayısal 0/1 sütunda yok sayılır (114–129). |
Vaka adları · vaka_adlari |
metin · Değişkenler | boş | virgülle ayrılmış adlar | Metin durumda vaka düzeyini tanımak için kullanılan adlar (büyük/küçük harf önemsiz); boşsa bilinen vaka adları, doluysa alandaki adlar bu listenin yerine geçer; yalnız bu alan doluysa aynı adlar bilinen kontrol listesinden çıkarılır; 'Vaka düzeyi' alanı doluysa o önceliklidir (satır 119–125). |
Kontrol adları · kontrol_adlari |
metin · Değişkenler | boş | virgülle ayrılmış adlar | Aynı biçimde kontrol düzeyi için; yalnız bu alan doluysa aynı adlar bilinen vaka listesinden çıkarılır (satır 119–125). |
Çoklu test düzeltmesi · duzeltme |
seçim · Seçenekler | BH |
BH, holm, bonferroni, hochberg, hommel, BY, none |
Yalnız eğilim testi p'lerine, SNP'ler üzerinden (247–248). |
Monte Carlo tekrar sayısı · B |
tamsayı · Seçenekler | 0 | 0–100000 | >0 ise eğilim testi için coin ile Monte Carlo kesin p (162, 206–209). |
Odds oranı güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | Aralıkların düzeyi (163–164). |
Güven aralığı yöntemi · ga_yontem |
seçim · Seçenekler | wald |
wald, profil |
Wald ya da profil olabilirlik aralığı (165, 226–230). |
Örnek ayar (ornek_param, satır 9): durum = "astim", lokuslar = ["rs1422993", "rs184448", "rs4490198"]; öteki alanlar varsayılandadır.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 140 |
| Durum sütunu SNP olarak da seçilmiş | "Durum sütunu SNP olarak da seçilemez." | 143 |
| Sayısal durumda 0 ve 1 dışında değer | "Sayısal durum sütunu yalnız 0 (kontrol) ve 1 (vaka) içermeli." | 147 |
| Metin durumda düzey sayısı 2 değil | "Durum sütununun tam iki düzeyi olmalı (kontrol, vaka)." | 152 |
| Vaka düzeyi sütunda yok | "Vaka düzeyi '…' durum sütununda yok (düzeyler: …)." | 128 |
| Yalnız vaka ya da yalnız kontrol var | "Hem vaka hem kontrol gözlenmeli." | 161 |
| Ortak değişken sabit | "Ortak değişken '…' sabit; modelden çıkarın." | 164 |
| SNP'de ikiden çok alel | "'…' iki alelli değil (3 alel); bu şablon iki alelli SNP ister." | 187 |
| Eksikler atılınca bir SNP'de vaka ya da kontrol kalmadı | "'…' için vaka ya da kontrol yok." | 193 |
| Bütün SNP'ler tek alelli | "Çözümlenecek çok biçimli (polimorfik) SNP kalmadı …" | 248 |
Ortak genotip ayrıştırıcısının iletileri (ayırıcısız, üç parçalı, 0/1/2 dışı; alellerinden yalnız biri eksik kodu olan genotip, ör. 0/1) |
Bölüm 1.5 | 76–77 (çağrı 153) |
Uyarılar (durdurmaz). Metin durumda hangi düzeyin vaka alındığı ve ölçütü, sayısal durumda Vaka düzeyi: 1 (kontrol: 0) (109, 146); hem SNP hem ortak değişken seçilen sütun (151); tek bir sonuç içeren ortak değişken düzeyi (tam ayrışma; 132); genotip okuma dökümü (244); tek alelli SNP'lerin çözümlenmediği (245); ortak değişken varken \chi^2 testlerinin düzeltilmediği (254); odds oranı ya da aralığı ıraksayan modeller (256).
Eksik değer kuralı. Her SNP, o SNP'nin genotipi, durumu ve bütün ortak değişkenleri dolu bireylerle çözümlenir (satır 180); birey sayısı SNP'den SNP'ye değişir ve n sütununda yazılır. Genotipte eksik simgeleri boş hücre, NA, na, 0, 00, 000, ?, -, . ve -9'dur (Bölüm 1.5); iki alelin ikisi de eksik kodu olmalıdır (0/0, -9/-9). Alellerinden yalnız biri eksik kodu olan genotip (0/1) çalıştırmayı durdurur; 0 adlı gerçek bir alel varsa yeniden kodlanır. Eksik sayılan genotiplerin dökümü çıktıda yazılır. "Eksik genotip kodları" alanı doluysa bu liste yerine alandaki kodlar eksik sayılır (boş hücre ve NA her zaman eksik) ve yarı eksik genotip için durma kuralı yeni listeyle işler; VCF tarzı 0/1 kodlu veride alana yalnız . yazılınca 0 gerçek bir alel olarak okunur (satır 97–98).
93.3 Örnek veri
Dosya: _ornek/astim_snp.csv; 1578 satır, 9 sütun. SNPassoc paketinin astım verisinden alınmıştır (González ve ark., 2007): on ülkeden 340 astımlı ve 1238 kontrol.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
ulke |
ortak değişken (çalıştırma 2) | kategorik (10 düzey) | İlk görülme sırası: Germany, Switzerland, Belgium, UK, Spain, Sweden, Australia, Estonia, France, Norway. |
cinsiyet |
kullanılmaz | ikili | Males, Females. |
yas, vki |
kullanılmaz | sayısal | vki'de 12 eksik. |
sigara |
ortak değişken (çalıştırma 2) | ikili (0/1) | 7 eksik. |
astim |
Durum | ikili (0/1) | 0: 1238 kontrol; 1: 340 vaka. |
rs1422993 |
SNP | kategorik | G/G 903, G/T 570, T/T 105; eksik yok. |
rs184448 |
SNP | kategorik | 34 eksik. |
rs4490198 |
SNP | kategorik | 10 eksik. |
Durum sütunu sayısal 0/1 olduğundan düzey sırası rol oynamaz. Metin durum sütununda vaka düzeyi 'Vaka düzeyi' alanından, bilinen vaka/kontrol adlarından, sayısal ya da düzey sırasından belirlenir ve çıktıda yazılır (93.5); ortak değişken faktörlerinde referans düzey arayüzdeki ilk düzeydir (ülkede Germany), bu yalnız ortak değişken katsayılarını etkiler, SNP odds oranlarını etkilemez.
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) ortak değişkenler ulke ve sigara; (3) profil olabilirlik aralığı, güven düzeyi 0,90, düzeltme Holm; (4) B=9999, tohum 93; (5) satır sırası karıştırılmış veri; (6) seyrek ek veri dogrulama/vaka_kontrol_genetik/vk_seyrek.csv (22 vaka, 38 kontrol; rs1422993'te vakalarda T/T yok).
93.4 Yöntem: formüller ve hesap adımları
Her SNP için hesap sırası: (1) genotipleri ayrıştır, eksiksiz bireyleri seç; (2) küçük aleli belirle, x'i kur; (3) 2\times3 genotip tablosu ve alel frekansları; (4) kontrollerde Hardy–Weinberg \chi^2; (5) alelik, eğilim ve genotipik testler; (6) beş lojistik model; son olarak (7) eğilim p'lerinin düzeltilmesi.
93.4.1 Küçük alel ve genotip tablosu
Vaka ve kontroller birlikte sayılarak iki alelin kopya sayıları bulunur; daha seyrek olan küçük alel (A_2), öteki yaygın alel (A_1) olur; eşitlikte adı sırada önce gelen yaygın sayılır (satır 182–186). Genotip tablosu:
| A_1A_1 (x=0) | A_1A_2 (x=1) | A_2A_2 (x=2) | Toplam | |
|---|---|---|---|---|
| Kontrol | n_{k0} | n_{k1} | n_{k2} | S |
| Vaka | r_0 | r_1 | r_2 | R |
| Toplam | n_0 | n_1 | n_2 | N |
Küçük alel frekansı kontrollerde \text{KAF}_k=(n_{k1}+2n_{k2})/(2S), vakalarda \text{KAF}_v=(r_1+2r_2)/(2R)'dir.
Neden küçük alel birleşik örnekten belirleniyor?
Referans genotipin vaka ve kontrollerde aynı olması gerekir; birleşik örnek bunu sağlar ve satırların sırasından bağımsızdır. Bedeli, vaka oranı yüksek tasarımlarda "küçük" alelin popülasyondaki küçük alel olmayabilmesidir: kontrollerdeki frekansı 0,5'i aşabilir (ek veride rs4490198: \text{KAF}_k=0{,}579). Yorumda kucuk_alel sütunu ve iki frekans birlikte okunur.
93.4.2 Kontrollerde Hardy–Weinberg testi
- E_g: kontrollerde denge altında beklenen genotip sayıları; sd =1, süreklilik düzeltmesi yok.
- Test yalnız kontrollerde yapılır: vakalarda dengeden sapma, ilişkinin kendisinden doğabilir (Wittke-Thompson ve ark., 2005).
Kontrollerde anlamlı sapma genotipleme hatasının ya da tabakalaşmanın işaretidir ve o SNP'nin bulgusu kuşkuyla karşılanır. Bu sütun bir kalite göstergesidir; düzeltilmez.
93.4.3 Alelik, eğilim ve genotipik testler
Alelik test bireyleri değil alel kopyalarını sayar: 2\times2 tabloda satırlar kontrol ve vaka, sütunlar A_1 ve A_2 kopya sayılarıdır (2N gözlem); Pearson \chi^2, 1 sd (satır 194–196).
Cochran–Armitage eğilim testi vaka oranının genotip skoru s_g ile doğrusal değişip değişmediğini sınar (Armitage, 1955):
- s_g: genotip skorları. (0{,}1{,}2) eklemeli, (0{,}1{,}1) baskın, (0{,}0{,}1) çekinik etkiye en duyarlı testi verir; şablon üçünü de hesaplar (satır 201).
- Pay: vakalardaki skor toplamının, vaka sayısıyla orantılı beklenen değerinden sapması.
- Payda: bu sapmanın, kenar toplamları sabitken varyansı (N paydalı biçim).
- sd =1. İstatistik, y (0/1) ile skor arasındaki Pearson korelasyonu r cinsinden N\,r^2'ye eşittir ve log-eklemeli lojistik modelin skor testidir.
egilim_chi2_N1sütunu aynı istatistiğin (N-1)/N ile çarpılmış biçimidir (Mantel, 1963); permütasyon varyansına karşılık gelir.
Neden alelik test yerine eğilim testi?
Alelik test bir bireyin iki alelini bağımsız iki gözlem sayar; bu yalnız birleşik örnek Hardy–Weinberg dengesindeyse doğrudur. Dengeden sapma varsa alelik \chi^2'nin gerçek düzeyi nominal düzeyden sapar. Eğilim testi bireyi birim alır ve denge varsaymaz (Sasieni, 1997; Lewis, 2002). Şablon çoklu test düzeltmesini bu yüzden eğilim testine uygular; alelik sütun karşılaştırma içindir.
Genotipik test 2\times3 tablonun Pearson \chi^2'sidir; sd, gözlenen genotip sütunu sayısı eksi 1'dir (üç genotip de varsa 2; satır 198–200). Kalıtım biçimi hakkında varsayım yapmaz, karşılığında eklemeli etkide eğilim testinden güçsüzdür.
Koddaki tercih
Monte Carlo seçeneği (B>0) coin::independence_test(y ~ x, teststat = "quadratic", distribution = approximate(nresample = B)) çağrısıdır (satır 206–209). İstatistik (N-1)\,r^2 biçimidir; p, durum etiketlerinin B rastgele karıştırmasında istatistiğin gözlenene eşit ya da ondan büyük çıkma oranıdır. Sonuç egilim_p_MC sütununa yazılır; düzeltmeye girmez (coin paketi: Hothorn ve ark., 2006). Tohum her çalıştırmada arayüzce atanır ve betiğe kaydedilir (Bölüm 57).
93.4.4 Kalıtım modelleri
Beş model, f(x)'in beş biçimidir; her biri glm(family = binomial) ile uydurulur (satır 216–242):
| Model | f(x) | Karşılaştırma | sd |
|---|---|---|---|
| Eş baskın (kodominant) | \beta_1[x=1]+\beta_2[x=2] | her genotip ↔ A_1A_1 | 2 |
| Baskın | \beta[x\ge1] | A_1A_2 ve A_2A_2 ↔ A_1A_1 | 1 |
| Çekinik | \beta[x=2] | A_2A_2 ↔ A_1A_1 ve A_1A_2 | 1 |
| Aşırı baskın | \beta[x=1] | A_1A_2 ↔ iki homozigot | 1 |
| Log-eklemeli | \beta\,x | A_2 kopyası başına | 1 |
Her model için:
- \hat\beta, \widehat{SE}: enbüyük olabilirlik kestirimi ve standart hatası.
- \ell_1: modelin, \ell_0: yalnız ortak değişkenleri (yoksa yalnız sabiti) içeren boş modelin log-olabilirliği; ikisi aynı bireylerle uydurulur.
- G^2: olabilirlik oranı istatistiği; p_{\text{OO}}=P(\chi^2_{\text{sd}}>G^2). Eş baskın modelde iki satır aynı p'yi taşır (2 sd'lik tek test).
- k: modelin parametre sayısı (ortak değişkenler dahil). AIC modeller arasında karşılaştırılır; küçük olan veriyle daha uyumludur.
Ortak değişkensiz kategorik modellerde odds oranı 2\times2 tablonun çapraz çarpım oranına, standart hata \sqrt{1/a+1/b+1/c+1/d}'ye eşittir; lojistik regresyon bu kapalı formülü yeniden üretir.
Koddaki tercih
Profil olabilirlik seçilirse aralık stats::confint(m, parm, level) ile bulunur (satır 226–229): katsayı bir ızgara üzerinde sabitlenir, öteki katsayılar yeniden kestirilir, işaretli olabilirlik kökü ara değerlemeyle \pm z'ye eşitlenir (Venzon ve Moolgavkar, 1988). Ara değerleme nedeniyle sınırlar kesin kökten 10^{-5} düzeyinde ayrılabilir (93.6.1). Olabilirlik oranı p'si her iki seçenekte aynıdır.
Wald aralığı küçük hücrede güvenilmez
Bir genotip yalnız vakalarda ya da yalnız kontrollerde gözlenirse \hat\beta sonsuza gider (ayrışma; Albert ve Anderson, 1984); glm çok büyük bir katsayıda durur ve Wald aralığı (0,\infty)'a açılır. Şablon böyle satırları saptayıp uyarır (satır 255–257) ve grafikten çıkarır, ama tabloda bırakır. Ek veride rs1422993'ün çekinik modeli OR =3\times10^{-8} verir; aynı modelin olabilirlik oranı p'si (0{,}015) geçerlidir, odds oranı satırı yorumlanmaz.
93.4.5 Çoklu test düzeltmesi
Düzeltme yalnız eğilim testi p'lerine ((0{,}1{,}2) skorlu, N paydalı) uygulanır; aile, çalıştırmadaki çözümlenen SNP'lerdir (satır 248). Model p'leri, alelik ve genotipik p'ler düzeltilmez.
Neden varsayılan Benjamini–Hochberg ve neden yalnız eğilim testi?
SNP başına on kadar p değeri üretilir (dört test, beş model); hepsi aynı veriden gelir ve yüksek ilişkilidir. Hepsini düzeltmek anlamsız ölçüde tutucu olur; birini önceden seçmek gerekir. Eğilim testi kalıtım biçimine en az duyarlı tek serbestlik dereceli testtir ve alanın ölçütüdür (Clarke ve ark., 2011). Beş modelden en küçük p'li olanı seçip raporlamak ise düzeltilmemiş bir çoklu karşılaştırmadır (S3).
93.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–92 | Üstbilgi: dokuz parametre, örnek veri ve ayar. | |
| 93–98 | .m(); .gn_eksik ve .gn_genotip ortak yardımcılara (mq_genotip_eksik, mq_genotip) bağlanır. |
Genetik şablonlarının ortak ayrıştırıcısı (Bölüm 1.5). |
| 100–149 | SNP ve ortak değişken listeleri; durumun 0/1'e çevrilmesi; vaka düzeyinin seçimi ve yazılması. | Ortak değişken listesinden durum ve SNP sütunları çıkarılır (102). |
| 150–167 | Ortak değişken çerçevesi (sayısal olmayanlar faktör); ortak değişken düzeylerinde tam ayrışma denetimi; B, güven düzeyi, aralık yöntemi. | |
| 169–175 | egilim(): Sasieni biçimli eğilim \chi^2'si. |
Payda sıfırsa (skor tek değerli) NA. |
| 178–191 | SNP döngüsü: ayrıştırma, eksiksiz bireyler, alel sayımı, küçük alel, x, genotip sayıları. | Tek alelli SNP atlanır; ikiden çok alel çalıştırmayı durdurur (183–184). |
| 192–214 | Alelik, genotipik, üç eğilim \chi^2'si, kontrollerde HW, isteğe bağlı Monte Carlo; testler satırı. |
|
| 215–243 | Boş model m0; kur() yardımcısı; beş model. |
İç sütun adları .mq_y ve .mq_z'dir (216, 221): kullanıcının ortak değişken adlarıyla çakışmaz. kur() tek değerli tasarımda NULL döndürür (220); o model tabloya girmez. |
| 244–257 | Genotip okuma dökümü; düzeltme; özet satırı; üç tablo; notlar; ıraksama denetimi. | |
| 258–270 | Log-eklemeli modelin odds oranı grafiği. | Iraksayan satırlar çizilmez. |
Metin durum sütununda vaka düzeyini belirleyen satırlar sonucun yönünü tayin eder. Ölçütler sırayla denenir (satır 115–141): (1) "Vaka düzeyi" alanı; (2) bilinen vaka/kontrol adları ("Vaka adları" ya da "Kontrol adları" alanı doluysa bu liste yerine alandaki adlar; yalnız biri doluysa aynı adlar öteki bilinen listeden çıkarılır; satır 119–125) (case, vaka, hasta, affected, yes, evet … vaka; control, kontrol, saglam, healthy, normal, no … kontrol); (3) sayı biçimli düzeylerde büyük değer; (4) durum sütunu Veri sekmesinde kategorik ise o sekmedeki düzey sırası (ikinci düzey vaka); (5) alfabetik sıra (ikinci düzey vaka).
yv <- as.numeric(dzc == dl[2])
İkinci düzey vaka sayılır; dl yukarıdaki ölçütle sıralanır. Case/Control, hasta/saglam, astim/normal yazımları ikinci ölçütle doğru çözülür. Ad tanınmıyorsa (ör. A/B) alfabetik sıra kullanılır; şablon seçimi ve ölçütünü "Vaka düzeyi: '…' (kontrol: '…'); seçim ölçütü: …" satırıyla yazar ve sıra ölçütlerinde ("Yanlışsa 'Vaka düzeyi' alanına vaka değerini yazın") uyarır. Vaka düzeyi alanı doldurulursa her zaman o kullanılır.
93.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/vaka_kontrol_genetik/elle_hesap.py ile hesaplanmıştır: eğilim \chi^2'si N r^2 biçiminde, lojistik modeller şablondan bağımsız bir Newton–Raphson döngüsüyle, profil aralıkları kök bulmayla. R tarafında (r_dogrulama.R) chisq.test, prop.trend.test, olabilirliğin nlm ile doğrudan enbüyüklenmesi ve 2\times2 tablonun kapalı formülü kullanılmıştır; glm çağrılmamıştır.
Adım 1 — rs1422993: tablo ve frekanslar. Alel sayıları G: 2\cdot903+570=2376, T: 570+2\cdot105=780; küçük alel T.
| G/G | G/T | T/T | Toplam | |
|---|---|---|---|---|
| Kontrol | 730 | 425 | 83 | 1238 |
| Vaka | 173 | 145 | 22 | 340 |
| Toplam | 903 | 570 | 105 | 1578 |
Adım 2 — Kontrollerde Hardy–Weinberg. q=0{,}2386914; beklenen sayılar 1238\cdot(0{,}5795;\ 0{,}3634;\ 0{,}0570)=(717{,}5;\ 449{,}9;\ 70{,}5); \chi^2=3{,}803, p=0{,}0511984.
Adım 3 — Alelik test. Alel tablosu: kontrol (1885; 591), vaka (491; 189); \chi^2=4{,}4170168, p=0{,}0355822.
Adım 4 — Eğilim testi, skor (0{,}1{,}2).
Aynı değer korelasyondan: S_{xy}=20{,}939163, S_{xx}=604{,}448669, S_{yy}=266{,}742712; r^2=0{,}00271936; N r^2=4{,}2911497. (N-1) biçimi 4{,}2884303. Baskın skorla 7{,}1209463, çekinik skorla 0{,}0234696: sinyal heterozigot fazlalığından gelir, T/T homozigotları vakalarda daha sık değildir.
Adım 5 — Genotipik test. 2\times3 tablonun \chi^2'si 8{,}1766331, sd =2, p=0{,}0167674.
Adım 6 — Eş baskın model, kapalı formül.
Adım 7 — Model karşılaştırması. Boş modelin sapması 1644{,}6069'dur (-2\ell_0; tek parametre).
| Model | OR | %95 GA | G^2 (sd) | p_{\text{OO}} | AIC |
|---|---|---|---|---|---|
| Eş baskın | 1,440; 1,118 | [1,120; 1,850]; [0,679; 1,841] | 8,061 (2) | 0,0177676 | 1642,546 |
| Baskın | 1,387 | [1,090; 1,765] | 7,073 (1) | 0,0078261 | 1641,534 |
| Çekinik | 0,963 | [0,592; 1,565] | 0,024 (1) | 0,8778632 | 1648,583 |
| Aşırı baskın | 1,422 | [1,114; 1,817] | 7,870 (1) | 0,0050257 | 1640,737 |
| Log-eklemeli | 1,221 | [1,010; 1,475] | 4,211 (1) | 0,0401510 | 1644,395 |
Log-eklemeli modelin olabilirlik oranı istatistiği (4,211) ile skor testi olan eğilim \chi^2'si (4,291) aynı hipotezi sınar ve birbirine yakındır.
Adım 8 — Benjamini–Hochberg. Üç SNP'nin eğilim p'leri 0{,}0040683 (rs184448), 0{,}0383113 (rs1422993), 0{,}4946222 (rs4490198); m=3:
Adım 9 — Kesin eğilim testi. Kenar toplamları sabitken vakalardaki genotip sayıları çok değişkenli hipergeometriktir. Bütün olası (r_1,r_2) çiftleri sayılarak skor toplamının beklenenden en az gözlenen kadar uzak olma olasılığı bulunur: rs1422993 için p_{\text{kesin}}=0{,}0424851. Şablonun Monte Carlo p'si (B=9999, tohum 93) 0{,}0448'dir; fark (0{,}0023) Monte Carlo standart hatasına (\sqrt{0{,}0425\cdot0{,}9575/9999}=0{,}0020) uygundur. Kesin p'nin asimptotik p'den (0{,}0383) büyük olması skor toplamının kesikliliğinden gelir.
93.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun "Tek SNP testleri" ve "Kalıtım modelleri" tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1–3 ve 5).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| rs1422993: KAF (kontrol) | 0,23869144 | 0,23869144 | 0,23869144 | 8,3e−17 | ✓ |
| rs1422993: KAF (vaka) | 0,27794118 | 0,27794118 | 0,27794118 | 2,2e−16 | ✓ |
| rs1422993: kontrollerde HWD p | 0,05119842 | 0,05119842 | 0,05119842 | 1,4e−17 | ✓ |
| rs1422993: alelik \chi^2 | 4,41701676 | 4,41701676 | 4,41701676 | 6,0e−16 | ✓ |
| rs1422993: eğilim \chi^2 (N) | 4,29114971 | 4,29114971 | 4,29114971 | 1,0e−14 | ✓ |
| rs1422993: eğilim \chi^2 (N-1) | 4,28843035 | 4,28843035 | 4,28843035 | 1,1e−14 | ✓ |
| rs1422993: eğilim p | 0,03831125 | 0,03831125 | 0,03831125 | 1,3e−15 | ✓ |
| rs1422993: baskın skorlu eğilim \chi^2 | 7,12094628 | 7,12094628 | 7,12094628 | 1,3e−14 | ✓ |
| rs1422993: çekinik skorlu eğilim \chi^2 | 0,02346959 | 0,02346959 | 0,02346959 | 1,9e−15 | ✓ |
| rs1422993: genotipik \chi^2 | 8,17663307 | 8,17663307 | 8,17663307 | 2,2e−16 | ✓ |
| rs1422993: genotipik p | 0,01676744 | 0,01676744 | 0,01676744 | 1,7e−17 | ✓ |
| rs184448: KAF (kontrol) | 0,42774566 | 0,42774566 | 0,42774566 | 3,9e−16 | ✓ |
| rs184448: KAF (vaka) | 0,48798799 | 0,48798799 | 0,48798799 | 0 | ✓ |
| rs184448: kontrollerde HWD p | 0,06753154 | 0,06753154 | 0,06753154 | 7,1e−16 | ✓ |
| rs184448: alelik \chi^2 | 7,69092579 | 7,69092579 | 7,69092579 | 5,8e−16 | ✓ |
| rs184448: eğilim \chi^2 (N) | 8,25307072 | 8,25307072 | 8,25307072 | 1,3e−15 | ✓ |
| rs184448: eğilim \chi^2 (N-1) | 8,24772547 | 8,24772547 | 8,24772547 | 1,3e−15 | ✓ |
| rs184448: eğilim p | 0,00406831 | 0,00406831 | 0,00406831 | 8,8e−17 | ✓ |
| rs184448: baskın skorlu eğilim \chi^2 | 9,35394199 | 9,35394199 | 9,35394199 | 6,1e−15 | ✓ |
| rs184448: çekinik skorlu eğilim \chi^2 | 2,08022366 | 2,08022366 | 2,08022366 | 4,9e−15 | ✓ |
| rs184448: genotipik \chi^2 | 9,65266947 | 9,65266947 | 9,65266947 | 1,8e−16 | ✓ |
| rs184448: genotipik p | 0,00801585 | 0,00801585 | 0,00801585 | 9,0e−17 | ✓ |
| rs4490198: KAF (kontrol) | 0,40528455 | 0,40528455 | 0,40528455 | 4,4e−16 | ✓ |
| rs4490198: KAF (vaka) | 0,42011834 | 0,42011834 | 0,42011834 | 2,8e−16 | ✓ |
| rs4490198: kontrollerde HWD p | 0,09851183 | 0,09851183 | 0,09851183 | 2,1e−16 | ✓ |
| rs4490198: alelik \chi^2 | 0,48291321 | 0,48291321 | 0,48291321 | 2,8e−16 | ✓ |
| rs4490198: eğilim \chi^2 (N) | 0,46645573 | 0,46645573 | 0,46645573 | 3,2e−15 | ✓ |
| rs4490198: eğilim \chi^2 (N-1) | 0,46615824 | 0,46615824 | 0,46615824 | 3,8e−15 | ✓ |
| rs4490198: eğilim p | 0,49462224 | 0,49462224 | 0,49462224 | 1,7e−15 | ✓ |
| rs4490198: baskın skorlu eğilim \chi^2 | 1,08819762 | 1,08819762 | 1,08819762 | 1,7e−14 | ✓ |
| rs4490198: çekinik skorlu eğilim \chi^2 | 0,00203489 | 0,00203489 | 0,00203489 | 3,1e−16 | ✓ |
| rs4490198: genotipik \chi^2 | 1,27404992 | 1,27404992 | 1,27404992 | 2,1e−15 | ✓ |
| rs4490198: genotipik p | 0,52886348 | 0,52886348 | 0,52886348 | 3,3e−16 | ✓ |
| rs1422993: BH düzeltilmiş eğilim p | 0,05746688 | 0,05746688 | 0,05746688 | 2,0e−15 | ✓ |
| rs184448: BH düzeltilmiş eğilim p | 0,01220494 | 0,01220494 | 0,01220494 | 6,2e−17 | ✓ |
| rs4490198: BH düzeltilmiş eğilim p | 0,49462224 | 0,49462224 | 0,49462224 | 1,7e−15 | ✓ |
| rs1422993, eş baskın (G/T – G/G): OR | 1,43964638 | 1,43964638 | 1,43964638 | 3,0e−12 | ✓ |
| rs1422993, eş baskın (G/T – G/G): GA alt | 1,12008219 | 1,12008204 | 1,12008204 | 1,4e−7 | ✓ |
| rs1422993, eş baskın (G/T – G/G): GA üst | 1,85038358 | 1,85038384 | 1,85038384 | 1,4e−7 | ✓ |
| rs1422993, eş baskın (T/T – G/G): OR | 1,11846229 | 1,11846229 | 1,11846229 | 5,1e−13 | ✓ |
| rs1422993, eş baskın (T/T – G/G): GA alt | 0,67949597 | 0,67949585 | 0,67949585 | 1,3e−7 | ✓ |
| rs1422993, eş baskın (T/T – G/G): GA üst | 1,84100854 | 1,84100889 | 1,84100889 | 1,9e−7 | ✓ |
| rs1422993, eş baskın: OO p | 0,01776758 | 0,01776758 | 0,01776758 | 6,1e−15 | ✓ |
| rs1422993, eş baskın: AIC | 1642,54615707 | 1642,54615707 | 1642,54615707 | 2,1e−15 | ✓ |
| rs1422993, baskın (G/T-T/T – G/G): OR | 1,38716945 | 1,38716945 | 1,38716945 | 2,9e−12 | ✓ |
| rs1422993, baskın (G/T-T/T – G/G): GA alt | 1,09020668 | 1,09020655 | 1,09020655 | 1,2e−7 | ✓ |
| rs1422993, baskın (G/T-T/T – G/G): GA üst | 1,76502228 | 1,7650225 | 1,7650225 | 1,2e−7 | ✓ |
| rs1422993, baskın: OO p | 0,00782608 | 0,00782608 | 0,00782608 | 2,0e−15 | ✓ |
| rs1422993, baskın: AIC | 1641,53406852 | 1641,53406852 | 1641,53406852 | 1,5e−15 | ✓ |
| rs1422993, çekinik (T/T – G/G-G/T): OR | 0,9627188 | 0,9627188 | 0,9627188 | 3,7e−13 | ✓ |
| rs1422993, çekinik (T/T – G/G-G/T): GA alt | 0,59208735 | 0,59208723 | 0,59208723 | 1,2e−7 | ✓ |
| rs1422993, çekinik (T/T – G/G-G/T): GA üst | 1,565356 | 1,56535632 | 1,56535632 | 2,0e−7 | ✓ |
| rs1422993, çekinik: OO p | 0,87786315 | 0,87786315 | 0,87786315 | 1,8e−12 | ✓ |
| rs1422993, çekinik: AIC | 1648,58329911 | 1648,58329911 | 1648,58329911 | 1,4e−16 | ✓ |
| rs1422993, aşırı baskın (G/T – G/G-T/T): OR | 1,42244344 | 1,42244344 | 1,42244344 | 3,0e−12 | ✓ |
| rs1422993, aşırı baskın (G/T – G/G-T/T): GA alt | 1,11350907 | 1,11350891 | 1,11350891 | 1,4e−7 | ✓ |
| rs1422993, aşırı baskın (G/T – G/G-T/T): GA üst | 1,81708923 | 1,81708948 | 1,81708948 | 1,4e−7 | ✓ |
| rs1422993, aşırı baskın: OO p | 0,00502566 | 0,00502566 | 0,00502566 | 1,4e−15 | ✓ |
| rs1422993, aşırı baskın: AIC | 1640,73673293 | 1640,73673293 | 1640,73673293 | 2,5e−15 | ✓ |
| rs1422993, log-eklemeli (T alel kopyası başına): OR | 1,22072475 | 1,22072475 | 1,22072475 | 1,9e−12 | ✓ |
| rs1422993, log-eklemeli (T alel kopyası başına): GA alt | 1,01045309 | 1,01045297 | 1,01045297 | 1,2e−7 | ✓ |
| rs1422993, log-eklemeli (T alel kopyası başına): GA üst | 1,47475318 | 1,47475336 | 1,47475336 | 1,2e−7 | ✓ |
| rs1422993, log-eklemeli: OO p | 0,04015098 | 0,04015098 | 0,04015098 | 2,2e−14 | ✓ |
| rs1422993, log-eklemeli: AIC | 1644,39542296 | 1644,39542296 | 1644,39542296 | 5,5e−16 | ✓ |
| rs184448, log-eklemeli (G alel kopyası başına): OR | 1,29913159 | 1,29913159 | 1,29913159 | 2,0e−12 | ✓ |
| rs184448, log-eklemeli (G alel kopyası başına): GA alt | 1,0861872 | 1,08618712 | 1,08618712 | 7,9e−8 | ✓ |
| rs184448, log-eklemeli (G alel kopyası başına): GA üst | 1,55382321 | 1,55382334 | 1,55382334 | 7,9e−8 | ✓ |
| rs184448, log-eklemeli: OO p | 0,00411193 | 0,00411193 | 0,00411193 | 5,5e−16 | ✓ |
| rs184448, log-eklemeli: AIC | 1605,77954876 | 1605,77954876 | 1605,77954876 | 1,7e−15 | ✓ |
| rs4490198, log-eklemeli (G alel kopyası başına): OR | 1,06090541 | 1,06090541 | 1,06090541 | 6,6e−13 | ✓ |
| rs4490198, log-eklemeli (G alel kopyası başına): GA alt | 0,89532375 | 0,89532367 | 0,89532367 | 8,2e−8 | ✓ |
| rs4490198, log-eklemeli (G alel kopyası başına): GA üst | 1,25710983 | 1,25710995 | 1,25710995 | 9,2e−8 | ✓ |
| rs4490198, log-eklemeli: OO p | 0,49506317 | 0,49506317 | 0,49506317 | 1,1e−13 | ✓ |
| rs4490198, log-eklemeli: AIC | 1638,11887443 | 1638,11887443 | 1638,11887443 | 1,4e−15 | ✓ |
| rs1422993, baskın: OR (R sütunu: 2 × 2 tablodan ad/bc) | 1,38716945 | 1,38716945 | 1,38716945 | 2,9e−12 | ✓ |
| rs1422993, baskın: GA üst (R sütunu: \sqrt{1/a+1/b+1/c+1/d}) | 1,76502228 | 1,7650225 | 1,7650225 | 1,2e−7 | ✓ |
| Ülke + sigara düzeltmeli — rs1422993: n | 1571 | 1571 | 1571 | 0 | ✓ |
| Ülke + sigara düzeltmeli — rs1422993: eğilim \chi^2 | 4,4353793 | 4,4353793 | 4,4353793 | 7,0e−15 | ✓ |
| Ülke + sigara düzeltmeli — rs1422993, eş baskın (G/T – G/G): OR | 1,3811985 | 1,3811985 | 1,3811985 | 2,6e−15 | ✓ |
| Ülke + sigara düzeltmeli — rs1422993, eş baskın (G/T – G/G): GA alt | 1,04890819 | 1,04890819 | 1,04890819 | 4,9e−9 | ✓ |
| Ülke + sigara düzeltmeli — rs1422993, eş baskın (G/T – G/G): GA üst | 1,81875716 | 1,81875717 | 1,81875717 | 4,9e−9 | ✓ |
| Ülke + sigara düzeltmeli — rs1422993, eş baskın (T/T – G/G): OR | 1,06370145 | 1,06370145 | 1,06370145 | 6,3e−16 | ✓ |
| Ülke + sigara düzeltmeli — rs1422993, eş baskın (T/T – G/G): GA alt | 0,61267027 | 0,61267026 | 0,61267026 | 1,1e−8 | ✓ |
| Ülke + sigara düzeltmeli — rs1422993, eş baskın (T/T – G/G): GA üst | 1,84676952 | 1,84676955 | 1,84676955 | 1,7e−8 | ✓ |
| Ülke + sigara düzeltmeli — rs1422993, eş baskın: OO p | 0,06939732 | 0,06939732 | 0,06939732 | 1,1e−9 | ✓ |
| Ülke + sigara düzeltmeli — rs1422993, eş baskın: AIC | 1407,87529108 | 1407,8752841 | 1407,8752841 | 5,0e−9 | ✓ |
| Ülke + sigara düzeltmeli — rs1422993, log-eklemeli (T alel kopyası başına): OR | 1,18623309 | 1,18623309 | 1,18623309 | 8,4e−15 | ✓ |
| Ülke + sigara düzeltmeli — rs1422993, log-eklemeli (T alel kopyası başına): GA alt | 0,9619778 | 0,9619778 | 0,9619778 | 4,3e−9 | ✓ |
| Ülke + sigara düzeltmeli — rs1422993, log-eklemeli (T alel kopyası başına): GA üst | 1,46276654 | 1,46276655 | 1,46276655 | 4,5e−9 | ✓ |
| Ülke + sigara düzeltmeli — rs1422993, log-eklemeli: OO p | 0,11191292 | 0,11191291 | 0,11191291 | 1,4e−9 | ✓ |
| Ülke + sigara düzeltmeli — rs1422993, log-eklemeli: AIC | 1408,68410672 | 1408,68409975 | 1408,68409975 | 4,9e−9 | ✓ |
| Ülke + sigara düzeltmeli — rs184448: n | 1537 | 1537 | 1537 | 0 | ✓ |
| Ülke + sigara düzeltmeli — rs184448: eğilim \chi^2 | 8,19576937 | 8,19576937 | 8,19576937 | 2,2e−15 | ✓ |
| Ülke + sigara düzeltmeli — rs184448, log-eklemeli (G alel kopyası başına): OR | 1,37537226 | 1,37537226 | 1,37537226 | 6,5e−16 | ✓ |
| Ülke + sigara düzeltmeli — rs184448, log-eklemeli (G alel kopyası başına): GA alt | 1,12825461 | 1,12825461 | 1,12825461 | 3,5e−9 | ✓ |
| Ülke + sigara düzeltmeli — rs184448, log-eklemeli (G alel kopyası başına): GA üst | 1,67661521 | 1,67661521 | 1,67661521 | 3,5e−9 | ✓ |
| Ülke + sigara düzeltmeli — rs184448, log-eklemeli: OO p | 0,00154526 | 0,00154526 | 0,00154526 | 5,0e−11 | ✓ |
| Ülke + sigara düzeltmeli — rs184448, log-eklemeli: AIC | 1374,90396361 | 1374,9039566 | 1374,9039566 | 5,1e−9 | ✓ |
| Profil olabilirlik %90 — rs1422993, eş baskın (G/T – G/G): GA alt | 1,16575757 | 1,16575873 | — | 1,0e−6 | ✓ |
| Profil olabilirlik %90 — rs1422993, eş baskın (G/T – G/G): GA üst | 1,77685419 | 1,77685422 | — | 1,9e−8 | ✓ |
| Profil olabilirlik %90 — rs1422993, eş baskın (T/T – G/G): GA alt | 0,72552351 | 0,72552423 | — | 7,2e−7 | ✓ |
| Profil olabilirlik %90 — rs1422993, eş baskın (T/T – G/G): GA üst | 1,67910401 | 1,67913645 | — | 1,9e−5 | ✗ |
| Profil olabilirlik %90 — rs1422993, baskın (G/T-T/T – G/G): GA alt | 1,13314811 | 1,13314863 | — | 4,6e−7 | ✓ |
| Profil olabilirlik %90 — rs1422993, baskın (G/T-T/T – G/G): GA üst | 1,69808954 | 1,69808885 | — | 4,1e−7 | ✓ |
| Profil olabilirlik %90 — rs1422993, çekinik (T/T – G/G-G/T): GA alt | 0,63040401 | 0,63040586 | — | 1,9e−6 | ✗ |
| Profil olabilirlik %90 — rs1422993, çekinik (T/T – G/G-G/T): GA üst | 1,42935979 | 1,42938921 | — | 2,1e−5 | ✗ |
| Profil olabilirlik %90 — rs1422993, aşırı baskın (G/T – G/G-T/T): GA alt | 1,15753677 | 1,15753829 | — | 1,3e−6 | ✗ |
| Profil olabilirlik %90 — rs1422993, aşırı baskın (G/T – G/G-T/T): GA üst | 1,74622809 | 1,74622869 | — | 3,4e−7 | ✓ |
| Profil olabilirlik %90 — rs1422993, log-eklemeli (T alel kopyası başına): GA alt | 1,04065282 | 1,04065473 | — | 1,8e−6 | ✗ |
| Profil olabilirlik %90 — rs1422993, log-eklemeli (T alel kopyası başına): GA üst | 1,42952579 | 1,42952704 | — | 8,7e−7 | ✓ |
| rs1422993: Holm düzeltilmiş eğilim p | 0,0766225 | 0,0766225 | 0,0766225 | 2,6e−15 | ✓ |
| rs184448: Holm düzeltilmiş eğilim p | 0,01220494 | 0,01220494 | 0,01220494 | 6,2e−17 | ✓ |
| rs4490198: Holm düzeltilmiş eğilim p | 0,49462224 | 0,49462224 | 0,49462224 | 1,7e−15 | ✓ |
| Satır sırası karıştırılmış — rs184448, log-eklemeli: OR | 1,29913159 | 1,29913159 | 1,29913159 | 2,0e−12 | ✓ |
Ölçütü karşılayan: 109/114. Python: eğilim \chi^2'si N r^2 biçiminde, lojistik modeller kendi Newton–Raphson döngüsüyle, profil aralıkları kök bulmayla hesaplanmıştır. R: chisq.test, prop.trend.test, HardyWeinberg paketinin HWChisq fonksiyonu; lojistik modeller nlm ile (olabilirliğin doğrudan enbüyüklenmesi), baskın modelde ayrıca 2 × 2 tablonun kapalı formülü. Hiçbirinde glm kullanılmamıştır. Güven sınırlarındaki 10^{-7} düzeyindeki farklar glm'nin yakınsama ölçütünden (sapmadaki göreli değişim <10^{-8}) gelir.
Ölçütü aşan beş satırın hepsi profil olabilirlik sınırlarıdır ve en büyük fark 2{,}1\times10^{-5}'tir: confint profili bir ızgarada hesaplayıp ara değerler, bağımsız hesap aynı denklemi kök bulmayla 10^{-13} duyarlıkla çözer. Fark yöntemin sayısal çözünürlüğüdür; sınırların dördüncü ondalığını etkilemez. Ortak değişkenli çalıştırmada Belçika ve Estonya'da kontrol yoktur (14 ve 6 vaka); bu ülkelerin katsayıları sonsuza gider ve 20 birey SNP kestirimine katkı yapmaz. Bağımsız hesaplar bu bireyleri çıkarıp olabilirliğin limitini almış, şablonla aynı odds oranlarını ve AIC'yi bulmuştur.
93.7 Çıktıyı okuma
Örnek ayarın konsol metni:
Vaka düzeyi: 1 (kontrol: 0).
Genotip okuma: 3 lokusta 4734 genotipin 44 tanesi eksik sayıldı (boş hücre: 44; eksik kodu: 0; alellerinden yalnız biri eksik kodu: 0; başka neden: 0).
Vaka–kontrol ilişkilendirmesi: 3 SNP; ortak değişkenler: yok; referans genotip yaygın alel homozigotu
"Tek SNP testleri" tablosu (kısaltılmış, iki parçada):
lokus         n  kucuk_alel  KAF_kontrol  KAF_vaka  HWD_kontrol_p  alelik_chi2  alelik_p
rs1422993  1578  T                0.2387    0.2779         0.0512       4.4170    0.0356
rs184448   1544  G                0.4277    0.4880         0.0675       7.6909    0.0055
rs4490198  1568  G                0.4053    0.4201         0.0985       0.4829    0.4871

lokus      egilim_chi2  egilim_p  egilim_chi2_N1  baskin_  cekinik_  genotipik_chi2  sd  genotipik_p  egilim_p_duzeltilmis
rs1422993       4.2911    0.0383          4.2884   7.1209    0.0235          8.1766   2       0.0168                0.0575
rs184448        8.2531    0.0041          8.2477   9.3539    2.0802          9.6527   2       0.0080                0.0122
rs4490198       0.4665    0.4946          0.4662   1.0882    0.0020          1.2740   2       0.5289                0.4946
"Kalıtım modelleri" tablosundan rs1422993:
model         karsilastirma              OR  GA_alt  GA_ust     p_LRT        AIC
eş baskın     G/T – G/G              1.4396  1.1201  1.8504  0.017768  1642.5462
eş baskın     T/T – G/G              1.1185  0.6795  1.8410  0.017768  1642.5462
baskın        G/T-T/T – G/G          1.3872  1.0902  1.7650  0.007826  1641.5341
çekinik       T/T – G/G-G/T          0.9627  0.5921  1.5654  0.877863  1648.5833
aşırı baskın  G/T – G/G-T/T          1.4224  1.1135  1.8171  0.005026  1640.7367
log-eklemeli  T alel kopyası başına  1.2207  1.0105  1.4748  0.040151  1644.3954
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
n |
Genotipi, durumu ve ortak değişkenleri dolu birey sayısı | SNP'ler arasında farklıysa testler farklı alt örneklerdedir. |
kucuk_alel, KAF_kontrol, KAF_vaka |
Birleşik örnekte seyrek alel ve iki gruptaki frekansı | Odds oranları bu alelin kopyalarına göredir. |
HWD_kontrol_p |
Kontrollerde denge \chi^2 p'si | Kalite göstergesi; küçükse bulgu sorgulanır. |
alelik_chi2, alelik_p |
Alel sayıları üzerinde \chi^2 | Denge varsayar; karşılaştırma içindir. |
egilim_chi2, egilim_p |
Cochran–Armitage, skor (0{,}1{,}2), N paydalı | Ana test. |
egilim_chi2_N1 |
Aynı istatistik × (N-1)/N | Başka kaynaklarla karşılaştırma için. |
baskin_egilim_chi2, cekinik_egilim_chi2 |
Skor (0{,}1{,}1) ve (0{,}0{,}1) ile eğilim \chi^2 | p verilmez; kalıtım biçimi hakkında ipucudur. |
genotipik_chi2, genotipik_sd, genotipik_p |
2\times3 tablo \chi^2'si | Biçim varsaymayan test. |
egilim_p_MC |
Monte Carlo kesin p (B>0 ise) | Küçük hücrelerde asimptotik p'nin yerine. |
egilim_p_duzeltilmis |
Düzeltilmiş eğilim p'si | Raporlanacak p. |
OR, GA_alt, GA_ust |
Odds oranı ve aralığı | Tablo başlığı aralık yöntemini ve düzeyini yazar. |
p_LRT, AIC |
Boş modele karşı olabilirlik oranı p'si; AIC | p düzeltilmemiştir; AIC yalnız aynı SNP'nin modelleri arasında karşılaştırılır. |
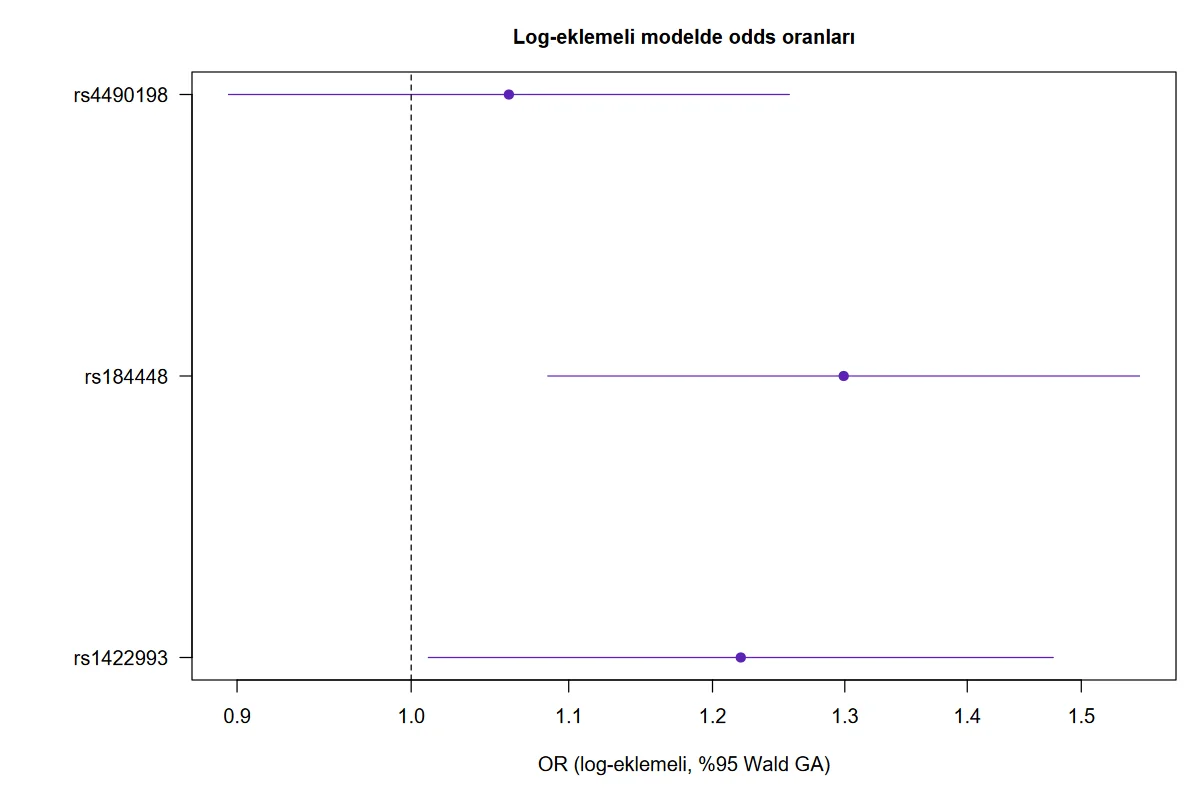
Şekil 93.1. Şablonun çizdiği grafik (örnek veri): log-eklemeli modelde küçük alel kopyası başına odds oranı ve %95 Wald aralığı; kesikli çizgi OR = 1.
Rapor cümlesi (örnek ayar):
Üç SNP'nin astımla ilişkisi 340 vaka ve 1238 kontrolde Cochran–Armitage eğilim testiyle sınandı; p değerleri Benjamini–Hochberg yöntemiyle düzeltildi. rs184448'in G aleli astımla ilişkiliydi (küçük alel frekansı kontrollerde 0,428, vakalarda 0,488; eğilim \chi^2_1 = 8{,}25, düzeltilmiş p = 0{,}012; log-eklemeli modelde alel başına OR = 1,30, %95 GA [1,09; 1,55]). rs1422993'te eğilim düzeltmeden sonra anlamlı değildi (\chi^2_1 = 4{,}29, düzeltilmiş p = 0{,}057); etki heterozigotlarda toplanmıştı (G/T: OR = 1,44, %95 GA [1,12; 1,85]; T/T: OR = 1,12, %95 GA [0,68; 1,84]). Kontrollerde hiçbir SNP Hardy–Weinberg dengesinden anlamlı sapmadı (p \ge 0{,}051).
93.8 Sık hatalar ve tuzaklar
- Metin durum sütununda vaka düzeyini denetlememek. Adlar bilinen vaka/kontrol adları değilse (ör.
A/B) vaka alfabetik ikinci düzeydir; yanlış seçilirse bütün odds oranları tersine döner (rs1422993'ün eş baskın odds oranı 1,44 yerine 0,69, kontrollerdeki Hardy–Weinberg p'si 0,051 yerine 0,249 çıkar; \chi^2 ve p değerleri aynı kalır). Konsoldaki "Vaka düzeyi: …" satırı okunur, gerekirse "Vaka düzeyi" alanı doldurulur ya da durum 0/1 kodlanır. - Ortak değişken düzeyinde tam ayrışma. Ortak değişkenin bir düzeyi yalnız vaka ya da yalnız kontrol içeriyorsa (örnekte Belçika 14 vaka, Estonya 6 vaka; kontrol yok) o düzeyin katsayısı sonsuza gider; çıktı bunu uyarır. SNP odds oranları bu bireylerin bilgisinden etkilenmez, ama
nonları da sayar. - Alelleri 0 ve 1 diye adlandırmak.
0eksik simgesidir;0/0eksik genotip sayılır,0/1ise iki alelin yalnız biri eksik kodu olduğundan çalıştırmayı "alellerinden yalnız biri eksik kodu ('0'; ör. '0/1')" iletisiyle durdurur. Sayısal 0/1/2 kodlama ya da harf adları kullanılır. - Eksik genotipi tanınmayan bir kodla yazmak.
-9/-9eksik sayılır; listede olmayan bir kod (ör.NN) üçüncü alel sayılır ve çalıştırma "iki alelli değil" iletisiyle durur. Eksik genotip boş bırakılır ya da tanınan bir kodla yazılır. - Sayısal kodlu kategorik ortak değişken. Ülke ya da merkez 1, 2, 3 … diye kodlanmışsa sayısal sütun olarak modele doğrusal girer. Sütun veri sekmesinde kategorik türe çevrilir; örnekte ülkenin sayısal kodu log-eklemeli OR'yi 1,216, kategorik hâli 1,178 verir.
- Beş modelden en küçük p'liyi raporlamak. Model p'leri düzeltilmez ve aynı veride beş ilişkili testtir. Kalıtım modeli önceden belirlenir ya da en iyi model AIC ile seçilip p'si keşif amaçlı sunulur (S3).
- Alelik testi ana test saymak. Dengeden sapma varsa düzeyi korumaz; ana test eğilim testidir.
- Iraksayan odds oranını yorumlamak. Bir genotip bir grupta hiç yoksa odds oranı 0 ya da sonsuz çıkar ve uyarı yazılır; bu satırlar yerine olabilirlik oranı p'si ya da
kesin_lojistikkullanılır. - Tabakalaşmayı göz ardı etmek. Vaka ve kontroller farklı kökenlerden geliyorsa alel frekansı farkı hastalıkla ilgisiz olabilir. Köken göstergeleri ortak değişken yapılır; örnekte ülke ve sigara düzeltmesi
rs1422993'ün log-eklemeli odds oranını 1,22'den 1,19'a indirir ve anlamlılığı kaldırır (p=0{,}112). - SNP listesine genotip olmayan sütun eklemek. Yalnız 0, 1, 2 içeren her sayısal sütun (sigara 0/1) SNP gibi çözümlenir ve düzeltme ailesine girer.
- Ortak değişkendeki eksikleri hesaba katmamak. Her eksik birey bütün testlerden düşer; \chi^2 testleri de küçülen örnekte yapılır.
93.9 Uzman soruları
S1. Eğilim testi ile log-eklemeli lojistik model aynı şey mi?
Aynı hipotezin (\beta=0) iki testidir. Eğilim \chi^2'si (N paydalı) log-eklemeli modelin skor testidir: yalnız boş model altındaki türevlere dayanır ve kapalı formüllüdür. Şablonun p_LRT sütunu aynı modelin olabilirlik oranı testidir. Büyük örneklemde ikisi yakınsar (rs1422993: 4,291 ve 4,211); küçük örneklemde ayrışabilir. Ortak değişken varken eğilim testi düzeltilmez, olabilirlik oranı testi düzeltilir; düzeltmeli çözümlemede karar p_LRT üzerinden verilir.
S2. N ve N-1 paydalı eğilim istatistikleri arasındaki fark nereden gelir?
Skor toplamının varyansı iki biçimde yazılabilir: binom (koşulsuz) modelde N, kenar toplamlarına koşullu (hipergeometrik) modelde N-1 paydasıyla. Oranları (N-1)/N'dir; N=1578'de fark dördüncü ondalıktadır. Karşılaştırılan kaynak hangi biçimi kullanıyorsa o sütun alınır: prop.trend.test N biçimini, permütasyon tabanlı araçlar N-1 biçimini verir.
S3. Hangi kalıtım modeli seçilmeli?
Biyolojik ön bilgi varsa o model. Yoksa iki savunulabilir yol vardır: (1) kalıtım biçimine en az duyarlı tek testi (eğilim, yani log-eklemeli) önceden seçmek; (2) eş baskın modeli (2 sd) genel test olarak kullanıp öteki modelleri AIC ile betimlemek. Savunulamayan yol, beş p'den en küçüğünü düzeltmeden raporlamaktır: rs1422993'te en küçük model p'si 0,005 (aşırı baskın) iken eğilim p'si 0,038'dir. En büyük istatistiğin dağılımını hesaba katan birleşik testler (Freidlin ve ark., 2002) şablonda yoktur.
S4. Referans genotip neden yaygın alelin homozigotu ve bu sonucu değiştirir mi?
Yaygın homozigot en kalabalık hücredir; referans alındığında odds oranlarının standart hataları en küçük olur. Seçim testleri değiştirmez: \chi^2'ler, olabilirlik oranı p'leri ve AIC kodlamadan bağımsızdır. Değişen, odds oranlarının yönü ve "baskın"/"çekinik" adlarının hangi alele göre okunduğudur: şablonda baskın model, küçük alelin baskın olduğu modeldir. 0/1/2 kodlamasında B aleli yaygınsa küçük alel A olur; kucuk_alel sütunu bunu gösterir.
S5. Wald ve profil olabilirlik aralıkları ne zaman ayrışır?
Olabilirlik katsayı çevresinde simetrik değilse: küçük hücrelerde ve odds oranı 1'den uzakken. Örnek veride (N=1578) fark üçüncü ondalıktadır. Seyrek veride Wald aralığı gereğinden geniş ya da dar kalabilir, profil aralığı olabilirlik oranı testiyle tutarlıdır (aralık 1'i içermez \Leftrightarrow p_{\text{OO}}<\alpha). Tam ayrışmada profil aralığının bir ucu da sonsuzdur; hiçbir aralık yöntemi sonlu kestirim üretmez.
S6. Kontrollerde Hardy–Weinberg sapması bulgu için ne anlama gelir?
Üç açıklama vardır: genotipleme hatası (çoğu zaman heterozigotların eksik okunması), kontrol grubunda tabakalaşma, rastlantı. İlk ikisi ilişki testini de bozar. Şablon \chi^2 yaklaşımını verir; küçük alel frekansı düşükse kesin test için hardy_weinberg yalnız kontrollerle çalıştırılır. Örnekte rs1422993'ün kontrol p'si 0,051'dir: eşiğin hemen üstündedir ve T/T homozigotları beklenenden çoktur (83 gözlenen, 70,5 beklenen); bu SNP'nin bulgusu ihtiyatla sunulur.
S7. Monte Carlo kesin p ne zaman gerekir ve neden düzeltmeye girmiyor?
Asimptotik \chi^2 yaklaşımı beklenen hücre sayıları küçükken (nadir alel, az vaka) bozulur. Monte Carlo p'si, durum etiketlerinin permütasyon dağılımına dayanır ve örneklem büyüklüğünden bağımsız geçerlidir; çözünürlüğü 1/(B+1)'dir. Şablon bu sütunu bilgi olarak verir; düzeltme asimptotik p'lere uygulanır. Çok testte Monte Carlo p'lerini düzeltmek için B çok büyük seçilmelidir (Bölüm 78.4.6). Örnekte kesin değer 0,0425, asimptotik değer 0,0383'tür: büyük örneklemde bile skor toplamının kesikliliği p'yi %10 kadar büyütür.
S8. Ortak değişkenle düzeltme her zaman doğru mu?
Hayır. Ortak değişken hem genotiple hem hastalıkla ilişkiliyse (köken, ülke) düzeltme yanlılığı giderir. Genotipin hastalığa etkisinin yolu üzerindeyse (ör. gen → vücut kitle indeksi → astım) düzeltme gerçek etkiyi siler. Yalnız hastalıkla ilişkili bir değişkenle düzeltme lojistik modelde odds oranını büyütme eğilimindedir ve gücü pek artırmaz. Seçim nedensel akıl yürütmeye dayanır, anlamlılığa değil. Ayrıca bir ortak değişken düzeyinde yalnız vaka ya da yalnız kontrol varsa o bireyler SNP kestirimine katkı yapmaz (örnekte iki ülke, 20 vaka); n sütunu bunları sayar ama etkin örnek daha küçüktür.
93.10 Kaynaklar
- Albert, A., & Anderson, J. A. (1984). On the existence of maximum likelihood estimates in logistic regression models. Biometrika, 71(1), 1–10. https://doi.org/10.1093/biomet/71.1.1
- Armitage, P. (1955). Tests for linear trends in proportions and frequencies. Biometrics, 11(3), 375–386. https://doi.org/10.2307/3001775
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B, 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Clarke, G. M., Anderson, C. A., Pettersson, F. H., Cardon, L. R., Morris, A. P., & Zondervan, K. T. (2011). Basic statistical analysis in genetic case-control studies. Nature Protocols, 6(2), 121–133. https://doi.org/10.1038/nprot.2010.182
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Freidlin, B., Zheng, G., Li, Z., & Gastwirth, J. L. (2002). Trend tests for case-control studies of genetic markers: Power, sample size and robustness. Human Heredity, 53(3), 146–152. https://doi.org/10.1159/000064976
- González, J. R., Armengol, L., Solé, X., Guinó, E., Mercader, J. M., Estivill, X., & Moreno, V. (2007). SNPassoc: An R package to perform whole genome association studies. Bioinformatics, 23(5), 654–655. https://doi.org/10.1093/bioinformatics/btm025
- Hothorn, T., Hornik, K., van de Wiel, M. A., & Zeileis, A. (2006). A Lego system for conditional inference. The American Statistician, 60(3), 257–263. https://doi.org/10.1198/000313006X118430
- Lewis, C. M. (2002). Genetic association studies: Design, analysis and interpretation. Briefings in Bioinformatics, 3(2), 146–153. https://doi.org/10.1093/bib/3.2.146
- Mantel, N. (1963). Chi-square tests with one degree of freedom; extensions of the Mantel-Haenszel procedure. Journal of the American Statistical Association, 58(303), 690–700. https://doi.org/10.1080/01621459.1963.10500879
- Sasieni, P. D. (1997). From genotypes to genes: Doubling the sample size. Biometrics, 53(4), 1253–1261. https://doi.org/10.2307/2533494
- Venzon, D. J., & Moolgavkar, S. H. (1988). A method for computing profile-likelihood-based confidence intervals. Applied Statistics, 37(1), 87–94. https://doi.org/10.2307/2347496
- Wittke-Thompson, J. K., Pluzhnikov, A., & Cox, N. J. (2005). Rational inferences about departures from Hardy-Weinberg equilibrium. American Journal of Human Genetics, 76(6), 967–986. https://doi.org/10.1086/430507