139. Hedefli en çok olabilirlik kestirimi (TMLE) ve Super Learner
Şablon kimliği: tmle · Kategori: nedensel çıkarım · Dil: R · Dosya: pro/sablonlar/nedensel/tmle.R (satır 1–279; üstbilgi 1–109) · Örnek veri: _ornek/tmle_jss.csv · Paketler: tmle 2.1.1, SuperLearner 2.0-42, glmnet 5.1, gam 1.22-7 (geniş kütüphanede ranger 0.18.0; R 4.5.3) · Yan dosya: yok (üstbilgi 10. satır kitap dışıdır)
139.1 Ne işe yarar
Şablon, ikili bir tedavinin (ilaç, program, maruziyet; A\in\{0{,}1\}) bir sonuç (Y; sürekli ya da 0/1) üzerindeki ortalama nedensel etkisini gözlemsel veriden kestirir. Her gözlemin iki potansiyel sonucu vardır, Y(1) ve Y(0); yalnız biri görülür. Aranan büyüklükler
ve tedavi görenler ile görmeyenler için ATT =\mathrm{E}[Y(1)-Y(0)\mid A=1], ATC =\mathrm{E}[Y(1)-Y(0)\mid A=0]'dır; sonuç 0/1 ise risk oranı \mathrm{EY}_1/\mathrm{EY}_0 ve olasılık oranı da verilir. Karıştırıcılar W (ortak değişkenler) gözlendiğinde ve pozitiflik sağlandığında (0<\Pr(A=1\mid W)<1) bu büyüklükler iki gözlenebilir işlevle yazılır:
- Q: sonuç regresyonu; g: eğilim skoru (tedavi mekanizması).
- Varsayımlar: tutarlılık (Y=Y(A)), koşullu değiştirilebilirlik (tüm karıştırıcılar W'de), pozitiflik. Hiçbiri veriden sınanamaz; yalnız pozitiflik eğilim skoru dağılımına bakılarak yoklanabilir.
TMLE (van der Laan ve Rubin, 2006) üç adımda çalışır: (1) Q ve g esnek makine öğrenmesi topluluğu Super Learner ile (van der Laan ve ark., 2007) kestirilir; (2) Q'nun başlangıç kestirimi, g'ye bağlı bir "akıllı ortak değişken" doğrultusunda tek parametreli bir lojistik dalgalandırmayla hedeflenir; (3) hedeflenmiş Q'nun ortalaması plug-in kestirici olarak alınır ve standart hata etki fonksiyonundan hesaplanır. Sonuç çift sağlamdır: Q ya da g'den biri tutarlı kestirilirse kestirici tutarlıdır; ikisi de tutarlı ise yarı parametrik açıdan etkindir (Gruber ve van der Laan, 2012; Schuler ve Rose, 2017). Çıktı biçimsel olarak AIPW'ye (Bölüm 125) benzer; fark, AIPW'nin düzeltmeyi toplama eklemesi, TMLE'nin düzeltmeyi Q'nun içine yedirmesidir: hedeflenmiş kestirimler her zaman sonuç alanının içinde kalır (0/1 sonuçta olasılık [0{,}1]) ve Q kötü kestirildiğinde bile ağırlıklar kararlıdır (Porter ve ark., 2011).
Ne zaman kullanılır?
- Karıştırıcı sayısı fazla ya da ilişki biçimi bilinmiyor; Q ve g için esnek öğreniciler isteniyor.
- Sonuç 0/1 ve risk farkının yanında risk oranı ile olasılık oranı birlikte gerekiyor.
- ATE, ATT ve ATC'nin aynı kestirimde yan yana verilmesi isteniyor.
Ne zaman kullanılmaz?
- Hızlı, öğrenicisiz çift sağlam kestirim ve sandviç SH: Bölüm 125
cift_saglam_aipw(Python: Bölüm 126). - Çapraz uydurmalı çift makine öğrenmesi: Bölüm 124
cift_makine_ogrenmesi. - Yalnız ağırlıklandırma ve denge tanısı (SMD, ağırlık dağılımı): Bölüm 127
dengeleme_agirliklari(Python: Bölüm 128). - Gözlenmeyen karıştırıcı kuşkusu: Bölüm 131
ihmal_duyarlilik(Python: Bölüm 132). TMLE gözlenmeyen karıştırıcıyı gideremez. - Zamana göre değişen tedavi: Bölüm 134
msm_ipw. Üç ya da daha çok düzeyli tedavi bu şablonda yoktur. - Çok küçük örneklem (n onlarla ölçülür): Super Learner'ın çapraz doğrulaması kararsızdır;
glmseçeneği daha güvenlidir.
Temel programla ilişki. Temel programdaki eğilim skoru paneli eşleştirme, ters olasılık ağırlıklandırma ve tabakalama yapar; makine öğrenmesi topluluğuyla Q ve g kestiren, hedefleme adımı olan ve etki fonksiyonu SH'si veren yöntem yalnız bu şablondadır.
139.2 Şablonun girdileri
Form, üstbilgideki 14 [[param]] bloğundan kurulur (tmle.R:11–108). Türlerin anlamı ve formun ortak denetimi Bölüm 1.2'dedir.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
İkili tedavi değişkeni · tedavi |
sütun · Değişkenler | ilk sütun | tam iki düzeyli | Tedavi A (11–15, 122–135). |
Tedavi sayılan düzey · tedavi_duzeyi |
metin · Değişkenler | boş | boş ya da tedavi sütunundaki iki düzeyden biri | Boşsa sayısalda büyük, metinde alfabetik son düzey; doluysa yazılan düzey tedavi sayılır (16–22, 125–134). |
Sonuç değişkeni · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal; 0/1 ise ikili | Y; ikili ise family = "binomial" (23–27, 136–138, 189). |
Ortak değişkenler · ortak |
sütunlar · Değişkenler | yok | en az 1 sütun | W (28–33, 115–116, 140–160). |
Q ve g için öğrenici kütüphanesi · ogrenici |
seçim · Model | sl_standart |
sl_standart, sl_genis, glm |
Kütüphane (34–40, 161–174). |
Q'nun başlangıç kestirimi çapraz doğrulamalı · cv_q |
onay · Gelişmiş | işaretli | işaretli / değil | cvQinit (41–46, 190). |
g alt kırpma sınırı · g_sinir |
ondalık · Seçenekler | 0 (otomatik) | 0–0,2 | gbound; 0 ise 5/(\sqrt n\ln n) (47–54, 175–176). |
Q Super Learner çapraz doğrulama katı · kat_q |
tamsayı · Gelişmiş | 10 | 2–20 | V.Q (55–62, 179). |
g Super Learner çapraz doğrulama katı · kat_g |
tamsayı · Gelişmiş | 10 | 2–20 | V.g (63–70, 180). |
Hedefleme (dalgalanma) modeli · dalgalanma |
seçim · Model | logistic |
logistic, linear |
fluctuation (71–78, 181). |
Ölçeklenmiş Q kestirimlerinin sınırı \alpha · y_sinir |
ondalık · Gelişmiş | 0,9995 | 0,9–0,999999 | alpha (79–86, 183). |
g modelinde ortak değişken ön elemesi · on_eleme_g |
onay · Gelişmiş | işaretli | işaretli / değil | prescreenW.g (87–93, 184). |
Ağırlıkları hedefleme adımına taşı · hedef_gwt |
onay · Gelişmiş | işaretsiz | işaretli / değil | target.gwt (94–100, 185). |
Güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | alpha.sig = 1 − guven (101–108, 186). |
Şablonun kendi denetimleri (mq_hata):
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 113 |
| Tedavi ve sonuç aynı sütun | "Tedavi ve sonuç farklı olmalı." | 114 |
| Tedavi ve sonuçtan farklı ortak değişken yok | "… en az bir ortak değişken seçin." | 115–116 |
| Tam gözlem sayısı <20 | "En az 20 tam gözlem gerekli." | 118–120 |
| Tedavinin düzey sayısı \ne2 | "Tedavi değişkeninin tam iki düzeyi olmalı." | 126 |
tedavi_duzeyi tedavi sütununda yok |
"'…' düzeyi tedavi sütununda yok; düzeyler: …" | 130–131 |
| Bir tedavi grubunda <5 gözlem | "Her tedavi grubunda en az 5 gözlem gerekli." | 135 |
| Sonuç sabit | "Sonuç değişkeni sabit." | 137 |
| Ortak değişken ondalık virgüllü sayılardan oluşan metin | "'…' sütunu ondalık virgüllü sayılardan oluşuyor … Ondalık ayırıcı nokta olmalıdır." | 143–146 |
| Kategorik ortak değişken tek düzeyli | "'…' sabit (tek düzeyli); … çıkarın." | 151 |
| Sayısal ortak değişken sabit | "'…' sabit; … çıkarın." | 156 |
| Tasarım matrisi eş doğrusal | "Ortak değişkenler doğrusal bağımlı …" | 160 |
tmle hata verdi |
"TMLE kestirilemedi: …" | 191 |
| \hat g sınırı dışında kalan gözlem payı \ge\%20 | "Eğilim skoru modeli tam (ya da yarı) ayrışma gösteriyor: …" | 195–200 |
Eksik değerli satırlar sessizce atılır (complete.cases, 118); çıktıdaki n atıldıktan sonraki sayıdır. Tedavi ya da sonuç ortak değişken listesindeyse listeden çıkarılır (115). ranger, gam ya da glmnet kurulu değilse ilgili öğrenici kütüphaneden çıkarılır ve konsola uyarı yazılır (167–174).
Tedavi düzeyi. Düzeyler sütun türüne ve Veri sekmesindeki sıraya bakılmadan, değerlerin metin biçimlerinden kurulur (mq_kimlik, 122–125). Tüm düzeyler sayıya çevrilebiliyorsa sayısal sıra kullanılır ve büyük olan düzey tedavidir (0/1 ve 1/2 kodlamalarında 1 ve 2); değilse düzeyler bayt sırasıyla (sort(method = "radix"), 128) dizilir ve sıradaki son düzey tedavi sayılır (kontrol < tedavi). Böylece aynı iki etiket, sütun metin ya da "kategorik" türde olsa da veride ilk görülme sırası ne olursa olsun aynı grubu tedavi sayar; kural Python ikizlerinde de aynıdır. tedavi_duzeyi alanı doluysa yazılan düzey tedavi, öteki kontrol olur (129–134); alan iki düzeyden birine eşit değilse çalıştırma durur. Çıktı hangi düzeyin tedavi, hangisinin kontrol sayıldığını ve kuralı yazar (214–216).
Tohum. Şablon tohumu kodda sabitlemez. Super Learner'ın çapraz doğrulama katları, Q'nun çapraz doğrulamalı başlangıç kestirimi ve glmnet'in çapraz doğrulaması R'nin rastgele sayı üretecini kullanır; üreteç kullanıcı kodundan önce set.seed(mq_tohum) ile kurulur (Bölüm 1.3). Kod panelinin Tohum alanı boşsa her çalıştırmaya yeni bir tohum atanır ve sonuç çalıştırmadan çalıştırmaya değişir; alana aynı tohum yazıldığında ya da kayıtlı betik yeniden oynatıldığında sonuç yinelenir. Yalnız ogrenici = glm ve cv_q işaretsizken hesap tohumdan bağımsızdır (139.8).
Örnek ayar (ornek_param, satır 9): tedavi = A, y = Y, ortak = W1, W2, W3, ogrenici = glm, cv_q = false, g_sinir = 0. Form varsayılanı ise sl_standart ve cv_q = true'dur; bu bölümdeki sayılar, aksi söylenmedikçe örnek ayara aittir ve tohumdan bağımsızdır.
139.3 Örnek veri
tmle_jss.csv, Gruber ve van der Laan'ın (2012, Bölüm 6.1) tmle makalesindeki benzetim örneğidir: 250 gözlem, 5 sütun, eksik değer yok. W_1,W_2,W_3 standart normal çevresinde karıştırıcılar, A tedavi (120 tedavi, 130 kontrol), Y 0/1 sonuç.
| Değişken | Rol | Tür (veri sekmesinin algıladığı) | Özet |
|---|---|---|---|
W1 |
ortak değişken | sayısal | ort. -0{,}102, SS 1{,}039 |
W2 |
ortak değişken | sayısal | ort. -0{,}047, SS 0{,}984 |
W3 |
ortak değişken | sayısal | ort. 0{,}023, SS 1{,}061 |
A |
tedavi | ikili | 0{,}480 tedavi |
Y |
sonuç | ikili | tedavide 0{,}792, kontrolde 0{,}554 |
Ham risk farkı 0{,}792-0{,}554=0{,}238'dir; karıştırıcılar düzeltildiğinde bu sayı değişir (139.6). Düzey sırası: A ve Y sayısal 0/1 olduğundan düzey sırası sorunu yoktur. Bu bölümde kullanılan çalıştırmalar (tmle_ornek örnek ayardır; öteki adlar tm_…): g10 (g sınırı 0{,}1), gwt (hedef ağırlık), lin (doğrusal dalgalanma), guven90, ornek_glm_cv ve ornek_glm_cv2 (glm + çapraz doğrulama, tohum 101 ve 202), sl_s1, sl_s2, sl_s1b (sl_standart, tohum 101, 202, 101), genis_s1, genis_s2, genis_s2b (sl_genis, tohum 101, 202, 303), t12 (tedavi 1/2), metin, metin_ters, metin_ters_kat, y12, y100, eksik, n30, ayrisma, zayif_ortusme, kat, kat_metin, virgul, gurultu_on, gurultu_off; sürekli sonuç için lalonde.csv (LaLonde, 1986; 614 gözlem; treat, re78) ile surekli ve surekli_lin. Türetilmiş veriler dogrulama/tmle/veri_uret.py ile üretilmiştir.
139.4 Yöntem: formüller ve hesap adımları
Hesap sırası: veri ve tasarım matrisi hazırlanır (113–160); kütüphane seçilir (161–174); tmle::tmle çağrılır (175–192): içinde Q ve g kestirilir, g kırpılır, Q hedeflenir, parametreler ve etki fonksiyonları hesaplanır, ATT ve ATC ayrıca hedeflenir; tablolar, özdeşlik denetimi, Super Learner ağırlıkları ve şekil yazılır (193–278). Aşağıda paketin (tmle 2.1.1) belgelenmiş ve kaynak kodunda izlenen hesabı anlatılır.
139.4.1 Super Learner: Q ve g'nin kestirimi
Kütüphane \{\psi_1,\ldots,\psi_J\} öğrenicilerden oluşur. Super Learner her öğrenicinin V katlı çapraz doğrulamayla elde edilen tahminlerini Z_{ij} ile gösterir ve \sum_j w_j=1, w_j\ge0 koşuluyla
(negatif olmayan en küçük kareler, ardından toplamı 1'e normlama; SuperLearner varsayılanı method.NNLS) ağırlıklarını bulur; son tahmin, her öğrenicinin tüm veriyle uydurulmuş tahminlerinin \hat w ağırlıklı toplamıdır. Q için girdi (A,W), g için W'dir. Şablon üç kütüphane sunar (161–166):
ogrenici |
Q kütüphanesi | g kütüphanesi |
|---|---|---|
glm |
SL.glm |
SL.glm |
sl_standart |
SL.glm, SL.glm.interaction, SL.gam, SL.glmnet, SL.mean |
SL.glm, SL.gam, SL.glmnet, SL.mean |
sl_genis |
standart + SL.ranger |
standart + SL.ranger (SL.glm.interaction yok) |
SL.glm: ana etkili GLM;SL.glm.interaction: tüm ikili etkileşimli GLM (Y ~ .^2);SL.gam: düzgünleştirme spline'lı toplamsal model (deg.gam = 2);SL.glmnet: lasso (alpha = 1, 10 katlı çapraz doğrulama,useMin = TRUE);SL.ranger: 500 ağaçlı rastgele orman;SL.mean: ağırlıklı ortalama.
glm seçeneğinde kütüphane tek öğrenicidir ve ağırlığı 1'dir; Super Learner bu durumda tüm veriyle uydurulan ana etkili GLM'e iner. cv_q işaretliyse Q'nun başlangıç kestirimi ayrıca "çapraz doğrulamalı" yapılır: her kat için ağırlığı sıfırdan büyük öğreniciler katın dışında uydurulup kattaki gözlemler tahmin edilir. Hedefleme bu örneklem dışı \hat Q üzerinde yürür; kat_q ve kat_g katlama sayısıdır. Tablo 3'teki "SL_agirligi" sütunu \hat w'dir (örnek ayarda her ikisi için 1; 139.7).
Koddaki tercih
g'nin Super Learner'ı yalnız eğilim skorunu yordar. on_eleme_g işaretliyse (= prescreenW.g) ortak değişken sayısı min.retain'i aşınca (burada \min\{\lceil n_{\rm etk}/20\rceil,\ p\}, n_{\rm etk}=\min\{5n_0,\,5n_1,\,n\}) W'nin g modeline girecek altkümesi, sonuçla ilişkisine göre cv.glmnet (Y'nin W üzerinde lasso regresyonu) ile seçilir; sonuçla ilişkisiz görülen değişkenler eğilim modelinden çıkar (tmle:::.prescreenW.g). Örnek veride p=3\le\min.retain olduğundan elenen yoktur. Seçimin hangi değişkenleri attığı çıktıya yazılmaz (139.8).
139.4.2 Eğilim skorunun kırpılması
\hat g'nin 0'a çok yakın değerleri 1/\hat g ağırlığını patlatır. Şablon alt sınırı g_sinir ile verir; 0 ise (gb=\,NULL, 175–176) paketin varsayılanı kullanılır:
- n: tam gözlem sayısı; örnek veride \mathrm{gb}=5/(\sqrt{250}\ln250)=0{,}05727 (konsol satırı "g sınırı = 0,05727").
- \hat g_1,\hat g_0: tedavi ve kontrol için hesapta kullanılan kırpılmış olasılıklar; \hat g_1+\hat g_0 kırpılan gözlemlerde 1'i aşabilir.
Şablon "g sınırının altında kalan gözlem" sayısını yazar: \hat g<\mathrm{gb} ya da 1-\hat g<\mathrm{gb} olanlar (269–270). Kırpma tek taraflı \hat g\ge\mathrm{gb} değil, iki taraflıdır.
139.4.3 Hedefleme: akıllı ortak değişken ve dalgalanma
Sonuç [0{,}1] dışındaysa önce ölçeklenir: Y^*=(Y-a)/(b-a), a,b sonucun (sınırları \%1 genişletilmiş) en küçük ve en büyük değeri; 0/1 sonuçta a=0, b=1. Başlangıç tahminleri [1-\alpha,\ \alpha] aralığına kırpılır (\alpha = y_sinir, 0,9995). Hedefleme lojistik dalgalanmada
modelinin iki ek parametresi (\varepsilon_0,\varepsilon_1), kesişimsiz ve \operatorname{logit}\hat Q sapma (offset) olarak, binom GLM'le bulunur. Dönüşte \hat Q^*(1,W)=\operatorname{expit}\{\operatorname{logit}\hat Q(1,W)+\varepsilon_1/\hat g_1\}, \hat Q^*(0,W)=\operatorname{expit}\{\operatorname{logit}\hat Q(0,W)+\varepsilon_0/\hat g_0\} ve sonuç özgün ölçeğe \hat Q^{*}(b-a)+a ile taşınır. Hedeflenmiş kestirimler
- H_1=A/\hat g_1 ve H_0=(1-A)/\hat g_0: "akıllı ortak değişkenler"; tek bir H=A/\hat g_1-(1-A)/\hat g_0 ile aynı düzeltmeyi, ama iki ayrı katsayıyla yapar.
- Dalgalanma, ATE'nin etki fonksiyonunun hedef denklemini çözer: n^{-1}\sum_i H_i(Y_i-\hat Q^*_i)=0 (139.6'da sayısal olarak -2{,}5\times10^{-17} çıkar). Bu denklem çift sağlamlığı ve etkinliği sağlayan koşuldur.
hedef_gwt işaretliyse H_1,H_0 yerine A ve 1-A kullanılır ve gözlem ağırlığı A/\hat g_1+(1-A)/\hat g_0 olur; \varepsilon'lar eklenirken bölünmezler. Aynı hedef denklem çözülür; fark yalnız sayısal kararlılıktadır (küçük \hat g'de ağırlığın regresyon ağırlığına taşınması). Doğrusal dalgalanma (dalgalanma = linear) sürekli sonuçta ölçekleme yapmadan Gauss dalgalanması kurar; logistic önerilir. 0/1 sonuçla linear birlikte kullanıldığında hedeflenmiş değerler olasılık ölçeğine dönmez, logit ölçeğinde kalır (139.8).
139.4.4 Etki fonksiyonu ve standart hatalar
Her parametrenin standart hatası etki fonksiyonundan hesaplanır:
\mathrm{IC}_{{\rm EY}_1,i}=\dfrac{A_i}{\hat g_{1i}}(Y_i-\hat Q^*_i)+\hat Q^*(1,W_i)-\widehat{\mathrm{EY}}_1 ve \mathrm{IC}_{{\rm EY}_0,i} benzerdir; \widehat{\mathrm{Var}} örneklem varyansıdır (n-1 bölenli). Güven aralığı \hat\theta\pm z_{1-\alpha/2}\mathrm{SH} ve p=2\Phi(-|\hat\theta/\mathrm{SH}|)'dir. 0/1 sonuçta ATE aralığı [-1{,}1]'e, \mathrm{EY} aralıkları [0{,}1]'e kırpılır. Risk ve olasılık oranları log ölçeğinde delta yöntemiyle (etki fonksiyonu üzerinden):
Aralık \exp\{\log\hat\theta\pm z\cdot\mathrm{SH}_{\log}\}'dır; tablodaki "SH_log" log ölçeğindeki standart hatadır.
Etki fonksiyonu SH'si neyi saymaz
SH, \hat Q ve \hat g'nin kestirim belirsizliğini ayrıca hesaba katmaz; etkin etki fonksiyonuna dayanır ve Q, g ya da ikisi birden iyi öğrenildiğinde asimptotik olarak geçerlidir. Çok küçük örneklemde ya da zayıf örtüşmede SH iyimserdir. Şablonda bootstrap yoktur (B = 1).
139.4.5 ATT ve ATC: tek adımlı hedefleme
ATT ve ATC, ATE'den ayrı bir hedeflemeyle bulunur (tmle:::oneStepATT). Hesap yalnız örtüşme alt kümesinde yapılır: ATT için eğilim skoru en küçük tedavi görenin skorundan az olmayan gözlemler (g\ge\min_{A=1}g), ATC için en büyük kontrolün skorundan fazla olmayanlar (g\le\max_{A=0}g). Alt kümede 10'dan fazla kontrol (ATT) ve 10'dan fazla tedavi (ATC) kalmıyorsa tüm veri kullanılır. Alt küme için eğilim skoru yeniden kestirilir: ATT'de alt kümede kalan kontroller tüm kontrollerin \%90'ı ya da fazlasıysa g'nin logit'ine tek bir kesişim kayması eklenir (\hat g_{\rm ATT}=\operatorname{expit}\{c+\operatorname{logit}\hat g\}, c binom GLM kesişimi, \operatorname{logit}\hat g sapma); değilse seçilen öğrenici kütüphanesiyle, \hat g'yi ek yordayıcı alarak yeniden öğrenilir. ATC'de aynı kural, kontrol yerine tedavi görenlere uygulanır.
Kestirici, küçük adımlı (\delta=0{,}001, en çok 2000 yineleme) bir gradyan inişidir. Her yinelemede \hat Q ve \hat g birlikte dalgalandırılır, kayıp
azalmayı bırakınca durulur ve bir önceki yinelemenin \hat\psi'si alınır:
- m: alt kümedeki gözlem sayısı; \hat q: alt kümedeki tedavi oranı.
- Etki fonksiyonu: \mathrm{IC}_{\rm ATT}=\big[(A-(1-A)\hat g/(1-\hat g))(Y-\hat Q)+A(\hat Q_1-\hat Q_0-\hat\psi)\big]/\hat q; SH =\sqrt{\widehat{\mathrm{Var}}(\mathrm{IC})/m}.
ATC, tedavi göstergesi ve Q_1,Q_0 yer değiştirilerek aynı yordamla bulunur ve işaret çevrilir. Bu adımda \hat g ve 1-\hat g her biri en az \mathrm{gb} olacak biçimde kırpılır (tmle:::oneStepATT'de [\mathrm{gb},1] aralığı).
Koddaki tercih
target.gwt ve fluctuation ATE'nin hedeflemesini değiştirir; ATT ve ATC'nin tek adımlı hedeflemesini değiştirmez. Örnek veride hedef_gwt işaretli ya da değilken ATT 0{,}27952 ve ATC 0{,}14553 aynı çıkar (tmle_ornek ve tm_gwt). ATT ve ATC her zaman Q başlangıcından ve g'den yeniden başlar; olasılık ölçeğine taşınmış başlangıç Q'yu kullanırlar (Q.ATT <- plogis(Q$Q)).
139.4.6 Özdeşlik denetimi
ATE, ATT ve ATC arasında \mathrm{ATE}=\pi\,\mathrm{ATT}+(1-\pi)\,\mathrm{ATC} (\pi=\bar A) özdeşliği geçerlidir. Şablon |\widehat{\mathrm{ATE}}-\pi\widehat{\mathrm{ATT}}-(1-\pi)\widehat{\mathrm{ATC}}|>\mathrm{SH}(\widehat{\mathrm{ATE}}) ise uyarı yazar (240–254). Uyarı, paketin ATT için tüm kontrollerin, ATC için tüm tedavi edilenlerin \%90'ından azının örtüşme alt kümesinde kaldığında g'yi yeniden kestirdiğini anlatır; öğrenici glm ise öneri "örtüşmeyi, ortak değişkenleri ya da g alt kırpma sınırını gözden geçirin"dir, esnek öğrenicide "'Yalnız ana etkili GLM' ya da standart kütüphaneyle doğrulayın"dır. Doğrusal dalgalanma ve sürekli sonuçta ATT ve ATC yazılmadığından (139.8) denetim yapılmaz. Örnek veride 0{,}480\times0{,}27952+0{,}520\times0{,}14553=0{,}20985, ATE 0{,}21157: fark 0{,}0017<0{,}0670; uyarı yoktur.
139.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–109 | Üstbilgi: 14 parametre, örnek veri, ayar. | Yan dosya alanı (10. satır) kitap dışıdır. |
| 110–111 | .m dil yardımcısı; SuperLearner ve tmle yüklenir. |
Paketlerden biri yoksa şablon başlamaz. |
| 113–120 | Veri, tedavi \ne sonuç, ortak değişkenler, tam gözlem, n\ge20. | Eksik satırlar atılır (118). |
| 121–135 | Tedavi düzeyleri (mq_kimlik), sayısal ya da bayt sırası, tedavi_duzeyi, A kodlaması, grup büyüklüğü. |
Tedavi düzeyi ve kontrol düzeyi çıktıya yazılır (214). |
| 136–139 | Y sabit değil, ikili mi, iki değerli ama 0/1 değil mi. | İkili: tüm değerler \{0{,}1\} (138); 1/2 kodlu 0/1 sonuç ikili sayılmaz ve uyarılır (223). |
| 140–160 | Ortak değişken matrisi: kategorik sütunlar gösterge değişkenine, sayısal olanlar olduğu gibi; ondalık virgüllü metin reddedilir (143–146). | Kategorik düzeyler model.matrix ile (başvuru ilk düzey); eş doğrusallık denetimi (160). |
| 161–174 | Öğrenici kütüphanesi; eksik paket öğrenicileri düşürülür. | Uyarı konsola yazılır (171). |
| 175–186 | g sınırı, V.Q, V.g, dalgalanma (yalnız sürekli sonuçta linear, 182), alpha, ön eleme, target.gwt, alpha.sig. |
Yalnız varsayılandan farklıysa tmle'ye geçirilir. |
| 187–192 | tmle(Y, A, W, family, Q.SL.library, g.SL.library, cvQinit, gbound, …); uyarılar toplanır. |
Hata mq_hata'ya çevrilir (191). |
| 193–200 | Eğilim skoru ayrışma denetimi: sınır dışı gözlem payı \ge\%20 ise durur. | Eşik şablonun kuralıdır. |
| 201–213 | Tablo 1 satırları (EY1, EY0, ATE; doğrusal olmayan dalgalanmada ATT, ATC) ve konsol satırı. | Doğrusal dalgalanma + sürekli sonuçta ATT/ATC yazılmaz (207–208). |
| 214–237 | Notlar: tedavi düzeyi, doğrusal dalgalanmanın 0/1 sonuçta lojistiğe çevrilmesi, ATT/ATC'nin yazılmaması, iki değerli sonuç, glm + çapraz doğrulama tohum notu, ön eleme dökümü (230–237). |
Yalnız ilgili durumda yazılır. |
| 238–239 | Tablo 1 başlığı. | "%95" güven düzeyine göre yazılır (239). |
| 240–254 | ATT/ATC özdeşlik denetimi. | Uyarı metni öğreniciye göre değişir (139.8). |
| 255–261 | Tablo 2: risk ve olasılık oranı (yalnız 0/1 sonuç). | SH log ölçeğindedir; başlık güven düzeyini yazar (260). |
| 262–272 | Tablo 3: Super Learner ağırlıkları; eğilim skoru aralığı; uyarılar. | Ağırlık yoksa NA (265–266). |
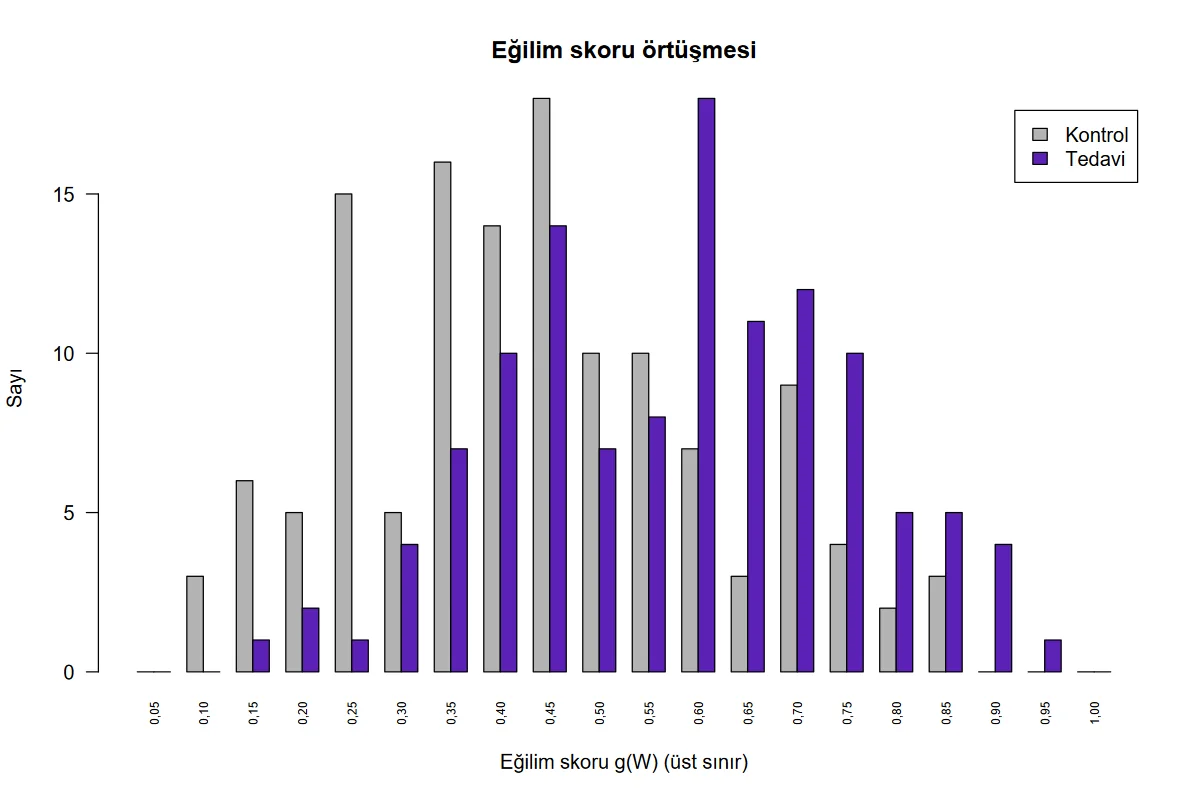
| 273–278 | Eğilim skoru örtüşme grafiği (20 aralıklı sütun grafiği). | Şekil 139.1. |
Süre: örnek ayarda çalıştırma 5{,}8 s; varsayılan sl_standart 9{,}7 s; sl_genis 14{,}2 s.
139.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/tmle/elle_hesap.py (yalnız numpy: Newton–Raphson ile lojistik regresyon, kendi dalgalanma ve tek adımlı ATT/ATC kodu), ara_degerler.py ve r_dogrulama.R (taban R glm.fit) ile hesaplanmıştır. tmle ve SuperLearner paketleri çağrılmaz.
Adım 1 — Başlangıç Q. Ana etkili lojistik regresyon: kesişim 0{,}265368, A için 1{,}062303, W_1 için 0{,}107885, W_2 için 0{,}063859, W_3 için -0{,}111989. Başlangıç (düzeltilmemiş) plug-in: \hat{\mathrm{EY}}_1=0{,}786063, \hat{\mathrm{EY}}_0=0{,}561376, ATE 0{,}224687.
Adım 2 — Eğilim skoru. g için lojistik regresyon katsayıları (-0{,}014992;\ 0{,}758785;\ 0{,}271995;\ 0{,}343872) (kesişim, W_1,W_2,W_3); \hat g\in[0{,}063430;\ 0{,}909333] (şablonun konsol satırıyla aynı: [0{,}0634;\ 0{,}9093]), tedavide en küçük 0{,}107775, kontrolde en büyük 0{,}838612. \mathrm{gb}=5/(\sqrt{250}\,\ln250)=0{,}057272; hiçbir gözlem kırpılmaz. Tedavi grubunda etkin örneklem büyüklüğü 96{,}6, en büyük ağırlık 9{,}28.
Adım 3 — Dalgalanma. Hedef denklemin düzeltmeden önceki değeri n^{-1}\sum H_i(Y_i-\hat Q_i)=-0{,}009889. Offset'li iki parametreli lojistik regresyon \hat\varepsilon_0=-0{,}048824, \hat\varepsilon_1=-0{,}082966 verir; dalgalandırmadan sonra denklem -2{,}5\times10^{-17}'dir (sayısal sıfır).
Adım 4 — Hedeflenmiş kestirimler. \widehat{\mathrm{EY}}_1=0{,}745001, \widehat{\mathrm{EY}}_0=0{,}533428, ATE =0{,}211573 (şablon 0{,}21157315; Gruber ve van der Laan'ın yayımladığı 0{,}21157). Aynı \hat Q ve \hat g ile hedeflemesiz AIPW 0{,}214798, ham fark 0{,}237821.
Adım 5 — Etki fonksiyonu. \mathrm{SH}(\widehat{\mathrm{ATE}})=0{,}0670384 (yayımlanan varyans 0{,}0044941, \sqrt{\cdot}=0{,}067038), \mathrm{SH}(\widehat{\mathrm{EY}}_1)=0{,}0456579, \mathrm{SH}(\widehat{\mathrm{EY}}_0)=0{,}0491671. %95 GA (ATE) [0{,}080180;\ 0{,}342966], p=0{,}00159947. Risk oranı 1{,}396629 (SH_{\log}=0{,}110597; GA [1{,}124452;\ 1{,}734688]), olasılık oranı 2{,}555417 (SH_{\log}=0{,}310840; GA [1{,}389551;\ 4{,}699470]).
Adım 6 — ATT ve ATC. Alt küme ATT için 247, ATC için 244 gözlemdir; ikisinde de kesişim kaymalı g kullanılır. Tek adımlı hedefleme ATT için 97, ATC için 120 yinelemede durur: ATT =0{,}279521 (SH 0{,}0721086), ATC =0{,}145531 (SH 0{,}0729995).
Adım 7 — Başka ayarlar. g sınırı 0{,}1 (4 gözlem kırpılır): ATE 0{,}212446; hedef ağırlıkla ATE 0{,}213957; %90 güven düzeyi ATE aralığını daraltır, kestirimi değiştirmez. Tedavi 1/2 kodlu: sonuç özdeş. Sürekli sonuç (re78, 614 gözlem): \widehat{\mathrm{EY}}_1=7144{,}758, \widehat{\mathrm{EY}}_0=6430{,}693, ATE 714{,}065 (SH 784{,}697); ATT 1283{,}496, ATC -146{,}588.
139.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| örnek ayar: EY1 | 0,74500136 | 0,74500136 | 0,74500136 | 1,5e−13 | ✓ |
| örnek ayar: SH(EY1) | 0,04565785 | 0,04565785 | 0,04565785 | 8,7e−15 | ✓ |
| örnek ayar: EY0 | 0,53342821 | 0,53342821 | 0,53342821 | 7,8e−16 | ✓ |
| örnek ayar: SH(EY0) | 0,04916707 | 0,04916707 | 0,04916707 | 2,1e−17 | ✓ |
| örnek ayar: ATE | 0,21157315 | 0,21157315 | 0,21157315 | 1,5e−13 | ✓ |
| örnek ayar: SH(ATE) | 0,06703835 | 0,06703835 | 0,06703835 | 5,7e−15 | ✓ |
| örnek ayar: GA alt (ATE) | 0,0801804 | 0,0801804 | 0,0801804 | 1,4e−13 | ✓ |
| örnek ayar: GA üst (ATE) | 0,34296589 | 0,34296589 | 0,34296589 | 1,6e−13 | ✓ |
| örnek ayar: p (ATE) | 0,00159948 | 0,00159948 | 0,00159948 | 1,1e−14 | ✓ |
| örnek ayar: ATT | 0,27952074 | 0,27952074 | 0,27952074 | 2,9e−14 | ✓ |
| örnek ayar: SH(ATT) | 0,07210856 | 0,07210856 | 0,07210856 | 1,8e−16 | ✓ |
| örnek ayar: ATC | 0,14553107 | 0,14553107 | 0,14553107 | 3,6e−14 | ✓ |
| örnek ayar: SH(ATC) | 0,07299946 | 0,07299946 | 0,07299946 | 1,2e−15 | ✓ |
| örnek ayar: RR | 1,3966291 | 1,3966291 | 1,3966291 | 2,1e−13 | ✓ |
| örnek ayar: SH(log RR) | 0,110597 | 0,110597 | 0,110597 | 3,1e−16 | ✓ |
| örnek ayar: OR | 2,5554165 | 2,5554165 | 2,5554165 | 7,9e−13 | ✓ |
| örnek ayar: SH(log OR) | 0,31083962 | 0,31083962 | 0,31083962 | 1,1e−13 | ✓ |
| g sınırı 0,1: EY1 | 0,74592422 | 0,74592422 | 0,74592422 | 1,5e−13 | ✓ |
| g sınırı 0,1: SH(EY1) | 0,04564008 | 0,04564008 | 0,04564008 | 8,8e−15 | ✓ |
| g sınırı 0,1: EY0 | 0,53347845 | 0,53347845 | 0,53347845 | 5,6e−16 | ✓ |
| g sınırı 0,1: SH(EY0) | 0,04916697 | 0,04916697 | 0,04916697 | 2,8e−17 | ✓ |
| g sınırı 0,1: ATE | 0,21244577 | 0,21244577 | 0,21244577 | 1,5e−13 | ✓ |
| g sınırı 0,1: SH(ATE) | 0,06702787 | 0,06702787 | 0,06702787 | 5,7e−15 | ✓ |
| g sınırı 0,1: ATT | 0,27952074 | 0,27952074 | 0,27952074 | 2,9e−14 | ✓ |
| g sınırı 0,1: SH(ATT) | 0,07210856 | 0,07210856 | 0,07210856 | 1,8e−16 | ✓ |
| g sınırı 0,1: ATC | 0,14553107 | 0,14553107 | 0,14553107 | 3,6e−14 | ✓ |
| g sınırı 0,1: SH(ATC) | 0,07299946 | 0,07299946 | 0,07299946 | 1,2e−15 | ✓ |
| g sınırı 0,1: RR | 1,39822747 | 1,39822747 | 1,39822747 | 2,0e−13 | ✓ |
| g sınırı 0,1: SH(log RR) | 0,11053712 | 0,11053712 | 0,11053712 | 3,2e−16 | ✓ |
| g sınırı 0,1: OR | 2,5673571 | 2,5673571 | 2,5673571 | 7,8e−13 | ✓ |
| g sınırı 0,1: SH(log OR) | 0,31122004 | 0,31122004 | 0,31122004 | 1,1e−13 | ✓ |
hedef ağırlık (target.gwt): EY1 |
0,74676428 | 0,74676428 | 0,74676428 | 1,3e−15 | ✓ |
hedef ağırlık (target.gwt): SH(EY1) |
0,04795447 | 0,04795447 | 0,04795447 | 1,5e−16 | ✓ |
hedef ağırlık (target.gwt): EY0 |
0,53280766 | 0,53280766 | 0,53280766 | 2,2e−16 | ✓ |
hedef ağırlık (target.gwt): SH(EY0) |
0,04985893 | 0,04985893 | 0,04985893 | 9,7e−17 | ✓ |
hedef ağırlık (target.gwt): ATE |
0,21395662 | 0,21395662 | 0,21395662 | 1,5e−15 | ✓ |
hedef ağırlık (target.gwt): SH(ATE) |
0,06900149 | 0,06900149 | 0,06900149 | 6,9e−17 | ✓ |
hedef ağırlık (target.gwt): ATT |
0,27952074 | 0,27952074 | 0,27952074 | 2,9e−14 | ✓ |
hedef ağırlık (target.gwt): SH(ATT) |
0,07210856 | 0,07210856 | 0,07210856 | 1,8e−16 | ✓ |
hedef ağırlık (target.gwt): ATC |
0,14553107 | 0,14553107 | 0,14553107 | 3,6e−14 | ✓ |
hedef ağırlık (target.gwt): SH(ATC) |
0,07299946 | 0,07299946 | 0,07299946 | 1,2e−15 | ✓ |
hedef ağırlık (target.gwt): RR |
1,40156445 | 1,40156445 | 1,40156445 | 3,8e−15 | ✓ |
hedef ağırlık (target.gwt): SH(log RR) |
0,11322262 | 0,11322262 | 0,11322262 | 2,5e−16 | ✓ |
hedef ağırlık (target.gwt): OR |
2,58573385 | 2,58573385 | 2,58573385 | 5,8e−15 | ✓ |
hedef ağırlık (target.gwt): SH(log OR) |
0,32234573 | 0,32234573 | 0,32234573 | 5,0e−16 | ✓ |
| %90 güven düzeyi: EY1 | 0,74500136 | 0,74500136 | 0,74500136 | 1,5e−13 | ✓ |
| %90 güven düzeyi: SH(EY1) | 0,04565785 | 0,04565785 | 0,04565785 | 8,7e−15 | ✓ |
| %90 güven düzeyi: EY0 | 0,53342821 | 0,53342821 | 0,53342821 | 7,8e−16 | ✓ |
| %90 güven düzeyi: SH(EY0) | 0,04916707 | 0,04916707 | 0,04916707 | 2,1e−17 | ✓ |
| %90 güven düzeyi: ATE | 0,21157315 | 0,21157315 | 0,21157315 | 1,5e−13 | ✓ |
| %90 güven düzeyi: SH(ATE) | 0,06703835 | 0,06703835 | 0,06703835 | 5,7e−15 | ✓ |
| %90 güven düzeyi: GA alt (ATE) | 0,10130488 | 0,10130488 | 0,10130488 | 1,4e−13 | ✓ |
| %90 güven düzeyi: GA üst (ATE) | 0,32184141 | 0,32184141 | 0,32184141 | 1,6e−13 | ✓ |
| %90 güven düzeyi: p (ATE) | 0,00159948 | 0,00159948 | 0,00159948 | 1,1e−14 | ✓ |
| %90 güven düzeyi: ATT | 0,27952074 | 0,27952074 | 0,27952074 | 2,9e−14 | ✓ |
| %90 güven düzeyi: SH(ATT) | 0,07210856 | 0,07210856 | 0,07210856 | 1,8e−16 | ✓ |
| %90 güven düzeyi: ATC | 0,14553107 | 0,14553107 | 0,14553107 | 3,6e−14 | ✓ |
| %90 güven düzeyi: SH(ATC) | 0,07299946 | 0,07299946 | 0,07299946 | 1,2e−15 | ✓ |
| %90 güven düzeyi: RR | 1,3966291 | 1,3966291 | 1,3966291 | 2,1e−13 | ✓ |
| %90 güven düzeyi: SH(log RR) | 0,110597 | 0,110597 | 0,110597 | 3,1e−16 | ✓ |
| %90 güven düzeyi: OR | 2,5554165 | 2,5554165 | 2,5554165 | 7,9e−13 | ✓ |
| %90 güven düzeyi: SH(log OR) | 0,31083962 | 0,31083962 | 0,31083962 | 1,1e−13 | ✓ |
| sonuç 1/2 kodlu (sürekli sayılır): EY1 | 1,74491194 | 1,74491194 | 1,74491194 | 4,5e−14 | ✓ |
| sonuç 1/2 kodlu (sürekli sayılır): SH(EY1) | 0,04553748 | 0,04553748 | 0,04553748 | 5,4e−15 | ✓ |
| sonuç 1/2 kodlu (sürekli sayılır): EY0 | 1,53363711 | 1,53363711 | 1,53363711 | 1,4e−16 | ✓ |
| sonuç 1/2 kodlu (sürekli sayılır): SH(EY0) | 0,04914386 | 0,04914386 | 0,04914386 | 1,4e−17 | ✓ |
| sonuç 1/2 kodlu (sürekli sayılır): ATE | 0,21127483 | 0,21127483 | 0,21127483 | 7,4e−14 | ✓ |
| sonuç 1/2 kodlu (sürekli sayılır): SH(ATE) | 0,06693887 | 0,06693887 | 0,06693887 | 3,6e−15 | ✓ |
| sonuç 1/2 kodlu (sürekli sayılır): ATT | 0,27935723 | 0,27935723 | 0,27935723 | 1,1e−15 | ✓ |
| sonuç 1/2 kodlu (sürekli sayılır): SH(ATT) | 0,07211685 | 0,07211685 | 0,07211685 | 1,5e−16 | ✓ |
| sonuç 1/2 kodlu (sürekli sayılır): ATC | 0,14580193 | 0,14580193 | 0,14580193 | 1,2e−15 | ✓ |
| sonuç 1/2 kodlu (sürekli sayılır): SH(ATC) | 0,07284612 | 0,07284612 | 0,07284612 | 1,8e−16 | ✓ |
| sonuç 0/100: EY1 | 74,49119438 | 74,49119438 | 74,49119438 | 1,0e−13 | ✓ |
| sonuç 0/100: SH(EY1) | 4,55374843 | 4,55374843 | 4,55374843 | 1,2e−13 | ✓ |
| sonuç 0/100: EY0 | 53,36371126 | 53,36371126 | 53,36371126 | 4,0e−16 | ✓ |
| sonuç 0/100: SH(EY0) | 4,91438599 | 4,91438599 | 4,91438599 | 2,0e−15 | ✓ |
| sonuç 0/100: ATE | 21,12748312 | 21,12748312 | 21,12748312 | 3,5e−13 | ✓ |
| sonuç 0/100: SH(ATE) | 6,69388693 | 6,69388693 | 6,69388693 | 5,4e−14 | ✓ |
| sonuç 0/100: ATT | 27,93572336 | 27,93572336 | 27,93572336 | 3,7e−15 | ✓ |
| sonuç 0/100: SH(ATT) | 7,21168547 | 7,21168547 | 7,21168547 | 8,6e−16 | ✓ |
| sonuç 0/100: ATC | 14,58019272 | 14,58019272 | 14,58019272 | 8,5e−15 | ✓ |
| sonuç 0/100: SH(ATC) | 7,284612 | 7,284612 | 7,284612 | 2,4e−15 | ✓ |
| tedavi 1/2 kodlu: EY1 | 0,74500136 | 0,74500136 | 0,74500136 | 1,5e−13 | ✓ |
| tedavi 1/2 kodlu: SH(EY1) | 0,04565785 | 0,04565785 | 0,04565785 | 8,7e−15 | ✓ |
| tedavi 1/2 kodlu: EY0 | 0,53342821 | 0,53342821 | 0,53342821 | 7,8e−16 | ✓ |
| tedavi 1/2 kodlu: SH(EY0) | 0,04916707 | 0,04916707 | 0,04916707 | 2,1e−17 | ✓ |
| tedavi 1/2 kodlu: ATE | 0,21157315 | 0,21157315 | 0,21157315 | 1,5e−13 | ✓ |
| tedavi 1/2 kodlu: SH(ATE) | 0,06703835 | 0,06703835 | 0,06703835 | 5,7e−15 | ✓ |
| tedavi 1/2 kodlu: ATT | 0,27952074 | 0,27952074 | 0,27952074 | 2,9e−14 | ✓ |
| tedavi 1/2 kodlu: SH(ATT) | 0,07210856 | 0,07210856 | 0,07210856 | 1,8e−16 | ✓ |
| tedavi 1/2 kodlu: ATC | 0,14553107 | 0,14553107 | 0,14553107 | 3,6e−14 | ✓ |
| tedavi 1/2 kodlu: SH(ATC) | 0,07299946 | 0,07299946 | 0,07299946 | 1,2e−15 | ✓ |
| tedavi 1/2 kodlu: RR | 1,3966291 | 1,3966291 | 1,3966291 | 2,1e−13 | ✓ |
| tedavi 1/2 kodlu: SH(log RR) | 0,110597 | 0,110597 | 0,110597 | 3,1e−16 | ✓ |
| tedavi 1/2 kodlu: OR | 2,5554165 | 2,5554165 | 2,5554165 | 7,9e−13 | ✓ |
| tedavi 1/2 kodlu: SH(log OR) | 0,31083962 | 0,31083962 | 0,31083962 | 1,1e−13 | ✓ |
| 5 eksik satır: EY1 | 0,74445186 | 0,74445186 | 0,74445186 | 2,7e−13 | ✓ |
| 5 eksik satır: SH(EY1) | 0,04565227 | 0,04565227 | 0,04565227 | 1,4e−14 | ✓ |
| 5 eksik satır: EY0 | 0,54107215 | 0,54107215 | 0,54107215 | 0 | ✓ |
| 5 eksik satır: SH(EY0) | 0,04978138 | 0,04978138 | 0,04978138 | 4,9e−17 | ✓ |
| 5 eksik satır: ATE | 0,20337971 | 0,20337971 | 0,20337971 | 2,7e−13 | ✓ |
| 5 eksik satır: SH(ATE) | 0,06751544 | 0,06751544 | 0,06751544 | 9,3e−15 | ✓ |
| 5 eksik satır: ATT | 0,27212105 | 0,27212105 | 0,27212105 | 4,4e−14 | ✓ |
| 5 eksik satır: SH(ATT) | 0,07275307 | 0,07275307 | 0,07275307 | 3,6e−16 | ✓ |
| 5 eksik satır: ATC | 0,13509199 | 0,13509199 | 0,13509199 | 5,6e−14 | ✓ |
| 5 eksik satır: SH(ATC) | 0,07345968 | 0,07345968 | 0,07345968 | 1,8e−15 | ✓ |
| 5 eksik satır: RR | 1,37588278 | 1,37588278 | 1,37588278 | 3,6e−13 | ✓ |
| 5 eksik satır: SH(log RR) | 0,1105242 | 0,1105242 | 0,1105242 | 2,3e−15 | ✓ |
| 5 eksik satır: OR | 2,47088835 | 2,47088835 | 2,47088835 | 1,4e−12 | ✓ |
| 5 eksik satır: SH(log OR) | 0,31255691 | 0,31255691 | 0,31255691 | 1,8e−13 | ✓ |
sürekli sonuç (re78), lojistik dalgalanma: EY1 |
7144,75783312 | 7144,75784257 | 7144,75784257 | 1,3e−9 | ✓ |
sürekli sonuç (re78), lojistik dalgalanma: SH(EY1) |
713,1309652 | 713,13096986 | 713,13096986 | 6,5e−9 | ✓ |
sürekli sonuç (re78), lojistik dalgalanma: EY0 |
6430,69303687 | 6430,69303771 | 6430,69303771 | 1,3e−10 | ✓ |
sürekli sonuç (re78), lojistik dalgalanma: SH(EY0) |
355,59743387 | 355,59743391 | 355,59743391 | 1,2e−10 | ✓ |
sürekli sonuç (re78), lojistik dalgalanma: ATE |
714,06479624 | 714,06480486 | 714,06480486 | 1,2e−8 | ✓ |
sürekli sonuç (re78), lojistik dalgalanma: SH(ATE) |
784,69690705 | 784,69691115 | 784,69691115 | 5,2e−9 | ✓ |
sürekli sonuç (re78), lojistik dalgalanma: ATT |
1283,4955767 | 1283,49557673 | 1283,49557672 | 1,9e−11 | ✓ |
sürekli sonuç (re78), lojistik dalgalanma: SH(ATT) |
789,51708342 | 789,51708341 | 789,51708341 | 2,4e−11 | ✓ |
sürekli sonuç (re78), lojistik dalgalanma: ATC |
−146,58759887 | −146,58762022 | −146,58762022 | 1,5e−7 | ✓ |
sürekli sonuç (re78), lojistik dalgalanma: SH(ATC) |
911,97607379 | 911,97607658 | 911,97607658 | 3,1e−9 | ✓ |
sürekli sonuç (re78), doğrusal dalgalanma: EY1 |
7232,10237571 | 7232,10238553 | 7232,10238553 | 1,4e−9 | ✓ |
sürekli sonuç (re78), doğrusal dalgalanma: SH(EY1) |
726,63564127 | 726,63564578 | 726,63564578 | 6,2e−9 | ✓ |
sürekli sonuç (re78), doğrusal dalgalanma: EY0 |
6430,61016806 | 6430,61016896 | 6430,61016896 | 1,4e−10 | ✓ |
sürekli sonuç (re78), doğrusal dalgalanma: SH(EY0) |
355,56286099 | 355,56286104 | 355,56286104 | 1,2e−10 | ✓ |
sürekli sonuç (re78), doğrusal dalgalanma: ATE |
801,49220765 | 801,49221657 | 801,49221657 | 1,1e−8 | ✓ |
sürekli sonuç (re78), doğrusal dalgalanma: SH(ATE) |
795,39014756 | 795,39015158 | 795,39015158 | 5,1e−9 | ✓ |
| 0/1 sonuç, doğrusal dalgalanma: EY1 | 1,09007773 | 1,09007773 | — | 7,1e−13 | ✓ |
| 0/1 sonuç, doğrusal dalgalanma: SH(EY1) | 0,04813358 | 0,04813358 | — | 3,5e−14 | ✓ |
| 0/1 sonuç, doğrusal dalgalanma: EY0 | 0,13493818 | 0,13493818 | — | 8,0e−16 | ✓ |
| 0/1 sonuç, doğrusal dalgalanma: SH(EY0) | 0,05247717 | 0,05247717 | — | 1,4e−17 | ✓ |
| 0/1 sonuç, doğrusal dalgalanma: ATE | 0,95513956 | 0,95513956 | — | 7,7e−13 | ✓ |
| 0/1 sonuç, doğrusal dalgalanma: SH(ATE) | 0,06451207 | 0,06451207 | — | 5,8e−15 | ✓ |
| 0/1 sonuç, doğrusal dalgalanma: ATT | 0,27952074 | 0,27952074 | — | 2,9e−14 | ✓ |
| 0/1 sonuç, doğrusal dalgalanma: SH(ATT) | 0,07210856 | 0,07210856 | — | 1,8e−16 | ✓ |
| 0/1 sonuç, doğrusal dalgalanma: ATC | 0,14553107 | 0,14553107 | — | 3,6e−14 | ✓ |
| 0/1 sonuç, doğrusal dalgalanma: SH(ATC) | 0,07299946 | 0,07299946 | — | 1,2e−15 | ✓ |
| 0/1 sonuç, doğrusal dalgalanma: RR | 8,07834932 | 8,07834932 | — | 7,1e−13 | ✓ |
| 0/1 sonuç, doğrusal dalgalanma: SH(log RR) | 0,38342187 | 0,38342187 | — | 1,4e−14 | ✓ |
| 0/1 sonuç, doğrusal dalgalanma: OR | −77,5804547 | −77,5804547 | — | 7,8e−12 | ✓ |
| 0/1 sonuç, doğrusal dalgalanma: SH(log OR) | 0,72228614 | 0,72228614 | — | 3,2e−12 | ✓ |
Ölçütü karşılayan: 140/140. Ölçüt satır başına 10^{-6} (değer 1'den büyükse göreli). Bağımsız Python yalnız numpy ile (başlangıç Q ve g için ana etkili GLM, iki parametreli dalgalanma, etki fonksiyonu, tek adımlı ATT/ATC), R taban R glm.fit ile yazılmıştır; tmle ve SuperLearner paketleri çağrılmaz. Doğrusal dalgalanmada sürekli sonuçta ATT ve ATC satırı yoktur (bulgu B3); 0/1 sonuç ve doğrusal dalgalanmada (EY_1,EY_0,ATE ve RR, OR) paket davranışı birebir yinelenmiştir: değerler olasılık ölçeğinde değil, logit ölçeğindedir (bulgu B2), R sütunu yoktur.
139.7 Çıktıyı okuma
Örnek ayarda şablonun üç tablosu ve konsol notları (tmle_ornek; sayılar olduğu gibi):
n = 250 (tedavi 120, kontrol 130); sonuç: ikili; öğrenici: glm; Q başlangıcı çapraz doğrulamasız; g sınırı = 0,05727
Tedavi sayılan düzey: '1' (n = 120); kontrol: '0' (n = 130). Kural: sayıya benzeyen düzeylerde büyük, değilse alfabetik son düzey.

TMLE kestirimleri (etki fonksiyonu SH, %95 GA)
  parametre                       kestirim        SH    GA_alt    GA_ust            p
  EY1 (tedavi altında ortalama)  0.745001  0.045658  0.655514  0.834489  7.465952e-60
  EY0 (kontrol altında ortalama) 0.533428  0.049167  0.437063  0.629794  2.009611e-27
  ATE                            0.211573  0.067038  0.080180  0.342966  1.599472e-03
  ATT                            0.279521  0.072109  0.138191  0.420851  1.060184e-04
  ATC                            0.145531  0.073000  0.002455  0.288607  4.619676e-02

Oransal etkiler (log ölçeğinde SH, %95 GA)
  olcu                   kestirim   SH_log   GA_alt   GA_ust        p
  Risk oranı (RR)        1.396629 0.110597 1.124452 1.734688 0.002523
  Olasılık oranı (OR)    2.555417 0.310840 1.389551 4.699470 0.002542

Super Learner topluluk ağırlıkları
  model ogrenici SL_agirligi
  Q     SL.glm   1
  g     SL.glm   1

Eğilim skoru aralığı [0,0634; 0,9093]; g sınırının altında kalan gözlem: 0.
Şekil 139.1. Şablonun şekli: eğilim skoru örtüşmesi (taban R `barplot`; gri kontrol, mor tedavi; 20 aralık, eksendeki sayılar aralığın üst sınırıdır).
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Konsol satırı | n, tedavi ve kontrol sayısı, sonuç türü, öğrenici, Q başlangıcı, g sınırı. | Ardından "Tedavi sayılan düzey" satırı hangi düzeyin tedavi, hangisinin kontrol sayıldığını ve kuralı yazar; n_1'in beklediğiniz grupla uyuştuğunu doğrulayın. |
| EY1, EY0 | \mathrm{E}[Y(1)] ve \mathrm{E}[Y(0)]. | Herkes tedavi alsaydı sonucun \%74{,}5'i, almasaydı \%53{,}3'ü olurdu. |
| ATE | \mathrm{EY}_1-\mathrm{EY}_0, SH etki fonksiyonundan. | Risk farkı 0{,}212; GA 0{,}080–0{,}343, sıfırı içermez. |
| ATT, ATC | Tedavi görenler ve görmeyenler için etki. | ATT 0{,}280, ATC 0{,}146; fark etki heterojenliği ya da kestirim gürültüsüdür; ATC'nin alt sınırı sıfıra yakındır. |
| RR, OR | Oransal etkiler (yalnız 0/1 sonuç). | Risk 1{,}40 kat, olasılık oranı 2{,}56; SH ve GA log ölçeğinden döner. |
| Super Learner ağırlıkları | Topluluk ağırlıkları \hat w. | Ağırlığı 0 olan öğrenici sonuca girmez; glm'de tek öğrenici. |
| Eğilim skoru aralığı | \min\hat g ve \max\hat g; kırpılan gözlem sayısı. | 0{,}063 ile 0{,}909: iki grupta da yeterli örtüşme; kırpılan yok. |
Varsayılan ayarda (sl_standart, cv_q işaretli, tohum 101) Super Learner ağırlıkları Q için SL.gam 0{,}785, SL.mean 0{,}215, ötekiler 0; g için SL.glm 0{,}973, SL.mean 0{,}027'dir; ATE 0{,}2049 (SH 0{,}0676), ATT 0{,}2669, ATC 0{,}1441. Tohum 202 ile ATE 0{,}2124, ATT 0{,}2715, ATC 0{,}1548 olur; tohum 101'le yineleme (sl_s1b) bire bir aynı sonucu verir. sl_genis'te rastgele orman ağırlığı bu örnekte 0 çıktığından (tohum 101) sonuç sl_standart ile aynıdır; tohum 202'de ATE 0{,}2116, 303'te 0{,}2128.
İkili tedavinin (A) ikili sonuç (Y) üzerindeki ortalama etkisi, W_1,W_2,W_3 karıştırıcıları kontrol edilerek hedefli en çok olabilirlik kestirimiyle (ana etkili GLM'lerle Q ve g; n=250) risk farkı olarak 0{,}212 bulunmuştur (SH 0{,}067; %95 GA 0{,}080–0{,}343; p=0{,}0016). Tedavi görenlerde etki 0{,}280, görmeyenlerde 0{,}146'dır; risk oranı 1{,}40, olasılık oranı 2{,}56'dır.
139.8 Sık hatalar ve tuzaklar
- Hangi düzeyin tedavi olduğu. Sayısal düzeylerde büyük, metin düzeylerinde bayt sırasıyla son düzey tedavidir; sütunun Veri sekmesindeki türü ve düzey sırası sonucu değiştirmez ve çıktı seçimi yazar.
a_tedavi/b_kontroletiketli sütundab_kontroltedavi sayılır (n_1=130, ATE -0{,}2116); beklediğiniz grup ters isetedavi_duzeyialanına tedavi düzeyini yazın (a_tedaviyazılırsa n_1=120 ve ATE +0{,}2116; bulgular B3). - Sonuç 0/1 değil, 1/2 kodlu. İkili sayılmaz (138): sürekli sonuç olarak işlenir, risk ve olasılık oranı tablosu çıkmaz, Q başlangıcı doğrusal olur ve ATE 0{,}2113 yazılır (0/1 kodlu aynı veride 0{,}2116). Şablon bu durumda "sonuç iki değerli ama 0/1 değil" uyarısını yazar (223); ikili sonuç için sütunu 0/1 kodlayın (bulgular B4).
- Doğrusal dalgalanma. Yalnız sürekli sonuç içindir. 0/1 sonuçta
linearseçilirse şablon lojistik dalgalanmayı kullanır ve bunu bir notla yazar (217–219); EY1, EY0, ATE, RR ve OR lojistik seçimle aynı çıkar. Sürekli sonuçtalinearile ATE hesaplanır ama paket ATT ve ATC'yi ham Q'yu olasılık sanarak hesapladığı için bu iki satır yazılmaz ve not düşülür (220–222). ATT ve ATC için dalgalanmayılogisticbırakın (bulgular B1, B2). - Yalnız
glmseçmek hesabı belirlenimci yapmaz.cv_qform varsayılanında işaretlidir;glm+ çapraz doğrulama tohuma bağlıdır: tohum 101'de ATE 0{,}2073, 202'de 0{,}2123. Şablon bu birleşimde sonucun tohuma bağlı olduğunu yazar (227–229); belirlenimci hesap içincv_q'yu da kaldırın (bulgular B6). - Tohum ve Super Learner. Varsayılan kütüphanede ATE tohuma göre 0{,}2049 ile 0{,}2124 arasında oynar; ATC 0{,}144–0{,}155. Raporlarken tohumu (sonuç kartının künyesi) yazın. Farklı tohumlarla birkaç çalıştırma yapıp kararlılığı bildirmek iyi uygulamadır.
- Örtüşme ve ayrışma. Bir ortak değişken tedaviyi neredeyse ayırıyorsa \hat g 0 ve 1'e yaslanır.
W4 = 4A + gürültü(SS 0,15)eklenince eğilim skoru aralığı [0{,}0000;\ 1{,}0000] ve g sınırının dışında kalan gözlem 250 olur (örnekte ATE +0{,}212 iken kırpılmış ağırlıklarla -0{,}383 çıkardı); g sınırı dışında kalan gözlem payı \%20'yi aşınca şablon durur ve "Eğilim skoru modeli tam (ya da yarı) ayrışma gösteriyor" iletisini verir (194–200;tm_ayrisma; bulgular B5). Orta düzeyde zayıf örtüşmede (W4 = 3A + N(0,1)) ATT -0{,}066, ATC +0{,}431 çıkar ve uyarı gelir (tm_zayif_ortusme). Eğilim skoru aralığına ve şekle her zaman bakın. - Küçük örneklem. n=30 (15/15) ile g sınırı 0{,}268 olur, 10 gözlem kırpılır ve ATE 0{,}258 (SH 0{,}168) çıkar; sınır sonucu belirler. n<100'de
glmve eğilim skoru grafiği tercih edilmelidir. - Sayısal sütunun "kategorik" türde olması. Sonuç (
sayisal_sutun) Veri sekmesinde "kategorik" işaretlense de sayı olarak aktarılır ve sonuç değişmez (tm_y_kat: ATE 0{,}2116); kategorik sayılan ortak değişken ise düzey sırasına göre gösterge değişkenine çevrilir (250 düzeyli bir sütun doğrusal bağımlı hatası verir). Etiketleri "10", "2", "5" olan metin bir ortak değişken (tm_kat) gösterge değişkenlerine çevrilir; ana etkili GLM'lerde başvuru düzeyi seçimi (alfabetik ya da sayısal sıra) \hat Q ve \hat g'nin kestirimlerini değiştirmez, çünkü kesişimli tam gösterge kodlaması bir yeniden parametrelemedir. Cezalı öğreniciler (glmnet) ve ön eleme için başvuru düzeyinin etkisi ayrıca sınanmamıştır. - Eksik değer. Sessizce atılır (
n = 245; ATE 0{,}2034); çıktıdaki n'yi veri sayınızla karşılaştırın. Sonuçtaki eksiklik (Y) "rastgele eksik" varsayımına dayanır; şablon eksikliği modellemez. - Ondalık virgüllü metin sütunu.
0,1404gibi değerler metin okunursa sütunun her değeri ayrı düzey olurdu; şablon bu durumu tanır ve "ondalık virgüllü sayılardan oluşuyor … Ondalık ayırıcı nokta olmalıdır" iletisiyle durur (143–146;tm_virgul; bulgular B7). Sütunu sayısal türe çevirip yeniden yükleyin. - Ön eleme. 15 ortak değişkenle (12'si gürültü)
on_eleme_gişaretliyken ATT 0{,}224, ATC 0{,}208; işaretsizken ATT 0{,}279, ATC 0{,}121 (ATE 0{,}216 ve 0{,}202). Ön elemeglmnetile sonuçla ilişkisi sıfırlanan değişkenleri g modelinden çıkarır; şablon tutulan ve elenen değişkenleri "g modelinde ortak değişken ön elemesi: tutulan (…): …; elenen (…): …" satırıyla yazar (230–237; bulgular B8). ATT ve ATC en çok etkilenen büyüklüklerdir. - Özdeşlik uyarısı. Uyarı gerçek örtüşme sorununu işaret eder; öğreniciye göre önerir:
glmiçin örtüşmeyi ve ortak değişkenleri gözden geçirmeyi, esnek öğrenici içinglmya da standart kütüphaneyle doğrulamayı (tm_zayif_ortusme). Paketin yeniden kestirim kuralı ATT için tüm kontrollerin, ATC için tüm tedavi edilenlerin \%90'ının alt kümede kalmasıdır ve metin bunu böyle anlatır (bulgular B9). - Tedavi sonrası değişkenler
ortak'a konmamalıdır; şablon denetlemez. Pozitiflik varsayımı ve eğilim skoru modelinin belirlenmesi şablon dışında sınanır.
139.9 Uzman soruları
S1. TMLE neden çift sağlamdır ve AIPW'den farkı nedir?
Hedefleme adımı, n^{-1}\sum_iH_i(Y_i-\hat Q^*_i)=0 denklemini çözer; bu, ATE'nin etki fonksiyonunun ortalamasının sıfır olması demektir. \hat g doğruysa kestirici \hat Q yanlış olsa da tutarlıdır; \hat Q doğruysa \hat g yanlış olsa da. AIPW düzeltmeyi toplama ekler ve [0{,}1] dışına taşabilir; TMLE düzeltmeyi lojistik dalgalanmayla Q'nun içine yerleştirir ve plug-in olarak sonuç uzayında kalır. Örnek veride aynı \hat Q,\hat g ile AIPW 0{,}2148, TMLE 0{,}2116'dır.
S2. Super Learner'ın ağırlıkları neden sıfır olabilir ve bu sorun mu?
NNLS çözümü köşe çözümdür; çapraz doğrulamalı riski en küçük olan birkaç öğreniciye ağırlık verir, ötekileri sıfırlar. Bu bir hata değil, seçimin sonucudur. Ancak ağırlıklar tohuma (katlara) bağlıdır: sl_standart'ta Q için SL.glm ağırlığı tohum 101'de 0, 202'de 0{,}049'dur. Ağırlıkları değil, kestirimin tohumlar arası kararlılığını raporlayın.
S3. g neden kırpılır ve 5/(\sqrt n\ln n) nereden gelir?
Kırpma, küçük \hat g'nin 1/\hat g ağırlığını patlatmasını önler; bunun bedeli küçük bir yanlılıktır. 5/(\sqrt n\ln n) tmle paketinin varsayılan sınırıdır (Gruber ve van der Laan, 2012); başka sınırlar da kullanılabilir. Şablonda bu değer g_sinir = 0 ile otomatiktir. n=250'de 0{,}057, n=30'da 0{,}268'dir: küçük örneklemde sınır, sonucu eğilim skorundan çok sınırın kendisi belirleyebilir.
S4. ATT ve ATC için ATE'den ayrı hedefleme neden gerekir?
ATE'nin etki fonksiyonu ile ATT'ninki farklıdır: ATT yalnız tedavi görenlerin dağılımı üzerinde ortalama alır, dolayısıyla \hat g/\hat q ağırlığı ve farklı bir hedef denklem gerekir. Paket bunu örtüşme alt kümesinde ve g'yi yeniden uydurarak yapar. Bu, ATE'nin kararlı olduğu hâllerde bile ATT veya ATC'yi kararsızlaştırabilir: sürekli sonuç ya da zayıf örtüşmede özdeşlik denetimi bu yüzden vardır.
S5. Sınır durumu: tek bir ortak değişken tedaviyi ayırıyorsa ne olur?
\hat g 0 ve 1'e gider, kırpma \hat g_1,\hat g_0\ge\mathrm{gb} yapar ve tüm gözlemler kırpılır. Şablon durmaz; tabloyu yazar (örnek: ATE -0{,}383, eğilim skoru aralığı [0{,}0000;\ 1{,}0000], "g sınırının altında kalan gözlem: 250"). Doğru yanıt örtüşme olmadığıdır: ATE bu veriyle tanımlanamaz. Ayrışan değişkeni çıkarmak çözüm değildir; o değişken tedavinin belirleyicisidir.
S6. Risk oranı ve olasılık oranının SH'si neden log ölçeğinde?
Oranlar için normal yaklaşım log ölçeğinde daha iyidir. Etki fonksiyonu delta yöntemiyle \mathrm{IC}_{\log\mathrm{RR}}=\mathrm{IC}_{{\rm EY}_1}/\mathrm{EY}_1-\mathrm{IC}_{{\rm EY}_0}/\mathrm{EY}_0 olarak kurulur; aralık \exp\{\log\hat\theta\pm z\,\mathrm{SH}_{\log}\}'dır. Örnek veride \log\mathrm{RR} için SH 0{,}1106 ve GA [1{,}124;\ 1{,}735].
S7. Başka bir uygulamayla (`tmle` dışı) ne zaman ayrışır?
Aynı \hat Q,\hat g ile Bölüm 125'in AIPW'si 0{,}2148 verir; fark hedeflemedendir. Ana etkili GLM ve çapraz doğrulamasız başlangıçla bu bölümün bağımsız Python ve R hesabı (10^{-6} içinde) paketle aynıdır (139.6.1). Super Learner kullanılınca öğrenicilerin ayarları (ör. glmnet'in useMin, gam'ın deg.gam) ve çapraz doğrulama katları sonucu değiştirir; bağımsız yeniden hesap bu nedenle yalnız glm seçeneği için yapılabilir.
S8. Güven aralıkları neden bazen [0{,}1]'e kırpılıyor?
0/1 sonuçta \mathrm{EY}_a ve ATE doğal olarak [0{,}1] ve [-1{,}1] aralıklarındadır; paket Wald aralığını bu sınırlara kırpar. ATT ve ATC aralıkları kırpılmaz. Aralığın bir ucu sınırdaysa SH'ye bölünmüş normal yaklaşım zayıftır; daha çok gözlem ya da farklı bir aralık yöntemi gerekir.
139.10 Kaynaklar
- Gruber, S., & van der Laan, M. J. (2010). A targeted maximum likelihood estimator of a causal effect on a bounded continuous outcome. The International Journal of Biostatistics, 6(1). https://doi.org/10.2202/1557-4679.1260
- Gruber, S., & van der Laan, M. J. (2012). tmle: An R package for targeted maximum likelihood estimation. Journal of Statistical Software, 51(13). https://doi.org/10.18637/jss.v051.i13
- LaLonde, R. J. (1986). Evaluating the econometric evaluations of training programs with experimental data. The American Economic Review, 76(4), 604–620.
- Petersen, M. L., Porter, K. E., Gruber, S., Wang, Y., & van der Laan, M. J. (2012). Diagnosing and responding to violations in the positivity assumption. Statistical Methods in Medical Research, 21(1), 31–54. https://doi.org/10.1177/0962280210386207
- Porter, K. E., Gruber, S., van der Laan, M. J., & Sekhon, J. S. (2011). The relative performance of targeted maximum likelihood estimators. The International Journal of Biostatistics, 7(1). https://doi.org/10.2202/1557-4679.1308
- Rosenbaum, P. R., & Rubin, D. B. (1983). The central role of the propensity score in observational studies for causal effects. Biometrika, 70(1), 41–55. https://doi.org/10.1093/biomet/70.1.41
- Schuler, M. S., & Rose, S. (2017). Targeted maximum likelihood estimation for causal inference in observational studies. American Journal of Epidemiology, 185(1), 65–73. https://doi.org/10.1093/aje/kww165
- van der Laan, M. J., Polley, E. C., & Hubbard, A. E. (2007). Super learner. Statistical Applications in Genetics and Molecular Biology, 6(1). https://doi.org/10.2202/1544-6115.1309
- van der Laan, M. J., & Rubin, D. (2006). Targeted maximum likelihood learning. The International Journal of Biostatistics, 2(1). https://doi.org/10.2202/1557-4679.1043
- Yazılım kaydı (şablonun
ozet.jsonçıktısı): R 4.5.3; SuperLearner 2.0-42, tmle 2.1.1, glmnet 5.1, gam 1.22-7; geniş kütüphanede ranger 0.18.0 (Wright ve Ziegler, 2017, https://doi.org/10.18637/jss.v077.i01); glmnet için Friedman ve ark. (2010, https://doi.org/10.18637/jss.v033.i01).