215. Bayesci model ortalaması (doğrusal regresyon, BAS)
Şablon kimliği: bayes_model_ortalamasi · Kategori: bayes · Dil: R · Dosya: pro/sablonlar/bayes/bayes_model_ortalamasi.R (satır 1–198; üstbilgi 1–103) · Örnek veri: _ornek/uscrime.csv · Paketler: BAS 2.0.2 (R 4.5.3)
215.1 Ne işe yarar
Şablon, bir yanıtı p aday açıklayıcıya bağlayan doğrusal regresyonda hangi değişkenlerin modelde olacağı belirsizliğini tek bir "en iyi model" seçerek gizlemez; 2^p adayın hepsini (ya da örneklenen bir bölümünü) sonsal olasılıklarıyla ağırlıklandırır. Cevapladığı soru: "Her değişkenin modelde bulunma olasılığı nedir ve katsayılar model belirsizliği hesaba katıldığında ne olur?"
- \gamma\in\{0{,}1\}^p: hangi değişkenlerin modelde olduğunu gösteren vektör; \mathbf x_{i,\gamma} yalnız seçilen sütunlar.
- p(\mathbf y\mid\gamma): \gamma modelinin sınırsal olabilirliği (215.4).
- P(\gamma): model öncülü; P(\gamma\mid\mathbf y): modelin sonsal olasılığı.
Ne zaman kullanılır?
- Çok sayıda aday değişken vardır, hangilerinin gerçekten ilişkili olduğu belirsizdir ve tek bir adım adım seçim sonucu yeterince güvenilir görünmüyorsa.
- Her değişken için "modelde olma olasılığı" ve seçim belirsizliğini içeren katsayı aralıkları isteniyorsa.
Ne zaman kullanılmaz?
- Aday sayısı küçük ve model biçimi kuramla belirliyse: temel programdaki Bayesçi Doğrusal Regresyon tek model kurar.
- Yanıt sayım, ikili ya da kümelenmiş ise: bu şablon yalnız normal doğrusal modeldir; karma ve genelleştirilmiş modeller için
brms_cok_duzeyli(Bölüm 216). - Yalnız en iyi alt kümeyi bulmak isteniyorsa: temel programdaki tüm alt kümeler regresyonu.
Temel programla ilişki. Temel programın Bayesçi Doğrusal Regresyon analizi (gui/panels/analyses/bayesian_linear.py) tek bir modelin sonsalını konjugat, referans ya da g öncülüyle analitik verir; JZS Bayes çarpanı yalnız tüm değişkenli model ile yalnız sabit model arasındadır. Değişken seçimi belirsizliği, dahil olma olasılığı ve model ortalamalı katsayı yoktur. Temel program tam çoklu doğrusallıkta sütun rankını denetler; bu şablon da aday sütunlar tam doğrusal bağımlıysa çalıştırmayı durdurur ve bağımlı adayları adıyla söyler (215.2). Hiyerarşik Bayesçi Regresyon ise deneysel Bayes (EB) kestirimidir ve bu konuyla ilgisizdir.
215.2 Şablonun girdileri
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Yanıt · y (satır 11–14) |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal sütun | Yanıt; sabit olamaz (satır 122). |
Aday açıklayıcı değişkenler · x (15–22) |
sütunlar, sayısal · Değişkenler | yok | en az 2 sütun | Adaylar; yanıtla aynı ad çıkarılır (109). |
Log dönüşümü uygulanacak sütunlar · log_sutunlar (23–29) |
sütunlar, sayısal · Değişkenler | boş | sayısal sütunlar | Yalnız veri çerçevesindeki (yanıt ve adaylar) sütunlar \log alınır (116–119). |
Katsayı öncülü · oncul (30–36) |
seçim · Model | ZS-null |
ZS-null, g-prior, hyper-g-n, JZS, BIC |
bas.lm(prior=) (135–139). |
Model öncülü · model_oncul (37–43) |
seçim · Model | uniform |
uniform, beta-binomial |
uniform() ya da beta.binomial(a,b) (133). |
MCMC yineleme sayısı · n_iter (44–52) |
tamsayı · Gelişmiş | 100000 | 1000–2 000 000 | Yalnız yöntem BAS dışındaysa MCMC.iterations (140). |
Her modelde bulunacak değişkenler · zorunlu (53–59) |
sütunlar · Değişkenler | boş | adaylardan | include.always (141–143). |
Model uzayı arama yöntemi · yontem (60–67) |
seçim · Model | otomatik |
otomatik, BAS, MCMC, MCMC+BAS |
otomatik: p\le20 ise BAS, değilse MCMC (132). |
Öncül hiperparametresi α · oncul_alpha (68–76) |
ondalık · Model | 0 | 0–10⁶ | 0 ise varsayılan; g öncülünde g=\alpha (n), hyper-g/n'de \alpha (3) (134–136). |
Beta-binom öncülü a, b · bb_a, bb_b (77–94) |
ondalık · Model | 1; 1 | 0,01–1000 | Yalnız beta-binom model öncülünde. |
HPD aralık düzeyi · guven (95–102) |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | confint(level=, nsim=100000) (184). |
Türlerin anlamı ve formun denetimi ortak bölümdedir (Bölüm 1). Şablona özgü denetimler:
- Veri yok → "Önce Veri sekmesinde bir veri açın." (107).
- Yanıttan farklı 2'den az aday → "Yanıttan farklı en az iki aday değişken seçin." (109).
- Sayısal olmayan sütun → "'…' sayısal değil." (114). Sayısal role atanan sütun, Veri sekmesinde kategorik görünse bile sayı olarak gelir (Bölüm 1.3); metin sütunu ise formun denetiminde, çalıştırma başlamadan durdurulur.
- \log için \le0 değer → "'…' log dönüşümü için pozitif olmalı." (117).
- n<p+3 → "…çok az gözlem var (n ≥ p + 3 gerekli)." (121).
- Yanıt ya da aday sabit → "Yanıt sabit." / "'…' sabit; adaylardan çıkarın." (122–123).
zorunluadaylardan değilse → "Zorunlu değişkenler aday değişkenler arasından seçilmeli." (142).bas.lmhatası → "Model ortalaması hesaplanamadı: …" (146).- Adaylar tam doğrusal bağımlı (ör. bir adayın başka bir adayın doğrusal dönüşümü olması) → "Aday değişkenler arasında tam doğrusal bağımlılık var (…); bu değişkenleri aday listesinden çıkarın." (124–128). Sütunlar merkezlenip birim SS'ye ölçeklenir,
qr(tol = 1e-9)ile sıra bakılır; sıra eksikse başka adaylardan türeyen sütunlar adlarıyla yazılır. - Eksik değerli satırlar ve aday olmayan \log sütunları çıkarılır ya da yok sayılır; sayıları ve adları çıktıda not olarak yazılır (111–113, 149–150).
Örnek ayar (ornek_param, satır 9): yanıt y, 15 aday, y ve So dışındaki hepsi \log dönüşümlü, ZS-null, tekdüze model öncülü, n_iter = 20000. Bu ayarda p\le20 olduğundan MCMC kullanılmaz.
215.3 Örnek veri
uscrime.csv: Ehrlich (1973) ABD ceza verisi (MASS UScrime), 47 eyalet, eksik değer yok. y hükümlü başına suç oranıdır; 15 aday sütun örnek ayarda adaylardır. So (Güney) 0/1'dir ve Veri sekmesince "ikili" algılanır; sayısal rolde olduğu için 0/1 sayı olarak gider. Diğer 14 sütun ve y sayısaldır.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
y |
yanıt (log) | numeric | suç oranı |
M, Ed, Po1, Po2, LF, M.F, Pop, NW, U1, U2, GDP, Ineq, Prob, Time |
aday (log) | numeric | yaş, eğitim, polis harcaması vb. |
So |
aday (ham) | binary | 0/1 |
Kategorik düzey sırasının bir etkisi yoktur: bütün adaylar sayısal sütundur. Bölümde şu çalıştırmalar kullanıldı (tohum 1, aksi belirtilmedikçe): örnek ayar (q11_bma_s1); g-prior, BIC, JZS, hyper-g-n, beta-binom, g=100; yöntem MCMC (20 000 ve 100 000 yineleme; tohum 1–3); MCMC+BAS; \log yok; zorunlu Ed, Ineq; ölçek dönüştürülmüş veri; 17 adaylı veri; sınır durumu dosyaları.
215.4 Yöntem: formüller ve hesap adımları
Şablon veriyi hazırlar (eksik satırı atar, seçilen sütunların logaritmasını alır), BAS::bas.lm ile model uzayını gezer, her model için sınırsal olabilirliği hesaplar ve üç tablo üretir: dahil olma olasılıkları, en olası beş model, model ortalamalı katsayılar.
215.4.1 Sınırsal olabilirlik ve g öncülü
Tasarım sütunları ortalanır; kesişim ve \sigma^2 için p(\alpha,\sigma^2)\propto\sigma^{-2}, katsayılar için Zellner'in g öncülü kullanılır:
- p_\gamma: modeldeki değişken sayısı; R^2_\gamma: modelin belirleme katsayısı.
- \mathrm{BF}(\gamma:0): \gamma modelinin yalnız kesişimli modele göre Bayes çarpanı.
- g: öncülün ölçeği;
g-priorseçeneğinde g=n (birim bilgi) ya daoncul_alpha.
Neden g=n
g=n öncülü bir gözlemin bilgisine denk gelir. Sabit g çok büyükse küçük modellere, çok küçükse büyük modellere çeker ve sonuç g'ye bağlı kalır: örnekte g=100 ile dahil olma olasılıkları belirgin küçülür (215.7). Bu bağımlılığı gidermek için g üzerine öncül konan karışım öncülleri vardır.
215.4.2 Karışım öncülleri ve BIC
ZS-nullveJZS: Zellner–Siow, g\sim\mathrm{TersGama}(1/2,\,n/2) (katsayı üzerinde Cauchy). BAS'taJZStümleve kesin sayısal,ZS-nullLaplace yaklaşımıyla çözer; sonuçlar çok yakındır, tam eşit değildir (en büyük dahil olma olasılığı farkı 0{,}0062; 215.6).hyper-g-n: \pi(g)=\frac{a-2}{2n}\big(1+\frac gn\big)^{-a/2}, a=3 (oncul_alphaile değişir).BIC: \mathrm{BF}(\gamma:0)\approx(1-R_\gamma^2)^{-n/2}\,n^{-p_\gamma/2} (Schwarz, 1978).
Koddaki tercih
initprobs = "eplogp", force.heredity = FALSE, pivot = TRUE sabittir (satır 137–138). oncul_alpha > 0 yalnız g-prior ve hyper-g-n için aktarılır (135–139); JZS, ZS-null, BIC için öncül ölçeği değiştirilemez. Model öncülü uniform() ya da beta.binomial(bb_a, bb_b)'dir (133); BAS'ın kendi varsayılanı beta-binomdur, şablonun varsayılanı tekdüzedir.
215.4.3 Model öncülü, dahil olma olasılığı, katsayılar
Tekdüze öncülde P(\gamma)=2^{-p}; beta-binomda P(\gamma)=B(a+p_\gamma,\,b+p-p_\gamma)/B(a,b) (a=b=1 iken model büyüklüğüne tekdüze). Sonsal dahil olma olasılığı ve model ortalamalı katsayı:
- \mathrm{PIP}_j: j. değişkenin modelde olma olasılığı (tablodaki
dahil_olma_olasiligi). - \mathrm E[\beta_j\mid\gamma,\mathbf y]: g öncülünde \frac{g}{1+g}\hat\beta^{\mathrm{OLS}}_{\gamma,j} (j\notin\gamma ise 0).
Sonsal SS, toplam varyans yasasıyla (model içi varyans ve modeller arası ortalama dağılımı) hesaplanır. HPD aralığı model ağırlıklarıyla örneklenen 100 000 t çekiminden (\mathrm{df}=n-1) bulunur; çekimler rastgele olduğundan sınırlar tohuma bağlıdır ve çıktı çekim sayısını ve tohumu yazar (215.7). Dışlanan modelde katsayı tam 0'dır; bu yüzden birçok aralığın bir ucu 0,000000 çıkar.
215.4.4 Tam sayım, örnekleme ve MCMC
yontem = BAS: bütün modelleri örnekler; ancak bas.lm varsayılan olarak en çok 2^{16} model alır. Serbest aday sayısı (zorunlu değişkenler çıkarıldıktan sonra) 16 ya da daha azsa 2^{p} modelin tamamı sayılır ve konsol "tam sayım (… model)" yazar; 17–20 adayda 2^{16} model yerine koymadan örneklenir ve konsol "BAS örnekleme (65536 / 131072 model)" gibi gerçek sayıyı yazar, ayrıca olasılıkların kesin değil yaklaşık olduğunu söyleyen bir not ekler (satır 148–172). MCMC: modelleri Metropolis–Hastings (MC³) ile gezer, sonsal olasılık ve PIP örnekleme sıklığıdır; tek zincirdir, R-hat ve etkin örneklem hesaplanmaz. Çıktı bunu not eder ve tanı olarak MCMC sıklığı ile yeniden normalleştirilmiş PIP'ler arasındaki en büyük farkı yazar; fark 0{,}05'i aşarsa yakınsama uyarısı verir. MCMC+BAS: MCMC ile bulunan modeller üzerinde BAS (örnekte 32 768 modelin tamamı bulunur ve sonuç kesin sayımla aynıdır; bu yöntemde fark tanısı hesaplanamaz). otomatik: p\le20 ise BAS, değilse MCMC.
215.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 104–108 | BAS yüklenir; veri yoksa durur. | .m() iletiyi arayüz diline göre seçer. |
| 109–119 | Adaylar belirlenir, eksik satır atılır (sayısı tutulur), sayısal ve pozitiflik denetimi, seçilen sütunlar \log alınır. | Aday olmayan log sütun adları ayrıca tutulur. |
| 120–129 | n\ge p+3, sabit sütun denetimi, tam doğrusal bağımlılık denetimi; adlar make.names ile düzeltilir. |
M.F gibi adlar korunur. |
| 130–139 | Formül, yöntem, model öncülü, \alpha ve bas.lm bağımsız değişken listesi kurulur. |
p\le20 için otomatik BAS. |
| 141–147 | include.always ve bas.lm çağrısı; uyarılar toplanır. |
Hata iletisi sarmalanır. |
| 148–172 | Gerçek yöntem etiketi, konsol satırı, eksik satır / log notu, örnekleme notu, MCMC notu ve tanısı. | Tam sayım yalnız tüm model uzayı sayıldıysa yazılır. |
| 173–176 | PIP tablosu. | Kesişim satırı 1'dir. |
| 177–183 | En olası 5 model: değişkenler, BF, sonsal olasılık, R^2, boyut. | Sıra postprobs'a göredir; BF ilk modele göre. |
| 184–191 | Model ortalamalı katsayılar ve HPD (100 000 çekim); HPD notu, uyarılar. | confint rastgeledir; tohum yazılır. |
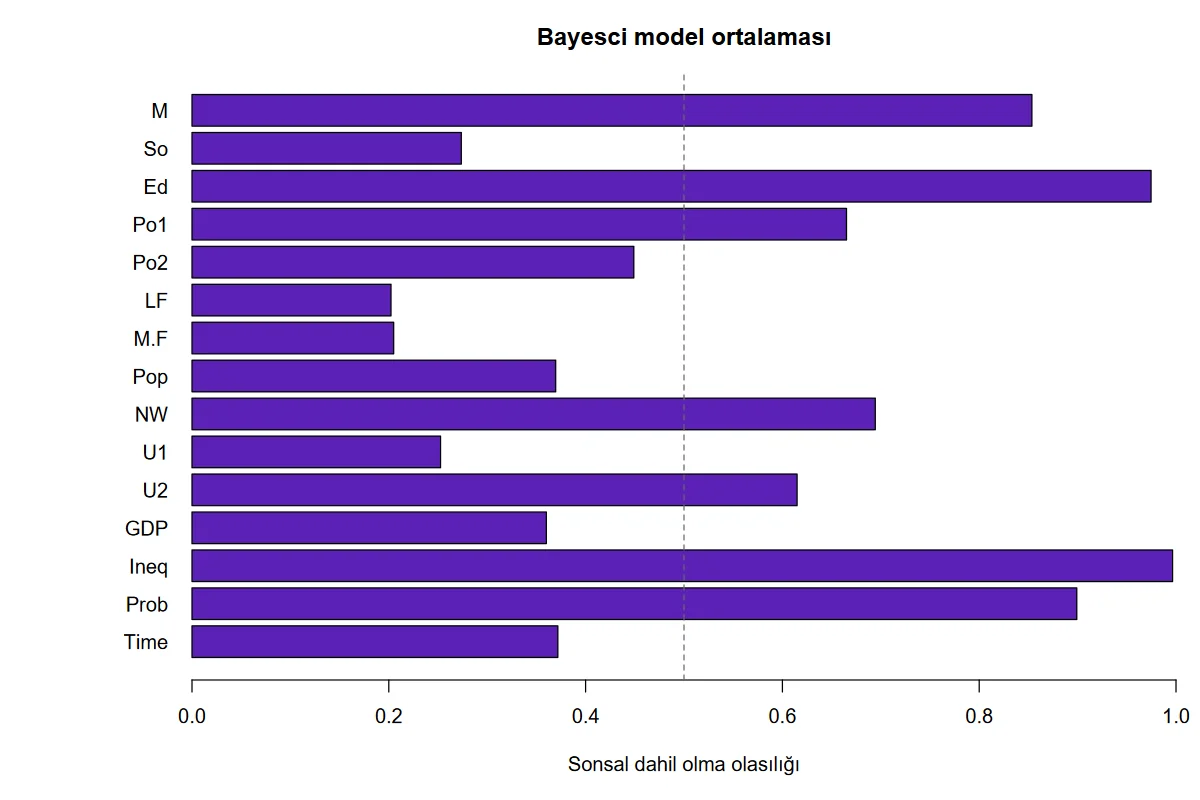
| 192–197 | PIP çubuk grafiği, 0,5 çizgisi. |
215.6 Elle hesap: örnek veride bağımsız yeniden hesap
dogrulama/bayes_model_ortalamasi/elle_hesap.py (numpy; BAS çağrılmaz) ve r_dogrulama.R (temel R; BAS doğrudan çağrı) kullanıldı.
Adım 1 — Her alt küme için R^2. Python, 2^{15}=32\,768 alt kümenin her birinde ortalanmış normal denklemleri çözer.
Adım 2 — g öncülü (g=n=47). Kapalı formülle Bayes çarpanı, tekdüze öncülle sonsal olasılık: en iyi model 7 değişkenli M+Ed+Po1+NW+U2+Ineq+Prob, olasılık 0{,}024696, R^2=0{,}82647; ikinci modelin Bayes çarpanı 0{,}9713. Şablonun g-prior çalıştırmasıyla 15 PIP, en iyi model olasılığı, Bayes çarpanları ve 15 model ortalamalı katsayı 10^{-12} içinde aynıdır. Kesişim, ortalanmış tasarımda \bar y=6{,}7249'dur.
Adım 3 — BIC. \mathrm{BF}=(1-R^2)^{-n/2}n^{-p_\gamma/2}; PIP'ler 10^{-12} içinde aynıdır (en iyi model olasılığı 0{,}034723).
Adım 4 — Zellner–Siow. g üzerinde ızgara tümleviyle tam ZS Bayes çarpanı: JZS çalıştırması 3\cdot10^{-13} içinde aynıdır; beta-binom model öncülüyle de (1{,}6\cdot10^{-12}). Varsayılan ZS-null (Laplace) tam tümleve göre en çok 0{,}0062 (NW: 0{,}6944 ↔ 0{,}6882) farklıdır; en iyi model olasılığı 0{,}018247 ↔ 0{,}018210.
Adım 5 — BAS'ın doğrudan çağrısı. Aynı tohumla ZS-null PIP'leri ve MCMC sonuçları (20 000 yineleme, tohum 1 ve 2) şablonla birebir aynıdır; HPD sınırları aynı tohum ve çekim sayısıyla yinelenir. MCMC'nin kesin sayımdan sapması en çok 0{,}044 (tohum 1) ve 0{,}036 (tohum 2) PIP farkıdır.
Adım 6 — 17 aday. 2^{17} modelin tamı (n.models = 2^17) ile şablonun 65 536 modelli örneklemesi arasında en çok 0{,}0044 PIP farkı vardır; şablon bunu "örnekleme" olarak yazar.
215.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | Ölçüt | |
|---|---|---|---|---|---|---|
| g-öncülü: dahil olma olasılığı M | 0,85036153 | 0,85036153 | 0,85036153 | 3,1e−13 | 1e−6 | ✓ |
| g-öncülü: dahil olma olasılığı So | 0,230689 | 0,230689 | 0,230689 | 4,9e−14 | 1e−6 | ✓ |
| g-öncülü: dahil olma olasılığı Ed | 0,97758643 | 0,97758643 | 0,97758643 | 2,7e−14 | 1e−6 | ✓ |
| g-öncülü: dahil olma olasılığı Po1 | 0,66548728 | 0,66548728 | 0,66548728 | 3,6e−13 | 1e−6 | ✓ |
| g-öncülü: dahil olma olasılığı Po2 | 0,42157966 | 0,42157966 | 0,42157966 | 3,7e−13 | 1e−6 | ✓ |
| g-öncülü: dahil olma olasılığı LF | 0,15674244 | 0,15674244 | 0,15674244 | 4,4e−14 | 1e−6 | ✓ |
| g-öncülü: dahil olma olasılığı M.F | 0,16032985 | 0,16032985 | 0,16032985 | 3,0e−14 | 1e−6 | ✓ |
| g-öncülü: dahil olma olasılığı Pop | 0,3301836 | 0,3301836 | 0,3301836 | 1,8e−13 | 1e−6 | ✓ |
| g-öncülü: dahil olma olasılığı NW | 0,67929253 | 0,67929253 | 0,67929253 | 3,8e−14 | 1e−6 | ✓ |
| g-öncülü: dahil olma olasılığı U1 | 0,20826082 | 0,20826082 | 0,20826082 | 7,8e−14 | 1e−6 | ✓ |
| g-öncülü: dahil olma olasılığı U2 | 0,59960839 | 0,59960839 | 0,59960839 | 1,1e−13 | 1e−6 | ✓ |
| g-öncülü: dahil olma olasılığı GDP | 0,31248397 | 0,31248397 | 0,31248397 | 2,7e−13 | 1e−6 | ✓ |
| g-öncülü: dahil olma olasılığı Ineq | 0,99748101 | 0,99748101 | 0,99748101 | 1,1e−15 | 1e−6 | ✓ |
| g-öncülü: dahil olma olasılığı Prob | 0,89633382 | 0,89633382 | 0,89633382 | 7,0e−15 | 1e−6 | ✓ |
| g-öncülü: dahil olma olasılığı Time | 0,33334905 | 0,33334905 | 0,33334905 | 1,5e−13 | 1e−6 | ✓ |
| g-öncülü: en iyi modelin sonsal olasılığı | 0,02469581 | 0,02469581 | 0,02469581 | 5,1e−15 | 1e−6 | ✓ |
| g-öncülü: en iyi modelin R²'si | 0,82647042 | 0,82647042 | 0,82647042 | 1,4e−14 | 1e−6 | ✓ |
| g-öncülü: 2. modelin Bayes çarpanı (en iyiye göre) | 0,97131608 | 0,97131608 | 0,97131608 | 5,1e−12 | 1e−6 | ✓ |
| g-öncülü: 3. modelin Bayes çarpanı (en iyiye göre) | 0,65836093 | 0,65836093 | 0,65836093 | 3,7e−13 | 1e−6 | ✓ |
| g-öncülü: 4. modelin Bayes çarpanı (en iyiye göre) | 0,59638324 | 0,59638324 | 0,59638324 | 8,0e−13 | 1e−6 | ✓ |
| g-öncülü: 5. modelin Bayes çarpanı (en iyiye göre) | 0,55235223 | 0,55235223 | 0,55235223 | 1,9e−12 | 1e−6 | ✓ |
| g-öncülü: kesişim (ortalanmış tasarımda ȳ) | 6,7249362 | 6,7249362 | — | 2,8e−15 | 1e−6 | ✓ |
| g-öncülü: model ortalamalı katsayı M | 1,16523624 | 1,16523624 | 1,16523624 | 2,7e−13 | 1e−6 | ✓ |
| g-öncülü: model ortalamalı katsayı So | 0,03166295 | 0,03166295 | 0,03166295 | 1,0e−14 | 1e−6 | ✓ |
| g-öncülü: model ortalamalı katsayı Ed | 1,90449113 | 1,90449113 | 1,90449113 | 5,3e−14 | 1e−6 | ✓ |
| g-öncülü: model ortalamalı katsayı Po1 | 0,62384073 | 0,62384073 | 0,62384073 | 3,3e−13 | 1e−6 | ✓ |
| g-öncülü: model ortalamalı katsayı Po2 | 0,32633062 | 0,32633062 | 0,32633062 | 3,1e−13 | 1e−6 | ✓ |
| g-öncülü: model ortalamalı katsayı LF | 0,04454757 | 0,04454757 | 0,04454757 | 4,4e−16 | 1e−6 | ✓ |
| g-öncülü: model ortalamalı katsayı M.F | 7,683185·10−4 | 7,683185·10−4 | 7,683185·10−4 | 1,2e−13 | 1e−6 | ✓ |
| g-öncülü: model ortalamalı katsayı Pop | −0,02075657 | −0,02075657 | −0,02075657 | 7,8e−15 | 1e−6 | ✓ |
| g-öncülü: model ortalamalı katsayı NW | 0,06663924 | 0,06663924 | 0,06663924 | 5,0e−16 | 1e−6 | ✓ |
| g-öncülü: model ortalamalı katsayı U1 | −0,01967689 | −0,01967689 | −0,01967689 | 1,1e−14 | 1e−6 | ✓ |
| g-öncülü: model ortalamalı katsayı U2 | 0,2030465 | 0,2030465 | 0,2030465 | 1,9e−14 | 1e−6 | ✓ |
| g-öncülü: model ortalamalı katsayı GDP | 0,18307036 | 0,18307036 | 0,18307036 | 2,5e−13 | 1e−6 | ✓ |
| g-öncülü: model ortalamalı katsayı Ineq | 1,41652465 | 1,41652465 | 1,41652465 | 4,2e−14 | 1e−6 | ✓ |
| g-öncülü: model ortalamalı katsayı Prob | −0,21561499 | −0,21561499 | −0,21561499 | 2,5e−14 | 1e−6 | ✓ |
| g-öncülü: model ortalamalı katsayı Time | −0,07929726 | −0,07929726 | −0,07929726 | 4,7e−14 | 1e−6 | ✓ |
| BIC: dahil olma olasılığı M | 0,90938063 | 0,90938063 | 0,90938063 | 2,2e−13 | 1e−6 | ✓ |
| BIC: dahil olma olasılığı So | 0,22862184 | 0,22862184 | 0,22862184 | 1,4e−13 | 1e−6 | ✓ |
| BIC: dahil olma olasılığı Ed | 0,99197483 | 0,99197483 | 0,99197483 | 1,6e−14 | 1e−6 | ✓ |
| BIC: dahil olma olasılığı Po1 | 0,68726312 | 0,68726312 | 0,68726312 | 3,9e−13 | 1e−6 | ✓ |
| BIC: dahil olma olasılığı Po2 | 0,40370221 | 0,40370221 | 0,40370221 | 4,2e−13 | 1e−6 | ✓ |
| BIC: dahil olma olasılığı LF | 0,16072461 | 0,16072461 | 0,16072461 | 4,2e−14 | 1e−6 | ✓ |
| BIC: dahil olma olasılığı M.F | 0,16774009 | 0,16774009 | 0,16774009 | 7,7e−14 | 1e−6 | ✓ |
| BIC: dahil olma olasılığı Pop | 0,35912529 | 0,35912529 | 0,35912529 | 4,4e−13 | 1e−6 | ✓ |
| BIC: dahil olma olasılığı NW | 0,77577441 | 0,77577441 | 0,77577441 | 1,5e−14 | 1e−6 | ✓ |
| BIC: dahil olma olasılığı U1 | 0,22632003 | 0,22632003 | 0,22632003 | 4,2e−14 | 1e−6 | ✓ |
| BIC: dahil olma olasılığı U2 | 0,6959277 | 0,6959277 | 0,6959277 | 1,6e−13 | 1e−6 | ✓ |
| BIC: dahil olma olasılığı GDP | 0,36349378 | 0,36349378 | 0,36349378 | 3,9e−13 | 1e−6 | ✓ |
| BIC: dahil olma olasılığı Ineq | 0,99920749 | 0,99920749 | 0,99920749 | 5,3e−15 | 1e−6 | ✓ |
| BIC: dahil olma olasılığı Prob | 0,94621219 | 0,94621219 | 0,94621219 | 1,1e−14 | 1e−6 | ✓ |
| BIC: dahil olma olasılığı Time | 0,40854856 | 0,40854856 | 0,40854856 | 2,1e−13 | 1e−6 | ✓ |
| JZS: dahil olma olasılığı M (ızgara tümlevi) | 0,84979382 | 0,84979382 | 0,84979382 | 2,8e−13 | 1e−6 | ✓ |
| JZS: dahil olma olasılığı So (ızgara tümlevi) | 0,2703865 | 0,2703865 | 0,2703865 | 9,5e−14 | 1e−6 | ✓ |
| JZS: dahil olma olasılığı Ed (ızgara tümlevi) | 0,97349875 | 0,97349875 | 0,97349875 | 3,7e−14 | 1e−6 | ✓ |
| JZS: dahil olma olasılığı Po1 (ızgara tümlevi) | 0,66425064 | 0,66425064 | 0,66425064 | 3,4e−13 | 1e−6 | ✓ |
| JZS: dahil olma olasılığı Po2 (ızgara tümlevi) | 0,44772111 | 0,44772111 | 0,44772111 | 3,2e−13 | 1e−6 | ✓ |
| JZS: dahil olma olasılığı LF (ızgara tümlevi) | 0,19877469 | 0,19877469 | 0,19877469 | 1,6e−14 | 1e−6 | ✓ |
| JZS: dahil olma olasılığı M.F (ızgara tümlevi) | 0,20159769 | 0,20159769 | 0,20159769 | 2,2e−14 | 1e−6 | ✓ |
| JZS: dahil olma olasılığı Pop (ızgara tümlevi) | 0,36530042 | 0,36530042 | 0,36530042 | 2,0e−13 | 1e−6 | ✓ |
| JZS: dahil olma olasılığı NW (ızgara tümlevi) | 0,68818243 | 0,68818243 | 0,68818243 | 4,9e−14 | 1e−6 | ✓ |
| JZS: dahil olma olasılığı U1 (ızgara tümlevi) | 0,24845574 | 0,24845574 | 0,24845574 | 4,8e−14 | 1e−6 | ✓ |
| JZS: dahil olma olasılığı U2 (ızgara tümlevi) | 0,60889832 | 0,60889832 | 0,60889832 | 1,3e−13 | 1e−6 | ✓ |
| JZS: dahil olma olasılığı GDP (ızgara tümlevi) | 0,35456073 | 0,35456073 | 0,35456073 | 2,1e−13 | 1e−6 | ✓ |
| JZS: dahil olma olasılığı Ineq (ızgara tümlevi) | 0,99640709 | 0,99640709 | 0,99640709 | 1,4e−14 | 1e−6 | ✓ |
| JZS: dahil olma olasılığı Prob (ızgara tümlevi) | 0,8955326 | 0,8955326 | 0,8955326 | 2,3e−14 | 1e−6 | ✓ |
| JZS: dahil olma olasılığı Time (ızgara tümlevi) | 0,36572428 | 0,36572428 | 0,36572428 | 1,1e−13 | 1e−6 | ✓ |
| JZS + beta-binom(1, 1): en büyük | fark | (15 değişken) | 1,576073·10−12 | 0 | — | 1,6e−12 |
| ZS-null: dahil olma olasılığı Intercept (BAS doğrudan) | 1 | — | 1 | 0 | 1e−6 | ✓ |
| ZS-null: dahil olma olasılığı M (BAS doğrudan) | 0,85357196 | — | 0,85357196 | 0 | 1e−6 | ✓ |
| ZS-null: dahil olma olasılığı So (BAS doğrudan) | 0,27370833 | — | 0,27370833 | 0 | 1e−6 | ✓ |
| ZS-null: dahil olma olasılığı Ed (BAS doğrudan) | 0,97466055 | — | 0,97466055 | 0 | 1e−6 | ✓ |
| ZS-null: dahil olma olasılığı Po1 (BAS doğrudan) | 0,66515529 | — | 0,66515529 | 0 | 1e−6 | ✓ |
| ZS-null: dahil olma olasılığı Po2 (BAS doğrudan) | 0,44900965 | — | 0,44900965 | 0 | 1e−6 | ✓ |
| ZS-null: dahil olma olasılığı LF (BAS doğrudan) | 0,20223744 | — | 0,20223744 | 0 | 1e−6 | ✓ |
| ZS-null: dahil olma olasılığı M.F (BAS doğrudan) | 0,20496594 | — | 0,20496594 | 0 | 1e−6 | ✓ |
| ZS-null: dahil olma olasılığı Pop (BAS doğrudan) | 0,36961497 | — | 0,36961497 | 0 | 1e−6 | ✓ |
| ZS-null: dahil olma olasılığı NW (BAS doğrudan) | 0,6944069 | — | 0,6944069 | 0 | 1e−6 | ✓ |
| ZS-null: dahil olma olasılığı U1 (BAS doğrudan) | 0,25258343 | — | 0,25258343 | 0 | 1e−6 | ✓ |
| ZS-null: dahil olma olasılığı U2 (BAS doğrudan) | 0,6149388 | — | 0,6149388 | 0 | 1e−6 | ✓ |
| ZS-null: dahil olma olasılığı GDP (BAS doğrudan) | 0,36011786 | — | 0,36011786 | 0 | 1e−6 | ✓ |
| ZS-null: dahil olma olasılığı Ineq (BAS doğrudan) | 0,99653585 | — | 0,99653585 | 0 | 1e−6 | ✓ |
| ZS-null: dahil olma olasılığı Prob (BAS doğrudan) | 0,89918413 | — | 0,89918413 | 0 | 1e−6 | ✓ |
| ZS-null: dahil olma olasılığı Time (BAS doğrudan) | 0,37179757 | — | 0,37179757 | 0 | 1e−6 | ✓ |
| ZS-null: en iyi modelin sonsal olasılığı (BAS doğrudan) | 0,01824728 | — | 0,01824728 | 0 | 1e−6 | ✓ |
| ZS-null: en büyük | PIP farkı | , Laplace yaklaşımı ↔ tam Zellner-Siow tümlevi (ölçüt 0,01) | 0,00622446 | 0 | — | 6,2e−3 |
| MCMC (20000 yineleme, tohum 1): en büyük | PIP farkı | şablon ↔ BAS doğrudan | 0 | 0 | — | 0 |
| MCMC (20000 yineleme, tohum 1): en büyük | PIP farkı | MCMC ↔ kesin sayım (ölçüt 0,05) | 0,04331927 | 0 | — | 4,3e−2 |
| MCMC (20000 yineleme, tohum 2): en büyük | PIP farkı | şablon ↔ BAS doğrudan | 0 | 0 | — | 0 |
| MCMC (20000 yineleme, tohum 2): en büyük | PIP farkı | MCMC ↔ kesin sayım (ölçüt 0,05) | 0,0419718 | 0 | — | 4,2e−2 |
| HPD alt sınırı, en büyük | fark | şablon (tohum 1) ↔ BAS doğrudan (tohum 1) | 0 | 0 | — | 0 |
| HPD alt sınırı, en büyük | fark | şablon (tohum 2) ↔ BAS doğrudan (tohum 2) | 0 | 0 | — | 0 |
| HPD alt sınırı, tohum 1 ↔ tohum 2 (aynı model; tohuma duyarlılık, ölçüt 0,2) | 0,09107865 | 0 | — | 9,1e−2 | 2e−1 | ✓ |
| p = 17: en büyük | PIP farkı | şablon ↔ 2^17 modelin tamı (ölçüt 0,01) | 0,00438372 | 0 | — | 4,4e−3 |
Ölçütü karşılayan: 94/94. Bağımsız Python: 2^15 alt kümenin hepsi için R² ve kapalı formül (g-öncülü g = n; BIC) ve g üzerinde ızgara tümleviyle tam Zellner-Siow Bayes çarpanı; BAS çağrılmaz. Bağımsız R: (i) temel R'de aynı kapalı formüller, (ii) BAS'ın şablonla aynı çağrıyla ve aynı tohumla doğrudan çalıştırılması. Varsayılan ZS-null, BAS'ta Laplace yaklaşımıyla hesaplanır; tam tümlevle (JZS) aynı değildir, fark satırında görülür.
Ek denetim: y ve Po1 yeniden ölçeklendiğinde (Po1×1000, y×0,001, \log yok) PIP'ler 10^{-14} içinde aynıdır, katsayılar ölçekle orantılı değişir; Zellner öncülleri ölçekten bağımsızdır. \log dönüşümü ise model değiştirir: dönüşümsüz çalıştırmada Po1'in PIP'i 0{,}842, Ed'in 0{,}895 olur (dönüşümlüde 0{,}665 ve 0{,}975).
215.7 Çıktıyı okuma
Örnek ayar, tohum 1 (q11_bma_s1):
n = 47, aday değişken = 15; öncül ZS-null; model öncülü uniform; tam sayım (32768 model)

 degisken  dahil_olma_olasiligi
Intercept                     1
        M               0.85357
       So               0.27371
       Ed               0.97466
      Po1               0.66516
      Po2               0.44901
       LF               0.20224
      M.F               0.20497
      Pop               0.36961
       NW               0.69441
       U1               0.25258
       U2               0.61494
      GDP               0.36012
     Ineq               0.99654
     Prob               0.89918
     Time                0.3718

 sira                                 degiskenler      BF  sonsal_olasilik      R2  boyut
    1 M + Ed + Po1 + NW + U2 + Ineq + Prob + Time       1         0.018247 0.84197      8
    2        M + Ed + Po1 + NW + U2 + Ineq + Prob 0.94162         0.017182 0.82647      7
    3        M + Ed + Po2 + NW + U2 + Ineq + Prob 0.63697         0.011623  0.8229      7
    4  M + Ed + Po1 + Pop + NW + U2 + Ineq + Prob 0.59445         0.010847 0.83751      8
    5             M + Ed + Po1 + U2 + Ineq + Prob 0.53013        0.0096734 0.80455      6

    terim  sonsal_ortalama  sonsal_SS  dahil_olma     HPD_alt   HPD_ust
Intercept           6.7249   0.028388           1      6.6679    6.7817
        M           1.1436    0.66968     0.85357           0    2.1733
       So         0.035475   0.091978     0.27371   -0.057068      0.31
       Ed           1.8585    0.63039     0.97466     0.62663    3.1725
      Po1          0.60067    0.53442     0.66516           0    1.4374
      Po2          0.31842    0.52099     0.44901    -0.19179    1.4519
       LF         0.059337    0.31994     0.20224    -0.46164    1.0642
      M.F        -0.027028    0.81092     0.20497     -2.0854    2.0809
      Pop        -0.022483   0.039822     0.36961    -0.12742 0.0053744
       NW         0.066684   0.057241     0.69441 -1.6323e-06   0.16636
       U1        -0.024569    0.17655     0.25258    -0.50906   0.37203
       U2          0.20703     0.2208     0.61494 -0.00012362   0.66789
      GDP          0.20625    0.36993     0.36012   -0.046217     1.192
     Ineq           1.3901    0.36661     0.99654     0.67022    2.1226
     Prob         -0.21536    0.11698     0.89918    -0.41058         0
     Time        -0.084335    0.16019      0.3718    -0.52418  0.051059

Not: HPD aralıkları model ağırlıklı 100000 rastgele çekimle hesaplanır (tohum: 1); sonsal ortalama, SS ve dahil olma olasılıkları çekime bağlı değildir.
Şekil 215.1. Şablonun çizdiği dahil olma olasılığı çubukları (örnek veri); kesik çizgi 0,5.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
dahil_olma_olasiligi |
P(\beta_j\ne0\mid y). | 0,5 üstü "medyan olasılık modeli"ne girer (Barbieri ve Berger, 2004); Ineq 0{,}997, Ed 0{,}975, Prob 0{,}899, M 0{,}854 güçlüdür. Düşük değer "ilişki yok" değil, "veride kanıt yok" demektir. |
BF, sonsal_olasilik, R2, boyut |
En olası beş model. | En iyi modelin olasılığı yalnız 0{,}018: model belirsizliği büyüktür; tek model seçmek yanıltır. |
sonsal_ortalama, sonsal_SS |
Model ortalamalı katsayı ve SS. | Dışlanma olasılığıyla küçülmüştür. Katsayılar \log–\log olduğundan esnekliktir. |
HPD_alt, HPD_ust |
Karışımdan %95 HPD. | Bir uç 0 ise sıfırdaki yığılma aralığa dahildir; sınırlar tohuma bağlıdır. |
Öncül duyarlığı (PIP, örnek veri). Öncül seçimi sonucu hissedilir biçimde değiştirebilir:
| Aday | ZS-null | g=n | hyper-g/n | JZS | BIC | g=100 | beta-binom |
|---|---|---|---|---|---|---|---|
| M | 0,854 | 0,850 | 0,848 | 0,850 | 0,909 | 0,816 | 0,891 |
| So | 0,274 | 0,231 | 0,272 | 0,270 | 0,229 | 0,188 | 0,397 |
| Po2 | 0,449 | 0,422 | 0,449 | 0,448 | 0,404 | 0,401 | 0,525 |
| NW | 0,694 | 0,679 | 0,686 | 0,688 | 0,776 | 0,614 | 0,773 |
| Time | 0,372 | 0,333 | 0,366 | 0,366 | 0,409 | 0,265 | 0,525 |
Beta-binom model öncülü zayıf adaylara daha çok yer verir (en olası model 15 değişkenin hepsini içerir, olasılık 0{,}0306). MCMC tek zincirdir, R-hat ve etkin örneklem verilmez; yerine çıktı, MCMC sıklığı ile yeniden normalleştirilmiş PIP'ler arasındaki en büyük farkı yazar (örnekte 20 000 yinelemede 0{,}0505; 0{,}05 üstü uyarı doğurur). Aynı veri, 20 000 yineleme, üç tohumda en olası model ve PIP'ler 0{,}04'e kadar kayar. Tohum, MCMC'de örneklemeyi, tam sayımda yalnız HPD çekimlerini etkiler; kod panelindeki isteğe bağlı Tohum alanı kullanılır (Bölüm 1.3), şablonun ayrı bir tohum alanı yoktur.
Rapor cümlesi: "Suç oranı üzerinde 15 aday değişken Bayesçi model ortalamasıyla (BAS; Zellner–Siow öncülü, tekdüze model öncülü, 32 768 modelin tamı) çözümlenmiştir. Eşitsizlik (0{,}997), eğitim (0{,}975), hükümlü olasılığı (0{,}899) ve erkek oranı (0{,}854) için sonsal dahil olma olasılığı 0{,}85'ten büyüktür; en olası modelin sonsal olasılığı 0{,}018'dir."
215.8 Sık hatalar ve tuzaklar
- Seçimi tek modele indirgemek. En olası modelin olasılığı 0{,}018'dir; "seçilen model" kavramı burada yanlıştır.
- Öncül seçimini rapor etmemek. Dahil olma olasılıkları öncüle bağlıdır (tabloya bakın); katsayı öncülü ve model öncülü mutlaka yazılmalıdır.
- p=17–20'de sonucu kesin sanmak. BAS yalnız 2^{16} modeli örnekler; çıktı "BAS örnekleme (65536 / 131072 model)" yazar ve olasılıklar yaklaşıktır.
- MCMC sonucunu kesin sanmak. Tek zincir; 100 000 yinelemede bile PIP'de 0{,}02 sapma vardır. Çıktıdaki fark tanısına bakın; p\le16'da BAS tercih edin.
- Eşdoğrusal adaylar. Tam doğrusal bağımlı adaylar (örn. \mathrm{Po1b}=2\,\mathrm{Po1}+3, ikisi de \log'suz) çalıştırmayı durdurur. Yaklaşık bağımlı adaylarda (biri \log'lu, öteki değil) durmaz; olasılık kopyalar arasında bölünür.
- HPD'yi kesin sanmak. Sınırlar tohumla değişir; tohum çıktıda yazılır.
- Yanıtı yanlış ölçekte yorumlamak. Yanıt \log ise katsayılar göreli etkidir.
- Eksik satırlar atılır; atılan sayı çıktıda not olarak yazılır, n değerini konsol satırından da kontrol edin.
215.9 Uzman soruları
S1. Dahil olma olasılığı 0,5'in üstündeyse değişken "anlamlı" mıdır?
Hayır. \mathrm{PIP}_j Bayesçi bir olasılıktır; 0,5 eşiği yalnız öngörü açısından en iyi tek modeli (medyan olasılık modeli) tanımlar (Barbieri ve Berger, 2004) ve p değeriyle karşılaştırılamaz.
S2. Katsayı öncülü seçimi sonucu ne kadar değiştirir?
Örnekte Zellner–Siow, JZS ve hyper-g/n birbirine çok yakındır; g=n ve g=100 küçük adayların olasılığını düşürür, BIC büyütür. Karışım öncülleri g'nin keyfî seçimine karşı daha kararlıdır (Liang ve ark., 2008).
S3. Model öncülü ne zaman belirleyicidir?
Tekdüze öncül ortalama model büyüklüğünü p/2 varsayar; beta-binom(1, 1) büyüklüğe tekdüzedir ve seyrek ve yoğun modellere de yer verir. Örnekte beta-binom altında So'nun PIP'i 0{,}274'ten 0{,}397'ye çıkar (Ley ve Steel, 2009).
S4. Değişkenleri ölçeklemek sonucu değiştirir mi?
Hayır; g öncülleri tasarım matrisinin ve yanıtın ölçeğinden bağımsızdır (215.6.1). Ancak \log dönüşümü model değiştirir.
S5. Tohum sonucu ne zaman etkiler?
Tam sayımda PIP, model olasılığı ve katsayı ortalaması tohumdan bağımsızdır; yalnız HPD sınırları değişir (bu örnekte tohum 1 ile 2 arasında en çok 0{,}11). MCMC'de tüm sonuçlar tohuma bağlıdır.
S6. p>20 iken ne olur?
Yöntem otomatik ise MCMC çalışır; tek zincir olduğundan çıktıdaki fark tanısına bakılır, çok sayıda yineleme ve birden çok tohumla tutarlılık elle denetlenmelidir. MCMC+BAS bulunan modelleri BAS ile yeniden değerlendirir.
S7. n küçükken kullanılabilir mi?
Şablon n\ge p+3 ister; bu sınırda sonuç bilgisizdir (18 gözlem, 15 aday: PIP'ler 0{,}27–0{,}59).
S8. Temel programdaki Bayesçi doğrusal regresyonla fark nedir?
O analiz tek modelin sonsalını verir ve tam çoklu doğrusallıkta rank denetimi yapar; bu şablon model uzayını gezer; tam doğrusal bağımlılıkta durur, yaklaşık bağımlılıkta uyarmaz.
215.10 Kaynaklar
- Barbieri, M. M., & Berger, J. O. (2004). Optimal predictive model selection. The Annals of Statistics, 32(3), 870–897. https://doi.org/10.1214/009053604000000238
- Clyde, M. A., Ghosh, J., & Littman, M. L. (2011). Bayesian adaptive sampling for variable selection and model averaging. Journal of Computational and Graphical Statistics, 20(1), 80–101. https://doi.org/10.1198/jcgs.2010.09049
- Ehrlich, I. (1973). Participation in illegitimate activities: A theoretical and empirical investigation. Journal of Political Economy, 81(3), 521–565. https://doi.org/10.1086/260058
- Hoeting, J. A., Madigan, D., Raftery, A. E., & Volinsky, C. T. (1999). Bayesian model averaging: A tutorial. Statistical Science, 14(4), 382–417. https://doi.org/10.1214/ss/1009212519
- Kass, R. E., & Raftery, A. E. (1995). Bayes factors. Journal of the American Statistical Association, 90(430), 773–795. https://doi.org/10.1080/01621459.1995.10476572
- Ley, E., & Steel, M. F. J. (2009). On the effect of prior assumptions in Bayesian model averaging with applications to growth regression. Journal of Applied Econometrics, 24(4), 651–674. https://doi.org/10.1002/jae.1057
- Liang, F., Paulo, R., Molina, G., Clyde, M. A., & Berger, J. O. (2008). Mixtures of g priors for Bayesian variable selection. Journal of the American Statistical Association, 103(481), 410–423. https://doi.org/10.1198/016214507000001337
- Raftery, A. E., Madigan, D., & Hoeting, J. A. (1997). Bayesian model averaging for linear regression models. Journal of the American Statistical Association, 92(437), 179–191. https://doi.org/10.1080/01621459.1997.10473615
- Schwarz, G. (1978). Estimating the dimension of a model. The Annals of Statistics, 6(2), 461–464. https://doi.org/10.1214/aos/1176344136
- Yazılım kaydı: BAS 2.0.2 (Clyde, 2025; https://doi.org/10.32614/CRAN.package.BAS), R 4.5.3.