15. Kompartımansız farmakokinetik analiz (NCA) ve ortalama biyoeşdeğerlik
Şablon kimliği: biyoesdegerlik_nca · Kategori: karma model · Dil: R · Dosya: pro/sablonlar/karma_model/biyoesdegerlik_nca.R (satır 1–456; üstbilgi 1–176) · Örnek veri: _ornek/biyoesdegerlik_nca_dsA.csv (ek: …_dsC.csv, …_dsC_eksik.csv, …_theoph.csv) · Paketler: PowerTOST 1.5-7; konsantrasyon kipinde PKNCA 0.12.1; karma modelde lmerTest 3.2-1, lme4 2.0-6 (Kenward–Roger için pbkrtest)
15.1 Ne işe yarar
Şablon iki işi birbirine bağlar. Birincisi kompartımansız analizdir (NCA): her deneğin konsantrasyon–zaman profilinden, hiçbir kompartıman modeli varsaymadan, maruz kalım ölçütlerini (eğri altı alan AUC, doruk konsantrasyon C_{\max}, doruk zamanı T_{\max}, uç eğim \lambda_z, yarı ömür t_{1/2}) hesaplar. İkincisi ortalama biyoeşdeğerliktir (ABE): iki dönemli, iki sıralı (2×2) çapraz tasarımda test ürününün referans ürüne göre geometrik ortalama oranını (GMR) ve onun güven aralığını kestirir; aralık kabul sınırlarının içindeyse iki ürün biyoeşdeğer sayılır. Cevapladığı soru şudur: "Test ürünü, referans ürünle aynı düzeyde ve aynı hızda maruz kalım sağlıyor mu?"
Log ölçekteki model:
- y_{ijk}: j. sıradaki i. deneğin k. dönemdeki farmakokinetik ölçütü (AUC, C_{\max}); pozitif olmalıdır.
- \gamma_j: sıra etkisi (TR, RT). s_{i(j)}: sıra içinde denek etkisi. \pi_k: dönem etkisi.
- \tau_{d(j,k)}: j. sıranın k. dönemde aldığı tedavinin (T ya da R) etkisi.
- \sigma_w^2: denek içi varyans. Biyoeşdeğerlik \theta=\exp(\tau_T-\tau_R) oranı üzerinden sınanır.
Ne zaman kullanılır? 2×2 çapraz biyoeşdeğerlik çalışmasında; denek–dönem başına hazır AUC ya da C_{\max} varsa (PK değeri kipi) ya da ham konsantrasyon–zaman profilleri varsa (konsantrasyon kipi); tek dozluk bir çalışmada yalnız NCA parametreleri isteniyorsa (tedavi sütunu verilmeden); bir sonraki çalışmanın örneklem büyüklüğü planlanacaksa.
Ne zaman kullanılmaz?
- İkiden çok tedavili çapraz tasarımlar, taşınma (carry-over) etkisinin sınanması ya da log dönüşümü gerektirmeyen yanıtlar:
capraz_gecisşablonu. - Yinelemeli (replicate) tasarımlar ve referansa göre ölçeklenen sınırlar: bu şablon yalnız sabit sınırlı ortalama biyoeşdeğerliği hesaplar; kodu düzenlenmiş bir model gerekir.
- Paralel gruplu tasarım: denek içi karşılaştırma yoktur; şablonun dönem ve sıra koşullarını sağlamaz.
- Log dönüşümü olmayan genel bir eşdeğerlik testinin gücü: temel programdaki Güç Analizi penceresinin Eşdeğerlik sekmesi.
- Çoklu doz (kararlı durum) ya da damar içi infüzyon parametreleri (klirens, dağılım hacmi): şablon doz bilgisi almaz ve bu parametreleri üretmez.
- Popülasyon farmakokinetiği (kompartıman modeli, rastgele etkili eğri parametreleri):
nlme_karmaşablonu.
Temel programla ilişki. Temel programda kompartımansız analiz ve çapraz biyoeşdeğerlik çözümlemesi yoktur. Güç Analizi penceresindeki eşdeğerlik testleri ham birimde, simetrik \pm\Delta sınırıyla çalışır; bu şablon log ölçekte, oran sınırlarıyla (0,80–1,25) ve 2×2 çapraz tasarımın serbestlik derecesiyle hesaplar.
15.2 Şablonun girdileri
Form, üstbilgideki 19 [[param]] bloğundan kurulur (biyoesdegerlik_nca.R:10–183).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Girdi türü · girdi |
seçim · Model | pk |
pk, konsantrasyon |
Kip (189); NCA dalı (216–317) ya da doğrudan PK değeri (318–322). |
Denek · denek |
kategorik sütun · Değişkenler | — | herhangi bir sütun | Denek kimliği; mq_kimlik ile tek biçimli metne çevrilir (209). |
PK değeri ya da konsantrasyon · deger |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal | PK kipinde ölçüt (> 0); konsantrasyon kipinde konsantrasyon (≥ 0); mq_sayisal ile okunur (207, 213–214). |
Zaman (konsantrasyon kipinde) · zaman |
sayısal sütun · Değişkenler | boş (zorunlu değil) | sayısal | Örnekleme zamanı; mq_sayisal ile okunur (208, 218); yalnız konsantrasyon kipinde. |
Sıra (ör. TR/RT) · sira |
kategorik sütun · Değişkenler | boş (zorunlu değil) | herhangi bir sütun | Sıra etkisi; biyoeşdeğerlik için gerekli (193). |
Dönem · donem |
sütun · Değişkenler | boş (zorunlu değil) | herhangi bir sütun | Dönem etkisi; biyoeşdeğerlik için gerekli. |
Tedavi (test/referans) · tedavi |
kategorik sütun · Değişkenler | boş (zorunlu değil) | herhangi bir sütun | Tedavi etkisi; konsantrasyon kipinde boşsa yalnız NCA (304). |
Test ürününün tedavi kodu · test |
metin · Model | T |
veride bulunan kod | Oranın payı (325–328). |
Referans ürünün tedavi kodu · referans |
metin · Model | R |
veride bulunan kod | Oranın paydası; tedavi faktörünün ilk düzeyi (340). |
Biyoeşdeğerlik modeli · model |
seçim · Model | anova |
anova, karma |
Sabit etkili doğrusal model (349) ya da denek rastgele karma model (343). |
TOST α (GA düzeyi 1 − 2α) · alfa |
ondalık · Seçenekler | 0,05 | 0,001–0,25 | t çeyreği (386); GA düzeyi 100(1-2\alpha); güç hesabı (412). |
Kabul alt sınırı (oran) · alt_sinir |
ondalık · Seçenekler | 0,8 | 0,01–1 | \theta_1; karar ve TOST (392–393). |
Kabul üst sınırı (oran) · ust_sinir |
ondalık · Seçenekler | 1,25 | 1–100 | \theta_2. |
Planlamada varsayılan gerçek oran θ0 · theta0 |
ondalık · Seçenekler | 0,95 | 0,5–2 | Güç ve örneklem büyüklüğü (405, 412–415). |
Hedef güç · hedef_guc |
ondalık · Seçenekler | 0,8 | 0,5–0,99 | sampleN.TOST(targetpower = …) (415). |
Planlama CV'si (oran; 0 = gözlenen CV_intra) · planlama_cv |
ondalık · Seçenekler | 0 | 0–3 | Sıfırdan büyükse ek "planlama" satırı (420–425). |
AUC yamuk kuralı (NCA) · auc_yontemi |
seçim · Model | lin up/log down |
lin up/log down, linear |
PKNCA.options(auc.method = …) (240). |
Kısmi AUC(0-τ) bitiş zamanı (0 = yok) · kismi_auc_son |
ondalık · Seçenekler | 0 | ≥ 0 | İkinci hesap aralığı [0,\tau]; \tau'ya ara değerlemeli alan aucint.last (233–237). |
Son ölçüm τ'dan önceyse λz ile τ'ya dış değerleme · kismi_auc_dis |
seçim · Seçenekler | hayir |
hayir, evet |
Evet: bu profillerde alan aucint.inf.obs ile uç eğimle τ'ya dış değerlenir (237–239, 252). |
λz için en az nokta · lz_en_az_nokta |
tamsayı · Gelişmiş | 3 | 2–10 | min.hl.points (240). |
λz seçiminde düzeltilmiş R² toleransı · lz_r2_tolerans |
ondalık · Gelişmiş | 0,0001 | 0–0,1 | adj.r.squared.factor (241). |
Konsantrasyon grafiği ekseni · cizim_olcegi |
seçim · Çıktı | log |
log, dogrusal |
Profil grafiğinin dikey ekseni (308–311). |
Örnek ayar (satır 9): girdi = pk, denek = Subj, sira = Seq, donem = Per, tedavi = Trt, deger = Var, test = T, referans = R; öteki alanlar varsayılandadır.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 179 |
| Konsantrasyon kipinde zaman sütunu yok | "zaman sütunu gerekli" | 183 |
| Aynı sütun iki role verilmiş | "rol sütunları birbirinden farklı olmalı" | 184 |
| PK kipinde sıra, dönem ya da tedavi boş | "sıra, dönem ve tedavi sütunları gerekli" | 186 |
| \alpha\le0 ya da \alpha\ge0{,}5 | "α 0 ile 0,5 arasında olmalı" | 189 |
| Sınırlar 0<\theta_1<\theta_2 değil | "Kabul sınırları 0 < alt < üst olmalı" | 190 |
| Eksiksiz satır sayısı < 4 | "Eksiksiz en az 4 satır gerekli" | 204 |
| Değer ya da zaman sütununda sayı olmayan değer | "… sütunu sayıya çevrilemedi …" (Bölüm 1.5) | 199–200 |
| Değer ya da zaman sonlu değil; negatif konsantrasyon | "sayısal olmalı"; "negatif olamaz" | 206, 211–212 |
| Aynı profilde aynı zaman iki kez | "aynı zaman birden çok kez var" | 216 |
| Bir profilde 3'ten az nokta; tümü sıfır | "en az 3 konsantrasyon gerekli"; "NCA yapılamaz" | 218, 220 |
| PK değeri ≤ 0 | "log dönüşümü için pozitif olmalı" | 307 |
| Test ya da referans kodu veride yok, ikisi aynı | "veride farklı iki tedavi olmalı" | 315–316 |
| İkiden az sıra ya da dönem | "en az iki sıra / dönem gerekli" | 318–319 |
| Bir deneğe iki sıra atanmış | "birden çok sıra atanmış" | 320 |
| Artık sd < 1 | "denek içi varyans kestirilemez" | 338 |
| Tedavi katsayısı kestirilemiyor | "Tedavi etkisi kestirilemedi" | 341 |
| SH sıfır ya da sonsuz | "denek içi varyans sıfır" | 373 |
| Hiçbir ölçüt hesaplanamadı | "Hiçbir ölçüt için … hesaplanamadı" | 384 |
| \theta_0 sınırların dışında | "θ0 kabul sınırlarının içinde olmalı" | 395 |
Durdurmayan notlar: eksik değerli satırların sayısı (211); ikiden çok tedavi varsa yalnız test ve referansın kullanıldığı (329); her iki tedavisi olan denek sayısı 3'ten azsa o ölçütün atlandığı (339); \lambda_z kestirilemeyen ve AUC%ext > %20 olan profil sayıları (280–281). Eksik değer: rol sütunlarından herhangi biri eksik olan satır atılır (210).
15.3 Örnek veri
Dosya: _ornek/biyoesdegerlik_nca_dsA.csv: Schütz, Labes ve Fuglsang'ın (2014) yazılım doğrulaması için yayımladığı başvuru veri setlerinden A. 18 denek, iki sıra (RT ve TR; 9'ar denek), iki dönem; 36 satır, eksik değer yok.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
Subj |
Denek | sayısal | 1–18. |
Seq |
Sıra | ikili (metin) | RT (9 denek), TR (9 denek). |
Per |
Dönem | ikili (sayı) | 1, 2. |
Trt |
Tedavi | ikili (metin) | R (referans), T (test); her biri 18 gözlem. |
Var |
PK değeri | sayısal | 45,58–241,09; geometrik ortalama R: 146,94, T: 139,72. |
Şablon denek, sıra, dönem ve tedavi sütunlarını metne çevirip kendi faktörlerini kurar: tedavinin ilk düzeyi her zaman referans kodudur (satır 340), öteki faktörlerin düzeyleri alfabetik sıralanır. Arayüzdeki düzey sırası sonucu etkilemez.
Bölümde kullanılan öteki dosyalar: …_dsC.csv (aynı makalenin veri seti C; 13 denek, sıralar dengesiz: TR 4, RT 9); …_dsC_eksik.csv (C'de 1 numaralı deneğin ikinci dönemi silinmiş); …_theoph.csv (12 deneğe ağızdan teofilin; 11'er örnekleme zamanı, 132 satır; R'nin Theoph verisi).
Çalıştırmalar: (1) örnek ayar; (2) örnek ayar + karma model + planlama CV'si 0,30; (3) veri seti C; (4) C-eksik, sabit etkili model; (5) C-eksik, karma model; (6) teofilin, konsantrasyon kipi, kısmi AUC bitişi 24; (7) teofilin, doğrusal yamuk kuralı.
15.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) konsantrasyon kipinde her profil için NCA parametreleri ve tedaviye göre özet; (2) her ölçüt için log ölçekte doğrusal model, tedavi farkı ve standart hatası; (3) GMR, güven aralığı, iki tek yönlü test ve karar; (4) denek içi değişim katsayısı; (5) Tip III ANOVA tablosu; (6) gözlenen değişim katsayısında güç ve hedef güç için örneklem büyüklüğü.
15.4.1 Eğri altı alan: yamuk kuralları
- (t_i, C_i): zamana göre sıralı ölçümler; t_m=t_{\text{last}}: sıfırdan büyük son konsantrasyonun zamanı.
- "Doğrusal" kuralda bütün aralıklar doğrusal yamukla hesaplanır (Gabrielsson ve Weiner, 2012).
- "Doğrusal artış / log azalış" kuralında C_{i+1}<C_i ve C_{i+1}>0 ise logaritmik, aksi hâlde doğrusal yamuk kullanılır.
Neden azalan aralıkta logaritmik yamuk?
Emilim bittikten sonra konsantrasyon yaklaşık üstel azalır: C(t)=C_i\,e^{-k(t-t_i)}. Bu eğrinin altındaki alan tam olarak logaritmik yamuk formülüdür. Doğrusal yamuk dışbükey bir eğrinin kirişini kullandığından alanı büyütür; aralık uzadıkça yanlılık artar. Teofilin verisinde doğrusal kural AUC_{0-t} geometrik ortalamasını 98,65'ten 101,48'e çıkarır.
Koddaki tercih
PKNCA.options(auc.method = …) (satır 240); varsayılan "doğrusal artış / log azalış". Hesap aralığı start = 0, end = Inf verilir ve auclast istenir (231–232): alan sıfır zamanından son ölçülebilir konsantrasyona kadar toplanır.
15.4.2 Uç eğim λz ve yarı ömür
- Aday nokta kümeleri: C_{\max}'tan sonraki ve sıfırdan büyük konsantrasyonların son k tanesi; k=k_{\min},\dots (hepsi).
- R^2_{\text{düz}}: düzeltilmiş belirleme katsayısı. Seçim kuralı: \lambda_z>0 olan adaylar arasında R^2_{\text{düz}}'si en iyiden en çok \delta kadar düşük olanlardan en çok noktalı olanı.
- k_{\min}: "λz için en az nokta" (varsayılan 3); \delta: "düzeltilmiş R² toleransı" (varsayılan 0,0001).
Neden düzeltilmiş R² ve tolerans?
Ham R^2 nokta sayısı azaldıkça yapay olarak yükselir; iki noktada her zaman 1'dir. Düzeltilmiş R^2 serbestlik derecesini hesaba katar. Tolerans, hemen hemen aynı uyumu veren adaylar arasında daha çok noktaya dayanan (daha kararlı) eğimi seçtirir. C_{\max}'ın dışarıda bırakılması, emilim evresinin uç eğime karışmasını önler.
15.4.3 Sonsuza dışdeğerleme
- C_{\text{last}}: gözlenen son konsantrasyon (PKNCA'nın
aucinf.obsveclast.obstanımı); regresyon doğrusunun kestirdiği değer değil. - \mathrm{AUC}_{\%\text{ext}}: toplam alanın dışdeğerlemeyle eklenen yüzdesi. %20'yi aşan profil sayısı uyarı olarak yazılır (satır 281).
Kısmi AUC(0–τ): τ'ya ara değerleme yapılır, son ölçümden sonrasına dış değerleme yapılmaz
"Kısmi AUC bitiş zamanı" alanı PKNCA'ya ikinci bir aralık [0,\tau] verir ve o aralıkta aucint.last ister (satır 233–237). \tau iki ölçümün arasına düşerse \tau anındaki konsantrasyon, seçilen yamuk kuralıyla (azalan parçada log-doğrusal, artan parçada doğrusal) ara değerlenir ve alan \tau'ya kadar toplanır. Teofilin verisinde \tau=24 için 1 numaralı deneğin son iki ölçümü 12,12 (5,94 mg/L) ve 24,37 (3,28 mg/L) saattedir; C(24)=\exp\{\ln 5{,}94+\tfrac{24-12{,}12}{24{,}37-12{,}12}(\ln 3{,}28-\ln 5{,}94)\}=3{,}3394 ve AUC0_24 = 92,3654 + 53,6448 = 146,0102 olur. Son ölçülebilir zamanı \tau'dan önce olan profilde (6 ve 10 numaralı denekler: 23,85 ve 23,70 saat) dış değerleme yapılmaz; AUC0_24 bu profillerde AUC_{0-t}'ye eşittir ve AUC(0–τ) değildir. Şablon bu profilleri sayar, uyarı olarak yazar ve her profilin alanının bittiği zamanı kismi_auc_bitis sütununda verir (satır 263, 270–279). Bütün profillerde aynı pencere isteniyorsa \tau, en erken son ölçüm zamanını aşmamalıdır. "Son ölçüm τ'dan önceyse λz ile τ'ya dış değerleme" seçeneği Evet yapılırsa bu profillerde PKNCA'nın aucint.inf.obs aralığı kullanılır: son ölçülebilir zamandan τ'ya kadar alan, uç eğimle (C_{\text{son}}\,(1-e^{-\lambda_z(\tau-t_{\text{son}})})/\lambda_z) eklenir; bitiş zamanı sütunu τ olur, λz kestirilemeyen profilde değer boş kalır (satır 237–239, 252, 274). Teofilin verisinde \tau=24 için 6 ve 10 numaralı denekte AUC0_24 71,6970 ve 135,5761 yerine 71,8341 ve 136,2940 olur; son ölçümü \tau'ya ulaşan profiller aynı kalır. Varsayılan Hayır'dır.
15.4.4 NCA özeti
- \bar y_G: geometrik ortalama; s^2_{\ln y}: log değerlerin örneklem varyansı (n-1 bölenli); \mathrm{DK}_G: geometrik değişim katsayısı (%).
- AUC ve C_{\max} için bu ikisi; T_{\max} için ortanca, en küçük ve en büyük; t_{1/2} için aritmetik ortalama ve standart sapma verilir (satır 282–298).
Neden geometrik özet?
AUC ve C_{\max} çarpımsal etkilerle (klirens, biyoyararlanım) belirlenir ve yaklaşık log-normal dağılır. Log ölçekteki ortalamanın geri dönüşümü geometrik ortalamadır; biyoeşdeğerlik de aynı ölçekte kurulduğundan özet ile çıkarım tutarlı kalır. T_{\max} yalnız örnekleme zamanlarını alabilen kesikli bir büyüklüktür; ortanca ve aralık uygundur.
15.4.5 Tedavi farkı: sabit etkili model
Varsayılan model, \ln y için sıra, denek, dönem ve tedavi etkilerinin hepsini sabit alan doğrusal modeldir: lm(ly ~ sira + denek + dönem + tedavi) (satır 349). Tam verili 2×2 tasarımda tedavi farkının en küçük kareler kestirimi kapalı biçimlidir (Chow ve Liu, 2008). Her denek için dönem farkının yarısı d_i=(\ln y_{i1}-\ln y_{i2})/2 alınırsa:
- \bar d_{TR}, \bar d_{RT}: iki sıradaki d_i ortalamaları; n_{TR}, n_{RT}: sıralardaki denek sayıları.
- s_p^2: d_i'lerin iki sıra üzerinden birleştirilmiş (havuzlanmış) varyansı; sd =n_{TR}+n_{RT}-2.
- \hat\sigma_w^2: modelin artık kareler ortalaması (KO_{\text{hata}}); \operatorname{Var}(d_i)=\sigma_w^2/2 olduğundan 2s_p^2'ye eşittir.
Neden dönem farkı?
Bir deneğin iki ölçümü arasındaki farkta denek etkisi s_{i(j)} ve sıra etkisi \gamma_j sadeleşir. TR sırasında E[d]=\tfrac12(\pi_1-\pi_2)+\tfrac12(\tau_T-\tau_R), RT sırasında E[d]=\tfrac12(\pi_1-\pi_2)-\tfrac12(\tau_T-\tau_R)'dir; iki sıranın ortalamaları çıkarılınca dönem etkisi de düşer ve geriye yalnız tedavi farkı kalır. Karşılaştırma böylece denekler arası değişkenlikten arınır; çapraz tasarımın gücü buradan gelir.
Koddaki tercih
Denek sabit etki olarak modele girdiğinde yalnız bir dönemi olan denek tedavi farkına katkı vermez; kestirim tam verili deneklere dayanır. Çıktıdaki n, her iki tedavisi de olan denek sayısıdır (satır 337–338). Şablon bu modeli "EMA yöntemi A" adıyla yazar: bütün etkiler sabittir.
15.4.6 Oran, güven aralığı, iki tek yönlü test
- \nu: artık serbestlik derecesi (sabit etkili modelde N-\operatorname{rank}(\mathbf X); tam veride n_{TR}+n_{RT}-2).
- \theta_1, \theta_2: kabul sınırları (0,80 ve 1,25). H_{01}:\theta\le\theta_1 ve H_{02}:\theta\ge\theta_2 ayrı ayrı, her biri \alpha düzeyinde sınanır.
- Karar: GA tümüyle [\theta_1,\theta_2] içindeyse "biyoeşdeğer" (satır 393). Bu, p_{\mathrm{TOST}}\le\alpha ile aynı karardır.
Neden %90 güven aralığı ve neden 0,80–1,25?
Eşdeğerlikte yokluk hipotezi "ürünler farklıdır"dır; iki tek yönlü testin her biri \alpha=0{,}05 ile yapılır ve ikisi de reddedilmelidir (Schuirmann, 1987). İki tek yönlü \alpha düzeyli test, 100(1-2\alpha)=\%90 güven aralığının sınırların içinde kalmasına denktir; toplam birinci tür hata yine en çok 0,05'tir. 0,80 ve 1,25 log ölçekte simetriktir: \ln 1{,}25=-\ln 0{,}80=0{,}2231.
15.4.7 Denek içi değişim katsayısı
- \hat\sigma_w^2: log ölçekte artık varyans (sabit etkili modelde KO_{\text{hata}}; karma modelde REML artık varyansı).
- Log-normal dağılımda değişim katsayısı yalnız log ölçekteki varyansa bağlıdır; formül bu ilişkinin kendisidir.
15.4.8 ANOVA tablosu: Tip III kareler toplamı
Denek(sıra), dönem ve tedavi için kareler toplamı, o terim modelden çıkarıldığında artık kareler toplamındaki artıştır (satır 360–363). Sıra için bu yol işlemez (denek kuklaları sırayı zaten içerir); şablon sıra etkisini denekler üzerinden ağırlıksız ortalamaların farkı olarak tanımlar ve genel doğrusal hipotez formülünü kullanır (364–375):
- \mathbf L: her sıradaki deneklerin (birinci dönem, referans tedavi düzeyinde) kestirilen ortalamalarının eşit ağırlıklı ortalaması alınarak kurulan sıra farkı karşıtlığı.
- (\mathbf X^{\top}\mathbf X)^{-}: kestirilebilen katsayılara indirgenmiş modelin ters matrisi; kodda
vcov(f) / KO_hata(satır 373). - Sıra etkisi denekler arası bir etkidir; bu yüzden \mathrm{KO}_{\text{hata}}'ya değil, denek(sıra) kareler ortalamasına bölünür.
Neden Tip III?
Her deneğin iki dönemi de varsa ardışık (Tip I) ve Tip III sıra kareler toplamı aynıdır. Bir deneğin bir dönemi eksikse Tip I, o deneğe yarım ağırlık verir; Tip III her deneği eşit ağırlıkla sayar. C-eksik veride Tip III 0,2649, ardışık toplam 0,5137'dir. GMR ve güven aralığı bu seçimden etkilenmez; fark yalnız sıra satırındadır.
15.4.9 Karma model seçeneği
model = karma seçilirse denek rastgele etki olur: lmer(ly ~ sira + dönem + tedavi + (1 | denek), REML = TRUE) (satır 343). Tedavi katsayısının standart hatası ve serbestlik derecesi Kenward–Roger yöntemiyle (Kenward ve Roger, 1997) hesaplanır (344):
- \hat{\boldsymbol\Phi}=(\mathbf X^{\top}\hat{\mathbf V}^{-1}\mathbf X)^{-1}; \mathbf V=\sigma_w^2\mathbf I+\sigma_s^2\mathbf Z\mathbf Z^{\top}; \mathbf P_i=-\mathbf X^{\top}\mathbf V^{-1}\mathbf G_i\mathbf V^{-1}\mathbf X, \mathbf Q_{ij}=\mathbf X^{\top}\mathbf V^{-1}\mathbf G_i\mathbf V^{-1}\mathbf G_j\mathbf V^{-1}\mathbf X, \mathbf G_i=\partial\mathbf V/\partial\sigma_i^2.
- \mathbf W: varyans bileşenlerinin REML kestirimlerinin asimptotik kovaryansı (beklenen bilginin tersi).
- \boldsymbol\ell: tedavi katsayısını seçen vektör; \operatorname{SH}=\sqrt{\boldsymbol\ell^{\top}\hat{\boldsymbol\Phi}_A\boldsymbol\ell}; tek serbestlik dereceli karşıtlıkta \nu yukarıdaki kapalı biçime iner.
Neden iki model?
Tam veride iki model aynı GMR'yi, aynı aralığı ve aynı serbestlik derecesini verir (veri seti A'da fark 10^{-10} düzeyindedir). Fark, bir dönemi eksik denek olduğunda çıkar: sabit etkili model o deneği tedavi karşılaştırmasının dışında bırakır; karma model, deneğin tek ölçümünü denekler arası bilgi olarak kullanır ve bunun karşılığında serbestlik derecesini veriden kestirir. C-eksik veride sabit etkili model GMR'yi %57,58 (sd 10), karma model %58,21 (sd 11,22) verir.
15.4.10 Güç ve örneklem büyüklüğü
2×2 tasarımda n denekle iki tek yönlü testin ikisinin de reddedilme olasılığı:
- \sigma_d=\sigma_w\sqrt{\tfrac12\big(\tfrac1{n_1}+\tfrac1{n_2}\big)}: tedavi farkının gerçek standart hatası; \sigma_w^2=\ln(\mathrm{CV}^2+1).
- \nu=n-2; t_c=t_{1-\alpha,\nu}; u=s/\sigma_w, yoğunluğu f_\nu(u) (\nu u^2\sim\chi^2_\nu); u_{\max}=(b-a)/(2t_c): bundan büyük u'da kabul bölgesi boştur.
- \theta_0: varsayılan gerçek oran. Gerekli n, gücü hedefe ulaştıran en küçük çift sayıdır.
Koddaki tercih
PowerTOST::power.TOST(…, design = "2x2") ve sampleN.TOST(…) (satır 412–415). Güç, gözlenen \mathrm{CV}_{\text{intra}} ve her iki tedavisi de olan deneklerin sıralara gerçek dağılımıyla (n_1, n_2; satır 389, 412–413) hesaplanır: \sigma_d=\sigma_w\sqrt{\tfrac12(1/n_1+1/n_2)}. Veri seti C'de sıralar 4 ve 9 deneklidir; güç 0,001415'tir (sıralar eşit sayılsaydı 0,002914). Gerekli n, aynı CV ve hedef güçle, dengeli tasarım için hesaplanır. "Planlama CV'si" sıfırdan büyükse tabloya o CV ile hesaplanan ek bir satır eklenir.
Gözlenen güç, çalışmanın başarısını açıklamaz
Tablodaki güç, biten çalışmanın \mathrm{CV}'si ile ama varsayılan \theta_0 ile hesaplanır; "bu CV ve bu örneklemle, gerçek oran \theta_0 olsaydı" sorusunu yanıtlar. Biyoeşdeğerlik kararı güven aralığıyla verilir; düşük gözlenen güç, sınırların içinde kalan bir aralığı geçersiz kılmaz.
15.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–176 | Üstbilgi: açıklama, örnek veri ve ayar, 19 parametre. | Form ve varsayılanlar (Bölüm 1.2). |
| 177–206 | Dil seçici .m; kip; rol sütunları; \alpha ve sınır denetimleri; uyarı toplayıcı sar; sayısal rollerin mq_sayisal, kimlik ve etken rollerinin mq_kimlik ile okunması; eksik satırların atılması. |
Değer ve zaman sütunu Veri sekmesindeki türünden bağımsız olarak değerleriyle okunur; sayı olmayan bir değer varsa çalıştırma sütunu bildiren iletiyle durur (Bölüm 1.5). |
| 207–234 | Konsantrasyon kipi: denetimler, hesap aralıkları (kısmi AUC için aucint.last), PKNCA seçenekleri, PKNCAconc → PKNCAdata → pk.nca. |
Gruplama: tedavi + dönem + sıra + denek (242). |
| 235–269 | Sonuçların geniş tabloya çevrilmesi, kısmi AUC'nin ve bitiş zamanının eklenmesi, sıralama, "NCA parametreleri" tablosu, kısmi AUC notu ve uyarıları, iki uyarı. | PKNCA'nın dışladığı sonuçlar atılır (246). |
| 270–293 | Tedaviye göre özet; biyoeşdeğerlik verisinin kurulması (AUC_{0-t}, AUC_{0-\infty}, C_{\max}). | Üç ölçüt de ayrı ayrı çözümlenir (300–303). |
| 294–305 | Profil grafiği. | Yarı logaritmik eksende sıfır konsantrasyonlar çizilmez (314). |
| 306–320 | PK kipi: pozitiflik denetimi, veri çerçevesi; test ve referans kodları, sıra ve dönem denetimleri. | Kodların başındaki ve sonundaki boşluk atılır (325). |
| 321–383 | Her ölçüt için model, tedavi katsayısı, Tip III tablosu, GMR, GA, CV, TOST. | Tedavi faktörünün düzeyleri (referans, test); katsayı test − referanstır (340). |
| 384–414 | Metin başlığı, iki tablo, güç ve örneklem büyüklüğü. | \theta_0 sınırların içinde olmalıdır (407). |
| 415–444 | GMR grafiği; PK kipinde denek başına referans–test grafiği; toplanan uyarılar. | Yeşil: sınırların içinde; turuncu: dışında (433). |
15.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/biyoesdegerlik_nca/elle_hesap.py ile hesaplanmıştır. Betik R'yi ve şablonun çağırdığı hiçbir işlevi kullanmaz: tedavi farkı dönem farklarından kapalı formülle, Tip III kareler toplamları numpy'nin sözde tersiyle, REML kendi Fisher puanlama yinelemesiyle, güç tek katlı sayısal integralle, NCA açık yamuk formülleriyle bulunur. R tarafında (r_dogrulama.R) dönem farklarına iki örneklem t testi, katmanlı varyans çözümlemesi, emmeans karşıtlıkları ve nlme::lme kullanılmış; PKNCA, PowerTOST ve lme4 yüklenmemiştir.
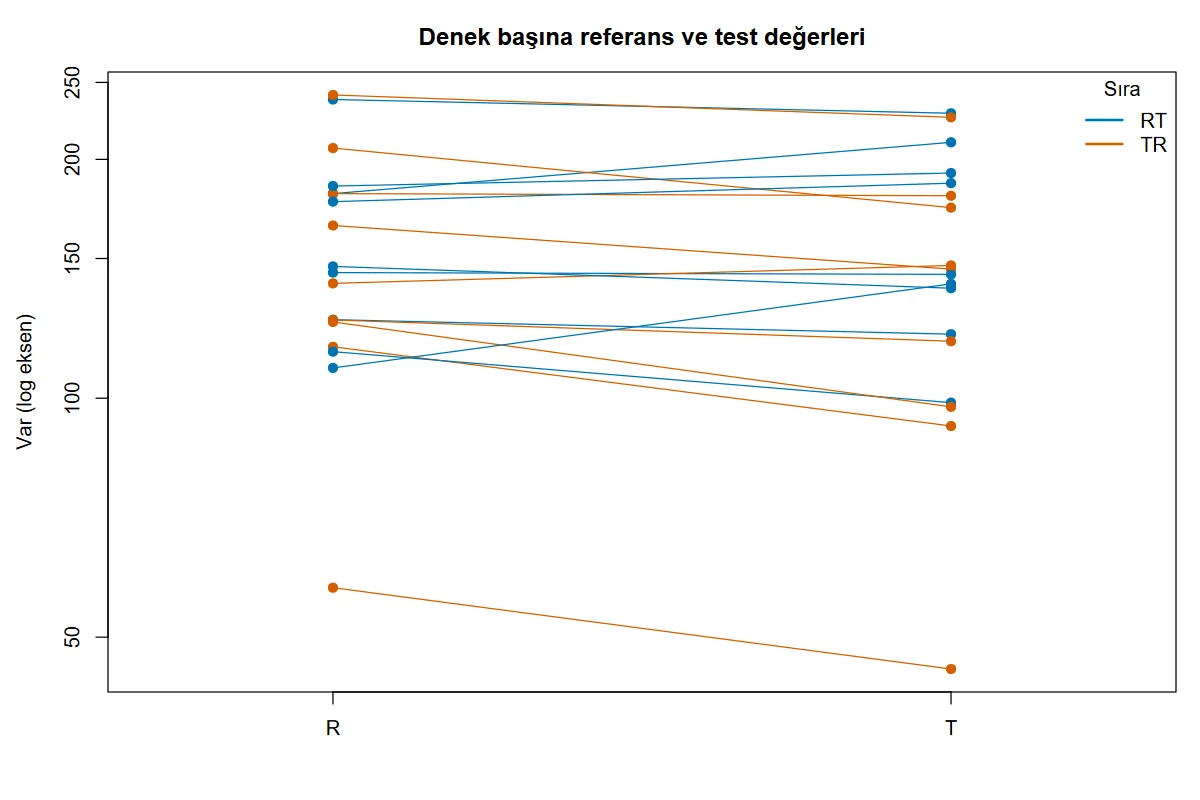
Adım 1 — Dönem farkları (veri seti A). Her denek için d_i=(\ln y_{i1}-\ln y_{i2})/2. TR sırasında (n=9): −0,0324; 0,0260; −0,1232; −0,1180; −0,1149; −0,0633; −0,0031; −0,0864; −0,0309. RT sırasında (n=9): −0,0744; 0,0741; −0,0268; 0,0316; −0,1219; 0,0211; 0,0200; 0,0026; −0,0189.
Adım 2 — Varyans ve standart hata. s_p^2=0{,}0031979 (sd 16):
Adım 3 — Oran ve aralık. t_{0{,}95;\,16}=1{,}745884:
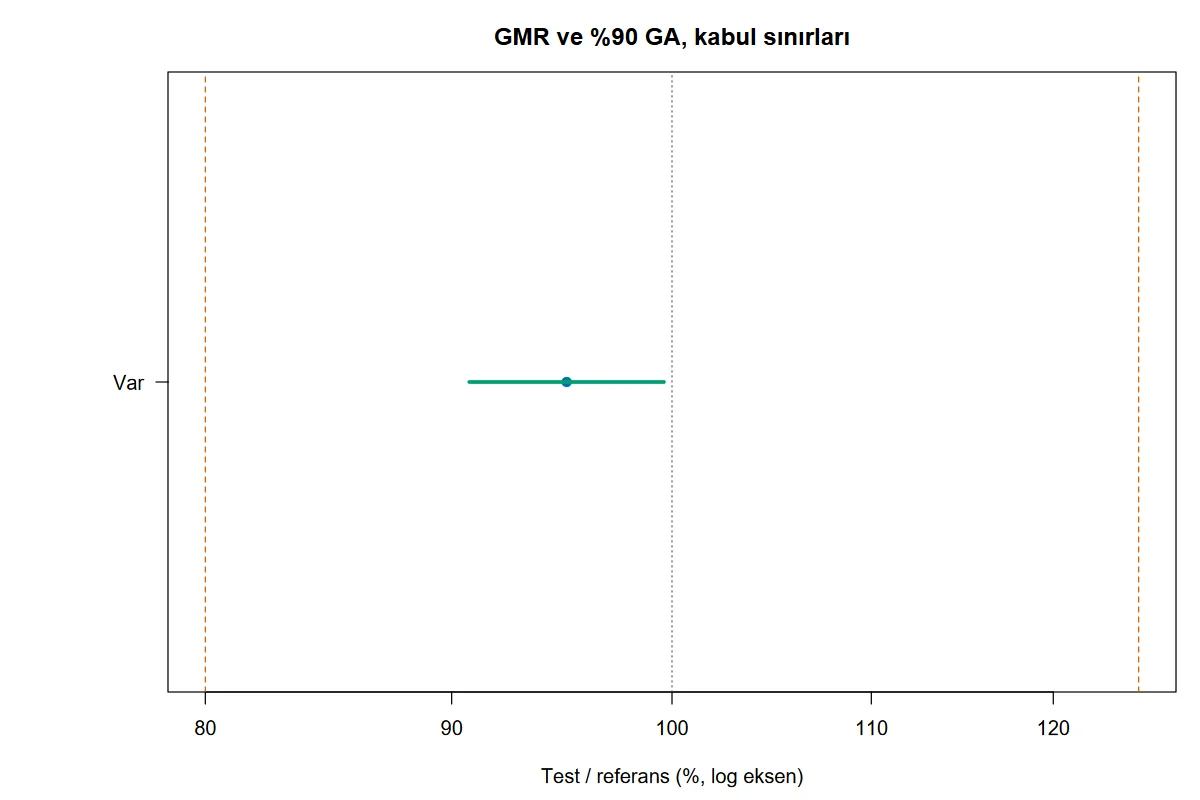
Yayımlanmış başvuru değerleri %95,09 ve %90,76–%99,62'dir (Schütz ve ark., 2014). \mathrm{CV}_{\text{intra}}=100\sqrt{e^{0{,}0063958}-1}=8{,}0102.
Adım 4 — İki tek yönlü test. t_1=(-0{,}050387-\ln 0{,}8)/0{,}026658=6{,}4805, p_1=3{,}79\cdot10^{-6}; t_2=(-0{,}050387-\ln 1{,}25)/0{,}026658=-10{,}2607, p_2<p_1. p_{\mathrm{TOST}}=3{,}79\cdot10^{-6}.
Adım 5 — Kareler toplamları. Tam ve dengeli veride tedavi kareler toplamı kapalı biçimlidir:
Öteki satırlar: sıra 0,218355 (sd 1), denek(sıra) 4,245386 (sd 16), dönem 0,045350 (sd 1), artık 0,102334 (sd 16). F_{\text{sıra}}=0{,}218355/(4{,}245386/16)=0{,}8229, p=0{,}3778. Dönem etkisi anlamlıdır (F=7{,}09, p=0{,}017); tasarım dönem etkisini tedavi farkından ayırdığı için bu, biyoeşdeğerlik sonucunu etkilemez.
Adım 6 — Güç. \mathrm{CV}=0{,}080102 için \sigma_w=\sqrt{\ln(1{,}006416)}=0{,}079974; n=18'de \sigma_d=0{,}079974/3=0{,}026658, \nu=16. İntegral 0,9999967 verir. Gerekli örneklem: n=4'te güç hedefin altında, n=6'da 0,914678 olduğundan 6. Planlama CV'si %30 ile: n=38'de güç 0,795328, n=40'ta 0,815845; gerekli n=40 (PowerTOST belgesindeki başvuru değeri: n=40, güç 0,815845).
Adım 7 — Bir dönemi eksik veri (C-eksik). Sabit etkili model: \hat\delta=-0{,}551995, SH 0,256358, sd 10; GMR %57,58 (%36,18–%91,63); Tip III \mathrm{KT}_{\text{sıra}}=0{,}264896, ardışık toplam 0,513748. Karma model (REML, 14 Fisher puanlama adımı): \hat\sigma_w^2=0{,}284552, \hat\sigma_s^2=0{,}068350, \hat\delta=-0{,}541066; model temelli SH 0,241772, Kenward–Roger düzeltmeli SH 0,244568, \nu=11{,}2238; GMR %58,21 (%37,55–%90,24).
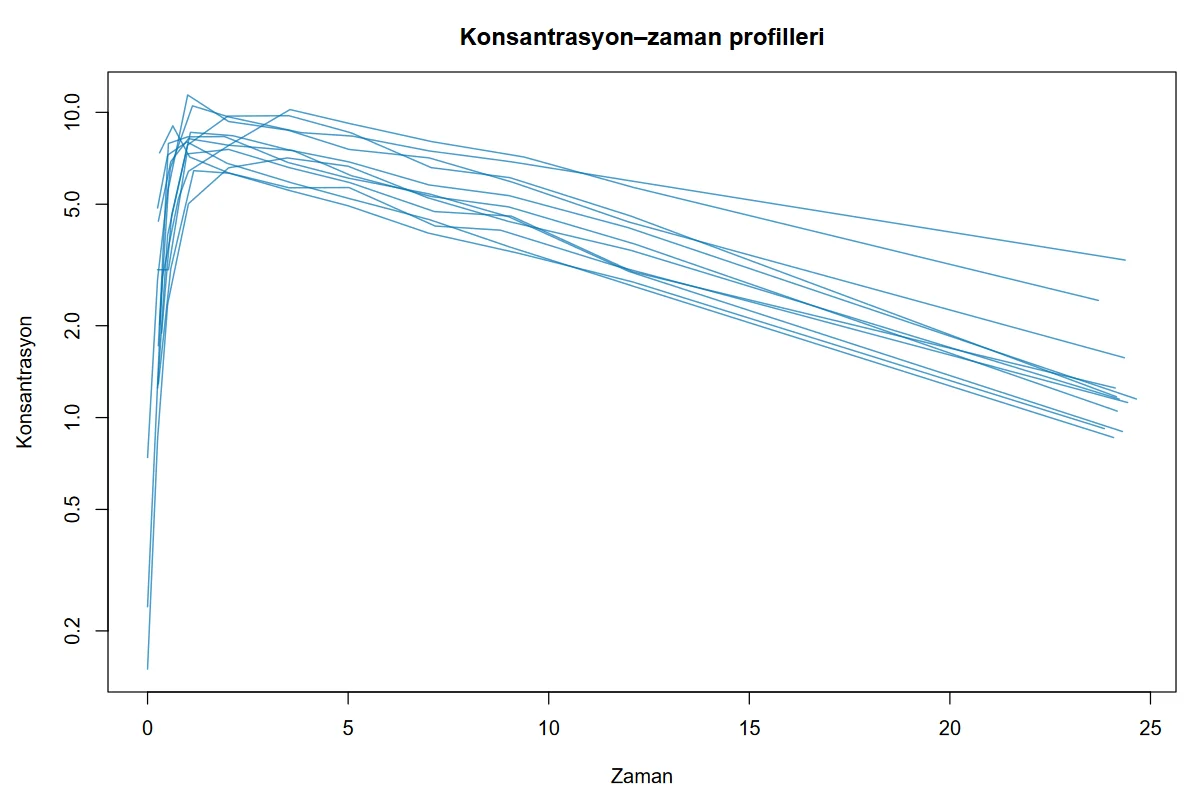
Adım 8 — NCA, 1 numaralı denek (teofilin). Ölçümler (saat; mg/L): (0; 0,74), (0,25; 2,84), (0,57; 6,57), (1,12; 10,50), (2,02; 9,66), (3,82; 8,58), (5,10; 8,36), (7,03; 7,47), (9,05; 6,89), (12,12; 5,94), (24,37; 3,28). C_{\max}=10{,}50, T_{\max}=1{,}12. İlk üç aralıkta konsantrasyon arttığı için doğrusal, sonraki yedi aralıkta logaritmik yamuk:
| Aralık | 0–0,25 | 0,25–0,57 | 0,57–1,12 | 1,12–2,02 | 2,02–3,82 | 3,82–5,10 | 5,10–7,03 | 7,03–9,05 | 9,05–12,12 | 12,12–24,37 |
|---|---|---|---|---|---|---|---|---|---|---|
| Alan | 0,4475 | 1,5056 | 4,6943 | 9,0667 | 16,3968 | 10,8410 | 15,2598 | 14,4957 | 19,6580 | 54,8693 |
Toplam \mathrm{AUC}_{0-t}=147{,}2347. Uç eğim adayları (C_{\max}'tan sonraki 7 noktanın son k tanesi):
| k | 3 | 4 | 5 | 6 | 7 |
|---|---|---|---|---|---|
| \lambda_z | 0,048457 | 0,047876 | 0,048174 | 0,047514 | 0,047786 |
| R^2_{\text{düz}} | 0,99999946 | 0,99941638 | 0,99942286 | 0,99841308 | 0,99856154 |
En iyi R^2_{\text{düz}} k=3'tedir ve hiçbir aday ona 0,0001'den yakın değildir; \lambda_z=0{,}048457 (PKNCA belgesindeki başvuru değeri 0,048457), t_{1/2}=\ln2/0{,}048457=14{,}3044 saat.
Tolerans kuralının etkisi 6 numaralı denekte görülür: en iyi R^2_{\text{düz}} 0,99792755 (k=3) iken k=7'nin değeri 0,99788960'tır; fark 0,0001'den küçük olduğundan yedi noktalı uyum seçilir (\lambda_z=0{,}087796).
15.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1–7).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| A: GMR (%) | 95,08615801 | 95,08615801 | 95,08615801 | 1,5e−16 | ✓ |
| A: %90 GA alt | 90,7620839 | 90,7620839 | 90,7620839 | 9,4e−16 | ✓ |
| A: %90 GA üst | 99,61623904 | 99,61623904 | 99,61623904 | 5,7e−16 | ✓ |
| A: denek içi DK (%) | 8,01020799 | 8,01020799 | 8,01020799 | 2,2e−16 | ✓ |
| A: p_{\mathrm{TOST}} | 3,794049·10−6 | 3,794049·10−6 | 3,794049·10−6 | 1,0e−20 | ✓ |
| A: KT sıra (Tip III) | 0,21835532 | 0,21835532 | 0,21835532 | 3,1e−16 | ✓ |
| A: KT denek(sıra) | 4,24538621 | 4,24538621 | 4,24538621 | 8,4e−16 | ✓ |
| A: KT dönem | 0,04534967 | 0,04534967 | 0,04534967 | 1,2e−16 | ✓ |
| A: KT tedavi | 0,02284945 | 0,02284945 | 0,02284945 | 4,1e−16 | ✓ |
| A: KT artık | 0,10233354 | 0,10233354 | 0,10233354 | 5,8e−16 | ✓ |
| A: F sıra | 0,82293692 | 0,82293692 | 0,82293692 | 3,3e−15 | ✓ |
| A: p sıra | 0,37778316 | 0,37778316 | 0,37778316 | 1,2e−15 | ✓ |
| A: F denek(sıra) | 41,48577588 | 41,48577588 | 41,48577588 | 5,3e−15 | ✓ |
| A: F dönem | 7,09048809 | 7,09048809 | 7,09048809 | 5,1e−15 | ✓ |
| A: p dönem | 0,01701883 | 0,01701883 | 0,01701883 | 2,8e−16 | ✓ |
| A: F tedavi | 3,57254491 | 3,57254491 | 3,57254491 | 2,5e−14 | ✓ |
| A: p tedavi | 0,07699753 | 0,07699753 | 0,07699753 | 3,4e−15 | ✓ |
| A: güç (n=18, gözlenen DK) | 0,99999669 | 0,99999669 | 0,99999669 | 4,9e−14 | ✓ |
| A: gerekli n | 6 | 6 | 6 | 0 | ✓ |
| A: gerekli n'de güç | 0,91467835 | 0,91467835 | 0,91467835 | 3,6e−13 | ✓ |
| Planlama DK %30: gerekli n | 40 | 40 | 40 | 0 | ✓ |
| Planlama DK %30: güç | 0,81584528 | 0,81584528 | 0,81584528 | 5,7e−14 | ✓ |
| A, karma model: GMR (%) | 95,08615801 | 95,08615801 | — | 4,5e−16 | ✓ |
| A, karma model: %90 GA alt | 90,76208391 | 90,7620839 | — | 9,4e−11 | ✓ |
| A, karma model: sd (Kenward–Roger) | 16 | 16 | — | 0 | ✓ |
| C: GMR (%) | 58,56293376 | 58,56293376 | 58,56293376 | 0 | ✓ |
| C: %90 GA alt | 39,40787608 | 39,40787608 | 39,40787608 | 8,2e−14 | ✓ |
| C: %90 GA üst | 87,02872501 | 87,02872501 | 87,02872501 | 8,2e−14 | ✓ |
| C: denek içi DK (%) | 55,61288274 | 55,61288274 | 55,61288274 | 2,6e−16 | ✓ |
| C: KT sıra (Tip III) | 0,37310331 | 0,37310331 | 0,37310331 | 2,2e−15 | ✓ |
| C: F sıra | 0,92018135 | 0,92018135 | 0,92018135 | 5,9e−15 | ✓ |
| C: KT tedavi | 1,58565046 | 1,58565046 | 1,58565046 | 2,0e−15 | ✓ |
| C: güç (n=13; sıralar 4 ve 9) | 0,00141539 | 0,00141539 | 0,00141539 | 2,5e−14 | ✓ |
| C: gerekli n | 118 | 118 | 118 | 0 | ✓ |
| C-eksik: GMR (%) | 57,58000087 | 57,58000087 | 57,58000087 | 1,4e−15 | ✓ |
| C-eksik: %90 GA alt | 36,18109769 | 36,18109769 | 36,18109769 | 2,4e−13 | ✓ |
| C-eksik: %90 GA üst | 91,63504459 | 91,63504459 | 91,63504459 | 2,4e−13 | ✓ |
| C-eksik: denek içi DK (%) | 58,66143757 | 58,66143757 | 58,66143757 | 1,2e−15 | ✓ |
| C-eksik: KT sıra (Tip III) | 0,26489599 | 0,26489599 | 0,26489599 | 1,8e−15 | ✓ |
| C-eksik: KT denek(sıra) | 4,46646886 | 4,46646886 | — | 8,0e−16 | ✓ |
| C-eksik: KT dönem | 0,57815062 | 0,57815062 | 0,57815062 | 1,4e−15 | ✓ |
| C-eksik: KT tedavi | 1,37114259 | 1,37114259 | 1,37114259 | 1,1e−15 | ✓ |
| C-eksik: F sıra | 0,65238469 | 0,65238469 | — | 3,0e−15 | ✓ |
| C-eksik: p sıra | 0,43637972 | 0,43637972 | — | 6,7e−16 | ✓ |
| C-eksik, karma: GMR (%) | 58,21272741 | 58,21272741 | 58,21272748 | 1,2e−9 | ✓ |
| C-eksik, karma: denek içi DK (%) | 57,37297329 | 57,37297324 | 57,37297629 | 5,2e−8 | ✓ |
| C-eksik, karma: sd (Kenward–Roger) | 11,22376346 | 11,22376345 | — | 1,3e−10 | ✓ |
| C-eksik, karma: %90 GA alt | 37,55055913 | 37,55055914 | — | 2,8e−10 | ✓ |
| C-eksik, karma: %90 GA üst | 90,244239 | 90,24423897 | — | 3,2e−10 | ✓ |
| C-eksik, karma: p_{\mathrm{TOST}} | 0,89015727 | 0,89015727 | — | 1,6e−10 | ✓ |
| NCA denek 1: AUC_{0-t} | 147,23474854 | 147,23474854 | 147,23474854 | 1,5e−15 | ✓ |
| NCA denek 1: \lambda_z | 0,048457 | 0,048457 | 0,048457 | 1,6e−16 | ✓ |
| NCA denek 1: \lambda_z nokta sayısı | 3 | 3 | 3 | 0 | ✓ |
| NCA denek 1: düzeltilmiş R^2 | 0,99999946 | 0,99999946 | 0,99999946 | 3,3e−16 | ✓ |
| NCA denek 1: t_{1/2} | 14,30437757 | 14,30437757 | 14,30437757 | 2,0e−15 | ✓ |
| NCA denek 1: AUC_{0-\infty} | 214,92363158 | 214,92363158 | 214,92363158 | 2,2e−15 | ✓ |
| NCA denek 1: AUC%ext | 31,49438828 | 31,49438828 | 31,49438828 | 1,2e−15 | ✓ |
| NCA denek 1: AUC(0–24) | 146,01019889 | 146,01019889 | 146,01019889 | 1,4e−15 | ✓ |
| NCA denek 6: AUC_{0-t} | 71,69701499 | 71,69701499 | 71,69701499 | 5,9e−16 | ✓ |
| NCA denek 6: \lambda_z | 0,08779574 | 0,08779574 | 0,08779574 | 9,7e−17 | ✓ |
| NCA denek 6: \lambda_z nokta sayısı | 7 | 7 | 7 | 0 | ✓ |
| NCA denek 6: düzeltilmiş R^2 | 0,9978896 | 0,9978896 | 0,9978896 | 3,3e−16 | ✓ |
| NCA denek 6: t_{1/2} | 7,89499787 | 7,89499787 | 7,89499787 | 2,2e−16 | ✓ |
| NCA denek 6: AUC_{0-\infty} | 82,17588332 | 82,17588332 | 82,17588332 | 3,5e−16 | ✓ |
| NCA denek 6: AUC%ext | 12,75175624 | 12,75175624 | 12,75175624 | 1,5e−15 | ✓ |
| NCA denek 6: AUC(0–24) | 71,69701499 | 71,69701499 | 71,69701499 | 5,9e−16 | ✓ |
| NCA denek 1: AUC_{0-t} (doğrusal kural) | 148,92305 | 148,92305 | 148,92305 | 0 | ✓ |
| NCA özet: AUC_{0-t} geometrik ortalama | 98,65049174 | 98,65049174 | 98,65049174 | 2,9e−16 | ✓ |
| NCA özet: AUC_{0-t} geometrik DK (%) | 22,53781637 | 22,53781637 | 22,53781637 | 9,5e−16 | ✓ |
| NCA özet: AUC_{0-\infty} geometrik ortalama | 114,8140479 | 114,8140479 | 114,8140479 | 5,1e−15 | ✓ |
| NCA özet: AUC_{0-\infty} geometrik DK (%) | 28,42569434 | 28,42569434 | 28,42569434 | 1,5e−15 | ✓ |
| NCA özet: C_{\max} geometrik ortalama | 8,64621679 | 8,64621679 | 8,64621679 | 4,1e−16 | ✓ |
| NCA özet: C_{\max} geometrik DK (%) | 16,97776054 | 16,97776054 | 16,97776054 | 2,1e−16 | ✓ |
| NCA özet: T_{\max} ortanca | 1,135 | 1,135 | 1,135 | 0 | ✓ |
| NCA özet: t_{1/2} ortalama | 8,18047338 | 8,18047338 | 8,18047338 | 1,3e−15 | ✓ |
| NCA özet: t_{1/2} SS | 2,11505926 | 2,11505926 | 2,11505926 | 5,2e−15 | ✓ |
| NCA özet: AUC_{0-t} geometrik ortalama (doğrusal kural) | 101,48234745 | 101,48234745 | 101,48234745 | 2,8e−15 | ✓ |
Ölçütü karşılayan: 77/77. Python: dönem farkı yöntemi (kapalı formül), sözde tersli en küçük kareler ve kestirilebilir işlevle Tip III kareler toplamı, kendi Fisher puanlamasıyla REML ve Kenward–Roger formülleri, tek katlı integralle TOST gücü, açık yamuk kuralı ve \lambda_z seçimi. R: dönem farklarında t.test, katmanlı aov(… + Error(denek)), emmeans karşıtlıkları, nlme::lme (REML), integrate ve açık formüller; PKNCA, PowerTOST ve lme4 yüklenmemiştir. A: veri seti A; C: veri seti C; C-eksik: bir deneğin bir dönemi eksik.
Sabit etkili modelin bütün büyüklükleri kapalı biçimli olduğundan üç yol makine hassasiyetinde örtüşür. Karma modelde fark (\le10^{-8}) REML yinelemelerinin yakınsama toleransından gelir.
15.7 Çıktıyı okuma
Örnek ayarın metin çıktısı tek satırdır:
Ortalama biyoeşdeğerlik: test = T, referans = R; log ölçekte sabit etkili ANOVA (EMA yöntemi A); %90 GA, kabul sınırları %80–%125
"Ortalama biyoeşdeğerlik: geometrik ortalama oranı (test/referans) ve %90 GA" tablosu:
| metrik | n | GMR_yuzde | GA_alt_yuzde | GA_ust_yuzde | CV_intra_yuzde | sd | p_TOST | karar |
|---|---|---|---|---|---|---|---|---|
| Var | 18 | 95,0862 | 90,7621 | 99,6162 | 8,0102 | 16 | 3{,}79\cdot10^{-6} | biyoeşdeğer |
"ANOVA (log ölçek; Tip III kareler toplamı; …)" tablosu:
| kaynak | sd | KT | KO | F | p |
|---|---|---|---|---|---|
| sira | 1 | 0,218355 | 0,218355 | 0,8229 | 0,3778 |
| denek | 16 | 4,245386 | 0,265337 | 41,4858 | 5{,}2\cdot10^{-10} |
| donem | 1 | 0,045350 | 0,045350 | 7,0905 | 0,0170 |
| tedavi | 1 | 0,022849 | 0,022849 | 3,5725 | 0,0770 |
| Residuals | 16 | 0,102334 | 0,006396 |
"Güç ve örneklem büyüklüğü (PowerTOST, 2×2, …)" tablosu (çalıştırma 2; ikinci satır planlama CV'si 0,30 ile):
| metrik | CV_yuzde | theta0 | n_gozlenen | guc | n_gerekli | ulasilan_guc |
|---|---|---|---|---|---|---|
| Var | 8,0102 | 0,95 | 18 | 0,999997 | 6 | 0,914678 |
| planlama | 30 | 0,95 | 40 | 0,815845 |
Konsantrasyon kipinin (çalıştırma 6) metin çıktısı ve özet tablosu:
Kompartımansız analiz (PKNCA): 12 profil, 12 denek; AUC kuralı: lin up/log down; λz: en az 3 nokta, en iyi düzeltilmiş R²
Uyarı: 1 profilde AUC%ext > %20; AUC0–∞ güvenilir değil.
Not: sıra, dönem ve tedavi sütunları verilmediği için yalnız NCA yapıldı (biyoeşdeğerlik yok).
| parametre | istatistik | n | deger | yayilim_1 | yayilim_2 |
|---|---|---|---|---|---|
| AUC0_t | geometrik ortalama [geometrik DK %] | 12 | 98,6505 | 22,5378 | |
| AUC0_inf | geometrik ortalama [geometrik DK %] | 12 | 114,8140 | 28,4257 | |
| Cmax | geometrik ortalama [geometrik DK %] | 12 | 8,6462 | 16,9778 | |
| Tmax | ortanca [en küçük, en büyük] | 12 | 1,135 | 0,63 | 3,55 |
| t_yari | ortalama [SS] | 12 | 8,1805 | 2,1151 |
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
n |
Her iki tedavisi de olan denek sayısı | Güç hesabına bu deneklerin sıralara dağılımı girer. |
GMR_yuzde, GA |
Test / referans geometrik ortalama oranı ve 100(1-2\alpha) güven aralığı | Aralık kabul sınırlarının içindeyse biyoeşdeğerlik gösterilmiştir. |
CV_intra_yuzde |
Denek içi değişim katsayısı | Bir sonraki çalışmanın örneklem büyüklüğünü belirleyen büyüklük. |
sd |
t dağılımının serbestlik derecesi | Karma modelde tam sayı olmayabilir (Kenward–Roger). |
p_TOST |
İki tek yönlü p'nin büyüğü | \le\alpha ise karar "biyoeşdeğer". |
ANOVA: sira |
Tip III KT; F denek(sıra)'ya karşı | Anlamlı sıra etkisi taşınma etkisine ya da rastgele atamada dengesizliğe işaret edebilir; 2×2 tasarımda ikisi ayrılamaz. |
ANOVA: denek |
Denek(sıra) | Büyük F, deneklerin birbirinden çok farklı olduğunu gösterir; çapraz tasarımın gerekçesidir. |
ANOVA: tedavi |
H_0:\tau_T=\tau_R | Fark testidir, eşdeğerlik testi değildir; karar için kullanılmaz. |
guc, n_gerekli |
Gözlenen CV'de güç; hedef güç için toplam denek | Kayıp payı ayrıca eklenmelidir. |
| NCA tablosu | Profil başına 11 parametre (+ kısmi AUC) | lz_nokta ve lz_adj_R2 uç eğimin dayanağıdır; AUC_ext_yuzde > 20 ise AUC_{0-\infty}'a güvenilmez. |
| NCA özeti | deger, yayilim_1, yayilim_2 |
Sütunların anlamı istatistik sütununda yazar; satırdan satıra değişir. |
Şekil 15.1. Geometrik ortalama oranı ve %90 güven aralığı (veri seti A). Kesikli çizgiler kabul sınırlarıdır (%80 ve %125); aralık sınırların içinde olduğundan yeşil çizilir. Yatay eksen logaritmiktir.
Şekil 15.2. Denek başına referans ve test değerleri (PK kipi). Her doğru bir deneği gösterir; renk sırayı ayırır. Doğruların yaklaşık paralel olması, denekler arası farkın büyük, denek içi farkın küçük olduğunu gösterir.
Şekil 15.3. Teofilin verisinde konsantrasyon–zaman profilleri (konsantrasyon kipi, yarı logaritmik eksen). Uç evrede profillerin doğrusallaşması, \lambda_z'nin log-doğrusal regresyonla kestirilmesinin dayanağıdır.
Rapor cümlesi:
Biyoeşdeğerlik, log dönüştürülmüş değerlerde sıra, sıra içinde denek, dönem ve tedavi etkilerini içeren sabit etkili doğrusal modelle değerlendirildi (n = 18). Test/referans geometrik ortalama oranı %95,09 (%90 GA: %90,76–%99,62) bulundu; aralık %80,00–%125,00 kabul sınırlarının içindeydi. Denek içi değişim katsayısı %8,01 idi.
15.8 Sık hatalar ve tuzaklar
- Değer ya da zaman sütununda sayı olmayan hücre bırakmak. Şablon bu sütunları değerleriyle okur (satır 207–208); Veri sekmesindeki tür "kategorik" olsa da sonuç değişmez. Sütunda sayıya çevrilemeyen bir hücre ("<LOQ", "1,5" gibi ondalık virgüllü metin) varsa çalıştırma, sütunun adını ve örnek değerleri yazan iletiyle durur. Ölçüm sınırının altındaki değerler veri hazırlanırken sayıya (çoğunlukla 0) çevrilmeli ya da boş bırakılmalıdır.
- Tedavi fark testini eşdeğerlik kanıtı saymak. ANOVA'daki tedavi p'si büyük diye ürünler eşdeğer olmaz; küçük diye eşdeğerlik reddedilmez. Veri seti A'da p=0{,}077'dir ve ürünler biyoeşdeğerdir; büyük örneklemde p<0{,}05 ile birlikte dar ve sınırların içinde bir aralık da mümkündür.
- Test ve referans kodlarını ters yazmak. Oran test / referanstır; kodlar yer değiştirirse GMR'nin tersi (100²/GMR) ve aralığın tersi çıkar. Sınırlar log ölçekte simetrik olduğundan karar değişmez, ama raporlanan oran yanlış yönü gösterir.
- Son ölçümü \tau'dan önce olan profilde kısmi AUC'yi AUC(0–τ) sanmak. Bu profillerde alan son ölçüme kadardır (15.4.3);
kismi_auc_bitissütunu \tau'dan küçükse değer başka bir pencereyi ölçer. Şablon bu profillerin sayısını uyarı olarak yazar. - AUC%ext büyükken AUC_{0-\infty}'u çözümlemek. Konsantrasyon kipinde biyoeşdeğerlik AUC_{0-t}, AUC_{0-\infty} ve C_{\max} için ayrı ayrı yapılır; dışdeğerleme payı yüksek profiller AUC_{0-\infty} satırına olduğu gibi girer. Şablon yalnız sayıyı bildirir.
- Gözlenen gücü yalnız toplam n ile yeniden hesaplamaya çalışmak. Güç, her iki tedavisi olan deneklerin sıralara dağılımıyla hesaplanır. Veri seti C'de sıralar 4 ve 9 deneklidir; toplam 13 denek eşit bölünmüş sayılırsa (7 ve 6) güç 0,002914, gerçek dağılımla 0,001415 çıkar.
- Karar sınırını yuvarlanmış değerle karşılaştırmak. Şablon güven sınırlarını yuvarlamadan karşılaştırır. Düzenleyici kurumlar sınırları iki ondalığa yuvarlayıp %80,00–%125,00 ile karşılaştırır; sınıra çok yakın (ör. %79,996) bir alt sınırda iki kural farklı karar verebilir.
- Bir dönemi eksik deneği "kullanıldı" sanmak. Sabit etkili modelde o denek ANOVA tablosuna girer ama tedavi farkına katkı vermez;
ntam verili denek sayısıdır.
15.9 Uzman soruları
S1. Sabit etkili model ile karma model ne zaman farklı sonuç verir?
Yalnız bir dönemi eksik denek olduğunda. Tam veride denek içi karşıtlık iki modelde de aynıdır ve REML kestirimi ANOVA kestirimine eşittir; veri seti A'da iki modelin GMR'si ve aralığı 10^{-10} içinde aynıdır. Eksik dönemde karma model, tek ölçümlü deneğin bilgisini denekler arası varyansla ağırlıklandırarak kullanır. C-eksik veride GMR %57,58'den %58,21'e, serbestlik derecesi 10'dan 11,22'ye değişir. Hangi modelin kullanılacağı çalışma protokolünde önceden yazılmalıdır.
S2. Tip III sıra kareler toplamı nasıl tanımlanıyor ve neden denek(sıra)'ya bölünüyor?
Sıra etkisi, her sıradaki deneklerin kestirilen ortalamalarının eşit ağırlıklı ortalamaları arasındaki farktır; kareler toplamı bu karşıtlığın genel doğrusal hipotez formülüdür (satır 364–375). Sıra, deneklere atanan bir etkidir: aynı sıradaki denekler onun tekrarlarıdır. Bu yüzden doğru hata terimi denekler arası değişkenliktir, yani denek(sıra) kareler ortalaması. Veri seti A'da F=0{,}218355/0{,}265337=0{,}823, sd (1, 16). Katmanlı varyans çözümlemesi (denek hata katmanı) aynı değeri verir (15.6.1).
S3. Güven aralığı neden log ölçekte kurulup geri dönüştürülüyor?
AUC ve C_{\max} çarpımsal modele uyar; log ölçekte tedavi etkisi toplamsal, hatalar yaklaşık normal ve varyans sabittir. \hat\delta'nın t aralığı log ölçekte simetriktir; üstel dönüşüm onu oran ölçeğinde asimetrik bir aralığa çevirir (95,09'un altında 4,32, üstünde 4,53 puan). Geri dönüşümde yanlılık düzeltmesi yapılmaz, çünkü kestirilen büyüklük geometrik ortalamaların oranıdır, aritmetik ortalamaların değil.
S4. p_TOST neden iki p'nin büyüğü?
Eşdeğerlik, iki yokluk hipotezinin ikisinin de reddedilmesini gerektirir (kesişim–birleşim testi). Birleşik testin p değeri, bileşen testlerin p değerlerinin en büyüğüdür; çoklu test düzeltmesi gerekmez, çünkü her iki koşul birlikte aranır. p_{\mathrm{TOST}}\le\alpha ile 100(1-2\alpha) aralığının sınırların içinde kalması aynı olaydır.
S5. Güç hesabı yaklaşık mı, kesin mi?
Kesindir. İki tek yönlü test istatistiği aynı \hat\delta ve aynı s'yi paylaşır; ortak dağılımları korelasyonu 1 olan iki değişkenli merkezî olmayan t'dir. PowerTOST bu olasılığı Owen'ın Q işleviyle hesaplar (Owen, 1965). Bağımsız hesapta aynı olasılık, s/\sigma_w üzerinde tek katlı integral olarak yazılmış ve sayısal olarak alınmıştır; iki sonuç 10^{-10} içinde aynıdır (15.6.1).
S6. λz seçiminde neden en iyi düzeltilmiş R² doğrudan alınmıyor?
"En iyi" uyum çoğu zaman en az noktayla elde edilir ve üç noktaya dayanan bir eğim kararsızdır. Tolerans kuralı, en iyiden en çok 0,0001 düşük olan adaylar arasından en çok noktalı olanı seçer. 6 numaralı denekte üç noktalı uyumun R^2_{\text{düz}}'si 0,99793, yedi noktalınınki 0,99789'dur; yedi noktalı uyum seçilir ve \lambda_z 0,09158 yerine 0,08780 olur. Tolerans sıfır yapılırsa her zaman en iyi R^2_{\text{düz}} seçilir.
S7. Gözlenen son konsantrasyon yerine regresyonun kestirdiği değer kullanılsaydı ne değişirdi?
\mathrm{AUC}_{0-\infty}'un dışdeğerleme terimi C_{\text{last}}/\lambda_z yerine \hat C_{\text{last}}/\lambda_z olurdu. Son ölçüm ölçüm sınırına yakın ve gürültülüyse kestirilen değer daha kararlıdır; düzenleyici yönergelerin çoğu ise gözlenen değeri ister. Şablon gözlenen değeri kullanır (aucinf.obs; satır 231–232) ve öteki tanımı üretmez.
S8. Sıra etkisi anlamlı çıkarsa çözümleme geçersiz mi?
2×2 tasarımda sıra etkisi, taşınma etkisi farkı ve tedavi × dönem etkileşimiyle tümüyle karışıktır; verinin kendisinden ayrılamazlar. Anlamlı bir sıra etkisi tek başına çözümlemeyi geçersiz kılmaz; arınma süresinin yeterliliği (ikinci dönem öncesi konsantrasyonların ölçüm sınırının altında olması) tasarım ve veri düzeyinde gösterilir. Sıra testine dayanarak yalnız birinci dönemi çözümleyen iki aşamalı yordam önerilmez (Senn, 2002).
S9. Tedavi sütununda ikiden çok kod varsa ne olur?
Yalnız test ve referans kodlu gözlemler tutulur ve bir not yazılır (satır 329). Model yine 2×2 çözümlemesidir; üçüncü tedavinin bulunduğu dönemler atıldığı için bazı deneklerin yalnız bir gözlemi kalabilir ve bunlar tedavi farkına katkı vermez. Üç tedavili bir çapraz tasarım bütün veriyle çözümlenecekse capraz_gecis şablonu kullanılır.
15.10 Kaynaklar
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Chow, S.-C., & Liu, J.-P. (2008). Design and analysis of bioavailability and bioequivalence studies (3. baskı). Chapman and Hall/CRC. https://doi.org/10.1201/9781420011678
- Denney, W., Duvvuri, S., & Buckeridge, C. (2015). Simple, automatic noncompartmental analysis: The PKNCA R package. Journal of Pharmacokinetics and Pharmacodynamics, 42(S1), 11–107, S65. https://doi.org/10.1007/s10928-015-9432-2
- European Medicines Agency. (2010). Guideline on the investigation of bioequivalence (CPMP/EWP/QWP/1401/98 Rev. 1/Corr).
- Gabrielsson, J., & Weiner, D. (2012). Non-compartmental analysis. Methods in Molecular Biology (s. 377–389). Humana Press. https://doi.org/10.1007/978-1-62703-050-2_16
- Halekoh, U., & Højsgaard, S. (2014). A Kenward-Roger approximation and parametric bootstrap methods for tests in linear mixed models: The R package pbkrtest. Journal of Statistical Software, 59(9). https://doi.org/10.18637/jss.v059.i09
- Kenward, M. G., & Roger, J. H. (1997). Small sample inference for fixed effects from restricted maximum likelihood. Biometrics, 53(3), 983–997. https://doi.org/10.2307/2533558
- Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- Labes, D., Schütz, H., & Lang, B. (2025). PowerTOST: Power and sample size for (bio)equivalence studies (R paketi, sürüm 1.5-7). https://doi.org/10.32614/CRAN.package.PowerTOST
- Owen, D. B. (1965). A special case of a bivariate non-central t-distribution. Biometrika, 52(3–4), 437–446. https://doi.org/10.1093/biomet/52.3-4.437
- Schuirmann, D. J. (1987). A comparison of the two one-sided tests procedure and the power approach for assessing the equivalence of average bioavailability. Journal of Pharmacokinetics and Biopharmaceutics, 15(6), 657–680. https://doi.org/10.1007/BF01068419
- Schütz, H., Labes, D., & Fuglsang, A. (2014). Reference datasets for 2-treatment, 2-sequence, 2-period bioequivalence studies. The AAPS Journal, 16(6), 1292–1297. https://doi.org/10.1208/s12248-014-9661-0
- Senn, S. (2002). Cross-over trials in clinical research (2. baskı). Wiley. https://doi.org/10.1002/0470854596