36. Kesin koşullu lojistik regresyon (kesin p, orta-p, kesin GA, ortanca yansız kestirim)
Şablon kimliği: kesin_lojistik · Kategori: model · Dil: R · Dosya: pro/sablonlar/model/kesin_lojistik.R (satır 1–250; üstbilgi 1–81) · Örnek veri: _ornek/penisilin_tavsan.csv · Paketler: yok (taban R)
36.1 Ne işe yarar
Lojistik regresyonun bilinen testleri (Wald, olabilirlik oranı) büyük örneklem yaklaşımıdır: az gözlemde, seyrek hücrelerde ya da bir grupta bütün yanıtlar aynı olduğunda (ayrışma) yanıltıcıdır, hatta kestirim sonsuza gider. Bu şablon aynı modeli yaklaşım kullanmadan çözümler. Cevapladığı soru: "Kesişimi (ya da tabaka etkilerini) ve öteki ortak değişkenleri hesaptan tam olarak çıkardığımda, bu ortak değişkenin etkisi için kesin p değeri, kestirim ve güven aralığı nedir?"
- \alpha_{s(i)}: gözlemin tabakasının kesişimi; tabaka seçilmemişse tek bir kesişim. \beta: sınanan ortak değişkenin katsayısı (log odds oranı). \boldsymbol\gamma: koşullanan, sınanmayan ortak değişkenlerin katsayıları.
- T: \beta'nın yeterli istatistiği; olay görülen birimlerin x değerlerinin toplamı. Gruplu veride y_i satırdaki olay sayısıdır.
- \mathbf S: öteki parametrelerin yeterli istatistikleri: tabaka başına olay sayıları ve \sum_i y_i\mathbf z_i. Bunlar gözlenen değerlerinde sabit tutulur (Cox ve Snell 1989).
- c(t): tabaka olay sayıları ve \sum y\mathbf z gözlenen değerlerine eşit kalırken T=t veren yanıt dizilimlerinin sayısı. Sağdaki olasılık \alpha ve \boldsymbol\gamma'yı içermez; çıkarım yalnız \beta'ya bağlı bu dağılımdan yapılır.
Ne zaman kullanılır? Küçük klinik ya da hayvan denemelerinde; olayın seyrek olduğu tablolarda; bir grupta bütün yanıtlar aynı olduğu için sıradan lojistik regresyonun katsayıyı sonsuza götürdüğü durumda; çok sayıda küçük tabakada (merkez, doz düzeyi, eşleştirilmiş küme) ortak bir odds oranı istendiğinde.
Ne zaman kullanılmaz?
- Örneklem büyük ve hücreler doluysa: temel programdaki Lojistik Regresyon aynı sonucu çok daha hızlı verir; kesin dağılımın durum sayısı büyük veride sınırı aşar ve şablon durur.
- Ayrışma var ama kesin yöntem için veri büyükse ya da sürekli ortak değişkenler varsa: cezalı olabilirlik (Firth) ayrı bir yöntemdir ve temel programdaki Lojistik Regresyon analizinin seçeneğidir.
- Yalnız tek bir 2×2 tablo varsa: temel programdaki Fisher Exact Testi yeterlidir; bu şablonun tabakasız çalıştırması aynı p değerini verir (36.6).
- Tabakalı 2×2 tablolarda büyük örneklem testi isteniyorsa: temel programdaki Cochran-Mantel-Haenszel Testi.
- Birden çok parametrenin birlikte (ortak) sınanması, sayım (Poisson) ya da sıralı yanıt: şablon bunları kapsamaz; her ortak değişken ayrı ayrı sınanır.
Temel programla ilişki. Temel programın Lojistik Regresyon analizi koşulsuz en çok olabilirlikle çalışır ve tabaka etkilerini parametre olarak kestirir. Bu şablon tabaka etkilerini kestirmez, koşullayarak yok eder; testleri ve aralıkları asimptotik dağılımdan değil, T'nin sayılarak bulunan koşullu dağılımından alır. Tek ikili ortak değişkenli tabakasız durumda sonuç Fisher kesin testine, tabakalı durumda kesin Mantel–Haenszel çözümlemesine (Mantel ve Haenszel 1959) indirgenir; yöntemin genel biçimi ve örnekleri için Mehta ve Patel'e (1995) bakılabilir.
36.2 Şablonun girdileri
Form on [[param]] bloğundan kurulur (kesin_lojistik.R:10–80).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Yanıt: olay sayısı ya da 0/1 · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | tam sayı | y_i (satır 95, 98). |
Deneme sayısı · deneme |
sayısal sütun · Değişkenler | boş | tam sayı \ge1 | n_i; boşsa her satır tek deneme (96). |
Kesin olarak sınanacak ortak değişkenler · x |
sütunlar (sayısal) · Değişkenler | — | en az bir sayısal sütun | Her biri için ayrı koşullu dağılım (197–233). |
Koşullanan ortak değişkenler · diger |
sütunlar (sayısal) · Değişkenler | boş | sayısal sütunlar | \sum y\mathbf z sabit tutulur; sınanmaz (86, 127–129). |
Tabaka · tabaka |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Tabaka başına olay sayısına koşullama (113, 157–162). |
Güven düzeyi · guven |
ondalık · Seçenekler | 0,95 | 0,5–0,999 | \alpha=1-\text{güven} (116). |
Orta-p çarpanı · orta_p_carpani |
ondalık · Seçenekler | 0,5 | 0–1 | Orta-p ve orta-p aralığında nokta olasılığının çarpanı (119, 186, 211). |
Güven aralığı türü · ga_turu |
seçim · Seçenekler | kesin |
kesin, orta_p |
Aralık kuyruğu fonksiyonu (120, 188). |
Her değişkenin koşullu dağılım tablosu · tum_dagilimlar |
onay · Çıktı | kapalı | açık / kapalı | Kapalıyken yalnız ilk değişkenin dağılımı (229–232). |
Ağ algoritması en çok durum sayısı · en_cok_durum |
tamsayı · Gelişmiş | 500000 | 1000 – 50000000 | Bellek koruması; aşılırsa durur (118, 170). |
Örnek ayar (ornek_param, satır 9): y = iyilesen, deneme = toplam, x = [hemen], tabaka = penisilin. Öteki alanlar varsayılandadır.
Şablonun kendi denetimleri:
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Yanıt aynı zamanda ortak değişken, deneme ya da tabaka; deneme ya da tabaka aynı zamanda ortak değişken | "…olarak da seçilemez" | 89–91 |
| Eksiksiz satır sayısı 2'den az | "Eksiksiz en az 2 satır gerekli." | 94 |
| Yanıt ya da deneme tam sayı değil | "Yanıt ve deneme sayısı tam sayı olmalı." | 97 |
| Deneme sayısı 1'den küçük | "Deneme sayısı en az 1 olmalı." | 99 |
| y<0 ya da y>n | "…yanıt 0/1 olmalı." / "Olay sayısı 0 ile deneme sayısı arasında olmalı." | 100–101 |
| Hiç olay yok ya da hepsi olay | "Yanıtın iki sonucu da gözlenmeli…" | 102 |
| Ortak değişken dört ondalıktan fazla | "en çok 4 ondalıklı olmalı…" | 104–105 |
| Yanıt, deneme ya da ortak değişken sütununda sayıya çevrilemeyen değer | "… sütunu sayıya çevrilemedi: … değer sayı değil (ör. …)." | 95–96, 109 |
| Ortak değişken sabit | "sabit; sınanamaz" | 110 |
| Ortak değişken sayısı \ge satır sayısı | "Ortak değişken sayısı satır sayısından az olmalı." | 115 |
| \alpha\le0 ya da \alpha>0{,}5 | "Güven düzeyi 0,5 ile 1 arasında olmalı." | 117 |
| Koşullu dağılım boş; durum sayısı sınırı aşıldı | "Koşullu dağılım boş kaldı…"; "Koşullu dağılım çok büyük…" | 165, 170–171 |
| Koşullu dağılım tek noktalı | "…değişken öteki koşullarla belirleniyor." | 199 |
Eksik değer: seçilen sütunlardan birinde eksik olan satır atılır (93). Tabaka tek düzeyliyse çalıştırma sürer ve "tabaka tek düzeyli; kesişimle aynı" notu yazılır (114). Güven düzeyi 0,5 ile 0,999 arasında seçilir; 0,5 de geçerlidir (\alpha=0{,}5; örnek ayarda %50 kesin aralık odds ölçeğinde [3{,}08;\ 45{,}26]). Yanıt, deneme ve ortak değişken sütunları mq_sayisal() ile sayıya çevrilir (95–96, 109; Bölüm 1.5): sütun veri sekmesinde hangi türde olursa olsun değerleri kullanılır.
36.3 Örnek veri
Dosya: _ornek/penisilin_tavsan.csv. Agresti'nin (2002) tavşan deneyidir: streptokok bulaştırılan tavşanlara beş penisilin düzeyinde, enjeksiyon hemen ya da gecikmeli yapılmış; yanıt iyileşmedir. Veri gruplu biçimdedir: her satır bir penisilin düzeyi × gecikme hücresidir. 10 satır, 54 tavşan, 29 iyileşme; eksik değer yoktur.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
penisilin |
Tabaka | sayısal | 0,125; 0,25; 0,5; 1; 4 (her biri iki satır) |
log2_doz |
Koşullanan ortak değişken (ek çalıştırmada) | sayısal | −3, −2, −1, 0, 2 |
hemen |
Sınanan ortak değişken | ikili | 1 = hemen, 0 = gecikmeli (1,5 saat) |
iyilesen |
Yanıt (olay sayısı) | sayısal | 0–6; toplam 29 |
toplam |
Deneme sayısı | sayısal | 2–6; toplam 54 |
doz4 |
Uç durum örneği | ikili | 1 = penisilin 4, 0 = ötekiler |
Tabaka sütunu kodda metne çevrilerek kullanılır (satır 113); düzey sırası sonucu etkilemez, çünkü koşullu dağılım tabakaların sırasından bağımsızdır. Beş tabakanın 2×2 tabloları:
| Penisilin | Hemen: iyileşen / toplam | Gecikmeli: iyileşen / toplam | Tabakadaki toplam iyileşen |
|---|---|---|---|
| 0,125 | 0 / 6 | 0 / 5 | 0 |
| 0,25 | 3 / 6 | 0 / 6 | 3 |
| 0,5 | 6 / 6 | 2 / 6 | 8 |
| 1 | 5 / 6 | 6 / 6 | 11 |
| 4 | 2 / 2 | 5 / 5 | 7 |
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar (tabakalı); (2) aynısı, orta-p güven aralığı; (3) tabakasız (tabaka boş); (4) tabakasız, x = [hemen, log2_doz], bütün dağılım tabloları; (5) tabakasız, x = [hemen], diger = [log2_doz]; (6) tabakasız, x = [doz4] (uç durum). Sütun türleri veri sekmesinin algıladığı gibidir.
36.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) ortak değişkenleri tam sayıya ölçekle; (2) sınanan her değişken için koşullu dağılımın katsayılarını c(t) ağ algoritmasıyla say; (3) \beta=0 altındaki dağılımdan skor ve olasılık testlerini, kesin p ve orta-p'yi hesapla; (4) koşullu en çok olabilirlik kestirimini ya da uç durumda ortanca yansız kestirimi bul; (5) kuyruk olasılıklarını \beta'ya göre çözerek güven aralığını kur; (6) ölçeği geri al, odds oranlarına çevir.
36.4.1 Koşullu dağılım ve ağ algoritması
Gözlemler tabaka sırasına dizilir ve satır satır işlenir. Her adımda o ana kadarki "durumlar" (tabakadaki birikmiş olay sayısı, \sum y\mathbf z, \sum yx) ve her duruma ulaşan dizilimlerin sayısının logaritması tutulur. i. satır n_i denemeliyse y=0,\dots,n_i olay için her durum n_i+1 yeni duruma açılır:
- s: içinde bulunulan tabakada o ana kadar sayılan olay; tabaka bitince gözlenen tabaka toplamına eşit olmayan durumlar atılır ve sayaç sıfırlanır (satır 160–164).
- \binom{n_i}{y}: n_i denemeden y'sinin olay olduğu dizilim sayısı; 0/1 veride her zaman 1'dir.
- Aynı duruma ulaşan yollar birleştirilir; sayılar log ölçeğinde toplanır (166–169). Son adımda kalan durumların t değerleri dağılımın desteğini, ağırlıkları \ln c(t)'yi verir (173–175).
Neden bütün dizilimler tek tek sayılmıyor?
54 tavşanın 29'unun iyileştiği dizilimlerin sayısı \binom{54}{29}\approx1{,}9\times10^{15}'tir. Ağ algoritması (Hirji, Mehta ve Patel 1987) aynı ara toplamlara ulaşan dizilimleri birleştirir; tutulan durum sayısı dizilim sayısıyla değil, ara toplamların alabileceği değer sayısıyla büyür (örnek veride son adımda dokuz durum kalır). Budama da aynı amaca hizmet eder: kalan satırlarla hedefe ulaşması olanaksız durumlar hemen atılır (satır 135–159).
Koddaki tercih
Algoritma taban R ile şablonun içinde yazılmıştır (kosullu(), satır 126–176); paket çağrılmaz. Ağırlıklar lchoose ve log-toplam-üstel (lse, 123) ile log ölçeğinde tutulur; bu, c(t) sayıları 10^{14}'ü aştığında da kesinliği korur. Ortak değişkenler önce 10^k (k\le4) ile çarpılarak tam sayı yapılır (olcek(), 103–106); sonuçlar çıktıda 10^k ile geri ölçeklenir (220–222). Durum sayısı en_cok_durum'u aşarsa çalıştırma durur (170).
36.4.2 Kesin testler ve orta-p
\beta=0 altında p_0(t)=c(t)/\sum_u c(u). İki test, "gözlenenden daha uç" kümeyi farklı tanımlar:
- t_g: gözlenen yeterli istatistik. \mu_0, \sigma_0^2: T'nin \beta=0 altındaki koşullu ortalaması ve varyansı.
- Olasılık testi gözlenenden daha az olası bütün değerleri, skor testi ortalamadan en az gözlenen kadar uzak bütün değerleri toplar. Tabloda skor testinin istatistiği q(t_g), olasılık testinin istatistiği p_0(t_g)'dir (satır 210–211).
- m: orta-p çarpanı; varsayılan 0{,}5. m=0 kesin p'yi, m=1 gözlenen noktayı tümüyle dışarıda bırakan değeri verir. Her iki testte de düşülen terim gözlenen noktanın olasılığıdır (211).
Neden orta-p?
Kesin test ayrık bir dağılıma dayanır; p değeri yalnız birkaç değer alabilir ve gerçek I. tür hata nominal düzeyin altında kalır (örnekte 0{,}05 düzeyinde ret olasılığı yalnız 0{,}0399'dur). Gözlenen noktanın olasılığının yarısını düşmek (Lancaster 1961) bu tutuculuğu azaltır; karşılığında hatanın \alpha'yı aşmadığı güvencesi kalkar. Hangisinin raporlanacağı çözümlemeden önce belirlenir.
36.4.3 Koşullu en çok olabilirlik ve ortanca yansız kestirim
- \hat\beta: koşullu en çok olabilirlik kestirimi (KMLE). Koşullu log-olabilirliğin türevi t_g-E_\beta(T), ikinci türevi -\operatorname{Var}_\beta(T)'dir; standart hata koşullu bilgiden gelir (satır 214, 221).
- \tilde\beta: ortanca yansız kestirim (OYK; Hirji, Tsiatis ve Mehta 1989). İki kök ayrık dağılım yüzünden farklıdır; ortalamaları alınır (215–216).
- t_g desteğin ucundaysa (t_{\min} ya da t_{\max}) E_\beta(T)=t_g denkleminin sonlu çözümü yoktur: KMLE sonsuzdur. Şablon bu durumda KMLE ve SH'yi boş bırakır, OYK'yi tek kökten verir (uç üstteyse P_\beta(T\ge t_g)=0{,}5) ve tabloda kestirim türünü "OYK" yazar (213–216, 223).
36.4.4 Kesin güven aralığı
- Aralık, her biri \alpha/2 düzeyindeki iki tek yanlı kesin testin tersine çevrilmesidir (Cornfield türü); kapsama olasılığı en az 1-\alpha'dır.
- t_g alt uçtaysa alt sınır -\infty, üst uçtaysa üst sınır +\infty yazılır (satır 217–218). Bu durumda ayrıca "Uç durum" tablosu, sonlu tarafın tek yanlı \alpha düzeyindeki sınırını ve tek yanlı kesin p'yi verir (224–228).
- Parametre tablosundaki iki yanlı p, 2\min\{P_0(T\ge t_g),\,P_0(T\le t_g)\}'dir (219) ve aralıkla tutarlıdır: aralık 0'ı içermiyorsa bu p<\alpha'dır. Testler tablosundaki iki p ile aynı olmak zorunda değildir.
Koddaki tercih
Bütün kökler kok() ile bulunur (satır 190–195): aralık [-1{,}1]'den başlayıp işaret değişene kadar ikiye katlanır (en çok 60 kez), sonra uniroot(tol = 1e-12) uygulanır. Kuyruk olasılıkları kuyruk() (179–183) ile, \ln c(t)+\beta t üzerinden log-toplam-üstel ile hesaplanır; büyük |\beta|'da taşma olmaz. Odds oranları e^{\beta}'dır ve ortak değişkenin bir birimlik artışına karşılık gelir (239–241).
Aynı tabloya uygulanan hazır fonksiyonlarla son basamaklar farklı çıkabilir
R'nin mantelhaen.test(exact = TRUE) ve fisher.test fonksiyonları aynı koşullu dağılımı kullanır, ama aralık köklerini uniroot'un varsayılan toleransıyla (yaklaşık 1{,}2\times10^{-4}) arar. Örnek veride ortak odds oranının üst sınırı bu fonksiyonla 529,84; şablonda ve iki bağımsız hesapta 531,51'dir (36.6). Fark tanımda değil, kök bulma duyarlığındadır; odds ölçeğinde büyük görünür, çünkü e^{6{,}27} çevresinde küçük bir \beta farkı çarpan olarak büyür.
36.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–81 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, 10 parametre. | Form buradan kurulur (Bölüm 1.2). |
| 84–102 | Sütun rolleri, çakışma denetimleri, eksiksiz satırlar, y ve n'nin tam sayı ve aralık denetimi. | Deneme sütunu yoksa n_i=1 (96). |
| 103–122 | Ortak değişkenlerin tam sayıya ölçeklenmesi, tabaka etiketleri, \alpha, seçenekler. | Ölçek çarpanı değişken başına ayrıdır (111). |
| 123–176 | kosullu(j): j. değişken için ağ algoritması; öteki bütün ortak değişkenler (sınanan diğerleri dahil) koşullanır (127). |
Birden çok değişken sınanıyorsa her biri ötekilere koşullu sınanır. |
| 178–195 | Kuyruk, orta-p kuyruğu, beklenen değer ve kök bulma işlevleri. | kq aralık türüne göre seçilir (188). |
| 196–233 | Her değişken için testler, KMLE, OYK, GA, iki yanlı p, uç durum satırı, dağılım tablosu. | Eşitlik karşılaştırmalarında 10^{-7} göreli pay vardır (203, 208). |
| 234–245 | Konsol satırı ve tablolar: testler, kestirimler, odds oranları, koşullu dağılım, uç durum, not. | Tablo başlığı aralık türünü yazar (237–238). |
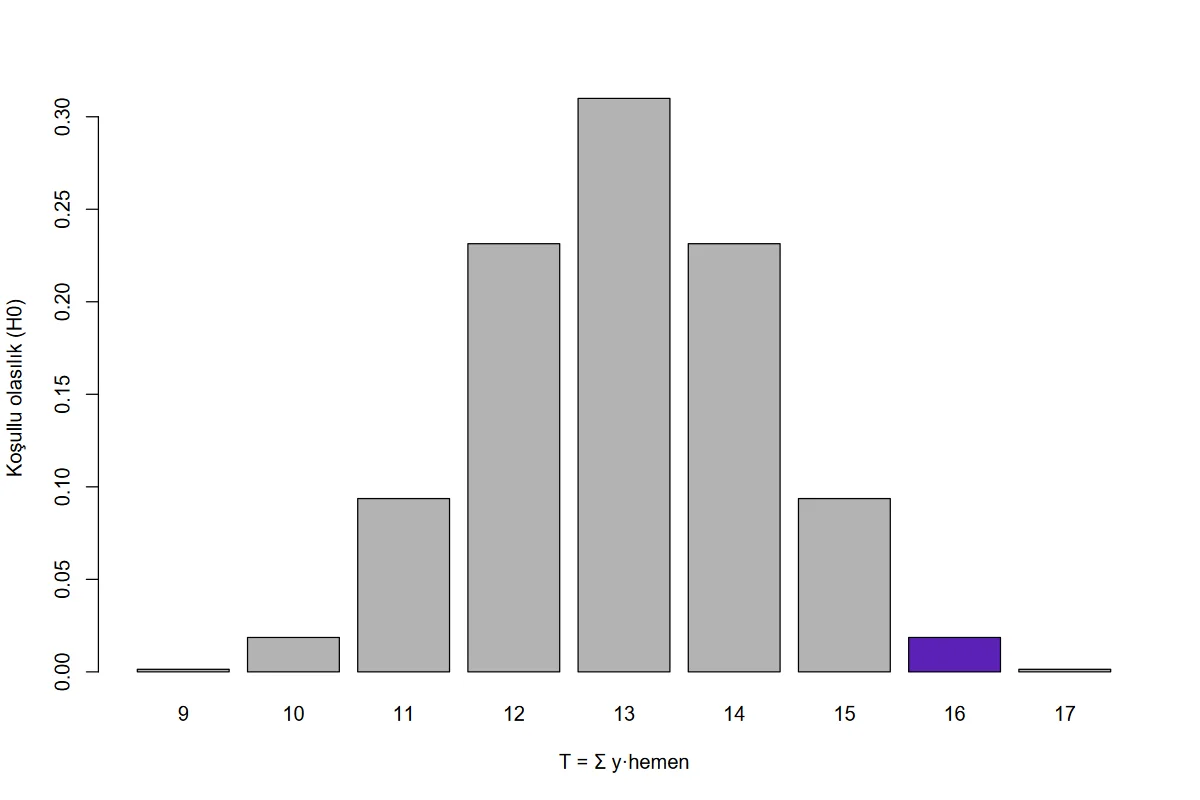
| 246–250 | Şekil: ilk sınanan değişkenin H_0 altındaki dağılımı; gözlenen değer mor. | Eksen etiketi ölçeklenmemiş T'dir. |
36.6 Elle hesap: örnek veride bağımsız yeniden hesap
Değerler dogrulama/kesin_lojistik/elle_hesap.py ile, şablonun ağ algoritması kullanılmadan hesaplanmıştır: üreteç fonksiyonu kesin tam sayı aritmetiğiyle açılmış (budama yok), olasılıklar kesir olarak tutulmuş, kökler ikiye bölmeyle bulunmuştur. R tarafında (r_dogrulama.R) tabaka başına hipergeometrik yoğunluklar (dhyper) evriştirilmiş, KMLE ayrıca survival::clogit(method = "exact") ile alınmıştır.
Adım 1 — Tabaka başına katkılar. Tek ikili ortak değişkende her tabaka bir 2×2 tablodur; tabakanın olay sayısı m sabitken "hemen" grubundaki olay sayısı x için dizilim sayısı \binom{n_1}{x}\binom{n_0}{m-x}'tir.
| Penisilin | n_1, n_0, m | x'in alabileceği değerler | Dizilim sayıları | Gözlenen x |
|---|---|---|---|---|
| 0,125 | 6, 5, 0 | 0 | 1 | 0 |
| 0,25 | 6, 6, 3 | 0, 1, 2, 3 | 20, 90, 90, 20 | 3 |
| 0,5 | 6, 6, 8 | 2, 3, 4, 5, 6 | 15, 120, 225, 120, 15 | 6 |
| 1 | 6, 6, 11 | 5, 6 | 6, 6 | 5 |
| 4 | 2, 5, 7 | 2 | 1 | 2 |
Birinci ve beşinci tabaka tek değer alabildiğinden bilgi taşımaz. t_g=0+3+6+5+2=16.
Adım 2 — Koşullu dağılım. Tabakaların çokterimlileri çarpılır: (20+90z+90z^2+20z^3)(15z^2+\dots+15z^6)(6z^5+6z^6)\,z^2. z^t'nin katsayısı c(t)'dir; toplam 1 306 800'dür.
| t | 9 | 10 | 11 | 12 | 13 | 14 | 15 | 16 | 17 |
|---|---|---|---|---|---|---|---|---|---|
| c(t) | 1800 | 24300 | 122400 | 302400 | 405000 | 302400 | 122400 | 24300 | 1800 |
| p_0(t) | 0,00138 | 0,01860 | 0,09366 | 0,23140 | 0,30992 | 0,23140 | 0,09366 | 0,01860 | 0,00138 |
Adım 3 — Testler. \mu_0=13, \sigma_0^2=1{,}590909; skor istatistiği (16-13)^2/1{,}590909=5{,}657143. Dağılım simetrik olduğundan iki test aynı kümeyi toplar (t\le10 ve t\ge16):
Adım 4 — KMLE. E_\beta(T)=16 denkleminin kökü \hat\beta=2{,}338053; bu noktada \operatorname{Var}_{\hat\beta}(T)=0{,}784078, \operatorname{SH}=1/\sqrt{0{,}784078}=1{,}129329. Odds oranı e^{2{,}338053}=10{,}3610.
Adım 5 — OYK ve güven aralığı. P_\beta(T\ge16)=0{,}5 ve P_\beta(T\le16)=0{,}5 köklerinin ortalaması \tilde\beta=2{,}300959. Aralık: P_\beta(T\ge16)=0{,}025 için \beta_{\text{alt}}=0{,}074539, P_\beta(T\le16)=0{,}025 için \beta_{\text{üst}}=6{,}275727; odds ölçeğinde [1{,}0774;\ 531{,}51]. Orta-p aralığı [0{,}291945;\ 5{,}585533], odds ölçeğinde [1{,}339;\ 266{,}54]: aynı veride belirgin biçimde daha dardır.
Adım 6 — Tabakasız çalıştırma. Tabaka yok sayılırsa veri tek bir 2×2 tablodur (hemen: 16/26, gecikmeli: 13/28) ve T sıradan hipergeometrik dağılır: p_0(16)=0{,}118158, olasılık testi p=0{,}289832 (Fisher kesin testinin iki yanlı p değeri), \hat\beta=0{,}601586, odds oranı 1{,}8250, kesin GA [0{,}5492;\ 6{,}2825]. Tabakalama odds oranını 1,83'ten 10,36'ya çıkarır: penisilin düzeyi iyileşmeyi güçlü biçimde belirlediğinden, tabakalar birleştirildiğinde gecikmenin etkisi örtülür.
Adım 7 — Koşullanan ortak değişken. Tabaka yerine log2_doz koşullanan ortak değişken yapılırsa (çalıştırma 5) c(t) yalnız \sum y = 29 ve \sum y\cdot\text{log2\_doz}=0 koşullarını sağlayan dizilimleri sayar: destek 8–18, p_0(16)=0{,}016555, p=0{,}034326, \hat\beta=2{,}427001 (SH 1,107508), kesin GA [0{,}119667;\ 5{,}626217]. Doz doğrusal girdiğinde sonuç tabakalı çözümlemeye yakındır.
Adım 8 — Uç durum. doz4 sınandığında (çalıştırma 6) t_g=7 desteğin üst ucudur (penisilin 4 alan yedi tavşanın hepsi iyileşmiştir). KMLE sonsuzdur; P_\beta(T\ge7)=0{,}5 kökü \tilde\beta=2{,}323310 (odds oranı 10,21). İki yanlı aralığın alt sınırı P_\beta(T\ge7)=0{,}025'ten 0{,}350728, üst sınırı sonsuzdur; tek yanlı %95 alt sınır (P_\beta(T\ge7)=0{,}05) 0{,}627142, tek yanlı p=p_0(7)=0{,}008813'tür.
36.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle alınmıştır (çalıştırmalar 1–6).
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Tabakalı · skor istatistiği | 5,65714286 | 5,65714286 | 5,65714286 | 4,9e−15 | ✓ |
| Tabakalı · skor testi kesin p | 0,0399449 | 0,0399449 | 0,0399449 | 6,9e−17 | ✓ |
| Tabakalı · olasılık testi kesin p | 0,0399449 | 0,0399449 | 0,0399449 | 6,9e−17 | ✓ |
| Tabakalı · P_0(T=t_g) | 0,01859504 | 0,01859504 | 0,01859504 | 4,9e−17 | ✓ |
| Tabakalı · orta-p (olasılık testi) | 0,03064738 | 0,03064738 | — | 6,9e−18 | ✓ |
| Tabakalı · KMLE \hat\beta | 2,33805323 | 2,33805323 | 2,33805323 | 1,2e−13 | ✓ |
| Tabakalı · SH (koşullu bilgi) | 1,12932894 | 1,12932894 | 1,12932894 | 8,5e−14 | ✓ |
| Tabakalı · ortanca yansız kestirim | 2,30095911 | 2,30095911 | 2,30095911 | 2,8e−14 | ✓ |
| Tabakalı · kesin GA alt | 0,07453937 | 0,07453937 | 0,07453937 | 3,7e−15 | ✓ |
| Tabakalı · kesin GA üst | 6,27572725 | 6,27572725 | 6,27572725 | 1,6e−14 | ✓ |
| Tabakalı · odds oranı GA üst | 531,51278289 | 531,51278289 | 531,51278289 | 9,9e−14 | ✓ |
| Tabakalı · iki yanlı p (2\times küçük kuyruk) | 0,0399449 | 0,0399449 | 0,0399449 | 6,9e−17 | ✓ |
| Tabakalı · P_0(T=9) | 0,00137741 | 0,00137741 | 0,00137741 | 6,1e−17 | ✓ |
| Tabakalı · \ln c(9) | 7,49554194 | 7,49554194 | — | 4,7e−16 | ✓ |
| Tabakalı · P_0(T=13) | 0,30991736 | 0,30991736 | 0,30991736 | 1,7e−16 | ✓ |
| Tabakalı · \ln c(13) | 12,91164235 | 12,91164235 | — | 1,8e−15 | ✓ |
Tabakalı · KMLE (R: clogit, kesin) |
2,33805323 | 2,33805323 | 2,33805323 | 1,2e−13 | ✓ |
Tabakalı · SH (R: clogit, kesin) |
1,12932894 | 1,12932894 | 1,12932894 | 8,5e−14 | ✓ |
| Tabakalı · orta-p GA alt | 0,29194482 | 0,29194482 | 0,29194482 | 4,3e−15 | ✓ |
| Tabakalı · orta-p GA üst | 5,58553306 | 5,58553306 | 5,58553306 | 1,4e−15 | ✓ |
| Tabakasız · skor istatistiği | 1,21504358 | 1,21504358 | 1,21504358 | 4,2e−14 | ✓ |
| Tabakasız · skor testi kesin p | 0,28983236 | 0,28983236 | 0,28983236 | 7,8e−16 | ✓ |
| Tabakasız · olasılık testi kesin p | 0,28983236 | 0,28983236 | 0,28983236 | 7,8e−16 | ✓ |
| Tabakasız · P_0(T=t_g) | 0,11815817 | 0,11815817 | 0,11815817 | 5,1e−16 | ✓ |
| Tabakasız · orta-p (olasılık testi) | 0,23075328 | 0,23075328 | — | 6,9e−16 | ✓ |
| Tabakasız · KMLE \hat\beta | 0,6015864 | 0,6015864 | 0,6015864 | 2,2e−13 | ✓ |
| Tabakasız · SH (koşullu bilgi) | 0,54787796 | 0,54787796 | 0,54787796 | 4,7e−15 | ✓ |
| Tabakasız · ortanca yansız kestirim | 0,59840489 | 0,59840489 | 0,59840489 | 2,3e−15 | ✓ |
| Tabakasız · kesin GA alt | −0,59922731 | −0,59922731 | −0,59922731 | 6,4e−15 | ✓ |
| Tabakasız · kesin GA üst | 1,83777279 | 1,83777279 | 1,83777279 | 1,6e−15 | ✓ |
| Tabakasız · odds oranı GA üst | 6,28253014 | 6,28253014 | 6,28253014 | 9,9e−16 | ✓ |
| Tabakasız · iki yanlı p (2\times küçük kuyruk) | 0,40153652 | 0,40153652 | 0,40153652 | 8,9e−16 | ✓ |
| log2_doz'a koşullu · hemen: skor istatistiği | 5,89494127 | 5,89494127 | — | 5,6e−15 | ✓ |
| log2_doz'a koşullu · hemen: skor testi kesin p | 0,03432557 | 0,03432557 | — | 1,4e−17 | ✓ |
| log2_doz'a koşullu · hemen: olasılık testi kesin p | 0,03432557 | 0,03432557 | — | 1,4e−17 | ✓ |
| log2_doz'a koşullu · hemen: P_0(T=t_g) | 0,0165552 | 0,0165552 | — | 3,1e−17 | ✓ |
| log2_doz'a koşullu · hemen: orta-p (olasılık testi) | 0,02604796 | 0,02604796 | — | 5,2e−17 | ✓ |
| log2_doz'a koşullu · hemen: KMLE \hat\beta | 2,42700077 | 2,42700077 | — | 1,5e−14 | ✓ |
| log2_doz'a koşullu · hemen: SH (koşullu bilgi) | 1,10750798 | 1,10750798 | — | 8,4e−15 | ✓ |
| log2_doz'a koşullu · hemen: ortanca yansız kestirim | 2,40355406 | 2,40355406 | — | 4,8e−14 | ✓ |
| log2_doz'a koşullu · hemen: kesin GA alt | 0,11966712 | 0,11966712 | — | 3,5e−15 | ✓ |
| log2_doz'a koşullu · hemen: kesin GA üst | 5,62621722 | 5,62621722 | — | 3,3e−14 | ✓ |
| log2_doz'a koşullu · hemen: odds oranı GA üst | 277,60999229 | 277,60999229 | — | 1,8e−13 | ✓ |
| log2_doz'a koşullu · hemen: iki yanlı p (2\times küçük kuyruk) | 0,03510752 | 0,03510752 | — | 2,8e−17 | ✓ |
| hemen'e koşullu · log2_doz: skor istatistiği | 28,3095602 | 28,3095602 | — | 3,5e−15 | ✓ |
| hemen'e koşullu · log2_doz: skor testi kesin p | 5,509374·10−10 | 5,509374·10−10 | — | 2,1e−25 | ✓ |
| hemen'e koşullu · log2_doz: olasılık testi kesin p | 5,509374·10−10 | 5,509374·10−10 | — | 2,1e−25 | ✓ |
| hemen'e koşullu · log2_doz: P_0(T=t_g) | 2,513339·10−10 | 2,513339·10−10 | — | 2,6e−25 | ✓ |
| hemen'e koşullu · log2_doz: orta-p (olasılık testi) | 4,252705·10−10 | 4,252705·10−10 | — | 4,7e−25 | ✓ |
| hemen'e koşullu · log2_doz: KMLE \hat\beta | 2,39376601 | 2,39376601 | — | 9,3e−16 | ✓ |
| hemen'e koşullu · log2_doz: SH (koşullu bilgi) | 0,6893841 | 0,6893841 | — | 1,1e−16 | ✓ |
| hemen'e koşullu · log2_doz: ortanca yansız kestirim | 2,33221432 | 2,33221432 | — | 2,7e−15 | ✓ |
| hemen'e koşullu · log2_doz: kesin GA alt | 1,1727355 | 1,1727355 | — | 5,2e−14 | ✓ |
| hemen'e koşullu · log2_doz: kesin GA üst | 4,4694607 | 4,4694607 | — | 4,0e−16 | ✓ |
| hemen'e koşullu · log2_doz: odds oranı GA üst | 87,30962393 | 87,30962393 | — | 1,3e−15 | ✓ |
| hemen'e koşullu · log2_doz: iki yanlı p (2\times küçük kuyruk) | 5,519933·10−10 | 5,519933·10−10 | — | 3,1e−25 | ✓ |
| Uç durum (doz4) · skor istatistiği | 6,80484226 | 6,80484226 | — | 5,4e−15 | ✓ |
| Uç durum (doz4) · skor testi kesin p | 0,01152724 | 0,01152724 | — | 4,9e−17 | ✓ |
| Uç durum (doz4) · olasılık testi kesin p | 0,01152724 | 0,01152724 | — | 4,9e−17 | ✓ |
| Uç durum (doz4) · P_0(T=t_g) | 0,00881296 | 0,00881296 | — | 1,9e−17 | ✓ |
| Uç durum (doz4) · orta-p (olasılık testi) | 0,00712076 | 0,00712076 | — | 8,8e−17 | ✓ |
| Uç durum (doz4) · ortanca yansız kestirim | 2,32330955 | 2,32330955 | — | 1,7e−15 | ✓ |
| Uç durum (doz4) · kesin GA alt | 0,35072756 | 0,35072756 | — | 1,3e−15 | ✓ |
| Uç durum (doz4) · iki yanlı p (2\times küçük kuyruk) | 0,01762592 | 0,01762592 | — | 3,8e−17 | ✓ |
| Uç durum (doz4) · tek yanlı %95 alt sınır | 0,62714237 | 0,62714237 | — | 2,2e−15 | ✓ |
| Uç durum (doz4) · tek yanlı p | 0,00881296 | 0,00881296 | — | 1,9e−17 | ✓ |
Ölçütü karşılayan: 66/66. Python: üreteç fonksiyonunun kesin tam sayı aritmetiğiyle açılımı (budama yok), olasılıklar kesirlerden, kökler ikiye bölmeyle. R: tabaka başına dhyper yoğunluklarının evrişimi ve uniroot(tol = 1e-13); KMLE ve SH ayrıca survival::clogit(method = "exact"). Koşullanan ortak değişkenli ve uç durumlu satırlar yalnız Python ile karşılaştırılmıştır.
36.7 Çıktıyı okuma
Örnek ayarın konsol satırı ve tabloları (kısaltılmış):
Kesin koşullu lojistik regresyon: n = 10 satır, 54 deneme, 29 olay; koşullanan: tabaka (penisilin, 5 düzey)

Kesin koşullu testler (H0: β = 0)
degisken      test  istatistik   kesin_p    orta_p
   hemen      Skor      5.6571    0.0399    0.0306
   hemen  Olasılık      0.0186    0.0399    0.0306

Kesin parametre kestirimleri (KMLE: koşullu ML, SH koşullu bilgiden; OYK: ortanca yansız; %95 kesin GA)
degisken    KMLE      SH     OYK  GA_alt  GA_ust  p_iki_yanli  kestirim_turu
   hemen  2.3381  1.1293  2.3010  0.0745  6.2757       0.0399           KMLE

Kesin odds oranları (birim artış başına)
degisken  OR_KMLE  OR_OYK  GA_alt    GA_ust
   hemen  10.3610  9.9838  1.0774  531.5128

'hemen' için H0 altında koşullu dağılım
degisken   T    log_c  olasilik_H0  gozlenen
   hemen   9   7.4955       0.0014
   hemen  10  10.0982       0.0186
   …
   hemen  16  10.0982       0.0186         *
   hemen  17   7.4955       0.0014
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Konsol satırı | Satır, deneme ve olay sayısı; neye koşullanıldığı | Tabaka ve koşullanan değişkenlerin doğru alındığı buradan denetlenir. |
Skor, Olasılık |
İki kesin testin istatistiği, kesin p ve orta-p | İstatistik sütunu skor testinde q(t_g), olasılık testinde p_0(t_g)'dir. İki test çarpık dağılımda farklı p verebilir. |
KMLE, SH |
Koşullu en çok olabilirlik kestirimi ve koşullu bilgiden SH | Log odds oranı. SH yalnız bilgi içindir; aralık SH'den değil, kuyruklardan kurulur. |
OYK |
Ortanca yansız kestirim | KMLE sonsuzken raporlanacak kestirim; sonluyken ona yakındır. |
GA_alt, GA_ust, p_iki_yanli |
Kesin (ya da orta-p) aralık ve onunla tutarlı iki yanlı p | Aralık KMLE çevresinde simetrik değildir. |
| Odds oranları | e^{\text{KMLE}}, e^{\text{OYK}} ve aralığın üstel dönüşümü | Ortak değişkenin bir birim artışı için; ikili değişkende iki grubun odds oranı. |
| Koşullu dağılım | T'nin değerleri, \ln c(t), p_0(t), gözlenen değerin işareti | Desteğin kaç noktalı olduğu testin ne kadar "ayrık" olduğunu gösterir. |
| Uç durum tablosu | Tek yanlı sınır ve tek yanlı p | Yalnız t_g desteğin ucundayken üretilir. |
Şekil 36.1. Şablonun şekli (örnek ayar): T=\sum y\cdot\text{hemen} istatistiğinin H_0 altındaki koşullu dağılımı; gözlenen değer (16) mor. Dağılım 13 çevresinde simetriktir; gözlenen değer üst kuyruktadır.
Rapor cümlesi (örnek ayar):
Penisilin düzeyine göre tabakalanmış kesin koşullu lojistik regresyonda, enjeksiyonun hemen yapılması iyileşme odds'unu anlamlı biçimde artırdı (kesin koşullu skor testi p = 0{,}040; orta-p = 0{,}031). Koşullu en çok olabilirlik odds oranı 10,36, %95 kesin GA [1,08; 531,5] bulundu.
36.8 Sık hatalar ve tuzaklar
- Tabakayı vermeden çözümlemek. Örnek veride tabakasız odds oranı 1,83 (p=0{,}29), tabakalı 10,36'dır (p=0{,}040). Tasarımda bloklama ya da eşleştirme varsa tabaka sütunu seçilir.
- Tabaka değişkenini aynı zamanda koşullanan ortak değişken yapmak. Tabaka içinde sabit olan bir değişken ek bilgi taşımaz; tabaka içinde değişen ek bir koşul ise desteği daraltır. Koşullanan değişken çoğaldıkça dağılım birkaç noktaya, sonunda tek noktaya iner ve şablon "koşullu dağılım tek noktalı" iletisiyle durur.
- Sürekli ortak değişken. Çok sayıda farklı değer alan bir ortak değişkende T'nin neredeyse her dizilimi farklı bir değer verir; koşullanan taraftaysa destek tek noktaya iner, sınanan taraftaysa durum sayısı hızla büyür. Kesin yöntem birkaç düzeyli (doz, puan, ikili) ortak değişkenler içindir.
- Odds oranının birimini unutmak. Odds oranı ortak değişkenin bir birimlik artışı içindir.
log2_doziçin 10,95, dozun iki katına çıkmasının; hampenisilinsütunu için bulunacak değer ise dozun 1 birim artmasının etkisidir. Ölçek sorudan önce seçilir. - Uç durumda sonsuz sınırı "hesaplanamadı" sanmak. Bir grupta bütün yanıtlar aynıysa KMLE sonsuzdur ve aralığın bir ucu sonsuz yazılır. Bu bir hata değil, verinin o yönde sınır koymadığının ifadesidir; ortanca yansız kestirim ve sonlu sınır raporlanır.
- Üç iki yanlı p değerini karıştırmak. Skor testi, olasılık testi ve "iki kat küçük kuyruk" tanımları çarpık dağılımda ayrışır: tabakasız çalıştırmada ilk ikisi 0{,}2898, üçüncüsü 0{,}4015'tir. Hangisinin raporlanacağı önceden belirlenir; güven aralığıyla tutarlı olan üçüncüsüdür.
- Orta-p aralığını kesin aralık diye raporlamak. Orta-p aralığı daha dardır (örnekte üst sınır 266,5; kesin aralıkta 531,5) ama kapsama güvencesi yoktur. Tablo başlığı hangi türün hesaplandığını yazar; raporda da belirtilir.
- Yanıt ve deneme sütunlarının türü. Olay ve deneme sayıları veri sekmesinde kategorik türe alınmış olsa da değerleriyle okunur (Bölüm 1.3 ve 1.5); sütunda sayıya çevrilemeyen bir değer (ör. "yok", "1,5") varsa çalıştırma sütun adını ve örnek değerleri yazarak durur. Konsol satırındaki deneme ve olay toplamları (örnekte 54 ve 29) yine de her çalıştırmada veriyle karşılaştırılır.
- Dört ondalıktan fazla basamak. Ortak değişken tam sayıya ölçeklenemiyorsa şablon durur; değer anlamlı bir basamağa yuvarlanır ya da birimi değiştirilir.
36.9 Uzman soruları
S1. Koşullama bilgi kaybettirmez mi; neden koşulsuz kesin test yapılmıyor?
Kesişim ve tabaka parametreleri bilinmediği sürece T'nin koşulsuz dağılımı onlara bağlıdır ve hesaplanamaz. Yeterli istatistiklerine koşullamak bu parametreleri dağılımdan tümüyle çıkarır; geriye yalnız \beta'ya bağlı bir dağılım kalır. Kaybedilen, tabaka toplamlarının \beta hakkında taşıdığı (çoğunlukla çok az) bilgidir. Örnekte birinci ve beşinci tabakalar hiçbir bilgi katmaz, çünkü toplamları 0 ve 7 (hepsi) olduğundan içlerindeki dizilim tektir.
S2. Sıradan lojistik regresyon bu veride ne verirdi, neden güvenilmez?
Tabaka göstergeleriyle koşulsuz model beş kesişim ve bir eğim kestirir; birinci ve beşinci tabakalarda yanıtların hepsi aynı olduğundan o tabakaların kesişimleri sonsuza gider. Çok sayıda küçük tabakada koşulsuz kestirim ayrıca yanlıdır: tabaka sayısı arttıkça parametre sayısı da arttığından odds oranı sistematik olarak büyük çıkar (eşleştirilmiş çiftlerde gerçek değerin karesine yakınsar). Koşullu olabilirlik tabaka parametrelerini kestirmediği için bu yanlılığı taşımaz.
S3. KMLE varken ortanca yansız kestirim neden ayrıca veriliyor?
İki kestirim farklı ölçütü karşılar: KMLE koşullu olabilirliği en büyükler, OYK ise gözlenen değerin kestirilen dağılımın tam ortasına düşmesini ister. Uçta olmayan veride yakındırlar (2,338 ve 2,301). OYK'nin üstünlüğü her veride sonlu olmasıdır; bu nedenle şablon onu her zaman hesaplar ve tabloda hangisinin raporlanacağını "kestirim türü" sütunuyla gösterir.
S4. Uç durumda iki yanlı aralığın alt sınırı ile "Uç durum" tablosundaki sınır neden farklı?
İki yanlı %95 aralık her kuyruğa \alpha/2=0{,}025 ayırır; üst sınır sonsuz olsa da alt sınır 0{,}025 düzeyinden çözülür (0{,}3507). Bir tarafın zaten sınırsız olduğu durumda bazı araştırmacılar bütün \alpha'yı sonlu tarafa verir: tek yanlı %95 sınır (0{,}6271). İkisi de geçerlidir, sorusu farklıdır; şablon ikisini ayrı tablolarda verir. Aynı ayrım p değerinde de vardır: tek yanlı 0{,}0088, iki yanlı 0{,}0176.
S5. Skor testi ile olasılık testi ne zaman ayrışır?
Dağılım simetrikse (örnek ayarda olduğu gibi) "ortalamadan uzak" ile "daha az olası" aynı kümeyi tanımlar. Çarpık ya da çok tepeli dağılımda ayrışırlar: ortalamaya yakın ama olasılığı düşük bir nokta olasılık testine girer, skor testine girmez. İkili ortak değişkenli tek tabloda olasılık testi Fisher kesin testinin iki yanlı p değeridir.
S6. Birden çok değişken sınandığında her biri neye koşullu?
Sınanan her değişken, kesişim ya da tabakalarla birlikte öteki bütün ortak değişkenlere koşullanır; sınanan diğer değişkenler de koşullanan tarafa geçer (satır 127). Çalıştırma 4'te hemen ve log2_doz birlikte sınanmıştır: hemen satırı, log2_doz'un koşullanan değişken olduğu çalıştırma 5 ile aynıdır (p=0{,}0343). Parametrelerin birlikte sıfır olduğu ortak bir kesin test üretilmez.
S7. Orta-p çarpanı 0,5'ten farklı seçilirse ne olur?
Çarpan, gözlenen noktanın olasılığının ne kadarının "uç" sayılacağını belirler. 0 kesin testi, 0,5 Lancaster'ın orta-p'sini verir. 1 seçilirse gözlenen nokta tümüyle dışarıda kalır: örnekte p 0{,}0213'e iner ve orta-p aralığı odds ölçeğinde [2{,}40;\ 46{,}6]'ya daralır. Bu değerin kuramsal bir dayanağı yoktur; varsayılan dışında bir çarpan ancak başka bir yazılımın sonucu yeniden üretilecekse kullanılır.
S8. Hesap hangi büyüklükte veride olanaksızlaşır?
Belirleyici olan gözlem sayısı değil, ağın durum sayısıdır: (tabakadaki olay sayısı) × (koşullanan toplamların alabileceği değerler) × (T'nin alabileceği değerler). İkili ortak değişkenler ve küçük tabakalarda yüzlerce gözlem sorunsuz çözülür; iki üç çok düzeyli koşullanan değişken birkaç on gözlemde bile sınırı (varsayılan 500 000 durum) aşabilir. Sınır aşıldığında şablon durur; gelişmiş sekmeden sınır yükseltilebilir, ama bellek ve süre durum sayısıyla orantılı artar.
36.10 Kaynaklar
- Agresti, A. (2002). Categorical data analysis (2nd ed.). Wiley. https://doi.org/10.1002/0471249688
- Cox, D. R., & Snell, E. J. (1989). Analysis of binary data (2nd ed.). Chapman & Hall/CRC. https://doi.org/10.1201/9781315137391
- Hirji, K. F., Mehta, C. R., & Patel, N. R. (1987). Computing distributions for exact logistic regression. Journal of the American Statistical Association, 82(400), 1110–1117. https://doi.org/10.1080/01621459.1987.10478547
- Hirji, K. F., Tsiatis, A. A., & Mehta, C. R. (1989). Median unbiased estimation for binary data. The American Statistician, 43(1), 7–11. https://doi.org/10.1080/00031305.1989.10475597
- Lancaster, H. O. (1961). Significance tests in discrete distributions. Journal of the American Statistical Association, 56(294), 223–234. https://doi.org/10.1080/01621459.1961.10482105
- Mantel, N., & Haenszel, W. (1959). Statistical aspects of the analysis of data from retrospective studies of disease. JNCI: Journal of the National Cancer Institute, 22(4), 719–748. https://doi.org/10.1093/jnci/22.4.719
- Mehta, C. R., & Patel, N. R. (1995). Exact logistic regression: Theory and examples. Statistics in Medicine, 14(19), 2143–2160. https://doi.org/10.1002/sim.4780141908
- R Core Team. (2026). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Therneau, T. M. (2026). survival: Survival analysis (R package version 3.8-6). https://doi.org/10.32614/CRAN.package.survival