86. QST–FST Karşılaştırması ve Nötrallik Testi
Şablon kimliği: qst_fst · Kategori: genetik · Dil: R · Dosya: pro/sablonlar/genetik/qst_fst.R (satır 1–481; üstbilgi 1–152) · Örnek veri: _ornek/qst_fst_yapay.csv · Paketler: hierfstat 0.5-11 (FST), lme4 2.0-6 (yalnız REML seçeneğinde)
86.1 Ne işe yarar
Ortak bahçe (orijin–döl) denemesinde farklı popülasyonlardan gelen aileler aynı ortamda yetiştirilir ve bir kantitatif özellik (boy, çiçeklenme zamanı, kök oranı) ölçülür. Şablon şu soruyu cevaplar: "Bu özellikte popülasyonlar arasındaki genetik farklılaşma, yalnız sürüklenme ve göçle açıklanabilecek düzeyde mi, yoksa seçilim popülasyonları birbirinden uzaklaştırmış ya da birbirine benzer tutmuş mu?"
Karşılaştırılan iki büyüklük aynı ölçektedir. Q_{ST} özelliğin eklemeli genetik varyansının popülasyonlar arası payıdır (Spitze, 1993); F_{ST} nötral belirteçlerdeki karşılığıdır:
- \sigma^2_{pop}: özelliğin popülasyon ortalamaları arasındaki genetik varyans.
- \sigma^2_A: popülasyon içi eklemeli genetik varyans; aile varyansından türetilir (86.4.1).
- H_0: özellik nötraldir; farklılaşması belirteçlerinkiyle aynı süreçten (sürüklenme, göç) gelir.
Q_{ST}>F_{ST} popülasyonların farklı uç değerlere doğru seçildiğini (çeşitlendirici seçilim, yerel uyum), Q_{ST}<F_{ST} bütün popülasyonlarda aynı değerin kayırıldığını (tekdüzeleştirici seçilim) düşündürür. Şablon farkın nötral beklentiyle uyumunu Whitlock ve Guillaume'un (2009) parametrik bootstrap yöntemiyle sınar, Q_{ST} ve \sigma^2_A için güven aralığı verir, birden çok özellikte p değerlerini düzeltir.
Ne zaman kullanılır? Aileler popülasyon içinde iç içeyse (her aile tek bir popülasyona ait); aile içi akrabalık biliniyorsa (yarım kardeş ya da tam kardeş); bireyler ortak ortamda yetiştirilmişse; aynı popülasyonlardan nötral eş baskın belirteç verisi ya da güvenilir bir F_{ST} kestirimi varsa.
Ne zaman kullanılmaz?
- Fenotipler doğal ortamda, popülasyonların kendi yerinde ölçülmüşse: popülasyon farkı çevre etkisini de taşır (P_{ST}); şablon bunu ayırmaz.
- Yalnız kalıtım derecesi ve varyans bileşenleri isteniyorsa:
kalitim_derecesi; soy kütüğüne dayalı hayvan modeli gerekiyorsa temel programın karma model analizleri. - Yalnız belirteçlerin farklılaşması isteniyorsa:
f_istatistikleri(Bölüm 71); belirteçler arasında seçilim altındaki lokuslar aranıyorsaaykiri_lokus(Bölüm 64). - Popülasyonlar hiyerarşik yapıdaysa (bölge içinde popülasyon) ya da akrabalık düzeni karmaşıksa: nötral beklenti tek bir F_{ST} ile temsil edilemez; şablonun modeli yetmez.
- Tasarımda aile yoksa (popülasyon başına tek tek bireyler): \sigma^2_A kestirilemez.
Temel programla ilişki. Temel programın karma model analizleri aynı varyans bileşenlerini kestirir, ama Q_{ST}'yi, nötral dağılımı ve F_{ST} ile karşılaştırmayı vermez. Bu şablon MerQuR+'a özgüdür.
86.2 Şablonun girdileri
Form, üstbilgideki on sekiz [[param]] bloğundan kurulur (qst_fst.R:10–135).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Kantitatif özellik(ler) · ozellikler |
sütunlar · Değişkenler | yok | en az 1 sayısal sütun | Her özellik ayrı çözümlenir (305). |
Popülasyon (orijin) · populasyon |
kategorik sütun · Değişkenler | ilk uygun sütun | herhangi bir sütun | Hem Q_{ST} hem F_{ST} için popülasyon (203, 310). |
Aile · aile |
kategorik sütun · Değişkenler | ilk uygun sütun | herhangi bir sütun | Popülasyon içinde iç içe alınır (311). |
Blok · blok |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | Yalnız REML'de sabit etki (291); ANOVA ile birlikte seçilemez. |
Gösterge sütunları · lokuslar |
sütunlar · Değişkenler | boş | metin genotip ya da 0/1/2 | F_{ST}'nin hesaplandığı belirteçler (201). |
Alel ayırıcısı · ayirici |
metin · Değişkenler | / |
boş olmayan metin | Metin genotipini iki alele böler (ortak ayrıştırıcı mq_genotip; ayırıcı 182). |
Eksik genotip kodları · eksik_kodlar |
metin · Değişkenler | boş | virgülle ayrılmış kodlar | Boşsa varsayılan liste (boş hücre, NA, 0, 00, 000, ?, -, ., -9) eksik sayılır; doluysa alandaki kodlar bu listenin yerine geçer (boş hücre ve NA her zaman eksik); baş ve son boşluk kırpılır, boş kodlar atılır (satır 194–195; Bölüm 1.5). |
Aile içi akrabalık · akrabalik |
seçim · Model | yarim |
yarim, tam |
\sigma^2_A=\sigma^2_{aile}/r; r=0{,}25 ya da 0{,}5 (166). |
Varyans bileşeni kestirimi · kestirim |
seçim · Model | anova |
anova, reml |
İç içe ANOVA ya da lme4::lmer (325–339). |
FST kaynağı · fst_kaynak |
seçim · Model | marker |
marker, deger |
Belirteçlerden hesap ya da elle giriş (198, 239). |
FST (elle girişte) · fst_deger |
ondalık · Model | 0 | −0,5–0,99 | Elle girilen F_{ST} (240). |
FST %95 GA alt sınırı · fst_alt |
ondalık · Model | 0 | −0,5–0,99 | Alt ve üst 0 ise aralık yok sayılır (243). |
FST %95 GA üst sınırı · fst_ust |
ondalık · Model | 0 | −0,5–0,99 | Beta dağılımının ölçeği (250–254). |
Bootstrap tekrar sayısı · B |
tam sayı · Seçenekler | 1000 | 0–100000 | 0 ise yalnız nokta kestirimleri (345). |
Rastgele sayı tohumu · tohum |
tam sayı · Seçenekler | 2009 | 0–2147483647 | Her özellikten önce set.seed (347); 0 (ya da boş) ise kod panelindeki çalıştırma tohumu kullanılır, o da yoksa 2009 (satır 175). |
Anlamlılık düzeyi α · alfa |
ondalık · Seçenekler | 0,05 | 0,001–0,5 | Aralık kantilleri ve karar eşiği (191, 440). |
Çoklu test düzeltmesi · duzeltme |
seçim · Seçenekler | holm |
holm, BH, bonferroni, none |
İki yönlü p değerlerine p.adjust (439). |
FST yeniden örnekleme birimi · fst_bootstrap |
seçim · Gelişmiş | alel |
alel, lokus |
Bootstrap'ta yeniden çekilen birim (229). |
Aileler üzerinden yeniden örnekleme GA · aile_ornekleme |
onay · Gelişmiş | kapalı | açık / kapalı | Q_{ST} için ikinci bir aralık (401–423). |
Aile yeniden örnekleme aralığı yöntemi · aile_aralik |
seçim · Gelişmiş | yüzdelik | yüzdelik, temel (pivot) | Yalnız aile_ornekleme açıkken; temel yöntemde aralık [2Q_{ST}-q_{ust},\ 2Q_{ST}-q_{alt}] olarak ve [0{,}1] ile sınırlı verilir, yüzdelik sınırlar QST_alt_yuzdelik ve QST_ust_yuzdelik sütunlarında kalır (satır 181, 419–422). |
Örnek ayar (ornek_param, satır 9): üç özellik (boy, cicek_zamani, kok_orani), populasyon = pop, aile = aile, on gösterge (msat1–msat10), B = 1000. Öteki alanlar varsayılandadır; blok seçilmez.
Veri düzeni. Fenotip ve genotip aynı dosyadadır. Aynı bireylerde ikisi de ölçülmüş olabilir ya da, çoğu çalışmada olduğu gibi, döller ölçülmüş, ana ağaçlar ya da ayrı bir örneklem genotiplenmiştir. İkinci durumda döl satırlarının gösterge hücreleri, genotip satırlarının özellik (ve aile) hücreleri boş bırakılır; popülasyon sütunu bütün satırlarda doludur. Her özellik, o özelliği, popülasyonu ve ailesi (seçildiyse bloğu) dolu olan satırlarla çözümlenir (308); F_{ST}, en az bir göstergede genotipi ve popülasyonu olan satırlarla (204–205).
Genotip yazımı Bölüm 71'deki ortak ayrıştırıcıyla aynıdır (satır 194–195, ortak mq_genotip'a bağlıdır; Bölüm 1.5): metin genotip alel1/alel2, SNP için sayısal 0/1/2. Boş hücre, NA, na, 0, 00, 000, ?, -, . ve -9 eksik genotip sayılır; iki alel de eksik kodu olmalıdır (0/0, -9/-9). Alellerinden yalnız biri eksik kodu olan genotip (0/1) çalıştırmayı durdurur: 0 adlı gerçek bir alel varsa yeniden kodlanır. Okunan genotip sayısı ve eksik sayılanların dökümü konsola yazılır (mq_genotip_notu, 184); bu tasarımda ana ağaçlar ile döllerin hücreleri bilerek boş bırakıldığından boş hücreler de dökümde görünür. "Eksik genotip kodları" alanı doluysa bu liste yerine alandaki kodlar eksik sayılır (boş hücre ve NA her zaman eksik) ve yarı eksik genotip için durma kuralı yeni listeyle işler; VCF tarzı 0/1 kodlu veride alana yalnız . yazılınca 0 gerçek bir alel olarak okunur (satır 194–195).
Şablonun kendi denetimleri (çalıştırmayı durdurur).
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil; özellik, popülasyon ya da aile seçilmemiş | ilgili ileti | 140, 144–146 |
| ANOVA ile birlikte blok seçilmiş | "İç içe ANOVA yönteminde blok etkisi kullanılamaz; blok için REML'i seçin ya da bloğu boş bırakın." | 184–185 |
| Popülasyon, aile ve blok aynı sütun | "birbirinden farklı olmalı" | 187 |
| Bir sütun iki rolde (özellik ve gösterge gibi) | "… olarak da seçilemez" | 188–189 |
| Özellik sütunu sayısal türde değil | "'…' sayısal olmalı." | 190 |
fst_kaynak = marker iken gösterge yok |
"gösterge sütunları seçilmeli ya da FST kaynağı 'Elle girilen FST' yapılmalı" | 229 |
| Genotipi ve popülasyonu belli birey 4'ten az | "en az 4 birey gerekli" | 235 |
| Bir göstergede 899'dan çok alel; çok biçimli gösterge yok | ilgili ileti | 190, 194 |
| En az iki bireyli popülasyon 2'den az | "en az iki birey içeren en az iki popülasyon gerekli" | 244 |
| Elle F_{ST}\ge1; aralık alt\le F_{ST}\le üst ve alt<üst değil; aralıkla birlikte F_{ST}\le0; aralık beta için çok geniş | ilgili ileti | 224, 230, 231, 234 |
| Özellikte eksiksiz gözlem 6'dan az; tek popülasyon; hiçbir popülasyonda birden çok aile yok; her ailede tek döl; sabit özellik | ilgili ileti | 325–329 |
| REML modeli kestirilemedi | "model kestirilemedi: …" | 363 |
Uyarı ve notlar (durdurmaz): tek biçimli göstergeler çıkarılır (210); tek lokusla lokus birimi seçilmişse F_{ST} sabit kalır (232); elle girişte aralık yoksa "test liberaldir" uyarısı (245), aralık varsa beta yaklaşımı notu (255); negatif F_{ST} (262); tam kardeş seçeneği (302); Q_{ST} ve F_{ST} verilerindeki popülasyonlar farklıysa (321); negatif ANOVA bileşeni (330); REML'de sınırdaki bileşenler (336, 338); tanımsız Q_{ST} (342); 10'dan az popülasyon (343); geçersiz bootstrap tekrarları (383); p=0 (460).
86.3 Örnek veri
Dosya: _ornek/qst_fst_yapay.csv. Sabit tohumla üretilmiş yapay bir ortak bahçe denemesi; 1080 satır, 16 sütun. İlk 720 satır döllerdir (özellikler birkaç eksik ölçüm dışında dolu, göstergeler boş); son 360 satır genotiplenen bireylerdir (göstergeler dolu, aile, blok ve özellikler boş).
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
pop |
Popülasyon | kategorik (12 düzey) | P01–P12; popülasyon başına 44–79 döl ve 30 genotip satırı. |
aile |
Aile | kategorik | Popülasyon içinde A1, A2, …; popülasyon başına 8–12, toplam 114 yarım kardeş ailesi; aile başına 4–8 döl. |
blok |
kullanılmaz (REML denemesinde blok) | ikili (1, 2) | 371 ve 349 döl. |
boy |
Özellik | sayısal | 711 ölçüm; nötral sürüklenmeyle üretilmiş. |
cicek_zamani |
Özellik | sayısal | 702 ölçüm; çeşitlendirici seçilimle üretilmiş. |
kok_orani |
Özellik | sayısal | 704 ölçüm; tekdüzeleştirici seçilimle üretilmiş. |
msat1 … msat10 |
Göstergeler | kategorik (metin genotip) | Lokus başına 4–7 alel (toplam 57), 345–353 genotip; en az bir lokusu dolu 360 birey. |
Aile adları popülasyonlar arasında yinelenir (her popülasyonda bir A1 vardır); şablon aileyi popülasyon adıyla birleştirerek ayırır (311). Popülasyon düzeyleri şablon içinde ada göre sıralanır; sıra hiçbir sonucu etkilemez. İç içe ANOVA seçeneğinde bütün sonuçlar verinin satır sırasından bağımsızdır (karıştırılmış satırlarla fark 0); REML seçeneğinde bootstrap çekimleri satır sırasıyla eşlendiği için aralıklar ve p değerleri satır sırasıyla değişir (86.8).
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar; (2) tohum = 1; (3) fst_bootstrap = lokus; (4) akrabalik = tam, alfa = 0,10, duzeltme = BH; (5) elle F_{ST}=0{,}0983 ve aralık 0,0869–0,1108; (6) aynı F_{ST}, aralıksız; (7) REML, bloksuz, B = 0; (8) REML, blok = blok, B = 200; (9) aile_ornekleme açık, B = 500; (10) sınır ve yazım denemeleri için türetilmiş veriler (karıştırılmış satırlar, -9/-9 eksik kodu, 0 adlı alel, sayı kimlikli popülasyon ve aileler, popülasyon varyansı olmayan bir özellik).
86.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) belirteçlerden Weir–Cockerham bileşenleri ve F_{ST} (ya da elle giriş); (2) her özellik için varyans bileşenleri, \sigma^2_A ve Q_{ST}; (3) her özellikte tohum yeniden kurulur ve B tekrar yapılır: her tekrarda F_{ST} yeniden örneklenir, nötral modelden bir Q_{ST} ve gözlenen modelden bir Q_{ST} çekilir; (4) p değerleri, aralıklar, çoklu test düzeltmesi ve karar; (5) tablolar ve her özellik için bir şekil.
86.4.1 Q_{ST} ve aile tasarımı
Yarım kardeş ailelerinde (aynı ana, farklı babalar) aile üyeleri eklemeli genetik varyansın dörtte birini paylaşır; tam kardeşlerde yarısını:
- \sigma^2_{aile}: popülasyon içinde aileler arası varyans bileşeni.
- r: aile içi eklemeli akrabalık; yarım kardeşte Q_{ST}=\sigma^2_{pop}/(\sigma^2_{pop}+8\sigma^2_{aile}).
Neden paydada 2\sigma^2_A?
Diploit bir türde, nötral ve eklemeli bir özellikte popülasyonlar arası genetik varyansın beklenen değeri 2F_{ST}\sigma^2_{A,0}, popülasyon içi eklemeli varyansınki (1-F_{ST})\sigma^2_{A,0}'dır (\sigma^2_{A,0} atasal popülasyondaki varyans). Oran \sigma^2_{pop}/(\sigma^2_{pop}+2\sigma^2_A) kurulduğunda \sigma^2_{A,0} sadeleşir ve geriye F_{ST} kalır. Çarpan 2, bu eşitliği sağlayan çarpandır; onsuz oran nötral özellikte F_{ST}'ye eşit olmaz.
Tam kardeş seçeneği
Tam kardeş ailelerinde aile varyansı eklemeli payın yanında baskınlık varyansının dörtte birini ve ortak ana/çevre etkisini de taşır. \sigma^2_A=2\sigma^2_{aile} bu yüzden fazla, Q_{ST} düşük kestirilir ve tekdüzeleştirici seçilim yanlışlıkla bulunabilir (Whitlock, 2008). Şablon seçenek kullanıldığında bunu not olarak yazar (302). Yarım kardeş ailelerinde de ana etkisi (tohum ağırlığı) aile varyansını şişirebilir; etkinin beklendiği özelliklerde sonuç temkinle okunur.
86.4.2 İç içe ANOVA ile varyans bileşenleri
Model y_{ijk}=\mu+P_i+A_{ij}+e_{ijk}: P_i popülasyon, A_{ij} popülasyon içinde aile, e_{ijk} aile içi artıktır. Üç ortalama kare ve dengesiz desendeki beklenen değerleri:
- n_{ij}: i. popülasyonun j. ailesindeki döl sayısı; n_{i\cdot} popülasyonun toplam döl sayısı; N toplam.
- p: popülasyon sayısı; a: toplam aile sayısı. Serbestlik dereceleri p-1, a-p, N-a.
- Dengeli desende (n döl, popülasyon başına f aile) n_0=n_0'=n ve n_{b0}=nf.
Bileşenler beklenen değerlerin çözümünden gelir:
Neden üç ayrı katsayı?
Aile büyüklükleri eşit değilken bir ortalama karenin içindeki aile varyansı payı, o karenin hangi düzeyde hesaplandığına göre değişir: aileler arası karede n_0, popülasyonlar arası karede n_0'. İkisi yalnız dengeli desende eşittir. Tek bir "ortalama aile büyüklüğü" kullanmak \hat\sigma^2_{pop}'u yanlı yapar; Sokal ve Rohlf'un (1995) katsayıları bu yanlılığı giderir (Gilbert ve Whitlock, 2015).
Koddaki tercih
anova_ks (satır 267–277) kareler toplamlarını grup toplamlarından kurar (\sum T^2/n biçimi), katsayıları yukarıdaki formüllerle hesaplar. qst_ks (278–283) bileşenleri çözer. Kestirimler kırpılmaz: KO_{aile}<KO_{artık} ise \hat\sigma^2_{aile}<0, KO_{pop} küçükse \hat\sigma^2_{pop}<0 olur ve Q_{ST} [0{,}1] aralığının dışına çıkabilir; şablon bu durumda uyarır (330). ANOVA kipinde blok etkisi modele alınamaz; blok seçilmişse çalıştırma durur (184).
86.4.3 REML ile kestirim
kestirim = reml seçildiğinde aynı model kısıtlı en çok olabilirlikle kestirilir: popülasyon ve aile rastgele, blok (seçildiyse ve birden çok düzeyi varsa) sabit etkidir.
- \beta_b: blok etkisi (sabit); blok seçilmediyse yoktur.
- REML bileşenleri sıfırın altına inemez; \hat\sigma^2_{pop}=0 iken Q_{ST}=0, \hat\sigma^2_{aile}=0 iken \sigma^2_A=0 ve Q_{ST}=1 (ya da tanımsız) olur.
Koddaki tercih
Model lme4::lmer(y ~ [blok +] (1 | pop) + (1 | fam), REML = TRUE) ile kurulur (satır 290–293); fam, popülasyon ve aile adının birleşimidir. Bileşenler VarCorr'dan okunur (284–289). lme4'ün uyarı ve iletileri gizlenir (suppressWarnings, suppressMessages); yakınsama uyarısı çıktıda görünmez. Sınırdaki bileşenler için şablon kendi notunu yazar: aile varyansı sıfıra yakınsa "nötral dağılım anlamsız" (336), popülasyon varyansı sıfırsa "QST = 0" (338). Dengeli desende ANOVA ve REML aynı kestirimi verir (bileşenler pozitifse); dengesiz desende farklıdır: örnek veride boy için Q_{ST} 0,0705 (ANOVA) ve 0,0766'dır (REML).
86.4.4 F_{ST}: belirteçlerden ya da elle
Belirteçlerden. Her alel için Weir ve Cockerham'ın (1984) üç varyans bileşeni (a: popülasyonlar arası, b: popülasyon içinde bireyler arası, c: birey içi) hesaplanır ve
alınır; toplam bütün lokusların bütün alelleri üzerindendir. Bileşenlerin formülleri ve gerekçesi Bölüm 71.4.1'dedir. Hesap hierfstat::wc ile yapılır (satır 221); şablon alel adlarını lokus içinde sıralı tam sayı kodlarına çevirir (207, 217–220).
Elle giriş. Belirteç verisi yoksa F_{ST} ve %95 güven aralığı forma yazılır. Bootstrap'ta F_{ST}'nin örnekleme dağılımı, ortalaması ve varyansı girilen değerlerle eşleşen bir beta dağılımıyla temsil edilir:
- z_{0{,}975}=1{,}959964; payda 3,92'dir. Girilen aralığın %95 aralık olduğu varsayılır;
alfabu hesabı değiştirmez. - \kappa: beta dağılımının yoğunlaşma parametresi; \kappa\le0 ise (aralık çok geniş) çalıştırma durur.
Neden beta, neden yalnız belirteç yokken?
F_{ST} bir orandır; normal yaklaşım küçük F_{ST}'de sıfırın altına taşan değerler üretir, beta üretmez. Ancak bu, şablonun pratik bir varsayımıdır; yayımlanmış bir yöntem değildir ve şablon bunu çıktıda açıkça yazar (255). Belirteç verisi varken F_{ST}'nin kendi verisinden yeniden örneklenmesi tercih edilir, çünkü lokuslar arası gerçek değişkenliği taşır. Aralık girilmezse F_{ST} sabit tutulur ve test, F_{ST}'nin belirsizliğini yok saydığı için liberaldir (245).
86.4.5 Nötrallik testi: parametrik bootstrap
Nötral bir özellikte beklenen popülasyon varyansı, gözlenen F_{ST} ve \sigma^2_A'dan hesaplanır (Lewontin–Krakauer beklentisi):
Her k=1,\dots,B tekrarında üç ortalama kare, kendi serbestlik derecesiyle ölçeklenmiş \chi^2 çekimleriyle yenilenir ve nötral bir Q_{ST} hesaplanır; aynı tekrarda F_{ST} de yeniden örneklenir:
- Q^{*}_{ST,N}: yenilenmiş üç ortalama kareden 86.4.2'deki çözümle hesaplanan Q_{ST}.
- F^{*}_{ST}:
alelbiriminde alel başına (a,b,c) üçlüleri,lokusbiriminde lokus toplamları yerine koyarak yeniden çekilir ve \sum a/\sum(a+b+c) yeniden kurulur. - p_{üst} küçükse gözlenen fark nötral dağılımın üst kuyruğundadır (Q_{ST}>F_{ST}); p_{alt} küçükse alt kuyruğundadır.
Neden fark, neden iki ayrı belirsizlik?
\hat Q_{ST}'nin örnekleme dağılımı çok geniş ve çarpıktır: popülasyon varyansı yalnız p-1 serbestlik derecesiyle kestirilir. \hat F_{ST} de bir kestirimdir. İki kestirimin doğrudan karşılaştırılması ya da güven aralıklarının örtüşmesine bakılması, nötral bir özellikte bile sık sık "fark var" sonucu verir. Whitlock ve Guillaume'un (2009) yöntemi sorunun kendisini benzetir: "özellik nötral olsaydı, bu tasarımla ve bu F_{ST} belirsizliğiyle Q_{ST}-F_{ST} ne kadar oynardı?" Gözlenen fark bu dağılımla karşılaştırılır.
Koddaki tercih
Döngü satır 362–379'dadır. Her tekrarda sırayla: fst_cek() (bir sample çağrısı), nötral Q_{ST} için üç rchisq, güven aralığı için üç rchisq daha (86.4.6). REML kipinde \chi^2 çekimleri yerine modelden veri benzetilir: kestirilen sabit etkilere, N(0,\sigma^2_{pop,N}) popülasyon etkileri, N(0,\hat\sigma^2_{aile}) aile etkileri ve N(0,\hat\sigma^2_e) artıklar eklenir, model lme4::refit ile yeniden kestirilir (353–357); \sigma^2_{pop,N} negatifse 0 alınır (352). Q^{*}_{ST,N} tanımsız olan ya da modeli kestirilemeyen tekrarlar atılır ve sayısı yazılır (382–384). p değerleri toleranslı sayılır (389–393): |D^{*}-D|\le10^{-8} olan tekrarlar iki kuyruğa da girer ve sayıları yazılır. ANOVA kipinde eşitlik olmaz; REML kipinde gözlenen Q_{ST} sınırda (0) ve F_{ST} sabitken nötral tekrarların kestirimi de sınırda kalır ve D^{*}=D olur (86.8). Ardından düzeltilmiş p değerinin Monte Carlo hatasına bakılır: p_{iki}'nin standart hatası 2\sqrt{\hat p(1-\hat p)/B} (\hat p=\min(p_{alt},p_{ust})) alınır, p_{iki}\pm2 SH aralığı aynı düzeltmeden geçirilir ve aralık \alpha'yı kesen özellikler için "karar Monte Carlo hatasına duyarlı" uyarısı yazılır (453–459).
Tohum. Bu şablonun kendi tohum alanı vardır (tohum, varsayılan 2009; 0 ya da boş verilirse kod panelindeki çalıştırma tohumu, o da yoksa 2009 kullanılır, satır 175). set.seed(tohum) her özelliğin döngüsünden hemen önce çağrılır (347); bu yüzden aynı ayarla her çalıştırma aynı sonucu verir ve MerQuR+'ın çalıştırmaya atadığı tohum (Bölüm 57) alan varsayılanında kalırken bu şablonda sonucu etkilemez. Tohumun her özellikte yeniden kurulmasının bir sonucu daha vardır: özelliklerin F^{*}_{ST} çekimleri aynı noktadan başlar; örnek veride üç özelliğin F_{ST} aralığı son basamağına kadar aynıdır.
86.4.6 Güven aralıkları
Q_{ST}'nin aralığı da parametrik bootstrap'tır (O'Hara ve Merilä, 2005): her tekrarda üç ortalama kare bu kez gözlenen değerleri çevresinde yenilenir (KO^{*}_{pop}=KO_{pop}\,\chi^2_{p-1}/(p-1)), Q^{*}_{ST} ve \sigma^{2*}_A hesaplanır; aralık B değerin \alpha/2 ve 1-\alpha/2 kantilleridir. \sigma^2_A aralığında negatif değerler 0'a çekilir (380); Q_{ST} aralığında kırpma yoktur. F_{ST} aralığı F^{*}_{ST} değerlerinin aynı kantilleridir; "nötral aralık" (notr_alt, notr_ust) D^{*}'ın kantilleridir.
aile_ornekleme açıkken ikinci bir Q_{ST} aralığı eklenir: her popülasyonda aileler yerine koyarak yeniden çekilir (seçilen her aile bütün dölleriyle gelir, iki kez seçilen aile iki ayrı aile sayılır), Q_{ST} yeniden kestirilir, yüzdelik aralığı alınır (401–423). Popülasyonlar sabit tutulur; bu aralık popülasyonların örneklenmesinden gelen belirsizliği içermez ve örnek veride nokta kestirimine göre yukarı kaymıştır (86.9 S8). Şablon, varsayılan yüzdelik aralıkta bu yanlılığı ve yanlılık düzeltmesi yapılmadığını aralık tablosunun altına not olarak yazar (448–449). aile_aralik = temel seçilirse aynı yeniden örneklemeden yanlılık düzeltmeli (temel, pivot) aralık verilir: alt sınır 2Q_{ST} eksi üst yüzdelik, üst sınır 2Q_{ST} eksi alt yüzdelik; [0{,}1] dışına taşan sınır 0 ya da 1'e çekilir ve bunu söyleyen not yazılır (446–447).
86.4.7 Çoklu test düzeltmesi ve karar
Birden çok özellik varsa iki yönlü p değerleri seçilen yöntemle düzeltilir (stats::p.adjust; satır 439). Holm yönteminde m değer küçükten büyüğe sıralanır, i. değer (m-i+1) ile çarpılır ve dizinin azalmaması sağlanır. Karar sütunu şu kuralla yazılır (440–441):
| Koşul | Karar |
|---|---|
| p_{düz}<\alpha ve p_{üst}<p_{alt} | "QST > FST (çeşitlendirici seçilim)" |
| p_{düz}<\alpha ve p_{üst}\ge p_{alt} | "QST < FST (tekdüzeleştirici seçilim)" |
| p_{düz}\ge\alpha | "nötral beklentiden ayrılmıyor" |
Düzeltmeye yalnız testi tamamlanan özellikler girer. Özellikler genetik olarak ilişkili olabildiğinden testler bağımsız değildir; şablon düzeltmenin yaklaşık olduğunu not eder (450).
86.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–152 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on sekiz parametre. | Form buradan kurulur (Bölüm 1.2). |
| 153–191 | Parametreler okunur ve denetlenir; rol çakışmaları; kantil sınırları. | Boş alan varsayılanına döner (bos, 138). |
| 193–195 | Ortak genotip ayrıştırıcısı (mq_genotip'a bağlanır). |
Eksik kodları mq_genotip_eksik'tedir (0 ve -9 dahil; 176). |
| 197–238 | Belirteçlerden F_{ST}: ayrıştırma, tek biçimli lokusların atılması, kodlama, wc, alel ve lokus bileşen tabloları, fst_cek. |
Genel F_{ST} alel bileşenlerinden (228); yeniden örnekleme birimi 211. |
| 239–263 | Elle F_{ST}: sabit ya da beta çekimi. | Aralık (0, 0) ise sabit (243–244). |
| 265–295 | Yardımcılar: anova_ks, qst_ks, reml_bil, reml_kur, kantil fonksiyonu. |
Kantil, sonlu değer sayısı 2'den azsa boş döner (295). |
| 297–345 | Özellik döngüsü: eksiksiz satırlar, aile kimliği, veri denetimleri, nokta kestirimleri, notlar. | ANOVA tablosu her kipte hesaplanır (324), yalnız ANOVA kipinde yazılır. |
| 346–400 | Parametrik bootstrap, p değerleri, aralıklar. | set.seed(tohum) (347). |
| 401–423 | İsteğe bağlı aile yeniden örneklemesi. | Rastgele akış, parametrik döngünün bittiği yerden sürer. |
| 426–460 | Tablolar, düzeltme, karar, notlar. | Hiçbir özellikte Q_{ST} kestirilemediyse durur (427). |
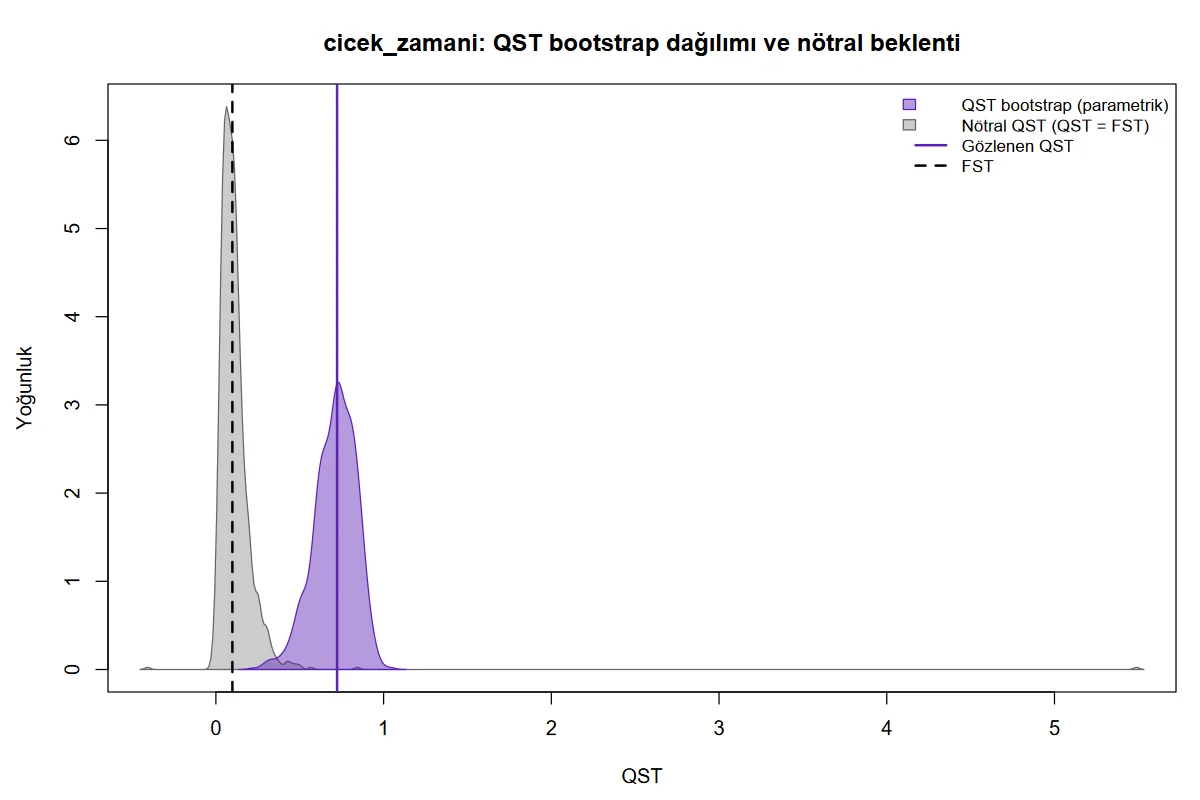
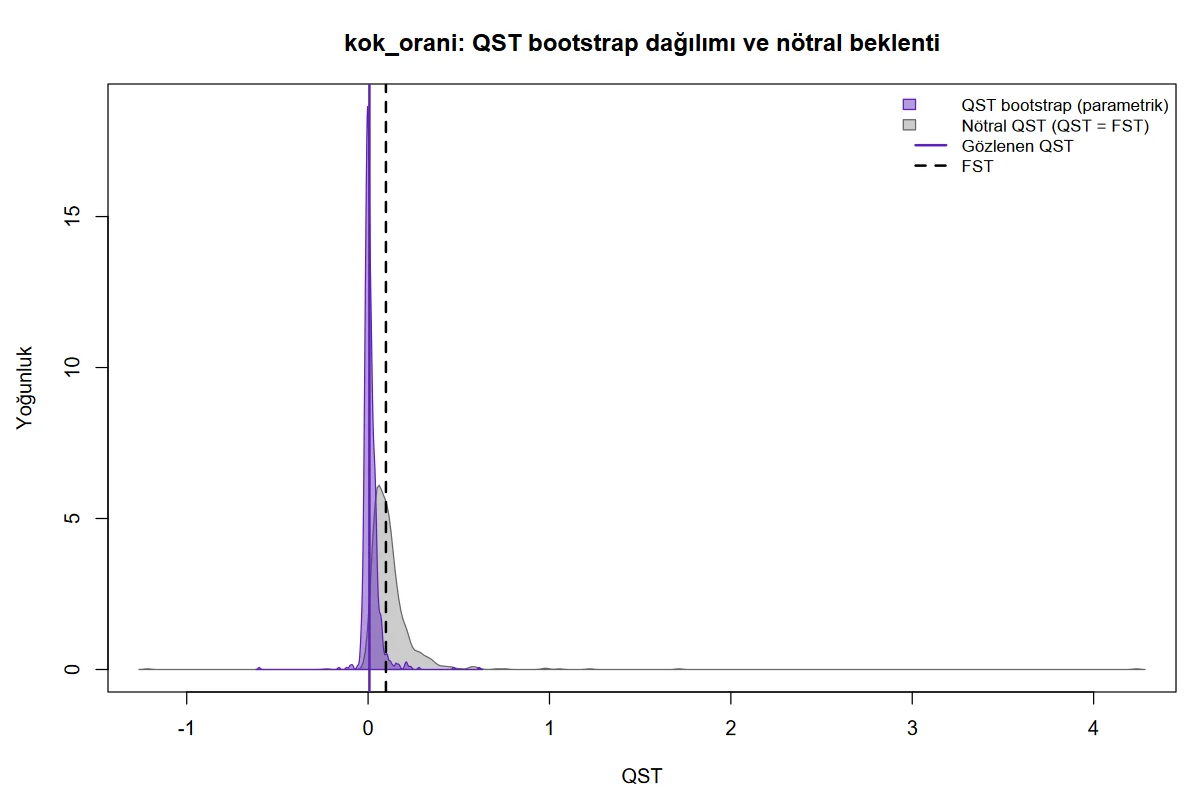
| 461–480 | Her özellik için yoğunluk grafiği (en çok 12 özellik). | Mor: Q_{ST} bootstrap dağılımı; gri: nötral Q_{ST}; düz çizgi gözlenen Q_{ST}, kesikli çizgi F_{ST}. |
86.6 Elle hesap: örnek veride bağımsız yeniden hesap
Python tarafında (dogrulama/qst_fst/elle_hesap.py) ortalama kareler grup ortalamalarından sapmaların kareleriyle, katsayılar 86.4.2'deki formüllerle, F_{ST} gamet göstergelerinin varyans çözümlemesi biçimiyle, REML açık kısıtlı olabilirliğin eniyilenmesiyle hesaplanmıştır. R tarafında (r_dogrulama.R) ortalama kareler lm ve anova ile, katsayılar formül kullanılmadan sentez yöntemiyle (Hartley, 1967: her rastgele etki sütununun ortalama karelere katkısı), F_{ST} Weir–Cockerham'ın formül biçimiyle, REML nlme::lme ile, bootstrap aynı tohum ve çekiliş sırasıyla (ama \chi^2 yerine gamma çekimleri ve ayrı yazılmış cebirle) kurulmuştur.
Adım 1 — F_{ST}. On lokusun 57 alelinin bileşen toplamları \sum a=0{,}660096, \sum b=-0{,}077343, \sum c=6{,}130676:
Lokus değerleri 0,0714 (msat4) ile 0,1185 (msat6) arasındadır.
Adım 2 — Boy için ortalama kareler ve katsayılar. N=711 döl, p=12 popülasyon, a=114 aile; serbestlik dereceleri 11, 102 ve 597.
| KO | sd | Katsayılar | |
|---|---|---|---|
| Popülasyon | 95,643479 | 11 | n_0'=6{,}523492, n_{b0}=59{,}015727 |
| Aile (popülasyon içinde) | 23,214905 | 102 | n_0=6{,}202418 |
| Artık | 10,783011 | 597 |
Adım 3 — Bileşenler ve Q_{ST}.
Çiçeklenme zamanında \hat\sigma^2_{pop}=20{,}910, \hat\sigma^2_A=4{,}014 ve Q_{ST}=0{,}722585; kök oranında 0{,}0494, 3{,}378 ve 0{,}007262'dir.
Adım 4 — Nötral beklenti (boy).
Gözlenen KO_{pop}=95{,}64 bu değerin altındadır; gözlenen fark D=0{,}070509-0{,}098325=-0{,}027816.
Adım 5 — Bootstrap (tohum 2009, B=1000). R'deki bağımsız döngü şablonla aynı sayıları üretir. Boy için nötral D^{*} değerlerinin %2,5 ve %97,5 kantilleri -0{,}0786 ve 0{,}1277'dir; 1000 tekrarın 676'sında D^{*}>D, 324'ünde D^{*}<D: p_{üst}=0{,}676, p_{alt}=0{,}324, p_{iki}=0{,}648. Çiçeklenme zamanında D=0{,}6243, nötral üst sınır 0{,}2098; yalnız iki tekrar gözleneni aşar: p_{üst}=0{,}002, p_{iki}=0{,}004. Kök oranında D=-0{,}0911, p_{alt}=0{,}021, p_{iki}=0{,}042.
Adım 6 — Holm düzeltmesi. Sıralı değerler 0,004; 0,042; 0,648. 0{,}004\cdot3=0{,}012; 0{,}042\cdot2=0{,}084; 0{,}648\cdot1=0{,}648. Yalnız çiçeklenme zamanı \alpha=0{,}05'in altındadır.
Adım 7 — Büyük bağımsız Monte Carlo. Python'da başka bir rastgele sayı üreteciyle 400 000 tekrar yapılmıştır; bu sayıda p değerlerinin Monte Carlo standart hatası 10^{-3}'ün altındadır. Sonuçlar: boy p_{iki}=0{,}638; çiçeklenme zamanı p_{iki}=0{,}0064; kök oranı p_{iki}=0{,}0546. F_{ST} aralığı 0{,}0873–0{,}1096 (şablon, B=1000: 0{,}0869–0{,}1108). Şablonun 1000 tekrarlı değerleri bu "sınırsız B" değerlerinin çevresinde, B=1000'in izin verdiği oynamayla durur (86.8).
Adım 8 — REML. Bloksuz modelde boy için \hat\sigma^2_{pop}=1{,}3265, \hat\sigma^2_{aile}=1{,}9999, \hat\sigma^2_e=10{,}8009 ve Q_{ST}=0{,}0766; blok sabit etkisiyle 1{,}3076; 1{,}8088; 10{,}0949 ve 0{,}0829. Blok artık varyansı küçültür (10,80'den 10,09'a).
Adım 9 — Elle girilen F_{ST}. F_{ST}=0{,}0983, aralık 0{,}0869–0{,}1108: SH=0{,}0239/3{,}919928=0{,}006097; \kappa=0{,}0983\cdot0{,}9017/0{,}006097^2-1=2383{,}38; beta parametreleri 234{,}29 ve 2149{,}10. Bu dağılımın %2,5 ve %97,5 kantilleri 0{,}0867 ve 0{,}1106'dır; girilen aralığı yeniden verir.
86.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle okunmuştur (çalıştırmalar 1–8). Bootstrap satırlarında Python sütunu boştur: şablonun rastgele akışı (\chi^2 çekimleri) Python'da yeniden kurulmamış, onun yerine Adım 7'deki bağımsız Monte Carlo yapılmıştır.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Genel F_{ST} | 0,09832465 | 0,09832465 | 0,09832465 | 1,4e−17 | ✓ |
| msat1: F_{ST} | 0,11785996 | 0,11785996 | 0,11785996 | 1,0e−15 | ✓ |
| msat4: F_{ST} | 0,07136004 | 0,07136004 | 0,07136004 | 1,4e−17 | ✓ |
| Boy: KO_{pop} | 95,64347886 | 95,64347886 | 95,64347886 | 6,6e−14 | ✓ |
| Boy: KO_{aile} | 23,21490519 | 23,21490519 | 23,21490519 | 1,9e−14 | ✓ |
| Boy: KO_{artık} | 10,78301144 | 10,78301144 | 10,78301144 | 1,9e−14 | ✓ |
| Boy: n_0' | 6,52349171 | 6,52349171 | 6,52349171 | 7,6e−15 | ✓ |
| Boy: n_0 | 6,20241818 | 6,20241818 | 6,20241818 | 1,6e−15 | ✓ |
| Boy: n_{b0} | 59,01572689 | 59,01572689 | 59,01572689 | 6,7e−15 | ✓ |
| Boy: \hat\sigma^2_{pop} | 1,21637112 | 1,21637112 | 1,21637112 | 9,9e−14 | ✓ |
| Boy: \hat\sigma^2_{aile} | 2,00436239 | 2,00436239 | 2,00436239 | 2,5e−14 | ✓ |
| Boy: \hat\sigma^2_A | 8,01744958 | 8,01744958 | 8,01744958 | 2,5e−14 | ✓ |
| Boy: Q_{ST} | 0,07050908 | 0,07050908 | 0,07050908 | 7,8e−15 | ✓ |
| Çiçeklenme: KO_{pop} | 1235,65399219 | 1235,65399219 | 1235,65399219 | 1,5e−13 | ✓ |
| Çiçeklenme: KO_{aile} | 16,83994538 | 16,83994538 | 16,83994538 | 2,3e−13 | ✓ |
| Çiçeklenme: KO_{artık} | 10,69490734 | 10,69490734 | 10,69490734 | 1,8e−13 | ✓ |
| Çiçeklenme: n_0' | 6,442474 | 6,442474 | 6,442474 | 4,5e−15 | ✓ |
| Çiçeklenme: n_0 | 6,12375308 | 6,12375308 | 6,12375308 | 1,6e−15 | ✓ |
| Çiçeklenme: n_{b0} | 58,27298627 | 58,27298627 | 58,27298627 | 6,1e−16 | ✓ |
| Çiçeklenme: \hat\sigma^2_{pop} | 20,91010425 | 20,91010425 | 20,91010425 | 1,4e−13 | ✓ |
| Çiçeklenme: \hat\sigma^2_{aile} | 1,0034758 | 1,0034758 | 1,0034758 | 9,4e−13 | ✓ |
| Çiçeklenme: \hat\sigma^2_A | 4,01390321 | 4,01390321 | 4,01390321 | 9,4e−13 | ✓ |
| Çiçeklenme: Q_{ST} | 0,72258514 | 0,72258514 | 0,72258514 | 1,6e−13 | ✓ |
| Kök oranı: KO_{pop} | 19,20936932 | 19,20936932 | 19,20936932 | 3,8e−13 | ✓ |
| Kök oranı: KO_{aile} | 16,03327414 | 16,03327414 | 16,03327414 | 1,0e−14 | ✓ |
| Kök oranı: KO_{artık} | 10,84971176 | 10,84971176 | 10,84971176 | 9,2e−15 | ✓ |
| Kök oranı: n_0' | 6,48174144 | 6,48174144 | 6,48174144 | 1,2e−14 | ✓ |
| Kök oranı: n_0 | 6,13858336 | 6,13858336 | 6,13858336 | 1,7e−15 | ✓ |
| Kök oranı: n_{b0} | 58,41193182 | 58,41193182 | 58,41193182 | 6,8e−15 | ✓ |
| Kök oranı: \hat\sigma^2_{pop} | 0,04941327 | 0,04941327 | 0,04941327 | 1,3e−13 | ✓ |
| Kök oranı: \hat\sigma^2_{aile} | 0,84442323 | 0,84442323 | 0,84442323 | 3,0e−14 | ✓ |
| Kök oranı: \hat\sigma^2_A | 3,37769291 | 3,37769291 | 3,37769291 | 3,3e−14 | ✓ |
| Kök oranı: Q_{ST} | 0,00726153 | 0,00726153 | 0,00726153 | 1,9e−14 | ✓ |
| F_{ST} bootstrap alt (%95; alel) | 0,08686096 | — | 0,08686096 | 0 | ✓ |
| F_{ST} bootstrap üst | 0,11075583 | — | 0,11075583 | 0 | ✓ |
| Boy: Q_{ST} alt | 0,01057173 | — | 0,01057173 | 2,8e−15 | ✓ |
| Boy: Q_{ST} üst | 0,18695968 | — | 0,18695968 | 1,5e−14 | ✓ |
| Boy: nötral Q_{ST}-F_{ST} alt | −0,07860216 | — | −0,07860216 | 9,7e−17 | ✓ |
| Boy: nötral Q_{ST}-F_{ST} üst | 0,12767174 | — | 0,12767174 | 1,0e−15 | ✓ |
| Boy: p_{alt} | 0,324 | — | 0,324 | 0 | ✓ |
| Boy: p_{üst} | 0,676 | — | 0,676 | 0 | ✓ |
| Boy: p_{iki} | 0,648 | — | 0,648 | 0 | ✓ |
| Boy: Holm p | 0,648 | — | 0,648 | 0 | ✓ |
| Boy: \sigma^2_A alt | 4,09659857 | — | 4,09659857 | 1,7e−14 | ✓ |
| Boy: \sigma^2_A üst | 12,47361758 | — | 12,47361758 | 2,4e−14 | ✓ |
| Boy: nötral Q_{ST} ortalaması | 0,10166146 | — | 0,10166146 | 0 | ✓ |
| Çiçeklenme: Q_{ST} alt | 0,44033831 | — | 0,44033831 | 2,1e−13 | ✓ |
| Çiçeklenme: Q_{ST} üst | 0,91178891 | — | 0,91178891 | 2,1e−13 | ✓ |
| Çiçeklenme: nötral Q_{ST}-F_{ST} alt | −0,08642752 | — | −0,08642752 | 1,7e−14 | ✓ |
| Çiçeklenme: nötral Q_{ST}-F_{ST} üst | 0,2097556 | — | 0,2097556 | 1,7e−13 | ✓ |
| Çiçeklenme: p_{alt} | 0,998 | — | 0,998 | 0 | ✓ |
| Çiçeklenme: p_{üst} | 0,002 | — | 0,002 | 0 | ✓ |
| Çiçeklenme: p_{iki} | 0,004 | — | 0,004 | 0 | ✓ |
| Çiçeklenme: Holm p | 0,012 | — | 0,012 | 0 | ✓ |
| Çiçeklenme: \sigma^2_A alt | 1,0911978 | — | 1,0911978 | 3,0e−12 | ✓ |
| Çiçeklenme: \sigma^2_A üst | 7,43808566 | — | 7,43808566 | 5,8e−13 | ✓ |
| Çiçeklenme: nötral Q_{ST} ortalaması | 0,11599705 | — | 0,11599705 | 2,1e−13 | ✓ |
| Kök oranı: Q_{ST} alt | −0,03142145 | — | −0,03142145 | 4,5e−15 | ✓ |
| Kök oranı: Q_{ST} üst | 0,10616763 | — | 0,10616763 | 1,2e−13 | ✓ |
| Kök oranı: nötral Q_{ST}-F_{ST} alt | −0,09019005 | — | −0,09019005 | 4,0e−16 | ✓ |
| Kök oranı: nötral Q_{ST}-F_{ST} üst | 0,2825185 | — | 0,2825185 | 2,1e−14 | ✓ |
| Kök oranı: p_{alt} | 0,021 | — | 0,021 | 0 | ✓ |
| Kök oranı: p_{üst} | 0,979 | — | 0,979 | 0 | ✓ |
| Kök oranı: p_{iki} | 0,042 | — | 0,042 | 0 | ✓ |
| Kök oranı: Holm p | 0,084 | — | 0,084 | 0 | ✓ |
| Kök oranı: \sigma^2_A alt | 0,57626651 | — | 0,57626651 | 1,0e−13 | ✓ |
| Kök oranı: \sigma^2_A üst | 6,66121847 | — | 6,66121847 | 2,0e−14 | ✓ |
| Kök oranı: nötral Q_{ST} ortalaması | 0,12322376 | — | 0,12322376 | 9,0e−15 | ✓ |
| Lokus birimi: F_{ST} alt | 0,08816674 | — | 0,08816674 | 9,7e−17 | ✓ |
| Lokus birimi: F_{ST} üst | 0,10780639 | — | 0,10780639 | 0 | ✓ |
| Lokus birimi: kök oranı p_{iki} | 0,058 | — | 0,058 | 0 | ✓ |
| Tohum 1: çiçeklenme p_{iki} | 0,02 | — | 0,02 | 0 | ✓ |
| Tohum 1: çiçeklenme nötral üst | 0,30661508 | — | 0,30661508 | 5,5e−13 | ✓ |
| Tam kardeş: boy Q_{ST} | 0,13172999 | 0,13172999 | 0,13172999 | 1,3e−14 | ✓ |
| Tam kardeş: boy Q_{ST} alt (%90) | 0,03249584 | — | 0,03249584 | 6,9e−15 | ✓ |
| Tam kardeş: kök oranı Benjamini–Hochberg p | 0,339 | — | 0,339 | 0 | ✓ |
| Elle F_{ST} + aralık: F_{ST} alt (beta) | 0,08634313 | — | 0,08634313 | 0 | ✓ |
| Elle F_{ST} + aralık: F_{ST} üst (beta) | 0,11139317 | — | 0,11139317 | 0 | ✓ |
| Elle F_{ST} + aralık: çiçeklenme p_{iki} | 0,01 | — | 0,01 | 0 | ✓ |
| Elle F_{ST}, sabit: kök oranı p_{iki} | 0,04 | — | 0,04 | 0 | ✓ |
| REML, boy: \hat\sigma^2_{pop} | 1,32653849 | 1,32653587 | 1,32657401 | 2,7e−5 | ✗ |
| REML, boy: \hat\sigma^2_{aile} | 1,99993573 | 1,99995053 | 1,99994878 | 7,4e−6 | ✗ |
| REML, boy: \hat\sigma^2_{artık} | 10,80094967 | 10,80094425 | 10,80093989 | 9,1e−7 | ✓ |
| REML, boy: Q_{ST} | 0,07656335 | 0,07656269 | 0,07656478 | 1,4e−6 | ✗ |
| REML, çiçeklenme: \hat\sigma^2_{pop} | 20,98549465 | 20,98358416 | 20,98448905 | 9,1e−5 | ✗ |
| REML, çiçeklenme: \hat\sigma^2_{aile} | 1,01309923 | 1,01308806 | 1,01307234 | 2,7e−5 | ✗ |
| REML, çiçeklenme: \hat\sigma^2_{artık} | 10,68729066 | 10,68731318 | 10,68731525 | 2,3e−6 | ✗ |
| REML, çiçeklenme: Q_{ST} | 0,72139177 | 0,72137569 | 0,72138747 | 1,6e−5 | ✗ |
| REML, kök oranı: \hat\sigma^2_{pop} | 0,03640466 | 0,03640493 | 0,03640795 | 3,3e−6 | ✗ |
| REML, kök oranı: \hat\sigma^2_{aile} | 0,8652083 | 0,86520773 | 0,8652065 | 1,8e−6 | ✗ |
| REML, kök oranı: \hat\sigma^2_{artık} | 10,83948496 | 10,83948633 | 10,83948434 | 1,3e−7 | ✓ |
| REML, kök oranı: Q_{ST} | 0,005232 | 0,00523205 | 0,00523249 | 4,8e−7 | ✓ |
| REML + blok, boy: \hat\sigma^2_{pop} | 1,30761105 | 1,30759428 | 1,30771049 | 7,6e−5 | ✗ |
| REML + blok, boy: \hat\sigma^2_{aile} | 1,80884797 | 1,80884997 | 1,80886688 | 1,0e−5 | ✗ |
| REML + blok, boy: \hat\sigma^2_{artık} | 10,0948813 | 10,09488276 | 10,0948623 | 1,9e−6 | ✗ |
| REML + blok, boy: Q_{ST} | 0,08287352 | 0,08287246 | 0,0828785 | 5,0e−6 | ✗ |
| REML + blok, çiçeklenme: \hat\sigma^2_{pop} | 21,1637342 | 21,16380553 | 21,16318553 | 2,6e−5 | ✗ |
| REML + blok, çiçeklenme: \hat\sigma^2_{aile} | 1,217026 | 1,21702415 | 1,21686059 | 1,4e−4 | ✗ |
| REML + blok, çiçeklenme: \hat\sigma^2_{artık} | 9,45710763 | 9,45710806 | 9,4572002 | 9,8e−6 | ✗ |
| REML + blok, çiçeklenme: Q_{ST} | 0,68491177 | 0,68491283 | 0,68493551 | 2,4e−5 | ✗ |
| REML + blok, kök oranı: \hat\sigma^2_{pop} | 0,00555159 | 0,0055434 | 0,00554664 | 8,2e−6 | ✗ |
| REML + blok, kök oranı: \hat\sigma^2_{aile} | 0,65918112 | 0,65918939 | 0,65918752 | 8,3e−6 | ✗ |
| REML + blok, kök oranı: \hat\sigma^2_{artık} | 9,78081982 | 9,78081966 | 9,78081842 | 1,4e−7 | ✓ |
| REML + blok, kök oranı: Q_{ST} | 0,00105164 | 0,00105007 | 0,00105069 | 1,6e−6 | ✗ |
Ölçütü karşılayan: 84/104. Python: sapma kareleri toplamlarıyla iç içe ANOVA, Sokal–Rohlf katsayıları, varyans çözümlemesi biçiminde Weir–Cockerham, açık kısıtlı olabilirliğin eniyilenmesi. R: lm + anova, katsayılar sentez yöntemiyle; Weir–Cockerham formül biçimi; nlme::lme; bootstrap aynı tohum ve çekiliş sırasıyla, \chi^2 çekimleri rgamma ile. Bootstrap satırlarında Python sütunu boştur (86.6). REML satırlarındaki farklar eniyileyicilerin yakınsama toleransından gelir.
Ölçütü karşılamayan satırların hepsi REML kestirimleridir. Üç hesap (lme4, nlme, açık olabilirlik) birbirinden dördüncü–altıncı anlamlı basamakta ayrılır; fark, olabilirlik yüzeyinin en büyük nokta çevresinde düz olmasından ve eniyileyicilerin durma ölçütlerinden gelir. Q_{ST}'deki en büyük fark 2{,}4\cdot10^{-5}'tir ve hiçbir yorumu etkilemez.
86.7 Çıktıyı okuma
Örnek ayarın konsol metni:
Genotip okuma: 10 lokusta 10800 genotipin 7306 tanesi eksik sayıldı (boş hücre: 7306; eksik kodu: 0;
alellerinden yalnız biri eksik kodu: 0; başka neden: 0).
Weir–Cockerham FST: 360 birey, 12 popülasyon, 10 çok biçimli lokus (57 alel)
QST: iç içe ANOVA (Sokal–Rohlf n0 katsayıları); σ²A = 4σ²aile (yarım kardeş); B = 1000 parametrik
bootstrap tekrarı, tohum 2009
Not: 3 özellik test edildi; iki yönlü p değerleri Holm ile düzeltildi. Özellikler genetik olarak
ilişkili olabildiğinden testler bağımsız değildir; düzeltme yaklaşıktır.
Uyarı: kok_orani için karar Monte Carlo hatasına duyarlı: düzeltilmiş p'nin ±2 Monte Carlo SH aralığı
α = 0,050 değerini içeriyor (B = 1000 tekrarla; tohumu değiştirmek ya da B'yi artırmak kararı
değiştirebilir). Kararı kesinleştirmek için B'yi (ör. 10000) artırıp çalıştırmayı yineleyin.
Tablolar (kısaltılmış: sayılar yuvarlanmış, bazı sütunlar atılmıştır; tablolarda tam hassasiyet saklanır):
Varyans bileşenleri ve QST (ANOVA; σ²A = σ²aile/0,25)
      ozellik    n  populasyon  aile   s2_pop  s2_aile  s2_artik      VA      QST
          boy  711          12   114   1.2164   2.0044   10.7830  8.0174  0.07051
 cicek_zamani  702          12   114  20.9101   1.0035   10.6949  4.0139  0.72259
    kok_orani  704          12   114   0.0494   0.8444   10.8497  3.3777  0.00726
İç içe ANOVA: ortalama kareler, serbestlik dereceleri ve n0 katsayıları (Sokal–Rohlf)
      ozellik     KO_pop  KO_aile  KO_artik  sd_aile  sd_artik  n0_pop_aile  n0_aile   n0_pop
          boy    95.6435  23.2149   10.7830      102       597       6.5235   6.2024  59.0157
 cicek_zamani  1235.6540  16.8399   10.6949      102       588       6.4425   6.1238  58.2730
    kok_orani    19.2094  16.0333   10.8497      102       590       6.4817   6.1386  58.4119
Weir–Cockerham FST (θ = Σa / Σ(a + b + c))
      FST  lokus_sayisi  alel_sayisi  birey  populasyon
 0.098325            10           57    360          12
QST–FST karşılaştırması (Whitlock–Guillaume parametrik bootstrap; %95 aralıklar; …)
      ozellik     QST  QST_alt  QST_ust  QST_FST  notr_alt  notr_ust  p_alt  p_ust  p_iki
          boy  0.0705   0.0106   0.1870  -0.0278   -0.0786    0.1277  0.324  0.676  0.648
 cicek_zamani  0.7226   0.4403   0.9118   0.6243   -0.0864    0.2098  0.998  0.002  0.004
    kok_orani  0.0073  -0.0314   0.1062  -0.0911   -0.0902    0.2825  0.021  0.979  0.042
İkinci tablonun sd_pop sütunu (üç özellikte 11) burada gösterilmemiştir. Son tablonun gösterilmeyen sütunları FST (0,0983), FST_alt (0,0869), FST_ust (0,1108), p_duzeltilmis (0,648; 0,012; 0,084) ve karar'dır; karar üç özellikte sırasıyla "nötral beklentiden ayrılmıyor", "QST > FST (çeşitlendirici seçilim)", "nötral beklentiden ayrılmıyor"dur.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Tablo 1 | Özellik başına gözlem, popülasyon ve aile sayısı; üç varyans bileşeni, \sigma^2_A, Q_{ST} | Negatif bileşen ANOVA'da olanaklıdır. s2_artik yarım kardeş tasarımında çevre varyansının yanında eklemeli varyansın dörtte üçünü de taşır. |
| Tablo 2 (yalnız ANOVA) | Ortalama kareler, serbestlik dereceleri, üç katsayı | n0_pop_aile n_0', n0_aile n_0, n0_pop n_{b0}'dır. |
| Tablo 3 ve 4 (yalnız belirteçle) | Genel F_{ST}; lokus başına alel sayısı, birey sayısı ve F_{ST} | Lokus değerleri arasında aşırı uçlar varsa o lokusun nötral olmadığından kuşkulanılır. Genel tablodaki birey en az bir lokusu dolu birey sayısıdır (331); lokus tablosundaki, o lokusta genotipi olanların sayısıdır. |
| Tablo 5 | Q_{ST} ve aralığı, F_{ST} ve aralığı, fark, nötral farkın aralığı, üç p değeri, düzeltilmiş p, karar | Gözlenen fark (QST_FST) nötral aralığın (notr_alt, notr_ust) dışındaysa ilgili tek yönlü p küçüktür. Karar düzeltilmiş p'ye göre yazılır. |
| Tablo 6 | Nötral Q_{ST}'nin ortalaması, standart sapması ve kantilleri; \sigma^2_A ve aralığı; geçerli tekrar sayısı | Ortalama ve standart sapma ağır kuyruktan etkilenir; kantiller okunur. |
| Tablo 7 (isteğe bağlı) | Aileler üzerinden yeniden örnekleme aralığı | Popülasyonlar sabit; parametrik aralığın yerine geçmez. |
| Şekil (özellik başına) | Q_{ST} bootstrap dağılımı ve nötral Q_{ST} dağılımı; gözlenen Q_{ST} ve F_{ST} çizgileri | Mor dağılımın gri dağılımdan ayrılması seçilim belirtisidir. Test Q_{ST}-F_{ST} farkı üzerindendir; şekil Q_{ST} ölçeğindedir. |
Şekil 86.1. Şablonun çizdiği grafik, çiçeklenme zamanı: Q_{ST}'nin bootstrap dağılımı (mor) nötral dağılımın (gri) çok sağındadır; kesikli çizgi F_{ST}'dir.
Şekil 86.2. Kök oranı: gözlenen Q_{ST} (0,007) sıfıra yakın, nötral dağılımın alt ucundadır; nötral dağılımın sağ kuyruğu uzundur.
Rapor cümlesi (örnek ayar):
On mikrosatellit lokusunda F_{ST} = 0{,}098 bulundu (%95 GA 0,087–0,111). Çiçeklenme zamanında popülasyonlar arası farklılaşma nötral beklentinin çok üstündeydi (Q_{ST} = 0{,}72; %95 GA 0,44–0,91; Q_{ST} - F_{ST} = 0{,}62; parametrik bootstrap, B = 1000, iki yönlü p = 0{,}004; Holm düzeltmeli p = 0{,}012); bu, çeşitlendirici seçilimle uyumludur. Boyda Q_{ST} (0,07; 0,01–0,19) F_{ST}'den ayırt edilemedi (p = 0{,}65). Kök oranında Q_{ST} (0,007) F_{ST}'nin altındaydı, ancak fark düzeltmeden sonra anlamlı değildi (iki yönlü p = 0{,}042; Holm düzeltmeli p = 0{,}084).
86.8 Sık hatalar ve tuzaklar
- B=1000 ile sınırdaki kararlara güvenmek. Nötral Q_{ST} dağılımının kuyruğu ağırdır: aile varyansının yenilenmiş değeri sıfıra yaklaştığında payda küçülür ve Q^{*}_{ST} çok büyük değerler alır (çiçeklenme zamanında tekrarların %0,26'sında, kök oranında %0,77'sinde yenilenmiş \sigma^2_A sıfırın altındadır). Üst kuyruk olasılıkları bu yüzden birkaç tekrara dayanır. Örnek veride 200 farklı tohumla çiçeklenme zamanının Holm düzeltmeli p değeri 0 ile 0,060 arasında değişmiş, bir tohumda (
tohum = 1) 0,05'i aşmıştır; kök oranının düzeltilmemiş p değeri 0,032 ile 0,096 arasındadır ve tohumların %29'unda 0,05'in altındadır. B=10000 ile aralıklar daralır (çiçeklenme 0,009–0,027; kök oranı düzeltilmemiş 0,048–0,063). Şablon bu durumu kendisi bildirir: düzeltilmiş p'nin \pm2 Monte Carlo SH aralığı \alpha'yı kesen her özellik için "karar Monte Carlo hatasına duyarlı" uyarısı yazar (örnek ayarda kök oranı). Yayın için B en az 10000 seçilir ve sonucun tohumdan bağımsız olduğu ikinci bir tohumla denetlenir. - Eksik genotipi
-9ile kodlamak.-9/-9ve-9eksik genotip sayılır; örnek veride eksik hücreler böyle kodlandığında alel sayısı 57'de kalır ve F_{ST} 0,0983 olarak değişmez. Yarı eksik genotip (-9/1gibi) çalıştırmayı durdurur. - Alel adı olarak 0 kullanmak.
0/0eksik genotip sayılır; bir alelin adı 0 ise o aleli taşıyan0/3gibi genotipler yarı eksik olur ve çalıştırma durur ("alellerinden yalnız biri eksik kodu"). msat1'in en küçük aleli 0 diye adlandırıldığında lokustaki 131 birey bu yüzden düşecekti; alel yeniden adlandırılınca (ör. 1000) birey sayısı 352'de kalır (Bölüm 71.8). - F_{ST}'yi aralıksız girmek. Sabit F_{ST} ile nötral dağılım daralır; test liberaldir. Örnekte çiçeklenme zamanının nötral üst sınırı 0,210'dan 0,198'e iner.
- REML ile sabit F_{ST} ve sınırdaki Q_{ST}. REML'de \hat\sigma^2_{pop}=0 ise gözlenen Q_{ST}=0'dır. F_{ST} sabitken hiçbir nötral tekrar gözlenen farkın altına inemez; Q^{*}_{ST}=0 olan tekrarlar gözlenene eşittir. Şablon bu eşit tekrarları iki kuyruğa da sayar (toleransı 10^{-8}) ve sayısını notla yazar; kesin eşitsizlikle sayılsalardı p_{alt} her zaman 0 çıkar ve karar "tekdüzeleştirici seçilim" olurdu. Popülasyon varyansı olmayan bir özellik ve altı popülasyonla yapılan denemede (500 tekrar, tohum 2009) nötral tekrarların %15'i tam olarak 0, %23'ü 10^{-8}'in altında çıkmıştır; eşitlikler sayıldığında p_{alt}=0{,}23, p_{iki}=0{,}45 olur ve karar "nötral beklentiden ayrılmıyor"dur. Yine de bu birleşimde (REML, elle ve aralıksız F_{ST}, "QST = 0" notu) test düşük güçlüdür: F_{ST} aralığıyla ya da belirteç verisiyle çalışmak daha bilgi vericidir.
- Negatif Q_{ST}'yi ya da 1'i aşan aralığı hata sanmak. ANOVA bileşenleri kırpılmaz. Kök oranında Q_{ST} aralığının alt sınırı -0{,}031'dir; sıfır olarak okunur. Kırpma nötral dağılımın biçimini bozardı; şablon dağılımı olduğu gibi kullanır.
- Tam kardeş ailelerini yarım kardeş (ya da tersi) saymak. Aynı veride
tamseçeneği boyda Q_{ST}'yi 0,071'den 0,132'ye çıkarır; \sigma^2_A yarıya iner. - Az popülasyonla çalışmak. \sigma^2_{pop}'un serbestlik derecesi p-1'dir. 10'dan az popülasyonda şablon not düşer; 12 popülasyonla bile boyun Q_{ST} aralığı 0,011–0,187'dir. Popülasyon sayısı, popülasyon başına aile sayısından daha değerlidir.
- Blok etkisini yok saymak. ANOVA kipi bloğu modele alamaz. Blok etkisi belirginse REML ve blok seçilir; örnekte blok artık varyansı %7 küçültür ve kök oranında Q_{ST}'yi 0,0052'den 0,0011'e indirir.
- REML'de satır sırasının etkisini unutmak. REML bootstrap'ında benzetilen artıklar verinin satır sırasıyla eşlenir. Aynı veri, aynı ayar ve aynı tohumla, yalnız satırlar karıştırıldığında B=200 ile kök oranının Q_{ST} üst sınırı 0,095'ten 0,273'e değişmiştir. Fark Monte Carlo oynamasıdır; B büyütülerek giderilir.
- Nötral olmayan belirteçlerle F_{ST} kestirmek. Seçilim altındaki ya da ona bağlı lokuslar F_{ST}'yi kaydırır. Lokus başına tablo ve
aykiri_lokusşablonu bu denetim içindir. - Belirteç ve özellik verisinin farklı popülasyonlardan gelmesi. Şablon popülasyon adları örtüşmüyorsa uyarır, ama çalıştırmayı sürdürür; karşılaştırma aynı popülasyonları varsayar.
86.9 Uzman soruları
S1. Neden Q_{ST} ve F_{ST}'nin güven aralıklarının örtüşmesine bakmak yetmez?
İki aralığın örtüşmemesi, farkın sıfırdan farklı olması için yeterli ama gereksiz ölçüde katı bir koşuldur; örtüşmesi ise farkın anlamsız olduğunu göstermez. Daha önemlisi, Q_{ST}'nin parametrik aralığı gözlenen değerin çevresinde kurulur, oysa sınanan şey nötral modeldir. Nötral dağılımın biçimi (sağa çarpık, p-1 serbestlik dereceli) aralıkların karşılaştırmasında hiç kullanılmaz. Şablon bu yüzden farkın nötral dağılımını doğrudan benzetir ve p değerini oradan alır.
S2. Nötral Q_{ST} neden F_{ST}'ye eşit sayılıyor; bu her zaman doğru mu?
Eşitlik, eklemeli gen etkili nötral bir özellik ve ada modeli benzeri bir popülasyon yapısı için türetilmiştir. Baskınlık ve epistasi nötral Q_{ST}'yi çoğu kez F_{ST}'nin altına çeker; bu, "Q_{ST}>F_{ST}" sonucunu daha güvenli, "Q_{ST}<F_{ST}" sonucunu daha kuşkulu yapar (Whitlock, 2008). Mutasyon hızı çok yüksek belirteçlerde F_{ST} aşağı yanlıdır ve Q_{ST}>F_{ST} yapay olarak ortaya çıkabilir. Hiyerarşik yapıda tek bir F_{ST} nötral beklentiyi temsil etmez.
S3. Alel birimi ile lokus birimi arasındaki fark nedir, hangisi seçilmeli?
Alel biriminde 57 alelin (a,b,c) üçlüleri yeniden çekilir; bir lokusun alelleri birbirinden bağımsızmış gibi davranılır. Lokus biriminde 10 lokusun toplamları çekilir; lokuslar bağımsız evrimsel gerçekleşmeler olarak alınır (Bölüm 71.4.2). Örnekte F_{ST} aralığı alel birimiyle 0,0869–0,1108, lokus birimiyle 0,0882–0,1078'dir; çok alelli mikrosatellitlerde ikisi yakındır. İki alelli SNP'lerde her lokusun iki aleli aynı bilgiyi taşır ve alel birimi belirsizliği olduğundan küçük gösterir; SNP verisinde lokus birimi seçilir. Varsayılan (alel), yöntemin yaygın uygulamasıyla aynı sayıları vermesi için seçilmiştir.
S4. p_{iki} neden 2\min(p_{alt},p_{üst}); neden tekrarların mutlak değeriyle sayılmıyor?
Nötral D^{*} dağılımı simetrik değildir: sağ kuyruğu uzundur. Mutlak sapmaya dayalı iki yönlü p, alt kuyruktaki bir gözlemi üst kuyruğun genişliğiyle karşılaştırır ve tekdüzeleştirici seçilimi neredeyse hiç bulamaz. Küçük kuyruğun iki katı, çarpık dağılımlarda olağan iki yönlü tanımdır. Yön önceden belirlenmişse tek yönlü p (p_ust ya da p_alt) raporlanır.
S5. p=0 ne anlama gelir?
Gözlenen farkın B nötral tekrarın hepsinden büyük (ya da küçük) olduğunu; yani p<1/B olduğunu. Şablon sayıma 1 eklemez; p=0 yazar ve bir notla açıklar. Raporda "p<0{,}001" (B=1000 için) biçiminde verilir. Düzeltme yöntemleri 0'ı 0 olarak bırakır.
S6. ANOVA mı REML mi?
Varsayılan ANOVA'dır, çünkü Whitlock ve Guillaume'un testi ortalama karelerin \chi^2 dağılımına dayanır ve dengesiz yarım kardeş tasarımı için katsayılarıyla birlikte tanımlanmıştır (Gilbert ve Whitlock, 2015). ANOVA yansızdır ama bileşenler negatif olabilir. REML bileşenleri sıfırda tutar, blok gibi sabit etkileri alır ve çok dengesiz desende daha verimlidir; bedeli, nötral dağılımın her tekrarda modelin yeniden kestirilmesiyle üretilmesi (örnekte B=200 için 24 saniye; ANOVA'da B=1000 için 3 saniye) ve sınırdaki kestirimlerin dağılımda yığılma yapmasıdır. İki yöntem aynı karara varmıyorsa sonuç sınırdadır.
S7. Holm düzeltmesinden sonra kök oranı anlamlı değil; tekdüzeleştirici seçilim "yok" mu denir?
Hayır. Özellik tekdüzeleştirici seçilimle üretilmiştir ve Q_{ST}=0{,}007 nötral dağılımın alt ucundadır; ama Q_{ST} sıfırın altına inemeyeceği için alt kuyrukta ayırt etme gücü düşüktür: nötral dağılımın %2,5 kantili zaten -0{,}09 dolayındadır (Q^{*}_{ST}\approx0). F_{ST} küçükken tekdüzeleştirici seçilimi göstermek, çeşitlendirici seçilimi göstermekten çok daha zordur. Raporda yön ve p değeri verilir, "nötral beklentiden ayrılmadı" denir; "seçilim yoktur" denmez.
S8. Aileler üzerinden yeniden örnekleme aralığı neden parametrik aralıktan farklı?
Örnekte (B=500) boy için parametrik aralık 0,013–0,183, aile yeniden örnekleme aralığı 0,054–0,236'dır; kestirim (0,071) ikincisinin alt ucuna yakındır. İki neden vardır. Popülasyonlar sabit tutulduğu için popülasyon varyansının örnekleme belirsizliği aralığa girmez. Ayrıca yerine koyarak çekilen ailelerin bir kısmı yinelenir ve yinelenen aile ayrı bir aile sayılır; bu, aileler arası varyansı aşağı, Q_{ST}'yi yukarı iter. Bu aralık parametrik varsayımdan (normal dağılım) kuşkulanıldığında aile varyansının duyarlılığını görmek için kullanılır; raporlanacak aralık parametrik olandır.
S9. Bütün özellikler aynı F^{*}_{ST} dizisini kullanıyor; bu bir sorun mu?
Tohum her özellikten önce yeniden kurulduğu için çekimler aynı noktadan başlar ve örnekte üç özelliğin F^{*}_{ST} dizisi örtüşür. Her özelliğin testi kendi içinde geçerlidir; ancak özellikler arasında p değerleri, ortak F_{ST} çekimleri üzerinden pozitif ilişkilidir. Gerçekte de böyledir: bütün özellikler aynı F_{ST} kestirimiyle karşılaştırılır. Çoklu test düzeltmeleri pozitif bağımlılıkta tutucu kalır (Holm her bağımlılıkta geçerlidir).
86.10 Kaynaklar
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B, 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Gilbert, K. J., & Whitlock, M. C. (2015). Q_{ST}–F_{ST} comparisons with unbalanced half-sib designs. Molecular Ecology Resources, 15(2), 262–267. https://doi.org/10.1111/1755-0998.12303
- Goudet, J. (2005). hierfstat, a package for R to compute and test hierarchical F-statistics. Molecular Ecology Notes, 5(1), 184–186. https://doi.org/10.1111/j.1471-8286.2004.00828.x
- Goudet, J., & Jombart, T. (2022). hierfstat: Estimation and tests of hierarchical F-statistics (R package version 0.5-11). https://doi.org/10.32614/CRAN.package.hierfstat
- Hartley, H. O. (1967). Expectations, variances and covariances of ANOVA mean squares by "synthesis". Biometrics, 23(1), 105–114. https://doi.org/10.2307/2528284
- Lewontin, R. C., & Krakauer, J. (1973). Distribution of gene frequency as a test of the theory of the selective neutrality of polymorphisms. Genetics, 74(1), 175–195. https://doi.org/10.1093/genetics/74.1.175
- O'Hara, R. B., & Merilä, J. (2005). Bias and precision in Q_{ST} estimates: Problems and some solutions. Genetics, 171(3), 1331–1339. https://doi.org/10.1534/genetics.105.044545
- Pinheiro, J., Bates, D., & R Core Team. (2025). nlme: Linear and nonlinear mixed effects models (R package version 3.1-168). https://doi.org/10.32614/CRAN.package.nlme
- Sokal, R. R., & Rohlf, F. J. (1995). Biometry: The principles and practice of statistics in biological research (3rd ed.). W. H. Freeman.
- Spitze, K. (1993). Population structure in Daphnia obtusa: Quantitative genetic and allozymic variation. Genetics, 135(2), 367–374. https://doi.org/10.1093/genetics/135.2.367
- Weir, B. S., & Cockerham, C. C. (1984). Estimating F-statistics for the analysis of population structure. Evolution, 38(6), 1358–1370. https://doi.org/10.1111/j.1558-5646.1984.tb05657.x
- Whitlock, M. C. (2008). Evolutionary inference from Q_{ST}. Molecular Ecology, 17(8), 1885–1896. https://doi.org/10.1111/j.1365-294X.2008.03712.x
- Whitlock, M. C., & Guillaume, F. (2009). Testing for spatially divergent selection: Comparing Q_{ST} to F_{ST}. Genetics, 183(3), 1055–1063. https://doi.org/10.1534/genetics.108.099812