165. Sonlu karışım regresyonu (gizil sınıflı regresyon, EM)
Şablon kimliği: sonlu_karisim_regresyon · Kategori: çok değişkenli · Dil: R · Dosya: pro/sablonlar/cok_degiskenli/sonlu_karisim_regresyon.R (satır 1–226; üstbilgi 1–95) · Örnek veri: _ornek/npreg.csv · Paketler: flexmix 2.3-21 (modeltools, lattice), R 4.5.3
165.1 Ne işe yarar
Şablon, tek bir regresyon doğrusunun bütün gözlemlere uymadığı durumu modeller: veri, gözlenmeyen K alt gruptan gelir ve her alt grupta yanıt ile açıklayıcılar arasındaki ilişki farklıdır. Hangi gözlemin hangi gruptan geldiği bilinmez; şablon hem grupların regresyon katsayılarını hem de her gözlemin gruplara ait olma olasılığını birlikte kestirir.
- y: yanıt; \mathbf x: açıklayıcı değişken vektörü (kesişim dahil).
- \pi_k: k. bileşenin karışım oranı (bir gözlemin k. gruptan gelme önsel olasılığı).
- f_k: k. bileşenin yoğunluğu: normal, Poisson ya da Bernoulli.
- \boldsymbol\beta_k: k. bileşenin regresyon katsayıları; \varphi_k: yayılma parametresi (yalnız normal bileşende \sigma_k).
Bileşen dağılımı üç seçenekten biridir: normal (doğrusal regresyon), Poisson (log bağlantı) ve ikili lojistik. Kestirim EM algoritmasıyladır (Dempster ve ark., 1977; bu modele uygulaması DeSarbo ve Cron, 1988; Wedel ve DeSarbo, 1995). Şablon flexmix paketini (Leisch, 2004; Grün ve Leisch, 2008) kullanır, birden çok rastgele başlangıç dener ve en yüksek log-olabilirliği seçer.
Ne zaman kullanılır?
- Dağılım grafiği birden çok "kol" ya da "bulut" gösteriyorsa ve bu kolların farklı eğimleri olabilecek gözlenmemiş bir nedeni varsa (iki ayrı tür, iki ayrı üretim yöntemi, iki ayrı tepki rejimi).
- Ortalama eğimin hiçbir alt grubu temsil etmediğinden şüpheleniliyorsa.
- Grup sayısı bilinmiyorsa ve bilgi ölçütleriyle seçilmek isteniyorsa (şablon 1..K için AIC, BIC ve ICL tablosu verir).
Ne zaman kullanılmaz?
- Alt grup gözleniyorsa (cinsiyet, tür, bölge sütunu): grubu etkileşimle modelleyin; temel programda bu, grup değişkeniyle etkileşimli doğrusal modeldir. Karma etkiler gerekiyorsa
lme4/glmmTMBtabanlı şablonlar (ör. Bölüm 19, Bölüm 20) uygundur. - Aynı birimden yinelenen ölçümler varsa: bu şablon gözlemleri bağımsız sayar. Birim içi bağımlılık için karma model gerekir.
- Amaç kümeleme ise ve yanıt-açıklayıcı ilişkisi ilgi konusu değilse: karışım dağılımı kümelemesi (yanıtsız) başka araçların işidir.
- Yanıt sayım olup aşırı yayılma varsa ve Poisson bileşenler yetmiyorsa: negatif binom bileşeni bu şablonda yoktur; Bölüm 27'deki negatif binom şablonu tek bileşenlidir.
- Yanıtı 0/1 olan lojistik karışım gerekiyorsa: "İkili lojistik (0/1)" bileşen dağılımını seçin (yanıt
cbind(y, 1 - y)olarak verilir; 165.8).
Temel programla ilişki. Temel programda yanıt-açıklayıcı ilişkisini gruplara ayıran bir karışım regresyonu yoktur. Yakın analizler gizil sınıf (LCA) ve gizil profil (LPA) analizleridir; onlar gözlenen göstergelerin dağılımından grup bulur, bu şablon ise her grubun regresyonunu ayrı kestirir. Şablonun K=1 satırı, normal bileşende, tek bileşenli doğrusal modelin log-olabilirliğidir; yalnız \sigma tanımı farklıdır (165.4.2).
165.2 Şablonun girdileri
Form, üstbilgideki 12 [[param]] bloğundan kurulur (sonlu_karisim_regresyon.R:10–94). Türlerin anlamı ve formun ortak denetimi Bölüm 1.2'dedir. Yanıt sayisal_sutun türündedir, yani sayısal roldür: Veri sekmesinde türü "kategorik" ya da "ikili" olan bir sütun da yanıt seçilebilir ve R'ye sayı olarak gider (Bölüm 1.3). Açıklayıcılar ve eş değişkenler sutunlar türündedir ve sayisal = true değildir: Veri sekmesinde "kategorik" sayılan sütun kategorik (kukla kodlanan) değişken olur.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Yanıt · y |
sayısal sütun · Değişkenler | veri sekmesindeki ilk sayısal sütun | sayısal sütun | Yanıt vektörü (10–14, 106–107). |
Açıklayıcı değişkenler · x |
sütunlar · Değişkenler | boş | en az 1 sütun | Yanıt dışındakiler formüle girer (15–20, 100–101, 112–121). |
Sayısal açıklayıcıların karesini de ekle · kare |
onay · Model | kapalı | açık/kapalı | Her sayısal açıklayıcı için I(x^2) terimi (21–26, 119). |
Bileşen sayısı K · k |
tamsayı · Model | 2 | 1–8 | İstenen bileşen sayısı (27–34, 105). |
Bileşen dağılımı · aile |
seçim · Model | gaussian |
gaussian, poisson, binomial |
Bileşen modeli (35–41, 133; ikili lojistikte yanıt cbind(y, 1 - y) olarak verilir, 129–131). |
Rastgele EM başlangıcı sayısı · baslangic |
tamsayı · Gelişmiş | 20 | 1–200 | stepFlexmix(nrep =) (42–49, 150). |
1..K bileşen için bilgi ölçütlerini karşılaştır · k_sec |
onay · Seçenekler | açık | açık/kapalı | K>1 iken 1..K için ek uydurma (50–55, 208–215). |
Karışım oranlarını açıklayan eş değişkenler · es_degiskenler |
sütunlar (isteğe bağlı) · Değişkenler | boş | sütunlar | Üyelik olasılığına çok terimli lojit (56–62, 102–105, 136–144). |
EM türü · siniflama |
seçim · Model | auto |
auto, CEM, SEM |
control$classify (63–69, 135). |
En küçük bileşen oranı · en_kucuk_oran |
ondalık · Gelişmiş | 0,01 | 0–0,4 | control$minprior (70–78, 134). |
EM yakınsama toleransı · tolerans |
ondalık · Gelişmiş | 10^{-10} | 10^{-14}–0,01 | control$tolerance (79–86, 134). |
En çok EM yinelemesi · en_cok_yineleme |
tamsayı · Gelişmiş | 5000 | 10–1 000 000 | control$iter.max (87–94, 134). |
Örnek ayar (ornek_param, satır 9) varsayılandan farklıdır: y = yn, x = [x], kare = açık, k = 2, aile = gaussian, baslangic = 5, k_sec = açık. Başlangıç sayısı 20 değil 5'tir.
Şablonun kendi denetimleri (mq_hata):
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 99 |
| Yanıttan farklı açıklayıcı yok | "Yanıttan farklı en az bir açıklayıcı seçin." | 101 |
| Yanıt sayısal değil | "Yanıt sayısal olmalı." | 106 |
| Eksiksiz satır sayısı <10 | "En az 10 tam satır gerekli." | 108 |
| Yanıt sabit | "Yanıt sabit." | 109 |
| Poisson ve yanıt negatif ya da tamsayı değil | "Poisson bileşenleri için yanıt negatif olmayan tamsayı olmalı." | 110 |
| İkili lojistik ve yanıt 0/1 değil | "İkili lojistik bileşenler için yanıt 0/1 olmalı." | 117 |
| Açıklayıcı ondalık virgüllü sayılardan oluşan metin sütunu | "'…' sütunu metin olarak okundu (ondalık virgüllü sayılar); … Veri sekmesinde ondalık ayracını nokta yapın …" | 121 |
| Açıklayıcı sabit ya da tek düzeyli | "'…' sabit (tek düzeyli); açıklayıcılardan çıkarın." | 123 |
| Açıklayıcılar tam doğrusal bağımlı (x ve 2x gibi) | "Açıklayıcılar tam doğrusal bağımlı: '…' başka terimlerin doğrusal birleşimi; terimlerden birini çıkarın." | 128–131 |
| Eş değişken sabit ya da tek düzeyli | "Eş değişken '…' sabit (tek düzeyli)." | 141 |
| n<K\,(p+1)+5 (p: katsayı sayısı, normalde +1 \sigma için) | "Gözlem sayısı bu bileşen ve parametre sayısı için yetersiz." | 132 |
| Uydurma hata verdi ya da yakınsamadı | "Karışım modeli kurulamadı; bileşen sayısını azaltın ya da başlangıç sayısını artırın. Paket iletisi: …" | 155–157 |
Son satırdaki iletinin sonuna paketin kendi hata metni eklenir (tryCatch hata iletisini son_hata'ya yazar, 152, 156); böylece uydurmanın neden başarısız olduğu görünür. Hata, çok küçük bir örneklemde bileşenlerin boşalmasından ya da paketin başka bir kısıtından gelebilir (165.8).
Seçilen yanıt, açıklayıcı ve eş değişken sütunlarından herhangi birinde eksik değer taşıyan satır atılır (106–108) ve atılan satır sayısı yazılır: "15 satır eksik değer nedeniyle çıkarıldı; 185 satırla çalışıldı." Bir eş değişken yanıtta ya da açıklayıcılarda da seçilmişse eş değişkenlerden çıkarılır ve bu bir uyarı satırıyla bildirilir (103–105).
165.3 Örnek veri
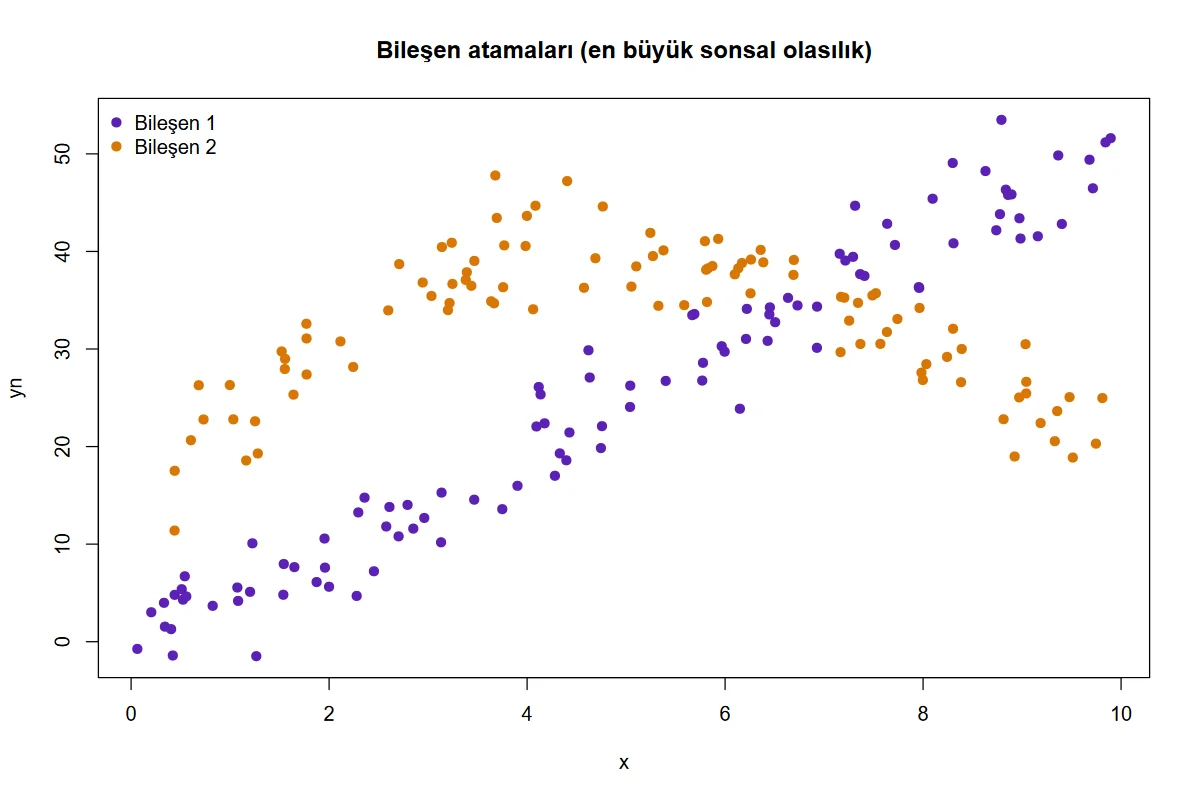
npreg.csv, flexmix paketinin vinyetindeki NPreg verisidir (Leisch, 2004): 200 satır, eksik değer yok. Veri, iki alt gruptan benzetilmiştir: yarısı y=5x+\varepsilon (doğrusal), yarısı y=15+10x-x^2+\varepsilon (parabol).
| Değişken | Rol | Tür (veri sekmesinin algıladığı) | Özet |
|---|---|---|---|
x |
açıklayıcı | sayısal | 0–10 arası (düzgün dağılım) |
yn |
yanıt (normal) | sayısal | -1{,}5 ile 53{,}5 arası |
yp |
yanıt (Poisson) | sayısal | sayım |
yb |
— | ikili | 0/1 (ayrı bir üretimle; ikili lojistik denemesinde kullanıldı) |
class |
— | ikili | gerçek alt grup (1/2); modelde kullanılmaz |
id1, id2 |
— | sayısal | kimlik; modelde kullanılmaz |
Örnek ayarda kategorik değişken yoktur. Kategorik açıklayıcı olduğunda düzey sırası Bölüm 1.3'teki kuralla belirlenir: Veri sekmesinde "kategorik" olan sütunda kullanıcı sırası, sayı etiketlerinde sayısal sıra, aksi hâlde ilk görülme sırası; ilk düzey kukla kodlamada başvuru olur. İki düzeyli metin sütunu (ör. evet/hayır) Veri sekmesinde "ikili" sayılır, R'ye metin olarak gider ve şablonun factor() çağrısı onu alfabetik sıralar (113–115; denemede ikili sütununda başvuru evet, katsayı ikilihayir).
Bu bölümde kullanılan çalıştırmalar (tohum 1; ayrıntı dogrulama/sonlu_karisim_regresyon/calistir.sh):
| Ad | Veri | Ayar |
|---|---|---|
p4_sk_ornek |
npreg.csv |
örnek ayar (normal, K=2, kare açık, 5 başlangıç) |
p4_sk_poisson |
npreg.csv |
yn yerine yp, aile = poisson |
p4_sk_k3, p4_sk_yk3_s1…8 |
npreg.csv |
K=3; tek başlangıç, tohum 1–8 |
p4_sk_iter10, p4_sk_cem, p4_sk_sem |
npreg.csv |
en_cok_yineleme = 10; siniflama = CEM; SEM |
p4_sk_es_sinif, p4_sk_es_x |
npreg.csv |
eş değişken class; eş değişken x (açıklayıcıyla aynı) |
p4_sk_uc, p4_sk_uc_dogru, p4_sk_tek, p4_sk_tek_k3 |
benzetim (veri_uret.py) |
üç ve tek bileşenli veri |
p4_sk_eksik, p4_sk_kat_*, p4_sk_y_*, p4_sk_n9, p4_sk_n12, p4_sk_virgul, p4_sk_kopya |
benzetim | hata ve sınır durumları |
165.4 Yöntem: formüller ve hesap adımları
Şablon önce veriyi temizler ve formülü kurar (yn ~ x + I(x^2)), sonra stepFlexmix ile K bileşenli modeli baslangic kez rastgele başlatıp en yüksek log-olabilirlikli çözümü alır. Bileşenleri kesişimlerine göre sıralar, refit ile katsayı standart hatalarını (SH) hesaplar, ardından sonsal olasılıklardan atamaları, entropiyi ve bilgi ölçütlerini üretir. İstenirse 1..K için uydurmayı yineler ve bir dağılım grafiği çizer.
165.4.1 Olabilirlik ve EM adımları
Gözlem i için bileşen k'nın sonsal olasılığı (sorumluluk):
- \tau_{ik}: i. gözlemin k. bileşenden geldiğinin sonsal olasılığı; her i için \sum_k\tau_{ik}=1.
- Pay: bileşenin ağırlıklı yoğunluğu; payda: karışım yoğunluğu.
E adımı bu \tau_{ik}'ları mevcut parametrelerle hesaplar. M adımı her bileşen için \tau_{ik} ağırlıklı bir regresyon uydurur ve oranı günceller:
- \hat\pi_k: bileşenin güncellenmiş oranı; sorumlulukların ortalaması.
- İkinci formül: normal bileşende ağırlıklı en küçük kareler, Poisson ve lojistik bileşenlerde ağırlıklı iteratif yeniden ağırlıklı en küçük kareler (
glm.fit, ağırlık =\tau_{ik}).
Neden EM ve neden birden çok başlangıç
Karışımın log-olabilirliği \sum_i\ln\sum_k\pi_kf_k çok tepelidir; EM her adımda log-olabilirliği artırır ama yerel bir en büyüğe yakınsar. Hangi yerel en büyüğe varıldığı başlangıç değerlerine bağlıdır. Şablon nrep = baslangic rastgele başlangıç dener ve en yüksek log-olabilirliği tutar (stepFlexmix); başlangıç sayısı arttıkça genel en büyüğe varma olasılığı artar ama garanti edilmez. 165.7'de K=3 için tek başlangıçlı sekiz tohumun üç farklı çözüm verdiği gösterilir.
Koddaki tercih
stepFlexmix(formula, data, k, nrep, model = FLXMRglm(family = aile), control = list(tolerance, iter.max, minprior [, classify]), verbose = FALSE [, concomitant]) (149–153). Paketin varsayılan yakınsama toleransı 10^{-6}'dır; şablon 10^{-10} kullanır (134). Durma ölçütü log-olabilirliğin göreli değişimidir. Şablon paketin yakınsama bayrağını (m@converged) okur: olağan EM yineleme sınırında kesilmişse "yakınsamadı" uyarısı yazar (154–157; 165.8).
165.4.2 Normal bileşende \sigma'nın tanımı
flexmix normal bileşende \sigma_k'yı serbestlik derecesi düzeltmeli ağırlıklı artık kestirimiyle yazar:
- r_{ik}: k. bileşenin regresyonuna göre i. gözlemin artığı.
- p: \mathbf x'in sütun sayısı (kesişim dahil; x, x^2 ile p=3). \sigma sayılmaz.
- n/(n-p): tek bir regresyon için bilinen \mathrm{SSE}/(n-p) düzeltmesinin ağırlıklı karşılığı. Her bileşenin kendi etkin örneklem büyüklüğü \sum_i\tau_{ik} olduğu hâlde düzeltme toplam n ve p ile yapılır.
Neden saf en çok olabilirlik değil
Saf en çok olabilirlik \hat\sigma_k^2=\sum\tau_{ik}r_{ik}^2/\sum\tau_{ik} verirdi. Paketin tanımı \sigma'yı n/(n-p) kadar büyütür; EM bu büyütülmüş \sigma ile devam ettiğinden sabit nokta saf olabilirliğin en büyüğü değildir ve raporlanan log-olabilirlik ile BIC saf en çok olabilirlik değerinden biraz farklıdır. Örnek veride (165.6): şablonun log-olabilirliği -642{,}5452, saf en çok olabilirlik çözümünün -642{,}5320 (fark 0{,}0132); \sigma değerleri 3{,}4757 ve 3{,}4802'ye karşılık 3{,}4444 ve 3{,}4509 (%0,9). Üstbilgi bu farkı açıkça belirtir (satır 7). Başka bir programın saf olabilirlikle uydurduğu çözümle karşılaştırırken bu fark beklenmelidir; \sigma düzeltmesi K=1 satırında da vardır (\sigma^2=\mathrm{SSE}/(n-p), örnekte \ell=-728{,}3149; saf olabilirlikle -728{,}3035).
Koddaki tercih
Normal bileşen FLXMRglm(family = "gaussian") ile kurulur (124). flexmix'in FLXMRglm M adımı: glm.fit(x, y, weights = w), ardından sigma <- sqrt(sum(w * artik^2 / mean(w)) / (nrow(x) - rank)). Poisson ve lojistik bileşenlerde yayılma parametresi yoktur.
165.4.3 Standart hatalar: refit
Şablon, K>1 iken katsayı SH'lerini refit(m) ile alır (150, 157–159). refit (varsayılan optim yöntemi) tüm parametrelerin (bileşen katsayıları, \sigma_k ve karışım oranlarının çok terimli lojit parametreleri) ortak log-olabilirliğini, EM çözümünden başlayarak doğrudan en büyükler ve sayısal Hessian'dan kovaryans kestirir:
- \boldsymbol\theta: bileşen katsayıları, \ln\sigma_k ve \pi'nin lojit parametreleri.
- \Phi: standart normal dağılım işlevi. p değerleri Wald z testinindir; küçük örneklemde ve yarı ayrışmış bileşenlerde güvenilirlikleri sınırlıdır.
Tabloda üç ayrı çözüm birleşir
Tablodaki katsayı, SH, z ve p refit çözümünden gelir (kod, EM katsayısının üstüne refit katsayısını yazar: 159). \sigma, karışım oranı, log-olabilirlik, AIC, BIC, ICL ve atamalar ise EM çözümündendir. İki çözüm tam aynı değildir: örnekte x katsayısı EM'de 4{,}8165, tabloda 4{,}8145, saf olabilirlik en büyüğünde 4{,}8145'tir. refit olabilirliğin gerçek en büyüğüne yaklaşır (10^{-4} düzeyinde, optim'in durma ölçütüyle), EM ise büyütülmüş \sigma'nın sabit noktasındadır. Fark küçüktür ama tablodaki katsayılarla \sigma ve log-olabilirlik tam tutarlı bir çözüme ait değildir.
K=1 iken refit çağrılmaz; katsayı, SH ve p glm özetinden gelir ve p değeri t değil normal dağılımdan hesaplanır (164–168).
165.4.4 Bilgi ölçütleri, entropi ve ICL
- \ell: EM çözümündeki log-olabilirlik; d: parametre sayısı. Normal bileşende d=K\,p+K+(K-1) (katsayılar, \sigma'lar, oranlar); Poisson ve lojistikte \sigma'sız. Örnekte d=2\cdot3+2+1=9.
- ICL: Biernacki ve ark. (2000) tamamlanmış olabilirlik ölçütü. Sert atamanın log-olasılığını BIC'e ekler: bileşenler ne kadar iç içeyse ICL BIC'ten o kadar büyük olur.
Şablonun yazdığı göreli entropi, ICL'den farklı olarak yumuşak sonsal olasılıklara dayanır:
- E_{\mathrm{rel}}=1: atamalar kesin (her \tau_{ik} 0 ya da 1); E_{\mathrm{rel}}=0: bütün \tau_{ik}=1/K, bileşenler ayrılamıyor.
- K=1 için şablon 1 yazar (172).
Neden iki ayrı entropi
ICL flexmix tanımıyla sert atama entropisini kullanır; "göreli entropi" ise şablonun kendi hesabıdır ve yumuşak entropiye dayanır. Aynı çıktıda iki ölçü bu yüzden birbirinden bağımsız ilerleyebilir. Örnekte yumuşak entropi toplamı 27{,}65 (E_{\mathrm{rel}}=0{,}8006); ICL'nin kullandığı sert terim 2\cdot18{,}20=36{,}40'tır (\mathrm{ICL}-\mathrm{BIC}=1369{,}175-1332{,}775). Yumuşak entropiyle ICL 1388{,}07 olurdu.
165.4.5 Yan seçenekler
- Kare terimi (
kare): her sayısal açıklayıcı içinI(x^2)eklenir (125). Kategorik açıklayıcıya eklenmez ve sessizce atlanır. - Eş değişkenler (
es_degiskenler): bileşen üyelik olasılığı \pi_k(\mathbf w), eş değişkenlere çok terimli lojitle bağlanır (FLXPmultinom; 143). Çıktıdaki "karışım oranı" bu durumda ortalama olasılıktır. Eş değişken tablosu bileşen 1'e göredir: \ln(\pi_k/\pi_1)=\gamma_{k0}+\boldsymbol\gamma_k^\top\mathbf w (194–202). Açıklayıcılarda zaten bulunan bir sütun eş değişken olarak seçilirse eş değişkenlerden çıkarılır ve uyarı yazılır (102–105). - EM türü (
siniflama):autoolağan (ağırlıklı) EM;CEMher gözlemi sert olarak en olası bileşene atar ve bileşenleri yalnız atanan gözlemlerle uydurur (Celeux ve Govaert, 1992; paketinclassify = "CEM"seçeneği);SEMgözlemi sonsal olasılıkla rastgele atar ve hiç yakınsamaz (yineleme sayısı üst sınırı bulur). CEM ve SEM içinrefitçalışmaz ("Only for weighted ML estimation possible"), bu yüzden SH, z ve p sütunları boş (NaN) çıkar; tablo başlığı "SH hesaplanamadı" olur ve bir not satırı bunu açıklar (181–185). - En küçük bileşen oranı (
en_kucuk_oran): EM sırasında oranı bu eşiğin altına düşen bileşen çıkarılır; sonuçta bileşen sayısı K'dan küçük olabilir ve şablon bunu bir uyarı satırıyla bildirir (159). - 1..K karşılaştırması: k=1,\dots,K için
stepFlexmixayrıca çalıştırılır (192–199); en çok zaman burada harcanır (süre yaklaşık K\times).
165.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–95 | Üstbilgi: 12 parametre. | Yan dosya alanı yok. |
| 96–117 | flexmix yüklenir; açıklayıcılar setdiff(P$x, P$y) ile yanıttan arındırılır; eş değişkenler açıklayıcılardan arındırılır; sütunlar df'den alınır, complete.cases ile eksik satırlar atılır; yanıt türü, n\ge10, sabitlik, Poisson ve 0/1 koşulları. |
Atılan eksik satır sayısı ve düşen eş değişken yazılır (103–109). Yanıt Veri sekmesinde "kategorik" olsa da sayısal rol olduğundan sayı olarak gelir. |
| 118–132 | Metin ve mantıksal sütunlar factor'a çevrilir; sabit sütun hatası; terim listesi (I(x^2)); formül; model matrisinin sıra (rank) denetimi; katsayı sayısı p_k (normal için +1); n<K(p_k+1)+5 denetimi. |
Sütun adları ters tırnakla korunur. Ondalık virgüllü metin sütunu ve tam doğrusal bağımlı terimler anlaşılır iletiyle durdurulur. |
| 133–144 | Model (FLXMRglm), kontrol listesi, CEM/SEM, eş değişken. |
İkili lojistikte stepFlexmix formülünün sol tarafı cbind(y, 1 - y)'dir (f_fit, 129–131). |
| 145–159 | uydur(k) işlevi: stepFlexmix, hata → NULL (paket iletisi son_hata'da), uyarılar uyari vektörüne toplanır. Yakınsama bayrağı ve CEM/SEM notu. Uydurulan bileşen sayısı K'dan azsa uyarı. |
Hata iletisi kullanıcıya iletilir. |
| 160–164 | Parametre matrisi, bileşenleri kesişime göre artan sıralayan sira, önsel oranlar, refit. |
Etiket değişimini önlemek için sıra birinci katsayıdadır. |
| 165–185 | Katsayı tablosu: SH, z, p refit'ten; K=1 ise glm'den. |
refit başarısız olursa (CEM/SEM) SH boş kalır; başlık ve not satırı bunu söyler. |
| 186–193 | Sonsal olasılıklar, atama (max.col), göreli entropi, log-olabilirlik, oranlar, \sigma, atanan sayıları. |
\sigma yalnız normal bileşende dolu. |
| 194–207 | Eş değişken katsayıları (varsa); "Model uyumu" tablosu; konsol satırı. | ICL sert atamayla, entropi yumuşak. |
| 192–200 | 1..K bilgi ölçütleri tablosu; uyarı satırı. | k=K_f için yeniden uydurulmaz. |
| 201–210 | Dağılım grafiği (ilk açıklayıcıya karşı yanıt, atamaya göre renk). | Grafik uydurulan eğrileri çizmez. |
165.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/sonlu_karisim_regresyon/elle_hesap.py (numpy/scipy; flexmix ve şablon çağrılmaz) ve r_dogrulama.R (yalnız temel R; optim, optimHess) ile hesaplanmıştır. İkisi de aynı EM'i kendi başına yazar: rastgele sorumluluklarla başlar (20 başlangıç), ağırlıklı en küçük kareler (normal) ya da IRLS (Poisson) ile M adımını yürütür ve göreli log-olabilirlik değişimi 10^{-14}'ün altına inene kadar sürer.
Adım 1 — Log-olabilirlik ve parametreler (şablonun tanımıyla). \sigma_k^2=\sum\tau r^2/\sum\tau\cdot n/(n-3) ile EM'in 20 başlangıcının hepsi -642{,}545166'da birleşir (yerel en büyük yok). \hat\pi=(0{,}494155;\ 0{,}505845), \hat\sigma=(3{,}475666;\ 3{,}480227), \ell=-642{,}5451665, d=9, \mathrm{AIC}=1303{,}090333, \mathrm{BIC}=1332{,}775189. Sert atama entropisiyle \mathrm{ICL}=1369{,}175329; yumuşak entropiyle 1388{,}0716. Atanan sayıları 100/100. Şablonun çıktısıyla ve R hesabıyla 10^{-6} içinde aynıdır.
Adım 2 — EM katsayıları. Aynı çözümde \hat{\boldsymbol\beta}_1=(-0{,}208510;\ 4{,}816505;\ 0{,}036281), \hat{\boldsymbol\beta}_2=(14{,}717914;\ 9{,}845807;\ -0{,}968270). Bunlar şablonun tablosundakilerle (4{,}814464 ve 9{,}848309 vb.) birebir aynı değildir: tablo refit çözümüdür (165.4.3). Bu yüzden katsayı karşılaştırması aşağıda tam en çok olabilirlik çözümüyle yapılır.
Adım 3 — Tam en çok olabilirlik ve SH. Bütün parametreler (6 katsayı, 2 \ln\sigma, 1 lojit) üzerinde BFGS ve ardından Newton adımlarıyla olabilirlik en büyüklenir; Hessian sayısal (h=10^{-4} merkezî fark) alınır. Sonuç \ell=-642{,}5320137; \hat{\boldsymbol\beta}_1=(-0{,}208588;\ 4{,}814502;\ 0{,}036537), \hat{\boldsymbol\beta}_2=(14{,}712879;\ 9{,}848458;\ -0{,}968530); SH (1{,}009204;\ 0{,}509612;\ 0{,}049755) ve (1{,}323777;\ 0{,}591588;\ 0{,}055261). Şablonun tablosuyla katsayılarda en çok 7\cdot10^{-5}, SH'lerde 2\cdot10^{-6} fark vardır. Saf olabilirlikte \hat\sigma=(3{,}444404;\ 3{,}450931), \hat\pi=(0{,}494000;\ 0{,}506000), \mathrm{BIC}=1332{,}748884 (şablonunkinden 0{,}026 küçük).
Adım 4 — K=1. Doğrusal model: \hat{\boldsymbol\beta}=(4{,}678682;\ 8{,}505582;\ -0{,}565838), \sigma^2=\mathrm{SSE}/(n-3) ile \ell=-728{,}314881, d=4, \mathrm{BIC}=1477{,}823032; şablonun bilgi ölçütleri tablosundaki ilk satırla aynıdır (ICL = BIC çünkü sert entropi 0).
Adım 5 — Poisson. yp için iki bileşenli Poisson karışımı: \ell=-440{,}386927, d=7, \mathrm{AIC}=894{,}773854, \mathrm{BIC}=917{,}862076; katsayılar ve SH tabloyla 10^{-4} içinde aynıdır. Poisson EM'i düz bir olabilirlik yüzeyinde yavaş yakınsar; \hat\pi ve ICL bağımsız hesapla 10^{-4} ve 4\cdot10^{-3} farklıdır (aşağıdaki tabloda ölçütler buna göre).
165.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | Ölçüt | |
|---|---|---|---|---|---|---|
| Normal: log-olabilirlik | −642,5451665 | −642,54516648 | −642,54516648 | 3,5e−11 | 1e−6 | ✓ |
| Normal: parametre sayısı | 9 | 9 | 9 | 0 | 1e−6 | ✓ |
| Normal: AIC | 1303,09033301 | 1303,09033296 | 1303,09033296 | 3,4e−11 | 1e−6 | ✓ |
| Normal: BIC | 1332,77518931 | 1332,77518926 | 1332,77518926 | 3,4e−11 | 1e−6 | ✓ |
| Normal: ICL (sert atamayla) | 1369,17532834 | 1369,17532881 | 1369,17532881 | 3,4e−10 | 1e−4 | ✓ |
| Normal: göreli entropi | 0,80056037 | 0,80056037 | 0,80056037 | 5,0e−9 | 1e−4 | ✓ |
| Normal: karışım oranı, bileşen 1 | 0,49415537 | 0,49415536 | 0,49415536 | 1,1e−8 | 1e−4 | ✓ |
| Normal: \sigma, bileşen 1 | 3,47566592 | 3,47566571 | 3,47566571 | 6,0e−8 | 1e−4 | ✓ |
| Normal: atanan sayısı, bileşen 1 | 100 | 100 | 100 | 0 | 1e−6 | ✓ |
| Normal: karışım oranı, bileşen 2 | 0,50584463 | 0,50584464 | 0,50584464 | 1,1e−8 | 1e−4 | ✓ |
| Normal: \sigma, bileşen 2 | 3,48022694 | 3,4802271 | 3,4802271 | 4,4e−8 | 1e−4 | ✓ |
| Normal: atanan sayısı, bileşen 2 | 100 | 100 | 100 | 0 | 1e−6 | ✓ |
| Normal: katsayı, bileşen 1, kesişim | −0,20851874 | −0,20858801 | −0,20856561 | 6,9e−5 | 2e−4 | ✓ |
| Normal: SH, bileşen 1, kesişim | 1,00920642 | 1,0092038 | 1,00920791 | 2,6e−6 | 2e−4 | ✓ |
| Normal: katsayı, bileşen 1, x | 4,81446435 | 4,8145016 | 4,81448637 | 7,7e−6 | 2e−4 | ✓ |
| Normal: SH, bileşen 1, x | 0,50960961 | 0,50961242 | 0,50961436 | 4,8e−6 | 2e−4 | ✓ |
| Normal: katsayı, bileşen 1, x^2 | 0,03654004 | 0,03653655 | 0,03653809 | 3,5e−6 | 2e−4 | ✓ |
| Normal: SH, bileşen 1, x^2 | 0,0497551 | 0,04975532 | 0,04975547 | 3,7e−7 | 2e−4 | ✓ |
| Normal: katsayı, bileşen 2, kesişim | 14,71322518 | 14,71287938 | 14,71291588 | 2,4e−5 | 2e−4 | ✓ |
| Normal: SH, bileşen 2, kesişim | 1,32377436 | 1,32377723 | 1,32377188 | 2,2e−6 | 2e−4 | ✓ |
| Normal: katsayı, bileşen 2, x | 9,84830961 | 9,84845789 | 9,84843779 | 1,5e−5 | 2e−4 | ✓ |
| Normal: SH, bileşen 2, x | 0,59158298 | 0,59158769 | 0,59158545 | 4,7e−6 | 2e−4 | ✓ |
| Normal: katsayı, bileşen 2, x^2 | −0,96851718 | −0,96852993 | −0,96852799 | 1,3e−5 | 2e−4 | ✓ |
| Normal: SH, bileşen 2, x^2 | 0,0552603 | 0,05526062 | 0,05526045 | 3,2e−7 | 2e−4 | ✓ |
| Normal, K=1: log-olabilirlik (\sigma^2=\mathrm{SSE}/(n-p)) | −728,31488133 | −728,31488133 | −728,31488133 | 3,1e−16 | 1e−6 | ✓ |
| Normal, K=1: BIC | 1477,82303213 | 1477,82303213 | 1477,82303213 | 1,7e−15 | 1e−6 | ✓ |
| Normal, K=2 (bilgi ölçütleri tablosu): BIC | 1332,77518931 | 1332,77518926 | 1332,77518926 | 3,4e−11 | 1e−6 | ✓ |
| Poisson: log-olabilirlik | −440,3869271 | −440,38692688 | −440,38692688 | 4,9e−10 | 1e−6 | ✓ |
| Poisson: parametre sayısı | 7 | 7 | 7 | 0 | 1e−6 | ✓ |
| Poisson: AIC | 894,7738542 | 894,77385377 | 894,77385377 | 4,8e−10 | 1e−6 | ✓ |
| Poisson: BIC | 917,86207576 | 917,86207533 | 917,86207533 | 4,7e−10 | 1e−6 | ✓ |
| Poisson: ICL (sert atamayla) | 1060,74057436 | 1060,74433195 | 1060,74433254 | 3,5e−6 | 1e−4 | ✓ |
| Poisson: göreli entropi | 0,26786357 | 0,26785422 | 0,26785422 | 9,3e−6 | 1e−4 | ✓ |
| Poisson: karışım oranı, bileşen 1 | 0,46692675 | 0,46698702 | 0,46698703 | 6,0e−5 | 1e−4 | ✓ |
| Poisson: atanan sayısı, bileşen 1 | 84 | 84 | 84 | 0 | 1e−6 | ✓ |
| Poisson: karışım oranı, bileşen 2 | 0,53307325 | 0,53301298 | 0,53301297 | 6,0e−5 | 1e−4 | ✓ |
| Poisson: atanan sayısı, bileşen 2 | 116 | 116 | 116 | 0 | 1e−6 | ✓ |
| Poisson: katsayı, bileşen 1, kesişim | 1,24434891 | 1,24430534 | 1,24436695 | 3,5e−5 | 2e−4 | ✓ |
| Poisson: SH, bileşen 1, kesişim | 0,28615794 | 0,2860666 | 0,28607458 | 9,1e−5 | 5e−4 | ✓ |
| Poisson: katsayı, bileşen 1, x | 0,05897596 | 0,05898545 | 0,05895666 | 1,9e−5 | 2e−4 | ✓ |
| Poisson: SH, bileşen 1, x | 0,10624034 | 0,10632146 | 0,10632087 | 8,1e−5 | 5e−4 | ✓ |
| Poisson: katsayı, bileşen 1, x^2 | 5,097040·10−4 | 5,087542·10−4 | 5,113121·10−4 | 1,6e−6 | 2e−4 | ✓ |
| Poisson: SH, bileşen 1, x^2 | 0,00899378 | 0,00898804 | 0,00898796 | 5,8e−6 | 5e−4 | ✓ |
| Poisson: katsayı, bileşen 2, kesişim | 1,78608234 | 1,78613611 | 1,78613358 | 3,0e−5 | 2e−4 | ✓ |
| Poisson: SH, bileşen 2, kesişim | 0,20675139 | 0,20666049 | 0,20667618 | 9,1e−5 | 5e−4 | ✓ |
| Poisson: katsayı, bileşen 2, x | −0,09492633 | −0,09492728 | −0,0949304 | 4,1e−6 | 2e−4 | ✓ |
| Poisson: SH, bileşen 2, x | 0,10090064 | 0,10123136 | 0,1012345 | 3,3e−4 | 5e−4 | ✓ |
| Poisson: katsayı, bileşen 2, x^2 | −0,00796546 | −0,00796768 | −0,00796715 | 2,2e−6 | 2e−4 | ✓ |
| Poisson: SH, bileşen 2, x^2 | 0,01128104 | 0,01135722 | 0,01135741 | 7,6e−5 | 5e−4 | ✓ |
| Poisson, K=1: log-olabilirlik | −460,1163664 | −460,1163664 | −460,1163664 | 1,1e−15 | 1e−6 | ✓ |
Ölçütü karşılayan: 50/50. Bağımsız Python ve R: flexmix kullanılmadan, kendi EM'i (normal bileşende şablonun kullandığı \sigma^2=\sum w r^2/\sum w\times N/(N-p) tanımıyla) ve tüm parametrelerde en çok olabilirlik (BFGS, Newton cilası, sayısal Hessian) ile. Katsayı ve SH şablonda refit (optim) çıktısından geldiği için bağımsız tam en çok olabilirlik çözümüyle 10^{-4} düzeyinde uyuşur; ölçüt bu satırlarda 2\cdot10^{-4}'tür.
Ek denetimler: (i) flexmix vinyetinin belgelediği normal karışım değerleri (\ell=-642{,}5451; bileşen 1: -0{,}2085;\ 4{,}8145;\ 0{,}0365; bileşen 2: 14{,}713;\ 9{,}848;\ -0{,}9685) şablonla uyuşur. Üstbilgi Poisson için -440{,}6424 verir; bu değer x içinde karesiz modele aittir: şablonun karesiz Poisson uydurması (\mathrm{kare} kapalı) -440{,}6403 verir ve fark 2\cdot10^{-3}'tür, kareli örnek ayarda -440{,}3869'dur. (ii) Bağımsız hesap ile şablon arasında bileşen sırası aynıdır (kesişime göre artan). (iii) 20 başlangıçlı bağımsız EM, K=2'de tek bir çözüme birleşir.
165.7 Çıktıyı okuma
Örnek ayarın konsol çıktısı (p4_sk_ornek):
2 bileşenli karışım (gaussian), n = 200, logLik = -642,5452, BIC = 1332,775, 5 başlangıç
Tablolar (Sonuçlar sekmesi; ondalık nokta tablodaki gibi):
Bileşen katsayıları (2 bileşen, SH ortak bilgi matrisinden)
 bilesen        terim  kestirim       SH          z             p
       1  (Intercept)  -0.208519  1.009206  -0.206616  8.363094e-01
       1            x   4.814464  0.509610   9.447357  3.474931e-21
       1       I(x^2)   0.036540  0.049755   0.734398  4.627061e-01
       2  (Intercept)  14.713226  1.323774  11.114602  1.065243e-28
       2            x   9.848309  0.591583  16.647383  3.161276e-62
       2       I(x^2)  -0.968517  0.055260 -17.526454  9.001004e-69

Karışım oranları ve bileşen büyüklükleri
 bilesen  karisim_orani     sigma  atanan
       1       0.494155  3.475665     100
       2       0.505845  3.480227     100

Model uyumu
 logLik     -642.545166    parametre sayısı 9    AIC 1303.090333
 BIC 1332.775189    ICL 1369.175330    göreli entropi 0.800560    EM yineleme 26

Bileşen sayısına göre bilgi ölçütleri
 K      logLik          AIC          BIC          ICL
 1 -728.314881  1464.629763  1477.823032  1477.823032
 2 -642.545166  1303.090333  1332.775189  1369.175330
(Tablolar sütun düzeniyle kısaltılmıştır; değerler dogrulama/cikti/p4_sk_ornek/ altındaki tablo1–4.pkl dosyalarındandır.)
Şekil 165.1. Şablonun çizdiği dağılım grafiği (örnek veri): renk, en büyük sonsal olasılıkla atanan bileşendir. Alt grup 1 (mor) doğrusal kolu, alt grup 2 (turuncu) parabolü yakalar; x\approx 4–9 aralığında iki kol kesiştiği için atamalar orada belirsizdir.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
kestirim, SH, z, p |
Bileşenin katsayıları ve Wald testi. | Her bileşen kendi regresyonudur. Bileşen 2'de x^2 katsayısı anlamlı (z=-17{,}5), bileşen 1'de değil (p=0{,}46): bileşen 1 doğrusal, bileşen 2 eğridir. Etiket sırası kesişimle verilir ve anlamsal değildir. |
karisim_orani |
\hat\pi_k | Evrenin yaklaşık yüzde kaçının o bileşenden olduğu. Eş değişken varsa ortalama olasılık. |
sigma |
Bileşenin artık sd'si | Yalnız normal bileşende. Flexmix tanımıyla (165.4.2) saf olabilirlikten %0,9 büyük. |
atanan |
Sert atamada gözlem sayısı | max.col ile en büyük \tau_{ik}; \sum_k\tau_{ik} değil, tam sayıdır ve \hat\pi_kn'e eşit olmak zorunda değildir. |
logLik, AIC, BIC |
Uyum ve ceza | Küçük AIC/BIC iyidir. BIC en çok güvenilen ölçüttür ama olabilirlik yüzeyi düzken K'yı küçük seçer. |
ICL |
BIC + sert atama entropisi | Bileşenler iyi ayrılmıyorsa BIC'ten belirgin büyük olur ve daha az bileşeni seçer. Burada fark 36{,}4. |
göreli entropi |
1 − yumuşak entropi / (n\ln K) | 1'e yakın: ayrılabilir bileşenler. Örnekte 0{,}80; 0{,}6 altı zayıf ayrışma işaretidir (ör. K=3 tek bileşenli veride 0{,}61). |
EM yineleme |
Son EM yineleme sayısı | Yakınsadı demek değildir; üst sınıra (5000 ya da en_cok_yineleme) eşitse yakınsama olmamıştır; olağan EM'de bu durumda şablon ayrıca uyarı yazar (165.8). |
| Bilgi ölçütleri tablosu | 1..K için ölçütler | K=3 log-olabilirliği artırır (-636{,}28) ama BIC 1346{,}73 ile K=2'den (1332{,}78) kötüdür; tablo K=2'yi seçer. |
Rapor cümlesi. Yanıt
yn, açıklayıcıxve x^2 ile iki bileşenli normal sonlu karışım regresyonu uydurulmuştur (EM, 5 rastgele başlangıç; n=200). Bileşen oranları 0{,}49 ve 0{,}51 bulunmuştur. Birinci bileşende x'in eğimi 4{,}81 (\mathrm{SH}=0{,}51) ve kareli terim anlamsızdır (p=0{,}46); ikinci bileşende eğim 9{,}85 (\mathrm{SH}=0{,}59) ve kareli terim -0{,}97'dir (\mathrm{SH}=0{,}055). Bilgi ölçütleri iki bileşeni destekler (\mathrm{BIC}=1332{,}8; tek bileşen 1477{,}8; üç bileşen 1346{,}7).
165.8 Sık hatalar ve tuzaklar
- Yerel en büyük. Tek başlangıçla K=3 uydurması, 8 tohumda üç farklı çözüm verir: \ell=-636{,}2778 (tohum 1 ve 4), -638{,}4441 (2, 3 ve 8) ve -639{,}5865 (5, 6 ve 7). BIC'ler 1346{,}73, 1351{,}07, 1353{,}35'tir. En iyi çözüm bile oranı 0{,}06 ve \sigma=0{,}79 olan küçük bir bileşen içerir ve bu bileşen gerçek bir alt grup olmayabilir (sonraki madde). K\ge3 için başlangıç sayısını artırın (varsayılan 20); örnek ayardaki 5 başlangıç K=2 için yeterlidir.
- Sahte bileşen. Bileşen sayısı gerçek sayıdan büyük seçilirse küçük oranlı ve çok küçük \sigma'lı bileşenler ortaya çıkar. Tek bileşenli benzetimde (n=150, gerçek \sigma=2) K=2 uydurması \hat\pi=(0{,}076;\ 0{,}924) ve \hat\sigma=(0{,}27;\ 1{,}93) verir ve \ell'yi 4{,}8 artırır; BIC 663{,}2 (tek bileşen: 652{,}8) bunu reddeder. Üç bileşenli doğru modelde (n=450) K=4'te oranı 0{,}068 olan fazladan bir bileşen çıkar; BIC K=3'ü seçer (2613{,}5 karşı 2633{,}4).
en_kucuk_oraneşiği yalnız oranı kontrol eder; küçük \sigma'ya (olabilirliğin tekilliği) karşı koruma yoktur. - Yakınsama bayrağı.
en_cok_yineleme = 10verildiğinde şablon \ell=-643{,}0001 ile "Model uyumu"ndaEM yineleme = 10yazar ve "EM yineleme sınırına (10) ulaştı ve yakınsamadı" uyarısı verir; sonuç yakınsamamış bir çözümdür (m@convergedyanlış). SEM ve CEM için bayrak kullanılmaz: SEM her zaman üst sınırı (5000) bulur ve şablon bunu bir not satırıyla belirtir. - Eksik değerli satırlar. Eksik değerli satırlar atılır ve sayısı yazılır (
eksik.csv: 15 satır silinir, n=185). Eksikliğin hangi sütunda olduğu yazılmaz; yanıt, açıklayıcı ve eş değişken sütunlarında ayrı ayrı denetleyin. - Eş değişken, açıklayıcıyla aynı. Aynı sütun hem açıklayıcı hem eş değişken seçilirse eş değişken düşer ve bir uyarı satırı bunu bildirir (103–105); sonuç eş değişkensiz modelin aynısıdır (\ell=-642{,}5452) ve eş değişken tablosu çıkmaz.
- Eş değişken ayrıştırıyorsa. Gerçek sınıfı (
class) eş değişken olarak seçmek üyelikleri neredeyse tam ayırır: lojit katsayıları 25{,}06 ve -37{,}62, oranlar 0{,}5/0{,}5, SH'ler güvenilmez. Eş değişken, bileşeni tanımlayan değişkenin kendisi olmamalıdır. - İkili lojistik.
aile = binomialseçildiğindeflexmixyanıtı iki sütunlu (başarı, başarısızlık) ister; şablon formülün sol tarafınıcbind(y, 1 - y)yapar (129–131) ve 0/1 yanıtla çalışır. Tam ayıran verilerde olabilirlik düz kalabilir ve çözüm kararsızlaşabilir; bileşen katsayılarına dikkat edin. - Tam doğrusal bağımlı açıklayıcılar.
xve2xbirlikte seçildiğinde model matrisinin sırası eksik kalır ve şablon "Açıklayıcılar tam doğrusal bağımlı" iletisiyle durur; iletide bağımlı terim adlandırılır (128–131). Sayısal sütunun bir kopyasını ya da başka sütunun doğrusal bileşimini çıkarın. - Ondalık virgüllü sütun.
4,177gibi virgüllü sayılarla okunmuş bir açıklayıcı Veri sekmesinde metindir; şablon bunu fark eder ve "sütunu metin olarak okundu (ondalık virgüllü sayılar)" iletisiyle durur (121). Veri sekmesinde ondalık ayracını nokta yapın. - Sayısal sütun "kategorik" gelirse. Açıklayıcı olarak seçilen 1–4 puanlı tam sayı sütunu Veri sekmesinde "kategorik" ise kukla kodlanır ve
kareo sütun için uygulanmaz (örnektepuan2…puan4). Sayısal etki isteniyorsa sütunun türünü Veri sekmesinde sayısal yapın. - Kategorik düzeylerin sırası. Kukla katsayıların adı ve başvuru düzeyi 1.3'teki kurala bağlıdır:
10,2,1etiketli sütun1,2,10sırasını alır (başvuru1; katsayılaretiket2,etiket10). İki düzeyli metin sütununda başvuru alfabetik ilk düzeydir. - Bileşen etiketi anlamsızdır. Bileşenler kesişime göre sıralanır; "bileşen 1" "düşük kesişimli grup" demektir. Yeni bir uydurmada ya da başka bir tohumda etiket aynı kalır ama K değişince kayabilir.
- CEM ve SEM çıktıları. CEM'in log-olabilirliği (-642{,}9905) ve SEM'in (-642{,}6613) olağan EM'den (-642{,}5452) kötüdür ve SH yoktur. Bu EM türleri yalnız hızlı keşif içindir.
- Tohum. Başlangıçlar rastgeledir; sonucu yinelemek için Kod panelindeki Tohum alanını (Bölüm 1.3) kullanın. Şablonun kendi formunda tohum alanı yoktur. K=2'de örnek veride sonuç tohumdan bağımsızdır (3 tohumda log-olabilirlik -642{,}5452).
165.9 Uzman soruları
S1. Raporlanan log-olabilirlik neden saf en çok olabilirlik değeri değil?
flexmix, normal bileşende \sigma^2'yi \sum w r^2/\sum w\times n/(n-p) ile kestirir; EM bu \sigma ile iterasyonu sürdürür ve sabit noktası olabilirliğin gerçek en büyüğü değildir. Örnekte -642{,}5452 ile -642{,}5320 arasındaki fark 0{,}0132'dir ve model seçimini değiştirmez, ama başka bir programın değeriyle (n/(n-p) düzeltmesiz) birebir karşılaştırılamaz. Düzeltme toplam n ve p ile yapıldığından bileşenin kendi etkin örneklem büyüklüğüne bakmaz; küçük bileşenlerde \sigma bu yüzden yine de aşağı yanlıdır.
S2. Tablodaki katsayılar neden EM çözümünün katsayıları değil?
Şablon, EM çözümünü refit'e verir ve refit bütün parametrelerde olabilirliği yeniden en büyükler; kod EM katsayısının üstüne bu çözümün katsayısını yazar (173). refit çözümünde \sigma da serbest ve saf olabilirlik tanımındadır, EM çözümünde değil. İki çözüm x katsayısında 2\cdot10^{-3} ayrışır (4,8165 ve 4,8145). Karşılaştırma yapılacaksa tablodaki katsayılarla saf olabilirlik çözümü (4{,}8145) uyuşur; \sigma ve log-olabilirlik ise EM çözümünündür.
S3. Bileşen sayısını nasıl seçmeliyim: AIC, BIC mi ICL mi?
AIC ayrışmayan bileşenleri de ödüllendirir ve çoğunlukla büyük K seçer (K=3 örnekte AIC 1300{,}56, K=2'nin 1303{,}09'undan küçüktür). BIC'in cezası d\ln n daha sıkıdır (örnekte K=2). ICL, ayrışmayı da cezalandırır; amaç anlamlı, ayrılabilir gruplar ise ICL'yi tercih edin. Üçü de çelişirse iki K değerini de bileşen büyüklükleri ve \sigma ile yorumlanabilirliğine göre değerlendirin; çok küçük oranlı (<0{,}1) ve çok küçük \sigma'lı bileşen sahte olabilir (165.8).
S4. Şablon gerçek en büyüğü bulduğunu nasıl garanti eder?
Garanti etmez. En yüksek log-olabilirlikli çözümü baslangic rastgele başlangıç arasından seçer ve K=3 örneğinde tek başlangıç üç farklı çözüm verdi (165.8). Çok başlangıçlı çözümlerin hepsi aynı değeri veriyorsa güven artar: bağımsız hesapta K=2 için 20 başlangıcın tümü -642{,}5452 verdi. Şablon başlangıçlar arası tutarlılığı çıktıya yazmaz; kullanıcı aynı ayarı iki üç tohumla yineleyerek bakmalıdır.
S5. `en_cok_yineleme` yetmezse ne olur?
EM üst sınırda kesilir, şablon o ana kadarki çözümü refit ile işler, yineleme sayısını "EM yineleme" satırına yazar ve olağan EM için "yakınsamadı" uyarısı verir. Örnekte 10 yineleme \ell=-643{,}0001 verdi (yakınsamış -642{,}5452'den 0{,}455 kötü). Çözüm en_cok_yineleme artırmak ve toleransı gevşetmemektir.
S6. Eş değişkenli model neden bazen \pi'yi kararsız bırakır?
Eş değişken üyeliği neredeyse tam ayırıyorsa çok terimli lojit tam ayrışmaya gider ve katsayılar sonsuza kaçar (örnekte 25{,}06 ve -37{,}62); SH güvenilmez olur, "karışım oranı" ortalama olasılıktan ibaret kalır. Bu, eş değişkenin bileşeni zaten tanımladığının işaretidir; bu durumda bileşen değişkeni açıklayıcı olarak ve etkileşimle modellemek daha doğrudur.
S7. CEM ve SEM neden SH vermez?
refit yalnız ağırlıklı en çok olabilirlik kestiriminde çalışır ("Only for weighted ML estimation possible"); CEM sert atama, SEM rastgele atama yaptığından olabilirlik tamlanmamış veri olabilirliği değildir. Şablon bu durumda SH, z ve p sütunlarını NaN bırakır, tablo başlığını "SH hesaplanamadı" yapar ve bir not satırı yazar. CEM ve SEM çözümleri yalnız başlangıç değeri üretmek ve hızlı keşif için uygundur; çıkarım için olağan EM kullanılmalıdır.
S8. ICL ile şablonun "göreli entropisi" neden aynı entropiyi kullanmaz?
flexmix::ICL sert atamanın log-olasılığını (-\sum_i\ln\tau_{i,\hat k_i}) BIC'e ekler. Şablonun "göreli entropi" satırı ise yumuşak Shannon entropisini n\ln K'e bölüp 1'den çıkarır (188). İki ölçü farklı şeyi ölçer: biri atama kesinliğini, öteki ceza terimini. Raporlarken hangi entropinin hangi ölçüte girdiği belirtilmelidir.
165.10 Kaynaklar
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/TAC.1974.1100705
- Biernacki, C., Celeux, G., & Govaert, G. (2000). Assessing a mixture model for clustering with the integrated completed likelihood. IEEE Transactions on Pattern Analysis and Machine Intelligence, 22(7), 719–725. https://doi.org/10.1109/34.865189
- Celeux, G., & Govaert, G. (1992). A classification EM algorithm for clustering and two stochastic versions. Computational Statistics & Data Analysis, 14(3), 315–332.
- Dempster, A. P., Laird, N. M., & Rubin, D. B. (1977). Maximum likelihood from incomplete data via the EM algorithm. Journal of the Royal Statistical Society: Series B, 39(1), 1–22. https://doi.org/10.1111/j.2517-6161.1977.tb01600.x
- DeSarbo, W. S., & Cron, W. L. (1988). A maximum likelihood methodology for clusterwise linear regression. Journal of Classification, 5(2), 249–282. https://doi.org/10.1007/BF01897167
- Grün, B., & Leisch, F. (2008). FlexMix version 2: Finite mixtures with concomitant variables and varying and constant parameters. Journal of Statistical Software, 28(4), 1–35. https://doi.org/10.18637/jss.v028.i04
- Grün, B., & Leisch, F. (2026). flexmix: Flexible mixture modeling (R paketi, sürüm 2.3-21). https://CRAN.R-project.org/package=flexmix
- Leisch, F. (2004). FlexMix: A general framework for finite mixture models and latent class regression in R. Journal of Statistical Software, 11(8), 1–18. https://doi.org/10.18637/jss.v011.i08
- R Core Team (2026). R: A language and environment for statistical computing. R Foundation for Statistical Computing.
- Schwarz, G. (1978). Estimating the dimension of a model. The Annals of Statistics, 6(2), 461–464. https://doi.org/10.1214/aos/1176344136
- Wedel, M., & DeSarbo, W. S. (1995). A mixture likelihood approach for generalized linear models. Journal of Classification, 12(1), 21–55. https://doi.org/10.1007/BF01202266