94. NIST SP 800-22 rastgelelik testleri
Şablon kimliği: nist_rastgelelik · Kategori: benzetim · Dil: Python · Dosya: pro/sablonlar/benzetim/nist_rastgelelik.py (satır 1–821; üstbilgi 1–169) · Örnek veri: _ornek/nist_pi_e.csv · Paketler: numpy 2.4.6, scipy 1.16.3, pandas 2.3.3, matplotlib 3.10.9
94.1 Ne işe yarar
Şablon, 0 ve 1'lerden oluşan bir diziyi (rastgele sayı üretecinin çıktısı, bir şifreleme algoritmasının akışı, \pi ya da e gibi bir sabitin ikili açılımı) NIST SP 800-22 Rev. 1a standardındaki 15 testle sınar. Cevapladığı soru şudur: "Elimdeki bit dizisi, yansız ve birbirinden bağımsız yazı-tura atışlarından oluşan bir diziden bu 15 özellikte ayırt edilebiliyor mu?"
Sıfır hipotezi, her bitin \tfrac12 olasılıkla 1 olduğu ve bitlerin bağımsız olduğudur. Her test, dizinin farklı bir özelliğine bakar: 1'lerin oranına, art arda gelen aynı bitlere, periyodikliğe, belirli desenlerin sıklığına, sıkıştırılabilirliğe, doğrusal yapıya ve rastgele yürüyüşün davranışına. Her test istatistiği sıfır hipotezi altında bilinen bir dağılımdan geçer ve bir p değeri verir. Standart, p<\alpha ise dizinin o testi geçemediğini söyler; varsayılan düzey \alpha=0{,}01'dir. Birden çok dizi verildiğinde şablon standardın ikinci düzey çözümlemesini de yapar: geçen dizi oranı ve p değerlerinin tekdüzeliği (94.4.16).
Ne zaman kullanılır?
- Bir üretecin ürettiği ikili diziyi değerlendirmek. Testlerin çoğu için en az 10^6 bit gerekir (94.4'teki tablo).
- Aynı üreteçten alınan çok sayıda dizinin (ör. 100 farklı tohum) ikinci düzey çözümlemesini yapmak.
- Sürekli bir ölçümü medyan eşiğiyle ikiliye çevirip aynı bataryadan geçirmek (
donusum = medyan; 94.8'deki uyarıya bakın).
Ne zaman kullanılmaz?
- Sürekli bir ölçümün normal ya da düzgün dağılıma uyup uymadığı sorusu için: temel programdaki dağılım uyum ve normallik analizleri. Bu şablon bit dizisinin bağımsızlığını ve düzgünlüğünü sınar, ölçümün dağılımını değil.
- Yalnızca ardışıklık (ortancaya göre runs) sorusu için: temel programdaki runs testi. Bu şablonun 3. testi aynı adı taşır ama aynı tanım değildir (94.4.3).
- Bir üretecin kriptografik olarak güvenli olduğunu kanıtlamak için: bataryayı geçmek, bakılan özelliklerde kusur bulunmadığını gösterir; güvenlik kanıtı değildir (Rukhin ve ark., 2010, Bölüm 1).
- Tek bir dizinin tek bir küçük p değerinden karar vermek için: tek dizide 188 p değeri üretilir (94.4.17); karar birçok dizi ve ikinci düzey çözümlemeyle verilir.
Temel programla ilişki. Temel programdaki runs testi, bit sayıları n_1 ve n_2 verildiğinde ardışık dizi sayısının koşullu dağılımına (kesin dağılım ya da süreklilik düzeltmeli normal yaklaşık) dayanır. NIST'in 3. testi ise 1'lerin oranını kestirir, bu orana bağlı bir normal yaklaşık kullanır ve oran \tfrac12'den 2/\sqrt n kadar uzaktaysa testi hiç uygulamadan p=0 yazar. İkisi aynı istatistik değildir; aynı diziden farklı p değerleri çıkabilir. Başka hiçbir NIST testinin temel programda karşılığı yoktur.
94.2 Şablonun girdileri
Form, üstbilgideki yirmi dört [[param]] bloğundan kurulur: dokuz veri ve ayar alanı ile on beş test onay kutusu (nist_rastgelelik.py:11–168). Türlerin ve formun ortak denetiminin anlamı Bölüm 1.2'de anlatılmıştır.
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Bit dizisi sütunları · sutunlar |
sütunlar (yalnız sayısal) · Değişkenler | yok (en az 1) | sayısal sütun | Her sütun ayrı bir bit dizisidir (11–17, 632–656). |
Seçili sütunları alt alta tek dizide birleştir · birlestir |
onay kutusu · Değişkenler | kapalı | açık / kapalı | Açıksa ve en az iki sütun seçiliyse sütunlar uç uca eklenip tek dizi yapılır; dizi adı a + b olur (18–23, 657–658). |
Sayıdan bite çevirme · donusum |
seçim · Model | ikili |
ikili, medyan |
ikili: değerler tam 0 ya da 1 olmalıdır. medyan: medyandan büyük olan 1, öteki 0; bütün bitler aynı çıkarsa şablon durur (24–30, 644–655). |
Anlamlılık düzeyi \alpha · alfa |
ondalık · Model | 0,01 | 0,0001–0,2 | Geçti/kaldı sınırı ve ikinci düzey kabul aralığının merkezi 1-\alpha (31–38, 607, 777). |
Blok içi frekans testi blok uzunluğu M · blok_M |
tamsayı · Gelişmiş | 128 | 2–100000 | 2. testin blok uzunluğu (39–46, 683). |
Örtüşmeyen şablon uzunluğu m · sablon_m |
tamsayı · Gelişmiş | 9 | 2–10 | 7. testin şablon uzunluğu; m=9 için 148 şablon (47–54, 688). |
Seri testi desen uzunluğu m · seri_m |
tamsayı · Gelişmiş | 0 | 0–24 | 0: otomatik, \min(16,\lfloor\log_2 n\rfloor-3) (55–62, 679). |
Yaklaşık entropi desen uzunluğu m · entropi_m |
tamsayı · Gelişmiş | 0 | 0–20 | 0: otomatik, \min(10,\lfloor\log_2 n\rfloor-6) (63–70, 680). |
Doğrusal karmaşıklık blok uzunluğu M · lk_M |
tamsayı · Gelişmiş | 500 | 500–5000 | 10. testin blok uzunluğu (71–78, 691). |
Frekans (monobit) · t_frekans |
onay kutusu · Seçenekler | işaretli | açık / kapalı | 94.4.1 testini çalıştırır ya da atlar; kapalıysa test SECILI listesine girmez, özet ve ayrıntı tablosunda yer almaz. (79–84, 629) |
Blok içi frekans · t_blok_frekans |
onay kutusu · Seçenekler | işaretli | açık / kapalı | 94.4.2 testini çalıştırır ya da atlar; kapalıysa test SECILI listesine girmez, özet ve ayrıntı tablosunda yer almaz. (85–90, 629) |
Runs · t_runs |
onay kutusu · Seçenekler | işaretli | açık / kapalı | 94.4.3 testini çalıştırır ya da atlar; kapalıysa test SECILI listesine girmez, özet ve ayrıntı tablosunda yer almaz. (91–96, 629) |
Bloktaki en uzun 1'ler dizisi · t_en_uzun_run |
onay kutusu · Seçenekler | işaretli | açık / kapalı | 94.4.4 testini çalıştırır ya da atlar; kapalıysa test SECILI listesine girmez, özet ve ayrıntı tablosunda yer almaz. (97–102, 629) |
İkili matris rankı · t_matris_rank |
onay kutusu · Seçenekler | işaretli | açık / kapalı | 94.4.5 testini çalıştırır ya da atlar; kapalıysa test SECILI listesine girmez, özet ve ayrıntı tablosunda yer almaz. (103–108, 629) |
Ayrık Fourier (spektral) · t_dft |
onay kutusu · Seçenekler | işaretli | açık / kapalı | 94.4.6 testini çalıştırır ya da atlar; kapalıysa test SECILI listesine girmez, özet ve ayrıntı tablosunda yer almaz. (109–114, 629) |
Örtüşmeyen şablon eşleşmesi · t_ortusmeyen_sablon |
onay kutusu · Seçenekler | işaretli | açık / kapalı | 94.4.7 testini çalıştırır ya da atlar; kapalıysa test SECILI listesine girmez, özet ve ayrıntı tablosunda yer almaz. (115–120, 629) |
Örtüşen şablon eşleşmesi · t_ortusen_sablon |
onay kutusu · Seçenekler | işaretli | açık / kapalı | 94.4.8 testini çalıştırır ya da atlar; kapalıysa test SECILI listesine girmez, özet ve ayrıntı tablosunda yer almaz. (121–126, 629) |
Maurer evrensel · t_evrensel_maurer |
onay kutusu · Seçenekler | işaretli | açık / kapalı | 94.4.9 testini çalıştırır ya da atlar; kapalıysa test SECILI listesine girmez, özet ve ayrıntı tablosunda yer almaz. (127–132, 629) |
Doğrusal karmaşıklık · t_dogrusal_karmasiklik |
onay kutusu · Seçenekler | işaretli | açık / kapalı | 94.4.10 testini çalıştırır ya da atlar; kapalıysa test SECILI listesine girmez, özet ve ayrıntı tablosunda yer almaz. (133–138, 629) |
Seri · t_seri |
onay kutusu · Seçenekler | işaretli | açık / kapalı | 94.4.11 testini çalıştırır ya da atlar; kapalıysa test SECILI listesine girmez, özet ve ayrıntı tablosunda yer almaz. Seçili değilse seri_m denetlenmez. (139–144, 629) |
Yaklaşık entropi · t_yaklasik_entropi |
onay kutusu · Seçenekler | işaretli | açık / kapalı | 94.4.12 testini çalıştırır ya da atlar; kapalıysa test SECILI listesine girmez, özet ve ayrıntı tablosunda yer almaz. Seçili değilse entropi_m denetlenmez. (145–150, 629) |
Kümülatif toplamlar (ileri, geri) · t_kumulatif_toplam |
onay kutusu · Seçenekler | işaretli | açık / kapalı | 94.4.13 testini çalıştırır ya da atlar; kapalıysa test SECILI listesine girmez, özet ve ayrıntı tablosunda yer almaz. (151–156, 629) |
Rastgele gezinti · t_rastgele_gezinti |
onay kutusu · Seçenekler | işaretli | açık / kapalı | 94.4.14 testini çalıştırır ya da atlar; kapalıysa test SECILI listesine girmez, özet ve ayrıntı tablosunda yer almaz. (157–162, 629) |
Rastgele gezinti varyantı · t_rastgele_gezinti_varyant |
onay kutusu · Seçenekler | işaretli | açık / kapalı | 94.4.15 testini çalıştırır ya da atlar; kapalıysa test SECILI listesine girmez, özet ve ayrıntı tablosunda yer almaz. (163–168, 629) |
Test seçimi. On beş onay kutusu varsayılan olarak işaretlidir; bir test işaretsizse hiç çalıştırılmaz. Hiçbiri işaretli değilse şablon durur. Seri ya da yaklaşık entropi seçili değilse seri_m ve entropi_m alanları denetlenmez (desen uzunluğu sınırı yalnız seçili testler için sınanır; 679–680). İkinci düzey çözümleme, çoklu test sayısı (94.4.17) ve grafik yalnız seçili testleri kapsar.
Diğer testlerin parametreleri (32×32 matris, 1032 bitlik örtüşen şablon bloğu, m=9 örtüşen şablon, Maurer'in L'si, rastgele gezinti durumları) forma açılmamıştır; kodda sabittir.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 606 |
| Hiçbir test seçilmemiş | "En az bir test seçin." | 631 |
| Sütun seçilmemiş | "En az bir bit dizisi sütunu seçin." | 634 |
| Sütunda sayısal değer yok | "… sütununda sayısal değer yok." | 643 |
medyan seçiliyken dönüşümden sonra bütün bitler aynı |
"… sütununda medyan çevirmesinden sonra bütün bitler aynı (medyan = …); sütun zaten 0/1 ise 'İkili (0/1)' dönüşümünü seçin." | 647–649 |
ikili seçiliyken sütunda 0/1 dışında değer var |
"… sütunu yalnız 0/1 içermeli (başka değer var). Medyan çevirmesini seçebilirsiniz." | 653–654 |
| Dizi 100 bitten kısa | "…: dizi en az 100 bit olmalı (şu an …)." | 661 |
seri_m ya da entropi_m, n için çok büyük |
"Desen uzunluğu m = …, n = … için çok büyük (en çok …)." | 667–668 (çağrı 679–680) |
Eksik ya da sayıya çevrilemeyen hücreler atılır ve atılan sayısı "Not: … eksik/sayı olmayan hücre atıldı." satırıyla yazılır (638–641). Sayıya çevirme ortak mq.sayisal yardımcısıyla yapılır (Bölüm 1.5); sütun veri sekmesinde kategorik görünse bile değerler sayı olarak okunur (94.8).
Örnek ayar (ornek_param, satır 10): sutunlar = ["pi", "e"], donusum = "ikili", alfa = 0.01; öteki alanlar varsayılandadır.
Uyarılar (durdurmaz). Bir test için dizi, standardın önerdiği en küçük uzunluktan kısaysa sonuç hesaplanır ama not sütununda "yaklaşık" diye işaretlenir ve konsola uyarı yazılır (705, 757–759). Bir testin koşulu hiç sağlanamıyorsa (ör. Maurer için n<387\,840) test "uygulanamaz" yazar ve nedeni not sütununa konur (672–673).
94.3 Örnek veri
Dosya: _ornek/nist_pi_e.csv; 1 000 000 satır, iki sütun, eksik değer yok (5 000 006 bayt). Sütunlar \pi ve e sabitlerinin ikili açılımının ilk 10^6 bitidir; tamsayı kısım dahildir (\pi=11{,}0010010000111111\ldots_2 ve e=10{,}1011011111100001\ldots_2). Açılımlar mpmath ile N+200 bit duyarlıkla hesaplanmıştır (nist_sp80022/uret_veri.py). NIST'in kendi veri dosyaları indirilmemiştir; dizilerin onlarla aynı olduğu, 16 testin p değerinin standardın Ek B'sinde yayımlanan değerlerle uyuşmasından anlaşılır (94.6.1).
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
pi |
bit dizisi 1 | ikili (0/1) | n=1\,000\,000; 1'lerin sayısı 499 722 (oran 0,499722) |
e |
bit dizisi 2 | ikili (0/1) | n=1\,000\,000; 1'lerin sayısı 500 029 (oran 0,500029) |
Sütunlar sayısal 0/1 olduğundan düzey sırası söz konusu değildir. Dizinin sırası önemlidir: satırlar sıralanır ya da karıştırılırsa dizinin kendisi değişir ve p değerleri değişir.
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar (iki dizi, 2\times10^6 bit toplam; 16,1 s); (2) nist_sp80022 doğrulamasındaki ek çalıştırma: \pi'nin ilk 10^7 bitinin ardışık 10^5'er bitlik 100 diziye bölünmesi (ikinci düzey çözümleme, 94.7); (3) küçük sınama çalıştırmaları (dogrulama/nist_rastgelelik/toplu.py: 2000 bitlik tohumlu dizilerle medyan, kategorik tür, hata iletileri; medyan_hata.py).
94.4 Yöntem: formüller ve hesap adımları
Her dizi için hesap sırası: (1) sütunu 0/1'e çevir, eksikleri at, gerekirse birleştir; (2) desen uzunluklarını sınırla; (3) seçili testleri (varsayılan: 15'i de) sırayla çalıştır, her test bir p değeri listesi döndürür; (4) her p değeri için p<\alpha ise "kaldı" (çoklu alt testli üç testin özet satırında karar Šidák düzeltmeli p ile verilir, 94.4.17); (5) iki ya da daha çok dizi varsa her test ve alt test için ikinci düzey çözümleme. Bitler \varepsilon_1,\dots,\varepsilon_n\in\{0{,}1\}, ±1 karşılıkları x_i=2\varepsilon_i-1'dir.
Aşağıdaki formüllerde \operatorname{igamc}(a,x)=Q(a,x)=\Gamma(a,x)/\Gamma(a) düzenlenmiş üst eksik gama işlevi, \operatorname{erfc} tümleyici hata işlevi, \Phi standart normal dağılım işlevidir. Kodda ilki scipy.special.gammaincc, ikincisi scipy.special.erfc, üçüncüsü scipy.stats.norm.cdf'tir (170–179).
Koddaki tercih
Şablon bir paket çağırmaz; 15 testi standardın formüllerinden saf numpy/scipy ile kurar (178–597). Olasılıklar kapalı formül ya da kesin hesapla bulunur: rank olasılıkları kapalı formülden (94.4.5), örtüşen şablon olasılıkları kesin dinamik programlamayla (94.4.8). Standart bu iki olasılık kümesini yuvarlak sayılarla da verir; şablonun değerleri bu sayılarla altı basamak aynıdır (94.6).
Testlerin önerilen en küçük uzunlukları kodda ONERILEN_N sözlüğündedir (609–612). Bundan kısa dizide test çalışır, sonuç "yaklaşık" işaretlenir.
| No | Test | Önerilen en küçük n | Koddaki satır |
|---|---|---|---|
| 1 | Frekans (monobit) | 100 | 190 |
| 2 | Blok içi frekans | 100 | 198 |
| 3 | Runs | 100 | 209 |
| 4 | Bloktaki en uzun 1'ler dizisi | 128 | 220 |
| 5 | İkili matris rankı | 38 912 | 267 |
| 6 | Ayrık Fourier (spektral) | 1000 | 298 |
| 7 | Örtüşmeyen şablon | 10^6 | 324 |
| 8 | Örtüşen şablon | 10^6 | 379 |
| 9 | Maurer evrensel | 387 840 | 407 |
| 10 | Doğrusal karmaşıklık | 10^6 | 461 |
| 11 | Seri | 1000 | 499 |
| 12 | Yaklaşık entropi | 1000 | 522 |
| 13 | Kümülatif toplamlar | 100 | 543 |
| 14 | Rastgele gezinti | 10^6 | 560 |
| 15 | Rastgele gezinti varyantı | 10^6 | 585 |
94.4.1 Frekans (monobit) testi
- S_n: 1'ler ile 0'ların sayısı arasındaki fark (n_1-n_0).
- s_{\text{obs}}: farkın, yansız dizide beklenen standart sapmaya (\sqrt n) oranı.
- Büyük n'de S_n/\sqrt n standart normal olduğundan p=2\{1-\Phi(s_{\text{obs}})\}'dir.
Test 1'lerin oranının \tfrac12'ye yakın olup olmadığına bakar (satır 190–194). Öteki testlerin çoğu bu oranın yaklaşık \tfrac12 olduğunu varsayar.
94.4.2 Blok içi frekans testi
Dizi, her biri M bitlik N=\lfloor n/M\rfloor ayrık bloğa bölünür; artan n-NM bit kullanılmaz. \pi_i, i'inci bloktaki 1'lerin oranıdır.
- 4M(\pi_i-\tfrac12)^2: i'inci bloğun standartlaştırılmış kare sapması (blokta 1'lerin sayısı \text{Binom}(M,\tfrac12)'dir).
- \chi^2: N bağımsız bloğun toplamı; sıfır hipotezinde yaklaşık \chi^2_N dağılır.
Blok uzunluğu M<n olmalıdır; N<1 ise test uygulanamaz (satır 198–205). Standart M\ge20, M>0{,}01\,n ve N<100 önerir; şablonun varsayılanı M=128'dir ve n=10^6'da N=7812 blok verir. Standardın kendi Ek B örneği de M=128 kullanır ve şablonun sonucu o değerle altı basamak uyuşur (94.6.1). Kod bu önerileri denetlemez ve blok_M en az 2 olabilir.
94.4.3 Runs testi
Bir run, aynı bitten oluşan kesintisiz bir dizidir. \hat\pi=\sum\varepsilon_i/n, \tau=2/\sqrt n. Önkoşul: |\hat\pi-\tfrac12|<\tau. Sağlanmıyorsa test uygulanmaz ve p=0 yazılır. Sağlanıyorsa
- V_n: toplam run sayısı (satır 214).
- 2n\hat\pi(1-\hat\pi): \hat\pi verildiğinde ve bitler bağımsızken beklenen run sayısı (yaklaşık).
- Payda: V_n'in standart sapmasının \sqrt2 ile çarpılmış yaklaşığı.
Önkoşulun gerekçesi: 1'lerin oranı bu kadar uzaktaysa frekans testi dizinin yansızlığını zaten reddeder; runs istatistiğinin dağılımı o durumda geçersizdir (satır 209–216; Rukhin ve ark., 2010, Bölüm 2.3).
94.4.4 Bloktaki en uzun 1'ler dizisi testi
Dizi M bitlik N=\lfloor n/M\rfloor bloğa bölünür; her blokta en uzun 1'ler dizisinin uzunluğu bulunur ve K+1 sınıfa dağıtılır. Blok uzunluğu n'e göre seçilir (satır 224–235):
| n | M | K | Sınıflar (en uzun dizi) |
|---|---|---|---|
| 128\le n<6272 | 8 | 3 | \le1, 2, 3, \ge4 |
| 6272\le n<750\,000 | 128 | 5 | \le4, 5, 6, 7, 8, \ge9 |
| n\ge750\,000 | 10 000 | 6 | \le10, 11, 12, 13, 14, 15, \ge16 |
- \nu_i: en uzun dizisi i'inci sınıfa düşen blok sayısı.
- \pi_i: aynı sınıfın teorik olasılığı. Koddaki değerler (226, 230, 234) standardın Bölüm 3.4 tablosundakilerdir: M=8 için 0,2148; 0,3672; 0,2305; 0,1875; M=128 için 0,1174; 0,2430; 0,2493; 0,1752; 0,1027; 0,1124; M=10^4 için 0,0882; 0,2092; 0,2483; 0,1933; 0,1208; 0,0675; 0,0727.
Standardın belirtim tablosundaki N=16,\ 49,\ 75 en küçük n için verilmiş blok sayılarıdır; kod her zaman N=\lfloor n/M\rfloor alır (satır 237). Standardın n=10^6 (\pi) sonucu N=100 ile yeniden üretilir (94.6.1).
94.4.5 İkili matris rankı testi
Dizi M\times Q=32\times32 bitlik, ardışık N=\lfloor n/1024\rfloor matrise bölünür (satırlar sırayla doldurulur); her matrisin \mathrm{GF}(2) üzerindeki rankı bulunur. Rankı 32, 31 ve \le30 olan matris sayıları F_{32},F_{31},F_{\le30}'dur.
- \pi_{32},\pi_{31}: rankı 32 ve 31 olma olasılıkları; \pi_{\le30}=1-\pi_{32}-\pi_{31}. 32\times32 için 0,2888; 0,5776; 0,1336.
- p=e^{-\chi^2/2}: iki serbestlik dereceli \chi^2 dağılımının üst kuyruğudur (\operatorname{igamc}(1,\chi^2/2)).
Rank hesabı satırları tamsayıya çevirip eleme yapar (_rank_gf2, satır 253–264). Olasılıklar kapalı formülden hesaplanır (276–277); standardın 3×3 örneği 32\times32 sabitlerini kullandığı için işlev isteğe bağlı olarak sabitleri dışarıdan da alır (267, 278–279). Standart en az 38\,912 bit (38 matris) önerir.
94.4.6 Ayrık Fourier (spektral) testi
- |S_j|: ±1 dizisinin j'inci Fourier katsayısının genliği; j=0 (sıfır frekans) dahildir.
- T: sıfır hipotezinde genliklerin %95'inin altında kalacağı eşik.
- N_0: eşiğin altında kalması beklenen genlik sayısı; N_1 gözlenen.
Periyodik özellikleri yakalar: dizi içinde birbirine yakın tepeler çok sayıdaysa N_1 beklenenden küçük olur (satır 298–307). Paydadaki varyans n(0{,}95)(0{,}05)/4'tür (Rukhin ve ark., 2010, Bölüm 2.6). Standart en az 1000 bit önerir.
94.4.7 Örtüşmeyen şablon eşleşmesi testi
Dizi her biri M=\lfloor n/N\rfloor bitlik N=8 bloğa bölünür. Her bir aperiyodik m bitlik şablon B için her blokta B'nin eşleşme sayısı W_j sayılır; bir eşleşme bulununca pencere m bit ileri atlar (örtüşmeye izin verilmez).
- Aperiyodik şablon: kendi kendisiyle kısmen örtüşmeyen şablon (t_{k+1..m}\neq t_{1..m-k} her k için;
_aperiyodik, satır 311–321). m=9 için 148 şablon vardır; m=2{,}3,\dots için sayı değişir. - \mu,\sigma^2: bir blokta eşleşme sayısının ortalaması ve varyansı.
- Her şablon ayrı bir p değeri verir; şablon başına 8 serbestlik dereceli test.
Şablon başına bağımsız bir test olduğundan bir dizide 148 p değeri üretilir (satır 324–353). Standart m=9 ya da 10 ve N=8 önerir. Özet tablosunda bu test için en küçük p gösterilir (94.7).
94.4.8 Örtüşen şablon eşleşmesi testi
Dizi, M=1032 bitlik N=\lfloor n/1032\rfloor bloğa bölünür. Her blokta B=1^9 (dokuz ardışık 1) şablonunun, örtüşmelere izin verilerek, kaç kez göründüğü sayılır; sayılar 0, 1, 2, 3, 4 ve \ge5 sınıflarına dağıtılır (K=5).
- \nu_i: B'nin i kez görüldüğü blok sayısı (i=5 sınıfı \ge5).
- \pi_i: aynı olasılıklar. Kodda sabit bir tablodan değil, 1032 bitlik rastgele bir blokta 1^9'un örtüşen sayısının dağılımından kesin dinamik programlamayla hesaplanır (
_ortusen_pi, satır 357–373): durum, art arda gelen 1 sayısı ve o ana kadarki eşleşme sayısıdır; her bit \tfrac12 olasılıkla 0 (durumu sıfırlar) ya da 1'dir.
Bu olasılıklar \pi_0=0{,}364091; \pi_1=0{,}185659; \pi_2=0{,}139381; \pi_3=0{,}100571; \pi_4=0{,}070432; \pi_5=0{,}139865'tir; standardın Bölüm 3.8'indeki (Hamano ve Kaneko, 2007 düzeltmesi) değerlerle altı basamak aynıdır (94.6).
Yayımlı tablodan sapma
NIST'in yayımlı Ek B tablosu bu test için eski, yaklaşık olasılıklarla hesaplanmıştır (Hamano ve Kaneko, 2007, bu olasılıkların hatalı olduğunu göstermiştir). Şablon düzeltilmiş olasılıkları kullanır; bu yüzden \pi için 0,2969 yerine 0,2607, e için yayımlı değer yerine 0,1590 verir (94.6.1). Aynı durum doğrusal karmaşıklık testinde de vardır (94.4.10).
94.4.9 Maurer'in evrensel istatistiksel testi
Dizi L bitlik ardışık bloklara bölünür; ilk Q=10\cdot2^L blok başlangıç tablosunu kurar, sonraki K=\lfloor n/L\rfloor-Q blok sınanır. T_j, j değerli bloğun en son görüldüğü sıradır. L, n'ye göre seçilir (satır 403, 410–413): n\ge387\,840 için 6; \ge904\,960 için 7; \ge2\,068\,480 için 8; \ge4\,654\,080 için 9; ... \ge1\,059\,061\,760 için 16.
- f_n: aynı L bitlik deseni yeniden görmek için geçen uzaklığın \log_2 ortalaması; sıkıştırılabilir dizilerde küçüktür.
- E_L,V_L: yansız dizide f_n'in beklenen değeri ve varyansı. Kodda tablodadır (398–402); L=6 için E=5{,}2177052, V=2{,}954.
- c: sonlu K düzeltmesi. Kod \sigma=c\sqrt{V_L/K} kullanır (433).
Standardın kısa örneği (Bölüm 2.9) \sigma'da c çarpanını atlar; şablon standardın genel formülünü ve c'yi kullanır (94.6.1). n<387\,840 için test "uygulanamaz" yazar (415).
94.4.10 Doğrusal karmaşıklık testi
Dizi M bitlik N=\lfloor n/M\rfloor bloğa bölünür (M varsayılan 500). Her bloğun doğrusal karmaşıklığı L_i (bloğu üretebilen en kısa doğrusal geri beslemeli kaydırmalı yazmacın uzunluğu) Berlekamp–Massey algoritmasıyla bulunur (_berlekamp_massey, satır 439–458; Massey, 1969).
T_i yedi sınıfa ayrılır: \le-2{,}5; (-2{,}5;-1{,}5]; (-1{,}5;-0{,}5]; (-0{,}5;0{,}5]; (0{,}5;1{,}5]; (1{,}5;2{,}5]; >2{,}5 (satır 474–480).
- \pi_i: (0{,}010417;\ 0{,}03125;\ 0{,}125;\ 0{,}5;\ 0{,}25;\ 0{,}0625;\ 0{,}020833) (satır 467; standardın Bölüm 2.10'u). İlk ve son terim 1/96 ve 1/48'in yuvarlanmışıdır.
- \mu: yansız dizide L_i'nin beklenen değeri.
Yayımlı Ek B tablosu bu test için \pi_0=0{,}01047 ile hesaplanmış gibidir: \pi için 0,255475 ve e için 0,826335 bu sabitle yeniden üretilir; şablon belirtimin yazılı değerini (\pi_0=0{,}010417) kullanır ve 0,246857 ile 0,826194 verir (94.6.1). Karar değişmez.
94.4.11 Seri testi
m bitlik her desenin dizide (dizi başa doğru uzatılarak, dairesel) kaç kez göründüğü \nu_{i_1\dots i_m} sayılır.
- \psi^2_m: m bitlik desenlerin sıklıklarının düzgün dağılımdan uzaklığı; \psi^2_0=0.
- İki p değeri üretilir ("∇ψ²" ve "∇²ψ²"; satır 499–507).
Desen uzunluğu sınırı m<\lfloor\log_2 n\rfloor-2'dir; seri_m = 0 iken kod \min(16,\lfloor\log_2n\rfloor-3) seçer, kullanıcı daha büyük bir değer girerse hata verir (664–669). m<3 için test uygulanamaz (692). n=10^6'da m=16'dır.
94.4.12 Yaklaşık entropi testi
- \varphi^{(m)}: m bitlik (dairesel) desenlerin sıklık entropisinin eksi işaretlisi; yalnızca \nu_i>0 olan desenler toplanır (satır 518).
- \mathrm{ApEn}(m): bir sonraki bitin ne kadar öngörülebilir olduğunun ölçüsü; yansız dizide \ln2'ye yakındır.
Sınır m<\lfloor\log_2n\rfloor-5'tir; entropi_m = 0 iken \min(10,\lfloor\log_2 n\rfloor-6) seçilir (680). Seri testiyle aynı kavramı ölçer, ama tek bir p verir (522–526).
94.4.13 Kümülatif toplamlar testi
S_k=\sum_{i\le k}x_i ve z=\max_k|S_k|. İleri testte dizi sırasıyla, geri testte tersine çevrilerek hesaplanır.
- z: rastgele yürüyüşün başlangıçtan en uzak noktası; yansız dizide yaklaşık \sqrt n düzeyindedir.
- İki toplam, yürüyüşün [-z,z] dışına çıkmama olasılığının yansılama ilkesiyle yazılmış serisidir. Kod
math.ceil/math.floorile sınırları alır (530–540).
İki p değeri üretilir (ileri, geri; 543–548).
94.4.14 Rastgele gezinti testi
S'=(0,S_1,\dots,S_n,0) yürüyüşünün sıfırdan sıfıra giden her parçası bir döngüdür; J döngü sayısıdır (sıfıra dönüş sayısı). Test yalnız J\ge\max(0{,}005\sqrt n,\ 500) ise uygulanır; aksi hâlde sekiz p değerinin hepsi "uygulanamaz" yazar (satır 563–566). Her durum x\in\{-4,-3,-2,-1{,}1{,}2{,}3{,}4\} için \nu_k(x), x'e tam k kez uğrayan döngü sayısıdır (k=0,\dots,4 ve \ge5).
Sekiz durumun her biri ayrı bir p değeri verir (satır 567–582).
94.4.15 Rastgele gezinti varyantı testi
Aynı S' ve J üzerinde, x\in\{-9,\dots,-1{,}1,\dots,9\} (18 durum) için \xi(x), x'e toplam uğrama sayısıdır.
J eşiği 94.4.14'tekiyle aynıdır (satır 585–597). On sekiz p değeri üretilir.
94.4.16 İkinci düzey çözümleme
Kod, iki ya da daha çok dizi varsa (m_dizi >= 2, satır 775) her (test, alt test) çifti için, o test uygulanabilen s dizi üzerinden iki ölçüt hesaplar (778–798). \hat p=1-\alpha olsun.
Geçen dizi oranı. p\ge\alpha olan dizilerin oranı \hat q, şu aralıkta olmalıdır:
Oran aralığın altındaysa karar "kaldı"; aralığın üstü ya da içi "geçti" sayılır (791). Standart aralığın dışındaki oranı kanıt sayar ve örnekte yalnız alt sınırı hesaplar; kod yalnız alt ucu karar için kullanır. Aralığın üst ucu 1'i aşabilir (örnekte s=100 için 1,0198).
p değerlerinin tekdüzeliği. p değerleri [0;0{,}1),\dots,[0{,}9;1] olmak üzere 10 eşit sınıfa dağıtılır; F_i sınıf sayılarıdır.
P_T\ge0{,}0001 ise p değerleri tekdüze sayılır (793). Standart tekdüzelik için en az 55 dizi önerir; s<55 ise P_T yazılır ama karar sütununa "yetersiz dizi (<55)" yazılır (793, 799–801). Geçen oran kararı için böyle bir koruma yoktur.
Neden tek dizide karar verilmez?
Dizi gerçekten rastgele olsa bile her testin p değeri [0{,}1]'de düzgün dağılır; \alpha=0{,}01'de bir testin yanlışlıkla "kaldı" demesi olasılığı \%1'dir. Birçok dizi aynı testten geçirildiğinde "kalan dizi oranı" \alpha'ya yakın olmalıdır (aralık ölçütü) ve p değerleri düzgün dağılmalıdır (tekdüzelik ölçütü). Ölçütlerden biri yalnızca tek tek p'lere bakmanın göremediği sapmaları, örneğin p'lerin sistematik biçimde 1'e yığılmasını da yakalar.
94.4.17 Çoklu test sayısı
Bir dizi için şablon, alt testler dahil
p değeri üretir (özet tablosundaki satır sayısı 17; 188 değer ayrıntı tablosundadır). \alpha=0{,}01'de dizi gerçekten rastgele olsa bile yaklaşık 188\times0{,}01\approx1{,}9 değerin \alpha'nın altında çıkması beklenir. Ayrıntı tablosundaki p değerleri düzeltilmeden raporlanır ve konsola beklenen sayı yazılır (755–756). Tek istisna özet tablosunun çoklu alt testli üç satırıdır (örtüşmeyen şablon 148, rastgele gezinti 8, rastgele gezinti varyantı 18 alt test): bu satırlarda p sütunu alt testlerin en küçük p değeridir, ama karar k alt testin en küçüğüne uygulanan Šidák düzeltmesiyle verilir:
k=1 ise (tek alt test uygulanabiliyorsa) p_{\text{Šidák}}=p_{\min}'dir. Düzeltilmiş p ve rastgele dizide \alpha altında beklenen alt test sayısı (\alpha k) satırın not sütununa yazılır (725–737). Šidák formülü k alt testi bağımsız sayar.
94.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–169 | Üstbilgi: dokuz veri ve ayar parametresi (11–78), on beş test onay kutusu (79–168), örnek veri, örnek ayar. | |
| 170–187 | İçe aktarmalar; _igamc (\operatorname{igamc} için gammaincc), _bits. |
_bits sürücüde kullanılmaz. |
| 188–598 | 15 test işlevi. Her biri (p listesi, ayrıntı sözlüğü) döndürür. | Uygulanamazsa p yerine None ve ayrıntıda neden yazar. İşlevler nist80022.py çekirdeğiyle birebir aynıdır. |
| 600–628 | Dil yardımcısı _m; veri denetimi; \alpha; ONERILEN_N ve test adları AD. |
\alpha P.get("alfa") or 0.01 ile okunur (607). |
| 629–631 | Seçili testler: SECILI = [k for k in AD if P.get("t_" + k, True)] onay kutularından seçili testlerin kodlarını AD sırasıyla toplar. |
Liste boşsa "En az bir test seçin." iletisiyle durur (631). Onay kutusu ayarda hiç yoksa test seçili sayılır (True varsayılanı). |
| 632–661 | Sütunları bite çevirme: mq.sayisal, eksikleri atma, ikili/medyan, birleştirme, 100 bit sınırı. |
medyan: x > medyan (646). |
| 664–673 | _otomatik_m ve _neden: seri ve yaklaşık entropi desen uzunluğunu sınırlar. |
Kullanıcı sınırı aşarsa hata. Sınır yalnız seçili testler için sınanır: seri ya da yaklasik_entropi SECILI içinde değilse ilgili m denetlenmez, 0 olarak bırakılır (679–680). |
| 676–749 | Her dizi için 15 testin çalıştırılması (681–697); seçili olmayan testin döngüde atlanması (698–700, if kod_ not in SECILI: continue); try/except (701–704); alt test adları (707–720); ayrıntı satırları; özet satırları (724–749). |
Atlanan test için ayrıntı ve özet satırı üretilmez. Her istisna [None] ve neden = "error" olarak yutulur (704); çoklu alt testli üç testte özet satırı en küçük p'yi alır ve kararı Šidák düzeltmeli p'ye göre verir (725–737). |
| 751–771 | Özet ve ayrıntı tabloları, TR/EN sütun adları. | Ayrıntı tablosu 5000 satırı aşarsa yalnız p<\alpha ve uygulanamaz olanlar listelenir (765–770). |
| 773–801 | İkinci düzey çözümleme: geçen oran aralığı, 10 sınıflı tekdüzelik. | s<55 için tekdüzelik kararı yazılmaz (793). |
| 803–821 | Grafik: her testin p değerleri (logaritmik eksen), \alpha çizgisi. | p değerleri [10^{-6},1]'e kırpılır (810). Yalnız seçili testler çizilir. |
Kritik bölüm, medyan dönüşümü ve tek değerli dizi denetimidir:
if P["donusum"] == "medyan":
    med = float(x.median())
    bit = (x.to_numpy(float) > med).astype(np.int8)
    if bit.min() == bit.max():
        mq.hata(...)   # "bütün bitler aynı ... 'İkili (0/1)' dönüşümünü seçin"
Medyandan büyük olan 1, eşit ya da küçük olan 0 olur. Veri zaten 0/1 ise ve 1'ler çoğunluktaysa medyan 1'dir ve hiçbir değer 1'i aşmadığından dönüşüm bütün bitleri 0 yapar; bütün bitleri aynı olan dizi sınanmaz, şablon iletiyle durur (647–649; 94.8).
Süre: 10^6 bitlik bir dizide örtüşmeyen şablon testi (148 şablon) ve doğrusal karmaşıklık testi yaklaşık 10 s'er, ikili matris rankı 0,6 s sürer; öteki testler 1 s'nin altındadır (nist_sp80022 günlükleri). İki dizilik örnek çalıştırma toplam 16,1 s sürmüştür. Doğrusal karmaşıklık ve örtüşmeyen şablon testlerinin süresi n ile doğrusal arttığından 100 dizi \times 10^6 bit gibi çalıştırmalar dakikalar mertebesindedir.
94.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/nist_rastgelelik/elle_hesap.py ile hesaplanmıştır: yalnız math, numpy ve scipy kullanılmış, şablon işlevleri çağrılmamıştır. Girdi, \pi'nin ilk 10^6 bitidir.
Adım 1 — Frekans. 1'lerin sayısı 499 722, 0'ların sayısı 500 278; S_n=499\,722-500\,278=-556, s_{\text{obs}}=556/1000=0{,}556,
Adım 2 — Blok içi frekans. M=128, N=\lfloor10^6/128\rfloor=7812 blok; \chi^2=4\cdot128\sum(\pi_i-\tfrac12)^2=7849{,}375, p=\operatorname{igamc}(3906;3924{,}6875)=0{,}3806152.
Adım 3 — Runs. \hat\pi=0{,}499722, \tau=2/\sqrt{10^6}=0{,}002; |\hat\pi-\tfrac12|=0{,}000278<\tau, test uygulanır. V_n=499\,596:
Adım 4 — Kümülatif toplamlar (ileri). z=\max|S_k|=1001. Birinci toplam 0{,}6858460, ikinci toplam 0{,}3141540; p=1-0{,}6858460+0{,}3141540=0{,}6283081.
Adım 5 — Rank olasılıkları. 32\times32 matrislerin rankına göre sayımı tamsayı aritmetiğiyle yapılır: rankı r olan matris sayısı \prod_{i=0}^{r-1}(2^{32}-2^i)^2/(2^r-2^i)'dir. \pi_{32}=0{,}2887881; \pi_{31}=0{,}5775762; \pi_{\le30}=0{,}1336357 (standardın 0,2888; 0,5776; 0,1336'sı).
Adım 6 — Örtüşen şablon olasılıkları. 1032 bitte 1^9'un örtüşen sayısının dağılımı, 60 durumlu geçiş matrisinin 1032. kuvvetiyle bulunur: 0{,}3640911; 0{,}1856589; 0{,}1393811; 0{,}1005711; 0{,}0704323; 0{,}1398654 (standardın Bölüm 3.8 değerleri: 0,364091; 0,185659; 0,139381; 0,100571; 0,070432; 0,139865).
Adım 7 — Standardın kısa örneği. 10 bitlik \varepsilon=1011010101 dizisi için S_{10}=2, p=\operatorname{erfc}(2/\sqrt{10}/\sqrt2)=0{,}5270893 (standardın 0,527089'u).
94.6.1 Doğrulama: MerQuR+, Python, R ve yayımlı değerler
MerQuR+ sütunu örnek ayarın "Alt test ayrıntısı" tablosundan tam hassasiyetle alınmıştır (çalıştırma 1). R sütunu, nist_sp80022/nist_r.R betiğinden gelir: 15 test standardın formüllerinden R'de, hazır paket kullanılmadan ve şablon kodundan çevrilmeden yazılmıştır (\pi ve e için 43'er p değeri; örtüşmeyen şablon için en küçük, ortalama ve ilk şablon).
Bağımsız hesap ve R, π'nin ilk 10^6 biti.
| Büyüklük | MerQuR+ | Bağımsız Python | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| π: Frekans: p | 0,578211 | 0,578211 | 0,578211 | 2,2e−16 | ✓ |
| π: Blok içi frekans (M=128): p | 0,380615 | 0,380615 | 0,380615 | 5,0e−16 | ✓ |
| π: Runs: p | 0,419268 | 0,419268 | 0,419268 | 1,1e−16 | ✓ |
| π: Kümülatif toplam, ileri: p | 0,628308 | 0,628308 | 0,628308 | 0 | ✓ |
Ölçütü karşılayan: 4/4.
R ile tüm p-değerleri (örnek ayar, π ve e; örtüşmeyen şablon için en küçük, ortalama ve ilk şablon):
| Dizi | Karşılaştırılan p-değeri | En büyük fark | En büyük fark nerede | ≤ 10−6 |
|---|---|---|---|---|
| π | 43 | 4,22e−15 | ortusen_sablon |
43/43 |
| e | 43 | 6,99e−15 | ortusen_sablon |
43/43 |
Yayımlı Ek B değerleri (NIST SP 800-22 Rev. 1a, s. B-1 ve B-2):
| Test | π: yayımlı | π: MerQuR+ | e: yayımlı | e: MerQuR+ | Durum |
|---|---|---|---|---|---|
| Frekans | 0,578211 | 0,578211 | 0,953749 | 0,953749 | ✓ |
| Blok içi frekans (M=128) | 0,380615 | 0,380615 | 0,211072 | 0,211072 | ✓ |
| Kümülatif toplam, ileri | 0,628308 | 0,628308 | 0,669887 | 0,669886 | ✓ |
| Kümülatif toplam, geri | 0,663369 | 0,663369 | 0,724266 | 0,724265 | ✓ |
| Runs | 0,419268 | 0,419268 | 0,561917 | 0,561917 | ✓ |
| Bloktaki en uzun 1'ler dizisi | 0,024390 | 0,024390 | 0,718945 | 0,718945 | ✓ |
| İkili matris rankı | 0,083553 | 0,083553 | 0,306156 | 0,306156 | ✓ |
| Spektral (DFT) | 0,010186 | 0,010186 | 0,847187 | 0,847187 | ✓ |
| Örtüşmeyen şablon (B=000000001) | 0,165757 | 0,165757 | 0,078790 | 0,078790 | ✓ |
| Örtüşen şablon | 0,296897 | 0,260718 | 0,078790 | 0,159037 | farklı (açıklama aşağıda) |
| Maurer evrensel | 0,669012 | 0,669012 | 0,282568 | 0,282568 | ✓ |
| Yaklaşık entropi (m=10) | 0,361595 | 0,361595 | 0,700073 | 0,700073 | ✓ |
| Rastgele gezinti (x=+1) | 0,844143 | 0,844143 | 0,786868 | 0,786868 | ✓ |
| Rastgele gezinti varyantı (x=-1) | 0,760966 | 0,760966 | 0,826009 | 0,826009 | ✓ |
| Doğrusal karmaşıklık (M=500) | 0,255475 | 0,246857 | 0,826335 | 0,826194 | farklı (açıklama aşağıda) |
| Seri (m=16, \nabla\psi^2) | 0,143005 | 0,143005 | 0,766182 | 0,766182 | ✓ |
Altı basamak uyuşan: 14/16; iki test (örtüşen şablon, doğrusal karmaşıklık) yayımlı tablodan farklıdır (bkz. 94.6).
Dört sabit üzerinde R karşılaştırması. nist_sp80022 doğrulamasında aynı iki dilli karşılaştırma \pi, e, \sqrt2 ve \sqrt3'ün ilk 10^6 biti için de yapılmıştır (her dizi için 43 p değeri): en büyük mutlak fark \pi'de 4{,}2\times10^{-15}, e'de 7{,}0\times10^{-15}, \sqrt2'de 7{,}9\times10^{-12} ve \sqrt3'te 1{,}0\times10^{-11}'dir; 172 karşılaştırmanın tamamı 10^{-6} ölçütünü karşılar. Bu karşılaştırmada "Python" sütunu şablonla aynı işlevleri (nist80022.py) çalıştırdığı için bağımsız sayılmaz; bağımsızlık R ayağından ve yayımlı değerlerden gelir.
Yayımlı değerlerle iki fark. 16 testin 14'ü altı basamak uyuşur. Farklı iki testin nedeni yeniden üretilebilir:
| Test | Dizi | Yayımlı | MerQuR+ | Yayımlı değerin yeniden üretimi |
|---|---|---|---|---|
| Doğrusal karmaşıklık | \pi | 0,255475 | 0,246857 | \pi_0=0{,}01047 ile 0,255475 |
| Doğrusal karmaşıklık | e | 0,826335 | 0,826194 | \pi_0=0{,}01047 ile 0,826335 |
| Örtüşen şablon | \pi | 0,296897 | 0,260718 | eski \pi_k ile 0,296900 |
| Örtüşen şablon | e | 0,078790 | 0,159037 | eski \pi_k ile 0,110431 |
Doğrusal karmaşıklıkta standardın metni \pi_0=0{,}010417 yazar (Bölüm 2.10); yayımlı tablo \pi_0=0{,}01047 ile hesaplanmış gibidir (dogrulama/nist_rastgelelik/yayimli_fark.py). Örtüşen şablonda yayımlı tablo, Hamano ve Kaneko'nun (2007) hatalı bulduğu eski olasılıklarla (0{,}367879; 0{,}183940; 0{,}137955; 0{,}099634; 0{,}069935; 0{,}140657) hesaplanmıştır; şablon düzeltilmiş olasılıkları kullanır. Gözlenen blok sayıları \nu (\pi için 348, 158, 136, 96, 73, 157; e için 329, 164, 150, 111, 78, 136) yayımlıyla aynıdır; fark yalnızca olasılık vektöründedir. Yayımlı e değeri (0,078790) Ek B'de örtüşmeyen şablon satırıyla aynı sayıdır; eski olasılıklarla yapılan yeniden hesap 0,110431 verir, bu yayımlı sayıyı açıklamaz. Her iki testte de karar ("geçti") değişmez.
Standardın kısa örnekleri. Standardın Bölüm 2'sindeki 21 örnekten 20'si ölçütü karşılar; bu karşılaştırma nist_sp80022/test_spec.py ile yapılmıştır (şablonun işlevleriyle birebir aynı kod). Frekans, blok içi frekans, runs, en uzun run, rank (üç sabitle), örtüşmeyen şablon, seri, yaklaşık entropi, kümülatif toplamlar ve rastgele gezinti varyantı örneklerinin hepsi \le5\times10^{-6} içinde tutar; Maurer'de standardın kısa örneği \sigma'da c'yi atladığı için, karşılaştırma c=1 ile ve f_n=1{,}194988 üzerinden yapılmıştır.
Bu 20 örneğin biri (rastgele gezinti) 5\times10^{-5} gevşetilmiş toleransla, öteki 19'u 6\times10^{-6} ile kabul edilmiştir; 21. örnek (DFT) tutmaz. İkisi ayrıca açıklanır:
| Örnek | Belirtim | MerQuR+ | Not |
|---|---|---|---|
| Rastgele gezinti (x=+1, 10 bit) | 0,502529 | 0,502488 | Belirtim \pi_k'yi yuvarlar; fark 4\times10^{-5} |
| DFT (100 bit) | 0,168669 | 0,646355 | Belirtim N_1=46 yazar; veri üzerinde N_1=48 sayılır (eşik 17,308); 46 yeniden üretilemedi |
DFT örneğinde N_1=46 varsayıldığında d=-1{,}3765 ve p=0{,}168669 çıkar; yani belirtimin sayısı kendi içinde tutarlıdır, ama N_1 değeri 100 bitlik verideki genlik sayımıyla örtüşmez. Aynı işlev 10⁶ bitlik \pi için yayımlı değeri altı basamak üretir (0,010186).
94.7 Çıktıyı okuma
Örnek ayarın konsol metni:
2 dizi, alt testler dahil 376 p-değeri, α = 0,0100: 5 tanesi α'nın altında (rastgele bir dizide beklenen ≈ 3,76).
Not: NIST p-değeri tekdüzeliği için en az 55 dizi önerir; daha az dizide tekdüzelik p-değeri yalnız bilgi içindir.
"NIST SP 800-22 sonuç özeti" tablosu (özet satırları; p altı basamak):
dizi  test                        alt_test                  p         kalan_alt_test  karar
pi    Frekans (monobit)                                     0.578211  0               geçti
pi    Blok içi frekans                                      0.380615  0               geçti
pi    Runs                                                  0.419268  0               geçti
pi    Bloktaki en uzun 1'ler dizisi                         0.024390  0               geçti
pi    İkili matris rankı                                    0.083553  0               geçti
pi    Ayrık Fourier (spektral)                              0.010186  0               geçti
pi    Örtüşmeyen şablon           en küçük p (148 alt test) 0.005302  1               geçti
pi    Örtüşen şablon                                        0.260718  0               geçti
pi    Maurer evrensel                                       0.669012  0               geçti
pi    Doğrusal karmaşıklık                                  0.246857  0               geçti
pi    Seri                        ∇ψ²                       0.143005  0               geçti
pi    Seri                        ∇²ψ²                      0.034354  0               geçti
pi    Yaklaşık entropi                                      0.361595  0               geçti
pi    Kümülatif toplamlar         ileri                     0.628308  0               geçti
pi    Kümülatif toplamlar         geri                      0.663369  0               geçti
pi    Rastgele gezinti            en küçük p (8 alt test)   0.268428  0               geçti
pi    Rastgele gezinti varyantı   en küçük p (18 alt test)  0.509815  0               geçti
e     Frekans (monobit)                                     0.953749  0               geçti
e     Blok içi frekans                                      0.211072  0               geçti
e     Runs                                                  0.561917  0               geçti
...
e     Örtüşmeyen şablon           en küçük p (148 alt test) 0.005374  3               geçti
...
e     Rastgele gezinti            en küçük p (8 alt test)   0.007779  1               geçti
e     Rastgele gezinti varyantı   en küçük p (18 alt test)  0.137861  0               geçti
Çoklu alt testli satırların not sütunu (örnek: π örtüşmeyen şablon):
karar, 148 alt testin en küçük p'sine Šidák düzeltmesiyle verilir (düzeltilmiş p = 0,5447); rastgele dizide α altında beklenen alt test sayısı ≈ 1,48
Özet tablosunun çoklu alt testli altı satırında (her dizide örtüşmeyen şablon, rastgele gezinti ve varyantı) p en küçük p değeridir, karar ise Šidák düzeltmeli p_{\text{Šidák}}=1-(1-p_{\min})^{k} ile verilir; düzeltilmiş değer not sütunundadır. \pi için örtüşmeyen şablon 0{,}5447, rastgele gezinti 0{,}918, varyant \approx1; e için 0{,}5495; 0{,}06056 ve 0{,}9308'dir. Hepsi \alpha=0{,}01'in üstünde olduğundan altı satırın hepsi "geçti"dir. Düzeltmesiz en küçük p'nin \alpha'nın altında kaldığı üç satırda (\pi örtüşmeyen şablon 0{,}005302; e örtüşmeyen şablon 0{,}005374 ve rastgele gezinti 0{,}007779) kalan_alt_test sırasıyla 1, 3 ve 1'dir. Toplam olarak \pi için 188 p değerinden 1, e için 188'den 4 tanesi \alpha'nın altındadır; beklenen sayı yaklaşık 1,9'dur. Örtüşmeyen şablon testinde \pi'de bir, e'de üç şablonun p<0{,}01 çıkması beklentiyle uyumludur (148\times0{,}01\approx1{,}5); bu yüzden hiçbir satır dizinin reddi anlamına gelmez.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
dizi, n |
Sütun adı ve bit sayısı | Birleştirme açıksa dizi adı a + b biçimindedir. |
test, alt_test |
Test ve alt testi (şablon, yön, durum) | Çoklu alt testli satırda en küçük p (k alt test) yazar. |
p |
p değeri (çoklu alt testli satırda en küçük p) | Tek p'li satırda p<\alpha ise "kaldı"; çoklu alt testli satırda karar Šidák düzeltmeli p'yedir. p\approx1 de şüphelidir (aşırı düzgün dizi); standart bunu ikinci düzeyde tekdüzelikle yakalar. |
kalan_alt_test |
\alpha'nın altında kalan alt test sayısı | Beklenen \approx\alpha\times alt test sayısı. |
karar |
geçti / kaldı / uygulanamaz | Uygulanamaz: dizi çok kısa ya da J<\max(0{,}005\sqrt n,500). |
not |
"yaklaşık" işareti, uygulanamaz nedeni ya da çoklu alt testli satırda Šidák düzeltmeli p ile beklenen alt test sayısı | Yaklaşık: n, standardın önerdiği en küçük uzunluktan kısa. |
kod, yaklasik, neden |
Ayrıntı tablosunda test kodu, yaklaşık bayrağı ve neden | |
dizi_sayisi, gecen_oran, oran_alt, oran_ust, oran_karari |
İkinci düzey: geçen dizi oranı, kabul aralığı ve karar | Oran aralığın altındaysa "kaldı"; üstü uyarı sayılmaz. |
tekduzelik_p, tekduzelik_karari |
p değerlerinin 10 sınıflı \chi^2 tekdüzelik sınaması | P_T<0{,}0001 ise "kaldı"; s<55 ise "yetersiz dizi (<55)". |
Örnek ayarda yalnız iki dizi olduğundan ikinci düzey tablosu 188 satırdır ve hepsinde "yetersiz dizi (<55)" yazar. Aynı tabloda geçen oran kararı yine de verilir: iki diziden biri bir alt testi geçemezse oran 0,5 olur ve aralığın altında kaldığı için "kaldı" yazar (188 satırın 5'inde).
Şekil 94.1. Şablonun çizdiği grafik (örnek veri): her testin p değerleri (log ölçek); kesikli çizgi \alpha=0{,}01. Örtüşmeyen şablonda 148, rastgele gezinti varyantında 18, rastgele gezintide 8 nokta vardır; her nokta bir alt testtir.
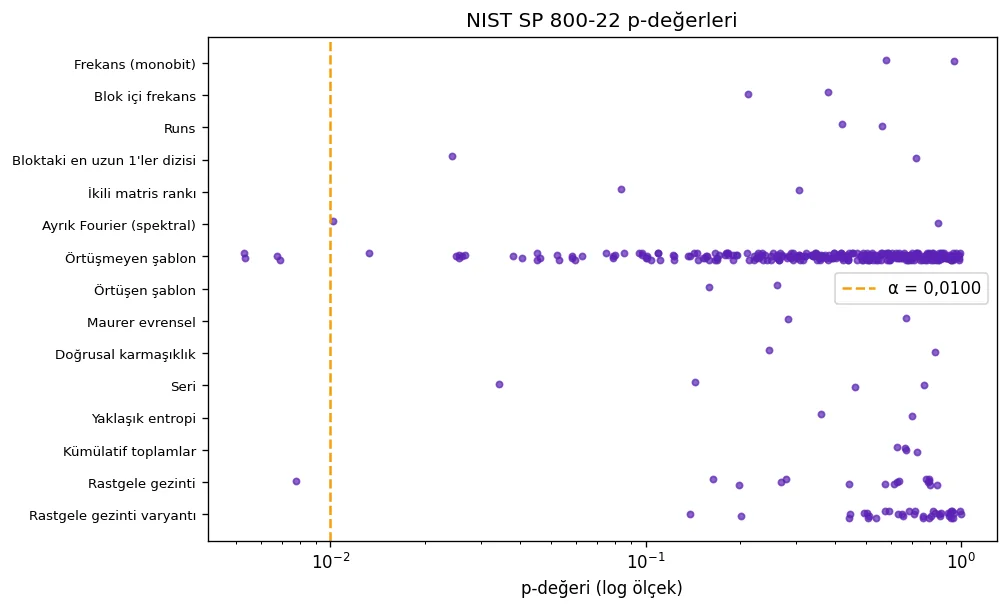
Her satır bir test, her nokta bir p değeridir. Noktaların \alpha çizgisinin sağında ve gelişigüzel dağılması beklenir; çizginin solundaki noktalar tek başlarına değil, sayıları ve konumlarıyla yorumlanır.
İkinci düzey çözümleme örneği (100 dizi \times 10^5 bit). \pi'nin ilk 10^7 bitinin ardışık 10^5'er bitlik 100 diziye bölünmesiyle elde edilen veride şablon şu konsol metnini yazar:
100 dizi, alt testler dahil 16464 p-değeri, α = 0,0100: 192 tanesi α'nın altında (rastgele bir dizide beklenen ≈ 165).
Uyarı: Bazı testlerde dizi uzunluğu NIST'in önerdiği en küçük uzunluğun altında; o sonuçlar 'not' sütununda yaklaşık diye işaretlidir.
Not: alt test ayrıntısı tablosu en çok 5000 satır gösterebilir; yalnız α'nın altındaki ve uygulanamayan p-değerleri listelendi (2528 satır). ...
Bu uzunlukta Maurer testi uygulanamaz (10^5<387\,840); rastgele gezinti testleri yalnız 14 dizide uygulanabilir (J\ge500 koşulu), öteki 86 dizide "uygulanamaz" yazar. İkinci düzeyde: tek ya da iki p değerli on üç satırın hepsinde geçen oran 0,97–1,00 aralığındadır ve kabul aralığının (0{,}9602–1{,}0198) içinde ya da üstündedir; tekdüzelik P_T\ge0{,}0401'dir. Örtüşmeyen şablonun 148 şablonundan 143'ü geçen oran ölçütünü, 148'i tekdüzelik ölçütünü sağlar. Rastgele gezinti ve varyantının ikinci düzey satırları 14 diziye dayanır ve "yetersiz dizi (<55)" yazar. Bu çalıştırma 10^6 bitlik dizi önerisinin altında olduğundan bir üreteç hakkında karar için değil, tabloların nasıl okunduğunu göstermek içindir.
Rapor cümlesi (örnek ayar, \pi dizisi):
\pi'nin ilk 10^6 biti NIST SP 800-22 Rev. 1a bataryasıyla sınanmıştır (\alpha=0{,}01). Frekans (p=0{,}578), runs (0{,}419), spektral (0{,}010), Maurer (0{,}669) ve doğrusal karmaşıklık (0{,}247) dahil on beş testin hiçbirinde dizi rastgelelik hipotezini reddettirmemiştir; örtüşmeyen şablon testinin 148 şablonundan biri \alpha'nın altında kalmıştır (en küçük p=0{,}0053; Šidák düzeltmeli p=0{,}545); bu sayı 148 testte beklenen büyüklüktedir (148\times0{,}01\approx1{,}5).
94.8 Sık hatalar ve tuzaklar
- Dizi çok kısa. Maurer, doğrusal karmaşıklık, şablon ve rastgele gezinti testleri 10^6 bit için tanımlanmıştır. Kısa dizide "uygulanamaz" ya da "yaklaşık" görünür; bu bir üreteç kusuru değildir. Örnekte 100 bitlik bir dizide 9 test uygulanamaz (
toplu.json: blok içi frekans, en uzun run, rank, örtüşen şablon, Maurer, doğrusal karmaşıklık, yaklaşık entropi, rastgele gezinti ve varyantı). - Tek dizideki küçük p değeri. Tek dizide 188 p değeri vardır; 1–4 tanesinin \alpha'nın altında kalması beklenir. Özet satırındaki karar, çoklu alt testli satırlarda (örtüşmeyen şablon, iki rastgele gezinti testi) en küçük p'ye Šidák düzeltmesi uygulanarak verilir; ayrıntı tablosundaki tek tek p değerleri düzeltilmemiştir ve bunlardan birkaçının \alpha'nın altında kalması dizinin reddi sayılmaz.
medyanseçeneğini 0/1 sütuna uygulamak. Zaten 0/1 olan bir sütunda 1'ler çoğunluktaysa medyan 1 olur ve x>1 hiçbir değerde sağlanmaz: bütün bitler 0 olacaktır. Şablon bu durumda (ve medyan çevirmesinden sonra bütün bitleri aynı olan her sütunda) çalıştırmayı "bütün bitler aynı … 'İkili (0/1)' dönüşümünü seçin" iletisiyle durdurur. Örnekte 2000 bitlik, 1'lerin sayısı 1181 olan sütunmedyanile bu hatayı verir (ileti "medyan = 1" yazar); aynı sütunikiliile çalıştırılınca dizi yanlı bulunur (frekans testi p\approx5{,}7\times10^{-16}). 0/1 sütunlar içinikilikullanılır.- Veri kodlaması.
ikiliseçiliyken sütunda 0/1 dışında bir değer (1/2 kodlaması, ondalık sayı) varsa şablon durur ve medyan çevirmesini önerir. Sürekli veriyi medyanla ikiliye çevirmek bilgi kaybettirir ve ardışık yapıyı yok eder; yalnız bağımsızlık sınanıyorsa anlamlıdır. - Satır sırası. Dizinin sırası önemlidir; satırları sıralamak ya da karıştırmak dizinin kendisini değiştirir. Eksik ya da sayı olmayan hücreler atıldığında komşu bitler birleşir ve bu, run ve desen testlerinin sayımlarını değiştirir.
- Kategorik görünen 0/1 sütun. Sütun veri sekmesinde kategorik türde algılansa bile
mq.sayisaletiketin sayı karşılığını verir ve sonuç sayısal sütunla aynıdır (2000 bitlik sınamada frekans p=0{,}3476545 iki türde de; bağımsız hesap 0{,}3476545). Yine de ikilik sütunu sayısal tutmak güvenlidir. - Bir testi geçmek yetmez. Aşırı düzenli bir dizi (ör. 0101…) bazı testleri geçebilir; bataryanın tamamı birlikte değerlendirilir. Sabit dizi (hepsi 0) birçok testte "kaldı" verir.
- Desen uzunluğu. Seri ve yaklaşık entropi için m sınırı \lfloor\log_2 n\rfloor-3 ve -6'dır; aşılırsa şablon durur (örnek: n=3000 için
seri_m=12iletisi "en çok 8"). 0 (otomatik) güvenli seçimdir. - Başka bataryalarla karıştırma. Bu şablon yalnız NIST SP 800-22'yi uygular; başka bataryalar farklı testler ve eşikler kullanır, sonuçlar karşılaştırılamaz.
- İkinci düzeyde az dizi. s<55 için tekdüzelik kararı yazılmaz; ama geçen oran kararı yazılır ve çok az dizide anlamsızdır.
- Süre. 10^6 bitlik dizi başına yaklaşık 10 s'lik iki test vardır; çok sayıda uzun diziyi çalıştırmadan önce küçük bir alt kümeyle denemek akıllıcadır.
94.9 Uzman soruları
S1. Yayımlı değerlerle neden altı basamak uyuşmuyorsunuz?
İki testte (doğrusal karmaşıklık, örtüşen şablon) standardın Ek B tablosu eski sabitlerle üretilmiştir; şablon standardın yazılı formülünü ve düzeltilmiş olasılıklarını kullanır. Yayımlı doğrusal karmaşıklık değerleri \pi_0=0{,}01047 ile, yayımlı \pi örtüşen şablon değeri eski \pi_k ile yeniden üretilir (94.6.1). Öteki 14 test altı basamak uyuşur ve karar hiçbirinde değişmez.
S2. Rank olasılıkları neden sabit değil de kapalı formülden hesaplanıyor?
32\times32 matrisler için kapalı formül standardın 0,2888; 0,5776; 0,1336 sabitlerini üretir (tam sayımla 0{,}2887881; 0{,}5775762; 0{,}1336357), ve aynı kod farklı M ve Q için de çalışır. Standardın 3\times3 örneği bu üç sabiti 3\times3 için de kullandığından işlev sabitleri dışarıdan alabilir; örnek yalnız bu yolla yeniden üretilir.
S3. Örtüşen şablon olasılıkları neden dinamik programlamayla?
Kesin hesap, standardın düzeltilmiş (Hamano–Kaneko) değerlerini altı basamak yeniden üretir ve m ya da M değişince de geçerlidir. Eski, yaklaşık \pi_k değerleri hatalıdır; yayımlı Ek B bu eski değerlerle üretildiğinden o satırda şablon yayımlı sayıdan sapar.
S4. Runs testi neden |\hat\pi-\tfrac12|\ge2/\sqrt n olduğunda p=0 veriyor?
Standardın önkoşuludur: 1'lerin oranı bu kadar uzaksa frekans testi dizinin yansızlığını reddeder ve runs istatistiğinin dağılımı geçersizdir. Kod testi hiç uygulamaz ve p=0 yazar; satır "kaldı" yazar ama nedenini not sütununda belirtmez.
S5. DFT'de sıfır frekans neden dahil?
Standardın uygulaması ilk n/2 katsayıyı alır ve j=0 dahildir; şablon aynısını yapar. Bu seçim 10^6 bitlik \pi ve e için yayımlı değerleri altı basamak yeniden üretir (0,010186; 0,847187). Standardın 100 bitlik kısa örneği ise N_1=46 saydığı için (veride N_1=48 sayılır) yeniden üretilemez (94.6.1).
S6. Rastgele gezinti testleri neden bazı dizilerde "uygulanamaz"?
Döngü sayısı J<\max(0{,}005\sqrt n,500) ise \chi^2 yaklaşığı geçersizdir ve standart testin uygulanmamasını ister. J yaklaşık \sqrt n kadar büyür: 10^5 bitlik 100 dizide J\ge500 koşulu yalnız 14 dizide sağlandı.
S7. İkinci düzeyde neden 10 sınıf, 0,0001 ve 3\sigma aralığı?
Standardın Bölüm 4.2'sidir: p değerleri 10 eşit sınıfa dağıtılır ve P_T\ge0{,}0001 ise tekdüze sayılır; geçen oran aralığı \hat p\pm3\sqrt{\hat p(1-\hat p)/s}'dir (\hat p=1-\alpha). Kod aralığın yalnız alt ucunu karar için kullanır (791).
S8. Çoklu test düzeltmesi (Bonferroni gibi) uygulanıyor mu?
Yalnız özet tablosunun üç çoklu alt testli satırında karar için Šidák düzeltmesi uygulanır (94.4.17). Ayrıntı tablosundaki p değerleri ve ikinci düzey çözümleme düzeltilmez: standardın yöntemi çoklu testi birçok dizi ve ikinci düzey sınamalarla ele alır. Tek dizide Bonferroni isteniyorsa \alpha alt test sayısına bölünerek (0{,}01/188\approx5{,}3\times10^{-5}) kullanılabilir; bu, bataryanın standart yorumundan farklı bir ölçüttür.
S9. Şablon neden her bataryayı tek bir "geçti/kaldı"ya indirmiyor?
Standart böyle bir toplu karar vermez; yorum p değerlerinin ve ikinci düzey ölçütlerin birlikte değerlendirilmesine dayanır. Şablonun özet tablosundaki "karar" sütunu her satırın kendi p'sine göredir. Çoklu alt testli satırda bu sütun, p sütunundaki en küçük p'ye değil, onun Šidák düzeltmeli değerine dayanır.
94.10 Kaynaklar
- Hamano, K., & Kaneko, T. (2007). Correction of overlapping template matching test included in NIST randomness test suite. IEICE Transactions on Fundamentals of Electronics, Communications and Computer Sciences, E90-A(9), 1788–1792. https://doi.org/10.1093/ietfec/e90-a.9.1788
- Harris, C. R., Millman, K. J., van der Walt, S. J., et al. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Massey, J. L. (1969). Shift-register synthesis and BCH decoding. IEEE Transactions on Information Theory, 15(1), 122–127. https://doi.org/10.1109/TIT.1969.1054260
- Maurer, U. M. (1992). A universal statistical test for random bit generators. Journal of Cryptology, 5(2), 89–105. https://doi.org/10.1007/BF00193563
- McKinney, W. (2010). Data structures for statistical computing in Python. Proceedings of the 9th Python in Science Conference, 56–61. https://doi.org/10.25080/Majora-92bf1922-00a
- Pareschi, F., Rovatti, R., & Setti, G. (2012). On statistical tests for randomness included in the NIST SP800-22 test suite and based on the binomial distribution. IEEE Transactions on Information Forensics and Security, 7(2), 491–505. https://doi.org/10.1109/TIFS.2012.2185227
- Rukhin, A., Soto, J., Nechvatal, J., Smid, M., Barker, E., Leigh, S., Levenson, M., Vangel, M., Banks, D., Heckert, A., Dray, J., & Vo, S. (2010). A statistical test suite for random and pseudorandom number generators for cryptographic applications (NIST Special Publication 800-22, Rev. 1a; L. E. Bassham III tarafından revize edilmiştir). National Institute of Standards and Technology. https://doi.org/10.6028/NIST.SP.800-22r1a
- Virtanen, P., Gommers, R., Oliphant, T. E., et al. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261–272. https://doi.org/10.1038/s41592-019-0686-2