25. Çok kategorili (nominal) karma lojit: temel kategori lojiti + küme rastgele etkileri (mclogit)
Şablon kimliği: nominal_karma · Kategori: karma model · Dil: R · Dosya: pro/sablonlar/karma_model/nominal_karma.R (satır 1–193; üstbilgi 1–95) · Örnek veri: _ornek/verbagg.csv · Paketler: mclogit 0.9.15
25.1 Ne işe yarar
Şablon, sırasız (nominal) kategorili bir yanıtın her kategorisini bir temel kategoriyle karşılaştıran lojit denklemlerini kurar ve gözlemleri gruplayan kümenin (kişi, okul, bölge) her denkleme kendi rastgele kesişimiyle girmesine izin verir. Cevapladığı soru şudur: "Aynı kümeden gelen gözlemlerin benzerliği ayıklandığında, açıklayıcı değişkenler yanıtın temel kategori yerine öteki kategorilerden birinde olma olasılığını nasıl değiştiriyor?"
- Y_{ig}: g. kümedeki i. gözlemin yanıtı; J kategori. Kategori 1 temel (referans) kategoridir.
- \boldsymbol\beta_j: j. lojit denkleminin katsayı vektörü (kesişim dahil); her açıklayıcı için J-1 katsayı vardır.
- u_{jg}: kümenin j. denklemdeki rastgele kesişimi. \boldsymbol\Sigma: bu kesişimlerin (J-1)\times(J-1) kovaryans matrisi.
- e^{\beta}: açıklayıcının bir birim artışıyla, aynı küme içinde, "j / temel" odds'unun kaç katına çıktığı (oran oranı).
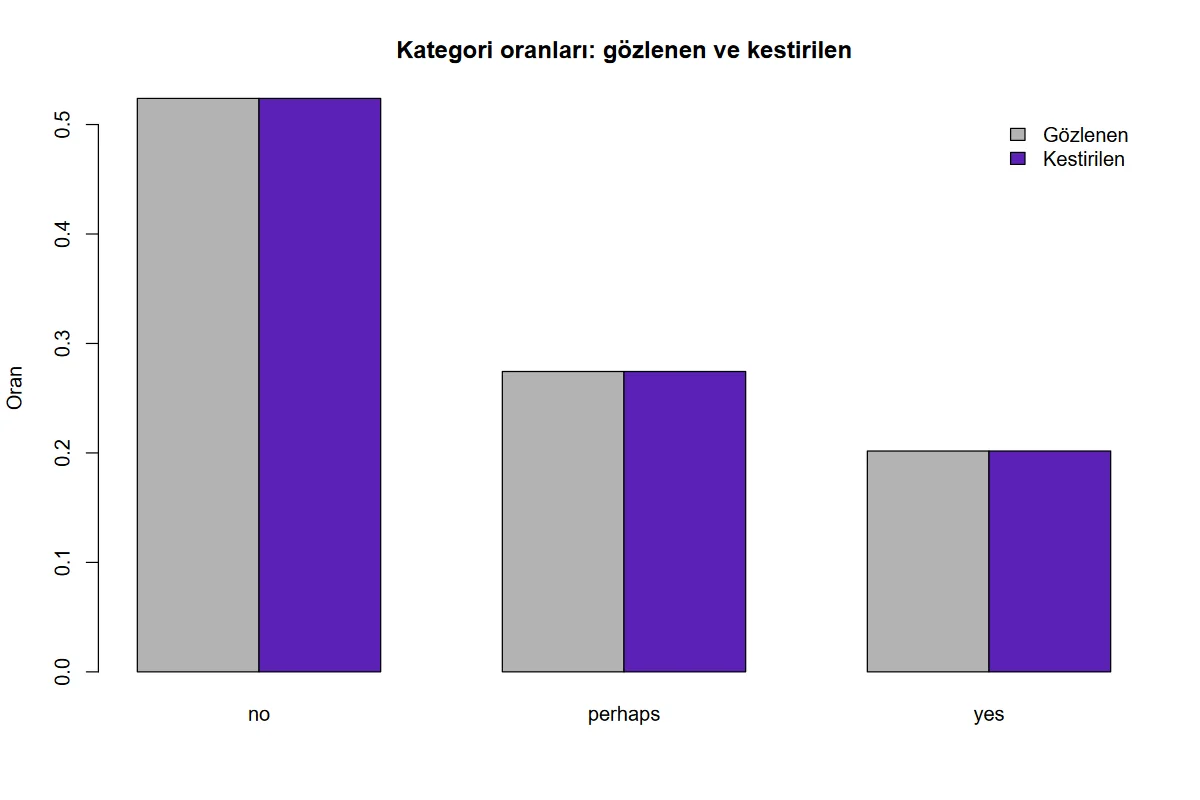
Küme seçilmezse \mathbf u_g düşer ve model sıradan çok terimli (multinomial) lojit regresyondur. Şablon her denklemin katsayılarını (SH, z, p, oran oranı), kümeli modelde rastgele kesişim kovaryansını ve bir uyum tablosunu verir; şekil gözlenen ve kestirilen kategori oranlarını yan yana çizer.
Ne zaman kullanılır? Yanıt üç ya da daha çok sırasız kategoriliyse (tercih edilen seçenek, tanı türü, davranış biçimi); gözlemler kümeler içinde yineleniyorsa; kategorilere özgü küme farklılıkları ve bunların ilişkisi de ilgi konusuysa.
Ne zaman kullanılmaz?
- Kategoriler sıralıysa: sıra bilgisini kullanan
clmm_sirali_karma(Bölüm 16) daha az parametreyle daha güçlüdür. - Yanıt iki kategoriliyse: şablon durur (satır 114);
glmer_ileriya da temel programdaki GLMM (Genelleştirilmiş Doğrusal Karma Modeller). - İlgi popülasyon ortalamalı etkideyse:
sirali_nominal_gee(nominal yanıt seçeneği, Bölüm 29). - Küme yoksa ve seçenekler gerekmiyorsa: temel programdaki Multinomial Lojistik Regresyon aynı sabit etkili modeli kurar.
- Küme başına gözlem çok azsa (2–5) ve varyans büyükse: cezalı yarı-olabilirlik yanlıdır (25.4.6); kareleme tabanlı bir yöntem gerekir.
Temel programla ilişki. Temel programın Multinomial Lojistik Regresyon analizi gözlemleri bağımsız sayar. Bu şablon aynı denklemlere küme rastgele kesişimlerini ekler; kümesiz çalıştırıldığında sabit etkili modelin en çok olabilirlik kestirimini verir ve sonuçlar bağımsız hesapla 10^{-7} içinde aynıdır (25.6.1).
25.2 Şablonun girdileri
Form, üstbilgideki on iki [[param]] bloğundan kurulur (nominal_karma.R:10–94).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Nominal yanıt (en az 3 kategori) · y |
sütun · Değişkenler | ilk sütun | herhangi bir sütun | factor() ile yanıt (112–121). |
Sabit etkiler · x |
sütunlar · Değişkenler | — (en az 1) | sütun listesi | Her lojit denkleminin terimleri (102, 134). |
Küme (rastgele kesişim grubu; boş = sabit etkili model) · grup |
kategorik sütun · Değişkenler | boş | herhangi bir sütun | random = ~1 | küme (128–131, 142). |
Frekans / ağırlık (gruplanmış veri; isteğe bağlı) · frekans |
sayısal sütun · Değişkenler | boş | negatif olmayan sayı | weights (107–110, 132). |
Temel (referans) yanıt kategorisi (boş = ilk kategori) · referans |
metin · Model | boş | yanıtın bir düzeyi | relevel() (116–120). |
Lojitler arası rastgele etki kovaryansı · kovaryans |
seçim · Model | free |
free, diagonal, single |
catCov (143). |
Yaklaşım yöntemi · yontem |
seçim · Model | PQL |
PQL, MQL |
method (144). |
Varyans bileşeni kestiricisi · kestirici |
seçim · Model | ML |
ML, REML |
estimator (145). |
Aşırı yayılım parametresi · yayilim |
seçim · Model | yok |
yok, Afroz, Fletcher, Pearson, Deviance |
dispersion (147–150). |
En çok yineleme · maks_yineleme |
tamsayı · Gelişmiş | 100 | 5–10000 | maxit (136, 139–140, 146). |
Yakınsama ölçütü (0 = otomatik) · epsilon |
ondalık · Gelişmiş | 0 | 0–0,01 | epsilon; 0 iken kümeli modelde 10^{-8}, kümesizde 10^{-12} (137–140, 146). |
İç optimizasyon algoritması · ic_optimizer |
seçim · Gelişmiş | nlminb |
nlminb, nlm, ucminf, BFGS, Nelder-Mead |
inner.optimizer; yalnız kümeli modelde (139–140). |
Örnek ayar (ornek_param, satır 9): y = resp, x = [Anger, Gender, btype, mode], grup = id, referans = "no". Öteki alanlar varsayılandadır.
Şablonun kendi denetimleri.
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 99 |
| Yanıt, küme ve frekans dışında sabit etki kalmıyor | "en az bir sabit etki seçin" | 103 |
| Küme ile yanıt aynı sütun | "Küme ve yanıt farklı olmalı." | 104 |
| Negatif frekans | "Frekanslar negatif olamaz." | 108 |
| Tam satır sayısı 10'dan az | "En az 10 tam satır gerekli." | 111 |
| Yanıtta 3'ten az kategori | "en az 3 kategorisi olmalı (2 kategori için ikili lojistik karma model…)" | 114 |
| Yanıtta 15'ten çok kategori | "15'ten fazla kategori var; nominal yanıt seçtiğinizden emin olun." | 115 |
| Referans kategori yanıtta yok | "Referans kategori '…' yanıtta yok. Kategoriler: …" | 118 |
| Sabit etki tek düzeyli ya da sabit | "'…' sabit (tek düzeyli); sabit etkilerden çıkarın." | 126 |
| Kümede 3'ten az düzey | "Kümede en az 3 düzey gerekli." | 130 |
| Yayılım seçili, küme yok | "yalnız küme seçiliyken kestirilir" | 148 |
mblogit hata verdi |
"Model kurulamadı: …" | 154 |
| Katsayı ya da SH sonlu değil | "sonlu değil (… tam ayrışma olabilir)" | 158 |
Eksik değer: yanıt, sabit etkiler, küme ve frekanstan biri eksik olan satır liste bazında atılır (106); frekansı sıfır olan satırlar da çıkarılır (109). Durdurmayan iletiler: 1000'den büyük SH için "yarı ayrışma olabilir" (159), algoritma yakınsamadıysa uyarı (180), kümeli modelde "PQL/MQL yaklaşık olabilirlik yöntemleridir…" notu (181) ve paketin kestirim sırasında verdiği uyarılar ("Uyarılar:", 182).
25.3 Örnek veri
Dosya: _ornek/verbagg.csv. De Boeck ve Wilson'ın (2004) sözel saldırganlık verisi (lme4 paketindeki VerbAgg): 316 kişi, 24 maddenin her birini "no", "perhaps", "yes" seçeneklerinden biriyle yanıtlamıştır; 7584 gözlem, eksik değer yok. Maddeler bir engellenme durumunda sövme, azarlama ya da bağırma davranışını istemeyi ya da yapmayı sorar. Özgün ölçek sıralıdır; şablon örneğinde yanıt nominal ele alınır.
| Değişken | Rol | Tür (veri sekmesi) | Özet |
|---|---|---|---|
resp |
Yanıt | kategorik (3 düzey) | no 3973, perhaps 2081, yes 1530 (oranlar 0,5239; 0,2744; 0,2017). |
Anger |
Sabit etki | sayısal | Öfke ölçeği puanı; 11–39, ortalama 20,00, SS 4,84; kişi içinde değişmez. |
Gender |
Sabit etki | ikili (metin) | F 243, M 73 kişi. |
btype |
Sabit etki | kategorik (3 düzey) | curse, scold, shout; her biri 2528 gözlem. |
mode |
Sabit etki | ikili (metin) | do, want; her biri 3792 gözlem. |
id |
Küme | sayısal (316 değer) | Kişi numarası; her kişide 24 gözlem. |
item, situ |
kullanılmaz | kategorik, ikili | Madde adı; durum türü (other, self). |
Temel kategori ve düzey sırası
Yanıtın düzey sırası veri sekmesinin kuralıyla gelir (Bölüm 1.3): resp kategorik algılanır ve düzeyleri verideki ilk görülme sırasıyla R'ye aktarılır; dosyanın ilk satırı "no" olduğundan sıra no, perhaps, yes'tir. "Temel (referans) yanıt kategorisi" boş bırakılırsa temel kategori bu sıranın ilk düzeyidir; verinin satır sırası değişirse temel kategori de değişir. Örnek ayar temel kategoriyi adıyla verir (referans = "no"); denklemler "perhaps / no" ve "yes / no"dur. Yazılan ad yanıtta yoksa hata iletisi geçerli kategorileri sayar (satır 118). Sabit etkilerde btype'ın referansı ilk görülen düzey (curse), iki değerli metin sütunları Gender ve mode'un referansı alfabetik ilk değerdir (F, do).
Bu bölümde kullanılan çalıştırmalar: (1) örnek ayar (kişi rastgele kesişimi, serbest kovaryans, PQL, ML); (2) küme yok (sabit etkili model); (3) köşegen kovaryans; (4) köşegen kovaryans, yakınsama ölçütü 10^{-13}; (5) tek ortak varyans; (6) MQL; (7) REML; (8) iç eniyileyici nlm, ucminf, BFGS, Nelder–Mead (ayrı ayrı); (9) yayılım Pearson; (10) gruplanmış veri ve frekans sütunu (küme yok).
25.4 Yöntem: formüller ve hesap adımları
Hesap sırası: (1) eksik ve sıfır frekanslı satırları at, yanıtı faktöre çevir, temel kategoriyi öne al; (2) küme yoksa çok terimli lojiti en çok olabilirlikle kestir; (3) küme varsa cezalı (PQL) ya da marjinal (MQL) yarı-olabilirlikle, çalışma yanıtı üzerinden doğrusal karma model kurarak \boldsymbol\beta, \mathbf u_g ve \boldsymbol\Sigma'yı dönüşümlü kestir; (4) katsayı, kovaryans ve uyum tablolarını yaz; (5) gözlenen ve kestirilen oranları çiz.
25.4.1 Kategori olasılıkları ve sabit etkili model
Kümesiz modelde log-olabilirlik ve Newton adımı:
- \mathbf y_i, \boldsymbol\pi_i: temel kategori dışındaki J-1 kategorinin gösterge ve olasılık vektörleri.
- \mathbf X_i=\mathbf I_{J-1}\otimes\mathbf x_i^{\top}: her denkleme aynı açıklayıcıları veren tasarım bloğu.
- w_i: frekans (ağırlık); sütun seçilmezse 1. Ağırlık, satırın o sayıda yinelenmesiyle aynı sonucu verir.
- Köşeli parantez içindeki matris Fisher bilgisidir; tersi katsayıların kovaryansıdır. Çok terimli lojitte gözlenen ve beklenen bilgi aynıdır.
Uyum ölçüleri: artık sapma D=-2\ell(\hat{\boldsymbol\beta}) ve \mathrm{AIC}=D+2\,p\,(J-1); p bir denklemdeki katsayı sayısıdır.
Neden bir temel kategori gerekir?
J olasılığın toplamı 1'dir; J ayrı doğrusal yordayıcı tanımlanamaz, yalnız J-1 fark tanımlanır. Bir kategorinin yordayıcısı sıfıra sabitlenir; öteki katsayılar o kategoriye göre log-odds farklarıdır. Temel kategori değişince katsayılar değişir, kestirilen olasılıklar ve log-olabilirlik değişmez: "yes / perhaps" katsayısı, "yes / no" ile "perhaps / no" katsayılarının farkıdır.
25.4.2 Rastgele kesişimlerin kovaryans yapıları
mclogit üç yapı sunar. Serbest yapıda \mathbf u_g\sim N(\mathbf 0,\boldsymbol\Sigma) ve \boldsymbol\Sigma kısıtsızdır. Öteki iki yapıda paket, temel kategori dahil her kategoriye bağımsız bir küme etkisi v_{cg} verir; lojit denklemindeki rastgele kesişim bunların farkıdır:
- v_{cg}\sim N(0,\tau_c^2): c. kategorinin küme etkisi (c=1,\dots,J), kategoriler arasında bağımsız.
- Köşegen yapıda J varyans vardır; lojitler arası kovaryansın hepsi temel kategorinin varyansı \tau_1^2'dir ve negatif olamaz.
- Tek ortak varyansta \tau_c^2=\tau^2: her lojit kesişiminin varyansı 2\tau^2, her kovaryans \tau^2, her korelasyon 0,5'tir.
- J=3 iken serbest yapının da köşegen yapının da üç parametresi vardır; köşegen yapı, kovaryansı pozitif ve her varyanstan küçük olan \boldsymbol\Sigma'ları kapsar.
Koddaki tercih
Kovaryans tablosu m$VarCov[[1]] nesnesinden kurulur (satır 169–171). Serbest yapıda bu, (J-1)\times(J-1) matrisin tamamıdır (perhaps~1, yes~1). Köşegen yapıda paket her kategori için ayrı bir 1\times1 bileşen tutar ve tablo bunların ilkini, temel kategorinin varyansını gösterir (örnek veride no~1 = 1,1831); öteki kategorilerin varyansları (perhaps 0,0471, yes 0,9052) tabloya girmez. Tek ortak varyansta tablo \tau^2'yi verir (~1 = 0,6890); lojit kesişimlerinin varyansı bunun iki katıdır.
25.4.3 Cezalı yarı-olabilirlik (PQL)
Rastgele etkiler üzerinden integral kapalı biçimde alınamaz. PQL (Breslow ve Clayton, 1993), modeli geçerli kestirimler çevresinde doğrusallaştırır: her gözlem için bir çalışma yanıtı ve ağırlık matrisi kurulur,
ve bu doğrusal karma modelin (ML ya da REML) log-olabilirliği \boldsymbol\Sigma'ya göre en büyüklenir:
- \boldsymbol\eta_i, \boldsymbol\pi_i, \mathbf W_i: geçerli \boldsymbol\beta ve \mathbf u_g ile hesaplanır (PQL); MQL'de \mathbf u_g=\mathbf 0 alınır (25.4.5).
- m: küme sayısı. \mathbf A_g: kümenin toplam ağırlık matrisi.
- Q(\boldsymbol\Sigma): çalışma yanıtının, \boldsymbol\beta ve \mathbf u en iyi değerlerindeyken kalan ağırlıklı kareler toplamı.
- REML'de köşeli paranteze \log\lvert\mathbf X^{\top}\mathbf V^{-1}\mathbf X\rvert eklenir.
\boldsymbol\Sigma verildiğinde \boldsymbol\beta ve \mathbf u_g karma model denklemlerinden bulunur:
- \mathbf K_g=(\mathbf A_g+\boldsymbol\Sigma^{-1})^{-1}; \mathbf C_g=\sum_{i\in g}w_i\mathbf W_i\mathbf X_i.
- \mathbf V: çalışma yanıtının marjinal kovaryansı (\mathbf W^{-1}+\mathbf Z\boldsymbol\Sigma\mathbf Z^{\top}); formüller onu açıkça kurmadan aynı sonucu verir.
- Katsayıların standart hataları (\mathbf X^{\top}\mathbf V^{-1}\mathbf X)^{-1}'in köşegeninin kareköküdür; z=\hat\beta/\operatorname{SH}, p=2\Phi(-\lvert z\rvert).
Üç adım (\mathbf z,\mathbf W → \boldsymbol\Sigma → \boldsymbol\beta,\mathbf u) doğrusal yordayıcı değişmeyene dek yinelenir. Yakınsamada kestirimler şu iki koşulu birlikte sağlar (PQL'in sabit noktası):
Neden "cezalı"?
İlk koşul, \log\prod_i\pi_{i,y_i}-\tfrac12\sum_g\mathbf u_g^{\top}\boldsymbol\Sigma^{-1}\mathbf u_g ifadesinin \mathbf u_g'ye göre türevinin sıfır olmasıdır: küme etkileri veriye uyacak biçimde büyür, ama \boldsymbol\Sigma^{-1} ile ağırlıklı kareleri kadar ceza öder. Küçük varyans büyük ceza, yani sıfıra doğru güçlü büzülme demektir. İkinci koşul varyansı, kestirilen etkilerin kareleri ile bu etkilerin belirsizliğinin (\mathbf K_g) toplamına eşitler.
Koddaki tercih
İç adımda mclogit, \ell_P'yi \boldsymbol\Sigma^{-1}'in Cholesky çarpanı üzerinden, formdaki "İç optimizasyon algoritması" ile en büyükler (varsayılan nlminb; satır 139–140). Dış döngü, doğrusal yordayıcıdaki göreli değişim \sum(\eta-\eta_{\text{önceki}})^2/\sum\eta^2 ölçütün (10^{-8}) altına indiğinde durur ve "yakınsadı" satırına 1 yazılır; iç eniyileyicinin kendi durumu bu satıra yansımaz, "Uyarılar:" satırında yazılır. Örnek ayarda iç adım her dış yinelemede "false convergence" iletisiyle durur ve kestirilen kovaryans sabit nokta koşulunu sağlamaz: tablodaki \hat{\boldsymbol\Sigma} için ikinci koşulun iki yanı arasındaki en büyük fark 0,063'tür. Sabit nokta, bağımsız hesapla ve şablonun köşegen yapılı çalıştırmasıyla bulunur (25.6).
25.4.4 Yaklaşık sapma
Kümeli modelde uyum tablosu "yaklaşık sapma" verir:
- Üçüncü terim, rastgele etkiler dahil kestirilen olasılıklarla hesaplanan artık sapmadır; son terim cezadır.
- İlk iki terim, rastgele etkiler üzerinden integralin Laplace türü yaklaşığından gelir.
Yaklaşık sapma bir olabilirlik değildir
D_P doğrusallaştırılmış modelin ölçütüdür; gerçek marjinal olabilirliğin -2 katı değildir. Bu yüzden şablon kümeli modelde AIC vermez (satır 176) ve notla uyarır (181). Kovaryans yapıları ya da sabit etki kümeleri D_P farkıyla olabilirlik oranı testine sokulmaz; sabit etkiler Wald z ile sınanır.
25.4.5 MQL, REML ve yayılım seçenekleri
MQL (marjinal yarı-olabilirlik) çalışma yanıtını ve ağırlıkları yalnız sabit kısımdan (\boldsymbol\eta_i=\mathbf X_i\boldsymbol\beta) kurar. Hesap daha kararlıdır, ama katsayılar popülasyon ortalamalı değerlere doğru küçülür ve varyanslar aşağı yanlıdır: örnek veride Anger'ın "yes / no" katsayısı PQL'de 0,0967, MQL'de 0,0798 (sabit etkili modelde 0,0809); yes varyansı 2,036 ve 1,440'tır. REML, varyans kestiriminde sabit etkilerin harcadığı serbestlik derecesini hesaba katar; 316 kümeyle fark küçüktür (sabit noktada yes varyansı 2,0883 yerine 2,1186).
Aşırı yayılım seçeneği yalnız küme seçiliyken açıktır ve değeri mblogit(dispersion = …) olarak geçirilir (147–150). Örnek veride Pearson seçeneğiyle çalıştırma, yayılım seçilmeden yapılan çalıştırmayla aynı katsayıları ve standart hataları verir.
25.4.6 PQL'in yanlılığı
PQL'in doğrusallaştırması, küme başına bilgi azken ve varyans büyükken iyi değildir: varyans bileşenleri ve onlara bağlı olarak katsayılar sıfıra doğru yanlı çıkar (Rodríguez ve Goldman, 1995; Goldstein ve Rasbash, 1996). Yanlılık küme büyüklüğüyle azalır. Örnek veride küme başına 24 gözlem vardır; bu, yaklaşımın görece güvenli olduğu bölgedir. Küme başına birkaç gözlemli veride sonuçlar alt sınır sayılır.
25.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 1–95 | Üstbilgi: kimlik, açıklama, örnek veri ve ayar, on iki parametre. | Form ve varsayılanlar buradan kurulur (Bölüm 1.2). |
| 96–111 | mclogit yüklenir; boş küme ve frekans ayıklanır; d kurulur; eksik ve sıfır frekanslı satırlar atılır. |
setdiff yanıtı, kümeyi ve frekansı x'ten düşürür (102). |
| 112–121 | Yanıt faktöre çevrilir, kullanılmayan düzeyler atılır, temel kategori öne alınır. | Sayısal kodlu yanıt da faktör olur; sıra sayı sırasıdır. |
| 122–132 | Metin ve mantıksal sabit etkiler faktör yapılır; sabit sütun denetlenir; küme faktörü ve ağırlık sütunu kurulur. | Sayısal sabit etki tek eğimle girer; kategorikse veri sekmesinde tür değiştirilir. |
| 133–150 | Formül ve mblogit argümanları: kümeli modelde random, catCov, method, estimator; kümesizde mclogit.control. |
estimator yalnız REML seçilince geçirilir (145). |
| 151–155 | Model kurulur; paketin konsol çıktısı yutulur, uyarılar toplanır. | Hata çevrilmiş iletiye dönüşür (154). |
| 156–164 | Katsayı tablosu: denklem, terim, kestirim, SH, z, p, oran oranı. | Satır adı yes~Anger biçiminden "yes / no" ve "Anger"e ayrılır (160–161). |
| 166–182 | Kovaryans tablosu (kümeli), uyum tablosu, notlar ve uyarılar. | Kümesizde artık sapma ve AIC; kümelide yaklaşık sapma (173–178). |
| 184–192 | Gözlenen ve kestirilen kategori oranları; mq_sekil. |
Kestirilen oran, gözlem olasılıklarının ağırlıklı ortalamasıdır (187). |
Katsayı tablosu satırları terim sırasıyla, her terimde denklem sırasıyla dizilir: önce iki kesişim, sonra Anger'ın iki katsayısı … Bir denklemin tüm katsayılarını okumak için tablo "denklem" sütununa göre süzülür.
25.6 Elle hesap: örnek veride bağımsız yeniden hesap
Ara değerler dogrulama/nominal_karma/elle_hesap.py ile, mclogit ve nnet kullanılmadan hesaplanmıştır: sabit etkili model Newton–Raphson ile; kümeli model, 25.4.3'teki iki koşulun sabit noktası aranarak (\boldsymbol\Sigma verilmişken cezalı olabilirliğin (\boldsymbol\beta,\mathbf u) modu, ardından \boldsymbol\Sigma güncellemesi; değişim 10^{-13}'ün altına inene dek). R tarafında (r_dogrulama.R) sabit model nnet::multinom ile; kümeli model, çalışma yanıtının profil log-olabilirliği \boldsymbol\Sigma'nın log-Cholesky parametrelerine göre stats::nlminb ile en büyüklenerek kurulmuştur. İki bağımsız yol aynı noktaya varır.
Adım 1 — Boş model. Yalnız kesişimli modelde kestirilen olasılıklar gözlenen oranlardır; sapma
Adım 2 — Sabit etkili model. Newton–Raphson 6 adımda yakınsar (son adım <10^{-13}):
| Terim | perhaps / no | SH | yes / no | SH |
|---|---|---|---|---|
| (Intercept) | −0,375782 | 0,130157 | −2,144653 | 0,145904 |
| Anger | 0,008139 | 0,005976 | 0,080868 | 0,006398 |
| GenderM | 0,171656 | 0,066089 | 0,302378 | 0,074044 |
| btypescold | −0,676977 | 0,067095 | −0,916017 | 0,073941 |
| btypeshout | −1,298007 | 0,070090 | −1,828723 | 0,083969 |
| modewant | 0,410137 | 0,055831 | 0,630270 | 0,064145 |
D=14444{,}4897; \mathrm{AIC}=D+2\cdot12=14468{,}4897. Boş modele göre olabilirlik oranı 15417{,}874-14444{,}490=973{,}384 (sd 10), McFadden R^2=1-D/D_0=0{,}0631. Anger'ın "yes / no" katsayısı için z=0{,}080868/0{,}006398=12{,}639 ve oran oranı e^{0{,}080868}=1{,}0842.
Adım 3 — Kümeli model: PQL'in sabit noktası (serbest kovaryans, ML).
| Terim | perhaps / no | SH | yes / no | SH |
|---|---|---|---|---|
| (Intercept) | −0,468534 | 0,307506 | −2,540051 | 0,393275 |
| Anger | 0,016636 | 0,014674 | 0,097320 | 0,018592 |
| GenderM | 0,209199 | 0,165522 | 0,422799 | 0,211991 |
| btypescold | −0,837191 | 0,072845 | −1,149299 | 0,082691 |
| btypeshout | −1,603461 | 0,076897 | −2,288729 | 0,094763 |
| modewant | 0,508790 | 0,060298 | 0,784043 | 0,071192 |
Yaklaşık sapma D_P=12960{,}2764; bunun 11556,5668'i artık sapma terimidir. Kişi düzeyindeki açıklayıcıların (Anger, Gender) standart hataları sabit modeldekinin 2,5–2,9 katıdır: bu değişkenler kişi içinde değişmez, bilgi 7584 gözlemden değil 316 kişiden gelir. Madde düzeyindeki açıklayıcıların (btype, mode) katsayıları ise mutlak değerce büyür; bu, koşullu (kişiye özgü) etkinin marjinal etkiden büyük olmasının beklenen sonucudur.
Adım 4 — Köşegen yapıyla bağlantı. 25.4.2'deki eşleme sabit noktada sağlanır: şablonun köşegen yapılı çalıştırması no 1,1831, perhaps 0,0471, yes 0,9052 varyanslarını kestirir ve
Üç kategoride iki yapı aynı modeldir; köşegen yapılı çalıştırma (ölçüt 10^{-13}) Adım 3'teki katsayıları ve standart hataları 5\times10^{-7} içinde yeniden üretir (25.6.1).
Adım 5 — İç eniyileyiciye göre şablonun serbest yapıdaki kestirimi. Aynı veri, aynı model, yalnız "İç optimizasyon algoritması" değişir. Son sütun, kestirilen \hat{\boldsymbol\Sigma} için sabit nokta koşulunun iki yanı arasındaki en büyük farktır (duraganlik.py).
| İç eniyileyici | \hat\Sigma_{11} | \hat\Sigma_{12} | \hat\Sigma_{22} | Yaklaşık sapma | Koşuldan sapma |
|---|---|---|---|---|---|
| nlminb (varsayılan) | 1,3555 | 1,1780 | 2,0364 | 12960,574 | 0,063 |
| ucminf | 1,3603 | 1,1868 | 2,0595 | 12960,217 | 0,066 |
| Nelder–Mead | 1,2303 | 1,1835 | 2,0889 | 12960,275 | 0,0003 |
| nlm, BFGS | 0,00005 | −0,00002 | 0,00004 | 14444,119 | — |
| Sabit nokta (bağımsız hesap) | 1,2303 | 1,1831 | 2,0883 | 12960,276 | <10^{-13} |
nlm ve BFGS ile kovaryans sıfıra çöker; katsayılar ve standart hatalar sabit etkili modelinkilere döner (Anger, yes / no: 0,0809; SH 0,0064). Bu çalıştırmalarda da "yakınsadı" satırı 1'dir.
25.6.1 Doğrulama: MerQuR+, Python ve R
MerQuR+ sütunu şablonun tablolarından tam hassasiyetle okunmuştur: sabit model satırları çalıştırma 2'den, "köşegen" satırları çalıştırma 4'ten, "örnek ayar" satırları çalıştırma 1'den.
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| Sabit: \hat\beta (perhaps; (Intercept)) | −0,37578225 | −0,37578225 | −0,3757824 | 1,5e−7 | ✓ |
| Sabit: \hat\beta (yes; (Intercept)) | −2,14465315 | −2,14465315 | −2,14465294 | 9,9e−8 | ✓ |
| Sabit: \hat\beta (perhaps; Anger) | 0,00813901 | 0,00813901 | 0,00813901 | 1,0e−10 | ✓ |
| Sabit: \hat\beta (yes; Anger) | 0,08086784 | 0,08086784 | 0,08086783 | 1,3e−8 | ✓ |
| Sabit: \hat\beta (perhaps; GenderM) | 0,17165586 | 0,17165586 | 0,17165578 | 8,0e−8 | ✓ |
| Sabit: \hat\beta (yes; GenderM) | 0,30237796 | 0,30237796 | 0,30237791 | 4,4e−8 | ✓ |
| Sabit: \hat\beta (perhaps; btypescold) | −0,67697677 | −0,67697677 | −0,67697671 | 5,4e−8 | ✓ |
| Sabit: \hat\beta (yes; btypescold) | −0,9160165 | −0,9160165 | −0,91601643 | 7,1e−8 | ✓ |
| Sabit: \hat\beta (perhaps; btypeshout) | −1,29800663 | −1,29800663 | −1,29800642 | 1,6e−7 | ✓ |
| Sabit: \hat\beta (yes; btypeshout) | −1,82872313 | −1,82872313 | −1,82872277 | 2,0e−7 | ✓ |
| Sabit: \hat\beta (perhaps; modewant) | 0,41013697 | 0,41013697 | 0,41013697 | 1,4e−9 | ✓ |
| Sabit: \hat\beta (yes; modewant) | 0,63026955 | 0,63026955 | 0,63026956 | 3,4e−9 | ✓ |
| Sabit: SH (perhaps; (Intercept)) | 0,13015657 | 0,13015657 | 0,13015658 | 1,0e−9 | ✓ |
| Sabit: SH (yes; (Intercept)) | 0,14590404 | 0,14590404 | 0,14590404 | 5,4e−9 | ✓ |
| Sabit: SH (perhaps; Anger) | 0,00597584 | 0,00597584 | 0,00597584 | 2,2e−11 | ✓ |
| Sabit: SH (yes; Anger) | 0,0063984 | 0,0063984 | 0,0063984 | 2,3e−10 | ✓ |
| Sabit: SH (perhaps; GenderM) | 0,0660893 | 0,0660893 | 0,0660893 | 9,4e−10 | ✓ |
| Sabit: SH (yes; GenderM) | 0,07404405 | 0,07404405 | 0,07404404 | 2,9e−9 | ✓ |
| Sabit: SH (perhaps; btypescold) | 0,06709515 | 0,06709515 | 0,06709516 | 7,7e−10 | ✓ |
| Sabit: SH (yes; btypescold) | 0,0739406 | 0,0739406 | 0,0739406 | 1,7e−9 | ✓ |
| Sabit: SH (perhaps; btypeshout) | 0,07009022 | 0,07009022 | 0,07009022 | 1,3e−10 | ✓ |
| Sabit: SH (yes; btypeshout) | 0,0839687 | 0,0839687 | 0,0839687 | 6,4e−9 | ✓ |
| Sabit: SH (perhaps; modewant) | 0,05583107 | 0,05583107 | 0,05583107 | 5,6e−10 | ✓ |
| Sabit: SH (yes; modewant) | 0,0641447 | 0,0641447 | 0,0641447 | 2,3e−9 | ✓ |
| Sabit: z (yes; Anger) | 12,63875113 | 12,63875113 | — | 4,8e−13 | ✓ |
| Sabit: p (perhaps; GenderM) | 0,00939511 | 0,00939511 | — | 1,4e−15 | ✓ |
| Sabit: oran oranı (yes; modewant) | 1,87811677 | 1,87811677 | — | 3,2e−14 | ✓ |
| Sabit: artık sapma | 14444,48967997 | 14444,48967997 | 14444,48967997 | 2,1e−14 | ✓ |
| Sabit: AIC | 14468,48967997 | 14468,48967997 | 14468,48967997 | 2,1e−14 | ✓ |
| Karma (köşegen, ölçüt 10^{-13}): \hat\beta (perhaps; (Intercept)) | −0,46853429 | −0,46853411 | −0,46853412 | 1,8e−7 | ✓ |
| Karma (köşegen, ölçüt 10^{-13}): \hat\beta (yes; (Intercept)) | −2,54005165 | −2,54005064 | −2,54005054 | 4,3e−7 | ✓ |
| Karma (köşegen, ölçüt 10^{-13}): \hat\beta (yes; Anger) | 0,0973201 | 0,09732005 | 0,09732005 | 5,5e−8 | ✓ |
| Karma (köşegen, ölçüt 10^{-13}): \hat\beta (perhaps; btypeshout) | −1,60346125 | −1,60346082 | −1,60346084 | 2,7e−7 | ✓ |
| Karma (köşegen, ölçüt 10^{-13}): \hat\beta (yes; modewant) | 0,78404352 | 0,78404327 | 0,78404327 | 2,5e−7 | ✓ |
| Karma (köşegen, ölçüt 10^{-13}): SH (perhaps; (Intercept)) | 0,30750597 | 0,30750575 | 0,30750576 | 2,1e−7 | ✓ |
| Karma (köşegen, ölçüt 10^{-13}): SH (yes; Anger) | 0,01859246 | 0,01859242 | 0,01859242 | 3,9e−8 | ✓ |
| Karma (köşegen, ölçüt 10^{-13}): yaklaşık sapma | 12960,27635326 | 12960,27639172 | 12960,27640251 | 3,8e−9 | ✓ |
| Karma (köşegen, ölçüt 10^{-13}): no~1 varyansı =\hat\Sigma_{12} | 1,18312323 | 1,18311491 | 1,18311522 | 7,0e−6 | ✗ |
| Karma (örnek ayar): \hat\Sigma_{11} (perhaps) | 1,35546994 | 1,23026521 | 1,23026533 | 9,2e−2 | ✗ |
| Karma (örnek ayar): \hat\Sigma_{12} | 1,1780165 | 1,18311491 | 1,18311522 | 4,3e−3 | ✗ |
| Karma (örnek ayar): \hat\Sigma_{22} (yes) | 2,03640159 | 2,08834023 | 2,08834001 | 2,6e−2 | ✗ |
| Karma (örnek ayar): \hat\beta (perhaps; (Intercept)) | −0,47435935 | −0,46853411 | −0,46853412 | 5,8e−3 | ✗ |
| Karma (örnek ayar): \hat\beta (yes; Anger) | 0,09672955 | 0,09732005 | 0,09732005 | 5,9e−4 | ✗ |
| Karma (örnek ayar): SH (yes; Anger) | 0,01839944 | 0,01859242 | 0,01859242 | 1,9e−4 | ✗ |
| Karma (örnek ayar): yaklaşık sapma | 12960,57434189 | 12960,27639172 | 12960,27640251 | 2,3e−5 | ✗ |
Ölçütü karşılayan: 37/45. Python: Newton–Raphson (sabit model); karma modelde cezalı olabilirliğin ortak modu ile \hat{\boldsymbol\Sigma}=\tfrac1m\sum_g(\hat{\mathbf b}_g\hat{\mathbf b}_g^{\top}+\mathbf K_g) durağanlık koşulunun sabit noktası (mclogit ve nnet kullanılmadan). R: nnet::multinom (sabit model); karma modelde çalışma doğrusal karma modelinin profil log-olabilirliği stats::nlminb ile (mclogit kullanılmadan). İki bağımsız hesap karma modelde birbiriyle 4\times10^{-7} içinde aynıdır. ✗ işaretli satırların kaynağı 25.6.1'de açıklanmıştır.
Sabit etkili modelde üç hesap 10^{-7} içinde aynıdır. Kümeli modelde köşegen yapılı çalıştırma sabit noktayı katsayılarda ve standart hatalarda ölçüt içinde yeniden üretir; tek ✗, varyans bileşenindeki 7\times10^{-6}'lık farktır ve paketin iç eniyileyicisinin duyarlığından gelir. Örnek ayar satırlarındaki farklar ise yuvarlama değil, 25.4.3'te anlatılan durumdur: serbest yapıda iç adım "false convergence" iletisiyle durduğunda \hat{\boldsymbol\Sigma} sabit noktadan uzakta kalır (perhaps varyansı 1,355 ↔ 1,230) ve katsayılar üçüncü, standart hatalar dördüncü ondalıkta ayrılır. Madde düzeyindeki etkilerin yorumu değişmez; varyans bileşenleri ve kişi düzeyindeki etkilerin standart hataları raporlanacaksa 25.8'deki denetim yapılır.
25.7 Çıktıyı okuma
Örnek ayarın konsol metni iki satırdır:
Not: PQL/MQL yaklaşık olabilirlik yöntemleridir; sapma tam olabilirlik değildir ve AIC verilmez.
Uyarılar: Inner iterations did not coverge - nlminb message: false convergence (8)
Tablolar (örnek ayar; dört ondalık):
| Tablo | Satır | Değerler |
|---|---|---|
| Temel kategori lojit katsayıları (referans: no) | yes / no, Anger | kestirim 0,0967; SH 0,0184; z 5,2572; p 1,46·10⁻⁷; oran oranı 1,1016 |
| yes / no, btypeshout | −2,2855; 0,0947; −24,1366; < 10⁻¹²⁰; 0,1017 | |
| perhaps / no, modewant | 0,5103; 0,0605; 8,4362; 3,28·10⁻¹⁷; 1,6658 | |
| Rastgele kesişim kovaryans matrisi (küme: id; PQL) | perhaps~1 | 1,3555; 1,1780 |
| yes~1 | 1,1780; 2,0364 | |
| Model uyumu | birey sayısı (ağırlıklı) 7584; kategori sayısı 3; küme sayısı 316; yaklaşık sapma 12960,5743; yakınsadı 1 |
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| denklem | "j / temel" | Katsayı, bu iki kategori arasındaki log-odds içindir; öteki kategoriler hakkında tek başına bir şey söylemez. |
| kestirim, oran_orani | \hat\beta, e^{\hat\beta} | Aynı küme içinde bir birim artışın odds'a etkisi. Olasılığa etkisi için tüm denklemler birlikte kullanılır (25.9 S6). |
| SH, z, p | Wald çıkarımı | Varyans bileşenleri kestirilmiş değerinde sabit sayılır; küme sayısı azsa iyimserdir. |
| Kovaryans matrisi | \hat{\boldsymbol\Sigma} (serbest), \tau_1^2 (köşegen), \tau^2 (tek) | Köşegen: lojitler arası ortak kısım; ayrıntı 25.4.2. |
| birey sayısı (ağırlıklı) | Frekansların toplamı | Gruplanmış veride satır sayısı değil, kişi sayısıdır. |
| yaklaşık sapma / artık sapma | D_P / D | D_P karşılaştırma ölçütü değildir; D (kümesiz) olabilirlik oranı ve AIC için kullanılır. |
| yakınsadı | Dış döngünün durumu | 1 olması iç adımın yakınsadığını göstermez; "Uyarılar:" satırı ayrıca okunur. |
Şekil 25.1. Şablonun çizdiği gözlenen ve kestirilen kategori oranları (örnek ayar). Kesişim içeren modelde kestirilen olasılıkların ortalaması gözlenen oranlara eşittir (0,524; 0,274; 0,202); çubukların örtüşmesi modelin açıklayıcı gücünü değil, kodlamanın tutarlılığını gösterir.
Rapor cümlesi (PQL sabit noktası, 25.6 Adım 3):
Kişi rastgele kesişimli temel kategori lojit modelinde (cezalı yarı-olabilirlik, 316 kişi, 7584 yanıt; temel kategori "hayır") öfke puanındaki bir birimlik artış "evet" yanıtının odds'unu 1,10 katına çıkardı, \hat\beta = 0{,}097 (SH 0,019), z = 5{,}23, p < 0{,}001; "belki" yanıtı için etki anlamlı değildi, \hat\beta = 0{,}017 (SH 0,015), z = 1{,}13, p = 0{,}257. Bağırma maddelerinde "evet" odds'u sövme maddelerine göre 0,10 katına indi, z = -24{,}15, p < 0{,}001. Kişiler arası varyans "belki" denkleminde 1,23, "evet" denkleminde 2,09, aralarındaki korelasyon 0,74 olarak kestirildi.
25.8 Sık hatalar ve tuzaklar
- "Yakınsadı = 1" satırına bakıp uyarı satırını atlamak. İç eniyileyici uyarı verdiyse kovaryans kestirimi sabit noktada olmayabilir. Denetim: aynı model Nelder–Mead ile ve, üç kategorili yanıtta, köşegen yapıyla yeniden çalıştırılır; katsayılar ve varyanslar üçüncü ondalıkta tutuyorsa sonuç kararlıdır. Tutmuyorsa uyarısız çalıştırma raporlanır.
- nlm ya da BFGS ile sıfıra çöken kovaryansı "küme etkisi yok" diye okumak. Örnek veride bu iki eniyileyici varyansları 10^{-5} düzeyine indirir ve sabit etkili modelin standart hatalarını verir; BFGS uyarı da yazmaz. Kovaryans tablosunda sıfıra yakın değerler görüldüğünde eniyileyici değiştirilip yeniden denenir.
- Köşegen yapıda tabloyu "her lojitin varyansı" sanmak. Tablo yalnız temel kategorinin varyansını gösterir; lojit kesişimlerinin varyansı bundan büyüktür (25.4.2). Tek ortak varyansta da lojit varyansı tablodaki değerin iki katıdır.
- Yaklaşık sapmaları karşılaştırmak. Örnek veride serbest (12960,57), köşegen (12960,29) ve tek varyanslı (13003,05) yapıların sapmaları ile PQL (12960,57) ve MQL (17685,86) sapmaları aynı ölçekte değildir; fark testi kurulmaz.
- Temel kategoriyi satır sırasına bırakmak. "Temel kategori" boşsa ilk görülen düzey alınır; veri sıralanınca denklemler değişir. Temel kategori adıyla yazılır.
- Sıralı bir yanıtı nominal modellemek. Örnek verinin yanıtı aslında sıralıdır (no < perhaps < yes). Nominal model geçerlidir ama iki katı parametre harcar; katsayıların iki denklemde aynı yönde ve "yes" denkleminde daha büyük çıkması sıranın izidir. Sıra savunulabiliyorsa
clmm_sirali_karmakullanılır. - Sayısal açıklayıcıyı veri sekmesinde kategorik bırakmak.
Angerkategorik işaretlenirse 26 düzeyli faktör olur ve her denkleme 25 katsayı girer; model kurulur ama soru değişir. Tersine, sayısal kodlu kategorik değişken (1, 2, 3) sayısal bırakılırsa tek eğimle girer. - Frekans sütununu yanlış türde vermek. Frekans sayısal olmalıdır. Gruplanmış veride (her satır bir hücre,
adetsütunu) kümesiz model, açık veriyle aynı katsayıları ve sapmayı verir: örnek veri 36 hücreye indirildiğinde artık sapma 14618,5236 ile aynıdır. Kümeli modelde frekanslı veri, hücrelerin kümeyle çaprazlanmış olmasını gerektirir. - Küme kimliğini sabit etkilere de koymak. Küme sütunu
x'te işaretlenirse şablon onu listeden düşürür; kişi başına bir kukla değişken modele girmez. - Kişi düzeyindeki değişkenin etkisini madde sayısıyla güçlenmiş saymak.
Gender'ın "yes / no" katsayısının SH'si sabit modelde 0,074, kümeli modelde 0,212'dir. Kümeyi yok sayan model, kişi düzeyindeki etkileri olduğundan çok daha kesin gösterir.
25.9 Uzman soruları
S1. Serbest yapıda varsayılan eniyileyicinin sonucu neden sabit noktadan farklı, hangisi doğru?
PQL bir yineleme şemasıdır; "çözüm"ü, çalışma modelinin varyans kestirimi ile ortak modun birbirini yeniden ürettiği noktadır. Bağımsız iki uygulama (durağanlık koşulunun doğrudan yinelenmesi ve profil olabilirliğin log-Cholesky parametreleriyle en büyüklenmesi) aynı noktaya 4\times10^{-7} içinde varır; şablonun köşegen yapılı çalıştırması da oradadır. Varsayılan nlminb adımı serbest yapıda, \boldsymbol\Sigma^{-1}'in Cholesky parametrelerinde ilerleyemeyip "false convergence" ile durur; dış döngü ise doğrusal yordayıcı az değiştiği için yakınsama bildirir. Raporlanacak değer sabit noktadır; 25.8'deki denetim ona ulaşmanın yoludur.
S2. Köşegen yapı gerçekten "korelasyonsuz" mu?
Kategoriye özgü etkiler v_{cg} korelasyonsuzdur; lojit denklemlerinin rastgele kesişimleri değildir. u_{jg}=v_{jg}-v_{1g} olduğundan her iki lojit, temel kategorinin etkisini paylaşır ve kovaryansları \tau_1^2>0'dır. Örnek veride korelasyon 1{,}1831/\sqrt{1{,}2303\cdot2{,}0883}=0{,}74'tür. Lojit kesişimlerini gerçekten ilişkisiz tutan bir yapı bu şablonda yoktur. Köşegen yapıda kestirimler temel kategori seçimine bağlı değildir; v_{cg}'ler tüm kategoriler için simetrik tanımlanır.
S3. PQL burada ne kadar yanlı?
Kesin değer için aynı modelin kareleme ya da benzetim tabanlı kestirimi gerekir; şablon bunu yapmaz. Bilinen yön, varyansların ve onlara bağlı katsayıların sıfıra doğru çekildiğidir; yanlılık ikili yanıtta ve küçük kümelerde en büyüktür, küme büyüklüğü arttıkça azalır. Üç kategori ve küme başına 24 gözlem görece güvenli bir durumdur. Küme başına 2–5 gözlemli tasarımlarda PQL varyansları belirgin biçimde küçük kestirir; o durumda sonuçlar alt sınır olarak sunulur.
S4. Yaklaşık sapma neden AIC'ye çevrilmiyor?
AIC, en büyüklenmiş gerçek log-olabilirlik ister. D_P'nin ilk iki terimi integralin Laplace türü yaklaşığıdır ve doğrusallaştırma noktasına bağlıdır; farklı yapılar ve yöntemler arasında ortak bir ölçek oluşturmaz. Örnek veride MQL'in yaklaşık sapması 17685,86'dır; bu, modelin 4700 birim daha kötü uyduğunu göstermez, yalnız rastgele etkilerin sapma terimine girmediğini gösterir.
S5. Rastgele kesişimler arasındaki 0,74'lük korelasyon ne anlatır?
"Belki"yi "hayır"a yeğleme eğilimi yüksek olan kişi, "evet"i "hayır"a yeğlemeye de yatkındır: iki lojit, kişinin genel saldırganlık eğilimini paylaşır. Korelasyonun 1'e yakın olması tek boyutlu bir gizli özelliğe, yani sıralı bir yanıta işaret eder; köşegen yapıda perhaps kategorisine özgü varyansın küçüklüğü (0,047) aynı şeyi söyler. Bu veri için sıralı karma model doğal seçimdir.
S6. Katsayılardan olasılığa nasıl geçilir?
Tek bir oran oranı, bir kategorinin olasılığının artıp artmadığını söylemez; olasılık tüm denklemlere bağlıdır. Ortalama kişi (\mathbf u=\mathbf 0) için \pi_j=e^{\eta_j}/(1+\sum_k e^{\eta_k}) hesaplanır ve iki koşul arasındaki fark alınır. Popülasyon ortalaması isteniyorsa bu ifade \mathbf u\sim N(\mathbf 0,\hat{\boldsymbol\Sigma}) üzerinden ortalanır; \mathbf u=\mathbf 0'daki değer popülasyon ortalaması değildir.
S7. Temel kategori değişirse sonuçlar nasıl değişir?
Sabit etkili modelde kestirilen olasılıklar ve sapma aynı kalır; katsayılar doğrusal dönüşür (\boldsymbol\beta_{j\mid k}=\boldsymbol\beta_{j\mid1}-\boldsymbol\beta_{k\mid1}). Kümeli modelde serbest yapı için aynı değişmezlik kuramsal olarak geçerlidir (\boldsymbol\Sigma de dönüşür); tek varyanslı ve köşegen yapılar zaten temel kategoriden bağımsız tanımlıdır. Uygulamada, iç eniyileyicinin durduğu nokta başlangıca bağlı olduğundan serbest yapıda temel kategori değişimi sayısal fark doğurabilir; bu, 25.8'deki denetimin bir başka gerekçesidir.
S8. Hangi veride model kurulamaz ya da güvenilmez?
Bir kategori bir açıklayıcının bir düzeyinde hiç gözlenmiyorsa ilgili katsayı sonsuza gider; şablon sonlu olmayan kestirimde durur (satır 158), çok büyük SH'de uyarır (159). Üçten az küme (130), on satırdan az veri (111) ve iki kategorili yanıt (114) durdurulur. Küme sayısı rastgele etki sayısına göre azsa (m küçük, J büyük) serbest yapının (J-1)J/2 parametresi kestirilemez; tek ortak varyans ya da köşegen yapı seçilir.
25.10 Kaynaklar
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Breslow, N. E., & Clayton, D. G. (1993). Approximate inference in generalized linear mixed models. Journal of the American Statistical Association, 88(421), 9–25. https://doi.org/10.1080/01621459.1993.10594284
- De Boeck, P., & Wilson, M. (Ed.). (2004). Explanatory item response models: A generalized linear and nonlinear approach. Springer. https://doi.org/10.1007/978-1-4757-3990-9
- Elff, M. (2025). mclogit: Multinomial logit models for categorical responses and discrete choices (R package version 0.9.15). https://doi.org/10.32614/CRAN.package.mclogit
- Goldstein, H., & Rasbash, J. (1996). Improved approximations for multilevel models with binary responses. Journal of the Royal Statistical Society: Series A (Statistics in Society), 159(3), 505–513. https://doi.org/10.2307/2983328
- Hartzel, J., Agresti, A., & Caffo, B. (2001). Multinomial logit random effects models. Statistical Modelling, 1(2), 81–102. https://doi.org/10.1177/1471082X0100100201
- Hedeker, D. (2003). A mixed-effects multinomial logistic regression model. Statistics in Medicine, 22(9), 1433–1446. https://doi.org/10.1002/sim.1522
- Rodríguez, G., & Goldman, N. (1995). An assessment of estimation procedures for multilevel models with binary responses. Journal of the Royal Statistical Society: Series A (Statistics in Society), 158(1), 73–89. https://doi.org/10.2307/2983404
- Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4. baskı). Springer. https://doi.org/10.1007/978-0-387-21706-2