218. Çok düzeyli çoklu atama ve havuzlanmış karma model
Şablon kimliği: cok_duzeyli_atama · Kategori: eksik veri · Dil: R · Dosya: pro/sablonlar/eksik_veri/cok_duzeyli_atama.R (satır 1–186; üstbilgi 1–90) · Örnek veri: _ornek/studentratings.csv · Paketler: mitml 0.4-5, lme4 2.0-6, pan 2.0, jomo 2.7-6
218.1 Ne işe yarar
Şablon, kümelenmiş (öğrenci içinde okul, hasta içinde klinik gibi) veride eksik değerleri, kümelenmeyi koruyarak m kez atar; her atanmış veri setinde y_{ij}=\beta_0+\beta_1x_{ij}+u_j+e_{ij} karma modelini kurar ve sonuçları Rubin kurallarıyla birleştirir. Cevapladığı soru: "Eksik yordayıcılı kümelenmiş veride sabit etkilerin ve küme varyansının güvenilir kestirimi nedir?"
- i: kümedeki gözlem, j: küme (ör. okul); y: bağımlı değişken, x: yordayıcı (birden çok olabilir).
- u_j: kümeye özgü rastgele kesişim; \tau^2: küme varyansı; \sigma^2: artık varyans.
- ICC: küme içi korelasyon, değişkenliğin kümeler arasındaki payı.
Ne zaman kullanılır? Eksik değerli değişkenlerin kümelenmiş (hiyerarşik) olduğu ve analiz modelinin küme rastgele etkisi içerdiği durumda. Atama modeli ortak (joint) modeldir: analiz değişkenleri ve yardımcı değişkenler birlikte, küme düzeyinde rastgele kesişimli çok değişkenli doğrusal karma modelle atanır (Schafer ve Yucel, 2002; Grund, Lüdtke ve Robitzsch, 2016).
Ne zaman kullanılmaz?
- Veri kümelenmemişse (küme yok ya da küme başına tek gözlem): temel programdaki Multiple Imputation analizi (zincirleme denklemler).
- Eksik değer yalnız kategorik değişkendeyse: şablon yalnız sayısal değişkenleri atar (sayısal rol; 218.2); kategorik yordayıcı kullanılamaz.
- Eksiklik rastgele değilse (MNAR) ve tedaviyi bırakma sonrası varsayım isteniyorsa:
mnar_referans_atama(Bölüm 219). - Rastgele eğimler ya da küme içi etkileşimler analiz modelindeyse: şablon yalnız rastgele kesişimli modeli kurar; atama modeli de yalnız rastgele kesişim içerir. Bu, analiz modelinden daha basit bir atama modelidir ve eğim varyansını eksik değerlere yansıtmaz (218.8).
Temel programla ilişki. Temel programdaki Multiple Imputation (gui/panels/analyses/multiple_imputation.py) tek düzeylidir: zincirleme denklemlerle (varsayılan tahmine dayalı ortalama eşleme; seçenek olarak FCS-normal ya da Bayes ridge) m veri seti atar (varsayılan m=5, tohum 42), havuzlanmış analiz sabit etkili OLS, lojistik ya da Poisson modelidir. Küme kimliği atama modelinde yer almaz; küme yapısı korunmaz. Temel programda ayrıca Little MCAR testi, eksik veri desenleri ve \delta kaydırmalı MNAR duyarlılık (tipping-point) tablosu vardır. Bu şablonun getirdiği: küme düzeyinde rastgele kesişimli ortak atama modeli, havuzlanmış karma model (kesişim varyansı ve ICC dahil), Barnard–Rubin küçük örneklem serbestlik derecesi ve iki Gibbs örnekleyici (pan, jomo). Karma modeller için temel programda LMM, Nested LMM ve Crossed LMM vardır; onlar eksik değeri atamaz.
218.2 Şablonun girdileri
Form, üstbilgideki on bir [[param]] bloğundan kurulur (cok_duzeyli_atama.R:11–89).
| Alan (form etiketi) · ad | Tür · sekme | Varsayılan | Geçerli değerler | Kodda etkisi |
|---|---|---|---|---|
Analiz modelinin bağımlı değişkeni · y |
sayısal sütun · Değişkenler | ilk sayısal sütun | sayısal | Atama ve analiz modelinde bağımlı değişken (95–101, 140). |
Analiz modelinin yordayıcıları · x |
sütunlar (sayısal, en az 1) · Değişkenler | boş | sayısal sütunlar | Sabit etki terimleri (95, 140). y ve kume listeden çıkarılır. |
Küme (düzey 2) kimliği · kume |
kategorik sütun · Değişkenler | boş | herhangi | Rastgele kesişim (99, 109, 119). |
Yardımcı değişkenler · yardimci |
sütunlar (sayısal, isteğe bağlı) · Değişkenler | boş | sayısal | Yalnız atama modelinin sol tarafında (97–98, 119). |
Atama algoritması · motor |
seçim · Model | pan |
pan, jomo |
panImpute ya da jomoImpute (128). |
Atanmış veri seti sayısı · m |
tamsayı · Seçenekler | 100 | 2–1000 | m (126). |
Isınma yinelemesi · n_burn |
tamsayı · Gelişmiş | 5000 | 100–200000 | n.burn (126). |
Atamalar arası yineleme · n_iter |
tamsayı · Gelişmiş | 100 | 1–10000 | n.iter (126). |
Rastgele sayı tohumu (0 = çalıştırmanın tohumu) · tohum |
tamsayı · Gelişmiş | 1 | 0–2147483647 | seed (127); 0 ya da boşsa Kod panelindeki çalıştırma tohumu (121–123). |
Analiz modelinde REML · reml |
onay · Model | açık | açık / kapalı | lmer(REML = ) (142). |
Tam veri serbestlik derecesi · df_tam |
ondalık · Seçenekler | 0 | 0–1000000 | testEstimates(df.com = ); 0 sonsuz demektir (145). |
Örnek ayar (ornek_param, satır 9): y = ReadAchiev, x = [ReadDis], kume = ID, yardimci = [SchClimate], motor = pan, m = 100, n_burn = 5000, n_iter = 100. tohum, reml, df_tam varsayılanda kalır.
Şablonun kendi denetimleri (mq_hata):
| Koşul | İleti (özet) | Satır |
|---|---|---|
| Veri açık değil | "Önce Veri sekmesinde bir veri açın." | 94 |
| Bağımlı değişken ve kümeden farklı yordayıcı kalmadı | "…en az bir yordayıcı seçin." | 95–96 |
| Hedef değişken sayısal değil | "'…' sayısal olmalı." | 101 |
| Kullanılabilir satır <30 | "En az 30 satır gerekli." | 111 |
| Küme sayısı <5 | "En az 5 küme gerekli." | 112 |
| Bir değişkende gözlenen değer <10 | "'…' için en az 10 gözlenen değer gerekli." | 115 |
| Bir değişken sabit | "'…' sabit; çıkarın." | 116 |
| Atama başarısız | "Atama başarısız: …" | 130 |
| Analiz modeli kurulamadı | "Analiz modeli kurulamadı: …" | 143 |
| Havuzlama başarısız | "Havuzlama başarısız: …" | 146 |
Eksik değerler ve sütun türü. Küme kimliği eksik olan satırlar atılır (99); atılan satır sayısı konsola yazılır ("Atılan satır: N (küme kimliği eksik: a; bütün değişkenleri eksik: b)."). Hedef değişkenlerin (bağımlı, yordayıcı, yardımcı) hepsi eksik olan satırlar da atılır (103). Bu iki süzgeçten sonra kalan satır sayısı çıktının ilk satırında yazılır (154–156). Sayısal rollere atanan sütunlar, Veri sekmesindeki türleri "kategorik" olsa bile sayı olarak aktarılır (Bölüm 1.3); bu şablonda bir sütunun düzey sıra numarasına dönüşmesi bu yüzden olmaz. Küme kimliği metne çevrilip tamsayıya kodlanır (109); düzeyler sıralı metin sırasıyla sayılandığından "10" "2"den önce gelir, ancak kimlik yalnız etiket olduğu için sonuç değişmez. Tohum. Şablonun formunda kendi Tohum alanı vardır (tohum, varsayılan 1); atama bu değerle yapılır (127). Alan 0 ya da boşsa Kod panelindeki çalıştırma tohumu (Bölüm 1.3) kullanılır. panImpute/jomoImpute kendi seed değeriyle yeniden tohumlandığından panel tohumu ancak bu yolla etkili olur. Kullanılan tohum çıktıda "Tohum: N" olarak yazılır.
218.3 Örnek veri
studentratings.csv, mitml paketinin studentratings veri setidir (Grund ve ark., 2016; Robitzsch ve Grund): Almanya'da 50 okuldan 750 öğrenci, okul başına 15 öğrenci. Okul kimliği ID (2001 …); eksik değerler gerçek ankette olduğu gibidir.
| Değişken | Rol | Tür (veri sekmesinin algıladığı) | Özet |
|---|---|---|---|
ID |
küme | sayısal (ID olarak kullanılır) | 50 okul, her birinde 15 öğrenci |
ReadAchiev |
bağımlı | sayısal | okuma başarısı; eksik değer yok (0,0 %) |
ReadDis |
yordayıcı | sayısal | okuma sırasında disiplin sorunları; %20,4 eksik |
SchClimate |
yardımcı | sayısal | okul iklimi; %18,7 eksik |
FedState, Sex, MathAchiev, MathDis, SES, CognAbility |
kullanılmaz | ikili / sayısal | örnek ayarda seçilmemiştir |
Bölümde kullanılan çalıştırmalar (dogrulama/cikti/): cda_ornek (örnek ayar); cda_jomo (motor = jomo); cda_t2 (tohum = 2); cda_kisa (n_burn = 200, n_iter = 10, m = 5); cda_dftam (df_tam = 748). Hepsi sablon_calistir.py ile örnek veride çalıştırılmıştır.
218.4 Yöntem: formüller ve hesap adımları
Hesap şu sırayla yapılır: (1) hedef değişkenler (y, x, yardımcılar) tek bir çok değişkenli karma modelle birlikte modellenir; (2) Gibbs örnekleyici ısınma yinelemelerinden sonra her n_iter yinelemede bir atanmış veri seti verir; (3) her veri setinde analiz modeli uydurulur; (4) sabit etkiler Rubin kurallarıyla, varyans bileşenleri ve ICC ortalamayla birleştirilir.
218.4.1 Atama modeli
Hedef değişken vektörü \mathbf y_{ij}=(y,x,a_1,\dots)' için ortak model, sol tarafta bütün hedefler, sağ tarafta yalnız kesişim ve küme rastgele kesişimi ile kurulur (119):
- \boldsymbol\mu: hedef değişkenlerin genel ortalama vektörü.
- \mathbf u_j: küme j için rastgele kesişim vektörü; \boldsymbol\Psi: küme düzeyi kovaryans matrisi (düzey 2).
- \mathbf e_{ij}: gözlem düzeyi sapma; \boldsymbol\Sigma: düzey 1 kovaryans matrisi.
Neden "boş" model
Sağ tarafta yalnız kesişim bulunduğundan atama modeli düzey 1'de ve düzey 2'deki bütün ilişkilere (değişkenler arası kovaryansların her iki düzeyde farklı olmasına) izin verir (Grund ve ark., 2016). Analiz modelinde yer alan bir ilişkinin atama modelinde de bulunması gerekir; aksi hâlde havuzlanmış katsayı o ilişkiye doğru yanlıdır. Ortak modelde analiz değişkenlerinin hepsi sol tarafta olduğundan bu koşul kendiliğinden sağlanır; yardımcı değişkenler de aynı yoldan eklenir.
Koddaki tercih
panImpute (Schafer ve Yucel, 2002) ve jomoImpute (Quartagno ve Carpenter), ikisi de bu ortak modeli Gibbs örneklemesiyle kestirir ve atanmış değerleri koşullu dağılımdan çeker. Şablon formula = v1 + v2 + v3 ~ 1 + (1 | kume_), n.burn, n.iter, m ve seed verir (119–128). Değişkenler iç adlarla (v1, v2, …) anılır; formül ve paket çıktıları güvenli kalır (107–108). silent = TRUE ile paketin ilerleme çıktısı susturulur.
218.4.2 Analiz modeli ve Rubin kuralları
Her \ell=1,\dots,m atanmış veri setinde analiz modeli lme4::lmer(y ~ x1 + … + (1 | kume), REML = reml) ile uydurulur (140–142). \hat Q_\ell ve U_\ell sırasıyla bir katsayı kestirimi ve onun kestirim varyansıdır. Birleştirilmiş kestirim, atama içi ve atamalar arası varyans:
- \bar Q: havuzlanmış katsayı; \bar U: atama içi varyans (ortalama standart hata karesi).
- B: atamalar arası varyans; T: toplam varyans; havuzlanmış standart hata \sqrt T.
- m: atanmış veri seti sayısı; 1+1/m çarpanı, sonlu m için düzeltmedir.
Göreli varyans artışı (RIV), serbestlik derecesi ve eksik bilgi kesri (FMI):
- r (RIV): eksik veri yüzünden varyansın tam veriye göre ne kadar arttığı.
- \nu_m: Rubin (1987) serbestlik derecesi; t=\bar Q/\sqrt T, t_{\nu} dağılımına göre sınanır.
- FMI: eksik veri yüzünden kaybedilen bilginin kesri; \nu aşağıda belirtilen serbestlik derecesidir.
Barnard–Rubin düzeltmesi (df_tam > 0): tam veride serbestlik derecesi \nu_{com} biliniyorsa
- \nu_{com}: tam veri serbestlik derecesi (örnek veride gözlem sayısı eksi sabit etki sayısı gibi bir değer girilir).
- \nu_{obs}: gözlenen veri serbestlik derecesi; \nu: düzeltilmiş serbestlik derecesi (Barnard ve Rubin, 1999).
Neden df_tam varsayılan olarak 0
\nu_{com}=\infty (0 girilir) Rubin'in özgün serbestlik derecesini verir. Büyük veri setlerinde (n binler) fark önemsizdir; küçük örneklemde \nu_m gözlenen veri serbestlik derecesini aşabilir ve p değeri aşırı iyimser olur. Karma modelde tam veri serbestlik derecesi tek bir sayı olarak tanımlı değildir; kullanıcı df_tam'ı kendi gerekçesiyle seçmelidir. Örnek veride (df_tam = 748 denendi; 750 satır eksi iki sabit etki) \nu 5535'ten 579'a düşer (218.7).
Koddaki tercih
testEstimates(fit, extra.pars = TRUE) (df_tam verilmişse df.com =) çağrılır (145). Havuzlanmış t ve \nu mitml tarafından bulunur; şablon p değerini 2 * pt(-|t|, sd) olarak yeniden hesaplar (kuyrukta kesme hatası yoktur; mitml'in 2 * (1 - pt(|t|)) biçimi çok küçük değerleri 0'a yuvarlardı), çok küçük p değerleri 0 yazılmaz (218.8).
Varyans bileşenleri ve ICC. extra.pars = TRUE ile \tau^2, \sigma^2 ve ICC her atanmış veri setinde kestirilir ve m kestirimin ortalaması alınır (170–176); Rubin varyansı ya da serbestlik derecesi bu büyüklükler için verilmez. ICC'nin ortalaması, \tau^2 ve \sigma^2 ortalamalarından hesaplanan oran değil, her veri setinin ICC değerinin ortalamasıdır.
218.5 Kod adım adım
| Satırlar | Ne yapar | Neden / dikkat |
|---|---|---|
| 91–92 | .m ile iki dilli ileti; mitml ve lme4 yüklenir. |
|
| 94–101 | Veri denetimi; xs = yordayıcılar eksi y ve kume; yard; hedef sayısal olmalı. |
y, x listesinde varsa sessizce çıkarılır. |
| 99, 103 | Küme eksik satırlar ve bütün hedefleri eksik satırlar atılır. | Sayıları konsola yazılır. |
| 107–117 | İç adlar v1…; küme tamsayıya kodlanır; 30 satır, 5 küme, 10 gözlenen değer, sabit değişken denetimi. |
Küme sayısı 5'ten az ise durur; küçük küme sayısında \tau^2 kestirimi kararsızdır. |
| 118 | Hiç eksik yoksa not. | Atama yine yapılır. |
| 119–139 | Formül; panImpute ya da jomoImpute; uyarılar toplanır; mitmlComplete(imp, "all"). |
summary(imp) ile en büyük Rhat okunur ve yazılır; 1,05 üstünde uyarı. Tohum alan 0 ise çalıştırma tohumuna döner. |
| 140–146 | Analiz formülü; her veri setinde lmer; testEstimates. |
lmer uyarıları ("singular", "converge") toplanıp sonda yazılır. |
| 147–153, 168 | Tablo 1: terim adları geri çevrilir; p yeniden hesaplanır; RIV ve FMI sütunları. | Terim adları iç adlardan özgün adlara döner. |
| 154–167 | Konsol özeti: atama satırı, tohum, en büyük Rhat; p<0{,}0001 notu. | Rhat 1,05'i aşarsa uyarı. |
| 170–176 | Tablo 2: \tau^2, \sigma^2, ICC. | Ortalama kestirimler. |
| 177–179 | Tablo 3: eksik yüzdesi; uyarılar. | Yüzde, atılan satırlardan sonraki veride hesaplanır. |
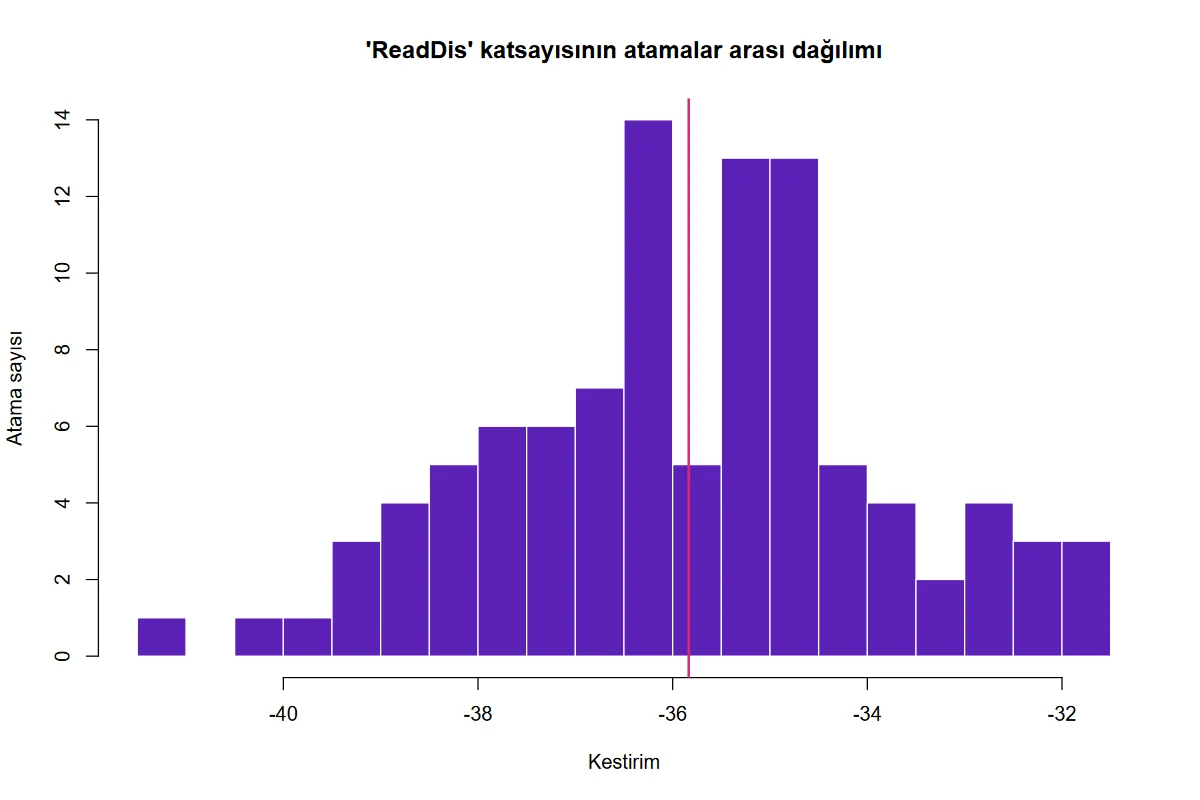
| 181–185 | Şekil: ilk yordayıcı katsayısının atamalar arası histogramı ve havuzlanmış kestirim çizgisi. | Yalnız ilk yordayıcı çizilir. |
218.6 Elle hesap: örnek veride bağımsız yeniden hesap
Bağımsız hesaplar iki yoldan yapılmıştır. dogrulama/cok_duzeyli_atama/r_dogrulama.R, şablonun R veri hazırlığını yineler, mitml::panImpute/jomoImpute'i doğrudan aynı tohumla çağırır, atanmış 100 veri setinde nlme::lme (REML) uydurur ve havuzlamayı açık formüllerle yazar (218.4.2); atanmış veri setlerini dışa aktarır. elle_hesap.py bu veri setlerini okur, karma modeli oran \rho=\tau^2/\sigma^2 üzerinden profil REML ile elle uydurur (V_j=I+\rho\mathbf 1\mathbf 1', V_j^{-1}=I-\frac{\rho}{1+n_j\rho}\mathbf 1\mathbf 1') ve Rubin ile Barnard–Rubin kurallarını kendi yazar; lme4, statsmodels ve mitml kullanılmaz. Atama adımı (Gibbs örnekleyici) iki yolda da paketin kendisidir: örnekleyicinin bağımsız yeniden yazımı bu doğrulamanın kapsamı dışındadır.
Adım 1 — Her veri setinde karma model. İlk atanmış veri setinde profil REML ile \hat\rho, sonra \hat\sigma^2=\mathrm{RSS}/(N-p) ve \hat\tau^2=\hat\rho\hat\sigma^2 bulunur; sabit etkiler genelleştirilmiş en küçük kareler ile.
Adım 2 — Rubin kuralları. m=100 için \bar Q, \bar U, B, T (218.4.2). Örnek ayarda eğim (\beta_1, ReadDis): \bar Q=-35{,}8353, \sqrt T=5{,}1768, r=0{,}1804, \nu_m=4238{,}5, FMI =0{,}1532; t=-6{,}9222.
Adım 3 — Varyans bileşenleri. \bar\tau^2=900{,}049, \bar\sigma^2=6996{,}203, ortalama ICC =0{,}113972.
Adım 4 — df_tam = 748. \nu_{obs} ve düzeltilmiş \nu: eğim için \nu=549{,}99, FMI =0{,}1559.
Adım 5 — jomo. Aynı adımlar jomo ile atanmış veri setlerinde de yinelenir: eğim -35{,}8044, \sqrt T=5{,}1037.
218.6.1 Doğrulama: MerQuR+, Python ve R
| Büyüklük | MerQuR+ | Python (bağımsız) | R (bağımsız) | En büyük fark | |
|---|---|---|---|---|---|
| pan: kesişim kestirim | 582,6355593 | 582,63555924 | 582,6355512 | 1,4e−8 | ✓ |
| pan: kesişim SH | 14,39423751 | 14,39423757 | 14,39423888 | 9,5e−8 | ✓ |
| pan: kesişim t | 40,47700052 | 40,47700035 | 40,47699611 | 1,1e−7 | ✓ |
| pan: kesişim sd | 5535,46440019 | 5535,46389523 | 5535,46917086 | 8,6e−7 | ✓ |
| pan: kesişim RIV | 0,15437931 | 0,15437932 | 0,15437924 | 7,7e−8 | ✓ |
| pan: kesişim FMI | 0,13404643 | 0,13404643 | 0,13404637 | 5,8e−8 | ✓ |
| pan: ReadDis eğimi kestirim | −35,83527908 | −35,83527906 | −35,83527595 | 8,7e−8 | ✓ |
| pan: ReadDis eğimi SH | 5,17684076 | 5,17684078 | 5,17684075 | 3,9e−9 | ✓ |
| pan: ReadDis eğimi t | −6,92222936 | −6,92222933 | −6,92222876 | 8,6e−8 | ✓ |
| pan: ReadDis eğimi sd | 4238,50080264 | 4238,50044352 | 4238,50269674 | 4,5e−7 | ✓ |
| pan: ReadDis eğimi RIV | 0,18040203 | 0,18040203 | 0,18040198 | 4,8e−8 | ✓ |
| pan: ReadDis eğimi FMI | 0,15323047 | 0,15323048 | 0,15323044 | 3,4e−8 | ✓ |
| pan: ReadDis p (mutlak fark; 2(1−pt) kesme hatası) | 5,113944·10−12 | 5,113946·10−12 | 5,113965·10−12 | 2,1e−17 | ✓ |
| pan: küme kesişim varyansı | 900,04946055 | 900,04946889 | 900,05152443 | 2,3e−6 | ✓ |
| pan: artık varyans | 6996,20319261 | 6996,20318951 | 6996,20246458 | 1,0e−7 | ✓ |
| pan: ICC | 0,11397181 | 0,11397181 | 0,11397206 | 2,4e−7 | ✓ |
| jomo: kesişim kestirim | 582,50096626 | 582,50096637 | 582,50095783 | 1,4e−8 | ✓ |
| jomo: kesişim SH | 14,21915234 | 14,21915232 | 14,21915392 | 1,1e−7 | ✓ |
| jomo: kesişim t | 40,96594173 | 40,96594181 | 40,96593658 | 1,3e−7 | ✓ |
| jomo: kesişim sd | 7616,96881504 | 7616,96872386 | 7616,97335344 | 6,0e−7 | ✓ |
| jomo: kesişim RIV | 0,12867541 | 0,12867541 | 0,12867537 | 4,3e−8 | ✓ |
| jomo: kesişim FMI | 0,11423823 | 0,11423823 | 0,1142382 | 3,4e−8 | ✓ |
| jomo: ReadDis eğimi kestirim | −35,80435676 | −35,8043568 | −35,8043535 | 9,1e−8 | ✓ |
| jomo: ReadDis eğimi SH | 5,10372359 | 5,1037236 | 5,10372366 | 1,3e−8 | ✓ |
| jomo: ReadDis eğimi t | −7,01534009 | −7,0153401 | −7,01533937 | 1,0e−7 | ✓ |
| jomo: ReadDis eğimi sd | 5912,60311711 | 5912,60298085 | 5912,60407376 | 1,6e−7 | ✓ |
| jomo: ReadDis eğimi RIV | 0,14863075 | 0,14863075 | 0,14863074 | 1,4e−8 | ✓ |
| jomo: ReadDis eğimi FMI | 0,12969254 | 0,12969254 | 0,12969253 | 1,1e−8 | ✓ |
| jomo: ReadDis p (mutlak fark; 2(1−pt) kesme hatası) | 2,550404·10−12 | 2,550301·10−12 | 2,550314·10−12 | 1,0e−16 | ✓ |
| jomo: küme kesişim varyansı | 900,30749472 | 900,30746119 | 900,30959563 | 2,3e−6 | ✓ |
| jomo: artık varyans | 6996,93028211 | 6996,93029371 | 6996,92953986 | 1,1e−7 | ✓ |
| jomo: ICC | 0,11399182 | 0,11399181 | 0,11399206 | 2,5e−7 | ✓ |
| pan, df_tam=748: kesişim sd | 578,68290887 | 578,6828997 | 578,68299548 | 1,5e−7 | ✓ |
| pan, df_tam=748: kesişim FMI | 0,13671209 | 0,1367121 | 0,13671203 | 5,8e−8 | ✓ |
| pan, df_tam=748: ReadDis eğimi sd | 549,98727734 | 549,98726763 | 549,98732852 | 9,3e−8 | ✓ |
| pan, df_tam=748: ReadDis eğimi FMI | 0,15589498 | 0,15589498 | 0,15589494 | 3,4e−8 | ✓ |
| pan, df_tam=748: ReadDis p (mutlak fark) | 1,243028·10−11 | 1,243028·10−11 | 1,243032·10−11 | 4,3e−17 | ✓ |
Ölçütü karşılayan: 37/37. Atama adımı (Gibbs örnekleyici) iki bağımsız yolda da paketin kendisidir; doğrulanan kısım karma model uydurma, Rubin ve Barnard–Rubin havuzlama ve varyans bileşenleridir. Python sütunu profil REML ile elle uydurulmuş, R sütunu nlme::lme ile uydurulmuştur; küme kesişim varyansında nlme ile fark (2,3·10⁻⁶) nlme eniyileyici toleransından gelir, ölçüt orada 5·10⁻⁶ alınmıştır.
Ek denetim: yakınsama. Şablon summary(imp)'i okur ve en büyük Rhat'ı yazar (örnek ayarda "en büyük Rhat = 1,002 (15 parametre)"); pan atamasında Rhat'ı en çok 1,002 (Beta), 1,001 (Psi), 1,001 (Sigma); jomo'da en çok 1,001. 5000 ısınma ve 100 atamalar arası yineleme bu veri için fazlasıyla yeterlidir (dogrulama/cok_duzeyli_atama/rhat_pan.txt, rhat_jomo.txt).
218.7 Çıktıyı okuma
Örnek veri, örnek ayar (cda_ornek); konsol:
Atama: pan; m = 100; ısınma = 5000; atamalar arası = 100; küme = 50; satır = 750
Tohum: 1
Gibbs yakınsaması: en büyük Rhat = 1,002 (15 parametre).
p değeri < 0,0001 olan terimler: (Kesişim), ReadDis (tabloda gerçek p değeri yazılıdır).
Tablo 1 — Havuzlanmış sabit etkiler (Rubin kuralları; Barnard–Rubin sd):
| terim | kestirim | SH | t | sd | p | RIV | FMI |
|---|---|---|---|---|---|---|---|
| (Kesişim) | 582,6356 | 14,3942 | 40,4770 | 5535,46 | 5,11·10⁻³¹⁴ | 0,1544 | 0,1340 |
| ReadDis | −35,8353 | 5,1768 | −6,9222 | 4238,50 | 5,11·10⁻¹² | 0,1804 | 0,1532 |
Tablo 2 — Varyans bileşenleri ve ICC: küme kesişim varyansı 900{,}049; artık varyans 6996{,}203; ICC 0{,}113972. Tablo 3 — Eksik yüzde: ReadAchiev 0,000; ReadDis 20,400; SchClimate 18,667.
Şekil 218.1. Atamalar arası değişkenlik: `ReadDis` katsayısının 100 atanmış veri setindeki dağılımı; çizgi havuzlanmış kestirimdir.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Kestirim, SH | Havuzlanmış sabit etki ve \sqrt T. | ReadDis bir birim arttıkça okuma başarısı ortalama 35,8 puan azalır (SH 5,2). |
| sd | Rubin (ya da Barnard–Rubin) serbestlik derecesi. | Büyük (binler) ise t normale yakındır; df_tam verilince küçülür (748 ile 550). |
| RIV, FMI | Eksik veri yüzünden varyans artışı ve kaybolan bilgi. | FMI 0,15: bilginin yaklaşık %15'i eksiklik yüzünden kayıp; m en az FMI·100 olmalıdır (bu veri için 100 fazlasıyla yeterli). |
| Küme kesişim varyansı, ICC | \tau^2, \sigma^2 ve ICC ortalamaları. | ICC 0,114: okullar arası fark, ReadDis sabitken artık değişkenliğin yaklaşık %11'idir. |
| Eksik yüzde | Atılan satırlardan sonraki eksiklik. | Yüksek yüzde FMI'yı ve gereken m'yi artırır. |
Çalıştırmalar arasında değişkenlik: tohum 1'de eğim -35{,}835 (SH 5,177), tohum 2'de -35{,}907 (SH 5,234): Monte Carlo farkı standart hatanın yaklaşık %1,4'üdür. Aynı tohumla yinelenen çalıştırma (cda_t1_yinele) tablo 1'in 8 hanesine kadar aynıdır. jomo ile eğim -35{,}804 (SH 5,104, FMI 0,130); m = 5, n_burn = 200, n_iter = 10 ile eğim -35{,}870 (SH 4,990), ama m küçük olduğundan sd 390 ve Monte Carlo hatası daha büyüktür.
Rapor cümlesi. Eksik değerler, okul düzeyinde rastgele kesişimli ortak model (pan; 100 atama, 5000 ısınma, atamalar arası 100 yineleme) ile atandı; sonuçlar Rubin kurallarıyla birleştirildi. Okuma sırasındaki disiplin sorunları arttıkça okuma başarısı azaldı (\hat\beta=-35{,}84; SH=5{,}18; t_{4238}=-6{,}92; p<0{,}001; FMI =0{,}15). Okul içi korelasyon 0{,}11'di.
218.8 Sık hatalar ve tuzaklar
- Atama modeli analiz modelinden basitse yanlılık. Şablon yalnız rastgele kesişimli atama modeli kurar. Analiz modeli rastgele eğim ya da küme düzeyi ortalama etkileşimi içeriyorsa atama modeli bunları yansıtmaz; atama modeli ile analiz modeli uyumlu olmalıdır. Bu şablon yalnız rastgele kesişimli analizler içindir.
- Yakınsama. Şablon Gibbs zincirinin en büyük Rhat değerini yazar ve 1,05'i aşarsa uyarı verir (sonda "Uyarılar" satırı). Küçük
n_burn, çok küçükn_iterya da çok kümeli/çok eksik değerli veride Rhat büyürsen_burn'ü artırın. mküçük bırakılırsa. FMI yüksekse ve m küçükse standart hata, p ve serbestlik derecesi kararsızdır (cda_kisa).df_tamverilmezse. Serbestlik derecesi binlere çıkar ve küçük kümeli veride p iyimser olur; karar öncesidf_tamdüşünülmelidir.- Çok küçük p. p değeri
2 × pt(−|t|, sd)ile hesaplanır; çok küçük değerler 0'a yuvarlanmaz (kesişim için 5{,}1\cdot10^{-314}). p<0{,}0001 olan terimler çıktıda ayrıca not edilir. - Kategorik yordayıcı kullanılamaz.
xveyardimciyalnız sayısal değişken alır. İkili değişken (Sex) 0/1 sayısal sütun olarak girilebilir; çok düzeyli kategorik değişken kullanılamaz. - Eksik küme kimliği. Satır atılır ve sayısı konsola yazılır.
- Tohum. Formdaki
tohumatamayı belirler ve çıktıda yazılır; alan 0 ya da boşsa Kod panelindeki çalıştırma tohumu kullanılır.
218.9 Uzman soruları
S1. Tek düzeyli FCS ataması neden yetmez?
Küme yapısını bilmeyen atama modeli, kümeler arasındaki farkı yok sayar; atanan değerler kümeye bağlı olmadığından küme içi korelasyon sıfıra doğru çekilir, kesişim varyansı ve düzey 2 etkileri alt yönde yanlı kalır. Küme göstergesi (kukla değişken) eklemek yaklaşık çözümdür, ama küme sayısı büyüdükçe kararsızlaşır. Ortak model kümeyi rastgele kesişimle modellediğinden ICC'yi korur (Grund ve ark., 2016).
S2. Neden analiz değişkenlerinin hepsi atama modelinin sol tarafında?
Ortak atama modeli değişkenler arasındaki bütün ikili ilişkileri (düzey 1 ve düzey 2) kestirir. Bir değişken sol tarafta yoksa onunla analiz değişkenleri arasındaki ilişki atamada sıfır sayılır ve analiz katsayısı sıfıra doğru yanlı olur. Bu nedenle y ve x zorunlu olarak atama modelinde bulunur (119).
S3. Rubin serbestlik derecesi ile Barnard–Rubin arasındaki fark?
Rubin (1987) \nu_m=(m-1)(1+1/r)^2 tam verideki serbestlik derecesini sonsuz sayar. Barnard ve Rubin (1999), \nu_{com} sonlu olduğunda \nu_{obs} ile birleştirir ve \nu'nun \nu_{com}'yi aşmamasını sağlar. Örnek veride (df_tam = 748) sd 4238'den 550'ye düşer; p 5,1·10⁻¹²'den 1,2·10⁻¹¹'e çıkar.
S4. FMI çıktıda iki farklı değer görünebilir mi?
Evet: FMI formülünde \nu yerine hangi serbestlik derecesinin kullanıldığına bağlıdır. df_tam = 0'da Rubin \nu_m; df_tam > 0'da düzeltilmiş \nu kullanılır; örnek eğimde FMI 0,1532'den 0,1559'a çıkar.
S5. Varyans bileşenleri için neden standart hata yok?
Şablon, \tau^2, \sigma^2 ve ICC'yi atanmış veri setlerinde kestirir ve ortalar; Rubin havuzlama kuralları sabit etkilere uygulanır. Varyans bileşenleri için normal yaklaşım kötü olduğundan (\ge0 sınırı) mitml bu büyüklüklere standart hata vermez. Atamalar arası dağılıma bakılabilir ama şablon bunu sunmaz.
S6. `pan` ile `jomo` ne zaman farklı sonuç verir?
İkisi de aynı ortak modeli kestirir; fark örnekleyicinin ayrıntısında (pan: Schafer–Yucel Gibbs; jomo: Quartagno–Carpenter, kategorik değişkenleri de kabul eder) ve rastgele sayı akışındadır. Örnek veride eğim -35{,}835 (pan) ve -35{,}804 (jomo); aradaki fark standart hatanın %0,6'sıdır. Bu şablonda yalnız sayısal değişken olduğundan ikisi birbirinin Monte Carlo karşılığıdır.
S7. `m` kaç olmalıdır?
FMI'ya göre: pratik kural olarak m\ge100\,\mathrm{FMI}. Örnek veride FMI 0,15, m=100 fazlasıyla yeterlidir; sonucu iki farklı tohumla yinelemek Monte Carlo hatasını doğrudan gösterir (tohum 1 ve 2: eğimler 0{,}07 fark).
218.10 Kaynaklar
- Barnard, J., & Rubin, D. B. (1999). Miscellanea: Small-sample degrees of freedom with multiple imputation. Biometrika, 86(4), 948–955. https://doi.org/10.1093/biomet/86.4.948
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Grund, S., Lüdtke, O., & Robitzsch, A. (2016). Multiple imputation of multilevel missing data: An introduction to the R package pan. SAGE Open, 6(4). https://doi.org/10.1177/2158244016668220
- Rubin, D. B. (1987). Multiple imputation for nonresponse in surveys. Wiley. https://doi.org/10.1002/9780470316696
- Schafer, J. L., & Yucel, R. M. (2002). Computational strategies for multivariate linear mixed-effects models with missing values. Journal of Computational and Graphical Statistics, 11(2), 437–457. https://doi.org/10.1198/106186002760180608
- Grund, S., Robitzsch, A., & Lüdtke, O. (2023). mitml: Tools for multiple imputation in multilevel modeling (R paket sürüm 0.4-5). https://CRAN.R-project.org/package=mitml
- Quartagno, M., & Carpenter, J. (2023). jomo: A package for multilevel joint modelling multiple imputation (R paket sürüm 2.7-6). https://CRAN.R-project.org/package=jomo