141. Anomali Tespiti
Analiz kimliği: anomaly_detection · Menü adı: Anomali Tespiti · Panel: gui/panels/analyses/anomaly_detection.py · Motor: stats/anomaly_detection.py, run_anomaly_detection (satır 744–782) ve yöntem işlevleri detect_iqr (72–128), detect_zscore (142–192), detect_modified_zscore (197–247), detect_isolation_forest (252–299), detect_lof (304–347), detect_mahalanobis + _mcd_estimate (428–496), detect_formal (558–607), detect_ts_stl (612–683); biçimsel testler stats/ts_diagnostics.py, grubbs_iterative (890–913), generalized_esd (916–947)
141.1 Ne işe yarar
Anomali tespiti, verideki olağandışı gözlemleri (aykırı değerleri) işaretler. Cevapladığı soru şudur: "Bu satırlardan hangileri ötekilerden belirgin biçimde ayrılıyor; hangi ölçüte göre?" Sonuç, her satır için bir bayraktır (1 = anomali) ve yönteme göre bir skor ya da sınır değeridir.
Tek bir model denklemi yoktur. MerQur on yöntemi tek panelde toplar; bunlar beş ailedir:
| Aile | Yöntemler | Neye bakar |
|---|---|---|
| Tek değişkenli eşik kuralları | IQR (Tukey çitleri), z puanı, düzeltilmiş z puanı (MAD) | Her sütunu ayrı ayrı; bir sütunda bile eşik aşılırsa satır anomali |
| Tek değişkenli biçimsel testler | Ardışık Grubbs, Rosner genelleştirilmiş ESD | Normal dağılım altında "en uç değer aykırı mı" hipotez testi |
| Çok değişkenli uzaklık | Mahalanobis D^2, MCD tabanlı sağlam D^2 | Satırın çok değişkenli merkezden, korelasyonu da hesaba katan uzaklığı |
| Makine öğrenmesi | Yalıtım ormanı (Isolation Forest), yerel aykırılık faktörü (LOF) | Yalıtılma kolaylığı ya da yerel yoğunluk |
| Zaman serisi | STL artığı + IQR | Trend ve mevsim çıkarıldıktan sonra beklenenden sapma |
Ne zaman kullanılır? Laboratuvar değerlerinde giriş hatası ya da olağandışı hasta aramak; sensör ve cihaz verisinde arıza bulmak; bir analizden önce veriyi temizlemek ya da aykırı gözlemlerin etkisini sınamak; zaman serisinde beklenmedik ayları bulmak.
Ne zaman kullanılmaz?
- Bir regresyon modelinin etkili gözlemleri aranıyorsa (Cook uzaklığı, kaldıraç): Doğrusal Regresyon tanılarını kullanın; anomali tespiti modeli bilmez.
- Amaç gözlemleri gruplara ayırmaksa: K-Ortalamalar ya da DBSCAN. DBSCAN'in "gürültü" noktaları da bir tür anomalidir, ama yoğunluk parametresi farklı anlamdadır.
- Tek bir değişkenin dağılımını betimlemek ve kutu grafiği çizmek yeterliyse: Tanımlayıcı İstatistikler.
- Aykırı değerlere dayanıklı bir kestirim isteniyorsa gözlem atmak yerine Sağlam Regresyon ya da sıra tabanlı testler daha uygundur.
Sık karıştırılan analizler. "Anomali" bir istatistiksel karar değildir: eşik kuralları (IQR, z, MAD) bir tanım uygular, Grubbs ve ESD bir test yapar, yalıtım ormanı ve LOF ise önceden verilen bir oran (kirlilik) kadar satırı işaretler. Aynı veride yöntemler farklı sayıda satır işaretler (141.6'da 7 ile 17 arası). Mahalanobis ile MCD arasındaki fark, aykırı değerlerin kendisinin ortalamayı ve kovaryansı bozup bozmadığıdır (maskeleme).
141.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Sayısal değişkenler | Seçilen her sütun sayıya çevrilebilmeli. | Sayıya çevrilemeyen hücre eksik sayılır (pd.to_numeric(errors="coerce")). |
| Normallik (z puanı, Grubbs, ESD, Mahalanobis) | Eşik ya da p değeri normal dağılıma göre kurulur. | Denetlenmez. Yöntem notları uyarır; çarpık değişkende düzeltilmiş z ya da IQR önerilir. |
| Çok değişkenli normallik (Mahalanobis, MCD) | D^2\sim\chi^2_p yaklaşımı. | Denetlenmez. |
| Gözlemlerin bağımsızlığı | Satırlar ayrı birimler. | Denetlenmez. Zaman sırası önemliyse STL yöntemi kullanılmalı. |
| Ölçek | ML yöntemleri uzaklık ya da bölme kullanır. | Yalıtım ormanı ve LOF'tan önce her sütun z'ye çevrilir (StandardScaler, payda n). |
| Beklenen anomali oranı (yalıtım ormanı, LOF) | Kirlilik oranı kadar satır işaretlenir. | Kullanıcı verir; oran sonuca doğrudan yansır. |
Eksik değer. Seçilen sütunlarda eksik olan satırlar liste bazında atılır; bütün yöntemler aynı dropna() ile başlar (ör. anomaly_detection.py:85, 147, 264, 507, 565). STL yönteminde sıra sütunu da bu kümeye girer (anomaly_detection.py:632).
Satır numarası. Sonuç tablosundaki "Satır no", satırın veri görünümündeki 1'den başlayan konumudur: Tıp #99'da satır no 9, patient_id = 9 olan hastadır. Bu bölümdeki satır numaraları da aynı biçimdedir.
Uç durumlar (kodun hata verdiği ya da davranış değiştirdiği koşullar):
- IQR, z ve düzeltilmiş z: n<4 ise hata (
anomaly_detection.py:86,148,207). - Yalıtım ormanı: n<10 ya da tek değişken ise hata (
256–258). LOF: n<\max(20,\ k+1) ya da tek değişken ise hata (307–311). - Mahalanobis ve MCD: n<p+5 ise hata (
499–500). MCD'de sabit sütun ya da tekil kovaryans açık bir iletiyle durdurulur (505–511). Klasik Mahalanobis'te kovaryansın tersi yerine sözde ters (pinv) kullanılır; tekil kovaryans hata vermez. - Grubbs ve ESD: n<7 ise hata (
556–557). ESD'de k, n-2 ile sınırlanır (ts_diagnostics.py:923). - z puanında standart sapması sıfır olan (sabit) sütunda z tanımsızdır; bu değişken değerlendirmeye girmez, özet tabloda yer almaz ve sonuç tablosundaki özgün değerleri korunur; durum not satırında yazılır. Düzeltilmiş z puanında \mathrm{MAD}=0 ise o sütunun tüm M değerleri 0 alınır (
anomaly_detection.py:216–217); sütunun yarısından çoğu aynı değerse bu durum oluşur ve o sütun hiçbir satırı işaretlemez. - STL: sıra sütunu seçilmemişse hata; periyot "oto" ise tarih sıklığından bulunur, sayısal sıra sütununda periyot elle verilmelidir; n<2m+1 ise hata (
606–644). - Anomali oranı %10'u aşarsa sonuç metnine uyarı eklenir (
anomaly_detection.py:890–892).
141.3 Parametreler
Varsayılanlar anomaly_detection.py panelindeki add_form_rows (satır 42–158) ve read_options (191–203) içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Yöntem | IQR (k×IQR, Q1/Q3 7. tür) | On yöntemden biri (141.1). | Her şeyi. |
| IQR çarpanı (k) | 1,5 | Tukey çitlerinin genişliği; STL yönteminde artığa uygulanan çit de bu değerdir. | k=3 "aşırı" aykırı değerleri bırakır (Tıp #99'da 17 → 10 satır). |
| Z eşiği | 3,0 | \lvert z\rvert sınırı. | Eşik düştükçe işaretlenen satır artar. |
| MAD eşiği | 3,5 | \lvert M\rvert sınırı (Iglewicz ve Hoaglin 1993). | Aynı. |
| Kirlilik oranı (ML) | 0,05 | Yalıtım ormanı ve LOF'ta işaretlenecek satır oranı. | İşaretlenen sayı yaklaşık n\times oran olur (200 satırda 10). |
| LOF komşu sayısı | 20 | LOF'un k en yakın komşusu. | Küçük k yerel, büyük k küresel yoğunluk karşılaştırır. |
| Mahalanobis/MCD eşiği (α) | 0,001 | p(\chi^2_p)<\alpha olan satır anomali. | α büyüdükçe kritik değer düşer. |
| Grubbs/ESD α ve k | α = 0,05; k = 10 | Testlerin anlamlılık düzeyi; ESD'nin aradığı en çok aykırı sayısı. | ESD k'dan fazla aykırı bulamaz (141.6, Adım 7). |
| Sıra/tarih sütunu ve periyot | — sıra sütunu —; m = oto | Yalnız STL yöntemi: sıralama ve mevsim periyodu. | Periyot STL ayrışmasını belirler. |
| Yalıtım ormanı: ağaç, tohum | 200 ağaç; tohum (seed) 42 | Ağaç sayısı ve rastgele sayı üretecinin başlangıç değeri. | Aynı tohum aynı sonucu verir; ağaç arttıkça skor kararlılaşır. |
| Ek çıktılar: Anomali gerekçesi (değişken katkısı) | kapalı | Her anomali satırına "neden" sütunu ekler. | Yalnız açıklama; bayrak değişmez. |
| Ek çıktılar: Bayrak/skoru veri setine kaydet | kapalı | anomaly_flag ve skor sütunlarını veri setine yazar. |
Veri setine yazar. |
| Özellik(ler) | — | Değerlendirilecek sayısal sütunlar (en az 1). | Tek değişkenli yöntemlerde her sütun ayrı değerlendirilir. |
Seçilen yöntemi kullanmayan bir seçenek varsayılandan farklı ayarlanmışsa sonuç değişmez; bu ayar "İstenen ve uygulanan ayarlar" bloğuna "bu yöntem kullanmaz" notuyla yazılır (anomaly_detection.py:789–824).
Neden kirlilik oranı bir "eşik" değil de bir "oran"?
Yalıtım ormanı ve LOF bir skor üretir, ama skorun evrensel bir eşiği yoktur: LOF \approx1 "komşularıyla aynı yoğunlukta", büyük değer "daha seyrek" demektir; kaç olduğunun anomali sayılacağı veriye bağlıdır. scikit-learn eşiği, skorların kirlilik yüzdeliği olarak koyar (offset_). Bu yüzden 200 satırda %5 her zaman 10 satır işaretler; veride hiç anomali olmasa bile. Kirlilik oranı bir bilgi değil bir varsayımdır.
141.4 Tıp örneği
Dosya: english/datasets/Tip/99_anomali_lab_results.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/99_anomali_lab_sonuclari.xlsx). Video senaryosundaki (VIDEO_SCRIPT_TR.txt, #99) değişken seçimi kullanılmıştır.
| Değişken | Rol | Tür | Açıklama (n = 200) |
|---|---|---|---|
WBC_K_uL |
Özellik | sürekli | Lökosit (10³/µL); ortalama 8,50, SS 6,73, medyan 7,15, en büyük 47,0 |
Hb_g_dL |
Özellik | sürekli | Hemoglobin (g/dL); ortalama 13,45, SS 1,96 |
creatinine |
Özellik | sürekli | Kreatinin (mg/dL); ortalama 0,90, SS 0,20 |
AST_U_L |
Özellik | tam sayı | AST (U/L); ortalama 27,3, SS 11,5 |
CRP_mg_L |
Özellik | sürekli | CRP (mg/L); ortalama 15,45, SS 52,05, medyan 4,39, en büyük 342,03 |
patient_id |
— | kimlik | Kullanılmaz. |
n ve eksik değer: 200 hasta, eksik yok. WBC ile CRP arasındaki korelasyon 0,930'dur: yüksek CRP'li hastaların lökositi de yüksektir (enfeksiyon/inflamasyon tablosu). Bu, tek değişkenli ve çok değişkenli yöntemlerin farkını görmek için iyi bir örnektir.
Klinik soru: Hangi hastaların laboratuvar profili olağandışıdır? Bunlar ölçüm/giriş hatası mı, yoksa gerçek klinik tablo mu?
Seçilen ayarlar: Arayüz varsayılanları ile on yöntemin her biri. STL yöntemi zaman sırası gerektirdiği için Tıp #94 aylık vaka serisinde (94_ts_monthly_case.xlsx, date sıra sütunu, m=12) çalıştırılmıştır.
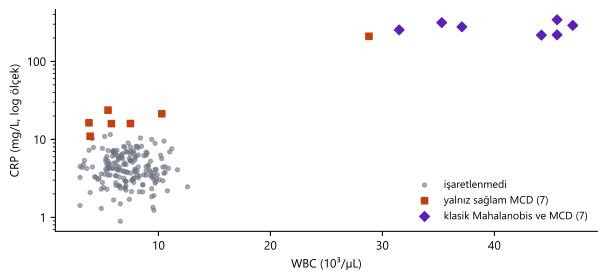
Şekil 141.1. Tıp #99'da WBC ve CRP (log ölçek). Mor: klasik Mahalanobis (p<0{,}001) ve MCD'nin birlikte işaretlediği 7 satır; turuncu: yalnız sağlam MCD'nin işaretlediği 7 satır. Klasik yöntem, uç değerlerin kendisi ortalamayı ve kovaryansı şişirdiği için CRP'si 15–25 mg/L olan beş satırı ve WBC–CRP doğrultusunda uzanan bir uç satırı kaçırır.
141.5 Formüller ve hesap adımları
MerQur'un izlediği sıra şudur: (1) seçilen sütunları sayıya çevir ve eksik satırları at, (2) seçilen yöntemin skorunu ya da sınırlarını hesapla, (3) her satıra bayrak ver, (4) istenirse gerekçe sütununu ve veri setine kayıt sütunlarını ekle (run_anomaly_detection, anomaly_detection.py:744–782). Tek değişkenli yöntemlerde bayrak satır bazındadır: herhangi bir sütunda sınır aşılırsa satır anomali sayılır (mantıksal "veya").
141.5.1 IQR (Tukey çitleri)
- x_{ij}: i. satırın j. değişkeni; p: seçilen değişken sayısı.
- Q_{1j}, Q_{3j}: j. değişkenin birinci ve üçüncü çeyreği; k: IQR çarpanı (varsayılan 1,5).
- \bigvee: "en az birinde doğru" (mantıksal veya).
Çeyrekler R quantile(type = 7) tanımıyla, yani sıralı değerler arasında doğrusal enterpolasyonla bulunur:
- x_{(r)}: küçükten büyüğe sıralı r. değer (1 tabanlı).
- q: 0,25 ya da 0,75.
Koddaki tercih
pandas quantile varsayılanı tür 7'dir (anomaly_detection.py:93–94). Bazı yazılımlar tür 6'yı, Tukey'in kutu grafiği ise menteşeleri (R fivenum) kullanır; sınırlar bu yüzden başka bir tanımla biraz farklı çıkabilir. Yöntemin adı bunu açıkça yazar: "IQR (1.5×IQR, Q1/Q3 7. tür)".
141.5.2 z puanı
- \bar x_j, s_j: j. sütunun ortalaması ve standart sapması (payda n-1).
- c: z eşiği (varsayılan 3).
Neden z puanı uç değerleri kaçırabilir?
\bar x ve s uç değerlerin kendisinden etkilenir. Bir uç değer s'yi büyüttükçe öteki uç değerlerin z'si küçülür (maskeleme). Ayrıca n gözlemde \lvert z\rvert'nin alabileceği en büyük değer (n-1)/\sqrt n'dir (Shiffler 1988): n=10'da 2,85. Yani 10 gözlemlik bir sütunda \lvert z\rvert>3 kuralı hiçbir satırı işaretleyemez. Tıp #99'da CRP'nin SS'si (52,05) birkaç çok uç değer yüzünden ortalamanın üç katıdır; CRP'si 23,7 mg/L olan hasta z=0{,}16 alır.
141.5.3 Düzeltilmiş z puanı (MAD)
- \tilde x_j: j. sütunun medyanı.
- \mathrm{MAD}_j: medyandan mutlak sapmaların medyanı (ölçeklenmemiş).
- 0{,}6745=\Phi^{-1}(0{,}75); c_M: MAD eşiği (varsayılan 3,5).
Neden 0,6745 ve neden 3,5?
Normal dağılımda \mathrm{MAD}=0{,}6745\,\sigma'dır. 0{,}6745/\mathrm{MAD} çarpanı bu yüzden 1/\sigma'nın sağlam bir kestirimidir ve M, normal veride z ile aynı ölçektedir. R mad() aynı şeyi 1{,}4826=1/0{,}6745 çarpanıyla yapar. 3,5 eşiğini Iglewicz ve Hoaglin (1993) benzetimle önermiştir. Medyan ve MAD verinin yarısına kadar kirlenmeye dayanıklıdır; maskeleme olmaz.
141.5.4 Mahalanobis uzaklığı
- \mathbf x_i: i. satırın p boyutlu vektörü.
- Klasik yöntemde \hat{\boldsymbol\mu}=\bar{\mathbf x} ve \hat{\boldsymbol\Sigma}=\mathbf S (örneklem kovaryansı, payda n-1).
- \chi^2_{p;\,1-\alpha}: p serbestlik dereceli ki-kare dağılımının 1-\alpha yüzdeliği; \alpha=0{,}001, p=5 için 20,515.
D^2, korelasyonu hesaba katar: WBC ve CRP birlikte yükseldiği için "WBC yüksek, CRP yüksek" beklenen bir yöndür; "WBC normal, CRP yüksek" ise aynı Öklid uzaklığında daha büyük D^2 alır. Çok değişkenli normal veride D^2\sim\chi^2_p'dir. Kod tersi pinv ile alır (anomaly_detection.py:524).
141.5.5 Sağlam Mahalanobis (MCD)
Klasik \bar{\mathbf x} ve \mathbf S uç değerlerle bozulur. En küçük kovaryans determinantı (minimum covariance determinant, MCD) kestiricisi, n satırdan kovaryans determinantı en küçük olan h satırlık alt kümeyi bulur ve konumu ile kovaryansı yalnız onlardan hesaplar (Rousseeuw ve Van Driessen 1999):
- \mathbf S_H: H alt kümesinin örneklem kovaryansı. Tıp #99'da h=\lfloor206/2\rfloor=103.
- h\approx n/2 seçimi en yüksek kırılma noktasını verir: verinin yaklaşık yarısı kirlense de kestirim sınırlı kalır.
Alt küme bulunduktan sonra kod dört düzeltme uygular (anomaly_detection.py:481–496):
- (h-1)/h: örneklem kovaryansını en çok olabilirlik (ML) paydasına çevirir.
- c_0, c_1: tutarlılık çarpanları. Merkezdeki h satır seçildiği için kesik dağılımın varyansı küçüktür; çarpan, normal veride \boldsymbol\Sigma'yı yansız kılar.
- f_0, f_1: sonlu örneklem çarpanları (Pison, Van Aelst ve Willems 2002); R
robustbase::covMcdvarsayılanıyla (use.correction = TRUE) aynı. - d^2_{0i}: ham MCD kestirimine göre uzaklık; w_i=1 olan satırlarla yeniden ağırlıklı konum \hat{\boldsymbol\mu} (ortalama) ve kovaryans \mathbf S_w hesaplanır.
Son olarak D^2_i, 141.5.4'teki formülle bu sağlam \hat{\boldsymbol\mu} ve \hat{\boldsymbol\Sigma}'yla hesaplanır ve aynı \chi^2_{p;\,1-\alpha} sınırıyla karşılaştırılır.
Koddaki tercih
En küçük determinantlı alt küme, olası alt kümelerin hepsi denenemeyeceği için arama ile bulunur. MerQur, scikit-learn MinCovDet (FAST-MCD) sonucuna ek olarak sabit tohumla (0) 500 rastgele (p+1) satırlık başlangıçtan C-adımları (her adımda en küçük d^2'li h satırı seç) yürütür ve en küçük \ln\det'li alt kümeyi alır (anomaly_detection.py:462–478). Sonuç tohuma bağlıdır ama tekrarlanabilir. R covMcd da rastgele alt kümelerle arar (varsayılan 500); Tıp #99'da R'ın farklı tohumlarla bulduğu alt kümeler \ln\det\mathbf S_H=2{,}6253–2{,}6293 verirken MerQur'un alt kümesi 2,6232 verir, yani daha küçük determinantlıdır. Alt küme farklı olunca işaretlenen satır sayısı sınırdaki satırlarda değişebilir (R'da tohuma göre 13 ya da 14).
141.5.6 Ardışık Grubbs testi
Her değişkende, en uç gözlemin aykırı olup olmadığı normal dağılım varsayımıyla sınanır; aykırıysa çıkarılır ve test kalan veride tekrarlanır (ts_diagnostics.py:890–913):
- \bar x, s: o adımda kalan n gözlemin ortalaması ve standart sapması.
- T_{n-2}: n-2 serbestlik dereceli t dağılımı.
- Durma: p\ge\alpha olduğunda ya da \lfloor n_0/2\rfloor adımda; p<\alpha olan her adımdaki gözlem aykırıdır.
Neden 2n\,P(T>t)?
G, n gözlemin en büyük standartlaştırılmış sapmasıdır. Tek bir gözlemin standartlaştırılmış sapması G_i ile t dağılımı arasındaki dönüşüm tamdır; en büyüğü için n gözleme ve iki yöne Bonferroni sınırı uygulanır (Grubbs 1969). Bu, outliers::grubbs.test(type = 10, two.sided = TRUE) tanımıdır. p 1'i aşınca MerQur 1'de keser; outliers paketi ise 2-p yazar (Tıp #99'da Hb için 1,000 ile 0,972). Karar değişmez.
141.5.7 Rosner genelleştirilmiş ESD
Grubbs testinin ardışık uygulaması maskelenmeye açıktır: iki benzer uç değer varsa birincisi ikincisini "normal" gösterebilir ve test ilk adımda durur. Rosner (1983) önce k adımın hepsini yapar, sonra karar verir (ts_diagnostics.py:916–947):
- \bar x^{(i)}, s^{(i)}: önceki i-1 en uç gözlem çıkarıldıktan sonraki ortalama ve standart sapma; i=1,…,k.
- t_{\pi,\,\nu}: \nu serbestlik dereceli t dağılımının \pi yüzdeliği.
- Aykırı sayısı: R_i>\lambda_i olan en büyük i. Bu i'ye kadar çıkarılan tüm gözlemler aykırıdır (arada R_j\le\lambda_j olan adım olsa bile).
Bu tanım EnvStats rosnerTest ile aynıdır. ESD en çok k aykırı bulabilir; k küçük seçilirse gerçek sayının altında kalır.
141.5.8 Yerel aykırılık faktörü (LOF)
Veri önce sütun başına z'ye çevrilir (payda n). Sonra her nokta için k en yakın komşu (Öklid) bulunur (Breunig ve ark. 2000):
- N_k(A): A'nın k en yakın komşusu (A kendisi hariç); d_k(B): B'nin k. komşusuna uzaklığı.
- \mathrm{lrd}: yerel erişilebilirlik yoğunluğu; ortalama erişim uzaklığının tersidir.
- \mathrm{LOF}\approx1: nokta komşularıyla aynı yoğunlukta; \mathrm{LOF}\gg1: komşularından seyrek bölgede.
Kirlilik oranı c ise en büyük \mathrm{LOF}'a sahip yaklaşık c\cdot n nokta işaretlenir (scikit-learn eşiği: -\mathrm{LOF}'un 100c. yüzdeliği). Kod k'yı n-1 ile sınırlar (anomaly_detection.py:325).
141.5.9 Yalıtım ormanı
Her ağaç, verinin bir alt örneğini rastgele bir değişken ve o değişkenin en küçük ile en büyük değeri arasında rastgele bir bölme noktasıyla tekrar tekrar ikiye böler; her nokta tek kalana (yalıtılana) dek sürer (Liu, Ting ve Zhou 2008). Aykırı noktalar az bölmeyle yalıtılır:
- h(\mathbf x): bir ağaçta \mathbf x'in köke uzaklığı (yalıtılana dek bölme sayısı; yaprakta kalan nokta sayısına göre c(\cdot) eklenir); E[\cdot]: ağaçlar üzerinden ortalama.
- \psi: ağaç başına alt örnek büyüklüğü; scikit-learn varsayılanı \min(256,\ n). Tıp #99'da \psi=200, yani her ağaç tüm satırları (karışık sırayla) görür.
- c(\psi): \psi noktalık ikili arama ağacında başarısız aramanın ortalama yol uzunluğu; skoru n'den bağımsız kılan ölçek.
- s\to1: kolay yalıtılan (anomali); s\approx0{,}5 ya da altı: sıradan nokta. MerQur, scikit-learn'ün
score_samplesdeğerinin işaretini çevirip s'yi yazar (anomaly_detection.py:276).
İşaretleme LOF'taki gibi kirlilik oranına göredir: s'si en büyük c\cdot n satır. Ağaç sayısı ve tohum formdan gelir (varsayılan 200 ve 42).
Koddaki tercih
Veri yalıtım ormanından önce de z'ye çevrilir. Bölme noktası her düğümde o değişkenin en küçük ile en büyük değeri arasında düzgün seçildiği için yöntem her değişkenin doğrusal dönüşümünden etkilenmez; standartlaştırma yalıtım ormanının sonucunu değiştirmez, LOF'unkini değiştirir. R'da kurulu bir yalıtım ormanı paketi olmadığından (isotree, solitude) doğrulama scikit-learn'ün aynı tohumla doğrudan çağrısıyla yapılmıştır.
141.5.10 Zaman serisi: STL artığı + IQR
Seri sıra sütununa göre sıralanır ve m dönemli sağlam STL ile trend, mevsim ve artık bileşenlerine ayrılır (Cleveland ve ark. 1990):
- T_t, S_t, R_t: trend, mevsim ve artık (remainder).
- STL ayarları R
stl(x, s.window = 11, robust = TRUE)ile aynıdır: mevsim penceresi 11, mevsim derecesi 0, trend penceresi \mathrm{nextodd}\lceil1{,}5m/(1-1{,}5/11)\rceil (m=12'de 21), alçak geçiren pencere \mathrm{nextodd}(m), iç yineleme 1, dış (sağlamlık) yineleme 15. - k: IQR çarpanı (varsayılan 1,5); çeyrekler tür 7.
Bu, R forecast::tsoutliers yaklaşımının (artığa Tukey çitleri) karşılığıdır. Sağlam STL, aykırı gözleme küçük ağırlık verir; bu yüzden aykırı ay trend ve mevsimi çekmez ve artığı büyük kalır. Periyot "oto" ise tarih sıklığından bulunur (aylık 12, çeyreklik 4, dakikalık veride saatlik ya da günlük döngü; anomaly_detection.py:635–653).
141.5.11 Anomali gerekçesi
"Anomali gerekçesi" kutusu, her işaretli satıra hangi değişkenin sorumlu olduğunu yazar (add_reasons, anomaly_detection.py:686–739). Yazılan z her zaman klasik z=(x-\bar x)/s'dir:
- IQR ve STL: çit dışına çıkan değişken(ler).
- z ve düzeltilmiş z: eşiği aşan değişken(ler).
- Grubbs ve ESD: satırın aykırı bulunduğu değişken(ler).
- Mahalanobis, MCD, yalıtım ormanı, LOF: z^2 katkısı en büyük iki değişken ve yüzde payı z_j^2/\sum_l z_l^2.
141.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Aşağıdaki ara değerler dogrulama/anomaly_detection/elle_hesap.py ile, MerQur kodu çağrılmadan hesaplanmıştır (dökümü elle_adimlar.txt).
Adım 1 — IQR çitleri (CRP). n=200, h=(n-1)\cdot0{,}25=49{,}75: Q_1=x_{(50)}+0{,}75\,(x_{(51)}-x_{(50)})=3{,}19+0{,}75\cdot0{,}01=3{,}1975. h=149{,}25: Q_3=6{,}54+0{,}25\cdot0{,}08=6{,}56.
CRP'de 13 satır U'nun üstündedir. WBC'de Q_1=6{,}0, Q_3=8{,}9, U=13{,}25: 8 satır. Hb (alt çit 8,45; bir satır 8,0), kreatinin (2) ve AST (2) ile birleşim 17 satırdır. k=3'te 10 satır kalır (yalnız WBC ve CRP'nin çok uç değerleri).
Adım 2 — z puanı. CRP: \bar x=15{,}44915, s=52{,}04898. Satır 137 (CRP 342,03): z=(342{,}03-15{,}44915)/52{,}04898=6{,}2745. Aynı satırda WBC z=(45{,}6-8{,}5045)/6{,}73372=5{,}5089. Satır 9 (CRP 23,7): z=0{,}159; işaretlenmez. \lvert z\rvert>3 ile 10 satır: 8 WBC/CRP uç değeri, satır 42 (AST 65; z=3{,}268) ve satır 111 (kreatinin 1,57; z=3{,}430).
Adım 3 — Düzeltilmiş z. CRP: \tilde x=4{,}385, \mathrm{MAD}=1{,}505. Satır 9:
Satır 137'de M=151{,}32. Medyan ve MAD uç değerlerden etkilenmediği için CRP'de 13 satır işaretlenir; toplam 14 satır. Kreatinin satır 111 burada M=0{,}6745\,(1{,}57-0{,}91)/0{,}14=3{,}18 ile sınırın altında kalır: kreatininde uç değer az olduğu için sağlam ölçek \mathrm{MAD}/0{,}6745=0{,}208, SS'den (0,195) bile büyüktür.
Adım 4 — Mahalanobis. p=5, \chi^2_{5;\,0{,}999}=20{,}515. Satır 137: D^2=42{,}748, p=4{,}2\times10^{-8}; satır 9: D^2=7{,}464, işaretlenmez. Toplam 7 satır (38, 78, 123, 137, 155, 191, 194); hepsi WBC ve CRP'si birlikte çok yüksek olanlardır. Satır 38'de D^2=29{,}457, p=1{,}886\times10^{-5}.
Adım 5 — MCD. h=103. MerQur'un arama sonucu alt kümesinde \ln\det\mathbf S_H=2{,}623222. Tutarlılık çarpanı c_0=(103/200)/F_{\chi^2_7}(\chi^2_{5;\,0{,}515})=1{,}874791; sonlu örneklem çarpanı f_0=1{,}062373. Ham uzaklıkla d_0^2\le\chi^2_{5;\,0{,}975}=12{,}8325 olan 177 satır yeniden ağırlıklı kestirime girer; c_1=1{,}055533, f_1=1{,}004005. Sağlam konum: WBC 7,253; Hb 13,519; kreatinin 0,888; AST 27,124; CRP 4,505 (klasik ortalama 15,449). Sağlam D^2: satır 9'da 108,95; satır 137'de 33062; satır 172'de 20,788 (sınırın hemen üstü). Toplam 14 satır: klasik 7'ye ek olarak 7 satır (Şekil 141.1). Bunların beşinde CRP 15–25 mg/L'dir (satır 10, 30, 157, 165, 187); satır 149'da WBC 28,8 ve CRP 210 birlikte yüksektir ve klasik kovaryansın şişirdiği WBC–CRP doğrultusunda kaldığı için klasik D^2'de gizlenir; satır 172'de düşük WBC (3,9) ve kreatinin (0,50) ile yüksek Hb (16,7) bir araya gelir.
Adım 6 — Ardışık Grubbs (CRP). İlk adım: G=6{,}2745 (satır 137),
Satır çıkarılıp tekrar edilir: G sırasıyla 6,434; 6,660; 7,262; 7,763; 8,062; 9,838; 13,526 (sekiz çok uç CRP), sonra 6,012 (satır 9); 5,845 (satır 165); 4,504 (satır 187, p=0{,}0007); 4,636 (satır 30); 4,928 (satır 157, p=6{,}6\times10^{-5}) ve 14. adımda G=3{,}236, p=0{,}195 ile durur. CRP'de 13 aykırı; WBC'de 8 (hepsi CRP'dekilerin içinde); toplam 13 satır. Uç değerler çıktıkça s küçüldüğü için G önce artar: bu, maskelemenin sayısal görünüşüdür.
Adım 7 — Rosner ESD (CRP, k=10). i=1: \pi_1=1-0{,}05/400=0{,}999875, t_{\pi_1,\,198}=3{,}7300,
On adımın hepsinde R_i>\lambda_i (R_{10}=5{,}845>\lambda_{10}=3{,}592): aykırı sayısı 10, yani k'nın kendisi. Grubbs aynı sütunda 13 aykırı bulmuştur; ESD'nin 10'da durması verinin değil k'nın sınırıdır. Toplam 10 satır.
Adım 8 — LOF (k=20). Satır 111 (kreatinin 1,57): \mathrm{lrd}=0{,}43546, 20 komşusunun ortalama lrd'si 0,74138:
Bu, en büyük 10. LOF'tur (11. değer 1,6874); satır 111 sınırdan işaretlenir. Satır 137'de \mathrm{LOF}=0{,}62267/0{,}12756=4{,}8813 (en büyük). 10 satır.
Adım 9 — Yalıtım ormanı. \psi=200, c(200)=9{,}7510. Satır 137'de s=0{,}7216; bu, ağaçlarda ortalama E[h]=-\log_2(0{,}7216)\cdot9{,}7510=4{,}59 bölmeyle yalıtıldığını gösterir. Tüm skorların medyanı 0,420; eşik 10. (0,5941) ile 11. (0,5545) skor arasındadır. 10 satır; LOF'tan farkı satır 187 (kreatinin 1,32, AST 56, Hb 10,1: birkaç değişkende birlikte uç) ile satır 111'dir.
Adım 10 — STL + IQR (Tıp #94, m=12). 60 ay; trend penceresi 21. Sağlam artığın çeyrekleri Q_1=-13{,}840, Q_3=12{,}435; çitler [-53{,}251;\ 51{,}846]. Üç ay dışarıdadır: satır 19 (2021-07; R=-60{,}99), satır 21 (2021-09; R=55{,}83), satır 57 (2024-09; R=-95{,}25). Sağlamsız STL'de satır 57'nin artığı -68{,}55'tir: sağlam ağırlıklar aykırı ayın trendi aşağı çekmesini önlediği için artık büyür.
Özet: aynı 200 hastada IQR 17, düzeltilmiş z 14, MCD 14, Grubbs 13, z 10, ESD 10, LOF 10, yalıtım ormanı 10, Mahalanobis 7 satır işaretlemiştir. Yedi satır (38, 78, 123, 137, 155, 191, 194) bütün yöntemlerde işaretlidir.
141.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan alınmıştır (dogrulama/anomaly_detection/merqur_calistir.py); motor tablo ve özet değerlerini 4 ondalığa yuvarladığı için round, np.round ve Series.round yalnız bellekte etkisizleştirilmiştir. Python sütunu numpy ile elle yazılmış formüllerdir; yalıtım ormanında scikit-learn doğrudan (MerQur sarmalayıcısı olmadan) aynı tohumla çağrılmıştır. R 4.5.3: quantile(type = 7), scale, mahalanobis, robustbase::covMcd sabitleri (.MCDcons, .MCDcnp2, .MCDcnp2.rew), outliers::grubbs.test, ESD formülle (EnvStats kurulu değil), dbscan::lof(minPts = k + 1), stl.
MCD için alt küme araması rastgele olduğundan karşılaştırma, MerQur'un bulduğu h-alt kümeden başlayan yeniden ağırlıklı kestirim üzerinden yapılmıştır (merqur_mcd_crit.py alt kümeyi yalnız bellekte izleyerek çıkarır). STL'nin sağlam sürümünde statsmodels STL sağlamlık yinelemesinde R stl'den ayrıldığı için (sağlamsız ayrıştırmada üçü 10^{-12} düzeyinde aynıdır) Python sütunu boş bırakılmıştır.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| IQR WBC_K_uL: Q_1 (tür 7) | 6 | 6 | 6 | 0,0e+00 | ✓ |
| IQR WBC_K_uL: Q_3 | 8,900000 | 8,900000 | 8,900000 | 0,0e+00 | ✓ |
| IQR WBC_K_uL: üst çit (k=1{,}5) | 13,250000 | 13,250000 | 13,250000 | 0,0e+00 | ✓ |
| IQR CRP_mg_L: Q_1 (tür 7) | 3,197500 | 3,197500 | 3,197500 | 4,4e−16 | ✓ |
| IQR CRP_mg_L: Q_3 | 6,560000 | 6,560000 | 6,560000 | 8,9e−16 | ✓ |
| IQR CRP_mg_L: üst çit (k=1{,}5) | 11,603750 | 11,603750 | 11,603750 | 1,8e−15 | ✓ |
| IQR (k=1{,}5) işaretli satırlar | 17 satır | 17 satır | 17 satır | aynı | ✓ |
| IQR (k=3) işaretli satırlar | 10 satır | 10 satır | 10 satır | aynı | ✓ |
| z puanı: en büyük \lvert z\rvert, WBC_K_uL | 5,716821 | 5,716821 | 5,716821 | 1,8e−15 | ✓ |
| z puanı: en büyük \lvert z\rvert, CRP_mg_L | 6,274491 | 6,274491 | 6,274491 | 8,9e−16 | ✓ |
| z puanı (\lvert z\rvert>3) işaretli satırlar | 10 satır | 10 satır | 10 satır | aynı | ✓ |
| Düzeltilmiş z: MAD, WBC_K_uL | 1,450000 | 1,450000 | — | 0,0e+00 | ✓ |
| Düzeltilmiş z: en büyük \lvert M\rvert, WBC_K_uL | 18,537121 | 18,537121 | 18,537121 | 1,8e−14 | ✓ |
| Düzeltilmiş z: MAD, CRP_mg_L | 1,505000 | 1,505000 | — | 0,0e+00 | ✓ |
| Düzeltilmiş z: en büyük \lvert M\rvert, CRP_mg_L | 151,323291 | 151,323291 | 151,323291 | 4,5e−13 | ✓ |
| Düzeltilmiş z (\lvert M\rvert>3{,}5) işaretli satırlar | 14 satır | 14 satır | 14 satır | aynı | ✓ |
| Mahalanobis: \chi^2_{5;\,0{,}999} kritik değer | 20,515006 | 20,515006 | 20,515006 | 2,8e−14 | ✓ |
| Mahalanobis: en büyük D^2 | 48,172657 | 48,172657 | 48,172657 | 2,8e−13 | ✓ |
| Mahalanobis: D^2 (satır 136) | 42,748351 | 42,748351 | 42,748351 | 9,2e−14 | ✓ |
| Mahalanobis: p (satır 37) | 1,8864·10−5 | 1,8864·10−5 | 1,8864·10−5 | 2,4e−18 | ✓ |
| Mahalanobis (p<0{,}001) işaretli satırlar | 7 satır | 7 satır | 7 satır | aynı | ✓ |
| MCD: h-alt kümenin \ln\det S_h | 2,623222 | 2,623222 | 2,623222 | 4,0e−15 | ✓ |
| MCD: tutarlılık çarpanı (ham) | — | 1,874791 | 1,874791 | 4,0e−15 | ✓ (Python–R) |
| MCD: tutarlılık çarpanı (yeniden ağırlıklı) | — | 1,055533 | 1,055533 | 6,7e−16 | ✓ (Python–R) |
| MCD: sağlam D^2 (satır 8) | 108,953244 | 108,953244 | 108,953244 | 3,6e−13 | ✓ |
| MCD: sağlam D^2 (satır 171) | 20,787730 | 20,787730 | 20,787730 | 3,9e−14 | ✓ |
| MCD (p<0{,}001) işaretli satırlar | 14 satır | 14 satır | 14 satır | aynı | ✓ (aynı alt küme) |
| Grubbs: G_1, WBC_K_uL | 5,716821 | 5,716821 | 5,716821 | 1,8e−15 | ✓ |
| Grubbs: p_1, WBC_K_uL | 4,7747·10−7 | 4,7747·10−7 | 4,7747·10−7 | 6,6e−16 | ✓ |
| Grubbs: G_1, CRP_mg_L | 6,274491 | 6,274491 | 6,274491 | 8,9e−16 | ✓ |
| Grubbs: p_1, CRP_mg_L | 7,3328·10−9 | 7,3328·10−9 | 7,3328·10−9 | 7,0e−15 | ✓ |
| Grubbs: G_1, creatinine | 3,429847 | 3,429847 | 3,429847 | 3,6e−15 | ✓ |
| Grubbs: p_1, creatinine | 0,101003 | 0,101003 | 0,101003 | 1,7e−14 | ✓ |
| Grubbs (ardışık, \alpha=0{,}05) işaretli satırlar | 13 satır | 13 satır | 13 satır | aynı | ✓ |
| ESD: \lambda_1 (n=200) | 3,605525 | 3,605525 | 3,605525 | 8,9e−16 | ✓ |
| ESD: aykırı sayısı, CRP_mg_L | 10 | 10 | 10 | 0,0e+00 | ✓ |
| Rosner ESD (k=10) işaretli satırlar | 10 satır | 10 satır | 10 satır | aynı | ✓ |
| LOF (k=20): en büyük skor | 4,881308 | 4,881308 | 4,881308 | 3,4e−10 | ✓ |
| LOF: skor (satır 110) | 1,702535 | 1,702535 | 1,702535 | 5,5e−11 | ✓ |
| LOF (%5 kirlilik) işaretli satırlar | 10 satır | 10 satır | 10 satır | aynı | ✓ |
| Yalıtım ormanı: en büyük skor (tohum 42) | 0,721613 | 0,721613 | — | 0,0e+00 | ✓ (MerQur–Python) |
| Yalıtım ormanı işaretli satırlar | 10 satır | 10 satır | — | aynı | ✓ (MerQur–Python) |
| STL sağlamsız artık (Tıp #94, satır 18) | −57,975031 | −57,975031 | −57,975031 | 3,0e−13 | ✓ |
| STL sağlamsız artık (Tıp #94, satır 56) | −68,545905 | −68,545905 | −68,545905 | 1,7e−12 | ✓ |
| STL sağlam artık (satır 56) | −95,251051 | — | −95,251051 | 1,0e−12 | ✓ (MerQur–R) |
| STL sağlam: üst çit | 51,846193 | — | 51,846193 | 1,5e−12 | ✓ (MerQur–R) |
| STL + IQR işaretli satırlar | 3 satır | — | 3 satır | aynı | ✓ (MerQur–R) |
Sonuç: 47 karşılaştırmanın tamamı eşleşir. LOF'taki 3\times10^{-10} fark, scikit-learn'ün lrd paydasına eklediği 10^{-10}'dur.
141.7 Çıktıyı okuma
MerQur'un varsayılan (IQR) sonuç metni şöyledir (kısaltılmış):
Anomali Tespiti
  Yöntem            = IQR (1.5×IQR, Q1/Q3 7. tür)
  N (gözlem)        = 200
  Anomali sayısı     = 17
  Anomali oranı     = %8.50

── Değişken bazlı özet ──
    Değişken      Q1     Q3  Alt sınır  Üst sınır  Anomali sayısı
    WBC_K_uL  6.0000  8.900     1.6500    13.2500               8
     Hb_g_dL 12.2750 14.825     8.4500    18.6500               1
  creatinine  0.7600  1.020     0.3700     1.4100               2
     AST_U_L 19.0000 34.000    -3.5000    56.5000               2
    CRP_mg_L  3.1975  6.560    -1.8462    11.6038              13

── İlk 10 Anomali ──
   Satır no  WBC_K_uL  Hb_g_dL  creatinine  AST_U_L  CRP_mg_L  Anomali
          9       5.5     14.6        1.24       34     23.70        1
         30       7.5     14.0        1.42       32     15.95        1
         38      31.5     12.6        1.01       51    253.46        1
  ...
Mahalanobis yönteminde tablo D^2 ve p sütunlarını, ML yöntemlerinde skor sütununu taşır:
  Yöntem            = Mahalanobis D² (χ²(5) p < 0.001)
   ...  Satır no  Mahalanobis D²  p (χ²)  Anomali
   ...        38         29.4565 <0.0001        1
   ...       137         42.7484 <0.0001        1
| Satır/Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
Yöntem |
Yöntem ve kullanılan eşik | Raporda aynen belirtilmeli (eşik keyfîdir). |
N (gözlem) |
Eksiksiz satır sayısı | Liste bazında silmeden sonra. |
Anomali sayısı, Anomali oranı |
İşaretli satır sayısı ve yüzdesi | %10'u aşarsa uyarı; yöntem ya da eşik veriye uymuyor olabilir. |
Değişken bazlı özet |
IQR: çeyrekler ve çitler; z: ortalama, SS, en büyük \lvert z\rvert; MAD: medyan, MAD, en büyük \lvert M\rvert; Grubbs: ilk G ve p; ESD: R_1, \lambda_1 | Hangi değişkenin kaç satırı işaretlediği. Satır bazındaki toplam, sütun sayılarının toplamından azdır (bir satır birden çok sütunda uç olabilir). |
İlk 10 Anomali |
İşaretli ilk 10 satır, değerleri ve skorları | Tamamı Tablo sekmesinde. |
Satır no |
Veri görünümündeki satır konumu (1'den başlar) | Sıralama ya da filtre sonrası değişebilir; patient_id gibi bir kimlik sütunuyla eşleştirin. |
| Skor sütunları | z, M, D^2, p(\chi^2), yalıtım skoru s, LOF, STL artığı | Büyük değer = daha uç. |
Gerekçe (istenirse) |
Sorumlu değişken ve klasik z | Klinik inceleme için başlangıç noktası. |
| Not satırı | Yöntemin kısa açıklaması ve eşiği | Mahalanobis notu MCD ile karşılaştırmayı önerir. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Laboratuvar değerlerinde (WBC, Hb, kreatinin, AST, CRP; n=200) çok değişkenli aykırı gözlemler Mahalanobis uzaklığıyla incelendi; \chi^2(5) dağılımına göre p<0{,}001 (D^2>20{,}52) ölçütüyle 7 hasta (%3,5) aykırı bulundu. Maskelemeyi denetlemek için MCD tabanlı sağlam uzaklık (h=103) aynı ölçütle 14 hastayı (%7,0) işaretledi; ek 7 hastanın beşinde CRP 15–25 mg/L aralığındaydı. Tek değişkenli düzeltilmiş z puanı (\lvert M\rvert>3{,}5) 14 hastayı işaretledi.
141.8 Uzman soruları
S1. IQR çeyrekleri neden başka bir yazılımın kutu grafiğinden farklı olabilir?
MerQur tür 7 çeyreklerini (R quantile varsayılanı, doğrusal enterpolasyon) kullanır; bazı yazılımlar tür 6'yı, Tukey'in özgün kutu grafiği menteşeleri kullanır. n=200'de fark küçüktür ama sınırdaki bir değer bir tanımda işaretlenip ötekinde işaretlenmeyebilir. Yöntem adı türü açıkça yazar; raporda belirtin.
S2. On gözlemlik bir sütunda z puanı neden hiçbir zaman 3'ü aşmıyor?
Örneklem ortalaması ve standart sapmasıyla hesaplanan \lvert z\rvert, (n-1)/\sqrt n ile sınırlıdır (Shiffler 1988): n=10'da 2,85; n=11'de 3,02. Küçük örneklemde \lvert z\rvert>3 kuralı anlamsızdır. Düzeltilmiş z, Grubbs ya da IQR kullanılmalıdır; Grubbs'ın kritik değeri bu sınırı hesaba katar.
S3. Mahalanobis 7, MCD 14 satır buldu. Hangisine güvenmeli?
Klasik \bar{\mathbf x} ve \mathbf S, en uç 7–8 satırın kendisiyle hesaplanır: CRP'nin klasik ortalaması 15,4, sağlam konumu 4,5'tir; kovaryans da o yönde şişer. Bu yüzden orta düzeyde uç satırlar (CRP 15–25) ve WBC–CRP doğrultusunda uzanan uç bir satır (149) klasik D^2'de sınırın altına iner (maskeleme). Kirlenme şüphesi olan veride sağlam MCD tercih edilir. Öte yandan MCD, verinin yarısını "temiz" kabul ettiği için çarpık ama kirlenmemiş bir dağılımda gereğinden çok satır işaretleyebilir; Tıp #99'da CRP'nin sağ kuyruğu doğal olarak uzundur. Karar klinik incelemeyle verilmelidir.
S4. MCD sonucu R `covMcd` ile neden birebir aynı değil?
MCD, kombinatoryal bir en küçükleme problemidir ve iki program da onu rastgele alt kümelerden başlayan aramayla yaklaşık çözer. R varsayılanı 500 alt küme kullanır ve Tıp #99'da tohuma göre farklı alt kümeler bulur (\ln\det 2,6253–2,6293; işaretli satır 13 ya da 14). MerQur'un sabit tohumlu araması daha küçük determinantlı bir alt küme bulmuştur (2,6232). Aynı alt kümeden başlandığında yeniden ağırlıklı kestirim ve uzaklıklar R'ın robustbase sabitleriyle 10^{-13} düzeyinde aynıdır (141.6.1).
S5. Grubbs ile ESD arasındaki fark ne zaman önemlidir?
Ardışık Grubbs ilk "anlamsız" adımda durur; birbirine yakın iki uç değer varsa birincisi ikincisini gizleyebilir ve test hiç başlamadan durabilir. ESD k adımın hepsini yapar ve R_i>\lambda_i olan en büyük i'yi alır; bu, araya giren anlamsız adımları atlar. Buna karşılık ESD en çok k aykırı bulabilir: Tıp #99'da CRP'de 10 adımın hepsi anlamlıdır; gerçek sayı (Grubbs'a göre 13) daha büyüktür. k, beklenen en çok aykırı sayısından büyük seçilmelidir.
S6. Yalıtım ormanı ve LOF neden her zaman 10 satır işaretliyor?
İkisi de bir skor üretir ve eşik, skorların kirlilik yüzdeliği olarak konur: %5 ve 200 satır, 10 satır demektir. Veride hiç aykırı olmasa da 10 satır işaretlenir. Bu yöntemlerde asıl bilgi skorun sırasıdır; sınırdaki satırlar (burada LOF'ta satır 111: 10. skor 1,7025, 11. skor 1,6874) oranın küçük bir değişikliğiyle girip çıkar.
S7. Yalıtım ormanında standartlaştırma sonucu değiştirir mi?
Hayır. Her bölme bir değişkeni ve o düğümdeki en küçük ile en büyük değeri arasında düzgün bir noktayı seçer; değişkenin doğrusal dönüşümü bölmelerin hangi noktaları ayırdığını değiştirmez. LOF ise Öklid uzaklığı kullanır; standartlaştırma olmasaydı CRP (SS 52) uzaklığı tek başına belirlerdi. MerQur ikisinde de standartlaştırır (payda n); LOF'ta bu bir tercihtir, yalıtım ormanında etkisizdir.
S8. STL yönteminde neden sağlam ayrıştırma kullanılıyor?
Sağlamsız STL'de aykırı bir ay, yerel regresyonla trend ve mevsim bileşenlerini kendine doğru çeker; artığı küçülür ve tam da aranan gözlem gizlenir. Sağlam STL, büyük artıklı gözlemlere çift kare (bisquare) ağırlıkla düşük ağırlık verir. Tıp #94'te 2024-09'un artığı sağlamsız STL'de -68{,}5, sağlam STL'de -95{,}3'tür. Ayarlar R stl(s.window = 11, robust = TRUE) ile aynıdır; statsmodels STL(robust = True) sağlamlık yinelemesini farklı uyguladığı için farklı artık verir.
S9. Grubbs p'si R `outliers` paketinden neden farklı çıkabiliyor?
Bonferroni sınırı 2n\,P(T>t) 1'i aşabilir. MerQur bu durumda p=1 yazar; outliers::grubbs.test ise p>1 olduğunda 2-p yazar (Tıp #99 Hb: 1,000 ile 0,972). İki değer de \alpha'nın çok üstündedir ve karar değişmez; 1'de kesmek olasılık sınırıyla uyumludur.
141.9 Sık hatalar ve tuzaklar
- İşaretli satırları otomatik silmek. Anomali bir tanımdır, hata kanıtı değildir. Tıp #99'daki yüksek CRP + WBC satırları büyük olasılıkla gerçek enfeksiyon tablolarıdır. Silmeden önce kaynağı inceleyin; silmeniz gerekiyorsa sonucu silmeden de raporlayın.
- Çarpık değişkende z puanı kullanmak. CRP gibi sağa çarpık değişkende SS şişer, orta düzeyde uç değerler kaçar; düzeltilmiş z ya da IQR kullanın.
- Kirlilik oranını bir sonuç sanmak. Yalıtım ormanı ve LOF, oran kadar satırı her zaman işaretler.
- ESD'de k'yı küçük bırakmak. ESD k'dan fazla aykırı bulamaz; k'yı beklenen sayının üstünde seçin.
- Çok değişkenli yöntemde maskelemeyi unutmak. Klasik Mahalanobis'i MCD ile karşılaştırın.
- Satır numarasını kimlik sanmak. "Satır no" verinin o anki satır konumudur; kalıcı bir kimlik değildir, kimlik sütunuyla eşleştirin.
- Zaman serisinde düzeye göre aykırı aramak. Mevsimsel bir seride yüksek aylar IQR ile "aykırı" görünür; STL yöntemini sıra sütunuyla kullanın.
- Sonuçların tohuma bağlı olduğunu unutmak. Yalıtım ormanında tohum ve ağaç sayısını raporlayın; MCD'nin araması da sabit tohumludur.
- Eksik değerli satırların hiç değerlendirilmediğini gözden kaçırmak. Bir sütunda eksik olan satır, öteki sütunlarda ne kadar uç olursa olsun sonuca girmez.
141.10 Kaynaklar
- Breunig, M. M., Kriegel, H.-P., Ng, R. T., & Sander, J. (2000). LOF: Identifying density-based local outliers. In Proceedings of the 2000 ACM SIGMOD International Conference on Management of Data (pp. 93–104). https://doi.org/10.1145/342009.335388
- Cleveland, R. B., Cleveland, W. S., McRae, J. E., & Terpenning, I. (1990). STL: A seasonal-trend decomposition procedure based on loess. Journal of Official Statistics, 6(1), 3–73.
- Grubbs, F. E. (1969). Procedures for detecting outlying observations in samples. Technometrics, 11(1), 1–21. https://doi.org/10.1080/00401706.1969.10490657
- Iglewicz, B., & Hoaglin, D. C. (1993). How to detect and handle outliers (ASQC Basic References in Quality Control, Vol. 16). ASQC Quality Press.
- Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764–766. https://doi.org/10.1016/j.jesp.2013.03.013
- Liu, F. T., Ting, K. M., & Zhou, Z.-H. (2008). Isolation forest. In 2008 Eighth IEEE International Conference on Data Mining (pp. 413–422). https://doi.org/10.1109/ICDM.2008.17
- Pison, G., Van Aelst, S., & Willems, G. (2002). Small sample corrections for LTS and MCD. Metrika, 55(1–2), 111–123. https://doi.org/10.1007/s001840200191
- Rosner, B. (1983). Percentage points for a generalized ESD many-outlier procedure. Technometrics, 25(2), 165–172. https://doi.org/10.1080/00401706.1983.10487848
- Rousseeuw, P. J., & Van Driessen, K. (1999). A fast algorithm for the minimum covariance determinant estimator. Technometrics, 41(3), 212–223. https://doi.org/10.1080/00401706.1999.10485670
- Shiffler, R. E. (1988). Maximum Z scores and outliers. The American Statistician, 42(1), 79–80. https://doi.org/10.1080/00031305.1988.10475530
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.