115. Bayesçi Doğrusal Regresyon
Analiz kimliği: bayesian_linear · Menü adı: Bayesçi Doğrusal Regresyon · Panel: gui/panels/analyses/bayesian_linear.py (execute, satır 156–222; _apply_flat_intercept, 239–295) · Motor: stats/bayesian_nonlinear.py, run_bayesian_linear (116–277) · Ekler: stats/bayes_nonlinear_extras.py (posterior_params, 60–101; bayes_extras, 165–259), stats/bayes_extras.py (jzs_log_bf, 21–38)
115.1 Ne işe yarar
Bayesçi doğrusal regresyon, sürekli bir bağımlı değişkeni bir ya da daha çok yordayıcıyla açıklayan doğrusal modelin katsayılarını ve hata varyansını sonsal dağılımlarıyla verir. Cevapladığı soru şudur: "Veriyi ve önsel bilgiyi birlikte hesaba katınca her katsayı hangi değerlerde, hangi olasılıkla bulunur?"
- y: n gözlemlik bağımlı değişken; X: n\times k tasarım matrisi (ilk sütun 1, sonra yordayıcılar ve kukla değişkenler).
- \beta: k katsayı (sabit dahil); \sigma^2: hata varyansı.
MerQur sonsalı kapalı biçimde hesaplar; örnekleme (MCMC) yoktur. Üç önsel seçilebilir: konjugat Normal–ters gama (varsayılan), referans (Jeffreys) ve Zellner g-önseli. İsteğe bağlı olarak tüm yordayıcıları içeren modelin yalnız sabitli modele karşı JZS Bayes faktörü ve R^2, standartlaştırılmış katsayılar, \sigma^2 için en yüksek yoğunluk aralığı, önsel duyarlılığı ve sonsal tahmin kontrolü eklenir.
Ne zaman kullanılır? Katsayılar için olasılık dilinde aralık ve P(\beta>0) gibi doğrudan sonsal olasılıklar istendiğinde; önceki çalışmalardan gelen bilgi önsel olarak eklenmek istendiğinde; modelin sabit modele karşı kanıtı Bayes faktörüyle raporlanacaksa.
Ne zaman kullanılmaz?
- Bağımlı değişken ikili ya da sayımsa: Lojistik Regresyon (bölüm 46) ya da Sayım Regresyonu (bölüm 47); bu modül normal olabilirlik varsayar.
- Gözlemler kümeli ya da tekrarlıysa: Hiyerarşik Bayesçi Regresyon (bölüm 116).
- Yordayıcı alt kümeleri arasında model seçimi ya da model ortalaması isteniyorsa: bu modül yalnız tam modeli kestirir; tek terimli karşılaştırma için kategorik yordayıcılarda Bayesçi ANOVA (bölüm 114) model uzayını tarar.
- İlişki doğrusal değilse: Doğrusal Olmayan Regresyon.
Sık karıştırılan analizler. Varsayılan konjugat önselde \beta'nın önsel varyansı \sigma^2/\tau'dur, yani önsel hata varyansına göre ölçeklenir ve sabit terim de \mu_0'a doğru büzülür. Bu, R'daki rstanarm/brms varsayılan önsellerinden (katsayılardan bağımsız, sabit terim merkezlenmiş) farklıdır; sonuçlar ancak önsel çok zayıfken birbirine yaklaşır. Referans önsel EKK kestirimlerini ve klasik t aralıklarını sayısal olarak aynen verir.
115.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Doğrusallık | E(y\mid X)=X\beta. | Denetlenmez; sonsal tahmin kontrolü uyumsuzluğu dolaylı gösterebilir. |
| Normal ve eşit varyanslı hata | \varepsilon_i\sim N(0,\sigma^2), bağımsız. | Denetlenmez; "Sonsal tahmin kontrolü" en küçük/en büyük değer ve SS uyumunu gösterir. |
| Tam rank | X'in sütunları doğrusal bağımsız. | Pivotlu QR ile denetlenir (bayesian_linear.py:178–189). |
| Önsel | Seçilen önsel türü ve hiperparametreler. | "Önsel duyarlılığı" kutusu \tau ızgarası ve referans önselle karşılaştırır. |
Eksik değer. Bağımlı değişken ya da seçili yordayıcılardan biri eksik olan satır liste bazında çıkarılır (stats/bayesian_nonlinear.py:140).
Kategorik yordayıcılar. Metin (object) ya da kategori türündeki sütunlar ve Veri sekmesinde "kategorik" işaretlenmiş sayısal sütunlar kukla değişkenlere açılır. Referans, ortak düzey sırasının ilk düzeyidir (kullanıcı sırası → sayısal/doğal sıra → verideki ilk görülme sırası); kullanılan sıra çıktıda yazılır (bayesian_nonlinear.py). İşaretlenmemiş sayı kodlu sütunlar (1, 2, 3) sürekli sayılır.
Uç durumlar:
- Satır kalmazsa hata ("Veri yok",
bayesian_nonlinear.py:140–142). - Tam çoklu doğrusallık: referans ya da g-önselinde ve "sabit için düz önsel" seçiliyken hata; konjugat önselde önsel modeli belirli kıldığından sonuç verilir ama ayrıştırılamayan sütunlar bir uyarıyla bildirilir (
bayesian_linear.py:181–189). - Referans önselde n\le k ise hata (
bayes_nonlinear_extras.py:66–67). - \sigma^2'nin sonsal ortalaması a_n\le1'de, SS'si a_n\le2'de tanımsızdır; "inf" basılır ve uyarı eklenir (
bayesian_linear.py:212–215).
115.3 Parametreler
Varsayılanlar bayesian_linear.py:41–153 ve stats_panel.py:8516–8526 içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımlı değişken | ilk sayısal sütun | y. | |
| Önsel kesinlik | 0,0100 | \tau: \beta\mid\sigma^2\sim N(\mu_0\mathbf 1,\ \sigma^2/\tau\, I); 0,0001–100. Yalnız konjugatta etkin. | Büyük \tau katsayıları \mu_0'a büzer. |
| Bağımsız değişkenler | — | Yordayıcılar (en az bir). | |
| Güven düzeyi | %95 | İnanılırlık aralığı düzeyi (%90/%95/%99/özel). | Aralıklar, HDI, PPC kapsamı. |
| Bayes faktörü (JZS) + R² | kapalı | Tam modelin sabit modele karşı JZS BF'si ve R^2. | Ek bölüm. |
| JZS önsel ölçeği (r) | medium (√2/4) | Zellner–Siow önsel ölçeği: √2/4, 1/2, √2/2. | Yalnız BF. |
| Önsel türü | Konjugat (NIG) | Konjugat, referans (Jeffreys) ya da Zellner g-önseli. | Tüm sonsal. |
| Önsel hiperparametreleri | μ0 = 0, a0 = 1, b0 = 1, g = 0 | \mu_0: tüm katsayıların (sabit dahil) önsel ortalaması; a_0, b_0: \sigma^2\sim ters gama; g=0 → g=n. | Konjugatta \mu_0, a_0, b_0; g-önselinde g. |
| Ek çıktı | üçü de kapalı | Standart β + HDI; önsel duyarlılığı; sonsal tahmin kontrolü. | Ek bölümler ve grafik panelleri. |
| Sabit terim için düz önsel | kapalı | Konjugatta sabite p(\beta_0)\propto1. | Sabit büzülmez; \sigma^2 sd'si 1 azalır. |
| Grafik / 3B katsayılar | Varsayılan / otomatik | Forest grafiği ya da iki katsayının 3B ortak sonsalı. | Yalnız Grafik sekmesi. |
Neden önsel kesinlik varsayılanı 0,01, ve bu neden "bilgi vermeyen" değil?
\tau=0{,}01, katsayının önsel standart sapmasını 10\sigma yapar. Bu, eğimler için genellikle zayıftır, ama sabit terim için ölçeğe bağlıdır: \bar y, 10\sigma'ya göre büyükse sabit belirgin biçimde 0'a çekilir. Tıp örneğinde \sigma\approx5{,}2, önsel SS ≈ 52 ve sabit 29,151'den 29,061'e iner. Bağımlı değişken birimi değiştirilirse (örneğin mmol/L yerine mg/dL) \sigma ve sabit aynı oranda ölçeklendiği için bu oran korunur, ama y'ye sabit bir sayı eklenmesi (konum değişimi) sonucu değiştirir. Konumdan bağımsızlık için "Sabit terim için düz önsel" kullanılır.
115.4 Tıp örneği
Dosya: english/datasets/Tip/47_bayesian_dose_response.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/47_bayesian_doz_yanit.xlsx).
| Değişken | Rol | Tür | Açıklama/özet |
|---|---|---|---|
response_score |
Bağımlı değişken | sürekli | Tedavi yanıt skoru; ortalama 28,976, SS 5,972 |
dose_mg |
Yordayıcı | sürekli | Doz (mg); ortalama 93,454, SS 56,858, aralık 0,7–198,6 |
age |
Yordayıcı | tamsayı | Yaş (yıl); ortalama 57,66, SS 11,568, aralık 40–79 |
patient_id |
kullanılmaz |
n ve eksik değer: 100 hasta, eksik değer yok. İki yordayıcının korelasyonu −0,106.
Klinik soru: Yanıt skoru dozla artıyor mu, yaşla değişiyor mu ve bu etkilerin büyüklüğü hakkında ne kadar emin olabiliriz? (VIDEO_SCRIPT_TR.txt, #47.)
Seçilen ayarlar: konjugat önsel, \tau=0{,}01, \mu_0=0, a_0=b_0=1, %95; Bayes faktörü ve üç ek çıktı açık. Ek çalıştırmalar: referans önsel; g-önseli (g=n=100); sabit için düz önsel; \tau=1; %90; JZS r=1/2.
115.5 Formüller ve hesap adımları
MerQur'un sırası şudur: (1) eksik satırları at, kategorik sütunları kukla değişkene aç, sabit sütunu ekle, rankı denetle; (2) seçilen önsele göre sonsal parametreleri (\mu_n,\ \Lambda_n^{-1},\ a_n,\ b_n) kapalı biçimde hesapla; (3) her katsayının marjinal t sonsalından ortalama, SS, inanılırlık aralığı ve P(\beta>0)'ı yaz; (4) \sigma^2 özetlerini ve (konjugatta) log marjinal olabilirliği ekle; (5) istenen BF ve ek çıktıları hesapla.
115.5.1 Konjugat Normal–ters gama önseli
- \Lambda_0: önsel kesinlik matrisi; tüm katsayılar (sabit dahil) aynı \tau'yu alır (
bayesian_nonlinear.py:152–155). - Ters-Gama(a,b): yoğunluğu \propto(\sigma^2)^{-a-1}e^{-b/\sigma^2}; b ölçek (oran) parametresidir. a_0=b_0=1 zayıf bir önseldir.
Sonsal aynı aileden çıkar (bayesian_nonlinear.py:170–175):
- \mu_n: EKK kestirimi (X'X ağırlığı) ile önsel ortalamanın (\Lambda_0 ağırlığı) kesinlik ağırlıklı ortalaması.
- b_n: artık kareler toplamının yarısı artı önselden sapma cezası; y'y-\mu_n'\Lambda_n\mu_n büzülmüş uyumun artığıdır.
Neden kapalı biçim ("konjugat")?
Önsel \beta'yı \sigma^2'ye koşullu normal, \sigma^2'yi ters gama alınca olabilirlikle çarpım yine normal × ters gama olur; sonsal, dört sayısal parametreyle tam olarak bilinir. Örneklemeye gerek yoktur, sonuç tohumdan bağımsızdır ve hesap anlıktır (Gelman ve ark. 2013, böl. 14).
115.5.2 Marjinal sonsallar: t dağılımı
\sigma^2 integrallenince her katsayının marjinali konum–ölçek t dağılımıdır (bayesian_nonlinear.py:177–208):
- s_j: t dağılımının ölçek parametresi; SS ondan büyüktür (\nu>2 iken). Aralık ve P(\beta>0) ölçekle, "Sonsal SS" sütunu gerçek SS ile yazılır.
- İA: inanılırlık aralığı (eşit kuyruklu). t simetrik olduğu için en yüksek yoğunluk aralığıyla aynıdır.
- T_\nu: standart t dağılım fonksiyonu.
\sigma^2'nin sonsalı Ters-Gama(a_n, b_n)'dir:
115.5.3 Log marjinal olabilirlik
Konjugat önselde verinin marjinal olabilirliği kapalı biçimlidir:
- |\cdot|: determinant; hesap log-determinantla (
slogdet) yapılır, böylece büyük ölçekli yordayıcılarda taşma olmaz. - İki konjugat modelin (aynı y) log marjinal olabilirlik farkı, onların Bayes faktörünün logaritmasıdır. Referans ve g-önselinde önsel uygunsuz (improper) olduğundan değer tanımsızdır ve "—" basılır.
115.5.4 Sabit terim için düz önsel
Seçilince \Lambda_0=\text{diag}(0,\tau,\dots,\tau) ve \mu_{0{,}1}=0 alınır; sabit için önsel p(\beta_0)\propto1'dir (_apply_flat_intercept, bayesian_linear.py:239–295):
Neden a_n'de n − 1?
Düz önselli bir parametre integrallendiğinde \sigma^2'nin üssünden bir \sigma çarpanı düşer; ters gama şekli 1/2 azalır. Sonsal t'nin serbestlik derecesi 2a_n=2a_0+n-1 olur (Tıp örneğinde 101). Sabit artık \mu_0'a çekilmez; y'ye sabit eklemek yalnız sabiti kaydırır.
115.5.5 Referans (Jeffreys) önseli
p(\beta,\sigma^2)\propto1/\sigma^2 ile (posterior_params, bayes_nonlinear_extras.py:65–71):
Sonsal t'nin sd'si n-k olur; inanılırlık aralıkları R confint(lm(...)) ile sayısal olarak aynıdır.
115.5.6 Zellner g-önseli
Sabit için düz, \sigma^2 için Jeffreys, eğimler için merkezlenmiş tasarımla (bayes_nonlinear_extras.py:73–100):
- X_c: ortalaması çıkarılmış yordayıcılar; \hat\beta_{-0}: EKK eğimleri; R^2: EKK belirtme katsayısı; \text{TKT}: y'nin toplam kareler toplamı.
- s: büzülme çarpanı; g=0 girilirse g=n ("birim bilgi" önseli).
- Sabitin sonsal ortalaması \bar y-\bar x's\hat\beta_{-0}; kovaryans \sigma^2'ye koşullu olarak merkezlenmiş parametrizasyondan A\,\text{diag}(1/n,\ s(X_c'X_c)^{-1})A' ile geri çevrilir (A: sabiti merkezden ham ölçeğe taşıyan matris).
Bu önselde ayrıca sabit modele karşı Bayes faktörü kapalı biçimlidir (Liang ve ark. 2008, eşitlik 5):
115.5.7 JZS Bayes faktörü ve R²
"Bayes faktörü (JZS) + R²" seçilince, tüm yordayıcıları içeren model yalnız sabitli modelle Zellner–Siow önseliyle karşılaştırılır: g-önselinin g'si sabit değil, ters gama dağılımlıdır (Rouder ve Morey 2012; jzs_log_bf, stats/bayes_extras.py:21–38):
- p=k-1: sabit hariç yordayıcı sayısı; R^2: EKK R^2'si (önsel türünden bağımsız).
- r: ölçek; "medium" \sqrt2/4, "wide" 1/2, "ultrawide" \sqrt2/2 (BayesFactor
rscaleContadlandırması). - Sayısal hesap: u=\ln g ile [-30{,}30] aralığında 6001 noktalı ızgarada tepe bulunur, sonra [-60{,}60]'ta tepe noktası işaretli uyarlamalı kuadratür (
scipy.quad, göreli tolerans 10^{-10}).
"R² (sonsal ortalama uyumu)": 1-\sum(y_i-x_i'\mu_n)^2/\text{TKT}; zayıf önselde EKK R^2'sine çok yakındır.
Neden tek bir g ve neden X'X/n ölçeği?
Önsel tüm eğimlere birlikte \beta\mid g,\sigma^2\sim N(0,\ g\sigma^2(X_c'X_c)^{-1}) verir. g=n\,h yazılırsa h\sim\text{Ters-Gama}(1/2,\ r^2/2) ve kovaryans h\sigma^2(X_c'X_c/n)^{-1} olur; X_c'X_c/n bir gözlemin bilgisidir ve önsel yordayıcıların birimlerinden bağımsızdır (Zellner ve Siow 1980). g üzerindeki ters gama karışımı, eğim vektörüne çok değişkenli Cauchy önseli verir ve "Bartlett/Lindley" paradokslarını önler (Liang ve ark. 2008). Bu tanım BayesFactor regressionBF/lmBF ile aynıdır.
115.5.8 Ek çıktılar
- Standartlaştırılmış katsayılar: \beta_j^*=\beta_j\,s_{x_j}/s_y (örneklem SS'leri, n-1 paydalı); ortalama, SS ve aralık uçları aynı çarpanla ölçeklenir (
bayes_extras,bayes_nonlinear_extras.py:176–194). - σ² için HDI: Ters-Gama(a_n,b_n)'nin %(1-\alpha) kütleli en dar aralığı; alt kuyruk olasılığı p\in(0,\alpha) üzerinde aralık genişliği en küçüklenir (
ig_hdi,119–129). Eşit kuyruklu aralık da yanında verilir. \sigma^2 sonsalı sağa çarpık olduğundan HDI eşit kuyruklu aralıktan sola kaymıştır. - Önsel duyarlılığı: \tau\in\{0{,}001;\ 0{,}01;\ 0{,}1;\ 1;\ 10;\ 100\} için konjugat sonsal ortalamaları ve log marjinal olabilirlik, ayrıca referans önsel (
172–186). - Sonsal tahmin kontrolü (PPC): analitik sonsal tahmin dağılımı \tilde y_i\sim t_\nu\!\left(x_i'\mu_n,\ \frac{b_n}{a_n}(1+x_i'\Lambda_n^{-1}x_i)\right) ile her gözlemin %(1-\alpha) tahmin aralığına düşme oranı (kapsam); ayrıca R=2000 benzetimli tekrar veri: her benzetimde \sigma^2\sim Ters-Gama, \beta\mid\sigma^2\sim N(\mu_n,\sigma^2\Lambda_n^{-1}), y^{\text{rep}}\sim N(X\beta,\sigma^2I); ortalama, SS, en küçük ve en büyük değer için \text{ppp}=P(T(y^{\text{rep}})\ge T(y)). Tohum (seed) 20240601'e sabittir (
188–221).
Koddaki tercih
PPC'deki ppp değerleri Monte Carlo tahminidir (2000 benzetim; ppp'nin standart hatası en çok 0,011). Benzetimle bulunan ppp 0 ya da 1 yazılmaz; çözünürlük sınırı yazılır ("<1/R", ">1-1/R"). Tohum sabit olduğu için aynı veri ve ayarla her çalıştırmada aynı sayılar çıkar. Kapsam oranı ise analitiktir ve tohuma bağlı değildir.
115.5.9 Yakınsama tanıları
Bu modülde MCMC yoktur; sonsal kesin olarak bilinir ve \hat R, ESS kavramları uygulanmaz. Tanımlar için bkz. 114.5.12. Aynı modeli MCMC ile kestiren bir yazılımla karşılaştırma 115.6.1'de verilmiştir: kesin sonsal ortalamalar, örnekleyicinin ortalamalarından MCSE'nin en çok 1,5 katı uzaktadır.
115.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/bayesian_linear/elle_hesap.py ve elle_ara.py ile, MerQur kodu çağrılmadan hesaplanmıştır. JZS integrali bağımsız hesapta \ln g dönüşümü olmadan, doğrudan g üzerinde parçalı uyarlamalı kuadratürle; \sigma^2 HDI'si yoğunluk eşitliği koşulunun (f(L)=f(U)) kök bulmayla çözümüyle alınmıştır.
Adım 1 — Çapraz çarpımlar. X=[\mathbf 1,\ \text{dose\_mg},\ \text{age}], n=100:
Adım 2 — Sonsal ortalama. \Lambda_n=X'X+0{,}01\,I (köşegen 100,01; 1193416,67; 345716,01):
EKK kestirimi (29{,}151092;\ 0{,}046287;\ -0{,}078058)''dir; büzülme en çok sabitte görülür (-0{,}090), çünkü sabitin X'X'teki ağırlığı (n=100), \tau=0{,}01'in yanında eğimlerinkinden çok daha küçüktür.
Adım 3 — σ² sonsalı. a_n=1+100/2=51; \mu_n'\Lambda_n\mu_n=84768{,}756862:
Adım 4 — Katsayı marjinalleri. \nu=102, t_{0{,}975;\,102}=1{,}983495. [\Lambda_n^{-1}]_{jj}=(0{,}308213;\ 3{,}1586\times10^{-6};\ 7{,}6133\times10^{-5}), ölçek s_j=\sqrt{(1362{,}482569/51)\,[\Lambda_n^{-1}]_{jj}}:
| Sabit | dose_mg | age | |
|---|---|---|---|
| \mu_{n,j} | 29,061241 | 0,046401 | −0,076734 |
| ölçek s_j | 2,869498 | 0,009186 | 0,045099 |
| SS =s_j\sqrt{102/100} | 2,898051 | 0,009277 | 0,045548 |
| %95 İA | [23,369605; 34,752877] | [0,028181; 0,064621] | [−0,166188; 0,012720] |
| P(\beta_j>0) | 1,000000 | 0,999999 | 0,045952 |
Örneğin age için: -0{,}076734\pm1{,}983495\times0{,}045099=[-0{,}166188;\ 0{,}012720] ve P(\beta>0)=1-T_{102}(0{,}076734/0{,}045099)=1-T_{102}(1{,}7015)=0{,}045952.
Adım 5 — Log marjinal olabilirlik. \ln\Gamma(51)-a_n\ln b_n-50\ln(2\pi)+\tfrac12(3\ln0{,}01-\ln|\Lambda_n|)=-331{,}776496.
Adım 6 — Önsel türüne göre karşılaştırma.
| Önsel | Sabit | dose_mg | age (%95 İA) | E(\sigma^2) | sd (\nu) |
|---|---|---|---|---|---|
| Konjugat, \tau=0{,}01 | 29,061241 | 0,046401 | −0,076734 [−0,166188; 0,012720] | 27,249651 | 102 |
| Konjugat, sabit düz | 29,151089 | 0,046287 | −0,078058 [−0,167946; 0,011830] | 27,439328 | 101 |
| Referans | 29,151092 | 0,046287 | −0,078058 [−0,169793; 0,013677] | 28,573615 | 97 |
| g-önseli, g=100 | 29,149358 | 0,045829 | −0,077285 | 28,067797 | 99 |
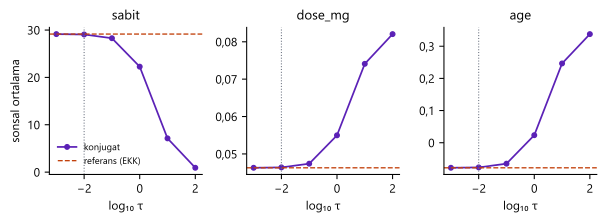
| Konjugat, \tau=1 | 22,267012 | 0,054979 | 0,023384 | 33,656018 | 102 |
Sabite düz önsel verilince eğimler referans önselle neredeyse aynı olur; \sigma^2 ise b_0=1 ve a_0=1'in katkısıyla biraz küçük kalır. \tau=1 çok bilgilendiricidir: sabit 22,3'e çekilir ve yaşın işareti değişir; bu, önselin modelin büyük bölümünü belirlediği bir ayardır.
Şekil 115.1. Önsel kesinliği τ'ya göre konjugat sonsal ortalamaları (mor) ve referans önsel (turuncu, kesikli). Dikey nokta çizgi varsayılan τ = 0,01'dir. τ ≥ 1'de sonsal, verinin değil önselin belirlediği bölgeye geçer.
Adım 7 — JZS Bayes faktörü. R^2=1-2714{,}493387/3530{,}8644=0{,}231210, p=2, r=\sqrt2/4, c=r^2n/2=6{,}25. İntegrandın tepesi g^*=13{,}18'dedir. İntegral:
r=1/2'de \ln\text{BF}_{10}=8{,}646971. g-önselinin sabit g=100'deki değeri \ln\text{BF}_{10}(100)=\tfrac{97}{2}\ln101-\tfrac{99}{2}\ln[1+100(1-0{,}231210)]=8{,}253104.
Adım 8 — Ek çıktılar. Standartlaştırılmış dose_mg katsayısı 0{,}046401\times56{,}858/5{,}972=0{,}441769. \sigma^2 için %95 HDI [20,097549; 35,049159], eşit kuyruklu aralık [20,669115; 35,880440]. PPC kapsamı tam %95,0 (100 gözlemden 95'i aralıkta).
115.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan alınmıştır; motor \sigma^2 özetlerini sonuç nesnesinde dört ondalığa yuvarladığından round yalnız bellekte etkisizleştirilmiştir (düz sabit modunda yuvarlama panel modülünde kalır; o satır dört ondalıkta karşılaştırılmıştır). R 4.5.3: kapalı biçimler base R matris cebiriyle; referans önsel lm()/confint(); JZS BF BayesFactor 0.9.12-4.8 lmBF (tek g, sayısal integral); g-önseli BAS 2.0.2 bas.lm(prior = "g-prior"). ‡: BAS'ın g-önseli sonsal SS'si, \sigma^2'yi EKK artığıyla sabitleyen yaklaşık bir değerdir (\sqrt{s}\timesEKK SH); kesin t sonsalının SS'sinden \sqrt{(1-R^2)/(1-sR^2)}=0{,}998515 oranında küçüktür, bu yüzden ölçüte alınmamıştır.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Konjugat: Sabit sonsal ort. | 29,061241 | 29,061241 | 29,061241 | 7,1e−13 | ✓ |
| Konjugat: Sabit sonsal SS | 2,898051 | 2,898051 | 2,898051 | 2,9e−13 | ✓ |
| Konjugat: Sabit %95 İA alt | 23,369605 | 23,369605 | 23,369605 | 1,9e−10 | ✓ |
| Konjugat: Sabit %95 İA üst | 34,752877 | 34,752877 | 34,752877 | 1,9e−10 | ✓ |
| Konjugat: dose_mg sonsal ort. | 0,046401 | 0,046401 | 0,046401 | 9,0e−16 | ✓ |
| Konjugat: dose_mg sonsal SS | 0,009277 | 0,009277 | 0,009277 | 9,1e−16 | ✓ |
| Konjugat: dose_mg %95 İA alt | 0,028181 | 0,028181 | 0,028181 | 6,2e−13 | ✓ |
| Konjugat: dose_mg %95 İA üst | 0,064621 | 0,064621 | 0,064621 | 6,2e−13 | ✓ |
| Konjugat: dose_mg P(\beta>0) | 0,999999 | 0,999999 | 0,999999 | 1,1e−16 | ✓ |
| Konjugat: age sonsal ort. | −0,076734 | −0,076734 | −0,076734 | 1,1e−14 | ✓ |
| Konjugat: age sonsal SS | 0,045548 | 0,045548 | 0,045548 | 4,5e−15 | ✓ |
| Konjugat: age %95 İA alt | −0,166188 | −0,166188 | −0,166188 | 3,0e−12 | ✓ |
| Konjugat: age %95 İA üst | 0,012720 | 0,012720 | 0,012720 | 3,0e−12 | ✓ |
| Konjugat: age P(\beta>0) | 0,045952 | 0,045952 | 0,045952 | 3,7e−14 | ✓ |
| Konjugat: σ² sonsal ort. | 27,249651 | 27,249651 | 27,249651 | 5,4e−12 | ✓ |
| Konjugat: σ² sonsal SS | 3,892807 | 3,892807 | 3,892807 | 7,7e−13 | ✓ |
| Konjugat: log marjinal olabilirlik | −331,776496 | −331,776496 | −331,776496 | 9,8e−12 | ✓ |
| Konjugat %90: dose_mg İA alt | 0,031153 | 0,031153 | 0,031153 | 1,6e−13 | ✓ |
| Konjugat %90: dose_mg İA üst | 0,061649 | 0,061649 | 0,061649 | 1,7e−13 | ✓ |
| Konjugat %90: age İA alt | −0,151595 | −0,151595 | −0,151595 | 8,0e−13 | ✓ |
| Konjugat %90: age İA üst | −0,001873 | −0,001873 | −0,001873 | 8,2e−13 | ✓ |
| τ = 1: Sabit sonsal ort. | 22,267012 | 22,267012 | 22,267012 | 6,2e−13 | ✓ |
| τ = 1: dose_mg sonsal ort. | 0,054979 | 0,054979 | 0,054979 | 6,9e−16 | ✓ |
| τ = 1: age sonsal ort. | 0,023384 | 0,023384 | 0,023384 | 9,4e−15 | ✓ |
| Standart β: dose_mg ort. | 0,441769 | 0,441769 | — | 1,3e−15 | ✓ |
| Standart β: dose_mg İA alt | 0,268299 | 0,268299 | — | 1,3e−14 | ✓ |
| Standart β: age ort. | −0,148638 | −0,148638 | — | 2,3e−15 | ✓ |
| Standart β: age İA alt | −0,321915 | −0,321915 | — | 1,7e−14 | ✓ |
| σ² %95 HDI alt | 20,097549 | 20,097549 | 20,097549 | 5,5e−08 | ✓ |
| σ² %95 HDI üst | 35,049159 | 35,049159 | 35,049159 | 5,5e−08 | ✓ |
| σ² %95 eşit kuyruk alt | 20,669115 | 20,669115 | 20,669115 | 4,0e−12 | ✓ |
| σ² %95 eşit kuyruk üst | 35,880440 | 35,880440 | 35,880440 | 7,1e−12 | ✓ |
| Duyarlılık τ = 0,001: log marjinal olab. | −335,086128 | −335,086128 | — | 1,7e−12 | ✓ |
| Duyarlılık τ = 100: log marjinal olab. | −354,488693 | −354,488693 | — | 4,0e−13 | ✓ |
| Duyarlılık τ = 100: sabit ort. | 0,918272 | 0,918272 | — | 1,9e−14 | ✓ |
| JZS log BF₁₀ (r=\sqrt2/4) | 8,731358 | 8,731358 | 8,731358 | 6,7e−11 | ✓ |
| JZS log BF₁₀ (r=1/2) | 8,646971 | 8,646971 | 8,646971 | 1,4e−11 | ✓ |
| R² (EKK) | 0,231210 | 0,231210 | 0,231210 | 5,3e−16 | ✓ |
| R² (sonsal ortalama uyumu) | 0,231203 | 0,231203 | — | 3,3e−16 | ✓ |
| Referans: Sabit sonsal ort. | 29,151092 | 29,151092 | 29,151092 | 3,2e−13 | ✓ |
| Referans: Sabit sonsal SS | 2,972204 | 2,972204 | 2,972204 | 3,6e−15 | ✓ |
| Referans: Sabit %95 İA alt | 23,313221 | 23,313221 | 23,313221 | 3,9e−11 | ✓ |
| Referans: Sabit %95 İA üst | 34,988963 | 34,988963 | 34,988963 | 3,9e−11 | ✓ |
| Referans: dose_mg sonsal ort. | 0,046287 | 0,046287 | 0,046287 | 5,8e−16 | ✓ |
| Referans: dose_mg sonsal SS | 0,009502 | 0,009502 | 0,009502 | 1,7e−18 | ✓ |
| Referans: dose_mg %95 İA alt | 0,027623 | 0,027623 | 0,027623 | 1,2e−13 | ✓ |
| Referans: dose_mg %95 İA üst | 0,064952 | 0,064952 | 0,064952 | 1,2e−13 | ✓ |
| Referans: age sonsal ort. | −0,078058 | −0,078058 | −0,078058 | 2,8e−15 | ✓ |
| Referans: age sonsal SS | 0,046705 | 0,046705 | 0,046705 | 1,4e−17 | ✓ |
| Referans: age %95 İA alt | −0,169793 | −0,169793 | −0,169793 | 6,1e−13 | ✓ |
| Referans: age %95 İA üst | 0,013677 | 0,013677 | 0,013677 | 6,1e−13 | ✓ |
| Referans: σ² sonsal ort. | 28,573615 | 28,573615 | 28,573615 | 2,5e−14 | ✓ |
| Referans: σ² sonsal SS | 4,190238 | 4,190238 | — | 1,8e−15 | ✓ |
| g-önseli: Sabit sonsal ort. | 29,149358 | 29,149358 | — | 0,0e+00 | ✓ |
| g-önseli: dose_mg sonsal ort. | 0,045829 | 0,045829 | 0,045829 | 1,4e−17 | ✓ |
| g-önseli: dose_mg sonsal SS | 0,009371 | 0,009371 | 0,009357 ‡ | 1,7e−18 | ✓ |
| g-önseli: age sonsal ort. | −0,077285 | −0,077285 | −0,077285 | 8,3e−17 | ✓ |
| g-önseli: age sonsal SS | 0,046060 | 0,046060 | 0,045991 ‡ | 0,0e+00 | ✓ |
| g-önseli: σ² sonsal ort. | 28,067797 | 28,067797 | — | 3,6e−15 | ✓ |
| g-önseli: log BF₁₀ (g=n) | 8,253104 | 8,253104 | 8,253104 | 2,8e−13 | ✓ |
| Düz sabit: Sabit sonsal ort. | 29,151089 | 29,151089 | 29,151089 | 1,0e−12 | ✓ |
| Düz sabit: dose_mg sonsal ort. | 0,046287 | 0,046287 | 0,046287 | 1,1e−15 | ✓ |
| Düz sabit: age sonsal ort. | −0,078058 | −0,078058 | −0,078058 | 1,4e−14 | ✓ |
| Düz sabit: age %95 İA alt | −0,167946 | −0,167946 | −0,167946 | 3,2e−12 | ✓ |
| Düz sabit: σ² sonsal ort. (4 ondalık) | 27,439300 | 27,439300 | 27,439300 | 0,0e+00 | ✓ |
| PPC: %95 tahmin aralığı kapsamı | 0,950000 | 0,950000 | — | 0,0e+00 | ✓ |
Monte Carlo: sonsal tahmin kontrolü. MerQur'un ppp değerleri (2000 benzetim) 400000 benzetimli bağımsız bir hesapla, binom standart hatası ölçeğinde karşılaştırılmıştır. Aynı ayarla ikinci çalıştırmada PPC tablosu ve ilk tekrar veri değerleri özdeştir.
| İstatistik | MerQur ppp (2000 benzetim, tohum 20240601) | Bağımsız ppp (400000 benzetim) | MC SH | \lvertfark\rvert/SH | Durum |
|---|---|---|---|---|---|
| mean | 0,4920 | 0,4985 | 0,0112 | 0,58 | ✓ |
| sd | 0,4615 | 0,4833 | 0,0112 | 1,95 | ✓ |
| min | 0,5715 | 0,5544 | 0,0111 | 1,54 | ✓ |
| max | 0,0710 | 0,0706 | 0,0057 | 0,08 | ✓ |
| Aynı tohumla ikinci çalıştırma | özdeş: evet | ✓ |
MCMC ile denetim: tekrarlanabilirlik, R̂ ve ESS. brms kurulu olmakla birlikte bu makinede Stan modeli derlenemediği için önceden derlenmiş MCMCpack 1.7.1 MCMCregress (Gibbs örnekleyicisi) kullanılmıştır. Önsel, \beta için düz (B_0=0) ve \sigma^2\sim Ters-Gama(0{,}0005;\ 0{,}0005) alınarak referans önsele yakınsatılmıştır. Dört zincir (tohumlar 11–14) × 50000 çekiliş; birinci zincir aynı tohumla yeniden çalıştırıldığında çekilişler özdeştir, tohum değişince ilk çekiliş farklıdır (sabitte −6,93 fark) ama özetler MCSE içinde kalır. Sıra-normalleştirilmiş \hat R (posterior 1.7.0) tüm parametrelerde \le1{,}00002, toplu ESS ≈ 188000–201000'dir.
| Parametre | Kesin sonsal ort. (referans) | MCMC ort. | MCSE | \lvertfark\rvert/MCSE | \hat R (sıra-norm.) | ESS (toplu) | ESS (kuyruk) |
|---|---|---|---|---|---|---|---|
| Sabit | 29,151092 | 29,157164 | 0,006655 | 0,91 | 1,00000 | 200215 | 197142 |
| dose_mg | 0,046287 | 0,046306 | 2,1389·10−5 | 0,85 | 1,00001 | 196962 | 198884 |
| age | −0,078058 | −0,078213 | 0,000104 | 1,48 | 1,00000 | 201036 | 198341 |
| σ² | 28,573615 | 28,567923 | 0,009654 | 0,59 | 1,00000 | 188136 | 193934 |
Sonuç: kapalı biçim tablosundaki 66 büyüklüğün tamamı 10^{-6} ölçütünü karşılar; dört ppp değeri Monte Carlo hatasının 3 katı içinde ve dört MCMC ortalaması kesin sonsal ortalamanın 1,5 MCSE yakınındadır.
115.7 Çıktıyı okuma
Varsayılan konjugat önselle, BF ve ek çıktılar açıkken sonuç metni (kısaltılmış; \sigma^2 satırları arayüzde dört ondalıkla görünür):
Bayesçi Doğrusal Regresyon (Konjugat Önsel)
  N (gözlem)         = 100
  Yordayıcı sayısı   = 3
  Log marj. olab.    = -331.7765
  σ² sonsal ortalaması  = 27.2497
  σ² sonsal SS          = 3.8928
  t serbestlik derecesi (ν)= 102.0
── Sonsal özeti ──
  Değişken  Sonsal ort.  Sonsal SS  %95 İA (alt)  %95 İA (üst)  P(β>0)
     Sabit      29.0612     2.8981       23.3696       34.7529   1.000
   dose_mg       0.0464     0.0093        0.0282        0.0646   1.000
       age      -0.0767     0.0455       -0.1662        0.0127   0.046
── BAYES FAKTÖRÜ (JZS) VE R² ──
  BF10 = 6194 (log BF10 = 8.7314) → Çok güçlü (kesin) kanıt  [r = 0.3536]
  R² (EKK) = 0.2312  ·  R² (sonsal ortalama uyumu) = 0.2312
── STANDARTLAŞTIRILMIŞ KATSAYILAR VE HDI ──
   dose_mg       0.4418     0.0883        0.2683        0.6152
       age      -0.1486     0.0882       -0.3219        0.0246
  σ² %95 HDI = [20.0975, 35.0492]  (eşit kuyruklu: [20.6691, 35.8804])
── ÖNSEL DUYARLILIĞI (sonsal ortalamaları) ──
         prior   Sabit  dose_mg     age  log_marg
   conj τ=0.01 29.0612   0.0464 -0.0767 -331.7765
     conj τ=1 22.2670   0.0550  0.0234 -335.7706
     reference 29.1511   0.0463 -0.0781         —
── SONSAL TAHMİN KONTROLÜ ──
  Gözlemlerin %95.0'i %95 sonsal tahmin aralığı içinde.
  stat observed rep_mean    ppp
   max    48.22  43.8446 0.0710
| Satır/Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Log marj. olab. | Konjugat modelin \ln p(y)'si | Yalnız aynı y'li konjugat modelleri karşılaştırmak için; tek başına anlamı yoktur. |
| σ² satırları ve ν | Ters gama sonsalı, t sd'si 2a_n | \sqrt{E(\sigma^2)}\approx5{,}2 tipik artık büyüklüğüdür. |
| Sonsal ort., Sonsal SS | \mu_{n,j} ve gerçek SS | SS, aralık ölçeğinin \sqrt{\nu/(\nu-2)} katıdır. |
| "%95 İA" sütunları | Eşit kuyruklu inanılırlık aralığı | Sonsal inanılırlık aralığıdır (güven aralığı değil); düzeyi seçilen güven düzeyidir ve not satırı bunu yazar. |
| P(β>0) | Sonsal tek yönlü olasılık | age için 0,046: yaşın etkisinin negatif olma olasılığı 0,954. |
| BF10 (JZS) | Tam modelin sabit modele karşı BF'si | Model düzeyinde kanıt; tek tek katsayıların BF'si değildir. |
| Standart β, HDI | \beta s_x/s_y; \sigma^2'nin en dar aralığı | β'lar için HDI ile eşit kuyruklu aralık aynıdır (simetrik t). |
| Önsel duyarlılığı | \tau ızgarası ve referans | Sabit için düz önsel seçiliyse \tau yalnız eğimlere uygulanır ve log marjinal olabilirlik "—" yazılır. |
| PPC | Kapsam ve ppp | ppp 0,05'in altı ya da 0,95'in üstü uyumsuzluk işaretidir; burada en büyük değer (0,071) sınıra yakındır: veride gözlenen 48,22 kadar büyük değerler model altında seyrektir. |
APA biçiminde rapor cümlesi:
Yanıt skoru, doz ve yaşla Bayesçi doğrusal regresyonla modellendi (konjugat Normal–ters gama önseli, \tau = 0{,}01, \mu_0 = 0, a_0 = b_0 = 1; n = 100). Doz katsayısının sonsal ortalaması 0,046 (%95 inanılırlık aralığı [0,028; 0,065]) idi ve pozitif olma olasılığı 0,999'dan büyüktü; yaş katsayısının sonsal ortalaması −0,077 (%95 İA [−0,166; 0,013]), negatif olma olasılığı 0,95 idi. Tam model sabit modele karşı kesin biçimde desteklendi, \text{BF}_{10} = 6194 (JZS, r = \sqrt2/4), R^2 = 0{,}23. Sonuçlar \tau \le 0{,}1 aralığında ve referans önselde değişmedi.
115.8 Uzman soruları
S1. Sonsal neden MCMC ile değil de kapalı biçimde?
Konjugat Normal–ters gama önseli, referans önsel ve g-önseli üçü de \beta\mid\sigma^2 normal, \sigma^2 ters gama biçiminde sonsal verir; marjinaller t'dir. Sonuç kesin, anlık ve tohumdan bağımsızdır. Aynı modeli Gibbs ile kestiren MCMCpack 200000 çekilişte ortalamaları 1,5 MCSE içinde tekrarlar; MCMC burada yalnız Monte Carlo hatası ekler.
S2. Varsayılan önsel "bilgi vermeyen" mi?
Değil. \tau=0{,}01 katsayıların önsel SS'sini 10\sigma yapar ve sabit dahil tüm katsayıları \mu_0=0'a çeker. Eğimlerde etkisi genellikle küçüktür; sabitte \bar y/\sigma büyükse belirgindir (burada 29,151 → 29,061). Konumdan bağımsız sonuç için "sabit terim için düz önsel" ya da referans önsel seçilmelidir.
S3. Referans önsel EKK ile tam olarak aynı mı?
Sonsal ortalamalar EKK kestirimleri, %95 inanılırlık aralıkları R confint(lm()) aralıklarıdır (10^{-10} düzeyinde). Fark yorumdadır. "Sonsal SS" ise EKK standart hatasından \sqrt{(n-k)/(n-k-2)} kat büyüktür; çünkü t dağılımının SS'sidir.
S4. JZS BF ile g-önseli BF'si neden farklı?
g-önselinde g sabittir (g=n=100): \ln\text{BF}=8{,}25. JZS'de g ters gama dağılımlıdır ve veriye uyan g bölgesi ağırlık alır: \ln\text{BF}=8{,}73. Sabit g, büyük n'de Lindley paradoksuna açıktır; JZS karışımı bunu önler (Liang ve ark. 2008). MerQur'un JZS değeri BayesFactor lmBF ile log ölçeğinde 10^{-10} düzeyinde aynıdır.
S5. BF tek tek katsayılar için mi?
Hayır. BF, tüm yordayıcıları içeren modelin yalnız sabitli modele karşı kanıtıdır. Tek bir katsayının kanıtı için iki model (o yordayıcı var/yok) ayrı ayrı çalıştırılıp BF'leri oranlanabilir (aynı r ile ve aynı satırlarla), ya da P(\beta>0) ve inanılırlık aralığı yorumlanır.
S6. Tam çoklu doğrusallıkta ne olur?
Konjugat önselde \Lambda_n=X'X+\tau I her zaman terslenebilir; sonuç üretilir ama doğrusal bağımlı sütunların katsayıları veriden değil önselden gelir ve çıktı bunu bir uyarıyla söyler. Referans ve g-önselinde (ve sabit için düz önselde) sonsal tanımsızdır; modül hata verir ve bağımlı sütunları adlandırır (bayesian_linear.py:178–189).
S7. Küçük n'de σ² özetleri neden "inf" olabilir?
Ters gama sonsalının ortalaması a_n>1, varyansı a_n>2 ister. Referans önselde a_n=(n-k)/2; örneğin n-k\le2 ise ortalama, n-k\le4 ise SS tanımsızdır. Modül bu durumda "inf" basar ve uyarı ekler. Katsayıların "Sonsal SS"si de \nu\le2'de tanımsızdır.
S8. Başka yazılımla fark: BAS ve brms aynı sayıları verir mi?
BAS'ın g-önseli sonsal ortalamaları ve BF'si aynıdır; ama BAS sonsal SS'yi \sqrt{s}\timesEKK SH olarak, yani \sigma^2'yi EKK artığıyla sabitleyerek yaklaşık verir; kesin t SS'si bu veride %0,15 büyüktür (115.6.1). brms/rstanarm varsayılan önselleri \sigma'dan bağımsız ve sabit için merkezlenmiş t önselidir; bu yüzden MerQur'un konjugat sonuçlarıyla ancak yaklaşık olarak eşleşir.
S9. PPC'de "max" için ppp 0,07 ne anlama gelir?
Model altında üretilen tekrar verilerin yalnız %7'sinde en büyük değer gözlenen 48,22'yi aşar. Normal hata varsayımı, verideki üst uç değeri tam olarak öngöremiyor olabilir; 0,05 eşiğine yakındır. Bu bir Monte Carlo tahminidir (2000 benzetim, SH ≈ 0,006); bağımsız 400000 benzetim 0,071 verir.
115.9 Sık hatalar ve tuzaklar
- Varsayılan önseli bilgi vermeyen sanmak. Sabit terim \mu_0'a çekilir; ölçek ve konum seçimi sonucu etkiler.
- \mu_0'ın yalnız eğimlere uygulandığını sanmak. \mu_0 tüm katsayılara, sabit dahil, uygulanır.
- "Sonsal SS" ile aralık genişliğini karıştırmak. Aralık t ölçeğiyle, SS t dağılımının gerçek SS'siyle yazılır.
- İnanılırlık aralığını güven aralığı diye raporlamak. "İA" sütunları sonsal inanılırlık aralığıdır.
- Model BF'sini katsayı BF'si sanmak. JZS BF tam modeli sabit modele karşı sınar.
- Sayıyla kodlanmış kategorik değişkeni sürekli bırakmak. 1–2–3 kodlu bir grup değişkeni tek bir eğim olarak girer; kategori olarak girmesi için Veri sekmesinde "kategorik" işaretlenmelidir.
- Büyük τ ile "sağlam" sonuç beklemek. \tau\ge1 bu veride yaşın işaretini değiştirir; duyarlılık tablosu raporlanmalıdır.
- PPC ppp'lerini kesin sayı sanmak. 2000 benzetimli Monte Carlo tahminidir.
115.10 Kaynaklar
- Clyde, M. A., Ghosh, J., & Littman, M. L. (2011). Bayesian adaptive sampling for variable selection and model averaging. Journal of Computational and Graphical Statistics, 20(1), 80–101. https://doi.org/10.1198/jcgs.2010.09049
- Gelman, A., Carlin, J. B., Stern, H. S., Dunson, D. B., Vehtari, A., & Rubin, D. B. (2013). Bayesian data analysis (3. baskı). CRC Press.
- Kass, R. E., & Raftery, A. E. (1995). Bayes factors. Journal of the American Statistical Association, 90(430), 773–795. https://doi.org/10.1080/01621459.1995.10476572
- Liang, F., Paulo, R., Molina, G., Clyde, M. A., & Berger, J. O. (2008). Mixtures of g priors for Bayesian variable selection. Journal of the American Statistical Association, 103(481), 410–423. https://doi.org/10.1198/016214507000001337
- Martin, A. D., Quinn, K. M., & Park, J. H. (2011). MCMCpack: Markov chain Monte Carlo in R. Journal of Statistical Software, 42(9), 1–21. https://doi.org/10.18637/jss.v042.i09
- Rouder, J. N., & Morey, R. D. (2012). Default Bayes factors for model selection in regression. Multivariate Behavioral Research, 47(6), 877–903. https://doi.org/10.1080/00273171.2012.734737
- Rubin, D. B. (1984). Bayesianly justifiable and relevant frequency calculations for the applied statistician. The Annals of Statistics, 12(4), 1151–1172. https://doi.org/10.1214/aos/1176346785
- Vehtari, A., Gelman, A., Simpson, D., Carpenter, B., & Bürkner, P.-C. (2021). Rank-normalization, folding, and localization: An improved R̂ for assessing convergence of MCMC. Bayesian Analysis, 16(2), 667–718. https://doi.org/10.1214/20-BA1221
- Zellner, A. (1986). On assessing prior distributions and Bayesian regression analysis with g-prior distributions. In P. K. Goel & A. Zellner (Ed.), Bayesian inference and decision techniques: Essays in honor of Bruno de Finetti (s. 233–243). North-Holland.
- Zellner, A., & Siow, A. (1980). Posterior odds ratios for selected regression hypotheses. In J. M. Bernardo, M. H. DeGroot, D. V. Lindley, & A. F. M. Smith (Ed.), Bayesian statistics: Proceedings of the first international meeting (s. 585–603). University Press.