70. Karar Ağacı (CART)
Analiz kimliği: decision_tree · Menü adı: Karar Ağacı (CART) · Panel: gui/panels/analyses/decision_tree.py (form 51–98, read_options 101–118, execute 121–129, metin 141–300) · Motor: ml/cart.py (CARTTree 137–743, kat ataması ve cp seçimi 746–760, scikit-learn sarmalayıcısı 774–873); ml/classification.py, Classification.decision_tree (665–756) ve ortak hat _run_sklearn_model (1089–1687; Bölüm 67.5) · Çağrı: stats_panel.py:8468–8473
70.1 Ne işe yarar
Sınıflandırma ve regresyon ağacı (CART; Breiman vd. 1984), veriyi X değişkenleri üzerinde art arda ikiye bölerek hedefin homojen olduğu dikdörtgen bölgeler arar. Her yaprak bir sınıf (ya da ortalama) tahmini ve okunabilir bir "EĞER … VE … İSE" kuralıdır. Ağaç önce büyütülür, sonra maliyet-karmaşıklık ölçütüyle budanır. Cevapladığı soru: "Hangi ölçüm eşikleri, hastaları sınıflara en iyi ayıran basit bir karar kuralı verir?" MerQur'un motoru R rpart'ın tanımlarını izleyen bağımsız bir uygulamadır (ml/cart.py); doğrulamada aynı eğitim kümesi ve aynı iç CV katlarıyla rpart'la 10^{-12} içinde aynı sonucu verir.
Ne zaman kullanılır?
- Klinik karar kuralı gibi açıklanabilir bir model gerekiyorsa.
- Eşik etkileri ve etkileşimler beklendiğinde (ör. "HbA1c düşükse BKİ'ye bak").
- Kategorik X'leri doğrudan, düzeylerini gruplayarak kullanmak için.
Ne zaman kullanılmaz?
- En yüksek tahmin başarımı amaçsa: Rastgele Orman (Bölüm 67) ya da Gradyan Artırma (Bölüm 69). Tek ağaç kararsızdır: veride küçük bir değişiklik bambaşka bir ağaç verebilir.
- İlişki düzgün ve doğrusalsa: Çoklu Doğrusal Regresyon, Çok Terimli Lojistik Regresyon.
- Etki büyüklüğü ve p değeri gerekiyorsa: ağaç bunları vermez.
- X'lerde çok eksik değer varsa: MerQur eksik X'li satırları atar (rpart'tan farklı olarak vekil bölmelerle tutmaz; 70.2).
Sık karıştırılan analizler. Rastgele ormanın ağaçları da CART ağaçlarıdır, ama budanmaz ve tek tek yorumlanmaz. C4.5/ID3 (Quinlan 1986) çok yollu bölme ve kazanç oranı kullanır; CART her zaman ikili böler. Koşullu çıkarım ağaçları (R ctree) bölmeyi permütasyon testleriyle seçer; MerQur'da yoktur.
70.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Bağımsız gözlemler | Satırlar birbirinden bilgi taşımaz. | Denetlenmez; kat sütunu iç CV'yi de gruplar. |
| Hedef türü | Sınıflandırmada kategorik; regresyonda sayısal (ANOVA ağacı). | Görev seçimi; regresyonda sayıya çevrilemeyen hedef hata. |
| Dağılım varsayımı | Yok. Bölmeler yalnız sıralamaya bağlı; ölçekleme yapılmaz. | — |
| Yeterli gözlem | Her yaprakta en az minbucket gözlem. |
minsplit, minbucket, maxdepth. |
Eksik değer. Ortak hat hedefi ya da herhangi bir X'i eksik satırları atar (67.2). Ağaç motoru eksik X'li veriyi kabul etmez (cart.py:178–179). R rpart ise eksik X'li gözlemleri modelde tutar ve vekil bölmelerle yönlendirir; eksik değerli veride MerQur ile rpart farklı ağaç verir. MerQur vekil bölmeleri yalnız değişken önemi ve tahmin sırasında görülmemiş kategori düzeyleri için kullanır (cart.py:577–608).
Uç durumlar (koddan):
- Ortak hattın tüm denetimleri (tek sınıf, tek gözlemli sınıf, kat sayısı; 67.2).
- Çok sınıflı hedefte 16'dan çok düzeyi olan kategorik X ile tam alt küme araması yapılamaz ve hata verilir (
cart.py:410–412). İki sınıfta ve regresyonda sınır yoktur (sıralama teoremi). - Budama "en küçük CV hatası" ya da "1-SE" iken CV kat sayısı 2'den küçükse form hata verir (
decision_tree.py:114–115). - Eğitim kümesi CV kat sayısından küçükse iç CV yapılamaz; CV'ye dayalı budama seçilmiş olsa da ağaç kullanıcının cp'sinde budanır. Çıktı bunu "iç CV yapılamadı" diye yazar ve ayar bloğuna kaydeder (
cart.py:819–833,decision_tree.py:209–220).
70.3 Parametreler
Varsayılanlar decision_tree.py:51–118 ve classification.py:665–707'dan alınmıştır. Ortak satırlar Bölüm 67.3'tekiyle aynıdır; farklı olarak Test oranı 0 seçilebilir ("Yok (tüm veri)"): model tüm veride kurulur ve metrikler eğitim verisinde hesaplanır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Ayrım ölçütü | Gini | Sınıflandırmada Gini ya da entropi (bilgi kazancı). Regresyonda her zaman ANOVA. | Bölme seçimi. |
| Karmaşıklık parametresi (cp) | 0,01 (0–1) | Göreli riski en az cp azaltmayan dal budanır. | Büyük cp, küçük ağaç. 0: yalnız sıfır kazançlı dallar atılır. |
| Budama | Verilen cp | Verilen cp / en küçük CV hatası / 1-SE kuralı. | Ağaç büyüklüğü. |
| Karmaşıklık (cp) hesabı | büyütme sırasında | rpart tanımı ya da kesin en zayıf halka. | cptable ve budama (70.5.4). |
| Bölünecek en küçük düğüm (minsplit) | 20 | Bölme denenmesi için en az gözlem. | Büyük değer, sığ ağaç. |
| En küçük yaprak (minbucket) | Otomatik (minsplit/3) | Yapraktaki en az gözlem; otomatikte round(20/3) = 7. | Büyük değer, sığ ağaç. |
| En büyük derinlik | 30 | Kök derinliği 0 sayılır. | — |
| CV kat sayısı (xval) | 10 (0 = kapalı) | cptable'ın xerror ve xstd sütunları için iç CV. | CV'ye dayalı budama. |
| Kategorik X | Alt küme bölmeleri | Düzeyler iki gruba ayrılır / kukla / sıralı kod. | Bölme biçimi (70.5.2). |
| Dengesiz sınıflar: dengeli ağırlık | kapalı | Eşit önsel olasılıklar (\pi_k=1/K). | Riskler ve olasılıklar önsellerle ağırlıklanır. |
| Test oranı | 0,20 (0 = yok) | Tabakalı test kümesi. | 0: metrikler eğitim verisinde (iyimser). |
| Grafik | Ağaç diyagramı | CP grafiği (plotcp), değişken önemi, ROC, PDP, 3B yüzey. | Yalnız grafik. |
minbucket neden round(minsplit/3)?
rpart'ın varsayılan ilişkisidir: 20 gözlemli bir düğüm bölünecekse çocuklardan biri en az 7 gözlem içermelidir; böylece bir yaprağın olasılık tahmini birkaç gözleme dayanmaz. MerQur "Otomatik" seçiliyken aynı kuralı uygular (cart.py:154). Ancak rpart'ta yalnız minbucket verilirse minsplit = 3 × minbucket olur; MerQur formunda minsplit her zaman bir değer taşıdığından bu kural uygulanmaz.
Koddaki tercih: varsayılan cp hesabı
Varsayılan "büyütme sırasında"dır (rpart tanımı); "kesin en zayıf halka" seçenek olarak durur. İki hesap kimi ağaçlarda farklı sonuç verebildiği için MerQur her çalıştırmada uygulanan hesabı ayar bloğuna yazar (classification.py:691–697). Tıp örneğinde iki hesap aynı ağacı ve aynı cptable'ı verir; farkın göründüğü durum 70.5.4'tedir.
70.4 Tıp örneği
Dosya: english/datasets/Tip/121_decision_tree_glycaemic_status.xlsx (Türkçe kopyası ve video betiği yoktur, değişkenler veri dosyasından seçilmiştir).
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
glycaemic_status |
Hedef | 3 sınıf | normoglycaemic 281, prediabetes 154, diabetes 115 |
hba1c_pct |
X | sayısal (%) | ort. 6,04; SS 0,94; 4,4–9,6 |
bmi |
X | sayısal (kg/m²) | ort. 28,5; SS 4,9; 18,0–44,1 |
age |
X | sayısal (yıl) | ort. 51,8; SS 11,9 |
systolic_bp |
X | sayısal (mmHg) | ort. 128,0; SS 14,8 |
family_history |
X | kategorik (3 düzey) | no 276, yes 211, unknown 63 |
sex |
X | kategorik (F, M) | F 288, M 262 |
n ve eksik değer: 550 hasta, eksik değer yok. Tabakalı bölme: eğitim 440 (diabetes 92, normoglycaemic 225, prediabetes 123), test 110.
Klinik soru: HbA1c, BKİ, yaş, sistolik kan basıncı, aile öyküsü ve cinsiyetten glisemik durumu (normoglisemi / prediyabet / diyabet) ayıran basit bir kural var mı?
Seçilen ayarlar: Arayüz varsayılanları (Gini, cp = 0,01, verilen cp'de budama, minsplit 20, minbucket 7, xval 10, alt küme bölmeleri, tohum 42). Ek çalıştırmalar: aynı tohumla ikinci kez; tohum 7; cp = 0; cp = 0 ve minsplit = 10 (iki cp hesabıyla); en küçük CV hatası ve 1-SE budaması; entropi; eşit önseller; ek metrikler + permütasyon önemi; regresyon ağacı (hedef hba1c_pct, X = glycaemic_status ve diğer beş değişken; yalnız ANOVA ağacını göstermek için).
70.5 Formüller ve hesap adımları
Hesap sırası: ortak hat (kategorik X'ler MerQur düzey sırasıyla düzey koduna, eksik satırlar atılır, tabakalı bölme; ölçekleme yok) → eğitim kümesinde ağacı büyüt (her düğümde tüm değişkenler ve tüm eşikler) → düğüm karmaşıklıkları → cp'de buda → iç CV ile cptable'a xerror/xstd → isteğe bağlı CV'ye dayalı cp seçimi ve yeniden budama → vekil bölmeler → değişken önemi → test metrikleri ve dış CV (classification.py:665–756, cart.py:796–843).
70.5.1 Düğüm riski ve safsızlık
Sınıflandırmada her gözlemin ağırlığı w_i=\pi_{y_i}\,n/N_{y_i}'dir (önsel yoksa w_i=1). Düğümün tahmini, riski ve safsızlığı:
- W_k(t)=\sum_{i\in t,\,y_i=k}w_i, W(t)=\sum_k W_k(t), p_k(t)=W_k(t)/W(t).
- R(t): düğümde yanlış sınıflanan (ağırlıklı) gözlem sayısı; eşitlikte sınıf listesindeki ilk sınıf (MerQur düzey sırası) tahmin edilir.
- Entropide doğal logaritma kullanılır (rpart "information").
- Regresyonda \hat y(t)=\bar y_t, R(t)=\sum_{i\in t}(y_i-\bar y_t)^2.
Bölme Gini ile, budama yanlış sınıflamayla: neden iki ölçüt?
Yanlış sınıflama sayısı bölme seçimi için kötü bir ölçüttür: iki çocuğun çoğunluk sınıfı aynıysa saflığı belirgin biçimde artıran bir bölme bile riski hiç azaltmaz (Breiman vd. 1984, §4.1). Gini ve entropi saflıktaki her iyileşmeyi ödüllendirir. Budama ise modelin asıl amacına, yani yanlış sınıflamaya göre yapılır. Tıp örneğindeki 6. düğüm bunun örneğidir (70.6, Adım 4).
70.5.2 Bölme arama ve iyileşme
- Sayısal X'te adaylar ardışık iki farklı değerin orta noktasıdır; kategorik X'te düzeylerin iki gruba ayrılışları.
- Geçerli bölme: düğümde n\ge minsplit, derinlik < maxdepth, her çocukta \ge minbucket gözlem.
- En büyük iyileşmeli bölme seçilir; göreli 10^{-10} içinde eşitlikte formüldeki ilk değişken ve ilk eşik (
cart.py:127–130). - Sol çocuk, hedef ortalaması (sınıflandırmada sınıf kodu ortalaması) küçük olan taraftır; düğüm numaraları rpart'taki gibidir (kök 1, çocuklar 2t ve 2t+1).
- Regresyonda iyileşme düğüm KT'sine oranlıdır (rpart tanımı); değişken öneminde yeniden \Delta\text{KT}'ye çevrilir.
Kategorik X'te iki sınıflı hedefte ve regresyonda düzeyler sınıf/hedef ortalamasına göre sıralanır ve yalnız L-1 "önek" ayrımı denenir; bu, 2^{L-1}-1 ayrımın hepsini denemekle aynı sonucu verir (Breiman vd. 1984, Teorem 4.5). Üç ve daha çok sınıfta teorem geçmez; bütün ayrımlar denenir (cart.py:392–466).
70.5.3 Maliyet-karmaşıklık ve cp
Bir alt ağaç T için maliyet-karmaşıklık ölçütü ve bir iç düğümün "en zayıf halka" değeri:
- \tilde T: yapraklar kümesi; T_t: t'den başlayan dal; R(T_t): dalın yapraklarının risk toplamı.
- g(t): dal budandığında risk artışının, kaybedilen bölme başına değeri.
- cp, α'nın kök riskine oranıdır: "bir bölme göreli hatayı en az cp kadar azaltmalı".
Bir düğümün karmaşıklığı, budanması için gereken en küçük cp'dir. "Verilen cp" budaması karmaşıklığı \le cp olan bütün iç düğümleri yaprağa çevirir (cart.py:535–552). cptable, farklı karmaşıklık değerlerini büyükten küçüğe dizer: satır j'nin ağacı \text{CP}_j\le\text{cp}<\text{CP}_{j-1} aralığında en iyidir; "Göreli hata" o ağacın risk toplamının kök riskine oranıdır; son satırın CP'si kullanıcının cp'sidir (cart.py:554–567).
70.5.4 İki karmaşıklık hesabı
Kesin en zayıf halka (Breiman vd. 1984, §3.3): ağaç tam büyütülür; en küçük g(t)'li dal çökertilir, g'ler yeniden hesaplanır, tekrarlanır (cart.py:478–524).
Büyütme sırasında (rpart; Therneau ve Atkinson; varsayılan): her düğüm, atasının geçici karmaşıklığından türetilen bir üst sınırla büyütülür; çocuklar büyüdükten sonra "önce hangi çocuk çöker" sırası gözetilerek düğüm karmaşıklığı hesaplanır ve α'yı aşmayan dal büyütme sırasında yaprağa döner (cart.py:227–300):
- R_L^{*}, s_L^{*}: sol dalın, karmaşıklığı c(t)'yi aşmayan kısmı çöktükten sonra kalan risk ve bölme sayısı (çocuğun karmaşıklığı c(t)'den küçükse çocuk yaprak sayılır); sağ için aynı.
- Bir düğümün karmaşıklığı atasınınkini aşamaz.
- Göreli 10^{-9} içindeki karmaşıklıklar birleştirilir (kayan nokta kaynaklı yinelenen satırları önler).
İki hesap ne zaman ayrılır?
Kendi risk azalışı 0 olan bölmeler (çoğunluk sınıfı değişmeyen bölmeler) ve bu tür dalları içeren derin ağaçlarda iki hesap farklı CP ve xerror verebilir; en zayıf halka daha çok yapraklı ağaç bırakabilir. Tıp verisinin tamamında (550 hasta, yalnız dört sayısal X, cp = 0) minsplit = 10 iken bölme sayıları aynı, üç CP farklıdır (ör. 0,005576 / 0,005948); minsplit = 6 iken büyütme hesabı 13 ve 43 bölmeli, en zayıf halka 11 ve 32 bölmeli ara ağaçlar verir (dogrulama/decision_tree/cp_kurali_farki.py). Bölümdeki eğitim kümesi çalıştırmalarında (minsplit 20 ve 10, altı X) iki hesap aynıdır. R rpart ile birebir karşılaştırma için "büyütme sırasında" seçilmelidir.
70.5.5 İç CV: xerror ve xstd
Kat ataması tohumla yapılır: V katlık etiketler 1{,}2,\dots,V,1{,}2,\dots biçiminde n uzunluğa getirilir ve numpy.random.default_rng(tohum).permutation ile karıştırılır (rpart'taki sample(rep(1:xval, length = n)) tanımı; cart.py:746–749). Her kat dışarıda bırakılır, ağaç kalan katlarda aynı denetimlerle büyütülür, her cptable satırı için şu cp'de budanır:
Dışarıdaki gözlemler tahmin edilir ve \ell_{ij} kaybı (yanlış sınıflama × ağırlık ya da kare hata) toplanır:
- Geometrik ortalama, satır j'nin ağacının en iyi olduğu aralığın "ortası"dır.
- Katın karmaşıklık eşikleri tam verinin kök riskiyle, katın ağırlık payına oranlanır (
cart.py:720–726). - 1-SE kuralı: en küçük xerror'lu satır j^{*} ise \text{xerror}_j\le\text{xerror}_{j^{*}}+\text{xstd}_{j^{*}} olan ilk (en küçük) ağacın CP'si seçilir (
cart.py:752–760).
İki ayrı CV
Çıktıdaki "5-katlı CV doğruluğu" ortak hattın dış CV'sidir (tabakalı, karıştırmalı; her katta ağaç ve iç CV yeniden çalışır). cptable'daki xerror ise iç CV'dir (rastgele, tabakasız, xval kat). İkisi farklı amaçlara hizmet eder ve farklı sayılar verir. Kat (grup) sütunu verilirse iç CV de o grupları kullanır (cart.py:811–818).
R rpart ile xerror farkı
Aynı tohum R'de farklı kat ataması verir; xerror ve xstd ancak aynı kat vektörü rpart.control(xval = <vektör>) ile verilince birebir eşleşir (70.6.1). Ağaç, rel error ve budama verilen cp'de katlardan bağımsızdır.
70.5.6 Vekil bölmeler ve değişken önemi
Birincil bölme s^{*} bir düğümü sol ve sağa ayırır; çoğunluk yönü m=\max(n_L,n_R) gözlemi doğru "tahmin eder". Bir başka değişkenle kurulabilecek en iyi taklit bölme vekildir:
- Sayısal vekil her iki yana en az 2 gözlem göndermeli; kategorik vekilde her düzey, gözlemlerinin çoğunun gittiği yana atanır ve en az 2 uyumsuz gözlem gerekir.
- Uyumu çoğunluk kuralından iyi olmayan (\text{adj}\le0) vekil atılır; en çok 5 vekil tutulur.
- İlk toplam: j'nin birincil bölme olduğu düğümler; ikinci: j'nin vekil olduğu düğümler.
- Regresyonda improve, \Delta\text{KT} birimine çevrilir: improve × KT(t).
- Yarışan (competitor) bölmeler öneme katılmaz. MerQur ham değeri ve yüzde payını yazar; R
summary()yalnız tam sayıya yuvarlanmış yüzdeyi yazar.
Neden vekiller öneme giriyor?
Birincil bölmeye neredeyse aynı ayrımı yapan bir değişken, ağaçta hiç görünmese de güçlü bir ayırıcıdır. Yalnız birincil bölmeleri saymak, ilişkili değişkenlerden birini yapay olarak sıfırlar. Vekil ağırlığı adj, bu değişkenin çoğunluk kuralının ötesinde ne kadar bilgi taşıdığıdır.
70.5.7 Tahmin ve olasılık
Test gözlemi kökten yaprağa indirilir; tahmin yaprağın sınıfı, olasılıklar yaprağın (önsel ağırlıklı) sınıf paylarıdır. Bir kategorik bölmede düğümde hiç görülmemiş bir düzey gelirse sırayla vekiller, hiçbiri kullanılamazsa kalabalık çocuk kullanılır (rpart usesurrogate = 2). Test metrikleri, dış CV, ek metrikler ve permütasyon önemi ortak hattadır (67.5.6–67.5.7).
70.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/decision_tree/elle_hesap.py ile hesaplanmıştır. Betik MerQur'u ve rpart'ı çağırmaz: bölmeyi MerQur'un tanımıyla kurar; ağacı tüm değişken ve eşikleri tarayarak büyütür, en zayıf halka karmaşıklığını, cptable'ı, vekilleri, önemi, test metriklerini ve dış CV'yi numpy ile hesaplar. Sınıf sırası MerQur düzey sırasıdır (verideki ilk görülme): prediabetes (0), diabetes (1), normoglycaemic (2); aile öyküsü düzeyleri yes, no, unknown.
Adım 1 — Kök. Eğitim 440: (123, 92, 225). Tahmin normoglycaemic; kök riski R=440-225=215. Gini:
Adım 2 — Kökte değişken başına en iyi bölme. minbucket = round(20/3) = 7. Her değişkenin en iyi bölmesi (rpart "primary" ve "competitor" satırları):
| Değişken | En iyi bölme | Sol (n; sınıflar) | Sağ (n; sınıflar) | improve |
|---|---|---|---|---|
| hba1c_pct | < 6,85 / ≥ 6,85 | 355; (119, 16, 220) | 85; (4, 76, 5) | 76,7073 |
| bmi | < 31,85 / ≥ 31,85 | 329; (47, 66, 216) | 111; (76, 26, 9) | 51,9445 |
| family_history | {yes} / | 168; (75, 29, 64) | 272; (48, 63, 161) | 12,5521 |
| systolic_bp | < 158,5 / ≥ 158,5 | 428; (118, 86, 224) | 12; (5, 6, 1) | 3,5361 |
| age | < 28,5 / ≥ 28,5 | 16; (2, 8, 6) | 424; (121, 84, 219) | 2,1105 |
| sex | F / M | 232; (63, 43, 126) | 208; (60, 49, 99) | 0,8025 |
HbA1c bölmesinin iyileşmesi:
HbA1c ≥ 6,85 tarafının sınıf kodu ortalaması küçüktür (86/85 = 1,01; öteki tarafta 456/355 = 1,28); bu yüzden o taraf sol çocuk (düğüm 2) olur.
Adım 3 — Kökün vekilleri. Çoğunluk yönü 355 gözlemdir. age ≥ 82,5 ve systolic_bp ≥ 164,5 bölmelerinin her biri 356 gözlemde birincil bölmeyle aynı yöne gönderir: uyum 356/440=0{,}809091, \text{adj}=(356-355)/(440-355)=1/85=0{,}011765.
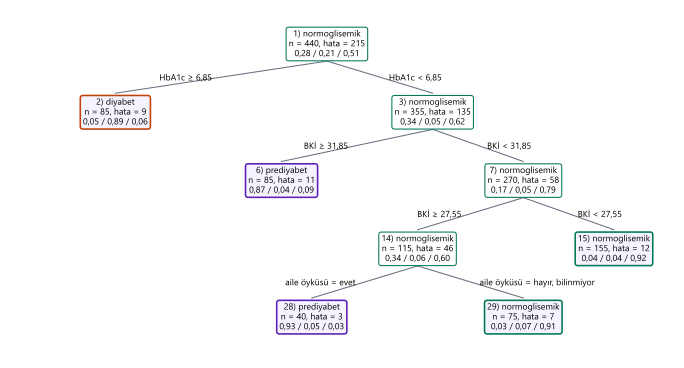
Adım 4 — Büyüyen ağaç ve riskler. Budanmış ağacın düğümleri (n; risk; tahmin): 1 (440; 215), 2: HbA1c ≥ 6,85 (85; 9; diabetes, yaprak), 3: HbA1c < 6,85 (355; 135), 6: BKİ ≥ 31,85 (85; 11; prediabetes, yaprak), 7: BKİ < 31,85 (270; 58), 14: 27,55 ≤ BKİ < 31,85 (115; 46), 15: BKİ < 27,55 (155; 12; normoglycaemic, yaprak), 28: aile öyküsü {yes} (40; 3; prediabetes, yaprak), 29: aile öyküsü {no, unknown} (75; 7; normoglycaemic, yaprak).
Düğüm 7'nin bölmesi (BKİ < 27,55) riski hiç azaltmaz: 58\to12+46=58; iki çocuğun da çoğunluk sınıfı normoglycaemic'tir. Gini iyileşmesi ise 12,8605'tir. Bölme, ancak 14. düğümün aile öyküsü bölmesiyle (46\to7+3) birlikte değer kazanır.
Adım 5 — Karmaşıklıklar ve cptable.
Göreli hatalar: 1; 144/215=0{,}669767; 78/215=0{,}362791; 42/215=0{,}195349. Tam büyütülmüş ağacın (cp = 0'da 26 bölme) geri kalan bütün dallarının risk azalışı 0'dır; cp = 0 ile bile aynı 4 bölmeli ağaç kalır.
| CP | nsplit | rel error | xerror | xstd | |
|---|---|---|---|---|---|
| 1 | 0,330233 | 0 | 1 | 1 | 0,048769 |
| 2 | 0,306977 | 1 | 0,669767 | 0,702326 | 0,046320 |
| 3 | 0,083721 | 2 | 0,362791 | 0,367442 | 0,037446 |
| 4 | 0,010000 | 4 | 0,195349 | 0,195349 | 0,028668 |
xerror ve xstd, default_rng(42) ile atanan 10 iç katla elde edilir (eğitim kümesinin ilk on gözleminin katları: 1, 4, 5, 2, 2, 4, 10, 1, 4, 3). 1-SE eşiği 0{,}195349+0{,}028668=0{,}224017; eşiği yalnız 4. satır sağlar.
Adım 6 — Değişken önemi. Birincil iyileşmeler: düğüm 1 HbA1c 76,7073; düğüm 3 BKİ 62,9182; düğüm 7 BKİ 12,8605; düğüm 14 aile öyküsü 41,3378. Vekil katkılarıyla:
HbA1c 76,8191 (düğüm 7'de 0,0087 adj'lı vekil), aile öyküsü 41,4497, sistolik KB 6,9636 (yalnız vekil: düğüm 1, 3 ve 14), yaş 1,0143 (yalnız vekil). Cinsiyetin önemi 0'dır.
Adım 7 — Test kümesi. Karışıklık matrisi (satır gerçek; prediabetes, diabetes, normoglycaemic):
| prediabetes | diabetes | normoglycaemic | |
|---|---|---|---|
| prediabetes | 26 | 2 | 3 |
| diabetes | 1 | 19 | 3 |
| normoglycaemic | 5 | 0 | 51 |
Doğruluk 96/110=0{,}872727; ağırlıklı kesinlik 0,873657, F1 0,872724; makro AUC 0,884372 (yaprak olasılıkları yalnız 5 farklı değer alır; AUC'de çok sayıda bağ vardır). Dış CV (5 kat): 0,943182; 0,886364; 0,920455; 0,886364; 0,886364 (ortalama 0,9045, SS 0,0262). Ek metrikler: κ = 0,7928; MCC 0,7931; dengeli doğruluk 0,8585; NIR =56/110=0{,}5091. Permütasyon önemi: HbA1c 0,259; BKİ 0,238; aile öyküsü 0,061; diğerleri 0 (ağaçta kullanılmazlar).
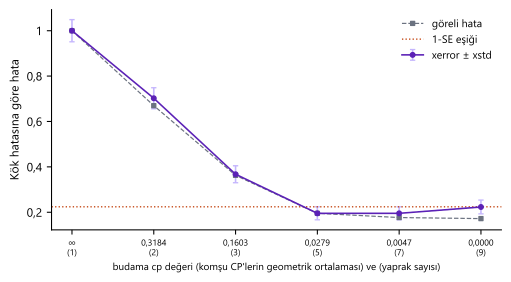
Adım 8 — Diğer ayarlar. Entropide kök iyileşmesi 131,8312'dir (doğal log ölçeği), ağaç aynıdır. Eşit önsellerle (dengeli ağırlık) aynı ağaç, farklı risk ölçeği: CP (0,401932; 0,283035; 0,074092; 0,01). "En küçük CV hatası" ve "1-SE" budaması (cp = 0, minsplit = 20) aynı 4 bölmeli ağacı seçer. cp = 0 ve minsplit = 10'da cptable 6 satıra çıkar (CP 0,009302 / 0,002326 / 0: 4, 6 ve 8 bölme; göreli hata 0,195349 / 0,176744 / 0,172093); xerror 4. ve 5. satırda eşittir (0,195349) ve 8 bölmede 0,223256'ya yükselir. En küçük xerror'un ilk satırı alındığından bu tabloda da 4 bölmeli ağaç seçilir; eğitim hatası azalırken CV hatasının artması aşırı uyumdur (Şekil 70.2). Tohum 7 ile bölme değişir; kök (HbA1c) ve 3. düğüm (BKİ) aynı karmaşıklığı (0,327907) alır ve cptable 0 bölmeden doğrudan 2 bölmeye atlar; test doğruluğu 0,9182.
Adım 9 — Regresyon ağacı. Hedef HbA1c; kök KT 372,1098. Kök bölmesi glycaemic_status = {prediabetes, normoglycaemic} / {diabetes}: improve 0,336293, yani \Delta\text{KT}=0{,}336293\times372{,}1098=125{,}1378. Sonra cinsiyet ve sistolik KB bölmeleri; cp = 0,01'de 3 bölme, 4 yaprak. Test R^2=0{,}296163, RMSE 0,859756, MAE 0,680062; dış CV R^2 ortalaması 0,2868.
Şekil 70.1. Tıp örneğinin budanmış ağacı (cp = 0,01). Kutularda düğüm numarası, tahmin, gözlem sayısı, yanlış sınıflanan sayısı ve sınıf olasılıkları (prediyabet / diyabet / normoglisemik); dolgulu kutular yapraktır.
Şekil 70.2. CP grafiği (cp = 0, minsplit = 10): iç 10 katlı CV hatası ± xstd, eğitimdeki göreli hata ve 1-SE eşiği. Alt eksende budama cp'si (komşu CP'lerin geometrik ortalaması) ve yaprak sayısı.
70.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan alınmıştır (ml.classification ad alanında round bellekte devre dışı; ml.cart'taki round hesap mantığı olduğundan değiştirilmemiştir). R: 4.5.3, rpart 4.1.24; aynı eğitim satırları, rpart.control(cp, minsplit, maxdepth = 30, xval = <MerQur'un kat vektörü>), faktör düzeyleri MerQur düzey sırasıyla (verideki ilk görülme); dış CV aynı 5 katla, her katta xval = 0.
xerror ve xstd satırlarında bağımsız Python sütunu boştur: iç CV her katta ağacın yeniden büyütülmesini ve büyütme sırasında karmaşıklık hesabını gerektirir; başvuru, aynı kat vektörüyle R rpart'tır. Bu satırlar dışında üç kaynak da doludur.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 (rpart) | En büyük fark | Durum |
|---|---|---|---|---|---|
| Kök: birincil + 4 yarışan bölmenin iyileşmesi (Gini; gösterilen hba1c_pct) | 76,707317 | 76,707317 | 76,707317 | 2,8e−14 | ✓ |
| Kök: vekil bölmelerin düzeltilmiş uyumu adj (age, systolic_bp) | 0,011765 | 0,011765 | 0,011765 | 2,6e−16 | ✓ |
| cptable CP (4 satır) | 0,330233 | 0,330233 | 0,330233 | 5,6e−16 | ✓ |
| cptable bölme sayısı nsplit | 0,000000 | 0,000000 | 0,000000 | 0,0e+00 | ✓ |
| cptable göreli hata (rel error) | 1 | 1 | 1 | 3,9e−16 | ✓ |
| cptable xerror (iç 10 katlı CV) | 1 | — | 1 | 3,3e−16 | ✓ (aynı katlar) |
| cptable xstd | 0,048769 | — | 0,048769 | 9,0e−17 | ✓ (aynı katlar) |
| Düğüm gözlem sayıları n (9 düğüm) | 440 | 440 | 440 | 0,0e+00 | ✓ |
| Düğüm riskleri (yanlış sınıflanan; 9 düğüm) | 215 | 215 | 215 | 0,0e+00 | ✓ |
| Düğüm sınıf olasılıkları (9 × 3) | 0,279545 | 0,279545 | 0,279545 | 4,4e−16 | ✓ |
| Değişken önemi (5; gösterilen hba1c_pct) | 76,819148 | 76,819148 | 76,819148 | 5,7e−14 | ✓ |
| Test olasılıkları (110 × 3) | 0,038710 | 0,038710 | 0,038710 | 4,4e−16 | ✓ |
| Test doğruluğu | 0,872727 | 0,872727 | 0,872727 | 3,3e−16 | ✓ |
| Test kesinliği (ağırlıklı) | 0,873657 | 0,873657 | 0,873657 | 4,4e−16 | ✓ |
| Test duyarlılığı (ağırlıklı) | 0,872727 | 0,872727 | 0,872727 | 4,4e−16 | ✓ |
| Test F1 (ağırlıklı) | 0,872724 | 0,872724 | 0,872724 | 1,1e−16 | ✓ |
| Test ROC-AUC (bire-karşı-diğerleri, makro) | 0,884372 | 0,884372 | 0,884372 | 5,6e−16 | ✓ |
| Dış 5 katlı CV doğrulukları (5) | 0,943182 | 0,943182 | 0,943182 | 4,4e−16 | ✓ |
| Aynı tohumla ikinci çalıştırma: test olasılıkları | 0,038710 | 0,038710 | — | 0,0e+00 | ✓ (birebir) |
| cp = 0: CP | 0,330233 | 0,330233 | 0,330233 | 5,6e−16 | ✓ |
| cp = 0, minsplit = 10: CP (6 satır) | 0,330233 | 0,330233 | 0,330233 | 5,6e−16 | ✓ |
| cp = 0, minsplit = 10: rel error | 1 | 1 | 1 | 3,9e−16 | ✓ |
| cp = 0, minsplit = 10: xerror | 1 | — | 1 | 3,6e−16 | ✓ |
| cp = 0, minsplit = 10: test olasılıkları | 0,044118 | 0,044118 | 0,044118 | 4,4e−16 | ✓ |
| Budama 'en küçük CV hatası': seçilen CP | 0,000000 | — | 0,000000 | 0,0e+00 | ✓ |
| Budama '1-SE': seçilen CP | 0,000000 | — | 0,000000 | 0,0e+00 | ✓ |
| Entropi: değişken önemi (5) | 132,037925 | 132,037925 | 132,037925 | 2,0e−13 | ✓ |
| Entropi: test olasılıkları | 0,038710 | 0,038710 | 0,038710 | 4,4e−16 | ✓ |
| Dengeli (eşit önsel): cptable rel error | 1 | — | 1 | 7,8e−16 | ✓ |
| Dengeli: xerror | 1,092157 | — | 1,092157 | 3,8e−15 | ✓ |
| Dengeli: değişken önemi | 100,410539 | — | 100,410539 | 5,0e−13 | ✓ |
| Dengeli: test olasılıkları | 0,065079 | — | 0,065079 | 4,4e−16 | ✓ |
| Tohum 7: CP | 0,327907 | 0,327907 | 0,327907 | 5,6e−17 | ✓ |
| Tohum 7: xerror | 1 | — | 1 | 3,6e−16 | ✓ |
| Tohum 7: test doğruluğu | 0,918182 | 0,918182 | 0,918182 | 2,2e−16 | ✓ |
| Regresyon ağacı (anova): CP | 0,336293 | 0,336293 | 0,336293 | 8,9e−16 | ✓ |
| Regresyon: rel error | 1 | 1 | 1 | 2,1e−15 | ✓ |
| Regresyon: xerror | 1,006538 | — | 1,006538 | 8,0e−15 | ✓ |
| Regresyon: değişken önemi (ΔSS; 6) | 125,137778 | 125,137778 | 125,137778 | 2,3e−12 | ✓ |
| Regresyon: test tahminleri (110) | 7,090909 | 7,090909 | 7,090909 | 4,4e−15 | ✓ |
| Regresyon: test R² | 0,296163 | 0,296163 | 0,296163 | 2,8e−16 | ✓ |
| Regresyon: test RMSE | 0,859756 | 0,859756 | 0,859756 | 3,3e−16 | ✓ |
| Regresyon: dış 5 katlı CV R² (5) | 0,120158 | 0,120158 | 0,120158 | 3,9e−16 | ✓ |
43 satırın tümü 10^{-6} ölçütünü sağlar; en büyük fark regresyon öneminde 2\times10^{-12}'dir (kayan nokta toplama sırası). Tohum yalnız bölmeyi, dış CV katlarını ve iç CV katlarını belirler; aynı tohumla iki çalıştırma bit düzeyinde aynıdır. CART ağacının kendisi deterministiktir.
70.7 Çıktıyı okuma
Sonuç metni (varsayılanlar; kısaltılmış):
CART Sınıflandırma
  Hedef               = glycaemic_status
  Sınıflar            = prediabetes, diabetes, normoglycaemic
  Algoritma           = CART (özyinelemeli bölümleme)
  Ön işleme           = ... Ölçekleme uygulanmadı (ağaç; bölme eşikleri özgün birimde). Kategorik X'ler alt küme bölmeleriyle kullanıldı (düzey kodları MerQur düzey sırasında): family_history, sex.
  Kullanılan düzey sırası (family_history): yes, no, unknown
  Kullanılan düzey sırası (sex): F, M

  ── Test Performansı ──
  Doğruluk            = 0.8727
  ...
    ↳ Kesinlik, duyarlılık ve F1 sınıfların gözlem sayısıyla ağırlıklı ortalamasıdır
      (ağırlıklı duyarlılık doğruluğa eşittir); sınıf bazında değerler sınıflandırma raporundadır.
  ROC-AUC             = 0.8844
  5-katlı CV doğruluğu= 0.9046 (±0.0262)
...
── CART ağaç ayrıntıları ──
  Ayrım ölçütü = Gini
  Denetim: minsplit = 20, minbucket = 7, maxdepth = 30, cp = 0.01, xval = 10
  Karmaşıklık (cp) hesabı = büyütme sırasında (önce çöken dal; cp'yi aşmayan dal büyütülmez)
  Budama: karmaşıklık parametresi cp = 0.01 → 5 yaprak, 4 bölme, derinlik 4 (ağaç n = 440 gözlemle kuruldu)

── Karmaşıklık parametresi tablosu ──
  CV hatası ve CV SS: iç CV (xval; tabakasız rastgele katlar). Model değerlendirmesindeki
  CV doğruluğu ayrı bir dış CV'dir (tabakalı).
              CP   Bölme Göreli hata CV hatası     CV SS
    1   0.330233       0    1.000000  1.000000  0.048769
    2   0.306977       1    0.669767  0.702326  0.046320
    3   0.083721       2    0.362791  0.367442  0.037446
    4   0.010000       4    0.195349  0.195349  0.028668
  En küçük CV hatası = 0.1953 (CV SS = 0.0287); 1-SE eşiği = 0.2240 (CV hatası ≤ eşik olan en küçük ağaç)
  Kök düğüm hatası (göreli hata 1'in karşılığı) = 215, n = 440

── Ağaç: düğüm) bölme, n, kayıp, tahmin, (sınıf olasılıkları); * = yaprak ──
  1) kök 440 215 normoglycaemic (0.280 0.209 0.511)
    2) hba1c_pct >= 6.85 85 9 diabetes (0.047 0.894 0.059) *
    3) hba1c_pct < 6.85 355 135 normoglycaemic (0.335 0.045 0.620)
      6) bmi >= 31.85 85 11 prediabetes (0.871 0.035 0.094) *
      7) bmi < 31.85 270 58 normoglycaemic (0.167 0.048 0.785)
        14) bmi >= 27.55 115 46 normoglycaemic (0.339 0.061 0.600)
          28) family_history = yes 40 3 prediabetes (0.925 0.050 0.025) *
          29) family_history = no,unknown 75 7 normoglycaemic (0.027 0.067 0.907) *
        15) bmi < 27.55 155 12 normoglycaemic (0.039 0.039 0.923) *

── Karar kuralları (eğer-ise; her yaprak için) ──
  [1] EĞER hba1c_pct >= 6.85 İSE diabetes (n = 85, %19.3); olasılık = 0.894
  [3] EĞER hba1c_pct < 6.85 VE 27.55 <= bmi < 31.85 VE family_history = yes İSE prediabetes (n = 40, %9.1); olasılık = 0.925
...
── Değişken önemi (birincil + vekil bölmeler) ──
  hba1c_pct                     76.8191   (%37.8)
  bmi                           76.8122   (%37.8)
  family_history                41.4497   (%20.4)
  systolic_bp                    6.9636    (%3.4)
  age                            1.0143    (%0.5)
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Budama satırı | Kural, seçilen cp, yaprak, bölme, derinlik. | CV budamasında seçilen CP, cptable'daki satırın CP'sidir. |
| cptable | CP, bölme sayısı, göreli hata, CV hatası (xerror), CV SS (xstd). | xerror'un düzleştiği yerden sonrası aşırı uyumdur; 1-SE kuralı en sade ağacı seçer. |
| Kök düğüm hatası | Göreli hata 1'in mutlak karşılığı. | Mutlak hata = göreli hata × kök hatası (ör. 0,1953 × 215 = 42 yanlış sınıflama). |
| Ağaç listesi | rpart print() biçimi: düğüm, koşul, n, kayıp, tahmin, olasılıklar. |
Sol çocuk her zaman ilk yazılır; koşulun yönü veriye göre "<" ya da "≥" olabilir. |
| Karar kuralları | Her yaprak için sadeleştirilmiş koşullar, n, %, olasılık. | Klinik kural metni; olasılık yaprağın eğitim payıdır. |
| Değişken önemi | Ham değer ve yüzde. | Vekiller dahildir; ağaçta görünmeyen değişken önem alabilir (age, systolic_bp). |
| Tablo sekmesi | cptable (rpart printcp). |
— |
| Grafik | Ağaç diyagramı (40 yaprağı aşarsa derinlik kesilir), CP grafiği, önem. | — |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Glisemik durum (normoglisemi, prediyabet, diyabet), HbA1c, beden kitle indeksi (BKİ), yaş, sistolik kan basıncı, aile öyküsü ve cinsiyetten bir sınıflandırma ağacıyla (CART; Gini ölçütü; minsplit = 20, minbucket = 7) tahmin edildi. Ağaç eğitim kümesinde (n = 440) büyütülüp karmaşıklık parametresi cp = 0,01'de budandı; on katlı iç çapraz doğrulama hatası bu ağaçta en küçüktü (göreli hata 0,195 ± 0,029). Beş yapraklı ağaç (derinlik 4) HbA1c ≥ %6,85'i diyabet, HbA1c < %6,85 iken BKİ ≥ 31,85 kg/m²'yi ya da BKİ 27,55–31,85 kg/m² ve pozitif aile öyküsünü prediyabet olarak sınıfladı. Test kümesinde (n = 110) doğruluk 0,873 (Cohen \kappa = 0{,}79; makro ortalama AUC 0,884), eğitim kümesinde beş katlı çapraz doğrulama doğruluğu 0{,}905 \pm 0{,}026 idi.
70.8 Uzman soruları
S1. MerQur'un ağacı rpart'la birebir aynı mı?
Eksik değer yoksa ve "büyütme sırasında" cp hesabı seçiliyse evet: Tıp örneğinde bölmeler, iyileşmeler, vekiller, cptable (xerror dahil, aynı kat vektörüyle), önem ve test olasılıkları 10^{-12} içinde aynıdır. Bilinen iki fark: (1) iyileşmesi göreli 10^{-10} içinde eşit iki eşikte MerQur ilkini seçer, rpart kayan nokta karşılaştırmasına göre diğerini seçebilir (cart.py:23–28); (2) eksik X'li gözlemler MerQur'da atılır, rpart'ta vekillerle tutulur.
S2. Aynı tohumla R'de neden farklı xerror alıyorum?
Kat ataması R'nin sample() üretecine, MerQur'unki numpy'ye dayanır; aynı tohum farklı katlar verir. xerror, xstd ve CV'ye dayalı budama seçimi bu yüzden farklıdır. Ağacın kendisi, rel error ve verilen cp'deki budama katlardan bağımsızdır. Birebir karşılaştırma için MerQur'un kat vektörü (ml.cart.xval_groups) R'ye xval olarak verilmelidir.
S3. Riski azaltmayan bir bölme neden ağaçta duruyor?
Bölme Gini ile seçilir, budama yanlış sınıflamayla yapılır. Tıp örneğinde 7. düğümün BKİ < 27,55 bölmesi tek başına yanlış sınıflamayı azaltmaz, ama 14. düğümdeki aile öyküsü bölmesinin önünü açar. Karmaşıklık dal için hesaplandığından (58\to22, iki bölme, c=18) ikisi birlikte 0,0837'lik bir CP ile kalır. Tek başına değerlendirilse budanırdı.
S4. "Büyütme sırasında" ile "en zayıf halka" ne zaman farklı sonuç verir?
Büyütme hesabı, karmaşıklığı α'yı aşmayan dalları büyütme sırasında yaprağa çevirir ve "önce hangi çocuk çöker" sırasını gözetir; en zayıf halka tam ağaç üzerinde global sırayla çökertir. Kendi risk azalışı 0 olan bölmeleri içeren derin dallarda CP değerleri ve ara ağaç büyüklükleri ayrılabilir (Tıp verisinin tamamında, dört sayısal X ile cp = 0, minsplit = 6: büyütme hesabında 13 ve 43, en zayıf halkada 11 ve 32 bölmeli ara ağaçlar). Global en zayıf halka sırasıyla budanmış ağaç isteniyorsa "kesin en zayıf halka" seçilir.
S5. Çok sınıflı hedefte kategorik X nasıl bölünüyor?
İki sınıfta ve regresyonda düzeyler ortalamaya göre sıralanıp yalnız L-1 önek ayrımı denenir; bu, en iyi ayrımı garanti eder. Üç ve daha çok sınıfta bu garanti yoktur ve 2^{L-1}-1 ayrımın hepsi denenir; 16'dan çok düzeyde MerQur hata verir. Tıp örneğinde aile öyküsü (3 düzey) için 3 ayrım denenir; kökte en iyisi {no, unknown} / {yes}'tir. "Kukla" seçeneğinde her düzey ayrı 0/1 değişken olur ve ağaç aynı ayrımı iki adımda kurmak zorunda kalabilir.
S6. Test kümesi küçük ya da çok küçük örneklemde ne olur?
Eğitim kümesi xval'den küçükse iç CV yapılamaz; CV'ye dayalı budama seçilmiş olsa bile kullanıcı cp'si uygulanır ve çıktı "iç CV yapılamadı" diye yazar (12 satırlı örnekte doğrulandı). Dış CV'nin katlarında da aynı şey olabilir. Küçük örneklemde "Test oranı = Yok (tüm veri)" seçilip iç CV'ye dayalı budama kullanılabilir; metrikler o zaman eğitim verisindedir ve iyimserdir.
S7. Değişken önemi neden ağaçta görünmeyen değişkenlere pay veriyor?
Vekil katkıları yüzünden: yaş ve sistolik KB hiç birincil bölme değildir, ama bazı düğümlerde çoğunluk kuralından biraz iyi taklit bölmeler kurar (adj 0,012–0,075). rpart'la aynı tanımdır. Yarışan bölmeler (ikinci en iyi) öneme katılmaz; BKİ'nin kökteki 51,94'lük yarışan iyileşmesi bu yüzden sayılmaz.
S8. Eşit önseller (dengeli ağırlık) neyi değiştirir?
Her gözlem \pi_k n/N_k ağırlığı alır; riskler, Gini, olasılıklar ve tahminler bu ağırlıklarla hesaplanır (rpart parms = list(prior = …)). Azınlık sınıfının yanlış sınıflanması pahalılaşır. Tıp örneğinde ağaç aynı kalır, ama CP'ler (0,402; 0,283; 0,074) ve yaprak olasılıkları değişir. Olasılıklar artık örneklemdeki sınıf payları değil, eşit önselli olasılıklardır.
70.9 Sık hatalar ve tuzaklar
- Tek ağacı kararlı sanmak. Tohum 7'de (başka bir bölme) kök aynı ama cptable 0'dan 2 bölmeye atlar; daha küçük veride ağaç yapısı tümden değişebilir. Kurallar dış CV ve farklı tohumlarla sınanmalıdır.
- xerror'u dış CV doğruluğuyla karıştırmak. İkisi farklı CV'lerdir (70.5.5).
- R ile karşılaştırırken kat vektörünü vermemek. Aynı tohum, R'de aynı katlar demek değildir.
- Eksik değerli veride rpart sonucu beklemek. MerQur eksik X'li satırları atar.
- Göreli hatayı yüzde hata sanmak. Göreli hata, kök hatasına oranıdır; mutlak hata için kök hatasıyla çarpın (0,195 × 215 = 42).
- cp = 0'ı "budama yok" sanmak. cp = 0'da da risk azalışı 0 olan dallar atılır; Tıp örneğinde 26 bölmelik tam ağaç 4 bölmeye iner.
- Küçük örneklemde "CV'de en küçük hata" ifadesine güvenmek. Eğitim n < xval ise CV yapılmamıştır.
- Yaprak olasılıklarını kalibre olasılık sanmak. Az gözlemli yapraklarda olasılıklar uç değerlidir; AUC'de çok bağ vardır.
70.10 Kaynaklar
- Breiman, L., Friedman, J. H., Olshen, R. A., & Stone, C. J. (1984/2017). Classification and regression trees. Chapman & Hall/CRC. https://doi.org/10.1201/9781315139470
- Hand, D. J., & Till, R. J. (2001). A simple generalisation of the area under the ROC curve for multiple class classification problems. Machine Learning, 45(2), 171–186. https://doi.org/10.1023/A:1010920819831
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2. baskı). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Loh, W.-Y. (2011). Classification and regression trees. WIREs Data Mining and Knowledge Discovery, 1(1), 14–23. https://doi.org/10.1002/widm.8
- Quinlan, J. R. (1986). Induction of decision trees. Machine Learning, 1(1), 81–106. https://doi.org/10.1007/BF00116251
- Strobl, C., Boulesteix, A.-L., Zeileis, A., & Hothorn, T. (2007). Bias in random forest variable importance measures: Illustrations, sources and a solution. BMC Bioinformatics, 8, 25. https://doi.org/10.1186/1471-2105-8-25
- Therneau, T. M., & Atkinson, E. J. (2023). An introduction to recursive partitioning using the RPART routines (rpart paketi belgesi, sürüm 4.1). Mayo Foundation.