29. Cohen'in Kappa Katsayısı
Analiz kimliği: kappa · Menü adı: Cohen's Kappa · Panel: gui/panels/analyses/kappa_coefficient.py (form 45–105, execute 128–175) · Motor: stats/hypothesis.py, HypothesisTests.kappa_coefficient (satır 6025–6218); ekler _kappa_q1_extras (2395–2498), çok değerlendirici fleiss_kappa (6222–6297) ve krippendorff_alpha (6299–6382)
29.1 Ne işe yarar
Cohen'in kappa katsayısı (κ), iki değerlendiricinin aynı birimleri aynı kategorilere ne ölçüde yerleştirdiğini, rastlantıyla beklenecek uyumu çıkararak ölçer. Cevapladığı soru şudur: "İki gözlemci, şansın açıklayabileceğinden ne kadar fazla uyuşuyor?"
- p_o: gözlenen (ağırlıklı) uyum oranı; ağırlıksız κ'da çapraz köşegendeki birimlerin oranı.
- p_e: iki değerlendirici birbirinden bağımsız kategori seçseydi beklenecek uyum oranı; iki marjinal dağılımın çarpımından gelir.
- 1-p_e: şansın üstünde ulaşılabilecek en büyük uyum payı. κ, bu payın ne kadarının gerçekleştiğini söyler.
κ = 1 tam uyum, κ = 0 şans düzeyinde uyum, κ < 0 şanstan kötü uyum demektir. Sıralı kategorilerde (evre, şiddet derecesi) ağırlıklı κ, uzak kategorilerdeki uyumsuzluğu yakın kategorilerdekinden daha çok cezalandırır.
Ne zaman kullanılır?
- İki patolog, iki radyolog, iki kodlayıcı aynı birimleri kategorik bir ölçekle değerlendirdiğinde.
- Nominal kategorilerde ağırlıksız κ; sıralı kategorilerde doğrusal ya da kuadratik ağırlıklı κ.
- Aynı değerlendiricinin iki zamandaki kararlarının tutarlılığında (değerlendirici içi güvenirlik).
Ne zaman kullanılmaz?
- Ölçüm sürekliyse (mm, mmHg): ICC (Intraclass Correlation) (Bölüm 87) ya da yöntem karşılaştırması için Bland-Altman (Bölüm 39).
- Üç ya da daha çok değerlendirici varsa: aynı paneldeki Çok değerlendirici seçeneği (Fleiss κ ya da Krippendorff α).
- Soru "iki değerlendiricinin kategori sıklıkları farklı mı?" ise: McNemar (2×2) ya da Bowker / Stuart–Maxwell (bu paneldeki ek çıktı). κ yüksekken marjinaller yine farklı olabilir.
- Değerlendiriciler farklı kategori setleri kullanıyorsa (ör. biri 3, öteki 5 düzeyli ölçek): κ tanımlı değildir; önce ölçekleri eşleyin.
Sık karıştırılan analizler. Ki-kare bağımsızlık testi iki değişkenin ilişkili olup olmadığını sınar; tam tersine sistematik uyumsuzluk da (A hep "evre 1" dediğinde B hep "evre 4" diyorsa) güçlü ilişki verir. κ ise yalnız köşegendeki uyumla ilgilenir. Yüzde uyum (p_o) şansı düzeltmez; tek kategori baskınsa yanıltıcı biçimde yüksek çıkar. ICC sürekli ölçümde aynı soruyu yanıtlar; kuadratik ağırlıklı κ, büyük örneklemde değerlendirici farkını da hata sayan mutlak uyum ICC'sine, ICC(A,1)'e eşittir (Fleiss ve Cohen 1973).
29.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Aynı birimler | Her satır aynı hastanın iki değerlendirmesidir. | Tasarımla sağlanır; aynı sütun iki kez seçilemez (stats_panel.py:5753–5755). |
| Ortak kategori seti | İki değerlendirici aynı kategori listesini kullanır. | Tablo iki sütunun kategori birleşimi üzerinden kare yapılır (hypothesis.py:6062–6068); yalnız bir tarafta görülen kategori, öteki tarafta 0 sıklıkla eklenir. |
| Birimler arası bağımsızlık | Hastalar birbirini etkilemez. | Denetlenmez. |
| Değerlendiricilerin bağımsızlığı | Biri ötekinin kararını görmeden karar verir. | Denetlenmez. |
| Sıralı ölçekte doğru sıra | Ağırlıklı κ, kategorilerin sırasına bağlıdır. | Sıra beş kurala göre belirlenir ve çıktıda yazılır; sıra tanınamazsa ağırlıklı κ'da uyarı (hypothesis.py:6176–6177). |
Eksik değer. pd.crosstab iki sütundan birinde eksik olan satırı tabloya almaz (hypothesis.py:6062): liste bazında silme. Künyedeki n de iki sütunun birlikte dolu olduğu satır sayısıdır (kappa_coefficient.py:199).
Uç durumlar.
- Tablo boşsa hata (
hypothesis.py:6070–6071). - p_e = 1 ise (iki değerlendirici de tek ve aynı kategoriyi kullanmışsa) κ = 0/0 tanımsızdır; MerQur κ, SE, GA ve p'yi "—" yazar ve uyarı ekler (
hypothesis.py:6103–6105,6178–6179). RDescTools::CohenKappaNaN verir. - Wald GA [-1;\ 1] aralığına kırpılır (
hypothesis.py:6130–6131). - Ağırlıklı κ'da sıra tanımlanamamışsa (verideki ilk görülme sırası) uyarı verilir; ağırlıksız κ sıraya bağlı olmadığından uyarı çıkmaz.
- Özel ağırlık matrisi k\times k değilse hata (
hypothesis.py:2467–2468).
29.3 Parametreler
Varsayılanlar kappa_coefficient.py:45–123 içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Gözlemci 1 / Gözlemci 2 | ilk iki kategorik sütun | Tablonun satırı ve sütunu. | κ simetriktir; yer değiştirmek yalnız tablonun yönünü değiştirir. |
| Ağırlık | Ağırlıksız (nominal/binary) | Doğrusal ya da kuadratik uyum ağırlıkları. | κ, SE, GA ve p değişir. |
| Güven Düzeyi | %95 | z_{1-\alpha/2} | Yalnız GA ve karar. |
| Çok değerlendirici | Yok (Cohen κ, 2 değerlendirici) | Fleiss κ ya da Krippendorff α (nominal, sıralı, aralık, oran). | Bambaşka bir katsayı hesaplanır; Cohen'e özgü ekler yok sayılır ve not düşülür (kappa_coefficient.py:157–164). |
| Ek değerlendiriciler | işaretsiz | Çok değerlendiricili yöntemde 3., 4., … sütun. | Yalnız çok değerlendiricili yolda kullanılır. |
| Ek çıktılar: Kategori κ + simetri testleri | kapalı | Kategori başına κ, Bowker ve Stuart–Maxwell. | Ek satırlar. |
| Ek çıktılar: PABAK / κ_max | kapalı | Prevalans ve yanlılık düzeltmeli uyum, ulaşılabilir en büyük κ. | Ek satır. |
| Ek çıktılar: Bootstrap GA | kapalı | B = 2000 yüzdelik bootstrap GA. | Ek satır; tohuma bağlı. |
| Özel ağırlık matrisi | boş | Kullanıcı tanımlı w_{ij} ile ek κ. | Ek satır; ana κ değişmez. |
| Kategori sırası | boş (otomatik) | Ağırlıklı κ ve sıralı Krippendorff α için sıra. | Ağırlıklı κ'yı değiştirebilir. |
| Tohum | 12345 | Bootstrap rastgele sayı üreteci. | Yalnız bootstrap GA. |
Bootstrap tekrar sayısı formda yoktur; B = 2000 sabittir (hypothesis.py:2477). Tohum (seed) değeri aynı kaldıkça bootstrap GA her çalıştırmada aynıdır.
Kategori sırası neden bu kadar önemli?
Doğrusal ve kuadratik ağırlık, kategoriler arasındaki sıra uzaklığından hesaplanır: |i-j|. Metin etiketlerinde bu sıra veriden okunamaz. MerQur şu sırayı izler: (1) kullanıcının yazdığı sıra; (2) sıralı pandas Categorical düzeyleri; (3) bütün etiketler sayıysa sayısal sıra (2 < 10), hepsi sayı içeriyorsa doğal sıra ("evre 2" < "evre 10"); (4) bilinen sıralı sözcükler (düşük < orta < yüksek, Likert …); (5) bunlar yoksa verideki ilk görülme sırası ve "sıra tanımlanmadı" uyarısı. Alfabetik sıra kullanılmaz: "stage 10" gibi bir etiket alfabetik sırada "stage 1 < stage 10 < stage 2" diye dizilirdi. Tıp örneğinde etiketler "stage 1" … "stage 4" olduğundan doğal sıra uygulanır. Sıralı ölçekte alanı doldurmak en güvenli yoldur.
29.4 Tıp örneği
Dosya: english/datasets/Tip/25_kappa_cancer_stage_pathologist.xlsx (Türkçe kopya: samples/Tum_Analiz_Tip/25_kappa_kanser_evre_patolog.xlsx).
| Değişken | Rol | Tür | Açıklama |
|---|---|---|---|
pathologist_a |
Gözlemci 1 | sıralı kategorik | "stage 1" … "stage 4"; sıklıklar 16, 23, 19, 12 |
pathologist_b |
Gözlemci 2 | sıralı kategorik | Aynı ölçek; sıklıklar 15, 22, 21, 12 |
patient_id |
kullanılmaz | 1–70 |
n ve eksik değer: 70 hasta, eksik değer yok.
Klinik soru: İki patolog aynı vakalara aynı kanser evresini veriyor mu? (VIDEO_SCRIPT_TR.txt, #25.)
Seçilen ayarlar: Arayüz varsayılanı (ağırlıksız κ, %95). Sayısal yürüyüş için ayrıca doğrusal ve kuadratik ağırlık, %99 güven düzeyi, bütün ek çıktılar (özel ağırlık matrisi: bitişik evreye yarım uyum, w=0{,}5), Fleiss κ ve Krippendorff α (nominal, sıralı) ile çalıştırılmıştır.
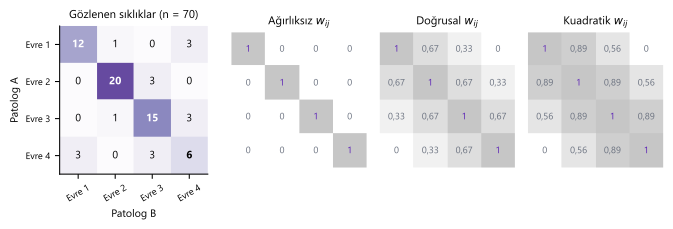
Şekil 29.1. Solda iki patoloğun 4×4 uyum tablosu (koyu yazı köşegen, yani uyum); sağda üç ağırlık şemasının uyum ağırlıkları w_{ij}. Kuadratik ağırlık, bir evre farkını 0,89 uyum sayar; üç evre farkı ise her şemada 0'dır.
29.5 Formüller ve hesap adımları
MerQur'un sırası şudur: (1) iki sütunun çapraz tablosunu kur ve kategori sırasını belirle, (2) tabloyu kare yap ve oranlara çevir, (3) ağırlık matrisini kur, (4) p_o, p_e ve κ'yı hesapla, (5) iki ayrı asimptotik SE hesapla: GA için H_1 altında, test için H_0 altında, (6) z testi ve Wald GA, (7) Landis–Koch etiketi, (8) istenen ekleri hesapla.
29.5.1 Uyum tablosu ve ağırlıklar
- n_{ij}: Gözlemci 1'in i., Gözlemci 2'nin j. kategoriyi verdiği birim sayısı.
- p_{i\cdot}, p_{\cdot j}: satır ve sütun marjinal oranları (iki değerlendiricinin kategori dağılımları).
- k: kategori sayısı; i,j=1,\dots,k belirlenen sıraya göre.
- w_{ij}: uyum ağırlığı; 1 tam uyum, 0 tam uyumsuzluk.
Neden iki ağırlık şeması?
Cohen (1968) ağırlığı serbest bırakmıştır. Doğrusal (Cicchetti–Allison) ağırlık, her basamak uzaklığı eşit cezalandırır. Kuadratik (Fleiss–Cohen) ağırlık, küçük uzaklıkları hafif, büyükleri ağır cezalandırır; bu şemayla κ, büyük örneklemde iki yönlü ANOVA'dan hesaplanan mutlak uyum ICC'sine eşittir (Fleiss ve Cohen 1973). Seçim yorumu değiştirir: aynı veride doğrusal ve kuadratik κ belirgin farklı çıkabilir (bu veride 0,632 ve 0,548).
29.5.2 Gözlenen ve beklenen uyum, κ
- p_e: iki değerlendirici marjinallerini koruyup bağımsız davransaydı beklenen ağırlıklı uyum. Her değerlendirici kendi marjinaliyle girer (Cohen); Scott π ve Fleiss κ ise iki marjinalin ortalamasını kullanır (Bölüm 29.5.6).
- Ağırlıksız durumda p_o=\sum_i p_{ii} ve p_e=\sum_i p_{i\cdot}p_{\cdot i}.
29.5.3 İki standart hata: GA için ve test için
MerQur Fleiss, Cohen ve Everitt'in (1969) büyük örneklem varyanslarını kullanır (hypothesis.py:6109–6119). Önce satır ve sütun ağırlık ortalamaları kurulur:
- \operatorname{Var}_1: gerçek κ'nın sıfır olmadığı varsayımı altında varyans; GA bunun karekökü SE₁ ile kurulur. R
vcd::Kappa'da "ASE". - \operatorname{Var}_0: H_0:\kappa=0 altında varyans; p_{ij} yerine p_{i\cdot}p_{\cdot j} geçer ve \hat\kappa=0 konur. SE₀ yalnız z testinde kullanılır.
- Ağırlıksız κ'da w=I alınır; formül Fleiss–Cohen–Everitt'in ağırlıksız hâline indirgenir.
Neden iki ayrı SE?
Test istatistiğinin dağılımı H_0 doğruyken hesaplanmalıdır; bu durumda iki değerlendirici bağımsızdır ve hücre olasılıkları marjinallerin çarpımıdır. GA ise gerçek κ'nın çevresinde kurulur; gözlenen p_{ij} kullanılır. İki SE farklıdır: bu veride ağırlıksızda SE₀ = 0,0702, SE₁ = 0,0681; kuadratikte SE₀ = 0,1194, SE₁ = 0,1329. Bu yüzden "GA 0'ı dışlıyor" ile "p<0{,}05" kararları sınırda ayrışabilir.
29.5.4 Test ve güven aralığı
- \Phi: standart normal dağılım fonksiyonu; z_{1-\alpha/2}: üst kuyruk kritik değeri (%95'te 1,959964).
- Kırpma: κ [-1;\ 1] dışına çıkamaz; Wald GA küçük n'de bu sınırı aşabileceğinden kırpılır.
Koddaki tercih
p, kuyruktan doğrudan, 2 * norm.sf(|z|) biçiminde hesaplanır (hypothesis.py:6124). Matematiksel olarak eşdeğer olan 2[1-\Phi(|z|)] biçiminde, |z| yaklaşık 8,3'ü geçince \Phi(|z|) kayan noktada tam 1'e yuvarlanır ve sonuç tam sıfır çıkar; kuyruk biçiminde küçük p korunur. Bu veride ağırlıksız κ için z=9{,}54 ve p=1{,}37\times10^{-21}'dir. Ekranda "< 0.0001" ve "p < .001" yazılır. R irr::kappa2, 2[1-\Phi(|z|)] biçimini kullandığından aynı veride 0 verir; Fleiss κ yolu da norm.sf kullanır (hypothesis.py:6258).
29.5.5 Ek çıktılar
Kategori bazında κ. Her kategori c için tablo "c" ve "c değil" olarak 2×2'ye indirilir ve ağırlıksız κ hesaplanır (hypothesis.py:2408–2415). Hangi kategoride uyumun zayıf olduğunu gösterir.
Bowker simetri testi ve Stuart–Maxwell marjinal homojenlik testi. İki değerlendiricinin sistematik olarak farklı kategori sıklığı verip vermediğini sınar:
- Bowker sd'si, toplamı sıfır olmayan çift sayısıdır (
hypothesis.py:2417–2424); bu veride 6 çiftten 4'ü. - \mathbf d: ilk k-1 kategori için satır ve sütun toplamları farkı n_{i\cdot}-n_{\cdot i}.
- \mathbf V: V_{ii}=n_{i\cdot}+n_{\cdot i}-2n_{ii}, V_{ij}=-(n_{ij}+n_{ji}); tekilse genelleştirilmiş ters kullanılır ve not düşülür (
hypothesis.py:2425–2446). sd =k-1.
PABAK ve κ_max.
- p_o^{(u)}, p_e^{(u)}: ağırlıksız gözlenen ve beklenen uyum (seçilen ağırlıktan bağımsız).
- PABAK: marjinaller eşit ve düzgün olsaydı κ'nın alacağı değer (Byrt, Bishop ve Carlin 1993). Prevalans ve yanlılığın κ'yı ne kadar bastırdığını gösterir.
- κ_max: verilen marjinallerle ulaşılabilecek en büyük κ (Cohen 1960). κ/κ_max oranı, marjinal farkının bıraktığı payın ne kadarının kullanıldığını söyler.
- k=2 ise ek olarak prevalans indeksi |n_{11}-n_{22}|/n ve yanlılık indeksi |n_{12}-n_{21}|/n yazılır.
Neden PABAK?
Feinstein ve Cicchetti'nin (1990) "paradoksları": yüzde uyum çok yüksekken κ düşük çıkabilir. Bir kategori çok yaygınsa p_e büyür ve 1-p_e küçülür; aynı p_o daha küçük κ verir. PABAK bu etkiyi siler. Bu veride evreler dengeli dağıldığından PABAK (0,676) κ'ya (0,670) çok yakındır.
Özel ağırlık matrisi. Kullanıcının w_{ij} matrisiyle aynı κ, SE₁ ve SE₀ formülleri uygulanır (hypothesis.py:2463–2475). Bu ek satırın GA'sı da [-1;\ 1]'e kırpılır.
Bootstrap GA. Birim çiftleri yerine koyarak B=2000 kez yeniden örneklenir, her örnekte seçili ağırlıkla κ hesaplanır, \alpha/2 ve 1-\alpha/2 yüzdelikleri alınır (hypothesis.py:2476–2497; np.percentile doğrusal aradeğerleme). Tohum 12345.
29.5.6 Çok değerlendirici: Fleiss κ ve Krippendorff α
Fleiss κ (hypothesis.py:6222–6297). Eksik değerli birimler çıkarılır. N birim, m değerlendirici, n_{sj} = s. birime j. kategoriyi veren değerlendirici sayısı:
- \bar q_j=1-\bar p_j. Varyans H_0 altındadır (Fleiss, Nee ve Landis 1979).
- MerQur GA'yı da bu SE₀ ile kurar: \hat\kappa_F\pm z_{1-\alpha/2}\,\text{SE}_0, [-1;\ 1]'e kırpılır (
hypothesis.py:6260–6261). - Kategori κ'sı \kappa_j=1-\sum_s n_{sj}(m-n_{sj})/[N m(m-1)\bar p_j\bar q_j], z_j=\kappa_j/\sqrt{2/(Nm(m-1))}.
m=2 olduğunda Fleiss κ, Scott'ın π katsayısıdır: beklenen uyum iki değerlendiricinin ortalama marjinaliyle hesaplanır. Bu yüzden Tıp verisinde Fleiss κ (0,670314) Cohen κ'dan (0,670451) biraz farklıdır.
Krippendorff α (hypothesis.py:6299–6382). Eksik değere izin verir; en az iki değer taşıyan her birim girer:
- o_{ck}: eşleşme (coincidence) matrisi; m_u: u biriminde değer veren değerlendirici sayısı; n=\sum_c n_c eşleşebilir değer sayısı.
- \delta^2_{ck}: nominal \mathbb 1[c\neq k]; sıralı \big(\sum_{g=c}^{k}n_g-\tfrac{n_c+n_k}{2}\big)^2; aralık (c-k)^2; oran [(c-k)/(c+k)]^2.
- Yorum eşikleri (Krippendorff 2004): α < 0,667 yetersiz, 0,667–0,80 geçici sonuçlar için kabul edilebilir, ≥ 0,80 güvenilir. α için p ve GA verilmez.
29.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/kappa/elle_hesap.py ile, MerQur kodu çağrılmadan hesaplanmıştır.
Adım 1 — Uyum tablosu. Satırlar Patolog A, sütunlar Patolog B (sıra evre 1–4):
| B: 1 | B: 2 | B: 3 | B: 4 | Toplam | |
|---|---|---|---|---|---|
| A: 1 | 12 | 1 | 0 | 3 | 16 |
| A: 2 | 0 | 20 | 3 | 0 | 23 |
| A: 3 | 0 | 1 | 15 | 3 | 19 |
| A: 4 | 3 | 0 | 3 | 6 | 12 |
| Toplam | 15 | 22 | 21 | 12 | 70 |
Adım 2 — Ağırlıksız κ.
Adım 3 — Standart hatalar ve test. Ağırlıksızda \bar w_{i\cdot}=p_{\cdot i} ve \bar w_{\cdot j}=p_{j\cdot} olur. Formüller \text{SE}_1=0{,}068122 ve \text{SE}_0=0{,}070245 verir:
%99 güven düzeyinde z_{0{,}995}=2{,}575829 ile GA [0{,}4950;\ 0{,}8459] olur. κ ∈ (0,60; 0,80] olduğundan Landis–Koch etiketi "önemli"dir.
Adım 4 — Ağırlıklı κ. k=4 için doğrusal ağırlıklar bir basamakta 2/3, iki basamakta 1/3; kuadratik ağırlıklar 8/9 ve 5/9'dur.
| Ağırlık | p_o | p_e | κ | SE₁ | z | %95 GA |
|---|---|---|---|---|---|---|
| Ağırlıksız | 0,757143 | 0,263061 | 0,670451 | 0,068122 | 9,5445 | [0,5369; 0,8040] |
| Doğrusal | 0,861905 | 0,624762 | 0,631980 | 0,086192 | 7,6340 | [0,4630; 0,8009] |
| Kuadratik | 0,896825 | 0,771655 | 0,548163 | 0,132870 | 4,5906 | [0,2877; 0,8086] |
Sıralı ölçekte ağırlıklı κ'nın genellikle ağırlıksızdan büyük olması beklenir; burada tersi olmuştur. Nedeni tablonun köşeleridir: 6 hastada (A: 1, B: 4 ve A: 4, B: 1) patologlar üç evre ayrı düşmüştür. Ağırlıksız κ bu uyumsuzluğu bir basamaklık uyumsuzlukla aynı sayar; ağırlıklı κ, uzaklığı ölçtüğü için bu altı vakayı ağır cezalandırır. Kuadratik ağırlıkta p_e de büyür (0,772); şansın üstünde kalan pay daralır.
Adım 5 — Kategori bazında κ. Evre 4 için 2×2 tablo: a=6, b=12-6=6, c=12-6=6, d=70-18=52:
Öteki evreler: \kappa_1=0{,}7101, \kappa_2=0{,}8363, \kappa_3=0{,}6503. Uyumsuzluğun kaynağı en ileri evredir.
Adım 6 — Simetri ve marjinal homojenlik. Bowker çiftleri: (1,2): 1^2/1=1; (1,4): 0^2/6=0; (2,3): 2^2/4=1; (3,4): 0/6=0; (1,3) ve (2,4) sıfır toplamlı olduğu için atlanır. \chi^2_{\text{B}}=2, sd = 4, p=0{,}7358. Stuart–Maxwell: \mathbf d=(1,\ 1,\ -2),
İki patoloğun evre dağılımları arasında sistematik fark yoktur; uyumsuzluk rastgele dağılmıştır.
Adım 7 — PABAK, κ_max, özel ağırlık, bootstrap.
Bitişik evreye yarım uyum veren özel matrisle κ = 0,687014 (SE₁ = 0,067506, GA [0,5547; 0,8193]). Bootstrap %95 GA (B = 2000, tohum 12345): [0,5362; 0,8041]; Wald GA'ya çok yakındır.
Adım 8 — Fleiss κ ve Krippendorff α (m = 2). Ortalama marjinaller \bar p=(0{,}221429;\ 0{,}321429;\ 0{,}285714;\ 0{,}171429), P_e=0{,}263367, \bar P=0{,}757143:
Krippendorff α'da n_c=(31;\ 45;\ 40;\ 24), n=140. Nominal: D_o=\sum o_{ck}\delta^2=34, D_e=14438, \hat\alpha=1-139\cdot34/14438=0{,}672669. Sıralı: \hat\alpha=0{,}575200.
29.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan, stats.hypothesis modülünde round() bellekte etkisizleştirilerek alınmıştır (dogrulama/kappa/merqur_calistir.py). z değerleri ağırlıklı κ'da yalnız metinde yazıldığından 4 ondalıkla karşılaştırılmıştır. R: 4.5.3; irr::kappa2 (κ, z, p), DescTools::CohenKappa (GA, özel ağırlık), vcd::Kappa (SE₁), DescTools::StuartMaxwellTest, irr::kappam.fleiss, irr::kripp.alpha. Bowker R sütunu doğrudan formülle hesaplanmıştır, çünkü temel R mcnemar.test sıfır toplamlı çiftte NaN verir. irr Fleiss kategori κ'larını üç ondalığa yuvarladığından R sütunundaki κ_j Fleiss (1971) tanımından hesaplanmıştır. Bootstrap satırı aynı tohumla yeniden üretimdir; R'de karşılığı yoktur.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| p_o (ağırlıksız) | 0,757143 | 0,757143 | — | 0,0e+00 | ✓ |
| p_e (ağırlıksız) | 0,263061 | 0,263061 | — | 0,0e+00 | ✓ |
| κ ağırlıksız | 0,670451 | 0,670451 | 0,670451 | 3,3e−16 | ✓ |
| SE₁ (H₁, GA için) | 0,068122 | 0,068122 | 0,068122 | 1,4e−17 | ✓ |
| SE₀ (H₀, test için) | 0,070245 | 0,070245 | — | 0,0e+00 | ✓ |
| z ağırlıksız | 9,5445 | 9,544523 | 9,544523 | 1,8e−15 | ✓ (4 ondalık) |
| p ağırlıksız, 2Φ(− | z | ) | 1,3674·10−21 | 1,3674·10−21 | 1,3674·10−21 |
| %95 GA alt | 0,536935 | 0,536935 | 0,536935 | 3,3e−16 | ✓ |
| %95 GA üst | 0,803968 | 0,803968 | 0,803968 | 1,1e−16 | ✓ |
| %99 GA alt | 0,494981 | 0,494981 | 0,494981 | 2,8e−16 | ✓ |
| %99 GA üst | 0,845922 | 0,845922 | 0,845922 | 4,4e−16 | ✓ |
| κ doğrusal | 0,631980 | 0,631980 | 0,631980 | 1,1e−16 | ✓ |
| SE₁ doğrusal | 0,086192 | 0,086192 | 0,086192 | 8,3e−17 | ✓ |
| z doğrusal | 7,6340 | 7,633973 | 7,633973 | 8,9e−16 | ✓ (4 ondalık) |
| p doğrusal, 2Φ(− | z | ) | 2,2763·10−14 | 2,2763·10−14 | 2,2763·10−14 |
| %95 GA doğrusal alt | 0,463047 | 0,463047 | 0,463047 | 0,0e+00 | ✓ |
| %95 GA doğrusal üst | 0,800912 | 0,800912 | 0,800912 | 3,3e−16 | ✓ |
| κ kuadratik | 0,548163 | 0,548163 | 0,548163 | 4,4e−16 | ✓ |
| SE₁ kuadratik | 0,132870 | 0,132870 | 0,132870 | 2,2e−16 | ✓ |
| z kuadratik | 4,5906 | 4,590593 | 4,590593 | 2,7e−15 | ✓ (4 ondalık) |
| %95 GA kuadratik alt | 0,287742 | 0,287742 | 0,287742 | 1,3e−15 | ✓ |
| %95 GA kuadratik üst | 0,808584 | 0,808584 | 0,808584 | 5,6e−16 | ✓ |
| Kategori κ (stage 1) | 0,710059 | 0,710059 | 0,710059 | 1,1e−16 | ✓ |
| Kategori κ (stage 2) | 0,836296 | 0,836296 | 0,836296 | 4,4e−16 | ✓ |
| Kategori κ (stage 3) | 0,650350 | 0,650350 | 0,650350 | 4,4e−16 | ✓ |
| Kategori κ (stage 4) | 0,396552 | 0,396552 | 0,396552 | 5,6e−17 | ✓ |
| Bowker \chi^2 (sd = 4) | 2 | 2 | 2 | 0,0e+00 | ✓ |
| Bowker p | 0,735759 | 0,735759 | 0,735759 | 3,3e−16 | ✓ |
| Stuart–Maxwell \chi^2 | 0,578947 | 0,578947 | 0,578947 | 3,3e−16 | ✓ |
| Stuart–Maxwell p | 0,901235 | 0,901235 | 0,901235 | 1,1e−16 | ✓ |
| PABAK | 0,676190 | 0,676190 | 0,676190 | 1,1e−16 | ✓ |
| κ_max | 0,961230 | 0,961230 | 0,961230 | 3,3e−16 | ✓ |
| Özel ağırlıklı κ | 0,687014 | 0,687014 | 0,687014 | 1,1e−16 | ✓ |
| Özel ağırlıklı SE₁ | 0,067506 | 0,067506 | — | 0,0e+00 | ✓ |
| Bootstrap GA alt (tohum 12345) | 0,536165 | 0,536165 | — | 1,1e−16 | ✓ |
| Bootstrap GA üst (tohum 12345) | 0,804141 | 0,804141 | — | 1,1e−16 | ✓ |
| Fleiss κ (m = 2) | 0,670314 | 0,670314 | 0,670314 | 3,3e−16 | ✓ |
| Fleiss z | 9,531111 | 9,531111 | 9,531111 | 5,3e−15 | ✓ |
| Fleiss p | 1,5561·10−21 | 1,5561·10−21 | 1,5561·10−21 | 7,3e−35 | ✓ |
| Fleiss %95 GA alt | 0,532472 | 0,532472 | — | 0,0e+00 | ✓ |
| Fleiss %95 GA üst | 0,808157 | 0,808157 | — | 0,0e+00 | ✓ |
| Fleiss κ_j (stage 1) | 0,709973 | 0,709973 | 0,709973 | 2,2e−16 | ✓ |
| Fleiss κ_j (stage 2) | 0,836257 | 0,836257 | 0,836257 | 3,3e−16 | ✓ |
| Fleiss κ_j (stage 3) | 0,650000 | 0,650000 | 0,650000 | 0,0e+00 | ✓ |
| Fleiss κ_j (stage 4) | 0,396552 | 0,396552 | 0,396552 | 5,6e−17 | ✓ |
| Krippendorff α nominal | 0,672669 | 0,672669 | 0,672669 | 2,2e−16 | ✓ |
| Krippendorff α sıralı | 0,575200 | 0,575200 | 0,575200 | 3,3e−16 | ✓ |
Sonuç: 47 büyüklüğün tamamı ölçütü karşılar. p satırları kuyruktan doğrudan hesapla, 2\Phi(-|z|) ile karşılaştırılmıştır; ağırlıksız κ'da p=1{,}37\times10^{-21}'dir. R sütununda irr::kappa2'nin z'si üzerinden pnorm(-|z|) kullanılmıştır, çünkü irr::kappa2'nin kendi p'si 2[1-\Phi(|z|)] biçimiyle hesaplanır ve bu veride 0 verir (Bölüm 29.5.4).
29.7 Çıktıyı okuma
Varsayılan ayarlarla sonuç metni (sade gösterim; ana p satırını panel "< 0.0001" yazar):
Test: Cohen's Kappa (ağırlıksız)
──────────────────────────────────────────────────
İstatistik : 0.6705
Etki büyüklüğü  : 0.6705  (κ = 0.6705 (önemli))

Karar: H₀ REDDEDİLİR  ***

Cohen's Kappa (ağırlıksız) κ = 0.6705 (önemli). p_o = 0.7571, p_e = 0.2631. %95 GA: [0.5369, 0.8040]. z = 9.5445, p < .001 ***. H₀ (κ=0) REDDEDİLİR.
Kategori sırası (ağırlıklar bu sıraya göre): stage 1 < stage 2 < stage 3 < stage 4  [doğal sıra — etiketteki sayıya göre (ör. evre 2 < evre 10)]
APA: Cohen's κ (ağırlıksız) = 0.670 (%95 GA [0.537, 0.804]), p < .001
Etiketler sayı içerdiği için doğal sıra tanınır ve ağırlıklı κ'da sıra uyarısı çıkmaz. Sıra tanınamasaydı (sayısız metin etiketleri) ağırlıklı κ metnine "kategori sırası etiketlerden tanınamadı; verideki ilk görülme sırası kullanıldı" uyarısı eklenirdi.
| Satır | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| İstatistik / Etki büyüklüğü | \hat\kappa_w | κ hem istatistik hem etki büyüklüğüdür. |
| Etiket | Landis–Koch | < 0 negatif, ≤ 0,20 hafif, ≤ 0,40 vasat, ≤ 0,60 orta, ≤ 0,80 önemli, üstü neredeyse mükemmel. |
| p_o, p_e | Ağırlıklı gözlenen ve beklenen uyum | p_o ham uyum yüzdesidir; κ ile birlikte raporlanmalıdır. |
| %95 GA | SE₁ ile Wald GA, kırpılmış | Örnekleme belirsizliği; 70 hastada genişlik 0,27. |
| z, p | SE₀ ile test | Yalnız "uyum şanstan farklı mı?" sorusunu yanıtlar; κ = 0,30 bile büyük n'de anlamlıdır. |
| Kategori sırası | Kullanılan sıra ve kaynağı | Ağırlıklı κ'da denetlenmesi gereken ilk satır. |
| Künye | Ağırlık, p_o, p_e, GA, yorum | n, iki sütunun birlikte dolu olduğu satır sayısıdır. |
| Grafik | Uyum tablosunun ısı haritası (köşegen uyum) | Satır Gözlemci 1, sütun Gözlemci 2. |
APA biçiminde rapor cümlesi:
İki patoloğun 70 hastaya verdiği kanser evreleri arasındaki uyum Cohen'in ağırlıksız kappa katsayısıyla değerlendirildi. Gözlenen uyum %75,7, şansla beklenen uyum %26,3 idi; uyum önemli düzeydeydi, κ = 0,67, %95 GA [0,54; 0,80], z = 9,54, p < 0,001. Uyumsuzluk en çok evre 4'te yoğunlaştı (kategori κ = 0,40); iki patoloğun evre dağılımları farklı değildi (Stuart–Maxwell \chi^2(3) = 0,58, p = 0,90).
29.8 Uzman soruları
S1. GA ile test neden farklı SE kullanıyor; bu tutarsızlık değil mi?
Değil. Test H_0:\kappa=0 altında yapılmalıdır; o durumda hücre olasılıkları p_{i\cdot}p_{\cdot j}'dir ve SE₀ buradan gelir. GA gerçek κ'nın çevresinde kurulur ve gözlenen tabloyu kullanır (SE₁). R irr::kappa2 aynı ayrımı yapar (hypothesis.py:6109–6119).
S2. Çok küçük p nasıl hesaplanır ve raporlanır?
MerQur p'yi kuyruktan doğrudan, 2\Phi(-|z|) ile hesaplar (hypothesis.py:6472); bu veride değer 1{,}37\times10^{-21}'dir. p=2[1-\Phi(|z|)] biçimi ise |z|>8{,}3 dolayında \Phi 1'e yuvarlandığı için tam 0 verir; irr::kappa2 bu biçimi kullanır. Raporlamada "< 0,001" yeterlidir. Fleiss κ yolu da doğrudan kuyruk olasılığını kullanır.
S3. Bu veride kuadratik κ neden ağırlıksızdan küçük?
Kuadratik ağırlık iki şeyi birden yapar: uzak uyumsuzlukları ağır cezalandırır ve yakın uyumsuzlukları neredeyse uyum sayarak p_e'yi büyütür. Burada 6 hastada üç evrelik uyumsuzluk var; kuadratik ağırlıkta bunlar tam ceza alır, ayrıca 1-p_e 0,228'e düşer. Sonuç κ = 0,548'dir. Ağırlıklı κ'yı ağırlıksızla "daha iyi uyum" beklentisiyle karşılaştırmak yanlıştır; ikisi farklı soruları yanıtlar.
S4. Tüm hastalara aynı evreyi verseler ne olur?
İki patolog da tek bir kategori kullanırsa p_o=p_e=1 ve κ = 0/0'dır. MerQur "1.0000 mükemmel" yazmaz; κ, SE, GA ve p'yi "—" yazar ve uyarı verir (hypothesis.py:6103–6105). Yalnız biri tek kategori kullanırsa p_e<1 kalır ve κ hesaplanır (genellikle 0'a yakındır).
S5. Yüksek yüzde uyumda κ neden düşük olabilir?
Prevalans paradoksu: bir kategori çok yaygınsa şansla beklenen uyum p_e yükselir, κ'nın paydası küçülür. Örneğin iki değerlendiricinin de %90 "var" dediği ikili bir tabloda %90 uyum, p_e=0{,}82 ile yalnız κ = 0,44 verir. PABAK ve κ_max bu durumu ayırt etmek için verilir (Byrt ve ark. 1993; Feinstein ve Cicchetti 1990).
S6. Bowker testinin sd'si neden 6 değil 4?
k=4'te 6 köşegen dışı çift vardır. MerQur n_{ij}+n_{ji}=0 olan çiftleri atar, çünkü bu terim 0/0'dır (hypothesis.py:2417–2424). Temel R mcnemar.test bu durumda NaN döndürür. Kimi programlar terimi sıfır sayıp sd'yi 6 bırakır; bu, p'yi değiştirir (burada p = 0,7358 yerine 0,9197 olurdu).
S7. İki değerlendiricide Fleiss κ neden Cohen κ'dan farklı?
Fleiss κ beklenen uyumu iki değerlendiricinin ortak marjinaliyle (\bar p_j) hesaplar; bu Scott π'dir. Cohen κ her değerlendiriciye kendi marjinalini verir. Marjinaller farklıysa Cohen'in p_e'si daha küçüktür ve κ biraz daha büyük çıkar. Bu veride fark 0,00014'tür. Değerlendiriciler sabit ve ilgi konusuysa Cohen κ, değiştirilebilir sayılıyorsa Scott π / Fleiss κ yeğlenir.
S8. Fleiss κ'nın GA'sı neden H_0 altındaki SE ile kurulmuş?
Fleiss, Nee ve Landis'in (1979) kapalı biçimli varyansı yalnız H_0 altında geçerlidir. MerQur, DescTools::KappaM ile tutarlı olmak için GA'yı da bu SE ile kurar (hypothesis.py:6260–6261). κ sıfırdan uzaksa bu GA yaklaşıktır; daha doğru bir aralık için Krippendorff α'nın bootstrap'ı ya da Cohen κ (iki değerlendiricide) kullanılabilir.
29.9 Sık hatalar ve tuzaklar
- Sıralı ölçekte kategori sırasını denetlememek. Ağırlıklı κ'da "Kategori sırası" satırını okuyun; "sıra tanımlanmadı" yazıyorsa "Kategori sırası" alanını doldurun.
- Ağırlıklı ve ağırlıksız κ'yı aynı ölçekte yorumlamak. Landis–Koch eşikleri ağırlıksız κ için önerilmiştir; ağırlıklı κ aynı etiketi alır ama karşılaştırılabilir değildir.
- Anlamlı p'yi iyi uyum sanmak. H_0:\kappa=0 testi yalnız "şanstan iyi" der; klinik yorum κ ve GA'ya dayanmalıdır.
- Yüzde uyumu tek başına raporlamak. p_o=0{,}757 şansla beklenen 0,263'ü içerir; κ ile birlikte verilmelidir.
- Eksik değerli satırları saymak. Liste bazında silinir; künyedeki n, analize giren hasta sayısıdır.
- Çok değerlendiricili yöntemde ağırlık seçmek. Fleiss κ ve Krippendorff α'da ağırlık, ek çıktılar ve özel matris kullanılmaz; MerQur bunu bir not satırıyla bildirir. Sıralı ölçekte Krippendorff α (sıralı) seçilmelidir.
- Landis–Koch etiketini sayısız raporlamak. "slight" karşılığı "hafif", "fair" karşılığı "vasat" yazılır; rapor ederken sayıyı ve eşik kaynağını verin.
- Bootstrap GA'yı tohum vermeden raporlamak. Farklı tohum farklı sınır verir; tohum (12345) yöntem bölümünde yazılmalıdır.
29.10 Kaynaklar
- Bowker, A. H. (1948). A test for symmetry in contingency tables. Journal of the American Statistical Association, 43(244), 572–574. https://doi.org/10.1080/01621459.1948.10483284
- Byrt, T., Bishop, J., & Carlin, J. B. (1993). Bias, prevalence and kappa. Journal of Clinical Epidemiology, 46(5), 423–429. https://doi.org/10.1016/0895-4356(93)90018-V
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
- Cohen, J. (1968). Weighted kappa: Nominal scale agreement provision for scaled disagreement or partial credit. Psychological Bulletin, 70(4), 213–220. https://doi.org/10.1037/h0026256
- Feinstein, A. R., & Cicchetti, D. V. (1990). High agreement but low kappa: I. The problems of two paradoxes. Journal of Clinical Epidemiology, 43(6), 543–549. https://doi.org/10.1016/0895-4356(90)90158-L
- Fleiss, J. L. (1971). Measuring nominal scale agreement among many raters. Psychological Bulletin, 76(5), 378–382. https://doi.org/10.1037/h0031619
- Fleiss, J. L., & Cohen, J. (1973). The equivalence of weighted kappa and the intraclass correlation coefficient as measures of reliability. Educational and Psychological Measurement, 33(3), 613–619. https://doi.org/10.1177/001316447303300309
- Fleiss, J. L., Cohen, J., & Everitt, B. S. (1969). Large sample standard errors of kappa and weighted kappa. Psychological Bulletin, 72(5), 323–327. https://doi.org/10.1037/h0028106
- Fleiss, J. L., Nee, J. C. M., & Landis, J. R. (1979). Large sample variance of kappa in the case of different sets of raters. Psychological Bulletin, 86(5), 974–977. https://doi.org/10.1037/0033-2909.86.5.974
- Hayes, A. F., & Krippendorff, K. (2007). Answering the call for a standard reliability measure for coding data. Communication Methods and Measures, 1(1), 77–89. https://doi.org/10.1080/19312450709336664
- Krippendorff, K. (2004). Content analysis: An introduction to its methodology (2nd ed.). Sage.
- Landis, J. R., & Koch, G. G. (1977). The measurement of observer agreement for categorical data. Biometrics, 33(1), 159–174. https://doi.org/10.2307/2529310
- Maxwell, A. E. (1970). Comparing the classification of subjects by two independent judges. British Journal of Psychiatry, 116(535), 651–655. https://doi.org/10.1192/bjp.116.535.651
- Sim, J., & Wright, C. C. (2005). The kappa statistic in reliability studies: Use, interpretation, and sample size requirements. Physical Therapy, 85(3), 257–268. https://doi.org/10.1093/ptj/85.3.257
- Stuart, A. (1955). A test for homogeneity of the marginal distributions in a two-way classification. Biometrika, 42(3–4), 412–416. https://doi.org/10.1093/biomet/42.3-4.412