43. Değişken Kümeleme (VARCLUS)
Analiz kimliği: varclus · Menü adı: Değişken Kümeleme · Panel ve motor aynı dosyada: gui/panels/analyses/varclus.py, run_varclus (satır 241–360), divisive_varclus_labels (satır 124–236), varclus_extras (satır 475–532), _format_varclus_text (satır 363–410)
43.1 Ne işe yarar
Değişken kümeleme, gözlemleri değil değişkenleri gruplar. Cevapladığı soru şudur: "Bu sayısal değişkenler, birbiriyle güçlü ilişkili kaç alt kümeye ayrılıyor ve her alt kümeyi en iyi hangi tek değişken temsil ediyor?" Her küme, üyelerinin birinci temel bileşeniyle (küme bileşeni) özetlenir; bir değişkenin kendi küme bileşenine yakın, diğer kümelerin bileşenlerine uzak olması iyi bir kümelemedir.
Bir kümelemenin niteliği, küme bileşenlerinin açıkladığı toplam standartlaştırılmış varyansla ölçülür:
- p: değişken sayısı; standartlaştırılmış değişkenlerin toplam varyansı p'dir.
- k: küme sayısı.
- \lambda_1^{(c)}: c. kümenin korelasyon alt matrisinin en büyük özdeğeri; küme bileşeninin üyelerinden açıkladığı varyans.
Ne zaman kullanılır? Çok sayıda, birbiriyle ilişkili sayısal değişken varsa ve amaç (i) değişkenlerin doğal gruplarını görmek, (ii) çoklu doğrusallığı azaltmak için her gruptan bir temsilci seçmek, (iii) bir ölçeğin maddelerinin beklenen alt boyutlara düşüp düşmediğine hızlıca bakmaksa. Kredi riski ve pazarlama modellerinde değişken azaltma, anket maddelerinin ön incelemesi tipik kullanımlardır.
Ne zaman kullanılmaz?
- Amaç gözlemleri (hastaları) gruplamaksa: Hiyerarşik Kümeleme ya da K-ortalamalar.
- Gizil yapıyı kuramsal bir modelle sınamak isteniyorsa: Doğrulayıcı Faktör Analizi; keşif amaçlı ama ortak ve özgün varyansı ayırmak isteniyorsa: Açımlayıcı Faktör Analizi. VARCLUS her değişkeni tek bir kümeye atar ve çapraz yükleri yok sayar.
- Değişkenler kategorikse: Uyum Analizi (Bölüm 42) ya da MCA.
- İki önceden tanımlı set arasındaki ilişki soruluyorsa: Kanonik Korelasyon (Bölüm 41).
- Değişkenleri azaltıp kestirim yapmak asıl amaçsa ve yanıt değişkeni varsa: PLS Regresyon ya da düzenlileştirilmiş regresyon; VARCLUS yanıtı görmez.
Sık karıştırılan analizler. Temel bileşenler analizi (TBA) tüm değişkenlerin ağırlıklı toplamlarını kurar; her bileşende her değişkenin bir yükü vardır. VARCLUS ise her değişkeni yalnız bir bileşene bağlar; bileşenler eğik olabilir (ilişkili). Bölücü değişken kümeleme, kümeleri eğik temel bileşenlerle ikiye bölerek ilerler; R Hmisc::varclus Spearman korelasyonunun karesiyle birleştirici kümeleme yapar; R ClustOfVar::hclustvar küme homojenliği ölçütüyle birleştirir. MerQur'un varsayılanı bunlardan hiçbiri değildir: 1-|r| uzaklığıyla ortalama bağlantılı birleştirici kümelemedir; bölücü algoritma ayrı bir seçenektir.
43.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Sayısal değişkenler | Pearson korelasyonu anlamlı olmalı. | Seçici yalnız sayısal sütun önerir; sayıya çevrilemeyen değer eksik sayılır. |
| Doğrusal ilişki | Kümeler doğrusal korelasyon yapısından çıkar. | Denetlenmez. |
| Sıfır olmayan varyans | Sabit sütunda korelasyon tanımsızdır. | Hata (varclus.py:262–264). |
| Yeterli örneklem | Korelasyon matrisi kararlı kestirilmeli. | Yalnız n\ge3 zorunlu (varclus.py:256–257); küçük n uyarısı yoktur. |
| Dağılım varsayımı | Yok; yöntem betimleyicidir, test yapılmaz. | — |
Eksik değer. Seçilen tüm sütunlar sayıya çevrilir, sonra liste bazında silinir (varclus.py:255); ek çıktılar aynı alt kümeyi yeniden kurar (varclus.py:482). Künyedeki n silmeden sonraki satır sayısıdır.
Uç durumlar.
- n<3 ya da 2'den az değişken: hata (
varclus.py:256–259). - Varyansı 0 olan sütun: adıyla birlikte hata (
varclus.py:262–264). - Küme sayısı \max\left(2,\ \min(k,\ p)\right)'ye kırpılır (
varclus.py:266). k=p istenirse her değişken tek başına bir küme olur. - Bölücü yöntemde MAXEIGEN ölçütü ya da ilerleme olmaması bölmeyi erken durdurabilir; gerçek küme sayısı sonuçta ve künyede yazılır (
varclus.py:281). - Tek üyeli kümede 1-R^2_{\text{own}}=0 ve oran 0'dır; o değişken otomatik olarak temsilci olur.
43.3 Parametreler
Varsayılanlar varclus.py:415–472 ve stats_panel.py:8853–8868 içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Algoritma | Ortalama bağlantı (1−|r|, birleştirici) | Ortalama bağlantı ya da bölücü (ikinci özdeğere göre bölme). | Kümeler, küme numaraları ve temsilciler değişebilir. Bu veride iki yöntem aynı üç kümeyi verir. |
| MAXEIGEN (bölücü) | 0,00 | Yalnız bölücü yöntemde: en büyük ikinci özdeğer bu değerin altına düşünce bölme durur. 0 = ölçüt yok. | Ortalama bağlantıda alan devre dışıdır (varclus.py:442–445). |
| Küme sayısı (K) | 3 | Ortalama bağlantıda ağacın kesildiği küme sayısı; bölücüde üst sınır. | 2–20. |
| Değişkenler | veriye bağlı | En az 2 sayısal değişken. | — |
| Ek çıktılar: R² ve 2. özdeğer | kapalı | Küme özeti (1. ve 2. özdeğer, açıklanan oran) ve değişken başına R^2_{\text{own}}, R^2_{\text{next}}. | Ek tablo. |
| Ek çıktılar: Küme arası korelasyon | kapalı | Küme bileşenleri arasındaki korelasyon matrisi ve standartlaştırılmış skor katsayıları. | Ek tablo. |
| Ek çıktılar: Dendrogram ve k taraması | kapalı | Değişken ağacı ve k=1\dots10 için açıklanan oran eğrisi. | Grafik sekmesi ağaca döner. Tarama her zaman ortalama bağlantıyla yapılır, bölücü seçilse de (varclus.py:514–531). |
Neden varsayılan ortalama bağlantı, bölücü yöntem değil?
Varsayılan yöntem ortalama bağlantıdır (varclus.py:249–251); bölücü yöntem ayrı bir seçenek olarak sunulur. İki yöntemin amacı aynıdır, ama ölçütleri farklıdır: ortalama bağlantı yalnız ikili korelasyonlara bakar; bölücü yöntem doğrudan küme bileşenlerinin açıkladığı varyansı en büyüklemeye çalışır. Yapı belirgin olduğunda (bu veride olduğu gibi) aynı sonucu verirler; ara durumlarda bölücü yöntemin açıklanan varyansı genellikle daha yüksektir. Kümelerin tek boyutluluğuna göre bölmek için "Bölücü" ve MAXEIGEN = 1 seçilir (43.5.5).
43.4 Tıp örneği
Dosya: english/datasets/Tip/38_varclus_SF36_18.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/38_varclus_SF36_18.xlsx). Değişken seçimi VIDEO_SCRIPT_TR.txt #38 bölümünden alınmıştır.
| Değişken | Rol | Tür | Açıklama |
|---|---|---|---|
physical_m1 … physical_m6 |
Değişkenler | sürekli (standartlaştırılmış madde puanı) | Fiziksel işlev maddeleri |
mental_m1 … mental_m6 |
Değişkenler | sürekli | Ruhsal sağlık maddeleri |
social_m1 … social_m6 |
Değişkenler | sürekli | Sosyal işlev maddeleri |
patient_id |
kullanılmaz |
n ve eksik değer: 180 hasta, 18 madde (p=18); eksik değer yoktur. Maddeler ortalaması yaklaşık 0, SS'si yaklaşık 1 olacak biçimde ölçeklenmiştir.
Klinik soru: 18 yaşam kalitesi maddesi, beklenen üç alt boyuta (fiziksel, ruhsal, sosyal) ayrışıyor mu; her alt boyutu en iyi hangi madde temsil ediyor?
Seçilen ayarlar: Varsayılanlar (ortalama bağlantı, k=3) ve üç ek çıktının tamamı. Karşılaştırma için bölücü yöntem (k=3; ayrıca k=20 ve MAXEIGEN = 1) ve ortalama bağlantı k=4 çalıştırmaları yapılmıştır.
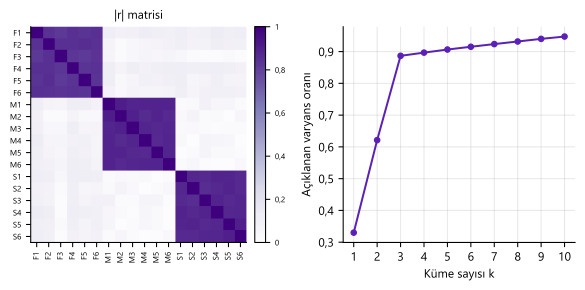
Korelasyon yapısı. Blok içi ortalama korelasyonlar fiziksel 0,838, ruhsal 0,880, sosyal 0,875 (en küçükleri 0,813; 0,862; 0,852); bloklar arası mutlak korelasyonların ortalaması 0,062, en büyüğü 0,135'tir. Yapı çok belirgindir.
Şekil 43.1. Solda 18 maddenin mutlak korelasyon matrisi (F: fiziksel, M: ruhsal, S: sosyal). Sağda ortalama bağlantı ağacının k = 1…10 kümede kesilmesiyle açıklanan varyans oranı; eğri k = 3'te kırılır.
43.5 Formüller ve hesap adımları
MerQur'un hesap sırası şudur: (1) sütunları sayıya çevir, liste bazında eksikleri sil, sabit sütunları reddet; (2) korelasyon matrisini ve 1-|r| uzaklığını kur; (3) seçilen algoritmayla (ortalama bağlantı ya da bölücü) kümeleri bul; (4) her kümenin birinci temel bileşenini kur; (5) her değişken için R^2_{\text{own}}, R^2_{\text{next}} ve oranı hesapla, en küçük oranlı değişkeni temsilci seç; (6) küme özetini ve istenen ek çıktıları ekle.
43.5.1 Korelasyon uzaklığı ve ortalama bağlantı
- r_{jl}: j. ve l. değişken arasındaki Pearson korelasyonu (
varclus.py:269–274). - d_{jl}: korelasyon uzaklığı; |r| kullanıldığı için ters yönlü güçlü ilişki (r=-0{,}9) de yakınlık sayılır.
- D(A,B): iki küme arasındaki ortalama bağlantı (UPGMA) uzaklığı; tüm çapraz çiftlerin ortalaması.
- Algoritma her adımda D'si en küçük iki kümeyi birleştirir; ağaç
fcluster(Z, t=k, criterion="maxclust")ile tam k kümeye kesilir (varclus.py:284–285).
Neden mutlak değer?
Değişken kümelemenin amacı aynı bilgiyi taşıyan değişkenleri bulmaktır. Ters kodlanmış bir anket maddesi (r=-0{,}85) kendi alt boyutuyla aynı bilgiyi taşır; işaretli korelasyonla bu madde başka kümeye düşerdi. Küme bileşeni (43.5.2) işaretten etkilenmez, çünkü R^2 korelasyonun karesidir.
43.5.2 Küme bileşeni
Her küme c için (n_c üye), üyelerin korelasyon alt matrisinin özayrışımı:
- \mathbf R_{cc}: kümenin n_c\times n_c korelasyon alt matrisi; \lambda_1^{(c)} en büyük özdeğeri, \mathbf v^{(c)} birim uzunluklu özvektörü (
varclus.py:297–298). - z_j: j. değişkenin z-puanı (
ddof=1). - C_c: küme bileşeni; kümenin birinci temel bileşeni, varyansı 1 olacak biçimde ölçeklenmiş.
- v_j^{(c)}/\sqrt{\lambda_1^{(c)}}: standartlaştırılmış skor katsayısı (
varclus.py:494–496). Ek çıktıda işaret, katsayıların toplamı pozitif olacak biçimde seçilir. - \lambda_1^{(c)}/n_c: kümenin açıklanan varyans oranı; \lambda_2^{(c)} ikinci özdeğer.
Koddaki tercih: korelasyon, kovaryans değil; ilk temel bileşen, merkez değil
MerQur küme bileşenini korelasyon matrisinden kurar (kovaryans matrisi seçeneği yoktur) ve birinci temel bileşeni kullanır (üyelerin eşit ağırlıklı ortalamasını bileşen alan seçenek uygulanmamıştır; varclus.py:143–144). Ana tablodaki R^2 değerleri işaretsiz bileşenle hesaplanır (varclus.py:298, 302–303); işaret R^2'yi etkilemez.
43.5.3 R²_own, R²_next ve oran
- c(j): j. değişkenin kümesi.
- R^2_{j,\text{own}}: değişkenin kendi küme bileşeniyle kare korelasyonu; büyük olması değişkenin kümesini iyi yansıttığını gösterir. İkinci eşitlik, birinci temel bileşenle korelasyonun \sqrt{\lambda_1}v_j olmasından gelir.
- R^2_{j,\text{next}}: en yakın diğer küme bileşeniyle kare korelasyon; küçük olması değişkenin başka kümeye karışmadığını gösterir.
- Oran: (1-R^2_{\text{own}})/(1-R^2_{\text{next}}); küçük oran iyi bir üyeliktir. Kümede oranı en küçük değişken temsilci seçilir (
varclus.py:326–331). - Tek kümeli çözümde 1-R^2_{\text{next}}=1 alınır (
varclus.py:322–325); 1-R^2_{\text{next}}=0 ise oran sonsuzdur.
Neden oran, yalnız R²_own değil?
Yalnız R^2_{\text{own}}'a bakılırsa, iki kümenin sınırında duran ve her iki bileşenle güçlü ilişkili bir değişken iyi temsilci gibi görünebilir. Oranın paydası bu durumu cezalandırır: R^2_{\text{next}} büyüdükçe payda küçülür, oran büyür. Temsilci, kendi kümesine en yakın ve diğerlerinden en uzak değişkendir; bu, regresyon modeline girdiğinde diğer temsilcilerle en az çoklu doğrusallık yaratacak değişkendir.
43.5.4 Bölücü algoritma
divisive_varclus_labels (varclus.py:124–236) şu adımları izler:
- Tüm değişkenler tek kümede başlar.
- Her kümenin ikinci özdeğeri \lambda_2^{(c)} hesaplanır. Küme sayısı K'ya ulaştıysa ya da en büyük \lambda_2^{(c)}\le MAXEIGEN ise durulur.
- \lambda_2'si en büyük küme, ilk iki özvektörünün ham quartimax döndürmesiyle ikiye bölünür (orthoblique, Harris ve Kaiser 1964).
- NCS evresi: her değişken, kendisiyle kare korelasyonu en büyük küme bileşenine atanır; bileşenler yeniden hesaplanır (en çok 10 tur; bir küme boşalacaksa durur).
- Arama evresi: tek bir değişkenin başka kümeye taşınması toplam açıklanan varyansı (\sum_c\lambda_1^{(c)}) artırıyorsa taşınır; en çok \lfloor1000/p\rfloor tur.
Bölme kuralı:
- \mathbf e_1, \mathbf e_2: bölünecek kümenin korelasyon alt matrisi \mathbf R_s'nin ilk iki özvektörü (birim uzunluklu, yüklere çevrilmeden).
- \theta^{*}: quartimax ölçütünü en büyükleyen açı; kod [0,\pi/2] aralığında 721 noktalı ızgarada arar, sonra \pm\pi/1440 aralığında sınırlı tek boyutlu en büyükleme yapar (
_quartimax_angle,varclus.py:93–105). - \mathbf t_m: döndürülmüş (eğik) bileşen yönleri; \ell_{jm} değişkenin bu bileşenle korelasyonu (
varclus.py:175–179). - Bölünme dejenere olursa (hiçbiri ya da hepsi taşınırsa) en zayıf bağlı tek değişken taşınır (
varclus.py:184–193).
Neden ikinci özdeğer bölme ölçütü?
Bir küme tek boyutluysa (tek bir gizil faktörü ölçüyorsa) korelasyon matrisinin yalnız birinci özdeğeri büyüktür; ikinci özdeğer 1'in altında kalır. \lambda_2>1 olması, kümede birinci bileşenin açıklayamadığı ve en az bir değişken kadar varyans taşıyan ikinci bir boyut bulunduğunu gösterir (Kaiser ölçütüyle aynı mantık). Bu mantıkla MAXEIGEN = 1 seçilebilir. MerQur'da varsayılan 0'dır: bölme yalnız K'ya ulaşınca durur.
Neden yükler değil özvektörler döndürülür?
MerQur bölmeyi döndürülmüş özvektörlerle yapar. Yükler (\mathbf V\sqrt{\boldsymbol\lambda}) döndürülüp en büyük kare yüke göre bölünseydi bölüntü farklı ve açıklanan varyans daha düşük çıkabilirdi (varclus.py:169–174). Dejenere bölünmede (hiçbir değişken taşınmazsa ya da hepsi taşınırsa) bir değişken öteki kümeye alınır; bölünme küme sayısını artırmazsa algoritma durur (varclus.py:184–231).
43.5.5 Küme özeti ve ek çıktılar
- Toplam oran: sonuç metnindeki "Toplam açıklanan varyans oranı" (
varclus.py:393–394). - \rho(C_a,C_b): küme bileşenleri arası korelasyon (
varclus.py:509–513). Küme bileşenleri dik değildir; bu matris kümelerin ne kadar ayrık olduğunu gösterir. - k taraması: ortalama bağlantı ağacı k=1,\dots,\min(p,10)'da kesilir ve her kesimde toplam oran hesaplanır (
varclus.py:522–531).
43.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Aşağıdaki ara değerler dogrulama/varclus/elle_hesap.py ile, MerQur kodu ve scipy kümeleme işlevleri çağrılmadan hesaplanmıştır: ortalama bağlantı elle (her adımda tüm çapraz çiftlerin ortalaması), quartimax açısı kapalı biçimle (\tan4\theta=D/C, Neuhaus ve Wrigley 1954), NCS ve arama evreleri yeniden yazılarak.
Adım 1 — Uzaklık ve birleştirme. Blok içi korelasyonlar 0,81–0,90 olduğu için blok içi uzaklıklar 0,10–0,19'dur; bloklar arası uzaklıklar 0,86–1,00'dır. Ortalama bağlantı önce her bloğu kendi içinde birleştirir. Fiziksel bloğun son üç birleşmesi:
| Birleşme | D(A,B) |
|---|---|
| (physical_m1, m6) ile (physical_m4) | 0,155650 |
| (m1, m6, m4) ile (physical_m2, m5) | 0,161136 |
| (m1, m6, m4, m2, m5) ile (physical_m3) | 0,171922 |
Bloklar arası birleşmeler 0,916755 (fiziksel + sosyal) ve 0,949356 (tümü) yüksekliğindedir. Ağaç k=3'te kesildiğinde uzaklığı 0,172 ile 0,917 arasında kalan bütün birleşmeler ayrılır: üç blok, üç kümedir.
Adım 2 — Küme bileşenleri ve özet.
| Küme | n_c | \lambda_1^{(c)} | \lambda_2^{(c)} | \lambda_1/n_c |
|---|---|---|---|---|
| Ruhsal | 6 | 5,398735 | 0,150080 | 0,899789 |
| Sosyal | 6 | 5,373163 | 0,159786 | 0,895527 |
| Fiziksel | 6 | 5,188096 | 0,193554 | 0,864683 |
Her kümede \lambda_2<0{,}2'dir: kümeler tek boyutludur ve MAXEIGEN = 1 ölçütüyle bölme burada durur.
Adım 3 — R² ve oran (mental_m1). Ruhsal kümenin skor katsayısı v_1/\sqrt{\lambda_1}=0{,}177056, yani v_1=0{,}177056\times\sqrt{5{,}398735}=0{,}411393:
| Değişken | R^2_{\text{own}} | R^2_{\text{next}} | Oran | Temsilci |
|---|---|---|---|---|
| mental_m1 | 0,913699 | 0,009507 | 0,087129 | ★ |
| mental_m4 | 0,890108 | 0,007605 | 0,110734 | |
| social_m5 | 0,904823 | 0,008210 | 0,095965 | ★ |
| physical_m2 | 0,879141 | 0,009886 | 0,122066 | ★ |
| physical_m3 | 0,848369 | 0,002485 | 0,152008 |
Temsilciler: mental_m1, social_m5, physical_m2. Tüm değişkenlerde R^2_{\text{next}}<0{,}015'tir.
Adım 4 — Küme bileşenleri arası korelasyonlar. Fiziksel–ruhsal 0,0848, fiziksel–sosyal −0,0931, ruhsal–sosyal 0,0086. Kümeler pratikte ilişkisizdir.
Adım 5 — k taraması. k=1\dots10 için toplam oran: 0,3300; 0,6214; 0,8867; 0,8967; 0,9065; 0,9152; 0,9236; 0,9318; 0,9401; 0,9474. k=2'den 3'e artış 0,265, 3'ten 4'e yalnız 0,010'dur: eğri k=3'te kırılır (Şekil 43.1).
Adım 6 — Bölücü algoritmanın ilk bölünmesi. Tüm değişkenlerin korelasyon matrisinin ilk dört özdeğeri 5,939793; 5,438385; 4,604357; 0,204973. Tek küme için \lambda_2=5{,}44>0 olduğundan bölünür. İlk iki özvektörün quartimax açısı \theta^{*}=-48{,}31°. Döndürülmüş bileşenlerle kare korelasyonlar (\ell_{j1}^2, \ell_{j2}^2): physical_m1 (0,2172; 0,2838), mental_m1 (0,7701; 0,0076), social_m1 (0,0071; 0,7052). Fiziksel ve sosyal maddeler ikinci bileşene daha yakın olduğu için yeni kümeye, ruhsal maddeler eski kümede kalır.
| Adım | Küme sayısı | \sum_c\lambda_1^{(c)} | Oran | En büyük \lambda_2 |
|---|---|---|---|---|
| 0 | 1 | 5,939793 | 0,3300 | 5,438385 |
| 1 | 2 (ruhsal | fiziksel + sosyal) | 11,184363 | 0,6214 | 4,785089 |
| 2 | 3 (üç blok) | 15,959995 | 0,8867 | 0,193554 |
İkinci adımda fiziksel + sosyal küme (\lambda_2=4{,}79) bölünür. k=3'te bölücü ve ortalama bağlantı aynı bölüntüyü verir; yalnız küme numaraları farklıdır (bölücüde ilk değişkenin kümesi 1 numaradır: fiziksel). k=20, MAXEIGEN = 1 ile çalıştırıldığında bölme 3 kümede durur, çünkü en büyük \lambda_2=0{,}194\le1.
Adım 7 — Tek üyeli küme (k=4). Ortalama bağlantı ağacı 4 kümede kesilince fiziksel bloğun en son katılan üyesi physical_m3 (D=0{,}1719) tek başına kalır. Onun için R^2_{\text{own}}=1, oran 0 olur ve otomatik temsilci seçilir. Geri kalan fiziksel maddelerin R^2_{\text{next}}'i 0,67'ye çıkar (physical_m1 oranı 0,3748), çünkü physical_m3 (tek üyeli kümenin bileşeni) onlarla 0,81–0,85 korelasyonludur. Toplam oran yalnız 0,8867'den 0,8967'ye çıkar.
43.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan alınmıştır; gui.panels.analyses.varclus ad alanında round() yalnız bellekte etkisizleştirilmiştir (dogrulama/varclus/merqur_calistir.py). R: 4.5.3, stats::hclust(as.dist(1 - abs(cor)), method = "average") + cutree (ortalama bağlantı bölüntüsü ve k taraması), küme istatistikleri eigen ve prcomp ile. Bölücü algoritmanın R'de hazır karşılığı olmadığı için bölücü bölüntü bağımsız Python uygulamasıyla doğrulanmış, R aynı bölüntülerin özdeğerlerini ve bölme geçmişini hesaplamıştır; ayrıca farklı bir ölçüt kullanan ClustOfVar::hclustvar da aynı üç bloğu vermiştir. Küme numaraları kaynaklar arasında farklı olduğundan kümeler üye bloklarıyla eşlenmiştir. Ölçüt: en büyük fark \le10^{-6}.
Ortalama bağlantı (k=3):
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| 1. özdeğer (mental) | 5,398735 | 5,398735 | 5,398735 | 8,9e−15 | ✓ |
| 2. özdeğer (mental) | 0,150080 | 0,150080 | 0,150080 | 1,6e−15 | ✓ |
| Açıklanan oran (mental) | 0,899789 | 0,899789 | 0,899789 | 7,8e−16 | ✓ |
| 1. özdeğer (sosyal) | 5,373163 | 5,373163 | 5,373163 | 4,4e−15 | ✓ |
| 2. özdeğer (sosyal) | 0,159786 | 0,159786 | 0,159786 | 1,0e−15 | ✓ |
| Açıklanan oran (sosyal) | 0,895527 | 0,895527 | 0,895527 | 7,8e−16 | ✓ |
| 1. özdeğer (fiziksel) | 5,188096 | 5,188096 | 5,188096 | 2,7e−15 | ✓ |
| 2. özdeğer (fiziksel) | 0,193554 | 0,193554 | 0,193554 | 7,8e−16 | ✓ |
| Açıklanan oran (fiziksel) | 0,864683 | 0,864683 | 0,864683 | 7,8e−16 | ✓ |
| Toplam açıklanan oran | 0,886666 | 0,886666 | 0,886666 | 7,8e−16 | ✓ |
| 1-R^2_{own} physical_m1 | 0,135009 | 0,135009 | 0,135009 | 1,1e−15 | ✓ |
| 1-R^2_{next} physical_m1 | 0,985952 | 0,985952 | 0,985952 | 0,0e+00 | ✓ |
| Oran physical_m1 | 0,136933 | 0,136933 | 0,136933 | 1,1e−15 | ✓ |
| 1-R^2_{own} physical_m2 | 0,120859 | 0,120859 | 0,120859 | 1,1e−15 | ✓ |
| 1-R^2_{next} physical_m2 | 0,990114 | 0,990114 | 0,990114 | 0,0e+00 | ✓ |
| Oran physical_m2 | 0,122066 | 0,122066 | 0,122066 | 4,4e−16 | ✓ |
| 1-R^2_{own} physical_m3 | 0,151631 | 0,151631 | 0,151631 | 2,6e−15 | ✓ |
| 1-R^2_{next} physical_m3 | 0,997515 | 0,997515 | 0,997515 | 0,0e+00 | ✓ |
| Oran physical_m3 | 0,152008 | 0,152008 | 0,152008 | 3,2e−15 | ✓ |
| 1-R^2_{own} mental_m1 | 0,086301 | 0,086301 | 0,086301 | 8,9e−16 | ✓ |
| 1-R^2_{next} mental_m1 | 0,990493 | 0,990493 | 0,990493 | 0,0e+00 | ✓ |
| Oran mental_m1 | 0,087129 | 0,087129 | 0,087129 | 8,9e−16 | ✓ |
| 1-R^2_{own} mental_m4 | 0,109892 | 0,109892 | 0,109892 | 8,9e−16 | ✓ |
| 1-R^2_{next} mental_m4 | 0,992395 | 0,992395 | 0,992395 | 1,1e−16 | ✓ |
| Oran mental_m4 | 0,110734 | 0,110734 | 0,110734 | 1,4e−15 | ✓ |
| 1-R^2_{own} social_m1 | 0,104487 | 0,104487 | 0,104487 | 2,4e−15 | ✓ |
| 1-R^2_{next} social_m1 | 0,988154 | 0,988154 | 0,988154 | 1,1e−16 | ✓ |
| Oran social_m1 | 0,105739 | 0,105739 | 0,105739 | 1,6e−15 | ✓ |
| 1-R^2_{own} social_m5 | 0,095177 | 0,095177 | 0,095177 | 7,8e−16 | ✓ |
| 1-R^2_{next} social_m5 | 0,991790 | 0,991790 | 0,991790 | 0,0e+00 | ✓ |
| Oran social_m5 | 0,095965 | 0,095965 | 0,095965 | 7,9e−16 | ✓ |
| Oran physical_m4 | 0,135208 | 0,135208 | 0,135208 | 1,5e−15 | ✓ |
| Oran physical_m5 | 0,142569 | 0,142569 | 0,142569 | 7,8e−16 | ✓ |
| Oran physical_m6 | 0,130551 | 0,130551 | 0,130551 | 1,0e−15 | ✓ |
| Oran mental_m2 | 0,096355 | 0,096355 | 0,096355 | 2,8e−15 | ✓ |
| Oran mental_m3 | 0,100207 | 0,100207 | 0,100207 | 1,2e−15 | ✓ |
| Oran mental_m5 | 0,105389 | 0,105389 | 0,105389 | 6,8e−16 | ✓ |
| Oran mental_m6 | 0,105586 | 0,105586 | 0,105586 | 1,1e−15 | ✓ |
| Oran social_m2 | 0,113796 | 0,113796 | 0,113796 | 7,8e−16 | ✓ |
| Oran social_m3 | 0,115388 | 0,115388 | 0,115388 | 2,2e−16 | ✓ |
| Oran social_m4 | 0,098758 | 0,098758 | 0,098758 | 8,7e−16 | ✓ |
| Oran social_m6 | 0,102172 | 0,102172 | 0,102172 | 1,3e−15 | ✓ |
| Küme bileşeni korelasyonu fiziksel–mental | 0,084822 | 0,084822 | 0,084822 | 1,5e−16 | ✓ |
| Küme bileşeni korelasyonu fiziksel–sosyal | −0,093087 | −0,093087 | −0,093087 | 2,5e−16 | ✓ |
| Küme bileşeni korelasyonu mental–sosyal | 0,008583 | 0,008583 | 0,008583 | 2,0e−16 | ✓ |
| k taraması, k = 1 | 0,329989 | 0,329989 | 0,329989 | 5,6e−16 | ✓ |
| k taraması, k = 2 | 0,621354 | 0,621354 | 0,621354 | 0,0e+00 | ✓ |
| k taraması, k = 3 | 0,886666 | 0,886666 | 0,886666 | 7,8e−16 | ✓ |
| k taraması, k = 4 | 0,896738 | 0,896738 | 0,896738 | 4,4e−16 | ✓ |
| k taraması, k = 5 | 0,906467 | 0,906467 | 0,906467 | 6,7e−16 | ✓ |
| k taraması, k = 6 | 0,915191 | 0,915191 | 0,915191 | 5,6e−16 | ✓ |
| k taraması, k = 7 | 0,923606 | 0,923606 | 0,923606 | 8,9e−16 | ✓ |
| k taraması, k = 8 | 0,931772 | 0,931772 | 0,931772 | 7,8e−16 | ✓ |
| k taraması, k = 9 | 0,940063 | 0,940063 | 0,940063 | 7,8e−16 | ✓ |
| k taraması, k = 10 | 0,947374 | 0,947374 | 0,947374 | 4,4e−16 | ✓ |
Bölücü algoritma, k=4 ve skor katsayıları:
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Bölücü geçmiş: 1 küme, açıklanan varyans | 5,939793 | 5,939793 | 5,939793 | 8,9e−16 | ✓ |
| Bölücü geçmiş: 1 küme, en büyük 2. özdeğer | 5,438385 | 5,438385 | 5,438385 | 1,8e−15 | ✓ |
| Bölücü geçmiş: 2 küme, açıklanan varyans | 11,184363 | 11,184363 | 11,184363 | 1,1e−14 | ✓ |
| Bölücü geçmiş: 2 küme, en büyük 2. özdeğer | 4,785089 | 4,785089 | 4,785089 | 5,3e−15 | ✓ |
| Bölücü geçmiş: 3 küme, açıklanan varyans | 15,959995 | 15,959995 | 15,959995 | 3,2e−14 | ✓ |
| Bölücü geçmiş: 3 küme, en büyük 2. özdeğer | 0,193554 | 0,193554 | 0,193554 | 5,0e−16 | ✓ |
| Bölücü k = 3: üç blokla aynı bölüntü (1 = evet) | 1 | 1 | 1 | 0,0e+00 | ✓ |
| MAXEIGEN = 1 ile durulan küme sayısı | 3 | 3 | — | 0,0e+00 | ✓ |
| k = 4: oran physical_m1 | 0,374792 | 0,374792 | 0,374792 | 1,5e−15 | ✓ |
| k = 4: oran physical_m3 | 0,000000 | 0,000000 | 0,000000 | 0,0e+00 | ✓ |
| k = 4: oran mental_m1 | 0,087254 | 0,087254 | 0,087254 | 8,9e−16 | ✓ |
| k = 4: physical_m3 tek üyeli küme (1 = evet) | 1 | 1 | 1 | 0,0e+00 | ✓ |
| Skor katsayısı mental_m1 | 0,177056 | 0,177056 | 0,177056 | 2,2e−16 | ✓ |
| Skor katsayısı mental_m2 | 0,176096 | 0,176096 | 0,176096 | 3,1e−16 | ✓ |
| Skor katsayısı social_m1 | 0,176119 | 0,176119 | 0,176119 | 3,1e−16 | ✓ |
| Skor katsayısı social_m2 | 0,175247 | 0,175247 | 0,175247 | 1,1e−16 | ✓ |
| Skor katsayısı physical_m1 | 0,179266 | 0,179266 | 0,179266 | 1,4e−16 | ✓ |
| Skor katsayısı physical_m2 | 0,180726 | 0,180726 | 0,180726 | 5,8e−16 | ✓ |
Sonuç: 73 büyüklüğün tamamı ölçütü karşılar; en büyük fark 10^{-14} düzeyindedir. 1-R^2_{\text{own}} ve 1-R^2_{\text{next}} yedi değişken için, oran 18 değişkenin hepsi için gösterilmiştir.
43.7 Çıktıyı okuma
Varsayılan ayarlar ve üç ek çıktıyla sonuç metni (kısaltılmış):
Değişken Kümeleme
  Yöntem            = Ortalama bağlantı (1−|r|, birleştirici)
  Küme sayısı       = 3
  Değişken sayısı   = 18
  Gözlem sayısı (n) = 180

── Küme Üyelikleri ──
  1:
    ★ mental_m1                 1-R²_own=0.0863  1-R²_next=0.9905  Oran=0.0871
      mental_m2                 1-R²_own=0.0962  1-R²_next=0.9982  Oran=0.0964
      ...
  3:
    ★ physical_m2               1-R²_own=0.1209  1-R²_next=0.9901  Oran=0.1221
      ...
── Küme Özeti (1. temel bileşen) ──
  1: n=6  1. özdeğer=5.3987  açıklanan oran=0.8998
  2: n=6  1. özdeğer=5.3732  açıklanan oran=0.8955
  3: n=6  1. özdeğer=5.1881  açıklanan oran=0.8647
  Toplam açıklanan varyans oranı = 0.8867

── Küme Temsilcileri ──
  mental_m1, social_m5, physical_m2
── Küme özeti ──
  Küme         n   1. özdeğer   2. özdeğer   Açık. oran
  1            6       5.3987       0.1501       0.8998
── Küme bileşenleri arası korelasyonlar ──
                 C1       C2       C3
  C1         1.0000   0.0086   0.0848
── k taraması: açıklanan varyans oranı (ortalama bağlantı) ──
  k=1: 0.330  k=2: 0.621  k=3: 0.887  k=4: 0.897  ...
| Satır/Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Künye | Yöntem, küme sayısı, değişken ve gözlem sayısı | Bölücüde gerçekleşen küme sayısı yazılır; ortak künye de aynı sayıyı gösterir. |
| Küme Üyelikleri | Küme başına değişkenler, oran sırasıyla; ★ temsilci | 1-R^2_{\text{own}} küçük, 1-R^2_{\text{next}} 1'e yakın olmalı. Oran 0,3'ün altı iyi üyelik sayılır (yaygın kural, kesin eşik değil). |
| Küme Özeti | n_c, \lambda_1, \lambda_1/n_c, toplam oran | Toplam oran, p değişkenin yerine k küme bileşeni kullanıldığında korunan bilgi payıdır. |
| Bölme geçmişi (bölücü) | Adım başına küme sayısı, açıklanan varyans, oran, en büyük \lambda_2 | En büyük \lambda_2 1'in altına düştüğünde ek bölme anlamlı bir boyut ayırmaz. |
| Ek: Küme özeti | 1. ve 2. özdeğer | \lambda_2>1 olan küme ikiye ayrılmaya adaydır. |
| Ek: R² tablosu | R^2_{\text{own}}, R^2_{\text{next}} | Ana tablonun tümleyenleri. |
| Ek: Küme arası korelasyon ve skor katsayıları | Bileşenler arası \rho; v_j/\sqrt{\lambda_1} | Yüksek \rho (> 0,5) kümelerin tam ayrışmadığını gösterir. Skor katsayılarıyla z-puanlarından küme puanı hesaplanabilir. |
| Ek: k taraması | k=1\dots10 için toplam oran | Eğrinin düzleştiği k makul küme sayısıdır; her zaman ortalama bağlantıyla hesaplanır. |
Tablo sekmesi değişken başına küme, 1-R^2_{\text{own}}, 1-R^2_{\text{next}}, oran ve temsilci işaretini verir; Grafik sekmesi 1-R^2_{\text{own}} çubuklarını (dendrogram seçildiyse ağaç ve tarama eğrisini) çizer.
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
On sekiz yaşam kalitesi maddesi, 1-|r| uzaklığı ve ortalama bağlantıyla değişken kümelemeye alındı (N = 180). Üç kümeli çözüm toplam standartlaştırılmış varyansın %88,7'sini açıkladı (iki kümede %62,1, dört kümede %89,7). Kümeler beklenen fiziksel, ruhsal ve sosyal alt boyutlarla birebir örtüştü; küme bileşenlerinin açıkladığı oranlar sırasıyla %86,5, %90,0 ve %89,6, kümelerin ikinci özdeğerleri 0,19'un altındaydı. Küme bileşenleri arasındaki korelasyonlar |ρ| ≤ 0,09 idi. Her kümede (1-R^2_{\text{own}})/(1-R^2_{\text{next}}) oranı en küçük madde temsilci seçildi: physical_m2 (0,122), mental_m1 (0,087) ve social_m5 (0,096). Bölücü algoritma aynı bölüntüyü verdi.
43.8 Uzman soruları
S1. Varsayılan ortalama bağlantı bölücü algoritmayla aynı sonucu verir mi?
Her zaman değil: MerQur varsayılanı ortalama bağlantıdır (varclus.py:249–251). Bölücü algoritma için "Bölücü" seçilip MAXEIGEN = 1 ve yeterince büyük K girilmelidir. Bu durumda bölme kuralı (orthoblique, ham quartimax), NCS ve arama evreleri ile en çok \lfloor1000/p\rfloor arama turu uygulanır; eşit ağırlıklı ortalama bileşeni, hiyerarşi zorlaması ve kovaryans matrisi seçenekleri yoktur. Bu veride iki yöntem aynı üç kümeyi verir.
S2. Temsilci seçimi neden 1 − R² oranıyla, R²_own ile değil?
Yalnız R^2_{\text{own}}, iki kümenin arasında duran değişkeni ödüllendirebilir. Oranın paydası 1-R^2_{\text{next}}, değişkenin en yakın diğer kümeyle paylaştığı varyansı cezalandırır. Bu veride iki ölçüt aynı temsilcileri seçer, çünkü R^2_{\text{next}} her yerde 0,015'in altındadır; bloklar arası korelasyonun yüksek olduğu verilerde ayrışırlar.
S3. k = 4'te tek maddelik bir küme çıktı ve o madde temsilci oldu. Bu doğru mu?
Hesap doğrudur ama yorumu yanıltıcıdır. Tek üyeli kümede küme bileşeni değişkenin kendisidir; R^2_{\text{own}}=1 ve oran 0'dır, dolayısıyla seçilecek başka aday yoktur. physical_m3 ayrı bir boyut olduğu için değil, fiziksel bloğun en zayıf bağlı üyesi olduğu (D=0{,}172) için ayrılmıştır. Toplam oranın yalnız 0,010 artması ve physical_m3'ün diğer fiziksel maddelerle 0,81–0,85 korelasyonu bunu gösterir. Tek üyeli kümeler, k fazla seçildiğinin işaretidir.
S4. Küme numaraları iki yöntemde neden farklı?
Ortalama bağlantıda numaralar scipy fcluster'ın ağaç sırasından gelir (bu veride ruhsal = 1); bölücü yöntemde numaralar veri setindeki ilk değişkenin kümesi 1 olacak biçimde yeniden sıralanır (varclus.py:232–236; bu veride fiziksel = 1). Numara bir etikettir; karşılaştırma üyeliklerle yapılmalıdır.
S5. Ters kodlanmış bir madde doğru kümeye düşer mi?
Evet. Uzaklık 1-|r| olduğu için işaret önemsizdir; R^2 değerleri de işaretsizdir. Ancak küme puanı (skor katsayılarıyla) hesaplanırken ters madde negatif katsayı alır; ek çıktıdaki katsayılar, toplamları pozitif olacak biçimde yönlendirilir (varclus.py:494). Hmisc varclus da benzer biçimde kare korelasyon kullanır.
S6. Neden faktör analizi değil de değişken kümeleme?
Faktör analizi ortak ve özgün varyansı ayırır, döndürme sonrası her değişkenin her faktörde bir yükü vardır ve yorum yük eşiklerine dayanır. Değişken kümeleme her değişkeni tek kümeye atar, küme bileşeni basit bir temel bileşendir ve sonuç doğrudan bir "değişken listesi + temsilci" olarak kullanılır. Amaç değişken azaltma ve çoklu doğrusallığı kırmaksa kümeleme daha işlevseldir; amaç gizil yapı modeli kurmaksa faktör analizi gerekir. Bu veride iki yaklaşımın aynı üç boyutu vermesi beklenir.
S7. Hesap korelasyon matrisinden mi, ham veriden mi?
Bütün kümeleme ve özdeğer hesapları korelasyon matrisi üzerindendir; R^2'ler ise ham değişkenle küme bileşeni arasındaki Pearson korelasyonundan hesaplanır (varclus.py:302–303). Ölçek farkı sonucu etkilemez. Değişkenlerin dağılımı çok çarpıksa Pearson korelasyonu yapıyı zayıf yansıtabilir; MerQur Spearman seçeneği sunmaz.
S8. Küçük örneklemde güvenilir mi?
Kod yalnız n\ge3 ister. Korelasyon matrisi n<p'de tekildir; ortalama bağlantı çalışır, ama küme bileşenlerinin özdeğerleri ve R^2'ler kararsızdır. Bu veride n/p=10'dur. Genel olarak her korelasyonun kararlı kestirilebileceği bir örneklem (en az birkaç yüz gözlem ya da n/p\ge10) önerilir; MerQur küçük örneklem uyarısı vermez.
43.9 Sık hatalar ve tuzaklar
- Varsayılanın bölücü algoritma olduğunu sanmak. Varsayılan ortalama bağlantıdır; bölücü algoritma için "Bölücü" ve MAXEIGEN = 1 seçilmelidir.
- İstenen K ile gerçekleşen küme sayısını karıştırmak. Bölücü yöntemde bölme erken durursa küme sayısı istenen K'dan az olur (ör. 20 istenip 3 bulunur); çıktı ve künye gerçekleşen sayıyı yazar.
- Tek üyeli kümelerin temsilcisini anlamlı sanmak. Oran tanım gereği 0'dır (43.8 S3).
- k taramasını bölücü yöntemin sonucu sanmak. Tarama her zaman ortalama bağlantı ağacından hesaplanır.
- MAXEIGEN'i ortalama bağlantıda değiştirmeye çalışmak. Alan yalnız bölücüde etkindir.
- Temsilci değişkeni küme bileşeniyle eş tutmak. Temsilci tek bir maddedir; kümenin bilgisinin R^2_{\text{own}} kadarını taşır (mental_m1 için %91). Kümenin tamamını kullanmak için skor katsayılarıyla küme puanı hesaplanabilir.
- Küme numarasını anlamlı saymak. Numara yönteme göre değişir (43.8 S4).
- Kategorik ya da sıralı az düzeyli değişkenleri doğrudan vermek. Pearson korelasyonu bu değişkenlerde ilişkiyi zayıflatır; kümeleme yapay olarak dağınık çıkabilir.
43.10 Kaynaklar
- Chavent, M., Kuentz-Simonet, V., Liquet, B., & Saracco, J. (2012). ClustOfVar: An R package for the clustering of variables. Journal of Statistical Software, 50(13), 1–16. https://doi.org/10.18637/jss.v050.i13
- Harris, C. W., & Kaiser, H. F. (1964). Oblique factor analytic solutions by orthogonal transformations. Psychometrika, 29(4), 347–362. https://doi.org/10.1007/BF02289601
- Neuhaus, J. O., & Wrigley, C. (1954). The quartimax method: An analytical approach to orthogonal simple structure. British Journal of Statistical Psychology, 7(2), 81–91. https://doi.org/10.1111/j.2044-8317.1954.tb00147.x
- SAS Institute Inc. (2023). SAS/STAT 15.3 user's guide: The VARCLUS procedure. SAS Institute.
- Sokal, R. R., & Michener, C. D. (1958). A statistical method for evaluating systematic relationships. University of Kansas Science Bulletin, 38, 1409–1438.
- Vigneau, E., & Qannari, E. M. (2003). Clustering of variables around latent components. Communications in Statistics – Simulation and Computation, 32(4), 1131–1150. https://doi.org/10.1081/SAC-120023882