18. Mann–Whitney U Testi
Analiz kimliği: mann_whitney · Menü adı: Mann-Whitney U · Panel: gui/panels/analyses/mann_whitney.py · Motor: stats/hypothesis.py, HypothesisTests.mann_whitney (satır 3576–3744), ek çıktılar _mw_adv (1215–1234), _mw_q1_extras (1353–1455), _np1way_block (1332–1350)
18.1 Ne işe yarar
Mann–Whitney U testi (Wilcoxon sıra toplamı testi), birbirinden bağımsız iki grubun değerlerinden birinin ötekinden büyük olma eğiliminde olup olmadığını sınar. Ortalamalar yerine birleşik sıralamadaki sıraları kullanır. Cevapladığı soru şudur: "Rastgele seçilen bir 1. grup gözlemi, rastgele seçilen bir 2. grup gözleminden büyük olmaya, küçük olmaktan daha yatkın mı?"
- X: 1. grubun rastgele bir gözlemi; Y: 2. grubun rastgele bir gözlemi.
- P(X>Y)+\tfrac12P(X=Y): stokastik üstünlük olasılığı; bağlı çiftlerin yarısı her iki yöne sayılır. MerQur bu olasılığı "CLES" satırında verir.
- "1. grup", MerQur'un ortak düzey sırasıyla belirlenir (
_ordered_levels): kategorik tipte ya da Veri sekmesinde tanımlı sıra; sayısal ya da sayı içeren etiketlerde sayısal/doğal sıra ("g2" < "g10"); aksi hâlde verideki ilk görülme sırası. Kullanılan sıra çıktıda yazılır.
İki dağılımın biçimi aynı, yalnız konumu kaymışsa (Y \overset{d}{=} X-\Delta), H_0 "medyanlar eşittir" (\Delta=0) biçimine indirgenir. Biçimler farklıysa test medyan testi değildir; bu bölümün Tıp örneği tam olarak bu durumu gösterir.
Ne zaman kullanılır? Bağımlı değişken sıralı (Likert, 1–7 puan) ya da sürekli ama çarpık veya aykırı değerliyse; iki grup farklı kişilerden oluşuyorsa; soru "hangi grup daha yüksek değer alma eğiliminde?" ise.
Ne zaman kullanılmaz?
- Aynı kişilerde iki ölçüm varsa: Wilcoxon İşaretli Sıra (Bölüm 19) ya da İşaret Testi (Bölüm 23).
- İkiden çok grup varsa: Kruskal-Wallis (MerQur grup sayısı 2 değilse hata verir,
hypothesis.py:3596–3597). - Asıl soru ortalama farkıysa ve dağılımlar kabaca normalse: Bağımsız t Testi (Bölüm 5); daha güçlüdür ve farkı özgün birimde verir.
- Gruplar yayılımca belirgin farklıysa ve soru "medyanlar farklı mı?" ise: Mann–Whitney bu soruyu yanıtlamaz; Brunner-Munzel (bu modülde ek çıktı) ya da medyan testi düşünülmelidir.
- İki grubun yayılımı karşılaştırılacaksa: bu modüldeki ölçek testleri ya da Levene.
Sık karıştırılan analizler. "Mann–Whitney U" ile "Wilcoxon sıra toplamı" aynı testtir: U_1=R_1-n_1(n_1+1)/2 olduğundan biri ötekinin doğrusal dönüşümüdür. "Wilcoxon işaretli sıra" ise eşleşik veri içindir. Kolmogorov–Smirnov iki örneklem testi (bu modülde ek çıktı) dağılımların herhangi bir farkına duyarlıdır; Mann–Whitney yalnız konum ya da stokastik üstünlük farkına.
18.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Bağımsızlık | Gözlemler gruplar arasında ve grup içinde birbirinden bağımsızdır. | Tasarımla sağlanır; denetlenmez. |
| En az sıralı ölçek | Değerler sıralanabilir; eşit aralık gerekmez. | Değer sütunu pd.to_numeric(..., errors="coerce") ile sayıya çevrilir; sayıya çevrilemeyen hücre eksik sayılır (hypothesis.py:3599–3600). |
| Aynı biçim (yalnız medyan yorumu için) | İki dağılım yalnız konumca farklıdır. | Denetlenmez. Ölçek testleri ve Brunner-Munzel ek çıktısı biçim farkını görmeyi sağlar. |
| İki grup | Grup değişkeninde tam iki düzey. | Değilse hata (hypothesis.py:3596–3597). |
Normallik ve varyans eşitliği gerekmez. Bağlar (eşit değerler) testi geçersiz kılmaz; MerQur her yolda bağlara orta sıra verir ve varyansı bağ düzeltmesiyle hesaplar.
Eksik değer. Grup değeri eksik olan satır hiçbir gruba girmez (_ordered_levels önce dropna() yapar, hypothesis.py:1204–1212). Değer sütunu eksik olan satır kendi grubundan atılır (hypothesis.py:3599–3600). Künyedeki n df[[grup, değer]].dropna() satır sayısıdır (stats_panel.py:5625–5626).
Uç durumlar.
- Bir grupta hiç geçerli gözlem yoksa hata (
hypothesis.py:3605–3607). n_1=1 kabul edilir; modülün bilgi metnindeki "her grupta n≥5" (mann_whitney.py:31) bir öneridir, kod sınırı değildir. - Tüm değerler eşitse bağ düzeltmeli varyans sıfırdır ve test tanımsızdır; p=1 yazılmaz, Kruskal–Wallis'teki gibi çevrilmiş hata iletisi verilir.
- n_1n_2>4\,000\,000 ise ikili fark matrisi kurulmaz; Hodges–Lehmann kestirimi ve GA atlanır, uyarı yazılır (
hypothesis.py:3666–3671). - "Tam (exact)" yöntemde bağ varsa ve koşullu dağılım tablosu çok büyükse (>2{,}5\times10^7 hücre) bağ düzeltmeli asimptotik yaklaşıma dönülür ve bu bir uyarıyla yazılır (
hypothesis.py:3638–3650).
18.3 Parametreler
Varsayılanlar mann_whitney.py:38–101 ve _advanced_options.py içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Grup Sütunu | veriye bağlı | Tam iki düzeyli gruplama değişkeni. | Düzey sırası U_1'in, rank-biserial r'nin ve Z'nin işaretini belirler. |
| Değer Sütunu | veriye bağlı | Karşılaştırılan sayısal ya da sıralı değişken; çoklu seçilebilir. | Her sütun ayrı test edilir; çoklu karşılaştırma düzeltmesi yoktur. |
| Güven Düzeyi | %95 | \alpha=1-\text{düzey}. | H₀ kararı, HL GA ve rank-biserial GA. |
| Hipotez yönü | Çift yönlü (≠) | Sağ yönlü: H_1 1. grup büyük; sol yönlü: 1. grup küçük. | Yalnız p; HL GA ve rank-biserial GA her zaman çift yönlüdür. |
| Hesaplama yöntemi | Otomatik | Otomatik / Tam (exact) / Asimptotik. | p değeri (18.5.3). |
| Etki büyüklükleri: CLES | kapalı | U_1/(n_1n_2). | Ek satır. |
| Etki büyüklükleri: Z / √N | kapalı | Bağ düzeltmeli Z ve \lvert Z\rvert/\sqrt N. | Ek satır. |
| Ek çıktı: Süreklilik düzeltmesi | açık | Asimptotik p'de payda 0,5 düzeltmesi. | Yalnız asimptotik p. |
| Ek çıktı: Betimsel | kapalı | Grup başına n, ortalama, SS, medyan, çarpıklık. | Ek bölüm. |
| Permütasyon p | Yok | Kesin (koşullu permütasyon) ya da Monte Carlo (B = 10000). | Ek satır; ana p değişmez. |
| Ek çıktılar: Rank-biserial GA | kapalı | Fisher z dönüşümlü GA. | Ek satır. |
| Ek çıktılar: Brunner-Munzel | kapalı | Varyans eşitliği istemeyen stokastik üstünlük testi. | Ek bölüm. |
| Ek çıktılar: KS, Wald-Wolfowitz, Moses | kapalı | Üç ek iki örneklem testi. | Ek bölüm. |
| Ek çıktılar: Kesin HL GA | kapalı | Bağsız veride kesin U dağılımına dayalı HL GA. | Ek satır; bağ varsa hesaplanmaz. |
| Puan / ölçek testleri: Van der Waerden + Savage | kapalı | Doğrusal sıra puanlı konum testleri. | Ek bölüm. |
| Puan / ölçek testleri: Ölçek testleri | kapalı | Siegel–Tukey, Ansari–Bradley, Mood, Klotz, Fligner–Killeen. | Ek bölüm. |
| Tohum | 12345 | Monte Carlo permütasyonunun üreteci. | Yalnız Monte Carlo p. |
Süreklilik düzeltmesi neden kesin yöntemi etkilemez?
U kesikli bir istatistiktir; sürekli normal eğriyle yaklaşırken her basamağın yarısı kadar (0,5) pay vermek kuyruk olasılığını kesin değere yaklaştırır. Kesin ve permütasyon yolları zaten kesikli dağılımın kendisini kullandığından düzeltmeye gerek yoktur. Hodges–Lehmann GA'sı da düzeltmesiz kurulur, çünkü R başvuru değerleri böyledir (hypothesis.py:862–864). Kutunun ipucu bunu doğru yazar.
18.4 Tıp örneği
Dosya: english/datasets/Tip/14_mann_whitney_diabetes_survival_quality.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/14_mann_whitney_diabet_yasam_kalite.xlsx).
| Değişken | Rol | Tür | Açıklama |
|---|---|---|---|
diabetes_type |
Grup Sütunu | nominal, 2 düzey | type-1 (n = 40), type-2 (n = 45); etiketler sayı içerdiği için doğal sırayla type-1 1. gruptur. |
survival_quality |
Değer Sütunu | sıralı (1–7 puan) | Yaşam kalitesi puanı; iki grupta da medyan 4. |
patient_id |
kullanılmaz |
n ve eksik değer: 85 hasta, eksik değer yok. Puanlar yedi değer aldığından veride yoğun bağ vardır: 85 gözlem yalnız 7 farklı değerde toplanır.
Klinik soru: Tip 1 ve tip 2 diyabetli hastaların yaşam kalitesi puanları farklı mı? (VIDEO_SCRIPT_TR.txt, #14.)
Seçilen ayarlar: Arayüz varsayılanları. Sayısal yürüyüş için tüm ek çıktı kutuları açık, permütasyon "Kesin" olarak ikinci bir çalıştırma; ayrıca "Tam (exact)", süreklilik düzeltmesiz, tek yönlü ve Monte Carlo çalıştırmaları yapılmıştır.
Şekil 18.1. İki grupta puan sıklıkları. Gri sayılar, her puanın birleşik sıralamada aldığı orta sıradır. Medyanlar eşit, ama type-2 puanları iki uçta yığılmıştır.
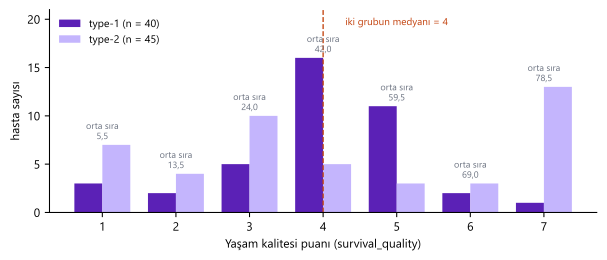
Şekil, bu verinin öğretici yanını gösterir: type-1 grubu ortada (4–5) toplanır, type-2 grubu 1–3 ve 7'de yığılır. Konum aynı, yayılım çok farklıdır. Mann–Whitney bu farkı görmez; ölçek testleri görür (18.6, Adım 7).
18.5 Formüller ve hesap adımları
MerQur'un sırası şudur: (1) grup düzeylerini sırala ve iki grubu ayır, (2) U_1 ve p'yi scipy.stats.mannwhitneyu ile hesapla (yöntem seçimine göre), (3) "Tam" seçildiyse ve bağ varsa p'yi koşullu kesin dağılımdan yeniden hesapla, (4) rank-biserial r'yi kur, (5) Hodges–Lehmann kestirimini ve testin ters çevrilmesiyle GA'sını kur, (6) orta sıra ve sıra toplamı tablosunu yaz, (7) istenen ek etki büyüklüklerini ve ek testleri ekle.
18.5.1 Birleşik sıralama ve U istatistiği
İki grubun N=n_1+n_2 gözlemi birlikte küçükten büyüğe sıralanır. Bağlı değerler, kapladıkları sıraların ortalamasını (orta sıra) alır.
- R_1: 1. grubun birleşik sıralamadaki sıra toplamı.
- U_1: x_i>y_j olan (i,j) çiftlerinin sayısı artı bağlı çiftlerin yarısı; 0\le U_1\le n_1n_2.
- U_2: aynı sayım 2. grup için.
- MerQur'un "U" diye yazdığı ve sonuç nesnesinde sakladığı değer her zaman U_1'dir (scipy'nin döndürdüğü istatistik); \min(U_1,U_2) değildir. R
wilcox.test'inW'si de U_1'dir.
Neden n₁(n₁+1)/2 çıkarılır?
- grubun alabileceği en küçük sıra toplamı 1+2+\dots+n_1=n_1(n_1+1)/2'dir (tüm 1. grup en altta). Bu sabiti çıkarmak, sıra toplamını "kaç ikili karşılaştırmayı 1. grup kazandı" sayımına çevirir. Böylece U_1/(n_1n_2) doğrudan bir olasılık kestirimi olur.
18.5.2 Normal yaklaşım ve bağ düzeltmesi
H_0 altında E(U_1)=n_1n_2/2'dir. Bağ düzeltmeli varyans ve iki yönlü p:
- t_j: j. bağ grubundaki gözlem sayısı (aynı değeri alan gözlemler); bağsız değerde t_j^3-t_j=0.
- 0{,}5: süreklilik düzeltmesi; "Süreklilik düzeltmesi" kapalıysa çıkarılmaz.
- Sağ yönlü (H_1: 1. grup büyük) p=1-\Phi\big((U_1-n_1n_2/2-0{,}5)/\sigma_U\big); sol yönlüde U_1 yerine U_2 konur (scipy
_mannwhitneyu.py,alternativedalı).
Bağ düzeltmesi neden varyansı küçültür?
Bağlı gözlemler aynı orta sırayı aldığında sıraların yayılımı azalır; 1{,}2,\dots,N sıralarının varyansı (N^2-1)/12 iken bağlı sıraların varyansı bundan \sum(t^3-t)/[12N] kadar küçüktür. U'nun varyansı sıra varyansıyla orantılı olduğundan aynı oranda küçülür. Düzeltme yapılmazsa varyans abartılır, z küçülür ve test tutucu olur. Yoğun bağlı Likert verisinde fark belirgindir.
18.5.3 Yöntem seçimi: otomatik, tam, asimptotik
Koddaki tercih
Otomatik, scipy'nin kuralıdır: iki grubun ikisi de 8'den büyükse ya da veride bağ varsa asimptotik, aksi hâlde bağsız kesin U dağılımı. MerQur'un ek kuralı ("en küçük grup < 5, N\le60 ve bağ yoksa kesin", hypothesis.py:3617–3621) scipy'nin kuralının alt kümesidir; bugünkü scipy ile sonucu değiştirmez, scipy kuralı değişirse küçük örneklemde kesin yolu güvenceye alır.
Tam (exact) seçildiğinde bağ yoksa scipy'nin kesin dağılımı kullanılır. Bağ varsa scipy'nin "exact" yolu bağları yok sayar; MerQur bunun yerine koşullu permütasyon dağılımını kurar: gözlenen orta sıralar sabit tutulur, N sıradan n_1'inin 1. gruba düşebileceği tüm \binom{N}{n_1} atama eşit olasılıklı sayılır (_subset_sum_dist, hypothesis.py:2075–2092). İki yönlü p, \lvert R_1-E(R_1)\rvert'den büyük ya da eşit sapmaların olasılığıdır (_perm_p_from_dist, hypothesis.py:2095–2104). Bu, R coin::wilcox_test(distribution = "exact") ile aynı tanımdır.
18.5.4 Rank-biserial r ve CLES
- r_{rb}: -1 ile 1 arasında; Cureton (1956) ve Kerby (2014) "basit fark" biçimi: r_{rb}=P(Y>X)-P(X>Y) (bağlar yarı yarıya).
- İşaret: r_{rb}>0 ise 2. grup büyük olma eğilimindedir; MerQur bunu çıktıda açıkça yazar (
res_hyp_mwu_r_sign_rule). - Etiket Cohen'in korelasyon eşikleriyle verilir: 0,1 küçük, 0,3 orta, 0,5 büyük (
_effect_label_r,hypothesis.py:240–246).
İşaret kuralı R'den farklı
R effectsize::rank_biserial(x, y) r=2U_1/(n_1n_2)-1 verir; 1. grup büyükse pozitiftir. MerQur'un r'si bunun tam ters işaretlisidir. Büyüklük aynıdır; raporda yönü sözle yazın.
İsteğe bağlı Z satırı bağ düzeltmeli varyansla, süreklilik düzeltmesiz ve U_1 yönünde kurulur: Z=(U_1-n_1n_2/2)/\sigma_U (hypothesis.py:1223–1229). Bu yüzden Z'nin işareti r_{rb}'ninkinin tersidir; yanındaki r=\lvert Z\rvert/\sqrt N işaretsizdir.
Rank-biserial GA Fisher z dönüşümüyle kurulur (hypothesis.py:1388–1396):
Bu, effectsize::rank_biserial tanımıdır; r_{rb}=\pm1 iken dönüşüm tanımsız olduğundan değer \pm0{,}9999999'a kırpılır.
18.5.5 Hodges–Lehmann kestirimi ve güven aralığı
Konum kayması \Delta için kestirim, tüm ikili farkların medyanıdır:
GA, testin ters çevrilmesiyle kurulur: her aday kayma d için 1. grup d kadar kaydırılır, birleşik sıralama ve bağlar yeniden sayılır, bağ düzeltmeli standart istatistik hesaplanır:
- R_1(d): x-d ile y'nin birleşik sıralamasında 1. grubun sıra toplamı.
- t_j(d): kaydırmadan sonraki bağ grupları (kaydırma yeni bağlar oluşturur ya da eskilerini bozar).
- GA sınırları: W(d)=z_{1-\alpha/2} ve W(d)=-z_{1-\alpha/2} eşitliklerinin kökleri.
Koddaki tercih
W(d), d'de artmayan bir basamak fonksiyonudur ve yalnız ikili farkların değerlerinde sıçrar. R wilcox.test(conf.int = TRUE, exact = FALSE) kökü uniroot ile yaklaşık bulur. MerQur kökü sıralı ikili farklar üzerinde ikili aramayla tam bulur: her aday noktanın sağındaki aralığın orta noktasında W değerlendirilir; kök, bu değerin \le z olduğu ilk noktadır (_hl_ci_inversion, hypothesis.py:896–927; _hl_w_two, 848–859). Sonuç her zaman bir ikili farktır; R'nin değeri bundan uniroot toleransı (\approx10^{-4}) kadar sapar. GA her zaman çift yönlü ve süreklilik düzeltmesizdir.
Neden test tersine çevirme?
Normal yaklaşıma dayalı kapalı biçimli tanım (K = round(C*), bağ düzeltmeli varyansla) bağları kaydırılmış veride yeniden saymaz. Ters çevirme yöntemi her aday kaymada bağları yeniden sayar ve GA'yı testin kendisiyle tutarlı kılar. Çıktı ve "Hesaplama yöntemi" ipucu "test tersine çevirme" yazar. İstenen güven düzeyine basamaklı W(d) nedeniyle tam ulaşılamıyorsa bu uyarıyla bildirilir.
Kesin HL GA (isteğe bağlı) yalnız bağsız veride ve N\le400'de kurulur: kesin U dağılımının \alpha/2 niceliği q_u bulunur, GA [D_{(q_u)};\ D_{(n_1n_2-q_u+1)}]'dir (D: sıralı ikili farklar; R wilcox.test(exact = TRUE) ile aynı, hypothesis.py:1436–1451).
18.5.6 Ek testler
Brunner–Munzel. Varyans eşitliği istemeden p=P(Y>X)+\tfrac12P(X=Y) için H_0:p=1/2 sınar. Grup içi ve birleşik sıralardan "yerleşim" varyansları hesaplanır; istatistik Welch tipi t dağılımıyla değerlendirilir (scipy.stats.brunnermunzel(..., distribution="t"), hypothesis.py:1397–1405):
- \bar R_1,\ \bar R_2: birleşik sıralamada grup ortalama sıraları.
- \hat\sigma_k^2: k. grubun birleşik sırası ile grup içi sırası arasındaki farkın varyansı, karşı grubun büyüklüğünün karesine bölünmüş (Brunner ve Munzel 2000).
- \hat p: MerQur'un "p̂ = P(2. grup > 1. grup) + ½P(=)" satırı; CLES'in tümleyenidir.
Kolmogorov–Smirnov. D=\max_t\lvert F_1(t)-F_2(t)\rvert, Z=D\sqrt{n_1n_2/N} ve p Kolmogorov sınır dağılımından (kstwobign); bağlı veride tutucudur. Wald–Wolfowitz birleşik sıralamada grup etiketlerinin dizi sayısını sayar; bağlarda 1. grup önce yazılır, N\le30'da kesin, aksi hâlde süreklilik düzeltmeli normal, tek yönlü (az dizi) p (hypothesis.py:1414–1423). Moses aşırı tepki testi 1. grubu kontrol sayar; kontrol sıralarının her iki ucundan h=\max(\lfloor0{,}05\,n_1\rfloor,1) gözlem kırpılır ve kalan açıklık S_h'nin kesin olasılığı verilir (hypothesis.py:1424–1435).
Doğrusal sıra puan testleri. Her sıra konumuna bir puan a_j verilir; bağlı gözlemler bağ grubundaki konum puanlarının ortalamasını alır. 1. grubun puan toplamı S koşullu permütasyon varyansıyla standartlaştırılır (hypothesis.py:1294–1323):
| Test | Puan a_j (j: 1..N sıra konumu) | Duyarlı olduğu fark |
|---|---|---|
| Van der Waerden | \Phi^{-1}\!\big(j/(N+1)\big) | konum (normal puan) |
| Savage | \sum_{i=1}^{j}1/(N-i+1)\ -1 | üst kuyruk, sağkalım tipi |
| Siegel–Tukey | 1 en küçüğe, 2–3 en büyük ikiye, 4–5 sonraki küçük ikiye … | yayılım |
| Ansari–Bradley | (N+1)/2-\lvert j-(N+1)/2\rvert | yayılım |
| Mood | \big(j-(N+1)/2\big)^2 | yayılım |
| Klotz | \big[\Phi^{-1}(j/(N+1))\big]^2 | yayılım (normal puan) |
Fligner–Killeen, her grubun kendi medyanından mutlak sapmalarını sıralar, \Phi^{-1}\big((1+r/(N+1))/2\big) puanlarıyla ki-kare istatistiği kurar (scipy.stats.fligner(center="median"), R fligner.test ile aynı). Ölçek testleri yalnız konumları eşit gruplar için anlamlıdır; MerQur bunu çıktıda not eder.
18.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/mann_whitney/elle_hesap.py ile, MerQur kodu çağrılmadan hesaplanmıştır.
Adım 1 — Sıklıklar ve orta sıralar. Birleşik veride her puanın sıklığı ve orta sırası:
| Puan | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
|---|---|---|---|---|---|---|---|
| type-1 sıklığı | 3 | 2 | 5 | 16 | 11 | 2 | 1 |
| type-2 sıklığı | 7 | 4 | 10 | 5 | 3 | 3 | 13 |
| Toplam t_j | 10 | 6 | 15 | 21 | 14 | 5 | 14 |
| Orta sıra | 5,5 | 13,5 | 24 | 42 | 59,5 | 69 | 78,5 |
Örneğin puan 4'ü alan 21 hasta 32. ile 52. sıraları paylaşır: (32+52)/2=42.
Adım 2 — Sıra toplamı ve U.
Ortalama sıralar 42,6625 (type-1) ve 43,3 (type-2); R_2=1948{,}5. Aynı U_1 ikili sayımdan da çıkar: 1800 çiftin 781'inde type-1 büyük, 211'i bağlı; 781+211/2=886{,}5.
Adım 3 — Bağ düzeltmeli varyans.
Bağsız varyans 1800\cdot86/12=12900 olurdu; bağlar varyansı %3,2 küçültür. \sigma_U=111{,}771450.
Adım 4 — z ve p.
Düzeltmesiz z=0{,}120782, p=0{,}903864. Sağ yönlü (H_1: type-1 büyük) p=0{,}549839; sol yönlü p=0{,}453704. İki yönlü koşullu kesin p=0{,}904944; sol yönlü kesin p=0{,}448865 (Python'da bağ grupları üzerinden \binom{85}{40} atamanın tam sayımıyla).
Adım 5 — Etki büyüklükleri.
r=\lvert Z\rvert/\sqrt{85}=0{,}013101. Rank-biserial GA: \SH=\sqrt{86/5400}=0{,}126198; \operatorname{artanh}(0{,}015)=0{,}015001; %95 GA [-0{,}228250;\ 0{,}256487].
Adım 6 — Hodges–Lehmann. 1800 ikili farkın 808'i negatif, 211'i sıfır, 781'i pozitiftir; medyan \hat\Delta_{HL}=0. Ters çevirmede W(d), aday noktaların sağındaki aralıkta:
| Aday nokta d | −3 | −2 | −1 | 0 | 1 | 2 |
|---|---|---|---|---|---|---|
| W (sağdaki aralık) | 4,454 | 2,271 | 0,816 | −1,056 | −3,345 | −5,314 |
Alt sınır, W\le1{,}96 olan ilk nokta: -1. Üst sınır, W\le-1{,}96 olan ilk nokta: 1. %95 GA [-1;\ 1].
Adım 7 — Ek testler.
| Test | İstatistik | p |
|---|---|---|
| Brunner–Munzel | W_{BM}=0{,}114275; sd =61{,}11; \hat p=0{,}5075 | 0,909395 |
| Kolmogorov–Smirnov | D=0{,}280556; Z=1{,}291058 | 0,071321 |
| Wald–Wolfowitz | 14 dizi (beklenen 43,35); Z=-6{,}3188 | 1{,}32\times10^{-10} |
| Moses (h=2) | S_h=65 | 0,012548 |
| Van der Waerden | Z=-0{,}358054 | 0,720303 |
| Savage | Z=-1{,}812878 | 0,069851 |
| Siegel–Tukey | Z=4{,}223744 | 2{,}40\times10^{-5} |
| Ansari–Bradley | Z=4{,}222716 | 2{,}41\times10^{-5} |
| Mood | Z=-4{,}131080 | 3{,}61\times10^{-5} |
| Klotz | Z=-3{,}852473 | 1{,}17\times10^{-4} |
| Fligner–Killeen | \chi^2(1)=17{,}021602 | 3{,}70\times10^{-5} |
Konum testlerinin hiçbiri anlamlı değildir; yayılım testlerinin hepsi anlamlıdır. Siegel–Tukey ve Ansari–Bradley puanları ortadaki gözlemlere büyük değer verir; Z>0, type-1'in ortada toplandığını gösterir. Mood ve Klotz'un puanı merkezden uzaklıkla büyür; Z<0 aynı sonucu söyler. Wald–Wolfowitz'in çok küçük p'si bir yanılsamadır: 85 gözlem 7 değerde toplandığından bağlı değerlerde "1. grup önce" kuralı dizileri yapay olarak azaltır; MerQur bu durumda uyarı ekler.
18.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan, round() bellekte etkisizleştirilerek alınmıştır (dogrulama/mann_whitney/merqur_calistir.py). R: 4.5.3, wilcox.test, coin::wilcox_test (kesin ve asimptotik), effectsize::rank_biserial (işareti çevrilerek), brunnermunzel::brunnermunzel.test, ks.test, DescTools::MosesTest, DescTools::RunsTest, coin::normal_test, savage_test, ansari_test, mood_test, klotz_test (ties.method = "average-scores"), fligner.test. Siegel–Tukey'in R paketlerinde aynı tanımlı karşılığı olmadığından puanlar R'de formülle kurulmuştur. R wilcox.test'in HL kestirimi uniroot köküdür (-4{,}18\times10^{-5}); karşılaştırmada ikili farkların medyanı median(outer(x, y, "-")) kullanılmıştır. Monte Carlo satırında Python, MerQur'un üreteç adımlarını aynı tohumla yeniden üretir.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Sıra toplamı R_1 (type-1) | 1706,500000 | 1706,500000 | — | 0,0e+00 | ✓ |
| Ortalama sıra (type-1) | 42,662500 | 42,662500 | — | 0,0e+00 | ✓ |
| Ortalama sıra (type-2) | 43,300000 | 43,300000 | — | 0,0e+00 | ✓ |
| U_1 | 886,500000 | 886,500000 | 886,500000 | 0,0e+00 | ✓ |
| p (çift yönlü, süreklilik düzeltmeli) | 0,907408 | 0,907408 | 0,907408 | 3,3e−16 | ✓ |
| p (düzeltmesiz) | 0,903864 | 0,903864 | 0,903864 | 2,2e−16 | ✓ |
| p (sağ yönlü) | 0,549839 | 0,549839 | 0,549839 | 2,2e−16 | ✓ |
| p (sol yönlü) | 0,453704 | 0,453704 | 0,453704 | 1,7e−16 | ✓ |
| Kesin koşullu p (çift yönlü) | 0,904944 | 0,904944 | 0,904944 | 1,4e−15 | ✓ |
| Kesin koşullu p (sol yönlü) | 0,448865 | 0,448865 | 0,448865 | 6,1e−16 | ✓ |
| Kesin permütasyon p (ek satır) | 0,904944 | 0,904944 | 0,904944 | 1,4e−15 | ✓ |
| Z (bağ düzeltmeli) | −0,121 | −0,120782 | −0,120782 | 8,3e−17 | ✓ (3 ondalık) |
| r=\lvert Z\rvert/\sqrt N | 0,0131 | 0,013101 | — | 0,0e+00 | ✓ (4 ondalık) |
| Rank-biserial r | 0,015000 | 0,015000 | 0,015000 | 1,4e−17 | ✓ |
| CLES U_1/(n_1n_2) | 0,4925 | 0,492500 | 0,492500 | 0,0e+00 | ✓ (4 ondalık) |
| Rank-biserial %95 GA alt | −0,228250 | −0,228250 | −0,228250 | 1,7e−16 | ✓ |
| Rank-biserial %95 GA üst | 0,256487 | 0,256487 | 0,256487 | 5,0e−16 | ✓ |
| HL kestirimi (ikili farkların medyanı) | 0,000000 | 0,000000 | 0,000000 | 0,0e+00 | ✓ |
| HL %95 GA alt | −1 | −1 | −1,000023 | 2,3e−05 | ✓ (R: 10−4) |
| HL %95 GA üst | 1 | 1 | 0,999952 | 4,8e−05 | ✓ (R: 10−4) |
| Brunner–Munzel W | 0,114275 | 0,114275 | 0,114275 | 4,2e−17 | ✓ |
| Brunner–Munzel p | 0,909395 | 0,909395 | 0,909395 | 1,1e−16 | ✓ |
| Brunner–Munzel \hat p | 0,507500 | 0,507500 | 0,507500 | 0,0e+00 | ✓ |
| KS D | 0,280556 | 0,280556 | 0,280556 | 4,4e−16 | ✓ |
| KS p | 0,071321 | 0,071321 | 0,071321 | 2,8e−17 | ✓ |
| Wald–Wolfowitz dizi sayısı | 14 | 14 | 14 | 0,0e+00 | ✓ |
| Wald–Wolfowitz p (tek yönlü) | 1,3180·10−10 | 1,3180·10−10 | 1,3180·10−10 | 5,2e−26 | ✓ |
| Moses açıklık S_h | 65 | 65 | 65 | 0,0e+00 | ✓ |
| Moses p | 0,012548 | 0,012548 | 0,012548 | 9,5e−17 | ✓ |
| Van der Waerden Z | −0,358054 | −0,358054 | −0,358054 | 0,0e+00 | ✓ |
| Savage Z | −1,812878 | −1,812878 | −1,812878 | 3,6e−15 | ✓ |
| Siegel–Tukey Z | 4,223744 | 4,223744 | 4,223744 | 2,7e−15 | ✓ |
| Ansari–Bradley Z | 4,222716 | 4,222716 | 4,222716 | 2,7e−15 | ✓ |
| Mood Z | −4,131080 | −4,131080 | −4,131080 | 1,8e−15 | ✓ |
| Klotz Z | −3,852473 | −3,852473 | −3,852473 | 1,3e−15 | ✓ |
| Fligner–Killeen \chi^2 | 17,021602 | 17,021602 | 17,021602 | 4,6e−14 | ✓ |
| Fligner–Killeen p | 3,6957·10−5 | 3,6957·10−5 | 3,6957·10−5 | 8,1e−20 | ✓ |
| Monte Carlo p (tohum 12345, B = 10000) | 0,912309 | 0,912309 | — | 0,0e+00 | ✓ |
Sonuç: 38 büyüklüğün tamamı ölçütü karşılar. HL GA sınırlarında R'nin farkı uniroot toleransındandır; MerQur ve Python değerleri tam ikili farklardır.
18.7 Çıktıyı okuma
Varsayılan ayarlarla sonuç metni:
Mann-Whitney U=886.50, p = 0.9074 ns. H₀ REDDEDİLEMEZ.
    Rank-biserial r = 1 − 2U₁/(n₁n₂); U₁ = 'type-1' grubunun U'su (gruplar sıralı
    düzeye göre: 1 = 'type-1', 2 = 'type-2'). r > 0: 'type-2' değerleri daha büyük
    olma eğiliminde; r < 0: 'type-1' değerleri daha büyük.
    Kullanılan düzey sırası (diabetes_type): type-1, type-2
    Hodges-Lehmann %95 GA (asimptotik) yöntemi: test tersine çevirme
APA: U = 886.50, p = .907, r = .02
Tüm seçeneklerle eklenen bölümlerden (kısaltılmış). Ek testler kendi başlıkları altında, p değerleri aynı biçimleyiciyle yazılır; çok küçük p bilimsel gösterimle verilir:
    Kesin koşullu permütasyon p (bağlara sağlam) = 0.904944
    Rank-biserial r = 0.0150 (pozitif: type-1 < type-2 eğilimi), %95 GA [-0.2282, 0.2565]
── Brunner-Munzel ──
    W = 0.1143, p = 0.909395, p̂ = P(type-2 > type-1) + ½P(=) = 0.5075
── Diğer iki bağımsız örneklem testleri ──
    Kolmogorov-Smirnov D = 0.2806, Z = 1.2911, p = 0.071321
    Wald-Wolfowitz: runs = 14, Z = -6.3188, p (tek yönlü) = 1.32e-10  ⚠ gruplar arası bağ var; ...
── Ölçek (yayılım) testleri ──
    Siegel-Tukey: S (type-1) = 2179.5095, E(S) = 1720.0000, SD = 108.7920,
                  Z = 4.2237, p = 0.000024
    Fligner-Killeen: χ²(1) = 17.0216, p = 0.000037
── ETKİ BÜYÜKLÜKLERİ ──
    rank-biserial r = 0.0150
    CLES (ortak dil etki büyüklüğü) = 0.4925
    Z = -0.121, r(Z/√N) = 0.0131
| Satır | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| İlk satır | U_1, p, yıldız, karar | U_1 1. grubun U'sudur; n_1n_2/2=900'e yakınlık "fark yok" demektir. |
| İşaret kuralı satırı | Hangi düzeyin 1. grup olduğu | r ve Z'yi okumadan önce bakın. |
| Künye: Hodges-Lehmann, %95 GA | \hat\Delta_{HL} ve GA | Konum kayması; puan biriminde. Burada [-1;1]: bir puandan büyük kayma dışlanır. |
| Tablo: ortalama sıra, sıra toplamı | Grup başına ortalama sıra ve sıra toplamı | Ortalama sıralar 42,7 ve 43,3: neredeyse eşit. |
| CLES | P(X>Y)+\tfrac12P(=) | 0,49: rastgele bir tip 1 hasta, rastgele bir tip 2 hastadan yüksek puan almaya %49 yatkın. |
| Kesin koşullu p | Bağlara dayanıklı kesin p | Asimptotik p ile aynı karar. |
| Ölçek testleri | Yayılım farkı | Burada anlamlı: grupların biçimi farklı (Şekil 18.1). |
| Uyarılar | "Tam" + bağ: koşullu dağılım kullanıldı (hypothesis.py:3642); büyük tablo: asimptotiğe dönüldü (3453); HL atlandı (3472) |
Bilgi amaçlıdır. |
APA biçiminde rapor cümlesi:
Yaşam kalitesi puanları tip 1 diyabetli (Mdn = 4, ortalama sıra = 42,66) ve tip 2 diyabetli (Mdn = 4, ortalama sıra = 43,30) hastalar arasında farklı değildi; U = 886{,}5, z = -0{,}12, p = 0{,}907, rank-biserial r = 0{,}015 (%95 GA [−0,23; 0,26]). Hodges–Lehmann konum kayması 0 puandı (%95 GA [−1; 1]). Buna karşın puanların yayılımı gruplar arasında belirgin farklıydı (Fligner–Killeen \chi^2(1) = 17{,}02, p < 0{,}001): tip 2 diyabetli hastaların puanları ölçeğin iki ucunda toplandı.
18.8 Uzman soruları
S1. MerQur'un "U"su hangisi: U₁ mi, min(U₁, U₂) mi?
Her zaman U_1, yani sıralı düzeye göre 1. grubun U'su (scipy mannwhitneyu'nun döndürdüğü değer; hypothesis.py:3624). R wilcox.test'in W'si de budur. Ders kitaplarının tablo değeri \min(U_1,U_2)'dir; bu veride ikisi aynıdır (886,5), ama gruplar yer değiştirse MerQur 913,5 yazar. p değişmez.
S2. Bağlar nasıl ele alınıyor ve kesin p bağlıyken neden ayrıca hesaplanıyor?
Tüm yollar orta sıra kullanır; asimptotik varyans \sum(t^3-t) ile düzeltilir. scipy'nin "exact" yolu bağsız U dağılımını kullanır ve bağlı veride yanlış olur. MerQur "Tam" seçildiğinde ve bağ varsa koşullu permütasyon dağılımını kurar (hypothesis.py:3633–3642); bu, R coin tanımıdır. Bu veride 0{,}904944; R coin ile 10^{-15} düzeyinde aynıdır.
S3. Medyanlar eşitken test neden "medyan farkı yok" demek değil?
Mann–Whitney stokastik üstünlüğü sınar. Burada iki grubun medyanı 4'tür ve p=0{,}91'dir; ama bu "dağılımlar aynı" anlamına gelmez. Ölçek testleri yayılımın çok farklı olduğunu gösterir (p<0{,}001). Biçimler farklıyken medyanlar farklı olup U anlamsız da çıkabilir, tersi de olabilir (Fagerland ve Sandvik 2009). Biçim farkı varsa raporda Brunner–Munzel \hat p'si ve ölçek testi birlikte verilmelidir.
S4. Hodges–Lehmann GA'sı R ile neden birebir aynı değil?
R kökü uniroot ile sürekli bir yaklaşık olarak bulur (-1{,}000023 ve 0{,}999952). W(d) basamak fonksiyonu olduğundan gerçek kök bir ikili farktır; MerQur ikili aramayla tam noktayı verir (-1 ve 1). Fark uniroot toleransıdır. R'nin HL kestirimi de aynı nedenle -4{,}2\times10^{-5} çıkar; MerQur ikili farkların medyanını (0) yazar.
S5. Rank-biserial r'nin işareti neden R ile ters?
MerQur r=1-2U_1/(n_1n_2) kullanır: 2. grup büyükse pozitif. effectsize::rank_biserial(x, y) 2U_1/(n_1n_2)-1 verir: 1. grup büyükse pozitif. Büyüklük ve GA genişliği aynıdır. MerQur işaret kuralını çıktının ikinci satırına yazar.
S6. Çok küçük örneklemde ne olur?
Bir grupta tek gözlem olsa bile test çalışır (yalnız n=0 hata verir). Bağ yoksa ve gruplardan biri \le8 ise kesin dağılım kullanılır; ör. 3'e 3 bağsız veride en küçük iki yönlü p=0{,}1'dir, yani \alpha=0{,}05'te anlamlılık imkânsızdır. HL GA'sı istenen düzeye ulaşamadığında en uç ikili farklar döner ve Wilcoxon modülünün aksine uyarı verilmez (hypothesis.py:3681–3682, ulaşılamadı bayrağı _ ile atılır); 3'e 3 örnekte GA [-5;\ -1], yani tüm ikili farkların aralığıdır. Bu durumda kesin HL GA kutusu daha dürüsttür.
S7. Süreklilik düzeltmesi varsayılan olarak neden açık?
R wilcox.test'in varsayılanı (correct = TRUE) düzeltmelidir; MerQur aynı değeri verir. Kapatıldığında p biraz küçülür (bu veride 0{,}9074\to0{,}9039). Düzeltme kesin, permütasyon ve HL GA yollarını etkilemez.
S8. Monte Carlo p neden kesin p'den farklı ve nasıl tekrarlanır?
10000 rastgele atamanın oranıdır; %99 GA'sı çıktıda verilir (0{,}9123, [0,9048; 0,9194]; kesin değer 0,9049 bu aralıktadır). Aynı tohumla aynı sonuç çıkar. Varsayılan tohum (seed) 12345'tir; değiştirilebilir ve çıktı satırı kullanılan tohumu yazar.
S9. Varyanslar farklıyken Mann–Whitney birinci tür hatayı korur mu?
Korumaz. H_0 "dağılımlar özdeş" iken geçerlidir; yalnız P(X>Y)=1/2 doğru ama yayılımlar farklıysa, özellikle grup büyüklükleri de farklıysa, gerçek birinci tür hata nominal düzeyden sapar. Brunner–Munzel bu durum için tasarlanmıştır; bu veride ikisi aynı kararı verir (p=0{,}909).
18.9 Sık hatalar ve tuzaklar
- "Medyanlar farklı" diye raporlamak. Test, biçimler aynı değilse medyan testi değildir. Bu Tıp örneğinde medyanlar eşit, dağılımlar çok farklıdır.
- Grup sırasını gözden kaçırmak. 1. grup düzey sırasıyla belirlenir (
type-1<type-2doğal sırası). U, r ve Z'nin işareti buna bağlıdır; tek yönlü hipotez seçerken de 1. grubu bilmek gerekir. - R'den gelen rank-biserial ile karşılaştırırken işareti unutmak. MerQur'da r>0 "2. grup büyük" demektir.
- "Tam" yöntemi bağlı veride scipy değeriyle karşılaştırmak. MerQur bağlı veride koşullu kesin p verir; scipy'nin
method="exact"değeri farklıdır ve yanlıştır. - Wald–Wolfowitz'i bağlı veride yorumlamak. Dizi sayısı bağların nasıl sıralandığına bağlıdır; Likert verisinde p anlamsızdır. MerQur uyarı ekler.
- Ölçek testlerini konumları farklı gruplarda kullanmak. Konum farkı da ölçek testi istatistiğini değiştirir.
- Çoklu değer sütununda düzeltme beklemek. Her sütun ayrı test edilir; düzeltme yoktur.
- Monte Carlo p'yi tohumsuz raporlamak. Monte Carlo p tohuma bağlıdır; çıktı satırındaki tohum ve B raporda yazılmalıdır.
18.10 Kaynaklar
- Ansari, A. R., & Bradley, R. A. (1960). Rank-sum tests for dispersions. The Annals of Mathematical Statistics, 31(4), 1174–1189. https://doi.org/10.1214/aoms/1177705688
- Bauer, D. F. (1972). Constructing confidence sets using rank statistics. Journal of the American Statistical Association, 67(339), 687–690. https://doi.org/10.1080/01621459.1972.10481279
- Brunner, E., & Munzel, U. (2000). The nonparametric Behrens-Fisher problem: Asymptotic theory and a small-sample approximation. Biometrical Journal, 42(1), 17–25. https://doi.org/10.1002/(SICI)1521-4036(200001)42:1<17::AID-BIMJ17>3.0.CO;2-U
- Conover, W. J. (1999). Practical nonparametric statistics (3rd ed.). Wiley.
- Cureton, E. E. (1956). Rank-biserial correlation. Psychometrika, 21(3), 287–290. https://doi.org/10.1007/BF02289138
- Fagerland, M. W., & Sandvik, L. (2009). The Wilcoxon–Mann–Whitney test under scrutiny. Statistics in Medicine, 28(10), 1487–1497. https://doi.org/10.1002/sim.3561
- Fligner, M. A., & Killeen, T. J. (1976). Distribution-free two-sample tests for scale. Journal of the American Statistical Association, 71(353), 210–213. https://doi.org/10.1080/01621459.1976.10481517
- Hodges, J. L., & Lehmann, E. L. (1963). Estimates of location based on rank tests. The Annals of Mathematical Statistics, 34(2), 598–611. https://doi.org/10.1214/aoms/1177704172
- Hollander, M., Wolfe, D. A., & Chicken, E. (2014). Nonparametric statistical methods (3rd ed.). Wiley.
- Hothorn, T., Hornik, K., van de Wiel, M. A., & Zeileis, A. (2008). Implementing a class of permutation tests: The coin package. Journal of Statistical Software, 28(8), 1–23. https://doi.org/10.18637/jss.v028.i08
- Kerby, D. S. (2014). The simple difference formula: An approach to teaching nonparametric correlation. Comprehensive Psychology, 3, 11.IT.3.1. https://doi.org/10.2466/11.IT.3.1
- Mann, H. B., & Whitney, D. R. (1947). On a test of whether one of two random variables is stochastically larger than the other. The Annals of Mathematical Statistics, 18(1), 50–60. https://doi.org/10.1214/aoms/1177730491
- McGraw, K. O., & Wong, S. P. (1992). A common language effect size statistic. Psychological Bulletin, 111(2), 361–365. https://doi.org/10.1037/0033-2909.111.2.361
- Moses, L. E. (1952). A two-sample test. Psychometrika, 17(3), 239–247. https://doi.org/10.1007/BF02288755
- Savage, I. R. (1956). Contributions to the theory of rank order statistics—the two-sample case. The Annals of Mathematical Statistics, 27(3), 590–615. https://doi.org/10.1214/aoms/1177728170
- Siegel, S., & Tukey, J. W. (1960). A nonparametric sum of ranks procedure for relative spread in unpaired samples. Journal of the American Statistical Association, 55(291), 429–445. https://doi.org/10.1080/01621459.1960.10482073
- Wald, A., & Wolfowitz, J. (1940). On a test whether two samples are from the same population. The Annals of Mathematical Statistics, 11(2), 147–162. https://doi.org/10.1214/aoms/1177731909
- Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin, 1(6), 80–83. https://doi.org/10.2307/3001968