76. Hiyerarşik Kümeleme
Analiz kimliği: hierarchical · Menü adı: Hiyerarşik Kümeleme · Panel: gui/panels/analyses/hierarchical.py (form 42–100, read_options/q5_options 120–127, execute 142–168, gövde metni 186–261) · Motor: ml/clustering.py, Clustering.hierarchical (satır 802–1017); çizelge _schedule_from_linkage (155–172), uzaklıklar _distance_matrix (175–185), kesim _cut_by_order (376–391), küme sayısı ölçütleri _sas_criteria (394–425), değişken ağacı _variable_tree (428–444) · Çağrı: stats_panel.py:7746–7780
76.1 Ne işe yarar
Hiyerarşik (birleştirici) kümeleme, her gözlemi önce tek başına bir küme sayar; sonra her adımda birbirine en yakın iki kümeyi birleştirir. n gözlem n-1 adımda tek kümeye iner. Sonuç, birleşme sırasını ve yüksekliklerini gösteren bir ağaçtır (dendrogram). İstenen K, ağacın K dala kesilmesiyle elde edilir. Cevapladığı soru şudur: "Gözlemler hangi sırayla ve hangi benzerlik düzeyinde gruplaşıyor; kaç grup doğal görünüyor?"
Bu bir hipotez testi değildir. Algoritmayı belirleyen iki seçim vardır: gözlemler arası uzaklık d(i,j) ve iki küme arası uzaklığı tanımlayan bağlantı yöntemi.
Ne zaman kullanılır?
- Küme sayısı önceden bilinmiyorsa ve iç içe (alt tip içinde alt tip) bir yapı merak ediliyorsa.
- n küçük ya da orta büyüklükteyse (birkaç bin): bellek n^2 ile büyür.
- Öklid dışı bir uzaklık (Manhattan, korelasyon, Gower) gerekiyorsa.
Ne zaman kullanılmaz?
- n on binlerceyse: K-Ortalamalar Kümelemesi (Bölüm 75).
- Kümeler yoğunluk bakımından ayrışıyor ve gürültü noktaları dışarıda bırakılmak isteniyorsa: DBSCAN (Bölüm 77).
- Değişkenleri (gözlemleri değil) gruplamak asıl amaçsa: Değişken Kümeleme (VARCLUS, Bölüm 43); bu modülde de "Değişkenleri kümele (R-tipi)" kutusu basit bir alternatif sunar.
Sık karıştırılan analizler. K-ortalamalar verilen K için doğrudan bölüntü arar ve ağaç üretmez. Ward bağlantısı ile k-ortalamalar aynı ölçütü (küme-içi KT) kullanır; ancak Ward bunu adım adım, geri dönüşsüz yapar, k-ortalamalar ise K sabitken bütün atamaları birlikte iyileştirir. Bölücü (divisive, ör. DIANA) yöntemler ağacı yukarıdan aşağı kurar; MerQur'da yalnız birleştirici yol vardır.
76.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Sayısal değişkenler | Uzaklık hesaplanabilmeli. | Yalnız sayısal sütunlar; Jaccard ikili, Gower ham veride. |
| Karşılaştırılabilir ölçek | Öklid türü uzaklıklarda büyük varyanslı değişken baskın olur. | Varsayılan z-puanı (n-1 paydalı); Jaccard ve Gower'da dönüşüm yapılmaz. |
| Uzaklık–bağlantı uyumu | Ward, merkez ve medyan bağlantıları Öklid geometrisine dayanır. | Merkez/medyan Öklid dışıyla hata (clustering.py:859–860); Ward Öklid dışıyla uyarı (clustering.py:850–857). |
| Kümeler gerçekten var | Algoritma yapısız veride de ağaç kurar. | Kofenetik korelasyon, küme sayısı ölçütleri ve silüet isteğe bağlıdır. |
Eksik değer. Varsayılan "Sil (listwise)" (ml/_preprocessing.py:320–322); doldurma seçenekleri K-ortalamalardakiyle aynıdır (75.2).
Uç durumlar.
- En az \max(K+1,\,3) satır (
clustering.py:474–477); tümüyle sabit sütun düşürülür. - Tek değişkenle korelasyon uzaklığı tanımsızdır: hata (
clustering.py:847–849). - Merkez (centroid) ve medyan bağlantısı yalnız Öklid uzaklıkla çalışır: hata (
clustering.py:859–860). - Jaccard'da 0/1 dışı iki değerli sütun (ör. 1/2) küçük → 0, büyük → 1 kodlanır ve not düşülür; ikiden çok değerli sütunda "sıfır dışı = 1" uygulanır ve uyarılır (
_jaccard_binary,clustering.py:225–245). - n>500 ise dendrogram ilk 500 gözlemden ayrıca kurulan bir ağaçla çizilir ve not yazılır; üyelikler ve çizelge tüm veridendir (
clustering.py:910,hierarchical.py:218–219). - Proksimite matrisi yalnız n\le100'de yazdırılır (
clustering.py:957).
76.3 Parametreler
Varsayılanlar hierarchical.py:42–127 ve ortak satırlar kmeans.py:83–105 içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımsız değişkenler | veriye bağlı | Kümelemeye giren sayısal sütunlar. | Uzay ve ağaç değişir. |
| Küme sayısı (K) | 3 | Ağacın kesileceği küme sayısı (2–20). | Bölüntü, silüet, CH ve tablo; ağaç aynı kalır. |
| Bağlantı yöntemi | Ward (varyansı en aza indirir) | Ward; Tam (complete); Ortalama (average); Tek (single); Merkez (centroid); Medyan; McQuitty (WPGMA). | Ağacın biçimi ve yükseklikleri tümüyle değişir (76.5.3). |
| Eksik Veri | Sil (listwise) | 75.2'de. | n değişir. |
| Uzaklık ölçüsü | Öklid | Öklid; Kare Öklid; Manhattan; Chebyshev; Pearson korelasyonu (1 − r); Kosinüs (1 − cos); Jaccard (ikili, ham veri); Gower. | Ağaç ve silüet değişir; CH ve küme sayısı ölçütleri her zaman Öklid uzayındadır. |
| Proksimite matrisini yazdır (n ≤ 100) | kapalı | Gözlemler arası uzaklık matrisi. | Yalnız ek tablo. |
| Küme üyeliğini veri setine kaydet | kapalı | HC{K}_CLUSTER (ve üyelik aralığı açıksa HC{k}_CLUSTER). |
Yalnız veri setine yazar. |
| Değişken dönüşümü | z-puanı (varsayılan) | z; Yok; Aralık 0–1; En büyük = 1; SS = 1. | Jaccard ve Gower'da yok sayılır. |
| K seçim ölçütleri tablosu | kapalı | Kofenetik korelasyon + k = 1..max(10, K) için R², SPRSQ, pseudo-F, pseudo-t². | Yalnız ek tablo. |
| Grafik | Dendrogram | Dendrogram; Kümeler (PCA düzlemi); Gözlem bazlı silüet; 3B küme grafiği. | Gözlem bazlı silüet seçilince metne küme başına silüet eklenir. |
| Üyelik aralığı (k = 2..) | Kapalı | k = 2..değer için küme büyüklükleri ve kaydedilecek üyelikler. | Ek bölüm. |
| Ek çıktılar: Dendrogramda K kesim çizgisi | kapalı | Grafikte K'ya karşılık gelen yükseklikte yatay çizgi. | Yalnız grafik. |
| Ek çıktılar: Değişkenleri kümele (R-tipi) | kapalı | Değişkenleri 1-r uzaklığıyla kümeler. | Ek bölüm ve grafik değişir. |
Neden CH ve küme sayısı ölçütleri seçilen uzaklıktan bağımsız?
Calinski–Harabasz ve öteki küme sayısı ölçütleri (R², SPRSQ, pseudo-F, pseudo-t²) kareler toplamı ayrıştırmasına dayanır; bu ayrıştırma yalnız Öklid uzayında tanımlıdır. MerQur bu yüzden onları her zaman dönüştürülmüş değişken uzayında, Öklid geometrisiyle hesaplar (clustering.py:901, 985). Silüet ise seçilen uzaklıkla hesaplanır (clustering.py:895–900). Manhattan ya da Gower seçildiğinde silüet ağaçla tutarlıdır; CH ve pseudo-F değildir.
76.4 Tıp örneği
Dosya: english/datasets/Tip/67_hierarchic_5tip_10gen.xlsx. Türkçe örnek klasöründe bu dosyanın kopyası yoktur; REHBER.md aynı adı (67_hierarchic_5tip_10gen.xlsx) verir. Değişken seçimi VIDEO_SCRIPT_TR.txt #67 bölümünden alınmıştır.
| Değişken | Rol | Tür | Açıklama / özet |
|---|---|---|---|
gene_01 … gene_10 |
Bağımsız değişkenler | sürekli | On genin ifade düzeyi (log ölçek); ortalamalar 0,96–1,26, SS 1,11–1,65 |
lower_type |
kullanılmaz (dendrogram yaprak etiketi) | metin, 5 düzey | Gerçek alt tip: type-A … type-E, her biri 8 hasta |
patient_id |
kullanılmaz |
n ve eksik değer: 40 hasta, eksik değer yok.
Klinik soru: On genin ifade örüntüsü hastaları kaç alt tipe ayırır ve bu alt tipler bilinen beş tiple örtüşür mü?
Seçilen ayarlar: K = 5 (formun varsayılanı 3; senaryo 5 ister), Ward bağlantısı, Öklid uzaklık, z-puanı. Sayısal yürüyüş için K seçim ölçütleri tablosu, üyelik aralığı k = 2..6, K kesim çizgisi, değişken kümeleme ve gözlem bazlı silüet açılmış; ayrıca altı bağlantı ve beş uzaklık seçeneği çalıştırılmıştır.
Koddaki tercih
Dendrogram yaprak etiketi olarak MerQur, kümelemeye girmeyen ilk metin sütununu kendiliğinden seçer (clustering.py:918–927); yoksa satır indeksini (0 tabanlı) yazar. Bu veride patient_id sayısal olduğu için lower_type seçilir ve dendrogramın yaprakları gerçek alt tipleri gösterir. Bu yararlı bir yan etkidir, ama yaprak etiketinin hangi sütundan geldiği çıktıda yazmaz.
76.5 Formüller ve hesap adımları
MerQur'un sırası şudur: (1) değişkenleri hazırla ve dönüştür (Jaccard/Gower'da ham), (2) uzaklıkları hesapla, (3) seçilen bağlantıyla birleştirme ağacını kur, (4) ağacı K kümeye kes, (5) silüeti (seçilen uzaklıkla) ve CH'yi (Öklid) hesapla, (6) çizelge, dendrogram ve istenen ek çıktıları üret.
76.5.1 Dönüşüm
z-puanı ve öteki dönüşümler K-ortalamalardaki tanımın aynısıdır (_scale, clustering.py:188–214; bkz. 75.5.1). Jaccard ve Gower seçildiğinde dönüşüm uygulanmaz (clustering.py:840–843).
Koddaki tercih
scikit-learn StandardScaler (n paydalı) kullanılsaydı birleşme yükseklikleri \sqrt{n/(n-1)} kat büyük olurdu. Bütün kümeleme yolları aynı _zscore_n1 yardımcısını kullanır; R hclust(dist(scale(X))) ile yükseklikler 10^{-15} düzeyinde aynıdır.
76.5.2 Uzaklıklar
- z_{iv}: i. gözlemin v. değişkendeki dönüştürülmüş değeri; z_{i\cdot} gözlemin p boyutlu satır vektörü.
- r(z_{i\cdot},z_{j\cdot}): iki gözlemin satır vektörleri arasındaki Pearson korelasyonu (değişkenler üzerinden hesaplanır).
- R_v: v. değişkenin ham aralığı (en büyük − en küçük); sıfırsa 1 alınır. Gower ham veride hesaplanır.
- Kare Öklid: d_{\text{Öklid}}^2. Jaccard: x\neq0 ikili kodunda uyuşmayanların, en az birinde 1 olan değişkenlere oranı.
Tutarsızlığa dikkat
Korelasyon ve kosinüs uzaklıkları z-ölçekli satırlar üzerinde hesaplanır (clustering.py:842–843, 885). Gen ifadesi çalışmalarında yaygın kullanım olan R as.dist(1 - cor(t(X))) ham satırlarla çalışır ve farklı bir ağaç verir. Aynı sonucu R'de almak için as.dist(1 - cor(t(scale(X)))) yazılmalıdır; bu bölümün doğrulaması bunu yapar.
76.5.3 Bağlantı yöntemleri ve Lance–Williams güncellemesi
İki küme i ve j birleşip yeni bir küme oluşturduğunda, yeni kümenin öteki her k kümesine uzaklığı Lance ve Williams (1967) formülüyle güncellenir:
| Yöntem (MerQur adı) | \alpha_i | \beta | \gamma | Uzaklık girdisi |
|---|---|---|---|---|
| Tek (single) | 1/2 | 0 | -1/2 | d |
| Tam (complete) | 1/2 | 0 | +1/2 | d |
| Ortalama (average, UPGMA) | n_i/(n_i+n_j) | 0 | 0 | d |
| McQuitty (WPGMA) | 1/2 | 0 | 0 | d |
| Merkez (centroid, UPGMC) | n_i/(n_i+n_j) | -n_in_j/(n_i+n_j)^2 | 0 | d^2 |
| Medyan (WPGMC) | 1/2 | -1/4 | 0 | d^2 |
| Ward | (n_i+n_k)/(n_i+n_j+n_k) | -n_k/(n_i+n_j+n_k) | 0 | d^2 |
- n_i,n_j,n_k: küme büyüklükleri. \alpha_j, \alpha_i'deki i ile j yer değiştirilerek elde edilir.
- "Uzaklık girdisi d^2": güncelleme kare uzaklıklar üzerinde yapılır; MerQur birleşme yüksekliğini bunun karekökü olarak raporlar.
- Tek bağlantı en yakın üyeler, tam bağlantı en uzak üyeler, ortalama bağlantı bütün çiftlerin ortalaması üzerinden ölçer.
Ward yüksekliği. Ward güncellemesi kare Öklid uzaklıklarla başlatıldığında, A ve B kümelerinin birleşme yüksekliği
olur; \Delta W_{AB} birleşmenin küme-içi KT'de yarattığı artıştır.
Neden \sqrt{2\Delta W}? "ward.D" ile "ward.D2" farkı nedir?
İki tekil gözlem için \Delta W=\tfrac12 d^2 olduğundan h=\sqrt{2\Delta W}=d olur: yükseklik ilk adımda olağan Öklid uzaklığıdır. MerQur'un Öklid + Ward yolu (scikit-learn ve scipy ward) bu tanımı kullanır; R'de karşılığı hclust(dist(z), "ward.D2")'dir. R'nin eski "ward.D" seçeneği karesi alınmamış uzaklıklara Ward güncellemesini uygular ve Ward ölçütünü gerçekleştirmez (Murtagh ve Legendre 2014). "Kare Öklid" + Ward seçildiğinde MerQur aynı ağacı kurar ama katsayıları h^2=2\Delta W olarak yazar (clustering.py:879–883); bu, R hclust(dist(z)^2, "ward.D") yüksekliklerine karşılık gelir.
Koddaki tercih
Öklid + (Ward, tam, ortalama, tek) yolunda küme etiketleri scikit-learn AgglomerativeClustering'den, çizelge, dendrogram, üyelik aralığı ve küme sayısı ölçütleri ise ayrıca kurulan scipy linkage ağacından alınır (clustering.py:872–877). İki kütüphane aynı ağacı kurduğu için bölüntü aynıdır, ama küme numaraları farklı sıralanır: bu veride Tablo sekmesindeki Küme 2 (n=9) ile üyelik aralığındaki k = 5 satırının Küme 2'si (n=6) farklı kümelerdir (76.7). Merkez, medyan ve McQuitty yalnız scipy ile kurulur ve kesim birleşme sırasıyla yapılır (clustering.py:864–871).
76.5.4 Ağacı K kümeye kesmek
K küme, ilk n-K birleşmenin uygulanmasıyla elde edilir. Yükseklikler artan sırada olduğunda bu, ağacı son K-1 birleşmenin altından yatay bir çizgiyle kesmekle aynıdır.
Tutarsızlığa dikkat
Merkez ve medyan bağlantıları monoton değildir: bir birleşme, öncekinden daha düşük yükseklikte olabilir (dendrogramda "ters dönme"). Bu veride medyan bağlantısının son birleşmelerinde yükseklik 3,3988'den 2,9959'a düşer. Yükseklik eşiğiyle kesmek bu durumda yanlış küme sayısı verir; MerQur bu iki yöntemde birleşme sırasıyla keser (_cut_by_order, clustering.py:376–391), R cutree(k = ) gibi.
76.5.5 Birleştirme çizelgesi ve dendrogram
Çizelgede her satır bir adımdır (_schedule_from_linkage, clustering.py:155–172): -i i. gözlem (analizdeki 1 tabanlı sıra), +j j. adımda oluşan kümedir; "Katsayı" birleşme yüksekliği, "n" oluşan kümenin büyüklüğüdür. Sıralama R hclust$merge kuralını izler: tekil gözlem önce, iki tekilde küçük numara önce. Dendrogramın dal renkleri K'ya göre verilir; "Dendrogramda K kesim çizgisi" kutusu yalnız yatay çizgiyi açar ve çizgi yüksekliği (h_{n-K}+h_{n-K+1})/2'dir (clustering.py:930–934).
76.5.6 Silüet ve Calinski–Harabasz
Tanımlar 75.5.5–75.5.6'daki gibidir. Silüet seçilen uzaklıkla hesaplanır: Öklid yolunda Öklid, kare Öklid + Ward'da kare Öklid, öteki uzaklıklarda kendi uzaklık matrisi (clustering.py:895–900). CH her durumda dönüştürülmüş uzayda Öklid'dir.
76.5.7 Kofenetik korelasyon
- c_{ij}: i ve j gözlemlerinin ağaçta ilk kez aynı kümeye girdiği birleşme yüksekliği (kofenetik uzaklık).
- d_{ij}: özgün uzaklık; Ward + kare Öklid yolunda kare uzaklık ve kare yükseklik kullanılır (
clustering.py:975–984). - r_{\text{kof}} 1'e yaklaştıkça ağaç özgün uzaklıkları daha iyi temsil eder (Sokal ve Rohlf 1962).
76.5.8 Küme sayısı ölçütleri
Ağaç boyunca her birleşmede küme-içi KT izlenir (_sas_criteria, clustering.py:394–425). k küme kaldığında:
- T: toplam KT (z ölçeğinde (n-1)p); P_k: k kümenin küme-içi KT'leri toplamı.
- \Delta W_k: k kümeye inen birleşmenin (A ile B) KT artışı; yarı-kısmi R^2 (SPRSQ) bu artışın T'ye oranıdır.
- pseudo-F_k: k kümeli bölüntünün CH değeriyle aynıdır; k=1'de tanımsızdır ("—").
- pseudo-t^2_k: birleşen iki kümenin ayrı kalmasının iki örneklem Hotelling T^2 benzeri ölçüsü. Büyük değer, birleşmenin iyi ayrılmış iki kümeyi zorla birleştirdiğini, yani k+1 kümenin daha uygun olabileceğini gösterir.
Koddaki tercih
Ölçütler, seçilen bağlantıdan bağımsız olarak her zaman dönüştürülmüş değişken uzayında Öklid KT'siyle hesaplanır. Gower ve Jaccard'da bu uzay ham değişkenlerdir (clustering.py:842); Gower'ın kendi aralığa bölme ölçeği burada kullanılmaz. Tablo k = 1,\dots,\max(10,K) satırını verir; kübik kümeleme ölçütü (CCC) satırı yoktur.
76.5.9 Değişken (R-tipi) kümeleme
"Değişkenleri kümele" kutusu, gözlemler yerine değişkenleri d=1-r (Pearson, ham veri) uzaklığıyla kümeler (_variable_tree, clustering.py:428–444). Ward, merkez ve medyan 1-r ile Öklid anlamı taşımadığı için bu üç seçimde ortalama bağlantı kullanılır (clustering.py:988). R karşılığı hclust(as.dist(1 - cor(X)), "average")'dir.
76.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Aşağıdaki değerler dogrulama/hierarchical/elle_hesap.py ile, MerQur, scipy ve scikit-learn çağrılmadan numpy ile hesaplanmıştır. Bağımsız hesap Lance–Williams güncellemesini doğrudan uygular (her adımda en küçük uzaklıklı çift).
Adım 1 — z-puanı. gene_01 için \bar x=1{,}196, s=1{,}649393. 1. hastanın değeri -0{,}645:
Adım 2 — İlk birleşme. Bütün \binom{40}{2}=780 çift arasında en küçük Öklid uzaklık 1. ve 11. hastalar arasındadır:
Ward'da iki tekil gözlemin yüksekliği uzaklığın kendisidir; çizelgenin 1. satırı "−1 −11 1.4646 2"dir.
Adım 3 — Ward güncellemesi (9. adım). 8. adımda 29. ve 36. hastalar birleşmiştir. 33. hastanın bu yeni kümeye uzaklığı, kare uzaklıklarla (d^2(33{,}29)=4{,}201571, d^2(33{,}36)=4{,}182630, d^2(29{,}36)=4{,}177719):
Bu, o anda en küçük uzaklıktır; çizelgenin 9. satırı "−33 8 2.0486 3"tür.
Adım 4 — Son birleşmeler ve kesim. Son beş yükseklik 5,6290; 6,4995; 6,9745; 7,0900; 16,9075. Son birleşmedeki büyük sıçrama iki ana dal olduğunu gösterir. K = 5 için ilk 35 birleşme uygulanır; küme büyüklükleri 10, 11, 9, 6, 4'tür.
Adım 5 — Küme sayısı ölçütleri. T=39\times10=390. Son birleşme \Delta W=16{,}907462^2/2=142{,}931134; SPRSQ =142{,}931134/390=0{,}366490, dolayısıyla R^2_2=0{,}366490.
K = 5'te küme-içi toplam P_5=176{,}491118:
K = 5'e inen birleşme (35. adım) beşer hastalık iki kümeyi (W_A=11{,}818724, W_B=15{,}766467) birleştirir; \Delta W=15{,}842726:
Adım 6 — Silüet (1. hasta). Hasta 1, n=10 hastalık kümededir. Kendi kümesindeki öteki 9 hastaya ortalama uzaklık a=2{,}752102; en yakın komşu kümeye ortalama uzaklık b=3{,}398076:
Ortalama silüet \bar s=0{,}146556; CH =10{,}585251 (pseudo-F_5 ile aynı). Kofenetik korelasyon r_{\text{kof}}=0{,}630282.
Adım 7 — Bağlantılar arası karşılaştırma (K = 5).
| Bağlantı / uzaklık | Silüet | CH | r_{\text{kof}} | Küme büyüklükleri |
|---|---|---|---|---|
| Ward / Öklid | 0,1466 | 10,585 | 0,6303 | 10, 11, 9, 6, 4 |
| Tam / Öklid | 0,1295 | 10,556 | 0,6787 | 14, 8, 5, 8, 5 |
| Ortalama / Öklid | 0,1267 | 10,002 | 0,6873 | 16, 12, 2, 4, 6 |
| Tek / Öklid | 0,0046 | 6,491 | 0,5680 | 14, 23, 1, 1, 1 |
| Merkez / Öklid | 0,0373 | 7,486 | 0,6716 | 21, 16, 1, 1, 1 |
| Medyan / Öklid | 0,0477 | 7,516 | 0,6612 | 21, 1, 16, 1, 1 |
| McQuitty / Öklid | 0,1254 | 10,092 | 0,6841 | 9, 13, 12, 4, 2 |
| Ward / kare Öklid | 0,2529 | 10,585 | 0,5781 | aynı ağaç (Ward) |
| Ortalama / Gower | 0,1233 | 9,800 | 0,6572 | 11, 11, 13, 4, 1 |
Tek, merkez ve medyan bağlantıları zincirleme yapar ve tekil kümeler üretir. Ortalama bağlantının kofenetik korelasyonu en yüksektir (uzaklıkları en iyi korur), Ward ise en dengeli kümeleri verir. Ward / kare Öklid satırında silüetin büyümesi, aynı bölüntünün kare uzaklıklarla ölçülmesinden gelir; yapı değişmemiştir.
Şekil 76.1. Ward (Öklid, z) dendrogramı. Mor dallar K = 5 kesiminin altındaki kümeler, turuncu kesikli çizgi K = 5 kesim yüksekliği; yaprak harfleri gerçek alt tiptir (A–E).
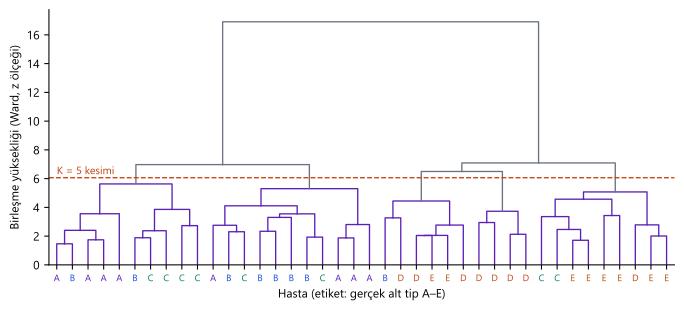
Adım 8 — Gerçek alt tiple karşılaştırma. MerQur kümeleri (Tablo sekmesindeki numaralarla) ile lower_type çapraz tablosu:
| Küme | type-A | type-B | type-C | type-D | type-E |
|---|---|---|---|---|---|
| 0 | 4 | 2 | 4 | 0 | 0 |
| 1 | 4 | 5 | 2 | 0 | 0 |
| 2 | 0 | 0 | 2 | 1 | 6 |
| 3 | 0 | 1 | 0 | 3 | 2 |
| 4 | 0 | 0 | 0 | 4 | 0 |
Ağaç iki büyük dalı (A–B–C ile D–E) iyi ayırır; beş tipin her birini ayrı bir kümeye koyamaz. Silüetin 0,15 olması da beş kümeli yapının zayıf olduğunu söyler. Küme sayısı ölçütleri aynı yönü gösterir: pseudo-F en büyük k = 2'dedir (21,98) ve son birleşmenin SPRSQ'su (0,366) bütün öteki adımlarınkinin yaklaşık altı katıdır.
76.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() çıktısından alınmıştır (dogrulama/hierarchical/merqur_calistir.py; round() yalnız bellekte etkisiz). Python sütunu numpy ile bağımsız Lance–Williams uygulamasıdır. R: 4.5.3, hclust (ward.D2, complete, average, single, mcquitty; merkez ve medyan dist^2 üzerinde, yükseklik karekök), cutree, cophenetic, cluster::silhouette, cluster::daisy(metric = "gower"); küme sayısı ölçütleri hclust$merge üzerinden tanımlarından. Bölüntü satırlarında değer, R cutree bölüntüsüne göre farklı kümeye düşen gözlem sayısıdır. Ölçüt: en büyük mutlak fark \le10^{-6} (değer 1'den büyükse göreli).
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Ward (Öklid): 39 birleşme yüksekliği | 16,907462 | 16,907462 | 16,907462 | 1,1e−14 | ✓ |
| Ward (Öklid): K = 5 bölüntüsü (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| Ward (Öklid): ortalama silüet | 0,146556 | 0,146556 | 0,146556 | 4,2e−16 | ✓ |
| Ward (Öklid): Calinski–Harabasz | 10,585251 | 10,585251 | 10,585251 | 2,1e−14 | ✓ |
| Tam bağlantı: 39 birleşme yüksekliği | 8,316890 | 8,316890 | 8,316890 | 5,3e−15 | ✓ |
| Tam bağlantı: K = 5 bölüntüsü (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| Tam bağlantı: ortalama silüet | 0,129540 | 0,129540 | 0,129540 | 2,5e−16 | ✓ |
| Tam bağlantı: Calinski–Harabasz | 10,555770 | 10,555770 | 10,555770 | 3,6e−15 | ✓ |
| Tam bağlantı: kofenetik r | 0,678729 | 0,678729 | 0,678729 | 5,6e−16 | ✓ |
| Tam bağlantı: R² (k = 1..10) | 0,546768 | 0,546768 | 0,546768 | 6,7e−16 | ✓ |
| Tam bağlantı: SPRSQ (k = 1..10) | 0,036115 | 0,036115 | 0,036115 | 3,9e−16 | ✓ |
| Tam bağlantı: pseudo-F (k = 1..10) | 10,555770 | 10,555770 | 10,555770 | 5,3e−14 | ✓ |
| Tam bağlantı: pseudo-t² (k = 1..10) | 3,023820 | 3,023820 | 3,023820 | 2,8e−14 | ✓ |
| Ortalama bağlantı: 39 birleşme yüksekliği | 5,085724 | 5,085724 | 5,085724 | 5,3e−15 | ✓ |
| Ortalama bağlantı: K = 5 bölüntüsü (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| Ortalama bağlantı: ortalama silüet | 0,126650 | 0,126650 | 0,126650 | 1,4e−16 | ✓ |
| Ortalama bağlantı: Calinski–Harabasz | 10,002330 | 10,002330 | 10,002330 | 4,1e−14 | ✓ |
| Ortalama bağlantı: kofenetik r | 0,687290 | 0,687290 | 0,687290 | 1,1e−16 | ✓ |
| Ortalama bağlantı: R² (k = 1..10) | 0,533391 | 0,533391 | 0,533391 | 4,4e−16 | ✓ |
| Ortalama bağlantı: SPRSQ (k = 1..10) | 0,048398 | 0,048398 | 0,048398 | 3,9e−16 | ✓ |
| Ortalama bağlantı: pseudo-F (k = 1..10) | 10,002330 | 10,002330 | 10,002330 | 4,8e−14 | ✓ |
| Ortalama bağlantı: pseudo-t² (k = 1..10) | 3,950635 | 3,950635 | 3,950635 | 1,8e−14 | ✓ |
| Tek bağlantı: 39 birleşme yüksekliği | 2,933617 | 2,933617 | 2,933617 | 4,9e−15 | ✓ |
| Tek bağlantı: K = 5 bölüntüsü (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| Tek bağlantı: ortalama silüet | 0,004562 | 0,004562 | 0,004562 | 5,7e−17 | ✓ |
| Tek bağlantı: Calinski–Harabasz | 6,491412 | 6,491412 | 6,491412 | 3,6e−15 | ✓ |
| Tek bağlantı: kofenetik r | 0,568036 | 0,568036 | 0,568036 | 1,0e−15 | ✓ |
| Tek bağlantı: R² (k = 1..10) | 0,425906 | 0,425906 | 0,425906 | 5,0e−16 | ✓ |
| Tek bağlantı: SPRSQ (k = 1..10) | 0,027653 | 0,027653 | 0,027653 | 5,6e−16 | ✓ |
| Tek bağlantı: pseudo-F (k = 1..10) | 6,491412 | 6,491412 | 6,491412 | 9,8e−15 | ✓ |
| Tek bağlantı: pseudo-t² (k = 1..10) | 1,904236 | 1,904236 | 1,904236 | 5,7e−14 | ✓ |
| Merkez (centroid): 39 birleşme yüksekliği | 3,905761 | 3,905761 | 3,905761 | 4,9e−15 | ✓ |
| Merkez (centroid): K = 5 bölüntüsü (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| Merkez (centroid): ortalama silüet | 0,037270 | 0,037270 | 0,037270 | 4,9e−17 | ✓ |
| Merkez (centroid): Calinski–Harabasz | 7,486396 | 7,486396 | 7,486396 | 1,8e−15 | ✓ |
| Merkez (centroid): kofenetik r | 0,671559 | 0,671559 | 0,671559 | 2,2e−16 | ✓ |
| Merkez (centroid): R² (k = 1..10) | 0,461087 | 0,461087 | 0,461087 | 4,4e−16 | ✓ |
| Merkez (centroid): SPRSQ (k = 1..10) | 0,018545 | 0,018545 | 0,018545 | 2,8e−16 | ✓ |
| Merkez (centroid): pseudo-F (k = 1..10) | 7,486396 | 7,486396 | 7,486396 | 2,8e−14 | ✓ |
| Merkez (centroid): pseudo-t² (k = 1..10) | 1,208133 | 1,208133 | 1,208133 | 2,8e−14 | ✓ |
| Medyan: 39 birleşme yüksekliği | 5,369351 | 5,369351 | 5,369351 | 5,3e−15 | ✓ |
| Medyan: K = 5 bölüntüsü (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| Medyan: ortalama silüet | 0,047692 | 0,047692 | 0,047692 | 3,5e−17 | ✓ |
| Medyan: Calinski–Harabasz | 7,515692 | 7,515692 | 7,515692 | 5,3e−15 | ✓ |
| Medyan: kofenetik r | 0,661185 | 0,661185 | 0,661185 | 8,9e−16 | ✓ |
| Medyan: R² (k = 1..10) | 0,462058 | 0,462058 | 0,462058 | 5,0e−16 | ✓ |
| Medyan: SPRSQ (k = 1..10) | 0,046061 | 0,046061 | 0,046061 | 2,8e−16 | ✓ |
| Medyan: pseudo-F (k = 1..10) | 7,515692 | 7,515692 | 7,515692 | 5,9e−14 | ✓ |
| Medyan: pseudo-t² (k = 1..10) | 3,441371 | 3,441371 | 3,441371 | 2,8e−14 | ✓ |
| McQuitty (WPGMA): 39 birleşme yüksekliği | 5,965975 | 5,965975 | 5,965975 | 5,3e−15 | ✓ |
| McQuitty (WPGMA): K = 5 bölüntüsü (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| McQuitty (WPGMA): ortalama silüet | 0,125446 | 0,125446 | 0,125446 | 2,8e−16 | ✓ |
| McQuitty (WPGMA): Calinski–Harabasz | 10,091544 | 10,091544 | 10,091544 | 1,1e−14 | ✓ |
| McQuitty (WPGMA): kofenetik r | 0,684149 | 0,684149 | 0,684149 | 4,4e−16 | ✓ |
| McQuitty (WPGMA): R² (k = 1..10) | 0,535601 | 0,535601 | 0,535601 | 4,4e−16 | ✓ |
| McQuitty (WPGMA): SPRSQ (k = 1..10) | 0,040745 | 0,040745 | 0,040745 | 3,9e−16 | ✓ |
| McQuitty (WPGMA): pseudo-F (k = 1..10) | 10,091544 | 10,091544 | 10,091544 | 3,6e−14 | ✓ |
| McQuitty (WPGMA): pseudo-t² (k = 1..10) | 3,723179 | 3,723179 | 3,723179 | 1,8e−14 | ✓ |
| Ward (kare Öklid): 39 birleşme yüksekliği | 285,862268 | 285,862268 | 285,862268 | 6,0e−14 | ✓ |
| Ward (kare Öklid): K = 5 bölüntüsü (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| Ward (kare Öklid): ortalama silüet | 0,252921 | 0,252921 | 0,252921 | 3,9e−16 | ✓ |
| Ward (kare Öklid): Calinski–Harabasz | 10,585251 | 10,585251 | 10,585251 | 2,0e−14 | ✓ |
| Ward (kare Öklid): kofenetik r | 0,578120 | 0,578120 | 0,578120 | 6,7e−16 | ✓ |
| Ward (kare Öklid): R² (k = 1..10) | 0,547459 | 0,547459 | 0,547459 | 5,0e−16 | ✓ |
| Ward (kare Öklid): SPRSQ (k = 1..10) | 0,040622 | 0,040622 | 0,040622 | 4,4e−16 | ✓ |
| Ward (kare Öklid): pseudo-F (k = 1..10) | 10,585251 | 10,585251 | 10,585251 | 2,3e−14 | ✓ |
| Ward (kare Öklid): pseudo-t² (k = 1..10) | 4,594560 | 4,594560 | 4,594560 | 1,1e−14 | ✓ |
| Ortalama + Manhattan: 39 birleşme yüksekliği | 13,729260 | 13,729260 | 13,729260 | 2,8e−14 | ✓ |
| Ortalama + Manhattan: K = 5 bölüntüsü (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| Ortalama + Manhattan: ortalama silüet | 0,136937 | 0,136937 | 0,136937 | 5,0e−16 | ✓ |
| Ortalama + Manhattan: Calinski–Harabasz | 9,758849 | 9,758849 | 9,758849 | 7,1e−15 | ✓ |
| Ortalama + Manhattan: kofenetik r | 0,657589 | 0,657589 | 0,657589 | 5,6e−16 | ✓ |
| Ortalama + Manhattan: R² (k = 1..10) | 0,527253 | 0,527253 | 0,527253 | 6,7e−16 | ✓ |
| Ortalama + Manhattan: SPRSQ (k = 1..10) | 0,039360 | 0,039360 | 0,039360 | 3,9e−16 | ✓ |
| Ortalama + Manhattan: pseudo-F (k = 1..10) | 9,758849 | 9,758849 | 9,758849 | 3,7e−14 | ✓ |
| Ortalama + Manhattan: pseudo-t² (k = 1..10) | 3,209386 | 3,209386 | 3,209386 | 2,1e−14 | ✓ |
| Ortalama + 1 − r: 39 birleşme yüksekliği | 1,130434 | 1,130434 | 1,130434 | 3,6e−15 | ✓ |
| Ortalama + 1 − r: K = 5 bölüntüsü (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| Ortalama + 1 − r: ortalama silüet | 0,193279 | 0,193279 | 0,193279 | 2,5e−16 | ✓ |
| Ortalama + 1 − r: Calinski–Harabasz | 2,685558 | 2,685558 | 2,685558 | 1,8e−15 | ✓ |
| Ortalama + 1 − r: kofenetik r | 0,560868 | 0,560868 | 0,560868 | 1,0e−15 | ✓ |
| Ortalama + 1 − r: R² (k = 1..10) | 0,234843 | 0,234843 | 0,234843 | 7,8e−16 | ✓ |
| Ortalama + 1 − r: SPRSQ (k = 1..10) | 0,035285 | 0,035285 | 0,035285 | 1,2e−16 | ✓ |
| Ortalama + 1 − r: pseudo-F (k = 1..10) | 2,685558 | 2,685558 | 2,685558 | 1,6e−14 | ✓ |
| Ortalama + 1 − r: pseudo-t² (k = 1..10) | 1,474610 | 1,474610 | 1,474610 | 3,0e−14 | ✓ |
| Ortalama + kosinüs: 39 birleşme yüksekliği | 1,364717 | 1,364717 | 1,364717 | 3,6e−15 | ✓ |
| Ortalama + kosinüs: K = 5 bölüntüsü (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| Ortalama + kosinüs: ortalama silüet | 0,241866 | 0,241866 | 0,241866 | 2,2e−16 | ✓ |
| Ortalama + kosinüs: Calinski–Harabasz | 8,762126 | 8,762126 | 8,762126 | 3,6e−15 | ✓ |
| Ortalama + Gower (ham): 39 birleşme yüksekliği | 0,334441 | 0,334441 | 0,334441 | 5,0e−16 | ✓ |
| Ortalama + Gower (ham): K = 5 bölüntüsü (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| Ortalama + Gower (ham): ortalama silüet | 0,123287 | 0,123287 | 0,123287 | 1,9e−16 | ✓ |
| Ortalama + Gower (ham): Calinski–Harabasz | 9,799862 | 9,799862 | 9,799862 | 7,1e−15 | ✓ |
| Ortalama + Gower (ham): kofenetik r | 0,657179 | 0,657179 | 0,657179 | 1,1e−16 | ✓ |
| Ortalama + Gower (ham): R² (k = 1..10) | 0,528298 | 0,528298 | 0,528298 | 5,6e−16 | ✓ |
| Ortalama + Gower (ham): SPRSQ (k = 1..10) | 0,037175 | 0,037175 | 0,037175 | 3,3e−16 | ✓ |
| Ortalama + Gower (ham): pseudo-F (k = 1..10) | 9,799862 | 9,799862 | 9,799862 | 2,5e−14 | ✓ |
| Ortalama + Gower (ham): pseudo-t² (k = 1..10) | 3,083764 | 3,083764 | 3,083764 | 1,1e−14 | ✓ |
| Ward + Manhattan (uyarılı): 39 birleşme yüksekliği | 48,769883 | 48,769883 | 48,769883 | 3,6e−14 | ✓ |
| Ward + Manhattan (uyarılı): K = 5 bölüntüsü (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| Ward + Manhattan (uyarılı): ortalama silüet | 0,141045 | 0,141045 | 0,141045 | 3,9e−16 | ✓ |
| Ward + Manhattan (uyarılı): Calinski–Harabasz | 10,591637 | 10,591637 | 10,591637 | 3,0e−14 | ✓ |
| Ward (ham veri): 39 birleşme yüksekliği | 23,217879 | 23,217879 | 23,217879 | 5,0e−14 | ✓ |
| Ward (ham veri): K = 5 bölüntüsü (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| Ward (ham veri): ortalama silüet | 0,132887 | 0,132887 | 0,132887 | 3,3e−16 | ✓ |
| Ward (ham veri): Calinski–Harabasz | 11,261988 | 11,261988 | 11,261988 | 4,8e−14 | ✓ |
| Ward (ham veri): kofenetik r | 0,680466 | 0,680466 | 0,680466 | 4,4e−16 | ✓ |
| Ward (ham veri): R² (k = 1..10) | 0,562762 | 0,562762 | 0,562762 | 5,6e−16 | ✓ |
| Ward (ham veri): SPRSQ (k = 1..10) | 0,038843 | 0,038843 | 0,038843 | 3,3e−16 | ✓ |
| Ward (ham veri): pseudo-F (k = 1..10) | 11,261988 | 11,261988 | 11,261988 | 4,8e−14 | ✓ |
| Ward (ham veri): pseudo-t² (k = 1..10) | 3,225041 | 3,225041 | 3,225041 | 1,1e−14 | ✓ |
| Ward üyelik k = 2 (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| Ward üyelik k = 3 (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| Ward üyelik k = 4 (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| Ward üyelik k = 5 (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| Ward üyelik k = 6 (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| Ward gözlem bazlı silüet (40 gözlem) | 0,019042 | 0,019042 | 0,019042 | 6,7e−16 | ✓ |
| Değişken kümeleme (1 − r, ortalama): 9 yükseklik | 0,631411 | 0,631411 | 0,631411 | 5,6e−16 | ✓ |
| Değişken kümeleme: 5 küme (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
Sonuç: 119 satırın tamamı ölçütü karşılar; en büyük fark 10^{-13} düzeyindedir. Yedi bağlantı, beş uzaklık seçeneği, ham ölçek, üyelik aralığı ve değişken kümelemede MerQur, bağımsız Python ve R aynı ağacı, aynı bölüntüyü ve aynı ölçütleri verir.
76.7 Çıktıyı okuma
MerQur'un sonuç metni (K = 5, Ward, K seçim ölçütleri, üyelik aralığı 2..6, değişken kümeleme ve gözlem bazlı silüet açık; kısaltılmış):
Hierarchical Clustering | n = 40 | Küme sayısı: 5 | Bağlantı: Ward | Silüet: 0.1466 | Calinski-H: 10.5853
Birleştirme çizelgesi:
    Adım     Küme A     Küme B        Katsayı      n
       1         -1        -11         1.4646      2
       2        -35        -37         1.7143      2
       ...
       9        -33          8         2.0486      3
       ...
      38         33         36         7.0900     19
      39         37         38        16.9075     40
Kofenetik korelasyon (ağaç ↔ uzaklıklar) = 0.6303
── Küme sayısı ölçütleri ──
    k     SPRSQ       R²    pseudo-F   pseudo-t²
    1    0.3665   0.0000           —      21.983
    2    0.0644   0.3665      21.983       4.141
    ...
    5    0.0406   0.5475      10.585       4.595
── Küme büyüklükleri, k = 2..6 ──
  k =  5: 0: 10, 1: 11, 2: 6, 3: 9, 4: 4
── Değişken kümeleme (1 − r, average bağlantı), 5 küme ──
  Küme 0: gene_01, gene_05, gene_08
  ...
── Gözlem bazlı silüet (küme ortalamaları) ──
  Küme 2: n = 9, ortalama genişlik = 0.1257, negatif = 1
  ...
[Tablo]
 Küme  n    %  gene_01_ort  gene_02_ort  ...
    2  9 22.5       2.8056       2.2152  ...
    3  6 15.0       1.7562       0.4572  ...
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Künye "Bağlantı" | Bağlantı adı | Merkez/medyan/McQuitty seçildiğinde bağlantının arayüz dilindeki adı yazılır (core/apa_format.py:357–365). |
| Künye Silüet, Calinski-H | 76.5.6 | 0,15: zayıf yapı. |
| Birleştirme çizelgesi | Adım, birleşenler, katsayı, n | Katsayıdaki büyük sıçrama (7,09 → 16,91) öncesindeki küme sayısını (2) önerir. n>200'de yalnız son 50 adım yazılır (hierarchical.py:198–200). |
| Kofenetik korelasyon | 76.5.7 | 0,63: ağaç uzaklıkların ancak bir kısmını korur. |
| Küme sayısı ölçütleri | 76.5.8 | pseudo-F'nin en büyük olduğu ve hemen ardından pseudo-t^2'nin büyüdüğü k aranır. |
| Küme büyüklükleri, k = a..b | Her k için küme n'leri | Numaralar Tablo sekmesindeki numaralarla aynı değildir (76.5.3); k = 5'te Tablo'daki 2 (n=9) burada 3, Tablo'daki 3 (n=6) burada 2'dir. |
| Değişken kümeleme | 1-r ile değişken grupları ve 9 birleşme yüksekliği | Birlikte değişen genleri gösterir. |
| Gözlem bazlı silüet | Küme başına ortalama ve negatif sayısı | Negatif silüetli hastalar sınırdadır. |
| Uyarılar | Ward + Öklid dışı uzaklık; Jaccard kodlaması | clustering.py:850–857, 225–245. |
| Tablo sekmesi | n, %, ham ortalamalar | Kümelerin profili. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
On genin ifade düzeyleri z-puanına dönüştürüldükten sonra 40 hasta Ward bağlantısı ve Öklid uzaklıkla hiyerarşik olarak kümelendi. Ağacın son birleşmesindeki büyük sıçrama (yükseklik 7,09'dan 16,91'e) ve en büyük pseudo-F değeri (k = 2'de 21,98) iki ana dalın varlığını gösterdi; bu dallar A–C ve D–E alt tiplerine karşılık geldi. Beş kümeli çözüm toplam değişkenliğin %54,7'sini açıkladı (pseudo-F = 10,59), ancak ortalama silüet genişliği düşüktü (0,15) ve kümeler bilinen beş alt tiple yalnız kısmen örtüştü. Kofenetik korelasyon 0,63'tür.
76.8 Uzman soruları
S1. Ward yükseklikleri R'deki hangi seçenekle aynı?
Öklid + Ward için R hclust(dist(scale(X)), "ward.D2") ile 10^{-15} düzeyinde aynıdır (76.6.1). Kare Öklid + Ward'da MerQur katsayıları h^2 yazar; bu, R hclust(dist(scale(X))^2, "ward.D") yüksekliğidir. Bazı yazılımların Ward çizelgesi başka bir ölçek (birikimli küme-içi KT) kullanabilir; karşılaştırmada katsayının tanımı denetlenmelidir. R "ward.D"'nin karesi alınmamış uzaklıkla kullanımı Ward ölçütünü uygulamaz.
S2. Merkez bağlantısında yükseklikler neden R'den farklı görünüyor?
R hclust(d, "centroid") Lance–Williams güncellemesini girdiye doğrudan uygular; belgesi girdinin kare uzaklık olmasını önerir ve o zaman yükseklikler kare uzaklıktır. MerQur scipy ile gözlemlerden kurar ve yüksekliği Öklid ölçeğinde (karekök) raporlar. sqrt(hclust(dist(z)^2, "centroid")$height) MerQur ile aynıdır. Kesim, ters dönmeler nedeniyle her iki programda da birleşme sırasıyla yapılır.
S3. Tablo sekmesindeki küme numaraları üyelik aralığıyla neden uyuşmuyor?
Öklid yolunda ana etiketler scikit-learn'den, üyelik aralığı scipy fcluster'dan gelir ve iki kütüphane kümeleri farklı sırayla numaralar (clustering.py:872–877, 963–971). Bölüntü aynıdır; yalnız numaralar farklıdır. "Kaydet" ile yazılan ana HC{K}_CLUSTER sütunu her zaman Tablo sekmesindeki numarayı taşır; üyelik aralığı K'yı içerse de bu sütunun üzerine yazılmaz (hierarchical.py:130–137). Öteki k'ların sütunları üyelik aralığının numaralandırmasını izler.
S4. Pseudo-F tablosu Manhattan ya da Gower seçildiğinde neyi ölçüyor?
Her zaman Öklid KT'sini (Gower ve Jaccard'da ham değişkenlerin). Ağaç Gower uzaklığıyla kurulmuş, ölçüt ham Öklid KT'siyle hesaplanmış olur; ikisi farklı geometrilerdir. Bu durumda k seçimi için silüet (seçilen uzaklıkla hesaplanır) daha tutarlıdır.
S5. Eşit uzaklıklar (bağlar) olduğunda sonuç programdan programa değişir mi?
Değişebilir. Bir adımda iki çift aynı en küçük uzaklıktaysa hangisinin önce birleşeceği uygulamaya bağlıdır ve sonraki ağaç farklılaşabilir. Sürekli ölçümlerde (bu veri gibi) bağ olasılığı ihmal edilir. Tam sayı ya da ikili veride (Jaccard, Gower ile kategorik kodlar) bağ sıktır; o durumda farklı programlar eşit derecede geçerli farklı ağaçlar verebilir.
S6. Tek bağlantıda neden üç tekil küme çıktı?
Tek bağlantı iki kümenin en yakın üyelerine bakar; uzun zincirler oluşur ve uzaktaki tek gözlemler en son katılır. K = 5'te bu, iki büyük küme ve üç tek hastalık "küme" demektir (silüet 0,005). Tek bağlantı aykırı gözlem bulmak için yararlıdır, alt tip bulmak için uygun değildir.
S7. Korelasyon uzaklığı R'de neden farklı bir ağaç verdi?
MerQur korelasyonu z-ölçekli satırlar üzerinde hesaplar (76.5.2). Önce her gen sütunu standartlaştırılır, sonra iki hastanın 10 genlik profili arasındaki korelasyon alınır. R'de yaygın cor(t(X)) ham satırları kullanır. Aynı sonuç için cor(t(scale(X))) gerekir.
S8. n = 1000 ise dendrogram neden ilk 500 gözlemi gösteriyor?
Grafik okunurluğu ve bellek için dendrogram ilk 500 satırdan ayrıca kurulan bir ağaçla çizilir (clustering.py:910); bu, tüm verideki ağacın bir alt ağacı değildir. Metinde not yazılır. Üyelikler, çizelge ve ölçütler tüm veridendir.
76.9 Sık hatalar ve tuzaklar
- Bağlantı yöntemini sonuca bakarak seçmek. Yedi yöntem aynı veride çok farklı bölüntüler verir (76.6, Adım 7). Yöntem, kümelerin beklenen biçimine göre önceden seçilmelidir.
- Dendrogram yüksekliklerini yöntemler arasında karşılaştırmak. Ward yüksekliği \sqrt{2\Delta W}, tam bağlantınınki en uzak çift uzaklığıdır; ölçekleri farklıdır.
- Kare Öklid + Ward katsayılarını Öklid sanmak. Katsayılar yüksekliğin karesidir; çizelge notu bunu yazar.
- Küme numaralarını tablolar arasında eşlemek. Tablo sekmesi ile üyelik aralığı farklı numaralandırır; ana
HC{K}_CLUSTERsütunu Tablo sekmesine, öteki k sütunları üyelik aralığına uyar. - Ölçeklemeden Öklid kullanmak. "Yok (ham veri)" seçilirse büyük varyanslı genler baskın olur; bu veride ham Ward farklı büyüklükte kümeler verir (10, 8, 11, 6, 5).
- Ward'ı Manhattan ya da korelasyonla kullanmak. MerQur uyarıyla çalıştırır; yükseklikler artık KT artışı değildir.
- Formun varsayılan K'sını (3) kabul etmek. Ağaç ve ölçütler incelenip K elle girilmelidir.
- Dendrogram yaprak etiketinin kaynağını bilmemek. İlk metin sütunu kendiliğinden etiket olur; yanlışlıkla bir sonuç değişkeni (ör. tanı) yaprakta görünebilir.
76.10 Kaynaklar
- Caliński, T., & Harabasz, J. (1974). A dendrite method for cluster analysis. Communications in Statistics, 3(1), 1–27. https://doi.org/10.1080/03610927408827101
- Gower, J. C. (1971). A general coefficient of similarity and some of its properties. Biometrics, 27(4), 857–871. https://doi.org/10.2307/2528823
- Kaufman, L., & Rousseeuw, P. J. (1990). Finding groups in data: An introduction to cluster analysis. Wiley. https://doi.org/10.1002/9780470316801
- Lance, G. N., & Williams, W. T. (1967). A general theory of classificatory sorting strategies: 1. Hierarchical systems. The Computer Journal, 9(4), 373–380. https://doi.org/10.1093/comjnl/9.4.373
- Milligan, G. W., & Cooper, M. C. (1985). An examination of procedures for determining the number of clusters in a data set. Psychometrika, 50(2), 159–179. https://doi.org/10.1007/BF02294245
- Murtagh, F., & Legendre, P. (2014). Ward's hierarchical agglomerative clustering method: Which algorithms implement Ward's criterion? Journal of Classification, 31(3), 274–295. https://doi.org/10.1007/s00357-014-9161-z
- Rousseeuw, P. J. (1987). Silhouettes: A graphical aid to the interpretation and validation of cluster analysis. Journal of Computational and Applied Mathematics, 20, 53–65. https://doi.org/10.1016/0377-0427(87)90125-7
- SAS Institute. (2016). SAS/STAT 14.2 user's guide: The CLUSTER procedure. SAS Institute Inc.
- Sokal, R. R., & Rohlf, F. J. (1962). The comparison of dendrograms by objective methods. Taxon, 11(2), 33–40. https://doi.org/10.2307/1217208
- Ward, J. H., Jr. (1963). Hierarchical grouping to optimize an objective function. Journal of the American Statistical Association, 58(301), 236–244. https://doi.org/10.1080/01621459.1963.10500845