120. Çoklu Atama
Analiz kimliği: multiple_imputation · Menü adı: Çoklu Atama · Panel ve havuzlama: gui/panels/analyses/multiple_imputation.py (form 134–297, read_options 310–335, execute 415–953, Rubin bloğu 756–811, _pool_r2 978–997, _d1_test 1000–1036) · Atama ve havuzlama yardımcıları: stats/mi_tools.py, fcs_impute (330–399), _norm_draw (224–233), impute_pmm (241–251), pool_rubin (185–204), little_mcar (159–180) · Çağıran: stats_panel.py:6834–6879
120.1 Ne işe yarar
Çoklu atama (multiple imputation, MI) eksik değerli bir veri setinde analizi, eksikleri tek bir tahminle doldurmadan yapar. Her eksik değer, gözlenen verinin verdiği bilgiyle uyumlu ama birbirinden farklı m değerle doldurulur; aynı analiz m tamamlanmış veri setinin her birinde ayrı ayrı yapılır; sonuçlar Rubin kurallarıyla tek bir kestirime, standart hataya (SH), serbestlik derecesine (sd) ve güven aralığına (GA) birleştirilir. Cevapladığı soru: "Eksik değerleri olan bu hastalarda sistolik kan basıncının yaş, BMI ve HbA1c ile ilişkisi nedir ve eksiklik yüzünden ne kadar bilgi kaybettik?"
MerQur'un yaptığı üç adım:
- Atama. m kez, her biri ayrı tohumla (seed) başlayan zincirleme denklemler (FCS/MICE) ya da Bayesçi ridge ile eksikler doldurulur.
- Analiz. Her tamamlanmış veride aynı model (varsayılan: doğrusal regresyon, OLS) kestirilir; katsayı \hat Q_l ve varyansı U_l=\SH_l^2 saklanır.
- Havuzlama. \bar Q, atama içi varyans \bar U, atamalar arası varyans B, toplam varyans T, Barnard–Rubin sd'si, kayıp bilgi oranı ve t testleri hesaplanır.
Ne zaman kullanılır? Eksiklik rastgele eksik (MAR) varsayımı altında makulse, yani eksik olma olasılığı gözlenen değişkenlerle açıklanabiliyorsa; eksik oranı birkaç yüzdeyi aşıyorsa; ve amaç bir regresyon modelinin (OLS, lojistik, Poisson) katsayılarıysa.
Ne zaman kullanılmaz?
- Eksiklik tamamen rastgele (MCAR) ve oranı çok küçükse: liste bazında silmeyle yapılan analiz (örneğin Doğrusal Regresyon, Bölüm 45) yansızdır ve daha basittir.
- Eksiklik gözlenmeyen değere bağlıysa (MNAR): MI tek başına yetmez; bu modüldeki MNAR δ duyarlılık analizi (120.5.7) sonucun ne kadar dayanıklı olduğunu gösterir, ama doğru modeli seçmez.
- Amaç bir karma model, sağkalım ya da yapısal eşitlik modeliyse: bu modülün analiz adımı yalnız OLS, lojistik ve Poisson kurar. Tamamlanmış veri setleri dışa aktarılıp başka analizde kullanılabilir, ama havuzlama elle yapılmalıdır.
- Bağımlı değişken kategorikse (metin): hata verir; ikili bağımlı değişken 0/1 sayısal kodlanmalı ve analiz modeli "Lojistik" seçilmelidir.
Sık karıştırılan yaklaşımlar. Ortalama ile doldurma ya da tek atama, atanan değeri gözlenmiş gibi sayar; SH'ler küçük, p değerleri iyimser çıkar. MI'da bu belirsizlik atamalar arası varyans B ile SH'ye geri eklenir. EM ile en çok olabilirlik (ML) kestirimi aynı MAR varsayımında tutarlıdır; ama yalnız çok değişkenli normal ortalama ve kovaryansı verir, regresyon SH'sini doğrudan vermez. MerQur'da EM yalnız Little MCAR testinde kullanılır.
120.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| MAR | Eksik olma olasılığı, eksik değerin kendisine değil gözlenen değişkenlere bağlı. | Doğrudan sınanamaz. Little MCAR testi yalnız MCAR'ı sınar (120.5.1); MNAR δ duyarlılığı ayrıca seçilebilir. |
| Atama modeli analiz modelini kapsar | Analizdeki tüm değişkenler (bağımlı dahil) ve etkileşimler atama modelinde olmalı. | Bağımlı, bağımsız ve yardımcı değişkenler atama modeline girer; analizdeki etkileşimler girmez (120.9). |
| Atama yöntemi değişken türüne uygun | Sayısal: PMM ya da norm; ikili: logreg; çok düzeyli: polyreg. | FCS'de otomatik seçilir (multiple_imputation.py:617–632). |
| Yeterli m | Kayıp bilgi oranı büyükse m büyük olmalı. | FMI (\gamma) > 0,30 ve > 0,50'de uyarı. |
| Zincirin yakınsaması | FCS döngüsünün durağan dağılıma ulaşması. | Denetlenmez; "Yakınsama izi" grafiği gözle denetim içindir. |
| Analiz modeli varsayımları | OLS, lojistik, Poisson modellerinin kendi varsayımları. | Yalnız bağımlı değişkenin tanım kümesi (lojistikte [0, 1], Poisson'da ≥ 0) denetlenir (:550–563, :701–719). |
Eksik değer. Bu modülün konusu eksik değerdir: seçilen bağımlı, bağımsız ve yardımcı değişkenlerdeki tüm eksikler atanır. Seçilmeyen sütunlar (Tıp örneğinde cholesterol) modelin dışında kalır ve atanmaz. Liste bazında karşılaştırma yalnız bağımlı ve bağımsız değişkenleri tam olan satırlarla yapılır (:801).
Uç durumlar.
- Seçilen değişkenlerde hiç eksik yoksa hata (
:571–574). - m<2 ya da m>100, en çok yineleme <1 hata (
:515–520). - Bağımlı değişken metinse hata; FCS dışı (Bayesçi ridge) yöntemde herhangi bir değişken metinse hata (
:542–549). - Lojistik/Poisson seçilip bağımlı değişken tanım kümesi dışındaysa hata; atanmış bir veri setinde tanım dışına düşen değer de hata verir, kesirli atanmış değerler için uyarı yazılır (
:701–719). - Monoton atama seçilip örüntü monoton değilse hata (
mi_tools.py:404–417). - Atama ya da analiz modelinde yakınsama/ayrışma uyarısı veren veri seti sayısı sonuçta bildirilir (susturulmaz).
120.3 Parametreler
Form multiple_imputation.py:134–297, seçenek okuma read_options (:310–335).
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımlı değişken: | ilk sayısal sütun | Analiz modelinin bağımlısı; atama modeline de girer. | — |
| Bağımsız değişkenler: | — | Analiz modelinin yordayıcıları; FCS'de kategorik de olabilir. | — |
| m (atama sayısı): | 5 | Tamamlanmış veri seti sayısı (2–100). | B'nin kestirim duyarlılığı, sd, FMI. |
| En çok yineleme: | 10 | FCS'de zincir döngü sayısı; Bayesçi ridge'de IterativeImputer yineleme sayısı. | Atanan değerler. |
| Tohum: | 42 | Tek tohumdan m bağımsız alt akış türetilir (SeedSequence(tohum).spawn(m)); l. atama l. akışla yapılır. |
Atanan değerler; aynı tohum aynı sonucu verir. |
| Yardımcı (auxiliary) değişkenler: | yok | Atama modeline girer, analiz modeline girmez. | Atamaları ve FMI'yı değiştirir. |
| Atama yöntemi: | FCS/MICE — sayısal: PMM; kategorik: logreg/polyreg | PMM, norm (Bayesçi doğrusal) ya da IterativeImputer + BayesianRidge. | Atanan değerler. |
| Analiz modeli: | Doğrusal regresyon (OLS) | OLS, lojistik, Poisson. | Havuzlanan katsayılar. |
| m tamamlanmış veri setini kaydet | kapalı | Uzun biçimli CSV (.imp, .id). |
Dosya. |
| İmpute değerleri gözlenen aralıkla sınırla (min/maks) | kapalı | Her güncellemeden sonra gözlenen [min, maks]'a sıkıştırır. | Norm'da etkili; PMM zaten gözlenen değer verir. |
| Tam sayılı değişkenlerin impute değerlerini yuvarla | kapalı | Gözlenen değerleri tam sayı olan değişkenlerde. | Norm'da etkili. |
| Grafik: | Havuzlanmış katsayılar | Katsayı karşılaştırması, yakınsama izi ya da gözlenen/atanan yoğunlukları. | Yalnız grafik. |
| Eksik veri analizi: t testleri ve kategorik tablo | kapalı | Eksiklik örüntüsüne göre t testleri ve kategorik tablolar. | Ek bölüm. |
| Monoton atama (sıralı regresyon) | kapalı | Monoton örüntüde tek geçişli atama. | Atanan değerler; yalnız FCS. |
| MNAR duyarlılık değişkeni: / MNAR δ kaydırmaları: | yok / boş | Seçilen değişkenin atanan değerlerine δ eklenir; her δ için yeniden m atama. | Ek tablo; ana sonuç δ = 0. |
| Etkileşim terimleri: | boş | Analiz modeline a:b; atama modeline girmez. |
Ek katsayılar. |
| Referans düzeyleri: | boş | Kategorik yordayıcının referansı. | Kategorik katsayılar. |
| Pasif atama: | boş | bmi = kilo / (boy / 100) ** 2: türetilmiş değişken ifadeden yeniden hesaplanır. |
Yalnız FCS. |
| Güven Düzeyi: | %95 | GA ve "anlamlı" işareti. | GA. |
Varsayılan yöntem FCS PMM
Atama yöntemi kutusunun varsayılan satırı FCS PMM'dir (eng_combo.setCurrentIndex(1), :198). read_options FCS'yi engine = "fcs", PMM'i num_method = "pmm" olarak geçirir (:316–321). Bu, mice'ın sayısal değişken varsayılanıdır: atanan değerler her zaman gözlenen değerlerden gelir, tanım kümesi korunur (negatif BMI ya da 7,3 çocuk gibi değerler çıkmaz). En çok yineleme kutusunun ipucu metni yalnız "IterativeImputer iç yineleme sayısı" der; FCS'de bu sayı zincir döngüsü sayısıdır (fcs_impute(…, maxit), 120.8 S8).
120.4 Tıp örneği
Dosya: english/datasets/Tip/54_multiple_imputation_missing_patient.xlsx (Türkçe kopya samples/Tum_Analiz_Tip/54_multiple_imputation_eksik_hasta.xlsx). Değişkenler VIDEO_SCRIPT_TR.txt #54'ten alınmıştır.
| Değişken | Rol | Tür | Gözlenen | Eksik | Özet (gözlenen) |
|---|---|---|---|---|---|
systolic_bp |
Bağımlı | sürekli (mmHg) | 150 | 0 | ort. 128,13; SS 20,34 |
age |
Bağımsız | sürekli (yıl) | 150 | 0 | ort. 54,43; SS 15,12 |
BMI |
Bağımsız | sürekli (kg/m²) | 114 | 36 (%24) | ort. 27,05; SS 4,46 |
HbA1c |
Bağımsız | sürekli (%) | 123 | 27 (%18) | ort. 6,39; SS 1,66 |
cholesterol |
(seçilmedi; ek çalıştırmada yardımcı) | sürekli | 125 | 25 | ort. 198,31 |
Eksiklik örüntüsü (1 = gözlenen, 0 = eksik; missing_patterns):
| n | systolic_bp | age | BMI | HbA1c | eksik sayısı |
|---|---|---|---|---|---|
| 97 | 1 | 1 | 1 | 1 | 0 |
| 26 | 1 | 1 | 0 | 1 | 1 |
| 17 | 1 | 1 | 1 | 0 | 1 |
| 10 | 1 | 1 | 0 | 0 | 2 |
n ve eksik değer: 150 hasta; 97'si eksiksiz (%64,7). Liste bazında silme 53 hastayı (%35) atar.
Klinik soru: Yaş, BMI ve HbA1c sistolik kan basıncını açıklıyor mu; liste bazında silme ile çoklu atama aynı sonuca mı götürüyor?
Seçilen ayarlar: Arayüz varsayılanları (FCS PMM, m=5, en çok yineleme 10, tohum 42, OLS, %95). Ek çalıştırmalar: FCS norm; yardımcı değişken cholesterol; m=20; MNAR δ ∈ {0, −2} (BMI).
120.5 Formüller ve hesap adımları
MerQur'un hesap sırası: değişken seçimi ve denetimler → FCS yöntemlerinin belirlenmesi → her l=1,\dots,m için tohumdan türetilen l. bağımsız alt akışla (SeedSequence(tohum).spawn(m)) FCS (başlangıç çekilişi + maxit döngü) → her tamamlanmış veride analiz modeli → Rubin havuzlaması (iki tablo: ana tablo ve mice eşdeğeri) → havuzlanmış R^2 ve D1 testi → liste bazında karşılaştırma → eksiklik örüntüleri ve Little MCAR testi → isteğe bağlı MVA, MNAR ve monoton çıktılar.
120.5.1 Eksiklik örüntüsü ve Little MCAR testi
- s: eksiklik örüntüsü; n_s: o örüntüdeki satır sayısı; S: örüntü sayısı.
- o: örüntüde gözlenen değişkenler; p_s=\lvert o\rvert; p: toplam sayısal değişken sayısı.
- \bar{\mathbf y}_{s,o}: örüntüdeki satırların gözlenen değişken ortalamaları.
- \hat{\boldsymbol\mu},\hat{\boldsymbol\Sigma}: tüm veriden çok değişkenli normal EM ile ML kestirimleri; \hat{\boldsymbol\Sigma} n paydalı (
em_mvn,mi_tools.py:117–156; durma 10^{-10}). - Test yalnız sayısal değişkenlerle yapılır (
multiple_imputation.py:869–876).
Neden MCAR testi MAR'ı kanıtlamaz?
d^2, örüntülerin ortalamalarının ortak ortalamadan farkını ölçer. Fark yoksa eksiklik gözlenen değişkenlerle ilişkisizdir (MCAR ile uyumlu). Ama MAR ile MNAR'ı ayıran bilgi (eksik değerin kendisi) veride yoktur; hiçbir test bunu ayıramaz. Anlamlı d^2 "MCAR değil" der; anlamsız d^2 MAR'ı ya da MCAR'ı kanıtlamaz (Little 1988a). Çıktı notu da bunu yazar.
120.5.2 Zincirleme denklemlerle atama (FCS)
- \mathcal J: eksiği olan değişkenler, veri sütun sırasıyla ziyaret edilir (
fcs_impute,mi_tools.py:368). - \mathbf Y_{-j}^{(t)}: o anki tamamlanmış veride j dışındaki tüm değişkenler (bağımlı değişken dahil); sabit sütunlar düşer, kategorikler kukla kodlanır (
_design,:209–221). - \boldsymbol\phi_j^{*}: atama modelinin parametrelerinin sonsal dağılımdan çekilmiş bir değeri; her döngüde yeniden çekilir.
- T: "En çok yineleme" (varsayılan 10); T sabittir, yakınsama ölçütü yoktur.
- Başlangıçta her eksik değer, aynı değişkenin gözlenen değerlerinden iadeli rastgele çekilir (
:359–364; miceinitialize).
Neden atama modelinde bağımlı değişken de var?
BMI atanırken sistolik kan basıncı yordayıcı olarak kullanılmazsa atanan BMI'lar kan basıncıyla ilişkisiz olur ve analizde BMI katsayısı sıfıra doğru çekilir. Atama modeli analiz modelindeki tüm ilişkileri içermelidir (van Buuren 2018, §6.2). MerQur bağımlı, bağımsız ve yardımcı değişkenlerin hepsini her değişkenin atama modeline koyar.
120.5.3 Bayesçi doğrusal regresyon çekilişi (norm ve PMM'in ortak adımı)
- \mathbf X_o,\mathbf y_o: j değişkeninin gözlendiği satırlardaki tasarım matrisi (sabitli) ve değerler; n_o satır, k sütun.
- \kappa=10^{-5}: sayısal kararlılık için küçük ridge cezası (mice ile aynı;
_norm_draw,mi_tools.py:224–233). - \mathbf L: (\mathbf X_o^{\top}\mathbf X_o+\kappa\,\mathrm{diag})^{-1}'in Cholesky çarpanı (alt üçgen).
- \sigma^{*} ve \boldsymbol\beta^{*}: düz öncül altında sonsal dağılımdan çekiliş (Rubin 1987, s. 167).
Neden parametre çekilişi?
Atama modelinin parametreleri de belirsizdir. Her atamada aynı \hat{\boldsymbol\beta} kullanılırsa atanan değerlerin değişkenliği yalnız artık gürültüsünden gelir; atamalar arası varyans B küçük çıkar ve havuzlanmış SH yine iyimser olur. \boldsymbol\beta^{*} ve \sigma^{*}'ın her atamada yeniden çekilmesi bu belirsizliği taşır. Rubin buna "uygun" (proper) atama der.
norm. y^{*}_i=\mathbf x_i^{\top}\boldsymbol\beta^{*}+\sigma^{*}\varepsilon_i, \varepsilon_i\sim N(0{,}1) (impute_norm, :236–238).
PMM (tip-1 eşleme).
- Gözlenen satırların öngörüsü \hat{\boldsymbol\beta} ile, eksik satırınki çekilmiş \boldsymbol\beta^{*} ile yapılır (tip-1; mice varsayılanı).
- \mathcal A_{i'}: \lvert\hat y_i^{\text{gözlenen}}-\hat y_{i'}^{\text{eksik}}\rvert'si en küçük 5 aday (
np.argpartition;impute_pmm,:241–251). - Atanan değer, adaylardan rastgele seçilenin gözlenen değeridir (Little 1988b).
İkili ve çok düzeyli kategorikler. logreg: lojistik GLM, \boldsymbol\beta^{*}\sim N(\hat{\boldsymbol\beta},\widehat{\mathbf V}), y^{*}\sim\text{Bernoulli}(\operatorname{expit}(\mathbf x^{\top}\boldsymbol\beta^{*})); ML başarısızsa hafif L2 cezalı kestirim kullanılır ve ayar bloğuna yazılır (:265–292). polyreg: scikit-learn LogisticRegression(C = 1e4) olasılıklarından çekiliş; parametre çekilişi yoktur (:295–307).
Kısıtlar, pasif atama ve Bayesçi ridge
Kısıtlar (min/maks, yuvarlama) her güncellemeden hemen sonra uygulanır (mice post = ve squeeze(); apply_constraints, :310–320). Pasif atanan sütun modelle atanmaz; her döngüde ifadeden yeniden hesaplanır ve bileşenleri atanırken yordayıcı olarak kullanılmaz (:330–399). "IterativeImputer + BayesianRidge" seçilirse scikit-learn IterativeImputer(BayesianRidge(), sample_posterior=True, random_state = tohum + l − 1) kullanılır (multiple_imputation.py:692–711); yalnız sayısal değişken kabul eder ve mice ile sayısal olarak karşılaştırılabilir değildir.
120.5.4 Analiz ve Rubin kuralları
Her tamamlanmış veri setinde l=1,\dots,m için analiz modeli kestirilir: OLS smf.ols, lojistik ve Poisson smf.glm (:605–610). Her parametre için \hat Q_l ve U_l=\SH_l^2 saklanır. Havuzlama parametre başına ayrı yapılır:
- \bar Q: havuzlanmış kestirim; atamaların ortalaması.
- \bar U: atama içi (within) varyans; eksik veri olmasaydı da var olacak örnekleme varyansı.
- B: atamalar arası (between) varyans; eksik verinin bilinmemesinden gelen ek belirsizlik.
- T: toplam varyans; \SH=\sqrt T (
multiple_imputation.py:756–760).
Neden (1+1/m)?
\bar Q, sonsuz sayıda atamanın ortalaması yerine yalnız m atamanın ortalamasıdır; bu sonlu ortalamanın kendisi de B/m kadar değişkendir. Toplam: \bar U+B+B/m. m=5'te B 1,2 ile çarpılır; m=20'de 1,05 ile.
- r: varyansta göreli artış (RIV); eksiklik yüzünden varyansın yüzde kaç arttığı. Kodda
relative_increase(:755). - \lambda: toplam varyansın eksiklikten gelen payı. MerQur'un ana tablosunda bu ölçü "λ" adıyla verilir; FMI adı yalnız \gamma'ya aittir.
- \nu_{\text{eski}}: Rubin'in (1987) büyük örneklem sd'si; \nu_{\text{com}}\to\infty varsayar.
- \nu_{\text{com}}=n-k: veri eksiksiz olsaydı analiz modelinin artık sd'si; n toplam satır (150), k parametre sayısı (
:762–763; miceget.dfcom). - \nu_{\text{göz}}: gözlenen veri sd'si; \nu_{\text{com}}'u kayıp bilgi kadar küçültür.
- \nu: Barnard–Rubin (1999) küçük örneklem sd'si; her zaman \nu\le\nu_{\text{com}} olur (
pool_rubin,mi_tools.py:185–206).
Neden Barnard–Rubin düzeltmesi?
\nu_{\text{eski}} küçük kayıplarda (\lambda\to0) sonsuza gider; tam veride sd yalnız \nu_{\text{com}}=146 iken MI sd'si 28614 çıkabilir (Tıp örneğinde age). Bu, tam veri analizinden daha kesin bir t dağılımı demektir ve anlamsızdır. Barnard–Rubin formülü iki sd'nin "harmonik" birleşimidir; küçük \lambda'da \nu_{\text{göz}}'e, büyük \lambda'da \nu_{\text{eski}}'ye yaklaşır.
- \gamma: kayıp bilgi oranı (FMI); mice
pool()'unfmisütunu. MerQur'un ikinci tablosundaki "FMI" budur; uyarılar ve yorum ölçeği bunu kullanır. - t, p ve GA her iki tabloda da \nu ile hesaplanır (
:763–776). - RE: sonsuz atamaya göre göreli etkinlik (Rubin 1987); m=5, \gamma=0{,}38 ise 0,930.
- B=0 olursa (eksik yoksa) \nu sayısal olarak tanımsız kalabilir; kod bu durumda normal kuantile düşer (
:768–772).
İki farklı "FMI"
Ana tablodaki "λ" sütunu \lambda=(1+1/m)B/T'dir; ikinci tablodaki FMI \gamma'dır (Rubin 1987; Barnard ve Rubin 1999). Uyarılar ("En büyük FMI > 0,30" ve "> 0,50") ile yorum ölçeği \gamma'yı ve aynı eşik tablosunu (0,10; 0,30; 0,50) kullanır. Tıp örneğinde BMI için \lambda=0{,}331, \gamma=0{,}376'dır. Rapor yazarken hangisinin verildiği belirtilmelidir; mice'ın "fraction of missing information" değeri \gamma'dır.
120.5.5 Havuzlanmış R^2 ve D1 testi
- Harel (2009) yöntemi; mice
pool.r.squared(_pool_r2,:953–969). Yalnız OLS'de. - T_z=U+(1+1/m)B_z; \nu_{\text{com}}=\infty alınır ve GA normal kuantille (1,96) kurulur; seçilen güven düzeyi buraya yansımaz.
- \bar{\mathbf Q},\bar{\mathbf U},\mathbf B: sabit hariç tüm eğimlerin vektör ve matris karşılıkları; k eğim sayısı (
_d1_test,:972–1010). - Test "tüm eğimler = 0"dır; D_1\sim F(k,\ \nu_1), \nu_1 Reiter (2007) küçük örneklem sd'si (t=k(m-1); t=2 ya da 4'te Li, Raghunathan ve Rubin 1991 formülüne düşülür). mice
D1(fit, fit0)ile aynıdır. - t=k(m-1)\le4 ise çıktıda kararsızlık notu yazılır.
120.5.6 Liste bazında karşılaştırma
Aynı analiz modeli, bağımlı ve bağımsız değişkenleri tam olan satırlarla bir kez kestirilir (:801–813). Bu tablo yalnız karşılaştırma içindir; havuzlanmış sonuçla arasındaki büyük fark, eksikliğin MCAR olmadığına ya da atama modelinin yetersiz olduğuna işaret edebilir.
120.5.7 MNAR δ duyarlılığı ve monoton atama
MNAR δ. Seçilen değişkenin atanan değerlerine her FCS güncellemesinde δ eklenir; kaydırılmış değerler sonraki değişkenlerin atanmasında kullanılır (mice post). Her δ için aynı tohumlarla m atama yeniden yapılır ve Rubin havuzlaması tekrarlanır (:870–896). δ = 0 satırları ana sonuçla aynıdır. Sonucun hangi δ'da değiştiği (devrilme noktası), MAR'dan ne kadar sapmaya dayanıklı olduğunu gösterir.
Monoton atama. Değişkenler eksik sayısına göre sıralanır; her değişken yalnız kendisinden önceki değişkenlerle tek geçişte atanır (monotone_impute, mi_tools.py:420–455). Örüntü monoton değilse hata verir. Tıp örneğinde örüntü monoton değildir (BMI eksikken HbA1c gözlenen ve tersi satırlar var).
120.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/multiple_imputation/elle_hesap.py ile, MerQur çağrılmadan numpy ile hesaplanmıştır. Atama adımı ayrı bir uygulamayla, MerQur'la aynı rastgele sayı akışı (SeedSequence(42).spawn(5), aynı çekiliş sırası) kullanılarak yeniden üretilmiştir; 5 tamamlanmış veri setinin her hücresi MerQur'unkiyle birebir aynıdır.
Adım 1 — Little MCAR testi. EM 26 yinelemede yakınsar: \hat{\boldsymbol\mu}=(128{,}1333;\ 54{,}4333;\ 27{,}0505;\ 6{,}4090) (sistolik, yaş, BMI, HbA1c). Dört örüntüyle d^2=8{,}323337; örüntülerde gözlenen değişken sayıları 4, 3, 3 ve 2 olduğundan \sum_sp_s=12 ve sd =12-4=8; p=0{,}402540. MCAR reddedilmez; bu MAR'ı kanıtlamaz.
Adım 2 — Başlangıç ve ilk döngü (atama 1, tohum 42). Başlangıçta 36 eksik BMI, 114 gözlenen BMI'dan rastgele çekilir (ilk üçü 31,70; 29,48; 24,91). İlk döngüde BMI için atama modeli \text{BMI}\sim1+\text{sistolik}+\text{yaş}+\text{HbA1c}, n_o=114:
\chi^2_{110} çekilişiyle \sigma^{*}=4{,}918637; çekilen \boldsymbol\beta^{*}=(25{,}878553;\ 0{,}008437;\ -0{,}007074;\ 0{,}095978).
Adım 3 — PMM örneği. İlk eksik BMI 3 numaralı hastadadır (sistolik 129, yaş 71, HbA1c 5,66):
En yakın 5 gözlenen hastanın \mathbf x^{\top}\hat{\boldsymbol\beta} değerleri ve gözlenen BMI'ları:
| Aday | \hat y^{\text{gözlenen}} | Gözlenen BMI |
|---|---|---|
| 1 | 27,007021 | 27,95 |
| 2 | 27,009835 | 19,05 |
| 3 | 27,010426 | 28,02 |
| 4 | 27,004132 | 25,14 |
| 5 | 27,021913 | 18,94 |
Rastgele seçilen aday 4'tür; atanan BMI 25,14'tür. Öngörüler birbirine çok yakın olduğu için (yaş ve HbA1c BMI'yı zayıf açıklar) seçim büyük ölçüde rastgeledir; atanan değerler BMI'nın gözlenen dağılımından gelir. Aynı döngüde HbA1c, güncellenmiş BMI ile atanır (n_o=123, \sigma^{*}=1{,}466911). Bu işlem 10 döngü sürer.
Adım 4 — Beş analiz. Her tamamlanmış veride OLS:
| l | Sabit | age | BMI | HbA1c | SH(BMI) | R^2 |
|---|---|---|---|---|---|---|
| 1 | 119,297559 | 0,045443 | 0,350434 | −0,480226 | 0,390800 | 0,008695 |
| 2 | 120,932506 | 0,045375 | 0,352510 | −0,761774 | 0,362028 | 0,011854 |
| 3 | 101,323063 | 0,063078 | 0,884779 | −0,064610 | 0,374105 | 0,039975 |
| 4 | 111,901274 | 0,071550 | 0,359281 | 0,410976 | 0,382239 | 0,008474 |
| 5 | 118,608341 | 0,054471 | 0,293327 | −0,212896 | 0,402992 | 0,005930 |
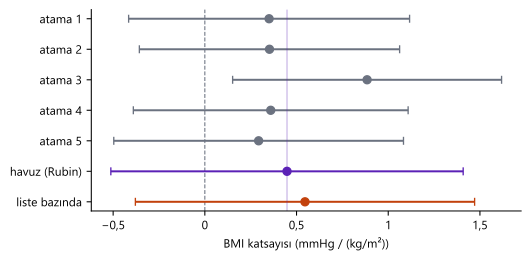
BMI katsayısı atamadan atamaya 0,29 ile 0,88 arasında değişir; SH'ler ise 0,36–0,40'ta sabittir. Bu, B'nin \bar U'ya göre büyük olacağını gösterir.
Adım 5 — Rubin kuralları, BMI. m=5, \nu_{\text{com}}=150-4=146.
t_{0{,}975;\,26{,}515}=2{,}053588; GA 0{,}448066\pm2{,}053588\times0{,}467774=[-0{,}512550;\ 1{,}408682]. RE =1/(1+0{,}376058/5)=0{,}930050.
Adım 6 — Tüm parametreler.
| Parametre | \bar Q | \bar U | B | SH | \lambda | \nu | \gamma | p | %95 GA |
|---|---|---|---|---|---|---|---|---|---|
| Sabit | 114,412549 | 228,397559 | 65,404748 | 17,518084 | 0,255751 | 38,940292 | 0,291242 | 9,56·10⁻⁸ | [78,977143; 149,847955] |
| age | 0,055984 | 0,013003 | 0,000130 | 0,114709 | 0,011823 | 141,632702 | 0,025488 | 0,626270 | [−0,170780; 0,282747] |
| BMI | 0,448066 | 0,146450 | 0,060302 | 0,467774 | 0,330705 | 26,515121 | 0,376058 | 0,346782 | [−0,512550; 1,408682] |
| HbA1c | −0,221706 | 1,088597 | 0,195887 | 1,150505 | 0,177587 | 61,252408 | 0,203186 | 0,847829 | [−2,522091; 2,078679] |
age tam gözlenmiştir ama \lambda=0{,}012'dir: öteki yordayıcıların atanmasıyla yaş katsayısı da az miktarda değişir. age için \nu_{\text{eski}}=28614 iken Barnard–Rubin \nu=141{,}63 verir; \nu_{\text{com}}=146'yı aşmaz.
Adım 7 — Havuzlanmış R^2 ve D1. R^2_{\text{havuz}}=0{,}013108 (%95 GA [0,006284; 0,089948]; FMI 0,339447). D1: r_1=0{,}234956, F(3,\ 75{,}18)=0{,}471055, p=0{,}703358. Model kan basıncını açıklamaz.
Adım 8 — Liste bazında silmeyle karşılaştırma (n=97):
| Parametre | Liste bazında b | SH | MI \bar Q | MI SH |
|---|---|---|---|---|
| Sabit | 103,258726 | 18,529909 | 114,412549 | 17,518084 |
| age | 0,124610 | 0,137864 | 0,055984 | 0,114709 |
| BMI | 0,546132 | 0,465759 | 0,448066 | 0,467774 |
| HbA1c | 0,261952 | 1,326510 | −0,221706 | 1,150505 |
MI, eksiksiz satırları atmadığı için age SH'sini 0,138'den 0,115'e indirir. HbA1c katsayısının işareti değişir; ama iki yöntemde de katsayı SH'sinin altındadır ve sıfırdan ayırt edilemez.
Adım 9 — Seçeneklerin etkisi (BMI satırı).
| Çalıştırma | \bar Q | SH | \nu | \gamma |
|---|---|---|---|---|
| PMM, m=5 (ana) | 0,4481 | 0,4678 | 26,52 | 0,3761 |
| norm, m=5 | 0,4032 | 0,4267 | 50,78 | 0,2384 |
PMM + yardımcı cholesterol |
0,3632 | 0,4192 | 50,61 | 0,2390 |
| PMM, m=20 | 0,4539 | 0,4218 | 95,49 | 0,2065 |
| MNAR δ = −2 (BMI) | 0,2851 | 0,4774 | 23,10 | — |
m=5'te B beş noktadan kestirildiği için \gamma ve \nu kararsızdır; m=20'de \gamma 0,21'e iner ve \nu 95'e çıkar. Bu, \gamma\approx0{,}4 düzeyinde m\ge20 önerisiyle uyumludur (Graham, Olchowski ve Gilreath 2007).
Şekil 120.1. BMI katsayısı: beş atamanın her birindeki kestirim (±1,96·√U), Rubin havuzu ve liste bazında silme (%95 GA; Tıp #54).
120.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan alınmıştır; modül round ve p_yuvarla adları yalnız bellekte etkisizleştirilerek tam hassasiyet sağlanmıştır. Atamalar rastgele olduğu için doğrulama iki katmanlıdır. (1) Atama: bağımsız Python uygulaması aynı tohumlarla aynı tamamlanmış verileri üretir (en büyük fark 0; norm'da 7\cdot10^{-15}). (2) Havuzlama: R 4.5.3, mice 3.19.0; MerQur'un yazdığı uzun biçimli tamamlanmış veri as.mids() ile okunmuş, with(imp, lm(…)), pool(), summary(…, conf.int = TRUE), pool.r.squared() ve D1(fit, fit0) çalıştırılmıştır. Little MCAR testinin R karşılığı norm 1.0-11.1 paketinin em.norm ML kestirimleriyle tanımdan hesaplanmıştır (R'de kurulu MCAR paketi yoktur). mice'ın kendi atamaları, rastgele sayı üreteci farklı olduğundan MerQur'la sayısal olarak karşılaştırılmamıştır.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Atanan değerler: en büyük fark (5 veri seti) | 0,000000 | 0,000000 | — | 0,0e+00 | ✓ |
| \bar Q Sabit | 114,412549 | 114,412549 | 114,412549 | 8,2e−13 | ✓ |
| \bar U Sabit | 228,397559 | 228,397559 | 228,397559 | 1,1e−11 | ✓ |
| B Sabit | 65,404748 | 65,404748 | 65,404748 | 1,1e−11 | ✓ |
| T Sabit | 306,883256 | 306,883256 | 306,883256 | 2,4e−11 | ✓ |
| SH \sqrt T Sabit | 17,518084 | 17,518084 | 17,518084 | 6,6e−13 | ✓ |
| t Sabit | 6,531111 | 6,531111 | 6,531111 | 2,2e−13 | ✓ |
| \lambda Sabit | 0,255751 | 0,255751 | 0,255751 | 2,2e−14 | ✓ |
| RIV r Sabit | 0,343636 | 0,343636 | 0,343636 | 3,8e−14 | ✓ |
| sd \nu (Barnard–Rubin) Sabit | 38,940292 | 38,940292 | 38,940292 | 4,5e−12 | ✓ |
| p Sabit | 9,5597·10−8 | 9,5597·10−8 | 9,5597·10−8 | 1,2e−19 | ✓ |
| p (ana tablo) Sabit | 9,5597·10−8 | 9,5597·10−8 | 9,5597·10−8 | 1,2e−19 | ✓ |
| GA alt Sabit | 78,977143 | 78,977143 | 78,977143 | 8,8e−13 | ✓ |
| GA üst Sabit | 149,847955 | 149,847955 | 149,847955 | 2,0e−12 | ✓ |
| FMI \gamma Sabit | 0,291242 | 0,291242 | 0,291242 | 2,4e−14 | ✓ |
| RE Sabit | 0,944958 | 0,944958 | — | 3,8e−15 | ✓ |
| \bar Q age | 0,055984 | 0,055984 | 0,055984 | 2,2e−15 | ✓ |
| \bar U age | 0,013003 | 0,013003 | 0,013003 | 5,9e−17 | ✓ |
| B age | 0,000130 | 0,000130 | 0,000130 | 8,1e−17 | ✓ |
| T age | 0,013158 | 0,013158 | 0,013158 | 1,3e−16 | ✓ |
| SH \sqrt T age | 0,114709 | 0,114709 | 0,114709 | 8,0e−16 | ✓ |
| t age | 0,488049 | 0,488049 | 0,488049 | 1,8e−14 | ✓ |
| \lambda age | 0,011823 | 0,011823 | 0,011823 | 7,3e−15 | ✓ |
| RIV r age | 0,011965 | 0,011965 | 0,011965 | 7,5e−15 | ✓ |
| sd \nu (Barnard–Rubin) age | 141,632702 | 141,632702 | 141,632702 | 1,8e−12 | ✓ |
| p age | 0,626270 | 0,626270 | 0,626270 | 1,3e−14 | ✓ |
| p (ana tablo) age | 0,626270 | 0,626270 | 0,626270 | 1,3e−14 | ✓ |
| GA alt age | −0,170780 | −0,170780 | −0,170780 | 1,5e−12 | ✓ |
| GA üst age | 0,282747 | 0,282747 | 0,282747 | 1,5e−12 | ✓ |
| FMI \gamma age | 0,025488 | 0,025488 | 0,025488 | 7,4e−15 | ✓ |
| RE age | 0,994928 | 0,994928 | — | 1,3e−15 | ✓ |
| \bar Q BMI | 0,448066 | 0,448066 | 0,448066 | 8,2e−14 | ✓ |
| \bar U BMI | 0,146450 | 0,146450 | 0,146450 | 1,1e−14 | ✓ |
| B BMI | 0,060302 | 0,060302 | 0,060302 | 2,5e−14 | ✓ |
| T BMI | 0,218813 | 0,218813 | 0,218813 | 4,0e−14 | ✓ |
| SH \sqrt T BMI | 0,467774 | 0,467774 | 0,467774 | 4,3e−14 | ✓ |
| t BMI | 0,957868 | 0,957868 | 0,957868 | 2,6e−13 | ✓ |
| \lambda BMI | 0,330705 | 0,330705 | 0,330705 | 7,4e−14 | ✓ |
| RIV r BMI | 0,494110 | 0,494110 | 0,494110 | 1,7e−13 | ✓ |
| sd \nu (Barnard–Rubin) BMI | 26,515121 | 26,515121 | 26,515121 | 9,4e−12 | ✓ |
| p BMI | 0,346782 | 0,346782 | 0,346782 | 1,3e−13 | ✓ |
| p (ana tablo) BMI | 0,346782 | 0,346782 | 0,346782 | 1,3e−13 | ✓ |
| GA alt BMI | −0,512550 | −0,512550 | −0,512550 | 1,9e−13 | ✓ |
| GA üst BMI | 1,408682 | 1,408682 | 1,408682 | 2,3e−14 | ✓ |
| FMI \gamma BMI | 0,376058 | 0,376058 | 0,376058 | 8,3e−14 | ✓ |
| RE BMI | 0,930050 | 0,930050 | — | 1,5e−14 | ✓ |
| \bar Q HbA1c | −0,221706 | −0,221706 | −0,221706 | 5,0e−14 | ✓ |
| \bar U HbA1c | 1,088597 | 1,088597 | 1,088597 | 1,2e−14 | ✓ |
| B HbA1c | 0,195887 | 0,195887 | 0,195887 | 2,3e−14 | ✓ |
| T HbA1c | 1,323662 | 1,323662 | 1,323662 | 3,4e−14 | ✓ |
| SH \sqrt T HbA1c | 1,150505 | 1,150505 | 1,150505 | 1,5e−14 | ✓ |
| t HbA1c | −0,192703 | −0,192703 | −0,192703 | 4,1e−14 | ✓ |
| \lambda HbA1c | 0,177587 | 0,177587 | 0,177587 | 1,6e−14 | ✓ |
| RIV r HbA1c | 0,215934 | 0,215934 | 0,215934 | 2,4e−14 | ✓ |
| sd \nu (Barnard–Rubin) HbA1c | 61,252408 | 61,252408 | 61,252408 | 6,1e−12 | ✓ |
| p HbA1c | 0,847829 | 0,847829 | 0,847829 | 3,2e−14 | ✓ |
| p (ana tablo) HbA1c | 0,847829 | 0,847829 | 0,847829 | 3,2e−14 | ✓ |
| GA alt HbA1c | −2,522091 | −2,522091 | −2,522091 | 8,5e−14 | ✓ |
| GA üst HbA1c | 2,078679 | 2,078679 | 2,078679 | 1,6e−14 | ✓ |
| FMI \gamma HbA1c | 0,203186 | 0,203186 | 0,203186 | 1,8e−14 | ✓ |
| RE HbA1c | 0,960950 | 0,960950 | — | 3,4e−15 | ✓ |
| Havuzlanmış R^2 | 0,013108 | 0,013108 | 0,013108 | 6,2e−17 | ✓ |
| R^2 GA alt | 0,006284 | 0,006284 | 0,006284 | 2,2e−17 | ✓ |
| R^2 GA üst | 0,089948 | 0,089948 | 0,089948 | 1,9e−16 | ✓ |
| R^2 FMI | 0,339447 | 0,339447 | 0,339447 | 1,0e−15 | ✓ |
| D1 F | 0,471055 | 0,471055 | 0,471055 | 2,0e−13 | ✓ |
| D1 payda sd | 75,178096 | 75,178096 | 75,178096 | 1,1e−11 | ✓ |
| D1 p | 0,703358 | 0,703358 | 0,703358 | 1,4e−13 | ✓ |
| D1 RIV | 0,234956 | 0,234956 | 0,234956 | 4,7e−14 | ✓ |
| Liste bazında b Sabit | 103,258726 | 103,258726 | 103,258726 | 3,1e−12 | ✓ |
| Liste bazında SH Sabit | 18,529909 | 18,529909 | 18,529909 | 5,2e−13 | ✓ |
| Liste bazında b age | 0,124610 | 0,124610 | 0,124610 | 7,0e−15 | ✓ |
| Liste bazında SH age | 0,137864 | 0,137864 | 0,137864 | 2,5e−16 | ✓ |
| Liste bazında b BMI | 0,546132 | 0,546132 | 0,546132 | 7,3e−14 | ✓ |
| Liste bazında SH BMI | 0,465759 | 0,465759 | 0,465759 | 1,6e−14 | ✓ |
| Liste bazında b HbA1c | 0,261952 | 0,261952 | 0,261952 | 5,9e−14 | ✓ |
| Liste bazında SH HbA1c | 1,326510 | 1,326510 | 1,326510 | 6,9e−15 | ✓ |
| Little MCAR d^2 | 8,323337 | 8,323337 | 8,323337 | 2,3e−13 | ✓ |
| Little MCAR sd | 8 | 8 | 8 | 0,0e+00 | ✓ |
| Little MCAR p | 0,402540 | 0,402540 | 0,402540 | 2,1e−14 | ✓ |
Ek çalıştırmalar:
FCS-norm (Bayesçi doğrusal regresyon çekilişi)
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Atanan değerler: en büyük fark (10−10 ondalıkta) | 0,000000 | 0,000000 | — | 0,0e+00 | ✓ |
| \bar Q Sabit | 120,091174 | 120,091174 | 120,091174 | 2,8e−12 | ✓ |
| \bar U Sabit | 224,484682 | 224,484682 | 224,484682 | 9,7e−12 | ✓ |
| B Sabit | 21,981879 | 21,981879 | 21,981879 | 6,6e−12 | ✓ |
| T Sabit | 250,862937 | 250,862937 | 250,862937 | 1,7e−11 | ✓ |
| SH \sqrt T Sabit | 15,838653 | 15,838653 | 15,838653 | 5,7e−13 | ✓ |
| \bar Q age | 0,039656 | 0,039656 | 0,039656 | 6,8e−15 | ✓ |
| \bar U age | 0,013007 | 0,013007 | 0,013007 | 3,6e−17 | ✓ |
| B age | 2,3386·10−5 | 2,3386·10−5 | 2,3386·10−5 | 3,1e−17 | ✓ |
| T age | 0,013035 | 0,013035 | 0,013035 | 2,1e−17 | ✓ |
| SH \sqrt T age | 0,114171 | 0,114171 | 0,114171 | 2,9e−16 | ✓ |
| \bar Q BMI | 0,403156 | 0,403156 | 0,403156 | 9,9e−14 | ✓ |
| \bar U BMI | 0,144028 | 0,144028 | 0,144028 | 1,0e−14 | ✓ |
| B BMI | 0,031707 | 0,031707 | 0,031707 | 3,1e−15 | ✓ |
| T BMI | 0,182077 | 0,182077 | 0,182077 | 1,3e−14 | ✓ |
| SH \sqrt T BMI | 0,426704 | 0,426704 | 0,426704 | 1,6e−14 | ✓ |
| \bar Q HbA1c | −0,782229 | −0,782229 | −0,782229 | 4,5e−14 | ✓ |
| \bar U HbA1c | 1,101249 | 1,101249 | 1,101249 | 1,0e−14 | ✓ |
| B HbA1c | 0,018244 | 0,018244 | 0,018244 | 1,0e−14 | ✓ |
| T HbA1c | 1,123141 | 1,123141 | 1,123141 | 2,2e−14 | ✓ |
| SH \sqrt T HbA1c | 1,059784 | 1,059784 | 1,059784 | 1,0e−14 | ✓ |
| sd \nu Sabit | 95,035156 | 95,035156 | 95,035156 | 1,3e−11 | ✓ |
| sd \nu age | 143,706227 | 143,706227 | 143,706227 | 4,8e−13 | ✓ |
| sd \nu BMI | 50,777861 | 50,777861 | 50,777861 | 1,3e−12 | ✓ |
| sd \nu HbA1c | 139,363087 | 139,363087 | 139,363087 | 3,4e−12 | ✓ |
| FMI Sabit | 0,123406 | 0,123406 | 0,123406 | 2,7e−14 | ✓ |
| FMI age | 0,015756 | 0,015756 | 0,015756 | 2,9e−15 | ✓ |
| FMI BMI | 0,238388 | 0,238388 | 0,238388 | 5,1e−15 | ✓ |
| FMI HbA1c | 0,033267 | 0,033267 | 0,033267 | 1,1e−14 | ✓ |
| Havuzlanmış R^2 | 0,014712 | 0,014712 | 0,014712 | 1,5e−16 | ✓ |
| R^2 GA alt | 0,002557 | 0,002557 | 0,002557 | 8,8e−17 | ✓ |
| R^2 GA üst | 0,081895 | 0,081895 | 0,081895 | 1,9e−16 | ✓ |
| R^2 FMI | 0,128210 | 0,128210 | 0,128210 | 2,8e−15 | ✓ |
| D1 F | 0,637445 | 0,637445 | 0,637445 | 2,4e−13 | ✓ |
| D1 payda sd | 119,200742 | 119,200742 | 119,200742 | 1,2e−12 | ✓ |
| D1 p | 0,592340 | 0,592340 | 0,592340 | 1,5e−13 | ✓ |
| D1 RIV | 0,097035 | 0,097035 | 0,097035 | 3,1e−15 | ✓ |
Yardımcı değişken: cholesterol (atama modelinde, analiz modelinde değil)
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Atanan değerler: en büyük fark (10−10 ondalıkta) | 0,000000 | 0,000000 | — | 0,0e+00 | ✓ |
| \bar Q Sabit | 118,137978 | 118,137978 | 118,137978 | 3,1e−12 | ✓ |
| \bar U Sabit | 217,498896 | 217,498896 | 217,498896 | 1,1e−11 | ✓ |
| B Sabit | 27,343199 | 27,343199 | 27,343199 | 6,2e−12 | ✓ |
| T Sabit | 250,310734 | 250,310734 | 250,310734 | 1,8e−11 | ✓ |
| SH \sqrt T Sabit | 15,821212 | 15,821212 | 15,821212 | 6,3e−13 | ✓ |
| \bar Q age | 0,050847 | 0,050847 | 0,050847 | 1,8e−15 | ✓ |
| \bar U age | 0,013025 | 0,013025 | 0,013025 | 5,2e−17 | ✓ |
| B age | 2,5807·10−5 | 2,5807·10−5 | 2,5807·10−5 | 1,5e−17 | ✓ |
| T age | 0,013056 | 0,013056 | 0,013056 | 7,6e−17 | ✓ |
| SH \sqrt T age | 0,114265 | 0,114265 | 0,114265 | 2,9e−16 | ✓ |
| \bar Q BMI | 0,363160 | 0,363160 | 0,363160 | 1,0e−13 | ✓ |
| \bar U BMI | 0,138891 | 0,138891 | 0,138891 | 9,8e−15 | ✓ |
| B BMI | 0,030678 | 0,030678 | 0,030678 | 1,1e−14 | ✓ |
| T BMI | 0,175705 | 0,175705 | 0,175705 | 2,3e−14 | ✓ |
| SH \sqrt T BMI | 0,419171 | 0,419171 | 0,419171 | 2,7e−14 | ✓ |
| \bar Q HbA1c | −0,402992 | −0,402992 | −0,402992 | 2,9e−14 | ✓ |
| \bar U HbA1c | 1,090372 | 1,090372 | 1,090372 | 6,0e−15 | ✓ |
| B HbA1c | 0,060549 | 0,060549 | 0,060549 | 8,3e−15 | ✓ |
| T HbA1c | 1,163031 | 1,163031 | 1,163031 | 6,9e−15 | ✓ |
| SH \sqrt T HbA1c | 1,078439 | 1,078439 | 1,078439 | 4,9e−15 | ✓ |
| sd \nu Sabit | 81,395913 | 81,395913 | 81,395913 | 1,0e−11 | ✓ |
| sd \nu age | 143,669581 | 143,669581 | 143,669581 | 3,4e−13 | ✓ |
| sd \nu BMI | 50,614148 | 50,614148 | 50,614148 | 1,4e−11 | ✓ |
| sd \nu HbA1c | 119,319104 | 119,319104 | 119,319104 | 4,9e−12 | ✓ |
| FMI Sabit | 0,151676 | 0,151676 | 0,151676 | 2,2e−14 | ✓ |
| FMI age | 0,015976 | 0,015976 | 0,015976 | 1,3e−15 | ✓ |
| FMI BMI | 0,239008 | 0,239008 | 0,239008 | 5,1e−14 | ✓ |
| FMI HbA1c | 0,077803 | 0,077803 | 0,077803 | 8,6e−15 | ✓ |
| Havuzlanmış R^2 | 0,010313 | 0,010313 | 0,010313 | 1,4e−16 | ✓ |
| R^2 GA alt | 0,005526 | 0,005526 | 0,005526 | 1,2e−16 | ✓ |
| R^2 GA üst | 0,073610 | 0,073610 | 0,073610 | 5,1e−16 | ✓ |
| R^2 FMI | 0,170471 | 0,170471 | 0,170471 | 3,6e−15 | ✓ |
| D1 F | 0,424798 | 0,424798 | 0,424798 | 2,1e−13 | ✓ |
| D1 payda sd | 114,007781 | 114,007781 | 114,007781 | 1,0e−11 | ✓ |
| D1 p | 0,735589 | 0,735589 | 0,735589 | 1,5e−13 | ✓ |
| D1 RIV | 0,110798 | 0,110798 | 0,110798 | 2,8e−14 | ✓ |
m = 20
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Atanan değerler: en büyük fark (10−10 ondalıkta) | 0,000000 | 0,000000 | — | 0,0e+00 | ✓ |
| \bar Q Sabit | 114,002812 | 114,002812 | 114,002812 | 1,7e−12 | ✓ |
| \bar U Sabit | 229,864300 | 229,864300 | 229,864300 | 1,3e−11 | ✓ |
| B Sabit | 29,983230 | 29,983230 | 29,983230 | 4,7e−13 | ✓ |
| T Sabit | 261,346692 | 261,346692 | 261,346692 | 1,2e−11 | ✓ |
| SH \sqrt T Sabit | 16,166221 | 16,166221 | 16,166221 | 3,8e−13 | ✓ |
| \bar Q age | 0,057976 | 0,057976 | 0,057976 | 3,5e−15 | ✓ |
| \bar U age | 0,013047 | 0,013047 | 0,013047 | 4,9e−17 | ✓ |
| B age | 0,000143 | 0,000143 | 0,000143 | 7,5e−17 | ✓ |
| T age | 0,013196 | 0,013196 | 0,013196 | 3,1e−17 | ✓ |
| SH \sqrt T age | 0,114876 | 0,114876 | 0,114876 | 2,2e−16 | ✓ |
| \bar Q BMI | 0,453861 | 0,453861 | 0,453861 | 8,2e−14 | ✓ |
| \bar U BMI | 0,144074 | 0,144074 | 0,144074 | 1,1e−14 | ✓ |
| B BMI | 0,032194 | 0,032194 | 0,032194 | 1,0e−14 | ✓ |
| T BMI | 0,177877 | 0,177877 | 0,177877 | 2,1e−14 | ✓ |
| SH \sqrt T BMI | 0,421755 | 0,421755 | 0,421755 | 2,6e−14 | ✓ |
| \bar Q HbA1c | −0,203088 | −0,203088 | −0,203088 | 2,1e−14 | ✓ |
| \bar U HbA1c | 1,061389 | 1,061389 | 1,061389 | 2,4e−15 | ✓ |
| B HbA1c | 0,142879 | 0,142879 | 0,142879 | 2,4e−14 | ✓ |
| T HbA1c | 1,211411 | 1,211411 | 1,211411 | 2,7e−14 | ✓ |
| SH \sqrt T HbA1c | 1,100641 | 1,100641 | 1,100641 | 1,2e−14 | ✓ |
| sd \nu Sabit | 115,512155 | 115,512155 | 115,512155 | 2,2e−12 | ✓ |
| sd \nu age | 142,269645 | 142,269645 | 142,269645 | 1,1e−12 | ✓ |
| sd \nu BMI | 95,491024 | 95,491024 | 95,491024 | 1,0e−11 | ✓ |
| sd \nu HbA1c | 114,534528 | 114,534528 | 114,534528 | 5,3e−12 | ✓ |
| FMI Sabit | 0,135305 | 0,135305 | 0,135305 | 7,7e−15 | ✓ |
| FMI age | 0,024952 | 0,024952 | 0,024952 | 5,9e−15 | ✓ |
| FMI BMI | 0,206487 | 0,206487 | 0,206487 | 3,8e−14 | ✓ |
| FMI HbA1c | 0,138750 | 0,138750 | 0,138750 | 1,8e−14 | ✓ |
| Havuzlanmış R^2 | 0,013545 | 0,013545 | 0,013545 | 1,2e−16 | ✓ |
| R^2 GA alt | 0,003744 | 0,003744 | 0,003744 | 7,3e−17 | ✓ |
| R^2 GA üst | 0,082259 | 0,082259 | 0,082259 | 2,5e−16 | ✓ |
| R^2 FMI | 0,179481 | 0,179481 | 0,179481 | 1,4e−15 | ✓ |
| D1 F | 0,533164 | 0,533164 | 0,533164 | 2,1e−13 | ✓ |
| D1 payda sd | 138,098726 | 138,098726 | 138,098726 | 1,1e−12 | ✓ |
| D1 p | 0,660289 | 0,660289 | 0,660289 | 1,5e−13 | ✓ |
| D1 RIV | 0,128060 | 0,128060 | 0,128060 | 1,2e−14 | ✓ |
Tekrarlanabilirlik: aynı tohum (42)
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Aynı tohumla 2. çalıştırma \bar Q Sabit | 114,412549 | 114,412549 | — | 0,0e+00 | ✓ |
| Aynı tohumla 2. çalıştırma \bar Q age | 0,055984 | 0,055984 | — | 0,0e+00 | ✓ |
| Aynı tohumla 2. çalıştırma \bar Q BMI | 0,448066 | 0,448066 | — | 0,0e+00 | ✓ |
| Aynı tohumla 2. çalıştırma \bar Q HbA1c | −0,221706 | −0,221706 | — | 0,0e+00 | ✓ |
195 değerin tamamı 10^{-6} ölçütüyle eşleşir. MNAR çalıştırmasının δ = 0 satırları ana sonuçla birebir aynıdır.
120.7 Çıktıyı okuma
Sonuç metni (varsayılan çalıştırma; kısaltılmış):
══ ÇOKLU ATAMA ══
Bağımlı değişken : systolic_bp
Bağımsız değişken: age, BMI, HbA1c
Toplam satır     : 150
Eksiksiz satır   : 97
m (atama)        : 5
En çok yineleme  : 10
Tohum            : 42

── EKSİK VERİ ──
  BMI                      :   36 (%24.00)
  HbA1c                    :   27 (%18.00)

── HAVUZLANMIŞ KESTİRİMLER (Rubin kuralları) ──
Parametre                Havuz β   Havuz SE        t         p                %95 GA       λ
Sabit                   114.4125    17.5181    6.531   <0.0001     (78.977, 149.848)   0.256 ★
age                       0.0560     0.1147    0.488    0.6263       (-0.171, 0.283)   0.012
BMI                       0.4481     0.4678    0.958    0.3468       (-0.513, 1.409)   0.331
HbA1c                    -0.2217     1.1505   -0.193    0.8478       (-2.522, 2.079)   0.178

── HAVUZLANMIŞ t TESTLERİ (Rubin kuralları) ──
Parametre                     t        df     p (t)     FMI
Sabit                     6.531     38.94   <0.0001   0.291
age                       0.488    141.63    0.6263   0.025
BMI                       0.958     26.52    0.3468   0.376
HbA1c                    -0.193     61.25    0.8478   0.203
Göreli etkinlik RE = 1/(1 + FMI/m): Sabit 0.9450, age 0.9949, BMI 0.9300, HbA1c 0.9609
Havuzlanmış R² (Harel 2009) = 0.0131  %95 GA [0.0063, 0.0899]  FMI = 0.3394
Tüm eğimler = 0, D1 Wald testi: F(3, 75.18) = 0.4711, p = 0.7034  (RIV = 0.2350)

FCS değişken başına yöntem: BMI: pmm, HbA1c: pmm
Little MCAR testi: χ² = 8.323, sd = 8, p = 0.4025 (4 eksiklik deseni; EM ML kestirimleri)

══ UYARILAR ══
⚠ En büyük FMI = 0.376 > 0.30 — yüksek bilgi kaybı; m'yi artırın (m ≥ 10).
| Satır/Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Eksiksiz satır | Seçilen değişkenlerin hepsi gözlenen satır sayısı. | Liste bazında analizin n'i. |
| Havuz β, Havuz SE | \bar Q, \sqrt T. | Asıl sonuç. |
Ana tablo t |
\bar Q/\sqrt T, tam hassasiyetle hesaplanıp 3 ondalık basılır. | İkinci tablodaki t ile aynıdır. |
Ana tablo p, GA |
Barnard–Rubin \nu ile t tabanlı. | İkinci tablodakiyle aynıdır. |
| Ana tablo λ | \lambda=(1+1/m)B/T. | Toplam varyansın eksiklikten gelen payı; FMI değildir. |
| İkinci tablo df, FMI | \nu ve \gamma (mice pool). |
Raporda verilecek sd ve FMI; uyarı ve yorum ölçeği bunu kullanır. |
| RE | (1+\gamma/m)^{-1}. | 0,93: m=5 ile sonsuz atamaya göre %7 verim kaybı. |
| Havuzlanmış R², D1 | Harel R^2; tüm eğimlerin ortak testi. | Model genel olarak anlamsız. |
| Little MCAR | d^2, sd, p, örüntü sayısı. | p>0{,}05: MCAR reddedilmez; MAR kanıtı değildir. |
| Liste bazında tablo | Eksiksiz satırlarla OLS. | Karşılaştırma içindir. |
| "En büyük FMI" uyarısı | En büyük \gamma; > 0,30 yüksek, > 0,50 çok yüksek bilgi kaybı. | Eşikler yorum ölçeğiyle aynı tablodandır. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
BMI (%24) ve HbA1c (%18) değişkenlerindeki eksik değerler, sistolik kan basıncı ve yaşı da içeren zincirleme denklemlerle (tahmine dayalı ortalama eşleme, 10 döngü) m = 5 kez atandı; doğrusal regresyon sonuçları Rubin kurallarıyla, Barnard–Rubin serbestlik dereceleriyle birleştirildi (n = 150). Little testi MCAR varsayımını reddetmedi, \chi^2(8) = 8{,}32, p = 0{,}40. Yaş, BMI ve HbA1c sistolik kan basıncını birlikte açıklamadı, D_1: F(3,\ 75{,}18) = 0{,}47, p = 0{,}70, havuzlanmış R^2 = 0{,}01. BMI katsayısı 0,45 mmHg idi (%95 GA [−0,51; 1,41]; t(26{,}52) = 0{,}96; p = 0{,}35); kayıp bilgi oranı 0,38 olduğundan atama sayısının artırılması önerilir.
120.8 Uzman soruları
S1. Ana tablodaki λ ile FMI neden ayrı adlarla verilir?
Rubin (1987) ile Barnard ve Rubin (1999) iki ayrı nicelik tanımlar; birine ötekinin adını vermek okuru yanıltır. Ana tablo \lambda=(1+1/m)B/T'yi, ikinci tablo mice'ın \gamma=(r+2/(\nu+3))/(r+1)'ini yazar (mi_tools.py:198). \gamma, \nu'nun sonluluğunu hesaba katar ve her zaman \lambda'dan biraz büyüktür; fark \nu küçükken belirgindir (BMI: 0,331 ve 0,376). mice \gamma'yı "fraction missing information" olarak verir; MerQur'un uyarıları da \gamma ile tetiklenir.
S2. \nu_{\text{com}} neden n-k ve n neden toplam satır?
Barnard–Rubin formülü "veri eksiksiz olsaydı" sd'sini ister; atanmış veri seti 150 satırdır ve OLS'nin artık sd'si 150-4=146'dır. mice get.dfcom de ilk modelin df.residual'ını alır. Eksiksiz satır sayısını (97-4) kullanmak, MI'nın geri kazandığı bilgiyi yok saymak olurdu.
S3. Aynı tohumla R'deki mice aynı sayıları verir mi?
Hayır. MerQur mice'ın algoritmasını numpy ile yeniden uygular; R'nin Mersenne-Twister üreteci ve mice'ın çekiliş sırası farklıdır. Algoritma aynı olduğundan büyük m'de sonuçlar dağılım olarak aynı yere yakınsar, tek tek atanan değerler aynı olmaz. Bu bölümde havuzlama adımı R ile birebir, atama adımı ise bağımsız Python uygulamasıyla birebir doğrulanmıştır.
S4. Atamalar neden tek tohumdan türetilen alt akışlarla yapılır?
Atamaların bağımsız olması Rubin havuzlamasının varsayımıdır. Atama l'yi tohum +\,l-1 ile başlatmak, ardışık tohumlarla yapılan tekrarlarda ortak veri setleri üretirdi (tohum 42 ve 43'te m-1 ortak set); farklı tohumla tekrar yanıltıcı olurdu. MerQur bu yüzden tek tohumdan np.random.SeedSequence(tohum).spawn(m) ile m bağımsız alt akış türetir (numpy'nin paralel akışlar için önerdiği yöntem; R mice de tek tohumla tek akış kullanır). Ardışık tohumlar (42, 43) birbirinden bağımsız atama kümeleri verir.
S5. PMM ile norm neden farklı sonuç veriyor? Hangisi doğru?
İkisi de MAR altında geçerlidir; farklı varsayımlar yapar. norm, artıkların normal ve varyansın sabit olduğunu varsayar; değer gözlenen aralığın dışına düşebilir. PMM yalnız öngörü sıralamasını kullanır, atanan değer bir gözlenen komşudan alınır; çarpık dağılımlarda daha dayanıklıdır. Tıp örneğinde BMI zayıf açıklandığı için PMM komşuları geniş bir bölgeden seçer ve B büyür (\gamma 0,38 ve 0,24). Küçük örneklemde ve çok zayıf atama modelinde PMM'in 5 adaylık havuzu atamalar arası değişkenliği artırabilir.
S6. Analiz modelindeki etkileşim atama modeline neden girmiyor?
interactions yalnız analiz formülüne eklenir (:596–604); FCS her değişkeni öteki değişkenlerin doğrusal fonksiyonuyla atar. Analizde x_1\times x_2 varsa ve x_1 eksikse atanan x_1'ler etkileşimi taşımaz; etkileşim katsayısı sıfıra doğru yanlı olur ("uyumsuz atama", van Buuren 2018 §6.4). Çözüm, çarpım terimini pasif atamayla ya da "just another variable" olarak atama modeline vermektir. MerQur bu durumda eksik değişkenleri adıyla yazan bir uyarı verir.
S7. D1'in payda sd'si neden 75,18? Hangi formül?
Reiter (2007) küçük örneklem sd'si t=k(m-1)=12 ve \nu^{*}=\frac{\nu_{\text{com}}+1}{\nu_{\text{com}}+3}\nu_{\text{com}} ile kullanılır; mice D1 (mitml) ile aynıdır. Li–Raghunathan–Rubin (1991) formülüne yalnız Reiter formülünün tanımsız olduğu t=2 ve t=4'te düşülür (:995–1006). t\le4'te çıktıya kararsızlık notu eklenir.
S8. "En çok yineleme" kaç olmalı?
FCS'de bu sayı yakınsama ölçütü değil, sabit döngü sayısıdır; mice varsayılanı 5, MerQur'unki 10'dur. Yakınsama izi grafiğinde zincirlerin ortalama ve SS izleri karışmış ve eğilimsizse yeterlidir. İpucu metni bu kutuyu yalnız "IterativeImputer iç yineleme sayısı" olarak tanımlar; FCS varsayılanken bu tanım eksiktir.
S9. m kaç olmalı?
Rubin'in verim formülü RE =(1+\gamma/m)^{-1} küçük m'yi yeterli gösterir (\gamma=0{,}38, m=5: 0,93). Ama p değerinin ve GA'nın tekrarlanabilirliği ile \gamma, \nu'nun kararlılığı için daha çok atama gerekir. White, Royston ve Wood (2011) en az eksik değerli satır yüzdesi kadar atama önerir; burada %35 eksik satır m\approx35 demektir. Tıp örneğinde m=20 ile \gamma 0,38'den 0,21'e, \nu 27'den 95'e değişmiştir; yani m=5 sonucu kararsızdır.
120.9 Sık hatalar ve tuzaklar
- λ'yı FMI diye raporlamak. Ana tablo \lambda, ikinci tablo FMI (\gamma) verir; rapora \gamma ve Barnard–Rubin \nu yazılmalıdır.
- Yardımcı değişkeni analiz modeline koymak ya da hiç kullanmamak. Eksiklikle ya da eksik değişkenle ilişkili değişken (Tıp örneğinde
cholesterol) yardımcı olarak atama modeline girmeli; analiz modelini değiştirmez ama atamayı iyileştirebilir (\gamma_{\text{HbA1c}} 0,20'den 0,08'e indi). - Etkileşimli analizde atama modelini düşünmemek. Etkileşim atama modeline girmez; MerQur eksik değişken içeren etkileşimde uyarı verir (120.8 S6).
- Küçük m ile kesin sonuç çıkarmak. \gamma\approx0{,}5 iken m=5 sonucu tekrar edilemez olabilir.
- Little testini MAR kanıtı saymak. Anlamsız test yalnız MCAR'ın reddedilmediğini gösterir.
- Liste bazında sonucu "doğru" kabul edip MI'yı sınamak. İkisi farklıysa sorun çoğu zaman liste bazındadır (MCAR değilse yanlı); ama atama modeli de yetersiz olabilir.
- Ana tablodaki t ile ikinci tablodakini tutarsız sanmak. Fark yuvarlamadan gelir.
120.10 Kaynaklar
- Barnard, J., & Rubin, D. B. (1999). Small-sample degrees of freedom with multiple imputation. Biometrika, 86(4), 948–955. https://doi.org/10.1093/biomet/86.4.948
- Dempster, A. P., Laird, N. M., & Rubin, D. B. (1977). Maximum likelihood from incomplete data via the EM algorithm. Journal of the Royal Statistical Society: Series B (Methodological), 39(1), 1–22. https://doi.org/10.1111/j.2517-6161.1977.tb01600.x
- Graham, J. W., Olchowski, A. E., & Gilreath, T. D. (2007). How many imputations are really needed? Some practical clarifications of multiple imputation theory. Prevention Science, 8(3), 206–213. https://doi.org/10.1007/s11121-007-0070-9
- Harel, O. (2009). The estimation of R² and adjusted R² in incomplete data sets using multiple imputation. Journal of Applied Statistics, 36(10), 1109–1118. https://doi.org/10.1080/02664760802553000
- Li, K. H., Raghunathan, T. E., & Rubin, D. B. (1991). Large-sample significance levels from multiply imputed data using moment-based statistics and an F reference distribution. Journal of the American Statistical Association, 86(416), 1065–1073. https://doi.org/10.1080/01621459.1991.10475152
- Little, R. J. A. (1988a). A test of missing completely at random for multivariate data with missing values. Journal of the American Statistical Association, 83(404), 1198–1202. https://doi.org/10.1080/01621459.1988.10478722
- Little, R. J. A. (1988b). Missing-data adjustments in large surveys. Journal of Business & Economic Statistics, 6(3), 287–296. https://doi.org/10.1080/07350015.1988.10509663
- Reiter, J. P. (2007). Small-sample degrees of freedom for multi-component significance tests with multiple imputation for missing data. Biometrika, 94(2), 502–508. https://doi.org/10.1093/biomet/asm028
- Rubin, D. B. (1987). Multiple imputation for nonresponse in surveys. Wiley. https://doi.org/10.1002/9780470316696
- van Buuren, S. (2018). Flexible imputation of missing data (2. baskı). Chapman & Hall/CRC. https://doi.org/10.1201/9780429492259
- van Buuren, S., & Groothuis-Oudshoorn, K. (2011). mice: Multivariate imputation by chained equations in R. Journal of Statistical Software, 45(3), 1–67. https://doi.org/10.18637/jss.v045.i03
- White, I. R., Royston, P., & Wood, A. M. (2011). Multiple imputation using chained equations: Issues and guidance for practice. Statistics in Medicine, 30(4), 377–399. https://doi.org/10.1002/sim.4067