81. t-SNE
Analiz kimliği: tsne · Menü adı: t-SNE · Panel: gui/panels/analyses/tsne.py (form 40–100, read_options 128–143, execute 170–213, künye 218–245, metin 257–349) · Motor: ml/dimensionality.py, DimensionalityReduction.tsne (satır 356–492); tam KL tsne_full_kl (97–139); güvenilirlik/süreklilik trust_continuity (66–94); hesap çekirdeği sklearn.manifold.TSNE (scikit-learn 1.8.0, Barnes-Hut)
81.1 Ne işe yarar
t-SNE (t-dağılımlı stokastik komşu gömme), çok değişkenli gözlemleri iki ya da üç boyutlu bir haritaya yerleştirir. Amaç, özgün uzayda birbirine yakın olan gözlemlerin haritada da yakın kalmasıdır. Cevapladığı soru: "Bu 12 gen ifadesine göre birbirine benzeyen hastalar kendi aralarında gruplanıyor mu?"
t-SNE bir hipotez testi ya da model değildir; p değeri, katsayı ya da güven aralığı üretmez. Çıktısı bir koordinat tablosu ve bir saçılım grafiğidir. Yöntem iki olasılık dağılımını eşleştirir: özgün uzaydaki komşuluk olasılıkları P ile haritadaki komşuluk olasılıkları Q. Haritadaki noktalar, P ile Q arasındaki Kullback–Leibler (KL) ıraksaması en küçük olacak biçimde yinelemeli olarak kaydırılır:
- \mathbf y_i: i. gözlemin haritadaki (gömme) koordinatı; 2 ya da 3 boyutlu.
- P_{ij}: özgün uzayda i ile j'nin komşu olma olasılığı (81.5.2–81.5.3).
- q_{ij}: haritada i ile j'nin komşu olma olasılığı (81.5.4).
Ne zaman kullanılır?
- Kümeler ya da alt tipler olup olmadığına görsel olarak bakmak için (keşif amaçlı).
- Değişken sayısı fazla, ilişkiler doğrusal olmayabilir ve PCA'nın iki boyutu yapıyı göstermiyorsa.
- Bilinen bir grup etiketinin (ör. tümör alt tipi) veride kendiliğinden ayrışıp ayrışmadığını görmek için ("Gruba göre renklendir").
Ne zaman kullanılmaz?
- Haritadaki uzaklıklar ya da küme büyüklükleri yorumlanacaksa: t-SNE yalnız yerel komşuluğu korur. Uzaklıkları korumak için Çok Boyutlu Ölçekleme (MDS) (Bölüm 82), varyans yapısı için PCA (Bölüm 80).
- Yeni gözlemleri aynı haritaya yerleştirmek gerekiyorsa: t-SNE'de dönüşüm fonksiyonu yoktur; her çalıştırma yeni bir harita kurar. PCA yeni gözlemi aynı eksenlere izdüşürür.
- Küme sayısını belirlemek için: harita bir kanıt değildir. K-Ortalamalar, Hiyerarşik Kümeleme, DBSCAN ya da Gizil Profil Analizi (LPA) kullanın.
- Gruplar arası farkı sınamak için: MANOVA ya da Diskriminant Analizi.
Sık karıştırılan analizler. UMAP (Bölüm 83) da yerel komşuluğu korur, ama komşuluk grafiğini bulanık küme kuramıyla kurar ve itme kuvvetini örnekleyerek hızlanır. PCA doğrusal ve deterministiktir; eksenleri değişkenlerin doğrusal birleşimidir ve yorumlanabilir. MDS bütün uzaklıkları korumaya çalışır. t-SNE eksenleri ise bir anlam taşımaz; harita döndürülse ya da yansıtılsa aynı çözümdür.
81.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Sayısal değişkenler | Uzaklık sayılarla hesaplanır. | Seçici yalnız sayısal sütunları listeler; en az 2 değişken (tsne.py:49, stats_panel.py:7835–7837). Sayısala çevrilemeyen sütun atılır (ml/_preprocessing.py:222–242). |
| Ortak ölçek | Geniş aralıklı değişken uzaklığa baskın olur. | Her değişken her zaman z puanına çevrilir; kapatılamaz (dimensionality.py:397). |
| Sabit olmayan değişkenler | Sabit sütun bilgi taşımaz. | Varyansı 0 olan sütun atılır (_preprocessing.py:294). |
| Anlamlı uzaklık ölçüsü | Yakınlık, benzerlik demektir. | Denetlenmez; Öklid, Manhattan, kosinüs ya da korelasyon seçilebilir. |
| Yeterli örneklem | Perplexity n'den küçük olmalıdır. | En az 5 tam satır (dimensionality.py:21, 394); perplexity gerekirse n-1'e indirilir (81.3). |
Eksik değer. "Eksik Veri" seçicisi (Sil, Ortalama, Medyan, KNN ile doldur) ortak hazırlık işlevine gider (_preprocessing.py:182–). Varsayılan "Sil (listwise)"tir: herhangi bir değişkeni eksik satır gömmeye girmez. Künyede "Gömmede kullanılan n" yazar.
Uç durumlar (koddan):
- Tam satır sayısı 5'ten azsa durur (
dimensionality.py:394). - Perplexity, \min(\text{perplexity},\ \max(2,\ n-1)) olarak kullanılır (
dimensionality.py:24–26, 436). Bu indirim bir uyarı metni üretir (dimensionality.py:488–491); metin sonuca uyarı olarak yazılır, künyede de "30 → 19" biçiminde görünür (tsne.py:258–272; 81.8, S6). - Satır sayısı "En fazla satır" sınırını (varsayılan 2000) aşarsa rastgele bir örneklem alınır; grup sütunu seçiliyse örneklem tabakalıdır (
dimensionality.py:406–423). Örneklem formdaki tohumla çekilir (81.8, S7). - Öklid dışı bir metrikte "PCA" başlangıcı rastgele başlangıca çevrilir ve uyarılır (
dimensionality.py:435,tsne.py:334–335). - Yineleme yalnız erken abartma evresini (250) kapsarsa KL tanımsızdır ve "—" yazılır (
dimensionality.py:445–449); arayüz bu yüzden en az 500 yineleme kabul eder (tsne.py:63).
81.3 Parametreler
Varsayılanlar tsne.py:40–143 ve motor imzasından (dimensionality.py:356–372) alınmıştır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımsız değişkenler | — | Gömülecek sayısal değişkenler (en az 2). | z puanına çevrilir. |
| Karmaşıklık (perplexity) | 30 (aralık 2–100) | Her gözlemin "etkin komşu sayısı" (81.5.2). | Küçük değer yerel ayrıntıyı, büyük değer genel yapıyı öne çıkarır (Şekil 81.2). |
| Yineleme | 1000 (500–5000) | En çok gradyan inişi adımı; ilk 250'si erken abartma evresidir. | 300 yineleme boyunca iyileşme olmazsa erken durur. |
| Eksik Veri | Sil (listwise) | Eksik değer işlemi. | Gömmeye giren n. |
| Gruba göre renklendir | yok | 2–30 düzeyli bir sütuna göre renk; örnekleme gerekirse tabaka. | Gömmeyi değiştirmez (örnekleme dışında). |
| Koordinatları veri setine kaydet | kapalı | TSNE_1, TSNE_2 (, TSNE_3) sütunları. |
— |
| Rastgele tohum | 42 | sklearn random_state. |
Yalnız rastgele başlangıçta etkilidir (81.6.1). |
| En fazla satır | 2000 ("Tüm veri" = 0) | Satır sınırı. | Aşılırsa örneklem alınır. |
| Öğrenme oranı | Otomatik | \eta=\max(n/\alpha/4,\ 50) (81.5.5). | Çok küçük \eta yakınsamayı yavaşlatır, çok büyük \eta noktaları dağıtır. |
| Erken abartma | 12 | İlk 250 yinelemede P'nin çarpanı \alpha. | Kümeler arası boşluğu erken açar. |
| Başlangıç | PCA | PCA ya da rastgele. | PCA başlangıcında tohum sonucu değiştirmez. |
| Uzaklık metriği | Öklid | Öklid, Manhattan, kosinüs, korelasyon. | Öklid dışında başlangıç rastgeledir. |
| Gömme boyutu | 2 | 2 ya da 3. | 3 boyutta Student-t serbestlik derecesi 2 olur (81.5.4). |
| Güvenilirlik / süreklilik | kapalı | T(5) ve C(5) ölçüleri. | Yalnız ek satır. |
| Grafik | 2B gömme | "3B gömme" seçilirse ayrıca 3 boyutlu bir gömme yalnız grafik için hesaplanır. | Metin ve tablo 2B gömmeye aittir. |
Neden PCA başlangıcında tohum etkisiz?
sklearn PCA başlangıcını \mathbf y^{(0)}=\mathbf T_{[:,1:2]}/\mathrm{SS}(\mathbf t_1)\times10^{-4} olarak kurar (\mathbf T: PCA puanları). Değişken sayısı 1000'den az ve n\ge10p olduğunda sklearn PCA'yı kovaryans matrisinin kesin özayrışmasıyla çözer; çözüm tohumdan bağımsızdır. Barnes-Hut gradyanında da rastgelelik yoktur. (n>500 ve n<10p olan verilerde sklearn rastgeleleştirilmiş SVD'ye geçer; o zaman tohum başlangıcı çok az değiştirebilir.) Bu yüzden aynı veri ve ayarlarla tohum 42 ve tohum 7 birebir aynı haritayı verir (81.6.1). Rastgele başlangıçta ise \mathbf y^{(0)}_i\sim N(\mathbf 0,\ 10^{-8}\mathbf I) çekilir ve tohum haritayı belirler. MerQur'un PCA'yı varsayılan yapması, Kobak ve Berens'in (2019) önerisine dayanır: PCA başlangıcı genel yapıyı daha iyi korur ve sonucu yeniden üretilebilir kılar (tsne.py:86–87, araç ipucu).
81.4 Tıp örneği
Dosya: english/datasets/Tip/70_tsne_cancer_5tip.xlsx (Türkçe kopya: samples/Tum_Analiz_Tip/70_tsne_kanser_5tip.xlsx). Değişken seçimi VIDEO_SCRIPT_TR.txt #70'ten alınmıştır.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
| gene_01 … gene_12 | özellik | sürekli | ortalamalar 0,92–1,10; SS 1,11–1,36 |
| lower_type | renk (gömmeye girmez) | 5 düzey | A, B, C, D, E; her biri 25 hasta |
| patient_id | — | kimlik | gömmeye girmez |
n ve eksik değer: 125 hasta, eksik değer yok.
Klinik soru: 12 genin ifade düzeyleri, beş tümör alt tipini ayıran bir yapı taşıyor mu?
Veri yapısı. Alt tiplerin gen ortalamaları neredeyse her gende aynı sırayla artar (A ≈ 0,1; B ≈ 0,5; C ≈ 0,9; D ≈ 1,5; E ≈ 2,1). Yani alt tipler ayrık kümeler değil, tek bir "ifade düzeyi" ekseni boyunca sıralanmış, birbirine geçen gruplardır. Bu bölümde t-SNE'nin böyle bir gradyanı nasıl gösterdiği de görülecektir.
Seçilen ayarlar: Arayüz varsayılanları (perplexity 30, 1000 yineleme, tohum 42, PCA başlangıcı, Öklid, 2 boyut, "Gruba göre renklendir" = lower_type). Ek çalıştırmalar: aynı ayarlarla ikinci çalıştırma; PCA başlangıcıyla tohum 7; rastgele başlangıçla tohum 42 (iki kez) ve tohum 7; perplexity 5 ve 50; güvenilirlik/süreklilik açık; "En fazla satır" = 100 ile tohum 7 (örnekleme davranışı); ilk 20 hasta (perplexity indirimi).
81.5 Formüller ve hesap adımları
MerQur'un hesap sırası: (1) seçilen sütunları sayısala çevirir, eksik değeri işler, sabit sütunları atar; (2) her sütunu z puanına çevirir; (3) gerekirse satırları örnekler; (4) etkin perplexity'yi belirler; (5) sklearn TSNE ile her gözlemin K en yakın komşusunu bulur, \sigma_i'leri ikili aramayla kestirir, simetrik P'yi kurar; (6) PCA başlangıcından gradyan inişiyle gömmeyi bulur (önce 250 yineleme erken abartma, sonra olağan evre); (7) son gömmeden KL'yi tanımla yeniden hesaplar; (8) isteğe bağlı güvenilirlik/süreklilik ve DBSCAN küme sezgisini ekler.
81.5.1 Ölçekleme ve uzaklık
- x_{ij}: i. hastanın j. değişkeni; \bar x_j: sütun ortalaması.
- s_j: n bölenli standart sapma (
StandardScaler,dimensionality.py:397). - d_{ij}^2: kare Öklid uzaklığı; p değişken sayısı (burada 12).
- Öklid dışı metrikte d_{ij} seçilen metrikle hesaplanır ve yine karesi alınır.
Koddaki tercih: n bölenli z
R scale() n-1 bölenli SS kullanır. Bu fark bütün uzaklıkları aynı \sqrt{n/(n-1)} katsayısıyla ölçekler, ama sonucu değiştirmez: \sigma_i uzaklıkla birlikte ölçeklenir ve perplexity ölçekten bağımsız olduğundan P aynı kalır. Yani ölçek katsayısı P'yi ve dolayısıyla haritayı (ikili arama toleransı içinde) etkilemez; R'de scale() ile de aynı P elde edilir. Önemli olan, değişkenlerin birbirine göre eşit ağırlıkta olmasıdır.
81.5.2 Koşullu olasılıklar ve perplexity
Barnes-Hut yönteminde her gözlem için yalnız en yakın K komşu kullanılır:
- N_K(i): i'nin K en yakın komşusu (kendisi hariç).
- \beta_i=1/(2\sigma_i^2): i merkezli Gauss çekirdeğinin kesinliği; \sigma_i çekirdeğin genişliği.
- Tıp örneğinde K=\min(124,\ 91)=91: her hasta 124 hastadan yalnız en yakın 91'ine olasılık dağıtır.
\beta_i, dağılımın entropisi hedef perplexity'ye eşit olacak biçimde seçilir:
- S_i=\sum_{k\in N_K(i)}\exp(-\beta_i d_{ik}^2): normalleştirme toplamı.
- H_i: entropi (nat); perplexity, 2^{\text{entropi (bit)}} ile aynıdır.
- Hedef: \lvert H_i-\ln(\text{perplexity})\rvert\le10^{-5}.
Neden perplexity? "Etkin komşu sayısı"
Gözlem i olasılığını m komşusuna eşit dağıtsaydı entropi \ln m, perplexity m olurdu. Perplexity 30, "her hasta yaklaşık 30 komşuya eşdeğer olasılık dağıtsın" demektir. Bu kural, yoğun bölgelerdeki gözlemlere dar (\sigma küçük), seyrek bölgelerdekilere geniş (\sigma büyük) çekirdek verir; böylece her gözlemin komşuluğu yerel yoğunluğa uyarlanır. Tek bir \sigma kullanılsaydı seyrek bölgelerdeki gözlemlerin hiç komşusu olmazdı.
İkili arama. sklearn'ün _binary_search_perplexity işlevi (van der Maaten'in özgün kodunun kopyası) \beta'yı şöyle arar:
- \beta=1, \beta_{\min}=-\infty, \beta_{\max}=+\infty ile başla.
- H'yi hesapla. \lvert H-\ln\text{perp}\rvert\le10^{-5} ise dur.
- H hedeften büyükse (dağılım çok yayvan) \beta_{\min}=\beta yap; \beta_{\max} sonsuzsa \beta\leftarrow2\beta, değilse \beta\leftarrow(\beta+\beta_{\max})/2.
- Küçükse \beta_{\max}=\beta; \beta_{\min} eksi sonsuzsa \beta\leftarrow\beta/2, değilse \beta\leftarrow(\beta+\beta_{\min})/2.
- En çok 100 adım.
Koddaki tercih: float32 kare uzaklıklar
sklearn kare uzaklıkları ikili aramadan önce 32 bitlik sayılara yuvarlar. Bu, ulaşılan perplexity'yi 10^{-6} düzeyinde etkiler; \beta değerleri ikili bölmenin ürettiği kesirler olduğundan çoğu zaman bit düzeyinde aynı kalır (81.6.1).
81.5.3 Simetrik ortak olasılıklar
- Her satır toplamı 1 olduğundan payda 2n'dir.
- P_{ij}=P_{ji}; \sum_{i\neq j}P_{ij}=1.
- j, i'nin K komşusu değilse ve i de j'nin komşusu değilse P_{ij}=0.
Neden simetrikleştirme?
Koşullu p_{j\mid i} asimetriktir: seyrek bölgedeki bir aykırı gözlemin herkesten uzak olması, p_{i\mid j}'yi her j için çok küçük yapar ve o gözlem haritada konumlandırılamaz. Ortalama almak her gözlemin toplam olasılığının en az 1/(2n) olmasını sağlar (van der Maaten ve Hinton 2008).
81.5.4 Gömmedeki olasılıklar: Student-t çekirdeği
- a: Student-t serbestlik derecesi. 2 boyutta a=1 (Cauchy çekirdeği (1+d^2)^{-1}), 3 boyutta a=2 (sklearn
degrees_of_freedom). - Payda, bütün nokta çiftleri üzerinden toplamdır.
Neden ağır kuyruklu t çekirdeği?
12 boyutta orta uzaklıkta pek çok komşu vardır; iki boyutta bunların hepsine yer yoktur ("kalabalıklaşma sorunu"). Haritada Gauss yerine ağır kuyruklu bir çekirdek kullanmak, orta uzaklıktaki gözlemlerin haritada daha uzağa yerleşmesine izin verir; böylece kümeler arasında boşluk açılır.
81.5.5 Amaç fonksiyonu ve optimizasyon
- C: KL ıraksaması; P_{ij}>0 olan çiftler üzerinden toplanır.
- Gradyanın ilk terimi (P_{ij}) komşuları birbirine çeker, ikinci terimi (q_{ij}) bütün noktaları birbirinden iter.
Optimizasyon (sklearn, _t_sne.py):
- Erken abartma: ilk 250 yinelemede P yerine \alpha P kullanılır (\alpha = "Erken abartma", varsayılan 12); momentum 0,5.
- Olağan evre: kalan yinelemelerde P, momentum 0,8.
- Öğrenme oranı: \eta=\max(n/\alpha/4,\ 50). Tıp örneğinde 125/12/4=2{,}6 olduğundan \eta=50.
- Kazançlar: gradyan ile önceki adımın işareti farklıysa kazanç 0,2 artar, aynıysa 0,8 ile çarpılır (en az 0,01).
- Barnes-Hut: itme terimi dörtlü ağaçla yaklaşık hesaplanır (açı \theta=0{,}5).
- Durma: "Yineleme" sayısına ulaşınca ya da 300 yineleme boyunca (her 50 yinelemede bir denetlenen) hata iyileşmezse ya da gradyan normu 10^{-7}'nin altına inerse.
Koddaki tercih: raporlanan KL tanımla yeniden hesaplanır
sklearn'ün kl_divergence_ değeri Barnes-Hut yaklaşık hatasıdır. MerQur bunun yerine son gömmeden tam Q ile KL'yi yeniden hesaplar (tsne_full_kl, dimensionality.py:97–139): P aynı K-komşulu seyrek matristir, Q'nun paydası bütün çiftler üzerinden toplanır. Tıp örneğinde Barnes-Hut değeri 0,5577, tam değer 0,5621'dir. P kesilmeden (bütün 124 komşu, sıkı tolerans) hesaplansaydı KL 0,5617 olurdu; yani K kesmesinin etkisi bu veride 0,0004'tür.
3 boyutta KL hangi çekirdekle?
tsne_full_kl, sklearn'ün optimize ettiği Student-t çekirdeğini kullanır: 2 boyutta serbestlik derecesi 1 (a=1), 3 boyutta 2 (a=2) (dimensionality.py:97–139). Böylece raporlanan KL her boyutta optimize edilen amaç değeridir. Aynı 3B gömmeye a=1 çekirdeği uygulansaydı Tıp örneğinde KL 0,918 çıkardı; optimize edilen amaç değeri 1,094'tür (dogrulama/tsne/boyut3_kl.py). 2B ve 3B KL'leri farklı çekirdeklerle tanımlı olduğundan birbiriyle karşılaştırılmaz.
81.5.6 Güvenilirlik, süreklilik ve küme sezgisi
"Güvenilirlik / süreklilik" seçilirse (dimensionality.py:460–463), k=\min(5,\ \lfloor n/2\rfloor-1) ile:
- U_k(i): haritada i'nin k en yakın komşusu olup özgün uzayda olmayanlar.
- r(i,j): j'nin özgün uzayda i'ye göre uzaklık sırası.
- T=1: haritadaki her komşu özgün uzayda da komşudur. Süreklilik C(k) aynı formüldür, roller ters çevrilir (özgün uzaydaki komşu haritada kaybolmuş mu?).
- Özgün uzay seçilen metrikle, harita Öklid uzaklığıyla ölçülür (Venna ve Kaski 2001).
Otomatik küme sezgisi (tsne.py:282–322): k=\max(5,\ \min(\lfloor0{,}01n\rfloor,\ 20)); her noktanın (kendisi dahil) k. komşu uzaklıklarının 95. yüzdeliği \varepsilon olur; DBSCAN(\varepsilon, min_samples = k) haritaya uygulanır. İzole oranı < %20 ve en az 2 küme varsa "doğal grup yapısı var" yazılır.
Küme sezgisi bir test değildir
DBSCAN haritanın kendisine uygulanır; t-SNE'nin yarattığı boşluklar kümeymiş gibi görünebilir ve küme sayısı perplexity'ye bağlıdır. Sezgi yalnız bir ipucudur; küme varlığını kanıtlamaz.
81.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/tsne/elle_hesap.py ile hesaplanmıştır. Betik MerQur'u ve sklearn'ü çağırmaz; ikili aramayı, P'yi, Q'yu ve KL'yi numpy ile tanımdan hesaplar.
Adım 1 — Ölçek ve komşular. 12 gen n bölenli z puanına çevrilir (MerQur girdisiyle en büyük fark 4{,}4\cdot10^{-16}). K=\lfloor3\cdot30+1\rfloor=91. Hasta 1'in en yakın komşuları ve kare uzaklıkları: hasta 59 (d^2=4{,}0473), 6 (6{,}1414), 16 (6{,}2810), 5 (6{,}9956), 37 (7{,}0648); 91. komşu d^2=27{,}293.
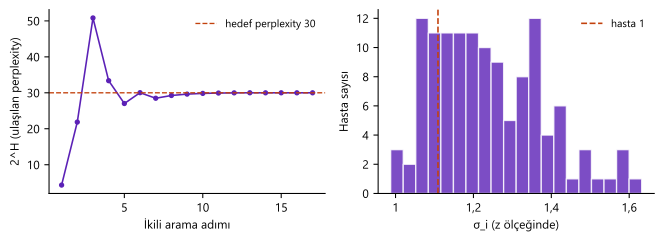
Adım 2 — Hasta 1 için ikili arama. Hedef \ln30=3{,}401197.
| Adım | \beta | H | e^{H} |
|---|---|---|---|
| 1 | 1 | 1,467186 | 4,34 |
| 2 | 0,5 | 3,084498 | 21,86 |
| 3 | 0,25 | 3,928305 | 50,82 |
| 4 | 0,375 | 3,507715 | 33,37 |
| 5 | 0,4375 | 3,296668 | 27,02 |
| 6 | 0,40625 | 3,402281 | 30,03 |
| ⋮ | ⋮ | ⋮ | ⋮ |
| 17 | 0,40657043 | 3,401199 | 30,00004 |
İlk adımda \beta=1 çok dar bir çekirdektir (yalnız ~4 etkin komşu). \beta yarıya inerek çekirdek genişler; hedef aşılınca (adım 3) aralık ikiye bölünmeye başlar. 17. adımda \lvert H-\ln30\rvert=1{,}3\cdot10^{-6}\le10^{-5} olur:
125 hastanın tamamında arama 13–20 adımda biter; \sigma_i 0,988 ile 1,632 arasındadır (ortalama 1,238). Ulaşılan perplexity 29,9997–30,0003'tür.
Şekil 81.1. Sol: hasta 1 için ikili aramada her adımda ulaşılan perplexity ve hedef 30. Sağ: 125 hastanın \sigma_i dağılımı; kesikli çizgi hasta 1.
Adım 3 — Koşullu ve ortak olasılık. Hasta 1'in en yakın komşusuna (hasta 59) verdiği olasılık:
Hasta 59'un hasta 1'e verdiği olasılık daha küçüktür: p_{1\mid59}=0{,}080280 (hasta 59'un bölgesi daha yoğundur). Ortak olasılık:
P'nin 15500 köşegen dışı hücresinden 13254'ü sıfırdan büyüktür; geri kalanı iki yönde de 91 komşu dışında kalan çiftlerdir.
Adım 4 — Gömmede olasılık ve KL. MerQur'un son gömmesinde hasta 1 (5{,}9789;\ -1{,}0566), hasta 59 (6{,}1898;\ -0{,}9810) noktasındadır; \lVert\mathbf y_1-\mathbf y_{59}\rVert^2=0{,}050205. Normalleştirme toplamı \sum_{k\neq l}(1+\lVert\mathbf y_k-\mathbf y_l\rVert^2)^{-1}=1210{,}304:
Bu çiftin KL'ye katkısı 0{,}0010064\cdot\ln(0{,}0010064/0{,}00078674)=0{,}000248'dir. Bütün çiftler üzerinden:
MerQur aynı değeri yazar (fark 2\cdot10^{-16}). Son gömmede tam gradyanın normu 4{,}6\cdot10^{-4}'tür: optimizasyon durağan bir noktaya çok yakındır.
Adım 5 — Güvenilirlik ve küme sezgisi. k=5 ile T(5)=0{,}926537, C(5)=0{,}912082. Küme sezgisi: k=\max(5,\min(1{,}20))=5; 125 noktanın 5. komşu uzaklıklarının (kendisi dahil) 95. yüzdeliği \varepsilon=1{,}685842; DBSCAN 1 küme ve 2 izole nokta bulur.
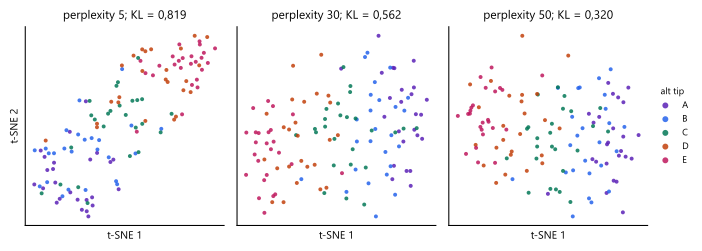
Adım 6 — Perplexity'nin etkisi. Aynı veri perplexity 5 ve 50 ile:
| Perplexity | K | KL | 10 komşunun aynı alt tipten olma oranı | Ana eksen ile alt tip sırası, \lvert\rho_S\rvert |
|---|---|---|---|---|
| 5 | 16 | 0,819371 | 0,430 | 0,848 |
| 30 | 91 | 0,562109 | 0,510 | 0,907 |
| 50 | 124 | 0,319923 | 0,478 | 0,903 |
Özgün 12 boyutlu uzayda komşu oranı 0,417'dir. Son sütun, haritanın birinci ana ekseni boyunca sıralamanın alt tip sırasıyla (A < B < … < E) Spearman korelasyonudur: haritada alt tipler ayrık kümeler değil, sıralı bir şerittir. KL perplexity büyüdükçe küçülür; bu, haritanın "daha iyi" olduğu anlamına gelmez, çünkü her perplexity farklı bir P tanımlar (81.8, S3).
Şekil 81.2. Perplexity 5, 30 ve 50 ile MerQur gömmeleri; renkler tümör alt tipi. Alt tipler ayrık kümeler yerine A'dan E'ye uzanan tek bir şerit oluşturur.
81.6.1 Doğrulama: MerQur, Python ve R
Python sütunu elle_hesap.py'nin tanımdan hesabıdır. R sütunu, ikili aramayı, P'yi, KL'yi ve güvenilirliği R'de ayrıca yazılmış kodla, DBSCAN'i dbscan paketiyle hesaplar (r_dogrulama.R). Rastgele başlangıç, Barnes-Hut yaklaşımı ve yineleme ayrıntıları programlar arasında farklı olduğundan gömme koordinatlarının R ile birebir eşleşmesi beklenmez; bunun yerine tanımla hesaplanabilen her büyüklük MerQur'un kendi gömmesi üzerinde doğrulanmış, R Rtsne paketi yalnız yapı benzerliği ve tekrarlanabilirlik için çalıştırılmıştır.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Girdi ve ortak olasılıklar P (perplexity 30, n = 125) | |||||
| z-ölçekli girdi: MerQur girdisine en büyük fark | — | 4,4409·10−16 | — | 0,0e+00 | ✓ |
| Komşu sayısı K = min(n − 1, ⌊3·30 + 1⌋) | — | 91 | 91 | 0,0e+00 | ✓ |
| Öğrenme oranı (otomatik) | 50 | 50 | — | 0,0e+00 | ✓ |
| β_i = 1/(2σ_i²) (125 değer) | — | 0,406570 | 0,406570 | 5,6e−16 | ✓ |
| Ulaşılan perplexity 2^H_i (125) | — | 30,000039 | 30,000040 | 1,2e−06 | ✓ |
| KL(P‖Q): MerQur'un son gömmesi üzerinde, Q tüm çiftlerden | |||||
| KL, varsayılan (PCA başlangıcı) | 0,562109 | 0,562109 | 0,562109 | 9,7e−10 | ✓ |
| KL, rastgele başlangıç, tohum 42 | 0,561164 | 0,561164 | — | 3,3e−16 | ✓ |
| KL, rastgele başlangıç, tohum 7 | 0,531382 | 0,531382 | — | 1,1e−16 | ✓ |
| KL, perplexity 5 | 0,819371 | 0,819371 | — | 6,7e−16 | ✓ |
| KL, perplexity 50 | 0,319923 | 0,319923 | — | 2,2e−16 | ✓ |
| Komşuluk koruma ve küme sezgisi (varsayılan gömme) | |||||
| Güvenilirlik T(5) | 0,926537 | 0,926537 | 0,926537 | 1,1e−16 | ✓ |
| Süreklilik C(5) | 0,912082 | 0,912082 | 0,912082 | 3,3e−16 | ✓ |
| DBSCAN ε (95. yüzdelik) | 1,690000 | 1,685842 | 1,685842 | 0,0e+00 | ✓ (2 ondalık) |
| DBSCAN küme / izole nokta | 1 | 1 | 1 | 0,0e+00 | ✓ |
Tohum ve tekrarlanabilirlik (gömme koordinatlarında en büyük mutlak fark).
| Karşılaştırma | MerQur (sklearn) | R Rtsne |
|---|---|---|
| PCA başlangıcı, tohum 42, iki çalıştırma | 0 | 0 |
| PCA başlangıcı, tohum 42 ile tohum 7 | 0 | — |
| Rastgele başlangıç, tohum 42, iki çalıştırma | 0 | 0 |
| Rastgele başlangıç, tohum 42 ile tohum 7 | 14,9409 | 7,9178 |
P, β ikili aramasıyla Python'da ve R'de ayrı ayrı tanımdan yazılmıştır (β₀ = 1, |H − ln 30| ≤ 10−5, en çok 100 adım). β değerleri ikili bölmenin ürettiği kesirler olduğundan iki dilde bit düzeyinde aynıdır; ulaşılan perplexity'deki 10−6 düzeyindeki fark, Python'un (sklearn gibi) kare uzaklıkları float32'ye yuvarlamasından gelir. MerQur'un iç P matrisi dışarı verilmez; KL'nin 10−16 düzeyinde eşleşmesi P'nin de aynı olduğunu gösterir. Rtsne 0.17 (θ = 0,5, η = 50, erken abartma 12 × 250 yineleme, aynı PCA ölçekli başlangıç) gömmesi MerQur'unkiyle birebir aynı değildir: aynı P ile KL = 0,5312 (MerQur 0,5621), güvenilirlik 0,9299, iki gömmede 10 en yakın komşunun ortak oranı 0,56, Procrustes benzerliği 0,876.
Tohum ve tekrarlanabilirlik. Aynı ayarlarla iki çalıştırma bit düzeyinde aynı koordinatları verir. sklearn çok çekirdekli çalışır (n_jobs = -1), ama her noktanın gradyanı tek bir iş parçacığında toplandığından sonuç değişmez. PCA başlangıcında tohum 42 ile tohum 7 aynı haritayı verir. Rastgele başlangıçta aynı tohum yine aynı haritayı, farklı tohum farklı bir haritayı verir (en büyük koordinat farkı 14,9; KL 0,5612'ye karşı 0,5314). Rtsne aynı davranışı gösterir.
81.7 Çıktıyı okuma
MerQur'un gerçek çıktısı (varsayılan ayarlar, güvenilirlik açık):
Bileşen: 2
Karmaşıklık: 30.0
Yineleme: 1000
Gömmede kullanılan n: 125
t-SNE — doğrusal olmayan boyut indirgeme. Eksen değerleri yorumlanmaz; sadece görsel.

KL ıraksaması (uyum kalitesi): 0.5621  →  iyi
  (düşük = lokal komşulukları daha iyi koruyor; yüksekse karmaşıklık (perplexity) ayarı
   veya yineleme sayısı denenebilir)
  ↳ KL, son gömmeden tanımla hesaplanan KL(P‖Q)'dir: P, her noktanın
    K = min(n − 1, ⌊3·perplexity + 1⌋) en yakın komşusundan; Q, tüm nokta çiftlerinden,
    gömmede optimize edilen Student-t çekirdeğiyle (serbestlik derecesi max(boyut − 1, 1)).
    Barnes-Hut yaklaşık iç kestirimi değildir. KL perplexity'ye ve n'e bağlıdır: not yalnız
    aynı perplexity ve aynı veriyle yapılan gömmeler arasında karşılaştırma içindir; eşikler
    yayımlanmış bir ölçüt değildir.

Otomatik küme sezgisi (DBSCAN ε≈1.69): 1 küme, 2 izole nokta (%2).
  ↳ Tek küme — örnekler homojen, ayrı topluluk tipleri yok. Veri sürekli bir gradyan
    olabilir (PCA daha uygun).
Not: PCA başlangıcı deterministiktir; tohum bu gömmeyi değiştirmez (tohum yalnız rastgele
başlangıçta etkilidir).
Güvenilirlik (k = 5) = 0.9265;  süreklilik = 0.9121
Gömme koordinatları Tablo sekmesinde.
| Satır/Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Karmaşıklık | Arayüzde istenen perplexity. | Küçük n'de kullanılan değer daha küçük olabilir; indirim metinde uyarıyla, künyede "30 → 19" biçiminde yazılır. |
| Gömmede kullanılan n | Gömmeye giren satır; örneklemde "n / N (rastgele örneklem, tohum = …)". | Örneklem formdaki tohumla çekilir. |
| KL ıraksaması → not | Tam KL ve not: < 0,5 çok iyi, < 1 iyi, < 2 orta, ≥ 2 zayıf (tsne.py:272–274). |
Not eşikleri yayımlanmış bir ölçüt değildir (not da bunu yazar); KL yalnız aynı veri ve perplexity içinde karşılaştırılır. |
| Otomatik küme sezgisi | DBSCAN \varepsilon, küme ve izole nokta sayısı. | Bu veride "tek küme" doğrudur: alt tipler sürekli bir gradyandır. |
| Not / Ayarlar | Tohumun etkisi; varsayılandan farklı ayarlar. | Ayarlar satırındaki tohum, örnekleme varsa onu da belirler. |
| Güvenilirlik, süreklilik | T(5), C(5). | 1'e yakın değer iyi yerel korumadır; 0,93 haritadaki komşuların çoğunun gerçekten komşu olduğunu gösterir. |
| Tablo sekmesi | Gözlem (1 tabanlı), grup ve 6 ondalıklı koordinatlar. | Koordinatların kendisi yorumlanmaz. |
Rapor cümlesi (Türkçe virgülle):
125 hastanın 12 gen ifade düzeyi z puanına çevrildi ve t-SNE ile iki boyuta indirgendi (perplexity = 30; PCA başlangıcı; 1000 yineleme; Barnes-Hut, θ = 0,5). Son gömmede KL(P‖Q) = 0,562; güvenilirlik T(5) = 0,93, süreklilik C(5) = 0,91 idi. Haritada beş alt tip ayrık kümeler oluşturmadı; A'dan E'ye uzanan tek bir şerit boyunca sıralandı.
81.8 Uzman soruları
S1. Raporlanan KL, sklearn'ün kl_divergence_ değeri mi?
Hayır. sklearn'ün değeri Barnes-Hut yaklaşık hatasıdır (Tıp örneğinde 0,5577). MerQur son gömmede Q'yu bütün çiftler üzerinden tam hesaplar ve KL'yi yeniden yazar (0,5621). P yine sklearn'ün K-komşulu seyrek matrisidir; çıktı notu da "tüm nokta çiftleri"nin yalnız Q için geçerli olduğunu yazar. 3 boyutta çekirdek, optimize edilen serbestlik derecesi 2'li Student-t'dir (81.5.5 uyarısı).
S2. σ_i neden her gözlem için farklı?
Perplexity sabit tutulur; yoğun bölgede aynı sayıda etkin komşuya küçük bir çekirdekle, seyrek bölgede büyük bir çekirdekle ulaşılır. Tıp örneğinde \sigma_i 0,99–1,63 aralığındadır. Bu uyarlama, t-SNE'nin farklı yoğunluktaki kümeleri benzer büyüklükte göstermesinin nedenidir; bu yüzden haritadaki küme genişliği yoğunluk hakkında bilgi vermez.
S3. Farklı perplexity değerlerinin KL'leri karşılaştırılabilir mi?
Hayır. KL, sabit bir P'ye göre Q'nun uyumudur; perplexity değişince P değişir. Büyük perplexity'de P daha düz olduğundan KL küçülür (5 → 0,82; 50 → 0,32). MerQur'un "çok iyi/iyi" notu bu karşılaştırmayı yanlışlıkla davet eder. Perplexity seçimi için gözle denetim, güvenilirlik/süreklilik ve sonuçların birkaç perplexity'de tutarlılığı kullanılmalıdır.
S4. Aynı tohumla sonuç her zaman aynı mı? R ile aynı mı?
Aynı makinede, aynı veri, ayar ve tohumla evet (81.6.1). Farklı bir sklearn sürümü ya da işlemci kayan nokta sonuçlarını değiştirebilir; t-SNE optimizasyonu küçük farkları büyütebildiği için harita da değişebilir. R Rtsne ile aynı değildir: dörtlü ağacın ayrıntıları, K seçimi ve sayısal türler farklıdır. Aynı P ile Rtsne gömmesinde KL 0,531, iki gömmenin 10 en yakın komşu ortaklığı %56'dır. Doğrulanması gereken, koordinatlar değil, P, KL ve komşuluk ölçüleridir.
S5. Kümeler arası uzaklık ya da küme büyüklüğü yorumlanabilir mi?
Hayır. Çekim yalnız komşular arasında etkilidir; kümeler arası boşluk, itme terimi ve erken abartmayla belirlenir. Küme genişliği de \sigma_i uyarlaması yüzünden yoğunluğu yansıtmaz. MerQur'un yorum rehberi de "Kümeler arası mesafe → YORUMSUZ" der.
S6. n küçükse ne olur?
Perplexity n-1'e indirilir (n = 20'de 30 → 19). Bu durumda her gözlem neredeyse herkese eşit olasılık dağıtır; P düzleşir ve harita anlamsız biçimde yayılır (n = 20 örneğinde koordinatlar ±100 düzeyindedir). MerQur indirimi sonuç metninde uyarıyla, künyede "30 → 19" biçiminde yazar. n<50 iken perplexity'yi elle 5–10'a düşürmek gerekir.
S7. "En fazla satır" aşıldığında arayüzdeki tohum örneklemi belirliyor mu?
Evet. Formdaki tohum hem satır örneklemine hem sklearn TSNE'ye gider (dimensionality.py:406–423); çıktıdaki "rastgele örneklem, tohum = …" ile "Ayarlar" satırındaki tohum aynıdır. Tek bir tohumun iki rastgele adımı belirlemesi, sonucun tek sayıyla yeniden üretilebilmesini sağlar. Farklı örneklemleri denemek için tohum değiştirilir.
S8. t-SNE haritasındaki kümeler gerçek mi?
Harita gerçek bir yapıyı gösterebilir, ama yapay boşluklar da üretebilir: ağır kuyruklu çekirdek orta uzaklıktaki noktaları iter. Bu veride t-SNE, alt tipler sürekli bir gradyan oluşturduğu için kümeler üretmemiştir ve küme sezgisi doğru biçimde "tek küme" demiştir. Küme iddiası için kümeleme analizlerinden biri ve bir doğrulama ölçüsü (siluet, kararlılık) gerekir.
81.9 Sık hatalar ve tuzaklar
- Eksenleri ya da koordinatları yorumlamak. t-SNE ekseni bir değişken birleşimi değildir; harita döndürülebilir, yansıtılabilir, ötelenebilir.
- Tek bir perplexity ile karar vermek. Yapıyı en az iki üç perplexity değerinde (ör. 5, 30, 50) karşılaştırın; KL'leri birbiriyle karşılaştırmayın.
- Küçük örneklemde varsayılan perplexity'yi bırakmak. n=20'de perplexity 19'a indirilir ve P düzleşir; uyarıyı okuyup perplexity'yi elle 5–10'a düşürün.
- 2B ve 3B KL'lerini karşılaştırmak. İki boyutta farklı Student-t çekirdekleri optimize edilir (81.5.5).
- "Rastgele tohum"u değiştirip kararlılığı denetlediğini sanmak. PCA başlangıcında tohum etkisizdir; kararlılık için "Başlangıç: Rastgele" seçilip farklı tohumlar denenmelidir.
- Öklid dışı metrikte PCA başlangıcı beklemek. Kosinüs, Manhattan ve korelasyonda başlangıç rastgeleye çevrilir; tohum o zaman sonucu değiştirir.
- KL notunu evrensel ölçüt sanmak. "< 0,5 çok iyi" eşikleri MerQur'a özgüdür; KL n'ye ve perplexity'ye bağlıdır.
81.10 Kaynaklar
- Belkina, A. C., Ciccolella, C. O., Anno, R., Halpert, R., Spidlen, J., & Snyder-Cappione, J. E. (2019). Automated optimized parameters for T-distributed stochastic neighbor embedding improve visualization and analysis of large datasets. Nature Communications, 10, 5415. https://doi.org/10.1038/s41467-019-13055-y
- Kobak, D., & Berens, P. (2019). The art of using t-SNE for single-cell transcriptomics. Nature Communications, 10, 5416. https://doi.org/10.1038/s41467-019-13056-x
- Kobak, D., & Linderman, G. C. (2021). Initialization is critical for preserving global data structure in both t-SNE and UMAP. Nature Biotechnology, 39(2), 156–157. https://doi.org/10.1038/s41587-020-00809-z
- van der Maaten, L. (2014). Accelerating t-SNE using tree-based algorithms. Journal of Machine Learning Research, 15, 3221–3245.
- van der Maaten, L., & Hinton, G. (2008). Visualizing data using t-SNE. Journal of Machine Learning Research, 9, 2579–2605.
- Venna, J., & Kaski, S. (2001). Neighborhood preservation in nonlinear projection methods: An experimental study. In G. Dorffner, H. Bischof, & K. Hornik (Eds.), Artificial Neural Networks — ICANN 2001 (Lecture Notes in Computer Science, Vol. 2130, pp. 485–491). Springer. https://doi.org/10.1007/3-540-44668-0_68
- Wattenberg, M., Viégas, F., & Johnson, I. (2016). How to use t-SNE effectively. Distill, 1(10), e2. https://doi.org/10.23915/distill.00002