4. Tek Örneklem t Testi
Analiz kimliği: ttest_one · Menü adı: Tek Örneklem t-Testi · Panel: gui/panels/analyses/one_sample_ttest.py · Motor: stats/hypothesis.py, HypothesisTests.one_sample_ttest (satır 2922–3031)
4.1 Ne işe yarar
Tek örneklem t testi, tek bir grubun ortalamasının önceden bilinen bir değere (\mu_0) eşit olup olmadığını sınar. Cevapladığı soru şudur: "Örneklem ortalamasının \mu_0'dan uzaklığı, yalnız örnekleme rastlantısıyla açıklanabilir mi?" \mu_0 veriden gelmez; bir referans değer, ölçek orta noktası, mevzuat sınırı ya da önceki çalışmalardan bilinen bir ortalamadır.
- \mu: değişkenin evren ortalaması (bilinmez; \bar x ile kestirilir).
- \mu_0: formdaki "Test edilen μ (μ₀)" kutusuna yazılan sabit; varsayılanı 0'dır.
Ne zaman kullanılır? Tek bir ölçüm dizisi varsa, değişken aralık ya da oran ölçeğindeyse ve dağılım kabaca normalse ya da n ortalamanın örnekleme dağılımını normale yaklaştıracak kadar büyükse.
Ne zaman kullanılmaz?
- Aynı kişilerde iki ölçüm varsa ve ölçümler arasındaki fark soruluyorsa: Eşleştirilmiş t Testi (bkz. Bölüm 6). Eşleştirilmiş test, farklar üzerinde \mu_0=0 ile yapılan tek örneklem testinin kendisidir.
- İki bağımsız grup karşılaştırılıyorsa: Bağımsız t Testi (Bölüm 5).
- Küçük örneklemde belirgin çarpıklık ya da aykırı değer varsa: medyanı \mu_0 ile karşılaştıran Wilcoxon işaretli sıra ya da İşaret Testi.
- Değişken ikili ise (oran sınanıyorsa): Binom testi.
- Amaç "fark yok" demekse: anlamsız p bunu göstermez; aynı modüldeki TOST eşdeğerlik satırı kullanılır (4.5.7).
Sık karıştırılan analizler. Z testi evren SS'sinin bilindiğini varsayar; MerQur'un bu modülü SS'yi veriden kestirir ve her zaman t dağılımını kullanır. Bayesçi t testinin tek örneklem modu (Bölüm 112) aynı t istatistiğinden Bayes faktörü üretir.
4.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Bağımsızlık | Her gözlem ayrı bir birimden gelir; gözlemler birbirini etkilemez. | Tasarımla sağlanır; istatistiksel denetimi yoktur. |
| Normallik | Değişken (ya da \bar x'in örnekleme dağılımı) yaklaşık normaldir. | Varsayılan açık Shapiro–Wilk (3\le n\le 5000); isteğe bağlı Kolmogorov–Smirnov (Lilliefors) (n\ge 5). |
| Ölçek | Sayısal değişken. | Sayıya çevrilemeyen değerler pd.to_numeric(..., errors="coerce") ile eksik sayılıp atılır. |
Eksik değer. Yalnız seçilen sütunda eksik olan satırlar çıkarılır (hypothesis.py:2932). Birden çok sütun seçilirse her sütun kendi geçerli değerleriyle ayrı test edilir; künyedeki n o sütunun eksiksiz değer sayısıdır (stats_panel.py:5039–5041).
Uç durumlar.
- n<2 ise hata: "Tek örneklem t-Testi için en az 2 gözlem gerekir" (
hypothesis.py:2934–2935). n=2 (\sd=1) geçerlidir. - Veri "neredeyse sabit" ise hata (
hypothesis.py:2938–2939). Ölçüt Rt.testile aynıdır: \SH<10\,\varepsilon\,|\bar x| ya da \SH=0 (\varepsilon=2{,}22\times10^{-16};_ttest_essentially_constant,hypothesis.py:288–295). - n<3 ya da n>5000 ise Shapiro–Wilk satırı yazılmaz; n<5 ise Lilliefors satırı yazılmaz (
hypothesis.py:631–645,671–681).
4.3 Parametreler
Varsayılanlar one_sample_ttest.py:38–97 ve _advanced_options.py içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Değer Sütunu | veriye bağlı | Sınanacak sayısal değişken; çoklu seçilebilir. | Birden çok sütunda her biri ayrı test edilir; çoklu karşılaştırma düzeltmesi yoktur. |
| Test edilen μ (μ₀) | 0 | Karşılaştırma değeri; 4 ondalık. | t, p, d ve farkın GA'sı değişir; ortalamanın GA'sı değişmez. |
| Güven Düzeyi | %95 | %90, %95, %99 ya da özel değer; \alpha=1-\text{düzey}. | GA genişliği ve H₀ kararı. |
| Hipotez yönü | Çift yönlü (≠) | Sağ yönlü: H_1:\mu>\mu_0; sol yönlü: H_1:\mu<\mu_0. | p tek kuyruktan; ana GA çift yönlü kalır, ek tek yönlü GA satırı yazılır. |
| Etki büyüklükleri: Hedges g | kapalı | g=d\cdot J(n-1). | Ek satır. |
| Etki büyüklükleri: %GA | kapalı | d için normal yaklaşımlı GA. | Ek satır. |
| Etki büyüklükleri: d GA (nct) | kapalı | d için merkezî olmayan t ile kesin GA. | Ek satır. |
| Varsayım kontrolleri: Shapiro | açık | Shapiro–Wilk W, p. | Yalnız bilgi. |
| Varsayım kontrolleri: K-S | kapalı | Lilliefors düzeltmeli Kolmogorov–Smirnov. | Yalnız bilgi. |
| Ek çıktı: Betimsel | açık | n, ortalama, SS, SH, medyan, en küçük/en büyük, çarpıklık, basıklık. | Ek bölüm. |
| Ek çıktı: Bootstrap GA | kapalı | Ortalama için 5000 yinelemeli yüzdelik GA. | Ek satır; Tohum ile tekrarlanabilir. |
| Eşdeğerlik testi: TOST, alt, üst | kapalı; −0,5 ve 0,5 | \bar x-\mu_0 için iki tek yönlü test (ham birim). | Ek bölüm. |
| Tohum | 12345 | Bootstrap rastgele sayı üreteci. | Yalnız bootstrap GA'sı. |
Neden TOST sınırları \bar x'e değil \bar x-\mu_0'a uygulanır?
TOST satırı farkı sınar: H_{01}:\ \bar x-\mu_0\le\Delta_L ve H_{02}:\ \bar x-\mu_0\ge\Delta_U (hypothesis.py:2996–3000, _tost_lines "M − μ₀" etiketiyle çağrılır). Bu nedenle sınırlar "μ₀ çevresinde kabul edilebilir sapma" olarak girilir: sistolik KB için ±10 mmHg yazmak "ortalama 110 ile 130 arasındadır" demektir. Varsayılan ±0,5 bir yer tutucudur ve ölçüm birimine göre mutlaka değiştirilmelidir.
4.4 Tıp örneği
Dosya: english/datasets/Tip/03_one_sample_t_systolic_bp.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/03_tek_orneklem_t_sistolik_KB.xlsx).
| Değişken | Rol | Tür | Açıklama |
|---|---|---|---|
systolic_bp |
Değer Sütunu | sürekli (mmHg) | Sistolik kan basıncı; ortalama 128,25, SS 14,08 |
patient_id, age, sex |
kullanılmaz |
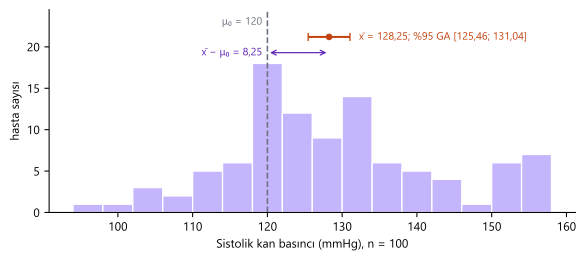
n ve eksik değer: 100 hasta, eksik değer yok.
Klinik soru: Bu hastaların ortalama sistolik kan basıncı 120 mmHg referans değerinden farklı mı? (VIDEO_SCRIPT_TR.txt, #3.)
Seçilen ayarlar: μ₀ = 120; arayüz varsayılanları (çift yönlü, %95, Shapiro ve Betimsel açık). Sayısal yürüyüş için tüm etki büyüklüğü kutuları, K-S, Bootstrap ve TOST (sınırlar −10 ve 10 mmHg) açılarak ikinci bir çalıştırma, sağ yönlü hipotezle üçüncü bir çalıştırma yapılmıştır.
Şekil 4.1. Sistolik kan basıncının dağılımı. Kesikli çizgi μ₀ = 120, turuncu nokta ve çubuk ortalama ve %95 GA'sıdır.
4.5 Formüller ve hesap adımları
MerQur'un sırası şudur: (1) sütunu sayıya çevir ve eksikleri at, (2) uç durumları denetle, (3) t ve p'yi scipy.stats.ttest_1samp ile hesapla, (4) ortalamanın ve farkın GA'sını kur, (5) d ve istenen ek etki büyüklüklerini, varsayım satırlarını, bootstrap ve TOST bölümlerini ekle.
4.5.1 Betimsel istatistikler
Ortalama, varyans ve SH bağımsız t testindeki tanımın tek grupluk hâlidir (bkz. 5.5.2):
- x_i: i. hastanın sistolik KB'si; n: geçerli gözlem sayısı.
- s: örneklem SS'si (
s.std(ddof=1),hypothesis.py:2943); \SH(\bar x): ortalamanın standart hatası.
Betimsel satırındaki çarpıklık ve basıklık pandas skew() ve kurt() ile hesaplanır; bunlar düzeltilmiş G_1 ve fazlalık basıklık G_2'dir (R e1071::skewness(type = 2) tanımı).
4.5.2 Test istatistiği ve p değeri
- t: ortalamanın \mu_0'dan uzaklığının kendi standart hatasına oranı.
- \sd=n-1: s hesaplanırken bir parametre (\bar x) kestirildiği için bir serbestlik derecesi kaybedilir.
- T_{n-1}: H₀ altında t'nin uyduğu, n-1 sd'li Student t dağılımı.
Neden z değil t dağılımı?
Payda evren SS'si \sigma yerine kestirilen s'yi içerir. Normallik altında (n-1)s^2/\sigma^2\sim\chi^2_{n-1} ve \bar x ile s^2 bağımsızdır; standart normal bir değişkenin bağımsız \sqrt{\chi^2_\nu/\nu}'ye oranı tanım gereği t_\nu dağılımına uyar (Student 1908). s'nin kendisi de değişken olduğu için kuyruklar normalden kalındır; n büyüdükçe t_{n-1} standart normale yaklaşır.
Karar p_val < alpha ile verilir (hypothesis.py:2951). Yıldız da seçilen \alpha'ya bağlıdır (_sig_alpha, hypothesis.py:249–256): p\ge\alpha ise "ns"; p<\alpha ise geleneksel eşikler (0,001; 0,01; 0,05), \alpha>0{,}05 ve 0{,}05\le p<\alpha ise "*". Böylece yıldız ile karar hiçbir güven düzeyinde çelişmez.
4.5.3 Güven aralıkları: ortalama ve fark
MerQur iki ayrı aralık verir. Ana sonuç nesnesinin ci_lower/ci_upper alanları ortalamanın GA'sıdır (hypothesis.py:2946–2948); "Ortalama farkı" satırı farkın GA'sını verir (hypothesis.py:2982–2995):
- t_{1-\alpha/2,\,n-1}: t_{n-1} dağılımının 1-\alpha/2 kantili (%95'te \alpha/2=0{,}025).
- İkinci aralık birincinin \mu_0 kadar kaydırılmış hâlidir; \mu_0 birinci aralığın içindeyse ikinci aralık 0'ı içerir ve çift yönlü test H₀'ı reddedemez.
Tek yönlü hipotezde ek satır, t_{1-\alpha} kantiliyle tek yönlü aralığı verir: sağ yönlüde [\,(\bar x-\mu_0)-t_{1-\alpha}\SH,\ \infty) (_one_sided_ci, hypothesis.py:1898–1904).
Koddaki tercih
R t.test(x, mu = …) yalnız ortalamanın GA'sını verir. MerQur ikisini de yazar. Çıktıyı R ile karşılaştırırken t.test GA'sından \mu_0 çıkarılmalıdır.
4.5.4 Cohen d ve Hedges g
- d: farkın SS birimindeki büyüklüğü; işareti farkın yönünü gösterir (
hypothesis.py:2944). Etiket |d|'ye göredir (0,2 / 0,5 / 0,8). - J: küçük örneklem yanlılık düzeltmesi; kesin gama biçimi, \nu=n-1 (
_hedges_J,hypothesis.py:298–307). Ayrıntısı ve "neden"i 5.5.8'dedir. - d=t/\sqrt n özdeşliği vardır; bu yüzden d'nin kesin GA'sı t'nin dağılımından kurulabilir.
4.5.5 d için güven aralıkları
Normal yaklaşım (_d_se, hypothesis.py:323–325; _d_ci, 329–331):
- \SH_d: d'nin büyük örneklem standart hatası; ilk terim ortalamanın, ikinci terim s'nin örnekleme değişkenliğinden gelir.
- z_{1-\alpha/2}: standart normal kantil (%95'te 1,959964).
Kesin aralık (_nct_ci, hypothesis.py:1807–1827): t, merkezî olmama parametresi \lambda=\delta\sqrt n olan merkezî olmayan t dağılımına uyar. \lambda'nın sınırları
denklemlerinin kökleridir; d sınırları \lambda/\sqrt n'dir (hypothesis.py:2968–2971). Yöntem bağımsız t testindekiyle aynıdır (5.5.8); yalnız ölçek çarpanı \sqrt{1/n_1+1/n_2} yerine 1/\sqrt n'dir.
4.5.6 Normallik satırları ve bootstrap
Shapiro–Wilk scipy.stats.shapiro ile hesaplanır. Lilliefors satırı lilliefors_nortest ile (stats/normality.py:117–150) R nortest::lillie.test ile aynı tanımı kullanır: D=\max_i\{\,i/n-\Phi(z_{(i)}),\ \Phi(z_{(i)})-(i-1)/n\,\}, z=(x-\bar x)/s; p Dallal–Wilkinson (1986) yaklaşımından gelir. Ortalama ve SS veriden kestirildiği için düz Kolmogorov–Smirnov p'si kullanılmaz (Lilliefors 1967).
Bootstrap GA (_boot_ci, hypothesis.py:337–345): veri yerine koyarak B=5000 kez yeniden örneklenir, her örneklemin ortalaması alınır ve \alpha/2, 1-\alpha/2 yüzdelikleri raporlanır. Üreteç numpy.random.default_rng(tohum)'dur; sınırlar 4 ondalığa yuvarlanır.
4.5.7 TOST
- \Delta_L,\ \Delta_U: eşdeğerlik sınırları (ham birim, \Delta_L<\Delta_U; aksi hâlde hata,
hypothesis.py:1875–1876). - p_{\text{TOST}}<\alpha ise eşdeğerlik kabul edilir; bu, (1-2\alpha) GA'nın [\Delta_L,\Delta_U] içinde kalmasıyla aynı karardır (Schuirmann 1987).
4.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/ttest_one/elle_hesap.py ile, MerQur kodu çağrılmadan hesaplanmıştır.
Adım 1 — Ortalama ve fark.
Adım 2 — Kareler toplamı, SS, SH.
Adım 3 — t ve p.
Sağ yönlü hipotezde p=3{,}04\times10^{-8} (çift yönlünün yarısı, çünkü t>0).
Adım 4 — Güven aralıkları. t_{0{,}975;\,99}=1{,}984217; yarı genişlik 1{,}984217\times1{,}407726=2{,}793233.
Sağ yönlü tek taraflı aralık: t_{0{,}95;\,99}=1{,}660391; 8{,}25-1{,}660391\times1{,}407726=5{,}912625, yani [5{,}912625;\ \infty).
Adım 5 — Etki büyüklükleri.
Yaklaşık J=1-3/(4\cdot99-1)=0{,}992405 ile g=0{,}581601 olurdu; fark 2\times10^{-6}'dır.
Merkezî olmayan t ile: \lambda_{\text{alt}}=3{,}725055, \lambda_{\text{üst}}=7{,}970574; \sqrt{100}=10'a bölünce [0{,}372505;\ 0{,}797057].
Adım 6 — Varsayım ve ek satırlar.
| Satır | Değer | MerQur etiketi |
|---|---|---|
| Shapiro–Wilk | W=0{,}9685, p=0{,}0171 | İHLAL |
| Lilliefors | D=0{,}0915, p=0{,}0384 | İHLAL |
| Çarpıklık / basıklık | 0{,}346 / -0{,}310 | |
| Bootstrap %95 GA (tohum 12345) | [125{,}50;\ 131{,}00] | |
| TOST (\pm10): t_1, p_1 | 12{,}964172; 2{,}32\times10^{-23} | |
| TOST: t_2, p_2 | -1{,}243140; 0{,}108376 | |
| TOST %90 GA | [5{,}912625;\ 10{,}587375] | eşdeğerlik gösterilemedi |
İki normallik testi de p<0{,}05 verir. Çarpıklık hafif sağa (0,35), basıklık normalden biraz düşüktür. n=100'de ortalamanın örnekleme dağılımı merkezi limit teoremiyle normale çok yakındır; dağılımdan bağımsız bootstrap aralığı [125{,}50;\ 131{,}00], t aralığıyla ([125{,}46;\ 131{,}04]) neredeyse aynıdır.
TOST'ta %90 GA'nın üst sınırı 10,59, \Delta_U=10'u aştığı için ortalamanın 120 ± 10 aralığında olduğu gösterilemez. Aynı veride klasik test "fark var" der; bu iki sonuç çelişmez: fark sıfırdan büyüktür, ama 10 mmHg'den küçük olduğu da kanıtlanamamıştır.
4.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan, stats.hypothesis modülünde yalnız round() bellekte etkisizleştirilerek alınmıştır (dogrulama/ttest_one/merqur_calistir.py). Yalnız metinde yazılan değerler gösterilen ondalıkta, _p_sig8 ile 4 anlamlı basamakta saklanan p_1 4 anlamlı basamakta karşılaştırılmıştır. R: 4.5.3, t.test, effectsize::cohens_d/hedges_g, shapiro.test, nortest::lillie.test; bootstrap R'da aynı üreteçle üretilemediği için yalnız Python ile (aynı algoritma ve tohum) karşılaştırılmıştır.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Ortalama \bar x | 128,250000 | 128,250000 | 128,250000 | 0,0e+00 | ✓ |
| SS s | 14,077258 | 14,077258 | 14,077258 | 1,6e−14 | ✓ |
| SH s/\sqrt n | 1,407726 | 1,407726 | 1,407726 | 1,6e−15 | ✓ |
| Ortalama farkı \bar x-\mu_0 | 8,250000 | 8,250000 | 8,250000 | 0,0e+00 | ✓ |
| t | 5,860516 | 5,860516 | 5,860516 | 1,8e−15 | ✓ |
| sd | 99 | 99 | 99 | 0,0e+00 | ✓ |
| p (çift yönlü) | 6,0735·10−8 | 6,0735·10−8 | 6,0735·10−8 | 2,1e−22 | ✓ |
| p (sağ yönlü) | 3,0367·10−8 | 3,0367·10−8 | 3,0367·10−8 | 1,1e−22 | ✓ |
| Ortalamanın %95 GA alt | 125,456767 | 125,456767 | 125,456767 | 1,1e−10 | ✓ |
| Ortalamanın %95 GA üst | 131,043233 | 131,043233 | 131,043233 | 1,1e−10 | ✓ |
| Farkın %95 GA alt | 5,456767 | 5,456767 | 5,456767 | 1,1e−10 | ✓ |
| Farkın %95 GA üst | 11,043233 | 11,043233 | 11,043233 | 1,1e−10 | ✓ |
| Tek yönlü %95 GA alt (sağ) | 5,912625 | 5,912625 | 5,912625 | 2,9e−11 | ✓ |
| Cohen d | 0,586052 | 0,586052 | 0,586052 | 1,1e−16 | ✓ |
| Hedges g | 0,5816 | 0,581599 | 0,581599 | 5,0e−15 | ✓ (4 ondalık) |
| d %95 GA alt (normal) | 0,3739 | 0,373893 | 0,373893 | 5,0e−16 | ✓ (4 ondalık) |
| d %95 GA üst (normal) | 0,7982 | 0,798211 | 0,798211 | 2,2e−16 | ✓ (4 ondalık) |
| d %95 GA alt (nct) | 0,372505 | 0,372505 | 0,372505 | 1,2e−09 | ✓ |
| d %95 GA üst (nct) | 0,797057 | 0,797057 | 0,797057 | 2,5e−09 | ✓ |
| Shapiro–Wilk W | 0,9685 | 0,968531 | 0,968531 | 2,2e−12 | ✓ (4 ondalık) |
| Shapiro–Wilk p | 0,0171 | 0,017082 | 0,017082 | 6,8e−12 | ✓ (4 ondalık) |
| Lilliefors D | 0,0915 | 0,091468 | 0,091468 | 0,0e+00 | ✓ (4 ondalık) |
| Lilliefors p | 0,0384 | 0,038394 | 0,038394 | 1,4e−17 | ✓ (4 ondalık) |
| Çarpıklık | 0,346 | 0,345708 | 0,345708 | 2,2e−16 | ✓ (3 ondalık) |
| Basıklık | −0,310 | −0,309801 | −0,309801 | 5,0e−16 | ✓ (3 ondalık) |
| TOST t_1 | 12,964172 | 12,964172 | 12,964172 | 5,3e−15 | ✓ |
| TOST p_1 | 2,3230·10−23 | 2,3232·10−23 | 2,3232·10−23 | 2,6e−38 | ✓ (4 anlamlı) |
| TOST t_2 | −1,243140 | −1,243140 | −1,243140 | 2,0e−15 | ✓ |
| TOST p_2 = p_{\text{TOST}} | 0,108376 | 0,108376 | 0,108376 | 4,7e−16 | ✓ |
| TOST %90 GA alt | 5,912625 | 5,912625 | 5,912625 | 2,9e−11 | ✓ |
| TOST %90 GA üst | 10,587375 | 10,587375 | 10,587375 | 2,9e−11 | ✓ |
| Bootstrap %95 GA alt (tohum 12345) | 125,5000 | 125,5000 | — | 0,0e+00 | ✓ (4 ondalık) |
| Bootstrap %95 GA üst (tohum 12345) | 131,0000 | 131,0000 | — | 0,0e+00 | ✓ (4 ondalık) |
Sonuç: 33 büyüklüğün tamamı ölçütü karşılar. En büyük fark d'nin nct GA sınırında 2{,}5\times10^{-9}'dur (kök bulma toleransı).
4.7 Çıktıyı okuma
Varsayılan ayarlarla sonuç metni (kısaltılmış):
Tek Örneklem t(99) = 5.8605, p = 6.073e-08 ***. Cohen d = 0.586 (Orta etki). Test edilen μ = 120.0; örnek ort. = 128.2500. H₀ REDDEDİLİR.
    Ortalama farkı = 8.2500, SE = 1.4077, %95 GA [5.4568, 11.0432]
── VARSAYIM KONTROLLERİ ──
Shapiro–Wilk [systolic_bp]: W = 0.9685, p = 0.0171 → İHLAL
── BETİMSEL İSTATİSTİKLER ──
    systolic_bp: n=100, M=128.2500, SD=14.0773, SE=1.4077, medyan=126.0000, ...
| Satır | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| İlk satır | t, sd, p, yıldız, d ve etiketi, \mu_0, \bar x, karar | p, 10^{-4}'ün altında 4 anlamlı basamakla yazılır (hypothesis.py:2954). |
| Ortalama farkı | \bar x-\mu_0, SH ve farkın GA'sı | GA 0'ı içermiyor: ortalama 120'den 5,5–11,0 mmHg yüksek. |
| Tabloda "GA (ortalama için)" | Ortalamanın GA'sı ([125{,}46;\ 131{,}04]) | Etiketin söylediği gibi farkın değil, ortalamanın aralığıdır. |
| VARSAYIM KONTROLLERİ | "İHLAL" ya da "karşılanıyor" | Etiket yalnız p<\alpha demektir; testi değiştirmez. |
| Alternatif hipotez satırı | Tek yönlü seçimde yön | p tek kuyrukludur; ana GA çift yönlü kalır. |
| APA satırı | t(99) = 5.86, p < .001, d = 0.59 |
Ondalık noktalıdır; Türkçe metne virgülle aktarılır. |
APA biçiminde rapor cümlesi:
Hastaların ortalama sistolik kan basıncı (O = 128,25 mmHg; SS = 14,08; n = 100) 120 mmHg referans değerinden anlamlı düzeyde yüksekti; t(99) = 5{,}86, p < 0{,}001. Ortalama fark 8,25 mmHg'dir (%95 GA [5,46; 11,04]) ve etki büyüklüğü ortadır (Cohen d = 0{,}59; %95 GA [0,37; 0,80]).
4.8 Uzman soruları
S1. Tablodaki GA ile "Ortalama farkı" satırındaki GA neden farklı?
Biri ortalamanın, diğeri \bar x-\mu_0'ın aralığıdır (hypothesis.py:2946–2948 ve 2982–2995); ikincisi birincinin \mu_0 kadar kaydırılmış hâlidir. R t.test yalnız ortalamanın aralığını verir.
S2. n = 2 ile test yapılabiliyor mu?
Evet. Kod n\ge2 ister (hypothesis.py:2934); \sd=1'de t dağılımı tanımlıdır ama Cauchy dağılımıdır ve kuyrukları çok kalındır, t_{0{,}975;\,1}=12{,}71. Shapiro–Wilk n<3'te yazılmaz.
S3. Tüm değerler aynıysa ne olur?
s=0 olduğundan t tanımsızdır. MerQur R t.test ile aynı ölçütle ("data are essentially constant") durur: \SH<10\,\varepsilon\,|\bar x| (hypothesis.py:288–295). Bu, kayan nokta hatasıyla oluşan 10^{-15} düzeyindeki yapay SS'lerin dev t değerleri üretmesini de engeller.
S4. Hedges g için hangi J kullanılıyor?
Kesin gama biçimi, \nu=n-1 ile (hypothesis.py:2962, _hedges_J). R effectsize::hedges_g(x, mu = …) ile 5\times10^{-15} düzeyinde aynıdır. Yaklaşık 1-3/(4\nu-1) biçimiyle fark bu veride 2\times10^{-6}'dır.
S5. d için iki GA var; hangisi raporlanmalı?
Normallik altında kesin olan merkezî olmayan t aralığıdır ([0{,}3725;\ 0{,}7971]). Normal yaklaşım ([0{,}3739;\ 0{,}7982]) simetriktir ve büyük |d|'de sapar. Yayında nct aralığı tercih edilmelidir.
S6. Shapiro–Wilk ve Lilliefors normallik ihlali gösteriyor. t testi geçersiz mi?
Hayır. t testi \bar x'in örnekleme dağılımının normalliğine dayanır; n=100'de hafif çarpıklık (0,35) bunu bozmaz. Büyük n'de normallik testleri önemsiz sapmalarda da anlamlı çıkar. Bootstrap GA t aralığıyla neredeyse aynıdır. Duyarlılık için Wilcoxon işaretli sıra testi raporlanabilir.
S7. Lilliefors p'si neden statsmodels'tan farklı olabilir?
MerQur nortest::lillie.test'in kullandığı Dallal–Wilkinson yaklaşımını ve p>0{,}1 bölgesinde Stephens formülünü kullanır (stats/normality.py:117). statsmodels lilliefors varsayılan olarak tablo ara değerlemesi yapar ve orta bölgede farklı p verir.
S8. Tek yönlü testte nct GA da tek yönlü mü?
Hayır. d'nin nct aralığı her durumda iki yönlü (1-\alpha) aralığıdır; kod tek yönlü seçimde t'yi (\bar x-\mu_0)/\SH olarak yeniden hesaplar (hypothesis.py:2968–2969), ama bu sayı ttest_1samp'in t'siyle aynıdır. Tek yönlü aralık yalnız ham farkta verilir.
S9. Yıldız neden seçilen \alpha'ya bağlı?
Yıldız, karar satırının kısa gösterimidir. Sabit 0,05 eşiğine bakan bir yıldız, %99 güven düzeyinde 0{,}01<p<0{,}05 için "*" ile "H₀ REDDEDİLEMEZ"i yan yana yazardı. MerQur bu yüzden p\ge\alpha'da "ns" basar, yıldızları yalnız p<\alpha'da geleneksel eşiklerle verir (4.5.2). Raporlamada yine p'nin kendisi yazılmalıdır.
4.9 Sık hatalar ve tuzaklar
- μ₀'ı girmeyi unutmak. Varsayılan \mu_0=0'dır; sistolik KB gibi sıfırdan uzak bir değişkende dev bir t ve "Büyük etki" çıkar. Sonuç anlamsızdır.
- Tablodaki GA'yı fark aralığı sanmak. Tablo ortalamanın aralığını verir; fark aralığı metindeki "Ortalama farkı" satırındadır.
- Öncesi–sonrası veriyi iki ayrı tek örneklem testiyle çözümlemek. İki ölçüm ayrı ayrı bir normla karşılaştırılırsa hasta içi korelasyon yok sayılır. Doğru yol eşleştirilmiş t testidir.
- Çoklu sütunda düzeltme yapmamak. Her sütun ayrı test edilir; Bonferroni ya da Holm uygulanmaz.
- TOST sınırlarını varsayılanda bırakmak. ±0,5 bir yer tutucudur; sınırlar ölçüm biriminde ve klinik gerekçeyle, veriden önce belirlenmelidir.
- APA satırını olduğu gibi kopyalamak. Ondalık noktalıdır.
4.10 Kaynaklar
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2. baskı). Lawrence Erlbaum. (Routledge yeniden basımı: https://doi.org/10.4324/9780203771587)
- Cumming, G., & Finch, S. (2001). A primer on the understanding, use, and calculation of confidence intervals that are based on central and noncentral distributions. Educational and Psychological Measurement, 61(4), 532–574. https://doi.org/10.1177/0013164401614002
- Dallal, G. E., & Wilkinson, L. (1986). An analytic approximation to the distribution of Lilliefors's test statistic for normality. The American Statistician, 40(4), 294–296. https://doi.org/10.1080/00031305.1986.10475419
- Efron, B. (1979). Bootstrap methods: Another look at the jackknife. The Annals of Statistics, 7(1), 1–26. https://doi.org/10.1214/aos/1176344552
- Hedges, L. V. (1981). Distribution theory for Glass's estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107–128. https://doi.org/10.3102/10769986006002107
- Lakens, D., Scheel, A. M., & Isager, P. M. (2018). Equivalence testing for psychological research: A tutorial. Advances in Methods and Practices in Psychological Science, 1(2), 259–269. https://doi.org/10.1177/2515245918770963
- Lilliefors, H. W. (1967). On the Kolmogorov–Smirnov test for normality with mean and variance unknown. Journal of the American Statistical Association, 62(318), 399–402. https://doi.org/10.1080/01621459.1967.10482916
- Schuirmann, D. J. (1987). A comparison of the two one-sided tests procedure and the power approach for assessing the equivalence of average bioavailability. Journal of Pharmacokinetics and Biopharmaceutics, 15(6), 657–680. https://doi.org/10.1007/BF01068419
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3–4), 591–611. https://doi.org/10.1093/biomet/52.3-4.591
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1