66. Karmaşıklık Matrisi Metrikleri
Analiz kimliği: confusion_metrics · Menü adı: Confusion Matrix Metrics · Panel ve motor: gui/panels/analyses/confusion_metrics.py (form 105–199, execute 246–428, ek testler _q5_tests 443–465, çok sınıflı _q5_multiclass 468–522, bootstrap _q5_boot 538–558, metin 651–763); Kappa SE stats/classification_eval.py, _kappa_stats (883–907)
66.1 Ne işe yarar
Karmaşıklık matrisi (confusion matrix), bir sınıflayıcının ya da tanı testinin önceden üretilmiş ikili tahminlerini gerçek sınıflarla 2×2 tabloda karşılaştırır. MerQur bu tablodan on temel metrik (doğruluk, duyarlılık, özgüllük, PPV, NPV, F1, MCC, dengeli doğruluk, Cohen κ, Youden J), STARD'ın istediği tanı oranlarını (LR+, LR−, tanısal OR, prevalans) ve isteğe bağlı testleri hesaplar. Cevapladığı soru şudur: "Bu tahminler gerçek durumu ne kadar ve hangi yönde doğru yakalıyor?"
| Tahmin + | Tahmin − | |
|---|---|---|
| Gerçek + | DP (doğru pozitif, TP) | YN (yanlış negatif, FN) |
| Gerçek − | YP (yanlış pozitif, FP) | DN (doğru negatif, TN) |
Model uydurulmaz, eşik seçilmez: tahmin sütunu zaten sınıf etiketidir. Bu yüzden analiz, ROC (Bölüm 64) ve TSS'in (Bölüm 65) tamamlayıcısıdır: onlar eşiği bulur, bu panel bulunan eşikteki başarımı ayrıntılı raporlar.
Ne zaman kullanılır?
- Yeni bir tanı testinin altın standarda göre doğruluğunu STARD biçiminde raporlamak için.
- Bir makine öğrenmesi modelinin test kümesi tahminlerini değerlendirmek için.
- İki sınıfı aşan durumlarda sınıf bazında (bire-karşı-diğerleri) ve makro/ağırlıklı özetler için.
Ne zaman kullanılmaz?
- Tahmin sürekli bir skor ya da olasılıksa ve eşik henüz seçilmediyse: ROC Curve (Bölüm 64) ya da TSS (Bölüm 65).
- Soru iki değerlendiricinin uyumuysa (ikisi de "gerçek" değil): Cohen's Kappa (Bölüm 29).
- Soru iki eşleşik oranın farkıysa (eski/yeni test aynı hastalarda): McNemar (Bölüm 28); bu paneldeki McNemar yalnız tahmin ile gerçek arasındaki sistematik sapmayı sınar.
Sık karıştırılan analizler. Ki-kare bağımsızlık testi (Bölüm 25) tahmin ile gerçeğin ilişkili olup olmadığını sorar; ilişki ters yönde de olabilir. Cohen κ bu panelde de verilir, ama burada iki sütun simetrik değildir: biri gerçektir. Doğruluk, dengesiz sınıflarda yanıltır; MCC ve dengeli doğruluk bu nedenle eklenmiştir.
66.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Gerçek sütunu en az iki sınıf içerir | Pozitif ve negatif örnek var. | Tek sınıfsa hata (confusion_metrics.py:279–282). |
| Pozitif sınıf gerçekte bulunur | Seçilen değer hedef sütunda. | Yoksa hata (:269–274). |
| Aynı kodlama | Tahmin ve gerçek aynı etiketleri kullanır. | Tip bağımsız eşleşme: 1, 1.0, "1" aynı (:212–218). |
| Bağımsız birimler | Her satır ayrı birim. | Denetlenmez. |
| Altın standart doğru | Gerçek sütun hatasız. | Denetlenmez. |
Eksik değer. İki sütundan birinde eksik olan satır atılır (confusion_metrics.py:271): liste bazında silme.
Uç durumlar.
- Geçerli satır yoksa hata (
:259–260). - Paydası sıfır olan oran (ör. hiç pozitif tahmin yoksa PPV) tanımsızdır: NaN saklanır, "—" yazılır, uyarı eklenir (
:285–293,:351–352). - Bir hücre 0 ise uyarı (
:349–350); LR, DOR ve log-GA'ları tanımsız olabilir (:323–343). - n < 30 ise küçük örneklem uyarısı (
:347–348). - Gerçek ya da tahminde ikiden çok sınıf varsa çok sınıflı özet kendiliğinden açılır; üstteki ölçüler "pozitif sınıf karşı diğerleri" olur (
:357–359).
66.3 Parametreler
Varsayılanlar confusion_metrics.py:105–207 ve stats_panel.py:7012–7048 içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Hedef (gerçek) | ilk kategorik sütun | Gerçek sınıf. | |
| Tahmin | ilk kategorik sütun | Tahmin edilen sınıf; hedefle aynı olamaz. | |
| Pozitif sınıf | Otomatik (ortak olay kuralı: 0/1'de 1, 1/2'de 2; iki düzeyden yalnız biri tanınan olumlu etiketse (evet, yes, var, present, pozitif …) o düzey; aksi hâlde düzey sırasındaki ikinci değer ve uyarı) | DP/YN'nin "pozitif" saydığı değer. | Se ↔ Sp, PPV ↔ NPV yer değiştirir; doğruluk, MCC, κ, dengeli doğruluk, J, DOR değişmez. |
| Güven Düzeyi | %95 | \alpha | Wilson, log, Clopper–Pearson, κ ve bootstrap GA'ları. |
| Ek çıktılar: Kappa SE/GA + McNemar + NIR testi | kapalı | κ ASE ve testi, McNemar (düzeltmeli, düzeltmesiz, kesin), doğruluk > NIR testi. | Ek blok ve tablo satırları. |
| Ek çıktılar: Çok sınıflı matris | kapalı | Sınıf bazlı ölçüler, makro/ağırlıklı ortalamalar. | İkiden çok sınıfta kendiliğinden açılır. |
| Ek çıktılar: F1/MCC/BA/Youden bootstrap GA | kapalı | Yüzdelik bootstrap GA. | B = 2000, tohum 42 (formda yok). |
Pozitif sınıf neden önemli, MCC neden değişmiyor?
Duyarlılık "gerçek pozitiflerin yakalanma oranı"dır; pozitif sınıfı değiştirmek tabloyu çapraz çevirir ve duyarlılık ile özgüllük, PPV ile NPV yer değiştirir. F1 yalnız pozitif sınıfa bakar (DN'yi hiç kullanmaz), bu yüzden değişir: Tıp #62'de pozitif = 1 için 0,9231, pozitif = 0 için 0,9508. MCC, κ, doğruluk, dengeli doğruluk, J ve DOR dört hücrenin simetrik fonksiyonlarıdır; değişmezler. Varsayılan pozitif, ROC ve TSS panelleriyle aynı kuralla düzey sırasındaki ikinci değerdir; metin etiketlerde ("hasta"/"sağlam") düzey sırası MerQur'un genel kuralından gelir (Bölüm 66.8 S5).
66.4 Tıp örneği
Dosya: english/datasets/Tip/62_complexity_diabetes_class.xlsx (Türkçe kopya: samples/Tum_Analiz_Tip/62_karmasiklik_diabet_sinif.xlsx).
| Değişken | Rol | Tür | Açıklama/özet |
|---|---|---|---|
actual_diagnosis |
Hedef (gerçek) | ikili (0/1) | 1 = diyabet; 75 pozitif, 125 negatif |
prediction_diagnosis |
Tahmin | ikili (0/1) | 81 pozitif, 119 negatif tahmin |
prediction_score |
kullanılmaz | sürekli | Tahminin dayandığı skor (ROC/TSS için) |
patient_id |
kullanılmaz | 1–200 |
n ve eksik değer: 200 hasta, eksik değer yok.
Klinik soru: Bir tanı sınıflayıcısının diyabet tahminleri gerçek tanılarla ne kadar uyuşuyor? (VIDEO_SCRIPT_TR.txt, #62.)
Seçilen ayarlar: Arayüz varsayılanı (pozitif = 1, %95). Sayısal yürüyüş için ayrıca bütün ek çıktılar, %99 güven düzeyi ve pozitif = 0 çalıştırılmıştır. Tıp verisi ikili olduğundan çok sınıflı özet iki sınıfla gösterilmiştir.
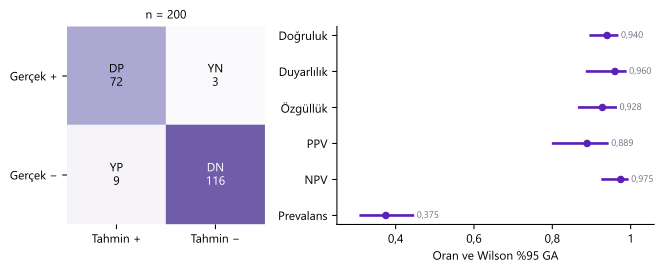
Şekil 66.1. Solda Tıp #62'nin 2×2 karmaşıklık matrisi; sağda oran metrikleri ve Wilson %95 GA'ları. Prevalans GA'sı, örneklem tasarımı vaka–kontrol değilse hastalık sıklığının kestirimidir.
66.5 Formüller ve hesap adımları
MerQur'un sırası şudur: (1) iki sütunda eksik olan satırları sil, (2) sınıfları tip bağımsız anahtarla eşle, (3) pozitif sınıfa göre y ve \hat y'yi 0/1'e çevir ve 2×2 tabloyu kur, (4) on metrik (paydası sıfır olanlar NaN), (5) Wilson GA'ları, (6) LR+, LR−, DOR ve log-GA'ları, prevalans ve tespit oranları, (7) istenen ekler: κ testi, McNemar, NIR testi, çok sınıflı özet, bootstrap.
66.5.1 Oran metrikleri ve Wilson GA
- N: analize giren satır sayısı. Doğruluk sklearn
accuracy_scoreile (confusion_metrics.py:323); öteki dört oran dört hücreden doğrudan (:314–317). - Her birinin GA'sı Wilson skor aralığıdır,
statsmodelsproportion_confint(method="wilson")ile (:302–314); formül Bölüm 64.5.6.
Neden Wilson, neden Wald değil?
Wald aralığı \hat p\pm z\sqrt{\hat p(1-\hat p)/N}, oran 0 ya da 1'e yakınken (duyarlılık 0,96 gibi) kapsama olasılığını tutturamaz ve sınırı 1'in üstüne taşıyabilir. Wilson aralığı skor testini tersine çevirir; asimetriktir, [0;\ 1] içinde kalır ve küçük N'de de nominal kapsamaya yakındır (Newcombe 1998). Bu veride duyarlılık 0,96 için Wilson [0,889; 0,986]'dır; Wald [0,916; 1,004] olurdu.
66.5.2 Bileşik metrikler
- F_1: PPV ile duyarlılığın harmonik ortalaması; DN'yi kullanmaz. Paydası 0 ise NaN (
:291). - MCC: gerçek ve tahmin 0/1 değişkenleri arasındaki Pearson korelasyonu (φ katsayısı), [-1;\ 1]; sklearn
matthews_corrcoef(:296), payda 0 ise 0 döner. - BA (dengeli doğruluk): sklearn
balanced_accuracy_score; J: Youden indeksi (= TSS). - \hat\kappa: sklearn
cohen_kappa_score; p_o doğruluk, p_e=\big[(\text{DP}+\text{YN})(\text{DP}+\text{YP})+(\text{DN}+\text{YP})(\text{DN}+\text{YN})\big]/N^2.
Neden MCC?
Doğruluk ve F1, sınıflardan biri baskınken yanıltır: %95'i negatif bir veride herkese "negatif" demek %95 doğruluk verir. MCC dört hücrenin tamamını kullanır ve yalnız iki sınıfı da iyi tahmin eden bir model yüksek MCC alır (Chicco ve Jurman 2020). Yorum bloğu |MCC| ≥ 0,7'yi güçlü, < 0,2'yi zayıf sayar (confusion_metrics.py:755–762); dengeli doğruluk doğruluktan 0,05'ten fazla düşükse dengesizlik uyarısı verir (:747–753).
66.5.3 STARD tanı oranları
- GA: \widehat{\text{LR}}\cdot\exp(\mp z\,\text{SE}_{\ln}); log yöntemi (Simel, Samsa ve Matchar 1991),
epiR::epi.testsile aynı (confusion_metrics.py:345–371). - \text{SE}(\ln\text{LR}^{-}): aynı biçimde YN ve DN ile.
- Bir hücre 0 ise ilgili oran ve GA tanımsızdır ("—"); MerQur 0,5 eklemesi (Haldane) yapmaz.
- Prevalans (\text{DP}+\text{YN})/N Wilson GA'lı; tespit oranı \text{DP}/N, tespit prevalansı (\text{DP}+\text{YP})/N (caret tanımları).
LR neden prevalanstan bağımsız, PPV neden değil?
LR'ler yalnız Se ve Sp'ye bağlıdır; Bayes kuralında ön-test odds'unu son-test odds'una çevirir: \text{odds}_{\text{son}}=\text{odds}_{\text{ön}}\cdot\text{LR}. PPV ise prevalansla birlikte değişir; aynı test, prevalansı %37,5 olan bu örneklemde PPV 0,889 verirken prevalansı %5 olan bir tarama nüfusunda çok daha düşük PPV verir. Bu yüzden STARD, tanı doğruluğunu LR ya da Se/Sp ile, uygulama değerini PPV/NPV ile raporlamayı önerir.
66.5.4 Ek testler: κ, McNemar, doğruluk > NIR
κ testi (_kappa_stats, classification_eval.py:883–907): ASE (H₁) ile GA, SE₀ (H₀) ile z; formüller Bölüm 65.5.5 ve 29.5.3. Tablo satır gerçek, sütun tahmindir.
McNemar (confusion_metrics.py:450–463), b=\text{YN}, c=\text{YP}:
- H₀: modelin yanlış pozitif ve yanlış negatif sayısı eşit, yani tahminlerin pozitif oranı gerçek prevalansa eşit (marjinal homojenlik).
- Düzeltmeli \chi^2 R
mcnemar.testve caret varsayılanı; ayrıca düzeltmesiz \chi^2 ve kesin p (iki yönlü binom). Üçü de yazılır.
Doğruluk için kesin GA ve NIR testi (_acc_nir, :405–412):
- k=\text{DP}+\text{DN}: doğru sınıflanan sayı; B_q(a,b): Beta dağılımının q yüzdeliği (Clopper–Pearson).
- NIR (no-information rate): herkese çoğunluk sınıfını söyleyen modelin doğruluğu; m, n gerçek pozitif ve negatif sayıları.
- Tek yönlü test: H₁: doğruluk > NIR. caret
confusionMatrixile aynı (AccuracyLower/Upper, AccuracyPValue).
Aynı tabloda iki farklı doğruluk GA'sı
Ana metrik bloğundaki doğruluk GA'sı Wilson'dır ([0,8981; 0,9653]); ek bloktaki "kesin GA" Clopper–Pearson'dır ([0,8975; 0,9686]). İkisi de doğrudur, farklı yöntemlerdir. caret ile karşılaştırırken kesin GA'yı, epiR ile karşılaştırırken yöntemi denetleyin.
66.5.5 Çok sınıflı özet ve bootstrap
Çok sınıflı (confusion_metrics.py:468–522): K\times K matris (satır gerçek, sütun tahmin); sınıflar MerQur'un düzey sırasıyla dizilir: Veri sekmesinde tanımlı sıra, yoksa sayısal ya da doğal sıra, o da yoksa verideki ilk görülme sırası. Her sınıf c için bire-karşı-diğerleri: \text{DP}_c=M_{cc}, \text{YN}_c=\sum_jM_{cj}-M_{cc}, \text{YP}_c=\sum_iM_{ic}-M_{cc}.
- K': gerçekte en az bir gözlemi olan sınıf sayısı; tanımsız (NaN) ölçüler ortalamaya girmez.
- n_c: c sınıfının gerçek sıklığı (destek). Mikro F1 tek etiketli sınıflamada doğruluğa eşittir.
- Çok sınıflı κ aynı
_kappa_statsile K\times K tablodan; doğruluk GA'sı ve NIR testi yukarıdaki gibi.
Bootstrap (:510–530): satırlar yerine koyarak çekilir (B=2000, default_rng(42)), tek sınıflı örnekler atlanır; F1, MCC, BA ve J için yüzdelik GA. Payda 0 olduğunda bootstrap içinde F1 ve MCC 0 sayılır.
66.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/confusion_metrics/elle_hesap.py ile, MerQur kodu çağrılmadan hesaplanmıştır.
Adım 1 — Tablo.
| Tahmin + | Tahmin − | Toplam | |
|---|---|---|---|
| Gerçek + | DP = 72 | YN = 3 | 75 |
| Gerçek − | YP = 9 | DN = 116 | 125 |
| Toplam | 81 | 119 | 200 |
Adım 2 — Oranlar. Doğruluk = 188/200 = 0,9400; Se = 72/75 = 0,9600; Sp = 116/125 = 0,9280; PPV = 72/81 = 0,8889; NPV = 116/119 = 0,9748. Duyarlılığın Wilson GA'sı (N=75, z^2=3{,}8415):
Adım 3 — Bileşik metrikler.
BA = (0,96 + 0,928)/2 = 0,9440; J = 0,8880. κ: p_o=0{,}94, p_e=(75\cdot81+125\cdot119)/40000=0{,}52375, \hat\kappa=(0{,}94-0{,}52375)/0{,}47625=0{,}8740.
Adım 4 — LR ve DOR.
LR− = 0,04/0,928 = 0,04310, GA [0,01421; 0,13076]. DOR = (72·116)/(9·3) = 309,33; SE(ln DOR) = 0,68334; GA [81,05; 1180,56]. DOR'un GA'sı geniştir, çünkü YN = 3 tek başına SE'nin büyük kısmını taşır (1/3). Prevalans 0,375 [0,3109; 0,4439], tespit oranı 0,36, tespit prevalansı 0,405.
Adım 5 — Ek testler. κ ASE = 0,03518, GA [0,8051; 0,9430]; SE₀ = 0,07057, z=12{,}385. McNemar: b=3, c=9; düzeltmeli \chi^2=(6-1)^2/12=2{,}0833, p=0{,}1489; düzeltmesiz \chi^2=3, p=0{,}0833; kesin p=2\,P(B\le3\mid12;\ 0{,}5)=0{,}1460. Model yanlış pozitiflere biraz eğilimli görünse de fark anlamlı değildir. Doğruluğun Clopper–Pearson GA'sı [0,8975; 0,9686]; NIR = 125/200 = 0,625, P(X\ge188)=2{,}23\times10^{-25}.
Adım 6 — Bootstrap ve çok sınıflı özet. Bootstrap %95 GA (B = 2000, tohum 42): F1 [0,8758; 0,9639], MCC [0,8036; 0,9384], BA [0,9093; 0,9736], J [0,8185; 0,9473]. İki sınıflı özette sınıf 0'ın F1'i 0,9508, sınıf 1'in 0,9231; makro F1 0,9369, ağırlıklı F1 (125 ve 75 ağırlıklarla) 0,9404, mikro F1 = doğruluk = 0,94.
Adım 7 — %99 ve pozitif = 0. %99'da duyarlılık Wilson GA [0,8554; 0,9898], LR+ GA [5,82; 30,56], κ GA [0,7834; 0,9646]. Pozitif = 0 seçildiğinde Se = 0,928, Sp = 0,96, PPV = 0,9748, F1 = 0,9508, LR+ = 0,928/0,04 = 23,2; MCC, κ, BA, J ve DOR aynıdır.
66.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan, gui.panels.analyses.confusion_metrics modülünde round() bellekte etkisizleştirilerek alınmıştır (dogrulama/confusion_metrics/merqur_calistir.py); Wilson ve log-GA'ları kodda 4 ondalığa yuvarlandığından bu adım gereklidir. R: 4.5.3; caret::confusionMatrix (doğruluk ve Clopper–Pearson GA, NIR testi, κ, McNemar, Se, Sp, PPV, NPV, F1, BA, prevalans, tespit oranları), epiR::epi.tests (LR+, LR−, DOR ve GA'ları), vcd::Kappa (ASE, GA), irr::kappa2 (z), binom::binom.confint(methods = "wilson"), mcnemar.test, binom.test. MCC için R paketi (mltools) kurulu olmadığından R sütunu tanımdan hesaplanmıştır. Bootstrap satırları aynı tohumla yeniden üretimdir.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Doğruluk | 0,940000 | 0,940000 | 0,940000 | 0,0e+00 | ✓ |
| Duyarlılık | 0,960000 | 0,960000 | 0,960000 | 0,0e+00 | ✓ |
| Özgüllük | 0,928000 | 0,928000 | 0,928000 | 0,0e+00 | ✓ |
| Kesinlik (PPV) | 0,888889 | 0,888889 | 0,888889 | 1,1e−16 | ✓ |
| NPV | 0,974790 | 0,974790 | 0,974790 | 4,4e−16 | ✓ |
| F1 | 0,923077 | 0,923077 | 0,923077 | 1,1e−16 | ✓ |
| MCC | 0,875755 | 0,875755 | 0,875755 | 2,2e−16 | ✓ |
| Dengeli doğruluk | 0,944000 | 0,944000 | 0,944000 | 0,0e+00 | ✓ |
| Cohen κ | 0,874016 | 0,874016 | 0,874016 | 1,1e−16 | ✓ |
| Youden J | 0,888000 | 0,888000 | 0,888000 | 1,1e−16 | ✓ |
| Wilson %95 GA alt, doğruluk | 0,898068 | 0,898068 | 0,898068 | 2,2e−16 | ✓ |
| Wilson %95 GA üst, doğruluk | 0,965348 | 0,965348 | 0,965348 | 1,1e−16 | ✓ |
| Wilson %95 GA alt, duyarlılık | 0,888870 | 0,888870 | 0,888870 | 4,4e−16 | ✓ |
| Wilson %95 GA üst, duyarlılık | 0,986304 | 0,986304 | 0,986304 | 1,1e−16 | ✓ |
| Wilson %95 GA alt, özgüllük | 0,868817 | 0,868817 | 0,868817 | 2,2e−16 | ✓ |
| Wilson %95 GA üst, özgüllük | 0,961661 | 0,961661 | 0,961661 | 4,4e−16 | ✓ |
| Wilson %95 GA alt, PPV | 0,802129 | 0,802129 | 0,802129 | 3,3e−16 | ✓ |
| Wilson %95 GA üst, PPV | 0,940432 | 0,940432 | 0,940432 | 4,4e−16 | ✓ |
| Wilson %95 GA alt, NPV | 0,928495 | 0,928495 | 0,928495 | 1,1e−16 | ✓ |
| Wilson %95 GA üst, NPV | 0,991390 | 0,991390 | 0,991390 | 2,2e−16 | ✓ |
| Wilson %99 GA alt, duyarlılık | 0,855392 | 0,855392 | 0,855392 | 2,2e−16 | ✓ |
| Wilson %99 GA üst, NPV | 0,993608 | 0,993608 | 0,993608 | 6,7e−16 | ✓ |
| LR+ | 13,333333 | 13,333333 | 13,333333 | 4,1e−14 | ✓ |
| LR+ %95 GA alt | 7,093732 | 7,093732 | 7,093732 | 1,8e−15 | ✓ |
| LR+ %95 GA üst | 25,061250 | 25,061250 | 25,061250 | 2,5e−14 | ✓ |
| LR− | 0,043103 | 0,043103 | 0,043103 | 6,9e−18 | ✓ |
| LR− %95 GA alt | 0,014208 | 0,014208 | 0,014208 | 5,7e−17 | ✓ |
| LR− %95 GA üst | 0,130765 | 0,130765 | 0,130765 | 5,0e−16 | ✓ |
| DOR | 309,333333 | 309,333333 | 309,333333 | 3,4e−13 | ✓ |
| DOR %95 GA alt | 81,052491 | 81,052491 | 81,052491 | 0,0e+00 | ✓ |
| DOR %95 GA üst | 1180,557311 | 1180,557311 | 1180,557311 | 3,2e−12 | ✓ |
| LR+ %99 GA üst | 30,557644 | 30,557644 | 30,557644 | 4,6e−14 | ✓ |
| DOR %99 GA alt | 53,210267 | 53,210267 | 53,210267 | 0,0e+00 | ✓ |
| Prevalans | 0,375000 | 0,375000 | 0,375000 | 0,0e+00 | ✓ |
| Prevalans Wilson GA alt | 0,310854 | 0,310854 | 0,310854 | 2,8e−16 | ✓ |
| Tespit oranı | 0,360000 | 0,360000 | 0,360000 | 0,0e+00 | ✓ |
| Tespit prevalansı | 0,405000 | 0,405000 | 0,405000 | 0,0e+00 | ✓ |
| κ ASE | 0,035180 | 0,035180 | 0,035180 | 4,2e−17 | ✓ |
| κ %95 GA alt | 0,805064 | 0,805064 | 0,805064 | 3,3e−16 | ✓ |
| κ %95 GA üst | 0,942967 | 0,942967 | 0,942967 | 2,2e−16 | ✓ |
| κ %99 GA alt | 0,783398 | 0,783398 | 0,783398 | 0,0e+00 | ✓ |
| κ z (SE₀) | 12,385046 | 12,385046 | 12,385046 | 0,0e+00 | ✓ |
| McNemar \chi^2 (düzeltmeli) | 2,083333 | 2,083333 | 2,083333 | 3,6e−15 | ✓ |
| McNemar p (düzeltmeli) | 0,148915 | 0,148915 | 0,148915 | 4,4e−15 | ✓ |
| McNemar \chi^2 (düzeltmesiz) | 3 | 3 | 3 | 0,0e+00 | ✓ |
| McNemar p (düzeltmesiz) | 0,083265 | 0,083265 | 0,083265 | 1,7e−16 | ✓ |
| McNemar kesin p | 0,145996 | 0,145996 | 0,145996 | 0,0e+00 | ✓ |
| Doğruluk Clopper–Pearson %95 alt | 0,897538 | 0,897538 | 0,897538 | 5,6e−16 | ✓ |
| Doğruluk Clopper–Pearson %95 üst | 0,968616 | 0,968616 | 0,968616 | 4,4e−16 | ✓ |
| Doğruluk Clopper–Pearson %99 alt | 0,882919 | 0,882919 | 0,882919 | 1,1e−16 | ✓ |
| NIR | 0,625000 | 0,625000 | 0,625000 | 0,0e+00 | ✓ |
| P(doğruluk > NIR) | 2,2271·10−25 | 2,2271·10−25 | 2,2271·10−25 | 2,7e−39 | ✓ |
| Bootstrap GA alt, F1 (tohum 42) | 0,875817 | 0,875817 | — | 0,0e+00 | ✓ |
| Bootstrap GA üst, F1 | 0,963855 | 0,963855 | — | 0,0e+00 | ✓ |
| Bootstrap GA alt, MCC (tohum 42) | 0,803585 | 0,803585 | — | 0,0e+00 | ✓ |
| Bootstrap GA üst, MCC | 0,938434 | 0,938434 | — | 0,0e+00 | ✓ |
| Bootstrap GA alt, Dengeli doğruluk (tohum 42) | 0,909272 | 0,909272 | — | 0,0e+00 | ✓ |
| Bootstrap GA üst, Dengeli doğruluk | 0,973627 | 0,973627 | — | 0,0e+00 | ✓ |
| Bootstrap GA alt, Youden J (tohum 42) | 0,818543 | 0,818543 | — | 0,0e+00 | ✓ |
| Bootstrap GA üst, Youden J | 0,947255 | 0,947255 | — | 0,0e+00 | ✓ |
| Makro F1 | 0,936948 | 0,936948 | 0,936948 | 3,3e−16 | ✓ |
| Makro PPV | 0,931839 | 0,931839 | — | 0,0e+00 | ✓ |
| Ağırlıklı F1 | 0,940416 | 0,940416 | — | 0,0e+00 | ✓ |
| Ağırlıklı özgüllük | 0,948000 | 0,948000 | — | 0,0e+00 | ✓ |
| Pozitif = 0: F1 | 0,950820 | 0,950820 | 0,950820 | 5,6e−16 | ✓ |
| Pozitif = 0: PPV | 0,974790 | 0,974790 | 0,974790 | 4,4e−16 | ✓ |
| Pozitif = 0: LR+ | 23,200000 | 23,200000 | — | 0,0e+00 | ✓ |
Sonuç: 67 büyüklüğün tamamı ölçütü karşılar.
66.7 Çıktıyı okuma
Varsayılan ayarlarla sonuç metni:
══ KARMAŞIKLIK MATRİSİ ══
                Tahmin=Pozitif   Tahmin=Negatif
Gerçek=Pozitif  TP=72              FN=3
Gerçek=Negatif  FP=9               TN=116

Gözlem  : n = 200  (pozitif = 75, negatif = 125)

══ METRİKLER ══  (%95 GA, Wilson)
Doğruluk            : 0.9400  [0.8981, 0.9653]
Duyarlılık          : 0.9600  [0.8889, 0.9863]
Özgüllük            : 0.9280  [0.8688, 0.9617]
Kesinlik (PPV)      : 0.8889  [0.8021, 0.9404]
NPV                 : 0.9748  [0.9285, 0.9914]
F1 Skoru            : 0.9231
MCC                 : 0.8758
Dengeli doğruluk    : 0.9440
Cohen's Kappa       : 0.8740  (Neredeyse mükemmel uyum)
Youden's J          : 0.8880

══ Tanı testi oranları (STARD) ══
LR+                 : 13.3333  [7.0937, 25.0612]
LR−                 : 0.0431  [0.0142, 0.1308]
Tanısal OR (DOR)    : 309.3333  [81.0525, 1180.5573]
Prevalans           : 0.3750  [0.3109, 0.4439]
Tespit oranı        : 0.3600
Tespit prevalansı   : 0.4050

══ YORUMLAMA ══
─ Genel başarı (doğruluk): %94.0
─ Pozitif yakalama (duyarlılık): %96.0
─ Negatif ayırma (özgüllük): %92.8
✓ MCC = 0.88: güçlü tahmin gücü.
"Kappa SE/GA + McNemar + NIR testi" açıkken eklenen blok:
══ Uyum ve sapma testleri ══
Cohen's Kappa      : 0.8740  (ASE = 0.0352, %95 GA [0.8051, 0.9430]);  H0: κ = 0 → z = 12.385, p < .001
McNemar            : χ² = 2.0833 (süreklilik düzeltmeli), p = 0.1489;  kesin binom p = 0.1460  (FN = 3, FP = 9)
McNemar (düzeltmesiz): χ² = 3.0000, p = 0.0833
Doğruluk %95 kesin GA [0.8975, 0.9686];  NIR = 0.6250, P(Doğruluk > NIR) < .001
| Satır | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Karmaşıklık matrisi | DP, YN, YP, DN | Satır gerçek, sütun tahmin; "pozitif" seçilen sınıftır. |
| Oran metrikleri | Değer ve Wilson GA | Se/Sp testin özelliği; PPV/NPV prevalansa bağlı. |
| F1, MCC, BA, κ, J | Tek sayı özetleri | Dengesiz sınıflarda MCC ve BA'ya bakın. κ etiketi Landis–Koch ölçeğidir (Cohen's Kappa paneliyle aynı): < 0 tesadüfün altında, ≤ 0,20 hafif, ≤ 0,40 vasat, ≤ 0,60 orta, ≤ 0,80 önemli, üstü neredeyse mükemmel (confusion_metrics.py:755–762). |
| STARD bloğu | LR+, LR−, DOR, prevalans | LR+ > 10 ve LR− < 0,1 güçlü tanı testi sayılır. |
| Uyum ve sapma testleri | κ testi, McNemar, NIR | McNemar anlamlıysa model sistematik olarak bir yöne kayar. |
| Bootstrap bloğu | F1, MCC, BA, J için GA | B ve tohum başlıkta. |
| Çok sınıflı blok | K\times K matris, sınıf bazında ölçüler, makro/ağırlıklı | İki sınıfta da açılabilir. |
| Uyarılar | n < 30, sıfır hücre, tanımsız oran | |
| Tablo sekmesi | 16 metrik + GA sütunları (ek testlerle 21 satır) | Değerler 4 ondalığa yuvarlanmış. |
| Grafik | 2×2 ısı haritası, hücre etiketleri | Başlıkta doğruluk ve MCC. |
APA biçiminde rapor cümlesi:
Diyabet sınıflayıcısının 200 hastadaki tahminleri gerçek tanılarla karşılaştırıldı (prevalans %37,5). Duyarlılık %96,0 (%95 GA [88,9; 98,6]), özgüllük %92,8 (%95 GA [86,9; 96,2]), PPV %88,9, NPV %97,5 idi. Pozitif olabilirlik oranı 13,3 (%95 GA [7,1; 25,1]), negatif olabilirlik oranı 0,04 (%95 GA [0,01; 0,13]) bulundu; MCC = 0,88, κ = 0,87. Yanlış pozitif ve yanlış negatif sayıları arasında anlamlı fark yoktu (McNemar \chi^2(1) = 2,08, p = 0,15).
66.8 Uzman soruları
S1. Wilson GA neden doğruluk için de kullanılıyor, caret Clopper–Pearson vermiyor mu?
Ana blok bütün oranlarda tutarlılık için Wilson kullanır (confusion_metrics.py:338). caret'in doğruluk GA'sı Clopper–Pearson'dır; MerQur onu ek testlerde "kesin GA" olarak verir (:433–440). Clopper–Pearson kapsamayı en az nominal tutar ama genişliği büyüktür; Wilson ortalamada nominale daha yakındır (Newcombe 1998).
S2. LR ve DOR GA'larında sıfır hücre nasıl ele alınıyor?
Hücrelerden biri 0 ise log-SE sonsuz olur; MerQur değeri ve GA'yı "—" yazar (confusion_metrics.py:351–371). epiR ve kimi meta-analiz yazılımları her hücreye 0,5 ekler (Haldane–Anscombe); MerQur eklemez. Kusursuz özgüllükte (YP = 0) LR+ sonsuzdur; bu bir yazılım hatası değil, verinin sınırıdır. Raporda düzeltme yapılacaksa ayrıca belirtilmelidir.
S3. McNemar burada neyi sınıyor; tanı testi doğruluğuyla ilgisi ne?
Gerçek ve tahmin aynı hastaların iki "ölçümü" sayılır; McNemar bu iki ölçümün pozitif oranlarının eşitliğini (YP = YN) sınar. Anlamlıysa model sistematik olarak fazla ya da az pozitif söyler. Doğruluk hakkında bilgi vermez: %50 doğruluklu bir model YP = YN ise McNemar'dan geçer. İki testi aynı hastalarda karşılaştırmak için McNemar paneli (Bölüm 28) kullanılmalıdır.
S4. Doğruluk > NIR testi neden tek yönlü?
Soru "model, herkese çoğunluk sınıfını söyleyen bilgisiz kuraldan iyi mi?"dir; kötü olması ilgi konusu değildir. caret'in tanımı budur ve MerQur aynısını kullanır: P(X\ge k), X\sim\text{Bin}(N,\ \text{NIR}) (confusion_metrics.py:440). Bu veride NIR 0,625, doğruluk 0,94; p=2{,}2\times10^{-25}.
S5. Pozitif sınıf metin olduğunda varsayılan ne?
ROC, TSS, karmaşıklık matrisi ve bütün ikili sonuç analizleri tek kuralı paylaşır (default_positive, classification_eval.py; core/binary_event.py): sayısal kodda büyük değer (0/1'de 1, 1/2'de 2); iki düzeyden yalnız biri tanınan olumlu etiketse (evet, yes, var, present, pozitif, event, case, died …) o düzey; aksi hâlde düzey sırasındaki ikinci değer ve "olay kategorisi seçilmedi" uyarısı. Alfabe kullanılmaz. Böylece "Pozitif/Negatif" ya da "Evet/Hayır" etiketli veri, satırların hangi sırayla geldiğinden bağımsız olarak aynı pozitif sınıfı verir. Gerçek ve tahmin sütunlarında ortak sınıf yoksa analiz durur. Metin etiketlerde pozitif sınıfı yine de çıktının künyesinden denetleyin ya da elle seçin.
S6. Tek sınıf tahmin edilirse ne olur?
Model herkese "negatif" derse DP + YP = 0'dır; PPV ve F1 tanımsız (NaN, "—"), MCC'nin paydası sıfırdır ve sklearn 0 döndürür, κ = 0 olur. MerQur uyarı satırında tanımsız oranları listeler (confusion_metrics.py:320–321, :379–380); yorum bloğunda da bu oranlar "—" yazılır.
S7. Makro ve ağırlıklı ortalama hangisi raporlanmalı?
Makro ortalama her sınıfa eşit ağırlık verir ve azınlık sınıfının başarımını görünür kılar; ağırlıklı ortalama sınıf sıklığıyla ağırlıklandırır ve doğruluğa yaklaşır. Dengesiz çok sınıflı problemlerde makro F1 ve makro duyarlılık (= dengeli doğruluk) yeğlenir. MerQur gerçekte bulunmayan sınıfları ve tanımsız değerleri ortalamaya almaz (confusion_metrics.py:498–514); sklearn zero_division ayarına göre farklı sonuç verebilir.
S8. Bootstrap GA neden yalnız F1, MCC, BA ve J için?
Oran metriklerinin (Se, Sp, PPV, NPV, doğruluk) kapalı biçimli Wilson GA'sı vardır. F1 ve MCC'nin varyansı kapalı biçimde karmaşıktır; bootstrap yüzdelik GA'sı bu yüzden yalnız onlara (ve BA, J'ye) uygulanır (confusion_metrics.py:538–558). Bootstrap satırları yerine koyarak çeker, sınıf oranını sabit tutmaz; tohum 42 ve B = 2000 formda değiştirilemez.
66.9 Sık hatalar ve tuzaklar
- Metin etiketlerde pozitif sınıfı denetlememek. Tanınmayan etiketlerde (ör. "A/B") varsayılan düzey sırasındaki ikinci değerdir ve uyarı yazılır. Künyedeki pozitif sınıfı okuyun ya da elle seçin.
- PPV'yi başka bir nüfusa taşımak. PPV ve NPV bu örneklemin prevalansına (%37,5) bağlıdır; tarama nüfusunda LR'lerle yeniden hesaplanmalıdır.
- Yalnız doğruluk raporlamak. Dengesiz sınıflarda yanıltır; MCC, BA ve Se/Sp birlikte verilmelidir.
- İki doğruluk GA'sını karıştırmak. Ana blok Wilson, ek blok Clopper–Pearson'dır.
- κ etiketini sayının yerine raporlamak. Landis–Koch sözcükleri yayımlanmış ama keyfî sınırlardır; raporda κ değerini ve GA'sını, etiketi kullanıyorsanız kaynağını verin.
- McNemar'ı doğruluk testi sanmak. Yalnız YP–YN dengesizliğini sınar.
- Sıfır hücrede LR'yi "sonsuz başarı" diye yorumlamak. Küçük örneklemde tek bir hasta tabloyu değiştirir; GA tanımsızdır.
- Tahmin sütunu olarak olasılık vermek. Panel her farklı değeri ayrı sınıf sayar ve çok sınıflı özete geçer; önce eşikle ikili tahmin üretin (TSS ya da ROC).
66.10 Kaynaklar
- Bossuyt, P. M., Reitsma, J. B., Bruns, D. E., Gatsonis, C. A., Glasziou, P. P., Irwig, L., … Cohen, J. F. (2015). STARD 2015: An updated list of essential items for reporting diagnostic accuracy studies. BMJ, 351, h5527. https://doi.org/10.1136/bmj.h5527
- Chicco, D., & Jurman, G. (2020). The advantages of the Matthews correlation coefficient (MCC) over F1 score and accuracy in binary classification evaluation. BMC Genomics, 21, 6. https://doi.org/10.1186/s12864-019-6413-7
- Clopper, C. J., & Pearson, E. S. (1934). The use of confidence or fiducial limits illustrated in the case of the binomial. Biometrika, 26(4), 404–413. https://doi.org/10.1093/biomet/26.4.404
- Fagerland, M. W., Lydersen, S., & Laake, P. (2013). The McNemar test for binary matched-pairs data: Mid-p and asymptotic are better than exact conditional. BMC Medical Research Methodology, 13, 91. https://doi.org/10.1186/1471-2288-13-91
- Glas, A. S., Lijmer, J. G., Prins, M. H., Bonsel, G. J., & Bossuyt, P. M. M. (2003). The diagnostic odds ratio: A single indicator of test performance. Journal of Clinical Epidemiology, 56(11), 1129–1135. https://doi.org/10.1016/S0895-4356(03)00177-X
- Kuhn, M. (2008). Building predictive models in R using the caret package. Journal of Statistical Software, 28(5), 1–26. https://doi.org/10.18637/jss.v028.i05
- Matthews, B. W. (1975). Comparison of the predicted and observed secondary structure of T4 phage lysozyme. Biochimica et Biophysica Acta (BBA) – Protein Structure, 405(2), 442–451. https://doi.org/10.1016/0005-2795(75)90109-9
- McNemar, Q. (1947). Note on the sampling error of the difference between correlated proportions or percentages. Psychometrika, 12(2), 153–157. https://doi.org/10.1007/BF02295996
- Newcombe, R. G. (1998). Two-sided confidence intervals for the single proportion: Comparison of seven methods. Statistics in Medicine, 17(8), 857–872. https://doi.org/10.1002/(SICI)1097-0258(19980430)17:8<857::AID-SIM777>3.0.CO;2-E
- Simel, D. L., Samsa, G. P., & Matchar, D. B. (1991). Likelihood ratios with confidence: Sample size estimation for diagnostic test studies. Journal of Clinical Epidemiology, 44(8), 763–770. https://doi.org/10.1016/0895-4356(91)90128-V