78. Gizil Sınıf Analizi (LCA)
Analiz kimliği: lca · Menü adı: Latent Class Analysis (LCA) · Panel: gui/panels/analyses/lca_panel.py · Motor: stats/latent_class.py, fit_lca (satır 824–922), ortak çıktı katmanı gui/panels/analyses/_latent_render.py
78.1 Ne işe yarar
Gizil sınıf analizi (LCA), kategorik göstergelerdeki (evet/hayır, Likert maddesi, tanı var/yok) yanıt örüntülerinin arkasında gözlenmeyen alt gruplar (sınıflar) olup olmadığını araştırır. Cevapladığı sorular: "Hastalar eşlik eden hastalık örüntülerine göre kaç gruba ayrılıyor?", "Her grubun büyüklüğü nedir ve her grupta hangi hastalık ne sıklıkta?", "Bu hasta hangi gruba aittir?"
Model bir sonlu karışım modelidir:
- \mathbf y_i=(y_{i1},\dots,y_{iJ}): i. kişinin J göstergedeki yanıtları.
- K: sınıf sayısı; \pi_r: r. sınıfın büyüklüğü (sınıf oranı), \sum_r\pi_r=1.
- R_j: j. göstergenin kategori sayısı.
- \theta_{jrc}=P(y_{ij}=c\mid \text{sınıf } r): koşullu yanıt olasılığı, \sum_c\theta_{jrc}=1.
- \mathbb 1(\cdot): gösterge fonksiyonu (koşul doğruysa 1).
Neden çarpım? Yerel bağımsızlık
Sınıf bilindiğinde göstergeler birbirinden bağımsız varsayılır (yerel bağımsızlık; Lazarsfeld ve Henry 1968). Bu varsayım, göstergeler arasındaki tüm ilişkinin sınıf üyeliğinden kaynaklandığını söyler. Hipertansiyon ile diyabetin birlikte görülmesi, ikisinin de yüksek olduğu bir "metabolik" sınıfın varlığıyla açıklanır. Varsayım modelin özüdür: ilişkiyi açıklamak için kaç sınıf gerektiği sorusu buradan doğar.
Ne zaman kullanılır? Göstergeler kategorik (ikili ya da çok kategorili, en çok 20 kategori) ve amaç kişileri gözlenmeyen tiplere ayırmaksa; sınıf sayısı bilinmiyor ve veriden seçilecekse.
Ne zaman kullanılmaz?
- Göstergeler sürekliyse (ölçek puanları, laboratuvar değerleri): Gizil Profil Analizi (LPA). MerQur 20'den çok farklı değerli göstergeyi LCA'da reddeder ve LPA'yı önerir (
latent_class.py:789–790). - Gizil yapı sürekli bir boyutsa (bir yetenek ya da şiddet düzeyi): Madde Tepki Kuramı (IRT) ya da faktör analizi.
- Kişileri yalnız uzaklıklara göre gruplamak yeterliyse ve olasılık modeli gerekmiyorsa: K-ortalamalar, hiyerarşik kümeleme (kategorik veride Gower uzaklığıyla).
- Gruplar önceden biliniyorsa ve amaç gruba atama kuralıysa: diskriminant analizi, çok terimli lojistik regresyon.
Sık karıştırılan analizler. LPA aynı karışım mantığını sürekli göstergelere uygular. K-ortalamalar her kişiyi kesin olarak tek kümeye atar; LCA her kişi için sınıf olasılıkları verir ve sınıf sayısını olabilirlik temelli ölçütlerle seçer. Kümeleme sonuçları ölçeğe ve uzaklık tanımına bağlıdır; LCA'nın varsayımı yerel bağımsızlıktır.
78.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Kategorik göstergeler | Her farklı değer bir kategori; 2–20 kategori. | 1 kategori ya da > 20 kategori hata (latent_class.py:787–790). |
| Yerel bağımsızlık | Sınıf içinde göstergeler bağımsız. | Doğrudan denetlenmez; mutlak uyum (G², X²) dolaylı bilgi verir. |
| Tanımlanabilirlik | Parametre sayısı bağımsız hücre sayısını aşmamalı. | Ölçüm parametresi > \prod R_j-1 ise uyarı (latent_class.py:875–878). |
| Yeterli örneklem | Her sınıfta kestirime yetecek kişi. | n<10 hata (latent_class.py:772–773); parametre sayısı ≥ n olan K atlanır (latent_class.py:860–863); en küçük \pi<0{,}05 uyarısı. |
| Küresel en büyük | EM yerel en büyükte kalabilir. | Çok başlangıç; en iyi \ell'nin tekrar sayısı ve ikinci en iyi \ell ile fark (latent_class.py:406–418). |
| Kayıp mekanizması (FIML) | Eksik göstergeler rastgele eksik (MAR). | Denetlenmez. |
Eksik değer. Varsayılan liste bazında silme: herhangi bir göstergesi eksik satır çıkarılır. "Tam bilgi (FIML)" seçilirse en az bir göstergesi gözlenmiş satırlar kalır ve eksik gösterge olabilirliğe 1 çarpanı olarak girer, yani yalnız gözlenen göstergeler katkı verir (latent_class.py:766–769, 442–446). Kovaryatı eksik satırlar her iki durumda çıkarılır.
Kategori sırası. Değerler sayıya çevrilebiliyorsa sayısal sırayla, değilse metin sırasıyla dizilir; ilk kategori sınıf oranlarının değil, standart hata parametrelemesinin referansıdır (latent_class.py:779–786). Çıktıdaki tüm kategoriler yazılır.
78.3 Parametreler
Varsayılanlar lca_panel.py:52–115 ve fit_lca imzasından (latent_class.py:824–829) alınmıştır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Göstergeler | en az 2 | Kategorik göstergeler. | Model; J ve R_j. |
| En küçük sınıf sayısı | 1 | Taramanın alt ucu K_{\min}. 1'den büyükse K_{\min}-1 sınıflı model yalnız en küçük K'nın VLMR / düzeltilmiş LMR / BLRT karşılaştırması için kestirilir, tabloda gösterilmez. | Seçim tablosunun ilk satırı. |
| En çok sınıf sayısı | 4 | K=K_{\min},\dots,K_{\max} modelleri kestirilir. | Seçim tablosunun satırları. |
| Raporlanacak sınıf sayısı | Otomatik (ölçüt) | Belirli bir K'yı ayrıntılı raporlatır. | Ayrıntılı bloklar hangi K için basılır. |
| Rastgele başlangıç sayısı | 20 | Her K\ge2 için EM başlangıç sayısı. | Küresel en büyüğe ulaşma olasılığı; "Tekrar" sütunu. |
| Rastgele tohum | 42 | Başlangıç ve BLRT için tohum (seed). | Aynı tohum aynı sonucu verir. |
| Eksik göstergeler | Liste bazında | Liste bazında ya da FIML. | n ve kestirimler. |
| Kovaryatlar (isteğe bağlı) | yok | Sınıf üyeliğini yordayan değişkenler; tek adımlı çok terimli logit. | \pi_r kişiye özgü olur; β tablosu basılır; G²/X² hesaplanmaz. |
| Seçim ölçütü | BIC | Otomatik seçimde en küçüğü alınacak ölçüt: BIC, SABIC, AIC, CAIC. | Seçilen K. |
| VLMR kovaryansı | Sandviç (sağlam MLR) | VLMR ağırlıklarında parametre kovaryansı: sandviç ya da ters Hessian. | VLMR ve düzeltilmiş LMR p. |
| En çok EM yinelemesi | 2000 | Her başlangıç için üst sınır. | Yakınsamazsa uyarı. |
| BLRT bootstrap sayısı | Kapalı (0) | Parametrik bootstrap LRT; B örneklem. | BLRT p sütunu; süre çok uzar. |
| Dış değişkenler (BCH) | yok | Sınıflar arasında karşılaştırılacak sayısal değişkenler, üç adımlı BCH. | Ek blok; sınıflama modelini değiştirmez. |
| Ek çıktılar: sınıf atamasını kaydet | kapalı | Modal sınıf ve sonsal olasılıklar veri setine. | Yeni sütunlar. |
Neden "standart hata türü" seçeneği LCA'da yok?
SE türü seçeneği (ampirik bilgi, gözlenen bilgi, sandviç) yalnız LPA panelindedir (lpa_panel.py:79–82). LCA'da standart hatalar her zaman ampirik bilgi matrisinden (skorların dış çarpımı) hesaplanır (latent_class.py:554–611); bu, R poLCA'nın tanımıdır. En küçük sınıf sayısı, başlangıç akışı ve cilalama kuralı ise iki panelde ortaktır (78.5.3).
78.4 Tıp örneği
Dosya: english/datasets/Tip/123_lca_multimorbidity_patterns.xlsx (çoklu hastalık örüntüleri verisi; Türkçe sunum ve video betiğinde karşılığı yoktur, değişken seçimi dosyanın tasarımına göre yapılmıştır).
| Değişken | Rol | Tür | Yaygınlık |
|---|---|---|---|
hypertension |
gösterge | 0/1 | %54,7 |
diabetes |
gösterge | 0/1 | %37,8 |
dyslipidemia |
gösterge | 0/1 | %41,6 |
heart_failure |
gösterge | 0/1 | %17,1 |
copd |
gösterge | 0/1 | %13,2 |
ckd |
gösterge | 0/1 | %16,3 |
depression |
gösterge (BCH örneğinde dış değişken) | 0/1 | %11,8 |
n ve eksik değer: 719 hasta, eksik değer yok. 2^7=128 olası yanıt örüntüsünden 87'si gözlenmiştir.
Klinik soru: Yedi kronik hastalığın birlikte görülme örüntüsü kaç çoklu hastalık tipine ayrılıyor? Bu tipler depresyon yaygınlığı açısından farklı mı (BCH örneği)?
Seçilen ayarlar: Arayüz varsayılanları (K_{\max}=4, 20 başlangıç, tohum 42, BIC, sandviç VLMR). Ek çalıştırmalar: ters Hessian VLMR; tohum 7; K_{\max}=5; B=50 ile BLRT (iki kez, aynı tohum); BCH için depresyon dışındaki 6 gösterge ile model ve depression dış değişken.
78.5 Formüller ve hesap adımları
MerQur'un hesap sırası: (1) göstergeleri kategori kodlarına çevirir; (2) K=K_{\min},\dots,K_{\max} için çok başlangıçlı EM ile en büyük log-olabilirliği arar; (3) sınıfları azalan \pi'ye göre sıralar; (4) bilgi ölçütlerini, entropileri ve ardışık K-1/K karşılaştırmalarını (VLMR, düzeltilmiş LMR, istenirse BLRT) hesaplar; (5) seçim ölçütüyle K'yı seçer; (6) seçilen modelde standart hataları ve mutlak uyumu, istenirse BCH karşılaştırmasını hesaplar.
78.5.1 Olabilirlik ve sonsal olasılık
- \eta_{ir}: i. kişinin r. sınıfa ait olup yanıtlarını vermesinin ortak log-olasılığı.
- h_{ir}: Bayes kuralıyla sonsal sınıf olasılığı; kişiye göre toplamı 1'dir.
- Eksik gösterge (FIML) için \mathbb 1(\cdot)=0 olur; o gösterge toplamdan düşer.
Koddaki tercih: log-sum-exp ve taban
Hesap log ölçeğinde yapılır: \ln\sum\exp(\eta)=m+\ln\sum\exp(\eta-m), m=\max_r\eta_{ir} (latent_class.py:425–429). Sıfır olasılıkların logaritması için \theta ve \pi 10^{-300}'den aşağı kırpılır (_LOG_FLOOR, latent_class.py:61, 460). Böylece \theta=0 çözümleri (sınırdaki parametreler) sayısal taşma olmadan işlenir.
78.5.2 EM algoritması
\ell'nin \pi ve \theta'ya göre doğrudan en büyüklenmesi zordur, çünkü logaritmanın içinde toplam vardır. EM (Dempster, Laird ve Rubin 1977) sınıf üyeliğini eksik veri sayar ve iki adımı yineler:
E-adımı. Güncel (\boldsymbol\pi^{(t)},\boldsymbol\theta^{(t)}) ile h_{ir}^{(t)} hesaplanır (78.5.1).
M-adımı. Tam veri log-olabilirliğinin beklenen değeri en büyüklenir; kapalı çözüm:
- o_{ij}: y_{ij} gözlenmişse 1, eksikse 0 (liste bazında silmede hep 1).
- \pi_r^{(t+1)}: sonsal olasılıkların ortalaması, yani "beklenen sınıf büyüklüğü / n".
- \theta_{jrc}^{(t+1)}: r. sınıfa ağırlıklı olarak düşen kişilerde c kategorisinin oranı.
Neden EM? Neden \ell hiç azalmaz?
M-adımı Q(\boldsymbol\psi\mid\boldsymbol\psi^{(t)})=\sum_i\sum_r h_{ir}^{(t)}\ln\big[\pi_r\prod_j\theta_{jr y_{ij}}\big]'yi en büyükler. Jensen eşitsizliği \ell(\boldsymbol\psi)-\ell(\boldsymbol\psi^{(t)})\ge Q(\boldsymbol\psi\mid\boldsymbol\psi^{(t)})-Q(\boldsymbol\psi^{(t)}\mid\boldsymbol\psi^{(t)}) verdiği için her adım \ell'yi artırır ya da sabit tutar. Yakınsama doğrusal hızdadır (Newton'un karesel hızına göre yavaş) ve bir yerel en büyüğe varır; hangi en büyüğe varacağını başlangıç belirler. Bu yüzden çok başlangıç gerekir.
Koddaki tercih: durma ölçütü ve iki evreli arama
_lca_em E-adımından sonra |\ell^{(t)}-\ell^{(t-1)}|<\text{tol} ise durur (latent_class.py:512–514); ölçüt mutlaktır. _fit_lca_k iki evrelidir (latent_class.py:701–734): tüm başlangıçlar önce gevşek \text{tol}=10^{-6} ile yakınsatılır, sonra hepsi nihai \text{tol}=10^{-10} ile kaldıkları yerden sürdürülür (LPA ile aynı kural). Ölçütün mutlak olduğu çıktıdaki kestirim satırında yazılır. Mutlak 10^{-10} ölçütü parametreleri yaklaşık 10^{-6} doğrulukla bırakır: bu veride MerQur'un K=3 çözümünden EM'i 10^{-15} ölçütüyle sürdürmek \ell'yi yalnız 1{,}5\times10^{-10} artırır, \theta'ları en çok 4{,}5\times10^{-7} kaydırır.
78.5.3 Başlangıç değerleri ve tekrar sayısı
Her başlangıçta \theta_{jr\cdot} satırları U(0{,}1) çekilip normalleştirilir, \pi_r=1/K alınır (latent_class.py:530–535, 502–503). K=1 için tek başlangıç yeterlidir (olabilirlik tek tepelidir). Her rastgele başlangıç (\text{tohum},K,i)'den türetilmiş ayrı bir akıştan çeker (_start_rng).
- \ell_s: s. başlangıcın vardığı (cilalanmışsa cilalanmış) log-olabilirlik; çıktıdaki "Tekrar" sütunu "tekrar/başlangıç" biçimindedir (
latent_class.py:383–388). - \Delta_2: en iyi ile ondan 10^{-3}'ten fazla farklı ikinci en iyi \ell arasındaki fark (
latent_class.py:391–398). - Uyarılar: tekrar < 2 ise "yerel optimum olabilir", \Delta_2<1 ise "olabilirlik çok tepeli" (
latent_class.py:403–418; Hipp ve Bauer 2006).
Koddaki tercih: başlangıca özgü akış ve hepsinin cilalanması
Her başlangıca ayrı akış verilmesi, N başlangıçlı aramanın 2N başlangıçlının alt kümesi olmasını sağlar: başlangıç sayısını artırmak hiçbir zaman daha kötü bir \ell vermez ve bir K'nın başlangıç sayısı öteki K'ların başlangıçlarını değiştirmez. Tüm başlangıçların cilalanması da gevşek evrede geride kalıp nihai ölçütte öne geçecek bir çözümün kaybolmasını önler. LCA ve LPA aynı kuralı kullanır (latent_class.py:701–742, 1050–1055).
78.5.4 Sınıf sıralaması, parametre sayısı ve bilgi ölçütleri
Kestirimden sonra sınıflar azalan \pi'ye göre yeniden numaralanır (latent_class.py:542–551); Sınıf 1 her zaman en büyük sınıftır.
- q: serbest parametre sayısı (kovaryatsız modelde); kovaryatlı modelde (K-1) yerine (K-1)\times(sabit + kovaryat sayısı) (
latent_class.py:538–539). - BIC: Schwarz (1978); SABIC: örneklem büyüklüğü düzeltmeli BIC, n yerine (n+2)/24 (Sclove 1987); CAIC: tutarlı AIC (Bozdogan 1987).
- Hepsinde küçük değer daha iyidir; otomatik seçim seçilen ölçütün en küçük olduğu K'dır (
latent_class.py:1582–1591).
Neden BIC varsayılan?
AIC'nin ceza terimi n'den bağımsızdır; büyük örneklemde gereğinden çok sınıf seçer. BIC'nin cezası \ln n ile büyür ve tutarlıdır: doğru model aday kümedeyse n\to\infty iken seçilme olasılığı 1'e gider. Benzetim çalışmalarında LCA için BIC ve BLRT en iyi sonucu veren ölçütlerdir (Nylund, Asparouhov ve Muthén 2007). SABIC küçük örneklemde BIC'den daha az cezalandırır.
78.5.5 Sınıflandırma kesinliği: iki entropi ve ortalama sonsal olasılıklar
- E: sonsal olasılıkların toplam entropisi; her kişi kesin atanmışsa (h\in\{0{,}1\}) 0'dır.
- Göreli entropi (Ramaswamy vd. 1993): taban n\ln K, yani K eşit sınıfa rastgele atamanın entropisi. Seçim tablosundaki "Entropi" budur (
latent_class.py:128–134). - Entropi R^2: taban, kestirilen sınıf oranlarının (önsel) entropisidir (
latent_class.py:136–148). Sınıflar eşit büyüklükteyse iki değer aynıdır.
- \hat c_i: modal (en olası) sınıf; eşitlikte küçük numaralı sınıf (
np.argmax). - \bar h_{rs}: modal sınıfı r olanların s. sınıfa ait olma olasılığı ortalaması. Köşegen ≥ 0,70 iyi kabul edilir; en küçük köşegen < 0,70 ise uyarı basılır (
_latent_render.py:168–170).
Neden iki entropi?
Göreli entropi sınıf büyüklüklerinin eşit olmamasını "belirsizlik" sayar: büyük bir sınıf ve küçük bir sınıf varsa önsel belirsizlik zaten düşüktür, ama taban \ln K bunu bilmez. Entropi R^2 belirsizlikteki azalmayı önsel belirsizliğe göre ölçer. İkisi farklı yazılımlarda aynı adla raporlandığı için MerQur ikisini etiketli basar. Yorumda entropi ≥ 0,80 "iyi", 0,60–0,80 "orta", < 0,60 "zayıf" ayrışma diye etiketlenir (_latent_render.py:164–167); bu eşikler seçim ölçütü değildir.
78.5.6 Mutlak uyum: G² ve Pearson X²
Yalnız kovaryatsız ve eksiksiz veride hesaplanır (latent_class.py:684–698):
- O_p, E_p=n\,P(\mathbf y_p): örüntü p'nin gözlenen ve beklenen sıklığı.
- X^2'deki son terim, gözlenmeyen örüntülerin katkısıdır: O_p=0 için (0-E_p)^2/E_p=E_p.
- sd tanımı R
poLCAile aynıdır.
78.5.7 Standart hatalar: ampirik bilgi ve delta yöntemi
Parametreler logit ölçeğinde yazılır: \gamma_{jrc}=\ln(\theta_{jrc}/\theta_{jr1}) (c\ge2), \alpha_r=\ln(\pi_r/\pi_1) (r\ge2). Gözlem başına skorlar analitiktir (latent_class.py:554–576):
- \mathbf S: n\times q skor matrisi; \mathbf S^{\top}\mathbf S ampirik bilgi matrisi (gözlem başına skorların dış çarpımı, OPG; Bandeen-Roche vd. 1997).
- \mathbf J: softmax Jacobian'ı; delta yöntemiyle logit ölçeğinden olasılık ölçeğine geçilir (
latent_class.py:225–229). - \pi için aynı yol \alpha bloğuyla izlenir. Ters alma
np.linalg.pinvile yapılır (tekil bilgi matrisinde genelleştirilmiş ters).
Koddaki tercih: neden OPG?
OPG yalnız birinci türev ister ve EM'in ürettiği sonsal olasılıklardan kapalı biçimde gelir; R poLCA da aynı tanımı kullanır ve doğrulamada SE'ler 10^{-7} düzeyinde eşleşir. Gözlenen bilgi (ters Hessian) ve sandviç (MLR) başka yazılımlarda kullanılan iki tanımdır. Üç tanım büyük örneklemde ve doğru belirlenmiş modelde yakın, küçük örneklemde farklıdır. LPA'da üçü de seçilebilir (Bölüm 79.5.6).
78.5.8 VLMR ve düzeltilmiş LMR testi
K-1 sınıflı model, K sınıflı modelin parametre uzayının sınırında yer alır (\pi_K=0 ya da iki sınıfın eşitliği). Bu yüzden olabilirlik oranı istatistiği \text{LR}=2(\ell_K-\ell_{K-1}) ki-kare dağılmaz. Lo, Mendell ve Rubin (2001), Vuong'un (1989) iç içe olmayan model karşılaştırmasından yola çıkarak LR'nin yaklaşık olarak ağırlıklı ki-kareler toplamı dağıldığını gösterir.
Ağırlıklar \lambda_m şu matrisin özdeğerleridir (latent_class.py:302–338):
- \mathbf S_0 (n\times p_0), \mathbf S_1 (n\times p_1): K-1 ve K sınıflı modellerin kestirimlerinde gözlem başına skorlar; \mathbf B çapraz blokları da içerir.
- \mathbf A_k: ortalama gözlenen bilgi; MerQur'da analitik skor toplamının merkezi fark Jacobian'ı (h=10^{-5}\max(1,|\psi|);
latent_class.py:371–380). - \lambda_m'lerin işareti karışıktır; ortalama \sum\lambda_m, SS \sqrt{2\sum\lambda_m^2} olarak raporlanır.
Kuyruk olasılığı Imhof (1961) ters çevirmesiyle hesaplanır (latent_class.py:232–299):
Neden sandviç varsayılan? Neden tanım farkı bu kadar önemli?
Vuong (1989) ve LMR (2001) ağırlıkları ters Hessian ile kurar. Bazı uygulamalar bunun yerine sandviç kovaryansı kullanır (Vermunt 2024). İki tanım aynı çözümde farklı p verir: bu verinin K=4/3 karşılaştırmasında sandviç p=0{,}0833, ters Hessian p=0{,}0194'tür; ters Hessian ağırlıkları daha küçüktür (ortalama 5,58'e karşı 7,12) ve p'yi küçültür. MerQur sandviçi varsayılan yapar ve kullanılan tanımı hem tabloda hem APA satırında yazar (_latent_render.py:117–118, 361–364).
Koddaki tercih: parametreleme, sınır kuralı ve H_0 modeli
VLMR için kategori logitlerinde referans, kestirimde en olası kategoridir ve logiti -15'in altında kalan (olasılığı ~0) parametreler sabit sayılıp dışlanır (latent_class.py:614–646); aksi hâlde bilgi matrisi tekil olurdu. Bu veride K=4 çözümünde üç olasılık tam 0'dır; p_1 31 yerine 28 olur. \lambda'lar tam sıralı yeniden parametrelemeye göre değişmezdir. H_0 modeli, ayrıca çok başlangıçla kestirilen en iyi K-1 çözümüdür; Başka bir yol H_0'ı K sınıflı çözümden bir sınıf silerek yeniden kestirmektir; iki yol aynı küresel en büyüğe varınca sonuç aynıdır (latent_class.py:1535–1545). \text{LR}^{*} \chi^2(\Delta q) dağılımına uymaz; onu bu dağılımla değerlendirmek çok küçük p verir.
78.5.9 Parametrik bootstrap LRT (BLRT)
Her bootstrap örneğinde (latent_class.py:885–898): (1) n kişilik veri, kestirilen K-1 sınıflı modelden üretilir (sınıf, \pi'den; yanıtlar \theta'dan); (2) bu veriye K-1 sınıflı model (üretici çözüm + 5 rastgele başlangıç) ve K sınıflı model (5 rastgele başlangıç) uydurulur, en çok 500 yineleme, \text{tol}=10^{-6}; (3) \text{LR}^{*}_b=\max\{0,\ 2(\ell_K^{(b)}-\ell_{K-1}^{(b)})\} saklanır.
Neden (1+c)/(B+1) ve neden en küçük p 1/(B+1)?
Gözlenen veri de H_0 altında bir bootstrap örneği gibi sayılır; bu, p'nin hiçbir zaman 0 olmamasını ve H_0 altında geçerli (biraz tutucu) bir test olmasını sağlar (Monte Carlo testlerindeki "+1" kuralı). c=0 iken p=1/(B+1) çıkar; bu, gerçek p'nin daha küçük olabileceğini söyler. Çıktı bu tabanı yazar (_latent_render.py:119–123). McLachlan (1987) yaklaşımı ve Nylund vd. (2007) benzetimleri BLRT'yi LCA'da en güvenilir sınıf sayısı testi olarak gösterir.
Koddaki tercih: bootstrap içinde az başlangıç
Bootstrap örneklerinde K sınıflı model yalnız 5 rastgele başlangıç ve 500 yinelemeyle kestirilir (latent_class.py:893–896). Bir örnekte K sınıflı model yerel en büyükte kalırsa \text{LR}^{*}_b olduğundan küçük çıkar ve p küçülür (liberal yönde). Gözlenen LR sınır değere yakınsa BLRT'yi daha çok başlangıçla tekrarlamak gerekir; MerQur arayüzü bu sayıyı değiştirmeye izin vermez.
78.5.10 BCH üç adımlı dış değişken karşılaştırması
Amaç, sınıflama modeline girmeyen bir değişkenin z (dış sonuç, "distal outcome") sınıflar arasında farkını, sınıflandırma hatasını hesaba katarak bulmaktır. Modal atamayla (\hat c_i) hesaplanan basit grup ortalamaları sınıflar arasındaki farkları zayıflatır, çünkü yanlış atanan kişiler grupları birbirine benzetir.
Adım 1: sınıflama modeli (78.5.2). Adım 2: modal atama ve sınıflandırma hatası matrisi (latent_class.py:1318–1323):
Adım 3: ağırlıklı ortalamalar ve sandviç SE (latent_class.py:1325–1350):
- \mathbf D: satır s gerçek sınıf, sütun t atanan sınıf; satır toplamları 1. Köşegen ne kadar 1'e yakınsa sınıflama o kadar kesindir.
- w_{is}: BCH ağırlığı; \mathbf D^{-1} nedeniyle negatif olabilir. Bir sınıfın ağırlık toplamı ≤ 0 ise o değişken için ortalama hesaplanmaz ve uyarılır.
- Bölme öğe öğedir; \widehat{\mathbf V}_{ab}=\sum_ig_{ia}g_{ib}/(t_at_b).
- İkili karşılaştırmalar: (\hat\mu_a-\hat\mu_b)^2/(V_{aa}+V_{bb}-2V_{ab})\sim\chi^2_1.
Neden \mathbf D^{-1}?
Modal atanan grupların beklenen ortalaması gerçek sınıf ortalamalarının \mathbf D ile karışımıdır: E[\bar z_{\hat c=t}]\propto\sum_s\pi_sD_{st}\mu_s. Bu karışım \mathbf D^{-1} ile ters çevrilerek gerçek sınıf ortalamaları kurtarılır (Bolck, Croon ve Hagenaars 2004; Vermunt 2010). Yöntemin üstünlüğü, dış değişken sınıflamayı değiştirmeden analiz edilebilmesidir; tek adımlı modele z'yi gösterge olarak koymak sınıfların anlamını kaydırabilir (Bakk, Tekle ve Vermunt 2013).
Koddaki tercih: SE ve eksik dış değişken
SE vaka düzeyinde sandviçtir; birinci adımdaki kestirim belirsizliğini (\mathbf D ve sonsal olasılıklardaki belirsizlik) içermez ve çıktı notu bunu yazar. Bu nedenle SE'ler bir miktar küçük olabilir (Bakk, Tekle ve Vermunt 2013). Dış değişkeni eksik olanlar yalnız 3. adımdan çıkarılır; \mathbf D tüm vakalarla kurulur. Seçilen çözüm tek sınıflıysa karşılaştırma yapılmaz ve ayar bloğuna yazılır (latent_class.py:1374–1377).
78.5.11 Kovaryatlı tek adımlı model
Kovaryat seçilirse sınıf oranı kişiye özgü olur: \pi_r(\mathbf x_i)=\exp(\mathbf x_i^{\top}\boldsymbol\beta_r)/\sum_s\exp(\mathbf x_i^{\top}\boldsymbol\beta_s), \boldsymbol\beta_1=\mathbf 0 (Dayton ve Macready 1988). M-adımında \boldsymbol\beta, h_{ir} kesirli yanıtlı çok terimli logit olarak tek bir Newton adımıyla (adım yarılamalı) güncellenir (latent_class.py:466–498, 520–523); bu bir genelleştirilmiş EM'dir ve \ell'yi yine azaltmaz. Kategorik kovaryatlar ilk düzey referanslı kukla kodlanır. Raporlanan \pi_r örneklem ortalamasıdır; β SE'leri aynı OPG matrisinden gelir. G² ve X² bu modelde hesaplanmaz. Sınıflar sıralandıktan sonra β yeni Sınıf 1'e göre yeniden referanslanır (latent_class.py:548–550).
78.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/lca/elle_hesap.py ile, MerQur çağrılmadan numpy ile hesaplanmıştır (kendi EM'imiz, 60 başlangıç).
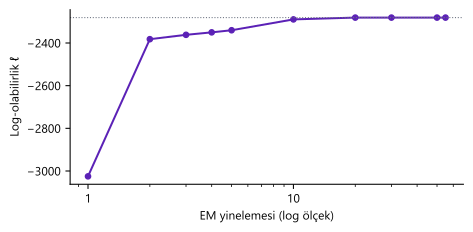
Adım 1 — EM başlangıcı (K=2, belgelenmiş başlangıç). Yürüyüşü izlenebilir kılmak için rastgele değil sabit bir başlangıç seçilmiştir: \pi=(0{,}5;\ 0{,}5), Sınıf 1'de tüm \theta_{j1}=0{,}25, Sınıf 2'de tüm \theta_{j2}=0{,}75 (\theta: hastalığın var olma olasılığı). Başlangıç log-olabilirliği \ell^{(0)}=-3025{,}084467.
Adım 2 — İlk E-adımı. 1 numaralı hastanın hiçbir hastalığı yok, \mathbf y_1=(0,\dots,0):
2 numaralı hastada yalnız ilk üç hastalık var; üç "1" ve dört "0" iki sınıfta simetrik olarak 3:1 olasılık oranı verir: h_{21}=0{,}75, h_{22}=0{,}25.
Adım 3 — İlk M-adımı. Sonsal olasılıkların toplamı \sum_ih_{i1}=559{,}062657, \sum_ih_{i2}=159{,}937343:
Tüm \theta^{(1)}: Sınıf 1 (0,4391; 0,2656; 0,3175; 0,0505; 0,0474; 0,0565; 0,0568), Sınıf 2 (0,9224; 0,7722; 0,7596; 0,5924; 0,4284; 0,5340; 0,3328). Tek adımda \ell -3025{,}08'den -2382{,}16'ya çıkar.
Adım 4 — Yakınsama.
| Yineleme | \ell | \pi_1 | \pi_2 | \theta_{\text{HT},1} | \theta_{\text{HT},2} |
|---|---|---|---|---|---|
| 1 | −3025,084467 | 0,500000 | 0,500000 | 0,250000 | 0,750000 |
| 2 | −2382,156889 | 0,777556 | 0,222444 | 0,439077 | 0,922415 |
| 3 | −2361,777781 | 0,741440 | 0,258560 | 0,416409 | 0,919903 |
| 5 | −2340,283133 | 0,684251 | 0,315749 | 0,377771 | 0,912442 |
| 10 | −2289,480403 | 0,545951 | 0,454049 | 0,239686 | 0,915619 |
| 20 | −2281,021059 | 0,480683 | 0,519317 | 0,163771 | 0,900935 |
| 30 | −2281,007566 | 0,478190 | 0,521810 | 0,161012 | 0,899941 |
| 55 | −2281,007551 | 0,478103 | 0,521897 | 0,160916 | 0,899905 |
(Satır t, t. E-adımındaki parametreleri ve \ell'yi gösterir.) EM doğrusal hızla ilerler: ilk adım \ell'yi 643 birim artırırken 20. adımdan sonra artış 10^{-2}'nin altındadır. Bu başlangıçtan varılan \ell=-2281{,}007551, 60 rastgele başlangıcın tamamının ve MerQur'un 20 başlangıcının tamamının vardığı değerdir. Sınıf adları sıralamayla değişir: MerQur'da Sınıf 1, \pi=0{,}5219 olan "çok hastalıklı" sınıftır.
Şekil 78.1. K = 2 EM yürüyüşünde log-olabilirlik (yatay eksen log ölçek). İlk adımlarda hızlı, sonra doğrusal yavaşlıkta yakınsama.
Adım 5 — Sınıf sayısı taraması.
| K | \ell | q | AIC | BIC | SABIC | CAIC | Entropi | Tekrar |
|---|---|---|---|---|---|---|---|---|
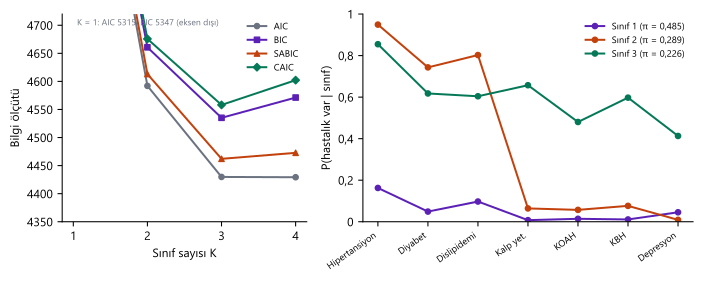
| 1 | −2650,567054 | 7 | 5315,13 | 5347,18 | 5324,95 | 5354,18 | — | 1/1 |
| 2 | −2281,007551 | 15 | 4592,02 | 4660,68 | 4613,05 | 4675,68 | 0,8093 | 20/20 |
| 3 | −2191,912176 | 23 | 4429,82 | 4535,12 | 4462,08 | 4558,12 | 0,7852 | 20/20 |
| 4 | −2183,654875 | 31 | 4429,31 | 4571,22 | 4472,79 | 4602,22 | 0,7553 | 16/20 |
K=3 için: -2\ell=4383{,}824353, q\ln n=23\times6{,}577861=151{,}290811, BIC =4535{,}115164; SABIC'te \ln(721/24)=3{,}402585. BIC, SABIC ve CAIC K=3'ü seçer; AIC K=4'ü çok az farkla (0{,}51) üstün bulur. K=4'te en iyi \ell 20 başlangıcın 16'sında tekrarlanır; ikinci en iyi \ell=-2183{,}7142 yalnız 0,059 uzaktadır ve çok tepelilik uyarısı basılır.
Şekil 78.2. Sol: K = 2–4 bilgi ölçütleri (K = 1 eksen dışında). Sağ: seçilen üç sınıflı çözümde her hastalığın sınıf içi olasılığı.
Adım 6 — Seçilen model (K=3).
| Sınıf 1 | Sınıf 2 | Sınıf 3 | |
|---|---|---|---|
| \pi (SE) | 0,4847 (0,0227) | 0,2890 (0,0290) | 0,2263 (0,0260) |
| hipertansiyon | 0,1627 | 0,9491 | 0,8547 |
| diyabet | 0,0490 | 0,7432 | 0,6176 |
| dislipidemi | 0,0974 | 0,8026 | 0,6041 |
| kalp yetersizliği | 0,0077 | 0,0642 | 0,6573 |
| KOAH | 0,0142 | 0,0572 | 0,4803 |
| KBH | 0,0111 | 0,0765 | 0,5975 |
| depresyon | 0,0456 | 0,0091 | 0,4130 |
Sınıf 1 "düşük yük", Sınıf 2 "kardiyometabolik", Sınıf 3 "ağır çoklu hastalık" diye adlandırılabilir.
Adım 7 — Bir hastanın sonsal olasılıkları (K=3). 1 numaralı hasta (hiç hastalık yok): \eta=(-1{,}134449;\ -7{,}415951;\ -8{,}470723), h_1=(0{,}997484;\ 0{,}001866;\ 0{,}000650), \ln P(\mathbf y_1)=-1{,}131930. 2 numaralı hasta (HT, diyabet, dislipidemi): \eta=(-7{,}964964;\ -2{,}024379;\ -5{,}796813), h_2=(0{,}002565;\ 0{,}975014;\ 0{,}022421).
Adım 8 — Entropi ve ortalama sonsal olasılıklar. E=169{,}633909; n\ln3=789{,}902236; göreli entropi =1-169{,}633909/789{,}902236=0{,}785247. Önsel entropi -n\sum\hat\pi_r\ln\hat\pi_r=752{,}112689; Entropi R^2=1-169{,}633909/752{,}112689=0{,}774457. Modal büyüklükler 351, 212, 156; ortalama sonsal olasılık köşegeni 0,9548; 0,8648; 0,8866 (hepsi ≥ 0,70).
Adım 9 — Mutlak uyum. 87 gözlenen örüntü; beklenen sıklıkların toplamı 693,746. G^2=112{,}3045, X^2=108{,}1649, sd =\min(719,\,127)-23=104; p(G^2)=0{,}272, p(X^2)=0{,}370. Yerel bağımsızlığın büyük bir ihlali görünmez; ama örüntülerin çoğu seyrektir ve \chi^2 yaklaşımı kabadır.
Adım 10 — VLMR ve düzeltilmiş LMR (K=4 / K=3).
p_0+p_1=23+28=51 ağırlık (sınırdaki 3 parametre dışlandı). Sandviç ağırlıkların en büyükleri 3{,}997;\ 1{,}286;\ 1{,}111;\ 0{,}929;\dots, en küçükleri \dots,-0{,}802;\ -1{,}128; ortalama \sum\lambda=7{,}1243, SS 6{,}7492. Imhof integrali: p_{\text{VLMR}}=0{,}0833, p_{\text{aLMR}}=0{,}0875. Ters Hessian ağırlıklarıyla p_{\text{VLMR}}=0{,}0194. K=2/1 ve K=3/2 karşılaştırmalarında LR 739,12 ve 178,19'dur; ağırlık ortalamaları 6,17 ve 8,00 olduğundan p<10^{-13}.
Adım 11 — BLRT (B=50, tohum 42). K=2 ve K=3'te 50 bootstrap LR'nin hiçbiri gözleneni aşmaz (en büyükleri 26,28 ve 26,82): p=1/51=0{,}0196, yani taban değer. K=4'te 50 değerin 8'i 16,51'e eşit ya da büyüktür (ortalama 12,54, en büyük 20,35): p=(1+8)/51=0{,}1765. Aynı tohumla ikinci çalıştırma aynı p'leri verir. BLRT ve VLMR K=3'ü destekler.
Adım 12 — BCH: sınıflara göre depresyon yaygınlığı. Depresyon dışındaki 6 göstergeyle K=3 (BIC ile seçilir): \pi=(0{,}4824;\ 0{,}3109;\ 0{,}2067), modal büyüklükler 352, 232, 135.
Ağırlık toplamları (346{,}85;\ 223{,}51;\ 148{,}64). BCH ortalamaları (depresyon oranı) ve modal grupların ham oranları:
| Sınıf 1 | Sınıf 2 | Sınıf 3 | |
|---|---|---|---|
| Modal grup oranı | 0,0511 | 0,0647 | 0,3852 |
| BCH ortalaması (SE) | 0,0499 (0,0124) | 0,0081 (0,0223) | 0,4431 (0,0499) |
Genel Wald \chi^2(2)=58{,}48, p<0{,}001; ikili: 1–2 \chi^2(1)=2{,}51, p=0{,}113; 1–3 58{,}14; 2–3 50{,}94 (ikisi de p<0{,}001). Modal atamayla Sınıf 2'nin oranı 0,065 görünürken BCH 0,008 bulur: Sınıf 3'ten yanlış atanan hastalar (D'de 0,1975) Sınıf 2'nin ham oranını şişirmiştir.
78.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundaki MixtureFit alanlarından tam hassasiyetle alınmıştır (motor sonuçları yuvarlamaz). VLMR ağırlıkları motorun kendi fonksiyonlarıyla aynı çözümde yeniden üretilmiş, BLRT bootstrap LR listesi _set_blrt yalnız bellekte sarılarak okunmuştur. Python: kendi EM'imiz (60 başlangıç), sayısal skorlarla OPG, Richardson'lu sayısal ikinci türevle Hessian, kendi Imhof integralimiz. R 4.5.3: poLCA 1.6 (40 başlangıç, tol 10^{-12}) ile \ell, \pi, \theta, SE, G², X²; VLMR ağırlıkları kendi log-olabilirlik fonksiyonumuz ve numDeriv ile, p CompQuadForm::imhof ile. Kovaryatlı model ve FIML yolları bu veride (kovaryat ve eksik değer yok) sayısal olarak sınanmamıştır.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Log-olabilirlik ℓ, K = 1–4 | −2650,567054 | −2650,567054 | −2650,567054 | 5,1e−09 | ✓ |
| Parametre sayısı, K = 1–4 | 7 | 7 | 7 | 0,0e+00 | ✓ |
| AIC, K = 1–4 | 5315,134109 | 5315,134109 | 5315,134109 | 1,0e−08 | ✓ |
| BIC, K = 1–4 | 5347,179138 | 5347,179138 | 5347,179138 | 1,0e−08 | ✓ |
| SABIC, K = 1–4 | 5324,952206 | 5324,952206 | — | 1,0e−08 | ✓ |
| CAIC, K = 1–4 | 5354,179138 | 5354,179138 | — | 1,0e−08 | ✓ |
| K = 2: sınıf oranları π (2) | 0,521897 | 0,521897 | 0,521897 | 1,5e−07 | ✓ |
| K = 2: θ = P(hastalık ∣ sınıf) (2 × 7) | 0,899905 | 0,899905 | 0,899905 | 1,7e−07 | ✓ (10⁻⁵; EM durma) |
| K = 3: sınıf oranları π (3) | 0,484681 | 0,484681 | 0,484681 | 6,5e−07 | ✓ |
| K = 3: θ = P(hastalık ∣ sınıf) (3 × 7) | 0,162696 | 0,162696 | 0,162696 | 1,1e−06 | ✓ (10⁻⁵; EM durma) |
| K = 4: sınıf oranları π (4) | 0,410968 | 0,410968 | 0,410968 | 4,2e−08 | ✓ |
| K = 4: θ = P(hastalık ∣ sınıf) (4 × 7) | 0,077001 | 0,077001 | 0,077001 | 1,0e−07 | ✓ (10⁻⁵; EM durma) |
| K = 3: SE(θ), ampirik bilgi (21) | 0,025758 | 0,025758 | 0,025758 | 9,0e−08 | ✓ (R: poLCA) |
| K = 3: SE(π) (3) | 0,022695 | 0,022695 | 0,022695 | 5,2e−08 | ✓ (R: poLCA) |
| Göreli entropi, K = 2–4 | 0,809309 | 0,809309 | 0,809309 | 5,9e−08 | ✓ |
| Entropi R², K = 2–4 | 0,809045 | 0,809045 | 0,809045 | 8,3e−08 | ✓ |
| K = 3: ortalama sonsal olasılıklar (3 × 3) | 0,954778 | 0,954778 | 0,954778 | 1,2e−06 | ✓ (10⁻⁵; EM durma) |
| K = 3: modal sınıf büyüklükleri (3) | 351 | 351 | 351 | 0,0e+00 | ✓ |
| K = 3: en küçük π / en küçük modal oran | 0,226341 | 0,226341 | — | 5,7e−07 | ✓ |
| K = 3: ilk 5 kişinin sonsal olasılıkları (5 × 3) | 0,997484 | 0,997484 | — | 2,0e−06 | ✓ (10⁻⁵; EM durma) |
| K = 3: aynı, MerQur kestirimlerinde (5 × 3) | 0,997484 | 0,997484 | — | 5,1e−15 | ✓ (Python: MerQur'un θ, π'si) |
| K = 3: G² | 112,304520 | 112,304520 | 112,304520 | 8,0e−10 | ✓ |
| K = 3: Pearson X² | 108,164980 | 108,164907 | 108,164924 | 7,4e−05 | ✓ |
| K = 3: artık sd = min(n, ΠR − 1) − npar | 104 | 104 | 104 | 0,0e+00 | ✓ |
| K = 2 / 1: LR = 2(ℓ_K − ℓ_K−1) | 739,119007 | 739,119007 | 739,119007 | 1,2e−10 | ✓ |
| K = 2 / 1: düzeltilmiş LR* | 725,335360 | 725,335360 | 725,335360 | 1,2e−10 | ✓ |
| K = 2 / 1: λ ortalaması Σλ, sandviç | 6,166605 | 6,166612 | 6,166612 | 7,0e−06 | ✓ (göreli 10⁻⁴) |
| K = 2 / 1: λ SS √(2Σλ²), sandviç | 10,024321 | 10,024321 | 10,024321 | 6,6e−07 | ✓ (göreli 10⁻⁴) |
| K = 2 / 1: λ ortalaması, ters Hessian | 8,196948 | 8,196952 | 8,196952 | 3,7e−06 | ✓ (göreli 10⁻⁴) |
| K = 2 / 1: λ sayısı (p₀ + p₁) | 22 | 22 | 22 | 0,0e+00 | ✓ |
| K = 2 / 1: VLMR p, sandviç | 3,33·10−16 | −8,88·10−16 | −5,88·10−15 | 6,2e−15 | ✓ (mutlak 10⁻⁴) |
| K = 2 / 1: düzeltilmiş LMR p, sandviç | 2,78·10−16 | −1,11·10−15 | −6,44·10−15 | 6,7e−15 | ✓ (mutlak 10⁻⁴) |
| K = 2 / 1: VLMR p, ters Hessian | 0 | −4,44·10−16 | 7,91·10−14 | 8,0e−14 | ✓ (mutlak 10⁻⁴) |
| K = 3 / 2: LR = 2(ℓ_K − ℓ_K−1) | 178,190749 | 178,190749 | 178,190749 | 7,1e−10 | ✓ |
| K = 3 / 2: düzeltilmiş LR* | 174,867714 | 174,867714 | 174,867714 | 6,9e−10 | ✓ |
| K = 3 / 2: λ ortalaması Σλ, sandviç | 8,000358 | 8,000445 | 8,000424 | 8,7e−05 | ✓ (göreli 10⁻⁴) |
| K = 3 / 2: λ SS √(2Σλ²), sandviç | 7,391179 | 7,391225 | 7,391214 | 4,5e−05 | ✓ (göreli 10⁻⁴) |
| K = 3 / 2: λ ortalaması, ters Hessian | 8,333013 | 8,333047 | 8,333039 | 3,4e−05 | ✓ (göreli 10⁻⁴) |
| K = 3 / 2: λ sayısı (p₀ + p₁) | 38 | 38 | 38 | 0,0e+00 | ✓ |
| K = 3 / 2: VLMR p, sandviç | 5,55·10−17 | 2,78·10−16 | −1,91·10−14 | 1,9e−14 | ✓ (mutlak 10⁻⁴) |
| K = 3 / 2: düzeltilmiş LMR p, sandviç | 2,22·10−16 | −1,11·10−16 | 9,21·10−15 | 9,3e−15 | ✓ (mutlak 10⁻⁴) |
| K = 3 / 2: VLMR p, ters Hessian | 0 | −6,66·10−16 | 3,83·10−15 | 4,5e−15 | ✓ (mutlak 10⁻⁴) |
| K = 4 / 3: LR = 2(ℓ_K − ℓ_K−1) | 16,514604 | 16,514604 | 16,514604 | 9,3e−09 | ✓ |
| K = 4 / 3: düzeltilmiş LR* | 16,206627 | 16,206627 | 16,206627 | 9,1e−09 | ✓ |
| K = 4 / 3: λ ortalaması Σλ, sandviç | 7,124418 | 7,124309 | 7,124343 | 1,1e−04 | ✓ (göreli 10⁻⁴) |
| K = 4 / 3: λ SS √(2Σλ²), sandviç | 6,749238 | 6,749231 | 6,749238 | 7,5e−06 | ✓ (göreli 10⁻⁴) |
| K = 4 / 3: λ ortalaması, ters Hessian | 5,577137 | 5,577094 | 5,577107 | 4,3e−05 | ✓ (göreli 10⁻⁴) |
| K = 4 / 3: λ sayısı (p₀ + p₁) | 51 | 51 | 51 | 0,0e+00 | ✓ |
| K = 4 / 3: VLMR p, sandviç | 0,083338 | 0,083336 | 0,083337 | 1,6e−06 | ✓ (mutlak 10⁻⁴) |
| K = 4 / 3: düzeltilmiş LMR p, sandviç | 0,087527 | 0,087526 | 0,087526 | 1,7e−06 | ✓ (mutlak 10⁻⁴) |
| K = 4 / 3: VLMR p, ters Hessian | 0,019390 | 0,019390 | 0,019390 | 2,9e−07 | ✓ (mutlak 10⁻⁴) |
| BLRT K = 2: p = (1 + c)/(B + 1), B = 50 | 0,019608 | 0,019608 | — | 0,0e+00 | ✓ (Python: formül) |
| BLRT K = 3: p = (1 + c)/(B + 1), B = 50 | 0,019608 | 0,019608 | — | 0,0e+00 | ✓ (Python: formül) |
| BLRT K = 4: p = (1 + c)/(B + 1), B = 50 | 0,176471 | 0,176471 | — | 0,0e+00 | ✓ (Python: formül) |
| BLRT aynı tohumla tekrar: p (K = 2–4) | 0,019608 | 0,019608 | — | 0,0e+00 | ✓ (iki MerQur çalıştırması) |
| Tohum 7 ile en iyi ℓ, K = 1–4 | −2650,567054 | −2650,567054 | −2650,567054 | 5,0e−09 | ✓ |
| BCH (6 gösterge, K = 3): ℓ | −1979,877432 | −1979,877432 | −1979,877432 | 8,7e−10 | ✓ |
| BCH: ağırlık toplamları Σw (3) | 346,854904 | 346,854802 | 346,854835 | 1,1e−03 | ✓ (göreli 10⁻⁴; EM durma) |
| BCH: sınıf ortalamaları (depresyon oranı, 3) | 0,049925 | 0,049925 | 0,049925 | 1,2e−06 | ✓ (10⁻⁴; EM durma) |
| BCH: genel Wald χ²(2) | 58,476550 | 58,476499 | 58,476516 | 5,1e−05 | ✓ (göreli 10⁻⁴; EM durma) |
| BCH: ikili Wald χ²(1) (3) | 2,510625 | 2,510510 | 2,510547 | 1,1e−04 | ✓ (göreli 10⁻⁴; EM durma) |
| BCH, MerQur sonsallarında: Σw (3) | 346,854904 | 346,854904 | 346,854904 | 3,6e−12 | ✓ |
| BCH, MerQur sonsallarında: ortalamalar (3) | 0,049925 | 0,049925 | 0,049925 | 3,4e−15 | ✓ |
| BCH, MerQur sonsallarında: SE (3) | 0,012433 | 0,012433 | 0,012433 | 2,2e−16 | ✓ |
| BCH, MerQur sonsallarında: genel Wald χ²(2) | 58,476550 | 58,476550 | 58,476550 | 5,6e−13 | ✓ |
| BCH, MerQur sonsallarında: ikili Wald χ²(1) (3) | 2,510625 | 2,510625 | 2,510625 | 5,6e−13 | ✓ |
Toplam 66 satır; eşleşmeyen: 0.
Gerekçeli toleranslar: (i) VLMR ağırlıkları üç kaynakta da sayısal ikinci türevden gelir (MerQur h=10^{-5} merkezi fark; Python Richardson; R numDeriv); göreli 10^{-4} eşleşme bu yöntemlerin doğruluğudur, p değerleri ise 10^{-6} düzeyinde aynıdır. (ii) EM'in mutlak 10^{-10} durma ölçütü parametreleri ~10^{-6} doğrulukta bırakır; \theta, ortalama ve bireysel sonsal olasılıklar bu yüzden 10^{-5}, BCH (\mathbf D^{-1} farkları büyütür) göreli 10^{-4} ile karşılaştırılmıştır. Aynı büyüklükler MerQur'un kendi kestirimleri girdi alınarak Python ve R'de yeniden hesaplanınca 10^{-6} ölçütünü karşılar ("MerQur kestirimlerinde/sonsallarında" satırları); fark yalnız EM'in nerede durduğundan gelir.
78.7 Çıktıyı okuma
Sonuç metni (varsayılan ayarlar, kısaltılmış; seçim tablosunda min π, en küçük mod., VLMR, düzeltilmiş LMR ve BLRT sütunları "…" ile çıkarılmıştır, değerleri 78.6'da):
GİZİL SINIF ANALİZİ (LCA)
Göstergeler             : hypertension, diabetes, ..., depression (7)
N                       : 719
Eksik veri              : Liste bazında silme
Kestirim                : EM; 20 rastgele başlangıç, tohum 42; en çok 2000 yineleme, tolerans 1e-10 (mutlak: |Δℓ| < tol)
── Sınıf sayısı seçimi ──
   K          LL  npar        AIC        BIC      SABIC       CAIC  Entropi  …  Tekrar
   1   -2650.567     7    5315.13    5347.18    5324.95    5354.18        —  …     1/1
   2   -2281.008    15    4592.02    4660.68    4613.05    4675.68    0.809  …   20/20
   3   -2191.912    23    4429.82    4535.12    4462.08    4558.12    0.785  …   20/20 ◄
   4   -2183.655    31    4429.31    4571.22    4472.79    4602.22    0.755  …   16/20
Seçilen model: K = 3 (BIC en küçük)
── Sınıf oranları ──
  Sınıf           π       SE    n (modal)       %
  1          0.4847   0.0227          351   %48.8
  2          0.2890   0.0290          212   %29.5
  3          0.2263   0.0260          156   %21.7
── Koşullu yanıt olasılıkları P(kategori | sınıf) (SE) ──
  hypertension
    Sınıf                    0                 1
    1          0.8373 (0.0258)   0.1627 (0.0258)
...
── Mutlak uyum (G², Pearson X²) ──
  G² = 112.3045, X² = 108.1650, sd = 104; p(G²) = 0.272, p(X²) = 0.370
── Sınıflandırma kesinliği (iki entropi tanımı) ──
   K Göreli entropi Entropi R²
   3         0.7852     0.7745
── Uyarılar ──
⚠ K = 4: en iyi iki farklı log-olabilirlik birbirine çok yakın (-2183.655 / -2183.714; fark 0.059); ...
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Kestirim satırı | başlangıç, tohum, yineleme, tolerans, "(mutlak: |Δℓ| < tol)" | Yeniden üretim bilgisi; tolerans mutlak |\Delta\ell| eşiğidir. |
| Seçim tablosu | K başına \ell, q, ölçütler, entropi, min π, en küçük modal oran, VLMR/aLMR/BLRT p, Tekrar | "◄" seçilen satırdır. p'ler K'yı K-1'e karşı sınar. |
| min π / en küçük mod. | kestirilen ve modal en küçük sınıf oranı | < 0,05 ise seçilen modelde uyarı (latent_class.py:912–913). |
| Tekrar | "16/20" | En iyi \ell'nin tekrar sayısı; 1 ise uyarı. |
| Sınıf oranları | π, SE, modal n ve % | π bir olasılık tahminidir; modal sayılar sınıflama hatası içerir. |
| Koşullu yanıt olasılıkları | her gösterge ve kategori için | Sınıfları adlandırmanın temeli; ikili göstergede iki sütun birbirinin tümleyenidir. |
| Mutlak uyum | G², X², sd, p | Seyrek tabloda yaklaşık; kovaryatlı ya da eksik veride basılmaz. |
| Seçilmeyen K'lar | her K'nın π ve θ'sı | SE yalnız seçilen modelde. |
| Ortalama sonsal olasılıklar | K\times K | Köşegen ≥ 0,70 iyi. |
| İki entropi | göreli ve R^2 | Raporda hangisinin kullanıldığı yazılmalı. |
| BCH bloğu | sınıf ortalamaları (SE), Wald | Dış değişken seçilmişse. |
| "Seçilen sınıf sayısı taranan en büyük değere eşit" | — | Otomatik seçim K_{\max}'ta durmuşsa; K_{\max}'ı artırın (_latent_render.py:179–180). |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Yedi kronik hastalık göstergesine 1–4 sınıflı gizil sınıf modelleri uygulandı (EM, her model için 20 rastgele başlangıç, N=719). BIC en küçük değerini üç sınıflı çözümde aldı (BIC =4535{,}12; iki sınıflı 4660,68; dört sınıflı 4571,22); VLMR testi üç sınıfı ikiye karşı destekledi (p<0{,}001) ama dördüncü sınıfı desteklemedi (sandviç kovaryanslı VLMR p=0{,}083; BLRT p=0{,}176, B=50). Sınıf oranları 0,48 (düşük hastalık yükü), 0,29 (kardiyometabolik) ve 0,23 (ağır çoklu hastalık) idi; göreli entropi 0,79, ortalama sonsal sınıf olasılıkları 0,86–0,95 arasındaydı. Depresyon yaygınlığı (BCH üç adımlı yöntem) sınıflar arasında farklıydı, Wald \chi^2(2)=58{,}48, p<0{,}001 (sırasıyla 0,05; 0,01; 0,44).
78.8 Uzman soruları
S1. Hangi algoritma, hangi başlangıç, ne zaman durur?
EM: E-adımı sonsal olasılıklar, M-adımı kapalı biçimli oranlar. Başlangıç: \theta satırları U(0{,}1)'den çekilip normalleştirilir, \pi=1/K. İki evre: tüm başlangıçlar |\Delta\ell|<10^{-6}'ya kadar, sonra hepsi |\Delta\ell|<10^{-10}'a kadar (mutlak ölçüt). R poLCA da EM ve rastgele başlangıç kullanır; durma ölçütü \ell'nin değişimidir (varsayılan 10^{-10}).
S2. K=4'te "Tekrar 16/20" ve "çok tepeli" uyarısı ne anlatıyor?
20 başlangıcın 16'sı aynı en iyi \ell'ye (−2183,655) vardı; diğer 4'ü −2183,714'teki yerel en büyükte kaldı. İlk iki farklı \ell arasındaki fark 0,059 < 1 olduğu için uyarı basılır: iki çözüm olabilirlik açısından neredeyse eşdeğerdir ama parametreleri farklı olabilir. Bu, dört sınıfın veride iyi tanımlanmadığının işaretidir; seçilen model K=3'tür ve 20/20 tekrarlanır.
S3. VLMR p neden sandviç ve Hessian tanımlarında bu kadar farklı?
Ağırlıklar \lambda, \mathbf V_k'nin tanımına bağlıdır. Sandviç \mathbf A^{-1}\mathbf B\mathbf A^{-1}, model yanlış belirlendiğinde (yerel bağımsızlık ihlali gibi) varyansı daha gerçekçi verir ve genellikle daha büyük ağırlıklar, dolayısıyla daha büyük p üretir. Bu veride K=4/3: sandviç 0,083, Hessian 0,019. Uygulamalar arasında iki tanım da kullanılır; LMR (2001) Hessian kullanır (Vermunt 2024). MerQur hangisini kullandığını her çıktıda yazar; raporda belirtilmelidir.
S4. \theta=0 çıkan sınıflarda ne olur?
K=4 çözümünde üç olasılık tam 0'dır (4. sınıfta diyabet ve kalp yetersizliği, 1. sınıfta KOAH). ML kestirimi parametre uzayının sınırındadır; SE tanımsıza yakındır. MerQur log hesabında 10^{-300} tabanı kullanır, VLMR'de logiti -15'in altındaki parametreleri sabit sayar. Bu yüzden K=4 VLMR'de p_1=28'dir. Raporda sınırdaki olasılıklar "0 (sabit)" diye belirtilmelidir.
S5. BLRT ile VLMR çeliştiğinde hangisine güvenilir?
Nylund vd. (2007) benzetimlerinde BLRT, LCA'da sınıf sayısını VLMR'den daha tutarlı belirler; VLMR biraz fazla sınıf seçme eğilimindedir. Ancak BLRT'nin p'si B ile sınırlıdır (1/(B+1) tabanı) ve MerQur bootstrap örneklerinde K sınıflı modeli yalnız 5 başlangıçla kestirir; yerel en büyükler p'yi küçültebilir. Kararda BIC, BLRT, VLMR, entropi ve sınıfların yorumlanabilirliği birlikte değerlendirilmelidir.
S6. BCH ortalaması neden modal grup ortalamasından bu kadar farklı?
Modal gruplar sınıflandırma hatası içerir: \mathbf D'nin üçüncü satırı, gerçek Sınıf 3 üyelerinin %19,7'sinin Sınıf 2'ye atandığını söyler. Depresyon Sınıf 3'te yaygın (%44) olduğundan bu kişiler Sınıf 2'nin ham oranını 0,065'e çıkarır. BCH ağırlıkları bu karışımı \mathbf D^{-1} ile çözer ve Sınıf 2 için 0,008 verir. Negatif ağırlıklar bu düzeltmenin parçasıdır.
S7. BCH ortalaması bir oran (0/1 değişken) için 0'ın altına düşebilir mi?
Evet. Ağırlıklar negatif olabildiğinden \hat\mu_s değişkenin doğal aralığının dışına çıkabilir; özellikle sınıflama zayıf ve sınıf küçükse. Bu veride Sınıf 2 için 0,008'dir ve SE 0,022 olduğundan GA 0'ı içerir. MerQur ortalamayı kırpmaz. İkili dış değişkende ML tabanlı alternatif (Vermunt 2010 ML düzeltmesi) MerQur'da yoktur.
S8. Entropi 0,79: sınıflar "iyi" ayrışmış mı?
Göreli entropi 0,785, MerQur etiketine göre "orta" (0,60–0,80) aralığındadır; ortalama sonsal köşegeni ise 0,86–0,95'tir. Entropi bir sınıf sayısı seçim ölçütü değildir (Nylund-Gibson ve Choi 2018); sınıfların modal atamayla kullanılacağı durumlarda (ör. BCH'siz ikinci adım analizleri) belirleyicidir. Entropi R^2 (0,774) taban olarak önsel sınıf oranlarını aldığı için biraz daha düşüktür.
S9. Tohum değişince sonuç değişir mi?
Tohum 7 ile tüm K'larda aynı en iyi \ell'ler bulunur (doğrulama tablosu). Değişebilecek olan, yerel en büyüklerin tekrar sayılarıdır. Her başlangıç (\text{tohum},K,i)'den türetilen kendi akışından çeker; başlangıç sayısını değiştirmek öteki K'ların başlangıçlarını değiştirmez (78.5.3). Sonuç kararlılığı için en iyi \ell'nin birden çok başlangıçta tekrarlanması ve farklı tohumla aynı çözümün bulunması raporlanmalıdır.
S10. poLCA ile neden aynı sınıf numaraları çıkmıyor?
poLCA sınıfları başlangıca göre rastgele sırada döndürür; MerQur her zaman azalan \pi sırasına dizer (latent_class.py:542–551). Karşılaştırmada sınıflar \pi'ye göre eşlenmelidir. Kestirimler, SE'ler (her ikisi de ampirik bilgi), G², X² ve sd tanımları aynıdır.
78.9 Sık hatalar ve tuzaklar
- Az başlangıçla yetinmek. 20 başlangıç bu veride yeterlidir, ama K ve gösterge sayısı arttıkça olabilirlik çok tepeli olur. "Tekrar" sütunu 1 ise sonuç güvenilmezdir.
- Sınıf sayısını yalnız bir ölçüte göre seçmek. AIC burada K=4'ü seçer; BIC, CAIC, VLMR ve BLRT K=3'ü. Gerekçe birden çok ölçütle ve yorumlanabilirlikle verilmelidir.
- Modal atamaları kesin grup sanmak. Modal gruplarla yapılan ikinci adım analizleri (ki-kare, ANOVA) sınıflandırma hatasını yok sayar ve farkları zayıflatır; dış değişkenler için BCH kullanılmalıdır.
- VLMR kovaryansını raporlamamak. Sandviç ve Hessian tanımları aynı çözümde p'yi bir büyüklük mertebesine kadar değiştirebilir.
- BLRT p=0{,}0196'yı "p=0{,}02" diye okumak. B=50'de bu en küçük ulaşılabilir değerdir; gerçek p çok daha küçük olabilir.
- Seyrek tabloda G²/X² p'sine güvenmek. 128 hücreden 41'i boştur; \chi^2 yaklaşımı zayıftır.
- Kovaryat ile göstergeyi karıştırmak. Aynı değişken hem gösterge hem kovaryat ya da hem gösterge hem dış değişken olamaz; MerQur hata verir (
latent_class.py:759–761,1359–1361). - Çok kategorili sürekli değişkeni LCA'ya koymak. 20'den çok değerli göstergeler reddedilir; 20 değerli bir değişken bile her değer için ayrı olasılık demektir ve parametre sayısını patlatır.
78.10 Kaynaklar
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/TAC.1974.1100705
- Bakk, Z., Tekle, F. B., & Vermunt, J. K. (2013). Estimating the association between latent class membership and external variables using bias-adjusted three-step approaches. Sociological Methodology, 43(1), 272–311. https://doi.org/10.1177/0081175012470644
- Bandeen-Roche, K., Miglioretti, D. L., Zeger, S. L., & Rathouz, P. J. (1997). Latent variable regression for multiple discrete outcomes. Journal of the American Statistical Association, 92(440), 1375–1386. https://doi.org/10.1080/01621459.1997.10473658
- Bolck, A., Croon, M., & Hagenaars, J. (2004). Estimating latent structure models with categorical variables: One-step versus three-step estimators. Political Analysis, 12(1), 3–27. https://doi.org/10.1093/pan/mph001
- Bozdogan, H. (1987). Model selection and Akaike's information criterion (AIC): The general theory and its analytical extensions. Psychometrika, 52(3), 345–370. https://doi.org/10.1007/BF02294361
- Celeux, G., & Soromenho, G. (1996). An entropy criterion for assessing the number of clusters in a mixture model. Journal of Classification, 13(2), 195–212. https://doi.org/10.1007/BF01246098
- Dayton, C. M., & Macready, G. B. (1988). Concomitant-variable latent-class models. Journal of the American Statistical Association, 83(401), 173–178. https://doi.org/10.1080/01621459.1988.10478584
- Dempster, A. P., Laird, N. M., & Rubin, D. B. (1977). Maximum likelihood from incomplete data via the EM algorithm. Journal of the Royal Statistical Society: Series B (Methodological), 39(1), 1–22. https://doi.org/10.1111/j.2517-6161.1977.tb01600.x
- Goodman, L. A. (1974). Exploratory latent structure analysis using both identifiable and unidentifiable models. Biometrika, 61(2), 215–231. https://doi.org/10.1093/biomet/61.2.215
- Hipp, J. R., & Bauer, D. J. (2006). Local solutions in the estimation of growth mixture models. Psychological Methods, 11(1), 36–53. https://doi.org/10.1037/1082-989X.11.1.36
- Imhof, J. P. (1961). Computing the distribution of quadratic forms in normal variables. Biometrika, 48(3–4), 419–426. https://doi.org/10.1093/biomet/48.3-4.419
- Lazarsfeld, P. F., & Henry, N. W. (1968). Latent structure analysis. Houghton Mifflin.
- Linzer, D. A., & Lewis, J. B. (2011). poLCA: An R package for polytomous variable latent class analysis. Journal of Statistical Software, 42(10), 1–29. https://doi.org/10.18637/jss.v042.i10
- Lo, Y., Mendell, N. R., & Rubin, D. B. (2001). Testing the number of components in a normal mixture. Biometrika, 88(3), 767–778. https://doi.org/10.1093/biomet/88.3.767
- McLachlan, G. J. (1987). On bootstrapping the likelihood ratio test statistic for the number of components in a normal mixture. Applied Statistics, 36(3), 318–324. https://doi.org/10.2307/2347790
- Nylund, K. L., Asparouhov, T., & Muthén, B. O. (2007). Deciding on the number of classes in latent class analysis and growth mixture modeling: A Monte Carlo simulation study. Structural Equation Modeling, 14(4), 535–569. https://doi.org/10.1080/10705510701575396
- Nylund-Gibson, K., & Choi, A. Y. (2018). Ten frequently asked questions about latent class analysis. Translational Issues in Psychological Science, 4(4), 440–461. https://doi.org/10.1037/tps0000176
- Ramaswamy, V., DeSarbo, W. S., Reibstein, D. J., & Robinson, W. T. (1993). An empirical pooling approach for estimating marketing mix elasticities with PIMS data. Marketing Science, 12(1), 103–124. https://doi.org/10.1287/mksc.12.1.103
- Schwarz, G. (1978). Estimating the dimension of a model. The Annals of Statistics, 6(2), 461–464. https://doi.org/10.1214/aos/1176344136
- Sclove, S. L. (1987). Application of model-selection criteria to some problems in multivariate analysis. Psychometrika, 52(3), 333–343. https://doi.org/10.1007/BF02294360
- Vermunt, J. K. (2010). Latent class modeling with covariates: Two improved three-step approaches. Political Analysis, 18(4), 450–469. https://doi.org/10.1093/pan/mpq025
- Vermunt, J. K. (2024). The Vuong-Lo-Mendell-Rubin test for latent class and latent profile analysis: A note on the different implementations in Mplus and LatentGOLD. Methodology, 20(1), 72–83. https://doi.org/10.5964/meth.12467
- Vuong, Q. H. (1989). Likelihood ratio tests for model selection and non-nested hypotheses. Econometrica, 57(2), 307–333. https://doi.org/10.2307/1912557