107. Düzenlileştirilmiş Regresyon (LASSO/Ridge/ElasticNet)
Analiz kimliği: regularized · Menü adı: Düzenlileştirilmiş Regresyon (LASSO/Ridge/ElasticNet) · Panel: gui/panels/analyses/regularized_regression_panel.py (form 51–193, execute 214–271, ikili/Poisson yolu _execute_glm 418–510, metin 513–577) · Motor: stats/regularized_regression.py, run_regularized (satır 180–369), metin format_regularized_text (381–463); ortak yardımcılar stats/regularized_extras.py; cezalı GLM stats/glmnet_glm.py · Çağrı: stats_panel.py:9614–9675
107.1 Ne işe yarar
Bu menü, doğrusal (ya da lojistik/Poisson) modeli üç cezadan biriyle kestirir ve ceza düzeyini varsayılan olarak çapraz doğrulamayla kendisi seçer. Cevapladığı soru: "Çok sayıda, birbiriyle ilişkili açıklayıcı varken yeni gözlemlerde iyi tahmin veren model hangisidir; hangi değişkenler bu modelde kalır?"
- \mathbf z_i: standartlaştırılmış açıklayıcılar ("Standardize et" açıkken; 52.5.1).
- α: ceza düzeyi; formdaki "α (alpha)", 0 = Otomatik (CV).
- l1: "L1 oranı (ElasticNet)"; LASSO'da 1, ElasticNet'te formdaki değer.
- Ridge (L2) yöntemi bu amacı kullanmaz; kendi birimindedir (107.5.1).
Ne zaman kullanılır?
- Tahmin amaçlı model kurulacak ve ceza düzeyinin veriyle seçilmesi isteniyorsa.
- Açıklayıcılar ilişkili gruplar oluşturuyor ve seçim de isteniyorsa: ElasticNet (Zou ve Hastie 2005); lasso gruptan birini alırken ElasticNet ilişkili değişkenleri birlikte tutma eğilimindedir.
- Katlar karıştırılarak, tekrarlı CV ile ya da bootstrap seçim sıklığıyla daha sağlam bir ceza seçimi isteniyorsa (bu seçenekler Ridge ve Lasso menülerinde yoktur).
Ne zaman kullanılmaz?
- Katsayılar için p değeri, GA ya da hipotez testi gerekiyorsa: Çoklu Doğrusal Regresyon.
- Ridge için LOO, GCV, HKB, L-W ölçütleri, VIF ya da ridge izi gerekiyorsa: Ridge Regresyon (Bölüm 52).
- Seçilenlerle cezasız yeniden uydurma (relaxed) ya da alt örneklem kararlılığı gerekiyorsa: Lasso Regresyon (Bölüm 53).
- Gözlem sayısı 20'nin altındaysa: menü hata verir.
Sık karıştırılan analizler. Ridge Regresyon ve Lasso Regresyon menüleri aynı modelleri stats/regression.py motoruyla kurar; bu menü ayrı bir motordur (stats/regularized_regression.py). LASSO yöntemi aynı birimdedir ve aynı α'da aynı katsayıları verir (iki motor da regularized_extras.fit_lasso'yu çağırır). Ridge yöntemi de Ridge menüsüyle aynı birimdedir (Ridge(alpha = α)). Farklar: bu menüde varsayılan otomatik α'dır, R^2(CV) tanımı farklıdır (107.5.6), ElasticNet ve karıştırmalı/tekrarlı CV vardır.
107.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Doğrusal ilişki (Gauss) ya da logit/log bağlantı (GLM) | Doğrusal yordayıcı açıklayıcıların doğrusal birleşimi. | Denetlenmez. |
| Bağımsız gözlemler | Satırlar arası bağımlılık yok. | Denetlenmez; sıralı veride "CV katlarını karıştır" önerilir. |
| Yeterli gözlem | En az 20 tam satır. | Hata (regularized_regression.py:230–232). |
| Değişken hedef | Hedef sabit olamaz; açıklayıcıların hepsi sabit olamaz. | Hata (regularized_regression.py:239–242). |
| İkili hedef 0/1 | Lojistik ailede yalnız 0 ve 1. | Hata (regularized_regression_panel.py:432–433). |
| Sayım hedefi | Poisson ailede negatif olmayan tam sayılar. | Hata (regularized_regression_panel.py:434–435). |
Eksik değer. Kategorik açıklayıcılar önce kukla değişkene açılır (eksik değer kuklada da eksik kalır, regularized_regression_panel.py:356–379); sonra hedef ve bütün açıklayıcılarda eksiksiz satırlar alınır (liste bazında silme, regularized_regression.py:228–229).
Uç durumlar (koddan):
- En az 2 açıklayıcı gerekir (
regularized_regression.py:217–219; çağıran panel de denetler). - Tek bir sabit açıklayıcı atılmaz: SS'si 1 alınır, standart sütunu sıfır olur ve katsayısı 0 kalır (
regularized_extras.py:48–54). - ElasticNet'te L1 oranı 0 ise model saf ridge olarak (glmnet birimiyle) uydurulur ve uyarılır.
- Koordinat inişi yakınsamazsa "Lasso koordinat inişi yineleme sınırında yakınsamadı" uyarısı yazılır.
- Seçilen α ızgaranın ucundaysa uyarılır (52.5.6'daki iletiler).
107.3 Parametreler
Varsayılanlar regularized_regression_panel.py:51–193, read_options (331–351) ve stats_panel.py:9614–9642'den alınmıştır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımlı değişken | ilk sayısal sütun | Hedef. | — |
| Yöntem | LASSO (L1) | LASSO, Ridge (L2), ElasticNet (L1+L2). | Ceza türü ve α birimi. |
| α (alpha) | 0 = Otomatik (CV) (aralık 0–10⁶, 6 ondalık) | 0 ise CV ile seçilir; > 0 ise sabit. | Model ve seçilen değişkenler. |
| L1 oranı (ElasticNet) | 0,50 | ElasticNet karışımı; 0 saf ridge, 1 lasso. | Seyreklik; LASSO/Ridge'de yok sayılır. |
| L1 oranını CV ile seç (ElasticNet) | kapalı | L1 oranını {0,1; 0,5; 0,7; 0,9; 0,95; 0,99; 1} içinden CV ile seçer. | L1 ve α birlikte seçilir. |
| CV kat sayısı | 5 (2–10) | K. | CV eğrisi, α, R^2(CV). |
| Standardize et (önerilir) | açık | 1/n-SS ile standartlaştırma; her eğitim katında yeniden. | Kapalıysa ceza ham birimlere uygulanır. |
| Grafik | Katsayı çubukları (varsayılan) | Çubuk, katsayı yolu, CV hata eğrisi, 3B yüzey. | Yalnız Grafik sekmesi. |
| Hedef dağılımı | Sürekli (Gauss, varsayılan) | İkili ya da sayım için cezalı GLM. | Motor glmnet_glm'e geçer. |
| α/λ seçim kuralı | En küçük CV hatası | λ_min ya da 1-SE kuralı. | 1-SE daha sade model. |
| CV katlarını karıştır (tohumlu) | kapalı | Katları tohumlu rastgele atar. | Kat bileşimi ve seçilen α. |
| CV / bootstrap tohumu | 42 | Karıştırma ve bootstrap tohumu (seed). | Yeniden üretilebilirlik. |
| CV tekrar sayısı | 1 (1–50) | Tekrarlı K-kat; > 1 ise katlar her tekrarda karıştırılır. | CV eğrisi tekrarların ortalaması. |
| Bootstrap kararlılık (B) | 0 = Kapalı (0–2000) | Seçilen α'da B bootstrap örnekleminde seçilme sıklığı. | Ek tablo sütunu ve bölüm. |
| Bağımsız değişkenler | en az 2 | Sayısal ya da kategorik. | Kategorikler kukla (ilk düzey referans). |
Tekrar sayısı > 1 iken neden karıştırma zorunlu?
Karıştırma kapalı ve tekrar > 1 olsaydı her tekrar aynı ardışık katları kullanır, ortalama hiçbir şey değiştirmezdi. MerQur bu durumda karıştırmayı kendiliğinden açar (regularized_regression_panel.py:241): r. tekrarın katları default_rng(tohum + 1000 r) ile karıştırılır. Çıktıdaki "CV: karıştırma = evet, tohum = 42, tekrar = 3" satırı bunu kayda geçirir.
α = 0 neden "Otomatik"?
α = 0 cezasız EKK demektir ve LASSO/ElasticNet için anlamlı bir ayar değildir. Form 0'ı "Otomatik (CV)" anlamında kullanır; çağıran kod α ≤ 0'ı None'a çevirir (stats_panel.py:9629). Cezasız model isteyen kullanıcı Çoklu Doğrusal Regresyon'u kullanmalıdır.
107.4 Tıp örneği
Dosya: english/datasets/Tip/57_elasticnet_risk_score.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/57_elasticnet_risk_skor.xlsx). Tıp setinde bu menünün karşılığı #57 "Elastik Ağ"dır; değişken seçimi VIDEO_SCRIPT_TR.txt #57'deki gibidir.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
risk_score |
Bağımlı | sürekli | ort. −0,118; SS 1,694; −4,30–4,80 |
x01 … x40 |
Açıklayıcı (40) | sürekli | ortalamalar −0,11–0,01; SS 0,62–0,76 |
patient_id |
— | kimlik | kullanılmaz |
n ve eksik değer: 220 hasta, eksik değer yok. Açıklayıcılar arası korelasyonlar 0,31–0,58 (ortanca 0,47): 40 değişken tek bir ilişkili küme oluşturur. y ile en güçlü ilişkiler x25 (r=0{,}552), x05 (0,510), x18 (0,471); diğer 37 değişkende 0,34–0,38 civarı ya da altıdır.
Klinik soru: 40 ilişkili belirteçten kurulan bir risk skoru modeli yeni hastalarda ne kadar iyi tahmin eder ve hangi belirteçler seçilir?
Seçilen ayarlar: Senaryoya uygun olarak Yöntem = ElasticNet, L1 oranı 0,5, α = 0 (otomatik), diğerleri varsayılan. Ek çalıştırmalar: LASSO (menü varsayılanı) ve Ridge (otomatik α); ElasticNet λ_1SE; L1 oranı CV; sabit α = 0,1; Ridge α = 1 ile ElasticNet L1 = 0, α = 1 (birim karşılaştırması); 3 tekrarlı CV; standartlaştırma kapalı LASSO; bootstrap (B = 100). Lojistik yol için türetilmiş ikili hedef: risk_yuksek = 1{risk_score > medyan} (110/110; yalnız bu doğrulama için).
107.5 Formüller ve hesap adımları
Hesap sırası (run_regularized, 173–362): (1) kategorik açılım, liste bazında silme, ön denetimler; (2) \bar x, 1/n-SS; (3) l1 oranı CV açıksa her oran için ızgara ve CV eğrisi, en iyisi; (4) seçilen l1 için veriye dayalı ızgara; (5) CV eğrisi (bütün tekrarlar); (6) α boşsa λ_min ya da λ_1SE; (7) son model tam veride; (8) eğitim R^2/RMSE ve kat bazlı R^2(CV)/RMSE(CV); (9) katsayı yolu, özgün ölçek, tablo; (10) panelde bootstrap.
107.5.1 Üç yöntemin amaç fonksiyonu
- \text{RSS}=\sum_i(y_i-\beta_0-\mathbf z_i^{\top}\boldsymbol\beta)^2.
- LASSO ve ElasticNet scikit-learn
Lasso/ElasticNetamacıdır; glmnet'in Gauss amacıyla aynı biçimdedir. - ElasticNet'te l1 = 0 ise
Ridge(alpha = α·n)ile kapalı formdan çözülür (regularized_extras.py:489–490): \frac{1}{2n}\text{RSS}+\frac{\alpha}{2}\lVert\boldsymbol\beta\rVert^2 amacının 2n katı.
Aynı menüde iki ridge birimi
"Ridge (L2)" yöntemiyle α = 1 ve "ElasticNet, L1 oranı = 0" ile α = 1 aynı model değildir: ikincisi α = n ridge'e eşittir. Tıp #57'de x01 katsayısı Ridge α = 1'de 0,069075, ElasticNet L1 = 0, α = 1'de 0,060367'dir; ikincisi Ridge α = 220 ile birebir aynıdır. Tooltip ve L1 = 0 uyarısı birimi yazar.
107.5.2 Koordinat inişi (ElasticNet)
- S(u,\gamma)=\operatorname{işaret}(u)\max(\lvert u\rvert-\gamma,0): yumuşak eşikleme (53.5.3).
- Paydadaki \alpha(1-\text{l1}): L_2 kısmı katsayıyı ayrıca 1/(1+\alpha(1-\text{l1})) oranında büzer.
- c_j=1 (standart açıklayıcılar); "Standardize et" kapalıysa c_j ham varyanstır.
Optimumda sıfırdan farklı katsayılar için \frac1n\mathbf z_j^{\top}\mathbf r-\alpha(1-\text{l1})\beta_j=\alpha\,\text{l1}\operatorname{işaret}(\beta_j), sıfırlar için \lvert\frac1n\mathbf z_j^{\top}\mathbf r\rvert\le\alpha\,\text{l1} sağlanır. MerQur bunu scikit-learn ElasticNet/Lasso ile tol = 1e-12, max_iter = 200000 kullanarak çözer (regularized_extras.py:481–498).
ElasticNet neden ilişkili değişkenleri birlikte tutar?
L_2 terimi amaç fonksiyonunu kesin dışbükey yapar. İki açıklayıcı neredeyse aynıysa lasso için aralarındaki ağırlık bölüşümü belirsizdir ve çözüm birini sıfırlar; ElasticNet'te L_2 cezası, toplam etkiyi iki katsayıya eşit bölmeyi daha ucuz kılar (Zou ve Hastie 2005, "gruplama etkisi"). Bu yüzden 40 ilişkili belirteçte ElasticNet, aynı tahmin hatasında lasso'dan biraz daha çok değişken seçer.
107.5.3 α ızgarası
LASSO ve ElasticNet (regularized_extras.py:57–74, 117–144):
- l1'e bölme: L_1 kısmının eşiği \alpha\,\text{l1} olduğundan bütün katsayıların sıfır kaldığı en küçük α budur.
- Yol durdurma kuralı lasso'daki gibidir (53.5.4): m\ge5 iken R^2 artışı <10^{-5}R^2 ya da R^2>0{,}999.
- Çok küçük l1'de glmnet'in kendi karışım parametresi \alpha'=(\text{l1}/s_y)/(\text{l1}/s_y+1-\text{l1}) 10^{-3}'ün altına düşerse λ_max glmnet'in 10^{-3} alt sınırıyla yeniden ölçeklenir (s_y: y'nin 1/n-SS'si).
Ridge yöntemi: Bölüm 52.5.6'daki df tabanlı 100 değerli ızgara (10^3\max d^2 → 10^{-3}\min d^2).
107.5.4 Çapraz doğrulama eğrisi
Kat kümeleri (cv_fold_sets, regularized_regression.py:84–100): karıştırma kapalı ve tek tekrarda ardışık bloklar; aksi hâlde r. tekrar için kat numaraları 1,\dots,K,1,\dots dizisinin default_rng(tohum + 1000 r) permütasyonudur (glmnet_glm.py:163–172). Her tekrar için eğri (_cv_curve, 112–136):
- \text{MSE}_{rk}: r. tekrarda k. test katının MSE'si; eğitim katında \bar x ve 1/n-SS yeniden hesaplanır ("Standardize et" kapalıysa yalnız merkezleme).
- w_k=n_k/n: kat büyüklüğü ağırlığı.
- R: tekrar sayısı; eğri ve SE tekrarlar üzerinden ortalanır (SE'ler birleştirilmez, ortalanır).
- Ridge yönteminde katta glmnet λ'sı sabit tutulur: eğitim katındaki ceza \alpha\,n_{\text{eğitim}}/n'dir (cv.glmnet tanımı; Bölüm 52 ile aynı). CV performansı da aynı kuralı kullanır.
ElasticNet'te katta y ölçeği. glmnet Gauss ailesinde y'yi her eğitim katında kendi SS'siyle yeniden ölçekler; bu, L_2 kısmının etkin ağırlığını kattan kata değiştirir. MerQur aynısını yapar (regularized_extras.py:501–539, y_scale_ref):
- s_y: tam verideki y'nin 1/n-SS'si; s_{y,k}: k. eğitim katındaki.
- Lasso'da (l1 = 1) L_2 terimi olmadığından bu ayar etkisizdir; Ridge yönteminde uygulanmaz.
- Bu tanım R
cv.glmnet(x, y/s_y, alpha = α', lambda = …, foldid = …)ile aynıdır.
Seçim kuralı (_pick, 103–109): \lambda_{\min} en küçük \overline{\text{CV}}'yi veren (eşitlikte en büyük) α; \lambda_{1\text{SE}} \overline{\text{CV}}\le\overline{\text{CV}}(\lambda_{\min})+\overline{\text{SE}}(\lambda_{\min}) olan en büyük α.
107.5.5 L1 oranının CV ile seçimi
"L1 oranını CV ile seç" açıkken \text{l1}\in\{0{,}1;\ 0{,}5;\ 0{,}7;\ 0{,}9;\ 0{,}95;\ 0{,}99;\ 1\} için ayrı ızgara ve CV eğrisi kurulur; en küçük \min_\alpha\overline{\text{CV}}'yi veren oran seçilir (eşitlikte ilk oran, regularized_regression.py:259–268). α sabit girilmişse her oran yalnız o α'da değerlendirilir. Izgarada 0 bulunmaz; saf ridge bu yolla seçilemez.
107.5.6 Uyum ölçüleri
- \tilde y_i: i'yi içermeyen eğitim katında, seçilmiş α ile kurulan modelin tahmini.
- \bar y_k: test katının kendi ortalaması.
- Kat R^2'lerinin ve RMSE'lerinin düz ortalaması (scikit-learn
cross_val_scoretanımı;_fold_perf, 146–170).
İki farklı "CV R²"
Ridge ve Lasso menülerindeki "R²_CV" havuzlanmış tanımdır (1-\sum e^2/\text{TSS}, tam veri ortalamasıyla). Bu menüdeki "R² (CV)" kat R^2'lerinin ortalamasıdır ve paydada kat ortalaması kullanır; aynı veride ve aynı α'da genellikle biraz daha küçüktür. Ayrıca ElasticNet'te R^2(CV) katta y ölçeklemesi (107.5.4) yapmadan sabit α ile hesaplanır; seçim eğrisiyle aynı amaç değildir. α seçimi bu sayıyla değil, CV-MSE eğrisiyle yapılır.
107.5.7 Katsayılar ve seçim
Son model tam veride kurulur; standart katsayılar \beta_j, özgün ölçek B_j=\beta_j/s_j, b_0=\bar y-\sum B_j\bar x_j (52.5.4; regularized_regression.py:320–329). Tabloda "β (std)" (6 ondalığa yuvarlı), "B" ve "Seçildi" sütunları vardır; \lvert\beta_j\rvert>10^{-8} olan değişken "seçilmiş" sayılır (297). Standartlaştırma kapalıysa tek sütun "β" vardır ve sabit ham ölçektedir. "Sabit" satırı standart ölçekte \bar y'dir.
107.5.8 Bootstrap seçim sıklığı
B>0 ise seçilen α ve l1'de, default_rng(tohum) ile n büyüklüğünde iadeli örneklemler çekilir; her biri kendi \bar x ve 1/n-SS'siyle standartlaştırılıp aynı α ile uydurulur (regularized_regression_panel.py:388–413):
- Ridge yönteminde (ve l1 = 0'da) hesaplanmaz: her değişken her zaman seçilidir ("Ridge'de tüm katsayılar sıfırdan farklı").
- Bölüm 53'teki "Seçim kararlılığı" iadesiz yarım örneklem kullanır; iki sıklık aynı veride farklı çıkar.
107.5.9 İkili ve Poisson hedef (glmnet_glm)
"Hedef dağılımı" ikili ya da sayım seçilince ayrı bir motor çalışır (stats/glmnet_glm.py). Amaç:
- a: LASSO'da 1, Ridge'de 0, ElasticNet'te L1 oranı ("a (L1 mix)").
- λ: formdaki α; glmnet'in λ'sıyla aynı birim. Burada Ridge de bu birimdedir (Gauss Ridge yönteminden farklı).
IRLS dış döngüsü (w=\mu(1-\mu) ya da \mu, 10^{-10}'da kırpılır); iç ağırlıklı elastik ağ problemi scikit-learn ElasticNet ile (tol = 1e-10; \alpha_{\text{sk}}=\lambda n/\sum w), saf ridge (a=0) ağırlıklı kapalı çözümle; dış durma ölçütü \max\lvert\Delta\beta\rvert<10^{-8} (glmnet_glm.py:40–81). λ dizisi:
ve yol, açıklanan sapma oranı D^2_m>0{,}999 ya da mutlak artışı D^2_m-D^2_{m-1}<10^{-5} (en az 5 λ; glmnet fdev tanımı, Friedman, Hastie ve Tibshirani 2010) olunca kesilir (glmnet_glm.py:89–131). Durdurma yalnız λ dizisi içeride kurulduğunda uygulanır; CV katlarında dizi verildiği için kat yolları sonuna kadar uydurulur (cv.glmnet ile aynı). CV: her test katında ortalama birim sapma; kat büyüklüğüyle ağırlıklı ortalama cvm ve cvsd; λ_min argmin cvm, λ_1SE (glmnet_glm.py:134–160). Katsayılar özgün ölçekte verilir ve exp(B) (lojistikte OR, Poisson'da oran oranı) eklenir. Kullanıcı α'sı verilirse diziye eklenir ve yol yeniden uydurulur; seçilen λ dizide α'ya en yakın değerdir (453–464).
Koddaki tercih: kullanıcı λ'sında erken durdurma yok
Tam veri yolunda erken durdurma uygulanır. Kullanıcı bir α girdiğinde ise yol erken durdurulmadan sonuna kadar uydurulur (early_stop=False); böylece model, durma noktası girilen değerin üstünde kalsa bile tam olarak kullanıcının λ'sıyla kurulur. Tıp #57'de LASSO lojistik, α = 10^{-5} ile model λ = 10^{-5}'te kurulur.
107.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/regularized/elle_hesap.py ile (MerQur ve scikit-learn çağrılmadan; kendi koordinat inişimiz, ardından etkin kümede KKT denklemlerinin kesin çözümü) hesaplanmıştır.
Adım 1 — Ölçekler. \bar y=-0{,}117541, s_y=1{,}689714. \frac1n\mathbf z_j^{\top}\mathbf y_c'nin en büyükleri: x25 0,933085; x05 0,861823; x18 0,796695; x40 0,643896; x17 0,628837.
Adım 2 — Izgaralar. LASSO: \lambda_{\max}=0{,}933085, durdurma kuralıyla 76 değer (0{,}00087020'ye kadar). ElasticNet (l1 = 0,5): \lambda_{\max}=0{,}933085/0{,}5=1{,}866169, 78 değer. Ridge: 10^3\max d^2=4207034{,}48'den 0{,}041050'ye 100 değer.
Adım 3 — 5 katlı CV (ElasticNet, l1 = 0,5). Ardışık 5 kat, her biri 44 hasta. Eğitim katlarında y'nin SS'si 1,6290–1,7298 olduğundan L_2 çarpanı c_k=s_y/s_{y,k} 0,9768–1,0372 arasındadır. Sonuç:
Adım 4 — Son model ve KKT. α = 0,137923'te 12 katsayı sıfırdan farklıdır; en büyükleri x25 0,578409, x05 0,523592, x18 0,376738, x12 −0,193099, x04 −0,158148, x33 −0,111639. KKT: bu 12 değişkenin hepsinde \frac1n\mathbf z_j^{\top}\mathbf r-\alpha(1-\text{l1})\beta_j=\pm0{,}068962=\pm\alpha\,\text{l1}; sıfır olanlarda en büyük \lvert\frac1n\mathbf z_j^{\top}\mathbf r\rvert=0{,}065547<0{,}068962. Özgün ölçek: x25 için B=0{,}578409/s_{25}=0{,}837461; b_0=-0{,}024903.
Adım 5 — Uyum. R^2_{\text{eğitim}}=0{,}479725, \text{RMSE}_{\text{eğitim}}=1{,}218793. Kat R^2'leri 0,4339; 0,4426; 0,3980; 0,3507; 0,2865 → ortalama R^2(\text{CV})=0{,}382342; kat RMSE'leri ortalaması 1,298185.
Adım 6 — Üç yöntemin karşılaştırması (otomatik α, λ_min):
| Yöntem | α | Seçilen | R^2_{\text{eğitim}} | R^2(CV) | RMSE(CV) | min CV-MSE |
|---|---|---|---|---|---|---|
| LASSO | 0,075685 | 11/40 | 0,488429 | 0,391384 | 1,288289 | 1,669327 |
| ElasticNet 0,5 | 0,137923 | 12/40 | 0,479725 | 0,382342 | 1,298185 | 1,694889 |
| Ridge | 58,752857 | 40/40 | 0,513652 | 0,312522 | 1,368463 | 1,881579 |
Ridge eğitimde en iyi uyumu, CV'de en kötü tahmini verir: bu veride gerçek etki birkaç belirteçte yoğunlaşmıştır. λ_1SE ile ElasticNet 5 değişken seçer (x04, x05, x12, x18, x25) ve R^2(\text{CV})=0{,}345845.
Şekil 107.1. Sol: ElasticNet (L1 = 0,5) katsayı yolu; renkli beş değişken λ_1SE modelinde kalanlar (x04, x05, x12, x18, x25), kesikli λ_min, noktalı λ_1SE. Sağ: LASSO (turuncu) ve ElasticNet (mor) 5 katlı CV-MSE ± SE; kesikli çizgiler λ_min.
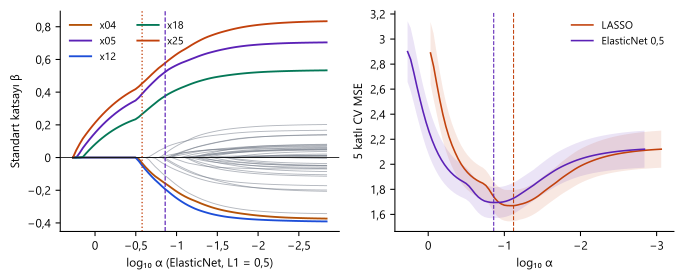
Adım 7 — L1 oranının CV ile seçimi. Yedi oranın en küçük CV-MSE'leri karşılaştırılır; en küçüğü l1 = 1'dedir (1,669327), dolayısıyla "L1 oranını CV ile seç" LASSO'ya döner: α = 0,075685, 11 değişken.
Adım 8 — Birim karşılaştırması. Ridge yöntemi α = 1: R^2_{\text{eğitim}}=0{,}561022, R^2(\text{CV})=0{,}221251. ElasticNet l1 = 0, α = 1: Ridge(α = 220) ile aynı; R^2_{\text{eğitim}}=0{,}403038, R^2(\text{CV})=0{,}278722.
Adım 9 — Tekrarlı CV. 3 tekrar, karıştırmalı (tohum 42, 1042, 2042): ortalama eğri \lambda_{\min}=0{,}104334'te en küçüktür (1,713008); model 17 değişken seçer, R^2(\text{CV})=0{,}379146 (15 katın ortalaması). Tek ardışık bölünmedeki 0,137923'ten farklı bir ızgara noktasıdır: CV bölünmesinin rastgeleliği α seçimini doğrudan etkiler.
Adım 10 — Standartlaştırma kapalı LASSO. Ham ölçekte \lambda_{\max}=0{,}644453, \lambda_{\min}=0{,}052274, 10 değişken. Açıklayıcıların SS'leri birbirine yakın (0,62–0,76) olduğundan sonuç standartlaştırılmış modele yakındır; ölçekler farklı olsaydı ceza büyük SS'li değişkenleri kayırırdı.
Adım 11 — Bootstrap (LASSO, α = 0,075685, B = 100). x05, x18, x25 1,00; x12 0,96; x04 0,95; x33 0,86; x23 0,65; x40 0,58.
Adım 12 — Lojistik LASSO (risk_yuksek). λ_max = 0,213962; dizi 75 değer; 5 kat CV: \lambda_{\min}=0{,}0209043 (CV sapma 1,108512), \lambda_{1\text{SE}}=0{,}0638388. λ_min'de 12 değişken; sapma 218,1316, boş model sapması 304,9848, D^2=0{,}2848; örneğin x05 için B=1{,}022614, \exp(B)=2{,}780. Kullanıcı λ = 0,02 ile sapma 216,9731.
107.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucunun alanlarından (coefficients, coefficients_raw, path, r2_cv …) tam hassasiyetle alınmıştır; tablo sütunlarındaki 6 ondalık yuvarlaması karşılaştırmaya girmez. R: 4.5.3, glmnet 5.1 (thresh = 1e-14). Gauss ElasticNet'te glmnet y'yi içeride ölçeklediği için MerQur amacı u=y/s_y üzerinde \alpha'=(\text{l1}/s_y)/(\text{l1}/s_y+1-\text{l1}), \lambda'=\alpha(\text{l1}/s_y+1-\text{l1}) ile kurulmuş, katsayılar s_y ile geri çarpılmıştır. Izgaralar glmnet'in kendi λ dizisinden, CV cv.glmnet(foldid = …) ile; Ridge yöntemi kapalı formla; tekrarlı CV kat numaraları ve bootstrap dizinleri Python'un default_rng ile ürettiği dosyadan R'ye aktarılmıştır.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| ElasticNet 0,5 (otomatik): ızgara uzunluğu (R: glmnet'in kendi dizisi) | 78 | 78 | 79 | 0,0e+00 | ✓ (R 79; bkz. metin) |
| ElasticNet 0,5 (otomatik): ızgara üst ucu (λ_max) | 1,866169 | 1,866169 | 1,866169 | 2,4e−15 | ✓ |
| ElasticNet 0,5 (otomatik): α_min | 0,137923 | 0,137923 | 0,137923 | 3,1e−16 | ✓ |
| ElasticNet 0,5 (otomatik): α_1SE | 0,264525 | 0,264525 | 0,264525 | 0,0e+00 | ✓ |
| ElasticNet 0,5 (otomatik): en küçük CV-MSE | 1,694889 | 1,694889 | 1,694889 | 2,2e−08 | ✓ |
| ElasticNet 0,5 (otomatik): β (std), 40 | 0,578409 | 0,578409 | 0,578409 | 1,5e−07 | ✓ |
| ElasticNet 0,5 (otomatik): B (özgün ölçek), 40 | 0,837461 | 0,837461 | 0,837461 | 2,2e−07 | ✓ |
| ElasticNet 0,5 (otomatik): sabit b₀ | −0,024903 | −0,024903 | −0,024903 | 2,0e−08 | ✓ |
| ElasticNet 0,5 (otomatik): R² (eğitim) | 0,479725 | 0,479725 | 0,479725 | 6,1e−09 | ✓ |
| ElasticNet 0,5 (otomatik): RMSE (eğitim) | 1,218793 | 1,218793 | 1,218793 | 7,2e−09 | ✓ |
| ElasticNet 0,5 (otomatik): R² (CV, kat ortalaması) | 0,382342 | 0,382342 | 0,382342 | 1,0e−08 | ✓ |
| ElasticNet 0,5 (otomatik): RMSE (CV) | 1,298185 | 1,298185 | 1,298185 | 9,5e−09 | ✓ |
| ElasticNet 0,5 (otomatik): seçilen değişken sayısı | 12 | 12 | 12 | 0,0e+00 | ✓ |
| ElasticNet 0,5 λ_1SE: seçilen α | 0,264525 | 0,264525 | 0,264525 | 0,0e+00 | ✓ |
| ElasticNet 0,5 λ_1SE: B (özgün ölçek), 40 | 0,656495 | 0,656495 | 0,656495 | 4,6e−08 | ✓ |
| ElasticNet 0,5 λ_1SE: R² (CV, kat ortalaması) | 0,345845 | 0,345845 | 0,345845 | 7,9e−09 | ✓ |
| ElasticNet 0,5 λ_1SE: seçilen değişken sayısı | 5 | 5 | 5 | 0,0e+00 | ✓ |
| LASSO (otomatik): ızgara uzunluğu (R: glmnet'in kendi dizisi) | 76 | 76 | 77 | 0,0e+00 | ✓ (R 77; bkz. metin) |
| LASSO (otomatik): ızgara üst ucu (λ_max) | 0,933085 | 0,933085 | 0,933085 | 2,2e−16 | ✓ |
| LASSO (otomatik): α_min | 0,075685 | 0,075685 | 0,075685 | 2,8e−17 | ✓ |
| LASSO (otomatik): α_1SE | 0,145158 | 0,145158 | 0,145158 | 2,2e−16 | ✓ |
| LASSO (otomatik): en küçük CV-MSE | 1,669327 | 1,669327 | 1,669327 | 3,3e−09 | ✓ |
| LASSO (otomatik): B (özgün ölçek), 40 | 0,916654 | 0,916654 | 0,916654 | 7,2e−08 | ✓ |
| LASSO (otomatik): R² (CV, kat ortalaması) | 0,391384 | 0,391384 | 0,391384 | 2,1e−08 | ✓ |
| LASSO (otomatik): RMSE (CV) | 1,288289 | 1,288289 | 1,288289 | 2,1e−08 | ✓ |
| LASSO (otomatik): seçilen değişken sayısı | 11 | 11 | 11 | 0,0e+00 | ✓ |
| Ridge (otomatik): ızgara üst ucu (λ_max) | 4207034,484087 | 4207034,484087 | 4207034,484087 | 9,3e−10 | ✓ |
| Ridge (otomatik): α_min | 58,752857 | 58,752857 | 58,752857 | 7,1e−15 | ✓ |
| Ridge (otomatik): α_1SE | 260,828636 | 260,828636 | 260,828636 | 2,3e−13 | ✓ |
| Ridge (otomatik): en küçük CV-MSE | 1,881579 | 1,881579 | 1,881579 | 3,8e−15 | ✓ |
| Ridge (otomatik): B (özgün ölçek), 40 | 0,726988 | 0,726988 | 0,726988 | 1,4e−15 | ✓ |
| Ridge (otomatik): R² (eğitim) | 0,513652 | 0,513652 | 0,513652 | 3,3e−16 | ✓ |
| Ridge (otomatik): R² (CV, kat ortalaması) | 0,312522 | 0,312522 | 0,312522 | 5,6e−16 | ✓ |
| Ridge (otomatik): RMSE (CV) | 1,368463 | 1,368463 | 1,368463 | 4,4e−16 | ✓ |
| L1 oranı CV: seçilen L1 oranı | 1 | 1 | 1 | 0,0e+00 | ✓ |
| L1 oranı CV: seçilen α | 0,075685 | 0,075685 | 0,075685 | 2,8e−17 | ✓ |
| L1 oranı CV: L1 = 0,5'in en küçük CV-MSE'si | 1,694889 | 1,694889 | 1,694889 | 2,2e−08 | ✓ |
| ElasticNet α = 0,1: B (özgün ölçek), 40 | 0,914629 | 0,914629 | 0,914628 | 3,3e−07 | ✓ |
| ElasticNet α = 0,1: R² (eğitim) | 0,507949 | 0,507949 | 0,507949 | 2,3e−08 | ✓ |
| ElasticNet α = 0,1: R² (CV, kat ortalaması) | 0,379094 | 0,379094 | 0,379094 | 3,1e−08 | ✓ |
| ElasticNet α = 0,1: seçilen değişken sayısı | 17 | 17 | 17 | 0,0e+00 | ✓ |
| Ridge α = 1: B (özgün ölçek), 40 | 1,198018 | 1,198018 | 1,198018 | 2,9e−15 | ✓ |
| Ridge α = 1: R² (eğitim) | 0,561022 | 0,561022 | 0,561022 | 1,1e−16 | ✓ |
| Ridge α = 1: R² (CV, kat ortalaması) | 0,221251 | 0,221251 | 0,221251 | 1,4e−16 | ✓ |
| ElasticNet L1 = 0, α = 1: B (özgün ölçek), 40 | 0,377450 | 0,377450 | 0,377450 | 4,0e−07 | ✓ (R: mutlak 1e−6) |
| ElasticNet L1 = 0, α = 1: R² (eğitim) | 0,403038 | 0,403038 | 0,403038 | 3,6e−08 | ✓ |
| ElasticNet L1 = 0, α = 1: R² (CV, kat ortalaması) | 0,278722 | 0,278722 | 0,278722 | 4,1e−08 | ✓ |
| LASSO, standartlaştırma kapalı: ızgara uzunluğu (R: glmnet'in kendi dizisi) | 76 | 76 | 77 | 0,0e+00 | ✓ (R 77; bkz. metin) |
| LASSO, standartlaştırma kapalı: ızgara üst ucu (λ_max) | 0,644453 | 0,644453 | 0,644453 | 2,2e−16 | ✓ |
| LASSO, standartlaştırma kapalı: α_min | 0,052274 | 0,052274 | 0,052274 | 6,9e−18 | ✓ |
| LASSO, standartlaştırma kapalı: B (özgün ölçek), 40 | 0,916205 | 0,916205 | 0,916205 | 1,2e−07 | ✓ |
| LASSO, standartlaştırma kapalı: R² (CV, kat ortalaması) | 0,392967 | 0,392967 | 0,392967 | 8,6e−10 | ✓ |
| ElasticNet, 3 tekrarlı CV: α_min | 0,104334 | 0,104334 | 0,104334 | 3,9e−16 | ✓ |
| ElasticNet, 3 tekrarlı CV: α_1SE | 0,264525 | 0,264525 | 0,264525 | 0,0e+00 | ✓ |
| ElasticNet, 3 tekrarlı CV: en küçük CV-MSE | 1,713008 | 1,713008 | 1,713008 | 1,1e−08 | ✓ |
| ElasticNet, 3 tekrarlı CV: B (özgün ölçek), 40 | 0,905202 | 0,905202 | 0,905201 | 3,1e−07 | ✓ |
| ElasticNet, 3 tekrarlı CV: R² (CV, kat ortalaması) | 0,379146 | 0,379146 | 0,379146 | 1,4e−08 | ✓ |
| ElasticNet, 3 tekrarlı CV: RMSE (CV) | 1,304228 | 1,304228 | 1,304228 | 1,7e−08 | ✓ |
| Bootstrap seçim sıklığı (LASSO, B = 100), 40 | 0,650000 | 0,650000 | 0,650000 | 0,0e+00 | ✓ (aynı bootstrap dizinleri) |
| Lojistik LASSO: λ_max | 0,213962 | 0,213962 | 0,213962 | 1,9e−16 | ✓ |
| Lojistik LASSO: λ dizisi uzunluğu | 75 | 75 | 75 | 0,0e+00 | ✓ |
| Lojistik LASSO: λ_min | 0,020904 | 0,020904 | 0,020904 | 1,4e−17 | ✓ |
| Lojistik LASSO: λ_1SE | 0,063839 | 0,063839 | 0,063839 | 2,8e−17 | ✓ |
| Lojistik LASSO: en küçük CV sapması | 1,108512 | 1,108512 | 1,108512 | 4,2e−09 | ✓ |
| Lojistik LASSO (λ_min): sabit | 0,110049 | 0,110049 | 0,110049 | 2,4e−09 | ✓ |
| Lojistik LASSO (λ_min): B, 40 | 1,022614 | 1,022614 | 1,022614 | 1,3e−07 | ✓ |
| Lojistik LASSO (λ_min): sapma | 218,131632 | 218,131632 | 218,131633 | 9,4e−07 | ✓ |
| Lojistik LASSO, kullanıcı λ = 0,02: B, 40 | 1,043063 | 1,043063 | 1,043063 | 2,0e−07 | ✓ |
| Lojistik LASSO, kullanıcı λ = 0,02: sapma | 216,973132 | 216,973132 | 216,973130 | 1,4e−06 | ✓ |
Gauss yolunda bütün katsayılar, CV eğrileri, R^2(CV), tekrarlı CV ve bootstrap sıklıkları üç kaynakta eşleşir. MerQur ile bağımsız Python arasındaki fark 10^{-9}'un altındadır; R ile en büyük fark (4\times10^{-7}) glmnet'in durma ölçütünden gelir. ElasticNet L1 = 0 satırında glmnet alpha = 0 çözümü (koordinat inişi) en küçük katsayılarda 4\times10^{-7} mutlak fark verir; MerQur ile Python kapalı formda 3\times10^{-16} içinde aynıdır, bu satırda R için mutlak 10^{-6} ölçütü kullanılmıştır. Izgara uzunluğunda glmnet 5.1'in kendi dizisi bir değer fazladır (78 yerine 79; 76 yerine 77): durdurulan noktada R^2 artışı eşiğin hemen altındadır (LASSO'da 9{,}67\times10^{-6}<10^{-5}) ve glmnet bu sınır noktayı yaklaşık çözümüyle eşiğin üstünde hesaplar. Ortak 76/78 değer, λ_min ve λ_1SE aynıdır. Lojistik yolda MerQur ve R glmnet(family = "binomial") aynı mutlak durdurma ölçütüyle 75 değerde durur (R'de sıkı yakınsama toleransıyla; glmnet'in varsayılan thresh = 1e-7 toleransıyla hesaplanan yaklaşık sapma oranları yolu 71 değerde keser). CV R'de aynı diziyle yapılmıştır; λ_min ve λ_1SE aynıdır.
107.7 Çıktıyı okuma
Sonuç metni (ElasticNet, L1 = 0,5, otomatik α; kısaltılmış):
Düzenlileştirilmiş Regresyon — ElasticNet (L1 + L2)
  N (gözlem)         : 220
  Hedef              : risk_score
  Toplam açıklayıcı  : 40
  Standartlaştırma   : evet

Hiperparametre:
  α (alpha)   = 0.137923  (CV ile seçildi)
  L1 oranı    = 0.50  (kullanıcı, sabit)
  CV kat sayısı = 5

Model Performansı:
  R² (eğitim)   = 0.4797
  R² (CV)       = 0.3823
  RMSE (eğitim) = 1.2188
  RMSE (CV)     = 1.2982
  Sabit         = -0.1175  (β0, standartlaştırılmış)
  Sabit (B)     = -0.0249  (orijinal ölçek)

Seçilen Açıklayıcılar (12/40):
  x01                           β (std) = +0.0093   B = +0.0150788
  x04                           β (std) = -0.1581   B = -0.215719
  x05                           β (std) = +0.5236   B = +0.76881
  ...
  x25                           β (std) = +0.5784   B = +0.837461
Yorum: 12 değişken sıfırdan farklı, 28 değişken sıfıra indirildi (seyreklik). ...
Eğitim R²'si CV R²'sinden belirgin biçimde büyükse aşırı uyum (overfitting) şüphesi vardır.

── APA 7 ÖZET ──
ElasticNet (L1 + L2): R² = .38 (CV), R² = .48 (eğitim), α = 0.1379, k = 12/40 yordayıcı, N = 220

CV eğrisi (78 α değeri, aynı K-kat): α_min = 0.137923 · α_1SE = 0.264525 (1-SE kuralında
sıfır olmayan katsayı: 5). ...
Lojistik yolda metin farklıdır:
DÜZENLİLEŞTİRİLMİŞ GLM — LASSO (İkili (lojistik))
  N = 220   Hedef: risk_yuksek   p = 40
  a (L1 mix) = 1.00   K = 5
  λ_min = 0.0209043   λ_1se = 0.0638388   seçilen: λ = 0.0209043 (λ_min)
  Sapma: 218.1316   Boş model sapması: 304.9848   Sapma oranı (D²) = 0.2848
  CV Sapma (λ) = 1.1085
Tablo sekmesi: Açıklayıcı · β (std) · B · Seçildi (✓/—) · (bootstrap açıksa) Bootstrap sıklığı. Lojistik yolda: Açıklayıcı · B · exp(B) · Seçildi.
| Öğe | Nasıl yorumlanır |
|---|---|
| α (CV ile seçildi / kullanıcı, sabit) | Modelin kurulduğu ceza; kaynağı satır sonundaki parantezde yazılır. |
| L1 oranı | ElasticNet karışımı; "(CV ile seçildi)" ise 107.5.5. |
| R² (eğitim) / R² (CV) | Eğitim uyumu / kat R^2'lerinin ortalaması. Fark büyükse aşırı uyum şüphesi; not satırı bunu koşullu cümleyle hatırlatır. |
| Sabit (β0, standartlaştırılmış) | \bar y; "Sabit (B)" tahmin denklemi içindir. |
| Seçilen açıklayıcılar | \lvert\beta\rvert>10^{-8}; standart katsayıya göre değil, tablo sırasıyla listelenir. |
| CV eğrisi satırı | Izgara uzunluğu, α_min, α_1SE ve 1-SE modelindeki sıfırdan farklı katsayı sayısı; seçim kuralı değiştirilmeden de λ_1SE modelinin seyrekliği görülür. |
| Bootstrap sıklığı | 0,6–0,8 üstü kararlı seçim; GA ya da p değildir. |
| exp(B) (lojistik) | Diğer açıklayıcılar sabitken 1 birim artışın cezalı OR'si; büzülmüş olduğundan cezasız OR'den 1'e yakındır. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Risk skorunu 40 ilişkili belirteçten (r=0{,}31–0{,}58) tahmin etmek için elastik ağ regresyonu (L1 oranı 0,5) kullanıldı (n = 220). Açıklayıcılar 1/n-standart sapmayla standartlaştırıldı; ceza düzeyi beş katlı çapraz doğrulamayla en küçük ortalama karesel hata ölçütüne göre seçildi (\alpha = 0{,}138). Model 12 belirteç seçti; eğitim verisinde R^2 = 0{,}48, çapraz doğrulamada kat ortalaması R^2 = 0{,}38 (RMSE = 1{,}30) elde edildi. En büyük standart katsayılar x25 (\beta = 0{,}58), x05 (\beta = 0{,}52) ve x18 (\beta = 0{,}38) içindi; bir standart hata kuralı (\alpha = 0{,}265) bu üç belirteç ile x12 ve x04'ten oluşan beş değişkenli bir model verdi.
107.8 Uzman soruları
S1. ElasticNet'te MerQur'un α'sı glmnet'in λ'sı mı?
Doğrudan değil. MerQur scikit-learn amacını kullanır: \frac{1}{2n}\text{RSS}+\alpha[\text{l1}\lVert\beta\rVert_1+\frac{1-\text{l1}}{2}\lVert\beta\rVert^2]. glmnet Gauss ailesinde y'yi 1/n-SS'siyle ölçekleyip aynı biçimi çözer; bu yalnız L_2 kısmını s_y oranında değiştirir. Eşdeğerlik y/s_y üzerinde \alpha'=(\text{l1}/s_y)/(\text{l1}/s_y+1-\text{l1}) ve \lambda'=\alpha(\text{l1}/s_y+1-\text{l1}) ile kurulur. Lasso'da (\text{l1}=1) iki tanım çakışır. Raporda "scikit-learn tanımı" ya da eşdeğer glmnet parametreleri yazılmalıdır.
S2. Neden CV'de eğitim katında y yeniden ölçekleniyor?
Böylece MerQur'un ElasticNet CV eğrisi R cv.glmnet ile aynı olur. glmnet her katta y'yi o katın SS'siyle ölçekler; bu, aynı λ'nın kattan kata biraz farklı L_2 ağırlığı taşıması demektir (burada %−2,3 ile %+3,7 arası). Lasso ve Ridge yönteminde bu ayar yoktur. Son model ve R^2(CV) ise ölçeklemesiz sabit amaçla kurulur; fark küçüktür.
S3. R^2(CV) neden Lasso menüsündeki R^2_{\text{CV}}'den farklı?
Bu menü kat R^2'lerini ortalar (paydada her katın kendi ortalaması), Lasso menüsü bütün dışarıda bırakılmış artıkları havuzlar (paydada tam veri ortalaması). Kat ortalamasıyla payda küçüldüğü için kat R^2'si genellikle daha düşüktür; ayrıca küçük katlarda kararsızdır. Raporda hangi tanımın kullanıldığı belirtilmelidir.
S4. Tekrarlı CV'de SE neden tekrarların SE'lerinin ortalaması?
_cv_curve her tekrarın eğrisini ve SE'sini ayrı hesaplar ve ikisini de ortalar (131–133). Bu, katlar arasındaki değişkenliği temsil eder; tekrarlar arası değişkenliği eklemez. Tekrarlar aynı veriyi kullandığından birbirinden bağımsız değildir ve SE'leri \sqrt R ile küçültmek iyimser olurdu. Tercih tutucudur; λ_1SE bu ortalama SE ile hesaplanır.
S5. Bootstrap sıklığı neden iadeli, Lasso menüsündeki neden iadesiz?
Bu menü klasik bootstrap'i (n gözlem, iadeli) kullanır; Lasso menüsü Meinshausen ve Bühlmann'ın (2010) önerdiği iadesiz yarım örneklemi. İadeli örneklemde yinelenen gözlemler etkili örneklem büyüklüğünü yaklaşık 0{,}632n'ye düşürür ama aynı noktaların tekrarı katsayıları kararlı gösterebilir. İkisi de tek α'da çalışır ve hata sınırı taşımaz; betimleyicidir. Bu menüde tohum formdan değiştirilebilir.
S6. Lojistik yolda sonuç neden glmnet ile 7. basamakta ayrışıyor?
İç elastik ağ çözümü tol = 1e-10, dış IRLS max|Δβ| < 1e-8 ile durur (glmnet_glm.py:71, 79); katsayılar bu düzeyde doğrudur. Ridge/Lasso menülerinin cezalı GLM motoru (regularized_extras.penalized_glm) 10^{-12} kullanır. Ayrıca yol durdurma kuralı göreli tanımlıdır; glmnet'in lojistik kuralı mutlak fark kullanır, bu yüzden MerQur'un varsayılan λ dizisi glmnet'inkinden uzundur. λ_min orta bölgedeyse seçim değişmez.
S7. α alanı neden bu kadar geniş (0–10⁶)?
LASSO ve ElasticNet için λ_max genellikle küçüktür, ama Ridge yönteminde CV'nin seçtiği α yüzlerce olabilir (Tıp #57'de α_1SE = 260,83). CV'nin seçtiği değerin elle yeniden girilip aynı modelin kurulabilmesi için alan 0–10^{6} aralığında ve 6 ondalıklıdır (regularized_regression_panel.py); Ridge ve Lasso menüleriyle aynı sınırdır.
S8. Kategorik değişkenler nasıl giriyor?
Sayısal olmayan sütunlar, MerQur düzey sırasının (kullanıcının tanımladığı sıra, yoksa sayısal/doğal sıra, o da yoksa verideki ilk görülme sırası) ilk düzeyi referans olacak biçimde kukla değişkenlere açılır (regularized_regression_panel.py:356–379; R model.matrix faktör düzeylerini alfabetik alır, karşılaştırmada factor(levels = …) verilmelidir) ve sıradan sütunlar gibi standartlaştırılıp cezalandırılır. Kukla sayısı metinde "kukla" notuyla yazılır. Grup cezası yoktur; bir faktörün kuklaları birbirinden bağımsız seçilir.
S9. Eğitim R² ile CV R² farkı ne zaman "aşırı uyum"dur?
Cezalı modellerde bir miktar fark beklenir; eğitim R^2'si her zaman iyimserdir. MerQur'un not satırı yalnız koşullu bir hatırlatmadır ("eğitim R²'si belirgin biçimde büyükse…"); farkın büyüklüğünü kendisi yargılamaz. Karar için CV eğrisinin şekline, λ_min ile λ_1SE arasındaki farka ve tekrarlı CV'deki α oynaklığına bakılmalıdır. Bu veride fark 0,10'dur ve ridge'de 0,21'e çıkar.
107.9 Sık hatalar ve tuzaklar
- Menü varsayılanının LASSO olduğunu unutmak. Yöntem kutusu "LASSO (L1)" ile açılır; ElasticNet istenirse seçilmelidir. L1 oranı alanı LASSO/Ridge'de yok sayılır.
- Ridge'i iki yoldan farklı α'larla kurmak. "Ridge (L2)" ile "ElasticNet + L1 oranı 0" aynı α'da n kat farklı cezadır.
- Kullanıcı λ'sını denetlememek (lojistik/Poisson). Seçilen λ, yol erken kesildiyse girilen değerden farklı olabilir; metindeki "seçilen: λ" satırına bakın.
- α'nın kaynağına bakmamak. CV ile mi seçildiği, kullanıcı mı girdiği satır sonundaki parantezde yazılır.
- Tek CV bölünmesiyle α'yı kesin sanmak. Tıp #57'de ardışık katlarla 0,138, 3 tekrarlı karıştırmalı CV'de 0,104 seçildi. Kritik raporlarda tekrarlı CV kullanılmalıdır.
- Sıralı veride karıştırmasız CV. Ardışık katlar, veri tarih ya da merkez sırasındaysa yanlı olur.
- Standartlaştırmayı kapatmak. Ceza ham birimlere uygulanır; büyük SS'li açıklayıcılar kayrılır. Yalnız açıklayıcılar aynı birimdeyse anlamlıdır.
- İkili hedefi 1/2 kodlamak. Bu menü yalnız 0/1 kabul eder (Ridge/Lasso menüleri iki değerin büyüğünü olay sayar).
- Bootstrap sıklığını p değeri gibi okumak. Seçim sıklığı belirsizliğin kaba bir göstergesidir; çıkarım vermez.
107.10 Kaynaklar
- Bühlmann, P., & van de Geer, S. (2011). Statistics for high-dimensional data: Methods, theory and applications. Springer. https://doi.org/10.1007/978-3-642-20192-9
- Friedman, J., Hastie, T., & Tibshirani, R. (2010). Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software, 33(1), 1–22. https://doi.org/10.18637/jss.v033.i01
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2. baskı). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Hoerl, A. E., & Kennard, R. W. (1970). Ridge regression: Biased estimation for nonorthogonal problems. Technometrics, 12(1), 55–67. https://doi.org/10.1080/00401706.1970.10488634
- Krstajic, D., Buturovic, L. J., Leahy, D. E., & Thomas, S. (2014). Cross-validation pitfalls when selecting and assessing regression and classification models. Journal of Cheminformatics, 6, 10. https://doi.org/10.1186/1758-2946-6-10
- Meinshausen, N., & Bühlmann, P. (2010). Stability selection. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 72(4), 417–473. https://doi.org/10.1111/j.1467-9868.2010.00740.x
- Tay, J. K., Narasimhan, B., & Hastie, T. (2023). Elastic net regularization paths for all generalized linear models. Journal of Statistical Software, 106(1), 1–31. https://doi.org/10.18637/jss.v106.i01
- Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267–288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
- Zou, H., & Hastie, T. (2005). Regularization and variable selection via the elastic net. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 67(2), 301–320. https://doi.org/10.1111/j.1467-9868.2005.00503.x