69. Gradyan Artırma
Analiz kimliği: gradient_boosting · Menü adı: Gradyan Artırma · Panel: gui/panels/analyses/gradient_boosting.py (form 36–84, read_options 86–101, execute 104–115) · Motor: ml/classification.py, Classification.gradient_boosting (satır 556–663), erken durdurma _early_stopping (1026–1087), ortak hat _run_sklearn_model (1089–1687; Bölüm 67.5) · Kütüphaneler: XGBoost 3.2.0 (varsayılan motor), scikit-learn 1.8.0 (klasik motor) · Çağrı: stats_panel.py:8449–8453
69.1 Ne işe yarar
Gradyan artırma, küçük karar ağaçlarını sırayla ekleyerek bir tahmin fonksiyonu kurar. Her yeni ağaç, o ana kadarki modelin kayıp fonksiyonunun gradyanına (sınıflandırmada "gerçek sınıf göstergesi − tahmin edilen olasılık") uydurulur ve küçük bir adımla (öğrenme oranı) modele eklenir (Friedman 2001). MerQur'un varsayılan motoru XGBoost'tur; XGBoost kaybın ikinci türevini de kullanır ve ağaç yapraklarını düzenlileştirir (Chen ve Guestrin 2016). Cevapladığı soru, rastgele ormandaki gibi bir tahmin sorusudur: "Bu hastanın sınıfı X'ten ne kadar doğru tahmin edilebilir?"
Ne zaman kullanılır?
- Tablo biçimli veride en yüksek tahmin başarımı aranıyorsa; ilişkiler doğrusal değil, etkileşimler bilinmiyorsa.
- Sınıflar dengesiz ve olasılık tahmini gerekiyorsa (log kaybı doğrudan en küçüklenir).
- Erken durdurma ile model karmaşıklığını veriden seçmek isteniyorsa.
Ne zaman kullanılmaz?
- Katsayı, GA ve p değeri gerekiyorsa: Çok Terimli Lojistik Regresyon ya da Sıralı Lojistik Regresyon (sıralı sınıflar için).
- Okunur bir kural gerekiyorsa: Karar Ağacı (CART) (Bölüm 70).
- Az veride ve ayar yapmadan sağlam bir varsayılan isteniyorsa: Rastgele Orman (Bölüm 67) daha az ayara duyarlıdır.
- Gözlemler bağımsız değilse: bölme ve CV için grup sütunu verilmelidir (67.5.1).
Sık karıştırılan analizler. Rastgele ormanın ağaçları birbirinden bağımsızdır ve ortalaması alınır; gradyan artırmanın ağaçları birbirine bağlıdır ve toplanır. "Klasik gradyan artırma" motoru Friedman'ın (2001) özgün algoritmasıdır (scikit-learn); XGBoost aynı fikrin ikinci dereceden açılımlı, düzenlileştirilmiş biçimidir. İki motorun varsayılanları farklıdır (öğrenme oranı 0,3 / 0,1; derinlik 6 / 3) ve aynı veride farklı sonuç verir.
69.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Bağımsız gözlemler | Eğitim ve test birbirinden bilgi taşımaz. | Denetlenmez; grup sütunu verilebilir. |
| Hedef türü | Sınıflandırmada kategorik; regresyonda sayısal. | Regresyonda sayıya çevrilemeyen hedef hata verir. |
| Dağılım varsayımı | Yok. Ölçekleme gereksiz. | — |
| Yeterli tur / küçük adım | Öğrenme oranı küçüldükçe daha çok tur gerekir. | Erken durdurma ve öğrenme eğrisi grafiği. |
Eksik değer ve uç durumlar. Ortak hattaki kurallar geçerlidir (67.2): hedefi ya da X'i eksik satır atılır, sabit X düşer, tek gözlemli sınıf ve kat sayısı denetimleri aynıdır. XGBoost eksik değeri kendisi işleyebildiği hâlde MerQur satırları önceden attığından bu özellik kullanılmaz.
- "Motor: XGBoost" seçili ve XGBoost yüklenemiyorsa hata verilir; "Otomatik" seçiliyse klasik motora geçilir ve "Algoritma" satırı nedenini yazar (
classification.py:593–648). - Klasik motorda
min_child_weightkarşılığı yoktur; değer kullanılmaz ve bu durum ayar bloğuna yazılır (classification.py:682–687; ipucu metni "yalnız XGBoost" der).
69.3 Parametreler
Varsayılanlar gradient_boosting.py:36–101 ve _ml_options.py:179–264'ten alınmıştır. Ortak satırlar (test oranı, CV, tohum, bölme ve kat sütunları, dengeli ağırlık, ayar, permütasyon önemi, kaydetme, eşik, ek çıktılar) Bölüm 67.3'tekiyle aynıdır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Ağaç sayısı | 100 (10–5000) | Tur sayısı M (çok sınıfta her turda K ağaç). | Fazla tur aşırı uyum; erken durdurma sınırlar. |
| Öğrenme oranı (eta) | Varsayılan | Adım küçültme η. XGBoost 0,3; klasik 0,1. | Küçük η + çok tur genelde daha iyi genelleme. |
| En büyük derinlik | Varsayılan | XGBoost 6; klasik 3. | Etkileşim derecesi. |
| Alt örneklem oranı | 1,00 (0,10–1,00) | Her turda kullanılan eğitim satırı payı. | <1: stokastik artırma; sonuç tohuma bağlanır, XGBoost tek iş parçacığıyla çalıştığı için makineden bağımsızdır (69.5.7). |
| min_child_weight | Varsayılan (1) | Yaprakta gereken en az Hessian toplamı. | Büyüdükçe ağaçlar sığlaşır. Yalnız XGBoost. |
| Motor | Otomatik (XGBoost varsa) | XGBoost ya da klasik (scikit-learn). | Algoritma ve varsayılanlar. |
| Erken durdurma (tur) | Kapalı | İç doğrulama kaybı bu kadar tur iyileşmezse durur. | Tur sayısı veriden seçilir (69.5.6). |
| Önem türü | Kazanç (bölünme başına ort.) | XGBoost: ortalama kazanç, toplam kazanç, kapsam (cover), sıklık. | Yalnız önem tablosu ve grafiği. |
| Ek çıktılar: SHAP (TreeSHAP) | kapalı | Test kümesinde ortalama mutlak SHAP. | Ek bölüm (yalnız XGBoost). |
| Grafik | Değişken önemi | ROC, PDP + ICE, SHAP özeti, öğrenme eğrisi, 3B yüzey. | Yalnız grafik. |
| Hiperparametre ayarı | kapalı | η ∈ {0,05; 0,1; 0,3} × derinlik ∈ {2, 3, 6} × ağaç ∈ {100, 200}. | En iyi ayarla model kurulur. |
Neden iki motorun varsayılanları farklı?
MerQur kütüphanelerin kendi varsayılanlarını korur (formda "Varsayılan" özel değeri None gönderir; gradient_boosting.py:91–96). XGBoost'ta η = 0,3 ve derinlik 6, düzenlileştirme (λ = 1) ve Hessian koşuluyla dengelenir; klasik algoritmada daha sığ ağaç ve küçük adım Friedman'ın (2001) önerisidir. İpucu metni, yeniden üretilebilirlik için motorun sabitlenmesini önerir: "Otomatik" seçimde XGBoost'u olmayan bir kurulum klasik motorla bambaşka bir model verir.
69.4 Tıp örneği
Dosya: english/datasets/Tip/65_gb_repeat_admission.xlsx (Türkçe kopya samples/Tum_Analiz_Tip/65_gb_tekrar_yatis.xlsx). Değişken seçimi VIDEO_SCRIPT_TR.txt #65'teki gibidir.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
repeat_admission_risk |
Hedef | 3 sınıf | medium 155, high 111, low 14 |
age |
X | tamsayı (yıl) | ort. 63,9; SS 13,9; 40–89; 50 farklı değer |
comorbidity_count |
X | sayım | ort. 2,06; 0–7 |
last_admission_day |
X | sayım (gün) | ort. 4,21; 0–12 |
drug_count |
X | sayım | ort. 4,91; 0–15 |
n ve eksik değer: 280 hasta, eksik değer yok. "low" sınıfı küçüktür (14 hasta, %5). Tabakalı bölme: eğitim 224 (high 89, low 11, medium 124), test 56 (22, 3, 31).
Klinik soru: Yaş, ek hastalık sayısı, son yatıştan bu yana geçen gün ve ilaç sayısı tekrar yatış riskini ne kadar doğru sınıflar?
Seçilen ayarlar: Arayüz varsayılanları (Otomatik → XGBoost 3.2.0; 100 tur, η = 0,3, derinlik 6, tohum 42). Ek çalıştırmalar: aynı tohumla ikinci kez; tohum 7; alt örneklem 0,8 (tohum 42 iki kez, tohum 7); klasik motor; erken durdurma 10 tur; permütasyon önemi + dengesiz veri metrikleri + SHAP; önem türü toplam kazanç ve sıklık.
69.5 Formüller ve hesap adımları
XGBoost motorunda hesap sırası: ortak hat (bölme, z ölçekleme; 67.5.1) → başlangıç kesişimi → her turda olasılıklar, gradyan ve Hessian → her sınıf için bir ağaç (histogram yöntemiyle bölme arama) → yapraklar η ile küçültülüp puana eklenir → M tur sonunda softmax olasılıkları → metrikler, önem, CV (classification.py:588–663, 1089–1687). Ağaç bölmeleri sıralamaya bağlı olduğundan z ölçekleme sonucu değiştirmez; doğrulamada R'ye ham veri verilmiş ve aynı olasılıklar elde edilmiştir.
69.5.1 Model ve amaç fonksiyonu
K sınıflı hedefte her sınıfın bir puanı vardır; olasılıklar softmax ile elde edilir:
- f_{mk}: m. turda k. sınıf için kurulan regresyon ağacı (yaprak değerleri w).
- b_k: başlangıç kesişimi (69.5.2); η: öğrenme oranı (0,3).
- 100 tur ve 3 sınıfta toplam 300 ağaç kurulur.
Her turda en küçüklenen düzenlileştirilmiş amaç, kaybın ikinci dereceden Taylor açılımıdır:
- g_{ik}, h_{ik}: i. gözlemde kaybın F_k'ya göre birinci ve ikinci türevi (69.5.3).
- T: ağacın yaprak sayısı; w_j: j. yaprağın değeri.
- γ: yaprak başına ceza (XGBoost varsayılanı 0); λ: yaprak değerlerinin L2 cezası (varsayılan 1). MerQur ikisini de değiştirmez.
69.5.2 Başlangıç kesişimi
XGBoost 3.x, çok sınıflı hedefte başlangıç puanını veriden kestirir. Hiç ağaç yokken log kaybını en küçükleyen sabit puanlar sınıf paylarının logaritmasıdır; softmax ötelemeye duyarsız olduğundan ortalaması sıfırlanır:
- \pi_k: k. sınıfın eğitim kümesindeki payı. Bu b ile ilk turda p_k=\pi_k olur.
- XGBoost değeri sayısal bir çözümle bulur; Tıp örneğinde formülden en çok 1{,}2\times10^{-5} farklıdır (69.6.1). Klasik motor (scikit-learn) aynı formülü kesin olarak kullanır.
Sürüm bağımlılığı
XGBoost 2.x ve öncesi çok sınıflı hedefte sabit base_score = 0,5 kullanırdı (bütün sınıflara aynı puan). Başlangıç noktası farklı olduğundan 100 tur sonunda olasılıklar sürümler arasında farklıdır. MerQur "Algoritma" satırına XGBoost sürümünü yazar (classification.py:618–622); başka bir kurulumla karşılaştırmada bu satır denetlenmelidir.
69.5.3 Gradyan ve Hessian
- y_{ik}: gözlem k. sınıftaysa 1, değilse 0.
- p_{ik}: o turun başındaki softmax olasılığı (float32).
- Gerçek kaybın Hessian'ının köşegeni p(1-p)'dir; XGBoost bunu 2 ile çarpar ve sıfıra yaklaşmasını 10^{-16} ile engeller.
Koddaki tercih: Hessian'daki 2 çarpanı
Çarpan XGBoost'un çok sınıflı hedef uygulamasındadır, makalede yoktur. Newton adımı -G/(H+\lambda) olduğundan Hessian'ı ikiye katlamak adımı yaklaşık yarıya indirir; sınıflar arası çapraz türevlerin yok sayılmasının yol açabileceği aşırı adımı önleyen ihtiyatlı bir tercihtir. Bağımsız yeniden yazımda çarpan 1 alınırsa test olasılıkları MerQur'dan 0,275'e kadar ayrılır; çarpan 2 ile 6\times10^{-7} içinde aynıdır. Aynı nedenle min_child_weight = 1 koşulu, p(1-p) değil 2p(1-p) toplamı üzerindendir.
69.5.4 Yaprak değeri ve bölme kazancı
Ağaç yapısı sabitken (69.5.1)'i en küçükleyen yaprak değeri ve bir bölmenin amaçta sağladığı azalış:
- G_j=\sum_{i\in j}g_{ik}, H_j=\sum_{i\in j}h_{ik}: yapraktaki gradyan ve Hessian toplamları; L, R: aday bölmenin sol ve sağ çocukları.
- Makaledeki tanım \tfrac12[\cdots]-\gamma'dır; XGBoost uygulaması ve önem tabloları ½'siz değeri kullanır (doğrulamada ağaç dökümündeki "gain" bu değerdir). Oranlar ve önem payları ½'den etkilenmez.
- Bölme koşulları: kazanç >10^{-6}, H_L\ge1 ve H_R\ge1 (
min_child_weight), derinlik < 6. Puana eklenen değer \eta\,w_j^{*}'dır.
Neden λ = 1 paydada?
λ, az gözlemli yaprakların değerini sıfıra doğru büzer. Tek gözlemli bir yaprakta H\approx0{,}5 iken w=-G/(H+1), cezasız -G/H'nin yaklaşık üçte biridir. Bu, η ile birlikte her turun katkısını küçük tutar.
69.5.5 Histogram yöntemi: aday eşikler
XGBoost 3.x varsayılanı tree_method = "hist", max_bin = 256'dır. Her değişken için eğitim kümesinden en çok 256 kesim noktası hesaplanır; değişkenin farklı değer sayısı 256'dan azsa her farklı değer kendi kutusudur. Bölme koşulu "x<c" biçimindedir ve c, bütün eğitim kümesinin bir sonraki farklı değeridir; düğüm içi orta nokta değildir.
Test değerinin hangi yana gittiği
Bir düğümde comorbidity_count yalnız 0 ve 3 değerlerini alıyor, eğitim kümesinde 1 ve 2 de varsa XGBoost koşulu "x<1" olur: test değeri 1 ya da 2 olan hasta sağa gider. Orta nokta kullanan bir uygulama (scikit-learn, rpart) eşiği 1,5 yapar ve 1'i sola, 2'yi sağa gönderir; düğüm içindeki bir sonraki değeri (3) eşik alan bir uygulama ikisini de sola gönderir. Eğitim bölmeleri üçünde de aynıdır, test tahminleri değişir. Tıp örneğinde bağımsız yeniden yazımın ilk sürümü düğüm içi sonraki değeri kullandığı için 1. turda bir test gözleminin puanı 0,36 farklı çıkmış, kesim noktaları bütün eğitim kümesinden alınınca fark 6\times10^{-7}'ye inmiştir.
69.5.6 Erken durdurma
"Erken durdurma (tur)" r seçilirse (classification.py:1026–1087):
- Eğitim kümesinin %20'si tabakalı olarak iç doğrulamaya ayrılır (tohum aynı).
- İç eğitimde en çok M tur uydurulur; her turdan sonra iç doğrulamada çok sınıflı log kaybı ölçülür.
- Kayıp r tur üst üste iyileşmezse durulur; en iyi tur M^{*} o ana kadarki en küçük kayıptır.
- Model M^{*} turla tüm eğitim kümesinde yeniden uydurulur.
- n_v: iç doğrulama gözlem sayısı (Tıp örneğinde 45).
- Klasik motorda aynı tanım
staged_predict_probaile uygulanır (scikit-learn'ün kendin_iter_no_changebölmesi kullanılmaz).
Koddaki tercih: CV'de yeniden erken durdurma yok
Dış CV, ana bölmede seçilen M^{*} ile yapılır; katlarda yeniden erken durdurma yapılmaz. Bu, CV'yi biraz iyimser yapabilir, çünkü M^{*} CV katlarının bir kısmını da içeren eğitim kümesinden seçilmiştir.
69.5.7 Tohum, alt örneklem ve iş parçacığı
Tohum (varsayılan 42) bölmeyi, CV katlarını, iç doğrulama bölmesini, permütasyon önemini ve XGBoost'un random_state'ini belirler. XGBoost'ta rastgelelik yalnız alt örneklemeden (subsample, colsample) gelir:
- Alt örneklem 1 (varsayılan): XGBoost modeli tohumdan bağımsızdır. Tohum değiştirmek yalnız bölmeyi ve CV'yi değiştirir. Sonuç iş parçacığı sayısından da bağımsızdır; doğrulamada 1, 2, 4, 8 ve 16 iş parçacığıyla olasılıklar bit düzeyinde aynıdır.
- Alt örneklem < 1: XGBoost'un satır örneklemesi iş parçacığı sayısına bağlıdır. MerQur bu yüzden XGBoost'u tek iş parçacığıyla (
n_jobs = 1) çalıştırır (classification.py:660–666); aynı veri ve tohum her bilgisayarda aynı modeli verir. Çok iş parçacığında sonuç makineye bağlı olurdu: tohum 42 ile test doğruluğu 1, 2, 4, 8 ve 16 iş parçacığında 0,9286; 0,9107; 0,9286; 0,9286; 0,9107 çıkar ve test olasılıkları tek iş parçacıklı sonuçtan 0,25'e kadar ayrılır (dogrulama/gradient_boosting/bulgu_is_parcacigi.py).
Yeniden üretilebilirlik notu
Alt örneklem < 1 ile tek bir tohumun sonucu, alt örneklem dizisinin bir gerçekleşmesidir; kararlılık için sonuç birkaç tohumun ortalaması olarak da verilebilir. R xgboost paketi aynı seed değeriyle başka bir alt örneklem dizisi üretir (R'nin set.seed() değeri sonucu değiştirmez); bu koşular R ile birebir karşılaştırılamaz.
69.5.8 Önem türleri ve SHAP
- S_j: 300 ağaçta j. değişkeni kullanan bölmeler; her tür toplamı 1 olacak biçimde ölçeklenir (
classification.py:1618–1628). - Varsayılan "Kazanç" XGBoost scikit-learn arayüzünün
feature_importances_değeridir (bölme başına ortalama kazanç). - Kapsam (cover): bölmelerdeki Hessian toplamı.
- SHAP: XGBoost'un TreeSHAP katkıları (
pred_contribs), test kümesinde ortalama mutlak değer; çok sınıfta önce sınıflar üzerinden |\cdot| ortalaması alınır (classification.py:1633–1648). Birimi log-odds puanıdır.
R xgb.importance ile adlar farklı
R xgb.importance()'ın "Gain" sütunu toplam kazancın payıdır; MerQur'un varsayılan "Kazanç"ı ise ortalama kazancın payıdır. Tıp örneğinde yaşın payı R'de 0,593, MerQur varsayılanında 0,407'dir. R ile karşılaştırmada "Önem türü: Toplam kazanç" seçilmelidir; bu seçimle değerler 10^{-15} içinde aynıdır.
69.5.9 Klasik motor (scikit-learn GradientBoostingClassifier)
F_k^{(0)}=b_k (69.5.2, kesin). Her aşamada m=1,\dots,M ve her sınıf k için:
- r_{ik}: negatif gradyan (artık); R_{jk}: artıklara uydurulan derinliği 3 olan regresyon ağacının yaprakları.
- Ağaç, Friedman MSE ölçütüyle büyütülür: bölme iyileşmesi \frac{n_Ln_R}{n_L+n_R}(\bar r_L-\bar r_R)^2.
- (K-1)/K çarpanı Friedman (2001) ve Friedman, Hastie ve Tibshirani'nin (2000) çok sınıflı Newton adımıdır; scikit-learn geriye uyumluluk için korur. ν: öğrenme oranı (0,1).
- Değişken önemi: tüm aşama ve sınıf ağaçlarındaki safsızlık azalışının ortalaması (MDI).
69.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/gradient_boosting/elle_hesap.py ile hesaplanmıştır. Betik ne MerQur'u ne XGBoost'u çağırır: 69.5.1–69.5.6'daki algoritmayı numpy ile yeniden yazar (float32 gradyan ve puan, float64 toplam, küresel kesim noktaları). Klasik motor için scikit-learn modeli doğrudan kurulur ve ilk aşaması formülle denetlenir.
Adım 1 — Bölme. İlk görülme kodları medium = 0, high = 1, low = 2; MerQur sınıf sırası da budur. Eğitim 224 (medium 124, high 89, low 11), test 56 (31, 22, 3). Bütün X'lerin farklı değer sayısı 256'dan küçüktür (en çok yaş, 50); histogram kutuları farklı değerlerin kendisidir.
Adım 2 — Başlangıç kesişimi. \pi=(0{,}553571;\ 0{,}397321;\ 0{,}049107) (medium, high, low); \log\pi=(-0{,}591364;\ -0{,}923010;\ -3{,}013751), ortalaması -1{,}509375:
Adım 3 — Birinci tur, "high" sınıfı. Her turda sınıf sırasıyla (medium, high, low) birer ağaç kurulur; örnek, birinci turun "high" ağacıdır. İlk turda her gözlemde p_{\text{high}}=0{,}397321. "high" olan 89 gözlemde g=-0{,}602679, diğer 135'inde g=0{,}397321; hepsinde h=2\times0{,}397321\times0{,}602679=0{,}478914. Kökte G=89\times(-0{,}602679)+135\times0{,}397321\approx0 (float32 artığı 3{,}6\times10^{-6}), H=224\times0{,}478914=107{,}2768.
Adım 4 — Kök bölmesi. En büyük kazanç yaş < 73'tedir. Sol çocukta 152 hasta (28'i high), sağda 72 hasta (61'i high):
İkinci düzeyde sol düğüm comorbidity_count < 4 (kazanç 6,8188), sağ düğüm comorbidity_count < 2 (4,7283) ile bölünür. XGBoost'un ağaç dökümü kökü "f0<73, gain = 43,7919" olarak yazar.
Adım 5 — Yaprak değerleri. En soldaki yaprak (yaş < 65, ek hastalık < 4, son yatış < 6 gün; 79 hasta): G=31{,}3884, H=37{,}8342, w^{*}=-31{,}3884/38{,}8342=-0{,}808268; puana eklenen 0{,}3\times w^{*}=-0{,}242480. En sağdaki yaprak (yaş ≥ 73, ek hastalık ≥ 2, son yatış ≥ 3; 46 hasta, hepsi high): G=-27{,}7232, H=22{,}0301, katkı +0{,}361135. Birinci turun "high" ağacında 18 bölme ve 19 yaprak vardır.
Adım 6 — 100 tur sonra test kümesi. 300 ağaçtan sonra softmax olasılıkları. Karışıklık matrisi (satır gerçek; medium, high, low):
| medium | high | low | |
|---|---|---|---|
| medium | 27 | 3 | 1 |
| high | 1 | 21 | 0 |
| low | 1 | 0 | 2 |
Doğruluk 50/56=0{,}892857; ağırlıklı kesinlik 0,894858, duyarlılık 0,892857, F1 0,892624; makro bire-karşı-diğerleri AUC 0,973147. CV (eğitimde 5 kat): 0,844444; 0,933333; 0,888889; 0,866667; 0,931818 (ortalama 0,8930, SS 0,0394).
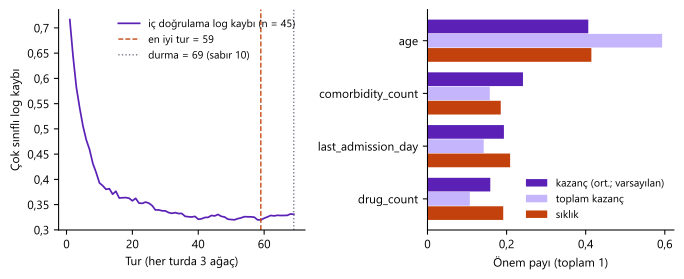
Adım 7 — Önem. 300 ağaçta toplam 1436 bölme ve 1736 yaprak vardır. Ortalama kazanç payı: yaş 0,406571; ek hastalık 0,241417; son yatış 0,193230; ilaç 0,158782. Toplam kazanç payı: 0,593264; 0,157487; 0,142164; 0,107085. Sıklık payı: 0,414345; 0,185237; 0,208914; 0,191504. Yaş en çok bölmeyi ve en büyük kazancı sağlar; ek hastalık sayısı ortalama kazançta ikinci, sıklıkta sonuncudur: az ama güçlü bölmeler yapar.
Adım 8 — Erken durdurma (10 tur). 224 eğitim gözleminden 179'u iç eğitim, 45'i iç doğrulama. İç doğrulama log kaybı 0,7164 (1. tur), 0,6429, 0,5821, … biçiminde düşer; en küçük değer 59. turdadır, 69. turda durulur. Model 59 turla tüm eğitim kümesinde yeniden kurulur; test doğruluğu yine 0,892857, AUC 0,969299.
Adım 9 — Ek metrikler. κ = 0,8024 (ASE 0,0752), MCC 0,8043, dengeli doğruluk 0,8307, makro F1 0,8266, doğruluk GA [0,7812; 0,9597], NIR =31/56=0{,}5536 (p=4{,}3\times10^{-8}). "low" sınıfının duyarlılığı 2/3'tür; 3 test gözlemiyle bu sayı çok belirsizdir. Permütasyon önemi: yaş 0,3536 ± 0,0393; son yatış 0,1286 ± 0,0482; ek hastalık 0,1161 ± 0,0282; ilaç 0,0571 ± 0,0355. Ortalama |SHAP|: yaş 1,918; son yatış 0,946; ek hastalık 0,892; ilaç 0,615.
Adım 10 — Klasik motor. scikit-learn başlangıç puanı formülle aynıdır (10^{-16}). İlk aşamada her sınıf ağacının yaprak değerleri (K-1)/K\cdot\bar r/(\pi_k(1-\pi_k)) formülüyle 9\times10^{-15} içinde aynıdır; üç sınıfın kök bölmesi kaba kuvvetle bulunan en büyük Friedman iyileşmesidir ("high" ve "medium" için yaş ≤ 72,5; "low" için yaş ≤ 42,5). 100 aşama sonra test doğruluğu 0,892857, AUC 0,975115, CV ortalaması 0,8481; önem payları yaş 0,572, son yatış 0,192, ek hastalık 0,138, ilaç 0,098.
Şekil 69.1. Sol: erken durdurmada iç doğrulama log kaybı (45 hasta); kesikli çizgi en iyi tur (59), noktalı çizgi durma turu (69). Sağ: XGBoost'un üç önem türü; aynı model, farklı sıralama.
69.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan alınmıştır (round bellekte devre dışı). Python sütunu numpy yeniden yazımıdır (XGBoost çağrılmaz); klasik motor satırlarında scikit-learn doğrudan kurulup tanımla denetlenmiştir. R: 4.5.3, xgboost 3.2.1.1 (aynı C++ çekirdeği), ham X, aynı eğitim satırları ve aynı ayarlar.
Tolerans: XGBoost gradyan, puan ve olasılıkları float32 tutar (göreli duyarlık 6\times10^{-8}); 300 ağaçlık toplamda bağımsız float64/float32 karışık yeniden yazımla birikim 6\times10^{-7}'dir ve 10^{-6} ölçütünün içindedir. Başlangıç kesişiminde fark 1{,}2\times10^{-5}'tir (XGBoost'un sayısal çözümü); MerQur ile R arasında bu fark da sıfırdır.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 (xgboost) | En büyük fark | Durum |
|---|---|---|---|---|---|
| Başlangıç kesişimi b (3), MerQur–R | 0,918004 | — | 0,918004 | 0,0e+00 | ✓ |
| Başlangıç kesişimi b: Python log π_k − ort. log π | 0,918004 | 0,918010 | — | 1,2e−05 | ≈ (2·10⁻⁵; xgboost yinelemeli kestirir) |
| Test olasılıkları (56 × 3) | 0,983828 | 0,983828 | 0,983828 | 4,8e−07 | ✓ |
| Test doğruluğu | 0,892857 | 0,892857 | 0,892857 | 1,1e−16 | ✓ |
| Test kesinliği (ağırlıklı) | 0,894858 | 0,894858 | — | 0,0e+00 | ✓ |
| Test duyarlılığı (ağırlıklı) | 0,892857 | 0,892857 | — | 0,0e+00 | ✓ |
| Test F1 (ağırlıklı) | 0,892624 | 0,892624 | — | 0,0e+00 | ✓ |
| Test ROC-AUC (bire-karşı-diğerleri, makro) | 0,973147 | 0,973147 | 0,973147 | 3,3e−16 | ✓ |
| Önem 'kazanç' (bölme başına ort.; 4, gösterilen age) | 0,406571 | 0,406571 | — | 2,2e−07 | ✓ |
| Önem 'toplam kazanç' (4; R xgb.importance Gain) | 0,593264 | 0,593264 | 0,593264 | 1,6e−07 | ✓ |
| Önem 'sıklık' (4; R Frequency) | 0,414345 | 0,414345 | 0,414345 | 5,0e−16 | ✓ |
| Dış 5 katlı CV doğrulukları (5) | 0,844444 | 0,844444 | — | 0,0e+00 | ✓ |
| Aynı tohumla ikinci çalıştırma: test olasılıkları | 0,983828 | 0,983828 | — | 0,0e+00 | ✓ (birebir) |
| Tohum 7 (yalnız bölme değişir): test olasılıkları | 0,990245 | 0,990245 | — | 2,4e−07 | ✓ |
| Tohum 7: test doğruluğu, AUC | 0,892857 | 0,892857 | — | 0,0e+00 | ✓ |
| Erken durdurma (10 tur): en iyi tur sayısı | 59 | 59 | — | 0,0e+00 | ✓ |
| Erken durdurma: iç doğrulama mlogloss eğrisi (69 tur) | 0,716421 | 0,716421 | — | 2,5e−07 | ✓ |
| Erken durdurma: test olasılıkları (59 turluk model) | 0,971762 | 0,971762 | — | 5,4e−07 | ✓ |
| Alt örneklem 0,8, aynı tohum: ikinci çalıştırma | 0,996368 | 0,996368 | — | 0,0e+00 | ✓ (birebir, aynı makine) |
| Klasik motor: F₀ (3; 1. sütun sklearn doğrudan uydurma, 2. sütun log π_k − ort. log π) | 0,918010 | 0,918010 | — | 1,1e−16 | ✓ |
| Klasik motor: ilk aşama yaprak değerleri, (K−1)/K·Σr/Σp(1−p) formülüyle | — | 8,8818·10−15 | — | 8,9e−15 | ✓ |
| Klasik motor: ilk aşamada 3 kök bölmesi Friedman iyileşmesinin en büyüğü | — | 3/3 | — | 0 | ✓ |
| Klasik motor: test olasılıkları (MerQur ↔ sklearn doğrudan) | 0,991803 | 0,991803 | — | 0,0e+00 | ✓ |
| Klasik motor: test doğruluğu, AUC | 0,892857 | 0,892857 | — | 0,0e+00 | ✓ |
Alt örneklem 0,8 koşuları yalnız MerQur içinde (aynı tohum) karşılaştırılmıştır; R paketiyle birebir eşleşme beklenmez (69.5.7).
69.7 Çıktıyı okuma
Sonuç metni (varsayılanlar; kısaltılmış):
XGBoost Sınıflandırma
  Hedef               = repeat_admission_risk
  Özellik sayısı      = 4
  Sınıflar            = medium, high, low
  Algoritma           = XGBoost (sürüm 3.2.0, XGBClassifier: 100 ağaç, eta=0.3, max_depth=6) — 'Gradyan artırma' seçimi, XGBoost bileşeni yüklü olduğu için XGBoost ile çalıştırıldı

  ── Test Performansı ──
  Doğruluk            = 0.8929
  Kesinlik            = 0.8949
  Duyarlılık          = 0.8929
  F1                  = 0.8926
    ↳ Kesinlik, duyarlılık ve F1 sınıfların gözlem sayısıyla ağırlıklı ortalamasıdır
      (ağırlıklı duyarlılık doğruluğa eşittir); sınıf bazında değerler sınıflandırma raporundadır.
  ROC-AUC             = 0.9731
  5-katlı CV doğruluğu= 0.8930 (±0.0394)

── Karmaşıklık Matrisi ──
          medium  high  low
  medium      27     3    1
  high         1    21    0
  low          1     0    2

── Özellik Önemi (ilk 10) ──
             Özellik     Önem
                 age 0.406571
   comorbidity_count 0.241417
...
Erken durdurma açıkken eklenen satır:
Erken durdurma: 10 tur iyileşme yoksa dur; en iyi tur = 59 / 100 (doğrulama: eğitimin %20'si, n = 45, ölçüt mlogloss); model 59 ağaçla tüm eğitim kümesinde yeniden uyduruldu.
SHAP açıkken:
── SHAP: ortalama |katkı| (test kümesi, TreeSHAP) ──
  age                      1.9183
  last_admission_day       0.9465
  comorbidity_count        0.8921
  drug_count               0.6155
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Başlık "XGBoost Sınıflandırma" | Gerçekte çalışan motor. | Klasik motorda "Gradyan artırma Sınıflandırma". |
| Algoritma | Sürüm, sınıf, tur, η, derinlik; klasik motorda nedeni. | Başka kurulumla karşılaştırmada önce bu satır denetlenir. |
| Test metrikleri, CV | Bölüm 67.7 ile aynı. | Çok sınıfta duyarlılık = doğruluk. |
| Özellik Önemi | Seçilen önem türü (varsayılan ortalama kazanç). | Tür değişince sıralama değişebilir (Şekil 69.1). |
| Hiperparametreler | Yalnız formda değiştirilenler ve ağaç sayısı. | Erken durdurmada son tur sayısı yazılır ("n_estimators = 59"). |
| Erken durdurma satırı | En iyi tur, doğrulama büyüklüğü, ölçüt. | En iyi tur sınıra (100) çok yakınsa tur sayısı artırılmalı. |
| SHAP | Ortalama mutlak katkı (log-odds puanı). | Sıralama permütasyon önemiyle birlikte okunmalı. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Tekrar yatış riski (düşük, orta, yüksek) yaş, ek hastalık sayısı, son yatıştan bu yana geçen gün ve ilaç sayısından gradyan artırmayla (XGBoost 3.2.0; 100 tur, öğrenme oranı 0,3, en büyük derinlik 6; tohum 42) tahmin edildi. Veri tabakalı olarak eğitim (n = 224) ve test (n = 56) kümelerine ayrıldı. Test doğruluğu 0,893 (%95 kesin GA [0,781; 0,960]; bilgisiz oran 0,554, p < 0{,}001), Cohen \kappa = 0{,}80 ve makro ortalama AUC 0,973 oldu; eğitim kümesinde beş katlı çapraz doğrulama doğruluğu 0{,}893 \pm 0{,}039 idi. Test kümesindeki permütasyon önemine göre en bilgilendirici değişken yaştı (doğrulukta ortalama düşüş 0,354). Düşük risk sınıfı testte yalnız üç hastayla temsil edildiğinden bu sınıfın başarımı belirsizdir.
69.8 Uzman soruları
S1. Tohum değiştirince XGBoost modeli neden değişmiyor?
Alt örneklem ve sütun örneklemesi 1 iken XGBoost'un algoritması deterministiktir: her turda tüm satırlar ve tüm değişkenler kullanılır, en iyi bölme tektir. Tohum yalnız MerQur'un eğitim/test bölmesini ve CV katlarını değiştirir. Tıp örneğinde tohum 7 ile test doğruluğu yine 0,8929, AUC 0,9545'tir; fark tamamen farklı test hastalarından gelir. Bağımsız yeniden yazım tohum 7'nin bölmesinde de MerQur'la 4\times10^{-7} içinde aynıdır.
S2. Aynı tohumla başka bir bilgisayarda farklı sonuç alırsam?
Aynı MerQur ve XGBoost sürümünde beklenmez. XGBoost'un satır örneklemesi iş parçacığı sayısına bağlıdır; MerQur bu yüzden XGBoost'u tek iş parçacığıyla çalıştırır ve sonuç makineden bağımsız olur. Çok iş parçacığında Tıp örneğinde yalnız iş parçacığı sayısı değiştirilerek test doğruluğu 0,893–0,946 arasında oynardı. Farkın olası kaynağı XGBoost sürümüdür: 3.x başlangıç kesişimini veriden kestirir, 2.x sabit kullanırdı.
S3. Hessian neden 2p(1−p)?
Kesin köşegen p(1-p)'dir. XGBoost'un çok sınıflı hedefi 2 çarpanını kullanır; Newton adımı yarıya iner ve sınıflar arası çapraz türevlerin yok sayılmasından doğabilecek aşırı adım engellenir. Sonuç olarak min_child_weight eşiği de bu ölçektedir: Tıp örneğinin ilk turunda h=0{,}479 olduğundan 1'lik eşik, her çocukta en az üç gözlem demektir.
S4. R'deki xgboost ile aynı sonucu nasıl alırım?
Aynı XGBoost sürümü, aynı eğitim satırları ve aynı parametrelerle (multi:softprob, eta 0,3, max_depth 6, nrounds 100, tree_method hist, alt örneklem 1) R xgb.train() MerQur'la 4\times10^{-16} içinde aynı olasılıkları verir. Eğitim satırlarını MerQur'un bölme tanımıyla almak gerekir (67.5.1); MerQur'un z ölçeklemesi bölmeleri değiştirmediği için R'ye ham veri verilebilir. Önem karşılaştırmasında "Toplam kazanç" seçilmelidir (69.5.8).
S5. Erken durdurmanın seçtiği tur sayısı güvenilir mi?
Seçim 45 gözlemlik tek bir iç doğrulama kümesine dayanır ve bu kümenin hangi hastalardan oluştuğuna duyarlıdır; doğrulama eğrisi minimum çevresinde düzdür (Şekil 69.1). Ayrıca dış CV aynı tur sayısıyla yapılır, katlarda yeniden seçilmez. Tur sayısını CV ile seçmek için "Hiperparametre ayarı" (ağaç ∈ {100, 200}) ya da daha küçük η ile daha çok tur denenebilir.
S6. Histogram yöntemi tam aramayla aynı mı?
Eğitim bölmeleri açısından, her değişkenin farklı değer sayısı 256'dan azsa evet: her değer kendi kutusudur. Ama eşik "bir sonraki küresel değer"dir, orta nokta değildir; eğitimde görülmeyen ara değerli test gözlemleri tam aramadan farklı yana gidebilir (69.5.5). Farklı değer sayısı 256'yı aşan sürekli değişkenlerde kutular nicelik taslağıyla birleştirilir ve bölmeler de yaklaşıktır.
S7. Az gözlemli sınıf ("low", eğitimde 11 hasta) için ne yapılabilir?
"Dengeli ağırlık" seçeneği gradyan artırmada örnek ağırlığı n/(K n_k) olarak uygulanır (classification.py:1317–1319); gradyan ve Hessian bu ağırlıklarla çarpılır. CV'de ağırlıklar tüm eğitim kümesinden hesaplanıp katlara dilimlenir. Test kümesinde 3 "low" hasta olduğundan bu sınıfın duyarlılığı (2/3) çok geniş bir belirsizlik taşır; sınıf bazlı tablo ve dengeli doğruluk birlikte raporlanmalıdır.
S8. SHAP ile permütasyon önemi neden farklı sıralama verebilir?
SHAP, modelin log-odds puanındaki ortalama mutlak katkıyı ölçer; permütasyon önemi test doğruluğundaki düşüşü. Puanı çok değiştiren ama sınıf kararını az değiştiren bir değişken SHAP'ta yüksek, permütasyonda düşük çıkar. Tıp örneğinde iki ölçüt aynı sırayı verir (yaş, son yatış, ek hastalık, ilaç). Çok sınıfta MerQur'un SHAP özeti sınıflar üzerinden ortalamadır; sınıfa özgü yön bilgisi yalnız grafikte vardır.
69.9 Sık hatalar ve tuzaklar
- Motoru "Otomatik"te bırakıp sonuçları başka kurulumla karşılaştırmak. XGBoost'u olmayan kurulum klasik motora geçer (η 0,1, derinlik 3): başka bir model. "Algoritma" satırını denetleyin ya da motoru sabitleyin.
- Alt örneklem < 1 ile tek tohumun sonucunu kesin sanmak. Sonuç alt örneklem dizisine bağlıdır; birkaç tohumla kararlılığı denetleyin.
- Varsayılan önem değerini R'nin "Gain" sütunuyla karşılaştırmak. MerQur ortalama, R toplam kazancı verir.
- Çok turla aşırı uyum. η = 0,3 büyük bir adımdır; erken durdurma ya da küçük η denenmeli, eğitim ile test/CV başarımı karşılaştırılmalıdır.
- Küçük sınıfın metriklerini kesin sanmak. Üç test gözleminde 2/3 duyarlılık bilgi taşımaz.
- SHAP değerlerini olasılık birimi sanmak. Katkılar log-odds (softmax puanı) birimindedir.
min_child_weight'i klasik motorda ayarlamak. Değer kullanılmaz (ayar bloğu bunu yazar); bu seçenek yalnız XGBoost içindir.
69.10 Kaynaklar
- Chen, T., & Guestrin, C. (2016). XGBoost: A scalable tree boosting system. In Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining (ss. 785–794). https://doi.org/10.1145/2939672.2939785
- Friedman, J. H. (2001). Greedy function approximation: A gradient boosting machine. The Annals of Statistics, 29(5), 1189–1232. https://doi.org/10.1214/aos/1013203451
- Friedman, J. H. (2002). Stochastic gradient boosting. Computational Statistics & Data Analysis, 38(4), 367–378. https://doi.org/10.1016/S0167-9473(01)00065-2
- Friedman, J., Hastie, T., & Tibshirani, R. (2000). Additive logistic regression: A statistical view of boosting. The Annals of Statistics, 28(2), 337–407. https://doi.org/10.1214/aos/1016218223
- Goldstein, A., Kapelner, A., Bleich, J., & Pitkin, E. (2015). Peeking inside the black box: Visualizing statistical learning with plots of individual conditional expectation. Journal of Computational and Graphical Statistics, 24(1), 44–65. https://doi.org/10.1080/10618600.2014.907095
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2. baskı). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Lundberg, S. M., Erion, G., Chen, H., DeGrave, A., Prutkin, J. M., Nair, B., Katz, R., Himmelfarb, J., Bansal, N., & Lee, S.-I. (2020). From local explanations to global understanding with explainable AI for trees. Nature Machine Intelligence, 2(1), 56–67. https://doi.org/10.1038/s42256-019-0138-9
- Natekin, A., & Knoll, A. (2013). Gradient boosting machines, a tutorial. Frontiers in Neurorobotics, 7, 21. https://doi.org/10.3389/fnbot.2013.00021