40. Etki Büyüklüğü Hesaplayıcı
Analiz kimliği: effect_size · Menü adı: Etki Büyüklüğü Hesaplayıcı · Panel ve motor: gui/panels/analyses/effect_size.py, execute (satır 662–745); Cohen d (271–388), η²/ω²/ε² (393–513), Cramér V (516–601), r (606–657), eşli d (774–815), sıra tabanlı (818–851), özet istatistik (867–940), 2×2 risk (943–983) · Çağrı: gui/panels/stats_panel.py:4935–4979
40.1 Ne işe yarar
Etki büyüklüğü, bir farkın ya da ilişkinin ne kadar büyük olduğunu örneklem büyüklüğünden bağımsız bir ölçekte verir. p değeri "fark sıfır mı?" sorusuna, etki büyüklüğü "fark ne kadar?" sorusuna cevap verir; APA 7 ikisinin birlikte ve etki büyüklüğünün GA'sıyla raporlanmasını ister. Bu modül yedi tür hesaplar:
| Analiz tipi (arayüz) | İç anahtar | Veri | Çıktı |
|---|---|---|---|
| Cohen's d (iki grup ortalaması) | cohen_d |
sürekli × 2 düzeyli grup | d, Hedges g, Glass Δ, nct GA; isteğe bağlı d_{av} ve iki Glass Δ |
| η²/ω² (ANOVA, 3+ grup) | eta |
sürekli × k düzeyli grup | \eta^2, \omega^2, \varepsilon^2, merkezî olmayan F GA'ları |
| Cramér's V (kategorik × kategorik) | cramer |
iki kategorik | φ, V, yanlılık düzeltmeli \tilde V, merkezî olmayan \chi^2 GA'sı; isteğe bağlı 2×2 risk ölçüleri |
| r/r² (korelasyon) | correlation |
iki sürekli | Pearson r, r^2, Fisher z GA |
| Eşleştirilmiş d | paired_d |
iki sürekli (aynı kişi) | d_z (nct GA), g_z, d_{av}, d_{rm} |
| Sıra tabanlı | rank |
sürekli/sıralı × grup | rank-biserial r = Cliff δ (GA), U, Kruskal–Wallis H, \varepsilon^2_R |
| Özet / test istatistiğinden | summary |
metin girdisi | yayımlanmış \bar x, SS, n, t, F, \chi^2'den etki büyüklüğü ve dönüşümler |
Ne zaman kullanılır? Bir testin sonucunu etki büyüklüğüyle tamamlamak, meta-analiz için makalelerdeki özet istatistiklerden etki büyüklüğü çıkarmak, güç analizine girdi hazırlamak ya da farklı ölçeklerdeki sonuçları karşılaştırmak için.
Ne zaman kullanılmaz?
- Hipotez testinin kendisi isteniyorsa: Bağımsız t Testi (Bölüm 5), Tek Yönlü ANOVA (Bölüm 7), Ki-Kare Bağımsızlık Testi, Korelasyon Analizi. Bu modül p'yi yalnız bilgi olarak verir.
- Kovaryatla düzeltilmiş ya da çok etkenli desende kısmi etki büyüklüğü isteniyorsa: ANCOVA (Bölüm 14) ve İki Yönlü ANOVA (Bölüm 9) kendi kısmi \eta^2_p/\omega^2_p değerlerini verir. Buradaki "eta" tipi tek etkenlidir.
- Medyan ya da kırpılmış ortalama gibi dayanıklı bir ölçünün GA'sı isteniyorsa: Bootstrap Güven Aralığı (Bölüm 15).
- 2×2 tabloda tabakalı (Mantel–Haenszel) OR isteniyorsa: Cochran–Mantel–Haenszel.
Sık karıştırılan analizler. Bu modül de bağımsız t testi gibi grupları MerQur'un ortak düzey sırası kuralıyla dizer (40.5.1); iki modülün d işareti aynıdır. Eşleştirilmiş t testinin d_z'si ile buradaki eşli d_z aynıdır. Lojistik regresyondaki OR düzeltilmiş (koşullu) OR'dir; buradaki 2×2 OR ham OR'dir.
40.2 Varsayımlar ve veri türü
| Tip | Varsayım | MerQur'da nasıl denetlenir |
|---|---|---|
| Cohen d, g | İki bağımsız grup; GA için normal dağılım ve eşit varyans | Denetlenmez; toplam n<30 uyarısı (effect_size.py:680–683). |
| η², ω², ε² | ANOVA varsayımları (normal hata, eşit varyans, bağımsızlık) | Denetlenmez; k<3 uyarısı, \omega^2<0 uyarısı (effect_size.py:687–694). |
| Cramér V | Bağımsız gözlemler; \chi^2 yaklaşımı için yeterli beklenen frekans | n<50 uyarısı (effect_size.py:698–701); beklenen frekans denetlenmez. |
| r | Doğrusal ilişki; Fisher z GA'sı için iki değişkenli normallik | n<30 uyarısı (effect_size.py:705–708). |
| Eşli d | Aynı birimde iki ölçüm; d_z GA'sı için farkların normalliği | Denetlenmez. |
| Sıra tabanlı | Sıralı ya da sürekli veri; dağılım varsayımı yok | Denetlenmez. |
Eksik değer. Her tip yalnız kullandığı iki sütunda liste bazında siler; bağımlı değişken sayıya çevrilir (effect_size.py:285–288, 406–409, 544, 619–622, 781). Künyedeki n, iki sütunun birlikte dolu olduğu satır sayısıdır (stats_panel.py:4970–4973).
Uç durumlar.
- Cohen d: grup sayısı 2 değilse hata; n_1+n_2-2\le0 ise hata. n=1 olan grupta SS tanımsızdır, J ve GA "—" yazılır (
effect_size.py:290–310). Havuzlanmış SS 0 ise d=0 yazılır (effect_size.py:315). - η²: N-k\le0 ise hata (
effect_size.py:420–421). - Cramér V: tablo 2 × 2'den küçükse hata (
effect_size.py:549–552). - r: n<3 ya da sütunlardan biri sabitse hata; n=3 ya da |r|=1 ise GA [-1;\ 1] yazılır (
effect_size.py:624–646). - Eşli d: n<3 ise hata (
effect_size.py:783–784). - Kullanıcı düzey sırasında olmayan bir düzey yazarsa hata (
effect_size.py:226–229). - 2×2 risk: tablo 2×2 değilse risk satırları notla atlanır, V verilir (
effect_size.py:734–738); hücrelerden biri 0 ise tüm hücrelere 0,5 eklenir (Haldane düzeltmesi,effect_size.py:959–960).
40.3 Parametreler
Varsayılanlar effect_size.py:1064–1161 (form) ve stats_panel.py:4935–4965 (çağrı) satırlarından okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Analiz tipi | Cohen's d | Yedi tipten biri (40.1 tablosu). | Kullanılan formül ve çıktı. |
| Sütun 1 | ilk sütun | Cohen d/η²/sıra: bağımlı değişken; Cramér V: 1. kategorik (satır); r/eşli: 1. sürekli. | Eşlide fark = Sütun 1 − Sütun 2. |
| Sütun 2 | ikinci sütun | Cohen d/η²/sıra: grup; Cramér V: 2. kategorik (sütun); r/eşli: 2. sürekli. | — |
| Güven Düzeyi | %95 | %90, %95, %99 ya da özel; \alpha=1-\text{düzey}. | Tüm GA'lar. |
| Standartlaştırıcı (ek) | Yalnız havuzlanmış SS | "Ortalama SS ve iki Glass Δ" seçilirse d_{av} ve her iki grubun denetim alındığı Glass Δ eklenir. | Ek bölüm; ana d değişmez. |
| 2×2 risk ölçüleri | kapalı | Cramér V tipinde 2×2 tabloda OR, RR, RD, 1/|RD|. | Ek bölüm. |
| Sütun 1 düzey sırası | boş (ortak düzey sırası; 0/1'de "1" önce) | 2×2 riskte satır sırası; ilk düzey = maruz grup. | RR, RD ve 1/|RD|'nin anlamı. |
| Sütun 2 düzey sırası | boş (ortak düzey sırası; 0/1'de "1" önce) | Cohen d/sıra tipinde grup sırası (ilk düzey = 1. grup); 2×2 riskte sütun sırası (ilk düzey = olay). | d'nin işareti, Glass Δ'nın paydası, RR'nin anlamı. |
| Özet istatistikler | boş | anahtar=değer çiftleri (40.5.8). |
Yalnız "Özet" tipinde. |
Neden düzey sırası bu kadar önemli?
Varsayılan sıra MerQur'un ortak düzey sırası kuralıdır (_default_levels, effect_size.py:233–242): kullanıcının sıralı kategorik sütunu; etiketlerin hepsi sayı ya da sayı içeriyorsa sayısal/doğal sıra; aksi hâlde verideki ilk görülme sırası. Alfabetik sıra kullanılmaz; kullanılan sıra çıktıda "Kullanılan düzey sırası" satırında yazılır. Cohen d'de sıra, d'nin işaretini ve Glass Δ'nın hangi grubun SS'sine bölüneceğini belirler. 2×2 riskte 0/1 kodlu sütunda "1" maruz grup ve "1" olay sayılır (_risk_default, 245–257); başka etiketlerde ortak kural geçerlidir. Tıp örneğinde RR 1,1653'tür (40.6, Adım 7).
40.4 Tıp örneği
Ana örnek Tıp #35 dosyasıdır; diğer tipler için Tıp setindeki uygun dosyalar kullanılmıştır.
| Tip | Dosya | Sütun 1 | Sütun 2 | n |
|---|---|---|---|---|
| Cohen d, sıra tabanlı | 35_effect_size_antidepresan.xlsx |
HAMD_change |
drug (SSRI 60, SNRI 60) |
120 |
| η², ω², ε² | 06_anova_drug_LDL.xlsx |
LDL_change |
drug_group (placebo, drug-A, -B, -C; 35'er) |
140 |
| Cramér V | 21_chisquare_smoking_copd.xlsx |
smoking_status (3 düzey) |
copd (present, absent) |
670 |
| 2×2 risk | 40_logistic_KAH.xlsx |
smoking (0/1) |
heart_attack (0/1) |
300 |
| r | 33_correlation_5klinik.xlsx |
BMI |
systolic_bp |
180 |
| Eşli d | 05_paired_t_bp_treatment.xlsx |
systolic_before |
systolic_post |
50 |
Tıp #35 (ana örnek). Hamilton depresyon ölçeği (HAMD) puanındaki değişim (son − başlangıç; negatif değer iyileşme). Eksik değer yok.
| SSRI | SNRI | |
|---|---|---|
| n | 60 | 60 |
| Ortalama | −8,6230 | −13,2115 |
| SS | 5,951500 | 7,590712 |
Klinik soru: İki antidepresan arasındaki HAMD değişimi farkı pratikte ne kadar büyük? Fark "orta" büyüklükte mi, GA'sı küçük bir etkiyi dışlıyor mu?
Seçilen ayarlar: Arayüz varsayılanları (Cohen's d, %95, düzey sırası boş). Ek olarak: Sütun 2 düzey sırası SNRI, standartlaştırıcı "Ortalama SS ve iki Glass Δ", %90 güven düzeyi; diğer tipler yukarıdaki dosyalarla; 2×2 riskte boş sıra, 1 / 1 sırası ve 0 / 0 sırası. Özet tipinde girdi metni: m1=-13.21, sd1=7.59, n1=60, m2=-8.62, sd2=5.95, n2=60; F=57.67, df1=3, df2=136; chi2=130.54, n=670, rows=3, cols=2 (Tıp #35 betimselleri, #06 F'si ve #21 \chi^2'si iki ondalıkla).
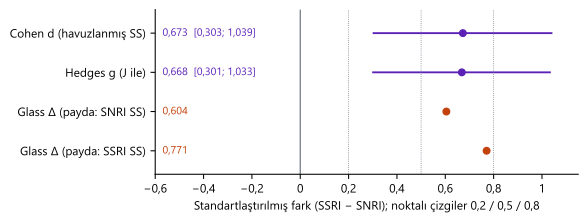
Şekil 40.1. SSRI − SNRI HAMD değişimi için standartlaştırılmış fark ölçüleri. Mor: Cohen d ve Hedges g, %95 nct GA'larıyla; turuncu: payda olarak iki grubun SS'sini kullanan Glass Δ'lar. Noktalı çizgiler Cohen'in 0,2 / 0,5 / 0,8 eşikleri.
40.5 Formüller ve hesap adımları
execute (effect_size.py:662–745) seçilen tipin yardımcı fonksiyonunu çağırır, sonra (Cohen d'de) standartlaştırıcı ekini, (Cramér V'de) 2×2 risk ekini hesaplar ve uyarıları ekler. Kullanılmayan seçenekler (ör. Cohen d tipinde girilen özet metni) sonucu değiştirmez; ayar bloğuna not düşülür (effect_size.py:748–769).
40.5.1 Cohen d, Hedges g, Glass Δ
Gruplar ortak düzey sırası kuralıyla dizilir; "Sütun 2 düzey sırası" doluysa o sıra öne alınır (_order_levels, _default_levels, effect_size.py:214–242).
- \bar x_g, s_g, n_g: g. grubun ortalaması, SS'si (payda n_g-1) ve büyüklüğü; 1. grup düzey sırasındaki ilk düzeydir.
- s_p: havuzlanmış SS.
- J: Hedges'in kesin yanlılık düzeltme çarpanı;
gammalnile hesaplanır (_hedges_j,effect_size.py:260–266). \nu\le1 ise tanımsızdır. - \Delta: Glass (1976) Δ; payda 2. grubun SS'sidir ve 2. grup "denetim" sayılır (
effect_size.py:322).
Neden kesin J?
d, evren etkisi \delta'nın yanlı kestiricisidir: E(d)=\delta/J(\nu). Hedges (1981) yansız kestiricinin J\,d olduğunu gösterdi. Yaygın 1-3/(4\nu-1) ve 1-3/(4N-9) biçimleri J'nin yaklaşımlarıdır; küçük \nu'de üçüncü ondalıkta ayrılırlar. MerQur bağımsız ve eşli gruplarda kesin biçimi kullanır (_hedges_j, effect_size.py:260–266). R effectsize::hedges_g ve MBESS kesin biçimi kullanır.
d için GA (merkezî olmayan t). Normal dağılım ve eşit varyans altında t=d\sqrt{n_1n_2/(n_1+n_2)}, serbestlik derecesi \nu=n_1+n_2-2 ve merkezî olmama parametresi \lambda=\delta\sqrt{n_1n_2/(n_1+n_2)} olan merkezî olmayan t dağılımına uyar (_d_ci_nct, effect_size.py:361–388):
- F_{t'}: merkezî olmayan t dağılımının birikimli fonksiyonu (
scipy.stats.nct.cdf); \lambda'ya göre azalandır. - Kökler Brent yöntemiyle
xtol=1e-12toleransla bulunur; başlangıç aralığı t_{\text{göz}}\pm(2+|t_{\text{göz}}|), kök kapsanmazsa 60 adıma kadar genişletilir. - Kök bulma başarısızsa normal yaklaşım kullanılır: d\pm z_{1-\alpha/2}\SH_d, \SH_d=\sqrt{\frac{n_1+n_2}{n_1n_2}+\frac{d^2}{2(n_1+n_2)}} (
effect_size.py:325–336). - g'nin GA'sı d'nin GA uçlarının J ile çarpımıdır (
effect_size.py:353–354); Reffectsize::hedges_gile aynı tanım.
Neden merkezî olmayan t?
d bir t istatistiğinin ölçeklenmiş hâlidir. \delta\neq0 iken t'nin dağılımı merkezî olmayan t'dir ve bu dağılım \lambda'da monotondur. Gözlenen t'yi sabit tutup \lambda'yı tarayarak "gözlenen t'yi %2,5 ve %97,5 kantilinde bırakan" \lambda değerleri bulunur; bu, \delta için kesin GA'dır (Cumming ve Finch 2001; Steiger 2004; Kelley 2007). Normal yaklaşım büyük |d|'de simetrik kaldığı için sapar.
Ek standartlaştırıcılar ("Ortalama SS ve iki Glass Δ", effect_size.py:723–733):
Koddaki tercih
Ek bölüm, yuvarlanmamış ortalama ve SS'lerden hesaplanır (effect_size.py:725–733); sonuç nesnesindeki dört ondalığa yuvarlanmış c.mean1, c.sd1 değerleri yalnız gösterim içindir. Eşit n'de d_{av}=d'dir. Eşli tipteki d_{av} başka bir paydadır (40.5.5).
40.5.2 η², ω², ε² (tek yönlü ANOVA)
Grupların sırası ilk görülme sırasıdır (effect_size.py:411). F ve p scipy.stats.f_oneway ile, kareler toplamları açıkça hesaplanır (effect_size.py:423–451):
- \mathrm{KT}_A, \mathrm{KT}_İ, \mathrm{KT}_T: gruplar arası, grup içi ve toplam kareler toplamı.
- \eta^2: örneklemde açıklanan varyans oranı; evren değerini yukarı yanlı kestirir.
- \omega^2 (Hays) ve \varepsilon^2 (Kelley 1935): yanlılığı azaltılmış kestiriciler; negatif çıkabilir, MerQur negatif değeri olduğu gibi yazar ve uyarır.
Neden \omega^2 ve \varepsilon^2?
E(\mathrm{KT}_A)=(k-1)\sigma^2+\sum n_g(\mu_g-\mu)^2 olduğundan \mathrm{KT}_A'nın (k-1)\sigma^2'lik kısmı H₀ altında bile vardır. \varepsilon^2 payda bu kısmı \mathrm{KO}_İ ile çıkarır; \omega^2 ayrıca paydada evren toplam varyansını \mathrm{KT}_T+\mathrm{KO}_İ ile kestirir. Küçük örneklemde \eta^2 ile fark büyüktür; burada N=140 olduğundan üç değer yakındır (Olejnik ve Algina 2003).
GA (merkezî olmayan F). eta_family_ci (effect_size.py:489–513):
- F_{F'}: merkezî olmayan F dağılımının birikimli fonksiyonu (
scipy.stats.ncf.cdf). - Merkezî F'nin birikimli değeri hedefin altındaysa sınır 0'dır (
_ncp_bound,effect_size.py:476–486); üst arama sınırı 10^7,xtol=1e-10. - \omega^2 ve \varepsilon^2 GA'sı için önce nokta kestirimin eşdeğer F'si F^{*}=\frac{\mathrm{ES}/(k-1)}{(1-\mathrm{ES})/(N-k)} bulunur, aynı \lambda\to\eta^2 dönüşümü uygulanır. Bu, R
effectsize::F_to_omega2/F_to_epsilon2tanımıdır. - Sınırlar [0{,}1]'de kesilir ve altı ondalığa yuvarlanır (
effect_size.py:504).
Tanım farkı
R effectsize'ın güncel sürümleri eta_squared() için varsayılan olarak tek yönlü GA verir (alternative = "greater", üst sınır 1). MerQur iki yönlü GA verir; R ile karşılaştırırken alternative = "two.sided" kullanılmalıdır. Çıktıdaki not satırı bunu söyler.
40.5.3 Cramér V, φ ve yanlılık düzeltmeli V
Çapraz tablo kurulur; satır ve sütunlar MerQur düzey sırasındadır (kullanıcının tanımladığı sıra, yoksa sayısal/doğal sıra, o da yoksa verideki ilk görülme sırası). Sıra \chi^2'yi ve V'yi değiştirmez. \chi^2 süreklilik düzeltmesiz Pearson istatistiğidir (chi2_contingency(..., correction=False), effect_size.py:556):
- r, c: tablonun satır ve sütun sayısı; n: toplam frekans.
- \tilde V: Bergsma (2013) yanlılık düzeltmeli V;
DescTools::CramerV(correct = TRUE)veeffectsize::cramers_v(adjust = TRUE)ile aynı. - GA: \chi^2'nin merkezî olmama parametresi için F_{\chi'^2}(\chi^2_{\text{göz}};\ \sd,\ \lambda) denklemi ters çevrilir; V=\sqrt{\lambda/(n\min(r-1,c-1))}, \varphi=\sqrt{\lambda/n} (
cramer_ci,effect_size.py:516–526). φ'nin GA'sı yalnız \min(r-1,c-1)=1 ise yazılır.
Neden düzeltmesiz \chi^2?
scipy'nin varsayılanı 2×2 tabloda Yates düzeltmesi uygular; düzeltilmiş \chi^2 ile hesaplanan φ ve V sistematik olarak küçük çıkar. R DescTools::Phi/CramerV düzeltmesiz \chi^2 kullanır; MerQur da bu tanımı kullanır (effect_size.py:554–556).
Yorum eşikleri (_interpret_v, effect_size.py:183–194): k=\min(r-1,c-1) olmak üzere Cohen'in w eşikleri \sqrt k'ya bölünür: k=1'de 0,1/0,3/0,5, k=2'de 0,07/0,21/0,35, k\ge3'te (0{,}1;\ 0{,}3;\ 0{,}5)/\sqrt k.
40.5.4 2×2 risk ölçüleri
Satır = maruziyet, sütun = sonuç; ilk satır "maruz", ilk sütun "olay" sayılır (risk_2x2, effect_size.py:943–983). Hücreler a (maruz, olay), b (maruz, olay yok), c (maruz değil, olay), d (maruz değil, olay yok):
- OR ve RR'nin GA'ları log ölçeğinde \pm z_{1-\alpha/2}\SH ile kurulup geri dönüştürülür; RD'ninki Wald aralığıdır.
- Herhangi bir hücre 0 ise OR için tüm hücrelere 0,5 eklenir (Haldane 1956) ve OR'nin yanına "†" konur; RR yalnız a>0 ve c>0 iken hesaplanır.
- 1/|\mathrm{RD}|'nin GA'sı, RD GA'sının uçlarının tersidir; RD GA'sı 0'ı içeriyorsa tanımsızdır (Altman 1998). Olayın yararlı ya da zararlı olduğu bilinmediğinden etiket nötrdür (NNT ya da NNH olarak kullanıcı yorumlar).
Koddaki tercih
RR'nin GA'sında süreklilik düzeltmesi yoktur. R DescTools::RelRisk(method = "wald") varsayılan olarak olay sayılarına 0,5 ekler (delta = 0.5) ve bu veride alt sınırı 0,9065 yerine 0,9085 verir; delta = 0 ile MerQur'la aynıdır.
40.5.5 Eşleştirilmiş d (d_z, g_z, d_{av}, d_{rm})
D_i=x_{1i}-x_{2i} (Sütun 1 − Sütun 2) olsun (paired_d, effect_size.py:774–815; Lakens 2013):
- \bar D, s_D: farkların ortalaması ve SS'si; s_1, s_2: iki ölçümün SS'leri; r_{12}: iki ölçüm arasındaki Pearson korelasyonu.
- d_z'nin GA'sı, t=d_z\sqrt n ve \sd=n-1 ile merkezî olmayan t'den bulunur; sınırlar \lambda/\sqrt n'dir.
- d_{av}'nin paydası iki varyansın ortalamasının kareköküdür (karesel ortalama; Cumming 2012). Bu tanım MerQur'un bütün modüllerinde aynıdır ve payda formülü çıktıda yazılır (
effect_size.py:835).
Neden üç farklı eşli d?
d_z farkların değişkenliğine göre ölçekler ve korelasyon yüksekse büyür; eşli t testinin gücüyle doğrudan ilişkilidir. d_{av} ve d_{rm} bağımsız gruplardaki d ile karşılaştırılabilir olmak için ham ölçümlerin değişkenliğine göre ölçekler; meta-analizde bağımsız ve eşli desenleri birleştirmek için tercih edilir. d_{rm}, s_D=\sqrt{s_1^2+s_2^2-2r s_1s_2} ilişkisinden eşit varyans altında d_{av}'ye yaklaşır.
R effectsize ile tanım farkı
effectsize::repeated_measures_d(method = "av") paydada MerQur gibi \sqrt{(s_1^2+s_2^2)/2} kullanır; bu veride ikisi de 1,5998 verir. Lakens'in (2013) aritmetik ortalama paydası ((s_1+s_2)/2) biraz büyük değer verir (1,6051). Ayrıca aynı işlevin d_z GA'sı nct'ye dayanmaz ([2,0254; 3,1878]); MerQur'un nct aralığı MBESS::ci.sm ile birebir aynıdır ([2,0188; 3,1876]).
40.5.6 Pearson r ve Fisher z GA
- r ve p
scipy.stats.pearsonrile; GA Fisher (1915) dönüşümüyle (effect_size.py:632–646). Rcor.test()ile aynıdır. - r^2 açıklanan varyans oranıdır.
40.5.7 Sıra tabanlı etki büyüklükleri
İki grupta Cliff (1993) δ ile rank-biserial r (Kerby 2014) aynı sayıdır (rank_effects, effect_size.py:818–851):
- U_1: 1. grubun Mann–Whitney U'su (bağlar yarım sayılır); \delta'da bağlar 0 katkı verir.
- \SH_z: rank-biserial r'nin Fisher z ölçeğindeki SH'si; R
effectsize::rank_biserialtanımı. \delta, \pm0{,}999999'da kırpılır. - H: bağ düzeltmeli Kruskal–Wallis istatistiği (
scipy.stats.kruskal); \varepsilon^2_R Tomczak ve Tomczak (2014) tanımı,effectsize::rank_epsilon_squaredile aynı.
40.5.8 Özet ve test istatistiklerinden
from_summary (effect_size.py:867–940) metni virgül ve noktalı virgülle böler, anahtar=değer çiftlerini okur (anahtarlar küçük harfe çevrilir, "χ" ve "²" tanınır). Tanınan girdiler ve formüller:
| Girdi | Hesap |
|---|---|
m1, sd1, n1, m2, sd2, n2 |
d=(m_1-m_2)/s_p, nct GA; g=J\,d |
t, n1, n2 |
d=t\sqrt{1/n_1+1/n_2}, nct GA |
t, df |
d=2t/\sqrt{\sd} (GA yok) |
t, n |
d_z=t/\sqrt n (GA yok) |
F, df1, df2 |
\eta^2_p=\frac{F\,\sd_1}{F\,\sd_1+\sd_2}, \omega^2_p=\max\!\left(0,\frac{(F-1)\sd_1}{F\,\sd_1+\sd_2+1}\right), \varepsilon^2_p=\max\!\left(0,\frac{(F-1)\sd_1}{F\,\sd_1+\sd_2}\right), GA'larıyla; \sd_1=1 ise d=2\sqrt{F/\sd_2} |
chi2, n, rows, cols (ya da k, df) |
φ, V ve GA; boyut ya da df yoksa GA hesaplanmaz ve uyarı yazılır |
d, r, or |
dönüşüm: r\to d=2r/\sqrt{1-r^2}, \mathrm{OR}\to d=\ln(\mathrm{OR})\sqrt3/\pi |
Bir d elde edilince dönüşümler eklenir (Hasselblad ve Hedges 1995; eşit n varsayımı):
- r dönüşümündeki 4 sabiti, n_1=n_2 varsayımından gelir; genelde a=(n_1+n_2)^2/(n_1n_2)'dir.
- OR dönüşümü, lojistik dağılımın SS'sinin \pi/\sqrt3 olmasına dayanır.
Özet tipinde \omega^2_p ve \varepsilon^2_p sıfırda kesilir
Ham veriden "eta" tipi negatif \omega^2'yi olduğu gibi yazar ve uyarır; özet tipi ise max(…, 0) ile 0'da keser (effect_size.py:898–899). Aynı F için iki tip F<1 olduğunda farklı sayı verir.
40.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Aşağıdaki değerler dogrulama/effect_size/elle_hesap.py ile, MerQur kodu çağrılmadan numpy ile hesaplanmıştır; scipy yalnız dağılım fonksiyonları ve kök bulma için kullanılmıştır.
Adım 1 — Grup sırası ve havuzlanmış SS (Tıp #35). Düzey sırası boş bırakıldığında MerQur verideki ilk görülme sırasını kullanır. Veride ilk satırlar SSRI olduğu için 1. grup SSRI, 2. grup SNRI'dir; Glass Δ'nın paydası SNRI'nin SS'sidir. El hesabı bu sırayla yürür. Kareler toplamları 2089{,}800460 (SSRI) ve 3399{,}515965 (SNRI):
Adım 2 — d, g, Glass Δ.
Adım 3 — nct GA. t_{\text{göz}}=0{,}672748\sqrt{60\cdot60/120}=0{,}672748\times5{,}477226=3{,}684794, \nu=118. Kökler \lambda_{\text{alt}}=1{,}661959, \lambda_{\text{üst}}=5{,}692839:
g GA'sı: [0{,}303431;\ 1{,}039365]\times0{,}993628=[0{,}301497;\ 1{,}032743]. %90 düzeyinde d GA'sı [0{,}362561;\ 0{,}980177]'dir. Normal yaklaşım: \SH_d=0{,}187668, [0{,}304927;\ 1{,}040570]; nct ile dördüncü ondalıkta ayrılır.
Sütun 2 düzey sırası SNRI girildiğinde d, g ve GA'ların işareti değişir (d=-0{,}672748); Glass Δ ise yalnız işaret değiştirmez, paydası SSRI SS'sine geçtiği için büyüklüğü de değişir (-0{,}770982).
Adım 4 — Sıra tabanlı (Tıp #35). 3600 çiftten SSRI'nin büyük olduğu 2477, küçük olduğu 1119, eşit olduğu 4 çift vardır:
Bağ düzeltmeli H=12{,}701030, \varepsilon^2_R=12{,}701030/119=0{,}106731.
Adım 5 — η², ω², ε² (Tıp #06). \mathrm{KT}_A=28129{,}320214, \mathrm{KT}_İ=22111{,}909143, \mathrm{KT}_T=50241{,}229357, \mathrm{KO}_İ=22111{,}909143/136=162{,}587567, F=57{,}670093:
GA: \lambda_{\text{alt}}=111{,}169816, \lambda_{\text{üst}}=242{,}631886; \eta^2 için [111{,}169816/247{,}169816;\ 242{,}631886/378{,}631886]=[0{,}449771;\ 0{,}640812]. \omega^2'nin eşdeğer F^{*}'ı 55,050947, \varepsilon^2'ninki 55,446997'dir; GA'lar [0{,}436389;\ 0{,}631025] ve [0{,}438452;\ 0{,}632540].
Adım 6 — Cramér V (Tıp #21). Tablo, düzeyler verideki ilk görülme sırasıyla (satırlar active smoking, old smoking, none non_drinker; sütunlar present, absent): \begin{pmatrix}150&100\\80&120\\20&200\end{pmatrix}, \chi^2=130{,}542684, \sd=2, n=670, \min(r-1,c-1)=1:
GA: \lambda sınırları 88,686734 ve 178,088888; V için [\sqrt{88{,}686734/670};\ \sqrt{178{,}088888/670}]=[0{,}363824;\ 0{,}515562].
Adım 7 — 2×2 risk (Tıp #40). Ham tablo (satır smoking 0/1, sütun heart_attack 0/1): \begin{pmatrix}111&93\\45&51\end{pmatrix}. Düzey sırası 1 / 1 ile a=51, b=45, c=93, d=111:
1/|\mathrm{RD}|=13{,}27; RD GA'sı 0'ı içerdiği için GA'sı tanımsızdır. Düzey sırası boş bırakıldığında da "1" maruz ve "1" olaydır; sonuç yukarıdakiyle aynıdır. Sıra elle "0" önce yazılırsa p_1=111/204=0{,}544118 (sigara içmeyenlerde kalp krizi geçirmeme riski) ve RR =1{,}160784 olur; OR ve RD aynı kalır, RR değişir. φ =0{,}070371, GA [0;\ 0{,}183524], \tilde V=0{,}040162.
Adım 8 — Korelasyon (Tıp #33) ve eşli d (Tıp #05). r=0{,}529199, n=180; z=0{,}589033, \SH_z=1/\sqrt{177}=0{,}075165; GA =[0{,}415063;\ 0{,}626936]. Eşli desende \bar D=19{,}98, s_D=7{,}665161, s_1=11{,}433017, s_2=13{,}461904, r_{12}=0{,}822499:
d_z'nin nct GA'sı [2{,}018806;\ 3{,}187631].
Adım 9 — Özet metni. İki ondalıklı betimsellerle d=-0{,}673072 (ham veride -0{,}672748), GA [-1{,}039698;\ -0{,}303744]; F=57{,}67'den \eta^2_p=0{,}559885; \chi^2=130{,}54'ten V=0{,}441402. Dönüşümler: r=-0{,}673072/\sqrt{0{,}453026+4}=-0{,}318958, \mathrm{OR}=\exp(-0{,}673072\times\pi/\sqrt3)=0{,}294989.
40.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonuç nesnesinden, panel modülünde round() ve p_yuvarla adları yalnız bellekte etkisizleştirilerek alınmıştır (dogrulama/effect_size/merqur_calistir.py). R 4.5.3: effectsize (cohens_d, hedges_g, glass_delta(adjust = FALSE), eta_squared/omega_squared/epsilon_squared(alternative = "two.sided"), cramers_v, rank_biserial, rank_epsilon_squared, F_to_*, chisq_to_cramers_v, d_to_r, d_to_oddsratio), MBESS::ci.smd/ci.sm, DescTools::OddsRatio/RelRisk(delta = 0)/BinomDiffCI, cor.test, kruskal.test. Ölçüt: en büyük fark \le 10^{-6} (değer 1'den büyükse göreli).
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Havuzlanmış SS s_p | 6,820530 | 6,820530 | 6,820530 | 8,9e−16 | ✓ |
| Cohen d (SSRI − SNRI) | 0,672748 | 0,672748 | 0,672748 | 2,2e−16 | ✓ |
| d %95 GA alt (nct) | 0,303431 | 0,303431 | 0,303431 | 2,0e−08 | ✓ |
| d %95 GA üst (nct) | 1,039365 | 1,039365 | 1,039365 | 1,1e−09 | ✓ |
d %95 GA alt, MBESS::ci.smd |
0,303431 | 0,303431 | 0,303431 | 2,2e−10 | ✓ |
| d %90 GA alt (nct) | 0,362561 | 0,362561 | 0,362561 | 6,0e−09 | ✓ |
| d %90 GA üst (nct) | 0,980177 | 0,980177 | 0,980177 | 4,7e−09 | ✓ |
| SH(d), normal yaklaşım | 0,187668 | 0,187668 | 0,187668 | 4,2e−16 | ✓ |
| Hedges g | 0,668462 | 0,668462 | 0,668462 | 4,4e−16 | ✓ |
| g %95 GA alt | 0,301497 | 0,301497 | 0,301497 | 2,0e−08 | ✓ |
| g %95 GA üst | 1,032743 | 1,032743 | 1,032743 | 1,0e−09 | ✓ |
| Glass Δ (payda SNRI SS'si) | 0,604489 | 0,604489 | 0,604489 | 0,0e+00 | ✓ |
| Glass Δ (payda SSRI SS'si) | 0,770982 | 0,770982 | 0,770982 | 4,4e−16 | ✓ |
| d_{av} (ek standartlaştırıcı) | 0,672748 | 0,672748 | 0,672748 | 2,2e−16 | ✓ |
| Rank-biserial r = Cliff δ | 0,377222 | 0,377222 | 0,377222 | 2,2e−16 | ✓ |
| Rank-biserial %95 GA alt | 0,187128 | 0,187128 | 0,187128 | 4,2e−16 | ✓ |
| Rank-biserial %95 GA üst | 0,540084 | 0,540084 | 0,540084 | 3,3e−16 | ✓ |
| Mann–Whitney U | 2479 | 2479 | 2479 | 0,0e+00 | ✓ |
| Kruskal–Wallis H | 12,701030 | 12,701030 | 12,701030 | 5,9e−14 | ✓ |
| \varepsilon^2_R | 0,106731 | 0,106731 | 0,106731 | 9,7e−16 | ✓ |
| ANOVA F (#06) | 57,670093 | 57,670093 | 57,670093 | 7,8e−14 | ✓ |
| ANOVA p | 4,0746·10−24 | 4,0746·10−24 | 4,0746·10−24 | 1,4e−37 | ✓ |
| η² | 0,559885 | 0,559885 | 0,559885 | 6,7e−16 | ✓ |
| η² %95 GA alt | 0,449771 | 0,449771 | 0,449771 | 1,3e−09 | ✓ |
| η² %95 GA üst | 0,640812 | 0,640812 | 0,640812 | 8,9e−10 | ✓ |
| ω² | 0,548402 | 0,548402 | 0,548402 | 4,4e−16 | ✓ |
| ω² %95 GA alt | 0,436389 | 0,436389 | 0,436389 | 2,5e−08 | ✓ |
| ω² %95 GA üst | 0,631025 | 0,631025 | 0,631025 | 1,1e−09 | ✓ |
| ε² | 0,550177 | 0,550177 | 0,550177 | 4,4e−16 | ✓ |
| ε² %95 GA alt | 0,438452 | 0,438452 | 0,438452 | 1,2e−08 | ✓ |
| ε² %95 GA üst | 0,632540 | 0,632540 | 0,632540 | 1,4e−09 | ✓ |
| Pearson χ² (#21, 3 × 2) | 130,542684 | 130,542684 | 130,542684 | 2,8e−14 | ✓ |
| Cramér V (= φ) | 0,441407 | 0,441407 | 0,441407 | 5,6e−17 | ✓ |
| V %95 GA alt | 0,363824 | 0,363824 | 0,363824 | 2,7e−09 | ✓ |
| V %95 GA üst | 0,515562 | 0,515562 | 0,515562 | 1,5e−09 | ✓ |
| Yanlılık düzeltmeli \tilde V (Bergsma) | 0,438335 | 0,438335 | 0,438335 | 2,2e−16 | ✓ |
| 2 × 2 (#40): φ | 0,070371 | 0,070371 | 0,070371 | 4,2e−17 | ✓ |
| 2 × 2: φ %95 GA üst | 0,183524 | 0,183524 | 0,183524 | 1,4e−09 | ✓ |
| 2 × 2: \tilde V | 0,040162 | 0,040162 | 0,040162 | 6,9e−18 | ✓ |
Sıra SNRI önce: Cohen d |
−0,672748 | −0,672748 | −0,672748 | 2,2e−16 | ✓ |
Sıra SNRI önce: Glass Δ (payda SSRI SS'si) |
−0,770982 | −0,770982 | −0,770982 | 4,4e−16 | ✓ |
| OR (varsayılan sıra: 1 maruz, 1 olay) | 1,352688 | 1,352688 | 1,352688 | 8,9e−16 | ✓ |
| OR %95 GA alt (varsayılan sıra: 1 maruz, 1 olay) | 0,831666 | 0,831666 | 0,831666 | 1,2e−15 | ✓ |
| RR (varsayılan sıra: 1 maruz, 1 olay) | 1,165323 | 1,165323 | 1,165323 | 1,3e−15 | ✓ |
| RR %95 GA alt (varsayılan sıra: 1 maruz, 1 olay) | 0,916326 | 0,916326 | 0,916326 | 2,2e−16 | ✓ |
| RR %95 GA üst (varsayılan sıra: 1 maruz, 1 olay) | 1,481979 | 1,481979 | 1,481979 | 2,7e−15 | ✓ |
| RD (varsayılan sıra: 1 maruz, 1 olay) | 0,075368 | 0,075368 | 0,075368 | 4,2e−17 | ✓ |
| RD %95 GA alt (varsayılan sıra: 1 maruz, 1 olay) | −0,045611 | −0,045611 | −0,045611 | 2,1e−17 | ✓ |
| 1/ | RD | (varsayılan sıra: 1 maruz, 1 olay) | 13,268293 | 13,268293 | 13,268293 |
| OR (sıra 0 önce) | 1,352688 | 1,352688 | 1,352688 | 8,9e−16 | ✓ |
| OR %95 GA alt (sıra 0 önce) | 0,831666 | 0,831666 | 0,831666 | 1,2e−15 | ✓ |
| RR (sıra 0 önce) | 1,160784 | 1,160784 | 1,160784 | 0,0e+00 | ✓ |
| RR %95 GA alt (sıra 0 önce) | 0,906518 | 0,906518 | 0,906518 | 5,6e−16 | ✓ |
| RR %95 GA üst (sıra 0 önce) | 1,486369 | 1,486369 | 1,486369 | 4,2e−15 | ✓ |
| RD (sıra 0 önce) | 0,075368 | 0,075368 | 0,075368 | 1,4e−17 | ✓ |
| RD %95 GA alt (sıra 0 önce) | −0,045611 | −0,045611 | −0,045611 | 2,1e−17 | ✓ |
| 1/ | RD | (sıra 0 önce) | 13,268293 | 13,268293 | 13,268293 |
| Pearson r (#33 BMI × SKB) | 0,529199 | 0,529199 | 0,529199 | 4,4e−16 | ✓ |
| r %95 GA alt (Fisher z) | 0,415063 | 0,415063 | 0,415063 | 3,3e−16 | ✓ |
| r %95 GA üst (Fisher z) | 0,626936 | 0,626936 | 0,626936 | 2,2e−16 | ✓ |
| r için p | 2,2197·10−14 | 2,2197·10−14 | 2,2197·10−14 | 6,2e−28 | ✓ |
| d_z (#05) | 2,606599 | 2,606599 | 2,606599 | 3,6e−15 | ✓ |
d_z %95 GA alt (nct, MBESS::ci.sm) |
2,018806 | 2,018806 | 2,018806 | 4,5e−10 | ✓ |
| d_z %95 GA üst | 3,187631 | 3,187631 | 3,187631 | 1,1e−09 | ✓ |
| g_z | 2,566463 | 2,566463 | 2,566463 | 2,0e−14 | ✓ |
| d_{av} (payda \sqrt{(s_1^2+s_2^2)/2}) | 1,599842 | 1,599842 | 1,599842 | 1,6e−15 | ✓ |
| d_{rm} | 1,553063 | 1,553063 | 1,553063 | 4,4e−16 | ✓ |
| Özet: d (m, sd, n) | −0,673072 | −0,673072 | −0,673072 | 3,3e−16 | ✓ |
| Özet: d GA alt | −1,039698 | −1,039698 | −1,039698 | 1,1e−10 | ✓ |
| Özet: η²ₚ (F = 57,67) | 0,559885 | 0,559885 | 0,559885 | 2,2e−16 | ✓ |
| Özet: η²ₚ GA alt | 0,449771 | 0,449771 | 0,449771 | 2,6e−09 | ✓ |
| Özet: ω²ₚ | 0,548402 | 0,548402 | 0,548402 | 3,3e−16 | ✓ |
| Özet: V (χ² = 130,54) | 0,441402 | 0,441402 | 0,441402 | 4,4e−16 | ✓ |
| Özet: V GA alt | 0,363820 | 0,363820 | 0,363820 | 1,6e−09 | ✓ |
| Dönüşüm d\to r | −0,318958 | −0,318958 | −0,318958 | 3,3e−16 | ✓ |
| Dönüşüm d\to OR | 0,294989 | 0,294989 | 0,294989 | 1,7e−16 | ✓ |
Sonuç: 76 büyüklüğün tamamı ölçütü karşılar. En büyük farklar nct ve merkezî olmayan F kök bulmalarındadır (\approx10^{-8}; R tarafının toleransı daha gevşektir). R paketlerinin varsayılan tanımları MerQur'dan farklı olan üç durum ayrıca gösterilmiştir:
| Büyüklük | MerQur | R işlevi ve varsayılanı | R değeri |
|---|---|---|---|
| d_{av} (eşli) | 1,5998 | effectsize::repeated_measures_d(method = "av"): payda \sqrt{(s_1^2+s_2^2)/2} |
1,5998 |
| d_z %95 GA alt | 2,0188 | effectsize::repeated_measures_d(method = "z") GA'sı |
2,0254 |
| RR %95 GA alt (sıra 0 önce) | 0,9065 | DescTools::RelRisk(method = "wald"), delta = 0,5 |
0,9085 |
40.7 Çıktıyı okuma
Cohen d tipinde varsayılan çıktı:
══ ETKİ BÜYÜKLÜĞÜ HESAPLAMA ══
Tip                 : Cohen's d (iki grup ortalama)
Kullanılan düzey sırası (drug): SSRI, SNRI
Grup 1 (SSRI): n=60, M=-8.6230, SD=5.9515
Grup 2 (SNRI): n=60, M=-13.2115, SD=7.5907
Birleştirilmiş SD   : 6.8205
── ETKİ BÜYÜKLÜĞÜ ──
Cohen's d           : 0.6727
Hedges' g (J düzelt.): 0.6685
Glass's Δ           : 0.6045
d %95 GA            : (0.3034, 1.0394)  [nct]
g %95 GA            : (0.3015, 1.0327)
Yorum: Orta
(Cohen 1988: 0.2 = küçük, 0.5 = orta, 0.8 = büyük)
── APA 7 ÖZET ──
d = 0.67, %95 GA [0.30, 1.04]
| Satır | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Grup 1/2 | Kullanılan düzey sırasıyla düzeyler (satırda yazılır) | d = Grup 1 − Grup 2; işaret yalnız yönü gösterir. |
| Glass's Δ | Payda Grup 2'nin SS'si | Grup 2 gerçekten denetim grubu değilse Glass Δ yorumlanmamalı ya da düzey sırası düzeltilmelidir. |
| d GA [nct] | Kesin GA | Normal yaklaşım yalnız kök bulma başarısız olursa kullanılır. |
| Yorum | |d| için 0,2/0,5/0,8 eşikleri | Eşikler kaba kılavuzdur; alan bilgisi önceliklidir. |
| APA 7 ÖZET | d ve GA | GA etiketi seçilen güven düzeyini yazar (ör. "%90 GA"). |
Diğer tiplerin çıktılarında da aynı düzen vardır. η² tipinde üç kestirici ve GA'ları, Cramér V tipinde φ, ham ve düzeltilmiş V, 2×2 risk bölümünde başlıkta "(maruz ↔ maruz değil; olay = …)" satırı yer alır; bu başlık satırı düzey sırasının doğru kurulup kurulmadığını denetlemenin en kolay yoludur. Ek bölümlerde de GA etiketi "%95 GA" biçimindedir.
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
SSRI grubunda HAMD puanındaki düşüş (O = −8,62; SS = 5,95; n = 60), SNRI grubundakinden (O = −13,21; SS = 7,59; n = 60) daha küçüktü; standartlaştırılmış fark (SSRI − SNRI) orta büyüklükteydi, Hedges g = 0,67, %95 GA [0,30; 1,03]. Sıra tabanlı ölçü aynı yönde bir etki gösterdi (Cliff δ = 0,38, %95 GA [0,19; 0,54]).
40.8 Uzman soruları
S1. Cohen d'de grup sırası nasıl belirleniyor; neden alfabetik değil?
Alfabetik sıra etiketin dilinden gelir: aynı veride "Hasta/Sağlıklı" ile "Patient/Healthy" ters sıralanır ve d'nin işareti dile göre değişir. Bu yüzden MerQur bütün analizlerde tek kural kullanır: kullanıcının tanımladığı sıra, sayısal ya da doğal sıra, son olarak verideki ilk görülme sırası. Bağımsız t testi, permütasyon testi ve bu modül aynı kuralla aynı işareti verir; Tıp #35'te SSRI − SNRI (d=+0{,}6727). Denetim grubu ikinci olacak biçimde "Sütun 2 düzey sırası" kutusu doldurulabilir; Glass Δ'da sıra yalnız işareti değil değeri de değiştirir.
S2. Hedges g'nin GA'sı neden d'nin GA'sı çarpı J?
J sabit bir çarpandır; g=Jd dönüşümü monoton olduğundan d'nin (1-\alpha) GA'sı J ile çarpılınca Jd'nin GA'sı olur. R effectsize::hedges_g aynı yolu izler. Bu aralık "yansız \delta kestirimi" için değil, J\delta için kurulmuş bir aralıktır; uygulamada fark J\approx0{,}99 olduğundan önemsizdir.
S3. η² için R'de farklı GA alıyorum.
effectsize'ın güncel sürümlerinde eta_squared() varsayılanı tek yönlü aralıktır (üst sınır 1). MerQur iki yönlü aralık verir; R'de alternative = "two.sided" yazılınca değerler 10^{-9} düzeyinde eşleşir. MerQur ayrıca \omega^2 ve \varepsilon^2 GA'sını eşdeğer F yoluyla hesaplar; bu, effectsize::F_to_omega2 tanımıdır, \omega^2'nin kendi örnekleme dağılımından kurulmuş bir aralık değildir.
S4. ω² negatif çıktı. Ne yazmalıyım?
F<1 olduğunda \omega^2 ve \varepsilon^2 negatif çıkar; bu, evren etkisinin sıfıra yakın olduğunu gösterir. MerQur değeri olduğu gibi yazar ve "0 olarak yorumlanır" uyarısını verir (effect_size.py:687–689). Raporda "\omega^2=0 (negatif kestirim)" yazılabilir. Özet tipi aynı durumda değeri 0'da keser; iki tip bu noktada farklı davranır.
S5. 3 × 2 tabloda yorum satırı neden 0,1/0,3/0,5 eşiklerini kullanıyor? \chi^2'nin sd'si 2.
Eşikler \chi^2'nin serbestlik derecesine değil, \min(r-1,c-1)'e göre seçilir (Cohen'in w ile V arasındaki V=w/\sqrt{\min(r-1,c-1)} ilişkisi). 3 × 2 tabloda \min(r-1,c-1)=1 olduğundan V=\varphi=w ve 0,1/0,3/0,5 eşikleri doğrudur. \min(r-1,c-1)=k\ge2 olan tablolarda eşikler (0{,}1;\ 0{,}3;\ 0{,}5)/\sqrt k'dır (k=2'de 0,07/0,21/0,35).
S6. Bergsma düzeltmeli V ne zaman tercih edilmeli?
Ham V, n küçük ve tablo büyükken yukarı yanlıdır; bağımsızlık altında bile E(\varphi^2)\approx(r-1)(c-1)/(n-1)'dir. \tilde V bu beklenen değeri çıkarır ve tablo boyutunu da düzeltir. n=670'te fark küçüktür (0,4414 ve 0,4383); n=300'lük 2×2 tabloda ham V=0{,}070, düzeltilmiş \tilde V=0{,}040'tır ve küçük etkilerde fark oransal olarak büyüktür.
S7. Eşli d_{av}'nin paydası neden karesel ortalama?
d_{av}'nin amacı, eşli desendeki etkiyi bağımsız gruplardaki d ile karşılaştırılabilir kılmaktır. Varyansların ortalamasının karekökü, eşit n'de bağımsız grupların havuzlanmış SS'siyle aynıdır (Cumming 2012); bu yüzden MerQur bütün modüllerde d_{av}=\bar D/\sqrt{(s_1^2+s_2^2)/2} tanımını kullanır (1,5998) ve paydayı çıktıda yazar. R effectsize::repeated_measures_d(method = "av") aynı tanımı verir. Lakens'in (2013) aritmetik ortalama paydası (s_1+s_2)/2 biraz küçük payda, dolayısıyla biraz büyük değer verir (1,6051); SS'ler eşitse iki tanım aynıdır. Raporda tanım yazılmalıdır.
S8. 2×2 riskte 0/1 kodlu değişkende hangi düzey maruz ve olay sayılır?
0/1 kodlamada "1" maruz grup ve olay sayılır; çıktı başlığı "(1 ↔ 0; olay = 1)" yazar ve kullanılan sıra ayrıca bir satırda verilir. "0" maruz ya da olay sayılsaydı RR "olay olmama" riskinin oranı olurdu; başka bir tanım isteniyorsa "Sütun 1 düzey sırası" ve "Sütun 2 düzey sırası" kutuları doldurulur. OR bu değişimden etkilenmez (her iki eksen birlikte çevrildiğinde ad/bc aynı kalır), RD yalnız işaret değiştirebilir, RR ise başka bir sayı olur.
S9. Özet istatistikten hesaplanan d, ham veriden hesaplanandan neden farklı?
Girdiler iki ondalığa yuvarlanmıştır (-13{,}21, 7{,}59, …). Bu veride fark 3\times10^{-4}'tür (-0{,}673072 ve -0{,}672748). Meta-analizde makalelerden alınan değerler zaten yuvarlanmıştır; mümkünse t ya da F istatistiğinden hesaplamak daha az yuvarlama hatası taşır.
S10. d\to r ve d\to\mathrm{OR} dönüşümleri ne kadar güvenilir?
r=d/\sqrt{d^2+4}, eşit grup büyüklüğü varsayar; dengesiz gruplarda 4 yerine (n_1+n_2)^2/(n_1n_2) gerekir. \mathrm{OR}=\exp(\pi d/\sqrt3), sürekli gizil değişkenin lojistik dağıldığı varsayımına dayanır (Hasselblad ve Hedges 1995). Her iki dönüşüm de yaklaşık ve modele bağlıdır; meta-analizde farklı ölçüleri birleştirmek için kullanılır, birincil sonuç olarak raporlanmaz.
40.9 Sık hatalar ve tuzaklar
- Grup sırasını varsaymak. Cohen d, Glass Δ ve sıra tabanlı ölçülerde 1. grup kullanılan düzey sırasındaki ilk düzeydir; sıra satırı okunmalıdır.
- Glass Δ'yı yanlış denetim grubuyla raporlamak. Payda 2. grubun SS'sidir; denetim grubu ikinci değilse "Sütun 2 düzey sırası" ile düzeltilmelidir.
- R
eta_squaredvarsayılanıyla karşılaştırmak. R tek yönlü aralık verir;alternative = "two.sided"kullanılmalıdır. - Negatif ω²'yi gizlemek. Değer olduğu gibi raporlanmalı ya da "0 (negatif kestirim)" yazılmalıdır; özet tipinin 0'da kestiği unutulmamalıdır.
- Eşli desende d_z'yi bağımsız grup d'siyle karşılaştırmak. d_z korelasyona bağlıdır; meta-analizde d_{av} ya da d_{rm} kullanılmalıdır.
- Yorum eşiklerini mutlak kural sanmak. Cohen'in eşikleri davranış bilimleri için önerilmiş kaba kılavuzlardır; klinik önem alan bilgisiyle değerlendirilir.
40.10 Kaynaklar
- Altman, D. G. (1998). Confidence intervals for the number needed to treat. BMJ, 317(7168), 1309–1312. https://doi.org/10.1136/bmj.317.7168.1309
- Ben-Shachar, M. S., Lüdecke, D., & Makowski, D. (2020). effectsize: Estimation of effect size indices and standardized parameters. Journal of Open Source Software, 5(56), 2815. https://doi.org/10.21105/joss.02815
- Bergsma, W. (2013). A bias-correction for Cramér's V and Tschuprow's T. Journal of the Korean Statistical Society, 42(3), 323–328. https://doi.org/10.1016/j.jkss.2012.10.002
- Cliff, N. (1993). Dominance statistics: Ordinal analyses to answer ordinal questions. Psychological Bulletin, 114(3), 494–509. https://doi.org/10.1037/0033-2909.114.3.494
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2. baskı). Lawrence Erlbaum. (Routledge yeniden basımı: https://doi.org/10.4324/9780203771587)
- Cumming, G., & Finch, S. (2001). A primer on the understanding, use, and calculation of confidence intervals that are based on central and noncentral distributions. Educational and Psychological Measurement, 61(4), 532–574. https://doi.org/10.1177/0013164401614002
- Fisher, R. A. (1915). Frequency distribution of the values of the correlation coefficient in samples from an indefinitely large population. Biometrika, 10(4), 507–521. https://doi.org/10.1093/biomet/10.4.507
- Glass, G. V. (1976). Primary, secondary, and meta-analysis of research. Educational Researcher, 5(10), 3–8. https://doi.org/10.3102/0013189X005010003
- Haldane, J. B. S. (1956). The estimation and significance of the logarithm of a ratio of frequencies. Annals of Human Genetics, 20(4), 309–311. https://doi.org/10.1111/j.1469-1809.1955.tb01285.x
- Hasselblad, V., & Hedges, L. V. (1995). Meta-analysis of screening and diagnostic tests. Psychological Bulletin, 117(1), 167–178. https://doi.org/10.1037/0033-2909.117.1.167
- Hedges, L. V. (1981). Distribution theory for Glass's estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107–128. https://doi.org/10.3102/10769986006002107
- Katz, D., Baptista, J., Azen, S. P., & Pike, M. C. (1978). Obtaining confidence intervals for the risk ratio in cohort studies. Biometrics, 34(3), 469–474. https://doi.org/10.2307/2530610
- Kelley, K. (2007). Confidence intervals for standardized effect sizes: Theory, application, and implementation. Journal of Statistical Software, 20(8), 1–24. https://doi.org/10.18637/jss.v020.i08
- Kelley, T. L. (1935). An unbiased correlation ratio measure. Proceedings of the National Academy of Sciences, 21(9), 554–559. https://doi.org/10.1073/pnas.21.9.554
- Kerby, D. S. (2014). The simple difference formula: An approach to teaching nonparametric correlation. Comprehensive Psychology, 3, 11.IT.3.1. https://doi.org/10.2466/11.IT.3.1
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, 863. https://doi.org/10.3389/fpsyg.2013.00863
- Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434
- Steiger, J. H. (2004). Beyond the F test: Effect size confidence intervals and tests of close fit in the analysis of variance and contrast analysis. Psychological Methods, 9(2), 164–182. https://doi.org/10.1037/1082-989X.9.2.164
- Tomczak, M., & Tomczak, E. (2014). The need to report effect size estimates revisited. An overview of some recommended measures of effect size. Trends in Sport Sciences, 21(1), 19–25.
- Woolf, B. (1955). On estimating the relation between blood group and disease. Annals of Human Genetics, 19(4), 251–253. https://doi.org/10.1111/j.1469-1809.1955.tb01348.x