68. Destek Vektör Makinesi (SVM)
Analiz kimliği: svm · Menü adı: Destek Vektör Makinesi (SVM) · Panel: gui/panels/analyses/svm_classification.py (form 33–78, read_options 81–93, execute 96–107) · Motor: ml/classification.py, Classification.svm (satır 497–554) ve ortak hat Classification._run_sklearn_model (1089–1687); çözücü scikit-learn SVC/SVR (gömülü libsvm) · Metin: _classification_format.py (format_classification_text, _format_q5)
68.1 Ne işe yarar
Destek vektör makinesi (SVM), iki sınıfı birbirinden en geniş boşlukla (marj) ayıran sınırı arar. Cevapladığı soru: "Özellikleri bilinen yeni bir hasta hangi sınıfa düşer?" Model, eğitim gözlemlerinin yalnız bir bölümüne (destek vektörleri) dayanan bir karar fonksiyonudur:
- \mathbf x: sınıflanacak gözlemin (eğitim kümesine göre z'lenmiş) özellik vektörü.
- SV: destek vektörlerinin, yani \alpha_i>0 olan eğitim gözlemlerinin kümesi.
- y_i\in\{-1,+1\}: eğitim gözleminin sınıfı; +1 sınıf listesindeki ikinci sınıftır (burada "1").
- \alpha_i: ikili (dual) sorunun çözümündeki ağırlık, 0\le\alpha_i\le C.
- K(\cdot,\cdot): çekirdek fonksiyonu (68.5.2).
- b: sabit terim; libsvm'deki -\rho.
Bu bir hipotez testi değildir; p değeri ya da katsayı GA'sı üretmez. Çıktı, ayrılmış test kümesindeki ve çapraz doğrulamadaki (CV) tahmin başarımıdır.
Ne zaman kullanılır?
- Sınıflar özellik uzayında (doğrusal ya da çekirdekle dönüştürülmüş biçimde) iyi ayrılıyorsa ve amaç tahminse.
- Gözlem sayısı küçük-orta (yüzlerden birkaç bine), özellik sayısı orta düzeydeyse.
- Özellikler sayısalsa ya da az düzeyli kategoriklerse.
Ne zaman kullanılmaz?
- Etkilerin yönü, büyüklüğü ve anlamlılığı (OR, GA, p) gerekiyorsa: İkili Lojistik Regresyon.
- Güvenilir olasılık (kalibrasyon) asıl çıktıysa: SVM olasılığı sonradan uydurulan bir sigmoidle elde edilir (68.5.6). İkili Lojistik Regresyon ya da Random Forest olasılıkları daha doğrudandır.
- Veri çok büyükse (on binlerce satır): eğitim süresi kabaca n^2–n^3 ile büyür. Gradient Boosting ya da Random Forest daha hızlıdır.
- Hangi değişkenin ne kadar önemli olduğu sorulacaksa: RBF çekirdekte katsayı yoktur. Random Forest ya da Karar Ağacı (CART) önem tabloları verir; SVM'de yalnız permütasyon önemi açılabilir.
Sık karıştırılan analizler. Doğrusal çekirdekli SVM ile lojistik regresyon ikisi de doğrusal bir sınır kurar; ama lojistik regresyon tüm gözlemlerin olabilirliğini en çoklar, SVM yalnız sınıra yakın gözlemlere (menteşe kaybı) bakar. k-En Yakın Komşu (KNN) de uzaklığa dayanır, ama model kurmaz; her tahminde eğitim kümesinin tamamına bakar (Bölüm 72). MerQur'un SVM menüsü "Görev: Regresyon" seçilince destek vektör regresyonu (SVR) çalıştırır; bu bölüm sınıflamayı anlatır, SVR farkları 68.5.8'dedir.
68.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Kategorik hedef | Y en az iki sınıflı. | Tek sınıfta hata (classification.py:1237–1238). |
| Sayısal özellikler | Uzaklık ve iç çarpım sayılarla hesaplanır. | Sayısal olmayan X, k-1 göstergeye çevrilir (encode_categoricals, 189–212). |
| Ortak ölçek | Çekirdek, ölçeği büyük değişkene baskın olur. | Otomatik z ölçekleme (1/n bölenli SS), yalnız eğitim kümesine uydurulur (classification.py:1278–1279). |
| Bağımsız gözlemler | Test ve CV başarımı, eğitimde görülmemiş birimler içindir. | Denetlenmez; tekrarlı ölçüm varsa "Kat (grup) sütunu" kullanılmalıdır. |
| Uygun C ve \gamma | Aşırı/az uyumu belirler. | Denetlenmez; isteğe bağlı ızgara araması (68.3). |
Eksik değer. Önce hedefi eksik satırlar atılır (classification.py:1204), sonra herhangi bir özelliği eksik satırlar liste bazında silinir (prepare_numeric_data, 1110–1114). Silme bölmeden önce yapılır; test ve eğitim kümeleri tam satırlardan oluşur.
Uç durumlar (koddan):
- Hedefte tek sınıf varsa durur: "en az 2 sınıf gerekir" (
classification.py:1237–1238). - Bir sınıfta 1 gözlem varsa tabakalı bölme yapılamaz ve durur (
1142–1149). - Test ya da eğitim kümesi sınıf sayısından küçük kalırsa durur (
1150–1155). - CV kat sayısı, eğitim kümesindeki en kalabalık sınıfın gözlem sayısını aşarsa durur (
1243–1245). - En az 10 tam satır gerekir (
min_rows,1113). - Sabit bir özellik hata vermez: StandardScaler sıfır SS'yi 1 kabul eder, sütun her yerde 0 olur ve çekirdeğe katkısı kalmaz.
68.3 Parametreler
Varsayılanlar svm_classification.py:33–93 ve _ml_options.py:179–271'den alınmıştır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Hedef sınıf (Y) | ilk kategorik sütun | Tahmin edilen sınıf. | Sınıflar MerQur düzey sırasıyla dizilir (Veri sekmesinde tanımlı sıra; yoksa sayısal ya da doğal sıra; o da yoksa verideki ilk görülme sırası); ikili sınıflamada "pozitif" sınıf ortak olay kuralıyla seçilir (0/1'de 1; tanınan olumlu etiket; aksi hâlde bu sıradaki ikinci) ve sınıf listesinin ikinci öğesi olur. |
| Çekirdek | rbf | rbf, linear, poly, sigmoid. | Karar sınırının biçimi (68.5.2). |
| Özellikler (X) | en az 1 | Açıklayıcılar. | Kategorikler k-1 göstergeye çevrilir. |
| Görev | Sınıflandırma | Sınıflandırma (SVC) ya da regresyon (SVR). | 68.5.8. |
| C (maliyet) | 1,0 (0,001–100000) | Marj ihlalinin cezası. | Büyük C: daha az eğitim hatası, daha karmaşık sınır. |
| gamma | scale = 1/(p\cdot\mathrm{Var}\,X) | rbf/poly/sigmoid ölçeği. | Büyük \gamma: daha yerel, kıvrımlı sınır. |
| Derece (poly) | 3 | Polinom derecesi. | Yalnız poly'de kullanılır. |
| coef0 | 0,0 | poly/sigmoid sabiti. | Yalnız poly ve sigmoid'de. |
| ε (epsilon) | 0,1 | SVR duyarsızlık bandı. | Sınıflamada kullanılmaz; 0,1'den farklıysa ayar kaydına "yalnız regresyon" notu düşer (classification.py:526–531). |
| Test oranı | 0,20 (0,10–0,50) | Tabakalı eğitim/test bölmesi. | Test başarımı bu kümede ölçülür. |
| CV kat sayısı (k) | 5 | Eğitim kümesinde tabakalı, karıştırmalı CV. | CV doğruluğu satırı. |
| CV tekrar sayısı | 1 | Tekrarlı tabakalı CV. | CV ortalamasının değişkenliği azalır. |
| Rastgele tohum | 42 | Bölme, CV katları ve Platt olasılığının iç CV'si. | Tohum değişince bölme ve olasılıklar değişir (68.6.1). |
| Hazır bölme sütunu / Ayrı test dosyası / Kat (grup) sütunu | yok | Rastgele bölme yerine verilen ayrım; grup dışarıda bırakma CV'si. | Tohum bölmeyi artık belirlemez. |
| Dengesiz sınıflar: dengeli ağırlık | kapalı | class_weight="balanced": C_j=C\,n/(K n_j). |
Azınlık sınıfında ihlal daha pahalıdır. |
| Hiperparametre ayarı (grid search + CV) | kapalı | C\in\{0{,}1;1;10;100\}, \gamma\in\{\text{scale};0{,}01;0{,}1;1\} (linear'da yalnız C) ızgarasında eğitim kümesi CV'si (classification.py:158–167, 1346–1369). |
Seçilen değerlerle yeniden uydurulur; test kümesi seçimde kullanılmaz. |
| Permütasyon önemi (test kümesi) | kapalı | Her özelliği 10 kez karıştırıp doğruluk düşüşü. | Ek tablo ve grafik. |
| Tahmin ve olasılıkları veri setine kaydet | kapalı | SVM_PRED, SVM_P_<sınıf> sütunları. |
Hedefi boş satırlar da tahmin edilir. |
| Olasılık eşiği (ikili) | Varsayılan (en olası sınıf) | Platt olasılığı ≥ eşik ise pozitif. | Varsayılan karar f(\mathbf x)>0'dır, eşik ise Platt olasılığına uygulanır (68.5.6). |
| Ek çıktılar | hepsi kapalı | Dengesiz veri metrikleri; PDP; karar fonksiyonu AUC. | Ek bölümler. |
| Grafik | Karışıklık matrisi | ROC, PDP + ICE, 3B karar yüzeyi seçilebilir. | Yalnız grafik. |
Neden γ'nın "scale" değeri 1/p'dir?
sklearn'ün tanımı \gamma=1/(p\cdot\mathrm{Var}\,X)'tir; \mathrm{Var}\,X, eğitim matrisinin bütün hücrelerinin varyansıdır. MerQur bu formülü z'lenmiş matrise uygular. Her sütunun ortalaması 0, 1/n bölenli varyansı 1 olduğundan bütün hücrelerin varyansı da 1'dir ve \gamma=1/p olur. Tıp örneğinde p=4, \gamma=0{,}25. R e1071'in varsayılanı da 1/p'dir; ama e1071 ölçeklemede n-1 bölenli SS kullanır (68.8, S5).
Koddaki tercih: tol = 10⁻⁶
libsvm'in durma toleransı sklearn ve e1071'de 10^{-3}'tür. MerQur bunu 10^{-6}'ya indirir (_SVM_TOL, classification.py:169–173). Gerekçe kodda yazılıdır: 10^{-3}'te iki program yaklaşık çözümün farklı noktalarında durur ve karar değerleri \sim7\cdot10^{-3} kadar ayrılır. Daha sıkı tolerans, eğitim süresini biraz uzatır ama sonucun programdan bağımsız olmasını sağlar. Çıktıdaki "tol = 1e-06" bu ayardır.
68.4 Tıp örneği
Dosya: english/datasets/Tip/64_svm_sepsis.xlsx (Türkçe kopya samples/Tum_Analiz_Tip/64_svm_sepsis.xlsx). Değişken seçimi VIDEO_SCRIPT_TR.txt #64'ten alınmıştır.
| Değişken | Rol | Tür | Özet (sepsis yok / var) |
|---|---|---|---|
| sepsis | Y | ikili (0/1) | 128 / 122 |
| CRP_mg_L | X | sürekli | ort. 5,35 / 79,13 mg/L |
| WBC_K_uL | X | sürekli | ort. 7,91 / 15,01 ×10³/µL |
| fever_C | X | sürekli | ort. 36,80 / 38,52 °C |
| lactate_mmol | X | sürekli | ort. 1,48 / 2,75 mmol/L |
n ve eksik değer: 250 hasta, eksik değer yok. Tabakalı bölmeyle 200 eğitim (102 sepsis yok, 98 sepsis) ve 50 test (26 / 24) gözlemi.
Klinik soru: Dört rutin bulgu (CRP, lökosit, ateş, laktat) sepsisi ayırt etmeye yeter mi?
Seçilen ayarlar: Arayüz varsayılanları (rbf, C=1, \gamma = scale, test oranı 0,20, 5 katlı CV, tohum 42). Doğrulamada ayrıca doğrusal çekirdek, derece 3 polinom ve C=10,\ \gamma=0{,}5 RBF çalıştırılmıştır.
Bu veri tam ayrılabilir
Sepsis grubunun CRP ortalaması (79 mg/L) yok grubununkinin (5 mg/L) on beş katıdır; dört değişkende de dağılımlar neredeyse örtüşmez. Bu nedenle bütün çekirdeklerde test ve CV doğruluğu 1,0000'dır. Başarım ölçüleri burada öğretici değildir; bölümün hesap yürüyüşü, karar fonksiyonunun ve destek vektörlerinin nasıl kurulduğuna odaklanır. Gerçek klinik verilerde sınıflar örtüşür ve C, \gamma seçimi sonucu belirgin biçimde değiştirir.
68.5 Formüller ve hesap adımları
MerQur'un hesap sırası: (1) hedefi ve özelliği eksik satırları atar; (2) kategorik X'i göstergeye çevirir; (3) ilk görülme sırasına göre sınıf kodlarıyla tabakalı eğitim/test bölmesi yapar; (4) eğitim kümesine z ölçekleyiciyi uydurur ve iki kümeye uygular; (5) \gamma'yı hesaplar, ikili sorunu libsvm SMO çözücüsüyle 10^{-6} toleransta çözer; (6) Platt olasılığı için iç CV'yle sigmoid uydurur; (7) test kümesinde tahmin, karışıklık matrisi ve ölçüleri hesaplar; (8) eğitim kümesinde 5 katlı CV'yi her katta yeniden ölçekleyerek yineler.
68.5.1 Ölçekleme ve bölme
- x_{ij}: i. gözlemin j. özelliği (ham birim).
- \bar x_j^{\,tr}, s_j^{\,tr}: yalnız eğitim kümesinden ortalama ve 1/n bölenli SS.
- n_{tr}: eğitim kümesi büyüklüğü (200).
Neden ölçekleyici bölmeden sonra ve yalnız eğitime uydurulur?
Test kümesinin ortalaması ölçekleyiciye girerse test bilgisi modele sızar ve başarım iyimser çıkar. MerQur ölçekleyiciyi Pipeline içine koyar (classification.py:1271–1279); CV'de clone(pipe) her katın eğitim kısmına yeniden uydurulur. Bölmede tabaka kodu olarak verideki ilk görülme sırası kullanılır; sınıf adının alfabetik sırası kullanılmaz (first_seen_codes, 177–186; çağrı 1136). Böylece Türkçe ve İngilizce adlı aynı veri aynı satırları test kümesine koyar.
68.5.2 Çekirdekler
- \mathbf u,\mathbf v: iki gözlemin z'lenmiş özellik vektörleri.
- \gamma: çekirdek ölçeği ("gamma"; varsayılan 1/(p\cdot\mathrm{Var}\,X)).
- c_0: "coef0"; d: "Derece (poly)".
- \lVert\mathbf u-\mathbf v\rVert^2: Öklid uzaklığının karesi.
Neden çekirdek?
SVM'nin ikili sorunu ve karar fonksiyonu verilere yalnız iç çarpımlarla girer. İç çarpım yerine K yazmak, veriyi açıkça hesaplamadan çok boyutlu bir uzaya taşıyıp orada doğrusal sınır kurmak demektir. RBF'de K, iki hasta özellik uzayında yakınsa 1'e, uzaksa 0'a yaklaşır; \gamma bu "yakınlık" yarıçapını belirler.
68.5.3 Birincil ve ikili sorun
Birincil (primal) sorun, marjı genişletirken ihlalleri C ile cezalandırır:
- \phi(\cdot): çekirdeğin örtük dönüşümü; \phi(\mathbf u)^{\top}\phi(\mathbf v)=K(\mathbf u,\mathbf v).
- \xi_i: i. gözlemin marj ihlali (gevşek değişken).
- C_i: gözlemin maliyeti; dengeli ağırlık kapalıyken C_i=C, açıkken C\,n/(K n_{y_i}).
- 2/\lVert\mathbf w\rVert: marj genişliği.
Çözücü bunun ikili (dual) biçimini çözer:
- \boldsymbol\alpha: n uzunluklu ikili değişken vektörü.
- \mathbf Q: işaretli çekirdek matrisi (n\times n).
- \mathbf y^{\top}\boldsymbol\alpha=0: sabit terimin varlığından gelen eşitlik kısıtı.
Optimumda Karush–Kuhn–Tucker (KKT) koşulları sağlanır; m_i=y_if(\mathbf x_i) eğitim marjı olmak üzere:
Neden çoğu α sıfırdır?
Marjın dışında kalan, doğru sınıflanmış gözlemlerde \alpha_i=0'dır; bu gözlemler karar fonksiyonuna hiç girmez. Sınıra değen (0<\alpha_i<C, "serbest") ya da marjı ihlal eden (\alpha_i=C) gözlemler destek vektörüdür. Model, eğitim kümesinin yalnız bu "sınırdaki" hastalarla özetlenmesidir.
68.5.4 SMO çözücüsü ve durma ölçütü
libsvm ikili sorunu ardışık en küçük eniyileme (SMO) ile çözer: her adımda yalnız iki \alpha değiştirilir, böylece eşitlik kısıtı korunur ve iki değişkenli alt sorun kapalı biçimde çözülür. Çalışma çifti ikinci derece bilgiyle seçilir (Fan, Chen ve Lin, 2005). G=\mathbf Q\boldsymbol\alpha-\mathbf 1 gradyan olmak üzere durma ölçütü:
- I_{\text{up}}: \alpha_i'nin y_i yönünde artabildiği indeksler (y_i=1,\ \alpha_i<C ya da y_i=-1,\ \alpha_i>0).
- I_{\text{low}}: \alpha_j'nin y_j yönünde azalabildiği indeksler.
- tol: MerQur'da 10^{-6} (68.3, "Koddaki tercih").
Sabit terim serbest destek vektörlerinden bulunur:
- F: serbest destek vektörleri (0<\alpha_i<C); hiç yoksa üst ve alt sınırın ortası alınır.
- \rho: libsvm'in yazdığı eşik; R e1071'in
model$rhodeğeri.
68.5.5 Karar ve çok sınıf
İkili sınıflamada tahmin f(\mathbf x)'in işaretidir (SVC.predict). K>2 sınıfta libsvm bire-bir (one-vs-one) yaklaşımıyla K(K-1)/2 ikili SVM kurar; her biri bir oy verir, en çok oyu alan sınıf seçilir (Hsu ve Lin, 2002). decision_function çıktısı bu oyların bire-karşı-diğerleri biçimine çevrilmiş özetidir; ham ikili karar değerleri değildir.
Ölçüler test kümesinde hesaplanır (classification.py:1402–1406): ikili sınıflamada kesinlik, duyarlılık ve F1 pozitif sınıf (sınıf listesinde ikinci; çıktıda adıyla yazılır) için; çok sınıfta destekle (sınıf büyüklüğüyle) ağırlıklı ortalama olarak.
68.5.6 Platt olasılığı
SVM doğal olarak olasılık üretmez. MerQur probability=True ile libsvm'e Platt ölçeklemesi yaptırır (classification.py:534):
- f_{\text{iç}}: libsvm'in iç etiket sırasına göre karar değeri (ikili sınıfta sklearn'ün f'sinin işaret değiştirmiş hâli).
- A,B: eğitim kümesinde iç 5 katlı CV karar değerlerine en çok olabilirlikle uydurulan sigmoid katsayıları (Lin, Lin ve Weng, 2007). İç katlar tohumla belirlenir.
Koddaki tercih: ikili sınıfta da çift birleştirme
sklearn'ün gömülü libsvm'i ikili sınıfta \tilde P'yi doğrudan vermez: çok sınıf için tasarlanmış çift karşılaştırma birleştirmesini (Wu, Lin ve Weng, 2004) K=2 için de yinelemeli çözer ve \max\lvert\mathbf Q\mathbf p-\mathbf p^{\top}\mathbf Q\mathbf p\rvert<0{,}005/K olunca durur. Sonuç sigmoidin kendisinden biraz sapar; Tıp örneğinde en büyük sapma 7{,}5\cdot10^{-4}'tür. Doğrulamada bu yineleme bağımsız yazılmış ve MerQur olasılıkları 2\cdot10^{-16} farkla yeniden üretilmiştir.
Karar ile olasılık her zaman uyuşmaz
Sınıf tahmini f(\mathbf x)>0'dan, ROC-AUC ve "Olasılık eşiği" ise Platt olasılığından gelir. Sigmoid ayrı bir CV'de uydurulduğu için f(\mathbf x)>0 olan bir gözlemin olasılığı 0,5'in altında kalabilir. Eşik 0,50 seçilirse tahminler varsayılan karardan farklılaşabilir. Ayrıca Platt olasılığı tohuma bağlıdır; karar fonksiyonu bağlı değildir.
68.5.7 Çapraz doğrulama
CV yalnız eğitim kümesinde, StratifiedKFold(5, shuffle=True, random_state=tohum) katlarıyla yapılır (classification.py:1468–1505). Her katta ölçekleyici, \gamma ve SVM o katın eğitim kısmına yeniden uydurulur; kat doğrulukları ortalanır, "±" değeri n-1 bölenli SS'dir (_classification_format.py:21–28).
68.5.8 Regresyon (SVR)
"Görev: Regresyon" seçilince SVR kullanılır ve hedef de z'lenir (TransformedTargetRegressor, classification.py:518–525). Amaç, \varepsilon genişliğindeki tüp içindeki hataları cezalandırmaz:
- y_i^{z}: z'lenmiş hedef; \varepsilon bu ölçekte yorumlanır (0,1 = hedef SS'sinin onda biri).
- \xi_i,\xi_i^{*}: tüpün üstündeki ve altındaki ihlaller.
Tahminler özgün birime geri çevrilir; çıktı R^2, RMSE ve MAE'dir.
68.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/svm/elle_hesap.py ile hesaplanmıştır. Betik MerQur'u ya da sklearn/libsvm'i çağırmaz: ölçekleme, çekirdek ve SMO çözücüsü numpy ile yazılmıştır.
Adım 1 — Bölme ve ölçekleme. Tohum 42 ile 200 eğitim, 50 test gözlemi. Eğitim ortalamaları ve 1/n bölenli SS'ler:
| CRP_mg_L | WBC_K_uL | fever_C | lactate_mmol | |
|---|---|---|---|---|
| \bar x^{\,tr} | 41,2215 | 11,3395 | 37,6460 | 2,1037 |
| s^{\,tr} | 39,300289 | 4,332908 | 0,948517 | 0,758056 |
z'lenmiş eğitim matrisinin bütün hücrelerinin varyansı 1'dir; \gamma=1/(4\times1)=0{,}25.
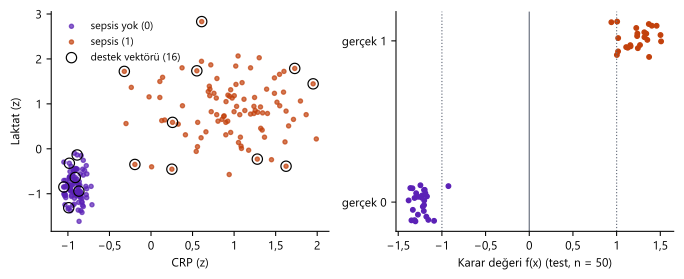
Adım 2 — İkili sorunun çözümü. Kendi SMO çözücümüz (10^{-12} eşiğinde, 288 adımda) 16 destek vektörü bulur: 6'sı "sepsis yok", 10'u "sepsis" sınıfında. Bunların 15'i serbest (0<\alpha_i<1), biri sınırdadır (\alpha_i=C=1; ham verideki 122. satır, sepsisli bir hasta). İkili amaç değeri -3{,}336422, \rho=-0{,}273231, yani b=0{,}273231. MerQur'un bulduğu destek vektörü kümesi aynıdır.
Adım 3 — MerQur çözümünün KKT denetimi. MerQur'un y_i\alpha_i değerleri (dual_coef_) ile her eğitim gözleminin marjı m_i=y_if(\mathbf x_i) hesaplandı. \sum y_i\alpha_i=-1{,}1\cdot10^{-16} (eşitlik kısıtı sağlanıyor). Serbest destek vektörlerinin marjları 0,99999992–1,00000043 aralığındadır; KKT koşullarından en büyük sapma 4{,}3\cdot10^{-7}'dir. Bu, libsvm'in 10^{-6} durma toleransıyla tutarlıdır.
Adım 4 — Tek hastanın karar değeri. Test kümesinin ilk hastası (ham verideki 205. satır): CRP 72,9; WBC 12,2; ateş 37,4; laktat 2,87; gerçek sınıf 1. z değerleri:
Her destek vektörü için K=\exp(-0{,}25\,\lVert\mathbf x_i-\mathbf x\rVert^2) ve katkı y_i\alpha_iK:
| Destek vektörü (ham satır) | Sınıf | \lVert\mathbf x_i-\mathbf x\rVert^2 | K | y_i\alpha_i | Katkı |
|---|---|---|---|---|---|
| 159 | 0 | 6,8189 | 0,181823 | −0,452297 | −0,082238 |
| 174 | 0 | 7,3431 | 0,159491 | −0,909794 | −0,145104 |
| 84 | 0 | 9,2308 | 0,099491 | −0,899230 | −0,089465 |
| 246 | 0 | 12,5422 | 0,043476 | −0,441226 | −0,019183 |
| 26 | 0 | 5,1793 | 0,273946 | −0,403579 | −0,110559 |
| 131 | 0 | 9,6336 | 0,089958 | −0,113916 | −0,010248 |
| 106 | 1 | 2,7548 | 0,502234 | 0,094617 | 0,047520 |
| 152 | 1 | 5,0486 | 0,283042 | 0,376679 | 0,106616 |
| 51 | 1 | 5,0019 | 0,286370 | 0,133734 | 0,038297 |
| 57 | 1 | 3,3606 | 0,431643 | 0,555646 | 0,239841 |
| 45 | 1 | 3,5098 | 0,415839 | 0,041962 | 0,017449 |
| 122 | 1 | 3,6359 | 0,402936 | 1,000000 | 0,402936 |
| 219 | 1 | 9,4018 | 0,095326 | 0,248729 | 0,023710 |
| 182 | 1 | 5,8624 | 0,230939 | 0,297081 | 0,068607 |
| 41 | 1 | 2,1168 | 0,589069 | 0,104863 | 0,061772 |
| 221 | 1 | 2,7813 | 0,498916 | 0,366731 | 0,182968 |
Hasta doğru sınıflanır. f=1{,}006 marjın hemen dışında demektir: bu hasta sınıra yakın ama doğru taraftadır. Destek vektörlerinin sayısal katkısında sınırdaki tek destek vektörü (satır 122, \alpha=C) en büyük paya sahiptir.
Adım 5 — Test kümesi. 50 test hastasında karar değerleri −1,381 ile 1,509 arasındadır; en küçük \lvert f\rvert 0,925'tir. Hiçbir test hastası marjın içine düşmez ve hepsi doğru sınıflanır: karışıklık matrisi [[26, 0], [0, 24]], doğruluk = kesinlik = duyarlılık = F1 = 1.
Adım 6 — Platt olasılığı. MerQur'un sigmoid katsayıları A=-3{,}891022, B=0{,}095552. İlk test hastasında sigmoid doğrudan 0,982198 verir; çift birleştirme yinelemesinden sonra 0,982203 olur (MerQur'un yazdığı değer). AUC, Mann–Whitney tanımıyla hem olasılıktan hem karar değerinden 1'dir.
Adım 7 — CV. MerQur'un beş katı (tohum 42) kullanılarak her katta yeniden ölçekleme, \gamma ve SMO: kat doğrulukları 1, 1, 1, 1, 1.
Adım 8 — Doğrusal çekirdek. Aynı veride doğrusal SVM yalnız 3 destek vektörü kullanır (2 + 1). Ağırlıklar, z ölçeğinde:
Dört bulgu da sepsis yönünde benzer ağırlık taşır; z ölçeğinde 1 SS'lik artışın karar değerine katkısı en çok ateştedir. Bu ağırlıklar OR değildir; ölçekleri marjın genişliğine bağlıdır (2/\lVert\mathbf w\rVert=1{,}415).
Şekil 68.1. Sol: eğitim kümesi, z ölçeğinde CRP ve laktat; halkalı noktalar 16 destek vektörüdür. Sağ: test kümesinde karar değeri; düz çizgi karar sınırı (f=0), noktalı çizgiler marj (f=\pm1).
68.6.1 Doğrulama: MerQur, Python ve R
R sütunu e1071::svm (libsvm 3) ile, MerQur'un bölmesi ve CV katları kullanılarak, 1/n bölenli z'lenmiş veride scale = FALSE, aynı \gamma, cost ve tolerance = 1e-6 ile hesaplanmıştır. Python sütunu kendi SMO çözücümüzdür.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 (e1071) | En büyük fark | Durum |
|---|---|---|---|---|---|
| γ = 1/(p·Var X) ('scale') | 0,250000 | 0,250000 | 0,250000 | 1,1e−16 | ✓ |
| z ölçek ortalamaları (4) | 41,221500 | 41,221500 | 41,221500 | 7,1e−15 | ✓ |
| z ölçek SS'leri, 1/n bölenli (4) | 39,300289 | 39,300289 | 39,300289 | 1,4e−14 | ✓ |
| Destek vektörü sayısı, sınıf 0 / 1 | 6 | 6 | 6 | 0,0e+00 | ✓ |
| Destek vektörlerinin eğitim sıraları (16) | 13 | 13 | 13 | 0,0e+00 | ✓ |
| Sabit terim b=-\rho | 0,273231 | 0,273231 | 0,273231 | 9,1e−08 | ✓ (tol. 1,0e−05) |
| Test karar değerleri f(x) (50) | 1,006152 | 1,006152 | 1,006152 | 4,9e−07 | ✓ (tol. 1,0e−05) |
| f(x), MerQur'un α'larıyla tanımdan (50) | 1,006152 | 1,006152 | 1,006152 | 5,1e−15 | ✓ |
| Test doğruluğu | 1 | 1 | 1 | 0,0e+00 | ✓ |
| Kesinlik / duyarlılık / F1 (sınıf 1) | 1 | 1 | — | 0,0e+00 | ✓ |
| Platt olasılığı P(1\mid x) (50) | 0,982203 | 0,982203 | — | 2,2e−16 | ✓ |
| ROC-AUC (Platt olasılığından) | 1 | 1 | — | 0,0e+00 | ✓ |
| 5 kat CV doğrulukları (5) | 1 | 1 | 1 | 0,0e+00 | ✓ |
| Doğrusal çekirdek: \mathbf w (4) | 0,676639 | 0,676639 | 0,676639 | 1,9e−07 | ✓ (tol. 1,0e−05) |
| Doğrusal çekirdek: b | 0,500389 | 0,500389 | 0,500389 | 1,9e−08 | ✓ (tol. 1,0e−05) |
| Doğrusal çekirdek: destek vektörü sayısı | 2 | 2 | 2 | 0,0e+00 | ✓ |
| Polinom (derece 3): destek vektörü sayısı | 11 | 11 | 11 | 0,0e+00 | ✓ |
| Polinom: test karar değerleri (50) | 0,574664 | 0,574664 | 0,574664 | 3,5e−06 | ✓ (tol. 1,0e−05) |
| RBF, C = 10, γ = 0,5: destek vektörü sayısı | 8 | 8 | 8 | 0,0e+00 | ✓ |
| RBF, C = 10, γ = 0,5: test karar değerleri (50) | 0,906362 | 0,906362 | 0,906362 | 7,5e−07 | ✓ (tol. 1,0e−05) |
Tekrarlanabilirlik (tohum).
| Çalıştırma | Destek vektörü (0 / 1) | b | Test doğruluğu | Karar değerlerinde fark (1. çalıştırmaya göre) |
|---|---|---|---|---|
| Tohum 42 | 6 / 10 | 0,273231 | 1 | — |
| Tohum 42, ikinci çalıştırma | 6 / 10 | 0,273231 | 1 | 0,0e+00 |
| Tohum 43 (başka bölme) | 5 / 12 | 0,258401 | 1 | farklı test kümesi |
MerQur ile R (e1071, aynı libsvm algoritması, tolerance = 1e-6) arasındaki en büyük karar değeri farkı dört modelde 5,7e−14 düzeyindedir. "Python (bağımsız)" sütunu kendi SMO çözücümüzün (durma eşiği 10^{-12}) kesin optimuma yakın çözümüdür; libsvm 10^{-6} KKT boşluğunda durduğu için f(x) ve b bu sütunla 10^{-5} ölçütüyle karşılaştırılır. MerQur çözümünün KKT koşullarından en büyük sapması 4,3e−07 düzeyindedir. Platt olasılığı R'de karşılaştırılmaz: hem sklearn hem e1071 sigmoid katsayılarını içerde rastgele 5 katlı CV ile kestirir ve iki programın rastgele sayı üreteci farklıdır.
Tohum ve tekrarlanabilirlik. Aynı tohumla iki çalıştırma bitişik olarak aynıdır: bölme, katlar, destek vektörleri ve karar değerleri (fark 0). Tohum yalnız rastgelelik içeren üç adımı belirler: eğitim/test bölmesi, CV katları ve Platt sigmoidinin iç CV'si. İkili sorun deterministiktir; aynı eğitim kümesi her zaman aynı \boldsymbol\alpha'yı verir. Tohum 43 başka bir bölme seçtiği için destek vektörü sayısı 17'ye (5 + 12) çıkar. Yalnız Platt olasılığı R ile karşılaştırılamaz, çünkü iki programın rastgele sayı üreteci farklıdır; bu yüzden olasılık, MerQur'un A, B katsayılarından tanımla yeniden hesaplanmıştır.
68.7 Çıktıyı okuma
MerQur'un gerçek çıktısı (varsayılan ayarlar, kısaltılmış):
SVM (rbf) Sınıflandırma
  Hedef               = sepsis
  Özellik sayısı      = 4
  Sınıflar            = 0, 1
  Algoritma           = SVM (rbf)
  Ön işleme           = Eksik değerli satırlar çıkarıldı (listwise). Standartlaştırma (z)
                        eğitim/test bölmesinden SONRA yalnız eğitim kümesine uyduruldu ...

  ── Test Performansı ──
  Doğruluk            = 1.0000
  Kesinlik            = 1.0000
  Duyarlılık          = 1.0000
  F1                  = 1.0000
    ↳ Kesinlik, duyarlılık ve F1 pozitif sınıf için: 1 (sınıf listesinde ikinci sınıf;
      ROC ve karmaşıklık matrisiyle aynı kural).
  ROC-AUC             = 1.0000
  5-katlı CV doğruluğu= 1.0000 (±0.0000)

── Karmaşıklık Matrisi ──
      0   1
  0  26   0
  1   0  24
...
── Model kurulumu ve yeniden üretilebilirlik ──
  Hiperparametreler (belirtilmeyenler kütüphane varsayılanı): kernel = rbf, C = 1.0,
     tol = 1e-06, gamma = scale = 0.25
  Bölme: eğitim n = 200, test n = 50 tabakalı (tohum = 42); ...
  CV: 5-kat tabakalı, karıştırmalı (tohum = 42); yalnız eğitim kümesinde (n = 200)

── SVM model özeti ──
  Destek vektörü sayısı = 16  (0: 6, 1: 10)
| Satır/Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Doğruluk | Test kümesinde doğru sınıflanan oran. | Sınıf oranları dengesizse tek başına yanıltıcıdır; "Dengesiz veri metrikleri" kutusu kappa, dengeli doğruluk, MCC ve NIR testini ekler. |
| Kesinlik / Duyarlılık / F1 | İkili sınıfta pozitif sınıf (sınıf listesinde ikinci; burada "1") için; çok sınıfta sınıf büyüklüğüyle ağırlıklı. Tanım satırı hangisi olduğunu yazar. | Pozitif sınıfı değiştirmek için düzey sırasını Veri sekmesinde tanımlayın ya da sınıfları yeniden kodlayın. |
| ROC-AUC | Platt olasılığından. | Karar değerinden AUC isteniyorsa "Karar fonksiyonu AUC" kutusu. |
| CV doğruluğu (±) | Eğitim kümesinde 5 kat ortalaması ve n-1 bölenli SS. | Test doğruluğuyla büyük fark aşırı uyum ya da şanslı bölme işaretidir. |
| Karmaşıklık Matrisi | Satır gerçek, sütun tahmin. | Köşegen dışı hücreler hata türleridir. |
| Hiperparametreler | Modele fiilen verilen değerler. | "scale" seçiliyken \gamma'nın sayısal değeri (1/p, 68.3) yazılır; seçilen çekirdekte kullanılmayan degree ve coef0 yazılmaz. |
| Destek vektörü sayısı | Toplam ve sınıf başına. | Eğitim kümesine oranı yüksekse (ör. > %50) sınıflar çok örtüşüyor ya da C küçüktür. |
| Doğrusal katsayılar | Yalnız linear çekirdek ve ikili sınıfta, z ölçeğinde \mathbf w ve b. | Pozitif katsayı, sınıf listesindeki ikinci sınıf yönündedir. |
Çıktıda APA özet satırı yoktur (Yapay Sinir Ağı ve KNN panellerinde vardır). Rapor cümlesi elle kurulur:
RBF çekirdekli bir destek vektör makinesi (C=1, \gamma=0{,}25; özellikler eğitim kümesine göre z'lendi) dört klinik bulguyla sepsisi tahmin etti. Tabakalı bölmede (eğitim n=200, test n=50, tohum 42) test doğruluğu 1,00 (26/26 sepsis yok, 24/24 sepsis doğru), ROC-AUC = 1,00; eğitim kümesinde 5 katlı CV doğruluğu Ort = 1,00 (SS = 0,00) bulundu. Model 16 destek vektörüne dayanmaktadır.
68.8 Uzman soruları
S1. MerQur'un durma toleransı neden 10⁻⁶? Sonuçları sklearn varsayılanından farklı mı yapar?
sklearn ve e1071 varsayılanı 10^{-3}'tür. Bu toleransta SMO, KKT boşluğu 10^{-3} olunca durur; karar değerleri kesin optimumdan 10^{-3} mertebesinde uzak kalabilir ve iki program farklı noktalarda durur. MerQur 10^{-6} kullanır (classification.py:173). Tıp örneğinde kesin optimumdan en büyük karar değeri farkı 4{,}9\cdot10^{-7}, e1071 ile fark 5{,}7\cdot10^{-14}'tür. Varsayılan sklearn ile çalışan biri, sınıra çok yakın hastalarda farklı tahmin görebilir.
S2. Sınıf tahmini neden Platt olasılığından değil karar değerinden?
SVC.predict libsvm'in karar fonksiyonunu kullanır; olasılık ayrı bir iç CV'yle uydurulmuş sigmoiddir. İkisi aynı veriden ama farklı adımlarla geldiği için sınıra yakın gözlemlerde çelişebilir. Olasılık eşiği seçeneği bu çelişkiyi bilinçli olarak olasılık lehine çözer (68.5.6).
S3. Destek vektörü sayısı neyi gösterir?
Eğitim gözlemlerinden kaçının modele girdiğini. Sayı küçükse sınıflar iyi ayrılmıştır ve model basittir; eğitim kümesinin büyük bölümü destek vektörüyse (\alpha=C olanlar çoğunluktaysa) sınıflar örtüşüyordur. Ayrıca bir-dışarıda-bırakma hatasının üst sınırı destek vektörü oranıdır (Cortes ve Vapnik, 1995): burada 16/200=0{,}08.
S4. Veri tam ayrılabilirken SVM neden lojistik regresyon gibi çökmez?
Ayrılabilir veride lojistik regresyonun ML kestirimi sonsuza gider (Bölüm 46). SVM'nin amacı \tfrac12\lVert\mathbf w\rVert^2'yi de içerdiği için çözüm sonludur: en geniş marjlı sınır tektir. Tıp örneğinde doğrusal SVM yalnız 3 destek vektörüyle sonlu \mathbf w verir.
S5. e1071::svm varsayılanlarıyla aynı sonuç alınır mı?
Hayır, üç fark var. (i) e1071 scale = TRUE ile n-1 bölenli SS kullanır; z değerleri \sqrt{(n-1)/n} oranında küçülür ve aynı \gamma farklı çekirdek verir. (ii) Tolerans 10^{-3}'tür. (iii) Platt sigmoidinin iç CV'si R'nin RNG'siyle belirlenir. Doğrulamada (i) ve (ii) MerQur'a eşitlendiğinde karar değerleri 10^{-14} farkla aynıdır.
S6. γ = "scale" neden MerQur'da her zaman 1/p?
Çünkü \mathrm{Var}\,X, 1/n bölenli z'lenmiş matrisin bütün hücrelerinden hesaplanır ve tam 1'dir (yuvarlama artığıyla 1+4\cdot10^{-16}). Ölçekleme yapılmamış veride "scale" verinin birimine uyum sağlar; MerQur hep ölçeklediği için bu uyarlama etkisizdir. Kategorik X'ten gelen 0/1 göstergeler de z'lenir.
S7. Çok sınıfta hangi strateji kullanılır ve sınıf olasılıkları nasıl bulunur?
Bire-bir: K(K-1)/2 ikili SVM ve oylama. Olasılık için her çift için ayrı Platt sigmoidi uydurulur, çiftlerin olasılıkları Wu, Lin ve Weng (2004) yöntemiyle birleştirilir. ROC grafiği bire-karşı-diğerleri eğrileri çizer.
S8. Bir sınıfın gözlem sayısı CV kat sayısından küçükse ne olur?
MerQur yalnız eğitim kümesindeki en kalabalık sınıf kat sayısından küçükse durur (classification.py:1340–1342). En küçük sınıf kat sayısından azsa sklearn uyarıyla devam eder ve bazı katlarda o sınıf hiç bulunmaz; kat doğrulukları kararsızlaşır. Küçük sınıflarda kat sayısını düşürün.
68.9 Sık hatalar ve tuzaklar
- Mükemmel doğruluğu modelin başarısı sanmak. Tıp örneğindeki 1,0000, verinin tam ayrılabilir olmasından gelir. Aynı tablo basit bir CRP eşiğiyle de elde edilebilir; karmaşık model seçmeden önce basit kurala bakın.
- Olasılık eşiğini 0,50 seçip varsayılanla aynı sonucu beklemek. Varsayılan karar f>0'dır; eşik Platt olasılığına uygulanır ve sınıra yakın gözlemlerde farklı tahmin verebilir.
- Platt olasılığını kalibre olasılık sanmak. Olasılık, iç CV'ye ve tohuma bağlı bir sigmoid dönüşümüdür. Küçük eğitim kümelerinde kararsızdır.
- Tohum değiştiğinde değişen her şeyi model kararsızlığına bağlamak. Tohum bölmeyi değiştirir; farklı test kümesi farklı doğruluk verir. Model kararlılığını ölçmek için tekrarlı CV kullanın.
- Doğrusal katsayıları OR gibi yorumlamak. \mathbf w z ölçeğinde ve marja göre ölçeklidir; yönü bilgi verir, büyüklüğü olasılık değişimi değildir.
- ε'yi sınıflamada ayarlamak. ε yalnız SVR'de kullanılır; sınıflamada değiştirmek sonucu etkilemez, yalnız ayar kaydına not düşer.
- Ham veriyi ölçeklenmiş sanmak. MerQur her zaman ölçekler; dışarıda (R/Python) yeniden üretirken aynı 1/n bölenli z ölçeklemeyi ve aynı \gamma'yı kullanın.
- Pozitif sınıfı kontrol etmemek. İkili ölçüler sınıf listesindeki ikinci sınıf içindir; tanınmayan metin etiketlerinde bu, düzey sırasındaki ikinci sınıftır ve uyarı yazılır. Çıktıdaki pozitif sınıf adını okuyun.
68.10 Kaynaklar
- Boser, B. E., Guyon, I. M., & Vapnik, V. N. (1992). A training algorithm for optimal margin classifiers. Proceedings of the Fifth Annual Workshop on Computational Learning Theory içinde (ss. 144–152). ACM. https://doi.org/10.1145/130385.130401
- Chang, C.-C., & Lin, C.-J. (2011). LIBSVM: A library for support vector machines. ACM Transactions on Intelligent Systems and Technology, 2(3), 1–27. https://doi.org/10.1145/1961189.1961199
- Cortes, C., & Vapnik, V. (1995). Support-vector networks. Machine Learning, 20(3), 273–297. https://doi.org/10.1007/BF00994018
- Fan, R.-E., Chen, P.-H., & Lin, C.-J. (2005). Working set selection using second order information for training support vector machines. Journal of Machine Learning Research, 6, 1889–1918.
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning (2. baskı). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Hsu, C.-W., & Lin, C.-J. (2002). A comparison of methods for multiclass support vector machines. IEEE Transactions on Neural Networks, 13(2), 415–425. https://doi.org/10.1109/72.991427
- Lin, H.-T., Lin, C.-J., & Weng, R. C. (2007). A note on Platt's probabilistic outputs for support vector machines. Machine Learning, 68(3), 267–276. https://doi.org/10.1007/s10994-007-5018-6
- Platt, J. C. (1999). Probabilistic outputs for support vector machines and comparisons to regularized likelihood methods. A. J. Smola, P. Bartlett, B. Schölkopf & D. Schuurmans (Ed.), Advances in large margin classifiers içinde (ss. 61–74). MIT Press.
- Wu, T.-F., Lin, C.-J., & Weng, R. C. (2004). Probability estimates for multi-class classification by pairwise coupling. Journal of Machine Learning Research, 5, 975–1005.