83. UMAP
Analiz kimliği: umap · Menü adı: UMAP · Panel: gui/panels/analyses/umap_panel.py (form 38–103, hedef adayları 106–116, read_options 119–129, execute 132–160, metin 163–243) · Motor: ml/dimensionality.py, DimensionalityReduction.umap (satır 494–580); güvenilirlik/süreklilik trust_continuity (66–94); hesap çekirdeği umap.UMAP (umap-learn 0.5.12)
Bu bölüm t-SNE bölümüne (Bölüm 81) dayanır: z-ölçekleme, güvenilirlik/süreklilik ve "eksenler yorumlanmaz" ilkesi orada anlatılmıştır.
83.1 Ne işe yarar
UMAP (Uniform Manifold Approximation and Projection), yüksek boyutlu gözlemleri iki ya da daha çok boyutlu bir haritaya yerleştirir. Önce her gözlemin komşularına bulanık (0 ile 1 arası) bağ ağırlıkları veren bir komşuluk grafiği kurar; sonra haritada benzer bir grafik oluşacak biçimde noktaları yerleştirir. Cevapladığı soru: "25 omik ölçüme göre birbirine benzeyen hastalar haritada bir arada mı?"
İki grafiğin uyumu, bulanık küme çapraz entropisiyle ölçülür ve en küçüklenir:
- w_{ij}: özgün uzaydaki bulanık bağ ağırlığı (83.5.3).
- \Phi_{ij}: haritadaki bağ ağırlığı; a, b "Min mesafe (min_dist)" ayarından türetilir (83.5.4).
- Birinci terim komşuları birbirine çeker; ikinci terim komşu olmayanları iter.
UMAP bir test ya da model değildir; p değeri üretmez. Çıktı koordinatlar, bir saçılım grafiği ve kısa bir küme sezgisidir.
Ne zaman kullanılır?
- Çok sayıda değişkenli (omik, spektral, anket) veride küme ya da gradyan yapısını görmek için.
- Gözlem sayısı t-SNE için büyükse: UMAP komşu grafiğini seyrek tutar ve itme kuvvetini örnekler.
- Bilinen bir sınıfın haritada ayrışmasını zorlamak ya da sınıf bilgisini katmak istendiğinde ("Gözetimli hedef").
Ne zaman kullanılmaz?
- Haritadaki uzaklıklar, küme büyüklükleri ya da kümeler arası boşluklar yorumlanacaksa: UMAP bunları korumaz. Uzaklıklar için Çok Boyutlu Ölçekleme (MDS) (Bölüm 82), varyans yapısı için PCA (Bölüm 80).
- Küme sayısına karar vermek için: K-Ortalamalar, Hiyerarşik Kümeleme, DBSCAN ya da Gizil Profil Analizi (LPA).
- Sınıf ayrımının istatistiksel kanıtı gerekiyorsa: gözetimli UMAP sınıfları zaten ayırır; Diskriminant Analizi ya da MANOVA kullanın.
Sık karıştırılan analizler. t-SNE (Bölüm 81) de yerel komşuluğu korur; olasılıkları satır başına normalleştirir ve tam bir itme terimi kullanır. UMAP ağırlıkları normalleştirmez, bulanık birleşimle simetrikleştirir ve itmeyi rastgele "negatif örneklerle" hesaplar. İki yöntemin genel yapıyı koruma farkının büyük kısmı başlangıçtan gelir (UMAP spektral, MerQur t-SNE'si PCA başlangıcı kullanır; Kobak ve Linderman 2021).
83.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Sayısal değişkenler | Uzaklık sayılarla hesaplanır. | Seçici yalnız sayısal sütunları listeler (en az 2). Sayıya çevrilemeyen hücre eksik sayılır; ileti bunu "eksik ya da sayıya çevrilemeyen" diye yazar (dimensionality.py:519). |
| Ortak ölçek | Geniş aralıklı değişken uzaklığa baskın olur. | Her zaman n bölenli z puanı (dimensionality.py:539); kapatılamaz. |
| Anlamlı uzaklık | Yakınlık benzerlik demektir. | Denetlenmez; Öklid, Manhattan, kosinüs, korelasyon, Chebyshev seçilebilir. |
| Veri bir "manifold" üzerindedir | Yerel olarak düzgün bir yapı vardır. | Denetlenmez. |
| Yeterli gözlem | Spektral başlangıç için. | En az boyut + 2 geçerli satır (dimensionality.py:535–538). |
Eksik değer. "Eksik veri" seçicisi: "Satırı çıkar (listwise)" (varsayılan), "Ortalama ile doldur", "Medyan ile doldur" (dimensionality.py:520–525). Düşen satır sayısı sonuçta yazılır ("Eksik veri nedeniyle çıkarılan satır: 2 / 200"). Gözetimli hedefi eksik satırlar ayrıca atılır (517–521).
Uç durumlar (koddan):
- Geçerli satır boyut + 2'den azsa durur (
dimensionality.py:535–538); umap-learn'ün spektral başlangıcı daha küçük n'de çöküyordu. - Boyut sayısı özellik sayısından büyükse uyarır (
umap_panel.py:172–174). - umap-learn yüklü değilse paket uyarısı verir (
dimensionality.py:512–516). - n<4096 ise komşular kesin (bütün uzaklıklar) bulunur; daha büyük veride yaklaşık NN-Descent kullanılır (umap-learn
umap_.py:2550).
83.3 Parametreler
Varsayılanlar umap_panel.py:38–129'den; motor imzası dimensionality.py:494–506.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Boyut sayısı | 2 (2–5) | Haritanın boyutu. | 3 ve üstünde grafik ilk iki boyutu gösterir. |
| Komşu sayısı (n_neighbors) | 15 (2–200) | Bulanık grafikte her gözlemin komşu sayısı k (kendisi dahil). | Küçük k yerel ayrıntıyı, büyük k genel yapıyı öne çıkarır. |
| Min mesafe (min_dist) | 0,1 (0–1) | Haritada noktaların ne kadar sıkışabileceği; a, b'yi belirler. | Küçük değer sıkı kümeler, büyük değer dağınık harita. |
| Bağımsız değişkenler | — | Gömülecek değişkenler. | z puanına çevrilir. |
| Uzaklık metriği | Öklid | Özgün uzaydaki uzaklık. | Komşuluk grafiği. |
| Rastgele tohum | 42 | umap-learn random_state. |
Tek iş parçacığında çalışma ve aynı harita (83.6.1). |
| Gözetimli hedef (y) | yok | Kategorik hedefle gözetimli UMAP. | Farklı sınıftaki bağları zayıflatır (83.5.6). |
| Eksik veri | Satırı çıkar | Silme ya da ortalama/medyanla doldurma. | Gömmeye giren n. |
| Güvenilirlik / süreklilik | kapalı | T(5), C(5) (Bölüm 81.5.6). | Yalnız ek satır. |
| Grafik | 2B gömme | "3B gömme" seçilirse ayrı bir 3 boyutlu gömme yalnız grafik için hesaplanır. | Metin ve tablo 2B gömmeye aittir. |
| Gruba göre renklendir | yok | Yalnız 3B gömme grafiğinde renk. | 2B grafikte renk yoktur. |
Neden komşu sayısı kendisini de sayar?
umap-learn komşu listesine gözlemin kendisini (uzaklık 0) ilk komşu olarak koyar. "Komşu sayısı 15" bu yüzden 14 gerçek komşu demektir; hedef toplam ise \log_2 15 olarak 15 üzerinden kurulur (83.5.2). t-SNE'nin perplexity'si ile doğrudan karşılaştırılamaz.
Panelde görünmeyen umap-learn varsayılanları (MerQur değiştirmez): spread = 1, n_epochs = 500 (n\le10000), init = "spectral", learning_rate = 1, negative_sample_rate = 5, local_connectivity = 1, set_op_mix_ratio = 1, repulsion_strength = 1, target_weight = 0,5.
83.4 Tıp örneği
Dosya: english/datasets/Tip/72_umap_omics_5tip.xlsx (Türkçe kopya: samples/Tum_Analiz_Tip/72_umap_omics_5tip.xlsx). Değişkenler VIDEO_SCRIPT_TR.txt #72'den alınmıştır.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
| omics_01 … omics_25 | özellik | sürekli | ölçümler yaklaşık standart ölçekte |
| lower_type | renk / gözetimli hedef | 5 düzey | S1–S5; her biri 40 hasta |
| patient_id | — | kimlik | gömmeye girmez |
n ve eksik değer: 200 hasta, eksik değer yok.
Klinik soru: 25 omik ölçüm, beş moleküler alt tipi ayıran bir yapı taşıyor mu?
Veri yapısı. Alt tiplerin ortalamaları bütün değişkenlerde aynı sırayla artar (S1 ≈ 0, S2 ≈ 0,4, S3 ≈ 0,8, S4 ≈ 1,3, S5 ≈ 1,6). Alt tip merkezleri arasındaki z ölçekli Öklid uzaklıkları ardışık tiplerde 1,8–2,3, S1–S5 arasında 7,1'dir: yapı, t-SNE bölümündeki gibi tek bir eksen boyunca sıralı, birbirine geçen gruplardır.
Seçilen ayarlar: Arayüz varsayılanları (2 boyut, k=15, min_dist = 0,1, Öklid, tohum 42). Ek çalıştırmalar: aynı ayarlarla ikinci çalıştırma; tohum 7; güvenilirlik açık; k=5 ve k=50; min_dist = 0,5; gözetimli hedef = lower_type; iki hücre boşaltılmış veride "Satırı çıkar" ve "Ortalama ile doldur".
83.5 Formüller ve hesap adımları
MerQur'un hesap sırası: (1) seçilen sütunları sayıya çevirir, eksik değeri işler, gözetimli hedefi tamsayı sınıf kodlarına çevirir; (2) z puanına çevirir; (3) umap-learn ile: her gözlemin k en yakın komşusunu bulur; (4) \rho_i ve \sigma_i'yi hesaplar ve yönlü üyelik ağırlıklarını kurar; (5) bulanık birleşimle simetrik w_{ij} grafiğini elde eder; (6) min_dist'ten a, b'yi kestirir; (7) spektral başlangıçtan 500 dönem stokastik gradyan inişiyle CE'yi en küçükler; (8) isteğe bağlı güvenilirlik/süreklilik ve DBSCAN küme sezgisini ekler.
83.5.1 Ölçek ve komşular
z puanı t-SNE'deki gibidir (n bölenli SS; Bölüm 81.5.1). umap-learn girdiyi 32 bitlik sayılara çevirir ve n<4096 olduğunda bütün çiftlerin uzaklığını hesaplayıp her satırı sıralar: N_k(i)=\{i=i_0,\ i_1,\dots,i_{k-1}\}, d_{i,i_0}=0.
83.5.2 Yerel bağlantı ρ ve ölçek σ
- \rho_i: i'nin en yakın (sıfırdan büyük) komşu uzaklığı;
local_connectivity = 1. - \sigma_i: sol taraf \log_2 k'ya eşit olacak biçimde ikili aramayla bulunur (en çok 64 adım, tolerans 10^{-5}).
- Toplam gözlemin kendisini (l=0) içermez; \log_2 15=3{,}906891.
- Alt sınır: \rho_i>0 ise \sigma_i\ge10^{-3}\cdot (i'nin komşu uzaklıklarının ortalaması) ve \ge10^{-3}\cdot (bütün komşu uzaklıklarının ortalaması).
Neden ρ çıkarılıyor?
Yüksek boyutta en yakın komşu bile uzaktır ("boyut laneti"); bu uzaklık her gözlem için farklıdır. \rho_i'yi çıkarmak, her gözlemin en az bir komşusuna tam ağırlıkla (1) bağlı olmasını sağlar: grafik hiçbir zaman kopuk tek noktalar içermez. Bu, UMAP kuramındaki "her nokta yerel olarak düzgün dağılmış bir manifold üzerindedir" varsayımının sayısal karşılığıdır (McInnes, Healy ve Melville 2018).
Koddaki tercih: hedef log₂ k ve ikili arama
t-SNE'de hedef entropi (\ln perplexity), UMAP'ta hedef ağırlık toplamıdır (\log_2 k). Arama \sigma=1'den başlar; toplam hedeften büyükse \sigma küçültülür (alt sınır 0'a doğru ortalama), küçükse üst sınır yoksa ikiye katlanır. Arama 32 bitlik uzaklık farklarıyla yapılır; aynı sayısal türler kullanıldığında bağımsız bir uygulama \sigma'yı bit düzeyinde yeniden üretir (83.6.1).
83.5.3 Yönlü ağırlıklar ve bulanık birleşim
- v_{j\mid i}: i'nin gözünden j'ye bağın üyelik derecesi; N_k(i) dışında 0.
- w_{ij}: olasılıksal t-ortak normla bulanık birleşim (
set_op_mix_ratio = 1): "en az bir yönde bağ var" olasılığı. - w_{ij}=w_{ji}; 0\le w_{ij}\le1.
Neden toplam değil bulanık birleşim?
v_{j\mid i} ve v_{i\mid j} iki ayrı yerel metrikle ölçülmüş üyeliklerdir. Bulanık küme kuramında iki üyeliği birleştirmenin doğal yolu a+b-ab biçimindeki olasılıksal birleşimdir: iki yön de 1 ise sonuç 1'dir, 1'i aşmaz. t-SNE ise ortalama alıp toplamı 1'e normalleştirir; UMAP normalleştirmez, bu yüzden w değerleri olasılık değil bağ gücüdür.
83.5.4 Haritadaki eğri: a ve b
- G: [0,\ 3\cdot\text{spread}] aralığında eşit aralıklı 300 nokta; spread = 1.
- \psi: "min_dist'e kadar tam bağ, sonra üstel azalma" hedef eğrisi.
- a, b:
scipy.optimize.curve_fitile doğrusal olmayan en küçük kareler (umap-learnfind_ab_params). - min_dist = 0,1 için a=1{,}5769, b=0{,}8951; min_dist = 0,5 için a=0{,}5830, b=1{,}3342.
Neden ψ değil de Φ?
\psi'nin x=\text{min\_dist}'te kırığı vardır ve türevi süreksizdir; gradyan inişi için düzgün bir eğri gerekir. \Phi ailesi b=1, a=1 iken t-SNE'nin Cauchy çekirdeğidir; a, b serbest bırakılarak \psi'ye en yakın düzgün eğri seçilir.
83.5.5 Optimizasyon
umap-learn CE'yi tam hesaplamaz; kenar örneklemeli stokastik gradyan inişi uygular:
- Başlangıç: bulanık grafiğin normalleştirilmiş Laplace matrisinin özvektörleri (spektral yerleşim); en büyük mutlak koordinat 10 olacak biçimde ölçeklenir ve N(0,\ 10^{-8}) gürültü eklenir.
- Budama: w_{ij}<\max w/500 olan kenarlar optimizasyondan çıkarılır (Tıp örneğinde hiçbir kenar bu eşiğin altında değildir).
- Dönem: 500 dönem; ağırlığı büyük kenar daha sık örneklenir (kenar başına örnekleme aralığı \max w/w_{ij} dönem).
- Çekim: örneklenen (i,j) kenarı için \mathbf y_i, -\dfrac{2ab\,d^{2(b-1)}}{1+a\,d^{2b}}(\mathbf y_i-\mathbf y_j) yönünde güncellenir (d^2=\lVert\mathbf y_i-\mathbf y_j\rVert^2).
- İtme: her çekime karşı 5 rastgele "negatif" nokta l için \dfrac{2b}{(0{,}001+d^2)(1+a\,d^{2b})}(\mathbf y_i-\mathbf y_l).
- Gradyan bileşenleri [-4,\ 4] aralığına kırpılır; öğrenme oranı 1'den doğrusal olarak 0'a iner.
Koddaki tercih: tohum ve tek iş parçacığı
MerQur random_state = tohum ve n_jobs = 1 verir (dimensionality.py:541–548). umap-learn tohum verildiğinde zaten tek iş parçacığına geçer; bu, örnekleme sırasını sabitler ve aynı tohumla bit düzeyinde aynı haritayı verir. Bedeli hızdır: büyük veride tohum vermek çok çekirdekli çalışmayı kapatır.
83.5.6 Gözetimli UMAP
"Gözetimli hedef" seçilirse hedef tamsayı sınıf kodlarına çevrilir (pd.factorize, dimensionality.py:531) ve umap-learn'e y olarak verilir; umap-learn yalnız iki gözlemin aynı ya da farklı sınıfta olmasına baktığından kodların sırası sonucu etkilemez. umap-learn kategorik hedefte, farklı sınıftaki gözlemler arasındaki her w_{ij}'yi e^{-5}\approx0{,}0067 ile çarpar (far_dist = 2{,}5/(1-0{,}5)=5), sonra yerel bağlantıyı yeniden kurar. Sonuç, sınıfların haritada neredeyse kesin ayrışmasıdır (Tıp örneğinde 10 komşunun aynı alt tipten olma oranı 1,00).
83.5.7 Küme sezgisi
umap_panel.py:191–230, t-SNE paneliyle aynı kuralı kullanır: k=\max(5,\ \min(\lfloor0{,}01n\rfloor,\ 20)); haritada her noktanın k. komşu uzaklıklarının 95. yüzdeliği = \varepsilon; DBSCAN(\varepsilon, min_samples = k). En az 2 küme ve izole oranı < %20 ise "gömmede … ayrı küme görünüyor; bu yalnız bir sezgidir, grup yapısını özgün veride bir kümeleme analiziyle sınayın" yazılır. Tek küme bulunursa "Otomatik sezgi gömmede tek küme buldu. Bu, veride grup olmadığını göstermez …" yazılır ve grup yapısının özgün veride bir kümeleme analiziyle sınanması önerilir. Tıp örneğinde n=200 için k=5, \varepsilon\approx0{,}47 olur ve 1 küme, 3 izole nokta (%2) bulunur; oysa veride beş alt tip vardır ve haritada komşuların yarısından fazlası aynı alt tiptendir (83.6, Adım 6). Çıktı da tek küme satırını grup yokluğunun kanıtı olarak sunmaz.
Küme sezgisi kanıt değildir
Gömmedeki kümeler doğrulanmış gruplar değildir: sürekli bir değişim de parçalara ayrılmış görünebilir. Komşu uzaklıklarının medyanına dayanan bir kural (\varepsilon = medyan × 1,2, min_samples n ile büyüyen) Tıp verisinde yalnız iki hücre silinince 4 kümeden 2 kümeye inecek kadar kararsızdı; yüzdelik kural daha kararlıdır ama yine yalnız bir sezgidir. Bu satır kanıt olarak kullanılmamalıdır.
83.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/umap/elle_hesap.py ile hesaplanmıştır. Betik MerQur'u ve umap-learn'ü çağırmaz; kesin komşuları, \rho, \sigma, w, a, b ve CE'yi numpy ile tanımdan hesaplar.
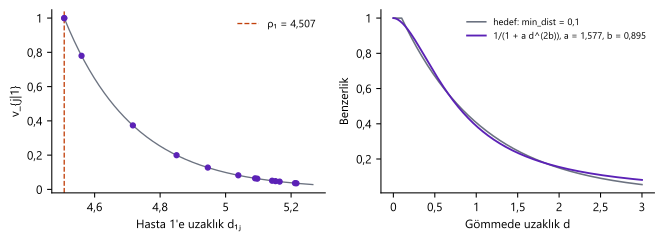
Adım 1 — Komşular. z ölçeğinde hasta 1'in 15 komşusu (kendisi dahil): 1 (d=0), 65 (4,5071), 10 (4,5072), 25 (4,5600), 12 (4,7168), 52 (4,8502), 62 (4,9457), 41 (5,0388), 120 (5,0900), 111 (5,0968), 70 (5,1419), 105 (5,1524), 11 (5,1650), 3 (5,2118), 4 (5,2163). 25 boyutta en yakın komşu bile 4,5 uzaklıktadır; komşu uzaklıkları dar bir aralıkta (4,51–5,22) toplanır.
Adım 2 — ρ ve σ. \rho_1=4{,}507131. \sigma_1 ikili aramayla 20 adımda bulunur:
\sigma_1, \rho'nun %5'i kadardır: ağırlık, komşu uzaklıklarının dar aralığında hızla düşer.
Adım 3 — Yönlü ağırlıklar. Hasta 1'in komşularına:
| Komşu | 65 | 10 | 25 | 12 | 52 | 62 | … | 4 |
|---|---|---|---|---|---|---|---|---|
| d | 4,5071 | 4,5072 | 4,5600 | 4,7168 | 4,8502 | 4,9457 | … | 5,2163 |
| v_{j\mid1} | 1 | 0,99953 | 0,77996 | 0,37363 | 0,19963 | 0,12750 | … | 0,03577 |
| v_{1\mid j} | 0,27289 | 0,26368 | 0,18077 | 0,15139 | 0 | 0,15140 | … | 0 |
| w_{1j} | 1 | 0,99966 | 0,81974 | 0,46846 | 0,19963 | 0,25959 | … | 0,03577 |
Örnek: w_{1{,}25}=0{,}77996+0{,}18077-0{,}77996\cdot0{,}18077=0{,}81974. Hasta 1, hasta 52'nin 15 komşusu arasında değildir (v_{1\mid52}=0); birleşim yine de w_{1{,}52}=0{,}19963 verir.
Bütün grafik 4166 sıfırdan büyük (simetrik) kenar içerir; en büyük ağırlık 1, budama eşiği 1/500'ün altında kenar yoktur.
Adım 4 — a ve b. min_dist = 0,1 ve spread = 1 için 300 noktalı en küçük kareler uyumu:
\Phi(0{,}1)=0{,}975, \Phi(1)=0{,}388: haritada 1 birim uzaklıktaki iki nokta, bağ gücünün yaklaşık %39'unu "temsil eder".
Şekil 83.1. Sol: hasta 1'in 14 komşusuna yönlü üyelik ağırlıkları ve \exp(-(d-\rho_1)/\sigma_1) eğrisi. Sağ: hedef eğri \psi (min_dist = 0,1) ve ona uydurulmuş \Phi(d).
Adım 5 — Çapraz entropi ve komşuluk ölçüleri. MerQur'un son gömmesinde, 19900 çiftin tamamı üzerinden CE = 4151,28. Bunun çekim kısmı (bağlı çiftler) ile itme kısmı (bütün çiftlerde 1-w) birlikte ölçülür; CE yalnız aynı grafik için farklı gömmeleri karşılaştırmaya yarar (uwot gömmesi: 4295,0). Güvenilirlik T(5)=0{,}861521, süreklilik C(5)=0{,}896286. Küme sezgisi: k=\max(5,\min(\lfloor0{,}01\times200\rfloor,20))=5; 5. komşu uzaklıklarının (kendisi dahil) 95. yüzdeliği \varepsilon=0{,}468094, min_samples = 5 → 1 küme, 3 izole nokta.
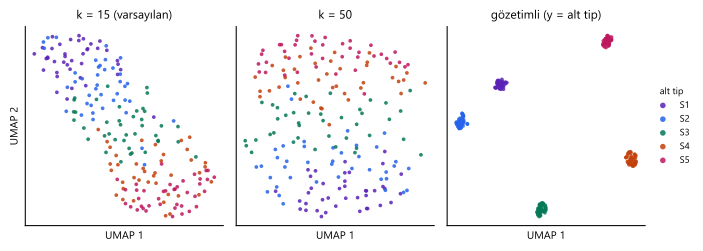
Adım 6 — Ayarların etkisi. Haritada 10 en yakın komşunun aynı alt tipten olma oranı (özgün 25 boyutlu uzayda 0,4740):
| Ayar | Oran |
|---|---|
| k=5 | 0,4940 |
| k=15 (varsayılan) | 0,5525 |
| k=50 | 0,5725 |
| min_dist = 0,5 | 0,5780 |
| tohum 7 | 0,5805 |
| gözetimli (y = alt tip) | 1,0000 |
Alt tip merkezleri arası uzaklıkların sırası haritada korunur (S1–S2 1,15; S1–S5 5,57), ama oranlar korunmaz: özgün uzayda S1–S5 / S1–S2 = 3,5, haritada 4,8.
Şekil 83.2. MerQur UMAP gömmeleri: varsayılan (k=15), k=50 ve gözetimli; renkler alt tip.
83.6.1 Doğrulama: MerQur, Python ve R
Python sütunu bulanık grafiği tanımdan yeniden kurar ve a, b'yi kendi Levenberg–Marquardt uyumuyla bulur. R sütunu uwot::similarity_graph (kesin komşu, nn_method = "fnn") ve uwot:::find_ab_params değerleridir; CE, güvenilirlik ve DBSCAN MerQur'un son gömmesinde R'de ayrıca hesaplanmıştır. Stokastik gradyan inişi, negatif örnekleme ve spektral başlangıcın ayrıntıları yüzünden gömme koordinatlarının R uwot ile birebir eşleşmesi beklenmez; doğrulama grafik, eğri ve gömme üzerinde tanımlanan ölçülerle yapılmıştır.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Bulanık simpleks grafiği (k = 15, Öklid, n = 200) | |||||
| z-ölçekli girdi: MerQur girdisine en büyük fark | — | 4,4409·10−16 | — | 0,0e+00 | ✓ |
| ρ_i: en yakın komşu uzaklığı (200) | 4,507131 | 4,507131 | — | 0,0e+00 | ✓ |
| σ_i: ikili arama (200) | 0,212927 | 0,212927 | — | 0,0e+00 | ✓ |
| — R uwot σ_i (float64 girdi) | 0,212927 | — | 0,212927 | 1,9e−06 | ✓ (tol. 10−5) |
| Kenar sayısı (w > 0) | 4166 | 4166 | 4166 | 0,0e+00 | ✓ |
| Simetrik ağırlıklar w_ij (n × n): MerQur'a en büyük fark | — | 1,1143·10−7 | — | 1,1e−07 | ✓ |
| — R uwot ile MerQur arasında en büyük fark | — | — | 2,4061·10−6 | 2,4e−06 | ✓ (tol. 10−5) |
| Gömme uzayındaki eğri 1/(1 + a d^{2b}) | |||||
| a (min_dist = 0,1) | 1,576943 | 1,576944 | 1,576943 | 1,5e−07 | ✓ |
| b (min_dist = 0,1) | 0,895061 | 0,895061 | 0,895061 | 1,6e−07 | ✓ |
| a (min_dist = 0,5) | 0,583030 | 0,583030 | 0,583030 | 2,2e−07 | ✓ |
| b (min_dist = 0,5) | 1,334167 | 1,334167 | 1,334167 | 3,9e−07 | ✓ |
| MerQur'un son gömmesi üzerinde | |||||
| Bulanık çapraz entropi (tüm çiftler) | — | 4151,276844 | 4151,276982 | 1,4e−04 | ✓ |
| Güvenilirlik T(5) | 0,861521 | 0,861521 | 0,861521 | 3,3e−16 | ✓ |
| Süreklilik C(5) | 0,896286 | 0,896286 | 0,896286 | 3,3e−16 | ✓ |
| DBSCAN ε (k. komşu uzaklığının 95. yüzdeliği) | 0,470000 | 0,468094 | 0,468094 | 0,0e+00 | ✓ (2 ondalık) |
| DBSCAN küme / izole nokta | 1 | 1 | 1 | 0,0e+00 | ✓ |
Tohum ve tekrarlanabilirlik (gömme koordinatlarında en büyük mutlak fark).
| Karşılaştırma | MerQur (umap-learn) | R uwot |
|---|---|---|
| Tohum 42, iki çalıştırma | 0 | 0 |
| Tohum 42 ile tohum 7 | 10,9072 | 3,4255 |
Python sütunu grafiği tanımdan yeniden kurar (kesin kNN, ρ, σ ikili araması, bulanık birleşim) ve a, b'yi kendi Levenberg–Marquardt uyumuyla bulur; umap-learn'ün girdiyi float32'ye çevirmesi taklit edildiğinde ρ ve σ bit düzeyinde aynıdır, ağırlık farkı float32 toplama artığıdır. R sütunu uwot::similarity_graph (uwot 0.2.5, nn_method = "fnn" kesin komşu) ve uwot:::find_ab_params değerleridir; uwot float64 çalıştığından σ'da 10−6 düzeyinde fark kalır (ikili arama toleransı 10−5). a ve b'deki 10−7 düzeyindeki fark, scipy.optimize.curve_fit ve nls durma ölçütlerinden gelir. Gömme koordinatları programlar arasında karşılaştırılmaz: uwot'un aynı ayarlı gömmesinde (tohum 42) aynı grafikle çapraz entropi 4295,0 (MerQur 4151,3), güvenilirlik 0,8656, iki gömmede 10 en yakın komşunun ortak oranı 0,45.
Tohum ve tekrarlanabilirlik. Aynı veri, ayar ve tohumla iki çalıştırma bit düzeyinde aynı haritayı verir; tohum 7 başka bir harita verir (en büyük koordinat farkı 10,9). Komşuluk grafiği ve a, b tohuma bağlı değildir (n<4096'da komşular kesin); tohum yalnız spektral başlangıçtaki gürültüyü ve optimizasyondaki örneklemeyi belirler. uwot aynı davranışı gösterir.
83.7 Çıktıyı okuma
MerQur'un gerçek çıktısı (varsayılan ayarlar):
UMAP (2D)
  Yöntem               = UMAP
  Boyut sayısı         = 2
  Gözlem sayısı (örneklem) = 200

Otomatik küme sezgisi (DBSCAN ε≈0.47): 1 küme, 3 izole nokta (%2).
  ↳ Otomatik sezgi gömmede tek küme buldu. Bu, veride grup olmadığını göstermez: yoğunluğa
    dayalı sezgi birbirine yakın grupları birleştirebilir ve sonuç gömme ayarlarına duyarlıdır.
    Daha yerel yapıyı görmek için n_neighbors'ı düşürmeyi (5-10) deneyin; grup yapısını özgün
    veride bir kümeleme analiziyle sınayın.

── UMAP ↔ t-SNE FARKI ──
  • Kümeler arası uzaklıklar ve küme büyüklükleri UMAP'ta da t-SNE'de olduğu gibi yorumlanmaz; iki yöntem arasındaki küresel yapı farkı büyük ölçüde başlangıç yapılandırmasından gelir
  • Yine de eksen değerleri yorumlanmaz; sadece görsel
  • n_neighbors ↑ → daha geniş gruplar; min_dist ↑ → kümeler arası daha boş alan

── Koordinatlar (ilk 5) ──
      UMAP1   UMAP2
  1  8.0166  6.5860
  2  8.3449  7.4672
  3  8.6004  7.1415
  4  8.0167  7.3392
  5  7.6581  8.2906
| Satır/Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Gözlem sayısı (örneklem) | Gömmeye giren satır. | Eksik satır düştüyse ayrıca "Eksik veri nedeniyle çıkarılan satır: n / N". |
| Ayarlar | Metrik, tohum, gözetim hedefi ya da eksik veri varsayılandan farklıysa. | — |
| Güvenilirlik / süreklilik | T(5), C(5). | Burada 0,86 ve 0,90: t-SNE'ye (0,93, 0,91; başka veri) benzer düzey. |
| Otomatik küme sezgisi | DBSCAN \varepsilon, küme ve izole nokta sayısı. | Kararsızdır (83.5.7); kanıt değildir. |
| UMAP ↔ t-SNE farkı | Sabit metin. | Kümeler arası uzaklığın iki yöntemde de yorumlanmadığını hatırlatır (83.8, S5). |
| Koordinatlar (ilk 5) | 1 tabanlı gözlem numarası, 4 ondalık. | Koordinatların kendisi yorumlanmaz; tamamı Tablo sekmesinde. |
Rapor cümlesi:
200 hastanın 25 omik ölçümü z puanına çevrildi ve UMAP ile iki boyuta indirgendi (komşu sayısı = 15, min_dist = 0,1, Öklid uzaklığı, spektral başlangıç, 500 dönem, tohum = 42). Haritada komşuluk korunumu güvenilirlik T(5) = 0,86 ve süreklilik C(5) = 0,90 idi. Beş alt tip ayrık kümeler yerine S1'den S5'e uzanan sıralı ve birbirine geçen bir yapı gösterdi.
83.8 Uzman soruları
S1. UMAP'ın bulanık grafiği t-SNE'nin P matrisinden nasıl farklı?
t-SNE her satırda bir Gauss dağılımı kurar, perplexity'ye göre \sigma_i seçer, satırları 1'e normalleştirir ve iki yönü ortalar. UMAP en yakın komşu uzaklığını (\rho_i) çıkarır, üstel çekirdekle \log_2 k toplamına göre \sigma_i seçer, normalleştirmez ve iki yönü bulanık birleşimle (a+b-ab) birleştirir. Sonuçta her gözlemin en az bir tam ağırlıklı bağı vardır.
S2. a ve b R uwot ile neden 10⁻⁷ düzeyinde farklı?
İki program da aynı 300 noktalı hedef eğriye en küçük kareler uyumu yapar; fark yalnız durma ölçütlerindendir (curve_fit ile nls). Bağımsız bir Levenberg–Marquardt uyumu iki değerin de gerçek minimumdan ~10^{-7} uzakta olduğunu gösterir. Bu fark haritayı etkilemez.
S3. Aynı tohumla sonuç her zaman aynı mı?
Aynı makinede, aynı veri ve ayarla evet: tohum verildiğinde umap-learn tek iş parçacığında çalışır. Farklı umap-learn, numba ya da numpy sürümü sonucu değiştirebilir. n\ge4096'da komşular yaklaşık NN-Descent ile bulunur; o zaman grafik de tohuma bağlı hâle gelir.
S4. Grafik ağırlıkları uwot ile neden tam aynı değil?
umap-learn girdiyi ve grafiği 32 bitlik sayılarla tutar, uwot 64 bitlik. Aynı tanım uygulandığında \sigma_i'ler ikili arama toleransı (10^{-5}) içinde kalır ve ağırlık farkı en çok 2{,}4\cdot10^{-6}'dır. Python'da girdi 32 bite yuvarlanınca \rho ve \sigma MerQur'la bit düzeyinde aynı çıkar.
S5. "UMAP küresel yapıyı t-SNE'den daha iyi korur" doğru mu?
Genel bir kural olarak değil. Kobak ve Linderman (2021), iki yöntem arasındaki genel yapı farkının büyük ölçüde başlangıçtan geldiğini gösterir: aynı (PCA ya da spektral) başlangıçla t-SNE ve UMAP benzer genel yapı verir. Tıp örneğinde alt tip merkezlerinin sırası korunur, ama uzaklık oranları korunmaz (83.6, Adım 6). MerQur'un çıktı metni de bu yüzden kümeler arası uzaklığın iki yöntemde de yorumlanmadığını yazar.
S6. Gözetimli UMAP'ı sınıf ayrımı kanıtı olarak kullanabilir miyim?
Hayır. Farklı sınıflar arasındaki bağlar e^{-5} ile zayıflatıldığı için sınıflar haritada her zaman ayrışır; Tıp örneğinde 10 komşunun saflığı 1,00'e çıkar. Bu, verideki ayrımı değil, eklenen hedef bilgisini gösterir. Ayrımın gücü, gözetimsiz harita ya da bir sınıflandırıcının dış doğrulamasıyla değerlendirilmelidir.
S7. Küme sezgisi neden komşu uzaklıklarının 95. yüzdeliğini kullanıyor?
Medyana dayalı bir \varepsilon yoğun bölgelerin ölçeğine göre ayarlanır, kümeler arası boşluğa göre değil; min_samples da n ile büyürse birkaç noktanın yeri değişince kümeler bölünür ya da birleşir (Tıp verisinde 4 → 2 küme). Yüzdelik kural ve \varepsilon ile aynı k'yı kullanan min_samples, t-SNE ve UMAP panellerinde aynı ve daha kararlı sonuç verir (83.5.7). Yine de kümeler bir sezgidir; kümeleme analiziyle sınanmalıdır.
83.9 Sık hatalar ve tuzaklar
- Kümeler arası boşluğu ya da küme büyüklüğünü yorumlamak. UMAP yerel komşuluğu korur; boşluklar ve yoğunluklar haritaya özgüdür.
- Küme sezgisi satırını sonuç olarak raporlamak. Satır bir sezgidir; grup yapısı özgün veride kümeleme analiziyle sınanmalıdır.
- Gözetimli haritayı gözetimsiz gibi sunmak. Hedef seçiliyse sınıflar zorla ayrışır; raporda bu açıkça yazılmalıdır.
- Tek bir komşu sayısıyla yetinmek. Yapıyı en az iki üç k değerinde (ör. 5, 15, 50) karşılaştırın.
- Tohumu değiştirmeden kararlılık sonucu çıkarmak. Aynı tohum aynı haritayı verir; kararlılık için farklı tohumlar denenmelidir.
- 2B grafikte grup renklerini beklemek. "Gruba göre renklendir" yalnız 3B gömme grafiğinde etkilidir.
- Metin hücrelerini fark etmemek. Sayıya çevrilemeyen hücre eksik sayılır ve satır düşer; iletiyi ve kalan gözlem sayısını denetleyin.
- Komşu sayısını t-SNE perplexity'siyle eş tutmak. İkisi farklı ölçeklerde tanımlıdır; k=15 yaklaşık 14 gerçek komşudur.
83.10 Kaynaklar
- Becht, E., McInnes, L., Healy, J., Dutertre, C.-A., Kwok, I. W. H., Ng, L. G., Ginhoux, F., & Newell, E. W. (2019). Dimensionality reduction for visualizing single-cell data using UMAP. Nature Biotechnology, 37(1), 38–44. https://doi.org/10.1038/nbt.4314
- Chari, T., & Pachter, L. (2023). The specious art of single-cell genomics. PLOS Computational Biology, 19(8), e1011288. https://doi.org/10.1371/journal.pcbi.1011288
- Kobak, D., & Linderman, G. C. (2021). Initialization is critical for preserving global data structure in both t-SNE and UMAP. Nature Biotechnology, 39(2), 156–157. https://doi.org/10.1038/s41587-020-00809-z
- McInnes, L., Healy, J., & Melville, J. (2018). UMAP: Uniform manifold approximation and projection for dimension reduction (arXiv:1802.03426). arXiv. https://arxiv.org/abs/1802.03426
- McInnes, L., Healy, J., Saul, N., & Großberger, L. (2018). UMAP: Uniform Manifold Approximation and Projection. Journal of Open Source Software, 3(29), 861. https://doi.org/10.21105/joss.00861
- Venna, J., & Kaski, S. (2001). Neighborhood preservation in nonlinear projection methods: An experimental study. In G. Dorffner, H. Bischof, & K. Hornik (Eds.), Artificial Neural Networks — ICANN 2001 (Lecture Notes in Computer Science, Vol. 2130, pp. 485–491). Springer. https://doi.org/10.1007/3-540-44668-0_68