17. Çoklu Karşılaştırma Düzeltme
Analiz kimliği: multiple_comparison · Menü adı: Çoklu Karşılaştırma Düzeltme · Panel: gui/panels/analyses/multiple_comparison.py · Motor: aynı dosya, execute (satır 603–713) ve pvalues_from_data (satır 274–400); düzeltmeler statsmodels.stats.multitest.multipletests, Storey q-değeri _storey_q (satır 85–98)
17.1 Ne işe yarar
Bu modül, bir p değeri listesini alır ve aynı anda birçok hipotez sınandığında ortaya çıkan birinci tür hata şişmesini denetleyen düzeltilmiş p değerlerini yedi (isteğe bağlı on bir) yöntemle yan yana verir. Cevapladığı soru şudur: "Bu m testten hangilerini, aile bazında bir hata ölçütünü koruyarak anlamlı sayabilirim?"
İki hata ölçütü vardır:
- m: test sayısı; R: reddedilen hipotez sayısı; V: bunlardan yanlışlıkla reddedilenler (doğru H_0'lar).
- FWER (aile bazında hata oranı): en az bir yanlış ret olasılığı. Bonferroni, Šidák, Holm, Hochberg, Hommel, Holm–Šidák bunu \alpha'da tutar.
- FDR (yanlış keşif oranı): retler içindeki yanlışların beklenen payı. Benjamini–Hochberg, Benjamini–Yekutieli, iki aşamalı BH, BKY ve Storey q bunu denetler.
İki giriş modu. (1) p-değer listesi: kullanıcı başka analizlerden gelen p'leri yapıştırır. (2) Veriden: bir grup ve bir ölçüm sütunu seçilir; her düzey referansa karşı ya da tüm çiftler için iki örneklem testi (Welch t, Student t, havuzlanmış SS t, Mann–Whitney U) çalıştırılır, üretilen ham p'ler p-kutusuna yazılır ve aynı düzeltmeler uygulanır.
Ne zaman kullanılır? Aynı soruya bağlı birden çok test yapıldığında: birden çok sonlanım, birden çok alt grup, kontrollere karşı birden çok tedavi, korelasyon matrisi, gen çapında taramalar.
Ne zaman kullanılmaz?
- Tek yönlü ANOVA içinde grup ortalamaları karşılaştırılacaksa: Tek Yönlü ANOVA'nın post hoc seçenekleri (Tukey, Dunnett) daha güçlüdür; çünkü testler arasındaki ilişkiyi (ortak MS_W, ortak kontrol) kesin dağılımla hesaba katarlar (Bölüm 7.5.7–7.5.9).
- Grupların genel ortalamadan sapması sorulacaksa: ANOM (Bölüm 8).
- Testler birbirinden bağımsız sorulara aitse (farklı çalışmalar, farklı araştırma soruları): aile tanımı yoktur, düzeltme gerekmez.
Sık karıştırılan analizler. Bu modül p değerlerini sonradan düzeltir; testlerin kendisini yapmaz (Veriden modu hariç, orada da yalnız iki örneklem testlerini yapar). Post hoc testler (Tukey, Games–Howell) ise ham verinin ortak yapısını kullanır ve eşzamanlı güven aralığı da verir; bu modül GA vermez.
17.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Geçerli ham p'ler | Her p, kendi testinin varsayımları altında doğru hesaplanmıştır ve H_0 altında Uniform(0, 1)'dir. | Denetlenmez; yalnız 0\le p\le1 aralığı denetlenir (multiple_comparison.py:236–240). |
| Bağımlılık yapısı | Bonferroni, Holm, BY her bağımlılıkta geçerlidir. Šidák, Holm–Šidák bağımsızlık ya da pozitif ortant bağımlılığı ister. Hochberg, Hommel ve BH bağımsızlık ya da pozitif regresyon bağımlılığı (PRDS) ister. | Denetlenmez; yöntem seçimi kullanıcıya kalır. Sonuç metni "Bağımlı testler: BY" önerisini yazar. |
| Aile tanımı | Hangi testlerin birlikte düzeltileceği önceden belirlenmiştir. | Denetlenmez. |
Giriş biçimi (_parse_p_values, multiple_comparison.py:132–242). ; yeni satıra çevrilir; # ile başlayan satırlar not sayılır ve sonuç metnine "Kaynak" olarak taşınır. Her satır şu sırayla denenir: (i) Etiket: p (iki noktadan sonraki kısımda virgül yoksa), (ii) virgülle ayrılmış birden çok değer, (iii) tek değer. Etiketsiz değerlere Test1, Test2, … adı verilir.
Uç durumlar.
- Liste boşsa ya da geçerli değer yoksa hata; tek p değeri varsa hata: "En az 2 p-değer gerekli" (
multiple_comparison.py:633–637). - p<0 ya da p>1 ise hata ve sıra numarası yazılır.
- \alpha (0{,}1) dışında ise hata; formdaki kutu 0,001–0,999 aralığındadır.
- m<5 ise "çok az, düzeltme gerekli olmayabilir", m>1000 ise "FDR yöntemleri tercih edilmeli" uyarısı yazılır (
multiple_comparison.py:695–702). - Veriden modunda üretim başarısız olursa p-kutusu temizlenir,
#!işaretli hata satırı yazılır ve Çalıştır açık hata verir; eski p'ler sessizce kullanılmaz (multiple_comparison.py:555–562, 571–574).
Ayrıştırılamayan satırlar
Etiketle değer son iki noktadan ayrılır; etiketinde iki nokta geçen C:D: 0.04 satırı "C:D" etiketiyle okunur. Satırda tek değer varsa ondalık virgül (0,03, A: 0,03) okunur ve okunan virgüllü değer sayısı yazılır. Ondalık virgülün liste virgülünden ayırt edilemediği satır (0,01,0,03) açık hatayla reddedilir; listeyi ; ile ayırın. Sayıya çevrilemeyen satırlar (p = 0.04 gibi) aileye girmez, ama sessizce düşmez: sayıları ve içerikleri uyarıda yazılır. Bu durumda m küçülür; uyarı ve "Test sayısı" satırı beklenen m ile karşılaştırılmalıdır.
17.3 Parametreler
Varsayılanlar multiple_comparison.py:438–598 içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| p-değerleri | boş | Satır başına bir p; Etiket: p; virgüllü liste; # not satırı. |
Düzeltilecek aile. |
| α (anlamlılık seviyesi) | 0,050 | Karar eşiği. | Yıldızlar ve "anlamlı" sayıları; iki aşamalı yöntemlerde düzeltilmiş p'nin kendisi de \alpha'ya bağlıdır (17.5.6). |
| Giriş modu | p-değer listesi (yapıştır) | Veriden seçilirse grup/ölçüm sütunlarından p üretilir; p-kutusu salt okunur olur. | |
| Grup sütunu, Ölçüm sütunu | ilk uygun sütunlar | Veriden modunda karşılaştırılacak gruplar ve sürekli değişken. | |
| Karşılaştırma | her grup referansa (kontrol) karşı | Ya da "tüm ikili çiftler". | m=k-1 ya da m=k(k-1)/2. |
| Referans (kontrol) düzeyi | boş | Boşsa "control/kontrol/placebo/plasebo" adlı düzey, yoksa verideki ilk düzey (multiple_comparison.py:260–266). |
Hangi farkların sınanacağı. |
| İkili test | Welch t-testi | Welch t; Student t (eşit varyans); havuzlanmış SS t (N-k sd, R pairwise.t.test(pool.sd = TRUE)); Mann–Whitney U. |
Ham p'ler. |
| Ek yöntemler: Holm-Šidák, TSBH, BKY, Storey q | kapalı | Tabloya ek sütunlar. | Ek sütun; yedi temel yöntem her zaman verilir. |
Neden α değişince TSBH ve BKY sütunu da değişir?
İki aşamalı yöntemler önce gerçek H_0 sayısını (m_0) birinci aşamadaki ret sayısından kestirir ve bu ret sayısı \alpha'ya bağlıdır. statsmodels'in verdiği "düzeltilmiş p", bu \alpha'ya özgü \hat m_0 ile çarpılmış BH p'sidir. Bu yüzden aynı ham p'ler, \alpha=0{,}05 ve \alpha=0{,}10 ile farklı TSBH p'leri verebilir. Bonferroni'den Storey'ye kadar öteki yöntemlerin düzeltilmiş p'si \alpha'dan bağımsızdır.
17.4 Tıp örneği
Dosya: english/datasets/Tip/13_multiple_comparison_antikoagulan.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/13_coklu_karsilastirma_antikoagulan.xlsx).
| Değişken | Rol | Tür | Açıklama |
|---|---|---|---|
drug |
Grup sütunu | metin, 9 düzey | Varfarin (ilk düzey, referans) ve drug-1 … drug-8 |
INR_stability_ratio |
Ölçüm sütunu | sürekli (0–1) | Hedef INR aralığında geçen sürenin oranı; yüksek değer daha iyi. |
patient_id |
kullanılmaz |
n ve eksik değer: 180 hasta, her kolda 20; eksik değer yoktur.
Klinik soru: Sekiz yeni antikoagülandan hangileri INR kararlılığında Varfarin'den farklıdır? Sekiz karşılaştırma tek bir aile oluşturur.
Seçilen ayarlar: Giriş modu = Veriden; Karşılaştırma = her grup referansa karşı; Referans boş (adında "control" olan düzey olmadığı için ilk düzey Varfarin seçilir); İkili test = Welch; \alpha=0{,}05. Dört ek yöntem de işaretlendi. Öteki üç ikili test ayrıca çalıştırıldı.
17.5 Formüller ve hesap adımları
MerQur'un sırası: (1) Veriden modundaysa ham p'leri üret ve p-kutusuna etiket: p satırları olarak yaz; (2) metni ayrıştır; (3) her yöntem için multipletests(p, alpha, method) çağır; düzeltilmiş p'yi 6 ondalığa yuvarla (6 ondalıkta sıfır görünecek kadar küçükse 4 anlamlı basamak); (4) istenen ek yöntemleri ekle; (5) metin, tablo ve grafik üret.
Aşağıda p_{(1)}\le\dots\le p_{(m)} sıralı ham p'ler, \tilde p_{(i)} düzeltilmiş p'ler; tüm düzeltilmiş p'ler en çok 1'e kırpılır. Karar: \tilde p\le\alpha ise H_0 reddedilir (statsmodels <= kullanır; sonuç metnindeki ★ dipnotu "ham p<\alpha; düzeltilmiş p\le\alpha" diye iki kuralı ayrı yazar).
17.5.1 Veriden modunda ham p'ler
- g: karşılaştırılan düzey; r: referans düzeyi. Fark \bar y_g-\bar y_r yönündedir (etiket "drug-1 vs Varfarin").
- Student: havuzlanmış iki grup varyansı, n_g+n_r-2 sd. Havuzlanmış SS: tüm grupların SS_W/(N-k)'sı, N-k sd (
multiple_comparison.py:335–363). - Mann–Whitney: scipy
mannwhitneyu(..., alternative="two-sided")"auto" kuralıyla: iki grup da 8'den büyükse ya da bağ varsa süreklilik düzeltmeli normal yaklaşım, aksi halde kesin dağılım (multiple_comparison.py:364–374). Kullanılan yol p-kutusuna#notu olarak yazılır. - Eksik ya da sayısal olmayan satırlar liste bazında atılır; düzey sırası verideki görülme sırasıdır.
Koddaki tercih
Bir testin p'si tanımsız çıkarsa (ör. iki grupta da tüm değerler aynı olduğunda Welch t=0/0) MerQur bu p'yi 1 yapar ve hangi testte tanımsız olduğunu not olarak yazar (multiple_comparison.py:375–379). Böyle bir çift ailede kalır ve m'yi büyütür; R t.test aynı durumda "data are essentially constant" hatası verir.
17.5.2 Tek adımlı FWER yöntemleri
- Bonferroni: Boole eşitsizliğinden; P(\bigcup A_i)\le\sum P(A_i). Her bağımlılık yapısında FWER \le\alpha.
- Šidák: testler bağımsızsa P(\text{hiç yanlış ret yok})=(1-\alpha')^m; \alpha'=1-(1-\alpha)^{1/m} eşiği FWER'i tam \alpha yapar. statsmodels bunu sayısal kayıpsız biçimde -\mathrm{expm1}(m\log1p(-p)) olarak hesaplar.
17.5.3 Adım-aşağı FWER yöntemleri: Holm ve Holm–Šidák
Neden adım-aşağı ve neden kümülatif en büyük?
Holm (1979) kapalı test ilkesinden çıkar: en küçük p, m hipotezli aileye karşı (\alpha/m), ikincisi kalan m-1 hipotezli aileye karşı (\alpha/(m-1)) sınanır ve ilk "red yok"ta durulur. Her adım öncekinden daha gevşek eşik kullandığı için Holm her durumda Bonferroni'den güçlüdür, yine de her bağımlılıkta FWER'i korur. "Kümülatif en büyük" (\max_{j\le i}), durma kuralının düzeltilmiş p'ye çevrilmesidir: daha küçük bir p reddedilmemişse büyük olan da reddedilemez, bu yüzden düzeltilmiş p'ler sıralı ham p'lerle aynı sırada artmak zorundadır (Wright 1992).
17.5.4 Adım-yukarı FWER yöntemleri: Hochberg ve Hommel
- Hochberg: Holm'la aynı eşikleri büyük p'den başlayarak kullanır; ilk "red"de durur ve daha küçük tüm p'leri reddeder.
- Hommel: tüm alt aileler I üzerinde Simes (1986) testiyle kapalı test; p_{(l):I}, I içindeki l. en küçük p'dir.
- Güç sıralaması (aynı veride): Holm ≤ Hochberg ≤ Hommel; üçü de FWER'i bağımsızlık ya da PRDS altında korur.
Koddaki tercih
statsmodels Hommel'i, R p.adjust("hommel") ile aynı kısa yol algoritmasıyla hesaplar (m döngüsü, 2^m alt küme taranmaz). Bağımsız Python doğrulaması ise tanımı kelimesi kelimesine uygular: m=8 için 255 alt kümenin her biri için Simes p'si alınır, her hipotez için kendini içeren alt kümelerin en büyüğü seçilir (dogrulama/multiple_comparison/elle_hesap.py). İki yol 10^{-15} düzeyinde eşleşir.
17.5.5 FDR yöntemleri: Benjamini–Hochberg ve Benjamini–Yekutieli
Neden m/j ve neden c_m?
BH kuralı "en büyük i için p_{(i)}\le i\alpha/m ise ilk i hipotezi reddet"tir. Bağımsız (ya da PRDS) testlerde FDR =\frac{m_0}{m}\alpha\le\alpha olur (Benjamini ve Hochberg 1995). Eşik i ile doğrusal arttığı için çok testte FWER yöntemlerinden çok daha güçlüdür. Keyfi bağımlılıkta aynı garanti için eşik c_m kadar sıkılaştırılır (Benjamini ve Yekutieli 2001); m=8'de c_8=2{,}717857.
17.5.6 Ek yöntemler: iki aşamalı BH, BKY ve Storey q
İki aşamalı yöntemler (multipletests(..., method="fdr_tsbh" | "fdr_tsbky"), statsmodels fdrcorrection_twostage, tek yineleme):
- TSBH: \alpha'=\alpha, f=1. BKY (Benjamini, Krieger ve Yekutieli 2006): \alpha'=\alpha/(1+\alpha), f=1+\alpha.
- r_1=0 ya da r_1=m ise ikinci aşama yapılmaz: \tilde p=\tilde p^{\,\text{BH}}\cdot f.
- \hat m_0/m: gerçek H_0 oranının kestirimi; BH'nin içindeki m_0/m tutuculuğunu geri alır.
- \hat m_0 birinci aşamada \alpha ile kestirildiği için düzeltilmiş p'nin kendisi \alpha'ya bağlıdır; sonuç metni bunu kullanılan \alpha ile not eder.
Storey q-değeri (_storey_q, multiple_comparison.py:85–98):
- \hat\pi_0: gerçek H_0 oranı; H_0 p'leri Uniform olduğundan \lambda'nın üstündeki p sayısı yaklaşık m\pi_0(1-\lambda)'dır.
- +1 terimi Storey, Taylor ve Siegmund (2004) sonlu örneklem biçimidir; hiç p>\lambda yokken \hat\pi_0=0 olmasını önler.
- q için karar q\le\alpha'dır (
multiple_comparison.py:668–670).
R qvalue ile fark
R qvalue::qvalue(p, lambda = 0.5) +1 terimini kullanmaz: bu veride \hat\pi_0=1/4=0{,}25, MerQur 2/4=0{,}50 verir; MerQur'un q'ları R'nin iki katıdır. MerQur bu farkı sonuç metninde yazar ("+1 terimi olmayan klasik tanımla … π̂₀ = 0.2500"). Ayrıca qvalue varsayılanı tek \lambda değil, \lambda ızgarası üzerinde düzgünleştirilmiş kestirimdir; MerQur'un değeriyle karşılaştırmak için R'de qvalue(p, pi0 = 0.5) kullanılmalıdır (17.6.1'deki R sütunu böyle hesaplanmıştır).
Koddaki tercih
Bütün yöntemlerin (yedi temel ve dört ek) düzeltilmiş p'leri p_yuvarla(p, 6) ile saklanır: 10^{-6}'dan küçük değerler 0 yerine 4 anlamlı basamakla. Bu veride drug-5 için TSBH, BKY ve Storey q 3{,}72\times10^{-7}, 3{,}91\times10^{-7} ve 3{,}72\times10^{-7}; BH 7{,}45\times10^{-7} olarak saklanır.
17.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Aşağıdaki ara değerler dogrulama/multiple_comparison/elle_hesap.py ile, MerQur ve statsmodels çağrılmadan hesaplanmıştır.
Adım 1 — Sekiz Welch testi (her kolda n=20; Varfarin ortalaması 0,671150, SS 0,127688).
| Karşılaştırma | \bar y_g | s_g | Fark | t_W | \nu | ham p |
|---|---|---|---|---|---|---|
| drug-1 vs Varfarin | 0,69895 | 0,111137 | 0,02780 | 0,734436 | 37,29 | 0,467277 |
| drug-2 vs Varfarin | 0,74465 | 0,127259 | 0,07350 | 1,823336 | 38,00 | 0,076126 |
| drug-3 vs Varfarin | 0,83880 | 0,093002 | 0,16765 | 4,746258 | 34,73 | 3{,}50\times10^{-5} |
| drug-4 vs Varfarin | 0,70890 | 0,084209 | 0,03775 | 1,103740 | 32,90 | 0,277714 |
| drug-5 vs Varfarin | 0,90615 | 0,088961 | 0,23500 | 6,753226 | 33,93 | 9{,}31\times10^{-8} |
| drug-6 vs Varfarin | 0,68230 | 0,086506 | 0,01115 | 0,323307 | 33,41 | 0,748478 |
| drug-7 vs Varfarin | 0,78800 | 0,100654 | 0,11685 | 3,214036 | 36,04 | 0,002759 |
| drug-8 vs Varfarin | 0,79930 | 0,114648 | 0,12815 | 3,339666 | 37,57 | 0,001904 |
Ham p<0{,}05 olan 4 test vardır: drug-3, drug-5, drug-7, drug-8.
Adım 2 — Sıralama ve adımlı çarpanlar.
| i | Test | p_{(i)} | Holm (m-i+1)p | BH \frac{m}{i}p | BY c_8\frac{m}{i}p |
|---|---|---|---|---|---|
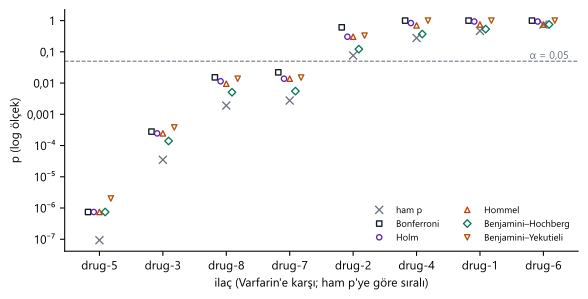
| 1 | drug-5 | 9{,}31\times10^{-8} | 7{,}45\times10^{-7} | 7{,}45\times10^{-7} | 2{,}02\times10^{-6} |
| 2 | drug-3 | 3{,}50\times10^{-5} | 0,000245 | 0,000140 | 0,000380 |
| 3 | drug-8 | 0,001904 | 0,011423 | 0,005077 | 0,013798 |
| 4 | drug-7 | 0,002759 | 0,013795 | 0,005518 | 0,014998 |
| 5 | drug-2 | 0,076126 | 0,304506 | 0,121802 | 0,331041 |
| 6 | drug-4 | 0,277714 | 0,833142 | 0,370285 | 1,006383 |
| 7 | drug-1 | 0,467277 | 0,934553 | 0,534030 | 1,451418 |
| 8 | drug-6 | 0,748478 | 0,748478 | 0,748478 | 2,034259 |
Holm için kümülatif en büyük alınır: 8. sıradaki 0,748478, 7. sıradaki 0,934553'ten küçük olduğu için drug-6'nın Holm p'si 0,934553 olur. BH ve BY için sondan kümülatif en küçük alınır ve 1'e kırpılır: BY'de drug-4, drug-1 ve drug-6 için 1.
Adım 3 — Hochberg ve Hommel. Hochberg sondan kümülatif en küçük: \min(0{,}748478,\ 2\times0{,}467277,\ 3\times0{,}277714,\ \dots); drug-1, drug-4 ve drug-6 için 0,748478, drug-2 için 4\times0{,}076126=0{,}304506, drug-8 için 6\times0{,}001904=0{,}011423. Hommel drug-8'de daha küçüktür: drug-8'i içeren alt aileler arasında Simes p'si en büyük olan {drug-8, drug-2, drug-4, drug-1, drug-6} ailesidir; Simes =\min(5\times0{,}001904/1,\ 5\times0{,}076126/2,\ \dots)=0{,}009519.
Adım 4 — Tek adımlı yöntemler. drug-8: Bonferroni 8\times0{,}001904=0{,}015230; Šidák 1-(1-0{,}001904)^8=0{,}015129.
Adım 5 — İki aşamalı yöntemler ve Storey. BH'de \alpha=0{,}05 ile 4 ret (r_1=4), \hat m_0=4: TSBH =\tilde p^{\,\text{BH}}\times4/8; drug-8 için 0{,}005077\times0{,}5=0{,}002538. BKY'de \alpha'=0{,}05/1{,}05=0{,}047619 ile yine 4 ret; drug-8 için 0{,}005077\times0{,}5\times1{,}05=0{,}002665. Storey: p>0{,}5 olan tek test drug-6'dır; \hat\pi_0=(1+1)/(8\times0{,}5)=0{,}5; q=0{,}5\times\tilde p^{\,\text{BH}}, bu veride TSBH ile aynı sayıları verir.
Adım 6 — Kararlar. On bir yöntemin tamamı aynı dört testi (drug-3, drug-5, drug-7, drug-8) reddeder. drug-2 (ham p=0{,}076) hiçbir yöntemde anlamlı değildir; en liberal yöntemler (TSBH ve Storey q) bile 0{,}0609 verir.
Şekil 17.1. Sekiz testin ham ve düzeltilmiş p değerleri (log ölçek), ham p'ye göre sıralı. Kesikli çizgi α = 0,05. FWER yöntemleri (Bonferroni, Holm, Hommel) FDR yöntemlerinin (BH) üstünde kalır; BY ikisinin arasındadır.
17.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri pvalues_from_data ve execute çağrılarından alınmıştır (dogrulama/multiple_comparison/merqur_calistir.py); modüldeki p_yuvarla ve round adları yalnız bellekte etkisizleştirilmiştir. Bağımsız Python hesabı her yöntemi tanımından uygular (Hommel için 255 alt kümenin tamamı). R 4.5.3: t.test, p.adjust (bonferroni, holm, hochberg, hommel, BH, BY), Šidák için 1-(1-p)^m, multtest::mt.rawp2adjp (SidakSD = Holm–Šidák, TSBH), BKY için p.adjust("BH") üzerinden elle iki aşama (multtest'in TSBH'si \alpha'=\alpha kullanır ve MerQur'un TSBH'siyle aynıdır), qvalue(p, pi0 = 0.5), pairwise.t.test(pool.sd = TRUE), wilcox.test(exact = FALSE, correct = TRUE). Ölçüt: en büyük mutlak fark \le 10^{-6}.
| Büyüklük (örnek: drug-8 vs Varfarin) | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark (8 test) | Durum |
|---|---|---|---|---|---|
| Welch t | 3,339666 | 3,339666 | 3,339666 | 7,8e−15 | ✓ |
| Ham p (Welch) | 0,001904 | 0,001904 | 0,001904 | 2,2e−15 | ✓ |
| Bonferroni: düzeltilmiş p | 0,015230 | 0,015230 | 0,015230 | 6,9e−17 | ✓ |
| Šidák: düzeltilmiş p | 0,015129 | 0,015129 | 0,015129 | 1,3e−15 | ✓ |
| Holm: düzeltilmiş p | 0,011423 | 0,011423 | 0,011423 | 4,4e−15 | ✓ |
| Hochberg: düzeltilmiş p | 0,011423 | 0,011423 | 0,011423 | 2,2e−15 | ✓ |
| Hommel: düzeltilmiş p | 0,009519 | 0,009519 | 0,009519 | 2,2e−15 | ✓ |
| Benjamini–Hochberg: düzeltilmiş p | 0,005077 | 0,005077 | 0,005077 | 2,2e−15 | ✓ |
| Benjamini–Yekutieli: düzeltilmiş p | 0,013798 | 0,013798 | 0,013798 | 1,1e−16 | ✓ |
| Holm–Šidák: düzeltilmiş p | 0,011369 | 0,011369 | 0,011369 ᵃ | 2,2e−15 | ✓ |
| İki aşamalı BH (TSBH): düzeltilmiş p | 0,002538 | 0,002538 | 0,002538 ᵇ | 1,6e−15 | ✓ |
| BKY iki aşamalı: düzeltilmiş p | 0,002665 | 0,002665 | 0,002665 ᶜ | 1,4e−15 | ✓ |
| Storey q: düzeltilmiş p | 0,002538 | 0,002538 | 0,002538 ᵈ | 1,6e−15 | ✓ |
| Storey \hat\pi_0 | 0,500000 | 0,500000 | 0,500000 | 0,0e+00 | ✓ |
| Ham p, Student t | 0,001889 | 0,001889 | 0,001889 | 2,3e−15 | ✓ |
| Ham p, havuzlanmış SS t | 0,000161 | 0,000161 | 0,000161 | 2,3e−15 | ✓ |
| Ham p, Mann–Whitney U | 0,003054 | 0,003054 | 0,003054 | 3,3e−16 | ✓ |
ᵃ multtest SidakSD. ᵇ multtest TSBH_0.05. ᶜ R'de hazır karşılık yok; p.adjust("BH") ile iki aşama elle. ᵈ qvalue(p, pi0 = 0.5); MerQur'un \hat\pi_0 tanımıyla.
Sonuç: 17 satırın tamamı (her satırda 8 test) ölçütü karşılar; en büyük fark 7{,}8\times10^{-15}'tir.
17.7 Çıktıyı okuma
MerQur'un sonuç metni (kısaltılmış):
══ ÇOKLU KARŞILAŞTIRMA DÜZELTMESİ ══
Test sayısı  : 8
α            : 0.050
Orijinal ham : 4/8 anlamlı
Kaynak       : p'ler veriden üretildi — grup: drug, ölçüm: INR_stability_ratio, ...

── DÜZELTİLMİŞ p-DEĞERLERİ ──   (ilk sütunlar; Sidak, BY ve ek yöntemler kesildi)
Test                    Orijinal       Bonf       Holm       Hoch       Homm         BH
drug-1 vs Varfarin        0.4673    1.0000     0.9346     0.7485     0.7485     0.5340
drug-3 vs Varfarin       <0.0001    0.0003★    0.0002★    0.0002★    0.0002★    0.0001★
drug-8 vs Varfarin        0.0019    0.0152★    0.0114★    0.0114★    0.0095★    0.0051★
TOPLAM ANLAMLI                4/8        4/8        4/8        4/8        4/8        4/8
...
Gerçek H₀ oranı kestirimi π̂₀ = 0.5000
| Satır / Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Test sayısı | Ayrıştırılan p sayısı m | Beklenen sayıyla karşılaştırın; atlanan satır varsa burada görünür. |
| Orijinal ham | p<\alpha olan ham p sayısı | Düzeltme öncesi durum. |
| Kaynak | # satırları (Veriden modunda test ve referans bilgisi) |
Hangi testlerden üretildiğini belgeler. |
| Tablo sütunları | Her yöntemin düzeltilmiş p'si, ★ = ret | p'ler 4 ondalık, 0,0001'in altı "<0.0001". Tam değerler Tablo sekmesindedir. |
| TOPLAM ANLAMLI | Yöntem başına ret sayısı | Yöntemler arası tutarlılık denetimi. |
| HANGİ YÖNTEMİ KULLANMALI? | Sabit öneri listesi | Veriye bağlı değildir; yöntemi çalışma planında seçin. |
| π̂₀ satırları | Storey kestirimi ve +1'siz karşılığı | Yalnız Storey q seçildiğinde. |
| Grafik | Yöntem başına anlamlı test sayısı (yatay çubuk) |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Sekiz yeni antikoagülan, INR kararlılık oranında Varfarin ile Welch t testleriyle karşılaştırıldı; aile bazında hata oranı Holm yöntemiyle denetlendi. drug-5 (t(33{,}93) = 6{,}75, Holm düzeltilmiş p < 0{,}001), drug-3 (t(34{,}73) = 4{,}75, p < 0{,}001), drug-8 (t(37{,}57) = 3{,}34, p = 0{,}011) ve drug-7 (t(36{,}04) = 3{,}21, p = 0{,}014) Varfarin'den anlamlı düzeyde yüksek kararlılık gösterdi; öteki dört ilaçta fark anlamlı değildi (tümü düzeltilmiş p \ge 0{,}30). Benjamini–Hochberg yanlış keşif oranı denetimi aynı dört karşılaştırmayı anlamlı buldu.
17.8 Uzman soruları
S1. Sekiz Welch testi neden Dunnett yerine p-düzeltmesiyle birleştiriliyor?
Dunnett, ortak kontrol ortalamasından gelen pozitif korelasyonu (bu tasarımda 0,5) kesin dağılımla kullanır ve Bonferroni/Holm'dan daha güçlüdür; ama ortak MS_W ve eşit varyans varsayar. Welch testleri her çiftin kendi varyansını kullanır ve ilişkiyi yok sayar; Holm her bağımlılıkta geçerli olduğu için güvenli ama biraz tutucudur. Varyanslar benzer ise ANOVA modülündeki Dunnett (kontrol = Varfarin) daha güçlü seçimdir.
S2. Hommel neden drug-8'de Hochberg'den küçük?
Hommel tüm alt aileleri Simes testiyle sınar; Hochberg ise yalnız "en büyük j p" biçimindeki alt aileleri kullanır. drug-8'i içeren en zor alt aile, iki küçük p'yi (drug-5, drug-3) ve drug-7'yi dışarıda bırakan beşli ailedir; Simes p'si 5\times0{,}001904=0{,}009519'dur. Hochberg'in o test için kullandığı çarpan 6'dır (0{,}011423). Hommel her zaman Hochberg'den güçlü ya da ona eşittir.
S3. BY ile BH arasındaki 2,72 kat fark nereden geliyor?
c_8=1+1/2+\dots+1/8=2{,}717857. BY bu katsayıyla her türlü bağımlılıkta FDR'yi korur; BH ise bağımsızlık ya da PRDS ister. Ortak Varfarin grubuna karşı yapılan testler pozitif bağımlıdır (PRDS koşulu sağlanır); bu durumda BH yeterlidir ve BY gereksiz yere tutucudur.
S4. TSBH ve Storey q bu veride neden aynı?
TSBH çarpanı \hat m_0/m=4/8, Storey çarpanı \hat\pi_0=(1+1)/4=0{,}5'tir; ikisi de BH p'sini 0,5 ile çarpar. Rastlantısal bir eşitliktir: TSBH m_0'ı ret sayısından, Storey p>0{,}5 olan test sayısından kestirir.
S5. İki aşamalı yöntemlerin "düzeltilmiş p"si neden \alpha'ya bağlı?
Birinci aşamadaki ret sayısı r_1, \alpha ile değişir; \hat m_0=m-r_1 ve düzeltilmiş p bu sayıyla çarpılır (17.5.6). Bu yüzden TSBH ve BKY sütunları klasik anlamda "her \alpha için geçerli" düzeltilmiş p değildir; yalnız seçilen \alpha'daki karar yorumlanmalıdır. Rapora "BKY, q = 0{,}05 ile" biçiminde düzeyle birlikte yazılmalıdır.
S6. Storey \hat\pi_0 neden R qvalue'dan farklı?
MerQur Storey, Taylor ve Siegmund (2004) sonlu örneklem biçimini kullanır: kesrin payında +1 terimi vardır. R qvalue klasik biçimi (+1'siz) ve varsayılan olarak \lambda ızgarasında düzgünleştirmeyi kullanır. Küçük m'de fark büyüktür (bu veride 0,50 ve 0,25); m binlerle ölçülünce önemsizleşir. MerQur iki değeri de yazar.
S7. Bir test tanımsız p verdiğinde ne olur?
Veriden modunda tanımsız p 1 yapılır ve bu bir notla yazılır (17.5.1). Örneğin bir kolun ve kontrolün tüm değerleri aynıysa Welch t=0/0'dır; MerQur bu çifti p=1 ile aileye katar. p=1 düzeltmelerin sıralamasına girer ve m'yi bir artırır; sonuç biraz tutuculaşır ama yanlış ret üretmez. Yine de böyle bir çift raporda açıklanmalıdır.
S8. Mann–Whitney p'leri R wilcox.test ile neden farklı olabilir?
MerQur scipy "auto" kuralını kullanır: iki grup da 8'den büyükse ya da bağ varsa süreklilik düzeltmeli normal yaklaşım. R wilcox.test bağsız ve n<50 ise kesin p hesaplar. Bu veride bağ olduğu için iki program da normal yaklaşıma geçer ve 3\times10^{-16} içinde eşleşir. Bağsız küçük örneklemlerde R ile karşılaştırırken exact = FALSE, correct = TRUE verilmelidir.
17.9 Sık hatalar ve tuzaklar
- Ondalık virgüllü değerleri virgülle listelemek.
0,01,0,03gibi bir satır ayırt edilemez ve reddedilir; değerleri;ya da satır başıyla ayırın. - Ayrıştırılamayan satır uyarısını görmezden gelmek.
p = 0.04gibi satırlar aileye girmez ve uyarıda listelenir; "Test sayısı" satırını denetleyin. - Aile tanımını sonradan değiştirmek. Anlamlı çıkmayan testleri listeden çıkarıp yeniden düzeltmek FWER/FDR garantisini bozar.
- İki aşamalı yöntemin p'sini başka \alpha ile yorumlamak. TSBH/BKY p'si seçilen \alpha'ya özgüdür.
- Bağımsızlık varsayan yöntemi her yerde kullanmak. Šidák, Hochberg, Hommel ve BH negatif bağımlılıkta garanti vermez; emin değilseniz Holm (FWER) ya da BY (FDR).
- "HANGİ YÖNTEMİ KULLANMALI?" listesini veri sonucu sanmak. Liste sabittir; yöntem çalışma planında, veriye bakmadan seçilmelidir.
- Referans düzeyini kontrol etmemek. Boş bırakılırsa adında "control/kontrol/placebo" geçen düzey, yoksa verideki ilk düzey referans olur.
- Veriden modunda üretilen p'leri ham p sanmamak. p-kutusundaki değerler düzeltilmemiş p'lerdir; raporda düzeltilmiş sütun kullanılmalıdır.
17.10 Kaynaklar
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Benjamini, Y., Krieger, A. M., & Yekutieli, D. (2006). Adaptive linear step-up procedures that control the false discovery rate. Biometrika, 93(3), 491–507. https://doi.org/10.1093/biomet/93.3.491
- Benjamini, Y., & Yekutieli, D. (2001). The control of the false discovery rate in multiple testing under dependency. The Annals of Statistics, 29(4), 1165–1188. https://doi.org/10.1214/aos/1013699998
- Dunn, O. J. (1961). Multiple comparisons among means. Journal of the American Statistical Association, 56(293), 52–64. https://doi.org/10.1080/01621459.1961.10482090
- Hochberg, Y. (1988). A sharper Bonferroni procedure for multiple tests of significance. Biometrika, 75(4), 800–802. https://doi.org/10.1093/biomet/75.4.800
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70.
- Hommel, G. (1988). A stagewise rejective multiple test procedure based on a modified Bonferroni test. Biometrika, 75(2), 383–386. https://doi.org/10.1093/biomet/75.2.383
- Marcus, R., Peritz, E., & Gabriel, K. R. (1976). On closed testing procedures with special reference to ordered analysis of variance. Biometrika, 63(3), 655–660. https://doi.org/10.1093/biomet/63.3.655
- Šidák, Z. (1967). Rectangular confidence regions for the means of multivariate normal distributions. Journal of the American Statistical Association, 62(318), 626–633. https://doi.org/10.1080/01621459.1967.10482935
- Simes, R. J. (1986). An improved Bonferroni procedure for multiple tests of significance. Biometrika, 73(3), 751–754. https://doi.org/10.1093/biomet/73.3.751
- Storey, J. D. (2002). A direct approach to false discovery rates. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 64(3), 479–498. https://doi.org/10.1111/1467-9868.00346
- Storey, J. D., Taylor, J. E., & Siegmund, D. (2004). Strong control, conservative point estimation and simultaneous conservative consistency of false discovery rates: A unified approach. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 66(1), 187–205. https://doi.org/10.1111/j.1467-9868.2004.00439.x
- Wright, S. P. (1992). Adjusted p-values for simultaneous inference. Biometrics, 48(4), 1005–1013. https://doi.org/10.2307/2532694