75. K-Ortalamalar Kümelemesi
Analiz kimliği: kmeans · Menü adı: K-Ortalamalar Kümelemesi · Panel: gui/panels/analyses/kmeans.py (form 38–123, execute 146–178, gövde metni 236–380) · Motor: ml/clustering.py, Clustering.kmeans (satır 514–682); başlangıç ve iyileştirme _kmeans_best (339–373), _kmeans_hw_refine (248–319); gap _gap_statistic (119–143); PAM _pam (480–509) · Çağrı: stats_panel.py:7711–7744
75.1 Ne işe yarar
K-ortalamalar, n gözlemi önceden sayısı verilen K kümeye böler. Her gözlem, değişken uzayında kendisine en yakın küme merkezine (ortalamasına) atanır; bölüntü, gözlemlerin kendi merkezlerinden uzaklık karelerinin toplamını en küçük yapacak biçimde aranır. Cevapladığı soru şudur: "Bu hastalar, ölçülen özellikler bakımından birbirine benzeyen kaç ve hangi gruplara ayrılır?"
Amaç fonksiyonu (küme-içi kareler toplamı):
- z_i: i. gözlemin dönüştürülmüş (varsayılan z-puanı) değişken vektörü; p boyutlu.
- C_k: k. kümedeki gözlemlerin kümesi; n_k bu kümedeki gözlem sayısı.
- \bar z_k: k. kümenin merkezi (centroid), yani kümedeki gözlemlerin ortalama vektörü.
- \lVert\cdot\rVert^2: Öklid uzaklığının karesi.
Bu bir hipotez testi değildir; H₀ ya da p değeri üretmez. Küme ANOVA tablosundaki p değerleri yalnız betimseldir (75.5.7).
Ne zaman kullanılır?
- Değişkenler sayısal, kümelerin kabaca küresel (her yöne benzer yayılımlı) ve büyüklüklerinin birbirine yakın olduğu düşünülüyorsa.
- K için kuramsal bir beklenti ya da K seçim ölçütlerinden (silüet, gap, dirsek) bir öneri varsa.
- Gözlem sayısı yüzlerle binler arasındaysa: hesap yükü n ile doğrusal artar.
Ne zaman kullanılmaz?
- Küme sayısı hakkında hiçbir ön bilgi yoksa ve iç içe yapı merak ediliyorsa: Hiyerarşik Kümeleme (Bölüm 76).
- Kümeler uzamış, kıvrımlı ya da yoğunlukları çok farklıysa ve gürültü noktaları ayrılmak isteniyorsa: DBSCAN (Bölüm 77).
- Aykırı değerler belirginse: aynı modülde Algoritma: K-medoids (PAM) seçeneği (75.5.8).
- Değişkenler kategorik ya da karışıksa: Gower uzaklığıyla Hiyerarşik Kümeleme.
- Gözlemlerin bilinen bir sınıfı varsa ve amaç bu sınıfı tahmin etmekse: sınıflandırma yöntemleri (lojistik regresyon, diskriminant analizi).
Sık karıştırılan analizler. Hiyerarşik kümeleme bir ağaç üretir ve K ağacın kesildiği yerdir; k-ortalamalar ağaç üretmez, verilen K için doğrudan bölüntü arar. Temel bileşenler analizi (PCA) gözlemleri değil değişkenleri özetler; kümeleme yapmaz, ama kümelerin iki boyutta görülmesi için kullanılır (Grafik: Kümeler (PCA düzlemi)). Gizil sınıf ya da Gauss karışım modelleri olasılık modelidir; k-ortalamalar eşit ve küresel kovaryanslı karışımın "sert atamalı" sınır durumudur.
75.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Sayısal değişkenler | Uzaklık ve ortalama tanımlı olmalı. | Form yalnız sayısal sütun listeler; sayıya çevrilemeyen sütun düşürülür, 3+ düzeyli "kategorik" işaretli sütun kullanılmaz (ml/_preprocessing.py:226–242). |
| Karşılaştırılabilir ölçek | Büyük varyanslı değişken uzaklığa baskın gelmesin. | Varsayılan z-puanı dönüşümü (n-1 paydalı SS). |
| Küresel, benzer büyüklükte kümeler | W ölçütü bu biçimi ödüllendirir. | Denetlenmez; silüet ve PCA grafiği yardımcı olur. |
| K doğru seçilmiş | Algoritma her K için bir bölüntü üretir. | K seçim ölçütleri tablosu, silüet kuralı ve gap istatistiği isteğe bağlıdır. |
| Aykırı değer az | Ortalama aykırı değere duyarlıdır. | Denetlenmez; PAM seçeneği sağlamdır. |
Eksik değer. Varsayılan "Sil (listwise)": seçilen değişkenlerden herhangi birinde eksik olan satır analize girmez (ml/_preprocessing.py:320–322). "Ortalama/Medyan ile doldur" (scikit-learn SimpleImputer) ve "KNN ile doldur" (5 komşu) seçenekleri satır silmeden doldurur (_preprocessing.py:326–347). Künyedeki n, analize fiilen giren satır sayısıdır (stats_panel.py:7700–7701).
Uç durumlar.
- En az \max(K+1,\,3) satır gerekir (
min_rows_for_k,clustering.py:474–477); aksi halde hata. - Tümüyle sabit sütun analizden çıkarılır (
_preprocessing.py:294–304); kalan sütun yoksa hata. - Ayrık nokta sayısı K'dan azsa bazı kümeler boş kalır; "{k} küme istendi ama yalnızca {m} küme dolu" uyarısı yazılır ve silüet/CH yorumlanmamalıdır (
clustering.py:616–619). - Silüet ya da CH tanımsızsa (tek dolu küme) künyede "—" görünür (
clustering.py:616–621,kmeans.py:224–233). - En iyi başlangıç yineleme bütçesi içinde yakınsamazsa uyarı verilir (
clustering.py:620–621).
75.3 Parametreler
Varsayılanlar kmeans.py:38–123 ve add_cluster_q5_rows (kmeans.py:83–105) içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımsız değişkenler | veriye bağlı | Kümelemeye giren sayısal sütunlar (en az 1). | Değişken eklemek/çıkarmak uzay ve bölüntüyü değiştirir. |
| Küme sayısı (K) | 3 | 2–20 arası. | Doğrudan bölüntü; "K seçim ölçütü" Elle değilse yok sayılır. |
| Başlangıç | k-means++ (önerilen) | Lloyd evresinin ilk merkezleri: k-means++ ya da rastgele gözlemler. | Yerel optimumu değiştirebilir; 25 başlangıçla genellikle aynı sonuç. |
| Eksik Veri | Sil (listwise) | 75.2'de. | n ve merkezler değişir. |
| K seçim ölçütü | Elle (yukarıdaki K) | Elle; "Ortalama silüet en yüksek (K=2..10)"; "Gap istatistiği (Tibshirani 2001)". | Seçilen K sonucu tümüyle değiştirir. |
| Rastgele tohum | 42 | Başlangıç tohumlarını ve gap referans verisini üretir. | Aynı tohum aynı sonucu verir. |
| Küme üyeliğini veri setine kaydet | kapalı | KM{K}_CLUSTER ve KM{K}_DIST sütunlarını ekler. |
Yalnız veri setine yazar. |
| Küme başına medyan ve çeyrekler | kapalı | Tablo sekmesine her değişken için medyan, Q1, Q3 (ham ölçek) ekler. | Ek sütunlar. |
| Algoritma | K-means | K-means ya da K-medoids (PAM). | PAM'de merkez gerçek bir gözlemdir (75.5.8). |
| Değişken dönüşümü | z-puanı (varsayılan) | z; Yok (ham veri); Aralık 0–1; En büyük = 1; SS = 1. | Uzaklıklar ve bölüntü değişir. |
| Başlangıç sayısı (nstart) | 25 | Bağımsız başlangıç sayısı; en küçük W seçilir. | Büyük K'da artırmak daha iyi optimum bulabilir (75.6.1). |
| En fazla yineleme | 300 | Her başlangıçta Lloyd + tek nokta taşıma geçişlerinin toplam bütçesi. | Yakınsama bütçeden önceyse etkisiz. |
| K seçim ölçütleri tablosu | kapalı | K = 2..10 için W, silüet, CH tablosu. | Yalnız ek tablo (hesap her durumda yapılır). |
| Grafik | Silüet / dirsek eğrisi | Silüet/dirsek; Kümeler (PCA düzlemi); Gözlem bazlı silüet; 3B küme grafiği. | "Gözlem bazlı silüet" seçilince metne küme başına silüet satırları eklenir. |
Neden "en fazla yineleme" iki evrenin toplamı?
_kmeans_best her başlangıçta önce scikit-learn Lloyd evresini tol=0 ile katı yakınsamaya dek çalıştırır, ardından kalan bütçeyle Hartigan–Wong tarzı tek nokta taşıma iyileştirmesini yapar (clustering.py:356–364). R kmeans(iter.max=) de tek bir bütçe kullanır. Lloyd bütçeyi tüketirse iyileştirme yapılmaz ve uyarı yazılır. Bu yüzden değeri küçültmek, sessizce daha kötü bir yerel optimum değil, açık bir uyarı üretir.
75.4 Tıp örneği
Dosya: english/datasets/Tip/66_kmeans_patient_4kume.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/66_kmeans_hasta_4kume.xlsx). Değişken seçimi VIDEO_SCRIPT_TR.txt #66 bölümünden alınmıştır.
| Değişken | Rol | Tür | Açıklama / özet |
|---|---|---|---|
age |
Bağımsız değişken | sürekli | Yaş (yıl); ortalama 55,70, SS 16,37 |
BMI |
Bağımsız değişken | sürekli | Beden kitle indeksi; ortalama 27,96, SS 4,60 |
systolic_bp |
Bağımsız değişken | sürekli | Sistolik kan basıncı (mmHg); ortalama 135,13, SS 19,89 |
glucose |
Bağımsız değişken | sürekli | Açlık glikozu (mg/dL); ortalama 122,48, SS 37,98 |
patient_id |
kullanılmaz |
n ve eksik değer: 240 hasta, hiçbir sütunda eksik değer yok.
Klinik soru: Yaş, BMI, sistolik basınç ve glikoz birlikte ele alındığında hastalar hangi metabolik fenotiplere ayrılır? Video senaryosu dört küme öngörür.
Seçilen ayarlar: K = 4 (formun varsayılanı 3'tür; senaryo 4 ister), öteki seçenekler arayüz varsayılanında (k-means++, z-puanı, nstart 25, en fazla yineleme 300, tohum 42). Sayısal yürüyüş için ayrıca K seçim ölçütleri tablosu, gözlem bazlı silüet, çeyrekler, silüet ve gap kuralları, PAM ve ham ölçek çalıştırılmıştır.
75.5 Formüller ve hesap adımları
MerQur'un sırası şudur: (1) değişkenleri hazırla ve dönüştür, (2) K = 2..10 için her birinde 25 başlangıçlı en iyi çözümü bul (W, silüet, CH eğrisi), (3) K seçim ölçütü Elle değilse K'yı seç, (4) seçilen K için 25 başlangıçlı son çözümü bul, (5) merkezleri, KT ayrıştırmasını, merkezler arası uzaklıkları, silüeti, CH'yi ve küme ANOVA'sını hesapla.
75.5.1 Değişken dönüşümü
- x_{ij}: i. hastanın j. değişkendeki ham değeri; \bar x_j: değişken ortalaması.
- s_j: örneklem standart sapması (n-1 paydalı); s_j=0 ise 1 alınır (sabit sütun zaten düşürülür).
- z_{ij}: ortalaması 0, SS'si 1 olan dönüştürülmüş değer.
Öteki seçenekler (_scale, clustering.py:188–214): Aralık 0–1: (x-\min)/(\max-\min); En büyük = 1: x/\max|x|; SS = 1: x/s (merkezlemesiz); Yok: ham değer.
Koddaki tercih
z-puanı n-1 paydasıyla hesaplanır (_zscore_n1, clustering.py:217–222). R scale() aynı tanımı kullanır. scikit-learn StandardScaler n paydalıdır; onunla hesaplanan merkezler \sqrt{n/(n-1)} kat farklı olur. z-ölçeğinde toplam KT tam olarak T=(n-1)\,p olur; bu veride 239\times4=956.
75.5.2 Lloyd evresi ve tek nokta taşıma (Hartigan–Wong ölçütü)
Lloyd algoritması iki adımı yineler: (a) her gözlemi en yakın merkeze ata, (b) her merkezi kümesinin ortalamasıyla güncelle. Her iki adım da W'yi artırmaz; atamalar değişmeyince durur. Ancak Lloyd'un durduğu nokta, tek bir gözlemi başka kümeye taşıyarak W'nin düşürülebileceği bir nokta olabilir; çünkü taşıma merkezleri de oynatır. MerQur bu yüzden Lloyd'dan sonra tek nokta taşıma iyileştirmesi uygular (_kmeans_hw_refine, clustering.py:248–319):
- A: i. gözlemin şu anki kümesi; B: aday küme; n_A, n_B küme büyüklükleri.
- İlk terim: i eklendiğinde B kümesinin KT'sindeki artış.
- İkinci terim: i çıkarıldığında A kümesinin KT'sindeki azalış.
- \Delta W_{i:A\to B}<0 ise taşıma W'yi düşürür ve yapılır.
Neden n_B/(n_B+1) ve n_A/(n_A-1) çarpanları?
Bir kümeye nokta eklemek merkezi o noktaya doğru 1/(n_B+1) oranında kaydırır. Kaydırılmış merkeze göre KT artışı \lVert z_i-\bar z_B\rVert^2 değil, onun n_B/(n_B+1) katıdır. Nokta çıkarırken merkez noktadan uzaklaşır ve azalış n_A/(n_A-1) kat büyür. Lloyd yalnız \lVert z_i-\bar z_B\rVert^2<\lVert z_i-\bar z_A\rVert^2 karşılaştırmasını yapar ve bu çarpanları görmez. Hartigan ve Wong (1979) algoritmasının "optimal transfer" adımı bu ölçütü kullanır; R kmeans() varsayılanı da budur.
Koddaki tercih
MerQur, R'nin Fortran Hartigan–Wong kodunu birebir uygulamaz; scikit-learn Lloyd çözümünü başlangıç alıp ölçütü tek nokta düzeyinde uygular. Her geçişte önce toplu Lloyd ataması denenir (clustering.py:277–283), sonra kazancı en büyük adaylardan başlayarak taşımalar yapılır. Sonuç, R ile aynı yerel optimum ölçütünü sağlar; ama hangi yerel optimuma varıldığı başlangıca bağlıdır. Çıktıdaki "Yineleme sayısı" yalnız Lloyd evresinin yineleme sayısıdır (clustering.py:358, 365); taşıma geçişleri sayılmaz.
75.5.3 Çok başlangıç ve tohum
Başlangıç tohumları np.random.RandomState(tohum).randint(0, 2^31−1, size=nstart) ile üretilir (clustering.py:347); her başlangıç kendi tohumuyla k-means++ (ya da rastgele) merkez seçer. Tohum sabitken sonuç belirlenimcidir. Çıktıdaki "En iyi çözüm … {m} başlangıcın {n} tanesinde bulundu" satırı, en küçük W'ye 10^{-8} göreli toleransla ulaşan başlangıç sayısıdır (clustering.py:370–372). Bu sayının nstart'a yakın olması, bulunan çözümün kararlı olduğunu gösterir.
Neden varsayılan 25 başlangıç?
k-ortalamalar amaç fonksiyonu çok tepelidir; tek başlangıç kötü bir yerel optimumda kalabilir. R kmeans belgesi nstart = 25 gibi değerler önerir. MerQur'un varsayılanı 25 başlangıç ve tek nokta taşımadır; doğrulamada USArrests verisinde K = 3 için bu ayarla bilinen en iyi W=78{,}323 bulunur (10 başlangıçta 78,484'te kalınabilir). Bu bölümün verisinde K = 4 için 25 başlangıcın 25'i aynı çözüme ulaşır; K = 7, 9 ve 10'da 25 başlangıç en iyi bilinen çözümü bulamaz (75.6.1).
75.5.4 Kareler toplamı ayrıştırması
- T: toplam KT; W_k: k. kümenin küme-içi KT'si; W=\sum_k W_k.
- B: kümeler arası KT; MerQur B=T-W olarak hesaplar (
clustering.py:661). - "arası/toplam" yüzdesi B/T'dir; tek boyutta ANOVA'daki \eta^2'nin çok değişkenli karşılığıdır.
Merkezler arası uzaklık tablosu \lVert\bar z_k-\bar z_l\rVert değerleridir (clustering.py:639–640). Kaydedilen KM{K}_DIST sütunu, her gözlemin kendi merkezine Öklid uzaklığıdır (clustering.py:636).
75.5.5 Silüet
- d(i,j): dönüştürülmüş uzayda Öklid uzaklığı (kare değil).
- a(i): i'nin kendi kümesindeki öteki gözlemlere ortalama uzaklığı.
- b(i): i'nin en yakın komşu kümeye ortalama uzaklığı.
- s(i)\in[-1,\,1]: 1'e yakın iyi yerleşmiş, 0 civarı iki küme sınırında, negatif yanlış kümede gibi duran gözlem. Tek gözlemli kümede s(i)=0.
- Ortalama silüet \bar s=\frac1n\sum_i s(i); künyede "Silüet" olarak yazılır.
Hesap scikit-learn silhouette_score ile yapılır (clustering.py:623); tanım Rousseeuw (1987) ve R cluster::silhouette ile aynıdır.
75.5.6 Calinski–Harabasz (pseudo-F)
Büyük CH, kümelerin birbirinden uzak ve kendi içlerinde sıkı olduğunu gösterir. Adındaki "F", tek yönlü ANOVA F oranıyla aynı biçimden gelir; ama kümeler veriden seçildiği için F dağılımına uymaz.
75.5.7 Küme ANOVA tablosu
Her değişken için, kümeler grup kabul edilerek tek yönlü ANOVA yapılır (_anova_by_cluster, clustering.py:93–116):
Tutarsızlığa dikkat
ANOVA ham ölçekte yapılır; MS(k) ve MS(e) bu yüzden özgün birimdedir. F, p ve R^2 doğrusal dönüşümle değişmez, dolayısıyla z ölçeğiyle aynıdır. p değerleri betimseldir: kümeler tam da bu farkları büyütmek için seçildiğinden H₀ altında F dağılımı geçerli değildir. MerQur bunu tablonun altına yazar.
75.5.8 K-medoids (PAM)
PAM, merkez olarak bir gözlem (medoid) seçer ve uzaklıkların (karesiz) ortalamasını en küçük yapar (_pam, clustering.py:480–509):
BUILD evresi önce tüm uzaklıkların toplamını en küçük yapan gözlemi, sonra amaçtaki azalışı en büyük olanları ekler. SWAP evresi, (medoid, medoid olmayan) takaslarından amaçtaki azalışı en büyük olanı yapar; azaltan takas kalmayınca durur. Amaç değeri R cluster::pam()$objective["swap"] ile aynı ölçektedir (ortalama uzaklık). PAM'de ayrıca "medoide göre küme-içi KT" verilir; bu bir KT ayrıştırması değildir, çünkü medoid küme ortalaması değildir (MerQur bu notu çıktıya yazar). Silüet ve CH etiketlerden, ortalamalarla hesaplanır.
75.5.9 K seçimi: silüet kuralı ve gap istatistiği
Silüet kuralı: K = 2..10 içinde ortalama silüeti en büyük olan K (clustering.py:594–595).
Gap istatistiği (Tibshirani, Walther ve Hastie 2001; clustering.py:119–152):
- W_k: gözlenen veride k kümeli çözümün küme-içi KT'si (k=1'de T).
- W_k^{*(b)}: b. referans veride aynı değer. Referans veri, z-ölçekli verinin her değişkeninin [en küçük, en büyük] aralığında düzgün dağılımdan çekilir (sınırlayıcı kutu).
- B=50 (sabit); \text{sd}_k: B referans \log W_k^* değerinin n-1 paydalı SS'si.
- \hat K: Tibshirani (2001) kuralı; R
cluster::maxSE(method = "Tibs2001SEmax").
Tutarsızlığa dikkat
Gap hesabında hem gözlenen hem referans veride W_k, scikit-learn KMeans(n_init=10) ile yalnız Lloyd evresiyle bulunur (clustering.py:127–131); ana çözümdeki 25 başlangıç ve tek nokta taşıma burada kullanılmaz. Bu veride gap tablosundaki \log W_6=4{,}742258 (W=114{,}6929), K tablosundaki W_6=114{,}5911'den büyüktür. Referans verilerde de daha zayıf yerel arama E^*[\log W]'yi biraz büyütür; Gap(4) MerQur'da 1,6649, en iyi bilinen W'lerle 1,6614'tür. Seçilen K değişmez. Ayrıca \hat K=1 çıkarsa (veride küme yapısına kanıt yok) MerQur en az iki küme gerektiği için K=2 kullanır ve bunu uyarıyla yazar (clustering.py:592–593).
Koddaki tercih
R cluster::clusGap varsayılanı spaceH0 = "scaledPCA" (referans kutu temel bileşen eksenlerinde) ve d.power = 1'dir (kareler değil uzaklıklar). MerQur spaceH0 = "original" ve kare uzaklığa karşılık gelen W (yani d.power = 2) kullanır; ayrıca B = 50 sabittir (R varsayılanı 100). Aynı veride clusGap(…, d.power = 2, spaceH0 = "original", B = 50) kendi çekilişleriyle de \hat K=4 verir; R varsayılanlarıyla da \hat K=4 çıkar, ama Gap değerleri tümüyle farklı ölçektedir (Gap(4) = 0,52).
75.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Aşağıdaki değerler dogrulama/kmeans/elle_hesap.py ile, MerQur ve scikit-learn çağrılmadan numpy ile hesaplanmıştır. Bağımsız hesap 400 rastgele başlangıçtan Lloyd + tek nokta taşıma çalıştırır; K = 4'te bulduğu bölüntü MerQur'unkiyle gözlem gözlem aynıdır.
Adım 1 — z-puanı. 1. hasta: yaş 30, BMI 22,52, sistolik 104, glikoz 86.
Adım 2 — Toplam KT. z ölçeğinde her sütunun KT'si n-1=239'dur; T=239\times4=956.
Adım 3 — Nihai merkezler (z ölçeği).
| Küme | n_k | yaş | BMI | sistolik | glikoz | W_k |
|---|---|---|---|---|---|---|
| 0 | 59 | −0,3284 | 0,0083 | −0,2768 | −0,6589 | 29,1138 |
| 1 | 60 | 1,1563 | 0,9402 | 1,1421 | 1,4895 | 36,6671 |
| 2 | 61 | −1,3463 | −1,4008 | −1,3304 | −0,9481 | 34,8937 |
| 3 | 60 | 0,5354 | 0,4758 | 0,4827 | 0,1224 | 35,4663 |
Adım 4 — 1. hastanın ataması. Dört merkeze uzaklık kareleri:
En küçüğü 2. kümededir; hasta 2. kümeye atanır. Hiçbir hasta için \Delta W_{i:A\to B}<0 olan taşıma kalmamıştır (yerel optimum).
Adım 5 — KT ayrıştırması ve CH.
Adım 6 — 1. hastanın silüeti. Kendi kümesindeki (2) öteki 60 hastaya ortalama uzaklık a=0{,}816744. Öteki kümelere ortalama uzaklıklar 0: 2,256450; 1: 5,074884; 3: 3,604713; en küçüğü b=2{,}256450:
Tüm hastaların ortalaması \bar s=0{,}442125. Küme başına ortalama silüet: 0,4323; 0,4562; 0,5305; 0,3478. 3. kümede bir hasta negatif silüetlidir.
Adım 7 — Küme ANOVA (yaş). Ham ölçekte kümeler arası KT 57468{,}8814 (sd 3), küme-içi KT 6607{,}5185 (sd 236):
Dört değişkenin R^2'leri: yaş 0,897; BMI 0,780; sistolik 0,857; glikoz 0,897. Kümeleri en çok yaş ve glikoz ayırır.
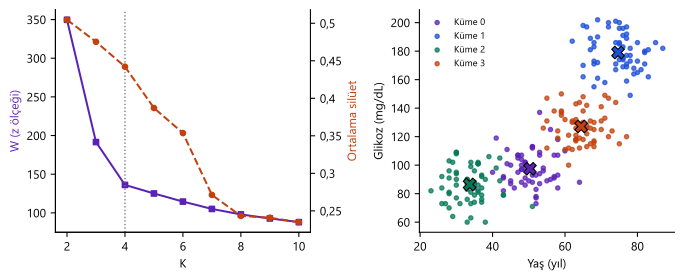
Şekil 75.1. Solda K = 2..10 için en iyi bilinen toplam küme-içi KT (dirsek, mor) ve ortalama silüet (turuncu); sağda K = 4 kümeleri yaş–glikoz düzleminde, büyük X işaretleri ham küme ortalamaları.
Adım 8 — K seçimi. K tablosu (MerQur çıktısı; K = 7, 9, 10 için 75.6.1'e bakın):
| K | W | Silüet | CH |
|---|---|---|---|
| 2 | 349,6999 | 0,5046 | 412,64 |
| 3 | 191,6069 | 0,4753 | 472,74 |
| 4 | 136,1409 | 0,4421 | 473,74 |
| 5 | 125,0807 | 0,3871 | 390,28 |
| 6 | 114,5911 | 0,3537 | 343,64 |
W, K = 4'ten sonra belirgin biçimde yavaş azalır (dirsek), CH K = 4'te en büyüktür ve gap kuralı K = 4'ü seçer. Silüet kuralı ise K = 2 seçer: dört küme yaş ekseni boyunca sıralanmış bir zincir oluşturduğundan iki büyük yarı en yüksek ortalama silüeti verir. Silüet kuralı tek başına bırakılırsa bu veride ikiye bölünmüş, klinik olarak daha az bilgi veren bir çözüm raporlanır.
Adım 9 — Gap. MerQur gap tablosu (B=50, tohum 42): Gap(3) = 1,4754, Gap(4) = 1,6649, Gap(5) = 1,6176, SE(5) = 0,0318. \text{Gap}(3)<\text{Gap}(4)-\text{SE}(4); \text{Gap}(4)=1{,}6649\ge1{,}6176-0{,}0318 olduğu için \hat K=4.
Adım 10 — PAM. Medoidler (1 tabanlı satır) 214, 96, 221, 43; ortalama uzaklık 0,724641. Bağımsız hesap bu medoidlerle 4 × 236 olası takasın hepsini denemiştir; en iyi takas amacı +4{,}8\times10^{-4} artırır, yani çözüm takas-yerel optimumdur ve R pam() ile aynı medoidleri verir. Bu veride PAM bölüntüsü k-ortalamalar bölüntüsüyle birebir aynıdır.
75.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() çıktısından alınmıştır (dogrulama/kmeans/merqur_calistir.py); ml.clustering içindeki round() yalnız bellekte etkisizleştirilmiştir. Python sütunu numpy ile bağımsız hesaptır (Lloyd + tek nokta taşıma, 400 başlangıç; PAM için takas denetimi). R: 4.5.3, kmeans(nstart = 500) (Hartigan–Wong), cluster::silhouette, cluster::pam, aov, quantile(type = 7); gap için Python'un ürettiği aynı 50 referans veri üzerinde kmeans(nstart = 25). "Aynı yerel arama" satırlarında Python sütunu, MerQur'un gap içinde çağırdığı scikit-learn yordamının aynı referans verilerde yeniden çalıştırılmasıdır (gap_sklearn_aciklama.py). Ölçüt: en büyük mutlak fark \le10^{-6} (değer 1'den büyükse göreli).
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| K = 4: toplam küme-içi KT W (z) | 136,140854 | 136,140854 | 136,140854 | 2,8e−13 | ✓ |
| K = 4: küme başına KT (4) | 29,113791 | 29,113791 | 29,113791 | 6,4e−14 | ✓ |
| K = 4: toplam KT (z) = (n − 1)·p | 956 | 956 | 956 | 0,0e+00 | ✓ |
| K = 4: kümeler arası KT | 819,859146 | 819,859146 | 819,859146 | 3,4e−13 | ✓ |
| K = 4: bölüntü (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ (Python: MerQur'a göre) |
| K = 4: küme büyüklükleri (4) | 59 | 59 | 59 | 0,0e+00 | ✓ |
| K = 4: nihai merkezler, z (4 × 4) | −0,328449 | −0,328449 | −0,328449 | 4,9e−15 | ✓ |
| K = 4: merkezler arası uzaklık (4 × 4) | 0 | 0 | 0 | 4,0e−15 | ✓ |
| K = 4: kendi merkezine uzaklık (240) | 0,390788 | 0,390788 | 0,390788 | 4,9e−15 | ✓ |
| K = 4: ham küme ortalamaları (4 × 4) | 50,322034 | 50,322034 | 50,322034 | 4,4e−11 | ✓ (10 anlamlı basamak) |
| K = 4: ortalama silüet | 0,442125 | 0,442125 | 0,442125 | 2,8e−16 | ✓ |
| K = 4: gözlem bazlı silüet (240) | 0,638040 | 0,638040 | 0,638040 | 9,4e−16 | ✓ |
| K = 4: küme başına ortalama silüet (4) | 0,432330 | 0,432330 | 0,432330 | 5,0e−16 | ✓ |
| K = 4: Calinski–Harabasz | 473,741601 | 473,741601 | 473,741601 | 2,3e−13 | ✓ |
| Küme ANOVA: MS(küme) (4 değişken) | 19156,293829 | 19156,293829 | 19156,293829 | 1,2e−10 | ✓ |
| Küme ANOVA: MS(hata) (4 değişken) | 27,997960 | 27,997960 | 27,997960 | 5,7e−14 | ✓ |
| Küme ANOVA: F (4 değişken) | 684,203205 | 684,203205 | 684,203205 | 2,6e−12 | ✓ |
| Küme ANOVA: p (4 değişken) | 4,3702·10−116 | 4,3702·10−116 | 4,3702·10−116 | 5,0e−90 | ✓ |
| Küme ANOVA: R² (4 değişken) | 0,896881 | 0,896881 | 0,896881 | 3,3e−16 | ✓ |
| Küme başına Q1, medyan, Q3 (tür 7; 4 × 4 × 3) | 47 | 47 | 47 | 3,6e−15 | ✓ |
| K tablosu W, K = 2–6, 8 | 349,699873 | 349,699873 | 349,699873 | 4,5e−13 | ✓ |
| K tablosu W, K = 7, 9, 10 | 105,153334 | 105,079697 | 105,079697 | 3,8e−01 | ≠ yerel optimum (75.6.1) |
| K tablosu silüet, K = 2–6, 8 | 0,504587 | 0,504587 | 0,504587 | 4,4e−16 | ✓ |
| K tablosu silüet, K = 7, 9, 10 | 0,269020 | 0,271275 | 0,271275 | 2,3e−03 | ≠ yerel optimum (75.6.1) |
| K tablosu CH, K = 2–6, 8 | 412,637926 | 412,637926 | 412,637926 | 1,1e−12 | ✓ |
| K tablosu CH, K = 7, 9, 10 | 314,219349 | 314,466758 | 314,466758 | 1,2e+00 | ≠ yerel optimum (75.6.1) |
| Silüet ölçütüyle seçilen K | 2 | 2 | 2 | 0,0e+00 | ✓ |
| Dönüşüm yok: W | 54330,936296 | 54330,936296 | 54330,936296 | 2,2e−11 | ✓ |
| Dönüşüm yok: silüet | 0,474419 | 0,474419 | 0,474419 | 2,2e−16 | ✓ |
| Dönüşüm yok: CH | 657,462250 | 657,462250 | 657,462250 | 2,3e−13 | ✓ |
| PAM: medoid satırları (0 tabanlı, sıralı) | 42 | 42 | 42 | 0,0e+00 | ✓ (Python: takas denetimi) |
| PAM: amaç (ortalama uzaklık) | 0,724641 | 0,724641 | 0,724641 | 5,6e−16 | ✓ |
| PAM: medoide göre küme-içi KT (4) | 30,619312 | 30,619312 | — | 0,0e+00 | ✓ (R'de karşılığı yok) |
| PAM: ortalama silüet | 0,442125 | 0,442125 | 0,442125 | 2,8e−16 | ✓ |
| PAM: bölüntü (farklı atama) | 0 | 0 | 0 | 0,0e+00 | ✓ |
| Gap: gözlenen log W, k = 1–5 | 6,862758 | 6,862758 | 6,862758 | 4,4e−15 | ✓ |
| Gap: gözlenen log W, k = 6–10 | 4,742258 | 4,741370 | 4,741370 | 1,9e−02 | ≠ yerel optimum (75.6.1) |
| Gap: gözlenen log W (k = 1–10), aynı yerel arama | 6,862758 | 6,862758 | — | 0,0e+00 | ✓ (Python: scikit-learn replikası) |
| Gap: E*[log W] (k = 1–10), aynı yerel arama | 7,171543 | 7,171543 | — | 0,0e+00 | ✓ (Python: scikit-learn replikası) |
| Gap: Gap(k) (k = 1–10), aynı yerel arama | 0,308785 | 0,308785 | — | 0,0e+00 | ✓ (Python: scikit-learn replikası) |
| Gap: SE(k) (k = 1–10), aynı yerel arama | 0,030022 | 0,030022 | — | 0,0e+00 | ✓ (Python: scikit-learn replikası) |
| Gap: Gap(k), en iyi bilinen W ile | 0,308785 | 0,308785 | 0,308785 | 8,1e−03 | ≠ yerel optimum (75.6.1) |
| Gap: seçilen K (Tibshirani kuralı) | 4 | 4 | 4 | 0,0e+00 | ✓ |
Sonuç: 43 satırın 38'i ölçütü karşılar. Beş satırdaki farkın nedeni hesap hatası değil yerel optimumdur. (i) K tablosunda K = 7, 9 ve 10 için 25 başlangıç en iyi çözümü bulamaz: W_7 = 105,1533 (en iyi bilinen 105,0797), W_9 = 93,0130 (92,7738), W_{10} = 88,3712 (87,9891); silüet ve CH bu satırlarda buna bağlı olarak farklıdır. Bu üç değer için bağımsız Python (400 başlangıç) ve R (500 başlangıç) de K = 10'da kendi aralarında 2\times10^{-3} farklıdır; buluşsal arama küresel optimumu garanti etmez. (ii) Gap hesabındaki yalnız Lloyd, 10 başlangıçlı arama (75.5.9) gözlenen veride K ≥ 6, referans verilerde birçok K için daha yüksek W bulur; MerQur değerleri scikit-learn replikasıyla 0 farkla eşleşir. Seçilen K üç kaynakta da 4'tür. Değerlendirilen kısımda (K = 4 çözümü, ANOVA, PAM, ham ölçek, silüet ve CH) tüm farklar 10^{-10}'un altındadır.
75.7 Çıktıyı okuma
MerQur'un sonuç metni (K = 4, öteki ayarlar varsayılan; kısaltılmış):
K-Means Clustering | n = 240 | K: 4 | Başlangıç: k-means++ | Silüet: 0.4421
Nihai küme merkezleri (z ölçeği; ham ortalamalar Tablo sekmesinde):
        age     BMI  systolic_bp  glucose
  0 -0.3284  0.0083      -0.2768  -0.6589
  1  1.1563  0.9402       1.1421   1.4895
  2 -1.3463 -1.4008      -1.3304  -0.9481
  3  0.5354  0.4758       0.4827   0.1224
Küme-içi kareler toplamı (z):
  Küme 0: 29.1138
  ...
  Toplam küme-içi KT = 136.1409, kümeler arası KT = 819.8591, toplam KT = 956.0000 → arası/toplam = %85.8
  Yineleme sayısı (en iyi başlangıç) = 7
  En iyi çözüm (en küçük küme-içi KT) 25 başlangıcın 25 tanesinde bulundu (...)
Nihai merkezler arası Öklid uzaklıkları (z):
  ...
Küme ANOVA tablosu (değişken başına):
  Değişken                    MS(k)   df        MS(e)    df          F        p     R²
  age                    19156.2938    3      27.9980   236    684.203   < .001  0.897
  BMI                     1314.7124    3       4.7262   236    278.174   < .001  0.780
  ...
[Tablo]
 Küme  n    %  age_ort  BMI_ort  systolic_bp_ort  glucose_ort
    0 59 24.6  50.3220  27.9998         129.6271      97.4576
    1 60 25.0  74.6333  32.2877         157.8500     179.0500
    2 61 25.4  33.6557  21.5169         108.6721      86.4754
    3 60 25.0  64.4667  30.1508         144.7333     127.1333
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Künye "Silüet" | Ortalama silüet \bar s | 0,44: ayrışma var ama kümeler birbirine dokunuyor (Kaufman–Rousseeuw ölçeğinde 0,26–0,50 "zayıf yapı"). |
| Nihai küme merkezleri | Dönüştürülmüş ölçekte merkezler | Değişkenler arası karşılaştırma için; klinik yorum Tablo sekmesindeki ham ortalamalarla yapılır. |
| Küme numarası | 0'dan başlayan etiket | Numaralar keyfidir; tohum ya da başlangıç değişince numaralar değişebilir, bölüntü değişmez. |
| Küme-içi KT, arası/toplam | 75.5.4 | %85,8: z uzayındaki toplam yayılımın bu oranı kümeler arası farktan gelir. |
| Yineleme sayısı | En iyi başlangıçta Lloyd yinelemesi | Taşıma geçişleri sayılmaz. |
| En iyi çözüm … n tanesinde | Kararlılık göstergesi | 25/25: çözüm başlangıca duyarlı değil. Küçük oran, nstart'ın artırılması gerektiğini düşündürür. |
| Küme ANOVA | Değişken başına F, R^2 | Hangi değişkenin kümeleri ayırdığını gösterir; p betimseldir (alttaki not). |
| Uyarılar (varsa) | Boş küme; yakınsamama | Koşullar: clustering.py:617–621. |
| Tablo sekmesi | n, %, ham ortalamalar; istenirse medyan, Q1, Q3 | Fenotip adlandırması buradan yapılır. Başlıklar arayüz dilinde görünür (ör. "Küme", "age_ort"; hiyerarşik ve DBSCAN'le aynı). |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Yaş, BMI, sistolik kan basıncı ve açlık glikozu z-puanına dönüştürüldükten sonra 240 hasta k-ortalamalar yöntemiyle (25 başlangıç, Hartigan–Wong ölçütü) dört kümeye ayrıldı. Küme sayısı dirsek ölçütü, Calinski–Harabasz indeksi (CH = 473,74) ve gap istatistiğiyle (Gap(4) = 1,66, SE = 0,03) birlikte belirlendi. Kümeler toplam değişkenliğin %85,8'ini açıkladı; ortalama silüet genişliği 0,44'tür. Kümeler genç-normal metabolik (n = 61; yaş ort. 33,7, glikoz 86,5 mg/dL), orta yaş-normoglisemik (n = 59; 50,3 yıl, 97,5 mg/dL), ileri orta yaş-sınırda (n = 60; 64,5 yıl, 127,1 mg/dL) ve yaşlı-hiperglisemik (n = 60; 74,6 yıl, 179,1 mg/dL) olarak adlandırıldı.
75.8 Uzman soruları
S1. R `kmeans()` ile aynı sonucu verir mi? Algoritma Hartigan–Wong mu?
Ölçüt olarak evet: MerQur her başlangıçta Lloyd çözümünü Hartigan–Wong "optimal transfer" ölçütüyle (75.5.2) taşıma kalmayana dek iyileştirir. Uygulama olarak hayır: R'nin AS 136 Fortran kodu ("quick transfer" adımı dahil) kullanılmaz ve başlangıçlar scikit-learn k-means++ ile üretilir. Bu veride K ≤ 6 ve K = 8'de R (nstart = 500) ile 10^{-12} düzeyinde aynı W, K = 4'te gözlem gözlem aynı bölüntü elde edilir; K = 7, 9, 10'da MerQur'un 25 başlangıcı daha kötü bir yerel optimumda kalır.
S2. z-puanı neden n-1 paydalı? Sonucu değiştirir mi?
Payda değişkenleri aynı oranda (\sqrt{n/(n-1)}) ölçeklediği için bölüntü değişmez; merkezler, KT'ler ve uzaklıklar ölçek kadar değişir. MerQur R scale() ile aynı tanımı kullanır; merkez ve KT tabloları bu yüzden R çıktısıyla doğrudan karşılaştırılabilir. z ölçeğinde T=(n-1)p kontrolü bu tanımın işaretidir.
S3. Silüet kuralı K = 2, gap kuralı K = 4 seçti. Hangisine güvenmeliyim?
İkisi farklı şey ölçer. Silüet, her gözlemin kendi kümesine en yakın komşu kümeye göre ne kadar iyi oturduğunu ölçer; zincir gibi dizilmiş kümelerde iki büyük parça yüksek silüet verir. Gap, W'nin yapısız (düzgün) veriye göre ne kadar hızlı düştüğünü ölçer. Bu veride dirsek, CH ve gap K = 4'te birleşir; senaryo da dört fenotip öngörür. Rapor birden çok ölçütü ve kuramsal gerekçeyi birlikte vermelidir (Milligan ve Cooper 1985).
S4. Gap değerleri R `clusGap` çıktısından neden farklı?
Üç neden var: (i) MerQur d.power = 2 karşılığı W (kare uzaklık KT'si) ve spaceH0 = "original" kullanır; R varsayılanı d.power = 1 ve "scaledPCA"dır. (ii) B = 50 sabittir. (iii) MerQur gap içinde yalnız Lloyd, 10 başlangıçlı arama kullanır (75.5.9). R'de clusGap(x, kmeans, K.max = 10, B = 50, d.power = 2, spaceH0 = "original") kullanılırsa değerler aynı ölçeğe gelir (bu veride Gap(4) = 1,654), ama referans çekilişleri farklı olduğu için tam eşleşme beklenmez.
S5. Küme ANOVA'sının p değerleri neden "betimsel"?
Bölüntü W'yi en küçük, dolayısıyla değişken başına kümeler arası KT'yi büyük yapacak biçimde seçilmiştir. Rastgele bölüntü varsayan F dağılımı bu durumda geçerli değildir; p sistematik olarak çok küçük çıkar. Tablo, hangi değişkenin ayrışmaya ne kadar katkı verdiğini (F ya da R^2 sıralaması) görmek için kullanılır.
S6. İki hastanın değerleri tamamen aynıysa ve K ayrık nokta sayısından büyükse ne olur?
Bazı kümeler boş kalabilir. MerQur dolu küme sayısını K ile karşılaştırır ve "… yalnızca {m} küme dolu" uyarısı yazar (clustering.py:616–619); merkez tablosunda boş kümenin satırı NaN olur. Silüet ve CH tanımsızsa künyede "—" görünür. Tek nokta taşıma, boş küme oluştuğunda durur (clustering.py:268–269).
S7. PAM neden "Başlangıç: k-means++" yazıyor?
Künye ek alanları formdaki başlangıç seçimini olduğu gibi yazar (kmeans.py:211–221). PAM'de bu alan yalnız formun durumunu gösterir: BUILD evresi belirlenimcidir ve başlangıç seçeneğini, nstart ve en fazla yineleme değerlerini kullanmaz. PAM çözümünü raporlarken bu üç alan yazılmaz.
S8. "Gözlem bazlı silüet" ve "K seçim ölçütleri tablosu" seçilmezse bu değerler hesaplanmıyor mu?
K = 2..10 için W, silüet ve CH her çalıştırmada hesaplanır (clustering.py:570–586), çünkü Grafik sekmesindeki silüet/dirsek eğrisi bunları kullanır; kutu yalnız tabloyu metne ekler. Gözlem bazlı silüet ise yalnız ilgili grafik seçildiğinde hesaplanır (clustering.py:672). Büyük n'de 9 × 25 başlangıçlık bu ön tarama çalışma süresinin çoğunu oluşturur.
75.9 Sık hatalar ve tuzaklar
- Ölçeklemeden kümelemek. "Yok (ham veri)" seçilirse glikoz (SS 38) ve sistolik basınç (SS 20) uzaklığa BMI'dan (SS 4,6) çok daha fazla katkı verir. Bu veride ham ölçek, glikozun baskın olduğu farklı bir bölüntü üretir (ortalama silüet 0,474, glikoz R^2 = 0,908).
- Küme numarasına anlam yüklemek. "Küme 0" ile "Küme 1" arasında sıra yoktur; numaralar tohum ve başlangıca bağlıdır.
- Merkez tablosunu ham değer sanmak. Metindeki merkezler z ölçeğindedir; klinik değerler Tablo sekmesindedir.
- Tek ölçütle K seçmek. Silüet kuralı bu veride K = 2 seçer. Dirsek, CH, gap ve konu bilgisi birlikte değerlendirilmelidir.
- ANOVA p değerini kümelerin "anlamlı" olduğu kanıtı saymak. p betimseldir (75.5.7).
- Formun varsayılan K'sını kabul etmek. Varsayılan 3'tür; senaryodaki ya da ölçütlerin önerdiği K elle girilmelidir.
- Büyük K'da nstart'ı düşük bırakmak. K ≥ 7'de 25 başlangıç bu veride bile en iyi çözümü bulamaz; "En iyi çözüm … n tanesinde" satırı 25'ten çok küçükse nstart artırılmalıdır.
- Kümelerin gerçekliğini varsaymak. K-ortalamalar yapısız veride de K küme üretir. Silüetin 0,25'in altında olması belirgin bir yapı olmadığını düşündürür.
75.10 Kaynaklar
- Caliński, T., & Harabasz, J. (1974). A dendrite method for cluster analysis. Communications in Statistics, 3(1), 1–27. https://doi.org/10.1080/03610927408827101
- Hartigan, J. A., & Wong, M. A. (1979). Algorithm AS 136: A K-means clustering algorithm. Applied Statistics, 28(1), 100–108. https://doi.org/10.2307/2346830
- Jain, A. K. (2010). Data clustering: 50 years beyond K-means. Pattern Recognition Letters, 31(8), 651–666. https://doi.org/10.1016/j.patrec.2009.09.011
- Kaufman, L., & Rousseeuw, P. J. (1990). Finding groups in data: An introduction to cluster analysis. Wiley. https://doi.org/10.1002/9780470316801
- Lloyd, S. (1982). Least squares quantization in PCM. IEEE Transactions on Information Theory, 28(2), 129–137. https://doi.org/10.1109/TIT.1982.1056489
- MacQueen, J. (1967). Some methods for classification and analysis of multivariate observations. L. M. Le Cam ve J. Neyman (Ed.), Proceedings of the Fifth Berkeley Symposium on Mathematical Statistics and Probability içinde (Cilt 1, ss. 281–297). University of California Press.
- Milligan, G. W., & Cooper, M. C. (1985). An examination of procedures for determining the number of clusters in a data set. Psychometrika, 50(2), 159–179. https://doi.org/10.1007/BF02294245
- Rousseeuw, P. J. (1987). Silhouettes: A graphical aid to the interpretation and validation of cluster analysis. Journal of Computational and Applied Mathematics, 20, 53–65. https://doi.org/10.1016/0377-0427(87)90125-7
- Steinley, D. (2006). K-means clustering: A half-century synthesis. British Journal of Mathematical and Statistical Psychology, 59(1), 1–34. https://doi.org/10.1348/000711005X48266
- Tibshirani, R., Walther, G., & Hastie, T. (2001). Estimating the number of clusters in a data set via the gap statistic. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 63(2), 411–423. https://doi.org/10.1111/1467-9868.00293