111. Koşullu Lojit (Seçim Modeli)
Analiz kimliği: conditional_logit · Menü adı: Koşullu Lojit (Seçim Modeli) · Panel: gui/panels/analyses/conditional_logit_panel.py · Motor: stats/conditional_logit.py, run_conditional_logit (satır 134–445); ek terimler ve sağlam SH panelde _expand (164–217) ve _post (220–266)
111.1 Ne işe yarar
Koşullu lojit (McFadden 1974), bir karar vericinin birkaç seçenek arasından birini seçtiği durumları modeller. Seçeneğin özellikleri (süre, maliyet, uzaklık) seçilme olasılığını nasıl değiştirir? Örnekte her hasta dört tedavi seçeneği arasından birini seçer; soru şudur: "Tedavi süresi bir ay uzayınca, diğer özellikler sabitken, o tedavinin seçilme odds'u kaç kat değişir?"
Her seçim kümesi i ve seçenek j için doğrusal fayda yazılır; seçilme olasılığı faydaların yumuşak en büyüğüdür:
- i=1,\dots,G: seçim kümesi (seçici; burada hasta), j=1,\dots,J_i: kümedeki seçenekler.
- \mathbf x_{ij}: j. seçeneğin özellik vektörü; seçeneğe göre değişir (süre, maliyet). Sabit terim yoktur: tüm seçeneklere eklenen sabit pay ve paydada sadeleşir.
- \boldsymbol\beta: fayda katsayıları; e^{\beta_m}, m. özellik bir birim arttığında seçeneğin diğer seçeneklere karşı seçilme odds'unun çarpıldığı sayıdır.
Neden bu biçim?
Fayda U_{ij}=V_{ij}+\varepsilon_{ij} ve hatalar bağımsız, özdeş Gumbel (I. tip uç değer) dağılımlıysa, en büyük faydalı seçeneğin seçilme olasılığı tam olarak bu formüldür (McFadden 1974). Ayrıca aynı formül, her kümeyi bir tabaka sayan ve kümede tek bir "olay" bulunan koşullu (tabakalı) lojistik olabilirliktir: kümeye özgü sabitler (hastanın genel tedavi eğilimi gibi) koşullandırmayla yok olur. Bu yüzden R'de survival::clogit ve eşleştirilmiş vaka-kontrol analizi aynı modeli kestirir.
Ne zaman kullanılır? Veri uzun biçimdedir (her seçici için seçenek başına bir satır), her kümede tam bir seçenek seçilmiştir ve açıklayıcılar seçeneğe göre değişir. Ulaşım türü, tedavi, ürün ya da göl seçimi gibi ayrık seçim çalışmaları; 1:M eşleştirilmiş vaka-kontrol verisi.
Ne zaman kullanılmaz?
- Açıklayıcılar yalnız kişiye özgüyse (yaş, gelir) ve seçeneğe göre değişmiyorsa: Multinomial Lojistik Regresyon. Koşullu lojitte kişi özelliği ancak "Kişi özellikleri (× alternatif)" etkileşimiyle girer.
- Bir kümede birden çok seçenek seçilebiliyorsa (çoklu yanıt) ya da hiçbiri seçilmeyebiliyorsa: MerQur bu analizde hata verir (
conditional_logit.py:214–217); ikili lojistik (küme-sağlam SH ile) ya da çoklu yanıt analizleri. - Seçenekler arasında benzerlik yapısı varsa (ör. iki ilaç tedavisi birbirine yakın ikame) ve IIA varsayımı bozuksa: iç içe lojit ya da karma lojit gerekir; MerQur'da yoktur.
- Sonuç sıralıysa: Sıralı Lojistik Regresyon.
Sık karıştırılan analizler. Multinomial lojistik kişi özelliklerini sınıfa özgü katsayılarla kullanır; koşullu lojit seçenek özelliklerini ortak katsayıyla kullanır. Koşullu lojite seçenek kuklaları (ASC) ve kişi özelliği × seçenek etkileşimleri eklenince multinomial lojistik onun özel durumu olur. İkili lojistik her satırı bağımsız sayar; seçim kümesi yapısını yok sayar ve kümede tek seçim kısıtını kullanmaz.
111.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Uzun biçim | Her seçici için seçenek başına bir satır; seçim sütunu 0/1. | Seçici, seçim ve özellik rolleri çakışırsa hata (conditional_logit.py:169–171). |
| Kümede tek seçim | Her kümede seçim toplamı tam 1. | Değilse hata ve bozuk küme sayısı (177–180). |
| Kümede en az iki seçenek | Tek seçenekli küme olabilirliğe katkı vermez. | Hata (172–175); eksik değer sonrası oluşan böyle kümeler notla çıkarılır (150–163). |
| Bağımsız kümeler | Kümeler arası bağımsızlık; aynı kişinin birden çok kümesi varsa bağımlılık. | "Küme (kişi) sütunu" ile küme-sağlam SH. |
| IIA (ilgisiz seçeneklerden bağımsızlık) | İki seçeneğin olasılık oranı diğer seçeneklere bağlı değil. | Denetlenmez. |
| Sonlu ML kestirimi | Hiçbir özellik seçilen seçeneği her kümede kesin ayırmamalı. | Her çalıştırmada ayrışma denetimi (253–270). |
| Yeterli küme | Küme sayısı > parametre sayısı. | Hata (169–171). |
Eksik değer. Seçici, seçim ya da özelliklerden biri eksik olan satır çıkarılır (conditional_logit.py:178–185). Bunun sonucunda 2'den az seçeneği kalan ya da seçilen seçeneği düşen kümeler, olabilirliğe katkı vermediği için notla çıkarılır (R clogit gibi); eksik değer olmadan bozuk olan küme ise veri yapısı hatası sayılır.
Ayrışma. Bir özellik, her kümede seçilen seçeneği diğerlerinden "küçük ya da eşit" (ya da "büyük ya da eşit") yapıyor ve en az bir kümede kesin ayırıyorsa olabilirlik o yönde sınırsız artar; sonlu ML kestirimi yoktur (Albert ve Anderson 1984). MerQur bunu tek tek özellikler için denetler ve ayrıca R^2_{\text{McF}}>0{,}99'u birleşik ayrışma belirtisi sayar (315). Ayrışmada katsayı, SH, z, p ve GA'lar NaN yapılır ve yazılmaz; LR ve skor testleri yazılır, Wald "geçersiz" olarak işaretlenir.
111.3 Parametreler
Varsayılanlar conditional_logit_panel.py:43–153 ve stats_panel.py:9750–9779'den alınmıştır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Seçici sütunu | ilk sütun | Seçim kümesi (kişi) kimliği. | Kümeleri tanımlar. |
| Seçim sütunu (0/1) | ilk sütun | Seçilen satır 1. | Olabilirlik. |
| Alt kimliği (isteğe bağlı) | (Yok) | Seçenek kimliği. | ASC, etkileşim ve seçenek başına paylar için gerekir. |
| Alternatif özellikleri | en az 0 | Seçeneğe göre değişen sayısal özellikler. | Modelin ana terimleri. |
| Güven düzeyi | %95 | Katsayı ve OR GA'sı. | Yalnız GA. |
| Kategorik yordayıcılar | boş | Seçeneğe özgü kategorik özellik → ilk düzey referanslı kuklalar. | Yeni terimler. |
| Kişi özellikleri (× alternatif) | boş | Kişi değişkeni × seçenek kuklası (ilk seçenek referans). | Yeni terimler; alt kimliği gerekir. |
| Küme (kişi) sütunu — sağlam SE | Yok | Küme-sağlam (sandviç) SH tablosu. | Ek tablo; ana tablo değişmez. |
| Ek çıktılar: Alternatif sabitleri (ASC) | kapalı | İlk seçenek dışındaki her seçenek için kukla. | Yeni terimler. |
| Ek çıktılar: Tahmini seçim olasılıkları ve isabet oranı | kapalı | \hat P_{ij}, isabet oranı, seçenek başına paylar. | Ek bölüm. |
| ASC referans alternatifi | boş (= ilk alternatif) | ASC ve etkileşimlerin referans seçeneği. | ASC'lerin referansı değişir; uyum aynı kalır. |
Koddaki tercih: kukla ve etkileşim kodlaması
_expand (conditional_logit_panel.py:164–217) R clogit(chosen ~ x + relevel(factor(alt), ref) + age:factor(alt) + strata(id)) ile aynı kodlamayı yapar: düzeyler ortak düzey sırası kuralıyla dizilir (Veri sekmesindeki sıra → sayısal ya da sayı içeren etiketlerde sayısal sıra → verideki ilk görülme sırası; alfabetik sıra kullanılmaz) ve kullanılan sıra çıktıda yazılır; ilk düzey (ya da "ASC referans alternatifi") referanstır; ASC adı ASC[seçenek], etkileşim adı değişken×seçenek olur. Alternatif kimliği seçilmeden ASC ya da etkileşim istenirse sessizce atlanmaz, uyarı yazılır (342–343).
111.4 Tıp örneği
Dosya: english/datasets/Enfeksiyon_Hastaliklari/85_conditional_logit_treatment.xlsx (Enfeksiyon Hastalıkları disiplininin #85 dosyası).
Tıp #85 dosyası bu analiz için kullanılamaz
english/datasets/Tip/85_conditional_logit_treatment.xlsx (ve Türkçe kopyası samples/Tum_Analiz_Tip/85_conditional_logit_tedavi.xlsx) aynı yapıdadır, ama 120 hastanın tamamı T3-radiotherapy'yi seçmiştir ve T3 her kümede en ucuz seçenektir. cost_TL seçilen seçeneği her kümede kesin ayırır: sonlu ML kestirimi yoktur. MerQur bunu doğru yakalar ("TAM/YARI-TAM AYRIŞMA … ayıran: cost_TL", ℓ = −0,005, McFadden R^2 = 1,0000) ve katsayıları yazmaz; R clogit 20 yinelemede yakınsamadan anlamsız katsayılar verir. Bu nedenle bölüm, seçimleri değişkenlik gösteren Enfeksiyon Hastalıkları kopyasını kullanır (aynı hastalar, aynı seçenek özellikleri; seçim sütunu farklı).
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
patient_id |
Seçici | kimlik | 120 hasta, her birinde 4 seçenek (480 satır) |
chosen |
Seçim | 0/1 | T1 32, T2 27, T3 59, T4 2 hasta |
treatment |
Alt kimliği | 4 seçenek | T1-surgical, T2-chemotherapy, T3-radiotherapy, T4-targeted-oriented |
duration_month |
Özellik | sürekli (ay) | seçenek ortalamaları 1,20 / 4,07 / 1,94 / 5,64; hastaya göre değişir |
cost_TL |
Özellik | TL | seçenek başına sabit: 80000 / 60000 / 40000 / 150000 |
n ve eksik değer: 480 satır, 120 seçim kümesi; eksik değer yok.
Klinik soru: Tedavi süresi ve maliyeti, hastaların tedavi seçimini nasıl etkiler?
Seçeneğe göre sabit maliyet
cost_TL her seçenekte aynı değeri alır; bu yüzden maliyet etkisi yalnız dört seçeneğin karşılaştırmasından gelir ve seçenek kimliğinden ayrılamaz. ASC'ler ile cost_TL birlikte modele konamaz (tam eşdoğrusallık; MerQur "parametre kovaryansı hesaplanamıyor" hatası verir). Maliyet katsayısı, "seçenek farkları maliyetle doğrusal" kısıtı altındaki bir ASC örüntüsü olarak okunmalıdır (111.6, Adım 7).
Seçilen ayarlar: Seçici patient_id, seçim chosen, alt kimliği treatment, özellikler duration_month ve cost_TL, %95 GA. Ayrıca: %99 GA; tahmini olasılıklar + küme-sağlam SH (patient_id); yalnız süre + ASC (+ olasılıklar); ASC referansı T3-radiotherapy.
111.5 Formüller ve hesap adımları
MerQur'un sırası: (1) rol ve yapı denetimleri, eksik değerli satırların ve katkısız kümelerin çıkarılması; (2) özelliklerin SS'lerine bölünerek ölçeklenmesi; (3) statsmodels ConditionalLogit ile Newton yöntemiyle ML kestirimi (gerekirse BFGS + Newton); (4) katsayıların özgün birime çevrilmesi; (5) ayrışma denetimi; (6) \ell(\mathbf 0), McFadden R^2, LR, Wald ve skor testleri, AIC/BIC; (7) panelde istenirse olasılıklar, isabet oranı ve küme-sağlam SH.
111.5.1 Koşullu olabilirlik
- c(i): i. kümede seçilen seçenek.
- G: küme sayısı; J_i: i. kümedeki seçenek sayısı (kümeler arasında farklı olabilir).
- Kümeye özgü sabitler (kişinin genel eğilimi) pay ve paydada sadeleştiği için \ell'de yer almaz.
Türevler:
- y_{ij}\in\{0{,}1\}: seçim göstergesi.
- \mathbf U: skor; ML'de \mathbf U(\hat{\boldsymbol\beta})=\mathbf 0, yani her özelliğin seçilen değerlerinin toplamı, modelin beklediği toplama eşittir.
- \mathbf I: bilgi matrisi; her kümede özelliklerin seçim olasılıklarıyla ağırlıklı küme içi kovaryansı. Kümede değişmeyen bir özellik bilgi taşımaz (kişi özelliği bu yüzden doğrudan giremez).
111.5.2 Kestirim: Newton–Raphson
Neden Newton?
Koşullu lojit olabilirliği \boldsymbol\beta'da içbükeydir (\mathbf I pozitif yarı tanımlı); ayrışma yoksa tek bir en büyük vardır ve Newton yöntemi karesel hızla yakınsar. Bu, tek olaylı tabakalarla Cox modelinin Newton yinelemesiyle aynıdır.
Koddaki tercih: ölçekleme ve sayısal Hessian
MerQur özellikleri n bölenli SS'lerine bölerek kestirir ve katsayıları, SH'leri ve GA sınırlarını SS'ye bölerek özgün birime çevirir (conditional_logit.py:225–230, 310–315); z, p ve testler ölçekten bağımsızdır. Gerekçe, 80000 TL gibi büyük değerlerin optimizasyonu bozmasıdır. Kestirim ConditionalLogit(y, X/s, groups).fit(method="newton", maxiter=100) ile yapılır; yakınsama, statsmodels'ın converged bayrağı, sonlu katsayı/SH ve ölçekli uzayda gradyan normu <10^{-3} ile denetlenir. Başarısızsa BFGS (en çok 1000 yineleme) ve ardından Newton rafinesi denenir (256–276); yakınsama uyarıları yutulmaz, metne yazılır.
statsmodels 0.14.6'da ConditionalLogit skoru analitik, Hessian'ı sayısal türevle (approx_fprime) hesaplar. Bu nedenle katsayılar analitik sonuçla aynıdır, ama SH, Wald ve skor istatistikleri 10^{-7} düzeyinde göreli farkla gelir (111.6.1).
111.5.3 Standart hata, Wald testi ve odds oranı
- z_m standart normale göre değerlendirilir; p=2\{1-\Phi(|z_m|)\}.
- OR: diğer özellikler sabitken x_m bir birim arttığında seçeneğin herhangi başka bir seçeneğe karşı seçilme odds'unun çarpanı.
111.5.4 Sıfır model, McFadden R^2 ve küresel testler
- \ell(\mathbf 0): tüm seçeneklerin eşit olasılıklı olduğu model; burada -120\ln4=-166{,}3553.
- Üç test de H_0:\boldsymbol\beta=\mathbf 0'ı sınar ve sd =k (terim sayısı) olan \chi^2'ye göre değerlendirilir. R
summary(clogit)"Likelihood ratio / Wald / Score (logrank) test" satırlarıyla aynıdır. - Skor testi \boldsymbol\beta=\mathbf 0'da hesaplandığı için ayrışmada da geçerlidir; Wald testi değildir.
Koddaki tercih: kesin \ell(\mathbf 0)
MerQur \ell(\mathbf 0)'ı -\sum\ln\binom{J_i}{m_i} olarak hesaplar (conditional_logit.py:341–350). Ortalama seçenek sayısıyla yazılan -G\ln\bar J yaklaşımı kümeler eşit büyüklükte değilse yanlıştır (R infert örneğinde −90,8508 yerine kesin −90,7794). Kümeler dengeli olduğunda iki formül aynıdır.
BIC'deki örneklem büyüklüğü seçim kümesi (olay) sayısı G'dir, satır sayısı değil; R BIC(clogit) nobs = nevent ile aynıdır (conditional_logit.py:386–387).
111.5.5 Küme-sağlam (sandviç) standart hata
- c: "Küme (kişi) sütunu"ndaki küme; \mathbf S_c kümedeki skor katkılarının toplamı.
- Her seçim kümesi ayrı bir küme olduğunda (bu örnekte olduğu gibi) bu, Lin ve Wei (1989) sağlam varyansıdır ve model yanlış belirtimine karşı korur; aynı kişinin birden çok seçim kümesi varsa kişi içi bağımlılığı hesaba katar.
- Küçük örneklem düzeltmesi (C/(C-1)) yoktur; R
clogit(… + cluster(id))ile aynıdır. \mathbf I burada analitik hesaplanır (conditional_logit_panel.py:248–265).
111.5.6 Tahmini olasılıklar, isabet oranı ve paylar
\hat P_{ij} kümede faydaların yumuşak en büyüğüdür. İsabet oranı, her kümede en yüksek olasılıklı seçeneğin gerçekten seçilen seçenek olduğu kümelerin oranıdır. Seçenek başına öngörülen pay \frac{1}{n_j}\sum_i\hat P_{ij}, gözlenen pay \frac{1}{n_j}\sum_iy_{ij}'dir.
ASC'li modelde paylar neden tam tutar?
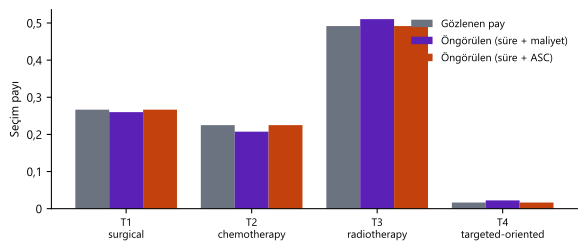
ASC'ler seçenek kuklalarıdır; skor denklemlerinin ASC bileşeni \sum_i(y_{ij}-\hat P_{ij})=0 demektir. Yani ML çözümünde her seçeneğin öngörülen toplam olasılığı gözlenen seçim sayısına eşitlenir. ASC'siz modelde bu eşitlik yoktur; paylar arasındaki fark, özelliklerin seçenekler arası farkları ne ölçüde açıkladığını gösterir.
111.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/conditional_logit/elle_hesap.py ile, MerQur ve statsmodels çağrılmadan numpy ile hesaplanmıştır. Yinelemelerde maliyet 1000 TL birimiyle yazılır (kod da ölçekleyerek çalışır); sonuçlar sonra TL'ye çevrilir.
Adım 1 — Başlangıç (\boldsymbol\beta^{(0)}=\mathbf 0). Her seçenek P_{ij}=1/4. \ell(\mathbf 0)=-120\ln4=-166{,}355323.
Negatif skorlar, seçilen seçeneklerin ortalamadan daha kısa ve daha ucuz olduğunu gösterir. Skor testi bu ilk adımın kendisidir:
Adım 2 — Yakınsama (maliyet 1000 TL biriminde).
| Yineleme | b_{\text{süre}} | b_{\text{maliyet}} (/1000 TL) | \ell | \max\lvert\Delta b\rvert |
|---|---|---|---|---|
| 0 | 0 | 0 | −166,355323 | |
| 1 | −0,113321 | −0,011487 | −137,014994 | 0,113 |
| 2 | −0,195031 | −0,018347 | −131,814962 | 0,0817 |
| 3 | −0,228767 | −0,020951 | −131,389601 | 0,0337 |
| 4 | −0,232659 | −0,021218 | −131,385752 | 0,00389 |
| 5 | −0,232699 | −0,021220 | −131,385752 | 4,0·10⁻⁵ |
| 6 | −0,232699 | −0,021220 | −131,385752 | 3,9·10⁻⁹ |
Adım 3 — Katsayılar. \mathbf I(\hat{\boldsymbol\beta})^{-1}'in köşegeninden:
| Terim | b | SH | z | p | OR | %95 GA |
|---|---|---|---|---|---|---|
duration_month (ay) |
−0,232699 | 0,076722 | −3,0330 | 0,002421 | 0,792392 | [0,681765; 0,920970] |
cost_TL (TL) |
−2,122049·10⁻⁵ | 4,207908·10⁻⁶ | −5,0430 | 4,58·10⁻⁷ | 0,999979 | [0,999971; 0,999987] |
cost_TL (1000 TL) |
−0,021220 | 0,004208 | −5,0430 | 4,58·10⁻⁷ | 0,979003 |
Süre bir ay uzadıkça tedavinin seçilme odds'u %20,8 azalır (e^{-0{,}232699}=0{,}792392). Maliyet için 1 TL anlamsız küçük bir birimdir; 10000 TL için OR =e^{-0{,}212205}=0{,}808799.
Adım 4 — Uyum ve testler.
Adım 5 — Bir hastanın olasılıkları. 1 numaralı hasta (T2-chemotherapy'yi seçti):
| Seçenek | Süre | Maliyet | V_{1j} | \hat P_{1j} |
|---|---|---|---|---|
| T1-surgical | 1,1 | 80000 | −1,953608 | 0,267184 |
| T2-chemotherapy (seçilen) | 4,4 | 60000 | −2,297105 | 0,189510 |
| T3-radiotherapy | 1,9 | 40000 | −1,290948 | 0,518322 |
| T4-targeted-oriented | 4,9 | 150000 | −4,323299 | 0,024984 |
Örnek: V_{13}=-0{,}232699(1{,}9)-2{,}122049\times10^{-5}(40000)=-1{,}290948. Model en kısa-ucuz bileşime (T3) en yüksek olasılığı verir; bu hasta için tahmin yanlıştır.
Adım 6 — Olasılıklar, isabet ve sağlam SH. İsabet oranı 59/120=0{,}491667'dir. Model 120 kümenin tamamında en yüksek olasılığı T3'e verir; isabet oranı bu yüzden T3'ü seçenlerin payına eşittir ve "herkese en sık seçeneği ata" kuralından iyi değildir. Model olasılıkları iyi ayırsa da (LR = 69,94) en olası seçenek her kümede aynıdır; isabet oranı tek başına model kalitesinin ölçüsü değildir. Ortalama öngörülen paylar T1 0,259931 / T2 0,207392 / T3 0,510360 / T4 0,022318; gözlenen 0,266667 / 0,225000 / 0,491667 / 0,016667. Küme-sağlam SH'ler: süre 0,079906, maliyet 3{,}980409\times10^{-6}; süre için sağlam z=-2{,}9122, p=0{,}003590.
Şekil 111.1. Seçenek başına gözlenen ve ortalama öngörülen seçim payları. ASC'li modelde öngörülen paylar gözlenen paylara tam eşittir.
Adım 7 — ASC'li model. Süre + üç ASC (referans T1-surgical):
| Terim | b | SH | p | OR |
|---|---|---|---|---|
duration_month |
−0,266085 | 0,154042 | 0,0841 | 0,766 |
| ASC[T2-chemotherapy] | 0,572420 | 0,493595 | 0,2462 | 1,773 |
| ASC[T3-radiotherapy] | 0,810761 | 0,249152 | 0,0011 | 2,250 |
| ASC[T4-targeted-oriented] | −1,675094 | 0,938758 | 0,0744 | 0,187 |
\ell=-131{,}126607; LR(4) =70{,}457432; skor 55,951980; AIC 270,253215; BIC 281,403182. Maliyetli model, bu modelin "ASC'ler maliyetle doğrusal" kısıtlı özel durumudur (maliyet seçeneğe göre sabit olduğu için). Kısıtın LR testi 2(-131{,}126607+131{,}385752)=0{,}5183, sd =2, p=0{,}7717: dört seçenek arasındaki farkı maliyetin doğrusal etkisi yeterince açıklar. ASC'ler eklenince süre katsayısının SH'si iki katına çıkar (0,077 → 0,154), çünkü süre de büyük ölçüde seçeneğe bağlıdır. Referans T3 alınınca ASC'ler T1 −0,810761 (p=0{,}0011), T2 −0,238341 (p=0{,}5322), T4 −2,485855 (p=0{,}0039) olur; uyum değişmez.
111.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucunun sözlüklerinden (katsayı, SH, z, p, GA, testler) ve clog2 alanından tam hassasiyetle alınmıştır. R: 4.5.3, survival::clogit 3.8-6 (kesin yöntem; sağlam SH için kümede tek olay olduğundan özdeş olan method = "breslow" + cluster(patient_id)), summary() LR ve skor testleri, Wald testi vcov ile doğrudan, AIC, BIC.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| β duration_month | −0,232699 | −0,232699 | −0,232699 | 2,8e−17 | ✓ |
| SH duration_month | 0,076722 | 0,076722 | 0,076722 | 2,6e−10 | ✓ |
| z duration_month | −3,033031 | −3,033031 | −3,033031 | 1,0e−08 | ✓ |
| p duration_month | 0,002421 | 0,002421 | 0,002421 | 8,2e−11 | ✓ |
| OR %95 GA alt duration_month | 0,681765 | 0,681765 | 0,681765 | 3,5e−10 | ✓ |
| OR %95 GA üst duration_month | 0,920970 | 0,920970 | 0,920970 | 4,7e−10 | ✓ |
| β cost_TL | −2,122049·10−5 | −2,122049·10−5 | −2,122049·10−5 | 2,7e−20 | ✓ |
| SH cost_TL | 4,207908·10−6 | 4,207908·10−6 | 4,207908·10−6 | 3,6e−14 | ✓ |
| z cost_TL | −5,043003 | −5,043003 | −5,043003 | 4,3e−08 | ✓ |
| p cost_TL | 4,582826·10−7 | 4,582827·10−7 | 4,582827·10−7 | 1,0e−13 | ✓ |
| OR %95 GA alt cost_TL | 0,999971 | 0,999971 | 0,999971 | 7,0e−14 | ✓ |
| OR %95 GA üst cost_TL | 0,999987 | 0,999987 | 0,999987 | 7,0e−14 | ✓ |
| ℓ(β̂) | −131,385752 | −131,385752 | −131,385752 | 5,7e−14 | ✓ |
| ℓ(0) | −166,355323 | −166,355323 | −166,355323 | 1,4e−13 | ✓ |
| McFadden R^2 | 0,210210 | 0,210210 | 0,210210 | 1,2e−15 | ✓ |
| LR χ²(2) | 69,939143 | 69,939143 | 69,939143 | 4,8e−13 | ✓ |
| Wald χ²(2) | 38,982006 | 38,982005 | 38,982005 | 1,3e−06 | ✓ |
| Skor χ²(2) | 49,063128 | 49,063135 | 49,063135 | 7,5e−06 | ✓ |
| AIC | 266,771503 | 266,771503 | 266,771503 | 1,1e−13 | ✓ |
| BIC (n = 120 seçici) | 272,346487 | 272,346487 | 272,346487 | 1,7e−13 | ✓ |
Ek çıktılar (%99 GA, sağlam SH, olasılıklar, ASC):
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| OR %99 GA alt duration_month | 0,650300 | 0,650300 | 0,650300 | 4,3e−10 | ✓ |
| OR %99 GA üst duration_month | 0,965531 | 0,965531 | 0,965531 | 6,4e−10 | ✓ |
| Küme-sağlam SH duration_month | 0,079906 | 0,079906 | 0,079906 | 8,3e−17 | ✓ |
| Küme-sağlam SH cost_TL | 3,980409·10−6 | 3,980409·10−6 | 3,980409·10−6 | 5,1e−21 | ✓ |
| İsabet oranı | 0,491667 | 0,491667 | 0,491667 | 3,3e−16 | ✓ |
| Ortalama öngörülen pay: T1-surgical | 0,259931 | 0,259931 | 0,259931 | 5,0e−16 | ✓ |
| Ortalama öngörülen pay: T2-chemotherapy | 0,207392 | 0,207392 | 0,207392 | 1,4e−16 | ✓ |
| Ortalama öngörülen pay: T3-radiotherapy | 0,510360 | 0,510360 | 0,510360 | 1,1e−16 | ✓ |
| Ortalama öngörülen pay: T4-targeted-oriented | 0,022318 | 0,022318 | 0,022318 | 2,8e−17 | ✓ |
| ASC modeli β: duration_month | −0,266085 | −0,266085 | −0,266085 | 4,4e−11 | ✓ |
| ASC modeli SH: duration_month | 0,154042 | 0,154042 | 0,154042 | 4,2e−09 | ✓ |
| ASC modeli β: ASC[T2-chemotherapy] | 0,572420 | 0,572420 | 0,572420 | 1,2e−10 | ✓ |
| ASC modeli SH: ASC[T2-chemotherapy] | 0,493595 | 0,493595 | 0,493595 | 8,1e−09 | ✓ |
| ASC modeli β: ASC[T3-radiotherapy] | 0,810761 | 0,810761 | 0,810761 | 3,3e−11 | ✓ |
| ASC modeli SH: ASC[T3-radiotherapy] | 0,249152 | 0,249152 | 0,249152 | 9,2e−10 | ✓ |
| ASC modeli β: ASC[T4-targeted-oriented] | −1,675094 | −1,675094 | −1,675094 | 3,0e−08 | ✓ |
| ASC modeli SH: ASC[T4-targeted-oriented] | 0,938758 | 0,938758 | 0,938758 | 1,3e−08 | ✓ |
| ASC modeli ℓ(β̂) | −131,126607 | −131,126607 | −131,126607 | 2,8e−13 | ✓ |
| ASC modeli Skor χ²(4) | 55,951955 | 55,951980 | 55,951980 | 2,5e−05 | ✓ |
| ASC modeli Wald χ²(4) | 33,974286 | 33,974286 | 33,974286 | 2,4e−07 | ✓ |
| ASC modeli öngörülen pay = gözlenen: T1-surgical | 0,266667 | 0,266667 | 0,266667 | 0,0e+00 | ✓ |
| ASC modeli öngörülen pay = gözlenen: T2-chemotherapy | 0,225000 | 0,225000 | 0,225000 | 0,0e+00 | ✓ |
| ASC modeli öngörülen pay = gözlenen: T3-radiotherapy | 0,491667 | 0,491667 | 0,491667 | 1,1e−16 | ✓ |
| ASC modeli öngörülen pay = gözlenen: T4-targeted-oriented | 0,016667 | 0,016667 | 0,016667 | 6,9e−18 | ✓ |
| Referans T3: β ASC[T1-surgical] | −0,810761 | −0,810761 | −0,810761 | 3,3e−11 | ✓ |
| Referans T3: β ASC[T2-chemotherapy] | −0,238341 | −0,238341 | −0,238341 | 8,7e−11 | ✓ |
| Referans T3: β ASC[T4-targeted-oriented] | −2,485855 | −2,485855 | −2,485855 | 3,0e−08 | ✓ |
47 büyüklüğün tamamı ölçüt içinde eşleşir. Varsayılan modelde katsayılar, \ell, LR ve sağlam SH 10^{-12} düzeyinde aynıdır; ASC modelinde katsayı farkları, R coxph'un yakınsama ölçütü nedeniyle 10^{-8} düzeyindedir. SH, Wald ve skor istatistiklerinde MerQur ile analitik başvuru (Python ve R aynı) arasında 10^{-7} düzeyinde göreli fark vardır (skor 49,063128 / 49,063135; ASC modelinde 55,951955 / 55,951980). Kaynak, statsmodels'ın sayısal Hessian'ıdır (111.5.2); raporlanan üç ondalıkta görünmez.
111.7 Çıktıyı okuma
Sonuç metni (varsayılan ayarlar, kısaltılmış):
Koşullu Lojit (Seçim Modeli)
  N (satır)           : 480
  N (seçici)          : 120
  Seçenek/seçici ort. : 4.0
Model Uyumu:
  Log-olabilirlik       = -131.386
  Sıfır model LL        = -166.355
  Pseudo R² (McFadden)  = 0.2102
  AIC                   = 266.772
  BIC                   = 272.346  (n = 120 olay/seçici)
Küresel Sıfır Hipotezi Testleri (H₀: tüm β = 0):
  Olabilirlik oranı (LR)     χ²(2) = 69.939, p < .001
  Wald                       χ²(2) = 38.982, p < .001
  Skor (log-rank)            χ²(2) = 49.063, p < .001
Katsayılar (β + odds oranı + %95 GA):
  duration_month:
    β = -0.2327  (SE = 0.07672, z = -3.03, p = .0024 *)
    OR = 0.792  [0.682, 0.921]
  cost_TL:
    β = -0.00002122  (SE = 0.000004208, z = -5.04, p < .001 *)
    OR = 0.99997878  [0.99997053, 0.99998703]
| Öğe | Nasıl yorumlanır |
|---|---|
| N (satır), N (seçici) | 480 satır, 120 seçim kümesi; BIC ve APA satırındaki N seçici sayısıdır. |
| Sıfır model LL | Tüm seçenekler eşit olasılıklı model; -\sum\ln J_i. |
| McFadden R^2 | 0,21: koşullu lojitte 0,2–0,4 iyi uyum sayılır (McFadden 1979). |
| LR / Wald / Skor | Üçü de anlamlıysa özellikler birlikte seçimi açıklar. Ayrışmada Wald "geçersiz" yazılır. |
| β ve OR | Süre: her ek ay seçilme odds'unu 0,79 katına indirir. |
cost_TL satırı |
Birim 1 TL olduğu için β küçüktür; MerQur β, SH ve OR'yi anlamlı basamaklarıyla yazar (OR = 0,99997878). z = −5,04 anlamlı bir etkiyi gösterir. Raporda değişkeni 1000 TL birimine çevirmek okumayı kolaylaştırır (z ve p değişmez). |
| Ayrışma uyarısı | Bir özellik seçilen seçeneği her kümede ayırıyor; katsayılar yazılmaz. Veriyi denetleyin. |
| Yakınsama uyarısı | Gradyan normu ölçekli uzayda 10^{-3}'ü aşıyor; sonuçlar güvenilmez olabilir. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Hastaların dört tedavi seçeneği arasındaki seçimi, tedavi süresi ve maliyetini seçenek özellikleri olarak içeren koşullu lojit modeliyle incelendi (120 hasta, 480 seçenek). Model, tüm seçeneklerin eşit olasılıklı olduğu sıfır modelden anlamlı biçimde iyiydi, LR \chi^2(2, N = 120) = 69{,}94, p < 0{,}001, McFadden R^2 = 0{,}21. Maliyet sabitken tedavi süresindeki her bir aylık artış, seçeneğin seçilme odds'unu yaklaşık %21 azalttı (OR = 0,79; %95 GA [0,68; 0,92]; p = 0{,}002); süre sabitken maliyetteki her 10000 TL'lik artış odds'u yaklaşık %19 azalttı (OR = 0,81; p < 0{,}001).
111.8 Uzman soruları
S1. Modelde neden sabit terim yok? Kişinin yaşı neden doğrudan girmiyor?
Olasılık, aynı kümedeki seçeneklerin fayda farklarına bağlıdır; kümedeki tüm seçeneklere eşit eklenen her terim (sabit, yaş, gelir) pay ve paydada sadeleşir. Bilgi matrisinde de küme içi kovaryansı sıfırdır. Kişi özelliği ancak seçenek kuklasıyla etkileşim olarak girer ("Kişi özellikleri (× alternatif)"): her seçenek için ayrı katsayı, multinomial lojistikteki gibi.
S2. ASC eklemek neden maliyeti modelden atmayı gerektirdi?
Maliyet seçeneğe göre sabittir: maliyet sütunu, üç ASC kuklasının doğrusal birleşimidir (sabit hariç). Tasarım matrisi tam rank değildir ve bilgi matrisi tekildir; MerQur "parametre kovaryansı hesaplanamıyor (tam ayrışma ya da eşdoğrusallık)" hatası verir. Maliyet etkisi ancak maliyetin aynı seçenek içinde kişiden kişiye değiştiği (deneysel tasarımlı) verilerde ASC'den ayrılabilir.
S3. Tıp #85 dosyasında MerQur katsayı vermedi, R verdi. Hangisi doğru?
MerQur. Tüm hastalar T3'ü seçmiş ve T3 her kümede en ucuzdur; maliyet katsayısı -\infty'a giderken olabilirlik artmaya devam eder, sonlu ML kestirimi yoktur. R clogit 20 yineleme sınırında durur ve büyük, anlamsız katsayılar yazar (yalnız uyarıyla). MerQur tek değişkenli ayrışmayı doğrusal denetimle yakalar, katsayıları NaN yapar, LR ve skor testini yine de yazar.
S4. Koşullu lojit ile tabakalı Cox modeli neden aynı sonucu veriyor?
Her kümede tek bir "olay" (seçim) ve eşit "süre" varsa Cox kısmi olabilirliği tam olarak koşullu lojit olabilirliğidir; bağların işlenmesi (kesin, Breslow, Efron) tek olayda fark yaratmaz. R clogit bu yüzden coxph üzerine kuruludur; skor testi Cox'taki log-rank testidir. Kesin yöntem sağlam varyansı desteklemediğinden doğrulamada sağlam SH için Breslow kullanılmıştır; nokta kestirimi aynıdır.
S5. IIA varsayımı nedir, MerQur denetliyor mu?
İlgisiz seçeneklerden bağımsızlık: iki seçeneğin olasılık oranı \exp\{(\mathbf x_{ij}-\mathbf x_{il})^{\top}\boldsymbol\beta\}'dır ve üçüncü bir seçeneğin varlığına bağlı değildir. Bir seçenek kaldırılınca olasılığı diğerlerine orantılı dağılır; ikame seçenekler varsa bu gerçekçi değildir. MerQur bu analizde IIA testi sunmaz; Hausman–McFadden testi Multinomial Lojistik Regresyon panelinde vardır (Hausman ve McFadden 1984).
S6. Sağlam SH neden küçük örneklem düzeltmesi içermiyor?
MerQur R coxph/clogit robust varyansını izler: \mathbf V(\sum\mathbf S_c\mathbf S_c^{\top})\mathbf V, C/(C-1) çarpanı olmadan. Bazı yazılımlar sağlam varyansı C/(C-1) ile çarpar; 120 kümede bu, SH'de yaklaşık %0,4'lük farktır. Az kümede (ör. 10 hastane) fark belirginleşir ve SH'ler küçük kalır.
S7. SH ve testlerde 7. basamakta neden fark var?
statsmodels ConditionalLogit Hessian'ı skorun sayısal türeviyle hesaplar. Nokta kestirimi skoru sıfırlayan değer olduğundan etkilenmez; SH, Wald ve skor testleri 10^{-7} göreli doğrulukla gelir. Analitik bilgi matrisi (panelde sağlam SH için zaten hesaplanan) kullanılırsa fark kalkar.
S8. Neden özellikleri ölçekleyerek kestiriyor? Sonuç değişir mi?
Değişmez. Ölçek dönüşümü doğrusal bir yeniden parametrelemedir: \beta^{*}=s\beta, \SH^{*}=s\,\SH; z, p, olabilirlik ve testler aynı kalır. 80000 TL düzeyindeki değerler ölçeksiz Newton adımlarında Hessian'ı kötü koşullu yapar ve yakınsamayı bozabilir; ölçekleme sayısal kararlılık içindir.
111.9 Sık hatalar ve tuzaklar
- Geniş biçimli veriyle çalıştırmak. Her kişi tek satırda ve seçenekler sütunlardaysa model kurulamaz; veri uzun biçime çevrilmelidir (seçenek başına bir satır).
- Kümede birden çok "1". Seçim sütunu her kümede tam bir kez 1 olmalıdır; aksi hâlde analiz bozuk küme sayısını yazıp durur.
- Tek tip seçim. Tüm kişiler aynı seçeneği seçtiyse ve o seçenek bir özellikte hep en iyiyse ayrışma oluşur (Tıp #85). Önce seçim dağılımına bakın.
- Seçeneğe göre sabit özellik + ASC. Bu ikisi birlikte konamaz; özellik etkisi ASC'den ayrılamaz.
- Küçük birimli katsayıyı yorumlamak. TL cinsinden maliyet katsayısı çok küçüktür (anlamlı basamakla yaklaşık -2{,}12\times10^{-5}) ve OR 1'e çok yakındır; yorum için değişkeni anlamlı bir birime (1000 ya da 10000 TL) çevirin.
- Kişi özelliğini doğrudan eklemek. Yaş gibi kümede sabit bir değişken "Alternatif özellikleri"ne konursa bilgi taşımaz ve kovaryans tekil olur; "Kişi özellikleri (× alternatif)" kullanılmalıdır.
- ASC'siz modelde öngörülen payların gözlenenle eşit olmasını beklemek. Bu eşitlik yalnız ASC'li modelde vardır (111.5.6); ASC'siz modelde paylar gözlenenden farklı olabilir ve çıktıdaki not bunu belirtir.
111.10 Kaynaklar
- Albert, A., & Anderson, J. A. (1984). On the existence of maximum likelihood estimates in logistic regression models. Biometrika, 71(1), 1–10. https://doi.org/10.1093/biomet/71.1.1
- Gail, M. H., Lubin, J. H., & Rubinstein, L. V. (1981). Likelihood calculations for matched case-control studies and survival studies with tied death times. Biometrika, 68(3), 703–707. https://doi.org/10.1093/biomet/68.3.703
- Hausman, J., & McFadden, D. (1984). Specification tests for the multinomial logit model. Econometrica, 52(5), 1219–1240. https://doi.org/10.2307/1910997
- Lin, D. Y., & Wei, L. J. (1989). The robust inference for the Cox proportional hazards model. Journal of the American Statistical Association, 84(408), 1074–1078. https://doi.org/10.1080/01621459.1989.10478874
- McFadden, D. (1974). Conditional logit analysis of qualitative choice behavior. P. Zarembka (Ed.), Frontiers in econometrics içinde (ss. 105–142). Academic Press.
- McFadden, D. (1979). Quantitative methods for analysing travel behaviour of individuals: Some recent developments. D. A. Hensher & P. R. Stopher (Ed.), Behavioural travel modelling içinde (ss. 279–318). Croom Helm.
- Therneau, T. M., & Grambsch, P. M. (2000). Modeling survival data: Extending the Cox model. Springer. https://doi.org/10.1007/978-1-4757-3294-8
- Train, K. E. (2009). Discrete choice methods with simulation (2. baskı). Cambridge University Press. https://doi.org/10.1017/CBO9780511805271