26. Ki-Kare Uyum İyiliği
Analiz kimliği: chisquare_gof · Menü adı: Ki-Kare Uyum İyiliği · Panel: gui/panels/analyses/chi_square_gof.py (form 39–96, execute 111–145, parse_expected_props 148–172) · Motor: stats/hypothesis.py, HypothesisTests.chi_square_goodness_of_fit (satır 5789–6021), kesin çokterimli _multinom_exact_p (463–509), p düzeltmesi _padjust (734–762)
26.1 Ne işe yarar
Ki-kare uyum iyiliği testi, tek bir kategorik değişkenin gözlenen sıklıklarının, önceden belirlenmiş oranlarla uyumlu olup olmadığını sınar. Cevapladığı soru şudur: "Kategoriler, beklenen oranlarda dağılmış bir evrenden gelmiş olabilir mi?"
- k: kategori sayısı; \pi_j: j. kategorinin evrendeki oranı.
- p_j: beklenen oran. "Beklenen oranlar" kutusu boşsa p_j=1/k (eşit dağılım).
Ne zaman kullanılır? Kan grubu dağılımı bir ülke ortalamasına uyuyor mu; doğumlar haftanın günlerine eşit mi dağılıyor; Mendel oranları (9:3:3:1) tutuyor mu; bir anket örnekleminin yaş grupları nüfus oranlarını yansıtıyor mu?
Ne zaman kullanılmaz?
- İki kategorik değişkenin ilişkisi soruluyorsa: Ki-Kare Bağımsızlık (Bölüm 25).
- Yalnız iki kategori varsa kesin sonuç için: Binom Testi (Bölüm 22). Uyum iyiliği aynı soruyu yaklaşık çözer.
- Sürekli bir değişkenin bir dağılıma (normal vb.) uyumu soruluyorsa: Normallik Testleri (Bölüm 3). Sürekli veriyi sınıflara bölüp bu testi uygulamak bilgi kaybettirir ve tahmin edilen parametreler için sd düzeltmesi gerektirir; MerQur bu düzeltmeyi yapmaz (26.8, S5).
- Aynı kişilerde tekrarlı kategorik ölçüm varsa: McNemar (Bölüm 28) ya da Cochran Q.
Sık karıştırılan analizler. Bağımsızlık testi iki değişkenli bir tabloda beklenen sıklıkları marjinallerden kestirir; uyum iyiliğinde beklenen sıklıklar dışarıdan verilir. Sd de farklıdır: uyum iyiliğinde k-1, bağımsızlıkta (r-1)(c-1).
26.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Bağımsız gözlemler | Her birim tek bir kategoriye bir kez sayılır. | Denetlenmez. |
| Kategoriler ayrık ve kapsayıcı | Her gözlem tam bir kategoriye düşer. | Oranı tanımsız gözlenen kategori varsa hata (hypothesis.py:5845–5848). |
| Sabit n, çokterimli örnekleme | n önceden bellidir; oranlar sabittir. | Tasarımla sağlanır. |
| Yeterli beklenen sıklık | Ki-kare yaklaşımı için E_j\ge5 önerilir. | Beklenen sıklığı 5'ten küçük hücre sayısı her çalıştırmada dipnotta, en az bir hücre varsa uyarıda (hypothesis.py:5970–5978). Çözüm: kesin ya da Monte Carlo p. |
Eksik değer. Seçilen sütunda eksik olan satırlar atılır (hypothesis.py:5817). Ağırlık sütunu kullanıldığında kategorisi eksik satırlar atılır; ağırlığı eksik ya da negatif satır hata verir (hypothesis.py:427–435).
Uç durumlar.
- İkiden az kategori varsa hata (
hypothesis.py:5850–5851). - Liste girişinde oran sayısı kategori sayısına eşit değilse hata; sıfır ya da negatif oran hata (
hypothesis.py:5863–5868). - Ad ile girişte (A=0.42, …) sözlükte olup veride hiç görülmeyen kategori 0 sıklıkla teste girer; veride olup sözlükte olmayan kategori hata verir (
hypothesis.py:5845–5849). - Kategori aralığı (ör. "1, 5") sayısal olmayan veride ya da alt ≥ üst ise hata (
hypothesis.py:5822–5825); ayrıştırılamayan aralık metni yok sayılmaz, ayar bloğuna yazılır (chi_square_gof.py:129–133). - Kesin çokterimli hesap çok büyük olursa (yaklaşık 6 milyon ara satır) Monte Carlo'ya geçilir ve bu yazılır (
hypothesis.py:5913–5916).
26.3 Parametreler
Varsayılanlar chi_square_gof.py:39–96 içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Sütun | ilk kategorik sütun | Sınanan değişken. | |
| Beklenen oranlar | boş (eşit) | "A=0.42, B=0.16, …" (adla) ya da "0.35, 0.42, …" (sırayla). | E_j, X^2, p. Oranlar toplamına bölünür (yüzde de girilebilir); ölçekleme yapıldıysa bu bir notla yazılır. |
| Ek çıktı: Etki (Cohen w / V) | kapalı | w ve uyum iyiliği V'si. | Ek satır. |
| Ek çıktı: G-testi (olabilirlik oranı) | kapalı | Pearson X^2 yerine G. | Ana istatistik, asimptotik p ve Monte Carlo benzetiminin ölçütü. |
| Ek çıktı: Standart artıklar | kapalı | Kategori başına Pearson artığı. | Ek blok. |
| Ağırlık (frekans) sütunu | Yok | Satırlar sayım tablosuysa her satırın sıklığı. | O_j ağırlık toplamı olur. |
| Güven Düzeyi | %95 | Yalnız karar eşiği \alpha. | Karar; varsayılan dışıysa not eklenir (chi_square_gof.py:126–127). |
| Kesin / Monte Carlo p | Yok | Kesin çokterimli ya da Monte Carlo (B=10000). | Ana p ve karar bu p'ye geçer. |
| Kategori bazlı testler | Yok | Kategori başına kesin binom testi + Holm ya da Bonferroni. | Ek blok. |
| Kategori aralığı | boş | Tam sayı kodlarda "alt, üst": aralıktaki tüm kodlar (gözlenmeyenler 0) teste girer, dışındakiler atılır. | Kategori kümesi ve n. |
| Tohum | 12345 | Monte Carlo rastgele sayı üretecinin tohumu (seed). | Yalnız Monte Carlo p. |
Neden liste girişi tehlikelidir?
Oranlar yalnız sayı olarak girilirse sabit bir kategori sırasına eşlenir: MerQur'un ortak düzey sırası kuralıyla: sütun pandas Categorical ise ya da Veri sekmesinde sıra tanımlıysa o sıra; tüm etiketler sayıysa sayısal, hepsi sayı içeriyorsa doğal sıra; aksi hâlde verideki ilk görülme sırası (_natural_cat_order). Tıp verisinde etiketler bir kısmı sayı olmayan "0, A, B, AB" olduğundan ilk görülme sırası geçerlidir; "A=0.42, B=0.16, AB=0.07, 0=0.35" oranlarını liste olarak girmek için "0.35, 0.42, 0.16, 0.07" yazmak gerekir. Kullanılan sıra çıktıda "Kategori sırası" satırında yazılır; ad ile giriş bu hatayı tümden önler.
Güven düzeyi neyi değiştirir?
Bu analizde GA yoktur; güven düzeyi yalnız "H₀ reddedildi/reddedilemedi" eşiğini belirler. Kategori testlerinde düzeltilmiş p'nin yanındaki yıldız da bu \alpha'ya göre konur (hypothesis.py:5966).
26.4 Tıp örneği
Dosya: english/datasets/Tip/22_chisquare_goodnessfit_blood_group.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/22_kikare_uyum_kan_grubu.xlsx).
| Değişken | Rol | Tür | Açıklama |
|---|---|---|---|
blood_group |
Sütun | kategorik (4 düzey) | A 83, 0 82, B 27, AB 8 |
patient_id |
kullanılmaz |
n ve eksik değer: 200 hasta, eksik değer yok.
Klinik soru: Tanıtım senaryosu (VIDEO_SCRIPT_TR.txt, #22) eşit dağılımı sınar; bu, kan grupları için biyolojik olarak beklenen bir hipotez değildir ve yalnız yöntemi göstermek içindir. Türkçe rehber (samples/Tum_Analiz_Tip/REHBER.md, #22) Türkiye dağılımını hipotez olarak verir: A %42, B %16, AB %7, 0 %35. Asıl klinik soru budur: "Bu hastanenin hastaları, kan grubu bakımından Türkiye nüfusuna benziyor mu?"
Seçilen ayarlar: (a) Varsayılan (eşit dağılım). (b) Türkiye oranları adla girilerek, etki, artık, kesin çokterimli p ve Holm'lu kategori testleri açık. Ek çalıştırmalar: aynı oranlar liste olarak; G-testi; Monte Carlo (tohum 12345 ve 2026); G + Monte Carlo; Bonferroni; özet sayım tablosu + ağırlık sütunu.
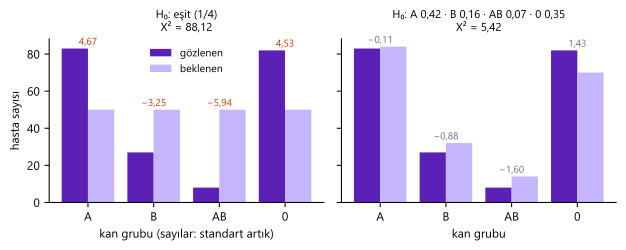
Şekil 26.1. Gözlenen ve beklenen kan grubu sayıları. Çubukların üstündeki sayılar Pearson standart artıklarıdır (\lvert r\rvert>2 turuncu). Solda eşit dağılım hipotezi, sağda Türkiye oranları.
26.5 Formüller ve hesap adımları
MerQur'un sırası şudur: (1) sütundaki eksikleri at, (2) varsa kategori aralığını uygula, (3) sıklıkları say (ağırlık varsa ağırlıkları topla), (4) kategori sırasını sabitle ve gözlenmeyen kategorilere 0 yaz, (5) oranları toplamına bölüp beklenen sıklıkları kur, (6) scipy.stats.power_divergence ile X^2 (ya da G) ve asimptotik p'yi hesapla, (7) istenen ek blokları ekle, (8) kesin ya da Monte Carlo seçildiyse ana p'yi değiştir, (9) beklenen sıklık dipnotunu ve uyarıyı yaz.
26.5.1 Gözlenen ve beklenen sıklıklar
- O_j: j. kategorinin gözlenen sıklığı; ağırlık sütunu yoksa w_i=1.
- E_j: beklenen sıklık. Oranlar toplamı 1 değilse ölçeklenir (
hypothesis.py:5870).
Koddaki tercih
Oranların toplamına bölünmesi kullanıcıya yüzde girme kolaylığı sağlar; ama R chisq.test(p = ) toplamı 1 olmayan oranlarda hata verir (rescale.p = TRUE istenmedikçe). MerQur'da yanlış yazılmış bir oran (0,42 yerine 0,24) uyarısız kabul edilir; "beklenen oran" satırında ölçeklenmiş oranlar yazıldığı için oradan denetlenmelidir.
26.5.2 Pearson X² ve G istatistiği
- X^2: Pearson (1900) istatistiği;
power_divergence(lambda_="pearson"). - G: olabilirlik oranı istatistiği; O_j=0 terimi 0 sayılır (
lambda_="log-likelihood"). - sd =k-1: oranlar toplamı 1 olduğundan k sıklıktan biri ötekilerden bellidir.
Neden ki-kare dağılımı?
H_0 altında (O_1,\dots,O_k) çokterimli dağılır. n büyükken (O_j-E_j)/\sqrt{E_j} vektörü, toplamı sıfır olma kısıtıyla k-1 boyutlu bir normal dağılıma yaklaşır; karelerinin toplamı da \chi^2_{k-1}'e. G ve X^2 Cressie–Read (1984) güç ıraksaklığı ailesinin iki üyesidir (\lambda=0 ve \lambda=1); H_0 altında asimptotik olarak eşdeğerdir, küçük n'de ayrışırlar.
G seçiliyken çıktı etiketleri
G-testi seçildiğinde ana istatistik satırı ve APA özeti "G" adıyla G'yi yazar; ayrıca "G-testi (olabilirlik oranı χ²) kullanıldı." satırı eklenir. Monte Carlo seçiliyse benzetim de G ölçütüyle kurulur; böylece istatistik ile p aynı ölçüte dayanır. Etki büyüklüğü (w, V) ise G seçili olsa da Pearson X^2'den hesaplanır, çünkü Cohen w X^2 üzerinden tanımlıdır.
26.5.3 Etki büyüklüğü
- w: Cohen'in (1988) w'si; eşikleri 0,1 küçük, 0,3 orta, 0,5 büyük. MerQur etiket vermez.
- V: uyum iyiliği için Cramér V benzeri ölçek; 0 ile 1 arasında kalması için k-1'e bölünür (
hypothesis.py:5893–5894).
26.5.4 Artıklar
- r_j: Pearson (standart) artığı; "Standart artıklar" bloğunda 2 ondalıkla, \lvert r_j\rvert>2 ise yıldızla (
hypothesis.py:5898–5902). - r^{\text{adj}}_j: düzeltilmiş (Haberman) artık; "Kategori bazlı testler" bloğunda 3 ondalıkla (
hypothesis.py:5964).
Neden iki artık?
O_j\sim\text{Binom}(n,\,p_j) olduğundan \text{Var}(O_j-E_j)=np_j(1-p_j)=E_j(1-p_j)'dir. Pearson artığı \sqrt{E_j}'ye böler; varyansı 1-p_j'dir, 1 değil. Bu yüzden "\lvert r\rvert>2" ölçütü tutucudur. Düzeltilmiş artık doğru varyansa böler ve H_0 altında yaklaşık standart normaldir (Haberman 1973). X^2=\sum r_j^2 olduğundan Pearson artıkları, hangi kategorinin istatistiğe ne kadar katkı yaptığını doğrudan gösterir.
26.5.5 Kesin çokterimli p ve Monte Carlo p
- Toplam, \sum_j x_j=n olan tüm sayım vektörleri üzerindendir: n=200, k=4'te \binom{203}{3}=1373701 vektör.
- Ölçüt olasılıktır: gözlenenden daha olası olmayan tüm tablolar (EMT::multinomial.test ve XNomial "Prob" tanımı). X^2'ye göre sıralayan kesin test farklı bir p verir.
Koddaki tercih
Tüm vektörler tek tek sayılmaz. Kategoriler iki yarıya bölünür; her yarının olası alt sayımları ve log-olasılıkları bir kez hesaplanır, alt toplamı s olan A-yarısı parçaları, alt toplamı n-s olan B-yarısının sıralanmış parçalarıyla ikili aramayla eşlenir ("ortada buluşma", hypothesis.py:463–509). İş yükü \binom{n+a}{a}+\binom{n+b}{b} satırdır; 6 milyonu aşarsa Monte Carlo'ya geçilir.
Monte Carlo seçeneği R chisq.test(p = , simulate.p.value = TRUE) tanımını izler (hypothesis.py:5920–5940):
- B=10000; tohum (seed) arayüzden, varsayılan 12345; üreteç
numpy.random.default_rng. - \varepsilon: makine duyarlığı; eşitlikleri kayan nokta hatasından korur.
- Payda ve paydaki 1, gözlenen tablonun da benzetim kümesine sayılmasıdır; p_{\text{MC}} hiçbir zaman 0 olmaz.
Kesin ya da Monte Carlo seçildiğinde ana p, karar ve APA cümlesi bu p'ye geçer; asimptotik p "Ana p ve karar …" satırında ayrıca yazılır (hypothesis.py:5942–5954).
26.5.6 Kategori bazlı binom testleri
Her kategori için O_j, \text{Binom}(n,\,p_j)'ye karşı iki yönlü kesin binom testiyle (minimum olabilirlik, Bölüm 22.5.2) sınanır; k p değeri Holm (varsayılan) ya da Bonferroni ile düzeltilir (hypothesis.py:5955–5969):
- p_{(1)}\le\dots\le p_{(k)}: sıralanmış ham p'ler; Holm adım adım azalan çarpan ve tekdüzelik (max) kuralı kullanır (R
p.adjustile aynı).
26.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/chisquare_gof/elle_hesap.py ile, MerQur kodu çağrılmadan hesaplanmıştır. Kesin p, toplamı 200 olan 1373701 sayım vektörünün tamamı numpy ile taranarak bulunmuştur (MerQur'un ortada buluşma algoritmasından bağımsız).
Adım 1 — Sıklıklar. A 83, B 27, AB 8, 0 82; n=200, k=4, sd =3.
Adım 2 — Eşit dağılım. E_j=50.
Pearson artıkları 33/\sqrt{50}=4{,}67 (A), -3{,}25 (B), -5{,}94 (AB), 4{,}53 (0); dördü de \lvert r\rvert>2. Düzeltilmiş artıklar \sqrt{1-0{,}25}=0{,}866'ya bölünerek 5{,}389; -3{,}756; -6{,}859; 5{,}226 olur. G=102{,}6666, p_G=4{,}15\times10^{-22}. Kesin çokterimli p=5{,}7887\times10^{-22}. w=\sqrt{88{,}12/200}=0{,}6638 (büyük), V=0{,}3832.
Adım 3 — Türkiye oranları: beklenen sıklıklar. E=200\times(0{,}42;\ 0{,}16;\ 0{,}07;\ 0{,}35)=(84;\ 32;\ 14;\ 70). En küçük E=14\ge5; uyarı çıkmaz.
Adım 4 — X^2 terimleri.
p=P(\chi^2_3\ge5{,}4217)=0{,}143396; %5 kritik değer 7,8147'dir. Katkının yarısına yakını AB'nin azlığından (2,57), kalanı 0 grubunun fazlalığından (2,06) gelir.
Adım 5 — G terimleri. 2O_j\ln(O_j/E_j): -1{,}9880; -9{,}1745; -8{,}9539; 25{,}9487; toplam G=5{,}832289, p_G=0{,}120061.
Adım 6 — Etki büyüklüğü. w=\sqrt{5{,}421726/200}=0{,}164647 (küçük); V=w/\sqrt3=0{,}095059.
Adım 7 — Artıklar. Pearson: -0{,}109; -0{,}884; -1{,}604; 1{,}434. Düzeltilmiş: AB için (8-14)/\sqrt{14\times0{,}93}=-1{,}663; 0 için 12/\sqrt{70\times0{,}65}=1{,}779. Hiçbiri \lvert r\rvert>2 değildir.
Adım 8 — Kesin çokterimli p. Gözlenen vektörün olasılığı P(\mathbf O)=3{,}9496\times10^{-5}. Olasılığı bundan büyük olmayan vektörlerin toplamı p_{\text{kesin}}=0{,}150221. Aynı tarama X^2 ölçütüyle (X^2(\mathbf x)\ge5{,}4217) 0{,}142078 verir; MerQur ilkini raporlar.
Adım 9 — Monte Carlo. Tohum 12345: 10000 benzetimden b=1430'unun X^2'si gözlenene eşit ya da büyük; p_{\text{MC}}=1431/10001=0{,}143086. Tohum 2026: b=1394, p_{\text{MC}}=0{,}139486. Kesin X^2 ölçütlü p (0,142078) çevresindeki Monte Carlo SH'si \sqrt{0{,}142\times0{,}858/10000}=0{,}0035'tir; iki tohum da bu belirsizlik içindedir.
Adım 10 — Kategori binom testleri. Ham p: A 0,942919; B 0,385282; AB 0,124809; 0 0,087887. Holm: en küçük (0) \times4=0{,}351546; AB \times3=0{,}374427; B \times2=0{,}770564; A \times1=0{,}942919. Bonferroni: 1; 1; 0,499235; 0,351546.
26.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan, stats.hypothesis modülünde round() bellekte etkisizleştirilerek alınmıştır (dogrulama/chisquare_gof/merqur_calistir.py). R: 4.5.3; chisq.test (X^2, artıklar), DescTools::GTest, EMT::multinomial.test ve XNomial::xmulti (kesin p; olasılık, X^2 ve LLR ölçütleri), binom.test + p.adjust. Monte Carlo p'nin R karşılığı yoktur (farklı rastgele sayı üreteci); bağımsız Python aynı algoritmayı numpy ile aynı tohumla yeniden kurmuştur. Yalnız metinde yazılan w, V ve Pearson artıkları gösterilen ondalıkta karşılaştırılmıştır.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Eşit dağılım: Pearson X^2 | 88,120000 | 88,120000 | 88,120000 | 0,0e+00 | ✓ |
| Eşit dağılım: asimptotik p | 5,5502·10−19 | 5,5502·10−19 | 5,5502·10−19 | 2,5e−33 | ✓ |
| Eşit dağılım: G | 102,666551 | 102,666551 | 102,666551 | 5,0e−13 | ✓ |
| Eşit dağılım: G için p | 4,1502·10−22 | 4,1502·10−22 | 4,1502·10−22 | 5,6e−37 | ✓ |
| Eşit dağılım: kesin çokterimli p (olasılık ölçütü) | 5,7887·10−22 | 5,7887·10−22 | 5,7887·10−22 | 1,4e−34 | ✓ |
| Eşit dağılım: Cohen w | 0,6638 | 0,663777 | 0,663777 | 3,3e−16 | ✓ (4 ondalık) |
| Eşit dağılım: Cramér V | 0,3832 | 0,383232 | 0,383232 | 3,9e−16 | ✓ (4 ondalık) |
| Eşit dağılım: AB düzeltilmiş artık | −6,858571 | −6,858571 | −6,858571 | 1,8e−15 | ✓ |
| Eşit dağılım: AB binom p | 1,8687·10−15 | 1,8687·10−15 | 1,8687·10−15 | 1,8e−29 | ✓ |
| Türkiye oranları: Pearson X^2 | 5,421726 | 5,421726 | 5,421726 | 4,4e−15 | ✓ |
| Türkiye oranları: asimptotik p | 0,143396 | 0,143396 | 0,143396 | 1,7e−16 | ✓ |
| Liste girişi (0, A, B, AB sırası): X^2 | 5,421726 | 5,421726 | 5,421726 | 8,9e−16 | ✓ |
| Liste girişi: p | 0,143396 | 0,143396 | 0,143396 | 1,7e−16 | ✓ |
| Ağırlık sütunlu özet tablo: p | 0,143396 | 0,143396 | 0,143396 | 1,7e−16 | ✓ |
| Türkiye oranları: G | 5,832289 | 5,832289 | 5,832289 | 5,3e−14 | ✓ |
| Türkiye oranları: G için p | 0,120061 | 0,120061 | 0,120061 | 2,9e−15 | ✓ |
| Kesin çokterimli p (olasılık ölçütü) | 0,150221 | 0,150221 | 0,150221 | 4,2e−15 | ✓ |
| Kesin p, XNomial (olasılık ölçütü) | 0,150221 | 0,150221 | 0,150221 | 2,6e−14 | ✓ |
| Cohen w | 0,1646 | 0,164647 | 0,164647 | 1,1e−16 | ✓ (4 ondalık) |
| Cramér V (uyum iyiliği tanımı) | 0,0951 | 0,095059 | 0,095059 | 2,8e−17 | ✓ (4 ondalık) |
| G seçiliyken Cohen w (X^2'den) | 0,1646 | 0,164647 | 0,164647 | 1,1e−16 | ✓ (4 ondalık) |
| Standart artık, A | −0,11 | −0,109109 | −0,109109 | 1,9e−16 | ✓ (2 ondalık) |
| Standart artık, B | −0,88 | −0,883883 | −0,883883 | 3,3e−16 | ✓ (2 ondalık) |
| Standart artık, AB | −1,60 | −1,603567 | −1,603567 | 3,3e−15 | ✓ (2 ondalık) |
| Standart artık, 0 | 1,43 | 1,434274 | 1,434274 | 2,2e−15 | ✓ (2 ondalık) |
| Düzeltilmiş artık, A | −0,143267 | −0,143267 | −0,143267 | 2,2e−15 | ✓ |
| Binom p, A | 0,942919 | 0,942919 | 0,942919 | 8,9e−16 | ✓ |
| Holm p, A | 0,942919 | 0,942919 | 0,942919 | 8,9e−16 | ✓ |
| Bonferroni p, A | 1 | 1 | 1 | 0,0e+00 | ✓ |
| Düzeltilmiş artık, B | −0,964396 | −0,964396 | −0,964396 | 1,7e−15 | ✓ |
| Binom p, B | 0,385282 | 0,385282 | 0,385282 | 4,2e−15 | ✓ |
| Holm p, B | 0,770564 | 0,770564 | 0,770564 | 7,3e−15 | ✓ |
| Bonferroni p, B | 1 | 1 | 1 | 0,0e+00 | ✓ |
| Düzeltilmiş artık, AB | −1,662822 | −1,662822 | −1,662822 | 6,7e−16 | ✓ |
| Binom p, AB | 0,124809 | 0,124809 | 0,124809 | 3,5e−16 | ✓ |
| Holm p, AB | 0,374427 | 0,374427 | 0,374427 | 2,1e−15 | ✓ |
| Bonferroni p, AB | 0,499235 | 0,499235 | 0,499235 | 2,4e−15 | ✓ |
| Düzeltilmiş artık, 0 | 1,778998 | 1,778998 | 1,778998 | 2,9e−15 | ✓ |
| Binom p, 0 | 0,087887 | 0,087887 | 0,087887 | 6,9e−17 | ✓ |
| Holm p, 0 | 0,351546 | 0,351546 | 0,351546 | 1,1e−16 | ✓ |
| Bonferroni p, 0 | 0,351546 | 0,351546 | 0,351546 | 1,1e−16 | ✓ |
| Monte Carlo p (tohum 12345, B = 10000) | 0,143086 | 0,143086 | — | 0,0e+00 | ✓ |
| Monte Carlo p (tohum 2026) | 0,139486 | 0,139486 | — | 0,0e+00 | ✓ |
| G + Monte Carlo: MC p (G ölçütüyle) | 0,121288 | 0,121288 | — | 0,0e+00 | ✓ |
Sonuç: 44 büyüklüğün tamamı ölçütü karşılar. Eşit dağılımda EMT::multinomial.test 0,000149 döndürmüştür; bu, 10^{-22} düzeyindeki olasılıklarda EMT'nin sayısal sınırıdır. XNomial ve bağımsız tam tarama MerQur ile aynı değeri (5{,}7887\times10^{-22}) verir; tabloda R sütununda XNomial değeri vardır.
26.7 Çıktıyı okuma
Türkiye oranları, etki + artık + kesin p + Holm açıkken sonuç metni:
TEST: Ki-Kare Uyum İyiliği Testi
──────────────────────────────────────────────────
İstatistik : 5.4217
p-değeri   : 0.150221  ns
df         : 3.0

KARAR: H₀ REDDEDİLEMEZ  ns

χ²(3) = 5.4217, p = 0.1502 ns. n = 200, k = 4, beklenen oran: A=0.420, B=0.160, AB=0.070, 0=0.350. H₀ REDDEDİLEMEZ.
Kategori sırası (beklenen oranların eşlendiği): A, B, AB, 0

── ETKİ BÜYÜKLÜKLERİ ──
    Cohen's w = 0.1646   Cramér's V = 0.0951

── STANDART ARTIKLAR (|>2| dikkat) ──
(gözlenen−beklenen)/√beklenen; |artık|>2 hücre farkı belirgindir.
    A: -0.11
    B: -0.88
    AB: -1.60
    0: +1.43

    Kesin çokterimli test (olasılık ölçütü): p = 0.150221

Ana p ve karar seçilen yönteme dayanır: kesin çokterimli p = 0.150221 (asimptotik p = 0.143396).

── Kategori bazlı binom testleri (düzeltme: holm) ──
    A                O = 83, E = 84.00, düzeltilmiş artık = -0.143, p = 0.9429, p adj = 0.9429
    B                O = 27, E = 32.00, düzeltilmiş artık = -0.964, p = 0.3853, p adj = 0.7706
    AB               O = 8, E = 14.00, düzeltilmiş artık = -1.663, p = 0.1248, p adj = 0.3744
    0                O = 82, E = 70.00, düzeltilmiş artık = +1.779, p = 0.0879, p adj = 0.3515

Beklenen frekansı 5'ten küçük hücre: 0 (%0.0); en küçük beklenen frekans = 14.00.

── APA 7 ÖZET ──
χ²(3, N = 200) = 5.42, p = .150 (kesin çokterimli)
| Satır | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| İstatistik / df | X^2 (ya da G), sd =k-1 | Kesin p seçilse de istatistik satırı X^2'dir. |
| p-değeri | Ana p | Kesin/MC seçiliyse o p; değilse asimptotik. ns, *, **, *** anlamlılık işaretleridir. |
| Yorum satırı | X^2, p (4 ondalık), n, k, ölçeklenmiş oranlar | Burada asimptotik değil ana p yazılır. |
| Kategori sırası | Oranların eşlendiği sıra | Liste girişinde mutlaka denetlenmeli. |
| Etki büyüklükleri | w, V | Her zaman Pearson X^2'den. |
| Standart artıklar | Pearson r_j | Yıldız \lvert r_j\rvert>2 demektir; tutucu ölçüttür (26.5.4). |
| Kesin / MC satırı ve "Ana p" notu | Seçilen p ve asimptotik p | Karar seçilen p'ye dayanır. |
| Kategori testleri | O, E, düzeltilmiş artık, ham ve düzeltilmiş p | Hangi kategorinin sapma gösterdiğini çoklu karşılaştırma denetimiyle söyler. |
| Dipnot / uyarı | E_j<5 hücre sayısı ve en küçük E | Herhangi bir hücre <5 ise uyarı satırı da eklenir (gof_warn_low_expected). |
| Frekans sekmesi | Kategori, Gözlenen, Beklenen, Fark | Beklenen ve fark 2 ondalık. |
| Grafik | Gözlenen ve beklenen çubuklar |
Eşit dağılım (varsayılan) çalıştırmasında: "χ²(3) = 88.1200, p < .001 ***"; APA "χ²(3, N = 200) = 88.12, p < .001".
APA biçiminde rapor cümlesi:
200 hastanın kan grubu dağılımı (A %41,5, 0 %41,0, B %13,5, AB %4,0) Türkiye nüfus oranlarından (A %42, 0 %35, B %16, AB %7) anlamlı biçimde farklı değildi, \chi^2(3, N = 200) = 5{,}42, kesin çokterimli p = 0{,}150, Cohen w = 0{,}16. Holm düzeltmeli kategori testlerinin hiçbiri anlamlı değildi.
26.8 Uzman soruları
S1. Kesin p neden asimptotik p'den büyük (0,150 > 0,143)?
İki farklı sıralama ölçütü kullanılıyor. MerQur'un kesin testi tabloları olasılıklarına göre sıralar; asimptotik p ise X^2'ye göre. X^2 ölçütüyle kesin test 0,142078 verir ve asimptotik 0,143396'ya çok yakındır. Olasılık ölçütü, p_j'leri eşit olmayan dağılımlarda X^2 ölçütünden ayrışır; ikisi de geçerli kesin testtir. MerQur ilkini kullanır ve kod yorumunda EMT::multinomial.test tanımını kaynak gösterir (hypothesis.py:463–469).
S2. Monte Carlo p neden kesin p'ye eşit değil?
Monte Carlo benzetimi X^2 ölçütünü kullanır (R chisq.test gibi), kesin seçenek olasılık ölçütünü. MC p (0,1431) kesin X^2 ölçütlü p'nin (0,1421) bir kestirimidir; 0,1502 ile karşılaştırılmamalıdır. Tohum değişince MC p yaklaşık \pm0{,}0035 (bir SH) oynar.
S3. G-testi ile X² hangisi?
İkisi de asimptotik olarak \chi^2_{k-1}'dir. Küçük beklenen sıklıklarda X^2'nin ki-kare yaklaşımı genellikle G'ninkinden iyidir; G ise iç içe modellerin karşılaştırılmasında toplanabilirlik (bölümlenebilirlik) avantajı taşır. Tıp verisinde G=5{,}83, X^2=5{,}42. MerQur'da G seçildiğinde ana istatistik satırı ve APA özeti "G" etiketini taşır ve Monte Carlo benzetimi de G ölçütüyle kurulur (26.5.2).
S4. Beklenen sıklık 5'ten küçükse ne yapmalı?
MerQur tek bir hücre bile 5'in altındaysa uyarır (Cochran'ın "hücrelerin en çok %20'si, hiçbiri 1'in altında" kuralından katıdır). Seçenekler: kesin çokterimli p (n ve k küçükse), Monte Carlo p, ya da kuramsal olarak anlamlıysa kategorileri birleştirmek. Kesin hesap n=200, k=4'te 1,4 milyon tabloyu tarar; ortada buluşma bunu saniyeler içinde yapar.
S5. Beklenen oranlar veriden kestirildiyse (ör. Poisson ortalaması) sd ne olmalı?
Kestirilen her parametre için sd bir azalır: k-1-m. MerQur sd'yi her zaman k-1 alır; kestirilen parametre sayısını soran bir seçenek yoktur (hypothesis.py:5876). Bu durumda p fazla büyük (tutucu) çıkar; doğru p için P(\chi^2_{k-1-m}\ge X^2) elle hesaplanmalıdır. R chisq.test de düzeltme yapmaz.
S6. Neden Pearson artığı yerine düzeltilmiş artığa bakılmalı?
Pearson artığının varyansı 1-p_j'dir. Büyük oranlı kategoride (Türkiye verisinde A, p=0{,}42) Pearson artığı düzeltilmişinin \sqrt{0{,}58}=0{,}76 katıdır. "\lvert r\rvert>2" eşiği yalnız düzeltilmiş artıkta yaklaşık %5 anlamlılığa karşılık gelir. MerQur düzeltilmiş artığı "Kategori bazlı testler" bloğunda verir.
S7. Sayım tablosu (kategori + frekans) verisi nasıl girilir?
"Ağırlık (frekans) sütunu" seçilir. Satırlar ağırlıklarıyla toplanır. Tıp verisinin dört satırlık özet tablosuyla ham 200 satırlık veri aynı X^2 ve p'yi verir (doğrulama tablosu). Ağırlıklar tam sayı değilse kesin ve Monte Carlo p hesaplanmaz (hypothesis.py:5908, 5920), kategori binom testleri sayıları yuvarlar.
S8. Başka yazılımlarla karşılaştırırken nelere bakılmalı?
Beklenen değerlerin kategorilerle hangi sırada eşleştiğine bakılmalıdır: MerQur'un liste girişi sayısal kodlarda kategori kod sırasını kullanır. Kesin p karşılaştırılırken hangi sıralama ölçütünün kullanıldığına bakılmalıdır; MerQur'un kesin p'si olasılık ölçütlüdür (S1).
26.9 Sık hatalar ve tuzaklar
- Liste girişinde oranları yanlış kategoriye eşlemek. Sıra MerQur'un ortak düzey sırasıdır (tanımlı sıra, sayısal/doğal sıra ya da verideki ilk görülme sırası). Çıktıdaki "Kategori sırası" satırına bakın ya da adla girin.
- "Anlamlı değil" sonucunu "nüfusla aynı" diye okumak. Tıp örneğinde AB %4 gözlendi, beklenen %7'dir; n=200 bu farkı ayırt etmeye yetmez. Etki büyüklüğü (w=0{,}16) ve kategori testleri birlikte raporlanmalıdır.
- Eşit dağılım hipotezini varsayılan diye kullanmak. Kutu boş bırakılırsa p_j=1/k sınanır. Kan grubu gibi doğal olarak eşit olmayan değişkenlerde bu anlamsız bir H_0'dır; çok küçük p bilgi taşımaz.
- G seçiliyken APA cümlesindeki istatistiği X^2 sanmak. "G" etiketli değer G'dir; Cohen w ise Pearson X^2'den hesaplanır.
- Pearson artığı \lvert r\rvert>2 ile kategori "anlamlı" demek. Tutucudur ve çoklu karşılaştırma düzeltmesi içermez; kategori bazlı testleri kullanın.
- Yüzdeleri oran kutusuna yazıp toplamı denetlememek. MerQur oranları kendisi ölçekler; 42, 16, 7, 35 doğru, ama bir yazım hatası da sessizce ölçeklenir.
- Sürekli veriyi sınıflayıp normal dağılıma uyum sınamak. Ortalama ve SS veriden kestirildiğinde sd düşmelidir; MerQur düşürmez. Normallik için Bölüm 3'ü kullanın.
26.10 Kaynaklar
- Agresti, A. (2013). Categorical data analysis (3rd ed.). Wiley.
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum.
- Cressie, N., & Read, T. R. C. (1984). Multinomial goodness-of-fit tests. Journal of the Royal Statistical Society: Series B (Methodological), 46(3), 440–464. https://doi.org/10.1111/j.2517-6161.1984.tb01318.x
- Haberman, S. J. (1973). The analysis of residuals in cross-classified tables. Biometrics, 29(1), 205–220. https://doi.org/10.2307/2529686
- Hope, A. C. A. (1968). A simplified Monte Carlo significance test procedure. Journal of the Royal Statistical Society: Series B (Methodological), 30(3), 582–598. https://doi.org/10.1111/j.2517-6161.1968.tb00759.x
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897