45. Çoklu Doğrusal Regresyon
Analiz kimliği: regression · Menü adı: Doğrusal Regresyon (Multiple Linear Regression) · Panel: gui/panels/analyses/linear_regression.py · Motor: stats/regression.py, Regression.linear (satır 343–756), _fit_qr (181–202); ek çıktılar stats/linlogit_extras.py, stats/regression_extras.py, stats/lof_het.py
45.1 Ne işe yarar
Çoklu doğrusal regresyon, sürekli bir bağımlı değişkeni (Y) birden çok açıklayıcı değişkenin (X) doğrusal birleşimiyle açıklar. Cevapladığı sorular şunlardır: "Yaş, BMI, tuz tüketimi ve egzersiz birlikte sistolik kan basıncının (SKB) ne kadarını açıklıyor?", "Diğerleri sabitken her yaş yılı SKB'yi kaç mmHg artırıyor?", "Bu özelliklere sahip bir hastanın beklenen SKB'si nedir?"
- y_i: i. hastanın bağımlı değişken değeri (SKB, mmHg).
- x_{ij}: j. açıklayıcının değeri; k açıklayıcı sayısı, p=k+1 sabit dahil parametre sayısı.
- \beta_j: kısmi eğim; diğer açıklayıcılar sabitken x_j'deki bir birimlik artışın y'nin ortalamasında yarattığı değişim.
- \varepsilon_i: hata terimi; ortalaması 0, varyansı sabit \sigma^2.
- \mathbf X: başına 1'ler sütunu eklenmiş n\times p tasarım matrisi.
Ne zaman kullanılır? Bağımlı değişken sürekli (ya da çok değerli ve yaklaşık simetrik) ise; amaç birden çok etkenin birbirinden arındırılmış etkisini kestirmek ya da tahmin yapmaksa. Açıklayıcılar sayısal ya da kategorik olabilir (kategorikler kukla kodlanır).
Ne zaman kullanılmaz?
- Bağımlı değişken ikili ise: İkili Lojistik Regresyon; sayımsa: Poisson / Negatif Binom Regresyon; sıralı ise: Sıralı Lojistik Regresyon.
- Aykırı değerler kestirimi belirliyorsa: Sağlam Regresyon (MM).
- Dağılımın ortası değil uçları ilgileniliyorsa: Kantil Regresyon.
- Açıklayıcı sayısı gözlem sayısına yakınsa ya da çoklu doğrusal bağıntı çok güçlüyse: Ridge / Lasso / Elastik Ağ.
- Gözlemler kümeli ya da tekrarlıysa: Doğrusal Karma Model ya da GEE.
- İlişki parametrelerinde doğrusal değilse: Doğrusal Olmayan Regresyon.
Sık karıştırılan analizler. Pearson korelasyonu iki değişken arasındaki ilişkinin gücünü ölçer, diğerlerini denetlemez; çoklu regresyonun "sıfırıncı derece" korelasyonu odur. ANCOVA aynı doğrusal modeldir, ama soru kategorik faktörün düzeltilmiş ortalamalarıdır. Ağırlıklı Doğrusal Regresyon (Survey Reg.) karmaşık örneklem tasarımında tasarım tabanlı SH verir; bu modüldeki WLS ağırlığı ise varyansı modelleyen ağırlıktır.
45.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Doğrusallık | E(y\mid\mathbf x) açıklayıcıların doğrusal fonksiyonu. | İsteğe bağlı RESET testi; artık–tahmin grafiği (varsayılan Grafik); kısmi regresyon grafikleri; uyum eksikliği testi. |
| Bağımsız hatalar | Gözlemler birbirini etkilemez. | Her çalıştırmada Durbin–Watson; 1,5–2,5 dışında uyarı (regression.py:608–613). |
| Sabit varyans | \operatorname{Var}(\varepsilon_i)=\sigma^2 her \mathbf x'te aynı. | Her çalıştırmada Breusch–Pagan (Koenker); p<0{,}05 ise uyarı. İsteğe bağlı özgün BP ve White. |
| Normal hatalar | \varepsilon_i\sim N; küçük örneklemde t ve F testlerinin kesinliği için. | Her çalıştırmada artıklara Shapiro–Wilk; p<0{,}05 ise uyarı. |
| Çoklu doğrusal bağıntı yok | Açıklayıcılar birbirinin doğrusal birleşimi değil. | Her çalıştırmada VIF (> 5 orta, > 10 sorun); tam bağımlılıkta QR ile sütun çıkarılır; isteğe bağlı koşul indeksi ve varyans oranları. |
| Aykırı / etkili gözlem yok | Tek gözlem kestirimi belirlememeli. | İsteğe bağlı Cook D, kaldıraç, DFFITS, DFBETAS, Bonferroni aykırı testi. |
Eksik değer. Bağımlı değişkeni sayıya çevrilemeyen ya da eksik olan satır önce atılır; sonra seçilen açıklayıcılardan herhangi birinde eksik olan satır çıkarılır (liste bazında, ml/_preprocessing.py:318–321, çağrı regression.py:294–297).
Uç durumlar (koddan).
- Satır sayısı k+2'den azsa hata verilir (
min_rows,regression.py:321). - Tek değerli (varyansı sıfır) açıklayıcı modelden çıkarılır ve nedeniyle birlikte uyarılır (
regression.py:330–341). - Bir sütun diğerlerinin doğrusal birleşimiyse (QR toleransı 10^{-7}), o sütun R
lm()gibi "—" (NA) katsayıyla çıkarılır ve uyarılır. Sabit terimin kendisi çıkarılacaksa hata verilir (regression.py:500–515). - Birim uzunluğa ölçekli tasarımın koşul sayısı 10^7'yi aşarsa "kötü koşullu" uyarısı (558–559).
- Artıklar yuvarlama gürültüsü düzeyindeyse (tam uyum; R
summary.lmölçütü) DW, BP ve SW hesaplanmaz (566–577). - WLS ağırlığı ya da sabit terimsiz model; değişken seçimi, bloklar, ZPP ve etkili gözlem seçenekleriyle birlikte kullanılamaz (
regression.py:384–386).
45.3 Parametreler
Varsayılanlar linear_regression.py:206–245 (read_options) ve formdan (add_form_rows, 41–65) alınmıştır; tümü varsayılanda kapalıdır ve sonucu değiştirmez.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımlı değişken | ilk sayısal sütun | Sürekli Y. | — |
| Bağımsız değişkenler | en az 1 | Sayısal ya da kategorik X. | Metin sütunları ve "kategorik" işaretli sütunlar otomatik kukla kodlanır. |
| Güven düzeyi | %95 | Katsayı GA'sı ve tahmin aralıkları. | GA genişliği. |
| Standart hata türü | Klasik (OLS) | HC0, HC1, HC2, HC3 sandviç SH. | SH, t, p, GA; model F satırı Wald F'ye döner. Katsayılar değişmez. |
| Standartlaştırılmış katsayılar (β) | kapalı | Ek sütun: b_j\,s_{x_j}/s_y. | Ek sütun. |
| Değişken seçim yöntemi | Enter (tümü) | İleriye, geriye, adımsal (kısmi F p'sine göre). | Modele giren değişkenler. |
| PIN / POUT | 0,05 / 0,10 | Giriş ve çıkış eşikleri. | Yalnız adımsal yöntemlerde. POUT < PIN ise POUT = 1,1·PIN alınır ve uyarılır. |
| Hiyerarşik bloklar | boş | "a, b | c" biçiminde bloklar. | Blok başına \Delta R^2 ve F değişimi tablosu. |
| Kategorik (faktör) değişkenler | boş | Sayısal kodlu sütunları kukla kodlatır. | Tasarım matrisi. |
| Etkileşim terimleri | boş | x1*x2 ya da x1:x2. |
Tasarım matrisi. |
| Referans kategori (faktörler) | İlk düzey | Kukla kodlamada referans; ilk düzey MerQur düzey sırasına göredir (kullanıcı sırası → sayısal/doğal sıra → verideki ilk görülme sırası). | Kukla katsayılarının anlamı. |
| Ek çıktı: Sıfırıncı derece / kısmi / yarı-kısmi korelasyonlar | kapalı | ZPP sütunları ve sr^2. | Ek bölüm. |
| Ek çıktı: Etkili gözlem tanıları | kapalı | Cook D, kaldıraç, Mahalanobis, DFFITS, DFBETAS, SDRESID. | Ek bölüm; gözlem tablosu Frekans sekmesinde. |
| Tüm alt kümeler | kapalı (en iyi k = 3, ölçüt Düz. R²) | En çok 15 aday terimin tüm alt kümeleri. | Ek tablo; isteğe bağlı en iyi modelle yeniden uydurma. |
| WLS ağırlık değişkeni | (yok) | Ağırlıklı en küçük kareler; ağırlığı eksik ya da ≤ 0 satır dışlanır. | Tüm kestirimler. |
| WLS ağırlık kaynağı (güç), başlangıç/bitiş/adım | (yok); −2 / 2 / 0,5 | w=1/x^{p}; p ızgarasında log-olabilirliği en büyük olan seçilir. | Tüm kestirimler. |
| Ek çıktılar (2): ANOVA tablosu + SEE / Eşdoğrusallık tanıları / RESET testi | kapalı | Kareler toplamı tablosu; tolerans, özdeğer, koşul indeksi; Ramsey RESET. | Ek bölümler. |
| Tahmin + GA/PI / Veri setine kaydet / Sabit terimsiz model | kapalı | Satır başına tahmin, ortalama GA ve birey tahmin aralığı; PRE, RES, ZRE, LMCI, UMCI, LICI, UICI sütunları; \beta_0=0 modeli. | Ek bölüm / yeni sütunlar / tüm kestirimler. |
| Model tanıları: Uyum eksikliği / Değişen varyans testleri | kapalı | Saf hata F testi; özgün BP ve White. | Ek bölüm. |
| Chow kırılma testi | Yok | Gözlem sırasına ya da grup değişkenine göre yapısal kırılma. | Ek bölüm. |
| Tanı grafiği | Artık – tahmin | ZRESID × ZPRED, histogram + P-P + Q-Q, kısmi regresyon, 3B düzlem. | Yalnız Grafik. |
Sağlam (HC) SH seçilince ne değişir, ne değişmez?
Katsayılar aynı kalır; yalnız varyans kestirimi değişir. p ve GA yine t_{n-p} dağılımından alınır (R coeftest(df = n − p) ve Long ile Ervin 2000 ile aynı). Model satırındaki F artık klasik F değil, sandviç kovaryanslı Wald F'dir. Bu yüzden HC seçilince model F'si de değişir; R^2 değişmez.
45.4 Tıp örneği
Dosya: english/datasets/Tip/39_multiple_regression_bp.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/39_coklu_regresyon_KB.xlsx: sistolik_KB, yas, BMI, tuz_g_gun, egzersiz_saat_hafta). Değişken seçimi VIDEO_SCRIPT_TR.txt #39'dan alınmıştır.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
systolic_bp |
Bağımlı | sürekli (mmHg) | ort. 160,37; SS 13,57; 131–200 |
age |
Açıklayıcı | sürekli (yıl) | ort. 50,56; SS 15,69; 25–79 |
BMI |
Açıklayıcı | sürekli (kg/m²) | ort. 26,11; SS 3,75; 18,0–36,3 |
salt_g_day |
Açıklayıcı | sürekli (g/gün) | ort. 7,86; SS 3,42; 2,2–13,7 |
exercise_hour_week |
Açıklayıcı | sürekli (saat/hafta) | ort. 5,10; SS 2,89; 0,1–10,0 |
n ve eksik değer: 200 hasta, hiçbir sütunda eksik değer yok; modelde 200 gözlem, p=5 parametre, artık serbestlik derecesi n-p=195.
Klinik soru: Yaş, BMI, günlük tuz tüketimi ve haftalık egzersiz süresi, birbirlerinin etkisi denetlendiğinde sistolik kan basıncıyla ilişkili mi? Her birinin bağımsız katkısı ne kadar?
Seçilen ayarlar: Arayüz varsayılanları (klasik SH, Enter, %95). Hesap yürüyüşü için ikinci bir çalıştırmada standartlaştırılmış katsayılar, ZPP, etkili gözlem, ANOVA, eşdoğrusallık, RESET, tahmin, uyum eksikliği ve değişen varyans testleri açılmıştır; ayrıca HC0–HC3 ve geriye doğru seçim çalıştırmaları yapılmıştır.
45.5 Formüller ve hesap adımları
MerQur önce tasarımı kurar (gerekirse kukla, etkileşim, seçim ya da bloklar), sonra QR ayrışımıyla rank denetimi yapar ve eşdoğrusal sütunları çıkarır. Modeli statsmodels OLS (ya da WLS) ile, ama kovaryansı kendi Householder QR'ından kurarak kestirir. Ardından her çalıştırmada dört tanıyı (DW, VIF, Koenker BP, artık SW) hesaplar ve seçilen ek çıktıları ekler.
45.5.1 En küçük kareler kestirimi
- \mathbf X^{\top}\mathbf X: p\times p çapraz çarpımlar matrisi; \mathbf X^{\top}\mathbf y: çapraz çarpımlar vektörü.
- Çözüm, "normal denklemler" \mathbf X^{\top}\mathbf X\boldsymbol\beta=\mathbf X^{\top}\mathbf y'nin çözümüdür; artık vektörü \mathbf e=\mathbf y-\mathbf X\hat{\boldsymbol\beta}, \mathbf X'in tüm sütunlarına diktir.
Neden en küçük kareler?
Hatalar ortalaması sıfır, eşit varyanslı ve ilişkisizse, en küçük kareler kestiricisi doğrusal yansız kestiriciler içinde varyansı en küçük olandır (Gauss–Markov). Hatalar ayrıca normal dağılıyorsa en çok olabilirlik kestiricisiyle aynıdır ve t, F testleri kesin olur.
Koddaki tercih: Householder QR, (X'X)⁻¹ değil
Formül (\mathbf X^{\top}\mathbf X)^{-1} içerir, ama MerQur bu tersi doğrudan almaz. \mathbf X=\mathbf Q\mathbf R ayrışımı yapılır, \mathbf R^{-1} üçgen çözümle bulunur ve (\mathbf X^{\top}\mathbf X)^{-1}=\mathbf R^{-1}\mathbf R^{-\top} statsmodels'e önceden yerleştirilir (_fit_qr, regression.py:181–202). statsmodels'in varsayılan pinv (SVD) yolu ölçeklenmemiş sütunlarda duyarlık kaybediyordu: NIST Pontius verisinde katsayı LRE 6,3, R ile 12,7 (kod yorumu, 160–167). Rank denetimi R lm()'nin dqrdc2 mantığıyla yapılır: sütunlar sırayla işlenir, önceki sütunlara izdüşümünden kalan normu özgün normunun 10^{-7} katından küçük olan sütun eşdoğrusal sayılır (_qr_keep_columns, 126–155).
45.5.2 Standart hata, t testi ve güven aralığı
- SSE: artık kareler toplamı; n-p: artık serbestlik derecesi (5 parametre kestirildiği için 200 − 5 = 195).
- s: "kestirimin standart hatası" (SEE), artıkların SS'si.
- Sig sütunu seçilen \alpha'ya göredir: p\ge\alpha ise "ns"; p<\alpha ise p<0{,}001 "", <0{,}01 "", aksi "" (
_sig,regression.py:1767–1775).
Neden n − p?
\hat{\boldsymbol\beta} veriden kestirildiği için artıklar p doğrusal kısıta uyar (\mathbf X^{\top}\mathbf e=\mathbf 0). \sum e_i^2/n bu nedenle \sigma^2'yi aşağı yanlı kestirir; n-p'ye bölmek yansız kestirici verir: E(\text{SSE})=(n-p)\sigma^2.
45.5.3 Varyans ayrışımı, R², düzeltilmiş R² ve F testi
- SST: toplam kareler toplamı; SSR: regresyon (açıklanan) kareler toplamı.
- R^2: açıklanan varyans oranı; açıklayıcı eklendikçe hiç azalmaz.
- \bar R^2: serbestlik derecesiyle cezalandırılmış R^2; gereksiz açıklayıcı eklenince azalabilir.
- F: tüm eğimlerin birlikte sıfır olduğu hipotezinin testi.
45.5.4 AIC ve BIC
- \ell: normal hata varsayımıyla en büyük log-olabilirlik (\hat\sigma^2_{\text{ML}}=\text{SSE}/n).
- p+1: \beta'lara ek olarak \sigma^2 de kestirilen parametre sayılır.
Koddaki tercih: σ² parametre sayılır (R ile aynı)
statsmodels AIC'de yalnız p parametre sayar; MerQur +2 (BIC'de +\ln n) ekleyerek R AIC(lm)/BIC(lm) ile hizalar (regression.py:722–723). R extractAIC(lm) ise n\ln(\text{SSE}/n)+2p tanımını kullanır; bu, sabit bir fark kadar farklıdır. Aynı veride model karşılaştırmasında farklar değişmez, ama mutlak AIC değerleri yazılımlar arasında karşılaştırılamaz.
45.5.5 Standartlaştırılmış katsayı ve ZPP korelasyonları
- s_{x_j}, s_y: örneklem SS'leri (n-1 paydalı). WLS'de ağırlıklı SS kullanılır (
regression.py:546–562). - r_{yj\cdot\text{diğ}}: kısmi korelasyon; diğer açıklayıcılar hem y'den hem x_j'den arındırıldığında y–x_j korelasyonu.
- sr_j: yarı-kısmi (part) korelasyon; diğerleri yalnız x_j'den arındırılır. sr_j^2, x_j modelden çıkarılınca R^2'deki azalmadır.
- ZPP her zaman klasik t ile hesaplanır, HC seçilse de (
regression_extras.py:377–394).
45.5.6 Sandviç (HC) varyans kestiricileri
- h_i=\mathbf x_i^{\top}(\mathbf X^{\top}\mathbf X)^{-1}\mathbf x_i: i. gözlemin kaldıracı.
- HC0: White (1980); HC1: serbestlik derecesi düzeltmesi; HC2 ve HC3: MacKinnon ve White (1985), kaldıraçlı gözlemlerin küçülen artıklarını büyütür.
- Model testi: F_W=\hat{\boldsymbol\beta}_{1}^{\top}\widehat{\operatorname{Var}}_{\text{HC}}(\hat{\boldsymbol\beta}_{1})^{-1}\hat{\boldsymbol\beta}_{1}/k\sim F_{k,\,n-p}.
Neden HC3 küçük örneklemde önerilir?
Kaldıraçlı gözlemlerde en küçük kareler doğruyu kendine çeker; artık e_i gerçek hatadan küçük çıkar (\operatorname{Var}(e_i)=\sigma^2(1-h_i)). HC0 bu küçülmeyi düzeltmez ve küçük n'de varyansı aşağı yanlı kestirir. HC3, birini dışarıda bırak jackknife kestiricisine yakındır ve benzetimlerde n<250 için kapsama oranı en iyi olanıdır (Long ve Ervin 2000).
45.5.7 Tanılar: Durbin–Watson, VIF, Breusch–Pagan, Shapiro–Wilk
- d\approx2(1-\hat\rho_1); 2'ye yakınsa birinci dereceden otokorelasyon yoktur. MerQur d'nin p değerini hesaplamaz; 1,5–2,5 dışında uyarı yazar (
regression.py:608–613). d satır sırasına bağlıdır; sıranın anlamı yoksa (kesitsel veri) yorum da yoktur. - R_j^2: x_j'nin diğer açıklayıcılar ve sabit üzerine regresyonunun R^2'si (
vif_values,linlogit_extras.py:42–62). WLS'de ağırlıklı regresyondan alınır.
- R^2_{e^2}: kare artıkların açıklayıcılar üzerine yardımcı regresyonunun R^2'si.
- Koenker (1981) biçimi (studentize) hataların normal olmasını gerektirmez; MerQur'un her çalıştırmada verdiği "Breusch-Pagan" budur (statsmodels
het_breuschpagan,regression.py:642), Rlmtest::bptest()varsayılanıyla aynıdır. - Özgün Breusch ve Pagan (1979) biçimi normal hata varsayar; "Değişen varyans testleri" kutusuyla ayrıca verilir, White testiyle birlikte (kareler ve çapraz çarpımlar, n R^2).
Aynı adla iki farklı test
Tanı bölümündeki "Breusch-Pagan: LM = 1.3969" Koenker'in studentize testidir; "Değişen varyans testleri" bölümündeki "Breusch-Pagan (özgün, studentize edilmemiş)" ise 1,2473 verir. Raporda hangisinin kullanıldığı yazılmalıdır.
45.5.8 Etkili gözlem tanıları
- r_i (SRESID): iç studentize artık; t_i (SDRESID): dış studentize (silinmiş) artık, s_{(i)}^2=[\text{SSE}-e_i^2/(1-h_i)]/(n-p-1).
- D_i: Cook uzaklığı; tüm katsayıların i. gözlem çıkarılınca ne kadar değiştiğinin ölçüsü.
- DFBETAS_{ij}=\left(\hat\beta_j-\hat\beta_{j(i)}\right)/\left(s_{(i)}\sqrt{[(\mathbf X^{\top}\mathbf X)^{-1}]_{jj}}\right).
- Eşikler (
influence_summary,regression_extras.py:428–454): D>4/n ve D>1; h>2p/n; Mahalanobis (n-1)(h_i-1/n) için \chi^2_k p<0{,}001; |\text{DFFITS}|>2\sqrt{p/n}; |\text{DFBETAS}|>2/\sqrt n; en büyük |t_i| için t_{n-p-1} p'si ve Bonferroni (\times n) düzeltmesi (Rcar::outlierTestile aynı).
45.5.9 Eşdoğrusallık tanıları, RESET ve tahmin aralıkları
Koşul indeksi. \mathbf X'in (sabit dahil) her sütunu birim uzunluğa ölçeklenir, \tilde{\mathbf X}^{\top}\tilde{\mathbf X}'in özdeğerleri \lambda_1\ge\dots\ge\lambda_p bulunur; koşul indeksi \sqrt{\lambda_1/\lambda_m}, varyans oranları ise her katsayının varyansının boyutlara dağılımıdır (Belsley, Kuh ve Welsch 1980; collinearity_diagnostics, linlogit_extras.py:89–108). 15–30 orta, ≥ 30 güçlü eşdoğrusallık olarak yazılır.
RESET. \hat y^2 ve \hat y^3 modele eklenince kısmi F (Ramsey 1969; reset_test, 122–137):
Tahmin ve aralıklar. Yeni bir \mathbf x_0 için:
- Ortalama GA, bu özellikteki hastaların ortalama SKB'sinin; birey tahmin aralığı tek bir hastanın SKB'sinin aralığıdır.
- HC seçiliyken tahmin aralıkları klasik modelle hesaplanır (
regression.py:892); sandviç varyans tek bir yeni gözlemin hata varyansını kestiremez.
45.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/regression/elle_hesap.py ile, MerQur ve statsmodels çağrılmadan numpy ile hesaplanmıştır (normal denklemler, doğrudan formüller).
Adım 1 — Çapraz çarpımlar. Sütun sırası: sabit, age, BMI, salt, exercise.
İlk satır, sütun toplamlarıdır (n=200, \sum\text{age}=10111 …); köşegen kareler toplamlarıdır.
Adım 2 — Katsayılar. Normal denklemlerin çözümü:
Adım 3 — Kareler toplamları ve s.
Adım 4 — Katsayı tablosu. t_{195;\,0{,}975}=1{,}972204.
| Terim | b | SH | t | p | %95 GA |
|---|---|---|---|---|---|
| Sabit | 85,280229 | 4,701277 | 18,140 | 9,90·10⁻⁴⁴ | [76,008350; 94,552107] |
| age | 0,511640 | 0,035312 | 14,489 | 9,01·10⁻³³ | [0,441998; 0,581281] |
| BMI | 1,643974 | 0,146114 | 11,251 | 5,91·10⁻²³ | [1,355808; 1,932140] |
| salt_g_day | 1,300227 | 0,160410 | 8,106 | 5,67·10⁻¹⁴ | [0,983866; 1,616589] |
| exercise_hour_week | −0,767794 | 0,192025 | −3,998 | 9,04·10⁻⁵ | [−1,146506; −0,389082] |
Örnek, age satırı: [(\mathbf X^{\top}\mathbf X)^{-1}]_{22}=0{,}035312^2/59{,}677606=2{,}0894\times10^{-5}; t=0{,}511640/0{,}035312=14{,}489; GA 0{,}511640\pm1{,}972204\times0{,}035312.
Adım 5 — Model özeti.
Adım 6 — Standartlaştırılmış katsayılar ve ZPP. s_y=13{,}571441.
| Açıklayıcı | \beta^{\text{std}} | Sıfırıncı derece r | Kısmi r | Yarı-kısmi sr | sr^2 | VIF |
|---|---|---|---|---|---|---|
| age | 0,5914 | 0,5980 | 0,7200 | 0,5847 | 0,3418 | 1,0233 |
| BMI | 0,4548 | 0,4293 | 0,6274 | 0,4540 | 0,2061 | 1,0036 |
| salt_g_day | 0,3278 | 0,2843 | 0,5020 | 0,3271 | 0,1070 | 1,0044 |
| exercise_hour_week | −0,1633 | −0,2473 | −0,2753 | −0,1613 | 0,0260 | 1,0243 |
Örnek: \beta^{\text{std}}_{\text{age}}=0{,}511640\times15{,}688134/13{,}571441=0{,}5914. VIF'ler 1'e çok yakın olduğundan \beta^{\text{std}}\approx sıfırıncı derece r ve sr_j^2'lerin toplamı (0,681) neredeyse R^2'ye (0,683) eşittir: açıklayıcılar neredeyse ilişkisizdir ve etkileri toplanır.
Adım 7 — Tanılar.
- Durbin–Watson d=1{,}8826 (1,5–2,5 içinde).
- Koenker BP: e_i^2'nin açıklayıcılar üzerine regresyonunda R^2_{e^2}=0{,}006984; \text{LM}=200\times0{,}006984=1{,}3969, \chi^2_4 ile p=0{,}8447. Özgün BP 1,2473 (p=0{,}8703); White 10,8460 (sd 14, p=0{,}6981).
- Shapiro–Wilk (artıklar): W=0{,}99543, p=0{,}8105.
- RESET: F(2,\,193)=1{,}8728, p=0{,}1565.
- Koşul indeksleri 1; 4,547; 5,777; 9,142; 23,027. En büyüğü 15–30 aralığındadır, ama son boyutun varyans oranları sabit (0,964) ve BMI'de (0,859) toplanır: bu, BMI'nin sıfırdan uzak ortalaması (26) nedeniyle sabitle olan "yapay" bağıntıdır; merkezleme ortadan kaldırır.
Adım 8 — Sandviç SH'ler.
| SH türü | SH (age) | SH (exercise) | Wald F (4, 195) |
|---|---|---|---|
| Klasik | 0,035312 | 0,192025 | 104,794 |
| HC0 | 0,033714 | 0,191070 | 113,104 |
| HC1 | 0,034144 | 0,193504 | 110,276 |
| HC2 | 0,034203 | 0,193796 | 109,644 |
| HC3 | 0,034700 | 0,196572 | 106,281 |
Değişen varyans kanıtı olmadığından (BP p=0{,}84) sandviç SH'ler klasik SH'ye yakındır; HC0 en küçük, HC3 en büyüktür.
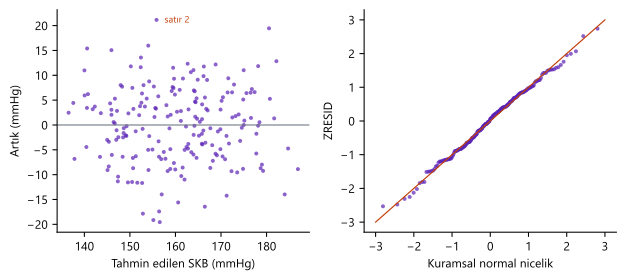
Adım 9 — Etkili gözlemler. En büyük Cook D satır 29'dadır (0,0508; 4/n = 0,02 eşiğini 7 gözlem aşar, 1'i hiçbiri aşmaz). En büyük kaldıraç 0,0582 (2p/n=0{,}05 eşiğini 3 gözlem aşar). En büyük silinmiş artık satır 2'dedir: t=2{,}8145, t_{194} ile p=0{,}005389; Bonferroni p=\min(1,\,200\times0{,}005389)=1: aykırı değer kanıtı yok.
Adım 10 — Tek bir hastanın tahmini. 1 numaralı hasta: yaş 78, BMI 27,91, tuz 11,6, egzersiz 5,2; gözlenen SKB 195.
Kaldıraç h_1=0{,}028880; ortalama GA 182{,}16\pm1{,}9722\times1{,}3128=[179{,}57;\ 184{,}75], birey tahmin aralığı 182{,}16\pm1{,}9722\times7{,}8359=[166{,}71;\ 197{,}62]. Artık 195-182{,}16=12{,}84 mmHg; ZRESID =12{,}84/7{,}7251=1{,}66.
Şekil 45.1. Sol: artık–tahmin grafiği (yapı ya da huni biçimi görülmüyor; en büyük silinmiş artık satır 2). Sağ: artıkların normal Q-Q grafiği.
45.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundaki katsayı tablosundan, diagnostics ve extras sözlüklerinden alınmıştır. Tanı değerlerindeki (round(dw, 4), BP p_yuvarla) gösterim yuvarlaması doğrulama sırasında stats.regression ad alanında bellekte devre dışı bırakılmıştır. R: 4.5.3, lm, confint, AIC, BIC, car::vif, lmtest::bptest (studentize TRUE/FALSE), lmtest::dwtest, shapiro.test, lmtest::resettest(power = 2:3), sandwich::vcovHC + lmtest::coeftest(df = n − p) + lmtest::waldtest(test = "F"), influence.measures, car::outlierTest, predict(interval = …).
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| b (Sabit terim) | 85,280229 | 85,280229 | 85,280229 | 5,4e−12 | ✓ |
| SH (Sabit terim) | 4,701277 | 4,701277 | 4,701277 | 2,3e−13 | ✓ |
| t (Sabit terim) | 18,139799 | 18,139799 | 18,139799 | 2,8e−13 | ✓ |
| p (Sabit terim) | 9,8962·10−44 | 9,8962·10−44 | 9,8962·10−44 | 1,8e−55 | ✓ |
| %95 GA alt (Sabit terim) | 76,008350 | 76,008350 | 76,008350 | 1,2e−11 | ✓ |
| %95 GA üst (Sabit terim) | 94,552107 | 94,552107 | 94,552107 | 1,8e−11 | ✓ |
| b (age) | 0,511640 | 0,511640 | 0,511640 | 2,4e−15 | ✓ |
| SH (age) | 0,035312 | 0,035312 | 0,035312 | 4,9e−17 | ✓ |
| t (age) | 14,489277 | 14,489277 | 14,489277 | 1,2e−13 | ✓ |
| p (age) | 9,0128·10−33 | 9,0128·10−33 | 9,0128·10−33 | 5,4e−45 | ✓ |
| %95 GA alt (age) | 0,441998 | 0,441998 | 0,441998 | 9,5e−14 | ✓ |
| %95 GA üst (age) | 0,581281 | 0,581281 | 0,581281 | 9,2e−14 | ✓ |
| b (BMI) | 1,643974 | 1,643974 | 1,643974 | 1,5e−13 | ✓ |
| SH (BMI) | 0,146114 | 0,146114 | 0,146114 | 6,8e−15 | ✓ |
| t (BMI) | 11,251338 | 11,251338 | 11,251338 | 1,5e−12 | ✓ |
| p (BMI) | 5,9090·10−23 | 5,9090·10−23 | 5,9090·10−23 | 6,2e−34 | ✓ |
| %95 GA alt (BMI) | 1,355808 | 1,355808 | 1,355808 | 5,4e−13 | ✓ |
| %95 GA üst (BMI) | 1,932140 | 1,932140 | 1,932140 | 3,8e−13 | ✓ |
| b (salt_g_day) | 1,300227 | 1,300227 | 1,300227 | 6,4e−14 | ✓ |
| SH (salt_g_day) | 0,160410 | 0,160410 | 0,160410 | 1,0e−15 | ✓ |
| t (salt_g_day) | 8,105653 | 8,105653 | 8,105653 | 4,4e−13 | ✓ |
| p (salt_g_day) | 5,6715·10−14 | 5,6715·10−14 | 5,6715·10−14 | 1,6e−25 | ✓ |
| %95 GA alt (salt_g_day) | 0,983866 | 0,983866 | 0,983866 | 4,8e−13 | ✓ |
| %95 GA üst (salt_g_day) | 1,616589 | 1,616589 | 1,616589 | 4,2e−13 | ✓ |
| b (exercise_hour_week) | −0,767794 | −0,767794 | −0,767794 | 1,9e−14 | ✓ |
| SH (exercise_hour_week) | 0,192025 | 0,192025 | 0,192025 | 5,0e−16 | ✓ |
| t (exercise_hour_week) | −3,998414 | −3,998414 | −3,998414 | 9,7e−14 | ✓ |
| p (exercise_hour_week) | 9,0434·10−5 | 9,0434·10−5 | 9,0434·10−5 | 3,3e−17 | ✓ |
| %95 GA alt (exercise_hour_week) | −1,146506 | −1,146506 | −1,146506 | 5,2e−13 | ✓ |
| %95 GA üst (exercise_hour_week) | −0,389082 | −0,389082 | −0,389082 | 5,0e−13 | ✓ |
| R^2 | 0,682502 | 0,682502 | 0,682502 | 7,8e−16 | ✓ |
| Düzeltilmiş R^2 | 0,675989 | 0,675989 | 0,675989 | 3,3e−16 | ✓ |
| F (4, 195) | 104,794279 | 104,794279 | 104,794279 | 4,1e−13 | ✓ |
| p_F | 1,7755·10−47 | 1,7755·10−47 | 1,7755·10−47 | 8,4e−61 | ✓ |
| AIC | 1392,303220 | 1392,303220 | 1392,303220 | 4,1e−12 | ✓ |
| BIC | 1412,093125 | 1412,093125 | 1412,093125 | 4,1e−12 | ✓ |
| Durbin–Watson | 1,882597 | 1,882597 | 1,882597 | 1,4e−14 | ✓ |
| Breusch–Pagan (Koenker) LM | 1,396875 | 1,396875 | 1,396875 | 1,3e−13 | ✓ |
| Breusch–Pagan p | 0,844738 | 0,844738 | 0,844738 | 2,3e−14 | ✓ |
| Shapiro–Wilk W (artık) | 0,995427 | 0,995427 | 0,995427 | 1,1e−10 | ✓ |
| Shapiro–Wilk p | 0,810491 | 0,810491 | 0,810491 | 1,5e−08 | ✓ |
| VIF (age) | 1,023338 | 1,023338 | 1,023338 | 2,9e−15 | ✓ |
| VIF (BMI) | 1,003576 | 1,003576 | 1,003576 | 3,6e−15 | ✓ |
| VIF (salt_g_day) | 1,004447 | 1,004447 | 1,004447 | 1,3e−15 | ✓ |
| VIF (exercise_hour_week) | 1,024293 | 1,024293 | 1,024293 | 4,4e−15 | ✓ |
Ek çıktılar (standartlaştırılmış katsayı, ZPP, sandviç SH, ANOVA, RESET, değişen varyans, etkili gözlem, eşdoğrusallık, tahmin):
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Std. \beta (age) | 0,591438 | 0,591438 | 0,591438 | 3,3e−15 | ✓ |
| Std. \beta (BMI) | 0,454813 | 0,454813 | 0,454813 | 4,1e−14 | ✓ |
| Std. \beta (salt_g_day) | 0,327797 | 0,327797 | 0,327797 | 1,6e−14 | ✓ |
| Std. \beta (exercise_hour_week) | −0,163288 | −0,163288 | −0,163288 | 3,8e−15 | ✓ |
| Kısmi r (age) | 0,720032 | 0,720032 | 0,720032 | 2,0e−15 | ✓ |
| Yarı-kısmi sr (age) | 0,584655 | 0,584655 | 0,584655 | 3,6e−15 | ✓ |
| Kısmi r (BMI) | 0,627410 | 0,627410 | 0,627410 | 5,2e−14 | ✓ |
| Yarı-kısmi sr (BMI) | 0,454002 | 0,454002 | 0,454002 | 6,1e−14 | ✓ |
| Kısmi r (salt_g_day) | 0,502014 | 0,502014 | 0,502014 | 2,1e−14 | ✓ |
| Yarı-kısmi sr (salt_g_day) | 0,327070 | 0,327070 | 0,327070 | 1,9e−14 | ✓ |
| Kısmi r (exercise_hour_week) | −0,275270 | −0,275270 | −0,275270 | 5,8e−15 | ✓ |
| Yarı-kısmi sr (exercise_hour_week) | −0,161340 | −0,161340 | −0,161340 | 3,8e−15 | ✓ |
| HC0 SH (age) | 0,033714 | 0,033714 | 0,033714 | 3,8e−16 | ✓ |
| HC0 SH (exercise_hour_week) | 0,191070 | 0,191070 | 0,191070 | 1,8e−15 | ✓ |
| HC0 Wald F (4, 195) | 113,103600 | 113,103600 | 113,103600 | 1,6e−11 | ✓ |
| HC1 SH (age) | 0,034144 | 0,034144 | 0,034144 | 3,4e−16 | ✓ |
| HC1 SH (exercise_hour_week) | 0,193504 | 0,193504 | 0,193504 | 1,1e−15 | ✓ |
| HC1 Wald F (4, 195) | 110,276010 | 110,276010 | 110,276010 | 1,6e−11 | ✓ |
| HC2 SH (age) | 0,034203 | 0,034203 | 0,034203 | 1,4e−16 | ✓ |
| HC2 SH (exercise_hour_week) | 0,193796 | 0,193796 | 0,193796 | 1,1e−15 | ✓ |
| HC2 Wald F (4, 195) | 109,644003 | 109,644003 | 109,644003 | 2,1e−11 | ✓ |
| HC3 SH (age) | 0,034700 | 0,034700 | 0,034700 | 1,0e−16 | ✓ |
| HC3 SH (exercise_hour_week) | 0,196572 | 0,196572 | 0,196572 | 1,1e−15 | ✓ |
| HC3 Wald F (4, 195) | 106,280686 | 106,280686 | 106,280686 | 1,8e−11 | ✓ |
| Regresyon KT | 25015,486797 | 25015,486797 | 25015,486797 | 9,1e−11 | ✓ |
| SEE (\hat\sigma) | 7,725128 | 7,725128 | 7,725128 | 3,6e−15 | ✓ |
| RESET F (2, 193) | 1,872766 | 1,872766 | 1,872766 | 8,8e−13 | ✓ |
| RESET p | 0,156480 | 0,156480 | 0,156480 | 1,4e−13 | ✓ |
| Özgün BP \chi^2 (4) | 1,247266 | 1,247266 | 1,247266 | 5,0e−14 | ✓ |
| White \chi^2 (14) | 10,845981 | 10,845981 | 10,845981 | 3,3e−13 | ✓ |
| Cook D (satır 2) | 0,030379 | 0,030379 | 0,030379 | 2,7e−15 | ✓ |
| Kaldıraç h (satır 2) | 0,019469 | 0,019469 | 0,019469 | 2,2e−16 | ✓ |
| SDRESID (satır 2) | 2,814519 | 2,814519 | 2,814519 | 1,4e−13 | ✓ |
| DFFITS (satır 2) | 0,396593 | 0,396593 | 0,396593 | 1,8e−14 | ✓ |
| DFBETAS age (satır 2) | −0,116223 | −0,116223 | −0,116223 | 7,4e−14 | ✓ |
| Cook D (satır 29) | 0,050782 | 0,050782 | 0,050782 | 1,8e−15 | ✓ |
| Kaldıraç h (satır 29) | 0,037107 | 0,037107 | 0,037107 | 1,5e−15 | ✓ |
| SDRESID (satır 29) | 2,604657 | 2,604657 | 2,604657 | 3,2e−14 | ✓ |
| DFFITS (satır 29) | 0,511316 | 0,511316 | 0,511316 | 8,8e−15 | ✓ |
| DFBETAS age (satır 29) | 0,208714 | 0,208714 | 0,208714 | 4,5e−14 | ✓ |
| Bonferroni öncesi aykırı p (satır 2) | 0,005389 | 0,005389 | 0,005389 | 2,3e−15 | ✓ |
| En küçük özdeğer | 0,008633 | 0,008633 | 0,008633 | 3,2e−16 | ✓ |
| En büyük koşul indeksi | 23,027455 | 23,027455 | 23,027455 | 4,4e−13 | ✓ |
| Hasta 1: \hat y | 182,161530 | 182,161530 | 182,161530 | 4,0e−13 | ✓ |
| Hasta 1: ortalama GA alt | 179,572377 | 179,572377 | 179,572377 | 3,6e−12 | ✓ |
| Hasta 1: tahmin aralığı alt | 166,707564 | 166,707564 | 166,707564 | 2,1e−11 | ✓ |
| Hasta 1: tahmin aralığı üst | 197,615496 | 197,615496 | 197,615496 | 2,1e−11 | ✓ |
| BP p (metin, 6 ondalık) | 0,844738 | 0,844738 | 0,844738 | 1,5e−14 | ✓ (6 ondalık) |
93 büyüklüğün tamamı 10^{-6} ölçütüyle eşleşir; en büyük göreli fark 10^{-12} düzeyindedir.
45.7 Çıktıyı okuma
Sonuç metni (varsayılan ayarlar):
MODEL: Doğrusal Regresyon
──────────────────────────────────────────────────
n = 200  |  Hedef: systolic_bp
R² = 0.682502  Düzeltilmiş R² = 0.675989
F = 104.7943  p = 1.776e-47
AIC = 1392.3032  BIC = 1412.0931

TANILAMA:
  Durbin-Watson = 1.8826  (1.5–2.5 arası iyi)
  Breusch-Pagan: LM = 1.3969, p = 0.844738  (homoskedastik)
  Artık Shapiro-Wilk: W = 0.9954, p = 0.810491  (normal)
  VIF (çoklu doğrusal bağıntı):
    age                       VIF = 1.0233
    BMI                       VIF = 1.0036
    salt_g_day                VIF = 1.0044
    exercise_hour_week        VIF = 1.0243

KATSAYILAR — Tablo sekmesinde görüntülenir.

── APA 7 ÖZET ──
F(4, 195) = 104.79, p < .001, R² = .68, düzeltilmiş R² = .68
Tablo sekmesi: Katsayı, Std.Hata, t, p, Sig, %95 GA Alt, %95 GA Üst (+ β (stand.), ZPP sütunları seçiliyse); dört ondalığa yuvarlanmış gösterim. Frekans sekmesi: VIF tablosu (etkili gözlem seçiliyse gözlem başına tanı tablosu). Grafik sekmesi: artık–tahmin (varsayılan).
| Öğe | Nasıl yorumlanır |
|---|---|
| R^2, düzeltilmiş R^2 | SKB varyansının %68,3'ü dört açıklayıcıyla açıklanır; düzeltilmiş değer neredeyse aynıdır (n büyük, k küçük). |
| F ve p | En az bir eğimin sıfırdan farklı olduğuna dair güçlü kanıt. |
| Katsayı (B) | age 0,512: diğerleri sabitken her yaş yılı SKB'yi ortalama 0,51 mmHg artırır (10 yılda 5,1 mmHg; GA [4,4; 5,8]). exercise −0,768: haftada 1 saat fazla egzersiz SKB'yi 0,77 mmHg düşürür. |
| Sabit | Tüm açıklayıcılar 0 iken beklenen SKB (yaş 0, BMI 0…); klinik anlamı yoktur. |
| β (stand.) | Göreli önem: yaş (0,59) > BMI (0,45) > tuz (0,33) > egzersiz (−0,16). Yalnız açıklayıcılar az ilişkiliyken bu sıralama güvenilirdir. |
| Durbin–Watson | 1,88: satır sırasında otokorelasyon işareti yok. |
| Breusch–Pagan | Koenker biçimi; p=0{,}84: değişen varyans kanıtı yok. "(homoskedastik)" etiketi p\ge0{,}05'te yazılır. |
| Shapiro–Wilk | p=0{,}81: artıklarda normallikten sapma kanıtı yok. |
| VIF | 1,00–1,02; > 5 olsaydı "⚠" işareti eklenirdi. |
Uyarı iletileri: DW 1,5–2,5 dışında (regression.py:610–611); VIF > 5 ve > 10 (597–601); BP p<0{,}05 (628–630); SW p<0{,}05 (645–647); HC seçildiğinde "Sağlam (robust) standart hatalar kullanıldı" notu (557); kötü koşulluluk (558–559); eşdoğrusal sütun çıkarıldı (482–484).
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Sistolik kan basıncını yordamak için yaş, BMI, günlük tuz tüketimi ve haftalık egzersiz süresini içeren çoklu doğrusal regresyon modeli kuruldu (n = 200). Model anlamlıydı ve varyansın %68'ini açıkladı, F(4, 195) = 104{,}79, p < 0{,}001, R^2 = 0{,}68, düzeltilmiş R^2 = 0{,}68. Diğer değişkenler denetlendiğinde yaş (b = 0{,}51; %95 GA [0,44; 0,58]; \beta = 0{,}59; p < 0{,}001), BMI (b = 1{,}64; %95 GA [1,36; 1,93]; \beta = 0{,}45; p < 0{,}001) ve tuz tüketimi (b = 1{,}30; %95 GA [0,98; 1,62]; \beta = 0{,}33; p < 0{,}001) SKB'yi artırırken egzersiz azalttı (b = -0{,}77; %95 GA [−1,15; −0,39]; \beta = -0{,}16; p < 0{,}001). Artıklar değişen varyans (Breusch–Pagan \chi^2(4) = 1{,}40, p = 0{,}84) ve normallikten sapma (Shapiro–Wilk W = 0{,}995, p = 0{,}81) göstermedi; tüm VIF değerleri 1,03'ün altındaydı.
45.8 Uzman soruları
S1. Kestirim hangi sayısal yolla yapılıyor? Neden statsmodels'in varsayılanı değil?
statsmodels OLS.fit() varsayılan olarak Moore–Penrose (SVD) pseudo-tersini kullanır; ölçeklenmemiş sütunlarda bu yol duyarlık kaybediyordu (NIST Pontius LRE 6,3). MerQur Householder QR'ı kullanır, \mathbf R^{-1}'i üçgen çözümle bulur ve (\mathbf X^{\top}\mathbf X)^{-1}=\mathbf R^{-1}\mathbf R^{-\top}'yi önceden yerleştirir. Böylece kovaryans koşul sayısının karesiyle değil, kendisiyle orantılı hata taşır. R lm() de QR kullanır; iki yazılım bu veride 10^{-13} düzeyinde eşleşir.
S2. İki açıklayıcı tam doğrusal bağımlıysa ne olur?
MerQur, R lm()'nin sınırlı pivotlu QR mantığını uygular; sözde tersin (pinv) en küçük normlu çözümünü katsayı diye vermez: sütunlar sırayla işlenir, önceki sütunlara izdüşümünden kalan normu özgün normunun 10^{-7} katından küçükse o sütun "aliased" sayılır, katsayı satırı "—" olarak kalır ve uyarı yazılır. Bağımlı olan sonraki sütundur; sıralamayı değiştirmek hangi değişkenin çıkarılacağını değiştirir (R ile aynı).
S3. Neden AIC değeri bazı yazılımlarınkinden farklı?
MerQur R tanımını kullanır: -2\ell+2(p+1), \ell tam normal log-olabilirlik. R extractAIC(lm) ve bazı yazılımlar n\ln(\text{SSE}/n)+2p yazar; aradaki fark n[\ln(2\pi)+1]+2 kadar sabittir (bu veride 569,58). Aynı veride iki modelin AIC farkı her iki tanımda aynıdır.
S4. Breusch–Pagan testi hangisi?
Tanı bölümünde her zaman Koenker'in (1981) studentize biçimi (nR^2) verilir; normal olmayan hatalara karşı sağlamdır ve R bptest() varsayılanıdır. Özgün biçim (ESS/2) normal hata varsayar; "Değişen varyans testleri" kutusuyla White testiyle birlikte verilir. Bu veride 1,3969 ve 1,2473; karar aynıdır.
S5. HC seçilince p neden z değil t dağılımından?
Sandviç kestiricinin kendisi asimptotiktir; ancak küçük örneklemde t_{n-p} kullanmak kapsama oranını iyileştirir ve R coeftest(df = n − p) davranışıyla aynıdır (Long ve Ervin 2000). statsmodels'in varsayılanı z'dir; MerQur use_t=True geçer (regression.py:201).
S6. Durbin–Watson'ın p değeri neden yok?
d'nin dağılımı \mathbf X'e bağlıdır ve kesin p ancak özdeğer hesabıyla (R dwtest, Imhof/Pan yöntemi) bulunur. MerQur yalnız istatistiği ve 1,5–2,5 kuralını verir. Kesitsel veride satır sırası anlamsızsa d yorumlanmamalıdır; zaman sıralı veride Zaman Serisi modülleri daha uygundur.
S7. Koşul indeksi 23 çıktı ama VIF'ler 1,02. Hangisine inanmalı?
İkisi farklı şeyi ölçer. VIF açıklayıcılar arasındaki bağıntıyı merkezlenmiş verilerde ölçer; koşul indeksi ise sabit terimi de içeren merkezlenmemiş tasarımda hesaplanır (Belsley tanımı). Son boyutta varyans oranları sabit ve BMI'de toplandığı için 23'lük indeks, BMI'nin ortalamasının sıfırdan uzak olmasından gelir; merkezleme bunu ortadan kaldırır. Açıklayıcılar arası sorunlu bağıntı yoktur.
S8. Adımsal seçim hangi ölçütle çalışıyor?
Kısmi F testinin p değeriyle: p\le\text{PIN} ise terim girer, p>\text{POUT} ise çıkar (select_terms, regression_extras.py:283–341). Kategorik bir faktörün kuklaları tek terim olarak birlikte girip çıkar. POUT < PIN ise POUT = 1,1·PIN alınır ve uyarılır. Bu veride geriye doğru seçim dört değişkeni de tutar (tümü p<0{,}001).
S9. Standartlaştırılmış β, R'de nasıl elde edilir?
MerQur b_j s_{x_j}/s_y formülünü kullanır. R'de lm.beta paketi ya da lm(scale(y) ~ scale(x1) + …) aynı sonucu verir. WLS'de MerQur ağırlıklı SS kullanır. Kategorik kuklalar ve etkileşimler için standartlaştırılmış katsayının anlamı tartışmalıdır; MerQur bunları da aynı formülle hesaplar.
45.9 Sık hatalar ve tuzaklar
- R^2'yi model doğruluğunun kanıtı saymak. Yüksek R^2 doğrusallık ya da nedensellik kanıtı değildir; artık grafikleri ve RESET birlikte okunmalıdır.
- Kısmi eğimi basit eğim gibi yorumlamak. b_{\text{age}}=0{,}51 "diğer üç değişken sabitken" yorumlanır. Açıklayıcılar ilişkiliyse basit regresyon eğiminden belirgin biçimde farklı olabilir.
- β (stand.) ile önem sıralamasını genellemek. Standartlaştırılmış katsayı örneklemin SS'sine bağlıdır; başka bir örneklemde (daha dar yaş aralığı) sıralama değişir.
- Durbin–Watson'ı kesitsel veride yorumlamak. Satırlar rastgele sıradaysa d anlamsızdır; uyarı da yanıltıcı olabilir.
- Tanı bölümündeki Breusch–Pagan'ı özgün Breusch–Pagan testiyle karıştırmak. Biri Koenker, diğeri özgün testtir.
- Tahmin aralığı yerine ortalama GA'yı tek hasta için kullanmak. Hasta 1 için ortalama GA ±2,6 mmHg, birey tahmin aralığı ±15,5 mmHg genişliğindedir.
- Adımsal seçimden sonra p değerlerini olduğu gibi raporlamak. Seçim süreci p değerlerini iyimser kılar.
- AIC'yi farklı yazılımlar arasında karşılaştırmak. Sabit terim tanımı farklıdır; yalnız aynı yazılımdaki modeller karşılaştırılmalıdır.
- ZPP tablosunun başlığı. Türkçe arayüzde "Kısmi r" ile "Yarı-kısmi (sr)" başlıkları sütun genişliği yetmediği için bitişik yazılır ("Kısmi rYarı-kısmi (sr)"); değerler doğru sütundadır.
45.10 Kaynaklar
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/TAC.1974.1100705
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. Wiley. https://doi.org/10.1002/0471725153
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Chow, G. C. (1960). Tests of equality between sets of coefficients in two linear regressions. Econometrica, 28(3), 591–605. https://doi.org/10.2307/1910133
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Durbin, J., & Watson, G. S. (1950). Testing for serial correlation in least squares regression. I. Biometrika, 37(3–4), 409–428. https://doi.org/10.1093/biomet/37.3-4.409
- Koenker, R. (1981). A note on studentizing a test for heteroscedasticity. Journal of Econometrics, 17(1), 107–112. https://doi.org/10.1016/0304-4076(81)90062-2
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- MacKinnon, J. G., & White, H. (1985). Some heteroskedasticity-consistent covariance matrix estimators with improved finite sample properties. Journal of Econometrics, 29(3), 305–325. https://doi.org/10.1016/0304-4076(85)90158-7
- Ramsey, J. B. (1969). Tests for specification errors in classical linear least-squares regression analysis. Journal of the Royal Statistical Society: Series B (Methodological), 31(2), 350–371. https://doi.org/10.1111/j.2517-6161.1969.tb00796.x
- Schwarz, G. (1978). Estimating the dimension of a model. The Annals of Statistics, 6(2), 461–464. https://doi.org/10.1214/aos/1176344136
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3–4), 591–611. https://doi.org/10.1093/biomet/52.3-4.591
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934