25. Ki-Kare Bağımsızlık Testi
Analiz kimliği: chisquare · Menü adı: Ki-Kare Bağımsızlık · Panel: gui/panels/analyses/chi_square_independence.py · Motor: stats/hypothesis.py, HypothesisTests.chi_square_independence (satır 7219–7553); ek ölçüler _ct_q1_extras (satır 2235–2373)
25.1 Ne işe yarar
Ki-kare bağımsızlık testi, iki kategorik değişkenin birbirinden bağımsız olup olmadığını sınar. Cevapladığı soru şudur: "Bir değişkenin kategorilerine düşme olasılığı, öbür değişkenin hangi kategoride olduğuna bağlı mı?"
- \pi_{ij}: evrende bir kişinin satır değişkeninin i. ve sütun değişkeninin j. kategorisinde birlikte bulunma olasılığı.
- \pi_{i\cdot}=\sum_j\pi_{ij} ve \pi_{\cdot j}=\sum_i\pi_{ij}: satır ve sütun marjinal olasılıkları.
- Bağımsızlık, ortak olasılığın marjinallerin çarpımına eşit olması demektir; test bunun tablonun bütün hücrelerinde aynı anda geçerli olup olmadığını sorar.
Ne zaman kullanılır? İki değişken de nominal ya da sıralı kategorik olduğunda (sigara durumu × KOAH, tedavi × iyileşme), her kişi tablonun yalnız bir hücresine düştüğünde ve beklenen frekanslar yeterince büyük olduğunda.
Ne zaman kullanılmaz?
- 2×2 tabloda beklenen frekanslardan biri 5'in altındaysa: Fisher Kesin Testi (ya da bu panelde "Kesin / Monte Carlo p: Fisher").
- Aynı kişilerde iki kez ölçülmüş ikili değişken (öncesi–sonrası tanı) varsa: gözlemler eşleşiktir, McNemar Testi.
- Üçüncü bir değişkene göre tabakalanmış 2×2×K tablolarda birleşik test isteniyorsa: Cochran–Mantel–Haenszel.
- Tek bir kategorik değişkenin bilinen bir dağılıma uyup uymadığı soruluyorsa: Ki-Kare Uyum İyiliği.
- İki puanlayıcının aynı kişileri sınıflaması karşılaştırılıyorsa (uyum, ilişki değil): Cohen's Kappa.
Sık karıştırılan analizler. Çapraz Tablo modülü aynı Pearson \chi^2'yi verir ama 2×2'de ana satırı düzeltmesiz basar; bu modül ise varsayılan olarak Yates düzeltmeli \chi^2'yi ana sonuç yapar (bkz. 25.5.3 ve Bölüm 33). Fisher Kesin Testi aynı hipotezi koşullu kesin dağılımla sınar.
25.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Bağımsız gözlemler | Her kişi tabloya bir kez girer; kişiler birbirini etkilemez. | Tasarımla sağlanır; denetlenmez. |
| Karşılıklı dışlayıcı kategoriler | Her gözlem tam bir satır ve tam bir sütun kategorisine düşer. | Denetlenmez. |
| Yeterli beklenen frekans | Asimptotik \chi^2 yaklaşımı için Cochran kuralı: hücrelerin en çok %20'sinde E<5, hiçbir hücrede E<1. | Her çalıştırmada dipnot (kaç hücre E<5, en küçük E); R×C'de kural bozulursa uyarı, 2×2'de \min E<5 ise Fisher önerisi (hypothesis.py:7466–7474). |
| En az iki düzey | Her iki değişkende en az iki kategori. | Tek düzeyli değişkende hata (hypothesis.py:7245–7247). |
Eksik değer. Tablo pd.crosstab(df[c1], df[c2]) ile kurulur (hypothesis.py:413); iki değişkenden biri eksik olan satır tabloya girmez (liste bazında silme). Künyedeki n, df[[c1, c2]].dropna() satır sayısıdır; ağırlık sütunu seçilirse toplam ağırlıktır (stats_panel.py:5696–5698).
Uç durumlar.
- Ağırlık sütununda eksik ya da negatif değer varsa hata (
hypothesis.py:418–419). Ağırlıklar tam sayıya yuvarlanabiliyorsa tablo tam sayıya çevrilir (hypothesis.py:422–423); değilse Monte Carlo ve Fisher yolları "tam sayı değil" notu verip çalışmaz (hypothesis.py:7390–7391). - Toplam ağırlığı 0 olan düzeyler tablodan atılır ve uyarı yazılır (
_ct_drop_zero_margins,hypothesis.py:566–577). - Aynı sütun hem Sütun 1 hem Sütun 2 (ya da ağırlık) olarak seçilirse analiz durdurulur (
stats_panel.py:1645–1661).
25.3 Parametreler
Varsayılanlar chi_square_independence.py:39–117 içinden okunmuştur. Motorun options.get(...) varsayılanları formla aynıdır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Sütun 1 / Sütun 2 | veriye bağlı | Satır ve sütun değişkeni. | \chi^2, p, V simetriktir; yönlü ölçüler (\lambda, Somers d, U, RR) satır/sütun rolüne bağlıdır. |
| Güven Düzeyi | %95 | \alpha=1-\text{düzey}. | Karar eşiği ve bütün GA'lar (OR, RR, RD, V, sıralı ölçüler, Monte Carlo p GA'sı). |
| Etki büyüklükleri: φ (2×2), C | kapalı | \varphi ve olumsallık katsayısı C satırı. | Ek satır; V her zaman verilir. |
| Ek çıktı: Yates düzeltmesi (2×2) | açık | 2×2'de süreklilik düzeltmesi. | 2×2'de ana \chi^2, p ve karar düzeltmeli olur; R×C'de etkisiz. |
| Ek çıktı: G-testi (olabilirlik oranı) | kapalı | Ana istatistik G^2 olur. | 2×2'de Yates açıksa düzeltme G^2'ye de uygulanır. |
| Tablolar: Beklenen değerler, Standart artıklar, Düzeltilmiş artıklar | kapalı | Hücre tabloları. | Yalnız gösterim. |
| Test tablosu: Tüm testler | kapalı | Pearson, Yates (2×2), G^2, Fisher (2×2), doğrusal-doğrusal, geçerli N. | Ek tablo; düzey sırası satırları da yazılır. |
| Kesin / Monte Carlo p | Yok | Monte Carlo \chi^2 (B=10000) ya da Fisher (2×2 kesin, R×C Monte Carlo). | Ana p, karar ve APA satırı bu p'ye geçer; asimptotik p ayrıca yazılır. |
| Ağırlık (frekans) sütunu | Yok | Özet (sayım) tablosu girişi. | Tablo ağırlık toplamlarıyla kurulur; n = toplam ağırlık. |
| Ek ölçüler: Sütun oranları z-testi | kapalı | Her satırda sütun oranlarının ikili z testi, Bonferroni, harfler. | Ek bölüm. |
| Ek ölçüler: Sıralı ölçüler | kapalı | \gamma, \tau_b, \tau_c, iki Somers d; ASE, GA, z, p. | Ek bölüm; düzey sırasına bağlı. |
| Ek ölçüler: RR / risk farkı (2×2) | kapalı | Kohort RR (1. sütun) ve RD, Wald GA. | Yalnız 2×2; R×C'de not. |
| Sütun 1 / Sütun 2 düzey sırası | boş | Virgülle ayrılmış düzey sırası. | Sıralı ölçülerin işaretini ve büyüklüğünü, doğrusal-doğrusal testi değiştirir. |
| Cramér V GA + Cohen yorumu | kapalı | V için merkezî olmayan \chi^2 GA'sı ve eşik satırı. | Ek satır. |
| λ, GK τ, belirsizlik katsayısı | kapalı | Nominal PRE ölçüleri. | Ek bölüm. |
| Tohum | 12345 | Monte Carlo üretecinin tohumu (seed). | Yalnız Monte Carlo p'yi etkiler. |
Neden Monte Carlo seçimi ana p'yi değiştiriyor?
Kesin ya da Monte Carlo p seçildiğinde ana p, yıldız, karar ve APA satırı o p'ye dayanır; asimptotik p "Ana p ve karar seçilen yönteme dayanır" satırında ayrıca yazılır (hypothesis.py:7485–7495). R'de chisq.test(simulate.p.value = TRUE) da aynı biçimde çalışır. Böylece Fisher seçildiğinde karar düzeltmeli asimptotik p'ye göre okunmaz (hypothesis.py:7481–7484). Ancak ana satırda istatistik Yates düzeltmeli \chi^2 olabilir (25.7'deki örnek); p'nin kaynağı APA satırında parantez içinde yazılır.
25.4 Tıp örneği
Ana dosya: english/datasets/Tip/21_chisquare_smoking_copd.xlsx (Türkçe kopya samples/Tum_Analiz_Tip/21_kikare_sigara_KOAH.xlsx).
| Değişken | Rol | Tür | Açıklama |
|---|---|---|---|
smoking_status |
Sütun 1 (satır) | metin, 3 düzey | active smoking 250, old smoking 200, none non_drinker 220 (hiç içmemiş) |
copd |
Sütun 2 (sütun) | metin, 2 düzey | present 250, absent 420 |
patient_id |
kullanılmaz |
n ve eksik değer: 670 hasta, eksik değer yok. Düzeyler sayısal değildir ve sıra tanımlanmamıştır; tanınan sıralı sözcük de yoksa verideki ilk görülme sırası kullanılır ve kullanılan sıra çıktıda yazılır. Verideki sıra: satırlar active smoking, old smoking, none non_drinker; sütunlar present, absent.
| present | absent | Toplam | |
|---|---|---|---|
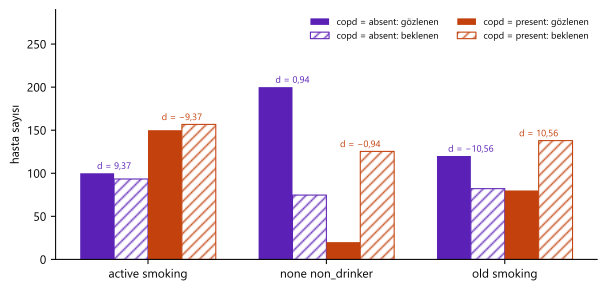
| active smoking | 150 | 100 | 250 |
| old smoking | 80 | 120 | 200 |
| none non_drinker | 20 | 200 | 220 |
| Toplam | 250 | 420 | 670 |
Klinik soru: KOAH varlığı sigara durumuna göre değişiyor mu? Değişiyorsa hangi grup beklenenden sapıyor?
2×2 seçenekleri için ikinci veri: Yates, OR, RR ve RD yalnız 2×2'de tanımlı olduğundan Tıp #23 (test × sonuc, n = 28) da kullanılmıştır. Bu dosyanın İngilizce kopyası bulunmadığından (23_fisher_diagnosis_test.xlsx) Türkçe kopya samples/Tum_Analiz_Tip/23_fisher_tani_testi.xlsx kullanıldı. Verideki sıra: satırlar Hızlı Test, PCR; sütunlar Pozitif, Negatif. Tablo: Hızlı Test 7 Pozitif, 8 Negatif; PCR 9 Pozitif, 4 Negatif.
Seçilen ayarlar: Önce arayüz varsayılanları, sonra bütün onay kutuları açık; doğrusal-doğrusal ve sıralı ölçüler için ayrıca anlamlı sıra (none non_drinker, old smoking, active smoking) girilmiştir.
Şekil 25.1. Tıp #21'de gözlenen (dolu) ve bağımsızlık altında beklenen (taralı) sayılar; çubukların üstünde düzeltilmiş artık d_{ij}.
25.5 Formüller ve hesap adımları
MerQur'un sırası şudur: (1) tabloyu kur, sıfır marjinalli düzeyleri at, tek düzeyde dur; (2) düzey sırasını belirle; (3) scipy.stats.chi2_contingency ile ana istatistiği hesapla (2×2 ve Yates açıksa düzeltmeli; G-testi seçiliyse G^2); (4) etki büyüklüklerini her zaman düzeltmesiz Pearson \chi^2'den hesapla; (5) artıkları, isteğe bağlı tabloları ve Monte Carlo p'yi ekle; (6) kesin/Monte Carlo seçildiyse ana p'yi değiştir; (7) 2×2'de OR ve GA'sını künyeye yaz.
25.5.1 Tablo ve düzey sırası
n_{ij} hücre sayısı, n_{i\cdot} satır toplamı, n_{\cdot j} sütun toplamı, n genel toplamdır. Düzey sırası _ct_order_axis ile şu öncelikle belirlenir: kullanıcı sırası > sıralı Categorical > sayısal ('2' < '10') ya da sayı içeren etiketlerde doğal sıra > tanınan sıralı sözcükler (düşük/orta/yüksek gibi) > verideki ilk görülme sırası. Alfabetik sıra kullanılmaz. Pearson \chi^2, G^2 ve V sıradan bağımsızdır; doğrusal-doğrusal test ve sıralı ölçüler sıraya bağlıdır.
Koddaki tercih
"Tüm testler" ya da "Sıralı ölçüler" açıksa sıra ve kaynağı yazılır; üç ya da daha çok düzeyli bir değişkenin sırası tanımlanmamışsa (verideki ilk görülme sırası) "sıra tanımlanmadı" uyarısı eklenir. Doğrusal-doğrusal test ve sıralı ölçüler sıraya bağlı olduğundan, sıra bilgisi veride yoksa program onu uyduramaz; kullanıcının görmesi gerekir. Tıp #21'de smoking_status için bu uyarı çıkar.
25.5.2 Beklenen frekanslar ve Pearson χ²
- E_{ij}: H_0 doğruysa (i,j) hücresinde beklenen sayı; marjinallerin çarpımı ile n'nin çarpımıdır (n\,\hat\pi_{i\cdot}\hat\pi_{\cdot j}).
- X^2: gözlenenle beklenen arasındaki farkların, beklenenle ölçeklenmiş karelerinin toplamı.
- r, c: satır ve sütun düzey sayısı.
- p: \chi^2_{\sd} dağılımının sağ kuyruğu; test her zaman tek kuyrukludur (büyük X^2 bağımsızlıktan uzaklaşma demektir).
Neden sd = (r − 1)(c − 1)?
Tabloda rc hücre vardır. Marjinaller veriden kestirildiği için satır toplamları r-1, sütun toplamları c-1 serbest parametre tüketir ve genel toplam zaten sabittir. Doymuş modelin rc-1 serbest parametresinden bağımsızlık modelinin (r-1)+(c-1) parametresi düşülünce (r-1)(c-1) kalır. Pearson (1900) ilk yazısında sd'yi rc-1 almıştı; Fisher (1922) kestirilen parametreler için düzeltmeyi gösterdi.
25.5.3 Yates süreklilik düzeltmesi (yalnız 2×2)
- a,b,c,d: 2×2 tablonun hücreleri (satır satır).
- 0{,}5: her hücrede mutlak sapmadan düşülen süreklilik payı; sapma 0,5'ten küçükse sıfıra çekilir (scipy ve R aynı kuralı uygular).
Neden düzeltme ve neden tartışmalı?
Sayılar kesiklidir; sürekli \chi^2 dağılımı küçük örneklemde gerçek kuyruk olasılığını küçük gösterir. Yates (1934) her sapmadan yarım birim düşerek p'yi Fisher kesin p'sine yaklaştırmayı önerdi. Düzeltme testi tutucu yapar (gerçek birinci tür hata oranı nominalin altında kalır). Bu yüzden pek çok kaynak (Campbell 2007) düzeltmesiz Pearson ya da (n-1)/n çarpanlı "N−1" \chi^2 önerir. MerQur'da 2×2 için varsayılan Yates açıktır (chi_square_independence.py:62), R chisq.test de varsayılan olarak correct = TRUE kullanır.
Koddaki tercih
Düzeltme yalnız yates and is_2x2 iken uygulanır (hypothesis.py:7257–7258, 7262). Uygulanınca metne "Yates süreklilik düzeltmesi uygulandı" ve düzeltmesiz Pearson satırı eklenir (hypothesis.py:7277–7284). Cramér V, \varphi ve C her zaman düzeltmesiz \chi^2'den hesaplanır (hypothesis.py:7260–7270); DescTools::CramerV ile aynı.
25.5.4 G-testi (olabilirlik oranı)
- \ln: doğal logaritma; n_{ij}=0 hücreleri toplama katkı vermez (0\ln 0=0).
- G^2, bağımsızlık modeli ile doymuş modelin log-olabilirlik farkının iki katıdır.
"G-testi" seçilince ana istatistik G^2 olur ve APA satırında "G²" yazılır. 2×2'de Yates de açıksa scipy düzeltilmiş sayılarla G^2 hesaplar (lambda_="log-likelihood", hypothesis.py:7256–7258); bu R DescTools::GTest(correct = "yates") tanımıdır ve düzeltmesiz G^2 ayrıca yazılır (hypothesis.py:7279–7282).
25.5.5 Etki büyüklükleri ve Cramér V'nin güven aralığı
- X^2: düzeltmesiz Pearson istatistiği.
- k: tablonun "küçük boyutu eksi bir"; V'yi 0–1 aralığına ölçekler.
- C: olumsallık katsayısı; üst sınırı 1'den küçüktür (\sqrt{(m-1)/m}, m=\min(r,c)), bu yüzden tablolar arası karşılaştırmada V yeğlenir.
Sözel etiket Cohen (1988) w eşiklerinden türetilir: V eşikleri 0{,}1/\sqrt{k}, 0{,}3/\sqrt{k}, 0{,}5/\sqrt{k} (_cramer_v_label, hypothesis.py:616–623). Altında "Önemsiz", sonra "Küçük", "Orta", "Büyük".
Neden df'ye bağlı eşikler?
Cramér V'nin büyüklük etiketi Cohen'in (1988) w eşiklerinden (0,1/0,3/0,5) \min(r,c)-1 serbestlik derecesine göre türetilir: V eşiği w/\sqrt{\min(r,c)-1}'dir. df'den bağımsız sabit eşikler büyük tablolarda etkiyi olduğundan küçük gösterir. Ana satır ve "Cramér V GA + Cohen yorumu" kutusu aynı etiketi kullanır; kutu eşikleri ayrıca açıkça yazar.
V'nin GA'sı (hypothesis.py:2328–2351). X^2, H_1 altında merkezî olmayan \chi^2_{\sd}(\lambda) dağılımına uyar. Sınırlar
denklemlerinin Brent kökleridir; F(X^2;\lambda=0)\le 1-\alpha/2 ise alt sınır 0'dır.
- \lambda: merkezî olmama parametresi; evrende n k V^2'ye karşılık gelir.
- F: merkezî olmayan \chi^2 birikimli dağılım fonksiyonu (
scipy.stats.ncx2.cdf).
Neden λ'yı doğrudan V'ye çeviriyor?
E[X^2]\approx \sd+\lambda olduğundan bazı yazılımlar \sqrt{(\lambda+\sd)/(nk)} kullanır. MerQur \lambda=n k V^2 tanımını izler; bu, R effectsize::cramers_v(adjust = FALSE, alternative = "two.sided") ile aynıdır (25.6.1'de 2{,}7\times10^{-9} fark). (\lambda+\sd) biçimi Tıp #21'de [0,3679; 0,5184] verirdi.
25.5.6 Artıklar
- r_{ij}: standart (Pearson) artık; \sum r_{ij}^2=X^2. Metinde |r_{ij}|>2 yıldızlanır.
- d_{ij}: düzeltilmiş standartlaştırılmış artık (Haberman 1973; R
chisq.test()$stdres); H_0 altında yaklaşık N(0{,}1). |d_{ij}|>1{,}96 yıldızlanır.
Neden iki ayrı artık?
r_{ij}'nin varyansı 1 değildir; E_{ij} kestirildiği için \operatorname{Var}(r_{ij})=(1-p_{i\cdot})(1-p_{\cdot j})<1. d_{ij} bu varyansla bölünerek gerçekten standart normal yapılır; bu yüzden hücre düzeyindeki karar d_{ij} ile verilmelidir. d_{ij} her zaman hesaplanıp sonuç sözlüğüne yazılır (hypothesis.py:7315–7320), metne yalnız kutu açıkken basılır. |d|>1{,}96 eşiği çoklu karşılaştırma için düzeltilmez.
25.5.7 Doğrusal-doğrusal ilişki ve sıralı ölçüler
Doğrusal-doğrusal test (Mantel 1963), hypothesis.py:7355–7373:
- u_i, v_j: satır ve sütun puanları. Düzeyler sayıya çevrilebiliyorsa düzey değeri, değilse sıra puanı 1{,}2,\dots (
_ct_scores,hypothesis.py:607–613). - \bar u=\sum_i n_{i\cdot}u_i/n, \bar v benzer: ağırlıklı ortalama puanlar.
- r_{uv}: bireysel gözlemlere açılmış verideki Pearson korelasyonu.
Sıralı ölçüler Brown ve Benedetti (1977) tanımlarıyla, hypothesis.py:2269–2320. Her hücre için A_{ij} sağ-alt ve sol-üst hücrelerin toplamı (uyumlu), D_{ij} sol-alt ve sağ-üst hücrelerin toplamıdır (uyumsuz):
- P, Q: uyumlu ve uyumsuz çift sayısının iki katı (her çift iki kez sayılır; oranlarda sadeleşir).
- m=\min(r,c).
- d_{C\mid R}: satır bağımsız, sütun bağımlı değişken (paydada satır bağları çıkarılır).
GA, ASE₁ ile Wald biçimindedir ve [-1{,}1]'e kırpılır; z ve p ise H_0 altındaki ASE₀ ile hesaplanır. Örneğin \gamma için
- ASE₁: asimptotik SH, GA için (H_1 altında).
- ASE₀: H_0 (bağımsızlık) altındaki SH; beş ölçünün z değeri bu yüzden aynı çıkar (z=13{,}395, 25.6).
- \tau_b, \tau_c ve Somers d ASE₁ formülleri Brown ve Benedetti (1977) biçimindedir (
hypothesis.py:2288–2305).
R ile karşılaştırırken dikkat
DescTools::KendallTauB \tau_b için farklı bir varyans ifadesi kullanır ve Tıp #21'de ASE'yi %0,2 büyük verir; DescTools::SomersDelta(direction = "row") ise R×C tabloda n-n_{\cdot j} vektörünü sütun öncelikli geri dönüştürdüğünden yanlış hizalanır. Sayısal delta yöntemi (çok terimli model, sayısal türev; dogrulama/chisquare/delta_ase.py) MerQur'un formülünü 10^{-12} düzeyinde doğrular. Görülen yaklaşık 2e-4 göreli fark DescTools'tan kaynaklanır.
25.5.8 Nominal ilişki ölçüleri (PRE)
hypothesis.py:2352–2372; \max_j n_{ij} satır i'nin en büyük hücresi, \max_j n_{\cdot j} en büyük sütun toplamıdır.
- \lambda_{C\mid R}: satır bilindiğinde sütunu "en sık kategori" kuralıyla tahmin ederken hatadaki orantılı azalma (Goodman ve Kruskal 1954).
- \tau_{C\mid R}: aynı fikir, rastgele atama kuralıyla.
- H_R=-\sum_i p_{i\cdot}\ln p_{i\cdot}, H_C, H_{RC}: satır, sütun ve ortak entropi (doğal log). U: belirsizlik katsayısı (Theil).
- Simetrik \lambda ve simetrik U=2(H_R+H_C-H_{RC})/(H_R+H_C) de verilir. Bu modülde PRE ölçülerine ASE ve GA verilmez; Çapraz Tablo modülü verir (Bölüm 33).
25.5.9 Sütun oranları z testi
Her satır i ve her sütun çifti (j,k) için havuzlanmış oranlı z testi (hypothesis.py:2248–2268):
- m=c(c-1)/2: bir satırdaki çift sayısı; Bonferroni çarpanı satır içinde uygulanır, satırlar arasında uygulanmaz.
- Aynı harfi paylaşan sütunların oranı p_{\text{Bonf}}\ge\alpha düzeyinde farklı değildir.
25.5.10 2×2 tabloda OR, RR ve RD
Odds oranı künyede verilir (hypothesis.py:7453–7464, ortak işlev stats/crosstab.py:276–306):
- Woolf (1955) log-Wald aralığı. Bir hücre 0 ise bütün hücrelere 0,5 eklenir (Haldane–Anscombe; R
DescTools::OddsRatio(method = "wald")), ham OR (0, ∞ ya da tanımsız) notta yazılır.
RR ve RD ("RR / risk farkı" kutusu, _rr_rd_lines, hypothesis.py:2145–2185), 1. sütun "olay" sayılarak:
- RR GA'sı log-Wald (
epitools::riskratio.wald); RD GA'sı Wald ve [-1{,}1]'e kırpılır. - "Olay" düzey sırasındaki ilk sütundur (25.5.1); kullanılan sıra çıktıda yazılır. İstenen olay ikinci sütundaysa düzey sırası alanından sıra değiştirilmelidir.
25.5.11 Monte Carlo ve Fisher p
Monte Carlo χ² (hypothesis.py:7407–7431): Patefield (1981) algoritmasıyla (scipy.stats.random_table) marjinalleri gözlenenle aynı B=10000 tablo üretilir, tohum numpy.random.default_rng(tohum).
- \varepsilon: makine epsilonu; (1-64\varepsilon) çarpanı gözlenene eşit X^2'li tabloların yuvarlama hatasıyla dışarıda kalmasını önler (R
chisq.testile aynı). - +1'ler gözlenen tablonun kendisini sayar (Hope 1968); böylece p_{\text{MC}} hiçbir zaman 0 olmaz.
- p'nin GA'sı Clopper–Pearson kesin binom aralığıdır ve b/B üzerinden kurulur (
hypothesis.py:7424–7425).
Fisher seçeneği: 2×2'de scipy.stats.fisher_exact iki yönlü kesin p (Bölüm 27); R×C'de Fisher–Freeman–Halton Monte Carlo p'si, B=10000 (hypothesis.py:6991–7000). Bu yol Fisher Kesin Testi modülündeki kesin FFH seçeneğini kullanmaz; kesin R×C p'si için Fisher Kesin Testi ya da Çapraz Tablo modülüne gidilmelidir.
25.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/chisquare/elle_hesap.py ile, MerQur kodu çağrılmadan hesaplanmıştır.
Adım 1 — Beklenen frekanslar. E_{11}=250\times250/670=93{,}283582. Bütün tablo:
| present | absent | |
|---|---|---|
| active smoking | 93,283582 | 156,716418 |
| old smoking | 74,626866 | 125,373134 |
| none non_drinker | 82,089552 | 137,910448 |
En küçük beklenen 74,63; hiçbir hücre 5'in altında değildir, asimptotik yaklaşım güvenlidir.
Adım 2 — Hücre katkıları ve X^2. (n_{ij}-E_{ij})^2/E_{ij}:
| present | absent | Satır toplamı | |
|---|---|---|---|
| active smoking | 34,483582 | 20,525942 | 55,009524 |
| old smoking | 0,386866 | 0,230277 | 0,617143 |
| none non_drinker | 46,962280 | 27,953738 | 74,916017 |
\chi^2_{0{,}95;\,2}=5{,}991 eşiği çok aşılmıştır. Katkıların %99'undan fazlası active ve none satırlarından gelir; old smoking bağımsızlıkla uyumludur.
Adım 3 — Etki büyüklükleri. k=\min(3{,}2)-1=1:
k=1 için Cohen eşikleri 0,1 / 0,3 / 0,5'tir; V=0{,}44 "Orta" etiketini alır. Merkezî olmayan \chi^2 kökleri \lambda_{\text{alt}}=88{,}6867, \lambda_{\text{üst}}=178{,}0889; V için %95 GA [\sqrt{88{,}6867/670};\ \sqrt{178{,}0889/670}]=[0{,}363824;\ 0{,}515562].
Adım 4 — Düzeltilmiş artıklar. active × present için satır ve sütun toplamı ikisi de 250'dir: 1-250/670=0{,}626866:
İki sütunlu tabloda her satırın iki artığı zıt işaretli ve eşit büyüklüktedir (present; absent): active \pm9{,}37, old \pm0{,}94, none \mp10{,}56. Aktif içicilerde KOAH beklenenden çok (150'ye karşı 93,3), hiç içmeyenlerde çok azdır (20'ye karşı 82,1); eski içiciler beklenene yakındır.
Adım 5 — Doğrusal-doğrusal test ve sıranın etkisi. Verideki sırada puanlar active = 1, old = 2, none = 3; present = 1, absent = 2. \bar u=1{,}955224, \bar v=1{,}626866, çapraz çarpım toplamı 118{,}805970, kareler toplamları 468,656716 ve 156,716418:
Klinik sıra (none = 1, old = 2, active = 3; absent = 1, present = 2) girildiğinde aynı r_{uv} ve M^2 çıkar: bu veride iki değişkenin ilk görülme sırası klinik sıranın tam tersidir ve iki ters çevirme birbirini götürür. Bu bir rastlantıdır. Etiketler alfabetik dizilseydi (active = 1, none = 2, old = 3; absent = 1, present = 2) r_{uv}=-0{,}194146 ve M^2=25{,}216367 çıkardı: aynı veride istatistik beşte birine düşer ve işaret döner. Pearson X^2 her sırada 130,54'tür.
Adım 6 — Sıralı ölçüler (klinik sıra). P=128000 (64000 uyumlu çift), Q=24800 (12400 uyumsuz çift):
\tau_b=0{,}412536 (ASE₁ 0,029967), \tau_c=0{,}459791, d_{C\mid R}=0{,}346309, d_{R\mid C}=0{,}491429; beşinin de z değeri 13{,}394639'dur. Verideki sırada da aynı değerler çıkar (Adım 5'teki nedenle). Alfabetik bir sırada ise \gamma=-0{,}319372 çıkardı: işaret ve büyüklük anlamsızdır.
Adım 7 — Nominal ölçüler. Satır en büyükleri 150+120+200=470, en büyük sütun toplamı 420:
Simetrik \lambda=0{,}223881; \tau_{C\mid R}=0{,}194840; entropiler H_R=1{,}094402, H_C=0{,}660603, H_{RC}=1{,}646454 ile U_{C\mid R}=0{,}164320, simetrik U=0{,}123704.
Adım 8 — 2×2 örneği (Tıp #23). ad-bc=7\times4-8\times9=-44, marjinaller 15, 13, 16, 12:
p değerleri 0,228871 ve 0,411981'dir; varsayılan ayarda MerQur 0,4120'yi ana p olarak yazar. En küçük beklenen 5,571 olduğundan Fisher önerisi çıkmaz. Fisher iki yönlü kesin p=0{,}276058 (Bölüm 27). \widehat{\text{OR}}=28/72=0{,}388889, \SH(\ln\text{OR})=0{,}793075, %95 GA [0{,}082179;\ 1{,}840316]. Olay ilk sütun olan "Pozitif" sonuçtur: \widehat{\text{RR}}=(7/15)/(9/13)=0{,}674074, GA [0{,}351488;\ 1{,}292720]; \widehat{\text{RD}}=-0{,}225641, GA [-0{,}581571;\ 0{,}130289].
25.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan, stats.hypothesis modülünde yalnız round ve _p_tam bellekte etkisizleştirilerek alınmıştır (dogrulama/chisquare/merqur_calistir.py). Yalnız metinde yazılan C, \varphi ve standart artık gösterilen ondalıkta karşılaştırılmıştır. R 4.5.3: chisq.test, DescTools (GTest, CramerV, ContCoef, GoodmanKruskalGamma, StuartTauC, SomersDelta, Lambda, GoodmanKruskalTau, UncertCoef, OddsRatio, RelRisk(delta = 0), BinomDiffCI), effectsize::cramers_v, prop.test, fisher.test. \tau_b ASE₁ R'de Brown–Benedetti formülüyle doğrudan hesaplanmış, Somers d(R\mid C) devrik tablodan alınmıştır (25.5.7). Monte Carlo p'de Python aynı üreteç akışını yeniden üretir; R'nin üreteci farklıdır, ancak bu veride üç kaynakta da b=0 olduğundan p=1/10001 eşittir.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Tıp #21 (3×2) | |||||
| Pearson \chi^2 | 130,542684 | 130,542684 | 130,542684 | 2,8e−14 | ✓ |
| sd | 2 | 2 | 2 | 0,0e+00 | ✓ |
| p (asimptotik) | 4,4980·10−29 | 4,4980·10−29 | 4,4980·10−29 | 1,1e−43 | ✓ |
| En küçük beklenen E_{21} | 74,626866 | 74,626866 | 74,626866 | 0,0e+00 | ✓ |
| Cramér V | 0,441407 | 0,441407 | 0,441407 | 5,6e−17 | ✓ |
| Olumsallık katsayısı C | 0,4038 | 0,403816 | 0,403816 | 3,3e−16 | ✓ (4 ondalık) |
| Standart artık r_{11} (active, present) | 5,87 | 5,872272 | 5,872272 | 3,6e−15 | ✓ (2 ondalık) |
| Düzeltilmiş artık d_{11} | 9,367672 | 9,367672 | 9,367672 | 1,8e−15 | ✓ |
| Düzeltilmiş artık d_{21} | 0,937954 | 0,937954 | 0,937954 | 1,1e−16 | ✓ |
| Düzeltilmiş artık d_{31} | −10,561327 | −10,561327 | −10,561327 | 4,3e−14 | ✓ |
| G^2 | 145,457335 | 145,457335 | 145,457335 | 1,1e−13 | ✓ |
| G^2 için p | 2,5962·10−32 | 2,5962·10−32 | — | 0,0e+00 | ✓ |
| Doğrusal-doğrusal M^2 (veri sırası) | 128,568124 | 128,568124 | 128,568124 | 2,0e−12 | ✓ |
| M^2 (kullanıcı sırası) | 128,568124 | 128,568124 | 128,568124 | 2,7e−12 | ✓ |
| \gamma (kullanıcı sırası) | 0,675393 | 0,675393 | 0,675393 | 0,0e+00 | ✓ |
| \gamma GA alt | 0,597888 | 0,597888 | 0,597888 | 4,4e−16 | ✓ |
| \tau_b | 0,412536 | 0,412536 | 0,412536 | 5,6e−17 | ✓ |
| \tau_b ASE₁ | 0,029967 | 0,029967 | 0,029967 | 3,5e−17 | ✓ |
| \tau_c GA üst | 0,527069 | 0,527069 | 0,527069 | 1,1e−16 | ✓ |
| Somers d(C\mid R) | 0,346309 | 0,346309 | 0,346309 | 2,2e−16 | ✓ |
| Somers d(C\mid R) GA alt | 0,295425 | 0,295425 | 0,295425 | 3,9e−16 | ✓ |
| Somers d(R\mid C) GA alt | 0,422221 | 0,422221 | 0,422221 | 2,2e−16 | ✓ |
| Cramér V %95 GA alt (nc \chi^2) | 0,363824 | 0,363824 | 0,363824 | 2,7e−09 | ✓ |
| Cramér V %95 GA üst | 0,515562 | 0,515562 | 0,515562 | 1,5e−09 | ✓ |
| \lambda simetrik | 0,223881 | 0,223881 | 0,223881 | 3,9e−16 | ✓ |
| \lambda(C\mid R) | 0,200000 | 0,200000 | 0,200000 | 0,0e+00 | ✓ |
| Goodman–Kruskal \tau(C\mid R) | 0,194840 | 0,194840 | 0,194840 | 1,1e−16 | ✓ |
| Belirsizlik katsayısı U simetrik | 0,123704 | 0,123704 | 0,123704 | 7,4e−16 | ✓ |
| Sütun oranı z testi p (old smoking) | 0,348268 | 0,348268 | 0,348268 | 2,8e−16 | ✓ |
| Monte Carlo \chi^2 p (B = 10000) | 9,9990·10−5 | 9,9990·10−5 | 9,9990·10−5 | 1,4e−20 | ✓ |
| Monte Carlo p GA üst (Clopper–Pearson) | 0,000369 | 0,000369 | 0,000369 | 3,3e−15 | ✓ |
| Monte Carlo FFH p | 9,9990·10−5 | 9,9990·10−5 | 9,9990·10−5 | 1,4e−20 | ✓ |
| Tıp #23 (2×2) | |||||
| Yates düzeltmeli \chi^2 | 0,673077 | 0,673077 | 0,673077 | 2,2e−16 | ✓ |
| Yates p | 0,411981 | 0,411981 | 0,411981 | 1,7e−16 | ✓ |
| Düzeltmesiz Pearson \chi^2 | 1,447863 | 1,447863 | 1,447863 | 2,4e−15 | ✓ |
| Düzeltmesiz p | 0,228871 | 0,228871 | 0,228871 | 3,9e−15 | ✓ |
| Yates düzeltmeli G^2 | 0,677577 | 0,677577 | 0,677577 | 1,1e−16 | ✓ |
| Fisher kesin p (iki yönlü) | 0,276058 | 0,276058 | 0,276058 | 3,9e−16 | ✓ |
| \varphi | 0,2274 | 0,227397 | 0,227397 | 1,9e−16 | ✓ (4 ondalık) |
| Düzeltilmiş artık d_{11} | −1,203272 | −1,203272 | −1,203272 | 2,0e−15 | ✓ |
| OR (Woolf) | 0,388889 | 0,388889 | 0,388889 | 1,1e−16 | ✓ |
| OR %95 GA alt | 0,082179 | 0,082179 | 0,082179 | 4,2e−17 | ✓ |
| OR %95 GA üst | 1,840316 | 1,840316 | 1,840316 | 2,2e−16 | ✓ |
| RR (Pozitif; log-Wald) | 0,674074 | 0,674074 | 0,674074 | 0,0e+00 | ✓ |
| RR %95 GA alt | 0,351488 | 0,351488 | 0,351488 | 3,3e−16 | ✓ |
| RR %95 GA üst | 1,292720 | 1,292720 | 1,292720 | 3,6e−15 | ✓ |
| Risk farkı RD | −0,225641 | −0,225641 | −0,225641 | 3,9e−16 | ✓ |
| RD %95 GA alt (Wald) | −0,581571 | −0,581571 | −0,581571 | 1,1e−16 | ✓ |
| Cramér V %95 GA üst | 0,597775 | 0,597775 | 0,597775 | 1,8e−09 | ✓ |
| \tau_b GA üst | 0,130688 | 0,130688 | 0,130688 | 2,2e−16 | ✓ |
Sonuç: 50 büyüklüğün tamamı ölçütü karşılar. En büyük fark Cramér V GA sınırında 2{,}7\times10^{-9}'dur (effectsize kök bulma toleransı).
25.7 Çıktıyı okuma
Varsayılan ayarlarla Tıp #21 çıktısı:
Ki-Kare Bağımsızlık Testi
χ²(2)=130.5427, p < .001 ***. Cramer's V=0.4414 (Orta). H₀ REDDEDİLİR.

Beklenen frekansı 5'ten küçük hücre: 0 (%0.0); en küçük beklenen frekans = 74.63.
APA: χ²(2, N = 670) = 130.54, p < .001, V = .44
Tıp #23'te (2×2) "Kesin / Monte Carlo p: Fisher" seçilince:
χ²(1)=0.6731, p = 0.2761 (Fisher kesin) ns. Cramer's V=0.2274 (Küçük). H₀ REDDEDİLEMEZ.
Yates süreklilik düzeltmesi uygulandı (2×2).
Pearson χ² (düzeltmesiz) = 1.4479, p = 0.2289; etki büyüklükleri (Cramér's V, φ, C) her zaman düzeltmesiz Pearson χ²'den hesaplanır.
Fisher kesin testi (2×2, iki yönlü): p = 0.276058
Ana p ve karar seçilen yönteme dayanır: Fisher kesin p = 0.276058 (asimptotik p = 0.411981).
APA: χ²(1, N = 28) = 0.67 (Yates düzeltmeli), p = .276 (Fisher kesin), V = .23
| Satır | Ne yazar | Nasıl yorumlanır |
|---|---|---|
χ²(2)=130.5427 |
Uygulanan istatistik ve sd | 2×2'de Yates açıksa düzeltmeli değer, G-testi seçiliyse G^2. |
p < .001 *** |
Ana p ve yıldız | Monte Carlo/Fisher seçildiyse o p; ikinci örnekte istatistik Yates \chi^2'si, p ise Fisher p'sidir. |
Cramer's V=0.4414 (Orta) |
Düzeltmesiz X^2'den V ve Cohen etiketi | Etiket k=\min(r,c)-1'e bağlıdır. |
| Beklenen frekans dipnotu | E<5 hücre sayısı, oranı, en küçük E | Her zaman yazılır. |
| Uyarı: "Beklenen frekans < 5 olan hücre var … Fisher kesin testi önerilir." | Yalnız 2×2'de \min E<5 | hypothesis.py:7467–7469. |
| Uyarı: Cochran kuralı | R×C'de E<5 hücre oranı > %20 ya da \min E<1 | hypothesis.py:7471–7473. |
| Uyarı: sıra tanımlanmadı | "Tüm testler" ya da "Sıralı ölçüler" açık ve ≥ 3 düzeyli değişkenin sırası verideki ilk görülme sırasından gelmiş | Sıralı ölçüler ve doğrusal-doğrusal test ancak anlamlı bir sırayla yorumlanır. |
| Künye: Odds Ratio (OR), OR %95 GA | 2×2'de Woolf OR ve GA | Sıfır hücrede "(Haldane–Anscombe)" eki. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Sigara durumu ile KOAH varlığı arasında anlamlı bir ilişki bulundu, \chi^2(2, N = 670) = 130{,}54, p < 0{,}001, Cramér V = 0{,}44 (%95 GA [0,36; 0,52]). Düzeltilmiş artıklara göre KOAH aktif içicilerde beklenenden sık (d = 9{,}37), hiç içmemişlerde beklenenden seyrekti (d = -10{,}56); eski içicilerde beklenene yakındı (d = 0{,}94).
25.8 Uzman soruları
S1. 2×2'de neden varsayılan Yates? Yates'in aşırı tutucu olduğu bilinmiyor mu?
Biliniyor. Yates düzeltmesi p'yi Fisher kesin p'sine yaklaştırır ve gerçek birinci tür hata oranını nominalin altına çeker (Campbell 2007). MerQur R chisq.test varsayılanını izler (correct = TRUE) ve düzeltmesiz Pearson'u her zaman ikinci satırda yazar. Tıp #23'te düzeltmesiz p=0{,}229, Yates p=0{,}412, Fisher p=0{,}276'dır. Küçük örneklemde kesin test, büyük örneklemde düzeltmesiz Pearson önerilir; Yates kutusunu kapatmak düzeltmesiz Pearson'u ana sonuç yapar.
S2. Yates seçiliyken Cramér V neden değişmiyor?
V, \varphi ve C her zaman düzeltmesiz X^2'den hesaplanır (hypothesis.py:7260–7270). Düzeltme bir test kuralıdır, etki büyüklüğü tanımının parçası değildir; DescTools::CramerV de düzeltmesiz X^2 kullanır. Tıp #23'te V=\varphi=0{,}2274'tür; Yates X^2'den hesaplansaydı 0,155 çıkardı.
S3. Doğrusal-doğrusal testin değeri neden ayardan ayara bu kadar değişiyor?
Çünkü puanlar düzey sırasına bağlıdır. Sıra tanımlanmamış metin düzeylerde verideki ilk görülme sırası kullanılır ve MerQur "sıra tanımlanmadı" uyarısı yazar. Tıp #21'de alfabetik bir sırada M^2=25{,}22, klinik sırada (ve bu veride rastlantıyla verideki sırada) 128,57 çıkar; sıra seçimi istatistiği beş kat değiştirebilir. Düzeyler sayısal kodlanmışsa (1, 2, 5) puan düzey değeridir; eşit aralıklı sıra puanı değildir. Bu, Agresti'nin bebek verisinde 1,83 ile 6,57 gibi farklı sonuçlar verebilir (kod yorumu hypothesis.py:7355–7357).
S4. Bir hücrede gözlem sıfırsa ya da bir düzeyin hiç gözlemi yoksa ne olur?
Hücre sıfırsa X^2 sorunsuz hesaplanır; G^2'de o hücre katkı vermez; OR için Haldane–Anscombe düzeltmesi devreye girer. Bir düzeyin marjinali sıfırsa (ağırlık sütunuyla 0 ağırlıklı düzey) o düzey atılır ve uyarı yazılır; aksi halde E_{ij}=0 olur ve scipy İngilizce iç hata verirdi (hypothesis.py:566–577). Tablo tek düzeye inerse analiz hata ile durur (hypothesis.py:7245–7247); R chisq.test de en az iki düzey ister.
S5. Monte Carlo p ile asimptotik p arasında ne zaman fark beklenir? Tohumu değiştirirsem karar değişir mi?
Beklenen frekanslar küçükken ve tablo seyrekken asimptotik \chi^2 yaklaşımı bozulur; Monte Carlo p koşullu kesin p'nin yansız bir kestirimidir. B=10000'de p'nin standart hatası \sqrt{p(1-p)/B}'dir; p\approx0{,}05 için yaklaşık 0,002. Karar sınırdaysa tohum değişikliği kararı değiştirebilir; MerQur bu yüzden p'nin Clopper–Pearson GA'sını yazar. GA eşiği içeriyorsa B artırılmalı ya da kesin test seçilmelidir. B bu panelde 10000'e sabittir (hypothesis.py:7237).
S6. Cramér V'nin GA'sı R'deki effectsize ile aynı mı? DescTools neden farklı?
effectsize::cramers_v(adjust = FALSE, alternative = "two.sided") ile aynı tanımdır; fark 10^{-9} düzeyindedir. effectsize'ın varsayılanı alternative = "greater"dır ve tek yönlü [\text{alt}, 1] aralığı verir; karşılaştırmada bu ayar değiştirilmelidir. DescTools::CramerV(method = "ncchisq") aynı tanımı daha gevşek kök toleransıyla bulur (4\times10^{-6} fark).
S7. Sıralı ölçülerin z değerleri neden hepsi aynı?
Beş ölçünün payı aynıdır (P-Q) ve ASE₀'ları da aynı \sqrt{\sum n_{ij}(A_{ij}-D_{ij})^2-(P-Q)^2/n} terimiyle ölçeklenir; oran sadeleşince z eşitlenir. Bu, H_0 altında tek bir "eğilim" testinin farklı normlaştırmaları demektir. GA'lar ise ASE₁ ile kurulduğundan farklıdır.
S8. Düzeltilmiş artığı 1,96'yı aşan hücreler için çoklu karşılaştırma düzeltmesi yapılıyor mu?
Hayır. Eşik hücre başına \alpha=0{,}05'tir. 3×2 tabloda 6 hücre vardır (bağımsız değildir); Bonferroni eşiği z_{1-0{,}05/12}=2{,}64 olurdu. Tıp #21'de active ve none hücreleri bu eşiği de rahatça aşar. Sütun oranları z testinde ise satır içi Bonferroni uygulanır.
25.9 Sık hatalar ve tuzaklar
- Verideki ilk görülme sırasını sıralı değişken sanmak. Sigara durumu gibi doğal sıralı bir değişken metin olarak girilmişse ve sıra tanımlanmamışsa sıralı ölçüler ve doğrusal-doğrusal test anlamsızdır; düzey sırası alanı doldurulmalıdır.
- Yates ve Fisher seçeneklerini birlikte okumak. Fisher seçilince ana p Fisher p'sidir ama ana satırdaki istatistik Yates \chi^2'si kalır; raporda istatistik ile p'nin kaynağı ayrı yazılmalıdır.
- 2×2'de RR'nin olayını kontrol etmemek. RR ve RD düzey sırasındaki ilk sütunu olay sayar; çıktıdaki sıra satırı denetlenmelidir.
- "Anlamlı" sonucu güçlü ilişki sanmak. n=670'te küçük ilişkiler de anlamlı çıkar; V ve GA'sı raporlanmalıdır.
- Eşleşik veriye ki-kare uygulamak. Aynı hastanın iki tanısı McNemar ister.
- Ağırlık sütununu ondalıklı girmek. Monte Carlo ve Fisher yolları tam sayı ister; ondalıklı ağırlıkta bu seçenekler yalnız not yazar.
- Çapraz Tablo ile sonuç karşılaştırırken 2×2'de farkı hata sanmak. Çapraz Tablo ana satırda düzeltmesiz Pearson, bu modül varsayılan olarak Yates verir.
25.10 Kaynaklar
- Agresti, A. (2013). Categorical data analysis (3. baskı). Wiley.
- Brown, M. B., & Benedetti, J. K. (1977). Sampling behavior of tests for correlation in two-way contingency tables. Journal of the American Statistical Association, 72(358), 309–315. https://doi.org/10.1080/01621459.1977.10480995
- Campbell, I. (2007). Chi-squared and Fisher–Irwin tests of two-by-two tables with small sample recommendations. Statistics in Medicine, 26(19), 3661–3675. https://doi.org/10.1002/sim.2832
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2. baskı). Lawrence Erlbaum. (Routledge yeniden basımı: https://doi.org/10.4324/9780203771587)
- Cramér, H. (1946). Mathematical methods of statistics. Princeton University Press.
- Fisher, R. A. (1922). On the interpretation of χ² from contingency tables, and the calculation of P. Journal of the Royal Statistical Society, 85(1), 87–94. https://doi.org/10.2307/2340521
- Goodman, L. A., & Kruskal, W. H. (1954). Measures of association for cross classifications. Journal of the American Statistical Association, 49(268), 732–764. https://doi.org/10.1080/01621459.1954.10501231
- Haberman, S. J. (1973). The analysis of residuals in cross-classified tables. Biometrics, 29(1), 205–220. https://doi.org/10.2307/2529686
- Hope, A. C. A. (1968). A simplified Monte Carlo significance test procedure. Journal of the Royal Statistical Society: Series B, 30(3), 582–598. https://doi.org/10.1111/j.2517-6161.1968.tb00759.x
- Mantel, N. (1963). Chi-square tests with one degree of freedom; extensions of the Mantel–Haenszel procedure. Journal of the American Statistical Association, 58(303), 690–700. https://doi.org/10.1080/01621459.1963.10500879
- Patefield, W. M. (1981). Algorithm AS 159: An efficient method of generating random R × C tables with given row and column totals. Applied Statistics, 30(1), 91–97. https://doi.org/10.2307/2346669
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Steiger, J. H. (2004). Beyond the F test: Effect size confidence intervals and tests of close fit in the analysis of variance and contrast analysis. Psychological Methods, 9(2), 164–182. https://doi.org/10.1037/1082-989X.9.2.164
- Woolf, B. (1955). On estimating the relation between blood group and disease. Annals of Human Genetics, 19(4), 251–253. https://doi.org/10.1111/j.1469-1809.1955.tb01348.x
- Yates, F. (1934). Contingency tables involving small numbers and the χ² test. Supplement to the Journal of the Royal Statistical Society, 1(2), 217–235. https://doi.org/10.2307/2983604