1. Tanımlayıcı İstatistikler
Analiz kimliği: descriptive · Menü adı: Tanımlayıcı İstatistikler · Panel: gui/panels/analyses/descriptive.py (yalnız künye) ve gui/panels/stats_panel.py, _show_desc_col (satır 3514–3635), _show_desc_grouped (3650–3736) · Motor: stats/descriptive.py, DescriptiveStats.numeric_descriptives (satır 344–444), numeric_frequency (448–497), extended_descriptives (665–749)
1.1 Ne işe yarar
Tanımlayıcı istatistikler tek bir değişkenin dağılımını birkaç sayıyla özetler. Cevapladığı soru şudur: "Bu değişkenin değerleri nerede toplanıyor, ne kadar yayılıyor ve dağılımın biçimi nasıl?" Ortada bir hipotez yoktur; tek çıkarımsal öğe ortalamanın güven aralığıdır (GA):
- \bar x: örneklem ortalaması; s: örneklem standart sapması (SS); n: geçerli gözlem sayısı.
- t_{1-\alpha/2,\ n-1}: n-1 serbestlik dereceli (sd) t dağılımının üst \alpha/2 kantili; \alpha=1-\text{güven düzeyi}.
Ne zaman kullanılır? Her analizin başında: veri girişi hatalarını yakalamak (BMI = 150 gibi), eksik değerleri saymak, ölçeği ve birimi görmek, çarpıklık ve aykırı değerleri fark etmek, makalenin "Tablo 1"ini hazırlamak.
Ne zaman kullanılmaz?
- İki ya da daha çok grubun ortalamalarını karşılaştırmak için: bu sekme yalnız özetler; sınama için Bağımsız t-Testi, Tek Yönlü ANOVA ya da Mann–Whitney U.
- Normalliği sınamak için: çarpıklık ve basıklık yalnız işarettir; sınama Normallik Testleri (Bölüm 3) ile yapılır.
- Anakütle değerlerinin belirli bir oranını kapsayan aralık (referans aralığı) için: ortalamanın GA'sı bunu vermez; Tolerans Aralıkları (Bölüm 2).
- Ortalama için dağılımdan bağımsız GA isteniyorsa: Bootstrap GA.
- Çok seçimli (çoklu yanıt) sorular için: sol listedeki Çok Seçimli Gruplar kutusu ya da Çoklu Yanıt Frekansı.
Sık karıştırılan analizler. Ortalamanın standart hatası (SH) ile SS karıştırılır: SS gözlemlerin yayılımını, SH ortalamanın kestirim belirsizliğini ölçer. Ortalamanın GA'sı ile tolerans aralığı da karıştırılır: %95 GA "evren ortalaması büyük olasılıkla buradadır" der; hastaların %95'inin nerede olduğunu söylemez. Normallik modülündeki çarpıklık ve basıklık bu modüldekiyle aynı tanımdadır (G_1, G_2).
1.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Ölçek | Ortalama, SS, çarpıklık için aralık ya da oran ölçeği gerekir. Kategorik sütunda yalnız frekans anlamlıdır. | Sütun türüne göre dal seçilir: numeric/binary ve sayısal dtype ise sayısal özet, değilse frekans tablosu (stats_panel.py:3561, 3609–3623). |
| Bağımsız gözlemler | GA'nın geçerliliği için gerekir; özet sayılar için gerekmez. | Denetlenmez. |
| Normallik | Yalnız GA'nın küçük n'de kesin olması için gerekir. | Denetlenmez; "SES / SEK" kutusu çarpıklık ve basıklık z'lerini verir. |
| Pozitif değer | Geometrik ve harmonik ortalama için tüm değerler >0 olmalı. | Bir değer bile \le 0 ise ikisi "—" yazılır (descriptive.py:724–728). |
Eksik değer. Her sütun kendi içinde ele alınır: pd.to_numeric(..., errors="coerce") ile sayıya çevrilemeyen hücreler eksik sayılır ve atılır (descriptive.py:369–371). "Eksik" satırı bu sayıyı verir. Sütunlar arasında liste bazında silme yoktur; her sütunun n'i ayrıdır.
Uç durumlar.
- Tamamen boş sütun listede gösterilmez (
stats_panel.py:3476–3484); seçilirse "geçerli n = 0" iletisi yazılır (3512–3531). - n<2: bütün sayısal alanlar boş döner (
descriptive.py:375–384). - s=0 (sabit sütun): SH = 0 alınır ve GA tek noktaya iner; uyarı yazılmaz (
descriptive.py:389). - Hiçbir değer tekrar etmiyorsa mod yazılmaz, "mod yok (tekrar eden değer yok)" yazılır (
descriptive.py:401–403). Birden çok mod varsa hepsi virgülle sıralanır. - SEK (basıklığın SH'si) n\ge4, SES n\ge3 ister (
descriptive.py:626–637).
1.3 Parametreler
Betimsel analizin "Çalıştır" düğmesi yoktur: sol listede sütuna tıklandığında sonuç hemen yenilenir ve rapora kart eklenir (stats_panel.py:3503–3510). Seçenekler _build_desc_params (stats_panel.py:3260–3393) ve _build_desc_q1_options (3395–3425) içinde kurulur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Sütun Seçin | ilk görünür sütun | Özetlenecek sütun; tür rozetiyle listelenir. | Sayısal sütunda tam özet, kategorikte frekans tablosu. |
| Gruba göre (Split-File) | (Gruplama yok) | Kategorik, ikili, sıralı ya da sayısal kodlu faktör sütunu. | Her düzey için ayrı satır ve gruplu kutu grafiği; tek sütun görünümü yerine geçer. |
| Bin sayısı | Otomatik (Sturges) | 1 = Otomatik; 2–100 kullanıcı kutu sayısı. | Yalnız frekans tablosu ve histogram. |
| Ondalık basamak | Otomatik (ölçeğe göre) | 0–8 ya da otomatik. | Yalnız gösterim; değerler tam saklanır. |
| Güven Düzeyi | %95 | %90, %95, %99 ya da 80–99,9 özel. | GA genişliği. |
| Ek çıktılar: SES / SEK | kapalı | Çarpıklık ve basıklığın SH'leri ve z'leri. | Ek satır. |
| Ek çıktılar: Sağlam ölçüler | kapalı | %5 kırpılmış ortalama, Huber M (k=1{,}5), MAD. | Ek satır. |
| Ek çıktılar: CV, geometrik/harmonik ort., toplam | kapalı | Değişim katsayısı (%), iki ortalama, toplam. | Ek satır. |
| Ek çıktılar: Uç değerler / aykırılar | kapalı | En yüksek ve en düşük 5 değer, Tukey kutu grafiği aykırıları. | Ek üç satır. |
| Ek çıktılar: Tüm sayısal değişkenlerin özet tablosu | kapalı | Bütün sayısal sütunlar için tek tablo. | Frekans sekmesine bu tablo yazılır. |
| Yüzdelikler | boş | Virgülle ayrılmış yüzdelikler, ör. 5, 10, 90, 95. | Ek satır; 0<p<100 dışı değerler atlanır. |
| Yüzdelik tanımı | Tip 7 | Hyndman–Fan tip 1–9. | Ana tablodaki Q1, Q3 ve IQR'yi, ek çeyrek satırını ve yüzdelikleri birlikte değiştirir; tip 7 dışında satır etiketi "(tip t)" eki alır. |
| Grafik ekleri: Histogramda normal eğri, Q-Q | kapalı | Histograma N(\bar x, s^2) eğrisi; üçüncü panelde Q–Q. | Yalnız grafik. |
| Z-puanlarını veri setine kaydet | düğme | z=(x-\bar x)/s değerlerini Z<sütun> adıyla ekler. |
Veri setini değiştirir. |
Neden "Yüzdelik tanımı" ana tabloyu da değiştiriyor?
Aynı çıktıda iki farklı Q1 bulunması okuru yanıltır. Seçilen tip numeric_descriptives(qtype=) ile ana tablodaki Q1, Q3 ve IQR'ye, extended_descriptives içindeki "Çeyrekler (yüzdelik tanımı tip t)" satırına ve yüzdeliklere birlikte uygulanır. Varsayılan tip 7'de (R ve pandas varsayılanı) ana tablo değişmez. Tip 6 seçen kullanıcı ana tabloda Q1 = 23,1375 görür ve satır etiketi "(tip 6)" eki alır. Rapora hangi tanımın kullanıldığı yazılmalıdır.
1.4 Tıp örneği
Dosya: english/datasets/Tip/01_descriptive_patient_vital.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/01_tanimlayici_hasta_vital.xlsx).
| Değişken | Rol | Tür | Açıklama/özet |
|---|---|---|---|
BMI |
özetlenen sütun | sürekli | Beden kitle indeksi (kg/m²); 13,89–50,38. |
sex |
Gruba göre | metin, 2 düzey | female 147, male 133. |
age, height_cm, weight_kg, systolic_bp, diastolic_bp, glucose_mg_dL |
çok değişkenli özet | sürekli/tamsayı | Video senaryosundaki diğer değişkenler. |
patient_id |
kullanılmaz |
n ve eksik değer: 280 hasta; hiçbir sütunda eksik değer yoktur.
Klinik soru: Örneklemin BMI dağılımı nasıl? Ortalama ile medyan arasında fark var mı, kadın ve erkekte BMI farklı mı dağılıyor, aşırı değerli hasta var mı?
Seçilen ayarlar: Varsayılanlar (Otomatik kutu, otomatik ondalık, %95). Hesap yürüyüşü için "Ek çıktılar" altındaki SES/SEK, sağlam ölçüler, CV satırı, uç değerler kutuları ve "5, 10, 90, 95" yüzdelikleri açılmıştır; ayrıca "Gruba göre: sex" ile ikinci bir görünüm alınmıştır.
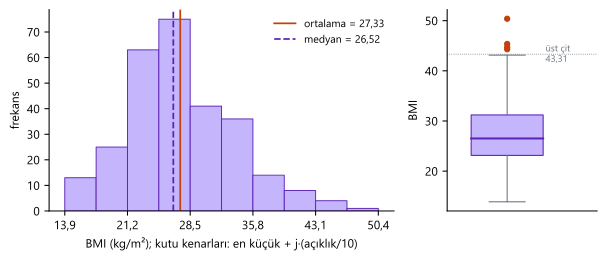
Şekil 1.1. BMI histogramı (MerQur'un otomatik 10 eşit genişlikli kutusu) ve Tukey menteşeli kutu grafiği. Turuncu çizgi ortalama, kesikli mor çizgi medyan; turuncu noktalar 1,5 × menteşe aralığı dışındaki dört aykırı değer.
1.5 Formüller ve hesap adımları
MerQur'un sırası şudur: (1) sütunu sayıya çevir, eksikleri at; (2) n<2 ise boş tablo döndür; (3) ortalama, SS, varyans, SH, medyan, mod, en küçük/en büyük, çeyrekler, çarpıklık, basıklık ve GA'yı hesapla; (4) ondalık sayısını ölçeğe göre seç; (5) Sturges kutularıyla frekans tablosunu kur; (6) istenen ek satırları ekle; (7) APA satırını yaz.
1.5.1 Konum ve yayılım
- x_i: i. hastanın BMI değeri; n: geçerli gözlem sayısı.
- s^2: örneklem varyansı; s: SS. Kodda
s_clean.std()ves_clean.var(); pandas varsayılanıddof=1(descriptive.py:388, 399). - \SH(\bar x): ortalamanın standart hatası (
descriptive.py:389).
Neden n-1?
Sapmalar evren ortalamasından değil, aynı veriden kestirilen \bar x'ten alınır. \sum(x_i-\bar x)=0 kısıtı nedeniyle n sapmanın yalnız n-1'i serbesttir; n'ye bölmek \sigma^2'yi sistematik olarak küçük kestirir. n-1'e bölmek kestiriciyi yansız yapar: E(s^2)=\sigma^2. R var() aynı tanımı kullanır. Ayrıntı için Bölüm 5'teki t testi anlatımına bakın.
Medyan, en küçük, en büyük, açıklık. Medyan pandas median() ile: n tekse ortadaki sıralı değer, çiftse ortadaki iki değerin ortalaması. Açıklık = en büyük − en küçük.
Mod. s_clean.mode() en sık görülen değer(ler)i döndürür (descriptive.py:400). Mod sayısı n'ye eşitse (hiç tekrar yoksa) "mod yok" yazılır.
Koddaki tercih
Hiçbir değer tekrarlanmıyorsa MerQur "mod yok" der (descriptive.py:401–403). Birden çok mod varsa MerQur hepsini yazar. Sürekli ölçümde (BMI 263 farklı değer) mod pek bilgi taşımaz: bu veride 26,24 değeri yalnız 3 kez görülür.
1.5.2 Çeyrekler ve yüzdelikler (Hyndman–Fan)
Ana tablodaki Q1 ve Q3 varsayılan olarak tip 7 tanımıyla hesaplanır; "Yüzdelik tanımı" seçimi bu satırları da değiştirir. Sıralı değerler x_{(1)}\le\dots\le x_{(n)} olsun:
- p: istenen olasılık (Q1 için 0,25; Q3 için 0,75).
- h: sıralı dizideki (kesirli) konum; \lfloor h\rfloor tam kısmı.
- İki komşu sıralı değer arasında doğrusal enterpolasyon yapılır.
"Yüzdelik tanımı" tip 6 seçilirse konum h=(n+1)p olur. Seçim np.quantile(x, ..., method=...) ile uygulanır; kod tipleri numpy yöntem adlarına eşler (descriptive.py:619–623: 6 → weibull, 7 → linear, 2 → averaged_inverted_cdf …).
Neden varsayılan tip 7?
Hyndman ve Fan (1996) dokuz tanımı karşılaştırmış ve tip 8'i önermiştir; R, pandas ve numpy yine de tip 7'yi varsayılan yapar. Tip 7'de en küçük değer Q(0), en büyük değer Q(1)'dir; yani tanım her p için verinin aralığında kalır. MerQur karşılaştırılabilirlik için R varsayılanını izler. Büyük n'de tipler arasındaki fark küçülür; bu veride Q1 farkı 0,015'tir.
1.5.3 Çarpıklık ve basıklık
Önce merkezî momentler hesaplanır, sonra küçük örneklem düzeltmesi uygulanır:
- m_k: k. merkezî moment (n'ye bölünür).
- g_1, g_2: moment oranlarıyla çarpıklık ve fazlalık basıklık (yanlı).
- G_1, G_2: MerQur'un yazdığı düzeltilmiş çarpıklık ve fazlalık basıklık. Kodda pandas
skew()vekurtosis()(descriptive.py:434–435). - Normal dağılımda G_1\approx0, G_2\approx0. G_2>0 kalın kuyruk ve sivri tepe, G_2<0 ince kuyruk.
Neden G_1 ve G_2?
g_1 ve g_2 küçük örneklemde yanlıdır. G_1 ve G_2, momentlerin yerine yansız birikim (k-istatistik) kestiricileri konarak elde edilir; normal örneklemde G_2 yansızdır (Joanes ve Gill 1998). R e1071::skewness(type = 2) bu tanımı verir. R psych::describe ve e1071'in varsayılanı ise tip 3'tür (b_1=g_1[(n-1)/n]^{3/2}, b_2=(g_2+3)(1-1/n)^2-3); bu veride 0,5709 ve 0,4315 verir, MerQur 0,5770 ve 0,4861. Karşılaştırmada tip belirtilmelidir.
SES ve SEK ("SES / SEK" kutusu, skew_kurt_se, descriptive.py:626–637):
- SES: normal anakütleden çekilen örneklemde G_1'in kesin standart hatası; SEK: G_2'nin.
- z: kaba bir normallik işareti; |z|>1{,}96 küçük örneklemde, |z|>3{,}29 orta büyüklükte sapma işareti sayılır (Normallik modülündeki metin, Bölüm 3).
Koddaki tercih
SES ve SEK, \sqrt{6/n} ve \sqrt{24/n} gibi büyük örneklem yaklaşımları değil, kesin formüllerdir. n=3'te SES tanımlıdır (1,2247), SEK n\ge4 ister; tanımsız olanlar "—" yazılır.
1.5.4 Ortalamanın güven aralığı
tcrit = scipy_stats.t.ppf(1 - alpha / 2, df=n - 1) (descriptive.py:390). \alpha formdaki güven düzeyinden gelir (stats_panel.py:4823–4843); özel düzey 80–99,9 arasında seçilebilir.
Neden z değil t?
\sigma bilinmediği için yerine s konur; (\bar x-\mu)/(s/\sqrt n) normallik altında tam olarak t_{n-1} dağılır (Student 1908). n=280'de t_{0{,}975;\,279}=1{,}9685 ile z_{0{,}975}=1{,}9600 arasındaki fark küçüktür; küçük n'de t belirgin biçimde daha geniş aralık verir. Normal olmayan dağılımda aralık merkezi limit teoremiyle yaklaşık geçerlidir.
1.5.5 Frekans tablosu ve histogram (Sturges)
- k: otomatik kutu sayısı (
_auto_bins,descriptive.py:280–287). - w: kutu genişliği; kenarlar
np.histogram(x, bins=k)ile en küçük ve en büyük değer arasında eşit aralıklıdır (descriptive.py:469). - Kutular [a, b) biçimindedir; son kutu [a, b] (en büyük değer içeride kalır,
descriptive.py:480).
Tutarsızlığa dikkat
Otomatik kutularda R ile yalnız kutu sayısı (nclass.Sturges) aynıdır. R hist() kenarları pretty() ile yuvarlak sayılara çeker: bu veride R 10, 15, …, 55 kenarlı 9 kutu (sayımlar 2, 25, 79, 92, 52, 18, 10, 1, 1) çizer; MerQur 13,89'dan başlayan 3,649 genişlikli 10 kutu kullanır. İki histogramın sayımları karşılaştırılamaz.
Etiketlerdeki ondalık, kutuları birbirinden ayıran en az ondalıktır (_bin_etiket_basamak, descriptive.py:290–299); bu yüzden kenarlar tabloda 13,9 – 17,5 gibi yuvarlanmış görünür. Yüzdeler bir ondalığa yuvarlanır; birikimli yüzde yuvarlanmamış yüzdelerin toplamından gelir.
1.5.6 Sağlam ölçüler
%5 kırpılmış ortalama (trimmed_mean, descriptive.py:657–662): her uçtan g=\lfloor 0{,}05\,n\rfloor gözlem atılır, kalanların ortalaması alınır. R mean(x, trim = 0.05) tanımıdır.
Huber M-kestiricisi (huber_m, descriptive.py:640–654):
- \tilde x: medyan; başlangıç \mu^{(0)}=\tilde x.
- \hat\sigma: ölçeklenmiş MAD; yineleme boyunca sabit tutulur.
- k=1{,}5: kırpma sabiti; \mu\pm1{,}5\hat\sigma dışındaki değerler sınıra çekilir (Winsorlaştırma).
- Durma: \left|\mu^{(t)}-\mu^{(t+1)}\right|<10^{-6}\hat\sigma.
Neden 1,4826 ve k=1{,}5?
1{,}4826=1/\Phi^{-1}(0{,}75); normal dağılımda MAD'ı \sigma'nın tutarlı kestiricisi yapar. k=1{,}5, normal dağılımda ortalamaya göre yaklaşık %95 etkinliği koruyup aykırı değerlerin etkisini sınırlayan yaygın seçimdir (Huber 1964). Ölçeğin sabit tutulması, R MASS::huber'in tanımıdır; konum ve ölçeği birlikte kestiren "Proposal 2" (MASS::hubers) değildir.
Koddaki tercih
Durma koşulu sağlandığında MerQur yeni değeri döndürür (descriptive.py:650–652: mu = mu1; break); MASS::huber bir önceki değeri döndürür. Fark durma toleransından küçüktür (<10^{-6}\hat\sigma): bu veride 27,030676 ile 27,030675. MAD = 0 ise MerQur medyanı sessizce döndürür; R hata verir.
1.5.7 CV, geometrik ve harmonik ortalama
CV ortalama 0 ise tanımsızdır ("—"). Geometrik ve harmonik ortalama yalnız tüm değerler pozitifken hesaplanır (descriptive.py:721–730). Pozitif verilerde \bar x_H\le\bar x_G\le\bar x eşitsizliği her zaman geçerlidir; aralarındaki fark sağa çarpıklığın bir işaretidir.
1.5.8 Uç değerler ve kutu grafiği aykırıları
En yüksek ve en düşük 5 değer kararlı sıralamayla (mergesort) seçilir ve satır numarasıyla yazılır. Aykırılar Tukey menteşeleriyle bulunur (descriptive.py:740–748):
- H_L, H_U: alt ve üst menteşe (R
fivenum); çeyreklere çok yakındır ama aynı değildir. - 1{,}5\,(H_U-H_L): Tukey'nin iç çit uzaklığı; R
boxplot.stats(coef = 1.5)tanımı.
Tutarsızlığa dikkat
Grafik sekmesindeki tek değişkenli kutu grafiği de aynı Tukey menteşeleriyle (R boxplot.stats) çizilir; metindeki aykırılar ile grafikteki noktalar bu yüzden aynıdır. Bu veride menteşeler 23,145 ve 31,21, tip 7 çeyrekleri 23,1525 ve 31,17'dir.
1.5.9 Gösterim: ondalık ve yuvarlama
Değerler TamSayi nesnesiyle tam saklanır, yalnız ekranda yuvarlanır (descriptive.py:417; core/tam_sayi.py). "Otomatik" ondalık şu kuralla seçilir (otomatik_ondalik, descriptive.py:245–254):
- s: SS. Konum ve yayılım alanları d ondalıkla yazılır; varyans kendi büyüklüğüyle, SH en az 3, çarpıklık ve basıklık 3 ondalıkla.
- BMI'de s=6{,}28, \lfloor\log_{10}s\rfloor=0, d=2.
Yuvarlama yarım yukarıdır (yuvarla, descriptive.py:206–223): Python round() ikili kayan noktada 52,775'i 52,77'ye indirir; MerQur değeri önce 15 anlamlı basamağa indirip ROUND_HALF_UP uygular ve 52,78 yazar. Ek satırlar en az 4 ondalıkla yazılır (descriptive.py:682–683).
1.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Aşağıdaki ara değerler dogrulama/descriptive/elle_hesap.py ile, MerQur kodu çağrılmadan numpy ile hesaplanmıştır.
Adım 1 — Toplam, ortalama, kareler toplamı.
Adım 2 — Varyans, SS, SH.
Adım 3 — Medyan ve çeyrekler. n=280 çift olduğundan medyan \left(x_{(140)}+x_{(141)}\right)/2=(26{,}51+26{,}53)/2=26{,}52.
Tip 6 ile h=(n+1)p: Q_1 için h=70{,}25, Q_1=23{,}13+0{,}25\times0{,}03=23{,}1375; Q_3=31{,}25.
Adım 4 — Momentler, çarpıklık, basıklık. m_2=39{,}341400, m_3=141{,}625472, m_4=5349{,}173377:
Çarpıklık belirgin ve sağa doğrudur (z=3{,}96>3{,}29); basıklık normalden ayırt edilemez.
Adım 5 — Güven aralıkları. t_{0{,}975;\,279}=1{,}968503; yarı genişlik 1{,}968503\times0{,}375511=0{,}739195:
%99 için t_{0{,}995;\,279}=2{,}593565, GA [26{,}353873;\ 28{,}301698].
Adım 6 — Frekans tablosu. \log_2 280=8{,}129; k=\lceil 9{,}129\rceil=10; w=(50{,}38-13{,}89)/10=3{,}649. Sayımlar: 13, 25, 63, 75, 41, 36, 14, 8, 4, 1 (toplam 280).
Adım 7 — Yüzdelikler (tip 7). P5: h=279\times0{,}05+1=14{,}95, x_{(14)}=17{,}79, x_{(15)}=18{,}11, P_5=17{,}79+0{,}95\times0{,}32=18{,}094. Aynı yolla P_{10}=20{,}169, P_{90}=35{,}162, P_{95}=38{,}372.
Adım 8 — Sağlam ölçüler. g=\lfloor 0{,}05\times280\rfloor=14; x_{(15)},\dots,x_{(266)} ortalaması 27{,}107460. Huber için \tilde x=26{,}52, medyan mutlak sapma 3{,}865, \hat\sigma=1{,}4826\times3{,}865=5{,}730249; sınırlar başlangıçta 26{,}52\pm8{,}595374.
| Yineleme t | 1 | 2 | 3 | … | 20 (durma) |
|---|---|---|---|---|---|
| \mu^{(t)} | 26,951288 | 27,017437 | 27,028454 | … | 27,030676 |
Sabit nokta 27,030676'dır. Ortalama (27,33) kırpılmış ortalamadan (27,11) ve Huber'den (27,03) büyüktür; sağ kuyruktaki yüksek BMI'ler ortalamayı yukarı çeker.
Adım 9 — CV ve diğer ortalamalar. \mathrm{CV}=100\times6{,}283503/27{,}327786=22{,}993\%; \bar x_G=26{,}623191; \bar x_H=25{,}923980; \bar x_H<\bar x_G<\bar x.
Adım 10 — Menteşeler ve aykırılar. n_4=\lfloor283/2\rfloor/2=70{,}5; H_L=(x_{(70)}+x_{(71)})/2=23{,}145, H_U=(x_{(210)}+x_{(211)})/2=31{,}21; çit uzaklığı 1{,}5\times8{,}065=12{,}0975. Üst çit 43{,}3075: 44,30, 44,70, 45,36 ve 50,38 aykırıdır; alt çit 11{,}0475'in altında değer yoktur.
Gruba göre (sex).
| female | male | |
|---|---|---|
| n | 147 | 133 |
| Ortalama / SS | 30,0937 / 6,4407 | 24,2707 / 4,4308 |
| Medyan | 29,65 | 24,18 |
| G_1 / G_2 | 0,270 / 0,160 | 0,306 / 1,138 |
| %95 GA | [29,0439; 31,1436] | [23,5107; 25,0307] |
| Aykırı | 1 (50,38) | 2 (13,89; 41,63) |
Grup içinde çarpıklık küçüktür (0,27 ve 0,31). Tüm örneklemdeki belirgin sağa çarpıklık (G_1=0{,}58), büyük ölçüde iki farklı merkezli dağılımın (kadınlarda ortalama yaklaşık 6 birim yüksek) üst üste binmesinden gelir. Betimsel istatistikte gruplara ayırmanın değeri buradadır.
1.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri DescriptiveStats.numeric_descriptives, numeric_frequency ve extended_descriptives çağrılarından, panelin kullandığı sırayla alınmıştır (dogrulama/descriptive/merqur_calistir.py). Betimsel analizde panel modülünde execute() yoktur; hesap stats_panel._show_desc_col içinden bu motor işlevleriyle yapılır. DescTable alanları TamSayi olduğundan değerler tam hassasiyetle okunur; round etkisizleştirmesi gerekmemiştir. R: 4.5.3; mean, sd, var, median, quantile(type = 7/6), e1071::skewness/kurtosis(type = 2), t.test()$conf.int, mean(trim = 0.05), MASS::huber, fivenum, boxplot.stats, nclass.Sturges. Ölçüt: en büyük fark \le10^{-6} (değer 1'den büyükse göreli).
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| n | 280 | 280 | 280 | 0,0e+00 | ✓ |
| Ortalama \bar x | 27,327786 | 27,327786 | 27,327786 | 1,8e−14 | ✓ |
| Medyan | 26,520000 | 26,520000 | 26,520000 | 3,6e−15 | ✓ |
| Mod | 26,240000 | 26,240000 | 26,240000 | 0,0e+00 | ✓ |
| SS s | 6,283503 | 6,283503 | 6,283503 | 8,9e−16 | ✓ |
| Varyans s^2 | 39,482409 | 39,482409 | 39,482409 | 4,3e−14 | ✓ |
| SH s/\sqrt n | 0,375511 | 0,375511 | 0,375511 | 0,0e+00 | ✓ |
| En küçük | 13,890000 | 13,890000 | 13,890000 | 0,0e+00 | ✓ |
| En büyük | 50,380000 | 50,380000 | 50,380000 | 0,0e+00 | ✓ |
| Açıklık | 36,490000 | 36,490000 | 36,490000 | 0,0e+00 | ✓ |
| Q1 (tip 7) | 23,152500 | 23,152500 | 23,152500 | 0,0e+00 | ✓ |
| Q3 (tip 7) | 31,170000 | 31,170000 | 31,170000 | 3,6e−15 | ✓ |
| IQR | 8,017500 | 8,017500 | 8,017500 | 1,8e−15 | ✓ |
| Çarpıklık G_1 | 0,577036 | 0,577036 | 0,577036 | 2,1e−15 | ✓ |
| Basıklık G_2 | 0,486095 | 0,486095 | 0,486095 | 2,0e−15 | ✓ |
| %95 GA alt | 26,588591 | 26,588591 | 26,588591 | 1,4e−13 | ✓ |
| %95 GA üst | 28,066981 | 28,066981 | 28,066981 | 2,1e−13 | ✓ |
| %99 GA alt | 26,353873 | 26,353873 | 26,353873 | 1,9e−12 | ✓ |
| %99 GA üst | 28,301698 | 28,301698 | 28,301698 | 1,9e−12 | ✓ |
| SES | 0,145609 | 0,145609 | 0,145609 | 5,6e−17 | ✓ |
| SEK | 0,290209 | 0,290209 | 0,290209 | 2,2e−16 | ✓ |
| P5 (tip 7) | 18,094000 | 18,094000 | 18,094000 | 0,0e+00 | ✓ |
| P95 (tip 7) | 38,372000 | 38,372000 | 38,372000 | 1,4e−14 | ✓ |
| P5 (tip 6) | 17,806000 | 17,806000 | 17,806000 | 0,0e+00 | ✓ |
| P95 (tip 6) | 39,308000 | 39,308000 | 39,308000 | 1,4e−14 | ✓ |
| Q1 (tip 6) | 23,137500 | 23,137500 | 23,137500 | 0,0e+00 | ✓ |
| Q3 (tip 6) | 31,250000 | 31,250000 | 31,250000 | 0,0e+00 | ✓ |
| %5 kırpılmış ortalama | 27,107460 | 27,107460 | 27,107460 | 1,4e−14 | ✓ |
| Huber M (k=1{,}5) | 27,030676 | 27,030676 | 27,030675 | 1,5e−06 | ✓ |
| CV (%) | 22,993092 | 22,993092 | 22,993092 | 2,5e−14 | ✓ |
| Geometrik ortalama | 26,623191 | 26,623191 | 26,623191 | 3,6e−14 | ✓ |
| Harmonik ortalama | 25,923980 | 25,923980 | 25,923980 | 3,6e−15 | ✓ |
| Toplam | 7651,780000 | 7651,780000 | 7651,780000 | 9,1e−13 | ✓ |
| Alt menteşe | 23,145000 | 23,145000 | 23,145000 | 0,0e+00 | ✓ |
| Üst menteşe | 31,210000 | 31,210000 | 31,210000 | 0,0e+00 | ✓ |
| Aykırı sayısı | 4 | 4 | 4 | 0,0e+00 | ✓ |
| Sturges kutu sayısı k | 10 | 10 | 10 | 0,0e+00 | ✓ |
| Ortalama (female) | 30,093741 | 30,093741 | 30,093741 | 3,9e−14 | ✓ |
| SS (female) | 6,440714 | 6,440714 | 6,440714 | 8,9e−16 | ✓ |
| Medyan (female) | 29,650000 | 29,650000 | 29,650000 | 0,0e+00 | ✓ |
| G_2 (female) | 0,159790 | 0,159790 | 0,159790 | 4,7e−16 | ✓ |
| %95 GA alt (female) | 29,043865 | 29,043865 | 29,043865 | 5,9e−12 | ✓ |
| Ortalama (male) | 24,270677 | 24,270677 | 24,270677 | 2,8e−14 | ✓ |
| SS (male) | 4,430841 | 4,430841 | 4,430841 | 1,8e−15 | ✓ |
| Medyan (male) | 24,180000 | 24,180000 | 24,180000 | 0,0e+00 | ✓ |
| G_2 (male) | 1,138300 | 1,138300 | 1,138300 | 6,7e−16 | ✓ |
| %95 GA alt (male) | 23,510686 | 23,510686 | 23,510686 | 7,1e−12 | ✓ |
Sonuç: 47 büyüklüğün tamamı ölçütü karşılar. Tek göze çarpan fark Huber M'dedir (1{,}5\times10^{-6} mutlak, 5\times10^{-8} göreli); nedeni 1.5.6'daki durma kuralı farkıdır. Python sütunu MerQur'un durma kuralıyla hesaplanmıştır; tam yakınsamış sabit nokta 27,0306765'tir.
1.7 Çıktıyı okuma
MerQur'un sonuç metni (BMI; ek çıktılar açık):
SÜTUN: BMI  [sayısal]
─────────────────────────────────────────────
n=280  Eksik=0
Ortalama=27.33  Medyan=26.52  Mod=26.24
SS=6.28  Varyans=39.48  Ort. std. hatası (SE)=0.376
Min=13.89  Maks=50.38  Açıklık=36.49
Q1=23.15  Q3=31.17  IQR=8.02
Çarpıklık=0.577  Basıklık=0.486
%95 GA=[26.59, 28.07]
Frekans/histogram kutu sayısı: 10 (otomatik, Sturges kuralı ⌈log₂ n + 1⌉)

Çarpıklık = 0.5770 (SE = 0.1456, z = 3.9629)  ·  Basıklık = 0.4861 (SE = 0.2902, z = 1.6750)
Yüzdelikler (tip 7):  P5=18.0940  P10=20.1690  P90=35.1620  P95=38.3720
%5 kırpılmış ortalama = 27.1075  ·  Huber M-kestirici (k = 1.5) = 27.0307 (ölçek MAD = 5.7302)
Değişim katsayısı (CV) = %22.9931  ·  Geometrik ort. = 26.6232  ·  Harmonik ort. = 25.9240  ·  Toplam = 7651.7800
En yüksek 5 değer (#satır:değer):  #10:50.3800, #212:45.3600, #111:44.7000, #45:44.3000, #253:43.1300
En düşük 5 değer (#satır:değer):  #17:13.8900, #90:14.2600, #176:15.0600, #73:15.4300, #5:15.6700
Kutu grafiği aykırıları (1.5 × menteşe aralığı): 4 adet 44.3000, 44.7000, 45.3600, 50.3800

── APA 7 ÖZET ──
M = 27.33, SD = 6.28, %95 GA [26.59, 28.07], Mdn = 26.52, n = 280
| Satır | Ne yazar | Nasıl yorumlanır |
|---|---|---|
n, Eksik |
Geçerli ve eksik gözlem sayısı | Eksik oranı yüksekse sonraki analizlerde örneklem küçülür. |
Ortalama, Medyan |
\bar x ve medyan | Ortalama > medyan sağa çarpıklığı gösterir (27,33 > 26,52). |
Mod |
En sık değer(ler) ya da "mod yok" | Sürekli ölçümde bilgi değeri düşüktür. |
SS, Varyans, SE |
s, s^2, s/\sqrt n | SS yayılımı, SE ortalamanın kesinliğini anlatır. |
Q1, Q3, IQR |
Tip 7 çeyrekler | Çarpık veride SS yerine IQR raporlanır. |
Çarpıklık, Basıklık |
G_1, G_2 (3 ondalık) | Kabaca \lvert G_1\rvert>1 belirgin asimetri; işaret ve büyüklük birlikte okunur. |
%95 GA |
Ortalamanın t aralığı | Hastaların değil, ortalamanın aralığıdır. |
Frekans/histogram kutu sayısı |
Sturges ya da kullanıcı k'si | Histogram şeklini kutu sayısı da etkiler. |
| SES/SEK satırı | z_{G_1}=3{,}96, z_{G_2}=1{,}68 | Çarpıklık anlamlı, basıklık değil. |
| Uç değerler | #satır:değer |
Satır numarası veri görünümündeki 1 tabanlı satır konumudur; veri girişini denetlemek için kullanılır. |
| APA satırı | M = …, SD = … |
Ondalık noktayla yazılır; Türkçe metne aktarırken virgüle çevirin. |
Gruba göre görünümde metin şöyledir (ek çıktılar kapalı; açıkken her grubun altına girintili ek satırlar gelir):
SÜTUN: BMI
Gruplama (Split-File): sex
──────────────────────────────────────────────────
  female: n=147 · Ortalama=30.09 · SS=6.44 · Medyan=29.65 · Min=14.26 · Maks=50.38
  male: n=133 · Ortalama=24.27 · SS=4.43 · Medyan=24.18 · Min=13.89 · Maks=41.63

Grup sayısı: 2  ·  Güven düzeyi: %95
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
280 hastanın BMI ortalaması 27,33 kg/m² (SS = 6,28; %95 GA [26,59; 28,07]), medyanı 26,52 kg/m² (çeyrekler arası aralık = 8,02) idi. Dağılım sağa çarpıktı (G_1 = 0{,}58; z = 3{,}96). Kadınlarda BMI (O = 30,09; SS = 6,44; n = 147) erkeklere göre (O = 24,27; SS = 4,43; n = 133) daha yüksekti. Tukey ölçütüne göre dört hastada BMI üst çitin (43,31 kg/m²) üzerindeydi.
1.8 Uzman soruları
S1. Çarpıklık ve basıklık hangi tanımla? R'de farklı sayı çıkıyor.
MerQur G_1 ve G_2'yi verir (pandas skew/kurtosis; descriptive.py:434–435). Bu, R e1071::skewness(x, type = 2) ile aynıdır. R'de psych::describe ve e1071'in varsayılanı tip 3'tür; bu veride 0,571/0,431 verir. moments::skewness tip 1'dir (g_1=0{,}574; basıklığı fazlalık olmadan b_2 olarak verir). Raporda tanım belirtilmelidir.
S2. Çeyrekler neden bazı programlardan farklı çıkar?
Bazı yaygın istatistik programlarının varsayılanı tip 6'dır (h=(n+1)p); MerQur'un ana tablosu tip 7'dir (h=(n-1)p+1; R ve pandas varsayılanı). Bu veride Q1: 23,1525 (tip 7) ve 23,1375 (tip 6). "Yüzdelik tanımı: Tip 6" seçilirse ana tablo da, ek satır da tip 6 değerlerini verir.
S3. Otomatik histogram R `hist()` ile neden aynı görünmüyor?
Kutu sayısı aynıdır (Sturges, 10). R hist() kenarları pretty() ile 5'in katlarına çeker ve bu veride 9 kutu çizer; MerQur en küçük ile en büyük arasını 10 eşit parçaya böler (descriptive.py:469). Kutu sayısı aynı, kenarlar farklıdır.
S4. Huber M neden `MASS::huber` ile altıncı basamakta ayrışıyor?
İki uygulama aynı yinelemeyi yapar; durma anında MerQur son hesaplanan değeri, R bir öncekini döndürür (descriptive.py:650–652). Fark 10^{-6}\hat\sigma'dan küçüktür (bu veride 1{,}5\times10^{-6}). Ölçek MAD'dır ve sabit tutulur; konum ile ölçeği birlikte kestiren MASS::hubers değildir. MAD = 0 olduğunda R hata verir, MerQur medyanı döndürür.
S5. n=1 ya da sabit sütunda ne olur?
n<2'de bütün sayısal alanlar boş gelir (descriptive.py:375–384). Sabit sütunda s=0, SH = 0 alınır ve GA [\bar x,\bar x] olarak yazılır (:389); panel GA'nın tek noktaya indiğini uyarıyla bildirir. Çarpıklık ve basıklık pandas tanımıyla 0 döner. Bu durumda GA'yı raporlamak anlamsızdır.
S6. Ortalamanın GA'sı normal olmayan veride geçerli mi?
Aralık t dağılımına dayanır; normallik altında kesindir. Bu verideki çarpıklık (G_1=0{,}58) n=280'de merkezi limit teoremiyle büyük ölçüde telafi edilir. Küçük n ve güçlü çarpıklıkta Bootstrap GA (yüzdelik ya da BCa) ya da log dönüşümünden sonra geometrik ortalamanın GA'sı önerilir.
S7. Kutu grafiği neden çeyrekler yerine Tukey menteşelerini kullanır?
Aykırı satırı ile grafikteki noktaların aynı kuralla bulunması gerekir. Metin Tukey menteşelerini (R fivenum) kullanır (descriptive.py:740–748); tek değişkenli kutu grafiği de aynı menteşelerle (R boxplot.stats) çizilir. Tip 7 çeyreklerle (bu veride 23,1525 ve 31,17) menteşeler (23,145 ve 31,21) küçük farklılık gösterir; sınırdaki bir değer bir kurala göre aykırı, ötekine göre bıyığın içinde kalabilir. Ortak kural bu çelişkiyi önler.
S8. "Ondalık basamak" seçimi hesapları etkiler mi?
Hayır. Değerler TamSayi ile tam saklanır (descriptive.py:417); yalnız ekran ve APA satırı seçilen basamakta, yarım yukarı yuvarlanarak yazılır (yuvarla, :206–223). Otomatik kural SS'nin büyüklüğüne bakar; çok küçük ölçekli değişkenlerde (SS = 0,0004) 6 ondalığa kadar çıkar.
S9. Gruba göre görünümde ek seçenekler uygulanıyor mu?
Evet; SES/SEK, sağlam ölçüler, CV, uç değerler ve yüzdelikler her grup için ayrı satırlar hâlinde yazılır (stats_panel.py:3705–3713). Grup değişkeninde eksik değeri olan satırlar hiçbir gruba girmez; sayıları sonuç metninde ayrıca yazılır.
1.9 Sık hatalar ve tuzaklar
- SH'yi SS yerine raporlamak. SH = 0,376, SS = 6,28'dir; "BMI 27,33 ± 0,38" yazmak dağılımı 17 kat dar gösterir.
- Ortalamanın GA'sını referans aralığı sanmak. [26,59; 28,07] hastaların değil, evren ortalamasının aralığıdır. Hastaların %95'ini kapsayan aralık için Tolerans Aralıkları kullanılır (Bölüm 2).
- Çarpık veride yalnız ortalama ± SS vermek. Medyan ve IQR (ya da çeyrekler) birlikte verilmelidir.
- Yüzdelik tanımını rapora yazmamak. Q1/Q3 seçilen tipe göre değişir; başka bir programla karşılaştırırken tip belirtilmelidir.
- Histogramı R'deki ile karşılaştırmak. Kenarlar farklıdır; sayımlar karşılaştırılamaz.
- Grup karışımını tek dağılım sanmak. BMI'deki çarpıklığın büyük kısmı cinsiyet farkından gelir; "Gruba göre" seçeneğiyle bakılmalıdır.
- Mod'u sürekli ölçümde yorumlamak. 263 farklı değer arasında 3 kez görülen değer anlamlı bir "tipik değer" değildir.
- APA satırını olduğu gibi Türkçe metne almak. MerQur APA satırını ondalık noktayla yazar.
- Uç değer satır numarasını hesap tablosu satırı sanmak.
#10veri görünümündeki 1 tabanlı satır konumudur; hesap tablosu programında başlık satırı nedeniyle 11. satırdır.
1.10 Kaynaklar
- Huber, P. J. (1964). Robust estimation of a location parameter. The Annals of Mathematical Statistics, 35(1), 73–101. https://doi.org/10.1214/aoms/1177703732
- Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361–365. https://doi.org/10.1080/00031305.1996.10473566
- Joanes, D. N., & Gill, C. A. (1998). Comparing measures of sample skewness and kurtosis. Journal of the Royal Statistical Society: Series D (The Statistician), 47(1), 183–189. https://doi.org/10.1111/1467-9884.00122
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Sturges, H. A. (1926). The choice of a class interval. Journal of the American Statistical Association, 21(153), 65–66. https://doi.org/10.1080/01621459.1926.10502161
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.