106. Kantil Regresyon
Analiz kimliği: quantile · Menü adı: Kantil Regresyon (Quantile Regression) · Panel: gui/panels/analyses/quantile_regression_panel.py · Motor: stats/quantile_regression.py, run_quantile (satır 86–339), _refit_exact_vertex (369–434) ve stats/quantile_inference.py (kesin LP, nid/ker/boot SH, eğim eşitliği testi)
106.1 Ne işe yarar
Kantil regresyon, yanıtın koşullu ortalamasını değil, koşullu kantilini (ör. medyan, alt %10, üst %90) modeller. Cevapladığı soru şudur: "Yatış süresi bir gün uzadığında, en pahalı %10'luk dilimdeki hastaların maliyeti ne kadar artar? Bu artış ucuz dilimdekiyle aynı mı?" Sıradan en küçük kareler (OLS) tek bir sayı verir; kantil regresyon dağılımın farklı noktalarında ayrı eğimler verir.
- Q_\tau(y\mid\mathbf x): \mathbf x verildiğinde y'nin \tau. kantili; \tau=0{,}5 koşullu medyandır.
- \boldsymbol\beta(\tau): her \tau için ayrı kestirilen katsayılar. \beta_j(\tau): diğer açıklayıcılar sabitken x_j'deki bir birimlik artışın y'nin \tau. koşullu kantilinde yarattığı değişim.
- \mathbf x_i=(1,x_{i1},\dots,x_{ip})^{\top}.
Ne zaman kullanılır? Etkinin dağılımın farklı kesimlerinde farklı olduğu düşünülüyorsa (değişen varyans, çarpık yanıt); aykırı y değerlerine OLS'den daha az duyarlı bir medyan modeli isteniyorsa; uç kesimler (yüksek maliyetli hastalar, düşük doğum ağırlıklı bebekler) asıl ilgi konusuysa.
Ne zaman kullanılmaz?
- Yalnız ortalama etki isteniyor ve varsayımlar sağlanıyorsa: Çoklu Doğrusal Regresyon daha verimlidir.
- Aykırılık açıklayıcılarda (kaldıraç) ise: kantil regresyon kaldıraç noktalarına karşı sağlam değildir; Sağlam Regresyon (MM).
- Yanıt ikili ya da sayım ise: İkili Lojistik Regresyon, Sayım Regresyonu.
- Gözlemler kümeli ya da tekrarlı ölçümse: bu modülde küme düzeltmesi yoktur; Doğrusal Karma Model ya da küme bootstrap gerekir.
- Sansürlü yanıt varsa: Tobit Regresyon ya da sağkalım modelleri.
Sık karıştırılan analizler. "Yanıtı kantillere bölüp her grupta ayrı OLS kurmak" kantil regresyon değildir; seçim yanıta göre yapıldığı için yanlıdır. Kantil regresyon tüm gözlemleri kullanır, yalnız ağırlıklarını (kontrol fonksiyonuyla) \tau'ya göre değiştirir. Sağlam regresyon ortalamayı aykırılara karşı korur; kantil regresyon dağılımın farklı noktalarını hedefler.
106.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Kantilde doğrusallık | Q_\tau(y\mid\mathbf x), \mathbf x'in doğrusal fonksiyonu. | "Uyum grafiği" ile görsel. |
| Bağımsız gözlemler | Kümelenme yok. | Denetlenmez. |
| Tam ranklı tasarım | Sabit ya da eşdoğrusal açıklayıcı yok. | Rank eksikse hata (quantile_regression.py:142–143). |
| Yeterli n | Asimptotik SH için. | n<p+2 hata (111–114); n<15 uyarı (116–117). |
| Hata dağılımı | Normallik ve sabit varyans gerekmez. | — |
Eksik değer. Hedef ve açıklayıcılarda eksik ya da sayıya çevrilemeyen değeri olan satır çıkarılır (107). Metin sütunları önce kukla değişkenlere açılır (ilk düzey referans, _encode_categoricals, panel 177–178).
Uç durumlar (koddan). y sabitse her kantilde kesişim =y, eğimler 0 yazılır; SH, p, GA ve sözde R^2 tanımsızdır ("—") (129, 148–158, 244–256). Sandviç SH sayısal olarak tanımsızsa not yazılır (290–295). Kantil girişi 0<\tau<1 dışındaysa ya da sayı değilse atlanır ve uyarılır; geçerli kantil kalmazsa 0,25, 0,50, 0,75 kullanılır (parse_quantiles, panel 135–156). Kesin LP çözümünün tek olmadığı saptanırsa uyarı yazılır (175–183; 106.5.7).
106.3 Parametreler
Varsayılanlar add_form_rows (quantile_regression_panel.py:45–114), read_options (117–126) ve stats_panel._run_quantile'dan alınmıştır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımlı değişken | ilk sayısal sütun | Sürekli y. | — |
| Kantiller (CSV) | 0.25, 0.50, 0.75 | Virgülle ayrılmış \tau listesi. | Her \tau için ayrı model. |
| Bağımsız değişkenler | en az 1 | Sayısal ya da kategorik. | Kategorikler kukla kodlanır. |
| SE / GA yöntemi | Sağlam çekirdek (varsayılan) | Sağlam çekirdek; nid (Hendricks–Koenker); ker (Powell); boot (xy bootstrap, B=200, tohum 42). | Yalnız SH, p, GA; katsayılar aynı. |
| Kantiller arası eğim eşitliği testi (Wald) | kapalı | Koenker–Bassett Wald testi. | Ek bölüm. |
| Grafik | Katsayı eğrileri (varsayılan) | Katsayı eğrileri, kantil süreci + GA bantları (\tau=0{,}05\dots0{,}95), uyum grafiği, 3B kantil düzlemleri. | "Kantil süreci" seçilirse metne 19 \tau'lu tablo eklenir. |
| Kantil tahminlerini ve artıkları veri setine kaydet | kapalı | QR_PRED_qXX, QR_RESID_qXX. |
Yeni sütunlar. |
| Güven Düzeyi | %95 | GA için \alpha. | GA genişliği; katsayı matrisindeki * her zaman p<0{,}05'tir. |
SH yöntemi neden katsayıyı değiştirmez?
Katsayılar her yöntemde aynı doğrusal programlama çözümüdür (106.5.2). SH yöntemleri yalnız \boldsymbol\beta(\tau)'nın örnekleme dağılımını farklı varsayımlarla kestirir: "sağlam" ve "ker" hata yoğunluğunu artıklardan çekirdekle, "nid" komşu kantillerin farkından, "boot" yeniden örneklemeyle. Asimptotik varyans hatanın kantildeki yoğunluğuna (f(Q_\tau)) bağlıdır; bu yoğunluk doğrudan gözlenmediği için yöntemler arasında SH farkı büyük olabilir (bu örnekte yaş eğiminin SH'si \tau=0{,}1'de 28,3 ile 50,6 arasında).
106.4 Tıp örneği
Dosya: english/datasets/Tip/59_quantile_hastane_cost.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/59_quantile_hastane_masraf.xlsx). Değişkenler ve kantiller VIDEO_SCRIPT_TR.txt #59'dan alınmıştır.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
total_cost_TL |
Bağımlı | sürekli (TL) | ort. 16385,6; SS 5863,4; medyan 16022,5; 1000–41431 |
age |
Açıklayıcı | sürekli (yıl) | ort. 54,08; SS 18,64; 20–84 |
admission_day |
Açıklayıcı | tam sayı (gün) | ort. 4,98; SS 2,04; 1–12 |
n ve eksik değer: 200 hasta, eksik değer yok. Maliyetin örneklem kantilleri (R tür 7): %10 = 9851,6; %50 = 16022,5; %90 = 23803,9 TL.
Klinik soru: Yaş ve yatış günü, ucuz (alt %10), tipik (medyan) ve pahalı (üst %90) hastalarda maliyeti aynı biçimde mi etkiliyor?
Seçilen ayarlar: Kantiller 0.10, 0.50, 0.90 (video senaryosu; arayüz varsayılanı 0.25, 0.50, 0.75); SH yöntemi varsayılan (sağlam çekirdek); %95 güven. Hesap yürüyüşü için eğim eşitliği testi açılmış; nid, ker ve boot ile ek çalıştırmalar yapılmıştır.
106.5 Formüller ve hesap adımları
MerQur her \tau için: (1) statsmodels QuantReg ile yinelemeli yeniden ağırlıklı en küçük karelerle (IRLS) bir başlangıç çözümü bulur; (2) kontrol fonksiyonunu doğrusal programlamayla kesin çözer (scipy HiGHS dual simpleks) ve amaç değeri kötüleşmiyorsa bu köşe çözümünü alır; (3) köşe gözlemlerinin artıklarını tam sıfır sayar; (4) seçilen yönteme göre kovaryansı hesaplar; (5) sözde R^2'yi ve karşılaştırma için OLS'yi ekler; (6) istenirse kantiller arası eğim eşitliğini sınar.
106.5.1 Kontrol fonksiyonu
- \rho_\tau: "kontrol" (check) fonksiyonu; pozitif artıklara \tau, negatif artıklara 1-\tau ağırlık verir.
- \tau=0{,}5'te \rho_{0{,}5}(u)=|u|/2: en küçük mutlak sapma (medyan) regresyonu.
- V(\tau)=\sum\rho_\tau(\hat e_i): en küçüklenen amaç değeri.
Neden bu fonksiyon kantili verir?
Tek bir sabit q için \sum\rho_\tau(y_i-q)'nun alt türevi -\tau\,\#\{y_i>q\}+(1-\tau)\,\#\{y_i<q\}'dur; sıfır, gözlemlerin \tau oranı q'nun altında kalınca olur. Yani en küçükleyen q, örneklem \tau-kantilidir (Koenker ve Bassett 1978). Açıklayıcı eklenince aynı mantık koşullu kantile genellenir: kestirimde kabaca n\tau gözlem doğrunun altında, n(1-\tau) üstünde kalır.
106.5.2 Kesin çözüm: doğrusal programlama
Artık pozitif ve negatif parçalara ayrılır, e_i=u_i-v_i, u_i,v_i\ge0:
Çözüm bir köşe noktasıdır: p gözlemden tam geçer (bu gözlemlerin artığı sıfırdır) ve
koşulu sağlanır (Koenker 2005, 2. bölüm).
Koddaki tercih: IRLS başlangıcı, kesin LP köşesi, sıfır artıklar
statsmodels QuantReg.fit(q, max_iter=2000) IRLS ile yaklaşık çözüm verir (160–161). Sonra rq_lp (quantile_inference.py:26–38) aynı problemi HiGHS dual simpleksle (method="highs-ds") kesin çözer; _refit_exact_vertex (quantile_regression.py:349–414) kesin çözümün amaç değeri IRLS'ninkinden kötü değilse onu alır ve en küçük |e|'li p gözlemin artığını tam 0 yapar. Gerekçe: IRLS köşe gözlemlerinde \pm10^{-7} düzeyinde rastgele işaretli artık bırakır; sağlam SH'deki ağırlık sıfırda süreksizdir (106.5.4) ve \tau=0{,}9'da 81 kat sıçrayabilir. Katsayılar böylece R quantreg::rq(method = "br") (Barrodale–Roberts simpleksi) ile aynı köşeye gelir.
106.5.3 Hall–Sheather bant genişliği
Tüm yoğunluk tabanlı SH'ler aynı olasılık ölçeğinde bant genişliğiyle başlar (Hall ve Sheather 1988):
- \phi, \Phi: standart normal yoğunluk ve dağılım fonksiyonu; z_{0{,}975}=1{,}959964.
- h_n olasılık ölçeğindedir; y ölçeğine \Phi^{-1}(\tau+h_n)-\Phi^{-1}(\tau-h_n) çarpanı ve bir ölçek kestirimiyle taşınır.
- Buradaki \alpha her zaman 0,05'tir; arayüzdeki güven düzeyinden etkilenmez.
106.5.4 Varsayılan SH: "sağlam çekirdek" (statsmodels robust)
- \hat\sigma_y: yanıtın standart sapması, n'ye bölünerek (\sqrt{\sum(y_i-\bar y)^2/n}).
- IQR: artıkların çeyrekler açıklığı (doğrusal ara değerli, R tür 7).
- \hat f: artıkların sıfırdaki yoğunluğunun Epanechnikov çekirdekli kestirimi (tüm gözlemler için tek bir sayı); 1/\hat f "seyreklik"tir.
- d_i: ağırlık; beklenen değeri \tau(1-\tau)/f^2'dir, yani homojen hatada klasik \tau(1-\tau)\,s^2(\mathbf X^{\top}\mathbf X)^{-1} formülüne iner. Pozitif ve negatif artıklara farklı ağırlık vermesi, sandviçi değişen varyansa karşı biraz sağlamlaştırır.
- Testler: t=\hat\beta_j/\SH_j, p ve GA t_{n-p} dağılımından.
Koddaki tercih: statsmodels tanımı, quantreg'de karşılığı yok
Bu formül statsmodels 0.14 QuantReg(vcov="robust", kernel="epa", bandwidth="hsheather") tanımıdır ve quantile_regression.py:418–426'da yeniden yazılmıştır. R quantreg'de birebir karşılığı yoktur: summary.rq(se = "ker") Gauss çekirdeği, artıkların n-1'e bölünmüş SS'si ve gözlem başına yoğunluk kullanır. Ölçek olarak yanıtın SS'sini almak statsmodels'in tercihidir; bu örnekte \min işlemi IQR tarafını seçtiği için etkisi yoktur. R summary.rq'nun kendi varsayılanı n<1001 için se = "rank"'tır (rank-skor testinin tersine çevrilmesiyle GA; SH vermez); MerQur'un varsayılan GA'ları bu nedenle R'nin varsayılan çıktısıyla aynı değildir. Bu kılavuzda başvuru değeri formül R'de elle yazılarak hesaplanmıştır.
106.5.5 nid, ker ve boot
nid (Hendricks ve Koenker 1992; özdeş olmayan dağılım): her gözlemin yoğunluğu komşu iki kantil doğrusunun uzaklığından kestirilir.
- \varepsilon=\epsilon_{\text{mak}}^{2/3}\approx3{,}7\times10^{-11}: sıfıra bölmeyi önleyen küçük sayı (quantreg ile aynı).
- \tau\pm h_n (0,\,1) dışına taşarsa h_n yarıya bölünür (
quantile_inference.py:79–83).
ker (Powell 1991): h=\big[\Phi^{-1}(\tau+h_n)-\Phi^{-1}(\tau-h_n)\big]\min\big(s_{\hat e},\ \text{IQR}(\hat{\mathbf e})/1{,}34\big), \hat f_i=\phi(\hat e_i/h)/h; s_{\hat e} artıkların n-1'e bölünmüş SS'si; aynı sandviç.
boot: B=200 xy-çift bootstrap; her örneklemde kesin LP; \widehat{\operatorname{Var}} = bootstrap katsayılarının örneklem kovaryansı (n-1). Tohum (seed) değeri 42'dir ve her \tau için aynı indis kümeleri kullanılır (vcov_rq, quantile_inference.py:118–125).
nid, ker ve boot'ta katsayılar doğrudan kesin LP'den alınır; p ve GA t_{n-p} ile hesaplanır (216–239). Tanımlar R summary.rq(se = "nid" | "ker") ile aynıdır.
106.5.6 Sözde R^2
- \tilde V: yalnız sabitli modelin amaç değeri; R^1, R^2'nin kontrol fonksiyonu karşılığıdır (Koenker ve Machado 1999). Yereldir: yalnız \tau kantilindeki uyumu ölçer.
- \tilde q_\tau: yalnız sabitli kantil regresyonun LP çözümü, yani y'nin LP kantili (R
rq(y ~ 1)); \tilde V bu çözümdeki en küçük amaç değeridir (Koenker ve Machado 1999).
Neden ara değerli kantil değil, LP çözümü?
Koenker–Machado tanımında \tilde V, sabitli modelin amaç fonksiyonunun en küçük değeridir. Doğrusal ara değerli bir örneklem kantili (R tür 7) bu en küçükleyen aralığın dışına düşebilir; o zaman \tilde V olması gerekenden büyük, R^1 biraz yüksek çıkar. n\tau tam sayı olduğunda (bu örnekte n=200 ve \tau=0{,}1,\,0{,}5,\,0{,}9) iki yol aynı sonucu verir; ilk 197 hastayla \tau=0{,}1'de LP tanımı (MerQur) 0,171388, ara değerli kantil 0,171468 verir. R quantreg LP tanımını kullanır.
106.5.7 Tek olmayan çözüm uyarısı
LP çözümü bazen tek değildir (en iyi çözümler kümesi bir kenar ya da yüzdür); tipik nedeni bağlı ya da kesikli y ve ikili açıklayıcılardır. MerQur bunu sınamak için amaç değerini en iyi değerde tutup rastgele (tohumu 20241107) bir yönde \boldsymbol\beta'yı en büyükler ve en küçükler; iki uç farklıysa "çözüm tekil değil" uyarısı yazar (rq_nonunique, quantile_inference.py:41–69).
Neden göreli pay?
Amaç değerine izin verilen pay yalnız amaç değerine görelidir (V\cdot10^{-12}); karşılaştırma eşiği 10^{-6}\max(1,|\beta_j|)'dir. Mutlak bir pay (ör. 10^{-10}\max|y|) katsayının ölçeğine bağlı yanlış alarm üretir: bu örnekte \tau=0{,}5'te yaş katsayısı (18{,}64) böyle bir pay içinde 2{,}3\times10^{-5} oynar, pay 10^{-13}V'ye indirildiğinde oynama 2\times10^{-8}'e düşer; yani oynama paya orantılıdır ve çözüm tektir. Göreli payla MerQur bu veride uyarı vermez; R rq(method = "br") da vermez. İkili ya da kesikli veride gerçek tek olmama durumu yine yakalanır.
106.5.8 Kantiller arası eğim eşitliği (Koenker–Bassett Wald)
m kantil için katsayılar alt alta yazılır, \hat{\boldsymbol\beta}=(\hat{\boldsymbol\beta}(\tau_1)^{\top},\dots,\hat{\boldsymbol\beta}(\tau_m)^{\top})^{\top}; ortak asimptotik kovaryans
- \mathbf H_k: \tau_k'daki nid yoğunluklarıyla (SH yöntemi ker ise Powell yoğunluklarıyla) \mathbf X^{\top}\operatorname{diag}(\hat f)\mathbf X.
- \mathbf D: ardışık kantillerdeki eğim farklarını seçen q\times mp kontrast matrisi; ortak testte q=(m-1)(p-1), tek eğimde q=m-1.
- Payda sd'si nm-q: R
anova.rqlistile aynı.
Koddaki tercih: varsayılan SH "sağlam" iken test nid ile
Eşitlik testi "sağlam" SH'nin kovaryansını kullanmaz; çapraz kantil kovaryansı gerektiği için nid yoğunluklarıyla kurulur (başlıkta "nid" yazar). SH yöntemi "ker" ise test de Powell yoğunluklarıyla yapılır; "boot" seçiliyse test yine nid'dir ve ayar bloğuna kaydedilir (_equality, quantile_regression.py:342–362).
106.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/quantile/elle_hesap.py ile, MerQur çağrılmadan (kesin LP scipy linprog(method="highs"), SH formülleri numpy) hesaplanmıştır.
Adım 1 — LP çözümleri.
| \tau | Sabit | age | admission_day | V(\tau) | \hat e>0 / <0 / =0 |
|---|---|---|---|---|---|
| 0,10 | 2450,000000 | −30,250000 | 2069,750000 | 163057,45 | 179 / 18 / 3 |
| 0,50 | 6302,363636 | 18,636364 | 1831,454545 | 330503,73 | 98 / 99 / 3 |
| 0,90 | 7620,142857 | 97,714286 | 1751,714286 | 148838,26 | 19 / 178 / 3 |
| OLS | 5727,702250 | 23,270823 | 1887,436075 | — | — |
Köşe koşulu: \tau=0{,}1'de 18\le n\tau=20\le21; \tau=0{,}9'da 178\le180\le181. Her çözümde tam üç gözlemin (p=3) artığı sıfırdır.
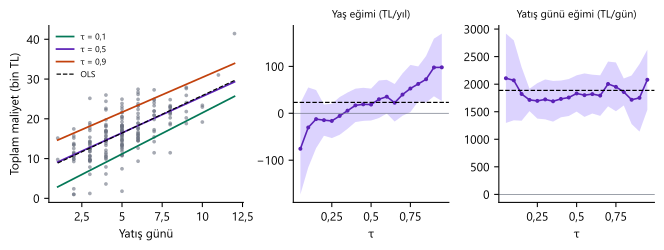
Yatış günü eğimi kantiller boyunca 2070'ten 1752'ye hafifçe azalır; yaş eğimi ise −30'dan +98'e çıkar: yaş ucuz hastalarda maliyeti artırmıyor, pahalı hastalarda her yıl yaklaşık 98 TL ekliyor. OLS (23,3 TL/yıl) bu farkı tek bir ortalamada gizler.
Adım 2 — Sözde R^2. \tau=0{,}5: tür 7 medyanı \tilde q=16022{,}5; \tilde V=453909{,}0.
\tau=0{,}1: \tilde V=195661{,}4, R^1=0{,}166635; \tau=0{,}9: \tilde V=205435{,}6, R^1=0{,}275499. LP kantilleri (9862 ve 23799) tür 7 kantillerinden (9851,6 ve 23803,9) farklıdır ama aynı en küçükleyen aralıkta kaldıkları için \tilde V aynıdır.
Adım 3 — Sağlam SH, \tau=0{,}5.
Medyanda \tau=1-\tau olduğundan tüm d_i eşittir ve sandviç \big(0{,}5/\hat f\big)^2(\mathbf X^{\top}\mathbf X)^{-1}'e iner:
GA: 18{,}636364\pm1{,}972079\times19{,}948567=[-20{,}7038;\ 57{,}9765] (t_{197;\,0{,}975}=1{,}972079).
Adım 4 — SH yöntemlerinin karşılaştırması (yaş eğimi).
| \tau | Sağlam | nid | ker | boot | p (sağlam) |
|---|---|---|---|---|---|
| 0,10 | 28,396643 | 43,283372 | 28,301207 | 50,611399 | 0,288059 |
| 0,50 | 19,948567 | 17,253993 | 25,165267 | 13,082161 | 0,351334 |
| 0,90 | 23,842205 | 31,176743 | 23,844634 | 28,480780 | 6,08·10⁻⁵ |
Uç kantillerde yöntemler arası fark büyüktür; yoğunluk orada az gözlemle kestirilir. Üst %90'da yaş etkisi her yöntemde anlamlıdır (p<0{,}003).
Adım 5 — Eğim eşitliği (nid). Ortak test (q=4): W=9{,}063491, F=2{,}265873, F_{4,\,596} altında p=0{,}060842. Tek tek: yaş F_{2,\,598}=4{,}195787, p=0{,}015505; yatış günü F=0{,}271778, p=0{,}762118. Yaş etkisi kantiller arasında farklıdır; yatış günü etkisi değildir. Powell yoğunluklarıyla ortak test F=3{,}988588 (p=0{,}0033) verir; testin sonucu yoğunluk kestirimine duyarlıdır.
Adım 6 — Tek hasta. 1 numaralı hasta (63 yaş, 6 gün, gerçek maliyet 18872 TL):
Hastanın maliyeti koşullu medyanın biraz üstünde, %90 kantilinin altındadır.
Şekil 106.1. Sol: yatış günü–maliyet serpmesi ve yaş ortalamada (54,1) iken \tau=0{,}1,\ 0{,}5,\ 0{,}9 kantil doğruları; kesikli çizgi OLS. Orta ve sağ: kantil süreci, \tau=0{,}05\dots0{,}95'te LP katsayısı ve nid tabanlı %95 GA bandı; kesikli yatay çizgi OLS katsayısı.
106.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundaki results sözlüğünden (yuvarlanmamış) alınmıştır. R: 4.5.3, quantreg 6.1: rq(method = "br"), summary.rq(se = "nid" | "ker"), anova(…, se = "nid" | "ker", joint = TRUE | FALSE), sözde R^2 için rq(y ~ 1); MerQur'un varsayılan "sağlam" SH'si R'de 106.5.4 formülüyle yazılmıştır. Bootstrap'ta MerQur'un default_rng(42) indisleri dosyaya yazılıp R'de rq.fit(br) ile aynı 200 örneklem çözülmüştür.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| τ = 0,1: b (sabit) | 2450,000000 | 2450,000000 | 2450 | 4,5e−13 | ✓ |
| τ = 0,1: b (age) | −30,250000 | −30,250000 | −30,250000 | 9,9e−14 | ✓ |
| τ = 0,1: b (admission_day) | 2069,750000 | 2069,750000 | 2069,750000 | 0,0e+00 | ✓ |
| τ = 0,1: sözde R^2 | 0,166635 | 0,166635 | 0,166635 | 3,9e−16 | ✓ |
| τ = 0,1: sağlam SH (age) | 28,396643 | 28,396643 | 28,396643 | 3,3e−12 | ✓ |
| τ = 0,1: sağlam SH (admission_day) | 277,691316 | 277,691316 | 277,691316 | 5,6e−12 | ✓ |
| τ = 0,1: sağlam p (age, t_{197}) | 0,288059 | 0,288059 | 0,288059 | 5,6e−14 | ✓ |
| τ = 0,1: %95 GA alt (age) | −86,250424 | −86,250424 | −86,250424 | 6,9e−11 | ✓ |
| τ = 0,5: b (sabit) | 6302,363636 | 6302,363636 | 6302,363636 | 4,5e−12 | ✓ |
| τ = 0,5: b (age) | 18,636364 | 18,636364 | 18,636364 | 2,6e−13 | ✓ |
| τ = 0,5: b (admission_day) | 1831,454545 | 1831,454545 | 1831,454545 | 4,5e−12 | ✓ |
| τ = 0,5: sözde R^2 | 0,271872 | 0,271872 | 0,271872 | 3,9e−16 | ✓ |
| τ = 0,5: sağlam SH (age) | 19,948567 | 19,948567 | 19,948567 | 1,8e−12 | ✓ |
| τ = 0,5: sağlam SH (admission_day) | 182,110879 | 182,110879 | 182,110879 | 2,0e−12 | ✓ |
| τ = 0,5: sağlam p (age, t_{197}) | 0,351334 | 0,351334 | 0,351334 | 4,4e−14 | ✓ |
| τ = 0,5: %95 GA alt (age) | −20,703786 | −20,703786 | −20,703786 | 5,0e−11 | ✓ |
| τ = 0,9: b (sabit) | 7620,142857 | 7620,142857 | 7620,142857 | 5,5e−12 | ✓ |
| τ = 0,9: b (age) | 97,714286 | 97,714286 | 97,714286 | 0,0e+00 | ✓ |
| τ = 0,9: b (admission_day) | 1751,714286 | 1751,714286 | 1751,714286 | 3,6e−12 | ✓ |
| τ = 0,9: sözde R^2 | 0,275499 | 0,275499 | 0,275499 | 1,1e−16 | ✓ |
| τ = 0,9: sağlam SH (age) | 23,842205 | 23,842205 | 23,842205 | 2,3e−12 | ✓ |
| τ = 0,9: sağlam SH (admission_day) | 228,628210 | 228,628210 | 228,628210 | 6,8e−12 | ✓ |
| τ = 0,9: sağlam p (age, t_{197}) | 6,0777·10−5 | 6,0777·10−5 | 6,0777·10−5 | 9,6e−17 | ✓ |
| τ = 0,9: %95 GA alt (age) | 50,695574 | 50,695574 | 50,695574 | 5,9e−11 | ✓ |
| OLS b (admission_day) | 1887,436075 | 1887,436075 | 1887,436075 | 1,4e−12 | ✓ |
nid, ker, boot ve eğim eşitliği testi:
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| τ = 0,1: nid SH (age) | 43,283372 | 43,283372 | 43,283372 | 1,5e−10 | ✓ |
| τ = 0,1: nid p (age) | 0,485450 | 0,485450 | 0,485450 | 1,5e−12 | ✓ |
| τ = 0,1: ker SH (age) | 28,301207 | 28,301207 | 28,301207 | 6,6e−13 | ✓ |
| τ = 0,1: boot SH (age) | 50,611399 | 50,611399 | 50,611399 | 5,0e−14 | ✓ |
| τ = 0,1: boot SH (admission_day) | 390,648956 | 390,648956 | 390,648956 | 2,8e−13 | ✓ |
| τ = 0,5: nid SH (age) | 17,253993 | 17,253993 | 17,253993 | 8,8e−11 | ✓ |
| τ = 0,5: nid p (age) | 0,281410 | 0,281410 | 0,281410 | 2,4e−12 | ✓ |
| τ = 0,5: ker SH (age) | 25,165267 | 25,165267 | 25,165267 | 1,8e−13 | ✓ |
| τ = 0,5: boot SH (age) | 13,082161 | 13,082161 | 13,086361 | 4,2e−03 | ✓ (R: 5/200 örneklemde başka köşe) |
| τ = 0,5: boot SH (admission_day) | 146,319738 | 146,319738 | 146,371657 | 5,2e−02 | ✓ (R: 5/200 örneklemde başka köşe) |
| τ = 0,9: nid SH (age) | 31,176743 | 31,176743 | 31,176743 | 1,5e−10 | ✓ |
| τ = 0,9: nid p (age) | 0,001986 | 0,001986 | 0,001986 | 9,7e−14 | ✓ |
| τ = 0,9: ker SH (age) | 23,844634 | 23,844634 | 23,844634 | 7,5e−14 | ✓ |
| τ = 0,9: boot SH (age) | 28,480780 | 28,480780 | 28,452278 | 2,9e−02 | ✓ (R: 2/200 örneklemde başka köşe) |
| τ = 0,9: boot SH (admission_day) | 325,526910 | 325,526910 | 325,910547 | 3,8e−01 | ✓ (R: 2/200 örneklemde başka köşe) |
| Eğim eşitliği, ortak F_{4,\,596} (nid) | 2,265873 | 2,265873 | 2,265873 | 2,0e−11 | ✓ |
| Eğim eşitliği, ortak p (nid) | 0,060842 | 0,060842 | 0,060842 | 2,0e−12 | ✓ |
| Eğim eşitliği, age F_{2,\,598} | 4,195787 | 4,195787 | 4,195787 | 3,8e−11 | ✓ |
| Eğim eşitliği, admission_day F_{2,\,598} | 0,271778 | 0,271778 | 0,271778 | 2,3e−12 | ✓ |
| Eğim eşitliği, ortak F (ker) | 3,988588 | — | 3,988588 | 1,9e−14 | ✓ |
45 büyüklüğün 41'i 10^{-10} düzeyinde eşleşir. Bootstrap SH'lerinde MerQur ile Python aynıdır; R'den fark, \tau=0{,}5'te 5, \tau=0{,}9'da 2 bootstrap örnekleminde LP çözümünün tek olmamasındandır: R'nin Barrodale–Roberts simpleksi ve HiGHS aynı amaç değerli farklı köşeleri seçer. Bu örneklemler dışında katsayılar aynıdır; göreli fark en çok 1{,}2\times10^{-3}'tür.
106.7 Çıktıyı okuma
Sonuç metni (varsayılan SH, eşitlik testi açık, kısaltılmış):
Katsayı matrisi (açıklayıcı × kantil, * → p < .05):
  Değişken                         q=0.10         q=0.50         q=0.90           OLS β
  Sabit terim                +2450.0000   +6302.3636*  +7620.1429*  +5727.7022
  age                         -30.2500    +18.6364    +97.7143*   +23.2708
  admission_day              +2069.7500*  +1831.4545*  +1751.7143*  +1887.4361
Katsayı çıkarımı — SH yöntemi: Hall-Sheather, Epanechnikov; köşeli parantez: %95 GA
  q=0.50  age                    b = +18.6364  SE = 19.9486  p = 0.3513  [-20.7038, 57.9765]
  q=0.90  age                    b = +97.7143  SE = 23.8422  p < 0.0001  [50.6956, 144.7330]
Kantiller arası eğim eşitliği testi (Koenker-Bassett Wald, nid; τ = 0.10, 0.50, 0.90):
  Tüm eğimler ortak (H0: eğimler τ'lar arasında eşit): F(4, 596) = 2.2659, p = 0.0608
  age                       F(2, 598) = 4.1958, p = 0.0155
  admission_day             F(2, 598) = 0.2718, p = 0.7621
Sözde R²:
  q = 0.10: 0.1666
  q = 0.50: 0.2719
  q = 0.90: 0.2755
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Katsayı matrisi | Her \tau için katsayı; * = p<\alpha |
Satır boyunca değişim heterojen etkiyi gösterir. Yıldız seçilen güven düzeyinin \alpha'sına göredir; başlık \alpha'yı yazar. |
| OLS β | Ortalama regresyonu | Kantil katsayıları OLS çevresinde dağılıyorsa etki homojendir. |
| SH satırları | b, SH, p, GA | Çok küçük p "p < 0.0001" biçiminde yazılır; raporda p<0{,}001 yazılır. |
| Eğim eşitliği | Ortak ve tek tek F | Anlamlıysa eğim kantiller arasında değişiyor. |
| Tek olmayan çözüm uyarısı | \tau listesi | Gerçekse başka algoritma eşit derecede iyi başka bir katsayı verebilir; bu örnekte uyarı çıkmaz (106.5.7). |
| Sözde R^2 | R^1(\tau) | Yereldir; OLS R^2'siyle karşılaştırılmaz. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Toplam tedavi maliyeti, yaş ve yatış günü açıklayıcılarıyla %10, %50 ve %90 kantillerinde kantil regresyonla modellendi (N = 200; SH: Hall–Sheather bant genişlikli Epanechnikov çekirdeği). Yatış günü tüm kantillerde maliyeti anlamlı biçimde artırdı (medyanda gün başına 1831 TL; %95 GA [1472; 2191]) ve etkisi kantiller arasında farklılaşmadı, F(2, 598) = 0{,}27, p = 0{,}762. Yaşın etkisi ise kantile bağlıydı, F(2, 598) = 4{,}20, p = 0{,}016: alt %10'da (b = -30{,}3; p = 0{,}288) ve medyanda (b = 18{,}6; p = 0{,}351) anlamlı değilken üst %90'da her yaş yılı maliyeti 97,7 TL artırdı (%95 GA [50,7; 144,7]; p < 0{,}001). Sözde R^2 değerleri sırasıyla 0,17, 0,27 ve 0,28'di.
106.8 Uzman soruları
S1. Katsayılar hangi algoritmayla bulunuyor? R ile neden birebir aynı?
statsmodels IRLS yalnız başlangıçtır; raporlanan katsayı, kontrol fonksiyonunun HiGHS dual simpleksle bulunan kesin LP köşesidir (rq_lp). R rq(method = "br") de bir köşe çözümü verir. Çözüm tek olduğunda iki algoritma aynı köşeye ulaşır (bu örnekte 10^{-12}). Çözüm tek değilse farklı köşeler seçilebilir; bu örnekte yalnız bazı bootstrap örneklemlerinde olmuştur.
S2. Varsayılan SH neden R'nin varsayılanından farklı?
MerQur'un varsayılanı statsmodels robust tanımıdır (Epanechnikov çekirdeği, tek bir seyreklik kestirimi, işarete göre iki ağırlık). R summary.rq'nun varsayılanı n<1001 için rank-skor GA'sıdır ve SH vermez; se = "nid" büyük örneklem varsayılanıdır. Aynı sayıları R'de elde etmek için MerQur'da "nid" ya da "ker" seçilmelidir; bu iki yöntem summary.rq ile 10^{-10} düzeyinde aynıdır.
S3. Neden p değerleri normal değil t_{n-p} ile?
statsmodels QuantRegResults t dağılımını kullanır ve MerQur nid/ker/boot'ta da t_{n-p} ile tutarlı davranır (224–238). quantreg summary.rq de t_{n-p} kullanır. Asimptotik teori normaldir; n=200'de fark küçüktür (yaş, \tau=0{,}1: t ile 0,288059, normal ile 0,286755).
S4. y'de çok sayıda bağ varsa (ör. tam sayı ölçekli puanlar) ne olur?
LP çözümü tek olmayabilir ve yoğunluk kestirimi bozulur (nid'de \hat f_i=0 olan gözlemler). MerQur tek olmama durumunu amaç değerine göreli payla sınar ve uyarır (106.5.7). Bağlı veride bootstrap SH'ler ve SH yöntemleri arasındaki farkın raporlanması önerilir.
S5. Sözde R^2 quantreg'deki gibi mi hesaplanıyor?
Evet. Yalnız sabitli modelin amaç değeri, bu modelin LP çözümünde (R rq(y ~ 1)) hesaplanır; Koenker–Machado (1999) tanımı budur. Ara değerli örneklem kantili kullanılsaydı n\tau tam sayı olmadığında R^1 biraz büyük çıkardı (106.5.6).
S6. Kantil doğruları kesişebilir mi?
Evet. Her \tau ayrı kestirildiği için \hat Q_{0{,}1}(\mathbf x)>\hat Q_{0{,}5}(\mathbf x) olabilen \mathbf x bölgeleri olabilir; çoğunlukla verinin seyrek kenarlarında görülür. MerQur kesişmeyi engelleyen bir kısıt (yeniden sıralama) uygulamaz.
S7. Eşitlik testi neden "sağlam" SH yerine nid kullanıyor?
Testin kovaryansı farklı kantillerin katsayıları arasındaki çapraz kovaryansı içermelidir: [\min(\tau_k,\tau_l)-\tau_k\tau_l]\mathbf H_k^{-1}\mathbf J\mathbf H_l^{-1}. statsmodels'in "sağlam" sandviçi tek kantil için tanımlıdır; çapraz terimi yoktur. Bu yüzden test nid (ya da ker) yoğunluklarıyla kurulur ve R anova.rqlist ile aynıdır.
S8. Bootstrap tohum değeri sabit mi? Her kantilde aynı örneklemler mi kullanılıyor?
Evet. Tohum (seed) 42'dir ve her \tau için default_rng(42) yeniden başlatılır; aynı 200 indis kümesi tüm kantillerde kullanılır. Bu, sonuçları yeniden üretilebilir yapar ve kantiller arası bootstrap karşılaştırmasını eşleştirilmiş kılar. R summary.rq(se = "boot") kendi rastgele sayı üretecini kullandığından sayılar R'den farklı çıkar; aynı indislerle verildiğinde (106.6.1) yalnız tek olmayan LP örneklemlerinde fark kalır.
106.9 Sık hatalar ve tuzaklar
- Kantil regresyonu "y'yi gruplara bölüp regresyon" sanmak. Model tüm gözlemleri kullanır; yanıta göre seçim yanlılık yaratır.
- Koşullu ve koşulsuz kantili karıştırmak. \beta_{\text{age}}(0{,}9)=97{,}7 "en pahalı %10 hastada" değil, "aynı yatış süresine sahip hastalar arasında üst %10'da" yaş etkisidir.
- SH yöntemini belirtmeden raporlamak. Uç kantillerde SH yöntemleri arasında iki kata varan fark vardır (yaş, \tau=0{,}1: 28,3 ile 50,6).
- Yıldızın hangi düzeye göre konduğuna bakmamak. Yıldız seçilen güven düzeyinin \alpha'sına göredir; %99 GA seçilince p<0{,}01 olur.
- Tek olmayan çözüm uyarısını görmezden gelmek. Uyarı, en iyi çözümlerin bir küme olduğunu gösterir (çoğunlukla bağlı ya da kesikli y, ikili açıklayıcılar); katsayı bu kümenin bir noktasıdır ve SH yöntemleri arasındaki fark raporlanmalıdır (106.5.7).
- Sözde R^2'yi OLS R^2'siyle karşılaştırmak. R^1 yalnız \tau kantilindeki yerel uyumu ölçer.
- Kaldıraç noktalarına karşı sağlam sanmak. Medyan regresyon y-aykırılarına sağlamdır, \mathbf x-aykırılarına değil.
106.10 Kaynaklar
- Barrodale, I., & Roberts, F. D. K. (1974). Algorithm 478: Solution of an overdetermined system of equations in the l1 norm. Communications of the ACM, 17(6), 319–320. https://doi.org/10.1145/355616.361024
- Hall, P., & Sheather, S. J. (1988). On the distribution of a studentized quantile. Journal of the Royal Statistical Society: Series B (Methodological), 50(3), 381–391. https://doi.org/10.1111/j.2517-6161.1988.tb01735.x
- Hendricks, W., & Koenker, R. (1992). Hierarchical spline models for conditional quantiles and the demand for electricity. Journal of the American Statistical Association, 87(417), 58–68. https://doi.org/10.1080/01621459.1992.10475175
- Koenker, R. (2005). Quantile regression. Cambridge University Press. https://doi.org/10.1017/CBO9780511754098
- Koenker, R., & Bassett, G. (1978). Regression quantiles. Econometrica, 46(1), 33–50. https://doi.org/10.2307/1913643
- Koenker, R., & Bassett, G. (1982). Tests of linear hypotheses and l1 estimation. Econometrica, 50(6), 1577–1583. https://doi.org/10.2307/1913398
- Koenker, R., & Machado, J. A. F. (1999). Goodness of fit and related inference processes for quantile regression. Journal of the American Statistical Association, 94(448), 1296–1310. https://doi.org/10.1080/01621459.1999.10473882
- Powell, J. L. (1991). Estimation of monotonic regression models under quantile restrictions. W. A. Barnett, J. L. Powell & G. Tauchen (Ed.), Nonparametric and semiparametric methods in econometrics and statistics içinde (ss. 357–384). Cambridge University Press.