58. Genelleştirilmiş Doğrusal Karma Modeller (GLMM)
Analiz kimliği: glmm · Menü adı: GLMM (Genelleştirilmiş Doğrusal Karma Modeller) · Panel ve motor: gui/panels/analyses/glmm.py (form 148–324, aile fonksiyonları 329–406, ML-AGQ _fit_ml_agq 409–675, read_options 710–729, execute 759–1285, Nakagawa R² 1312–1338, GLM'e karşı LRT 1341–1386, EMM 1389–1442, metin 1523–1735, grafik 1740–1794, tablo 1833–1921) · VB yolu: statsmodels BinomialBayesMixedGLM / PoissonBayesMixedGLM.fit_vb; çağıran stats_panel.py:6926–6979
58.1 Ne işe yarar
GLMM, kümeli ya da tekrarlı ölçülmüş ikili (hasta/sağlıklı, komplikasyon var/yok) ya da sayım (yan etki sayısı) yanıtı açıklayıcılarla modeller ve kümeler arası farkları bir rastgele kesişimle temsil eder. Katsayılar kümeye özgüdür (koşullu): "Aynı hasta yeni ilaca geçseydi beklenen yan etki sayısı kaç kat olurdu?" sorusunu cevaplar. Doğrusal karma modelin (LMM, Bölüm 54) normal olmayan yanıtlar için genellemesidir.
- i=1,\dots,K: küme; j=1,\dots,n_i: küme içi gözlem.
- u_i: kümenin rastgele kesişimi; \sigma_u: kümeler arası standart sapma (bağlantı ölçeğinde).
- g: binomda logit (varsayılan), probit ya da cloglog; Poisson ve NB2'de log. o_{ij}: isteğe bağlı denge terimi.
- Koşullu bağımsızlık: u_i bilindiğinde aynı kümenin gözlemleri birbirinden bağımsızdır; küme içi korelasyon yalnız ortak u_i'den doğar.
- NB2'de \operatorname{Var}(Y\mid u)=\mu+\mu^2/\theta; \theta ("size") veriden kestirilir.
Neden rastgele etki, neden koşullu katsayı?
Aynı hastanın ölçümleri ortak bir "eğilim" taşır; bunu her hastaya ayrı sabit (kukla) koyarak modellemek K parametre harcar ve yeni hastalara genellenmez. Rastgele kesişim bu eğilimi tek bir varyansla özetler. Bedeli, olabilirliğin bir integral olmasıdır: u_i gözlenmediği için her kümenin olabilirliği u_i üzerinden ortalanır. Doğrusal olmayan bağlantıda bu integralin kapalı biçimi yoktur; MerQur onu uyarlamalı Gauss–Hermite karelemeyle (AGQ) hesaplar. Katsayılar u_i sabitken yorumlanır; logit ve log bağlantıda GEE'nin marjinal katsayısından farklıdır (57.1, S8).
Ne zaman kullanılır?
- Kümeli ikili ya da sayım yanıtında bireye (kümeye) özgü etki isteniyorsa.
- Kümeler arası değişkenliğin büyüklüğü (\sigma_u, ICC) ilgi konusuysa.
- Eksik veri MAR olabilirse: olabilirlik tabanlı kestirim MAR altında geçerlidir (GEE değildir).
- Küme sayısı orta-azsa: GEE'nin sandviç SH'sinden daha kararlıdır (model doğruysa).
Ne zaman kullanılmaz?
- Yanıt sürekli ve normale yakınsa: LMM (Bölüm 54); iç içe ya da çapraz çok düzeyli yapı: İç İçe LMM ve Çapraz LMM (Bölüm 55, 56).
- Amaç popülasyon ortalaması etkisiyse ya da rastgele etki dağılımı varsayımı istenmiyorsa: GEE (Bölüm 57).
- Rastgele eğim ya da birden çok rastgele terim gerekiyorsa: MerQur GLMM yalnız tek rastgele kesişim kestirir; sürekli yanıtta LMM, ikili yanıtta Bayesci Hiyerarşik Model düşünülmeli.
- Kümeleme yoksa: Lojistik Regresyon (46), Poisson / Negatif Binom Regresyon (47).
- Sayım verisinde sıfır şişkinliği belirginse: sıfır şişkin modeller (MerQur'da ayrı analizler).
Sık karıştırılan analizler. GLMM ile GEE aynı veride farklı parametreleri kestirir: GLMM koşullu, GEE marjinal. Log bağlantıda ve yalnız rastgele kesişimde eğimler iki yaklaşımda aynı anlamı taşır, sabit terim \sigma_u^2/2 kadar kayar; logit bağlantıda marjinal eğimler koşullu eğimlerden mutlak değerce küçüktür. Karma lojistik regresyonun "ICC"si gizil (latent) ölçektedir ve 0/1 yanıtın korelasyonu değildir.
58.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Yanıt aileyle uyumlu | Binom: 0/1 ya da olay/deneme; Poisson/NB: negatif olmayan tam sayı. | İhlalde hata (glmm.py:862–882). |
| Rastgele kesişim normal | u_i\sim N(0,\sigma_u^2). | Denetlenmez; koşullu modlar (BLUP) listelenir. |
| Koşullu bağımsızlık | u_i verildiğinde gözlemler bağımsız. | Denetlenmez. |
| Poisson'da eşit yayılım | \operatorname{Var}(Y\mid u)=\mu. | Koşullu Pearson \chi^2/sd ve p; oran > 1,2 ve p<0{,}05 ise uyarı (1170–1176, 1639–1640). |
| Sıfır sayısı modelle uyumlu | Sayımda gözlenen sıfırlar ≈ beklenen. | Gözlenen/beklenen sıfır oranı (1177–1188); karar verilmez. |
| Yeterli küme | \sigma_u kestirilebilir. | K<2 hata (854–857); K<5 uyarı (858–859). |
| Yeterli gözlem | N<30 hata (849–850); gözlem/açıklayıcı < 10 uyarı (1097–1098). |
Eksik değer. Yanıt, küme, açıklayıcılar, deneme ve offset sütunlarında liste bazında silme (glmm.py:839–845, drop_missing_rows). Bir kümenin eksik satırı atılır, öteki satırları kalır.
Ölçekleme. Sayısal açıklayıcılar kestirimden önce z-puanına çevrilir (ortalama, n paydalı SS; 913–924) ve katsayılar ile tam kovaryans özgün ölçeğe doğrusal dönüşümle geri çevrilir: \boldsymbol\beta=\mathbf A\boldsymbol\beta_z, \mathbf V=\mathbf A\mathbf V_z\mathbf A^{\top} (948–957). ML kestirimi ölçek dönüşümüne değişmez olduğundan sonuç aynıdır; amaç büyük değerli açıklayıcılarda (yıl, yaş) e^{\eta} taşmasını önlemektir.
Uç durumlar.
- \hat\sigma_u alt sınıra (10^{-4}) inerse tekil uyum uyarısı; sabit etki SH'leri \sigma_u=0 koşulunda \boldsymbol\beta bloğundan verilir (550–552, 611–621, 1147–1148).
- Bilgi matrisi tersinmezse sözde ters kullanılır ve uyarı yazılır (614–630, 1158–1159).
- Bir SH'nin varyansı ≤ 0 çıkarsa SH, z, p, GA "—" yazılır (961–964, 1052–1054).
- NB2'de \hat\theta üst sınıra (10^6) dayanırsa model Poisson limitinden raporlanır, \theta "≥ 1000000" yazılır, SH'si verilmez (597–606).
- Binomda olay oranı %5'in altında ya da %95'in üstündeyse uyarı (1099–1112).
- VB yolunda yakınsamama ya da sayısal uyarılar kaydedilir (992–1002).
58.3 Parametreler
Varsayılanlar glmm.py:148–324 (form), 710–729 (read_options) ve çağırandan (stats_panel.py:6942–6948) okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımlı değişken | ilk ikili sütun | 0/1, olay sayısı ya da sayım. | Aile denetimleri. |
| Bağımsız değişkenler | en az 1 | Sabit etkiler; metin sütunları gösterge kodlanır. Referans düzeyi verilmezse ortak düzey sırasının ilk düzeyidir (sayısal/doğal sıra, aksi hâlde verideki ilk görülme sırası); kullanılan referanslar çıktıda yazılır. | Tasarım matrisi. |
| Grup değişkeni (rastgele kesişim) | ilk sütun | Küme kimliği. | u_i'nin birimi. |
| Aile | Binom (ikili) | Poisson (sayım), Negatif binom NB2 (aşırı yayılımlı sayım). | Koşullu dağılım. |
| Yöntem | Maksimum olabilirlik — adaptif Gauss-Hermite (AGQ) | Varyasyonel Bayes (VB). | Kestirim türü; VB yalnız logit 0/1 binom ve offset'siz Poisson'da etkin. |
| nAGQ | 25 | 1–50; 1 = Laplace. | İntegral yaklaşımının doğruluğu; yalnız ML'de. |
| Bağ fonksiyonu (binom) | logit | probit, cloglog. | Katsayı ölçeği; OR yalnız logit'te. Binom dışı ailede yok sayılır ve ayar bloğuna yazılır (810–821). |
| Deneme sayısı (olay/deneme) | Yok | Binom yanıt "olay sayısı / deneme" olur. | Olabilirliğe \binom{n}{y} sabiti girer. |
| Denge terimi (offset) | Yok | Doğrusal yordayıcıya katsayısız eklenir. | Hız modeli. |
| Rastgele etki LRT (GLMM vs GLM, σ²_u = 0) | kapalı | Aynı sabit etkili GLM ile olabilirlik oranı. | Ek bölüm. |
| EMM faktörü, düzeltme, ikinci faktör, kontrast, referans, düzey sırası, etkileşim | boş / Bonferroni | LMM bölümündeki ortak alanlar (54.3). | Ek bölümler; yalnız ML. |
| Güven Düzeyi | %95 | z_{1-\alpha/2}, GA, ★. |
Seçeneklerin birbirini etkilediği durumlar
NB2, deneme sayısı, offset ya da logit dışı bağlantı seçildiğinde form VB'yi kapatır (_sync_vb, 244–259). Kod düzeyinde bu kombinasyonla VB istenirse ML'ye geçilir, ayar bloğuna ve uyarılara yazılır (824–834, 926–927). ML basit modelde (logit binom ya da Poisson, offset'siz) çökerse VB'ye düşülür ve uyarılır (965–972); gelişmiş modelde hata verilir. VB yolunda EMM, LRT, kontrast ve düzey sırası hesaplanmaz; seçildiyse ayar bloğuna "VB'de yok" kaydı düşer (1116–1125).
Neden varsayılan nAGQ = 25?
Laplace yaklaşımı (nAGQ = 1), her kümenin integrandını tepesindeki normal eğriyle değiştirir; küme küçük ve yanıt ikili ise integrand çarpık olduğundan yanlıdır (özellikle \sigma_u aşağı). Düğüm sayısı arttıkça uyarlamalı kareleme gerçek integrale yakınsar. Bu veride log-olabilirlik nAGQ = 10'da 12 basamak kararlıdır (58.6, Adım 5). 25, tek rastgele kesişimde hesap maliyeti düşükken güvenli bir seçimdir; R lme4::glmer varsayılanı ise 1'dir.
58.4 Tıp örneği
Ana yürüyüş (Poisson): english/datasets/Tip/56_glmm_side_effect.xlsx (Türkçe kopya: samples/Tum_Analiz_Tip/56_glmm_yan_etki.xlsx); değişkenler video betiği #56'dan.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
side_effect_count |
Bağımlı | sayım | ort. 2,96; varyans 4,20; 0–12; 10 sıfır |
time_month |
Açıklayıcı | sayısal, 1–4 | her hastada 4 ay |
new_drug |
Açıklayıcı | 0/1 | 16 hasta yeni ilaç (ort. 3,95), 24 hasta eski (ort. 2,30); hasta içinde sabit |
patient_id |
Rastgele kesişim | tam sayı | 40 hasta |
n ve eksik değer: 160 satır (40 × 4), eksik yok.
Klinik soru: Ay ve hastalar arası farklar denetlendiğinde yeni ilaç, aynı hastanın aylık yan etki sayısını kaç kat değiştirir?
Seçilen ayarlar: Aile Poisson; diğerleri arayüz varsayılanı (ML-AGQ, nAGQ = 25, %95); "Rastgele etki LRT" açık. Ek çalıştırmalar: Laplace (nAGQ = 1), NB2 (Laplace), VB.
İkili örnek: 56_glmm_komplikasyon.xlsx (Tıp #56'nın ikinci dosyası): complication (0/1; 600 hastada 27 olay, %4,5) ~ age (29,2–94,8 yaş), rastgele kesişim clinic_id (20 klinik × 30 hasta). Logit (AGQ 25 ve Laplace) ve probit.
58.5 Formüller ve hesap adımları
MerQur'un hesap sırası (ML): (1) denetimler, liste bazında silme; (2) sayısal açıklayıcıların ölçeklenmesi; (3) başlangıç: sabit etkili GLM, \sigma_u=0{,}5; (4) \boldsymbol\theta=(\boldsymbol\beta,\ln\sigma_u[,\ln\theta_{NB}]) üzerinde L-BFGS-B ile marjinal log-olabilirliğin en büyüklenmesi; her değerlendirmede küme modları Newton ile bulunur ve AGQ uygulanır; (5) Newton cilası; (6) sayısal Hessian'dan kovaryans; (7) özgün ölçeğe dönüşüm; (8) Wald z, GA, OR/IRR; (9) koşullu modlar (BLUP), Pearson \chi^2, sıfır oranı, AIC/BIC, Nakagawa R^2/ICC, istenirse LRT ve EMM.
58.5.1 Marjinal olabilirlik
- v=u_i/\sigma_u: standart rastgele etki; \phi: standart normal yoğunluk. Parametreleme \sigma_u v olduğundan \sigma_u\to0 sınırında integral tanımlı kalır.
- f: koşullu yoğunluk. Binom (logit) \ln f=y\eta-n\ln(1+e^{\eta})+\ln\binom{n}{y}; Poisson \ln f=y\eta-e^{\eta}-\ln y!; NB2 \ln f=\ln\Gamma(y+\theta)-\ln\Gamma(\theta)-\ln y!+\theta\ln\frac{\theta}{\theta+\mu}+y\ln\frac{\mu}{\theta+\mu} (
_family_funcs, 329–406). - Log-olabilirlik tamdır: -\ln y! ve \ln\binom{n}{y} sabitleri dahildir; aynı yanıtın GLM olabilirliğiyle doğrudan karşılaştırılabilir.
58.5.2 Uyarlamalı Gauss–Hermite karelemesi
Her küme için önce integrandın tepesi ve eğriliği bulunur:
- \ell_i(v)=\sum_j\ln f(y_{ij}\mid\eta_{ij}(v)): kümenin koşullu log-olabilirliği.
- (x_k,w_k): Q = nAGQ noktalı Gauss–Hermite düğüm ve ağırlıkları (
numpy.polynomial.hermite.hermgauss). - W: Fisher (beklenen) ağırlığı; logit binomda \mu(1-\mu), Poisson'da \mu, NB2'de \mu\theta/(\theta+\mu), probit ve cloglog'da (\partial\mu/\partial\eta)^2/[\mu(1-\mu)] (
_fisher_w, 678–696). - Q=1'de x_1=0, w_1=\sqrt\pi ve formül Laplace yaklaşımına iner: \ln L_i\approx\ell_i(\hat v_i)-\tfrac12\hat v_i^2-\tfrac12\ln h_i.
- Toplam log-sumexp ile hesaplanır (taşmasız).
Neden "uyarlamalı"?
Sıradan Gauss–Hermite, düğümleri v=0 çevresine yerleştirir; büyük kümede ya da büyük \sigma_u'da integrandın kütlesi 0'dan uzakta ve dardır, düğümler onu kaçırır. Uyarlamalı biçim düğümleri her kümenin kendi tepesine (\hat v_i) taşır ve eğriliğine (h_i) göre ölçekler (Liu ve Pierce 1994; Pinheiro ve Bates 1995). Böylece integrand, düğüm sisteminde neredeyse standart normal çarpı yavaş değişen bir fonksiyon olur ve az düğümle doğru hesaplanır.
Koddaki tercih: eğrilik için Fisher ağırlıkları
Mod Newton adımlarıyla (gözlenen ikinci türev, adım ±2 ile sınırlı, |\Delta|<10^{-11}'e kadar) bulunur; düğüm ölçeği için eğrilik ise Fisher ağırlıklarıyla hesaplanır (glmm.py:475–478). Bu, lme4'ün PIRLS tanımıdır ve kanonik bağlantıda (logit, Poisson log) gözlenen eğrilikle aynıdır. Kanonik olmayan bağlantıda (probit, cloglog, NB2'nin log'u) iki tanım ayrışır: MerQur'un NB2 Laplace olabilirliği lme4::glmer.nb ile aynı tanımdadır, gözlenen Hessian kullanan glmmTMB'den 10^{-2} düzeyinde farklıdır. nAGQ büyüdükçe fark kaybolur; Laplace'ta (nAGQ = 1) kalıcıdır.
58.5.3 En büyükleme ve standart hatalar
- \ln\sigma_u\in[\ln10^{-5},\ln50]; NB2'de \ln\theta\in[\ln10^{-4},\ln10^{6}].
- Gradyan merkezi farkla (h=10^{-6}\max(1,|\theta_k|)), Hessian statsmodels
approx_hessile sayısal alınır. Sabit etki SH'leri \widehat{\operatorname{Var}}'ın \boldsymbol\beta bloğundan, özgün ölçeğe \mathbf A ile çevrilerek gelir. - \SH(\hat\sigma_u)=\hat\sigma_u\sqrt{\widehat{\operatorname{Var}}(\ln\hat\sigma_u)}, \SH(\hat\sigma_u^2)=2\hat\sigma_u^2\sqrt{\widehat{\operatorname{Var}}(\ln\hat\sigma_u)} (delta yöntemi; 1160–1165). NB2'de \SH(\hat\theta)=\hat\theta\sqrt{\widehat{\operatorname{Var}}(\ln\hat\theta)}.
- Wald: z=\hat\beta/\SH, p=2[1-\Phi(|z|)], GA \hat\beta\pm z_{1-\alpha/2}\SH; logit ve log bağlantıda e^{\hat\beta} ve GA'sı (OR, IRR).
Koddaki tercih: L-BFGS-B + Newton cilası
L-BFGS-B (ftol 10^{-14}, gtol 10^{-9}) iç noktada en çok beş Newton adımıyla cilalanır; adım, olabilirliği düşürmüyorsa yarılanır (559–585). \ln\sigma_u alt sınıra (\ln10^{-4}, lme4 isSingular toleransı) inerse cila yapılmaz ve tekil uyum işaretlenir. "Yakınsadı" bayrağı: parametreler sonlu, Hessian pozitif tanımlı ve \boldsymbol\beta gradyanı <10^{-3} (637–641). Bu cila sayesinde MerQur, lme4 ve glmmTMB ile 10^{-7} düzeyinde aynı optimumu bulur; lme4'ün varsayılan PIRLS toleransı (tolPwrss = 1e-7) Laplace'ta log-olabilirliği 10^{-4} kadar düşük bırakabilir (58.6.1).
R lme4'ün nAGQ > 1 log-olabilirliği doymuş modele göredir
glmer(..., nAGQ = 25) Poisson'da logLik olarak −94,3521 verir; MerQur −310,0843. Fark doymuş Poisson modelinin log-olabilirliğidir: \sum\ln P(Y=y_i\mid\mu=y_i)=-215{,}7322. Bu nedenle R'de anova(glmer_nAGQ25, glm) yanlış bir LRT (436,1) üretir. MerQur tam log-olabilirliği raporladığı için GLM ile karşılaştırması (4,663) doğrudur. Binom 0/1'de doymuş log-olabilirlik 0 olduğundan iki yazılım aynı sayıyı verir.
58.5.4 Koşullu modlar, aşırı yayılım ve sıfırlar
- \hat u_i: integrandın tepesi (koşullu mod, BLUP'un GLMM karşılığı); "Koşullu modlar" bölümünde ilk 20'si yazılır.
- k: kestirilen parametre sayısı (\boldsymbol\beta + \sigma_u [+ \theta]). X^2/\text{sd}>1{,}2 ve p<0{,}05 ise aşırı yayılım uyarısı.
- Sıfırlar: Poisson'da \sum_{ij}e^{-\tilde\mu_{ij}}, NB2'de \sum(\theta/(\theta+\tilde\mu))^{\theta} beklenen sıfır sayısıdır; oran = gözlenen/beklenen (
performance::check_zeroinflationtanımı). - Binom 0/1'de aşırı yayılım tanımsızdır ve hesaplanmaz.
58.5.5 Bilgi ölçütleri ve rastgele etki LRT'si
- k:
lme4gibi \boldsymbol\beta + 1 (+ \theta). N: gözlem sayısı (küme sayısı değil). - \ell_{\text{GLM}}: aynı sabit etkili GLM'in tam log-olabilirliği (NB2'de
statsmodelsNB2 GLM'i; 1335–1380). - MerQur hem \chi^2_1 p'sini hem de sınır karışımı p'sini (yarısı) yazar; H_0:\sigma_u^2=0 parametre uzayının sınırında olduğundan ikincisi doğrudur (Self ve Liang 1987).
58.5.6 Nakagawa R^2 ve gizil ölçek ICC
- \sigma_f^2=\operatorname{var}(\mathbf X\hat{\boldsymbol\beta}), n-1 paydalı; sabit etkilerin açıkladığı bağlantı ölçeği varyansı.
- \sigma_d^2: dağılım (gözlem düzeyi) varyansı: logit \pi^2/3, probit 1, cloglog \pi^2/6; Poisson'da log-normal yaklaşımla \ln(1+1/\lambda), \lambda=\exp(\beta_0^{(0)}+\sigma_{u}^{2\,(0)}/2), burada ^{(0)} yalnız kesişimli modelden (aynı nAGQ) gelir (
_nakagawa, 1306–1332). - NB2'de hesaplanmaz; olay/deneme binomunda \pi^2/3 tanımı korunur ve not düşülür.
- Tanımlar
performance::r2_nakagawaveiccile aynıdır (Nakagawa vd. 2017).
58.5.7 Varyasyonel Bayes yolu
"Varyasyonel Bayes" seçildiğinde statsmodels BayesMixedGLM.fit_vb ortalama-alan (mean-field) yaklaşımıyla sonsal ortalama ve SD verir; rastgele kesişim SD'si \exp(\text{sonsal ort.}[\ln\sigma_u])'dur (1090–1094). Standartlaştırılmış katsayılar özgün ölçeğe çevrilirken sabit terimin varyansına çapraz terim eklenmez (faktörize sonsal; 1004–1034). Sonsal SD frekansçı SH değildir ve küme düzeyinde sabit açıklayıcılarda belirgin biçimde küçüktür (58.6, Adım 8). Log-olabilirlik, AIC, LRT, EMM ve Nakagawa VB'de verilmez.
58.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/glmm/elle_hesap.py ile hesaplanmıştır: AGQ integrali, mod ve eğrilik, BFGS + Nelder–Mead + Newton en büyüklemesi ve Richardson ekstrapolasyonlu sayısal Hessian numpy/scipy ile yeniden yazılmıştır; MerQur ve statsmodels çağrılmaz.
Adım 1 — Başlangıç. Rastgele etkisiz Poisson GLM: \ell_{\text{GLM}}=-312{,}415845, AIC 630,83. Bu, LRT'nin sıfır modelidir.
Adım 2 — Birinci hastanın integrali (son parametrelerde). Hasta 1: eski ilaç, aylar 1–4, sayımlar 2, 1, 2, 1. \hat\beta=(0{,}865646;\ -0{,}021944;\ 0{,}540883), \hat\sigma_u=0{,}212523. Doğrusal yordayıcının sabit kısmı 0{,}865646-0{,}021944\,t: 0,8437; 0,8218; 0,7998; 0,7779.
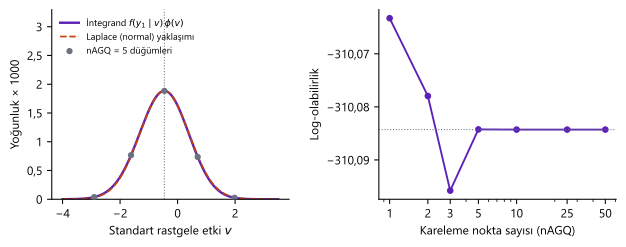
Mod: \hat v_1=-0{,}459784, yani \hat u_1=\hat\sigma_u\hat v_1=-0{,}097715 (MerQur "Koşullu modlar" satırı 1: −0,0977). Eğrilik:
Laplace: \ln L_1\approx-5{,}512007; AGQ 25: \ln L_1=-5{,}512617. Bu kümede Laplace hatası 6\cdot10^{-4}'tür.
Şekil 58.1. Sol: birinci hastanın integrandı f(\mathbf y_1\mid v)\phi(v) (mor), tepesine oturtulmuş Laplace normal eğrisi (kesikli) ve nAGQ = 5'in uyarlamalı düğümleri. Sağ: aynı parametrelerde toplam log-olabilirliğin kareleme nokta sayısıyla değişimi.
Adım 3 — En büyükleme sonucu (AGQ 25).
| Terim | \hat\beta | SH | z | p | IRR | %95 GA (IRR) |
|---|---|---|---|---|---|---|
| Sabit | 0,865646 | 0,130164 | 6,650 | <0,0001 | — | — |
| time_month | −0,021944 | 0,041091 | −0,534 | 0,5933 | 0,9783 | [0,9026; 1,0603] |
| new_drug | 0,540883 | 0,115228 | 4,694 | <0,0001 | 1,7175 | [1,3703; 2,1527] |
Örnek: z_{\text{new\_drug}}=0{,}540883/0{,}115228=4{,}694; IRR =e^{0{,}540883}=1{,}7175; GA e^{0{,}540883\pm1{,}959964\times0{,}115228}. Aynı hastada yeni ilaç aylık yan etki sayısını 1,72 kat artırır.
Adım 4 — Rastgele kesişim. \ln\hat\sigma_u=-1{,}5487, \widehat{\operatorname{Var}}(\ln\hat\sigma_u)=0{,}1007:
\ell=-310{,}084280; k=4; AIC =620{,}168561+8=628{,}1686; BIC =620{,}168561+4\ln160=640{,}4693.
Adım 5 — Kareleme nokta sayısının etkisi (aynı parametrelerde toplam \ell):
| nAGQ | 1 | 2 | 3 | 5 | 10 | 25 | 50 |
|---|---|---|---|---|---|---|---|
| \ell | −310,06329 | −310,07795 | −310,09578 | −310,08424 | −310,084280 | −310,084280 | −310,084280 |
Laplace, olabilirliği bu veride 0,021 kadar yüksek tahmin eder; nAGQ = 10'dan sonra değer 12 basamak sabittir. Laplace ile en büyükleme yapıldığında katsayılar dördüncü basamakta değişir (\hat\beta_{\text{new\_drug}}=0{,}540879, \hat\sigma_u=0{,}212938, \ell=-310{,}063272). İkili örnekte fark daha büyüktür: \hat\sigma_u Laplace 0,701214, AGQ 25 0,696547.
Adım 6 — Rastgele etki LRT'si ve uyum tanıları.
Koşullu Pearson X^2=145{,}931, sd =160-4=156, oran 0,935, p=0{,}707: aşırı yayılım yok. Beklenen sıfır \sum e^{-\tilde\mu}=11{,}66, gözlenen 10 (oran 0,858): sıfır şişkinliği yok.
Adım 7 — Nakagawa R^2 ve ICC (Poisson). Yalnız kesişimli model: \hat\beta_0^{(0)}=1{,}027467, \hat\sigma_u^{2\,(0)}=0{,}116853:
\sigma_f^2=0{,}071260, \sigma_u^2=0{,}045166; toplam 0,407303: R^2_m=0{,}1750, R^2_c=0{,}2858, ICC (düzeltilmiş) =0{,}045166/(0{,}045166+0{,}290877)=0{,}1344.
İkili örnekte (logit, AGQ 25): \hat\beta_{\text{age}}=0{,}028603 (SH 0,018703; OR 1,029 [0,992; 1,067]), \hat\sigma_u=0{,}696547; \sigma_d^2=\pi^2/3=3{,}289868, ICC (düzeltilmiş) =0{,}485178/(0{,}485178+3{,}289868)=0{,}1285; LRT 2,686 (p_{\text{karışım}}=0{,}051).
Adım 8 — VB ve NB2 ile karşılaştırma.
| Yöntem | \hat\beta_{\text{new\_drug}} | SH / sonsal SD | \hat\sigma_u | \ell |
|---|---|---|---|---|
| ML, AGQ 25 (Poisson) | 0,540883 | 0,115228 | 0,2125 | −310,0843 |
| ML, Laplace (Poisson) | 0,540879 | 0,115309 | 0,2129 | −310,0633 |
| ML, Laplace (NB2, \hat\theta=78{,}52) | 0,540729 | 0,115320 | 0,2055 | −310,0107 |
| VB (Poisson) | 0,540703 | 0,088504 | 0,2406 | — |
VB, hasta içinde sabit olan new_drug'ın belirsizliğini %23 küçük verir; ortalama-alan yaklaşımı sabit etki ile rastgele etki arasındaki sonsal korelasyonu yok sayar. time_month hasta içinde değiştiği için onun SD'si ML SH'sine yakındır (0,0409 ve 0,0411). NB2'de \hat\theta=78{,}5 (SH ≈ 250): aşırı yayılım yoktur; AIC Poisson'dan 1,85 büyüktür.
58.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan alınmıştır; glmm modülü katsayıları ve p'yi yuvarlamadan saklar. R 4.5.3: lme4::glmer(nAGQ = 25) (nloptwrap BOBYQA, xtol_abs = 1e-12, tolPwrss = 1e-12), Laplace modelleri için glmmTMB (Laplace, TMB), NB2 için lme4::glmer ile MerQur'un \hat\theta'sında sabit negative.binomial(θ) ailesi (aynı Fisher eğrilikli Laplace tanımı), MASS::glm.nb, performance::r2_nakagawa / icc (yalnız kesişimli sıfır modeliyle), koşullu Pearson ve beklenen sıfırlar fitted() üzerinden. lme4'ün nAGQ > 1 log-olabilirliğine doymuş model sabiti (−215,7322) eklenmiştir.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Poisson, AGQ 25: \beta Sabit | 0,865646 | 0,865646 | 0,865646 | 6,3e−09 | ✓ |
| Poisson, AGQ 25: SH Sabit | 0,130164 | 0,130164 | 0,130164 | 1,7e−08 | ✓ (sayısal Hessian, 5·10−5) |
| Poisson, AGQ 25: \beta time_month | −0,021944 | −0,021944 | −0,021944 | 3,5e−10 | ✓ |
| Poisson, AGQ 25: SH time_month | 0,041091 | 0,041091 | 0,041091 | 7,1e−09 | ✓ (sayısal Hessian, 5·10−5) |
| Poisson, AGQ 25: \beta new_drug | 0,540883 | 0,540883 | 0,540883 | 2,3e−08 | ✓ |
| Poisson, AGQ 25: SH new_drug | 0,115228 | 0,115228 | 0,115228 | 7,4e−09 | ✓ (sayısal Hessian, 5·10−5) |
| Poisson, AGQ 25: \hat\sigma_u | 0,212523 | 0,212523 | 0,212523 | 1,9e−08 | ✓ |
| Poisson, AGQ 25: log-olabilirlik | −310,084280 | −310,084280 | −310,084280 | 1,7e−13 | ✓ |
| Poisson, AGQ 25: AIC | 628,168561 | 628,168561 | 628,168561 | 3,4e−13 | ✓ |
| Poisson, AGQ 25: BIC | 640,469256 | 640,469256 | 640,469256 | 3,4e−13 | ✓ |
| Poisson, AGQ 25: SH(\hat\sigma_u) (delta) | 0,067457 | 0,067457 | — | 2,5e−08 | ✓ (sayısal Hessian, 5·10−5) |
| Poisson, AGQ 25: koşullu Pearson χ² | 145,931283 | 145,931283 | 145,931287 | 3,8e−06 | ✓ |
| Poisson, AGQ 25: beklenen sıfır sayısı | 11,661649 | 11,661649 | 11,661649 | 6,4e−09 | ✓ |
| Poisson, AGQ 25: GLM log-olabilirlik | −312,415845 | −312,415845 | −312,415845 | 5,7e−13 | ✓ |
| Poisson, AGQ 25: LRT χ² (GLMM – GLM) | 4,663130 | 4,663130 | 4,663130 | 1,5e−12 | ✓ |
| Poisson, AGQ 25: \sigma^2_d=\ln(1+1/\lambda) | 0,290877 | 0,290877 | 0,290877 | 2,4e−10 | ✓ |
| Poisson, AGQ 25: \sigma^2_f | 0,071260 | 0,071260 | 0,071260 | 6,0e−09 | ✓ |
| Poisson, AGQ 25: R^2 marjinal | 0,174957 | 0,174957 | 0,174957 | 1,6e−08 | ✓ |
| Poisson, AGQ 25: R^2 koşullu | 0,285847 | 0,285847 | 0,285847 | 3,2e−09 | ✓ |
| Poisson, AGQ 25: ICC düzeltilmiş | 0,134406 | 0,134406 | 0,134406 | 2,0e−08 | ✓ |
| Binom logit, AGQ 25: \beta Sabit | −5,089225 | −5,089225 | −5,089224 | 2,5e−07 | ✓ |
| Binom logit, AGQ 25: SH Sabit | 1,237429 | 1,237427 | 1,237425 | 4,3e−06 | ✓ (sayısal Hessian, 5·10−5) |
| Binom logit, AGQ 25: \beta age | 0,028603 | 0,028603 | 0,028603 | 4,1e−09 | ✓ |
| Binom logit, AGQ 25: SH age | 0,018703 | 0,018703 | 0,018703 | 1,8e−07 | ✓ (sayısal Hessian, 5·10−5) |
| Binom logit, AGQ 25: \hat\sigma_u | 0,696547 | 0,696547 | 0,696547 | 1,2e−08 | ✓ |
| Binom logit, AGQ 25: log-olabilirlik | −107,225805 | −107,225805 | −107,225805 | 2,8e−14 | ✓ |
| Binom logit, AGQ 25: AIC | 220,451610 | 220,451610 | 220,451610 | 5,7e−14 | ✓ |
| Binom logit, AGQ 25: BIC | 233,642399 | 233,642399 | 233,642399 | 4,3e−13 | ✓ |
| Binom logit, AGQ 25: LRT χ² | 2,686166 | 2,686166 | 2,686166 | 5,9e−14 | ✓ |
| Binom logit, AGQ 25: R^2 marjinal | 0,025102 | 0,025102 | 0,025102 | 6,9e−09 | ✓ |
| Binom logit, AGQ 25: ICC düzeltilmiş | 0,128522 | 0,128522 | 0,128522 | 3,7e−09 | ✓ |
| Binom probit, AGQ 25: \beta Sabit | −2,634459 | −2,634459 | −2,634459 | 9,6e−08 | ✓ |
| Binom probit, AGQ 25: SH Sabit | 0,573050 | 0,573050 | 0,573046 | 3,8e−06 | ✓ (sayısal Hessian, 5·10−5) |
| Binom probit, AGQ 25: \beta age | 0,013423 | 0,013423 | 0,013423 | 9,6e−10 | ✓ |
| Binom probit, AGQ 25: SH age | 0,008756 | 0,008756 | 0,008756 | 1,6e−07 | ✓ (sayısal Hessian, 5·10−5) |
| Binom probit, AGQ 25: \hat\sigma_u | 0,327523 | 0,327523 | 0,327523 | 6,8e−08 | ✓ |
| Binom probit, AGQ 25: log-olabilirlik | −107,200260 | −107,200260 | −107,200260 | 4,7e−13 | ✓ |
| Binom probit, AGQ 25: AIC | 220,400520 | 220,400520 | 220,400520 | 8,5e−14 | ✓ |
| Binom probit, AGQ 25: BIC | 233,591309 | 233,591309 | 233,591309 | 5,1e−13 | ✓ |
Laplace ve NB2:
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Poisson, Laplace (R: glmmTMB): \beta Sabit | 0,865549 | 0,865549 | 0,865549 | 1,6e−07 | ✓ |
| Poisson, Laplace (R: glmmTMB): SH Sabit | 0,130192 | 0,130192 | 0,130192 | 3,7e−08 | ✓ (glmmTMB sdreport, 5·10−4) |
| Poisson, Laplace (R: glmmTMB): \beta time_month | −0,021944 | −0,021944 | −0,021944 | 1,2e−10 | ✓ |
| Poisson, Laplace (R: glmmTMB): SH time_month | 0,041091 | 0,041091 | 0,041091 | 2,1e−08 | ✓ (glmmTMB sdreport, 5·10−4) |
| Poisson, Laplace (R: glmmTMB): \beta new_drug | 0,540879 | 0,540879 | 0,540879 | 9,8e−08 | ✓ |
| Poisson, Laplace (R: glmmTMB): SH new_drug | 0,115309 | 0,115309 | 0,115309 | 1,3e−08 | ✓ (glmmTMB sdreport, 5·10−4) |
| Poisson, Laplace (R: glmmTMB): \hat\sigma_u | 0,212938 | 0,212938 | 0,212938 | 6,3e−08 | ✓ |
| Poisson, Laplace (R: glmmTMB): log-olabilirlik | −310,063272 | −310,063272 | −310,063272 | 7,6e−12 | ✓ |
| Poisson, Laplace (R: glmmTMB): AIC | 628,126543 | 628,126543 | 628,126543 | 1,5e−11 | ✓ |
| Poisson, Laplace (R: glmmTMB): BIC | 640,427238 | 640,427238 | 640,427238 | 1,5e−11 | ✓ |
| Binom logit, Laplace (R: glmmTMB): \beta Sabit | −5,090016 | −5,090016 | −5,090021 | 4,8e−06 | ✓ |
| Binom logit, Laplace (R: glmmTMB): SH Sabit | 1,236682 | 1,236681 | 1,236700 | 1,9e−05 | ✓ (glmmTMB sdreport, 5·10−4) |
| Binom logit, Laplace (R: glmmTMB): \beta age | 0,028527 | 0,028527 | 0,028527 | 7,0e−08 | ✓ |
| Binom logit, Laplace (R: glmmTMB): SH age | 0,018683 | 0,018683 | 0,018678 | 5,4e−06 | ✓ (glmmTMB sdreport, 5·10−4) |
| Binom logit, Laplace (R: glmmTMB): \hat\sigma_u | 0,701214 | 0,701214 | 0,701214 | 5,9e−07 | ✓ |
| Binom logit, Laplace (R: glmmTMB): log-olabilirlik | −107,161168 | −107,161168 | −107,161168 | 1,3e−11 | ✓ |
| Binom logit, Laplace (R: glmmTMB): AIC | 220,322337 | 220,322337 | 220,322337 | 2,7e−11 | ✓ |
| Binom logit, Laplace (R: glmmTMB): BIC | 233,513126 | 233,513126 | 233,513126 | 2,6e−11 | ✓ |
| NB2, Laplace: \beta Sabit | 0,867123 | 0,867123 | 0,867123 | 3,0e−07 | ✓ |
| NB2, Laplace: SH Sabit (θ dahil tam Hessian) | 0,131780 | 0,131778 | — | 1,7e−06 | ✓ (sayısal Hessian, 5·10−5) |
| NB2, Laplace: \beta time_month | −0,022132 | −0,022132 | −0,022132 | 1,7e−07 | ✓ |
| NB2, Laplace: SH time_month (θ dahil tam Hessian) | 0,041861 | 0,041861 | — | 3,1e−08 | ✓ (sayısal Hessian, 5·10−5) |
| NB2, Laplace: \beta new_drug | 0,540729 | 0,540729 | 0,540729 | 1,4e−07 | ✓ |
| NB2, Laplace: SH new_drug (θ dahil tam Hessian) | 0,115320 | 0,115320 | — | 1,0e−09 | ✓ (sayısal Hessian, 5·10−5) |
| NB2, Laplace: \hat\sigma_u | 0,205519 | 0,205519 | 0,205519 | 1,7e−07 | ✓ |
| NB2, Laplace: log-olabilirlik | −310,010743 | −310,010743 | −310,010744 | 4,7e−07 | ✓ |
| NB2, Laplace: \hat\theta | 78,519247 | 78,519460 | — | 2,1e−04 | ✓ (düz profil, 10−5) |
| NB2: GLM (NB) log-olabilirlik | −311,391645 | −311,391645 | −311,391645 | 2,0e−08 | ✓ |
SH'ler üç kaynakta da sayısal Hessian'dan geldiği için 5\cdot10^{-5} göreli ölçüt kullanılmıştır; binom örneğinde age merkezlenmemiş (ortalama 61,8) olduğundan sabit ve eğim arasındaki korelasyon yüksektir ve Hessian'ın koşulu kötüdür. glmmTMB SH'leri sdreport'un sayısal türeviyle 3\cdot10^{-4}'e kadar ayrışır. NB2'de MerQur'un SH'leri \ln\theta'yı da içeren tam Hessian'dan gelir; R'nin \theta sabit modelinde bu belirsizlik yoktur, bu yüzden NB2 SH'leri bağımsız Python ile karşılaştırılmıştır. VB için bağımsız başvuru kurulmamıştır.
58.7 Çıktıyı okuma
Sonuç metni (Poisson, AGQ 25, LRT açık; kısaltılmış):
══ GLMM — GENELLEŞTİRİLMİŞ DOĞRUSAL KARMA MODELLER ══
Bağımlı değişken : side_effect_count
Dağılım ailesi   : Poisson (sayım)
Rastgele kesişim : patient_id
Yöntem           : Maksimum olabilirlik, adaptif Gauss-Hermite (nAGQ=25)

── SABİT ETKİLER (ML, Wald z) ──
Parametre                      β        SH         z   p (yakl.)                %95 GA
Sabit                     0.8656    0.1302     6.650     <0.0001        (0.611, 1.121) ★
time_month               -0.0219    0.0411    -0.534      0.5933       (-0.102, 0.059)
new_drug                  0.5409    0.1152     4.694     <0.0001        (0.315, 0.767) ★

── OLAY HIZI ORANI (IRR = exp β) ──
time_month                 0.978        (0.903, 1.060)
new_drug                   1.718        (1.370, 2.153) ★

── RASTGELE ETKİLER ──
Rastgele kesişim SS        : 0.2125  (SH 0.0675)
Rastgele kesişim varyansı  : 0.0452  (SH 0.0287)

── MODEL UYUMU ──
Log-olabilirlik  : -310.0843
AIC              : 628.1686
BIC              : 640.4693

── AŞIRI YAYILIM / SIFIR ŞİŞKİNLİĞİ ──
  Pearson χ² = 145.931, sd = 156, oran = 0.935, p = 0.7071 (oran > 1 aşırı yayılım)
  Sıfırlar: gözlenen = 10, modelin beklediği = 11.7, oran = 0.858

── NAKAGAWA R² VE GİZİL ÖLÇEK ICC ──
  R² marjinal = 0.1750   R² koşullu = 0.2858
  ICC (düzeltilmiş) = 0.1344   ICC (düzeltilmemiş) = 0.1109

── RASTGELE ETKİ LRT (GLMM vs GLM) ──
  GLM  : Log-olabilirlik = -312.4158  npar = 3  AIC = 630.8317
  GLMM : Log-olabilirlik = -310.0843  npar = 4  AIC = 628.1686
  χ²(1) = 4.6631, p = 0.0308  (½χ²₀:½χ²₁ p = 0.0154)
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Yöntem | ML (nAGQ), Laplace (nAGQ = 1) ya da VB. | VB'de sütun başlığı "β (mean) / SD" olur; SD frekansçı SH değildir. |
| Sabit etkiler | \hat\beta, SH, z, p, GA, ★. | Koşullu (kümeye özgü) etki. Katsayı, SH ve GA metinde ve Tablo sekmesinde anlamlı basamakla yazılır; küçük katsayılar (ör. probit age 0,0134) sıfıra yuvarlanmaz. |
| OR / IRR | e^{\hat\beta} ve GA. | Logit'te OR, Poisson/NB'de IRR; probit ve cloglog'da yoktur. |
| Rastgele etkiler | \hat\sigma_u, \hat\sigma_u^2 ve delta SH'leri. | Bağlantı ölçeğinde. \hat\sigma_u=0{,}21: hastaların temel yan etki hızı, tipik olarak e^{\pm0{,}21} = ×0,81–1,24 aralığında değişir. |
| Model uyumu | Tam \ell, AIC, BIC; NB2'de \hat\theta. | Aynı yanıtın GLM'iyle karşılaştırılabilir. |
| Aşırı yayılım / sıfırlar | Koşullu Pearson oranı, gözlenen/beklenen sıfır. | Oran > 1,2 ve p<0{,}05 uyarı verir. |
| Nakagawa | R^2_m, R^2_c, iki ICC, varyans bileşenleri. | Gizil ölçektedir; 0/1 yanıtın korelasyonu değildir. |
| LRT | GLM ve GLMM \ell, AIC; \chi^2_1 ve karışım p. | Karışım p'si raporlanmalı. |
| Koşullu modlar | İlk 20 kümenin \hat u_i'si. | Bağlantı ölçeğinde kümeye özgü sapma. |
Tablo sekmesi: sabit etkiler, ayırıcı satır, rastgele kesişim SD'si ve varyansı (SH'leriyle), log-olabilirlik, AIC, BIC, Pearson \chi^2/sd, sıfır oranı, NB θ, Nakagawa satırları, LRT, EMM. Grafik sekmesi: sabit etkilerin çubuk + GA grafiği; başlıkta \hat\sigma_u.
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Aylık yan etki sayısı, hasta için rastgele kesişim içeren Poisson genelleştirilmiş doğrusal karma modelle incelendi (40 hasta, 160 ölçüm; en çok olabilirlik, 25 noktalı uyarlamalı Gauss–Hermite kareleme). Ay denetlendiğinde yeni ilaç, aynı hastanın beklenen aylık yan etki sayısını 1,72 kat artırdı (IRR = 1,72; %95 GA [1,37; 2,15]; z = 4{,}69; p < 0{,}001); zamanın etkisi anlamlı değildi (IRR = 0,98; %95 GA [0,90; 1,06]; p = 0{,}593). Hastalar arası standart sapma \hat\sigma_u = 0{,}21 idi; rastgele kesişim, sabit etkili Poisson modeline göre uyumu iyileştirdi (\chi^2 = 4{,}66; sınır karışımı p = 0{,}015). Aşırı yayılım saptanmadı (Pearson \chi^2/\text{sd} = 0{,}94).
58.8 Uzman soruları
S1. MerQur'un AGQ'su lme4'ün nAGQ'suyla aynı mı?
Evet, tanım aynıdır: düğümler her kümenin koşullu moduna oturtulur ve Fisher (PIRLS) eğriliğiyle ölçeklenir; integral \sigma_u v parametrelemesiyle alınır. Bu veride AGQ 25 katsayıları glmer(nAGQ = 25) ile 2\cdot10^{-7}, log-olabilirlik (doymuş sabit eklendikten sonra) 10^{-10} düzeyinde aynıdır. Fark iki noktadadır: lme4 nAGQ > 1'de log-olabilirliği doymuş modele göre verir; MerQur tam değeri verir. lme4 nAGQ > 1'i yalnız tek skaler rastgele etkiye izin verir; MerQur da yalnız tek rastgele kesişim kestirir.
S2. SH'ler neden sayısal Hessian'dan? Analitik değil mi?
AGQ olabilirliğinin \boldsymbol\beta ve \ln\sigma_u'ya göre ikinci türevi, her değerlendirmede modların yeniden bulunmasını içerir; analitik biçimi uzun ve hataya açıktır. lme4 de deriv12 ile sonlu fark kullanır. MerQur'un Hessian'ı standartlaştırılmış ölçekte alınır, bu da koşulu iyileştirir. Sonlu fark nedeniyle SH'ler yazılımlar arasında 10^{-5} göreli düzeyde ayrışabilir; dördüncü ondalıkta görünmez.
S3. Tekil uyum (\hat\sigma_u\approx0) neyi gösterir, sonuçlar geçerli mi?
Veri kümeler arası farkı ayırt edecek bilgiyi taşımıyordur. MerQur \hat\sigma_u\le10^{-4}'te uyarı verir ve sabit etki SH'lerini \sigma_u=0'da \boldsymbol\beta bloğundan hesaplar; bu durumda model fiilen GLM'dir ve katsayılar GLM'inkine eşittir. LRT karışım p'si 0,5'e yakın çıkar. Rastgele kesişim tasarım gereği gerekliyse (ör. kümeli randomizasyon) modelde tutulur ve sınır kestirimi raporlanır.
S4. LRT için neden p değeri ikiye bölünüyor?
H_0:\sigma_u^2=0 parametre uzayının sınırındadır. Bu durumda LR istatistiğinin asimptotik dağılımı \chi^2_1 değil, \tfrac12\chi^2_0+\tfrac12\chi^2_1 karışımıdır (Self ve Liang 1987); \chi^2_1 p'si tutucudur. MerQur ikisini birlikte yazar; raporlanması gereken karışım p'sidir (bu veride 0,0154).
S5. Nakagawa ICC'si 0,13, ama aynı hastanın aylarındaki yan etki sayılarının korelasyonu başka çıkıyor; hangisi doğru?
Nakagawa ICC'si gizil (bağlantı) ölçekte tanımlıdır: \sigma_u^2'yi gözlem düzeyindeki dağılım varyansının yaklaşık değeriyle (\ln(1+1/\lambda)) kıyaslar. Ham sayımların küme içi korelasyonu ise ortalamaya bağlıdır ve farklı bir büyüklüktür. Poisson için \sigma_d^2 log-normal yaklaşımdır; MerQur performance'ın varsayılanını izler ve \lambda'yı yalnız kesişimli modelden alır. Delta ya da trigamma yaklaşımı farklı sayı verir.
S6. Varyasyonel Bayes neden daha "anlamlı" sonuç veriyor?
Ortalama-alan VB, sonsal dağılımı sabit etkiler ve rastgele etkiler arasında bağımsız çarpanlara ayırır. Küme düzeyinde sabit bir açıklayıcının (\text{new\_drug}) belirsizliği büyük ölçüde u_i'lerle paylaşılır; bu paylaşım yok sayılınca sonsal SD küçülür (0,0885; ML SH 0,1152). MerQur bunu uyarı olarak yazar. Çıkarım için ML-AGQ kullanılmalı; VB büyük veri ya da ML'nin çöktüğü durumda keşif amaçlıdır.
S7. Laplace (nAGQ = 1) ne zaman yeterli?
Küme başına çok gözlem varsa ve yanıt sayımsa integrand normale yakındır; Laplace yeterlidir. Küme küçük (≤ 5) ve yanıt ikiliyse, özellikle olay oranı düşük ve \sigma_u büyükse, Laplace \sigma_u'yu ve katsayıları yanlı verebilir. Bu bölümün ikili örneğinde \hat\sigma_u Laplace 0,7012, AGQ 25 0,6965'tir. MerQur'da varsayılan 25'tir; Laplace yalnız karşılaştırma ya da NB2 içindir (NB2'de de AGQ seçilebilir, ama glmer.nb ile karşılaştırma Laplace'ta yapılır).
S8. NB2'de MerQur'un θ'sı R glmmTMB ve glmer.nb'den farklı; hangisi doğru?
Üçü farklı şeyler hesaplar. MerQur Laplace'ı Fisher eğriliğiyle kurar (glmer.nb ile aynı tanım); glmmTMB gözlenen Hessian kullanır, bu yüzden log-olabilirlikleri 10^{-2} düzeyinde farklıdır. glmer.nb \theta'yı ayrı bir dış döngüde ve gevşek ölçütle günceller; bu veride yineleme sınırına ulaşır (\hat\theta=181). MerQur \theta'yı diğer parametrelerle birlikte en büyükler (\hat\theta=78{,}5, en yüksek olabilirlik). \theta yönünde profil çok düzdür (SH ≈ 250); hepsi "aşırı yayılım yok" sonucunu verir.
S9. Rastgele eğim ekleyebilir miyim?
Hayır. MerQur GLMM yalnız tek rastgele kesişim kestirir (random_spec, 907; _fit_ml_agq skaler \sigma). Rastgele eğim ya da çok düzeyli yapı gerekiyorsa sürekli yanıtta LMM (Bölüm 54–56) kullanılır; ikili/sayım yanıtta MerQur'da bir karşılığı yoktur.
58.9 Sık hatalar ve tuzaklar
- Koşullu katsayıyı popülasyon etkisi gibi raporlamak. GLMM katsayısı "aynı hasta için" etkidir; ortalama hasta etkisi isteniyorsa GEE.
- R
anova(glmer_nAGQ25, glm)sonucunu MerQur LRT'siyle karşılaştırmak.lme4'ün nAGQ > 1 log-olabilirliği doymuş modele göredir; R'deki LRT yanlıştır. - Sınırdaki LRT'de \chi^2_1 p'sini raporlamak. Karışım p'si raporlanmalı.
- VB sonsal SD'sini SH sanmak. Küme düzeyindeki değişkenlerde belirgin biçimde küçüktür.
- Az kümeyle \sigma_u'yu yorumlamak. K<5'te uyarı gelir; 10'dan az kümede \hat\sigma_u çok belirsizdir.
- Nakagawa ICC'sini ham korelasyon sanmak. Gizil ölçektedir; Poisson'da yaklaşımdır.
- Probit ya da cloglog'da OR aramak. Bu bağlantılarda e^{\beta} verilmez.
- Olay/deneme biçiminde VB beklemek. VB yalnız 0/1 logit ve offset'siz Poisson'da vardır; öteki durumlarda ML'ye geçilir.
- Tek rastgele kesişimin yetmediği yapıyı zorlamak. Hasta içinde zamanla değişen eğilim varsa rastgele eğim gerekir; MerQur GLMM bunu kestirmez.
58.10 Kaynaklar
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Bolker, B. M., Brooks, M. E., Clark, C. J., Geange, S. W., Poulsen, J. R., Stevens, M. H. H., & White, J.-S. S. (2009). Generalized linear mixed models: A practical guide for ecology and evolution. Trends in Ecology & Evolution, 24(3), 127–135. https://doi.org/10.1016/j.tree.2008.10.008
- Breslow, N. E., & Clayton, D. G. (1993). Approximate inference in generalized linear mixed models. Journal of the American Statistical Association, 88(421), 9–25. https://doi.org/10.1080/01621459.1993.10594284
- Brooks, M. E., Kristensen, K., van Benthem, K. J., Magnusson, A., Berg, C. W., Nielsen, A., Skaug, H. J., Mächler, M., & Bolker, B. M. (2017). glmmTMB balances speed and flexibility among packages for zero-inflated generalized linear mixed modeling. The R Journal, 9(2), 378–400. https://doi.org/10.32614/RJ-2017-066
- Liu, Q., & Pierce, D. A. (1994). A note on Gauss–Hermite quadrature. Biometrika, 81(3), 624–629. https://doi.org/10.1093/biomet/81.3.624
- Nakagawa, S., Johnson, P. C. D., & Schielzeth, H. (2017). The coefficient of determination R² and intra-class correlation coefficient from generalized linear mixed-effects models revisited and expanded. Journal of the Royal Society Interface, 14(134), 20170213. https://doi.org/10.1098/rsif.2017.0213
- Neuhaus, J. M., Kalbfleisch, J. D., & Hauck, W. W. (1991). A comparison of cluster-specific and population-averaged approaches for analyzing correlated binary data. International Statistical Review, 59(1), 25–35. https://doi.org/10.2307/1403572
- Pinheiro, J. C., & Bates, D. M. (1995). Approximations to the log-likelihood function in the nonlinear mixed-effects model. Journal of Computational and Graphical Statistics, 4(1), 12–35. https://doi.org/10.1080/10618600.1995.10474663
- Self, S. G., & Liang, K.-Y. (1987). Asymptotic properties of maximum likelihood estimators and likelihood ratio tests under nonstandard conditions. Journal of the American Statistical Association, 82(398), 605–610. https://doi.org/10.1080/01621459.1987.10478472