93. Ağırlıklı Ortalama (Karmaşık Örneklem)
Analiz kimliği: survey_means · Menü adı: Ağırlıklı Ortalama (Karmaşık Örneklem) · Panel: gui/panels/analyses/survey_means.py (form 51–135, execute 140–172) · Ortak seçenekler: gui/panels/analyses/_survey_extras_ui.py (form 18–46, okuma 251–289, apply_svy_extras 292–372) · Motor: stats/survey_design.py, run_survey_means (933–1054), Taylor çekirdeği _taylor_meat (443–487), DEFF _srs_var_mean (490–518) · Hesap kütüphanesi: svy 0.18 (polars) · Çağıran: stats_panel.py:8015–8074
Bu bölüm, karmaşık örneklem ailesinin (Ağırlıklı Ortalama, Ağırlıklı Frekans, Ağırlıklı Toplam) ortak kuramını da verir: örneklem tasarımı, Taylor doğrusallaştırması, tasarım serbestlik derecesi ve tasarım etkisi burada bir kez anlatılır. Bölüm 94 ve 95 bu kurama gönderme yapar.
93.1 Ne işe yarar
Ağırlıklı Ortalama, karmaşık bir örneklem tasarımıyla toplanmış verilerden bir sayısal değişkenin evren ortalamasını ve bu kestirimin tasarıma dayalı standart hatasını verir. Cevapladığı soru şudur: "Bu örneklem, evrenden eşit olmayan olasılıklarla, tabakalara ayrılarak ve kümeler halinde seçildiyse, evrendeki ortalama nedir ve bu kestirim ne kadar belirsizdir?"
Burada bir hipotez sınanmaz; amaç kestirimdir. Kestirilen büyüklük evren ortalamasıdır:
- U: hedef evren (ör. bir ilin tüm yetişkinleri); N: evrendeki birim sayısı.
- y_i: i. birimin değeri (ör. sistolik kan basıncı).
- \bar Y: evren ortalaması; bilinmez, örneklemden kestirilir.
Karmaşık örneklem ne demek? Basit rastgele örneklemede (BRÖ) evrendeki her birimin seçilme olasılığı eşittir ve birimler birbirinden bağımsız seçilir. Sağlık taramaları ve hanehalkı anketlerinde bu nadiren olur. Üç öğe tasarımı karmaşık yapar:
- Tabaka (strata). Evren önce örtüşmeyen gruplara ayrılır (yaş grubu, bölge, kurum büyüklüğü) ve her gruptan ayrı ayrı örneklem çekilir. Tabakalama genellikle varyansı küçültür, çünkü tabakalar arası fark örnekleme hatasına girmez.
- Küme (PSU, birincil örnekleme birimi). Bireyler tek tek değil, gruplar halinde seçilir: önce klinikler ya da köyler, sonra onların içindeki kişiler. Aynı kümedeki kişiler birbirine benzediği için bilgi tekrar eder; kümeleme genellikle varyansı büyütür.
- Ağırlık. Bir birimin seçilme olasılığı \pi_i ise ağırlığı w_i=1/\pi_i'dir: o birimin evrende kaç kişiyi temsil ettiği. Seçilme olasılıkları eşit değilse ağırlıksız ortalama yanlıdır.
Ne zaman kullanılır? Veri; tabakalı, kümeli ya da ağırlıklı bir örneklem tasarımından geliyorsa (TÜİK, DHS, saha taramaları) ve amaç evren düzeyinde bir ortalama ile onun güvenilir belirsizliğini raporlamaksa.
Ne zaman kullanılmaz?
- Örneklem gerçekten BRÖ ise ve ağırlık yoksa: Tanımlayıcı İstatistikler aynı ortalamayı ve SH'yi verir (tasarımsız SH, BRÖ formülüdür).
- Amaç iki grubun ortalamasını sınamaksa: alt grup (by) kestirimleri ve domain karşılaştırmaları ek çıktısı kullanılır; tasarımı yok sayan Bağımsız t Testi kümeli veride SH'yi küçük verir.
- Bağımlı değişken kategorikse: Ağırlıklı Frekans (Karmaşık Örneklem) (Bölüm 94).
- Evren toplamı (kaç hasta, kaç hektar) isteniyorsa: Ağırlıklı Toplam (Karmaşık Örneklem) (Bölüm 95).
- Ortalamanın başka değişkenlerle ilişkisi soruluyorsa: Ağırlıklı Doğrusal Regresyon (Survey Reg.).
- Ağırlıklar sıklık ağırlığıysa (bir satır k özdeş gözlemi temsil ediyorsa): bu analiz SH'yi yanlış verir; sıklık ağırlığı kabul eden analizler (ör. lojistik regresyonun sıklık ağırlığı seçeneği) gerekir.
Sık karıştırılan analizler. "Ağırlıklı ortalama" adı iki farklı şeyi anlatabilir. Tanımlayıcı istatistiklerdeki ağırlıklı ortalama yalnız nokta kestirimini değiştirir. Bu analiz ise SH'yi de tasarımdan hesaplar. Ağırlık analitik (kesinlik) ağırlığı da değildir. Bir ölçümün varyansının tersi olan ağırlık meta-analiz ve ağırlıklı en küçük kareler içindir; anket ağırlığı ise seçilme olasılığının tersidir.
93.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Tasarım doğru tanımlı | Ağırlık, tabaka, küme ve FPC sütunları örneklemin gerçekte nasıl çekildiğini yansıtır. | Denetlenmez. Yanlış tanım SH'yi sessizce bozar. |
| Kümeler tabaka içinde iç içe | Her PSU yalnız bir tabakadadır. | Denetlenmez; MerQur PSU kimliğini her zaman (tabaka, küme) çiftinden kurar (survey_design.py:363–370). |
| PSU'lar iadeli seçilmiş (ya da FPC verilmiş) | Taylor formülü iadeli seçim varsayar; iadesiz seçimde FPC ile düzeltilir. | FPC sütunu verilirse uygulanır; biçimi denetlenir (bkz. 93.3). |
| Tabaka başına en az 2 PSU | Tek PSU'lu tabakada tabaka içi varyans kestirilemez. | Uyarı yazılır; tabaka varsayılan olarak varyansa katkısız sayılır (_lonely_note, 675–686). |
| Yeterli PSU sayısı | Taylor ve t yaklaşımı PSU sayısı büyüdükçe iyileşir. | Denetlenmez. Tasarım sd'si raporda yazılır. |
| Hedef sayısal | Ortalama alınacak değişken sayıdır. | Sayısal olmayan sütun çağırma katmanında reddedilir (stats_panel.py:8042–8045). |
Dağılım varsayımı yoktur. Taylor yöntemi ortalamanın örnekleme dağılımının, PSU sayısı büyük olduğunda yaklaşık normal olmasına dayanır. GA, normal yerine t(tasarım sd) kantiliyle kurulur.
Eksik değer. İki tür eksiklik ayrı işlenir.
- Tasarım sütununda eksik. Ağırlığı, tabakası, kümesi ya da FPC'si eksik ya da sayıya çevrilemeyen satır analizden atılır. Raporda "Tasarım sütunlarında ... {n} gözlem analiz dışı bırakıldı" uyarısı çıkar (
_drop_design_na, 573–595). - Hedef değişkende eksik. Satır silinmez. O değişken için alt grup (domain) dışı sayılır; tasarım (tabaka, PSU, sd) tüm örneklemden korunur (
survey_design.py:983–1007). Bu, Rsvymean(na.rm = TRUE)davranışıdır. Raporda değişken başına kullanılan n yazılır.
Uç durumlar.
- Hedef seçilmemişse ya da sütun yoksa hata (
survey_design.py:952–953, 981–982). - Tasarım sütunu temizliğinden sonra satır kalmazsa hata (
survey_design.py:644–645). - FPC değerleri hem 1'den küçük hem 1'den büyükse ya da hepsi tam 1 ise hata (R
as.fpckuralı,fpc_mode, 598–617). - Bir tabakada FPC'nin ima ettiği evren büyüklüğü örneklenen PSU sayısından küçükse ("%100'ün üstünde örnekleme") hata (
_validate_fpc, 653–672). - Negatif ağırlık hata vermez; kestirim yapılır, açık uyarı yazılır (
survey_design.py:830–834). Rsvymeande negatif ağırlığı kabul eder. - Kestirim 0 ise CV tanımsızdır; çıktıda "—" yazılır.
- Yapısal olarak sıfır olan varyans (V<10^{-14}\max(1,\hat{\bar Y}^2)) tam 0 yazılır (
survey_design.py:786).
93.3 Parametreler
Form survey_means.py:51–120 ve ortak add_svy_extra_rows (_survey_extras_ui.py:18–46) ile kurulur. Varsayılanlar bu iki dosyadan okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Ağırlık: | (yok) | Örnekleme ağırlığı w_i. İsteğe bağlıdır; (yok) seçilirse her gözlemin ağırlığı 1 alınır. | Nokta kestirimini, SH'yi ve DEFF'i değiştirir. |
| Tabaka: | (yok) | Tabaka değişkeni h. | Varyans yalnız tabaka içi farklardan hesaplanır; tasarım sd'si \#\text{PSU}-H olur. Ortalamayı değiştirmez. |
| Küme / PSU: | (yok) | Birincil örnekleme birimi. (yok) ise her gözlem kendi PSU'sudur. | Varyans PSU toplamlarından hesaplanır; sd küçülür. Ortalamayı değiştirmez. |
| FPC (popülasyon): | (yok) | Sonlu evren düzeltmesi. Değerler > 1 ise tabakadaki evren büyüklüğü N_h (kümeli tasarımda evrendeki PSU sayısı), tümü ≤ 1 ise örnekleme oranı f_h. | Tabaka katkısını (1-f_h) ile küçültür. |
| Alt grup (by): | (yok) | Her düzey için ayrı domain kestirimi. | Ek satırlar; tasarım tüm örneklemden korunur. |
| Hedef değişken(ler): | — | Bir ya da daha çok sayısal değişken. Ağırlık sütunu listede seçilmişse çıkarılır (stats_panel.py:8038). |
Her değişken ayrı satırdır; çoklu karşılaştırma söz konusu değildir. |
| DEFF paydası: | Otomatik | Tasarım etkisinin paydasındaki BRÖ varyansı: Otomatik (FPC yoksa iadeli, varsa iadesiz), İadesiz (sonlu evren düzeltmeli), İadeli (WR; FPC'siz). | Yalnız DEFF ve DEFT'i değiştirir; kestirimi, SH'yi ve GA'yı değiştirmez. |
| Güven Düzeyi | %95 | %90, %95, %99 ya da özel değer. | GA genişliği; t kantili tasarım sd'siyle. |
| Ek çıktılar: Ağırlıksız n ve ağırlık toplamı (N̂) | kapalı | Değişken (ve domain) başına geçerli n ve \sum w. | Ek tablo. |
| Ek çıktılar: Domainler arası farklar (kontrast) | kapalı | Alt grup çiftleri arasındaki fark, tasarım kovaryansıyla SH, t, p. | Ek tablo; yalnız Alt grup seçiliyse. |
| Oran kestirimi (Y / X) | boş | \hat R=\sum wy/\sum wx ve Taylor SH'si. | Ek satır. |
| Yüzdelikler (ör. 0.25, 0.5) | boş | Ağırlıklı yüzdelikler ve Woodruff GA'sı. | Ek tablo. |
| Tek PSU'lu tabaka | Katkısız (certainty) | Tek PSU'lu tabakanın varyansa katkısı: sıfır (certainty) ya da genel PSU ortalamasına göre (adjust). | Yalnız tek PSU'lu tabaka varsa SH değişir. |
| Varyans yöntemi: | Taylor | Taylor; ya da jackknife, BRR, Fay BRR, Rao–Wu bootstrap, hazır replikasyon ağırlıkları. | SH ve sd yöntemle değişir; bu bölüm Taylor yolunu anlatır. |
Neden Otomatik payda iadeli BRÖ?
DEFF, tasarımın varyansını "aynı n ile BRÖ yapılsaydı" varyansına böler (Kish 1965). Bu "BRÖ varyansı" iki türlü tanımlanır: iadeli seçimde s^2/n, iadesiz seçimde (1-f)\,s^2/n. İadesiz biçim evren büyüklüğünü gerektirir; bu bilgi ancak sonlu evren düzeltmesi (FPC) verilmişse vardır. FPC yokken N yerine ağırlık toplamı \hat N=\sum w konursa ve ağırlıklar göreli ise (\sum w\approx n), 1-n/\hat N sıfıra yaklaşır, payda çöker ve DEFF yapay olarak büyür: Tıp verisinde (\sum w/n=1{,}083) 0,65 yerine 8,45 çıkardı. Bu yüzden Otomatik payda FPC yoksa iadeli, FPC verilmişse iadesiz BRÖ'dür (_resolve_deff_basis); R svymean(deff = "replace") aynı tanımı verir. Kullanılan payda ve gerekçesi çıktıda yazılır (bkz. 93.6, Adım 5).
Ağırlık isteğe bağlı. Ağırlıksız bir tabakalı ya da kümeli tasarım için forma "(yok)" seçeneği vardır (survey_means.py:63–69); kullanıcının veriye sabit 1 sütunu eklemesi gerekmez. Seçilirse with_unit_weight (survey_design.py:34–45) verinin bir kopyasına __mq_agirlik_1__ adlı, tüm değerleri 1 olan bir iç sütun ekler ve tasarım bu sütunla kurulur. Bu, R svydesign()'ın ağırlık ya da olasılık verilmediğinde yaptığıyla aynıdır ("No weights or probabilities supplied, assuming equal probability"). Uygulanan ayar, sonuç metninin "İstenen ve uygulanan ayarlar" bloğuna "tüm ağırlıklar 1 (ağırlıksız tasarım)" diye yazılır. Ağırlıksız tasarımda da Otomatik DEFF paydası (FPC yoksa) iadelidir.
93.4 Tıp örneği
Dosya: english/datasets/Tip/78_survey_means_bp.xlsx (Türkçe kopya samples/Tum_Analiz_Tip/78_survey_means_KB.xlsx). Değişken seçimi VIDEO_SCRIPT_TR.txt #78 ve SUNUMLAR_TR/78_survey_means_bp_TR.pptx ile aynıdır.
| Değişken | Rol | Tür | Açıklama |
|---|---|---|---|
systolic_bp |
Hedef | sürekli (mmHg) | Sistolik kan basıncı; ağırlıksız ortalama 131,67, SS 19,19 |
weight |
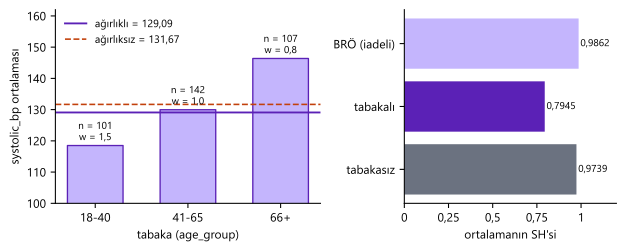
Ağırlık | sürekli | Tabaka içinde sabit: 18-40 → 1,5; 41-65 → 1,0; 66+ → 0,8 |
age_group |
Tabaka | 3 düzey | 18-40 (n=101), 41-65 (n=142), 66+ (n=107) |
patient_id |
kullanılmaz |
n ve eksik değer: 350 kişi, hiçbir sütunda eksik yok. Küme sütunu yoktur; her kişi kendi PSU'sudur. Ağırlık toplamı \sum w=379{,}1; \sum w/n=1{,}083. Ağırlıklar göreli ağırlıktır: evren büyüklüğünü değil, yaş gruplarının evrendeki payını düzeltir. Yaşlılar örneklemde fazla, gençler az temsil edilmiştir.
Klinik soru: Tarama yapılan evrende yetişkinlerin ortalama sistolik kan basıncı nedir? Örneklemdeki yaş dağılımı evreninkinden farklı olduğu için ağırlıksız ortalama yanıltıcı mıdır?
Seçilen ayarlar: Ağırlık weight, tabaka age_group, küme ve FPC yok, DEFF paydası Otomatik, %95. Karşılaştırma için şu çalıştırmalar da yapılmıştır: tabakasız; ağırlıksız; iadeli ve iadesiz DEFF paydası; %99; Alt grup = age_group.
Kümeli ikinci örnek. #78 verisinde küme yoktur. Küme etkisini göstermek için Tıp setindeki 91_survey_phreg_death.xlsx dosyası kullanılmıştır: hedef age (yaş), ağırlık weight, tabaka region (A, B, C), küme clinical_id. Her bölgede 15 klinik vardır; klinik numaraları 1–15 üç bölgede de tekrar eder. 300 hasta, 45 PSU (bölge × klinik), \sum w=464{,}639.
Şekil 93.1. Sol: üç yaş tabakasının sistolik KB ortalaması, ağırlıklı ve ağırlıksız genel ortalama. Sağ: ağırlıklı ortalamanın SH'si; tabakasız tasarım, tabakalı tasarım ve iadeli BRÖ varsayımı.
93.5 Formüller ve hesap adımları
MerQur'un izlediği sıra şudur:
- Ağırlık yoksa 1 sütunu ekler.
- FPC'yi denetler ve evren büyüklüğüne çevirir; tasarım sütunu eksik olan satırları atar; tek PSU'lu tabakaları ve negatif ağırlıkları bildirir (
_prep_design, 759–787). - PSU kimliğini (tabaka, küme) çiftinden kurar ve tasarımı
svykütüphanesine verir (_build_design, 302–360). - Her hedef için ağırlıklı ortalamayı ve Taylor SH'sini hesaplar. Hedefte eksik varsa ya da tek PSU kuralı "adjust" ise aynı hesabı kendi
_domain_taylorişleviyle yapar (711–736). - GA'yı t(tasarım sd) ile kurar.
- CV'yi ve seçilen paydayla DEFF/DEFT'i ekler.
İki yol (svy ve _domain_taylor) aynı formülü uygular. Bu bölümdeki doğrulama ikisini de kapsar.
93.5.1 Ağırlıklı ortalama (Hájek kestiricisi)
- s: örneklemdeki gözlemler (n tane).
- w_i: i. gözlemin örnekleme ağırlığı; ağırlık seçilmemişse 1.
- \hat N: evren büyüklüğünün kestirimi (ağırlık toplamı).
- \hat Y: evren toplamının Horvitz–Thompson kestirimi (Bölüm 95).
- \hat{\bar Y}: evren ortalamasının kestirimi; çıktıda
M̂.
Neden toplamı ağırlık toplamına bölmek?
Evren büyüklüğü N bilinse bile \hat Y/N yerine \hat Y/\hat N kullanılır. Ağırlıklar yalnız göreli doğruysa da (toplamları N'ye eşit olmasa da) oran kestiricisi aynı sonucu verir; ağırlıkları bir sabitle çarpmak \hat{\bar Y}'yi değiştirmez. Ayrıca pay ve paydadaki örnekleme dalgalanması birbirini kısmen dengeler; bu yüzden oran kestiricisi genellikle daha kararlıdır. Bu kestirici Hájek kestiricisi olarak bilinir. Bir oran olduğundan hafif yanlıdır, ama yanlılık O(1/n) düzeyindedir ve büyük örneklemde ihmal edilir.
93.5.2 Taylor doğrusallaştırması: ortalamayı bir toplama çevirmek
\hat{\bar Y} doğrusal olmayan bir kestiricidir; iki toplamın oranıdır. Varyansını doğrudan yazmak zordur. Taylor doğrusallaştırması (Woodruff 1971; Binder 1983), oranı gerçek değeri çevresinde birinci dereceden açar:
Böylece \hat{\bar Y}'nin varyansı, z_i değerlerinin ağırlıksız toplamının varyansına eşitlenir. Toplamların tasarım varyansı için kapalı bir formül vardır. Uygulamada bilinmeyen \bar Y ve N yerine kestirimleri konur. MerQur'un kullandığı doğrusallaştırılmış değişken (etki fonksiyonu) şudur (survey_design.py:782; svy aynı tanımı kullanır, R svymean içinde x * pweights / psum sonra merkezleme):
- z_i: i. gözlemin ortalamaya "katkısı"; ağırlıklı sapmanın ağırlık toplamına bölümü.
- \sum_i z_i=0 olur; \hat{\bar Y} tanımı gereği.
- Büyük ağırlıklı ve ortalamadan uzak gözlemler büyük z_i alır; varyansa en çok onlar katkı verir.
Neden "doğrusallaştırma" deniyor?
Oran g(\hat Y,\hat N)=\hat Y/\hat N biçiminde bir fonksiyondur. Birinci dereceden Taylor açılımı g(\hat Y,\hat N)\approx g(Y,N)+\partial_Y g\,(\hat Y-Y)+\partial_N g\,(\hat N-N) olur; kısmi türevler 1/N ve -Y/N^2'dir. Sonuç iki toplamın doğrusal birleşimidir. Doğrusal birleşimin varyansı, gözlem başına z_i değerlerinin toplamının varyansıdır. Bu yaklaşım, PSU sayısı büyüdükçe doğru varyansa yakınsar (Binder 1983). Küçük PSU sayısında jackknife ya da BRR gibi replikasyon yöntemleri tercih edilebilir; MerQur bunları "Varyans yöntemi" seçeneğinde sunar.
93.5.3 Tabakalı, kümeli tasarım varyansı
z_i önce PSU içinde toplanır, sonra her tabakada PSU toplamlarının yayılımı ölçülür (_taylor_meat, 428–472):
- h=1,\dots,H: tabakalar; tabaka yoksa H=1.
- j=1,\dots,n_h: h. tabakadaki örneklenmiş PSU'lar; küme yoksa her gözlem bir PSU'dur, n_h tabakadaki gözlem sayısıdır.
- z_{hj}: (h,j) PSU'sundaki z_i'lerin toplamı.
- \bar z_h: tabakadaki PSU toplamlarının ortalaması.
- f_h: örnekleme oranı; FPC verilmemişse 0.
- n_h/(n_h-1): tabaka içi örneklem varyansının yansızlık çarpanı.
Neden varyans PSU toplamlarından hesaplanıyor?
Kümeli tasarımda bağımsız olan birimler bireyler değil, PSU'lardır. Aynı klinikteki hastaların değerleri ilişkili olabilir. Bu ilişkiyi modellemek yerine, her PSU'nun toplam katkısını tek bir bağımsız gözlem saymak, küme içi korelasyonu otomatik olarak hesaba katar. Buna "nihai küme" (ultimate cluster) yaklaşımı denir. Yalnız birinci aşama birimlerinin iadeli seçildiği varsayılır; ikinci ve sonraki aşamaların varyansı PSU toplamlarının yayılımının içinde kalır. R survey aynı varsayılanı kullanır.
Neden tabaka içi merkezleme?
Tabakalar evrenden ayrı ayrı örneklendiği için tabakalar arasındaki fark bir rastlantı kaynağı değildir. Her tabakada PSU toplamları kendi ortalamaları \bar z_h çevresinde merkezlenir. Böylece yalnız tabaka içindeki dalgalanma varyansa girer. Tabaka değişkeni sonuçla ilişkiliyse (yaş grubu ve kan basıncı gibi) tabakalama varyansı belirgin biçimde azaltır. Tıp örneğinde SH tabakasız 0,9739'dan tabakalı 0,7945'e iner; varyans %33 azalır (93.6, Adım 6).
Klasik tabakalı formülle bağlantı. Küme yoksa ve ağırlık tabaka içinde sabitse (w_i=w_h), z_{hi}-\bar z_h=w_h(y_{hi}-\bar y_h)/\hat N olur ve formül sadeleşir:
- \hat N_h/\hat N: tabakanın evrendeki kestirilen payı.
- s_h^2: tabaka içi örneklem varyansı (n_h-1 paydalı).
Bu, ders kitaplarındaki tabakalı ortalama varyansıdır (Cochran 1977, bölüm 5). Taylor formülü bu özel durumu kendiliğinden verir; Tıp örneğindeki elle hesap bu biçimle yapılmıştır.
Koddaki tercih: PSU'lar her zaman tabaka içinde iç içe
Hem tabaka hem küme seçilmişse MerQur PSU kimliğini tabaka + "\x1f" + küme dizgisinden kurar (survey_design.py:363–370). Aynı küme etiketi farklı tabakalarda görünürse bunlar farklı PSU sayılır. Bu, R svydesign(..., nest = TRUE) davranışıdır. R'nin varsayılanı nest = FALSE'tur ve Tıp #91 verisinde "Clusters not nested in strata at top level; you may want nest=TRUE." hatasıyla durur. Küme etiketleri zaten tabakalar arasında tekilse sonuç değişmez.
Koddaki tercih: kümesiz tasarımda PSU sayısı
Küme seçilmemişse svy motoru PSU sayısını 1 döndürür. MerQur bunu gözlem sayısıyla değiştirir ve çıktıda "350 (küme yok: her gözlem bir PSU)" yazar (_mark_unit_psu, 363–371). Tasarım sd'si n-H olur. R svydesign(ids = ~1) ile aynıdır.
93.5.4 Tasarım serbestlik derecesi ve güven aralığı
- \#\text{PSU}: örneklemdeki toplam PSU sayısı (küme yoksa n).
- H: tabaka sayısı.
- t_{1-\alpha/2,\,\sd}: t dağılımının üst kantili; %95 için \alpha=0{,}05.
Neden sd = PSU sayısı − tabaka sayısı?
Varyans formülünde bağımsız bilgi kaynağı PSU toplamlarıdır. Her tabakada n_h PSU toplamı vardır ve tabaka ortalaması \bar z_h çıkarıldığı için bir serbestlik kaybedilir. Toplam serbestlik \sum_h(n_h-1)=\#\text{PSU}-H'dir. Bu, R degf()'in verdiği "tasarım sd"sidir. Kümeli tasarımlarda bu sayı gözlem sayısından çok küçük olabilir. Tıp #91 örneğinde 300 hasta vardır ama sd yalnız 45-3=42'dir; #79'un ikinci dosyasında 500 kişi için sd 16'dır. Küçük sd, t kantilini büyütür ve GA'yı genişletir.
Kodda GA %95 düzeyinde svy kütüphanesinin döndürdüğü lci/uci değerlerinden alınır. Başka bir güven düzeyi seçilirse apply_svy_extras aynı SH ile yeniden kurar (_survey_extras_ui.py:304–313). İki yol aynı t(tasarım sd) tanımını kullanır; doğrulama tablosunda %95 ve %99 GA'nın ikisi de R ile eşleşir.
Değişim katsayısı:
Çıktıda yüzde olarak yazılır (%0.62). Bazı resmî istatistik kurumları belirli bir CV eşiğinin (ör. %30) üstündeki kestirimleri güvenilmez sayar. MerQur böyle bir eşik uygulamaz.
93.5.5 Tasarım etkisi (DEFF) ve DEFT
Tasarım etkisi, karmaşık tasarımın varyansını aynı n ile yapılmış bir BRÖ'nün varyansına oranlar (Kish 1965):
MerQur paydayı şöyle kurar (_srs_var_mean, 475–499; R svymean(deff=) kaynağıyla aynı):
- s_w^2: ağırlıklı evren varyansı kestirimi; n/(n-1) çarpanı R
svyvarile aynıdır. - n: geçerli (ağırlığı sıfırdan farklı) gözlem sayısı.
- (\hat N-n)/\hat N=1-n/\hat N: iadesiz seçimin sonlu evren düzeltmesi; \hat N ağırlık toplamıdır.
- DEFT: SH ölçeğinde tasarım etkisi; GA'nın BRÖ'ye göre kaç kat geniş olduğunu söyler.
Yorumu. DEFF = 1 ise tasarım BRÖ kadar verimlidir. DEFF > 1 ise tasarım daha az verimlidir (genellikle kümeleme ve değişken ağırlıklar yüzünden). DEFF < 1 ise daha verimlidir (genellikle etkili tabakalama yüzünden). Etkin örneklem büyüklüğü n_{\text{etkin}}=n/\text{DEFF} olarak okunur.
Koddaki tercih: Otomatik DEFF paydası
_resolve_deff_basis (survey_design.py:544–559): Otomatik seçimde FPC sütunu yoksa iadeli, varsa iadesiz payda kullanılır. İadesiz paydada FPC'li kümesiz tasarımda f=n/N FPC sütunundan, aksi hâlde \hat N=\sum w ile kurulur. Açıkça "İadesiz" ya da "İadeli (WR)" seçilirse seçim olduğu gibi uygulanır. Kullanılan payda ve gerekçesi çıktıda yazılır. İadeli payda R deff = "replace", \hat N'li iadesiz payda R svymean(deff = TRUE) tanımıdır. İadesiz paydada \hat N\le n ise payda tanımsızdır; DEFF "—" yazılır ve "'İadeli (WR)' paydasını seçin" notu çıkar. R aynı durumda Inf ya da NA verir.
Göreli ağırlıkta "İadesiz" paydayı seçmek
FPC olmadan "İadesiz" payda elle seçilirse \hat N=\sum w kullanılır. Tıp #78'de \sum w/n=1{,}083'tür; ağırlıklar göreli olduğu hâlde 1-n/\hat N=0{,}0768 çarpanı paydayı küçültür ve DEFF 8,45 çıkar (iadeli payda ile 0,65). 8,45 değeri "tasarım BRÖ'den 8 kat daha az verimli" gibi okunursa ciddi bir yanlış yorum doğar: tasarım aslında tabakalamadan kazanç sağlamıştır. R svymean(deff = TRUE) aynı 8,45'i verir; bu bir hesap hatası değil, tanım seçimidir. Aynı seçim Tıp #79'un kümeli dosyasında (\sum w/n=1{,}155) DEFF'i 1,42 yerine 10,61 yapar. Otomatik payda bu tuzağa düşmez.
93.5.6 Alt grup (domain) kestirimi
Alt grup seçildiğinde her düzey d için ortalama, veri süzülmeden kestirilir. Domain dışındaki gözlemler z_i=0 alır, tabaka ve PSU yapısı tüm örneklemden korunur (_domain_taylor, 711–736; svy by yolu aynı tanımı kullanır):
- \delta_{di}: gözlem d domaininde ise 1, değilse 0.
- Varyans, z_i^{(d)} ile 93.5.3'teki formülden; tasarım sd'si tüm tasarımın sd'sidir.
Neden veriyi süzüp ayrı analiz yapmıyoruz?
Domainin örneklemdeki büyüklüğü (kaç kişinin o domaine düştüğü) rastlantısaldır. Süzülmüş veride bu rastlantı yok sayılır. Ayrıca bir domainin hiç gözlem içermeyen PSU'ları ve tabakaları silinir; bu da sd'yi ve varyansı yanlış kurar. Doğru yol, domain göstergesini tasarımın içinde tutmaktır (Lumley 2010). R svyby aynı ilkeyi izler. Çıktı bunu "Alt grup kestirimleri domain (alt-popülasyon) kestirimidir: tam tasarım ... korunur; veri filtrelenmez." notuyla bildirir.
Alt grup satırları her çalıştırmada aynı sırada (düzeylerin doğal sırası) yazılır (_by_order, 697–708). Domain DEFF'inin paydası yalnız domainin gözlemlerinden kurulur; payda türü ana tabloyla aynıdır (Otomatik'te FPC yoksa iadeli, R svyby ile aynı).
93.5.7 FPC ve tek PSU'lu tabaka
FPC biçimi R as.fpc kuralıyla okunur (fpc_mode, 598–617). Tüm değerler ≤ 1 ise örnekleme oranıdır ve evren büyüklüğüne N_h=n_h/f_h ile çevrilir (_fpc_rate_to_popsize, 620–650). f_h=0 "iadeli, düzeltme yok" demektir. Herhangi biri > 1 ve hepsi ≥ 1 ise evren büyüklüğüdür. FPC tabaka içinde değişiyorsa tabakanın ilk geçerli değeri kullanılır ve uyarı yazılır (_normalize_fpc, 545–570). Çarpan şudur:
Burada n_h tabakadaki örneklenmiş PSU sayısıdır; kümeli tasarımda N_h evrendeki PSU sayısı olmalıdır. Bölüm 95'te FPC'li sayısal bir örnek vardır.
Tek PSU'lu tabaka (_taylor_meat, 457–466). n_h=1 iken tabaka içi varyans tanımsızdır. "Katkısız (certainty)" seçeneğinde tabaka varyansa hiç katkı vermez; R'de bu davranış options(survey.lonely.psu = "certainty") ile elde edilir. R'nin varsayılanı "fail"dir; R bu durumda hata verir. "Ortalamaya göre (adjust)" seçeneğinde tabakanın PSU toplamı, tüm PSU toplamlarının ortalamasına göre merkezlenir ve (1-f_h) ile çarpılır (R "adjust"). Bu seçenek açıksa ve tek PSU'lu tabaka varsa, ortalama svy yerine _domain_taylor ile hesaplanır (survey_design.py:973, 934).
93.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Aşağıdaki değerler dogrulama/survey_means/elle_hesap.py ile, MerQur kodu çağrılmadan numpy ile hesaplanmıştır. Metinde 6 anlamlı ondalık gösterilir.
Adım 1 — Tabaka özetleri.
| Tabaka | n_h | w_h | \hat N_h=w_hn_h | \bar y_h | s_h |
|---|---|---|---|---|---|
| 18-40 | 101 | 1,5 | 151,5 | 118,504950 | 11,976330 |
| 41-65 | 142 | 1,0 | 142,0 | 129,971831 | 14,605908 |
| 66+ | 107 | 0,8 | 85,6 | 146,364486 | 20,160391 |
| Toplam | 350 | 379,1 |
Adım 2 — Ağırlıklı ortalama.
Ağırlıksız ortalama 131,674286'dır. Yaşlılar (yüksek kan basıncı) örneklemde fazla temsil edildiği için ağırlıksız ortalama evren ortalamasını yaklaşık 2,6 mmHg büyük kestirir.
Adım 3 — Taylor varyansı. Ağırlık tabaka içinde sabit ve küme yok; 93.5.3'teki sade biçim geçerlidir. Her tabakanın katkısı:
Betik genel formülü uygular (her gözlem için z_i, tabaka içi merkezleme, n_h/(n_h-1) çarpanı); tabaka katkıları yukarıdaki sade biçimle aynı çıkar.
Adım 4 — sd, GA ve CV. \sd=350-3=347, t_{0{,}975;\,347}=1{,}966824:
%99 için t_{0{,}995;\,347}=2{,}590072 ve GA [127{,}032896;\ 131{,}148587]'dir.
Adım 5 — DEFF. Ağırlıklı varyans s_w^2=340{,}433703:
FPC verilmediği için Otomatik payda iadeli seçilir ve çıktıda DEFF = 0,6490 yazılır. Tabakalı tasarım, aynı n'li bir BRÖ'den daha kesindir; etkin örneklem büyüklüğü yaklaşık 350/0{,}65\approx539'dur. İadesiz payda elle seçilseydi göreli ağırlıklar yüzünden 8,45 çıkardı (93.5.5 uyarısı).
Adım 6 — Tabakalamanın kazancı. Aynı ağırlıklarla tabaka belirtilmezse tek tabaka vardır ve tüm gözlemler genel ortalama çevresinde merkezlenir: \widehat V=0{,}948557, \SH=0{,}973939, sd 349. Tabakalı varyans bunun 0{,}631251/0{,}948557=0{,}665 katıdır. Yaş grupları arasındaki büyük ortalama farkı (118 ile 146 mmHg) tabakalı tasarımda varyansa girmez.
Adım 7 — Ağırlıksız tasarım. Ağırlık "(yok)" seçilip tabaka korunursa w_i=1:
FPC olmadığından Otomatik payda iadelidir. Bu sonuç, örneklemin kendisinin ortalamasıdır; evren ortalamasının yansız kestirimi değildir. Tabaka bilgisi SH'yi BRÖ'ye göre yine küçültür (BRÖ SH'si 19{,}190261/\sqrt{350}=1{,}025763).
Adım 8 — Alt grup (by = age_group). Domain tabakayla çakıştığı için her domain SH'si s_h/\sqrt{n_h}'ye eşittir: 18-40 için 118{,}504950 (SH 1,191689), 41-65 için 129{,}971831 (SH 1,225701), 66+ için 146{,}364486 (SH 1,948979). İadeli DEFF her üçünde tam 1'dir: domain içinde ağırlık sabit ve tasarım BRÖ'dür; Otomatik payda iadeli olduğundan çıktı da 1 yazar. İadesiz payda elle seçilseydi 18-40 domaininde \hat N_d=151{,}5>n_d=101 olur ve DEFF 1/(1-101/151{,}5)=3{,}00 çıkardı; öteki iki domainde \hat N_d\le n_d olduğundan payda tanımsız kalırdı ("—"). Bu değerlerin tasarımla ilgisi yoktur.
Adım 9 — Kümeli örnek (Tıp #91, yaş). 45 PSU, 3 tabaka, \sd=42:
| Kümeli (bölge × klinik) | Küme yok sayılırsa | |
|---|---|---|
| \hat{\bar Y} | 62,109225 | 62,109225 |
| Tabaka katkıları A / B / C | 0,250809 / 0,221157 / 0,183859 | 0,244399 / 0,208843 / 0,193346 |
| \widehat V | 0,655825 | 0,646589 |
| SH | 0,809830 | 0,804107 |
| sd | 42 | 297 |
| t_{0{,}975} | 2,018082 | 1,967984 |
| %95 GA | [60,474921; 63,743528] | [60,526755; 63,691694] |
| DEFF (iadeli / iadesiz) | 1,142656 / 3,224768 | 1,126563 / 3,179351 |
Bu veride klinikler içinde yaşlar pek benzeşmez; kümeleme varyansı yalnız %1,4 artırır. Asıl fark sd'dedir: 297 yerine 42 sd, t kantilini 1,968'den 2,018'e çıkarır. Kümeyi yok saymak SH'yi az, GA'yı biraz daha fazla küçültür.
93.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri panelin execute() fonksiyonunun döndürdüğü sonuç nesnesinden alınmıştır (dogrulama/survey_means/merqur_calistir.py). Motor sonuç nesnelerinde round() kullanılmadığı için ek bir hassasiyet ayarı gerekmemiştir. Python değerleri elle_hesap.py (yalnız numpy ve scipy dağılım fonksiyonları), R değerleri r_dogrulama.R (R 4.5.3, survey 4.5: svydesign, svymean(deff = TRUE / "replace"), svyby, confint(df = degf()), cv) ile üretilmiştir. Kümeli örnekte R'de nest = TRUE kullanılmıştır. Ölçüt: en büyük fark \le10^{-6} (değer 1'den büyükse göreli).
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 (survey 4.5) | En büyük fark | Durum |
|---|---|---|---|---|---|
| Tabakalı, ağırlıklı (varsayılan): \hat{\bar Y} | 129,090741 | 129,090741 | 129,090741 | 2,3e−13 | ✓ |
| Tabakalı, ağırlıklı (varsayılan): SH | 0,794513 | 0,794513 | 0,794513 | 1,7e−15 | ✓ |
| Tabakalı, ağırlıklı (varsayılan): GA alt | 127,528074 | 127,528074 | 127,528074 | 3,6e−13 | ✓ |
| Tabakalı, ağırlıklı (varsayılan): GA üst | 130,653408 | 130,653408 | 130,653408 | 3,1e−13 | ✓ |
| Tabakalı, ağırlıklı (varsayılan): tasarım sd | 347 | 347 | 347 | 0,0e+00 | ✓ |
| Tabakalı, ağırlıklı (varsayılan): DEFF | 0,648989 | 0,648989 | 0,648989 | 2,8e−15 | ✓ |
| Varsayılan: CV | 0,006155 | 0,006155 | 0,006155 | 2,6e−18 | ✓ |
| DEFF, iadeli payda (elle seçim) | 0,648989 | 0,648989 | 0,648989 | 2,8e−15 | ✓ |
| DEFF, iadesiz payda (elle seçim) | 8,454701 | 8,454701 | 8,454701 | 3,6e−14 | ✓ |
| %99 GA alt | 127,032896 | 127,032896 | 127,032896 | 1,8e−12 | ✓ |
| %99 GA üst | 131,148587 | 131,148587 | 131,148587 | 1,8e−12 | ✓ |
| Tabakasız: \hat{\bar Y} | 129,090741 | 129,090741 | 129,090741 | 2,3e−13 | ✓ |
| Tabakasız: SH | 0,973939 | 0,973939 | 0,973939 | 3,4e−15 | ✓ |
| Tabakasız: tasarım sd | 349 | 349 | 349 | 0,0e+00 | ✓ |
| Tabakasız: DEFF | 0,975211 | 0,975211 | 0,975211 | 6,8e−15 | ✓ |
| Ağırlıksız: \hat{\bar Y} | 131,674286 | 131,674286 | 131,674286 | 2,8e−13 | ✓ |
| Ağırlıksız: SH | 0,848861 | 0,848861 | 0,848861 | 3,3e−16 | ✓ |
| Ağırlıksız: GA alt | 130,004726 | 130,004726 | 130,004726 | 3,7e−13 | ✓ |
| Ağırlıksız: GA üst | 133,343845 | 133,343845 | 133,343845 | 2,8e−14 | ✓ |
| Ağırlıksız: tasarım sd | 347 | 347 | 347 | 0,0e+00 | ✓ |
| Ağırlıksız: DEFF | 0,684824 | 0,684824 | 0,684824 | 3,3e−16 | ✓ |
| Alt grup 18-40: \hat{\bar Y}_d | 118,504950 | 118,504950 | 118,504950 | 5,0e−13 | ✓ |
| Alt grup 18-40: SH | 1,191689 | 1,191689 | 1,191689 | 1,1e−15 | ✓ |
| Alt grup 41-65: \hat{\bar Y}_d | 129,971831 | 129,971831 | 129,971831 | 4,8e−13 | ✓ |
| Alt grup 41-65: SH | 1,225701 | 1,225701 | 1,225701 | 3,3e−15 | ✓ |
| Alt grup 66+: \hat{\bar Y}_d | 146,364486 | 146,364486 | 146,364486 | 6,8e−13 | ✓ |
| Alt grup 66+: SH | 1,948979 | 1,948979 | 1,948979 | 4,4e−15 | ✓ |
| Alt grup 18-40: DEFF (iadeli, otomatik) | 1,000000 | 1 | 1 | 2,2e−16 | ✓ |
| Alt grup 41-65: DEFF (iadeli, otomatik) | 1,000000 | 1,000000 | 1 | 5,6e−16 | ✓ |
| Alt grup 66+: DEFF (iadeli, otomatik) | 1,000000 | 1,000000 | 1 | 4,4e−15 | ✓ |
| Kümeli (Tıp #91: bölge × klinik): \hat{\bar Y} | 62,109225 | 62,109225 | 62,109225 | 2,1e−14 | ✓ |
| Kümeli (Tıp #91: bölge × klinik): SH | 0,809830 | 0,809830 | 0,809830 | 5,6e−16 | ✓ |
| Kümeli (Tıp #91: bölge × klinik): GA alt | 60,474921 | 60,474921 | 60,474921 | 4,3e−14 | ✓ |
| Kümeli (Tıp #91: bölge × klinik): GA üst | 63,743528 | 63,743528 | 63,743528 | 2,1e−14 | ✓ |
| Kümeli (Tıp #91: bölge × klinik): tasarım sd | 42 | 42 | 42 | 0,0e+00 | ✓ |
| Kümeli (Tıp #91: bölge × klinik): DEFF | 1,142656 | 1,142656 | 1,142656 | 1,3e−15 | ✓ |
| Kümeli: PSU sayısı | 45 | 45 | 45 | 0,0e+00 | ✓ |
| Kümeli: DEFF (iadeli, elle seçim) | 1,142656 | 1,142656 | 1,142656 | 1,3e−15 | ✓ |
| Küme yok sayılırsa: SH | 0,804107 | 0,804107 | 0,804107 | 6,7e−16 | ✓ |
Sonuç: 39 büyüklüğün tamamı ölçütü karşılar. Farkların büyük çoğunluğu 10^{-13} düzeyindedir. Alt grup DEFF'leri Otomatik (iadeli) paydayla üç domainde de 1'dir; R svyby(deff = "replace") aynı değeri verir. İadesiz payda yalnız elle seçildiğinde kullanılır ve tablodaki ayrı satırda karşılaştırılmıştır. Ek çıktılar (domain karşılaştırması, oran, yüzdelik) bu tabloda yer almaz.
93.7 Çıktıyı okuma
Varsayılan ayarlarla sonuç metni (künye bloğu kısaltılmış):
Karmaşık Anket — Ağırlıklı Ortalama (Taylor SE)
  N (gözlem)     = 350
  PSU sayısı     = 350 (küme yok: her gözlem bir PSU)
  Tabaka sayısı  = 3
  Tasarım df     = 347

  systolic_bp    M̂ = 129.0907   SE = 0.7945   %95 GA = [127.5281, 130.6534]   CV =  %0.62

Tasarım etkisi (DEFF = tasarım varyansı / BRÖ varyansı, DEFT = √DEFF)
  BRÖ paydası: iadeli, FPC'siz
  (Payda otomatik seçildi: sonlu evren düzeltmesi verilmediği için referans iadeli basit rastgele örneklemdir.)
  systolic_bp    DEFF =   0.6490   DEFT =   0.8056

── APA 7 ÖZET ──
  systolic_bp: M = 129.09, SE = 0.79, %95 GA [127.53, 130.65], DEFF = 0.65
N = 350, tasarım df = 347
| Satır | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| N (gözlem) | Tasarım temizliğinden sonra kalan satır sayısı | Eksik hedefli satırlar burada sayılır; değişken başına n uyarı satırındadır. |
| PSU sayısı | Örneklenmiş PSU sayısı; kümesizse gözlem sayısı ve açıklama | sd'nin kaynağı; az PSU, geniş GA demektir. |
| Tasarım df | \#\text{PSU}-H | GA'daki t kantilinin sd'si. |
M̂ |
\hat{\bar Y} | Evren ortalamasının kestirimi. |
SE |
Taylor SH | Tasarımı hesaba katan belirsizlik. |
%95 GA |
\hat{\bar Y}\pm t\cdot\SH | Güven düzeyi değiştirilirse etiket ve sınırlar değişir; %95 dışında "Güven aralıkları: %99, Wald (simetrik) (t, tasarım df)." notu eklenir. |
CV |
SH/kestirim, yüzde | Göreli kesinlik. |
| BRÖ paydası | iadeli ya da iadesiz ve Otomatik ise seçimin gerekçesi (FPC verildi mi) | DEFF'i yorumlamadan önce bu satırı okuyun (93.5.5). |
DEFF, DEFT |
Varyans ve SH ölçeğinde tasarım etkisi | Paydası tanımsızsa "—" ve dipnot. |
| APA satırı | M, SE, GA, DEFF |
Ondalık noktayla yazılır; Türkçe metne aktarırken virgüle çevirin. |
| Uyarılar | "Uyarı:" önekiyle tasarım notları | Eksik değer, atılan satır, FPC biçimi, tek PSU, negatif ağırlık (_note_lines, 2079–2084). |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Yaş grubuna göre tabakalanmış ve ağırlıklandırılmış tarama örnekleminde (n=350; 3 tabaka; tasarım sd = 347), yetişkinlerin ortalama sistolik kan basıncı 129,09 mmHg olarak kestirildi (Taylor doğrusallaştırmalı SH = 0,79; %95 GA [127,53; 130,65]; CV = %0,62). Ağırlıksız örneklem ortalaması 131,67 mmHg idi; fark, yaşlı katılımcıların örneklemde fazla temsil edilmesinden kaynaklanmaktadır. İadeli BRÖ paydasıyla tasarım etkisi DEFF = 0,65 bulundu; tabakalama kestirimin kesinliğini artırmıştır.
93.8 Uzman soruları
S1. Taylor SH'si hangi varsayımla doğru? PSU'lar gerçekte iadesiz seçildi.
Formül, PSU'ların tabaka içinde iadeli seçildiğini varsayar (_taylor_meat, 428–472). İadesiz seçimde gerçek varyans biraz daha küçüktür; fark 1-f_h çarpanıdır ve FPC sütunu verilirse uygulanır. Örnekleme oranı küçükse (ör. %5'in altı) iadeli varsayım ihmal edilebilir bir aşırı kestirim üretir ve tutucu taraftadır. İkinci aşama varyansları ayrıca modellenmez; "nihai küme" yaklaşımı onları PSU toplamlarının içinde tutar. Bu, R survey paketinin varsayılanıdır.
S2. DEFF'in referansı neden iadeli basit rastgele örneklem?
Kish'in (1965) tanımında DEFF, aynı n'lik basit rastgele örneklem varyansına oranlanır. İadesiz varyans evren büyüklüğünü ister; FPC verilmemişse bu bilgi yoktur ve ağırlık toplamından tahmin etmek göreli ağırlıklarda paydayı çökertir: Tıp örneğinde \sum w/n=1{,}083 iken 1-n/\hat N=0{,}077 olur ve DEFF 0,65 yerine 8,45 çıkar. R svymean(deff = TRUE) 8,45'i verir; R deff = "replace" 0,65'i. MerQur FPC yoksa iadeli, varsa iadesiz paydayı kullanır ve raporda paydanın türü yazılmalıdır.
S3. Ağırlık seçmeden çalıştırdım. Sonuç "ağırlıklı ortalama" mı?
Hayır. Ağırlık "(yok)" seçilebilir; her gözlem 1 ağırlık alır (with_unit_weight, survey_design.py:34–45). Nokta kestirimi örneklem ortalamasıdır. SH ise tabaka ve küme yapısından hesaplanır. Bu, eşit olasılıklı ama tabakalı ya da kümeli tasarımlar için doğrudur (ör. her tabakadan orantılı seçim). Seçilme olasılıkları eşit değilse sonuç yanlıdır; Tıp örneğinde 2,6 mmHg fark eder. Uygulanan ayar sonuç metninin ayar bloğunda "tüm ağırlıklar 1 (ağırlıksız tasarım)" diye görünür.
S4. Tasarım sd'si neden PSU sayısına bağlı, gözlem sayısına değil?
Varyans PSU toplamlarının tabaka içi yayılımından kestirilir; bağımsız bilgi PSU sayısı kadardır. Her tabakada bir ortalama çıkarıldığından sd \#\text{PSU}-H'dir. Tıp #91'de 300 hasta ama 42 sd vardır. R degf() aynı tanımı kullanır. Alt grup kestiriminde de sd tüm tasarımınkidir.
S5. Aynı klinik numarası üç bölgede de geçiyor. MerQur bunları tek PSU mu sayar?
Hayır. Tabaka ve küme birlikte verildiğinde PSU kimliği (tabaka, küme) çiftinden kurulur (survey_design.py:363–370); 15 klinik × 3 bölge = 45 PSU. R'de bu nest = TRUE ile elde edilir. R'nin varsayılanı nest = FALSE'tur ve bu veride hata verir. Etiketler gerçekten aynı fiziksel kümeyi gösteriyorsa (bir klinik iki tabakada birden), tasarım tabakalı değildir ve tabaka bilgisi yeniden düşünülmelidir.
S6. Hedef değişkende eksik değer var. Neden satırları silmiyor?
Silmek, eksikliğe göre küçülmüş bir alt örneklemi tam tasarım gibi kullanmak olur: bazı PSU'lar ve tabakalar kaybolur, sd ve varyans değişir. MerQur eksik değeri bir domain dışı sayar; tasarım tüm örneklemden korunur (survey_design.py:988–1007). R svymean(na.rm = TRUE) da böyledir. Bu yaklaşım eksikliğin rastgele (MCAR) olduğunu varsaymaz, ama ortalamanın "yanıt verenler" alt evrenine ait olduğunu kabul eder. Eksiklik bilgilendiriciyse ağırlık düzeltmesi ya da atama gerekir.
S7. Tek PSU'lu bir tabaka varsa ne olur? R hata veriyor.
R'nin varsayılanı survey.lonely.psu = "fail"dir. MerQur'un varsayılanı "Katkısız (certainty)"dir. Tabaka varyansa katkı vermez ve uyarı satırı yazılır (_lonely_note, 675–686). Bu davranış varyansı küçük kestirebilir. "Ortalamaya göre (adjust)" seçeneği PSU toplamını genel PSU ortalamasına göre merkezler; R "adjust" ile aynıdır ve tutucudur. Tek PSU'lu tabakalar çoksa tabakaları birleştirmek (collapsed strata) daha savunulabilir.
S8. Alt grup ortalamalarının farkı anlamlı mı, nasıl bakarım?
"Domainler arası farklar (kontrast)" ek çıktısı tüm domain çiftleri için \hat{\bar Y}_a-\hat{\bar Y}_b, tasarım kovaryansını içeren SH, t(tasarım sd), p ve GA verir (survey_extras.py:65–104). Domain ortalamalarının z değişkenleri birlikte tek bir kovaryans matrisinde toplanır; böylece iki domainin aynı PSU'ları paylaşmasından doğan kovaryans hesaba girer (R svycontrast ile aynı mantık). Çoklu karşılaştırma düzeltmesi yapılmaz; notta bu açıkça yazılır.
93.9 Sık hatalar ve tuzaklar
- Göreli ağırlıkta "İadesiz" paydayı seçmek. FPC olmadan iadesiz payda \hat N=\sum w ile kurulur; ağırlıklar göreliyse DEFF şişer. DEFF bloğundaki "BRÖ paydası" satırını okuyun; Otomatik ya da "İadeli (WR)" kullanın.
- Ağırlıksız çalıştırmayı evren kestirimi sanmak. "(yok)" eşit olasılık varsayar. Tasarım eşit olasılıklı değilse ortalama yanlıdır.
- Kümeyi tabaka yerine (ya da tersi) girmek. Klinik "Tabaka:" alanına girilirse 45 küçük tabaka oluşur ve tabaka içi varyans yalnız aynı klinikteki hastalardan hesaplanır; SH sistematik olarak küçülür. Klinikler seçim birimiyse Küme / PSU: alanına girilmelidir.
- Alt grup için veriyi süzüp yeniden çalıştırmak. Süzülmüş veride tabaka ve PSU yapısı bozulur. "Alt grup (by):" seçeneğini kullanın.
- Ağırlık sütununu hedef olarak da seçmek. Çağırma katmanı ağırlığı hedef listesinden sessizce çıkarır (
stats_panel.py:8038); ağırlığın ortalaması isteniyorsa aynı sütunun bir kopyası hedef yapılmalıdır. - FPC'yi yanlış ölçekte girmek. Kümeli tasarımda FPC evrendeki PSU sayısıdır, kişi sayısı değil. Oran ve büyüklük karışık girilirse MerQur durur; hepsi 1 girilirse de durur (R ile aynı).
- Tasarım sd'sini görmezden gelmek. Az PSU'lu tasarımda (ör. 20 PSU, 4 tabaka, sd 16) t kantili 2,12'dir; normal kantil (1,96) ile kurulan GA yanlış dar olur.
- APA satırını olduğu gibi aktarmak. APA satırı ondalık nokta kullanır ve DEFF'in hangi paydayla hesaplandığını yazmaz.
93.10 Kaynaklar
- Binder, D. A. (1983). On the variances of asymptotically normal estimators from complex surveys. International Statistical Review, 51(3), 279–292. https://doi.org/10.2307/1402588
- Cochran, W. G. (1977). Sampling techniques (3. baskı). Wiley.
- Horvitz, D. G., & Thompson, D. J. (1952). A generalization of sampling without replacement from a finite universe. Journal of the American Statistical Association, 47(260), 663–685. https://doi.org/10.1080/01621459.1952.10483446
- Kish, L. (1965). Survey sampling. Wiley.
- Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8), 1–19. https://doi.org/10.18637/jss.v009.i08
- Lumley, T. (2010). Complex surveys: A guide to analysis using R. Wiley. https://doi.org/10.1002/9780470580066
- Woodruff, R. S. (1952). Confidence intervals for medians and other position measures. Journal of the American Statistical Association, 47(260), 635–646. https://doi.org/10.1080/01621459.1952.10483443
- Woodruff, R. S. (1971). A simple method for approximating the variance of a complicated estimate. Journal of the American Statistical Association, 66(334), 411–414. https://doi.org/10.1080/01621459.1971.10482279